目录
- 摘要
- 前置术语界定:Vibe Coding / Agentic Coding / Agentic Software Engineering
- 一、引言:从 Code Change 到 Software Change 的范式转移
- 二、Software Change 模型:管理对象的精确定义
- 三、Git 的新位置:从 Software Change 控制面退回到 Source Code Control Plane
- 四、Agentic Git Workflow:把 Agent 纳入版本控制工作流
- 五、Context Engineering:把工程知识从 Prompt 升级为持久化资产
- 六、Agent Governance:四维边界模型
- 七、Verification:Risk-adaptive 证据体系
- 八、Software Change Record (SCR):Software Change 的可追溯实例
- 九、AI-Native SDLC:从需求到运维的端到端 Software Provenance
- 十、VIBE CODING ENGINEERING 框架:Intent / Context / Agent / Evidence / Change
- 十一、MVP 实施路线
- 结论
摘要
Vibe Coding 在 2025-2026 年迅速从"AI 辅助写代码"的工作方式,扩展为对软件工程全链条的重组力量。本文给出的"管理对象从 Code Change 升级为 Software Change"的核心判断,沿着 Git 工作流重设计这条具体主线,逐节给出工程化落地形态:
- 在 对象层,把 Software Change 精确定义为六个分量的复合对象,对应"为什么改 / 凭什么改 / 怎么改 / 改了什么 / 如何证明 / 谁批准"。
- 在 协议层,保留 Git 作为 Source Code Control Plane 的核心地位,但承认它只稳定承载 Software Change 中的 Code Change 子集;其余分量由专门系统承载。
- 在 工作流层,把 Agent 纳入 Git 工作流------Plan-first、Worktree 隔离、Intent-branch、SCR 关联、Commit 保持简洁。
- 在 Context 层,把 AGENTS.md 作为组织级 Canonical Policy Layer,把工具级 Rules(.cursor/rules、.github/copilot-instructions.md、CLAUDE.md)作为 Tool-specific Execution Layer。
- 在 Governance 层,用 Context / Capability / Execution / Approval 四维边界替代"四级权限"作为正式模型。
- 在 Verification 层,采用 Risk-adaptive 证据体系------不同变更类型要求不同维度证据,避免"必须六维齐全"的过度治理。
- 在 SCR 层,把 Software Change Record 定义为跨系统聚合对象,作为审计、回滚、合规的依据。
- 在 闭环 SDLC 层,从需求到运维实现端到端 Software Provenance。
整篇文章的目标:让 Vibe Coding 不再是"AI 帮程序员写代码"的浅层叙事,而是 AI-Native Software Change Management 的工程化方法论。
前置术语界定:Vibe Coding / Agentic Coding / Agentic Software Engineering
在进入正文之前,必须先厘清三个常被混用的术语,否则后续论证将建立在概念错位之上。三者不是严格的时间演化关系,而是不同分析层次的概念:
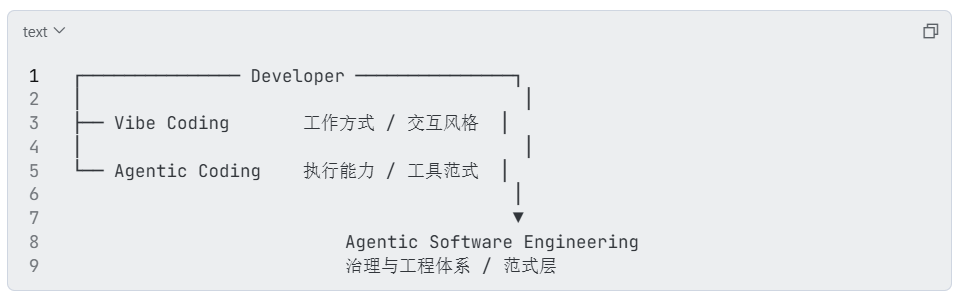
| 术语 | 分析层次 | 含义 | 关注重点 |
|---|---|---|---|
| Vibe Coding | 工作方式 | 开发者主要通过自然语言与代码生成模型或 Agent 交互 | 对话式编程、Context 管理、个人工作流 |
| Agentic Coding | 工具范式 | AI 具备自主规划、调用工具、迭代修复、跨文件编辑能力的编码模式 | Agent Loop、Tool Use、Plan/Act/Replan |
| Agentic Software Engineering | 工程范式 | 在 Agentic Coding 之上,把意图、上下文、证据、权限、责任纳入工程治理体系的完整范式 | Software Change、Provenance、Governance、HITL/HOTL |
三者是从开发者视角到工具能力视角再到工程治理视角的不同切片,不是必然的演进阶段。一个组织可以同时具备三者:开发者用 Vibe Coding 工作、Agent 具备 Agentic Coding 能力、组织运行在 Agentic Software Engineering 治理框架之上。
后续章节讨论的全部内容,都是围绕如何把 Vibe Coding / Agentic Coding 升级为 Agentic Software Engineering。
另外一个需要前置界定的关键概念是 Software Change(在第二章精确定义):
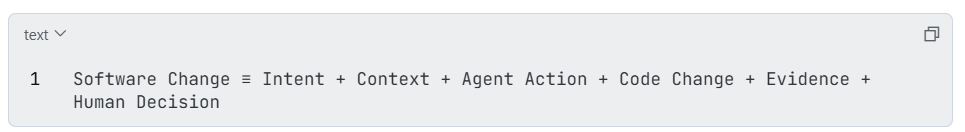
以及它的工程实现核心 Software Change Record (SCR)(在第八章精确定义)。
一、引言:从 Code Change 到 Software Change 的范式转移
1.1 现象:AI 不再只是补全代码
把 Vibe Coding 简单理解为"AI 帮程序员写代码"是危险的。这种理解会让团队把治理对象仍然停留在"代码差异"上,而错过真正的变化。
实际发生的变化是工作流的重组:
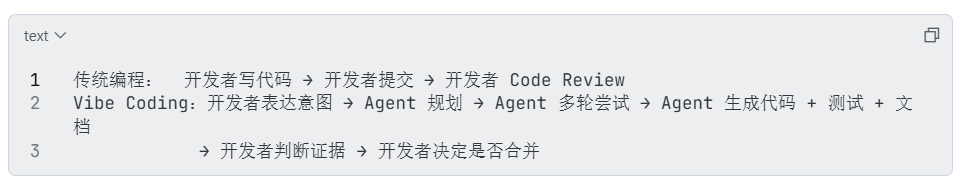
开发者仍然在环路里,但位置变了------从"写代码"前移到"判证据"。这不是工作量的简单转移,而是责任分布的重构。
1.2 传统代码管理体系的承载边界
传统代码管理体系(Git + Issue Tracker + CI + Code Review)能够稳定承载的对象是 Code Change:
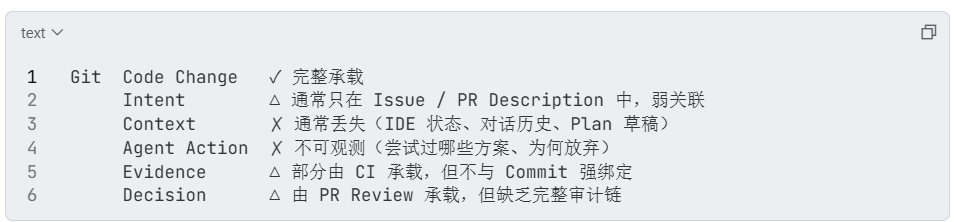
当 Agent 成为主要代码生产者时,Intent、Context、Agent Action、Evidence 反而成了更值得管理的对象------而 Git 并没有为它们提供稳定位置。
1.3 结论:管理对象必须升级
因此本文的立论点是:
Vibe Coding 的工程化不是"给 AI 配一把 Git 权限",而是承认软件工程的管理对象已经从 Code Change 扩展为 Software Change,并围绕这一扩展对象重设计工作流。
后续章节将围绕这一立论,给出 Git、Commit、PR、AGENTS.md、Context、Skills、Agent Governance、Verification、SCR、闭环 SDLC 与五层框架的具体落地。
二、Software Change 模型:管理对象的精确定义
2.1 Software Change 公式
Software Change 是本文对象层的核心定义,也是全文唯一的主模型:
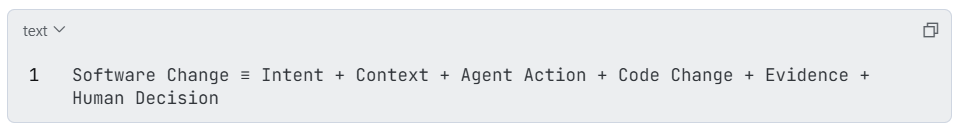
各分量的含义与典型载体:
| 分量 | 含义 | 典型载体 |
|---|---|---|
| Intent | 这次变更要解决的问题、任务边界、验收标准 | Issue / ADR / PR Title / 用户故事 |
| Context | Agent 决策时所依赖的工程知识、规则、Skills、调用链 | AGENTS.md / Rules / Skills / ADR / 依赖图 |
| Agent Action | Agent 实际做了什么:尝试过哪些方案、调用过哪些工具、为何放弃 | Agent Log / Trace / Replay / Iteration History |
| Code Change | 代码层面发生的实际差异 | Git Commit / Diff / Branch |
| Evidence | 证明这次变更正确、安全、符合 Scope 的证据 | CI 报告 / 测试结果 / 安全扫描 / Architecture 校验 / Scope 检查 / Policy 检查 / Operational 信号 |
| Human Decision | 谁、在什么证据下、基于什么判断最终批准了这次变更 | PR Review / Approve / 审批记录 |
这个公式回答的是"管理什么"的问题。后文所有治理机制都是为这六个分量服务的。
2.2 Evidence 进一步拆分:Change-time 与 Post-deployment
Operational Evidence 与其他五类 Evidence 有根本性的时间维度差异------其他五类都属于 Change-time Evidence,而 Operational Evidence 是 Post-deployment Evidence:
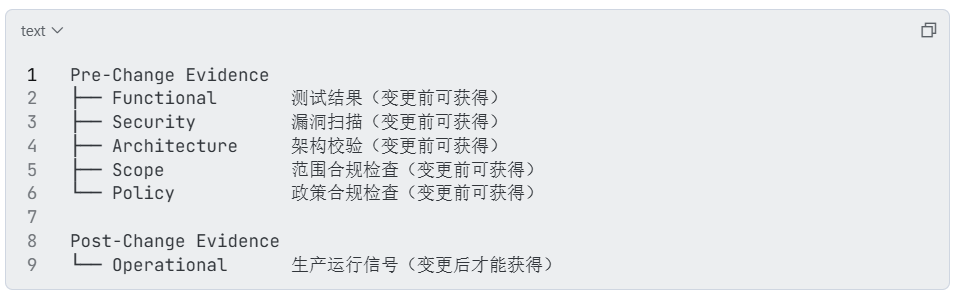
这个拆分不是定义上的简化,而是生命周期上的本质差异------Operational Evidence 只有在 Release 之后才能被收集,因此它是闭环 SDLC 的反馈环节(详见第九章)。
2.3 Software Change 与传统 SCM 的对照
| 维度 | 传统 SCM | AI-Native Software Change Management |
|---|---|---|
| 管理对象 | Code Change | Software Change(六个分量) |
| 主索引 | Commit Hash | Software Change Record ID(SCR-ID) |
| 证据 | CI Pass/Fail | Risk-adaptive Pre/Post-Change Evidence |
| 责任 | Author + Reviewer | Author + Agent + Reviewer + Approver + Operator |
| 追溯 | Diff → Commit → Author | Intent → Context → Action → Diff → Evidence → Decision → Operator |
三、Git 的新位置:从 Software Change 控制面退回到 Source Code Control Plane
3.1 Git 在新范式中的精确位置
Git 仍然是源代码版本与历史的核心权威系统,但它的职责被精确化为 Source Code Control Plane:
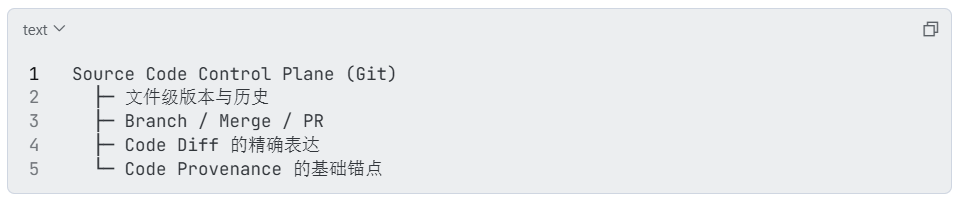
而 Software Change 体系的其他层面,需要在 Git 之外建立专门系统:
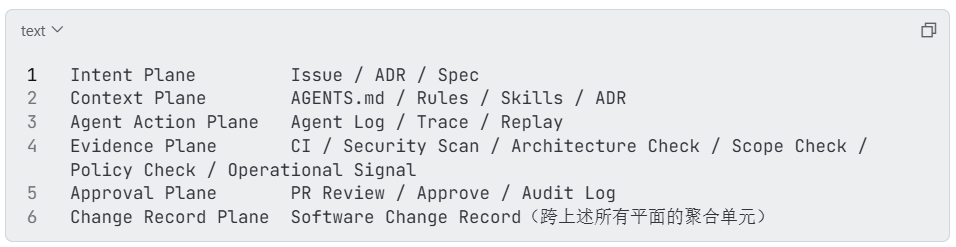
3.2 一个关键判断
Git 不是被 AI 取代,而是从 Software Change 的完整控制面退回到 Source Code Control Plane。
这个判断成立的原因是:Git 的核心契约(不可变哈希、分布式历史、Diff 表达)是 Code Provenance 的理想载体,但 Git 从未也不应被设计用来承载 Intent、Context、Agent Action、Evidence、Approval 等语义。把这些语义强塞进 Commit Message 或 PR Description,会让 Git 历史被污染。
3.3 Git 与 Software Change Record 的边界
正确的分工是:
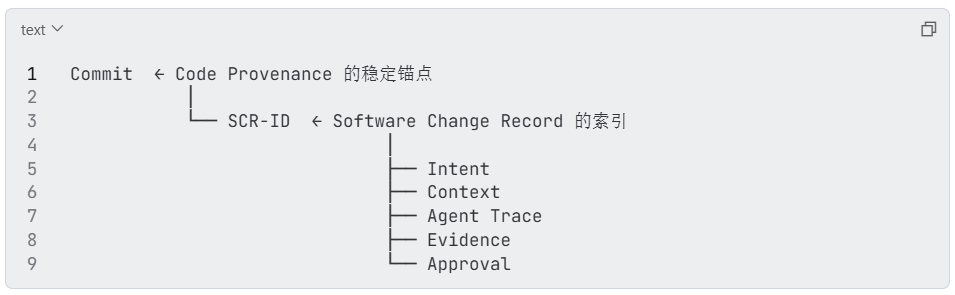
Commit 只承载 SCR-ID 的引用,不承载 SCR 的全部字段。这是 Git 与 SCR 之间的边界------Commit 保持简洁,SCR 在独立系统中聚合所有证据(详见第八章)。
四、Agentic Git Workflow:把 Agent 纳入版本控制工作流
4.1 Branch 策略的重设计
传统 Git Flow / GitHub Flow 的核心假设是"一个 PR 对应一个开发者的一次提交"。Agentic 时代这一假设被打破:
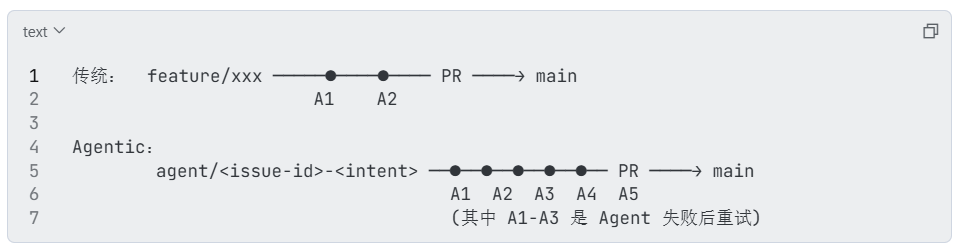
需要明确的新规则:
- 每个 PR 必须可追溯回一个明确的 Intent------不允许"Agent 自己发现了一个问题就提交"。
- 失败尝试不必出现在 Git 历史里,但必须出现在 Agent Trace 平台(避免 Git 噪声,同时保留学习价值)。
- Branch 命名必须编码 Intent 来源:
agent/<issue-id>-<short-intent>,例如agent/1234-fix-oom-in-worker。 - Worktree 是 Agent 并行工作的关键基础设施------见下文 4.2。
4.2 Worktree:把 Agent 隔离在独立工作目录
多个 Agent 同时修改同一仓库时,必须用 Git Worktree 提供文件系统级隔离,避免互相覆盖:
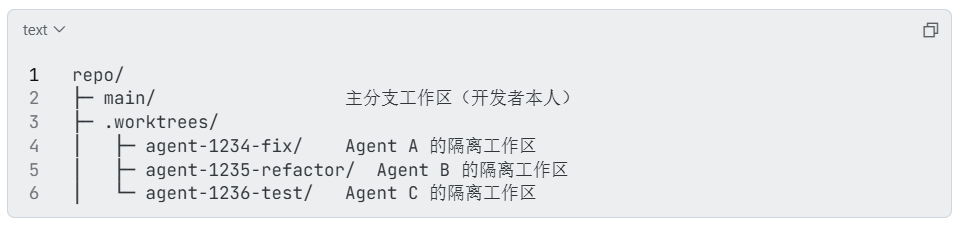
关键约束:
- 每个 Worktree 必须绑定一个明确的 Intent / Issue ID。
- Agent 在自己的 Worktree 中拥有受控编辑权限(详见第六章 Capability Boundary),但默认不允许直接 push 到
main。 - Worktree 之间通过 PR 互相集成,不允许直接合并。
4.3 Commit 演进:保持简洁,仅承载 SCR 引用
Commit 在新范式中承担双重身份:
- 代码版本快照(Git 原生语义)------通过 Diff 表达。
- Code Provenance 锚点(工程层扩展)------通过 Commit Message 与 SCR-ID 关联。
保持简洁的设计原则:
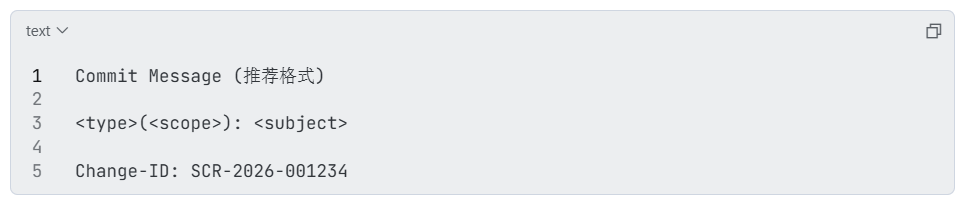
Commit Message 不再承载 Intent、Context、Plan、Evidence、Approver 等详细字段------这些字段全部进入 SCR。Commit 与 SCR 之间通过 Change-ID 单一字段引用保持松耦合。
这样设计的理由:
- Git 历史保持可读------
git log不被治理字段污染。 - SCR 可独立演化------调整 Evidence 维度、Approval 流程时,不需要重写 Git 历史。
- 审计与 Git 解耦------审计系统直接读 SCR,不需要解析 Git 历史。
4.4 Signed Commit 与 Agent 身份
Agent 生成的 Commit 必须用 Agent 专用签名密钥,签名内容应包含:
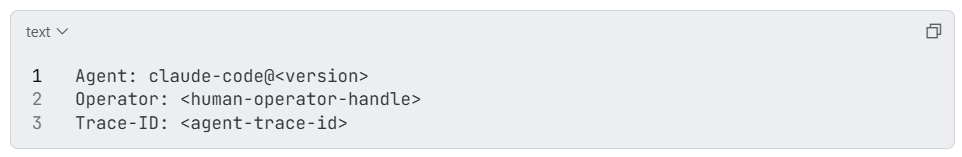
这把"谁实际产生了这段代码"明确写入 Git 历史本身,成为 Code Provenance 的基础。
4.5 Pull Request 控制点重设计:从 Diff-centric 到 Context-aware
PR 在新范式中的角色变化:
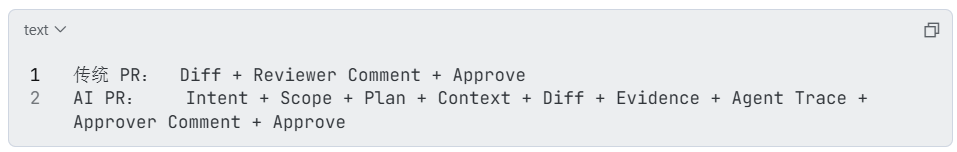
PR 不再只是"代码差异的请求",而是 Software Change 的控制点------所有进入主干分支的 Software Change 都必须经过 PR 集中校验。
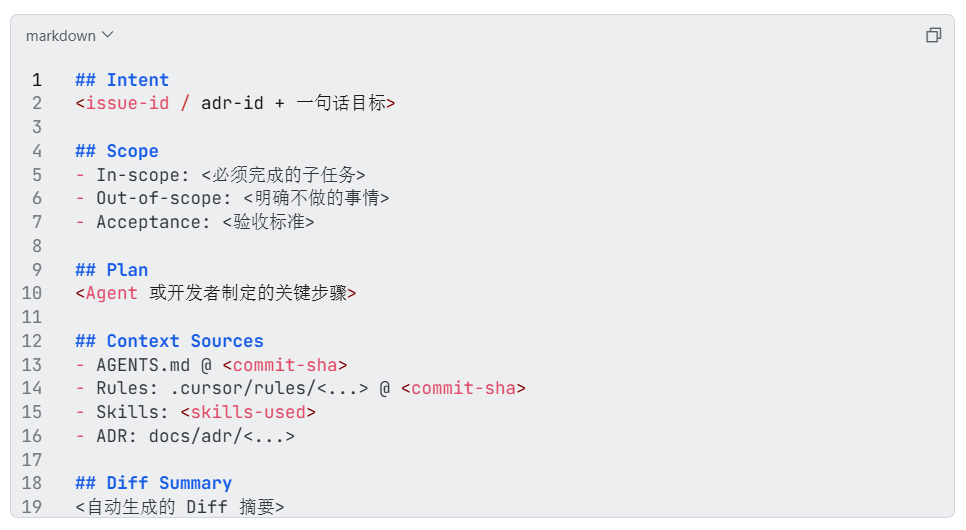
PR Description 的标准模板:
4.6 Reviewer 的新职责
Reviewer 不再只看 Diff,还必须检查:
- Intent 是否清晰------这个 PR 解决了什么问题,边界在哪?
- Scope 是否合规------有没有超出 Issue 描述的改动?
- Context 是否充分------Agent 是否使用了合适的 AGENTS.md / Rules / Skills?
- Evidence 是否可信------CI 通过 ≠ 安全合规,Reviewer 必须看证据清单本身。
- Plan 是否合理------Agent 的实现路径是否过度复杂或过度简单?
这五条必须全部通过,PR 才算"代码正确 + 工程正确"。
Approve 策略是 Risk-dependent 的:高风险或不可逆 Software Change 必须设置 Human Approval Gate(详见 §6.7 的 HITL 场景白名单);低风险变更(如文档修正、依赖补丁、格式化、生成的代码、低风险配置变更)可根据组织政策采用 Policy Engine + 自动化 Evidence + 自动化 Approve 的路径,不强制要求人工 Approve。
4.7 PR 自动化与人工的边界
| 阶段 | 自动化 | 人工 |
|---|---|---|
| Lint / Format | ✅ | --- |
| Unit Test | ✅ | --- |
| Security Scan | ✅ | --- |
| Architecture Check | ✅ | --- |
| Scope Check | ✅ | 抽查 |
| Policy Check | ✅ | 抽查 |
| Diff 阅读 | --- | ✅(高风险必审,低风险抽样) |
| Intent / Plan 判断 | --- | ✅(高风险必审,低风险抽样) |
| 风险与回滚评估 | 辅助 | ✅(高风险必做) |
| 最终 Approve | Risk-dependent:低风险可经 Policy Engine 自动通过;高风险 / 不可逆变更必须 HITL | ✅(按 Approval Policy) |
4.8 Scope Compliance:把"任务边界"做成可验证对象
Scope Compliance 是 AI 时代最重要的治理能力之一------其重要性甚至超过"AI Code Review"。
Scope 的三层定义:
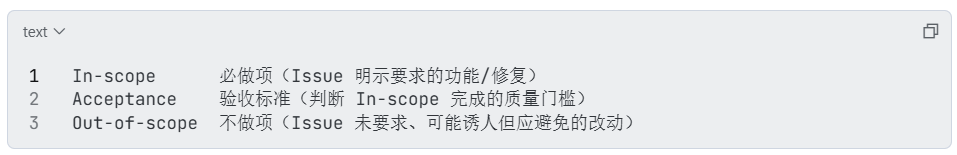
Scope Check 的实现路径:
| 检查项 | 工具支持 |
|---|---|
| 修改文件是否全部在 In-scope 声明的模块内 | git diff --name-only 与白名单对比 |
| 新增依赖是否在 In-scope 声明的依赖列表中 | package.json / requirements.txt Diff |
| 是否引入了 Out-of-scope 中禁止的模式 | 静态规则 + LLM-as-judge |
| Acceptance 标准是否全部覆盖 | Issue ↔ Test Case 矩阵 |
| 是否破坏了非目标模块的测试 | 全量测试回归 |
关键原则:Scope 不可由 Agent 单方面扩大。任何超出 Issue 描述的改动,都必须由人类 Reviewer 显式批准或在 Issue 中显式扩展。
未来 AI Coding 真正重要的治理能力,可能不是"AI 能写多少代码",而是"AI 能否严格控制自己不应该写什么"。这可以发展成 Scope-Aware Agent 或 Scope Enforcement Layer------这是值得继续发展的方向。
五、Context Engineering:把工程知识从 Prompt 升级为持久化资产
5.1 Context 的层次结构
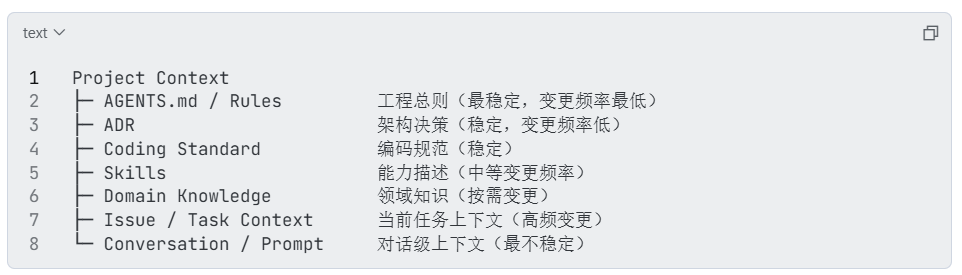
5.2 AGENTS.md 作为 Canonical Policy Layer
AGENTS.md 是受治理 Repository 的组织级 Context / Policy 基线,具体工具的 Rules 文件是 Tool-specific Execution Layer,其实际优先级由工具自身规则定义。
这是文章对"AGENTS.md > Rules > Prompt"那种一刀切优先级声明的修正。不同 Agent / IDE 对规则加载、优先级、作用域的实现机制并不相同,因此组织级政策(AGENTS.md)应当只声明"组织约束是什么",而不越权规定"工具内部加载顺序"。
AGENTS.md 应包含的标准结构:
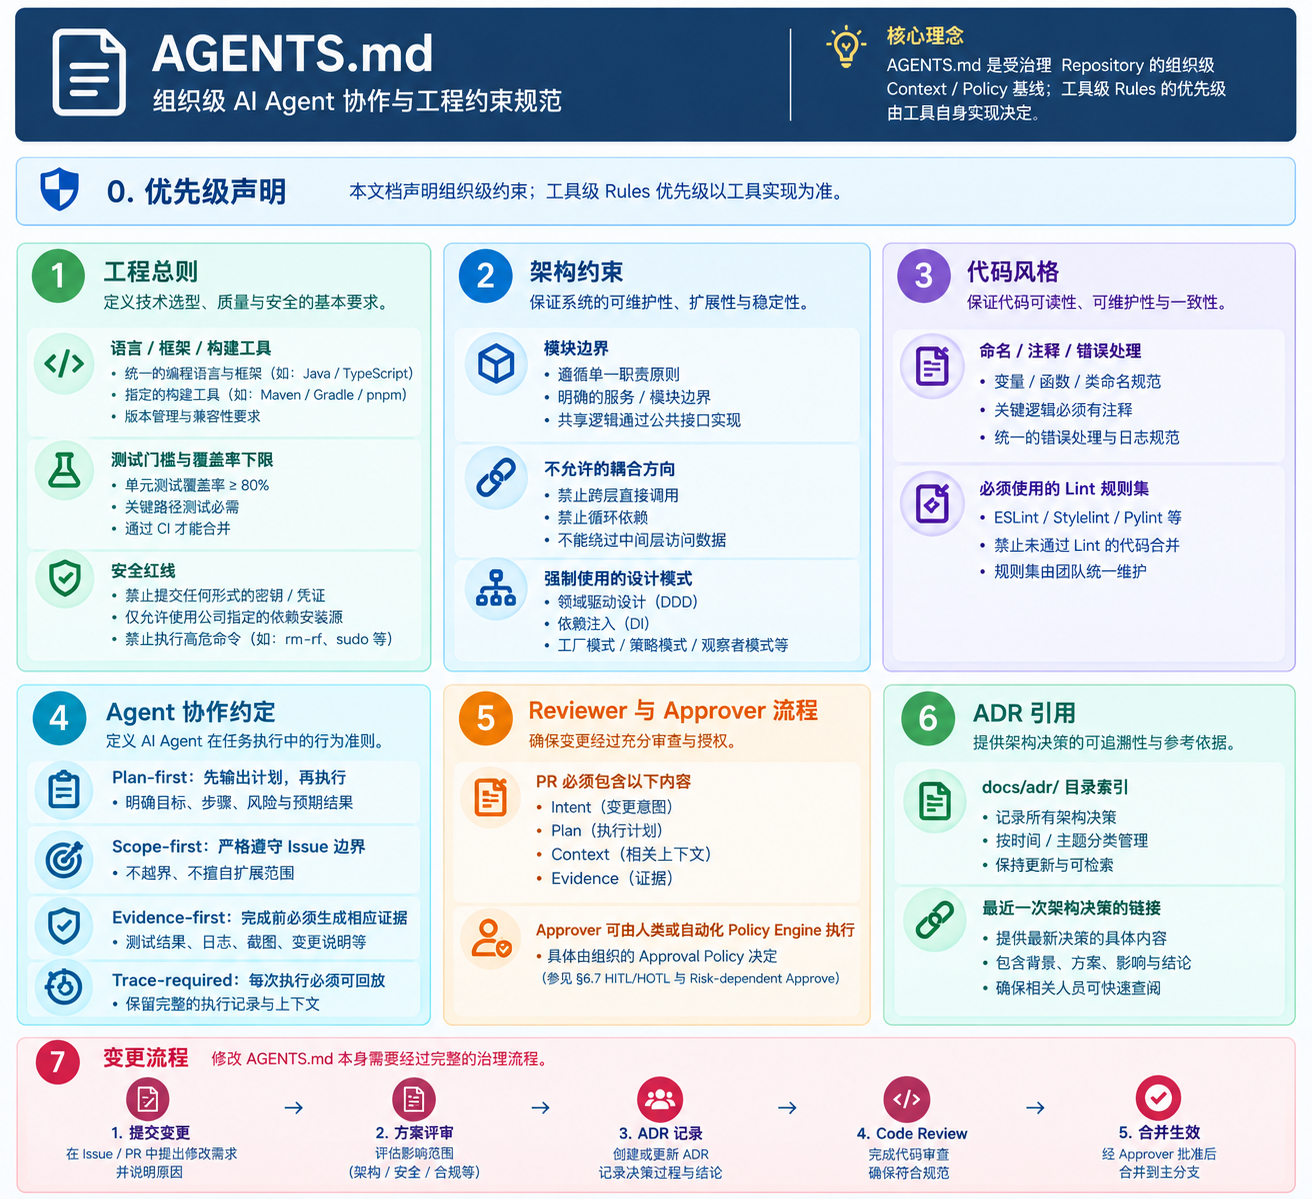
5.3 工具级 Rules 的并列存在
不同工具都有自己的 Rules 文件,AGENTS.md 不强行指定其优先级:
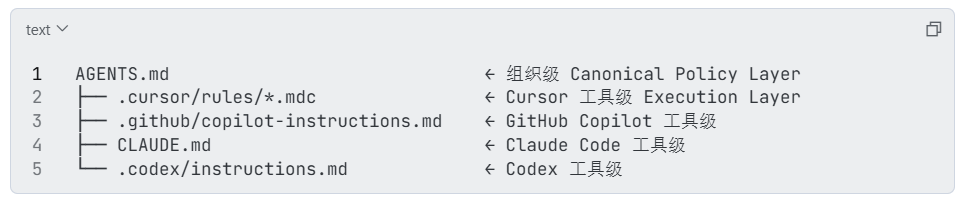
工具级 Rules 应在语义上继承组织级 Policy,不得与其冲突;具体的继承、加载与优先级机制由各工具自身实现决定。
5.4 Context-as-Code 的核心原则
| 原则 | 含义 |
|---|---|
| Versioned | Context 必须纳入版本控制,可回溯到任意 Commit |
| Composable | Context 必须可组合,而非整体替换 |
| Deterministic | 同一份 Context + 同一任务,应当产生可复现的 Agent 行为 |
| Auditable | 任何 Context 变更必须有 PR + Reviewer |
| Discoverable | Agent 必须能自动发现相关 Context(而非靠人记住) |
5.5 Skill ≠ MCP ≠ Tool 的清晰分层
许多文章把 Skill、MCP、Tool 串成"Skill → Tool → MCP"的纵向链。这是错误的------MCP 不是 Tool 的下一级,而是与 Tool 并列的能力访问路径。
准确的分层是:
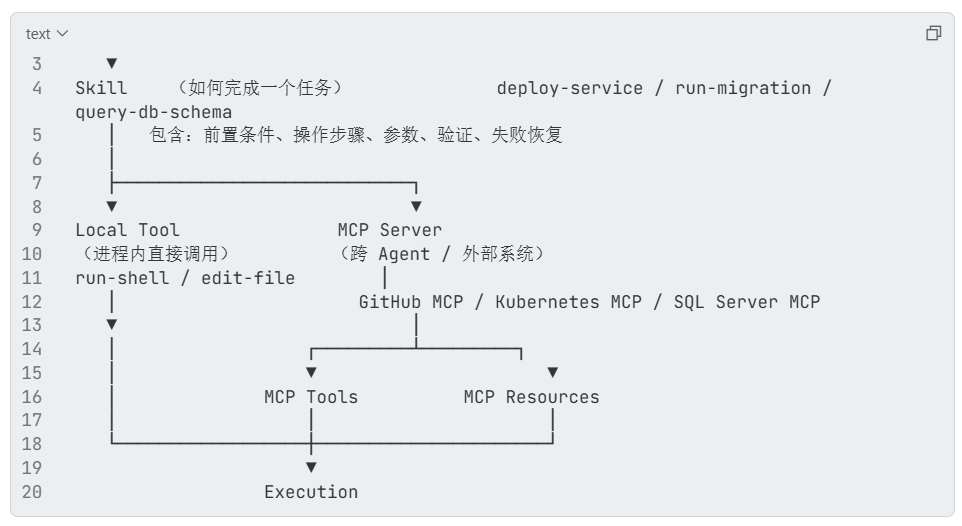
各层回答的是不同问题:
| 层 | 回答的问题 | 实例 |
|---|---|---|
| Skill | 如何完成一个任务(能力编排) | deploy-service / run-migration / query-db-schema |
| Local Tool | 进程内具体执行什么操作 | run-shell / edit-file / http-request |
| MCP Server | Agent 如何访问一个外部能力(跨进程 / 跨 Agent 的协议层) | GitHub MCP / Kubernetes MCP / SQL Server MCP |
Skill → Local Tool / MCP Server 是并列的两条能力访问路径,而不是纵向层级:
- Skill 可以直接调用进程内 Local Tool;
- Skill 也可以通过 MCP 协议访问外部 MCP Server 上的 Tools / Resources。
即 Skill 编排能力,Tool 提供进程内执行能力,MCP 提供跨 Agent / 外部系统的能力访问协议------三者之间是"编排 ↔ 执行 ↔ 协议"的三角关系,而非单向链路。
5.6 Context Loading 的工程化
Agent 在执行任务前应按以下顺序加载 Context(具体优先级由工具实现决定):
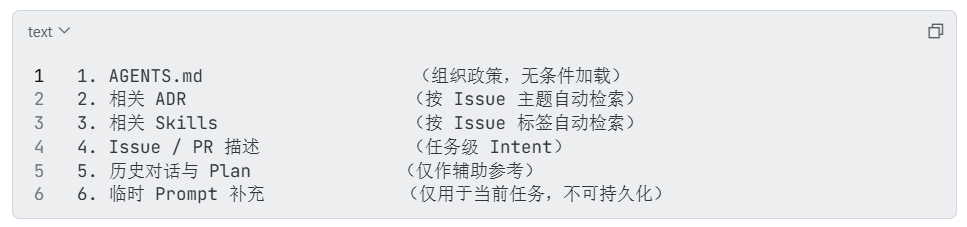
这种"由稳到不稳"的加载顺序,保证 Agent 决策始终建立在最稳定的工程知识之上。
5.7 Context Pollution 的治理
Context 污染是 Context-as-Code 的头号风险:
- 症状:AGENTS.md 被塞入过多临时规则;Rules 文件膨胀;Skills 描述模糊。
- 治理:定期审计(每季度),把临时规则清理或迁移到 ADR;通过 Lint 检查 Rules 文件长度与重复度。
六、Agent Governance:四维边界模型
6.1 为什么"四级权限"应降级为示例
把 Agent 权限简化为 L1 / L2 / L3 / L4 四级虽然便于理解,但在生产环境中过于简化------权限的真实形态是多维度的边界。因此本文把 四维 Boundary 模型提升为正式治理框架,把 L1-L4 降级为参考示例。
6.2 四维边界模型
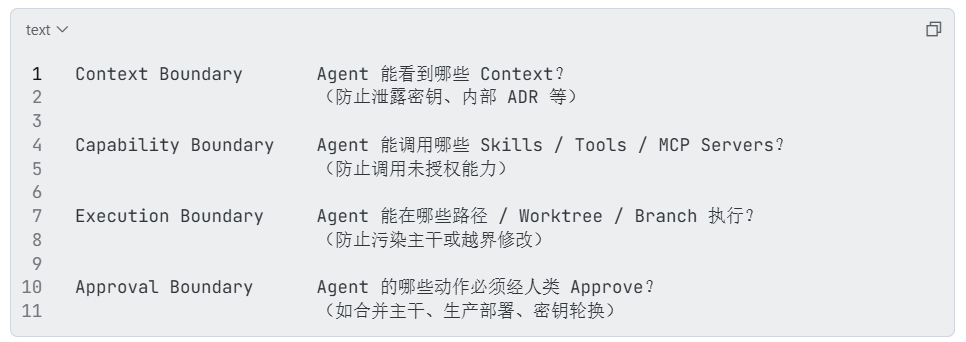
四维边界共同构成 Agent 的行动空间,缺一不可:
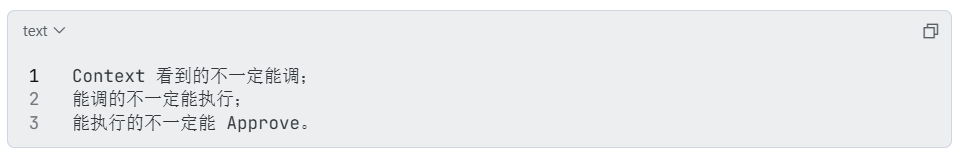
6.3 四维边界的实例描述
相比"L2"这种标签,下面这种四维描述更精确:
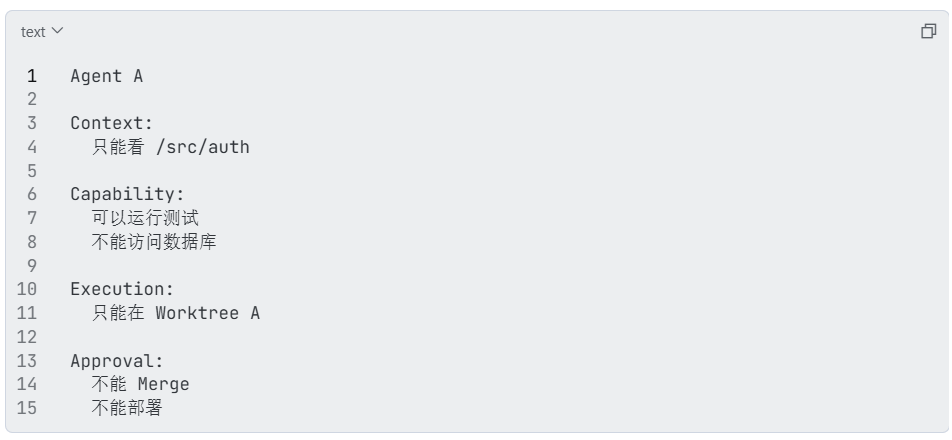
6.4 L1-L4 作为参考示例
如果组织需要更简洁的权限标签,可把 L1-L4 作为对四维边界的常见组合的参考示例:
| 级别 | 名称 | 典型四维配置 | 典型场景 |
|---|---|---|---|
| L1 | Read-Only | Context: 全部 / Capability: 只读工具 / Execution: 仅查看 / Approval: 无 | 探索代码、回答问题、生成 Plan |
| L2 | Sandboxed-Edit | Context: 限定模块 / Capability: 文件编辑 + 测试 / Execution: 限定 Worktree / Approval: 无 | 生成代码、跑测试、迭代修复 |
| L3 | Branch-Author | Context: 限定模块 / Capability: 完整工具集 / Execution: 限定 Branch / Approval: PR Approve | 提交完整 Software Change 提案 |
| L4 | Production-Push | Context: 全部 / Capability: 完整工具集 / Execution: 主干 / Approval: 强制人类 Approve | 仅授予受信任的 CI/CD Agent 或人类 |
但必须强调:真实生产环境的 Agent 权限配置,应当用四维边界精确描述,而不是套用 L1-L4 标签。L1-L4 只是常见组合的速记。
6.5 最小授权原则
每个 Agent 实例必须按"完成任务所需的最小权限"启动:
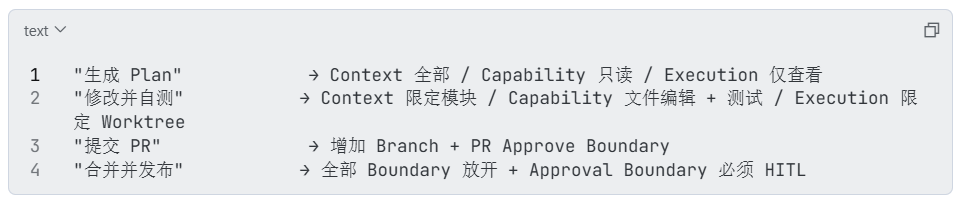
禁止"一启动就全部放开"的反模式。Agent 的边界放宽必须在 PR / Pipeline 中逐步获得,而不是一次性赋予。
6.6 权限审计
所有超出 Read-Only 的动作必须产生不可篡改的审计记录:
- 谁触发了 Agent(Operator)
- Agent 的四维边界配置
- 执行了什么动作(文件修改、命令执行、网络请求)
- 经过了哪些 Approve
审计记录本身就是 Software Change Record 的一部分(见第八章)。
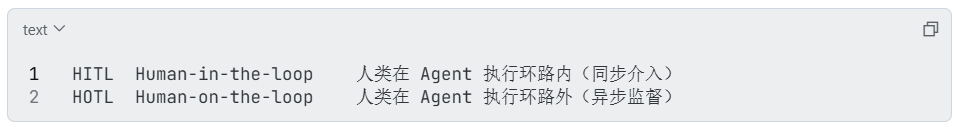
6.7 HITL 与 HOTL:人机协作的位置从"写代码"前移到"判证据"
把人类放在哪,决定了责任分布的形态。
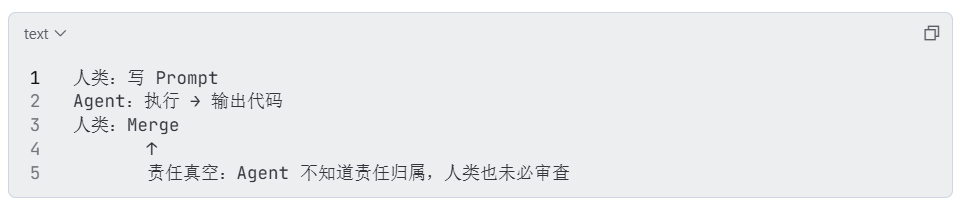
常见错误是把人类放在"Prompt 输入口"------人类写 Prompt、Agent 输出代码。这种模式责任真空:
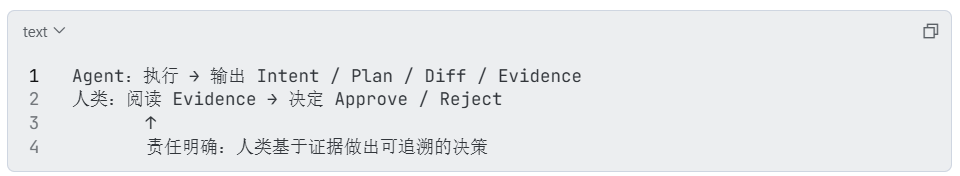
正确做法是把人类放在 Evidence 判断口:
HITL 的硬约束场景(不允许 HOTL):
- 合并到主干(Production-Push)
- 生产部署
- 密钥 / 凭证轮换
- 数据库 schema 变更
- 公共 API Breaking Change
- 架构级重构(涉及 ≥3 个模块)
- 合规相关变更(隐私、审计、监管报告)
HOTL 的可行场景(必须满足前置条件):
- L1 / L2 级别操作(在限定 Worktree 内)
- 已通过 CI / Lint / 测试的常规 Bug Fix
- 有明确 ADR 与 Acceptance 标准的 Feature
- 已有 Approve 模板的小型重构
无论 HITL 还是 HOTL,每一次 Approve(人类或 Policy Engine 自动)都应留下:
- Approve 时间
- 基于哪些 Evidence ID 做出判断
- Approver 身份(人类 Operator ID / Policy Engine ID)
- Decision-Rationale 自由文本(自动化 Approve 可采用结构化理由)
这些字段进入 SCR,构成完整的责任链。Decision-Rationale 在受监管场景可作为强制字段,在其他场景作为增强型 Decision Provenance。
七、Verification:Risk-adaptive 证据体系
7.1 从"必须六维齐全"到 Risk-adaptive
文章第一版曾提出"任何 Production-Push 必须六维齐全"。这一规则虽然便于执行,但过度治理------例如修改一个 README 要求六维证据显然不合理。
更合理的设计是 Risk-adaptive Evidence:
Evidence 不是最大化的,而是根据 Change Risk 自动确定的。
7.2 Risk-adaptive Evidence 矩阵
| 变更类型 | Required Pre-Change Evidence | Required Post-Change Evidence |
|---|---|---|
| 文档 / 注释改动 | Functional(Lint 通过) | --- |
| 内部重构 | Functional + Architecture + Scope | --- |
| 新增功能 | Functional + Security + Architecture + Scope | Operational |
| 修改公共 API | Functional + Security + Architecture + Scope + Policy | Operational |
| 生产配置变更 | Functional + Security + Architecture + Scope + Policy | Operational |
不同变更类型要求不同维度的证据。这把 Evidence 从"硬门槛"变成"风险自适应门槛",更符合真实工程实践。
7.3 证据的不可伪造性
无论 Risk-adaptive 矩阵如何变化,所有 Evidence 必须满足:
- 可复现:他人按相同流程可得到相同结论。
- 可追溯:每条证据有 ID,可关联回 Commit / PR。
- 可审计:证据生成过程本身可审计(如 CI 日志、SCA 报告、Architecture Check 输出)。
- 不可被 Agent 单方面篡改:证据存储在受控系统(CI、Security Platform、ADR Repo),Agent 只能引用,不能修改。
7.4 Pre-Change 与 Post-Change Evidence 的生命周期区分
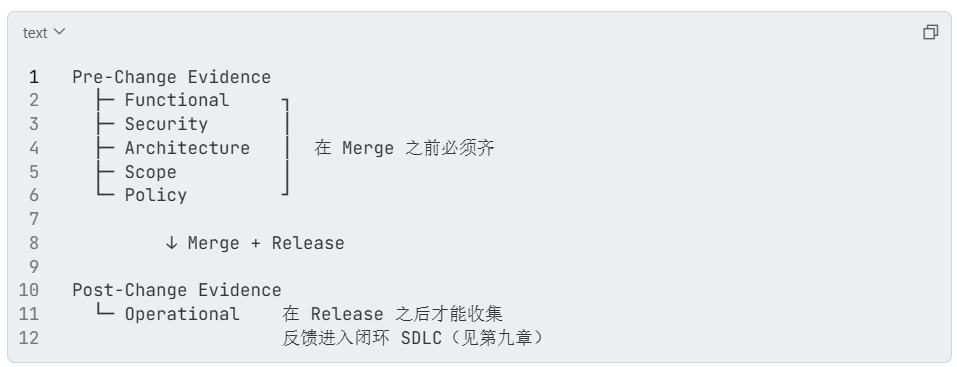
Operational Evidence 的特殊性在于它不在 PR 阶段就存在,而是在 Release 之后从生产环境回流。因此 Operational 不应作为 PR 合并的硬门槛,而应作为后续变更决策的输入信号。
7.5 证据缺失的处置
任何必填维度的证据缺失或失败时,Software Change 必须被阻止合并,并由 Reviewer 判断:
- 补充证据(最常见)
- 降低变更范围(拆分 PR)
- 回退变更(放弃本次 Change)
不存在"补证据后合并"的捷径------补证据本身要走 PR 流程。
八、Software Change Record (SCR):Software Change 的可追溯实例
8.1 SCR 的定位:理论到工程的桥梁
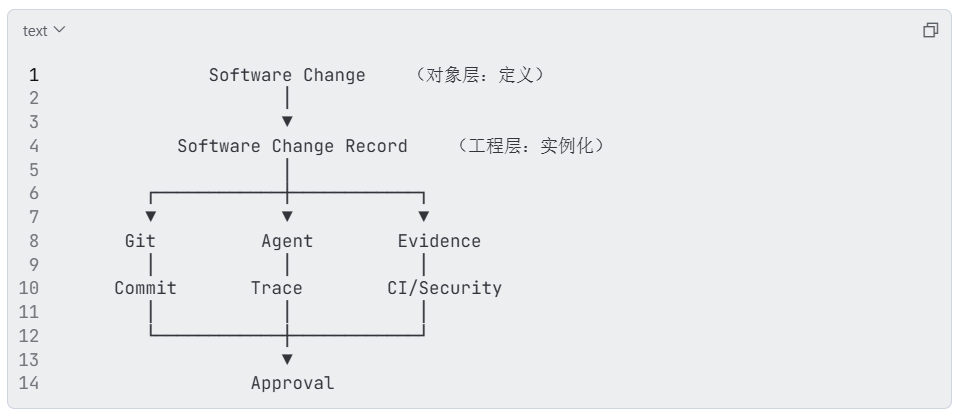
如果说 Software Change 公式回答的是"管理什么"(对象层),那么 Software Change Record (SCR) 回答的就是"如何落地"(工程层)。
Software Change Record 是 Software Change 公式的可追溯实例,是跨 Git、Issue、Agent Trace、CI、Security、Approval 的聚合对象。
8.2 SCR 的标准字段
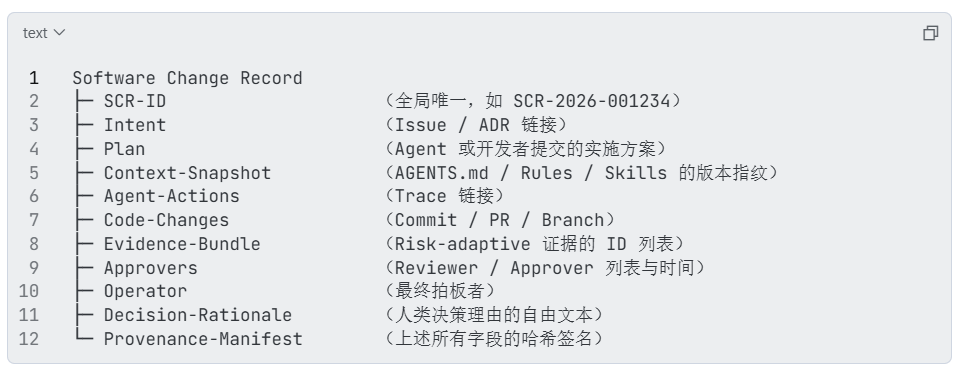
8.3 SCR 的完整性约束(SCR Integrity Requirements)
SCR 本质上是跨系统聚合的 Provenance Record,其完整性由一组必填字段约束保证------任何必填字段缺失都视为 SCR 不完整,组织可按合规要求在约束之上增强(如 Decision-Rationale):
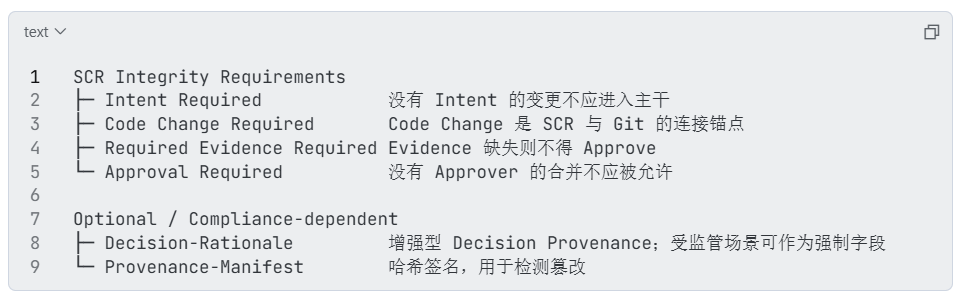
注意:SCR 完整性约束不是"物理上不可拆分",而是"逻辑完整性要求"------它在数据模型层以完整性检查体现,而非数据库层面的不可变记录。
8.4 SCR 的系统形态
SCR 不是单一数据库记录,而是一个跨系统聚合对象。它的数据分布在多个系统中,由一个 SCR Aggregator 统一索引:
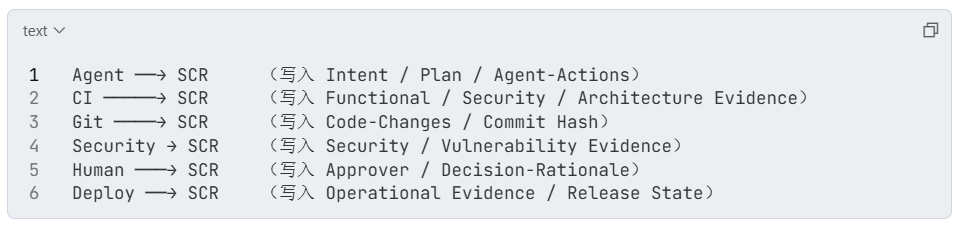
SCR Aggregator 在这一形态下实质上是 Software Change Event Aggregator------把分散在多个系统中的事件归并到同一索引下。
8.5 SCR 的生命周期
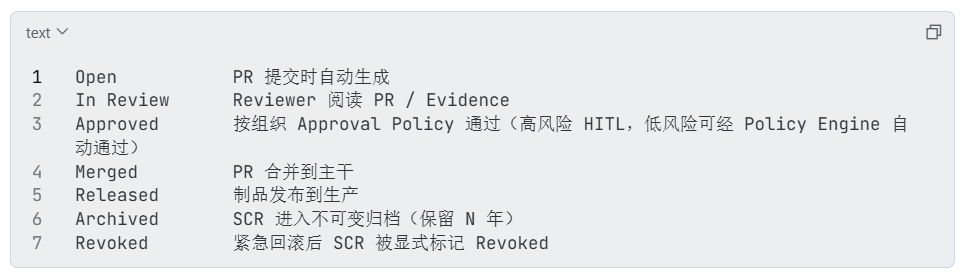
每个状态变更都必须记录操作者、时间、原因。任何状态"跳跃"都必须有明确理由。
8.6 SCR 的回滚与撤销
SCR 一旦 Merged 不应被直接修改或删除。回滚通过以下方式:
- Revert SCR:创建反向 SCR 引用原 SCR。
- Hotfix SCR:紧急变更必须新建独立 SCR,不允许"补丁式"修改历史。
- Revoked 标记:原 SCR 可被显式标记 Revoked,但记录本身必须保留。
这与 Git 的不可变历史哲学一致,但把"不可变"的语义从 Code 层扩展到 Software Change 层。
8.7 Provenance 与合规
在受监管行业(金融、医疗、关键基础设施),Decision Provenance 是合规底线:
- 谁授权了这次变更?
- 基于什么证据?
- 是否经过独立 Reviewer?
AI-Native Software Change Management 应将 Decision Provenance 的完整性纳入合规检查项,作为事前要求而不是事后补救。
SCR 中 Provenance-Manifest 字段是双向追溯的核心------它对 SCR 的所有关键字段计算哈希签名,使任何篡改可被检测。
8.8 双向追溯
理想的 Provenance 体系应当支持双向追溯:
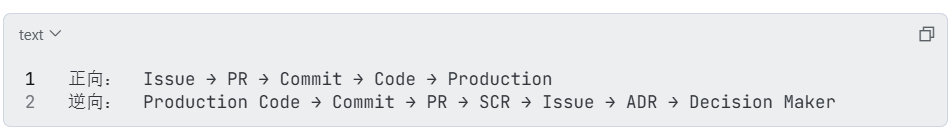
逆向追溯在事故回滚、合规审计、漏洞归因中尤其重要。具体的时间目标(例如"30 分钟内完成")应当作为组织可配置目标,而不是技术事实------不同组织对响应 SLA 的要求不同。
九、AI-Native SDLC:从需求到运维的端到端 Software Provenance
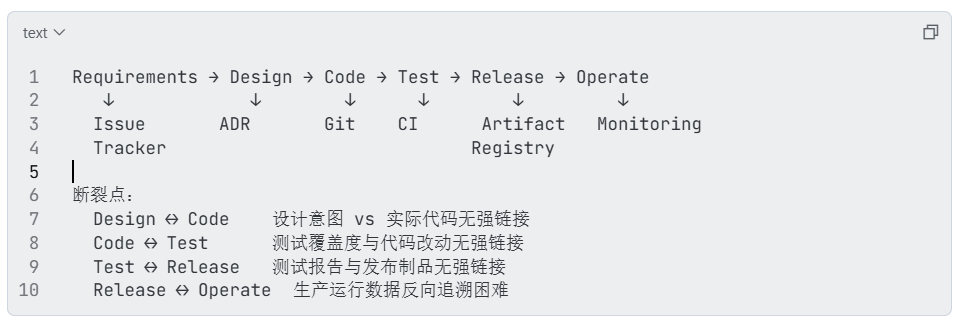
9.1 传统 SDLC 的断裂
传统软件开发生命周期(SDLC)在多个环节之间存在信息断裂:
9.2 闭环 SDLC:SCR 串联全链条
AI-Native 闭环 SDLC 用 SCR 串联全链条,每个环节都向 SCR 添加字段:
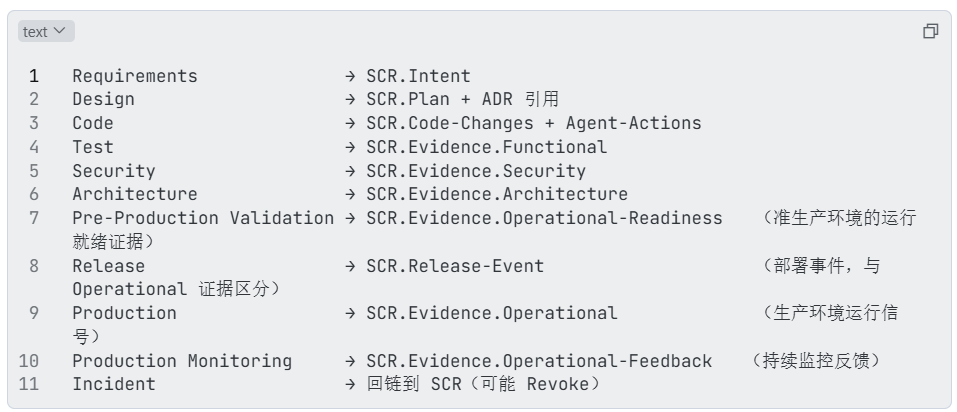
9.3 闭环:Operational Evidence 反哺下一轮变更
闭环的关键是 Operational Evidence 反馈回 Intent:
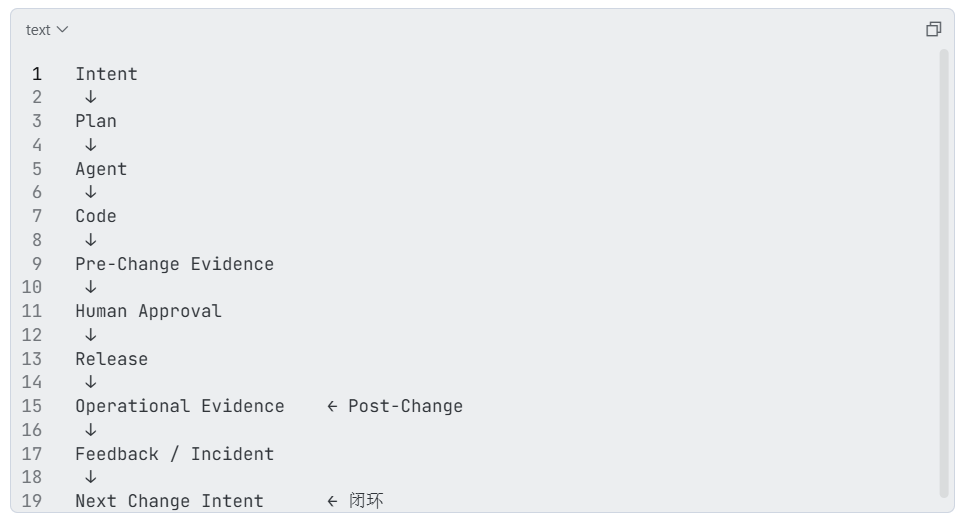
Operational Evidence 不是 SDLC 的终点,而是下一轮变更的起点。这把"开发"与"运维"从接力棒关系变成螺旋上升关系。
9.4 与 GitOps 的结合
闭环 SDLC 与 GitOps 天然契合:
- Git = Code Provenance 主存储
- SCR = Software Change Provenance 主存储
- GitOps Controller = Operational Evidence 来源
三者共同把"代码、变更、运行状态"统一到 Git 工作流之上。
十、VIBE CODING ENGINEERING 框架:Intent / Context / Agent / Evidence / Change
10.1 框架的精确位置
VIBE CODING ENGINEERING 回答的是"如何治理"------它是 Software Change 公式的治理框架,而不是另一个对象模型。
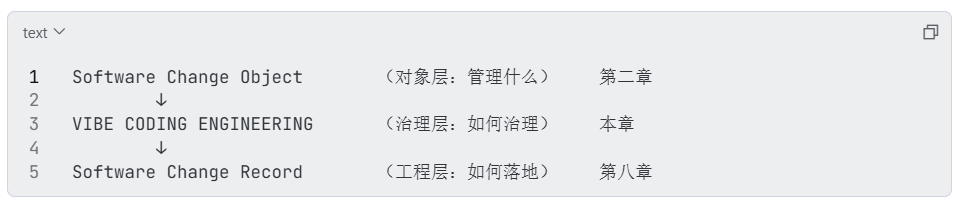
三者形成层次清晰的三段映射:
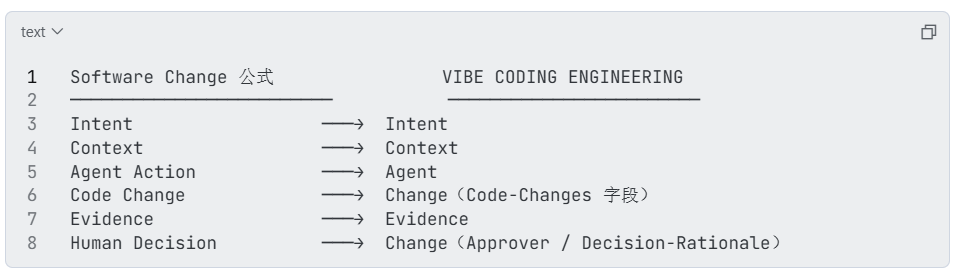
10.2 五层框架
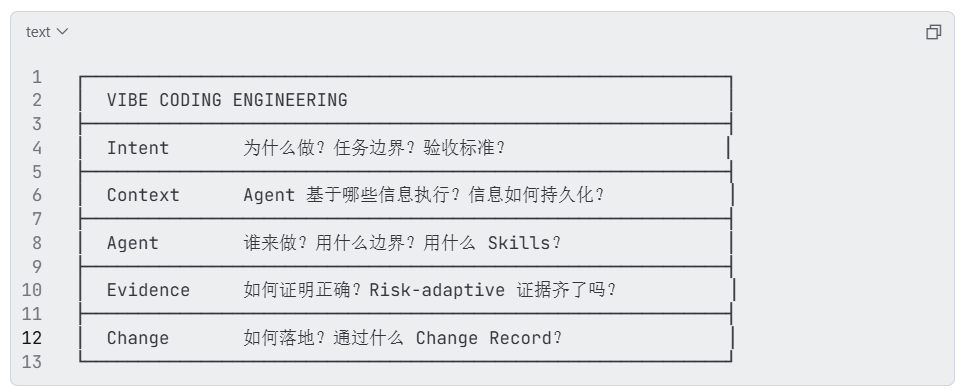
10.3 各层的关键工程动作
| 层 | 关键工程动作 | 落地载体 |
|---|---|---|
| Intent | Plan-first / Scope-first / Issue 标准化 | Issue / ADR / 用户故事模板 |
| Context | AGENTS.md / Rules / Skills 持久化 | AGENTS.md / .cursor/rules / .github/copilot-instructions.md / Skills / ADR |
| Agent | Worktree 隔离 / 四维边界 / Skills / MCP | .worktrees/ / 四维边界配置 / MCP Servers |
| Evidence | Risk-adaptive 证据自动收集 / Pre/Post-Change 拆分 | CI / Security / Architecture / Scope / Policy / Operational 平台 |
| Change | SCR / Provenance / 闭环 SDLC | SCR Aggregator / 审计日志 / GitOps |
10.4 与四维 Agent Governance 的对应
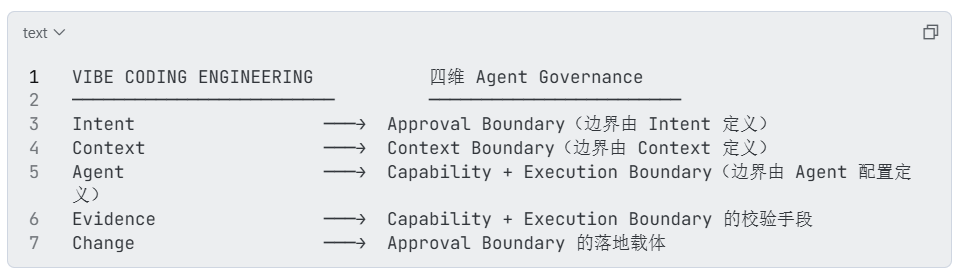
十一、MVP 实施路线
11.1 收敛后的引入序列
VIBE CODING ENGINEERING 不应一蹴而就落地。建议按以下 MVP 序列逐步引入,每一步都是独立可交付、可回滚、可验证的:
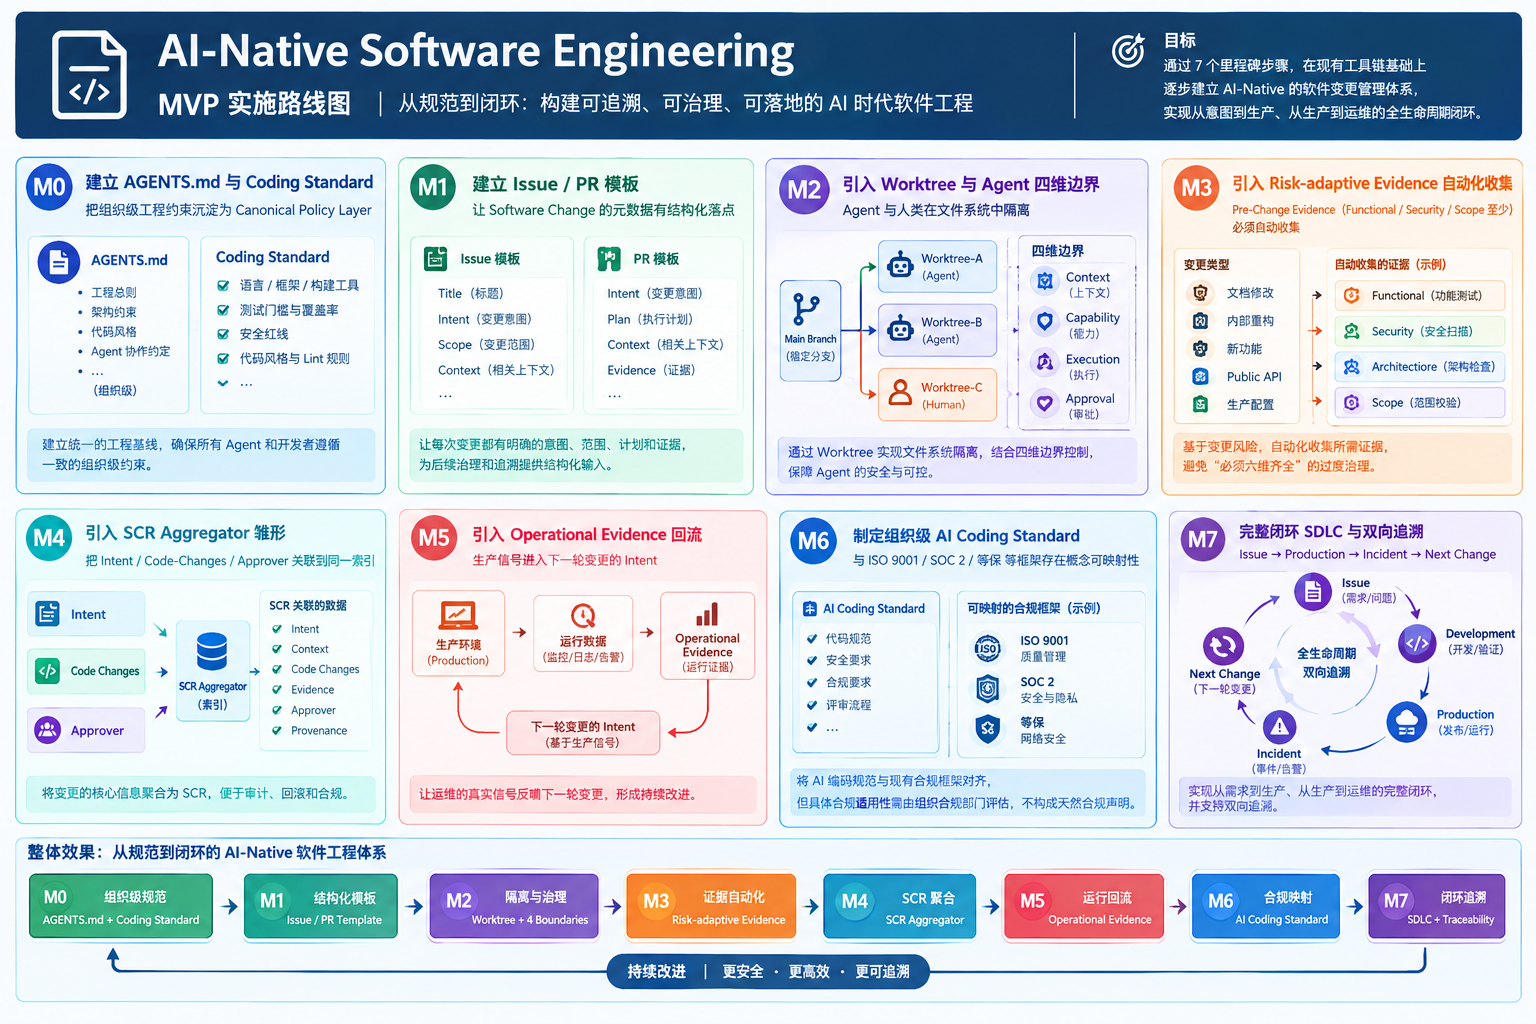
11.2 各阶段的验证标准
| 阶段 | 验证标准 | 不通过则回滚 |
|---|---|---|
| M0 | AGENTS.md 通过 PR 合并,至少 1 名架构师 Review | 不合并 |
| M1 | 100% 新建 Issue / PR 使用模板 | 不合规 Issue / PR 退回 |
| M2 | 所有 Agent 操作在 Worktree 内,可被审计 | 禁止 Agent 直接编辑主干 |
| M3 | Pre-Change Evidence 缺失的 PR 不可合并 | CI 强制卡点 |
| M4 | 每个 PR 可关联到 SCR-ID | 未关联则提示补录 |
| M5 | 生产事故可回溯到 SCR | 缺失则事故复盘不通过 |
| M6 | Standard 通过架构委员会 Approve | 未通过则不发布 |
| M7 | 抽样逆向追溯在组织 SLA 内完成 | 不达标则扩大归档覆盖 |
11.3 常见反模式
实施过程中应避免的反模式:
- 一上来就 L4 全开------边界放宽应逐步获得。
- AGENTS.md 写成大杂烩------临时规则必须迁移到 ADR。
- Commit 塞满 Evidence 字段------Commit 只承载 SCR 引用,详细字段在 SCR 系统。
- "必须六维齐全"硬门槛------根据 Change Risk 自适应。
- Prompt 当工程知识------Context 必须版本化、可审计。
- SCR 只是 Issue 的别名------SCR 必须聚合跨系统证据。
- Operational Evidence 当成 PR 门槛------Operational 是 Post-Change 反馈,不是合并卡点。
结论
三个层次的最终总结
Vibe Coding 的工程化可以归纳为三个层次的转变:
层次一:认知转变
- 旧认知:AI 帮程序员写代码
- 新认知:软件工程的生产方式发生系统性变化,管理对象从 Code Change 升级为 Software Change
层次二:协议转变
- 旧协议:以 Git 为中心的代码管理体系
- 新协议:以 Git 为 Source Code Control Plane,以 SCR 为 Software Change Provenance 主载体的多层体系
层次三:治理转变
- 旧治理:以 PR Review 为核心的人工把关
- 新治理:以 Risk-adaptive Evidence + Decision Provenance + 四维 Agent Governance + HITL/HOTL 为核心的可审计闭环
全文三个核心模型
| 模型 | 回答 | 章节 |
|---|---|---|
| Software Change 公式 | 管理什么? | 第二章 |
| VIBE CODING ENGINEERING 五层框架 | 如何治理? | 第十章 |
| Software Change Record (SCR) | 如何落地? | 第八章 |
这三个模型共同构成文章的方法论核心。其他机制(RBAC、Scope、MCP、Skills、AGENTS、Provenance、HITL、PR、Git)都是这三个模型下面的工程实现。
五个应被长期记住的核心观点
① Code Change → Software Change------管理对象的升级,是全文第一核心创新。
② Git = Source Code Control Plane------Git 不消失,但退回到 Software Change 的子平面,是第二核心判断。
③ PR = Context-aware Change Control Point------PR 从 Diff Review 升级为 Intent + Scope + Context + Plan + Diff + Evidence + Approval 的多维控制点,是最现实的工程变化。
④ Agent Governance = 四维 Boundary------Context / Capability / Execution / Approval 四维模型,比四级权限标签更精确,是治理框架的核心。
⑤ SCR = Software Change 的可追溯实例------跨系统聚合对象,作为审计、回滚、合规的依据,是工程实现的核心。
真正的演进主线
如果只能记住一句话:
Vibe Coding 的工程化,不是"AI 帮程序员写代码",而是把软件工程从"代码仓库时代"推向"Software Change 工厂时代"------围绕 Git 构建 AI-Native Software Change Management 体系,使每一次变更都 Intent 清晰、Context 可控、Agent 可审、Evidence 可信、Decision 可追。
这就是 Software Provenance 的真正含义:不是"这段代码从哪来",而是"这次变更为什么发生、怎么发生、如何被验证、谁最终负责"。
Software Provenance 将与 Code Provenance、Data Provenance、Model Provenance 共同构成下一代软件供应链的四大支柱。而这一切的起点,是对 Vibe Coding 这一现象的工程化重设计。
Vibe Coding 不会消失------它只会从"演示效果"演化为"工程体系"。工程师的核心工作,也将从"写代码"转向"判证据"。
这就是软件工程在 AI-Native 时代的真正开始。
附录 A:术语对照表
| 术语 | 含义 | 层次 |
|---|---|---|
| Vibe Coding | 通过自然语言与代码生成模型或 Agent 交互的工作方式 | 工作方式层 |
| Agentic Coding | AI 具备自主规划、工具调用、迭代修复能力的编码模式 | 工具范式层 |
| Agentic Software Engineering | 在 Agentic Coding 之上纳入治理体系的工程范式 | 工程范式层 |
| Software Change | Intent + Context + Agent Action + Code Change + Evidence + Human Decision | 对象层 |
| Software Change Record (SCR) | 跨系统聚合 Software Change 证据的 Provenance Record(满足 SCR 完整性约束) | 工程层 |
| Software Provenance | 围绕 Software Change 的完整追溯链 | 顶层目标 |
| Code Provenance | 代码从哪来(Package → Repo → Commit → Author → License) | Git 原生能力 |
| Decision Provenance | 变更为什么发生、谁批准、基于什么证据 | 治理层能力 |
| Source Code Control Plane | Git 在新范式中的精确职责:源代码版本与历史 | Git 重新定位 |
| AGENTS.md | 组织级 Canonical Policy Layer | 持久化 Context |
| Context-as-Code | Context Engineering 的工程化版本控制版本 | Context 治理 |
| Skills | Agent 的可复用能力描述 | 能力层 |
| MCP | Model Context Protocol,外部能力协议层 | 跨工具能力共享 |
| Tool | 具体执行的操作(run-shell / edit-file / http-request) | 执行层 |
| 四维 Agent Governance | Context / Capability / Execution / Approval 四个边界 | 治理框架 |
| L1-L4 参考权限示例 | 常见权限组合的速记标签(非标准答案) | 权限示例 |
| Verification First | 完成前必须先收集相应证据 | 完成判定原则 |
| Pre-Change Evidence | Functional / Security / Architecture / Scope / Policy | 合并前证据 |
| Post-Change Evidence | Operational | 合并后证据 |
| Risk-adaptive Evidence | 不同变更类型要求不同维度证据 | 证据策略 |
| HITL | Human-in-the-loop,同步介入 | 高风险场景 |
| HOTL | Human-on-the-loop,异步监督 | 常规场景 |
| Worktree | Git Worktree,Agent 文件系统级隔离 | 并行工作基础设施 |
| Scope Compliance | 把任务边界做成可机器验证的硬约束 | Scope 治理 |
| VIBE CODING ENGINEERING | Intent / Context / Agent / Evidence / Change 五层治理框架 | 框架整合 |