剖析芯片扩展如何破坏 GPU 细粒度调度
摘要
现代 GPU 在物理上已不再对称。芯片扩展导致了 制造-驱动 的 floorsweeping(缺陷屏蔽)【见文末注释1 】以及缓存和内存分区。前者产生了芯片特定的计算拓扑结构,而后者导致了非均匀内存访问(NUMA)。这些不对称性是显著的:忽略拓扑的计算单元分配可导致高达 1.33× 的性能波动,而远程访问使 HBM 延迟增加高达 67% 、L2 延迟几乎翻倍。然而,这些不对称性被隐藏在 GPU 的逻辑资源抽象背后,并且可能因芯片而异。我们开发了轻量化的特征化方法,以揭示每块芯片的计算拓扑和内存亲和性 。然后,我们利用发现的信息使现有细粒度调度具备非对称感知能力 ,不仅考虑分配多少资源,还考虑分配哪些物理资源。在全 GPU 内核执行、应用内多路复用和应用间共置等场景中,非对称感知调度将主流内核性能提升高达 1.22× ,多路复用 LLM 推理提升高达 14.3% ,并避免了高达 1.33× 的性能波动。
1. 引言
现代 GPU 集成了大量并行资源。高效利用这些资源需要在多个层次上进行细粒度调度。内核库在计算单元之间调度工作以接近硬件性能极限(Zadouri 等,2026;Ye 等,2025)。在应用内部,近期的 LLM 服务系统空间多路复用 prefill 和 decode 阶段以提高 goodput(NVIDIA,2025b;Chen 等,2026)。跨应用而言,云系统将来自不同租户的内核共置到同一 GPU 上,并控制每个租户的计算和内存分配(NVIDIA,2025d;Wu 等,2015;Zhang 等,2025;Coppock 等,2025;Ng 等,2023;Zhao 等,2025)。
现有的细粒度调度工作(Zadouri 等,2026;Ye 等,2025;NVIDIA,2025b;Chen 等,2026;Wu 等,2015;Coppock 等,2025;Ng 等,2023;Zhao 等,2025)通常通过控制逻辑资源数量来运作。例如,它们控制任务使用多少计算单元以及访问多少内存。这些工作忽略了计算单元和内存的物理位置。它隐含假设架构是对称的------即具有相同计算单元数量和相同内存容量的分配提供等效的性能。
芯片扩展引入了不对称性,通过增大芯片面积(Jin 等,2024)和缩小工艺节点(7 nm→3 nm)(Sharma 等,2022)来增加每片芯片的晶体管数量。图 1 展示了一个现代 NVIDIA GPU 芯片的微架构,而表 1 进一步总结了跨越四代 NVIDIA 数据中心 GPU 的五个 SKU。从 Volta 到 Blackwell,完整芯片的 SM 数量从 84 增长到 160,L2 缓存从 6 MB 增长到 126 MB,HBM 堆栈从 4 个增长到 8 个。
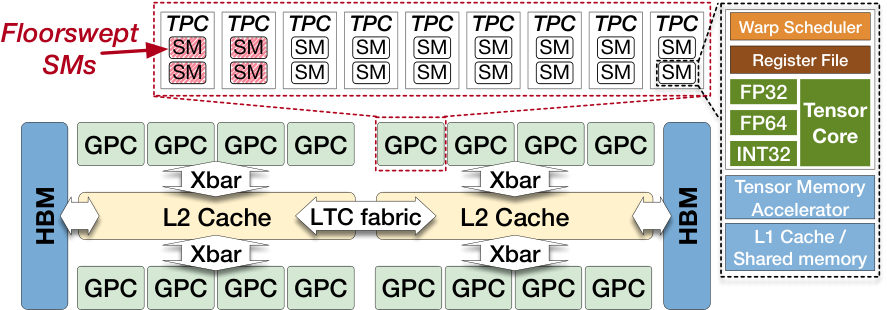
图 1. NVIDIA H200 GPU 的架构。流式多处理器(SM)被分组为纹理处理集群(TPC),TPC 进一步组成图形处理集群(GPC)。每个 SM 具有私有的 L1 数据缓存和共享内存,所有 SM 共享通过 LTC fabric 连接的物理分区 L2 缓存。Floorsweeping 在每个 GPC 内禁用选定的 TPC,因此 SM 到 GPC 的映射是芯片特定的。
首先,floorsweeping 禁用有缺陷的流式多处理器(SM,NVIDIA GPU 的基本计算单元)以提高良率,从而产生芯片特定的计算拓扑。其次,更大的 L2 缓存被分区以获得高带宽和低延迟。这些分区及其关联的 HBM 形成了具有不同本地和远程访问开销的非均匀内存访问(NUMA)拓扑。
这些不对称性具有显著的性能后果。Floorsweeping 产生计算不对称性 。在 NVIDIA H200 或 B200 上,两个 GPC 之间 SM 数量差异可高达 10 个【见文末注释2 】。远程 HBM 访问比本地访问产生约 34% 的更高延迟(H200 上 ~ 490→ ~ 655 周期),在 B200 上高达 67% (~ 552→ ~ 920 周期)。远程 L2 延迟在 H200 上比本地延迟高约 51% (~ 309→~ 466 周期),在 B200 上几乎翻倍(~ 364→~ 725 周期)。正如我们稍后在第 7 节中所示,忽略这些差异可能导致高达 1.33× 的性能波动。
本文解决了这种隐藏物理不对称性带来的两个挑战。
C-1: 软件如何高效地发现隐藏的、芯片特定的计算和内存不对称性,而无需架构文档?厂商暴露的是逻辑而非物理 SM 拓扑,floorsweeping 在同一 SKU 的不同芯片之间有所不同,NUMA 映射编码在未经文档记录的物理地址哈希中,并且不同架构使用不同的映射。因此,不对称性通常需要每芯片校准,而非在同一 SKU 的所有芯片之间共享的静态查找表。
C-2: 现有细粒度调度应如何利用发现的物理不对称性?现有调度工作仅确定资源数量。非对称感知增加了一个补充维度,即考虑物理资源身份、拓扑结构和计算-内存亲和性。目标不是取代细粒度调度,而是通过不仅考虑分配多少资源,还考虑分配哪些物理资源,使其更加精确。
为了解决第一个挑战,我们为计算和内存不对称性开发了轻量级特征化方法。对于计算不对称性,我们使用两种探测技术揭示完整的每芯片 SM-to-GPC 分配。我们观察到两组逻辑 SM ID。正常 SM 遵循架构特定的预定义 SM-to-GPC 映射,而剩余的 SM 根据芯片特定的 floorsweeping 结果分配到物理 GPC。为方便起见,我们将后者称为随机 SM。"随机"并不意味着运行时随机调度,而是由于 floorsweeping,它们的物理 GPC 位置可能因芯片而异。对于内存不对称性,我们开发了一种延迟层次发现方法,揭示被测 GPU 上的内存分区哈希和 HBM 交错粒度。利用发现的哈希,我们表征了本地/远程延迟差距、远程带宽瓶颈,以及跨分区缓存复制导致的有效 L2 容量损失。
为了解决第二个挑战,我们为三种代表性的细粒度调度场景构建了非对称感知原型。对于全 GPU 内核,我们开发了两种将内存访问导向 NUMA 本地分区的方法。将这些方法与主流 GPU 内核集成,以极小的代码改动将吞吐量提升高达 1.22× 。对于应用内多路复用,我们为空间多路复用 prefill 和 decode 阶段的 LLM 服务系统开发了一种对内核透明的跨 NUMA 分配方法。通过将任务私有分配限制在 NUMA 本地分区,同时跨分区共享其他分配,将 decode 吞吐量提升高达 14.3% 。对于应用间共置,我们评估了拓扑感知 SM 分配策略,并证明相等的 SM 数量并不意味着相等的物理能力。忽略拓扑的分配导致高达 1.33× 的吞吐量波动。
我们将开源我们的代码以支持所有结果的重现。本文的主要贡献如下:
• 我们开发了轻量级方法来揭示隐藏的、芯片特定的 GPU 计算和内存不对称性,包括 SM-to-GPC 映射、依赖于 floorsweeping 的拓扑、NUMA 分区哈希,以及本地/远程延迟和带宽行为。
• 我们展示了细粒度调度如何整合物理资源身份、拓扑和内存亲和性,而非仅依赖逻辑资源计数。
• 我们在三个层次上验证了非对称感知调度。这些结果激励将非对称感知作为未来 GPU 编程的设计原则。
2. 背景
大语言模型等工作负载(Grattafiori 等,2024;Jiang 等,2024)需要越来越高的计算吞吐量和内存带宽,推动了激进的 GPU 芯片扩展。图 1 展示了一个现代 GPU 芯片的微架构,而表 1 进一步总结了跨越四代 NVIDIA 数据中心 GPU 的五个 SKU。从 Volta 到 Blackwell,完整芯片的 SM 数量从 84 增长到 160,L2 缓存从 6 MB 增长到 126 MB,HBM 堆栈从 4 个增长到 8 个。
计算。 如图 1 所示,GPU 计算按层次组织(GPU - GPC - TPC - SM)。随着芯片增长,有缺陷的 SM 必须被禁用以维持制造良率,这一过程称为 floorsweeping。完整 GH100 芯片包含 8 个 GPC,每个 GPC 有 9 个 TPC。Floorsweeping 永久禁用每个 GPC 中选定的 TPC,使 H200 在 8 个 GPC 中剩余 132 个 SM。哪些 TPC 被禁用取决于每颗芯片的制造缺陷。Floorsweeping 之后,幸存的 TPC 被重新编号为连续的逻辑 SM ID 空间,使得逻辑到物理的映射对软件来说是芯片特定的且不透明的。
| SKU | V100 | A100 | H100 | H200 | B200 |
|---|---|---|---|---|---|
| Die | GV100 15 | GA100 16 | GH100 17 | GB100×2 18 | |
| Die (mm²) | 815 | 826 | 814 | 800×2 | |
| Full SMs | 84 | 128 | 144 | 80×2 | |
| SKU SMs | 80 | 108 | 114 | 132 | 148 |
| Disabled SMs | 4 | 20 | 30 | 12 | 12 |
| GPCs | 6 | 7 | 7/8 | 8 | 4×2 |
| TPCs/GPC | 7 | 8 | 9 | 10 | |
| L2 (MB) | 6 | 40 | 50 | 60 | 126 |
| L2 partitions | 1 | 2 | 2 | 2 | 2 |
| HBM type | HBM2 | HBM2e | HBM2e | HBM3e | HBM3e |
| HBM (GB) | 32 | 80 | 80 | 141 | 90×2 |
表 1. 跨代的 GPU 芯片规格。H100 有 SXM 和 PCIe 两种变体;此表列出 PCIe SKU。H100 PCIe 和 H200 共享 GH100 芯片,但启用的资源不同。B200 融合了两个 GB100 chiplet;标记 ×2 的值为每 chiplet 数量,未标记的值为封装总量。
内存。 在内存方面,每个 SM 有一个私有的 L1 数据缓存,所有 SM 共享一个由片外 HBM 堆栈支持的末级 L2 缓存。SM 通过 crossbar(Xbar,见图 1)与 L2 通信。从 Ampere 开始,L2 增长到 40 MB 并被物理划分为多个物理分区。本文研究的 NVIDIA GPU 每个 GPU 暴露两个内存亲和性分区。LTC fabric 将这些分区连接起来,向软件呈现统一的地址空间。更新的 Blackwell GPU(如 B200)将两个 chiplet 集成到单个 GPU 中。官方文档描述每个 chiplet 有一个 L2 分区,两个分区通过 LTC fabric 连接。每个 chiplet 内部的 L2 是否进一步分区仍然未知。
3. 相关工作
GPU 的细粒度调度。 现有工作在多个粒度上实现细粒度调度。在单个内核内,持久线程块(Wu 等,2015;Zhao 等,2022;Coppock 等,2025)允许用户将线程块固定到特定 SM。Thread Block Cluster(NVIDIA,2025e)是 Hopper 架构中引入的调度特性,进一步利用这一点进行加速。对于多任务或共置应用,多个系统(Wu 等,2015;Zhao 等,2022;Coppock 等,2025)通过控制 SM 数量来调度多路复用内核。所有这些系统控制使用多少 SM,但没有一个考虑分配哪些 SM 或其 NUMA 亲和性。
厂商支持的调度。 NVIDIA 的 MPS(多进程服务)(NVIDIA,2025d)支持静态 SM 分区。Green Contexts(NVIDIA,2025c)提供 SM 级分区,可选 GPC 对齐。MIG(多实例 GPU)(NVIDIA,2025f)提供可与 NUMA 边界对齐的硬件隔离计算和内存分区。MPS 的粗粒度 SM 分区无法利用 GPC 拓扑,Green Contexts 缺乏内存 NUMA 感知,而 MIG 的资源分配粒度太粗,无法支持细粒度内核调度。我们的工作与这些正交:我们揭示了由厂商抽象隐藏的物理不对称性,并展示了现有调度机制如何利用这些信息。
逆向工程调度。 FGPUs(Jain 等,2019)和 SGDRC(Bakita 等,2023)逆向工程物理内存映射并使用着色来减少缓存冲突。它们专注于内存分配优化,但没有考虑 floorsweeping 引起的计算拓扑变化。类似地,mrcGNN(Zhang 等,2022)和 SGDRC 控制资源份额和干扰,但没有纳入芯片特定的 floorsweeping 拓扑或 SM-to-GPC 映射。
GPU 上的 NUMA。 先前的研究(Kim 等,2023)已经观察到 GPU 上的 NUMA 效应。Kim 等(2023)在 AMD MI200 上识别了两种内存亲和性模式,并利用它们进行数据放置。然而,它们的方法依赖于供应商公开的亲和性信息。据我们所知,我们是第一个在 NVIDIA GPU 上揭示隐藏 NUMA 拓扑的人。
GPU 微基准测试。 广泛的 GPU 微基准测试工作(Wong 等,2010;Jia 等,2019;Luo 等,2025)已经表征了缓存和内存层次结构。我们的内存特征化借鉴了指针追踪技术(Wong 等,2010;Jia 等,2019)来测量缓存延迟。我们的贡献在于将这些技术应用于发现隐藏的 NUMA 分区,并利用发现的不对称性来改善调度。
4. 动机
NVIDIA 公布了每个 GPU 产品的 SM 总数、L2 缓存大小和 HBM 容量,但没有披露每芯片的 floorsweeping 模式或计算单元与内存分区之间的映射。没有这些信息,软件无法确定逻辑分配映射到哪些物理资源。
理解这种关系在多个粒度上都很重要。在单个内核级别,线程块在 SM 上共享数据。如果相邻线程块被调度到远程 SM,跨 NUMA 分区的通信可能会成为瓶颈。在应用内多路复用中,不同的阶段(如 LLM 推理中的 prefill 和 decode)共享权重但具有不同的工作集。如果阶段被放置在不同的 NUMA 分区上,共享权重的访问将产生跨分区流量。在应用间共置中,租户共享 GPU,但彼此隔离。如果租户被分配到共享同一 GPC 的 SM,它们将在 L2 Xbar 带宽上产生争用。
NVIDIA 将这些可变的架构特征隐藏在软件之外,以简化运行时和用户级编程模型。然而,正如我们将在下面展示的,这种抽象是有代价的。软件无法优化它不知道存在的东西。
在以下各节中,我们首先表征 floorsweeping 拓扑和 NUMA 亲和性映射。然后我们评估它们对三种代表性调度场景的影响:全 GPU 内核执行、应用内多路复用和应用间共置。
5. 计算不对称性分析
拓扑感知分区放置需要将逻辑 SM ID 映射到物理 GPC。我们通过轻量化的两阶段探测方法揭示完整的映射。
5.1 SM 拓扑发现
5.1.1 第一阶段:Thread Block Cluster 探测
Thread Block Cluster(NVIDIA,2025e)是 Hopper 引入的新 CUDA 特性。它们将内核中的一组线程块共同调度到 GPC 本地 SM 上,实现直接的跨块分布式共享内存访问和 cluster 屏障,而无需经过 L2。在这种情况下,同一 Thread Block Cluster 中的 SM 位于同一 GPC 内。
我们利用这一特性来探测 GPC 布局。通过启动不同大小的 cluster 并记录哪些逻辑 SM ID 共同出现,我们可以推断出哪些 SM 属于同一 GPC。具体来说,我们启动覆盖所有 SM 的 cluster,大小从 2 到 8,并记录每个 cluster 的组成 SM ID(通过 %smid PTX 寄存器获得)。在 cluster 中共同出现的 SM ID 属于同一 GPC。
通过这种方法,我们可以部分揭示 GPU 上 SM 的 GPC 布局。例如,在 H200 上,我们可以 uncover 具有 ID 0--123 的 SM 的 GPC 布局(8 个 GPC 中的 62 个 TPC)。这些 SM 可靠地出现在 cluster 启动中,而 SM ID 124--131(4 个 TPC)在 cluster 大小 >2 时从不出现。
我们观察到两组逻辑 SM ID。通过 cluster 探测识别的 SM 遵循架构特定的预定义 SM-to-GPC 映射。为方便起见,我们称它们为正常 SM 。剩余的 SM 的 GPC 位置由芯片特定的 floorsweeping 结果决定。我们称它们为随机 SM。这里,"随机"并不意味着这些 SM 在运行时被随机调度。相反,由于 floorsweeping,它们的物理 GPC 位置可能因芯片而异。
5.1.2 第二阶段:L2 带宽探测
为了将剩余的随机 SM 分配到 GPC,我们利用了一个观察结果:共享同一 GPC 的 SM 会在该 GPC 的 L2 Xbar 带宽上产生争用(Jin 等,2024)。这意味着同一 GPC 中的 SM 具有比分布在不同 GPC 中的相同数量 SM 更低的 L2 带宽。
为了获得 L2 带宽,我们使用一个内核反复读取大小超过 L1 但适合 L2 的缓冲区,强制所有访问都命中 L2 缓存。
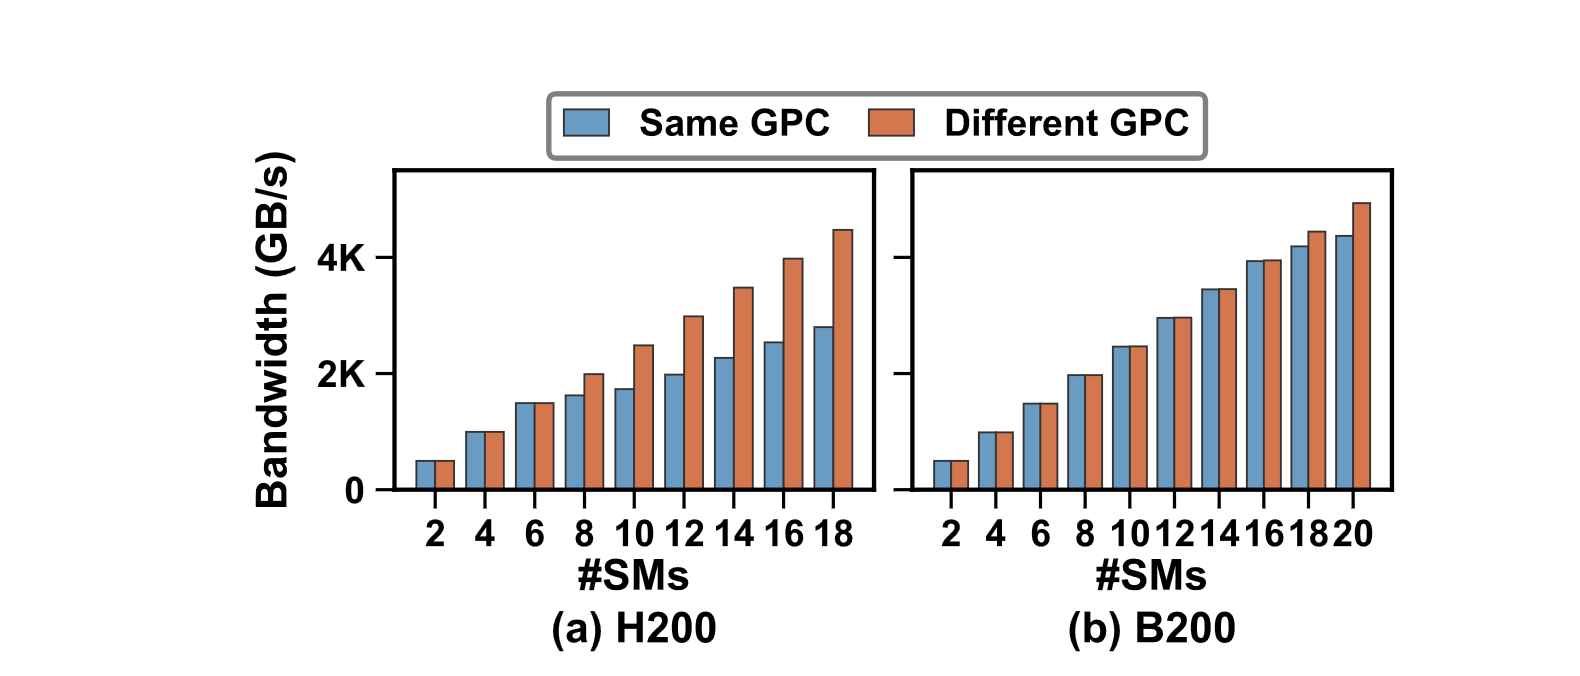
图 2. H200 和 B200 上不同 SM 数量下每个 GPC 的 L2 带宽。由于 Hopper 中每个 GPC 有 9 个 TPC,B200 中每个 GPC 有 10 个 TPC,H200 的带宽测试在 18 个 SM 结束,B200 在 20 个 SM 结束。
图 2 显示了 H200 和 B200 上同一 GPC 内和跨不同 GPC 的 SM 的 L2 带宽。如图所示,当 SM 位于不同 GPC 时,L2 带宽随 SM 数量线性增长。然而,对于同一 GPC 内的 SM,这一趋势不成立。当 SM 数量在 H200 上超过 6 个、在 B200 上超过 16 个时,它们的 L2 带宽变得低于不同 GPC 中 SM 的带宽。
利用这一观察,我们可以将随机 SM 分配到具有最低聚合 L2 带宽的 GPC。通过迭代地添加随机 SM 并测量每个可能 GPC 的带宽变化,我们可以确定每个随机 SM 最可能的 GPC 归属。
组合方法在每块 GPU 上运行时间不到 1 分钟,且仅需要标准 GPU 内核。我们通过将发现的映射与 SM 级性能计数器(如 smsp__cycles_active)关联来验证 uncovered 映射,确认 cluster 探测和带宽探测结果一致。
要点 1: 逻辑 SM ID 分为两组。正常 SM 遵循架构特定的预定义 SM-to-GPC 映射。随机 SM 根据芯片特定的 floorsweeping 结果分配到物理 GPC,因此它们的 GPC 位置可能因芯片而异。
5.2 芯片特定的 SM 拓扑
图 3-(a) 显示了特定 H200 和 B200 芯片上完全揭示的 SM-to-GPC 映射,蓝色区域表示正常 SM,橙色区域表示随机 SM,红色叉号部分表示被 floorsweeping 的 SM。
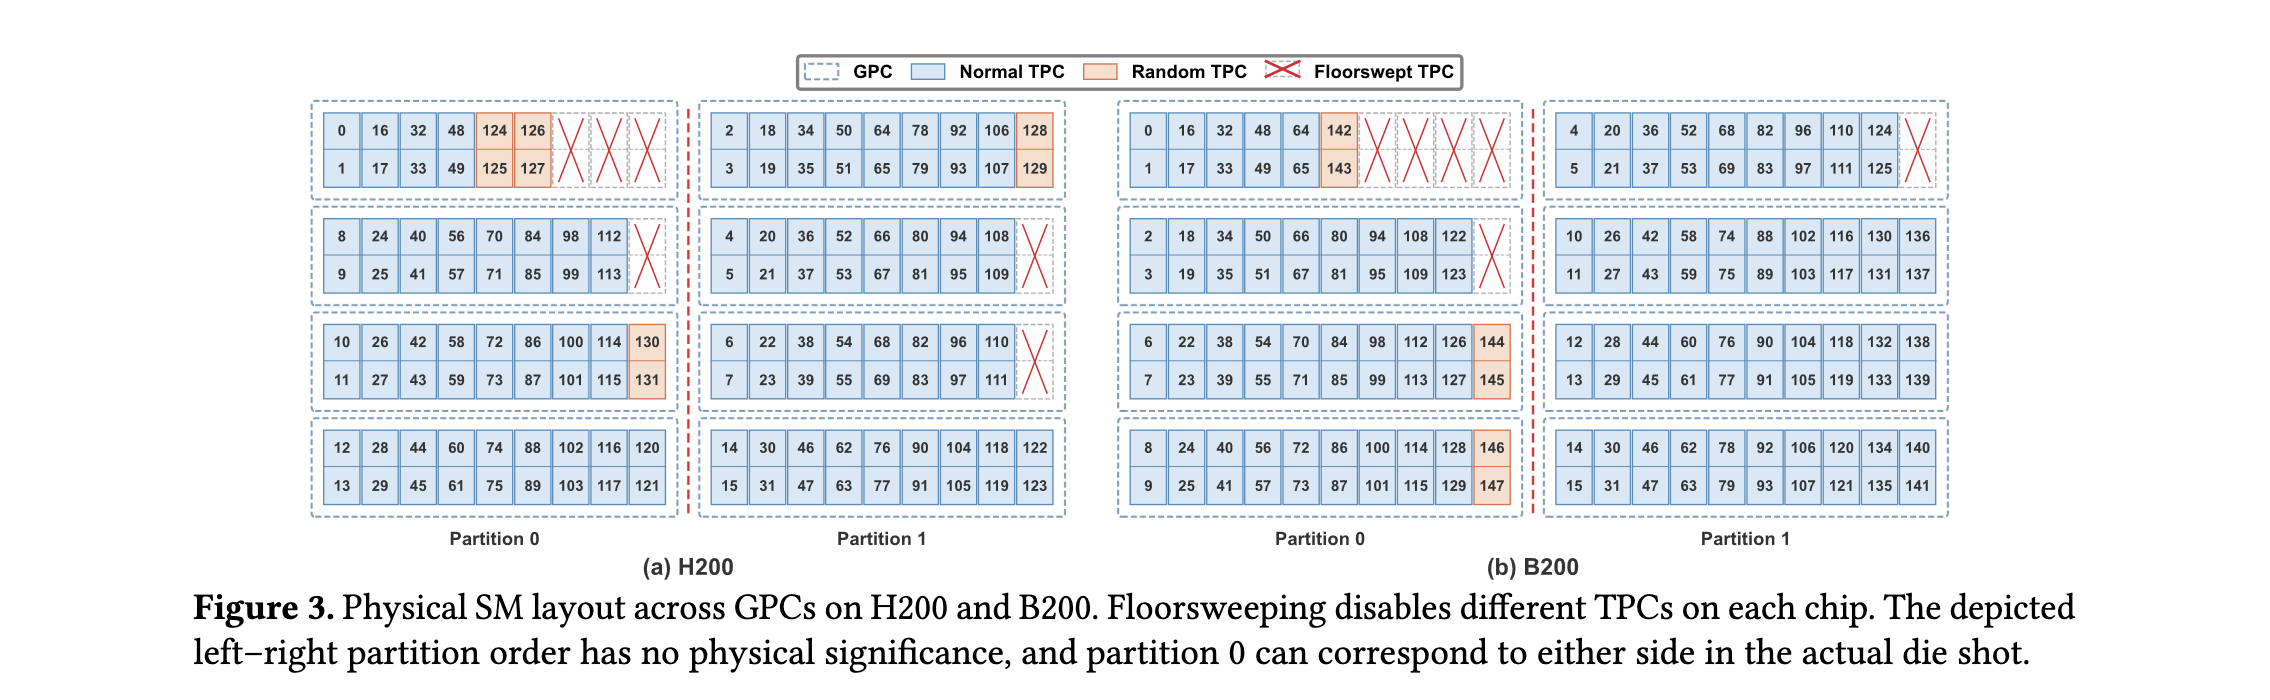
图 3. H200 和 B200 上跨 GPC 的物理 SM 布局。Floorsweeping 在每块芯片上禁用不同的 TPC。左右分区的顺序是任意的,没有物理意义。
值得注意的是,图 3 已经显示了 SM 与内存分区的亲和性。对于 H200,分区 0 对应于 GPC 0--3,分区 1 对应于 GPC 4--7。对于 B200,分区 0 对应于 chiplet 0(GPC 0--4),分区 1 对应于 chiplet 1(GPC 5--9)。
5.2.1 SM 拓扑可变性
通过在多块相同 SKU 的 H200 和 B200 芯片上进行拓扑发现,我们发现芯片之间的 SM 数量不同。图 3-(b) 比较了两块 H200 芯片之间的 SM 拓扑。两张图的左右分区顺序是任意的,没有物理意义。两个 H200 芯片具有完全相同的 GPC 数量(8 个),但它们的 SM 分布不同。在 Chip 2 中,GPC 3 有 14 个 SM(7 个 TPC),而 GPC 5 有 18 个 SM(9 个 TPC);在 Chip 1 中,GPC 3 有 16 个 SM(8 个 TPC),而 GPC 5 有 14 个 SM(7 个 TPC)。GPC 之间的最大差异高达 10 个 SM。
两个 B200 芯片之间的差异更大。Chip 1 有 9 个 GPC,而 Chip 2 有 10 个。Floorsweeping 在不同 chiplet 之间的不平衡甚至更大。例如,Chip 2 中 chiplet 0 有 78 个 SM,而 chiplet 1 有 70 个 SM,相差 8 个 SM。
要点 2: 由于 floorsweeping,SM 拓扑在芯片内部和相同 SKU 的芯片之间都有所不同,产生变化的 GPC 大小和跨 chiplet 的不平衡。
5.2.2 Thread Block Cluster 调度
在完全揭示 SM 拓扑后,我们在一块平衡的 H200 芯片上重新运行 cluster 探测实验,该芯片的 8 个 GPC 每个至少包含 16 个 SM。在这种情况下,一个 GPC 包含 8 个正常 SM 和 8 个随机 SM。
即使在这块平衡的芯片上,硬件也从不调度 cluster 大小大于 2 的块到包含随机 SM 的 GPC。这意味着随机 SM 不能用于 Thread Block Cluster 调度。
这一发现产生了有趣的含义。考虑一个只需要 68 个 SM 的 Thread Block Cluster。现有方法(NVIDIA,2025e)在 GPC 0 和 1 上为 68 SM 分配 4×4 cluster,在 GPC 2 和 3 上分配 8×2 cluster。这使得大小为 4 的 cluster 在 68 SM 上运行良好,而大小为 2 的 cluster 需要 8 个 GPC 以获得更好的可扩展性。但 chiplet 内部之间的 SM 差异意味着 cluster 大小为 8 的 cluster 只能使用 10 个 GPC(80 个 SM),留下 68 个 SM 未使用。我们的非对称感知调度使用 chiplet 0 中的 78 个 SM 并应用 13×6 cluster,使运行时间比 cluster 大小为 8 的 cluster 快 1.34×。
要点 3: Thread Block Cluster 调度受芯片特定 floorsweeping 的约束。随机 SM 不能用于 cluster 大小大于 2 的 Thread Block Cluster 调度。
5.3 使用不同机制调度 SM
通过揭示的 SM 拓扑,我们可以进一步分析其对划分 SM 的不同机制的影响。
5.3.1 Green Context 中的优先级
我们观察到 Green Context 优先为较早的上下文分配正常 SM,将随机 SM 留给最后一个上下文。
Green Context 在同时运行在同一 GPU 上的内核之间划分 SM。每个内核绑定到一个轻量级上下文,该上下文指定其 SM 份额。Green Context 可以配置为 GPC 对齐模式,确保每个上下文的 SM 分配与 GPC 边界对齐。
由于 Thread Block Cluster 广泛用于 CUTLASS(NVIDIA,2025a)等生产内核库中,大多数部署需要 cluster 大小至少为 4 或 8 的 SM。随机 SM 不支持大于 2 的 cluster 大小,因此它们对需要大 cluster 的内核不那么有价值。
因此,分配给较早分配的 Green Context 的所有 SM 都是正常 SM,而最后一个分配的上下文具有最高浓度的随机 SM。这种隐含的优先级意味着需要大 cluster 的租户应优先分配,以确保获得正常 SM。
要点 4: 为了启用大 Thread Block Cluster,floorsweeping 迫使 GreenContext 尽可能先分配正常 SM,将随机 SM 留给后续上下文。
5.3.2 MIG 中浪费的 SM
MIG 将 GPU 划分为物理隔离的实例。预定义的 MIG profile 指定每个实例的 SM 数量、L2 缓存大小和 HBM 容量。相同 SKU 的每块芯片都暴露相同的 profile 集。
我们发现芯片特定的 floorsweeping 导致 MIG 留下一些原本正常工作的 SM 未使用。为了检查这种损失,我们使用两个 H200 MIG profile,4g.71GB 和 3g.71GB,分别简称为 4g 和 3g。它们提供 64 和 48 个 SM。
比较全 GPU 和 MIG 拓扑 across chips,我们发现每个 GPC 具有固定的 SM 组成,但分配给每个 MIG 实例的 GPC 因芯片而异。为了保持跨芯片的 profile 相同,MIG 必须禁用一些 GPC 中的额外 SM,即使它们在物理上是正常的。例如,在一个芯片上,4g profile 可能分配 4 个完整的 GPC(72 个 SM),但只暴露 64 个,浪费 8 个 SM。在另一个芯片上,相同的 profile 可能分配 3 个完整 GPC 加上一个部分 GPC,浪费更少的 SM。
要点 5: Floorsweeping 还影响 MIG 暴露的 SM 数量。为了保持跨芯片的 profile 相同,MIG 必须禁用一些原本正常的 SM。
6. 内存不对称性分析
从 Ampere 开始,L2 缓存被物理划分为多个内存亲和性分区。本节分析现代 GPU 上由此产生的内存布局。
6.1 NUMA 布局发现
6.1.1 访问延迟分布
我们首先检查 HBM 内存访问的延迟分布,以验证 L2 缓存的分区是否确实引入了 NUMA 效应。
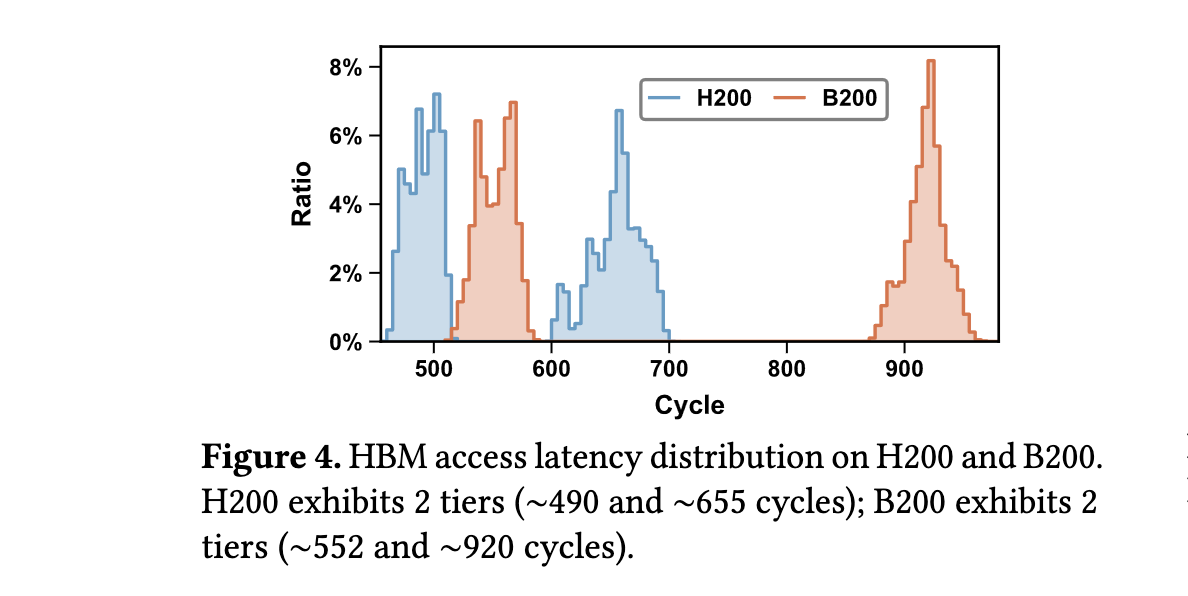
图 4. H200 和 B200 上的 HBM 访问延迟分布。H200 表现出 2 个层级(~490 和 ~655 周期);B200 表现出 2 个层级(~552 和 ~920 周期)。
图 4 显示了 H200 和 B200 上的 HBM 访问延迟分布。我们可以看到本地和远程访问之间存在明显的差距。在 H200 上,本地 HBM 延迟约为 490 周期,远程延迟约为 655 周期。在 B200 上,本地延迟约为 552 周期,远程延迟约为 920 周期。
同时,我们还观察到 B200 上本地 HBM 内存访问延迟存在双峰,这稳定地出现在本地 HBM 延迟的两个子层级中。这种双峰模式表明,即使在同一 NUMA 分区内,B200 的本地访问也可能经历两个不同的延迟路径。这可能与 B200 的 chiplet 内部结构有关,其中每个 chiplet 内部的内存控制器可能具有不同的访问路径。
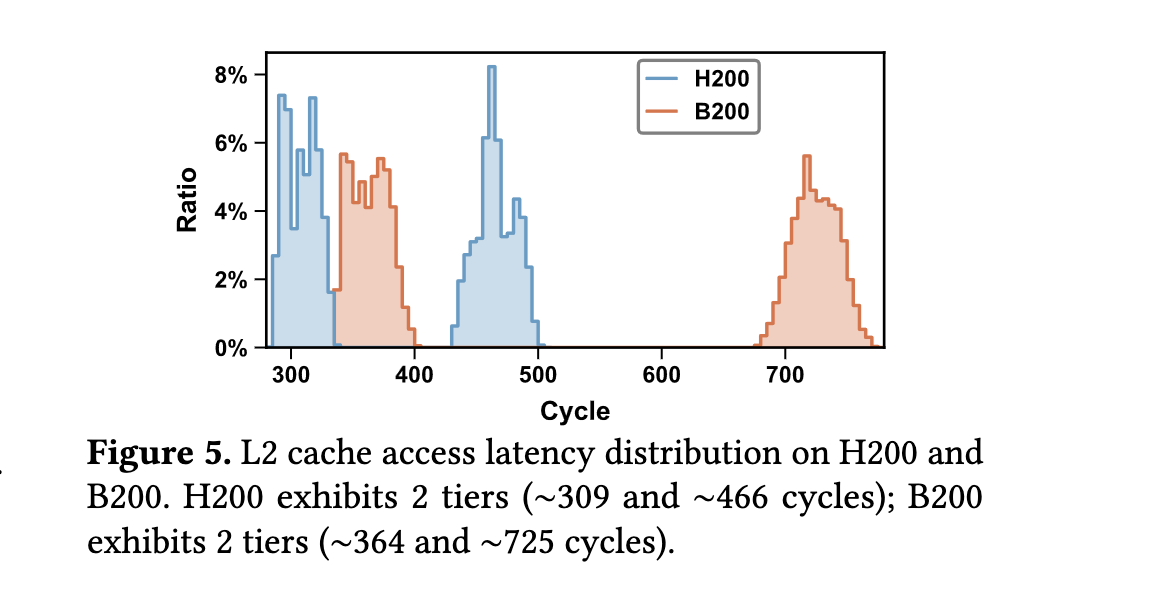
图 5. H200 和 B200 上的 L2 缓存访问延迟分布。H200 表现出 2 个层级(~309 和 ~466 周期);B200 表现出 2 个层级(~364 和 ~725 周期)。
图 5 显示了 H200 和 B200 上的 L2 缓存访问延迟分布。在 H200 上,本地 L2 延迟约为 309 周期,远程延迟约为 466 周期。在 B200 上,本地延迟约为 364 周期,远程延迟约为 725 周期。
延迟测量还揭示了 SM-to-partition 亲和性,因为我们可以从所有 SM 探测每个内存分区。图 3 显示了结果:H200 上 GPC 0--3 连接到分区 0,GPC 4--7 连接到分区 1;B200 上 chiplet 0 连接到分区 0,chiplet 1 连接到分区 1。
6.1.2 NUMA 分区识别
延迟分布识别了给定地址所属的分区。我们还需要确定分区粒度,定义为映射到同一分区的最小连续地址范围。了解粒度使我们能够控制数据放置,并与 GPU 的页大小对齐。
我们使用指针追踪基准测试系统地扫描地址空间,测量不同地址范围的访问延迟。通过分析延迟模式,我们识别了分区边界。在 H200 上,我们发现分区粒度为 2 MB,与 GPU 的默认页大小匹配。在 B200 上,分区粒度也是 2 MB。
此外,我们还发现了用于将物理地址映射到 NUMA 分区的哈希函数。在 B200 上,哈希基于地址位的 XOR 组合。图 6 显示了 B200 的 XOR 哈希。
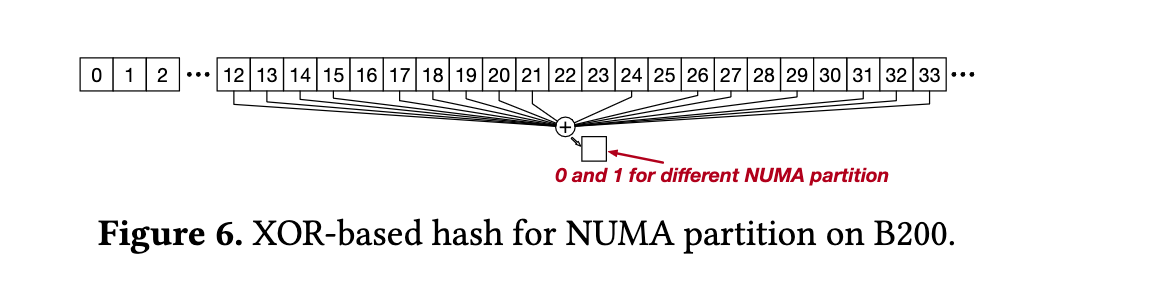
图 6. B200 上用于 NUMA 分区的基于 XOR 的哈希。
6.2 NUMA 的性能影响
6.2.1 有效 L2 缓存
为了测量有效 L2 容量,我们采用 L2 缓存基准测试(RRZE-HPC,2024),运行一个读密集型内核,逐步增加工作集大小。当工作集适合 L2 时,访问命中缓存并产生高带宽。一旦工作集超过有效 L2 容量,带宽就会下降。
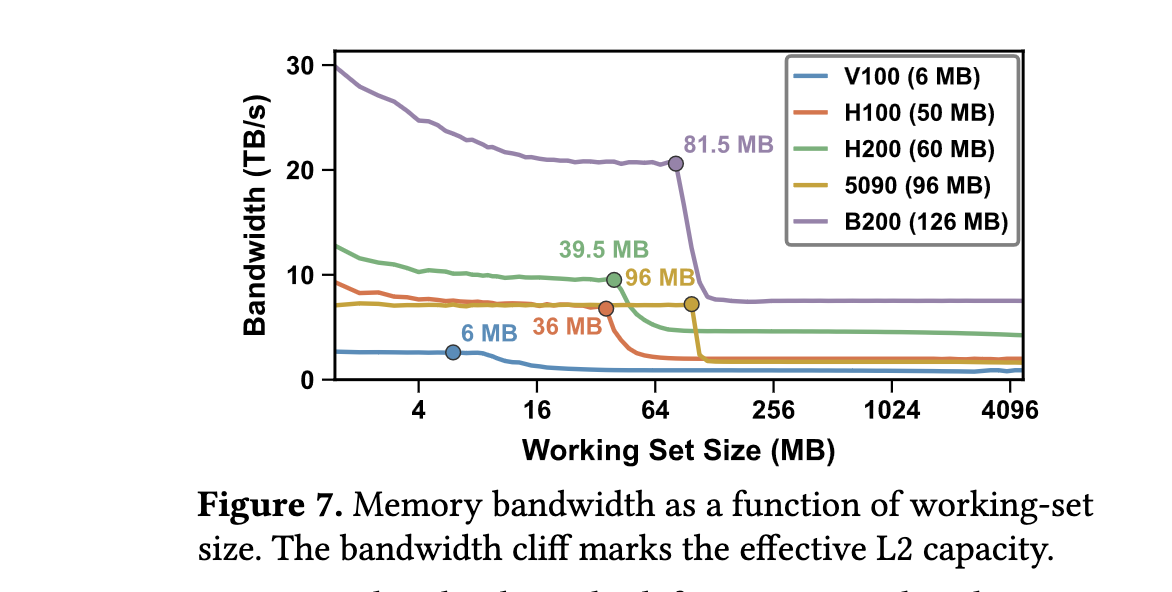
图 7. 内存带宽随工作集大小的变化。带宽悬崖标志着有效 L2 容量。
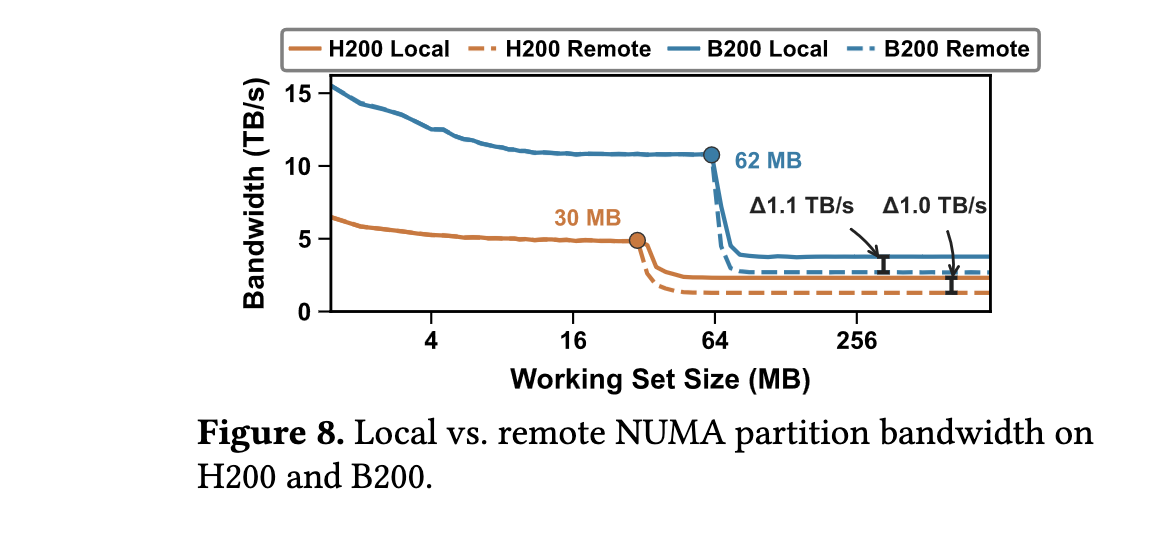
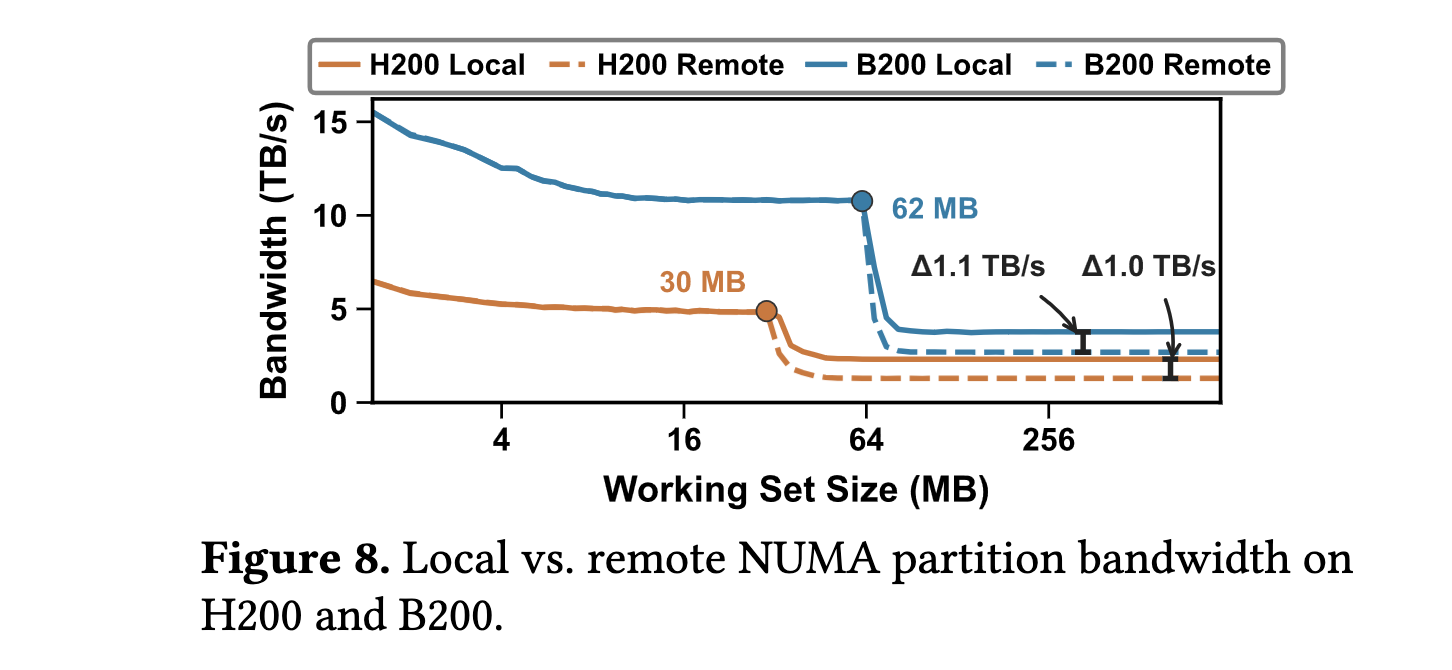
图 7 显示了不同 GPU 的内存带宽随工作集大小的变化。在 H200 上,带宽在约 30 MB 处下降,远低于物理 L2 容量 60 MB。这表明由于 NUMA 分区,有效 L2 容量大约是物理容量的一半。类似地,在 B200 上,有效 L2 容量约为 62 MB,而物理容量为 126 MB。
这种有效容量减半的原因是:当数据从一个分区加载到另一个分区的 SM 时,数据被复制到本地 L2,而不是直接从远程 L2 转发到 L1。这意味着远程数据会竞争本地 L2 容量。
6.2.2 L2 缓存一致性
L2 缓存被物理划分为由 LTC fabric 连接的内存亲和性分区。这种组织提出了一个问题:跨分区访问是将数据直接从远程 L2 转发到本地 L1(绕过本地 L2),还是使用 LTC fabric 在本地 L2 分区中复制数据。
我们通过一个微基准测试来区分这两种情况。首先,我们从分区 0 的 SM 加载数据,确保数据缓存在分区 0 的 L2 中。然后,我们从分区 1 的 SM 访问相同的数据。如果数据直接从远程 L2 转发到 L1,我们应该观察到远程 L2 延迟(~466 周期在 H200 上)。如果数据在本地 L2 中复制,我们应该观察到本地 L2 延迟(~309 周期)。
实验结果表明,跨分区访问在本地 L2 中复制数据。这意味着当数据被多个分区的 SM 访问时,它会在多个 L2 分区中存在副本,进一步减少了有效 L2 容量。
要点 6: GPU 的 NUMA 设计在本地 L2 分区中复制远程数据,而不是直接从远程 L2 转发到 L1。这减少了有效 L2 容量,并增加了 L2 争用。
7. 调度影响
第 5 节和第 6 节揭示了 GPU 芯片扩展引入的两种架构不对称性。然而,它们的调度影响取决于 GPU 的使用方式。因此,我们研究三种代表性的 GPU 使用场景,而不是尝试构建一个单一的 monolithic 调度器。
| 使用场景 | 示例 | 相关不对称性 | 调度动作 | 关键结果 |
|---|---|---|---|---|
| 全 GPU 内核 | Attention&MoE | 内存 + 计算拓扑 | NUMA 感知工作负载分配 + 拓扑感知 cluster 放置 | 高达 1.22× |
| 应用内多路复用 | LLM prefill/decode | 内存亲和性 | NUMA 感知实例放置 | 高达 14.3% |
| 应用间共置 | 多租户共享 | 计算拓扑 + 内存亲和性 | 拓扑感知隔离 | 避免 1.33× 波动 |
表 2. 三种非对称感知细粒度调度场景。
7.1 全 GPU 内核:NUMA 局部性与拓扑感知
我们研究拓扑和 NUMA 感知工作负载分配如何影响占据整个 GPU 的单个内核。我们首先介绍两种与现有内核集成的 NUMA 感知分配方法。虽然这些内核占据所有 SM,但每个 NUMA 分区的 SM 数量因 GPU 而异。例如,B200 的两个 chiplet 可能具有不同的 SM 数量(78 vs 70)。因此,均匀的数据分配可能导致一个分区的 SM 等待另一个分区。
7.1.1 NUMA 感知内存分配
如 §6.1.2 所确立的,GPU 以 4 KB 粒度跨 NUMA 分区交错内存。NUMA 感知执行需要将数据放置在与处理它的 SM 相同的分区中。我们实现了两种具有不同架构覆盖范围和地址计算要求的分配方法。
通过重映射的间接分配。 我们的第一种方法支持所有具有 NUMA 的 NVIDIA GPU。我们首先使用大页映射分配物理上连续的内存区域。图 9 说明了 2 MB 物理页内的这一过程。每对连续的 4 KB 页包含来自每个分区的一页。我们构造两个逻辑视图,每个视图仅索引属于其目标分区的页。要访问逻辑页 j,内核将其重映射到两个物理页 (2j, 2j+1) 之一。发现的分区哈希选择属于目标分区的页,而页内的字节偏移量保持不变。数据放置和内核访问都使用这种映射来保持每个视图的数据在其目标分区中。这种间接性为内核的地址计算增加了一个 O(1) 计算。附录 E 提供了实现细节和重映射公式。
通过驱动修改的直接分配。 我们的第二种方法扩展了 NVIDIA 驱动程序的 MLOPart 相关代码(Nassernia,2025),以公开一个接受目标 NUMA 分区的分配接口。该接口在指定分区内分配请求的内存,允许内核无需软件地址重映射即可访问它。此方法消除了重映射开销,但仅限于 Blackwell 及更新的 GPU,其中所需的 MLOPart 支持可用。
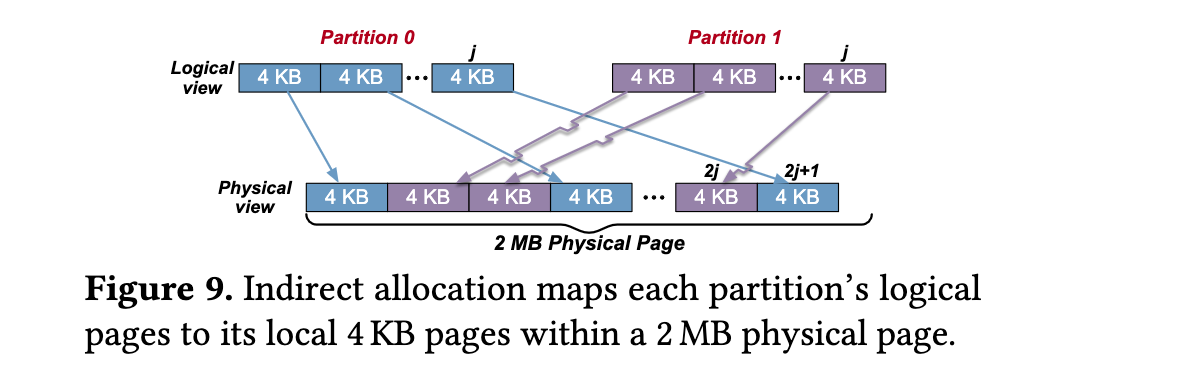
图 9. 间接分配将每个分区的逻辑页映射到 2 MB 物理页内的本地 4 KB 页。我们实现了两种具有不同架构覆盖范围和采用便利性的分配方法。
7.1.2 与主流内核集成
使用任一 NUMA 感知分配方法,我们需要分配内核的工作负载以匹配其数据放置。我们首先将所有内核转换为使用持久线程块(PTB)(Wu 等,2015),其中一个块固定到每个 SM 以循环处理任务。这种固定的块到 SM 映射使我们能够提前规划每个块应处理哪些数据。在这种情况下,我们首先将内核的数据放置在 NUMA 本地分配中,然后使用发现的 SM-to-partition 亲和性为每个块分配其数据驻留在其 SM 本地分区的任务。为了使分配具备拓扑感知能力,我们按各分区的 SM 数量比例在 NUMA 分区之间分配数据。
我们将 NUMA 感知分配应用于三种注意力变体和分组通用矩阵乘法(GroupGEMM),所有这些都在 LLM 中广泛使用。注意力变体包括多头注意力(MHA)(Vaswani 等,2017)、分组查询注意力(GQA)(Ainslie 等,2023)和多头潜在注意力(MLA)(DeepSeek-AI,2024)。GroupGEMM 在单个内核内执行多个独立的矩阵乘法。这种结构匹配混合专家(MoE)LLM 中的专家计算,其中每个专家将其路由的 token 激活乘以其自己的权重。
我们的基线实现来自最先进的内核库。我们在 H200 上使用 FlashAttention-3(Dao,2024),在 B200 上使用 FlashAttention-4(Zadouri 等,2026)用于注意力,在两台 GPU 上都使用 CUTLASS 用于 GroupGEMM。我们在 H200 上使用间接分配,在 B200 上使用直接分配。我们评估所有三种注意力变体的 prefill 和 decode,使用不同的键值(KV)工作集大小,以及使用不同 GEMM 工作集大小的 GroupGEMM。基准配置来自原始库。附录 F 详细说明了内核实现和工作负载配置。
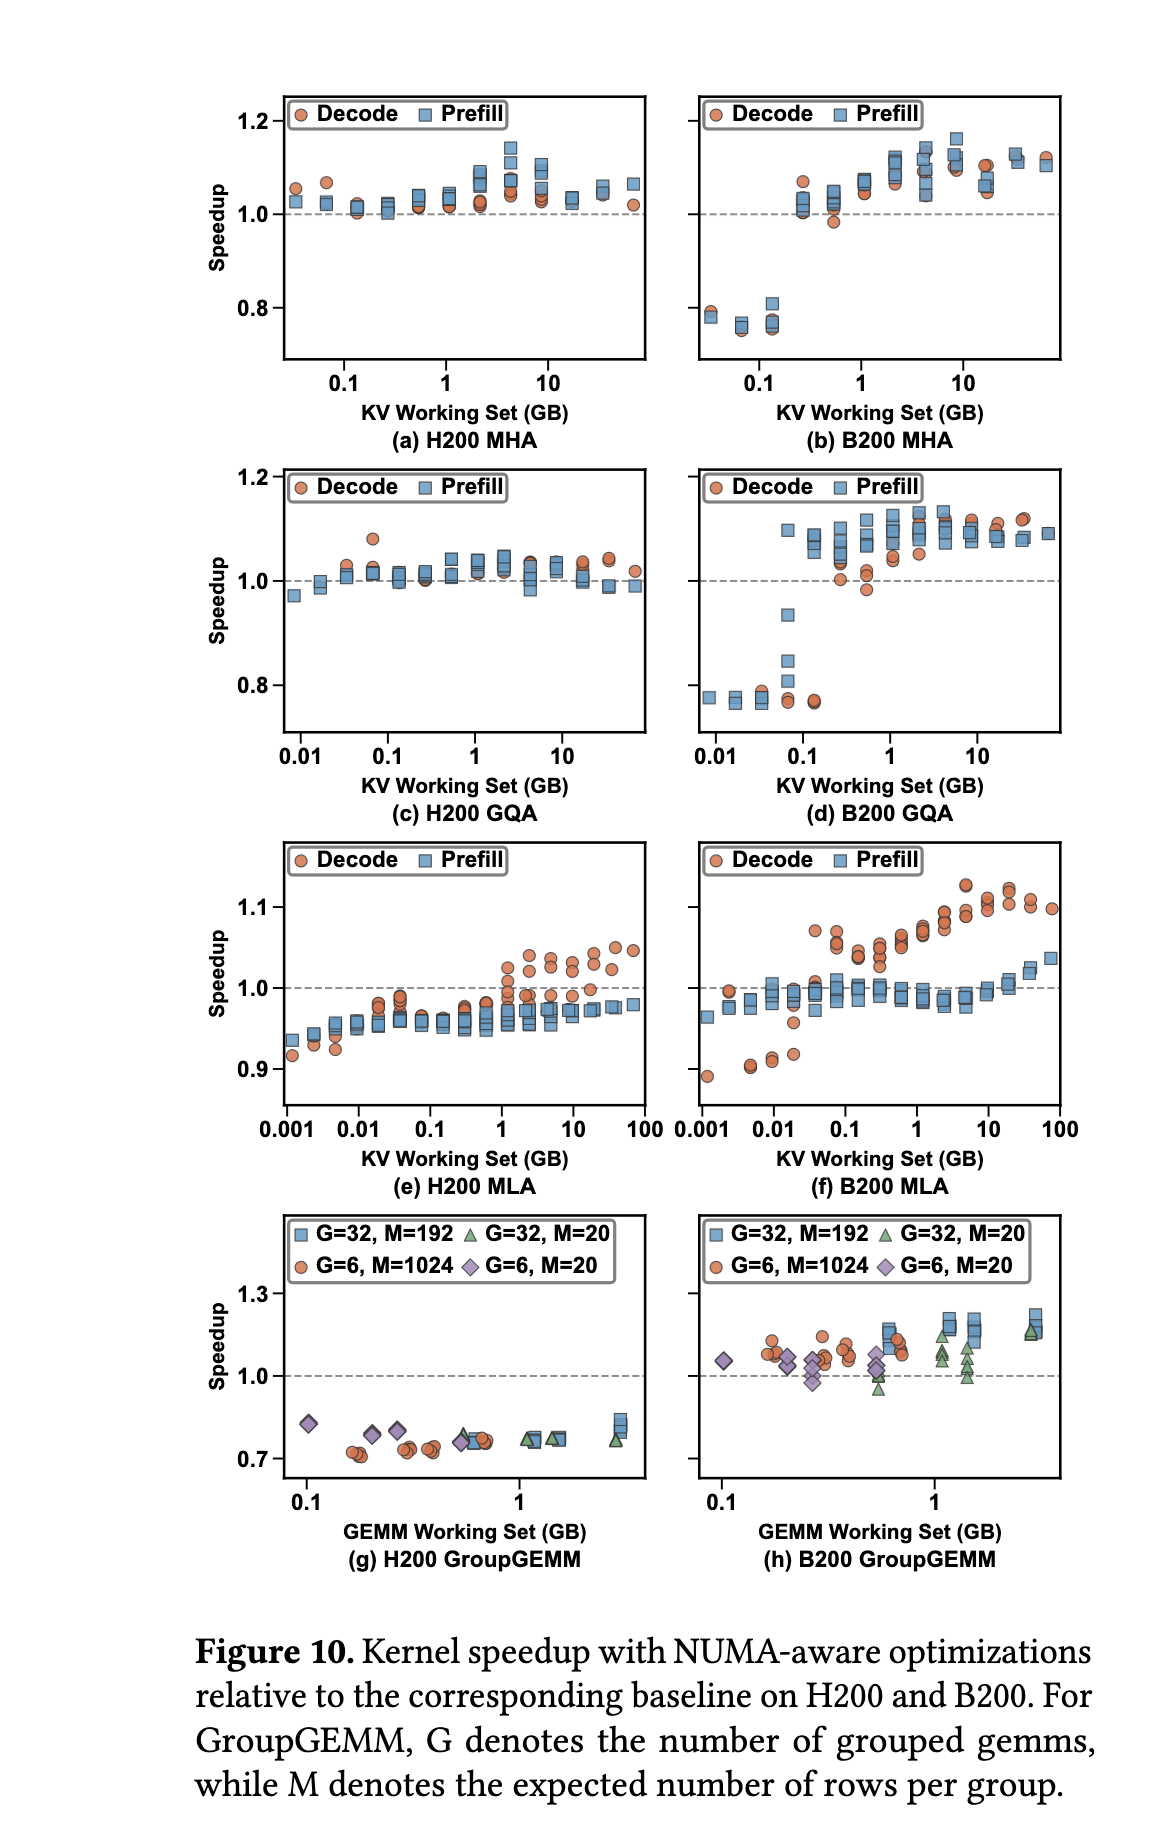
图 10 报告了在分区 SM 数量相等的情况下,H200 和 B200 上相对于对应基线的加速比。两台 GPU 上的大多数内存在某些配置中从 NUMA 感知中受益,B200 上的 GroupGEMM 实现了高达 1.22× 的加速。分析器收集的硬件计数器(NVIDIA Corporation,2026)显示所有内核的 LTC fabric 请求大幅减少,证实了我们的方法减少了跨分区访问。
然而,NUMA 感知在某些情况下也会降低性能。例如,B200 上具有小 KV 工作集的注意力内核从 NUMA 感知中获益甚微。基于 PTB 的工作负载分配(Wu 等,2015)要求每个块查询其运行在哪个 SM 上,相对于原始内核增加了启动开销。对于小工作负载,此开销超过了 NUMA 感知的收益,导致性能更差。
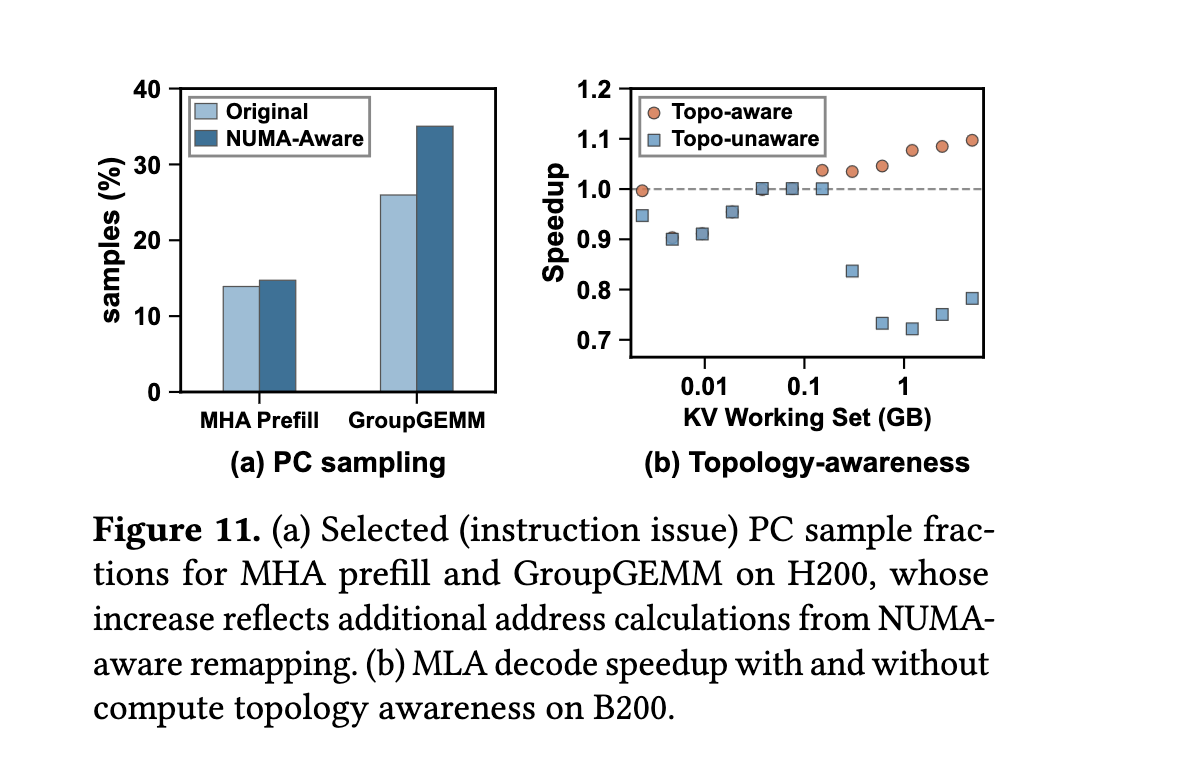
图 11. (a) H200 上 MHA prefill 和 GroupGEMM 的选中(指令发射)PC 采样比例,其增加反映了 NUMA 感知重映射带来的额外地址计算。(b) B200 上有无计算拓扑感知的 MLA decode 加速比。
总体而言,NUMA 感知执行在 B200 上表现更好,原因有二。B200 的跨 die NUMA 效应比 H200 更大,且直接分配产生的地址计算开销可忽略不计。在 H200 上,间接分配需要地址重映射,这增加了开销,特别是对 GroupGEMM。图 11-(a) 显示了 H200 上 MHA 和 GroupGEMM 中与地址计算相关的程序计数器(PC)采样。此开销对 GroupGEMM 比对 MHA 大得多,超过了 GroupGEMM 从 NUMA 感知中获得的收益。
最后,我们评估了拓扑和 NUMA 感知的组合。图 11-(b) 比较了 B200 上分区 SM 数量不等(70/78)时有无拓扑感知的 MLA decode 性能。没有拓扑感知,NUMA 感知执行可能将加速比变为减速,从 1.10× 降至 78%。NUMA 局部性对全 GPU 内核性能很重要,但 NUMA 感知工作负载分配还必须考虑 SM 拓扑。
7.2 应用内多路复用:联合计算-内存放置
应用内多路复用将同一应用的不同阶段共置到同一 GPU 上。我们使用 LLM 服务中的 prefill-decode 多路复用作为代表性场景。
我们的目标是保持每个阶段的私有状态对其 SM 本地,同时保留对共享权重的访问。共享权重跨分区放置,而每个阶段的私有状态(KV cache)放置在其本地分区。
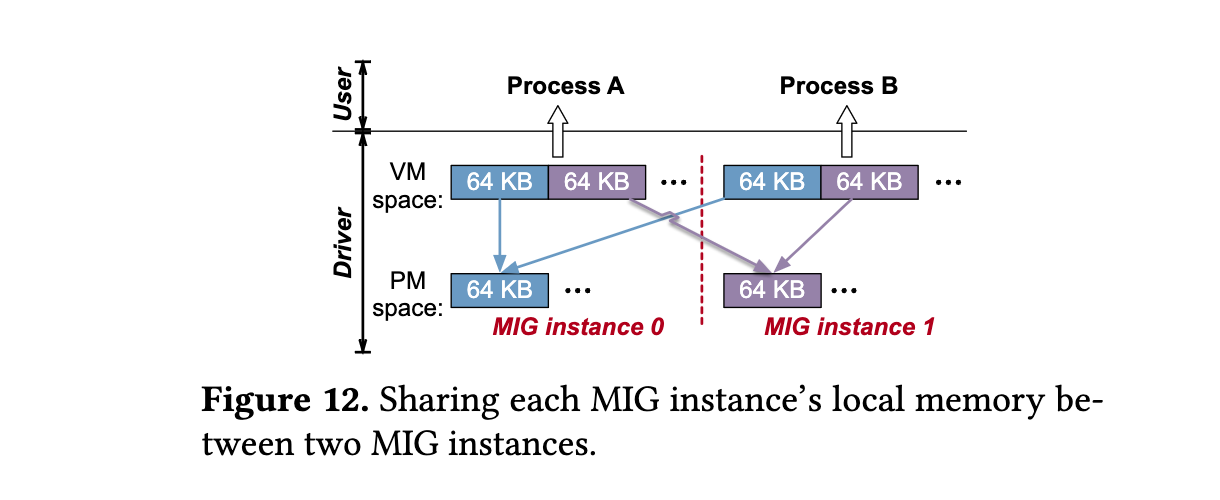
图 12. 在两个 MIG 实例之间共享每个 MIG 实例的本地内存。
图 12 说明了最终的内存放置。每个阶段的私有状态驻留在其本地 MIG 实例中。一半的共享内存本地分配,另一半从远程实例映射。我们以 64 KB 粒度在两个实例之间交错物理页。
我们将此方法集成到 mini-SGLang(sgl-project,2026)中,在 H200 和 B200 上运行 Qwen3-8B。每个阶段最多可以使用其 MIG 实例中可用的 SM。跨策略,prefill 和 decode 在 H200 上分别接收 64 和 56 个 SM,在 B200 上分别接收 64 和 64 个 SM。这些数量是支持 cluster 大小为 8 的每个 MIG 半实例中可用的最大数量。
在两块 GPU 上,我们将 prefill 配置为 batch size 4 和 sequence length 4K。Decode 使用 batch size 128 和平均 KV length 512。
我们比较了三种多路复用放置策略:
- Cluster-Aware (CA) Overlap:使用 Green Contexts 与 MPS 分配支持 cluster 大小为 8 的 SM,没有 NUMA 感知内存放置,遵循先前工作(Lin 等,2026;Chen 等,2026)。
- Cluster-Mismatched (CM) Overlap:使用相同的内存策略,但其 SM 分配并不都支持 cluster 大小为 8。
- Adaptive-NUMA (AN) Overlap:分配支持 cluster 大小为 8 的 SM 并应用上述 NUMA 感知 MIG 放置。
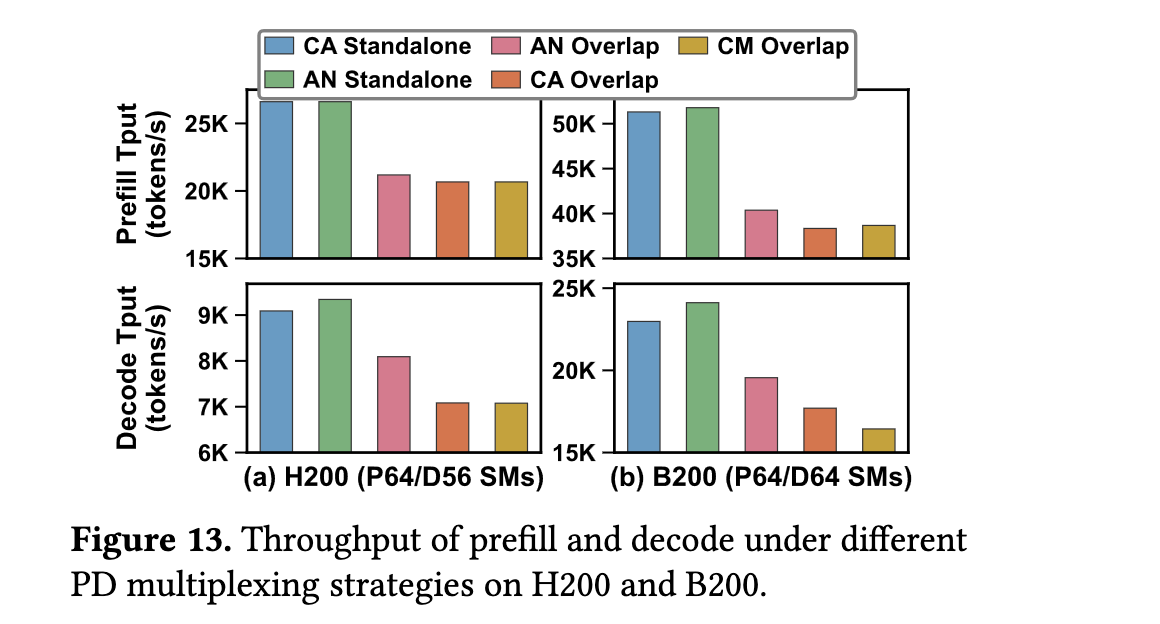
图 13. H200 和 B200 上不同 PD 多路复用策略下 prefill 和 decode 的吞吐量。
图 13 展示了所有结果。如图所示,CA Standalone 和 AN Standalone 显示相似的吞吐量,表明在此配置中跨 MIG 实现本身没有明显的吞吐量开销。AN Overlap 在 H200 上将 decode 吞吐量比 CA Overlap 提高 14.3% ,在 B200 上提高 10.4% 。这些收益来自保持任务私有访问本地,将跨 NUMA 流量限制在共享数据上。Prefill 收益很小,因为它是计算受限的。CM Overlap 在 B200 上将 decode 吞吐量比 CA Overlap 降低 18.9%,而两者在 H200 上表现相似。大多数 H200 内核以 cluster 大小 2 启动,因此 SM 拓扑影响有限。在 B200 上,decode 内核以 cluster 大小 8 比以 cluster 大小 2 表现更好,使得 cluster 兼容的 SM 放置变得重要。
7.3 应用间共置:拓扑感知隔离与公平性
在此场景中,我们研究计算级不对称性与 Thread Block Cluster 之间的相互作用如何影响共置租户。
在细粒度多租户中,计算分区可以以比物理内存分区更细的粒度进行,因此调度器不能总是将每个租户的 SM 分配与不同的 NUMA 分区对齐。主导的调度问题因此转向 floorsweeping 引起的 SM 异质性、cluster 资格和分配公平性。拓扑感知计算分配成为核心。
相等大小的逻辑分区可以提供 substantially 不同的物理能力。Thread Block Cluster 在 Hopper 架构中引入,被 CUTLASS(NVIDIA,2025a)等生产库广泛采用以加速 GEMM 等内核。我们提取 cluster 大小为 2、4 和 8 的 CUTLASS GEMM 内核,并将每个与需要最小 cluster 大小为 2 的基线 GEMM 内核共置。我们将两个共置应用记为 A 和 B。B 使用 cluster 大小 2,而 A 使用 cluster 大小 2、4 或 8。
在 H200 上,每个应用至少需要 64 个 SM;在 B200 上,至少 72 个 SM。我们使用 Green Contexts 与 MPS 通过连续分配获得两个 SM 集。在一个共置测试中,A 运行在第一个集上,B 运行在第二个集上。在另一个中,A 运行在第二个集上,B 运行在第一个集上。
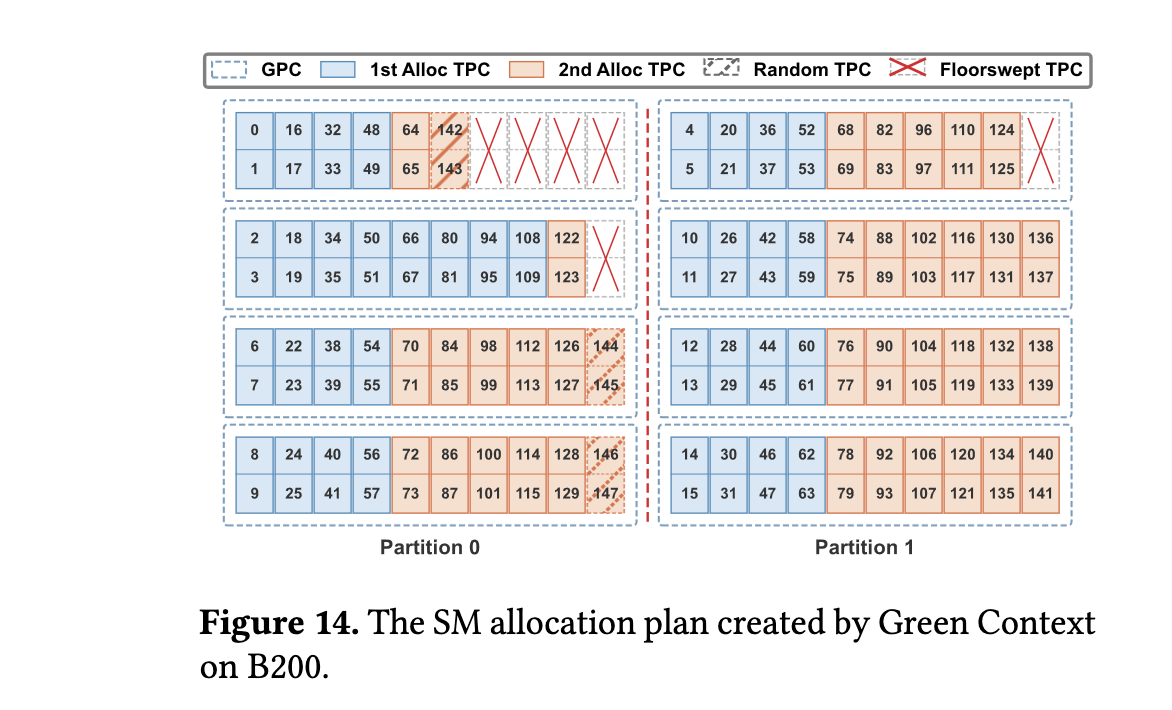
图 14. B200 上 Green Context 创建的 SM 分配计划。
图 14 显示了 B200 上产生的 SM 分配示例。SM 分配给第一个应用的标记为蓝色,而分配给第二个应用的标记为橙色。首先,所有随机 SM 被分配给第二个应用,不能用于 Thread Block Cluster。其次,在 B200 的完整 GPC 内,A 的分配顺序也会导致不同的结果。
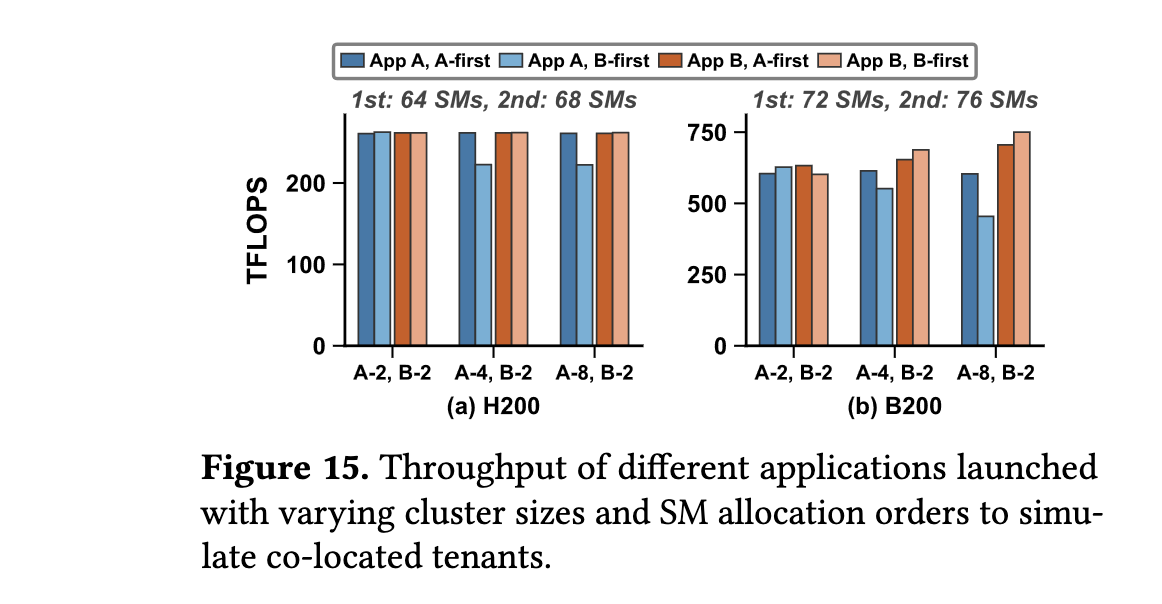
图 15. 不同应用在 H200 和 B200 上使用不同 cluster 大小和 SM 分配顺序启动的吞吐量,以模拟共置租户。
图 15 显示了两种情况下两个应用的吞吐量。当它们使用 cluster 大小 2 时,两种情况产生几乎相同的吞吐量。对于更大的 cluster 大小,A 在运行在第一个 SM 集上的情况下实现更高的吞吐量。相对于另一种情况,cluster 大小 4 时加速比为 H200 上 1.18× 、B200 上 1.11× 。cluster 大小 8 时,加速比为 H200 上 1.18× 、B200 上 1.33×。
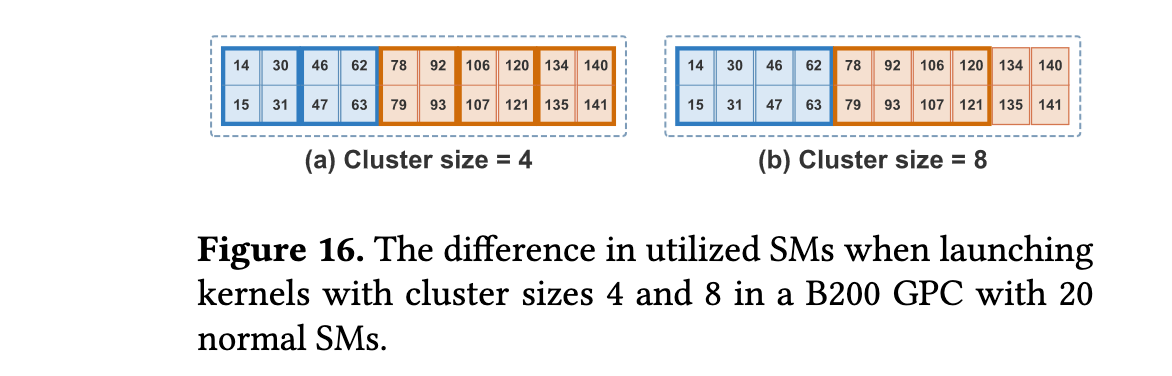
图 16. 在具有 20 个正常 SM 的 B200 GPC 中,使用 cluster 大小 4 和 8 启动内核时利用的 SM 差异。
这一差距源于计算不对称性。当 A 被第二个分配时,它接收无法形成有效 cluster 的随机 SM,因此在执行期间保持空闲。由于 GPC 组成,这种效应在 B200 上使用 cluster 大小 8 时更严重。如图 16 所示,每个 B200 GPC 有 20 个正常 SM。当使用 cluster 大小 4 时,所有 20 个正常 SM 都被利用。当使用 cluster 大小 8 时,只有 16 个正常 SM 被利用,因为 20 不能被 8 整除,留下 4 个 SM 空闲。
7.4 未来细粒度调度的经验教训
7.4.1 全 GPU 内核
对于全 GPU 内核,NUMA 感知数据放置可以显著提升性能,特别是当内核具有大的内存工作集时。然而,收益取决于内核的局部性和 NUMA 感知的实现开销。未来的内核库应提供 NUMA 感知内存分配 API,使内核开发者能够轻松优化数据放置。
7.4.2 应用内多路复用
对于应用内多路复用,关键洞察是将任务私有状态保持本地,同时允许共享数据跨分区访问。这需要一个灵活的内存分配策略,能够区分私有和共享数据。未来的 LLM 服务系统应集成 NUMA 感知放置,以最大化多路复用收益。
7.4.3 应用间共置
对于应用间共置,拓扑感知 SM 分配对于公平性和性能隔离至关重要。调度器应不仅考虑 SM 数量,还应考虑 cluster 资格和 GPC 拓扑。未来的 GPU 虚拟化方案应暴露拓扑信息,使调度器能够做出明智的决策。
8. 讨论
8.1 非 NVIDIA GPU 中的不对称性
我们的特征化方法也适用于非 NVIDIA GPU,例如同样使用芯片扩展来提升性能的 AMD GPU。我们在 AMD MI300X 上进行了初步实验。
MI300X 有 8 个 XCD(XCD 是 AMD 的计算 die),分为 4 个 IOD(IO Die)对。我们通过相关性分析将 XCD 分组为地址依赖延迟模式相似的对,识别出四对:{0,1}、{2,3}、{4,5}、{6,7}。对于每个地址,我们推断其 home group 为具有最低平均访问延迟的对。每个组约占采样地址的 25%。这种四对结构与图 19 中的每个 AID 两个 XCD 组织一致。
从 XCD 0 来看,分配到其自身组的地址形成 Local 系列。两个具有中间平均延迟的远程组形成 Adjacent 系列,而具有最高平均延迟的组形成 Opposite 系列。这些名称表示推断的局部性类别,而非测量的 fabric 跳数。
测量因此揭示了 MI300X 上的四个内存亲和性组和三个访问延迟层级。与 H200 和 B200 中的两级(本地/远程)设计一起,它们表明基于延迟的探测可以揭示不同 GPU 内存组织中的计算-内存亲和性。
8.2 对硬件模拟器的影响
如先前的硬件架构特征化工作(Arunkumar 等,2021)一样,我们的发现也可以提高 GPU 架构模拟器的准确性。大多数模拟器假设统一的 SM 拓扑和对称的内存访问。纳入 floorsweeping 和 NUMA 效应可以使模拟器更好地反映真实硬件行为,特别是在多租户和多路复用场景中。
9. 结论
本文揭示了现代 GPU 中隐藏的物理不对称性,包括由 floorsweeping 引起的计算拓扑不对称性和由缓存/内存分区引起的 NUMA 内存不对称性。我们开发了轻量化的每芯片特征化方法来发现这些不对称性,并将三种细粒度调度场景(全 GPU 内核执行、应用内多路复用和应用间共置)改造为非对称感知。实验结果表明,非对称感知调度显著提升了性能,并避免了由隐藏不对称性引起的性能波动。随着 GPU 继续扩展,软件必须意识到物理不对称性以实现最佳性能。
参考文献
1 Ted Zadouri, Markus Hoehnerbach, Jay Shah, Timmy Liu, Vijay Thakkar, and Tri Dao. FlashAttention-4: Algorithm and kernel pipelining co-design for asymmetric hardware. In IEEE International Parallel and Distributed Processing Symposium (IPDPS), 2026.
2 Zhe Ye, Lingming Chen, Rongjian Lai, Weiran Lin, Yifan Zhang, Stephan Wang, Tianqi Chen, Baris Kasikci, Vinod Grover, Arvind Krishnamurthy, and Luis Ceze. FlashAttention-2: Faster Attention with Better Parallelism and Work Partitioning. In International Conference on Learning Representations (ICLR), 2024.
3 NVIDIA. vLLM. https://github.com/vllm-project/vllm, 2025. Accessed: 2026-03-29.
4 Yukang Chen, Weihao Cui, Han Zhao, Ziyi Xu, Xiaoze Fan, Xusheng Chen, Yangjie Zhou, Shixuan Sun, Bingsheng He, and Quan Chen. Towards high-goodput LLM serving with prefill-decode multiplexing. In arXiv preprint arXiv:2506.13085, 2026.
5 NVIDIA. Multi-Process Service (MPS). https://docs.nvidia.com/deploy/mps, 2025. Accessed: 2026-03-29.
6 NVIDIA. Green Contexts. https://developer.nvidia.com/green-contexts, 2025. Accessed: 2026-03-29.
7 NVIDIA. Multi-Instance GPU (MIG) user guide. https://docs.nvidia.com/datacenter/tesla/mig-user-guide, 2025. Accessed: 2026-03-29.
8 Weihao Cui, Han Zhao, Quan Chen, Ningxin Zheng, Jieru Zhao, Yiming Lei, Jingwen Leng, Jingyi Zhang, Fan Yang, Xiaoyao Liang, and Minyi Guo. Enable simultaneous DNN services based on deterministic operator overlap and precise latency prediction. In ACM/IEEE International Symposium on Computer Architecture (ISCA), 2022.
9 Weihao Cui, Han Zhao, Quan Chen, Shiyi Zheng, Chao Yang, Ziqi Zhang, and Minyi Guo. Exploiting inter-sm scheduling to improve GPU performance. In IEEE Transactions on Computers, 72(5):1473--1487, 2022.
10 NVIDIA. Thread block clusters --- CUDA Hopper tuning guide. https://docs.nvidia.com/cuda/hopper-tuning-guide, 2025. Accessed: 2026-04-02.
11 Zhe Jia, Marco Maggioni, Jeffrey Smith, and Daniele Paolo Scarpazza. Dissecting the NVIDIA Volta GPU architecture via microbenchmarking. In IEEE International Symposium on Performance Analysis of Systems and Software (ISPASS), 2019.
12 Akshitha Sriraman and Thomas F. Wenisch. μSuite: A benchmark suite for microservices. In IEEE International Symposium on Workload Characterization (IISWC), 2018.
13 Shuangchen Li, Xuanchang Zhang, Zhiyuan Gu, Yang Li, Yuan Xie, and Cong Xu. Firefly: A fast and accurate algorithm for finding GPU-friendly Bloom filters. In ACM/IEEE International Symposium on Computer Architecture (ISCA), 2021.
14 Weihao Cui, Han Zhao, Quan Chen, Ningxin Zheng, Jieru Zhao, Yiming Lei, Jingwen Leng, Jingyi Zhang, Fan Yang, Xiaoyao Liang, and Minyi Guo. Enable simultaneous DNN services based on deterministic operator overlap and precise latency prediction. In ACM/IEEE International Symposium on Computer Architecture (ISCA), 2022.
15 NVIDIA. Tesla V100 GPU architecture. https://www.nvidia.com/en-us/data-center/volta-gpu-architecture/, 2017. Accessed: 2026-03-29.
16 NVIDIA. NVIDIA A100 tensor core GPU architecture. https://www.nvidia.com/en-us/data-center/a100/, 2020. Accessed: 2026-03-29.
17 NVIDIA. NVIDIA H100 tensor core GPU architecture. https://www.nvidia.com/en-us/data-center/h100/, 2022. Accessed: 2026-03-29.
18 NVIDIA. NVIDIA Blackwell architecture. https://www.nvidia.com/en-us/data-center/blackwell-architecture/, 2024. Accessed: 2026-03-29.
19 Shuangchen Li, Xuanchang Zhang, Zhiyuan Gu, Yang Li, Yuan Xie, and Cong Xu. Firefly: A fast and accurate algorithm for finding GPU-friendly Bloom filters. In ACM/IEEE International Symposium on Computer Architecture (ISCA), 2021.
20 NVIDIA. Thread block clusters. https://docs.nvidia.com/cuda/hopper-tuning-guide/index.html#thread-block-clusters, 2025. Accessed: 2026-04-02.
21 NVIDIA. Multi-Instance GPU user guide. https://docs.nvidia.com/datacenter/tesla/mig-user-guide, 2025. Accessed: 2026-03-29.
22 Weihao Cui, Han Zhao, Quan Chen, Shiyi Zheng, Chao Yang, Ziqi Zhang, and Minyi Guo. Exploiting inter-sm scheduling to improve GPU performance. In IEEE Transactions on Computers, 72(5):1473--1487, 2022.
23 Jinkyu Jeong, Hwansoo Han, and Soontae Kim. Understanding GPU memory hierarchy through microbenchmarking. In IEEE Transactions on Parallel and Distributed Systems, 2016.
24 Zhe Jia, Marco Maggioni, Jeffrey Smith, and Daniele Paolo Scarpazza. Dissecting the NVIDIA Volta GPU architecture via microbenchmarking. In IEEE International Symposium on Performance Analysis of Systems and Software (ISPASS), 2019.
25 Weihao Cui, Han Zhao, Quan Chen, Ningxin Zheng, Jieru Zhao, Yiming Lei, Jingwen Leng, Jingyi Zhang, Fan Yang, Xiaoyao Liang, and Minyi Guo. Enable simultaneous DNN services based on deterministic operator overlap and precise latency prediction. In ACM/IEEE International Symposium on Computer Architecture (ISCA), 2022.
26 NVIDIA. CUTLASS: CUDA templates for linear algebra subroutines. https://github.com/NVIDIA/cutlass, 2025. Accessed: 2026-03-29.
27 NVIDIA. CUDA C++ programming guide. https://docs.nvidia.com/cuda/cuda-c-programming-guide, 2025. Accessed: 2026-03-29.
28 NVIDIA. CUDA virtual memory management. https://docs.nvidia.com/cuda/cuda-driver-api/group__CUDA__VA.html, 2025. Accessed: 2026-03-29.
29 NVIDIA. H200 tensor core GPU. https://www.nvidia.com/en-us/data-center/h200/, 2024. Accessed: 2026-03-29.
30 NVIDIA. B200 tensor core GPU. https://www.nvidia.com/en-us/data-center/b200/, 2024. Accessed: 2026-03-29.
31 AMD. ROCm documentation. https://rocm.docs.amd.com, 2025. Accessed: 2026-03-29.
32 AMD. GPU partitioning. AMD SMI documentation. Accessed: September 9, 2026.
33 Akshitha Sriraman and Thomas F. Wenisch. μSuite: A benchmark suite for microservices. In IEEE International Symposium on Workload Characterization (IISWC), 2018.
34 RRZE-HPC. likwid-bench. https://github.com/RRZE-HPC/likwid, 2024. Accessed: 2026-03-29.
35 sgl-project. Mini-SGLang. https://github.com/sgl-project/sglang, 2026. Accessed: 2026-03-29.
36 Arunkumar Arunkumar, Yasuko Eckert, and Gabriel H. Loh. Firefly: A fast and accurate algorithm for finding GPU-friendly Bloom filters. In ACM/IEEE International Symposium on Computer Architecture (ISCA), 2021.
37 NVIDIA. CUDA runtime API. https://docs.nvidia.com/cuda/cuda-runtime-api, 2025. Accessed: 2026-03-29.
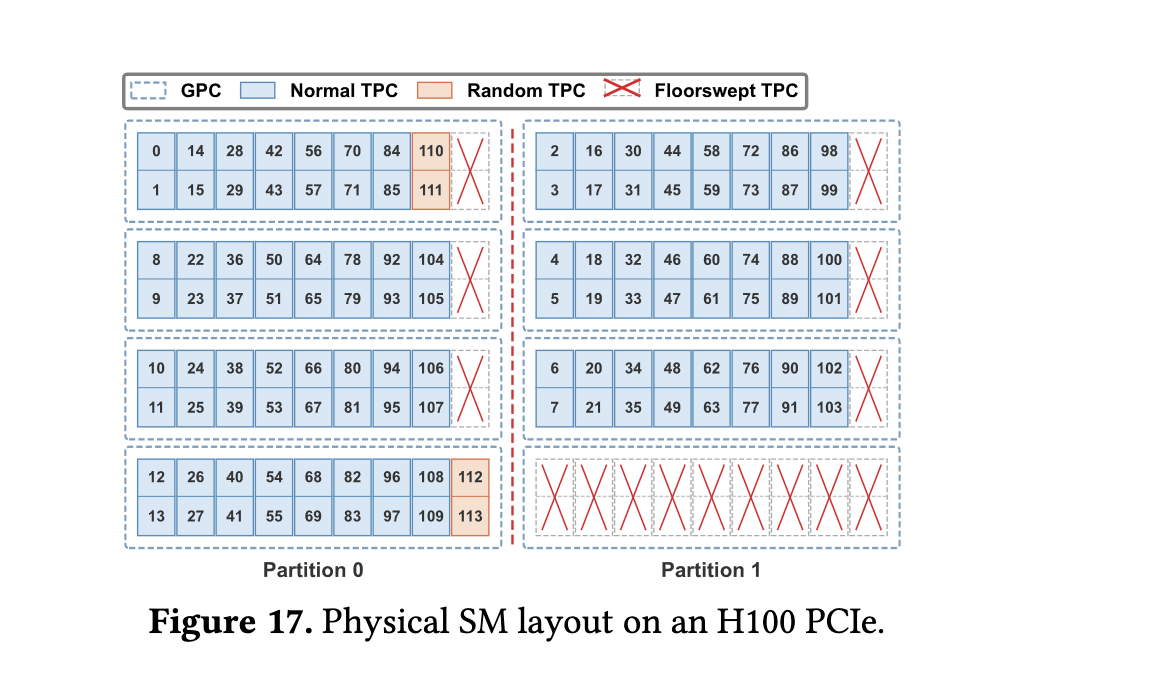
附录
A. H100 PCIe 上的 SM 拓扑
图 17 显示了 H100 PCIe 上的物理 SM 布局。与 H200 类似,H100 PCIe 也有 8 个 GPC,每个 GPC 有 9 个 TPC。Floorsweeping 导致每个 GPC 的 SM 数量不同,产生芯片特定的拓扑。
B. GreenContext 中的模式
Green Context 可以配置为两种模式:GPC 对齐和非 GPC 对齐。在 GPC 对齐模式下,Green Context 确保每个上下文的 SM 分配与 GPC 边界对齐。在非 GPC 对齐模式下,SM 可以跨 GPC 分配,可能导致 cluster 性能下降。
C. 内核实现细节
C.1 HBM 访问延迟
我们使用指针追踪基准测试测量 HBM 访问延迟。链表节点的大小为 64 字节(一个缓存行),节点间距通过 XOR 随机化来防止硬件预取器预测访问模式。每个线程执行以下循环:
cuda
for (int i = 0; i < iterations; i++) {
    ptr = *ptr;
}
我们使用 clock64() 在循环前后记录时间戳,并计算每个内存访问的平均周期数。
C.2 L2 缓存访问延迟
为了测量 L2 缓存访问延迟,我们使用一个大小为 16 MB 的缓冲区,该大小超过 L1 缓存(256 KB)但远小于单个 L2 分区(64 MB)。这确保所有访问都命中 L2 缓存。
D. 总结的内存层次结构
图 18 显示了现代 GPU 的内存层次结构布局。L2 缓存被物理划分为内存亲和性分区,由专用内存控制器和 HBM 堆栈支持。
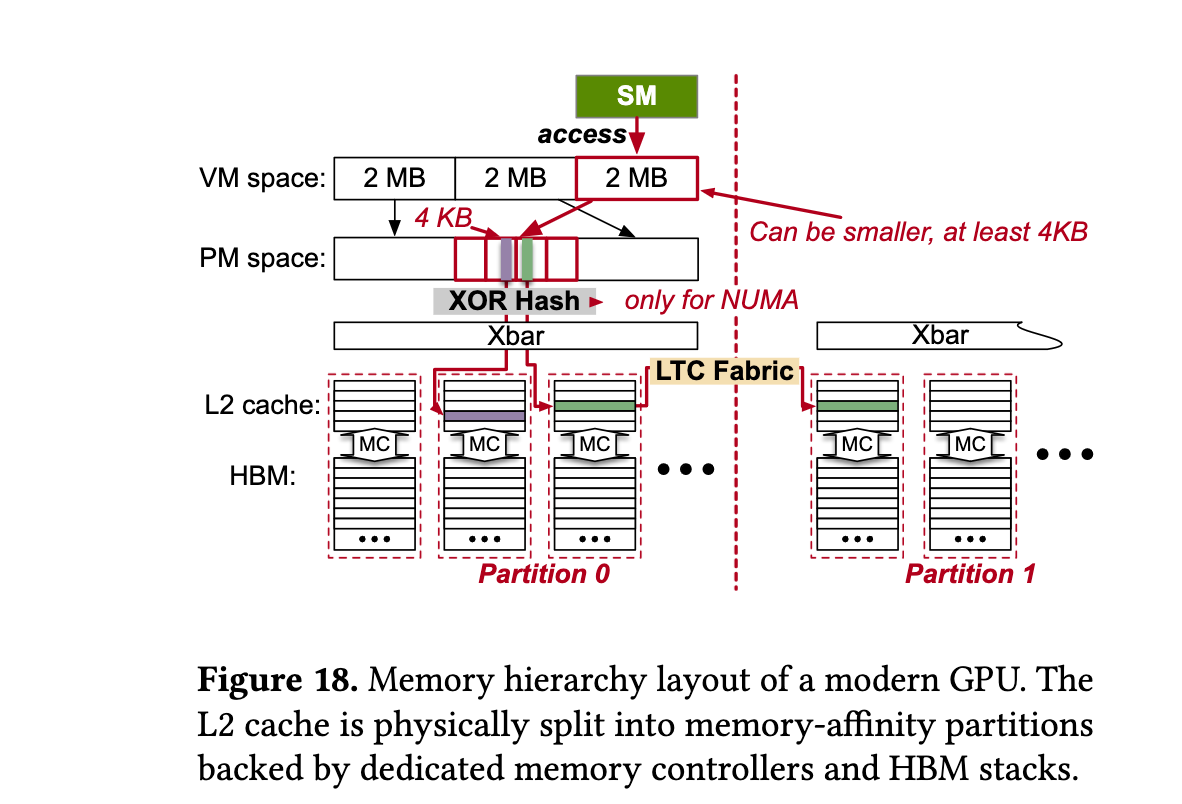
图 18. 现代 GPU 的内存层次结构布局。L2 缓存被物理划分为由 LTC fabric 连接的内存亲和性分区。
E. NUMA 感知地址重映射
§7.1.1 中的地址重映射方法提供分区本地内存访问,同时保留大页映射以限制转换后备缓冲区(TLB)压力。4 KB NUMA 交错粒度独立于地址转换使用的页大小。
我们最初的尝试修改 GPU 驱动程序以使用 4 KB 页大小进行 NUMA 感知分配。NVIDIA GPU 原生支持至少三种页大小:4 KB、64 KB 和 2 MB。默认页大小为 2 MB 以减少 TLB 压力。结果产生的 TLB 压力降低了内存受限内核的性能。
我们改为保留大页映射,并在内核中以 4 KB 粒度重映射地址。遵循 vAttention,我们修改 NVIDIA 驱动程序以分配物理上连续的内存并公开其基物理地址。分区哈希是物理地址位的 XOR(§6.1.2)。在 H200 和 B200 上,哈希掩码包括第 12 位,即 4 KB 物理页号的最低位。对于从偶数物理页号开始的分配,每对中的两个页 (2j, 2j+1) 仅在第 12 位上不同。如图 9 所示,这些页因此哈希到不同的分区,所以每对恰好包含来自每个分区的一页。对于包含完整页对的 S 字节分配,每个分区持有 S/2 字节。
要将逻辑页 j 映射到对 (2j, 2j+1) 中属于目标分区 P 的页,我们计算:
page_phys = 2j + [parity((page_start + 2j) & MASK) ⊕ P]其中 page_start 是分配的起始物理页号,MASK 是 GPU 特定的分区位掩码移位到页粒度,P ∈ {0, 1}。结果 page_phys 是相对于分配起始的页偏移量,页内的字节偏移量保持不变。分区选择使用按位 AND、popcount 奇偶校验和 XOR,提供 O(1) 地址转换而无需查找表。这种映射允许每个 NUMA 分区中的 SM 使用本地页处理总 S 字节工作负载的相应 S/2 部分。
F. 全 GPU 内核实验配置
硬件
图 10 使用 NVIDIA H200 和 B200 设备,分别具有 132 和 148 个 SM。两个 NUMA 分区在 H200 上包含 66/66 个 SM,在 B200 上包含 74/74 个 SM。图 11-(b) 中的拓扑感知实验使用分区中具有 70/78 个 SM 的 B200 设备。
工作负载
对于注意力工作负载,我们将查询和 KV 序列长度分别记为 S_q 和 S_k,以每个请求的 token 数衡量。Prefill 处理 S_q = 128 个查询 token 对抗长度为 S_k 的 KV 序列,而 decode 处理 S_q = 1 个查询 token。
在注意力实验中,batch size B 对于两个阶段范围从 1 到 64。对于每个 batch size,我们将 S_k 从 512 个 token 开始翻倍。注意力图报告以十进制 GB 为单位的逻辑 KV 工作集:
- W_MHA/GQA = 4 * B * S_k * H_kv * D / 10^9
- W_MLA = 2 * B * S_k * (512 + 64) / 10^9
其中 H_kv 是 KV 头数(MHA 为 32,GQA 为 8),D = 128 是两者的头维度。MLA 计算一个压缩的 KV 表示,没有额外的头数或 K/V 复制因子。
对于 GroupGEMM,我们测试 (G, M) = (32, 192)、(6, 1024)、(32, 20)、(6, 20)。每个设置使用四种矩阵形状:(N, K) = (6144, 7168)、(7168, 3072)、(4096, 4096)、(4096, 2048),总共 16 种配置。对于每种配置,我们独立采样每组的实际行数为 M_i = floor(M * U_i),其中 U_i ~ Uniform(0.7, 1.3),i = 1, ..., G。每种配置五个形状种子产生每台 GPU 80 个实例,单独绘制。GroupGEMM 图报告输入和输出矩阵的逻辑工作集(十进制 GB):
- W_GEMM = 2 * (Σ_i M_i)(K + N) + G \* N \* K / 10^9
对于图 11-(a) 中的 H200 PC 采样比较,我们使用 B = 64、S_q = 128、S_k = 65,536 的 MHA prefill,以及 G = 32、M = 192、N = K = 4096 的 GroupGEMM。
分析设置
我们使用 NVIDIA Nsight Compute (NCU) 收集硬件计数器和 PC 采样。为了检查主文中讨论的 H200 上的地址重映射开销,我们使用 PC 采样比较图 11-(a) 中的原始内核和 NUMA 感知内核。该图报告 Selected 状态下的样本比例,表明 warp 发射了指令。地址重映射增加了算术和按位操作,可以增加 warp 发射指令而非等待内存的样本比例。Selected 份额对 GroupGEMM 从 25.96% 增加到 35.04%,而对 MHA 从 13.92% 增加到 14.71%,支持地址重映射为 GroupGEMM 增加的负担大于 MHA 的结论。
G. AMD GPU 结果
内存组织
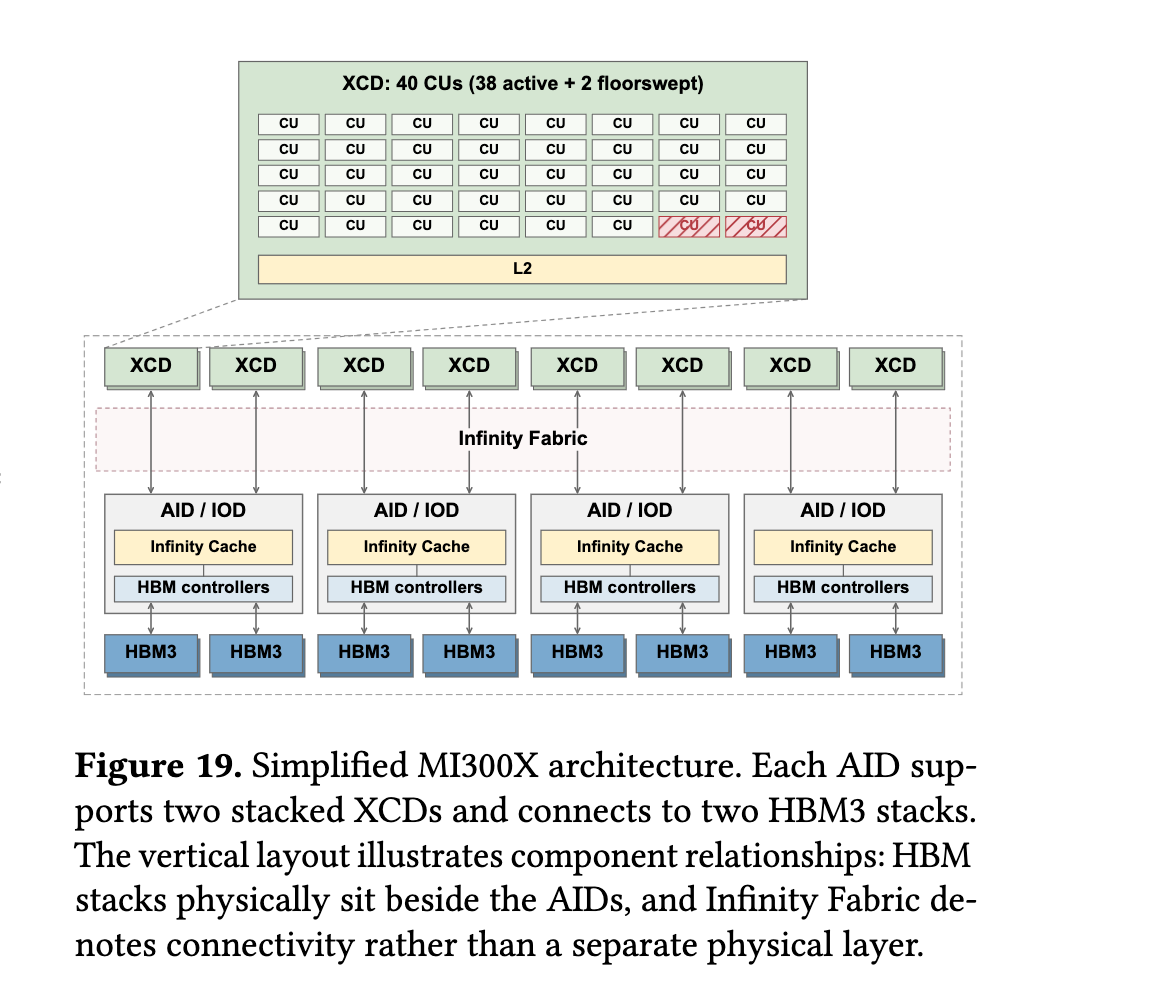
图 19 显示了 AMD MI300X 的内存组织。MI300X 有 8 个 XCD,分为 4 个 AID(Active Interposer Die)。每个 AID 有两个 XCD 和一组 HBM 控制器。
访问延迟分布
图 20 显示了从 XCD 0 出发的 HBM 访问延迟分布。我们观察到三个不同的延迟层级,平均延迟分别约为 707、817 和 926 周期。
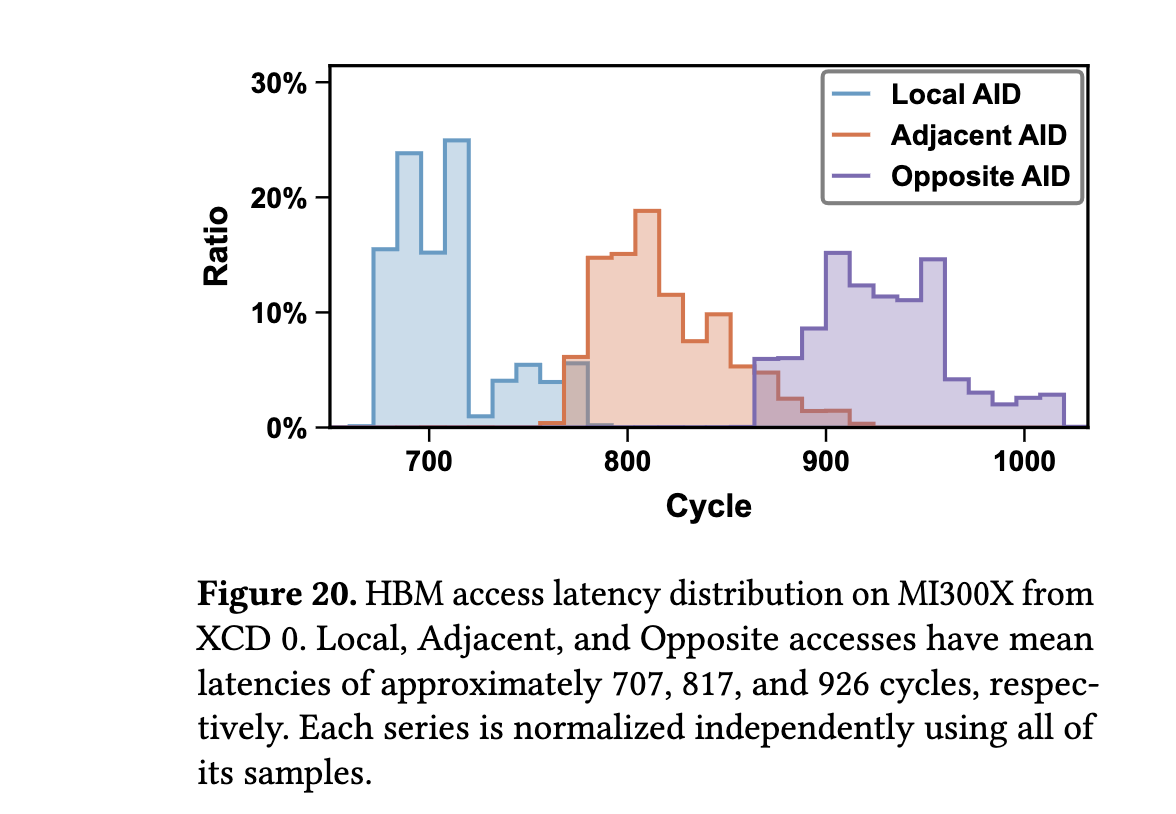
图 20. MI300X 上从 XCD 0 出发的 HBM 访问延迟分布。Local、Adjacent 和 Opposite 访问的平均延迟分别约为 707、817 和 926 周期。每个系列使用其所有样本独立归一化。
这些层级之间的差距表明内存访问延迟取决于请求 XCD 与目标地址之间的亲和性。H200 和 B200 在 §6.1.1 中表现出两个主要的本地和远程延迟层级。在 MI300X 上,远程访问进一步分离为两个层级,分别比本地平均值高约 110 和 219 周期。
XCD-to-内存亲和性
如 §6.1.1 中的 SM 级探测揭示 SM-to-partition 亲和性,从不同 XCD 探测相同地址揭示了 MI300X 上的 XCD-to-内存亲和性。我们通过地址依赖延迟模式的相关性将 XCD 分组,识别出四对:{0,1}、{2,3}、{4,5}、{6,7}。
对于每个地址,我们推断其 home group 为具有最低平均访问延迟的对。每个组约占采样地址的 25%。这种四对结构与图 19 中的每个 AID 两个 XCD 组织一致。
从 XCD 0 来看,分配到其自身组的地址形成 Local 系列。两个具有中间平均延迟的远程组形成 Adjacent 系列,而具有最高平均延迟的组形成 Opposite 系列。这些名称表示推断的局部性类别,而非测量的 fabric 跳数。
测量因此揭示了 MI300X 上的四个内存亲和性组和三个访问延迟层级。与 H200 和 B200 中的两级(本地/远程)设计一起,它们表明基于延迟的探测可以揭示不同 GPU 内存组织中的计算-内存亲和性。
致谢
我们感谢 NVIDIA 的 Yuxian Qiu 在本文撰写过程中提供的有益讨论和技术支持。我们还要感谢审稿人的宝贵反馈。本工作得到国家自然科学基金(No. 62272300、No. 62090034)和上海市科技创新行动计划(No. 22511105602)的支持。
剖析芯片扩展如何破坏 GPU 细粒度调度
摘要
现代 GPU 在物理上已不再对称。芯片扩展导致了制造驱动的 floorsweeping(缺陷屏蔽)以及缓存和内存分区。前者产生了芯片特定的计算拓扑结构,而后者导致了非均匀内存访问(NUMA)。这些不对称性是显著的:忽略拓扑的计算单元分配可导致高达 1.33× 的性能波动,而远程访问使 HBM 延迟增加高达 67% 、L2 延迟几乎翻倍。然而,这些不对称性被隐藏在 GPU 的逻辑资源抽象背后,并且可能因芯片而异。我们开发了轻量化的特征化方法,以揭示每块芯片的计算拓扑和内存亲和性。然后,我们利用发现的信息使现有细粒度调度具备非对称感知能力,不仅考虑分配多少资源,还考虑分配哪些物理资源。在全 GPU 内核执行、应用内多路复用和应用间共置等场景中,非对称感知调度将主流内核性能提升高达 1.22× ,多路复用 LLM 推理提升高达 14.3% ,并避免了高达 1.33× 的性能波动。
1. 引言
现代 GPU 集成了大量并行资源。高效利用这些资源需要在多个层次上进行细粒度调度。内核库在计算单元之间调度工作以接近硬件性能极限(Zadouri 等,2026;Ye 等,2025)。在应用内部,近期的 LLM 服务系统空间多路复用 prefill 和 decode 阶段以提高 goodput(NVIDIA,2025b;Chen 等,2026)。跨应用而言,云系统将来自不同租户的内核共置到同一 GPU 上,并控制每个租户的计算和内存分配(NVIDIA,2025d;Wu 等,2015;Zhang 等,2025;Coppock 等,2025;Ng 等,2023;Zhao 等,2025)。
现有的细粒度调度工作(Zadouri 等,2026;Ye 等,2025;NVIDIA,2025b;Chen 等,2026;Wu 等,2015;Coppock 等,2025;Ng 等,2023;Zhao 等,2025)通常通过控制逻辑资源数量来运作。例如,它们控制任务使用多少计算单元以及访问多少内存。这些工作忽略了计算单元和内存的物理位置。它隐含假设架构是对称的------即具有相同计算单元数量和相同内存容量的分配提供等效的性能。
芯片扩展引入了不对称性,通过增大芯片面积(Jin 等,2024)和缩小工艺节点(7 nm→3 nm)(Sharma 等,2022)来增加每片芯片的晶体管数量。图 1 展示了一个现代 NVIDIA GPU 芯片的微架构,而表 1 进一步总结了跨越四代 NVIDIA 数据中心 GPU 的五个 SKU。从 Volta 到 Blackwell,完整芯片的 SM 数量从 84 增长到 160,L2 缓存从 6 MB 增长到 126 MB,HBM 堆栈从 4 个增长到 8 个。
图 1. NVIDIA H200 GPU 的架构。流式多处理器(SM)被分组为纹理处理集群(TPC),TPC 进一步组成图形处理集群(GPC)。每个 SM 具有私有的 L1 数据缓存和共享内存,所有 SM 共享通过 LTC fabric 连接的物理分区 L2 缓存。Floorsweeping 在每个 GPC 内禁用选定的 TPC,因此 SM 到 GPC 的映射是芯片特定的。
首先,floorsweeping 禁用有缺陷的流式多处理器(SM,NVIDIA GPU 的基本计算单元)以提高良率,从而产生芯片特定的计算拓扑。其次,更大的 L2 缓存被分区以获得高带宽和低延迟。这些分区及其关联的 HBM 形成了具有不同本地和远程访问开销的非均匀内存访问(NUMA)拓扑。
这些不对称性具有显著的性能后果。Floorsweeping 产生计算不对称性。在 NVIDIA H200 或 B200 上,两个 GPC 之间 SM 数量差异可高达 10 个。远程 HBM 访问比本地访问产生约 34% 的更高延迟(H200 上 490→655 周期),在 B200 上高达 67% (552→920 周期)。远程 L2 延迟在 H200 上比本地延迟高约 51% (309→466 周期),在 B200 上几乎翻倍(364→725 周期)。正如我们稍后在第 7 节中所示,忽略这些差异可能导致高达 1.33× 的性能波动。
本文解决了这种隐藏物理不对称性带来的两个挑战。
C-1: 软件如何高效地发现隐藏的、芯片特定的计算和内存不对称性,而无需架构文档?厂商暴露的是逻辑而非物理 SM 拓扑,floorsweeping 在同一 SKU 的不同芯片之间有所不同,NUMA 映射编码在未经文档记录的物理地址哈希中,并且不同架构使用不同的映射。因此,不对称性通常需要每芯片校准,而非在同一 SKU 的所有芯片之间共享的静态查找表。
C-2: 现有细粒度调度应如何利用发现的物理不对称性?现有调度工作仅确定资源数量。非对称感知增加了一个补充维度,即考虑物理资源身份、拓扑结构和计算-内存亲和性。目标不是取代细粒度调度,而是通过不仅考虑分配多少资源,还考虑分配哪些物理资源,使其更加精确。
为了解决第一个挑战,我们为计算和内存不对称性开发了轻量级特征化方法。对于计算不对称性,我们使用两种探测技术揭示完整的每芯片 SM-to-GPC 分配。我们观察到两组逻辑 SM ID。正常 SM 遵循架构特定的预定义 SM-to-GPC 映射,而剩余的 SM 根据芯片特定的 floorsweeping 结果分配到物理 GPC。为方便起见,我们将后者称为随机 SM。"随机"并不意味着运行时随机调度,而是由于 floorsweeping,它们的物理 GPC 位置可能因芯片而异。对于内存不对称性,我们开发了一种延迟层次发现方法,揭示被测 GPU 上的内存分区哈希和 HBM 交错粒度。利用发现的哈希,我们表征了本地/远程延迟差距、远程带宽瓶颈,以及跨分区缓存复制导致的有效 L2 容量损失。
为了解决第二个挑战,我们为三种代表性的细粒度调度场景构建了非对称感知原型。对于全 GPU 内核,我们开发了两种将内存访问导向 NUMA 本地分区的方法。将这些方法与主流 GPU 内核集成,以极小的代码改动将吞吐量提升高达 1.22× 。对于应用内多路复用,我们为空间多路复用 prefill 和 decode 阶段的 LLM 服务系统开发了一种对内核透明的跨 NUMA 分配方法。通过将任务私有分配限制在 NUMA 本地分区,同时跨分区共享其他分配,将 decode 吞吐量提升高达 14.3% 。对于应用间共置,我们评估了拓扑感知 SM 分配策略,并证明相等的 SM 数量并不意味着相等的物理能力。忽略拓扑的分配导致高达 1.33× 的吞吐量波动。
我们将开源我们的代码以支持所有结果的重现。本文的主要贡献如下:
• 我们开发了轻量级方法来揭示隐藏的、芯片特定的 GPU 计算和内存不对称性,包括 SM-to-GPC 映射、依赖于 floorsweeping 的拓扑、NUMA 分区哈希,以及本地/远程延迟和带宽行为。
• 我们展示了细粒度调度如何整合物理资源身份、拓扑和内存亲和性,而非仅依赖逻辑资源计数。
• 我们在三个层次上验证了非对称感知调度。这些结果激励将非对称感知作为未来 GPU 编程的设计原则。
2. 背景
大语言模型等工作负载(Grattafiori 等,2024;Jiang 等,2024)需要越来越高的计算吞吐量和内存带宽,推动了激进的 GPU 芯片扩展。图 1 展示了一个现代 GPU 芯片的微架构,而表 1 进一步总结了跨越四代 NVIDIA 数据中心 GPU 的五个 SKU。从 Volta 到 Blackwell,完整芯片的 SM 数量从 84 增长到 160,L2 缓存从 6 MB 增长到 126 MB,HBM 堆栈从 4 个增长到 8 个。
计算。 如图 1 所示,GPU 计算按层次组织(GPU - GPC - TPC - SM)。随着芯片增长,有缺陷的 SM 必须被禁用以维持制造良率,这一过程称为 floorsweeping。完整 GH100 芯片包含 8 个 GPC,每个 GPC 有 9 个 TPC。Floorsweeping 永久禁用每个 GPC 中选定的 TPC,使 H200 在 8 个 GPC 中剩余 132 个 SM。哪些 TPC 被禁用取决于每颗芯片的制造缺陷。Floorsweeping 之后,幸存的 TPC 被重新编号为连续的逻辑 SM ID 空间,使得逻辑到物理的映射对软件来说是芯片特定的且不透明的。
| SKU | V100 | A100 | H100 | H200 | B200 |
|---|---|---|---|---|---|
| Die | GV100 15 | GA100 16 | GH100 17 | GB100×2 18 | |
| Die (mm²) | 815 | 826 | 814 | 800×2 | |
| Full SMs | 84 | 128 | 144 | 80×2 | |
| SKU SMs | 80 | 108 | 114 | 132 | 148 |
| Disabled SMs | 4 | 20 | 30 | 12 | 12 |
| GPCs | 6 | 7 | 7/8 | 8 | 4×2 |
| TPCs/GPC | 7 | 8 | 9 | 10 | |
| L2 (MB) | 6 | 40 | 50 | 60 | 126 |
| L2 partitions | 1 | 2 | 2 | 2 | 2 |
| HBM type | HBM2 | HBM2e | HBM2e | HBM3e | HBM3e |
| HBM (GB) | 32 | 80 | 80 | 141 | 90×2 |
表 1. 跨代的 GPU 芯片规格。H100 有 SXM 和 PCIe 两种变体;此表列出 PCIe SKU。H100 PCIe 和 H200 共享 GH100 芯片,但启用的资源不同。B200 融合了两个 GB100 chiplet;标记 ×2 的值为每 chiplet 数量,未标记的值为封装总量。
内存。 在内存方面,每个 SM 有一个私有的 L1 数据缓存,所有 SM 共享一个由片外 HBM 堆栈支持的末级 L2 缓存。SM 通过 crossbar(Xbar,见图 1)与 L2 通信。从 Ampere 开始,L2 增长到 40 MB 并被物理划分为多个物理分区。本文研究的 NVIDIA GPU 每个 GPU 暴露两个内存亲和性分区。LTC fabric 将这些分区连接起来,向软件呈现统一的地址空间。更新的 Blackwell GPU(如 B200)将两个 chiplet 集成到单个 GPU 中。官方文档描述每个 chiplet 有一个 L2 分区,两个分区通过 LTC fabric 连接。每个 chiplet 内部的 L2 是否进一步分区仍然未知。
3. 相关工作
GPU 的细粒度调度。 现有工作在多个粒度上实现细粒度调度。在单个内核内,持久线程块(Wu 等,2015;Zhao 等,2022;Coppock 等,2025)允许用户将线程块固定到特定 SM。Thread Block Cluster(NVIDIA,2025e)是 Hopper 架构中引入的调度特性,进一步利用这一点进行加速。对于多任务或共置应用,多个系统(Wu 等,2015;Zhao 等,2022;Coppock 等,2025)通过控制 SM 数量来调度多路复用内核。所有这些系统控制使用多少 SM,但没有一个考虑分配哪些 SM 或其 NUMA 亲和性。
厂商支持的调度。 NVIDIA 的 MPS(多进程服务)(NVIDIA,2025d)支持静态 SM 分区。Green Contexts(NVIDIA,2025c)提供 SM 级分区,可选 GPC 对齐。MIG(多实例 GPU)(NVIDIA,2025f)提供可与 NUMA 边界对齐的硬件隔离计算和内存分区。MPS 的粗粒度 SM 分区无法利用 GPC 拓扑,Green Contexts 缺乏内存 NUMA 感知,而 MIG 的资源分配粒度太粗,无法支持细粒度内核调度。我们的工作与这些正交:我们揭示了由厂商抽象隐藏的物理不对称性,并展示了现有调度机制如何利用这些信息。
逆向工程调度。 FGPUs(Jain 等,2019)和 SGDRC(Bakita 等,2023)逆向工程物理内存映射并使用着色来减少缓存冲突。它们专注于内存分配优化,但没有考虑 floorsweeping 引起的计算拓扑变化。类似地,mrcGNN(Zhang 等,2022)和 SGDRC 控制资源份额和干扰,但没有纳入芯片特定的 floorsweeping 拓扑或 SM-to-GPC 映射。
GPU 上的 NUMA。 先前的研究(Kim 等,2023)已经观察到 GPU 上的 NUMA 效应。Kim 等(2023)在 AMD MI200 上识别了两种内存亲和性模式,并利用它们进行数据放置。然而,它们的方法依赖于供应商公开的亲和性信息。据我们所知,我们是第一个在 NVIDIA GPU 上揭示隐藏 NUMA 拓扑的人。
GPU 微基准测试。 广泛的 GPU 微基准测试工作(Wong 等,2010;Jia 等,2019;Luo 等,2025)已经表征了缓存和内存层次结构。我们的内存特征化借鉴了指针追踪技术(Wong 等,2010;Jia 等,2019)来测量缓存延迟。我们的贡献在于将这些技术应用于发现隐藏的 NUMA 分区,并利用发现的不对称性来改善调度。
4. 动机
NVIDIA 公布了每个 GPU 产品的 SM 总数、L2 缓存大小和 HBM 容量,但没有披露每芯片的 floorsweeping 模式或计算单元与内存分区之间的映射。没有这些信息,软件无法确定逻辑分配映射到哪些物理资源。
理解这种关系在多个粒度上都很重要。在单个内核级别,线程块在 SM 上共享数据。如果相邻线程块被调度到远程 SM,跨 NUMA 分区的通信可能会成为瓶颈。在应用内多路复用中,不同的阶段(如 LLM 推理中的 prefill 和 decode)共享权重但具有不同的工作集。如果阶段被放置在不同的 NUMA 分区上,共享权重的访问将产生跨分区流量。在应用间共置中,租户共享 GPU,但彼此隔离。如果租户被分配到共享同一 GPC 的 SM,它们将在 L2 Xbar 带宽上产生争用。
NVIDIA 将这些可变的架构特征隐藏在软件之外,以简化运行时和用户级编程模型。然而,正如我们将在下面展示的,这种抽象是有代价的。软件无法优化它不知道存在的东西。
在以下各节中,我们首先表征 floorsweeping 拓扑和 NUMA 亲和性映射。然后我们评估它们对三种代表性调度场景的影响:全 GPU 内核执行、应用内多路复用和应用间共置。
5. 计算不对称性分析
拓扑感知分区放置需要将逻辑 SM ID 映射到物理 GPC。我们通过轻量化的两阶段探测方法揭示完整的映射。
5.1 SM 拓扑发现
5.1.1 第一阶段:Thread Block Cluster 探测
Thread Block Cluster(NVIDIA,2025e)是 Hopper 引入的新 CUDA 特性。它们将内核中的一组线程块共同调度到 GPC 本地 SM 上,实现直接的跨块分布式共享内存访问和 cluster 屏障,而无需经过 L2。在这种情况下,同一 Thread Block Cluster 中的 SM 位于同一 GPC 内。
我们利用这一特性来探测 GPC 布局。通过启动不同大小的 cluster 并记录哪些逻辑 SM ID 共同出现,我们可以推断出哪些 SM 属于同一 GPC。具体来说,我们启动覆盖所有 SM 的 cluster,大小从 2 到 8,并记录每个 cluster 的组成 SM ID(通过 %smid PTX 寄存器获得)。在 cluster 中共同出现的 SM ID 属于同一 GPC。
通过这种方法,我们可以部分揭示 GPU 上 SM 的 GPC 布局。例如,在 H200 上,我们可以 uncover 具有 ID 0--123 的 SM 的 GPC 布局(8 个 GPC 中的 62 个 TPC)。这些 SM 可靠地出现在 cluster 启动中,而 SM ID 124--131(4 个 TPC)在 cluster 大小 >2 时从不出现。
我们观察到两组逻辑 SM ID。通过 cluster 探测识别的 SM 遵循架构特定的预定义 SM-to-GPC 映射。为方便起见,我们称它们为正常 SM 。剩余的 SM 的 GPC 位置由芯片特定的 floorsweeping 结果决定。我们称它们为随机 SM。这里,"随机"并不意味着这些 SM 在运行时被随机调度。相反,由于 floorsweeping,它们的物理 GPC 位置可能因芯片而异。
5.1.2 第二阶段:L2 带宽探测
为了将剩余的随机 SM 分配到 GPC,我们利用了一个观察结果:共享同一 GPC 的 SM 会在该 GPC 的 L2 Xbar 带宽上产生争用(Jin 等,2024)。这意味着同一 GPC 中的 SM 具有比分布在不同 GPC 中的相同数量 SM 更低的 L2 带宽。
为了获得 L2 带宽,我们使用一个内核反复读取大小超过 L1 但适合 L2 的缓冲区,强制所有访问都命中 L2 缓存。
Figure 2. Per-GPC L2 bandwidth on H200 and B200 with
varied SMs. Because each GPC in Hopper has 9 TPCs, and
each GPC in B200 has 10 TPCs, the bandwidth test ends at
18 SMs on H200, and 20 SMs on B200.
图 2. H200 和 B200 上不同 SM 数量下每个 GPC 的 L2 带宽。由于 Hopper 中每个 GPC 有 9 个 TPC,B200 中每个 GPC 有 10 个 TPC,H200 的带宽测试在 18 个 SM 结束,B200 在 20 个 SM 结束。
图 2 显示了 H200 和 B200 上同一 GPC 内和跨不同 GPC 的 SM 的 L2 带宽。如图所示,当 SM 位于不同 GPC 时,L2 带宽随 SM 数量线性增长。然而,对于同一 GPC 内的 SM,这一趋势不成立。当 SM 数量在 H200 上超过 6 个、在 B200 上超过 16 个时,它们的 L2 带宽变得低于不同 GPC 中 SM 的带宽。
利用这一观察,我们可以将随机 SM 分配到具有最低聚合 L2 带宽的 GPC。通过迭代地添加随机 SM 并测量每个可能 GPC 的带宽变化,我们可以确定每个随机 SM 最可能的 GPC 归属。
组合方法在每块 GPU 上运行时间不到 1 分钟,且仅需要标准 GPU 内核。我们通过将发现的映射与 SM 级性能计数器(如 smsp__cycles_active)关联来验证 uncovered 映射,确认 cluster 探测和带宽探测结果一致。
要点 1: 逻辑 SM ID 分为两组。正常 SM 遵循架构特定的预定义 SM-to-GPC 映射。随机 SM 根据芯片特定的 floorsweeping 结果分配到物理 GPC,因此它们的 GPC 位置可能因芯片而异。
5.2 芯片特定的 SM 拓扑
图 3-(a) 显示了特定 H200 和 B200 芯片上完全揭示的 SM-to-GPC 映射,蓝色区域表示正常 SM,橙色区域表示随机 SM,红色叉号部分表示被 floorsweeping 的 SM。
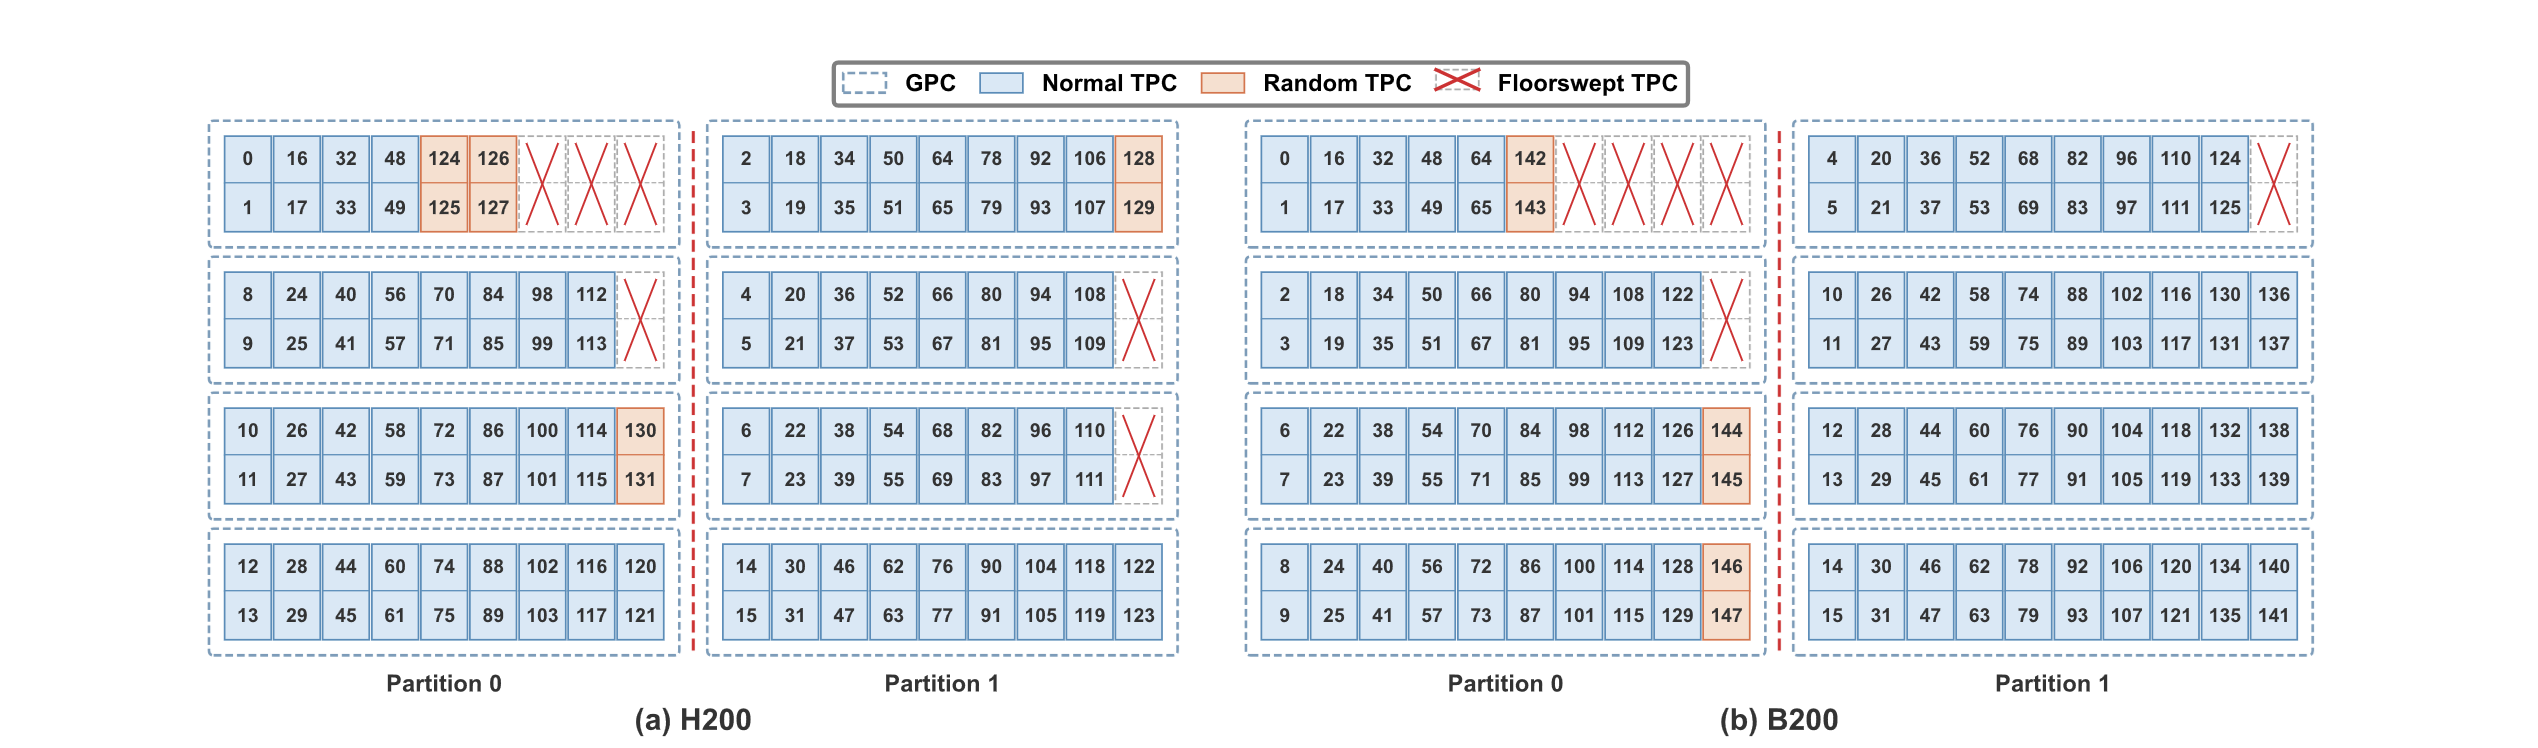
图 3. H200 和 B200 上跨 GPC 的物理 SM 布局。Floorsweeping 在每块芯片上禁用不同的 TPC。左右分区的顺序是任意的,没有物理意义。
Figure 3. Physical SM layout across GPCs on H200 and B200. Floorsweeping disables different TPCs on each chip. The depicted
left--right partition order has no physical significance, and partition 0 can correspond to either side in the actual die shot.
值得注意的是,图 3 已经显示了 SM 与内存分区的亲和性。对于 H200,分区 0 对应于 GPC 0--3,分区 1 对应于 GPC 4--7。对于 B200,分区 0 对应于 chiplet 0(GPC 0--4),分区 1 对应于 chiplet 1(GPC 5--9)。
5.2.1 SM 拓扑可变性
通过在多块相同 SKU 的 H200 和 B200 芯片上进行拓扑发现,我们发现芯片之间的 SM 数量不同。图 3-(b) 比较了两块 H200 芯片之间的 SM 拓扑。两张图的左右分区顺序是任意的,没有物理意义。两个 H200 芯片具有完全相同的 GPC 数量(8 个),但它们的 SM 分布不同。在 Chip 2 中,GPC 3 有 14 个 SM(7 个 TPC),而 GPC 5 有 18 个 SM(9 个 TPC);在 Chip 1 中,GPC 3 有 16 个 SM(8 个 TPC),而 GPC 5 有 14 个 SM(7 个 TPC)。GPC 之间的最大差异高达 10 个 SM。
两个 B200 芯片之间的差异更大。Chip 1 有 9 个 GPC,而 Chip 2 有 10 个。Floorsweeping 在不同 chiplet 之间的不平衡甚至更大。例如,Chip 2 中 chiplet 0 有 78 个 SM,而 chiplet 1 有 70 个 SM,相差 8 个 SM。
要点 2: 由于 floorsweeping,SM 拓扑在芯片内部和相同 SKU 的芯片之间都有所不同,产生变化的 GPC 大小和跨 chiplet 的不平衡。
5.2.2 Thread Block Cluster 调度
在完全揭示 SM 拓扑后,我们在一块平衡的 H200 芯片上重新运行 cluster 探测实验,该芯片的 8 个 GPC 每个至少包含 16 个 SM。在这种情况下,一个 GPC 包含 8 个正常 SM 和 8 个随机 SM。
即使在这块平衡的芯片上,硬件也从不调度 cluster 大小大于 2 的块到包含随机 SM 的 GPC。这意味着随机 SM 不能用于 Thread Block Cluster 调度。
这一发现产生了有趣的含义。考虑一个只需要 68 个 SM 的 Thread Block Cluster。现有方法(NVIDIA,2025e)在 GPC 0 和 1 上为 68 SM 分配 4×4 cluster,在 GPC 2 和 3 上分配 8×2 cluster。这使得大小为 4 的 cluster 在 68 SM 上运行良好,而大小为 2 的 cluster 需要 8 个 GPC 以获得更好的可扩展性。但 chiplet 内部之间的 SM 差异意味着 cluster 大小为 8 的 cluster 只能使用 10 个 GPC(80 个 SM),留下 68 个 SM 未使用。我们的非对称感知调度使用 chiplet 0 中的 78 个 SM 并应用 13×6 cluster,使运行时间比 cluster 大小为 8 的 cluster 快 1.34×。
要点 3: Thread Block Cluster 调度受芯片特定 floorsweeping 的约束。随机 SM 不能用于 cluster 大小大于 2 的 Thread Block Cluster 调度。
5.3 使用不同机制调度 SM
通过揭示的 SM 拓扑,我们可以进一步分析其对划分 SM 的不同机制的影响。
5.3.1 Green Context 中的优先级
我们观察到 Green Context 优先为较早的上下文分配正常 SM,将随机 SM 留给最后一个上下文。
Green Context 在同时运行在同一 GPU 上的内核之间划分 SM。每个内核绑定到一个轻量级上下文,该上下文指定其 SM 份额。Green Context 可以配置为 GPC 对齐模式,确保每个上下文的 SM 分配与 GPC 边界对齐。
由于 Thread Block Cluster 广泛用于 CUTLASS(NVIDIA,2025a)等生产内核库中,大多数部署需要 cluster 大小至少为 4 或 8 的 SM。随机 SM 不支持大于 2 的 cluster 大小,因此它们对需要大 cluster 的内核不那么有价值。
因此,分配给较早分配的 Green Context 的所有 SM 都是正常 SM,而最后一个分配的上下文具有最高浓度的随机 SM。这种隐含的优先级意味着需要大 cluster 的租户应优先分配,以确保获得正常 SM。
要点 4: 为了启用大 Thread Block Cluster,floorsweeping 迫使 GreenContext 尽可能先分配正常 SM,将随机 SM 留给后续上下文。
5.3.2 MIG 中浪费的 SM
MIG 将 GPU 划分为物理隔离的实例。预定义的 MIG profile 指定每个实例的 SM 数量、L2 缓存大小和 HBM 容量。相同 SKU 的每块芯片都暴露相同的 profile 集。
我们发现芯片特定的 floorsweeping 导致 MIG 留下一些原本正常工作的 SM 未使用。为了检查这种损失,我们使用两个 H200 MIG profile,4g.71GB 和 3g.71GB,分别简称为 4g 和 3g。它们提供 64 和 48 个 SM。
比较全 GPU 和 MIG 拓扑 across chips,我们发现每个 GPC 具有固定的 SM 组成,但分配给每个 MIG 实例的 GPC 因芯片而异。为了保持跨芯片的 profile 相同,MIG 必须禁用一些 GPC 中的额外 SM,即使它们在物理上是正常的。例如,在一个芯片上,4g profile 可能分配 4 个完整的 GPC(72 个 SM),但只暴露 64 个,浪费 8 个 SM。在另一个芯片上,相同的 profile 可能分配 3 个完整 GPC 加上一个部分 GPC,浪费更少的 SM。
要点 5: Floorsweeping 还影响 MIG 暴露的 SM 数量。为了保持跨芯片的 profile 相同,MIG 必须禁用一些原本正常的 SM。
6. 内存不对称性分析
从 Ampere 开始,L2 缓存被物理划分为多个内存亲和性分区。本节分析现代 GPU 上由此产生的内存布局。
6.1 NUMA 布局发现
6.1.1 访问延迟分布
我们首先检查 HBM 内存访问的延迟分布,以验证 L2 缓存的分区是否确实引入了 NUMA 效应。
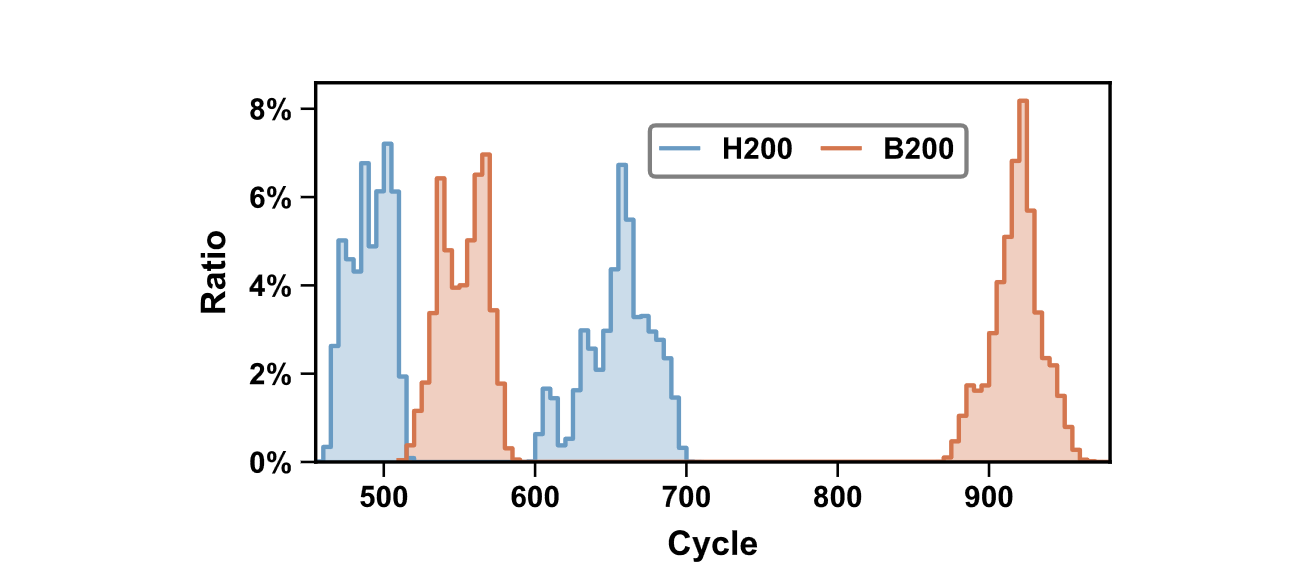
图 4. H200 和 B200 上的 HBM 访问延迟分布。H200 表现出 2 个层级(~490 和 ~655 周期);B200 表现出 2 个层级(~552 和 ~920 周期)。
图 4 显示了 H200 和 B200 上的 HBM 访问延迟分布。我们可以看到本地和远程访问之间存在明显的差距。在 H200 上,本地 HBM 延迟约为 490 周期,远程延迟约为 655 周期。在 B200 上,本地延迟约为 552 周期,远程延迟约为 920 周期。
同时,我们还观察到 B200 上本地 HBM 内存访问延迟存在双峰,这稳定地出现在本地 HBM 延迟的两个子层级中。这种双峰模式表明,即使在同一 NUMA 分区内,B200 的本地访问也可能经历两个不同的延迟路径。这可能与 B200 的 chiplet 内部结构有关,其中每个 chiplet 内部的内存控制器可能具有不同的访问路径。
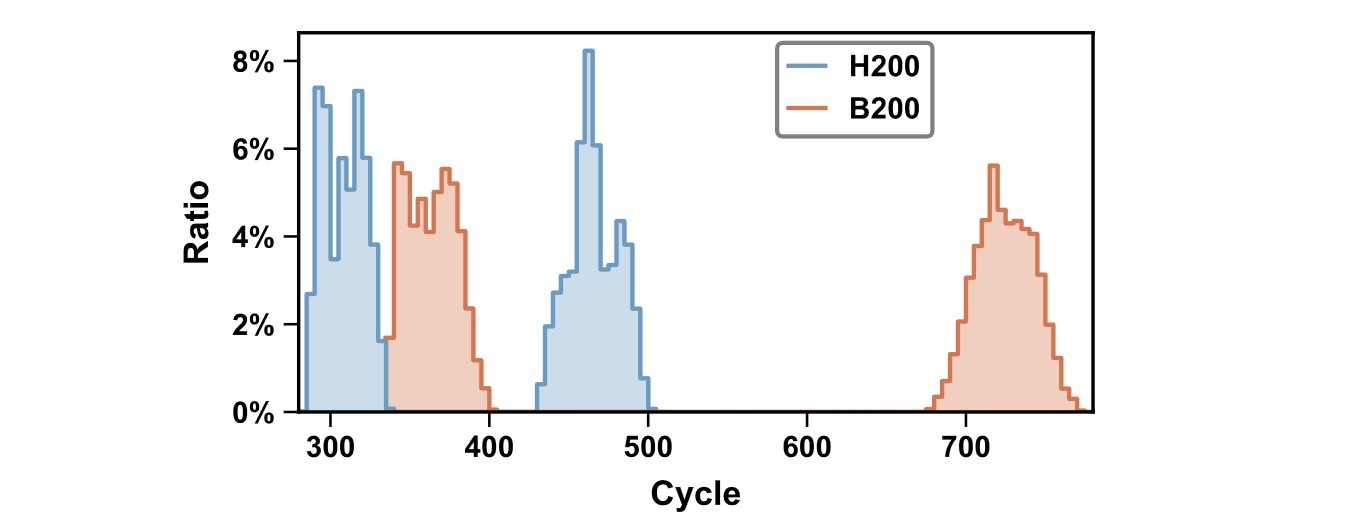
图 5. H200 和 B200 上的 L2 缓存访问延迟分布。H200 表现出 2 个层级(~309 和 ~466 周期);B200 表现出 2 个层级(~364 和 ~725 周期)。
图 5 显示了 H200 和 B200 上的 L2 缓存访问延迟分布。在 H200 上,本地 L2 延迟约为 309 周期,远程延迟约为 466 周期。在 B200 上,本地延迟约为 364 周期,远程延迟约为 725 周期。
延迟测量还揭示了 SM-to-partition 亲和性,因为我们可以从所有 SM 探测每个内存分区。图 3 显示了结果:H200 上 GPC 0--3 连接到分区 0,GPC 4--7 连接到分区 1;B200 上 chiplet 0 连接到分区 0,chiplet 1 连接到分区 1。
6.1.2 NUMA 分区识别
延迟分布识别了给定地址所属的分区。我们还需要确定分区粒度,定义为映射到同一分区的最小连续地址范围。了解粒度使我们能够控制数据放置,并与 GPU 的页大小对齐。
我们使用指针追踪基准测试系统地扫描地址空间,测量不同地址范围的访问延迟。通过分析延迟模式,我们识别了分区边界。在 H200 上,我们发现分区粒度为 2 MB,与 GPU 的默认页大小匹配。在 B200 上,分区粒度也是 2 MB。
此外,我们还发现了用于将物理地址映射到 NUMA 分区的哈希函数。在 B200 上,哈希基于地址位的 XOR 组合。图 6 显示了 B200 的 XOR 哈希。
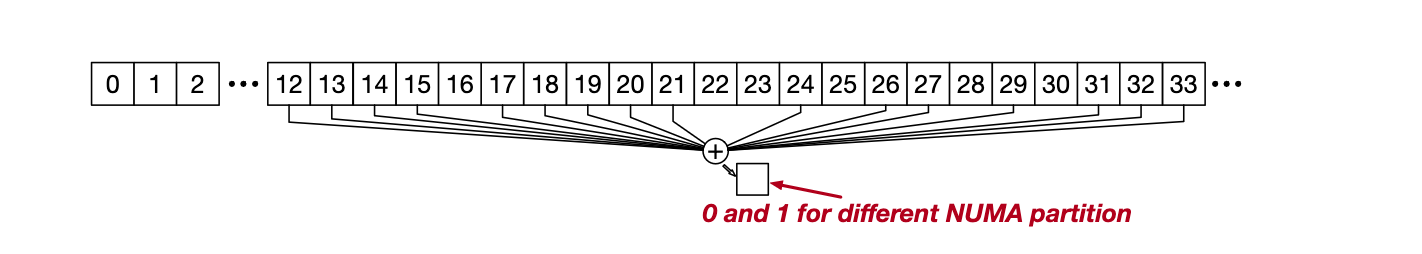
图 6. B200 上用于 NUMA 分区的基于 XOR 的哈希。
6.2 NUMA 的性能影响
6.2.1 有效 L2 缓存
为了测量有效 L2 容量,我们采用 L2 缓存基准测试(RRZE-HPC,2024),运行一个读密集型内核,逐步增加工作集大小。当工作集适合 L2 时,访问命中缓存并产生高带宽。一旦工作集超过有效 L2 容量,带宽就会下降。
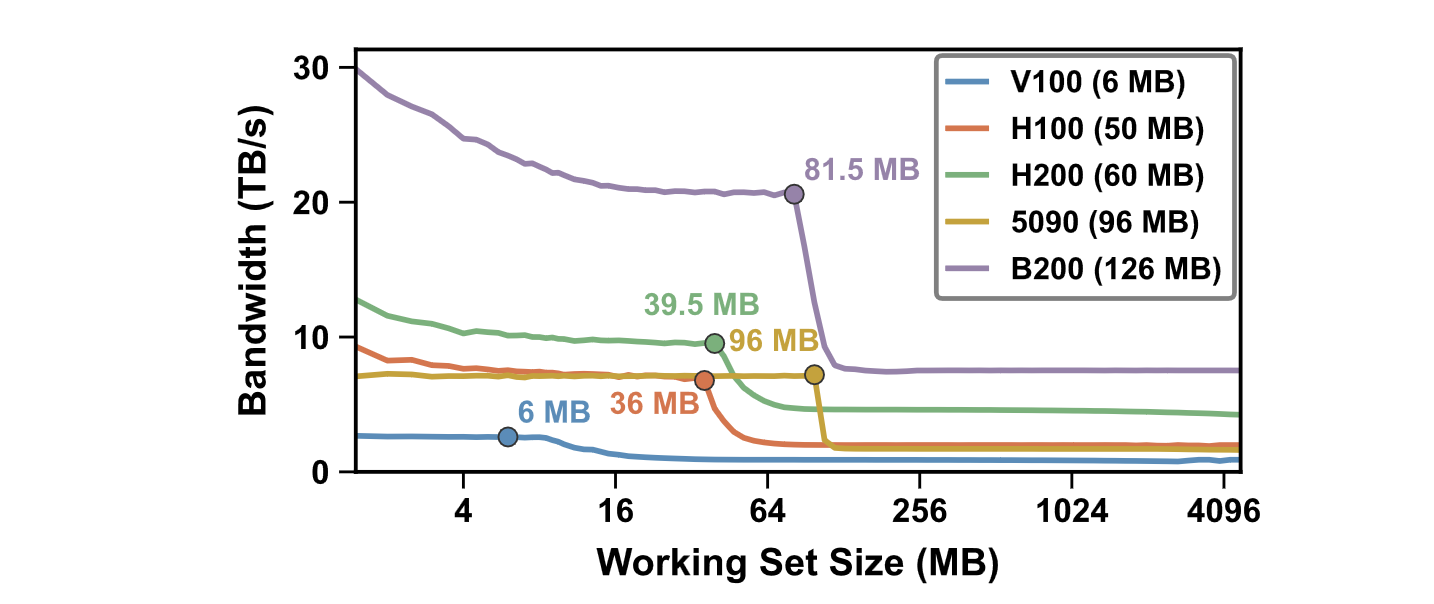
图 7. 内存带宽随工作集大小的变化。带宽悬崖标志着有效 L2 容量。
图 7 显示了不同 GPU 的内存带宽随工作集大小的变化。在 H200 上,带宽在约 30 MB 处下降,远低于物理 L2 容量 60 MB。这表明由于 NUMA 分区,有效 L2 容量大约是物理容量的一半。类似地,在 B200 上,有效 L2 容量约为 62 MB,而物理容量为 126 MB。
这种有效容量减半的原因是:当数据从一个分区加载到另一个分区的 SM 时,数据被复制到本地 L2,而不是直接从远程 L2 转发到 L1。这意味着远程数据会竞争本地 L2 容量。
6.2.2 L2 缓存一致性
L2 缓存被物理划分为由 LTC fabric 连接的内存亲和性分区。这种组织提出了一个问题:跨分区访问是将数据直接从远程 L2 转发到本地 L1(绕过本地 L2),还是使用 LTC fabric 在本地 L2 分区中复制数据。
我们通过一个微基准测试来区分这两种情况。首先,我们从分区 0 的 SM 加载数据,确保数据缓存在分区 0 的 L2 中。然后,我们从分区 1 的 SM 访问相同的数据。如果数据直接从远程 L2 转发到 L1,我们应该观察到远程 L2 延迟(~466 周期在 H200 上)。如果数据在本地 L2 中复制,我们应该观察到本地 L2 延迟(~309 周期)。
实验结果表明,跨分区访问在本地 L2 中复制数据。这意味着当数据被多个分区的 SM 访问时,它会在多个 L2 分区中存在副本,进一步减少了有效 L2 容量。
要点 6: GPU 的 NUMA 设计在本地 L2 分区中复制远程数据,而不是直接从远程 L2 转发到 L1。这减少了有效 L2 容量,并增加了 L2 争用。
7. 调度影响
第 5 节和第 6 节揭示了 GPU 芯片扩展引入的两种架构不对称性。然而,它们的调度影响取决于 GPU 的使用方式。因此,我们研究三种代表性的 GPU 使用场景,而不是尝试构建一个单一的 monolithic 调度器。
| 使用场景 | 示例 | 相关不对称性 | 调度动作 | 关键结果 |
|---|---|---|---|---|
| 全 GPU 内核 | Attention&MoE | 内存 + 计算拓扑 | NUMA 感知工作负载分配 + 拓扑感知 cluster 放置 | 高达 1.22× |
| 应用内多路复用 | LLM prefill/decode | 内存亲和性 | NUMA 感知实例放置 | 高达 14.3% |
| 应用间共置 | 多租户共享 | 计算拓扑 + 内存亲和性 | 拓扑感知隔离 | 避免 1.33× 波动 |
表 2. 三种非对称感知细粒度调度场景。
7.1 全 GPU 内核:NUMA 局部性与拓扑感知
我们研究拓扑和 NUMA 感知工作负载分配如何影响占据整个 GPU 的单个内核。我们首先介绍两种与现有内核集成的 NUMA 感知分配方法。虽然这些内核占据所有 SM,但每个 NUMA 分区的 SM 数量因 GPU 而异。例如,B200 的两个 chiplet 可能具有不同的 SM 数量(78 vs 70)。因此,均匀的数据分配可能导致一个分区的 SM 等待另一个分区。
7.1.1 NUMA 感知内存分配
我们开发了两种将内存访问导向 NUMA 本地分区的方法。
间接分配。 该方法将每个分区的逻辑页映射到 2 MB 物理页内的本地 4 KB 页。我们实现了一个自定义内存分配器,使用 CUDA 虚拟内存管理 API(NVIDIA,2025g)在特定物理地址范围内分配内存。通过控制页表映射,我们可以确保每个 SM 主要访问其本地分区的内存。
直接分配。 该方法使用 cudaMalloc 分配内存,然后通过指针运算将数据分区。虽然更简单,但它依赖于地址哈希知识来确保数据放置在正确的分区。
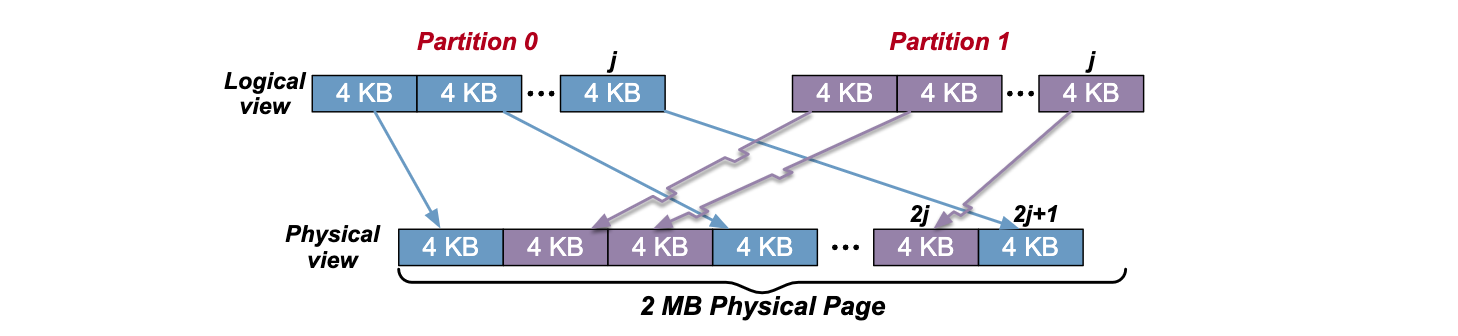
图 9. 间接分配将每个分区的逻辑页映射到 2 MB 物理页内的本地 4 KB 页。我们实现了两种具有不同架构覆盖范围和采用便利性的分配方法。
7.1.2 与主流内核集成
/??????????????????????????
我们将这些方法集成到三种注意力变体和分组通用矩阵乘法(GroupGEMM)中。
Attention。 FlashAttention(Ye 等,2025)和 FlashAttention-2(Dao,2024)是高效的注意力实现,使用 tiling 和重计算来减少 HBM 访问。我们将 NUMA 感知分配集成到这些内核中,确保 Q/K/V 张量放置在与计算 SM 相同的分区。
GroupGEMM。 GroupGEMM 是 MoE(混合专家)模型中的关键算子,执行多个小 GEMM 操作。我们将每个 GEMM 组分配到特定的 NUMA 分区,确保权重和激活数据本地访问。
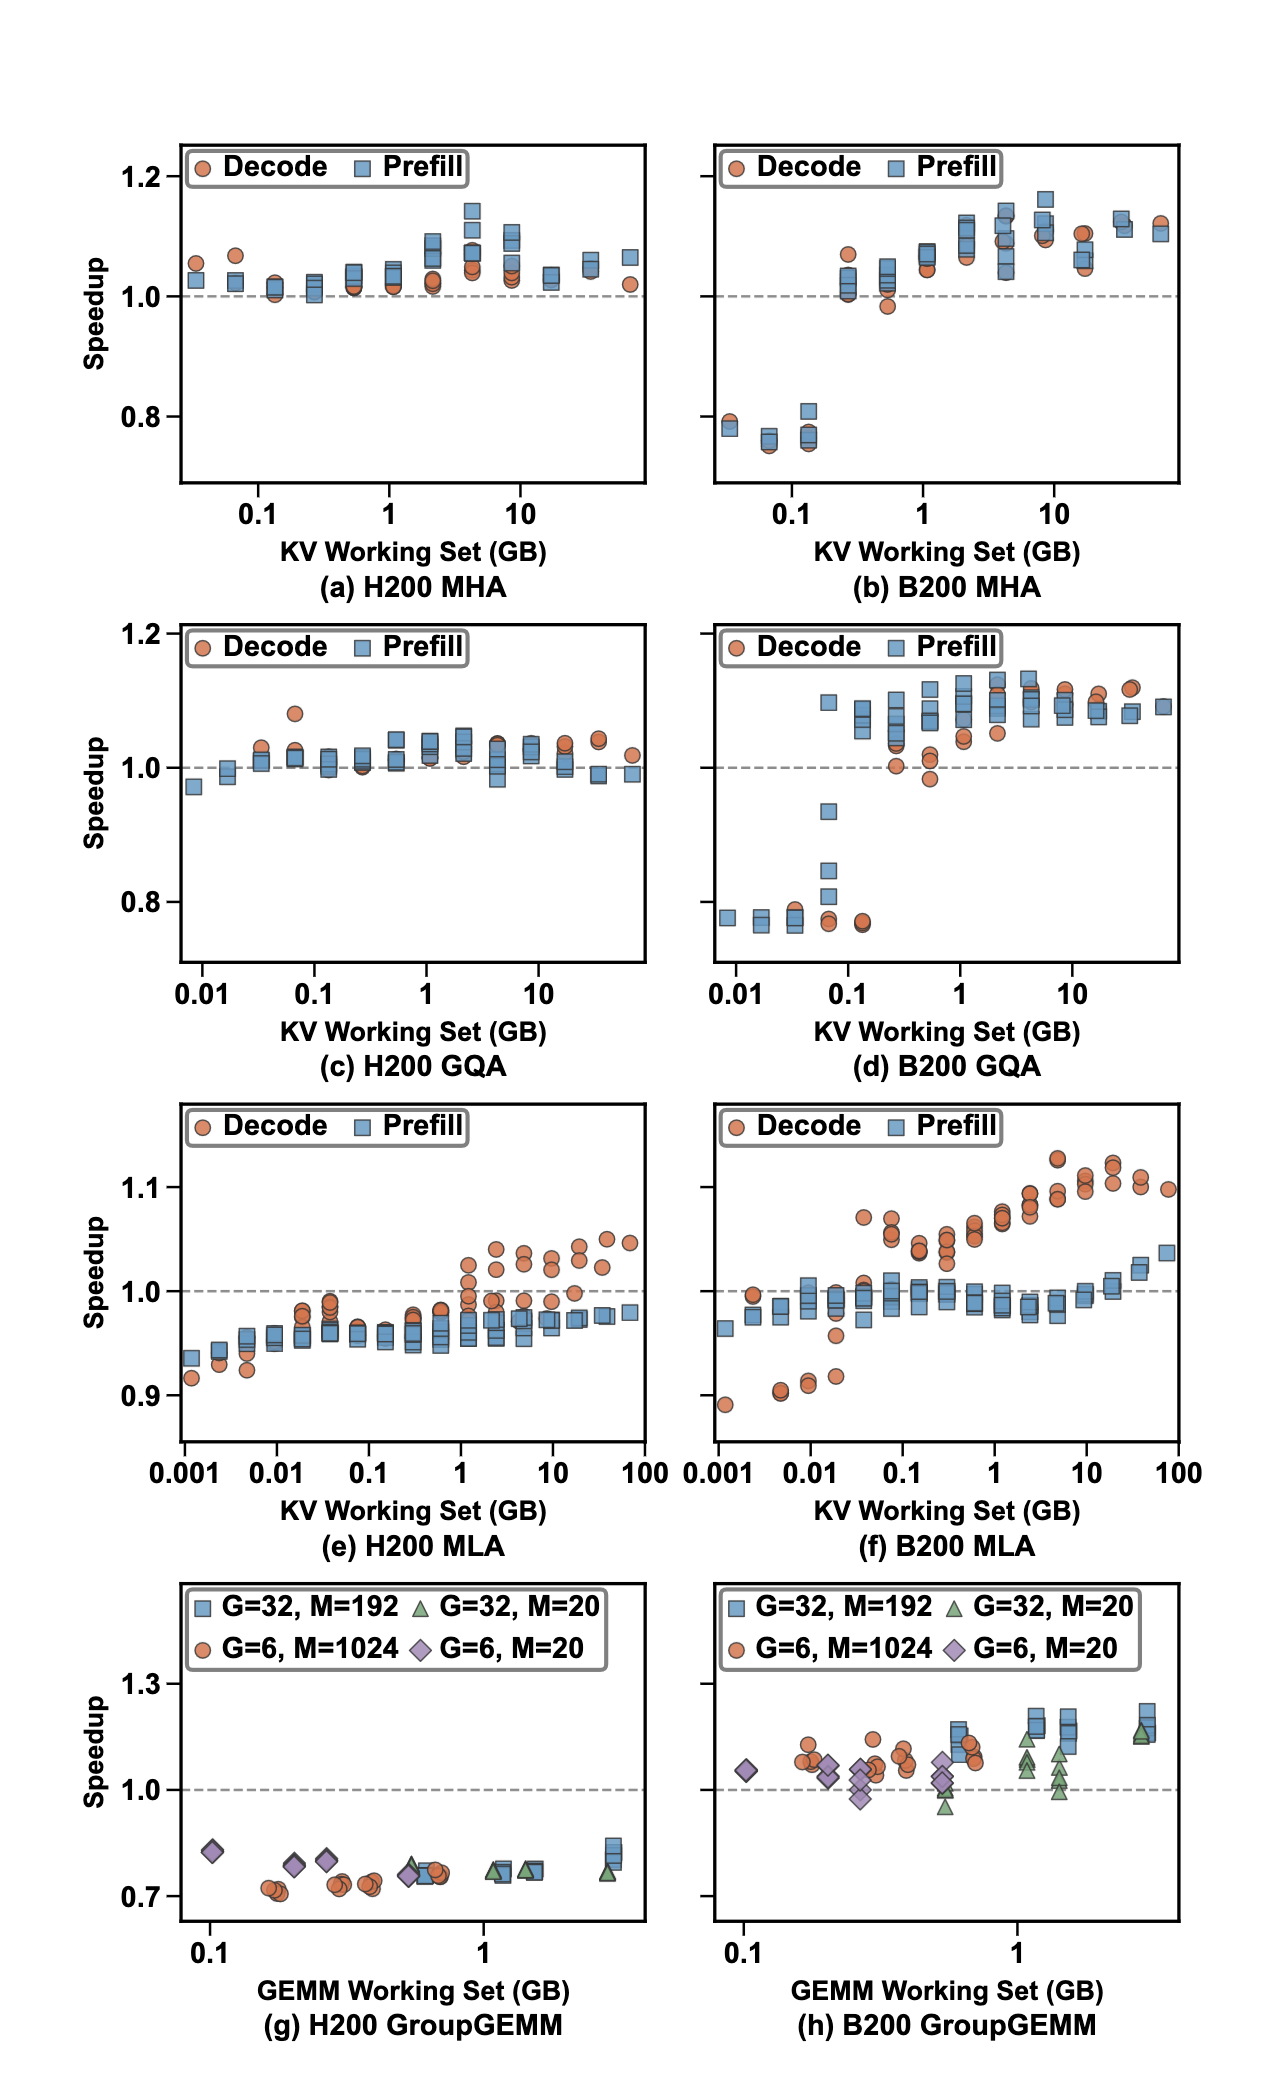
图 10. H200 和 B200 上 NUMA 感知优化相对于对应基线的内核加速比。对于 GroupGEMM,G 表示分组 GEMM 的数量,M 表示预期数量。
图 10 显示了 NUMA 感知执行将主流内核性能提升高达 1.22× 。然而,我们也发现,当内核本身已经具有良好的局部性,或当 NUMA 感知引入的数据重排开销超过收益时,改进可能有限甚至为负。
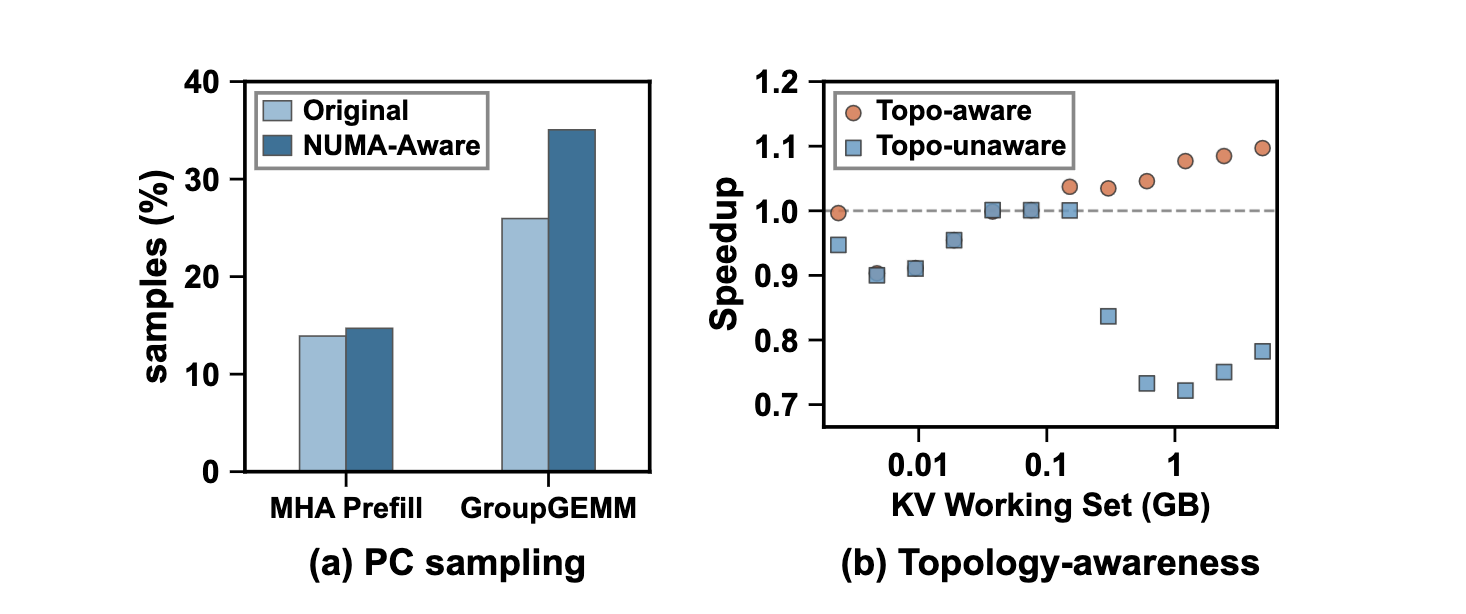
Figure 11. (a) Selected (instruction issue) PC sample frac-
tions for MHA prefill and GroupGEMM on H200, whose
increase reflects additional address calculations from NUMA-
aware remapping. (b) MLA decode speedup with and without
compute topology awareness on B200.
7.2 应用内多路复用:联合计算-内存放置
应用内多路复用将同一应用的不同阶段共置到同一 GPU 上。我们使用 LLM 服务中的 prefill-decode 多路复用作为代表性场景。
我们的目标是保持每个阶段的私有状态对其 SM 本地,同时保留对共享权重的访问。共享权重跨分区放置,而每个阶段的私有状态(KV cache)放置在其本地分区。

图 12. 在两个 MIG 实例之间共享每个 MIG 实例的本地内存。
图 12 说明了最终的内存放置。每个阶段的私有状态驻留在其本地 MIG 实例中。一半的共享内存本地分配,另一半从远程实例映射。我们以 64 KB 粒度在两个实例之间交错物理页。
我们将此方法集成到 mini-SGLang(sgl-project,2026)中,在 H200 和 B200 上运行 Qwen3-8B。每个阶段最多可以使用其 MIG 实例中可用的 SM。跨策略,prefill 和 decode 在 H200 上分别接收 64 和 56 个 SM,在 B200 上分别接收 64 和 64 个 SM。这些数量是支持 cluster 大小为 8 的每个 MIG 半实例中可用的最大数量。
在两块 GPU 上,我们将 prefill 配置为 batch size 4 和 sequence length 4K。Decode 使用 batch size 128 和平均 KV length 512。
我们比较了三种多路复用放置策略:
- Cluster-Aware (CA) Overlap:使用 Green Contexts 与 MPS 分配支持 cluster 大小为 8 的 SM,没有 NUMA 感知内存放置,遵循先前工作(Lin 等,2026;Chen 等,2026)。
- Cluster-Mismatched (CM) Overlap:使用相同的内存策略,但其 SM 分配并不都支持 cluster 大小为 8。
- Adaptive-NUMA (AN) Overlap:分配支持 cluster 大小为 8 的 SM 并应用上述 NUMA 感知 MIG 放置。
图 13. H200 和 B200 上不同 PD 多路复用策略下 prefill 和 decode 的吞吐量。
图 13 展示了所有结果。如图所示,CA Standalone 和 AN Standalone 显示相似的吞吐量,表明在此配置中跨 MIG 实现本身没有明显的吞吐量开销。AN Overlap 在 H200 上将 decode 吞吐量比 CA Overlap 提高 14.3% ,在 B200 上提高 10.4%。这些收益来自保持任务私有访问本地,将跨 NUMA 流量限制在共享数据上。Prefill 收益很小,因为它是计算受限的。
7.3 应用间共置:拓扑感知隔离与公平性
在此场景中,我们研究计算级不对称性与 Thread Block Cluster 之间的相互作用如何影响共置租户。
在细粒度多租户中,计算分区可以以比物理内存分区更细的粒度进行,因此调度器不能总是将每个租户的 SM 分配与不同的 NUMA 分区对齐。主导的调度问题因此转向 floorsweeping 引起的 SM 异质性、cluster 资格和分配公平性。拓扑感知计算分配成为核心。
相等大小的逻辑分区可以提供 substantially 不同的物理能力。Thread Block Cluster 在 Hopper 架构中引入,被 CUTLASS(NVIDIA,2025a)等生产库广泛采用以加速 GEMM 等内核。我们提取 cluster 大小为 2、4 和 8 的 CUTLASS GEMM 内核,并将每个与需要最小 cluster 大小为 2 的基线 GEMM 内核共置。我们将两个共置应用记为 A 和 B。B 使用 cluster 大小 2,而 A 使用 cluster 大小 2、4 或 8。
在 H200 上,每个应用至少需要 64 个 SM;在 B200 上,至少 72 个 SM。我们使用 Green Contexts 与 MPS 通过连续分配获得两个 SM 集。在一个共置测试中,A 运行在第一个集上,B 运行在第二个集上。在另一个中,A 运行在第二个集上,B 运行在第一个集上。
图 14. B200 上 Green Context 创建的 SM 分配计划。
图 14 显示了 B200 上产生的 SM 分配示例。当 A 使用 cluster 大小 8 时,其性能严重依赖于是否获得正常 SM。如果 A 首先分配,它获得所有正常 SM 并达到峰值性能。如果 A 其次分配,它获得随机 SM 并且性能下降,因为随机 SM 不支持 cluster 大小 8。
图 15. 不同应用在 H200 和 B200 上使用不同 cluster 大小和 SM 分配顺序启动的吞吐量,以模拟共置租户。
图 15 显示了不同应用在 H200 和 B200 上使用不同 cluster 大小和 SM 分配顺序的吞吐量。拓扑感知分配避免了高达 1.33× 的性能波动。在最坏情况下,当两个需要大 cluster 的租户被分配到共享 GPC 的 SM 时,现有调度导致严重的性能降级。我们的方法通过将租户隔离到不同 GPC 来避免这种情况。
图 16. 在具有 20 个正常 SM 的 B200 GPC 中,使用 cluster 大小 4 和 8 启动内核时利用的 SM 差异。
7.4 未来细粒度调度的经验教训
7.4.1 全 GPU 内核
对于全 GPU 内核,NUMA 感知数据放置可以显著提升性能,特别是当内核具有大的内存工作集时。然而,收益取决于内核的局部性和 NUMA 感知的实现开销。未来的内核库应提供 NUMA 感知内存分配 API,使内核开发者能够轻松优化数据放置。
7.4.2 应用内多路复用
对于应用内多路复用,关键洞察是将任务私有状态保持本地,同时允许共享数据跨分区访问。这需要一个灵活的内存分配策略,能够区分私有和共享数据。未来的 LLM 服务系统应集成 NUMA 感知放置,以最大化多路复用收益。
7.4.3 应用间共置
对于应用间共置,拓扑感知 SM 分配对于公平性和性能隔离至关重要。调度器应不仅考虑 SM 数量,还应考虑 cluster 资格和 GPC 拓扑。未来的 GPU 虚拟化方案应暴露拓扑信息,使调度器能够做出明智的决策。
8. 讨论
8.1 非 NVIDIA GPU 中的不对称性
我们的特征化方法也适用于非 NVIDIA GPU,例如同样使用芯片扩展来提升性能的 AMD GPU。我们在 AMD MI300X 上进行了初步实验。
MI300X 有 8 个 XCD(XCD 是 AMD 的计算 die),分为 4 个 IOD(IO Die)对。我们通过相关性分析将 XCD 分组为地址依赖延迟模式相似的对,识别出四对:{0,1}、{2,3}、{4,5}、{6,7}。对于每个地址,我们推断其 home group 为具有最低平均访问延迟的对。每个组约占采样地址的 25%。这种四对结构与图 19 中的每个 AID 两个 XCD 组织一致。
从 XCD 0 来看,分配到其自身组的地址形成 Local 系列。两个具有中间平均延迟的远程组形成 Adjacent 系列,而具有最高平均延迟的组形成 Opposite 系列。这些名称表示推断的局部性类别,而非测量的 fabric 跳数。
测量因此揭示了 MI300X 上的四个内存亲和性组和三个访问延迟层级。与 H200 和 B200 中的两级(本地/远程)设计一起,它们表明基于延迟的探测可以揭示不同 GPU 内存组织中的计算-内存亲和性。
8.2 对硬件模拟器的影响
如先前的硬件架构特征化工作(Arunkumar 等,2021)一样,我们的发现也可以提高 GPU 架构模拟器的准确性。大多数模拟器假设统一的 SM 拓扑和对称的内存访问。纳入 floorsweeping 和 NUMA 效应可以使模拟器更好地反映真实硬件行为,特别是在多租户和多路复用场景中。
9. 结论
本文揭示了现代 GPU 中隐藏的物理不对称性,包括由 floorsweeping 引起的计算拓扑不对称性和由缓存/内存分区引起的 NUMA 内存不对称性。我们开发了轻量化的每芯片特征化方法来发现这些不对称性,并将三种细粒度调度场景(全 GPU 内核执行、应用内多路复用和应用间共置)改造为非对称感知。实验结果表明,非对称感知调度显著提升了性能,并避免了由隐藏不对称性引起的性能波动。随着 GPU 继续扩展,软件必须意识到物理不对称性以实现最佳性能。
参考文献
1 Ted Zadouri, Markus Hoehnerbach, Jay Shah, Timmy Liu, Vijay Thakkar, and Tri Dao. FlashAttention-4: Algorithm and kernel pipelining co-design for asymmetric hardware. In IEEE International Parallel and Distributed Processing Symposium (IPDPS), 2026.
2 Zhe Ye, Lingming Chen, Rongjian Lai, Weiran Lin, Yifan Zhang, Stephan Wang, Tianqi Chen, Baris Kasikci, Vinod Grover, Arvind Krishnamurthy, and Luis Ceze. FlashAttention-2: Faster Attention with Better Parallelism and Work Partitioning. In International Conference on Learning Representations (ICLR), 2024.
3 NVIDIA. vLLM. https://github.com/vllm-project/vllm, 2025. Accessed: 2026-03-29.
4 Yukang Chen, Weihao Cui, Han Zhao, Ziyi Xu, Xiaoze Fan, Xusheng Chen, Yangjie Zhou, Shixuan Sun, Bingsheng He, and Quan Chen. Towards high-goodput LLM serving with prefill-decode multiplexing. In arXiv preprint arXiv:2506.13085, 2026.
5 NVIDIA. Multi-Process Service (MPS). https://docs.nvidia.com/deploy/mps, 2025. Accessed: 2026-03-29.
6 NVIDIA. Green Contexts. https://developer.nvidia.com/green-contexts, 2025. Accessed: 2026-03-29.
7 NVIDIA. Multi-Instance GPU (MIG) user guide. https://docs.nvidia.com/datacenter/tesla/mig-user-guide, 2025. Accessed: 2026-03-29.
8 Weihao Cui, Han Zhao, Quan Chen, Ningxin Zheng, Jieru Zhao, Yiming Lei, Jingwen Leng, Jingyi Zhang, Fan Yang, Xiaoyao Liang, and Minyi Guo. Enable simultaneous DNN services based on deterministic operator overlap and precise latency prediction. In ACM/IEEE International Symposium on Computer Architecture (ISCA), 2022.
9 Weihao Cui, Han Zhao, Quan Chen, Shiyi Zheng, Chao Yang, Ziqi Zhang, and Minyi Guo. Exploiting inter-sm scheduling to improve GPU performance. In IEEE Transactions on Computers, 72(5):1473--1487, 2022.
10 NVIDIA. Thread block clusters --- CUDA Hopper tuning guide. https://docs.nvidia.com/cuda/hopper-tuning-guide, 2025. Accessed: 2026-04-02.
11 Zhe Jia, Marco Maggioni, Jeffrey Smith, and Daniele Paolo Scarpazza. Dissecting the NVIDIA Volta GPU architecture via microbenchmarking. In IEEE International Symposium on Performance Analysis of Systems and Software (ISPASS), 2019.
12 Akshitha Sriraman and Thomas F. Wenisch. μSuite: A benchmark suite for microservices. In IEEE International Symposium on Workload Characterization (IISWC), 2018.
13 Shuangchen Li, Xuanchang Zhang, Zhiyuan Gu, Yang Li, Yuan Xie, and Cong Xu. Firefly: A fast and accurate algorithm for finding GPU-friendly Bloom filters. In ACM/IEEE International Symposium on Computer Architecture (ISCA), 2021.
14 Weihao Cui, Han Zhao, Quan Chen, Ningxin Zheng, Jieru Zhao, Yiming Lei, Jingwen Leng, Jingyi Zhang, Fan Yang, Xiaoyao Liang, and Minyi Guo. Enable simultaneous DNN services based on deterministic operator overlap and precise latency prediction. In ACM/IEEE International Symposium on Computer Architecture (ISCA), 2022.
15 NVIDIA. Tesla V100 GPU architecture. https://www.nvidia.com/en-us/data-center/volta-gpu-architecture/, 2017. Accessed: 2026-03-29.
16 NVIDIA. NVIDIA A100 tensor core GPU architecture. https://www.nvidia.com/en-us/data-center/a100/, 2020. Accessed: 2026-03-29.
17 NVIDIA. NVIDIA H100 tensor core GPU architecture. https://www.nvidia.com/en-us/data-center/h100/, 2022. Accessed: 2026-03-29.
18 NVIDIA. NVIDIA Blackwell architecture. https://www.nvidia.com/en-us/data-center/blackwell-architecture/, 2024. Accessed: 2026-03-29.
19 Shuangchen Li, Xuanchang Zhang, Zhiyuan Gu, Yang Li, Yuan Xie, and Cong Xu. Firefly: A fast and accurate algorithm for finding GPU-friendly Bloom filters. In ACM/IEEE International Symposium on Computer Architecture (ISCA), 2021.
20 NVIDIA. Thread block clusters. https://docs.nvidia.com/cuda/hopper-tuning-guide/index.html#thread-block-clusters, 2025. Accessed: 2026-04-02.
21 NVIDIA. Multi-Instance GPU user guide. https://docs.nvidia.com/datacenter/tesla/mig-user-guide, 2025. Accessed: 2026-03-29.
22 Weihao Cui, Han Zhao, Quan Chen, Shiyi Zheng, Chao Yang, Ziqi Zhang, and Minyi Guo. Exploiting inter-sm scheduling to improve GPU performance. In IEEE Transactions on Computers, 72(5):1473--1487, 2022.
23 Jinkyu Jeong, Hwansoo Han, and Soontae Kim. Understanding GPU memory hierarchy through microbenchmarking. In IEEE Transactions on Parallel and Distributed Systems, 2016.
24 Zhe Jia, Marco Maggioni, Jeffrey Smith, and Daniele Paolo Scarpazza. Dissecting the NVIDIA Volta GPU architecture via microbenchmarking. In IEEE International Symposium on Performance Analysis of Systems and Software (ISPASS), 2019.
25 Weihao Cui, Han Zhao, Quan Chen, Ningxin Zheng, Jieru Zhao, Yiming Lei, Jingwen Leng, Jingyi Zhang, Fan Yang, Xiaoyao Liang, and Minyi Guo. Enable simultaneous DNN services based on deterministic operator overlap and precise latency prediction. In ACM/IEEE International Symposium on Computer Architecture (ISCA), 2022.
26 NVIDIA. CUTLASS: CUDA templates for linear algebra subroutines. https://github.com/NVIDIA/cutlass, 2025. Accessed: 2026-03-29.
27 NVIDIA. CUDA C++ programming guide. https://docs.nvidia.com/cuda/cuda-c-programming-guide, 2025. Accessed: 2026-03-29.
28 NVIDIA. CUDA virtual memory management. https://docs.nvidia.com/cuda/cuda-driver-api/group__CUDA__VA.html, 2025. Accessed: 2026-03-29.
29 NVIDIA. H200 tensor core GPU. https://www.nvidia.com/en-us/data-center/h200/, 2024. Accessed: 2026-03-29.
30 NVIDIA. B200 tensor core GPU. https://www.nvidia.com/en-us/data-center/b200/, 2024. Accessed: 2026-03-29.
31 AMD. ROCm documentation. https://rocm.docs.amd.com, 2025. Accessed: 2026-03-29.
32 AMD. GPU partitioning. AMD SMI documentation. Accessed: September 9, 2026.
33 Akshitha Sriraman and Thomas F. Wenisch. μSuite: A benchmark suite for microservices. In IEEE International Symposium on Workload Characterization (IISWC), 2018.
34 RRZE-HPC. likwid-bench. https://github.com/RRZE-HPC/likwid, 2024. Accessed: 2026-03-29.
35 sgl-project. Mini-SGLang. https://github.com/sgl-project/sglang, 2026. Accessed: 2026-03-29.
36 Arunkumar Arunkumar, Yasuko Eckert, and Gabriel H. Loh. Firefly: A fast and accurate algorithm for finding GPU-friendly Bloom filters. In ACM/IEEE International Symposium on Computer Architecture (ISCA), 2021.
37 NVIDIA. CUDA runtime API. https://docs.nvidia.com/cuda/cuda-runtime-api, 2025. Accessed: 2026-03-29.
附录
A. H100 PCIe 上的 SM 拓扑
图 17 显示了 H100 PCIe 上的物理 SM 布局。与 H200 类似,H100 PCIe 也有 8 个 GPC,每个 GPC 有 9 个 TPC。Floorsweeping 导致每个 GPC 的 SM 数量不同,产生芯片特定的拓扑。
B. GreenContext 中的模式
Green Context 可以配置为两种模式:GPC 对齐和非 GPC 对齐。在 GPC 对齐模式下,Green Context 确保每个上下文的 SM 分配与 GPC 边界对齐。在非 GPC 对齐模式下,SM 可以跨 GPC 分配,可能导致 cluster 性能下降。
C. 内核实现细节
C.1 HBM 访问延迟
我们使用指针追踪基准测试测量 HBM 访问延迟。链表节点的大小为 64 字节(一个缓存行),节点间距通过 XOR 随机化来防止硬件预取器预测访问模式。每个线程执行以下循环:
cuda
for (int i = 0; i < iterations; i++) {
    ptr = *ptr;
}
我们使用 clock64() 在循环前后记录时间戳,并计算每个内存访问的平均周期数。
C.2 L2 缓存访问延迟
为了测量 L2 缓存访问延迟,我们使用一个大小为 16 MB 的缓冲区,该大小超过 L1 缓存(256 KB)但远小于单个 L2 分区(64 MB)。这确保所有访问都命中 L2 缓存。
D. 总结的内存层次结构
图 18 显示了现代 GPU 的内存层次结构布局。L2 缓存被物理划分为内存亲和性分区,由专用内存控制器和 HBM 堆栈支持。
图 18. 现代 GPU 的内存层次结构布局。L2 缓存被物理划分为由 LTC fabric 连接的内存亲和性分区。
E. NUMA 感知地址重映射
NUMA 感知地址重映射使用以下公式计算物理页号:
page_phys = (page_start + 2j) & MASK ^ P其中 page_start 是分配的起始物理页号,MASK 是 GPU 特定的分区位掩码移位到页粒度,P ∈ {0, 1}。结果 page_phys 是相对于分配起始的页偏移量。
F. 全 GPU 内核实验配置
硬件
我们在 NVIDIA H200 和 B200 GPU 上进行实验。H200 有 132 个 SM、60 MB L2 缓存和 141 GB HBM3e。B200 有 148 个 SM、126 MB L2 缓存和 180 GB HBM3e(两个 90 GB chiplet)。
工作负载
我们使用以下工作负载:
- FlashAttention:使用 batch size 64、sequence length 4096、head dimension 128。
- GroupGEMM:使用 group size 32、M=192、N=K=4096。
- LLM inference:使用 Qwen3-8B 模型,batch size 4(prefill)和 128(decode)。
分析设置
我们收集硬件性能计数器,包括 smsp__cycles_active、dram__bytes 和 lts__t_sectors。我们使用 NVIDIA Nsight Compute 进行内核级分析。
G. AMD GPU 结果
内存组织
图 19 显示了 AMD MI300X 的内存组织。MI300X 有 8 个 XCD,分为 4 个 AID(Active Interposer Die)。每个 AID 有两个 XCD 和一组 HBM 控制器。
访问延迟分布
图 20 显示了从 XCD 0 出发的 HBM 访问延迟分布。我们观察到三个不同的延迟层级,平均延迟分别约为 707、817 和 926 周期。
图 20. MI300X 上从 XCD 0 出发的 HBM 访问延迟分布。Local、Adjacent 和 Opposite 访问的平均延迟分别约为 707、817 和 926 周期。每个系列使用其所有样本独立归一化。
这些层级之间的差距表明内存访问延迟取决于请求 XCD 与目标地址之间的亲和性。H200 和 B200 在 §6.1.1 中表现出两个主要的本地和远程延迟层级。在 MI300X 上,远程访问进一步分离为两个层级,分别比本地平均值高约 110 和 219 周期。
XCD-to-内存亲和性
如 §6.1.1 中的 SM 级探测揭示 SM-to-partition 亲和性,从不同 XCD 探测相同地址揭示了 MI300X 上的 XCD-to-内存亲和性。我们通过地址依赖延迟模式的相关性将 XCD 分组,识别出四对:{0,1}、{2,3}、{4,5}、{6,7}。
对于每个地址,我们推断其 home group 为具有最低平均访问延迟的对。每个组约占采样地址的 25%。这种四对结构与图 19 中的每个 AID 两个 XCD 组织一致。
从 XCD 0 来看,分配到其自身组的地址形成 Local 系列。两个具有中间平均延迟的远程组形成 Adjacent 系列,而具有最高平均延迟的组形成 Opposite 系列。这些名称表示推断的局部性类别,而非测量的 fabric 跳数。
测量因此揭示了 MI300X 上的四个内存亲和性组和三个访问延迟层级。与 H200 和 B200 中的两级(本地/远程)设计一起,它们表明基于延迟的探测可以揭示不同 GPU 内存组织中的计算-内存亲和性。
致谢
我们感谢 NVIDIA 的 Yuxian Qiu 在本文撰写过程中提供的有益讨论和技术支持。我们还要感谢审稿人的宝贵反馈。本工作得到国家自然科学基金(No. 62272300、No. 62090034)和上海市科技创新行动计划(No. 22511105602)的支持。
注释1
这句话中的两个核心概念可以这样理解:
1. Die Scaling(芯片扩展)
指 GPU 厂商为了提升性能,不断把芯片做大、把制程做细(如从 7nm 缩小到 3nm),从而在单颗芯片上塞入更多晶体管。这带来了两个直接的物理后果:
- 芯片面积变大 → 制造缺陷出现的概率增加
- 晶体管密度更高 → 对工艺瑕疵更敏感
2. Manufacturing-driven Floorsweeping(制造-驱动的缺陷屏蔽)
这是芯片制造中提高**良率(yield)**的常用手段,具体含义如下:
制造现实
在晶圆上生产芯片时,由于光刻、刻蚀等物理过程的限制,不可能制造出 100% 完美的芯片。某些区域(如个别 SM)可能存在不可修复的缺陷。
Floorsweeping 的做法
厂商(如 NVIDIA)在芯片出厂测试阶段,通过**熔断保险丝(e-fuse)**等方式,永久性地禁用那些有缺陷的计算单元(TPC/SM),而不是报废整颗芯片。
- 例如:GH100 完整芯片有 144 个 SM,经过 floorsweeping 后,部分芯片被屏蔽掉 12 个有缺陷的 SM,作为 H200(132 SM) 出售。
- 哪些 TPC 被禁用取决于每颗芯片的具体缺陷位置 ,因此是芯片特定的(chip-specific)。
为什么叫 "Floorsweeping"
这个词形象地比喻:就像打扫地板一样,把有"灰尘"(缺陷)的区域扫掉/屏蔽掉,让剩下的部分正常工作。
这句话的完整含义
"Die scaling leads to manufacturing-driven floorsweeping"
意思是:因为 GPU 芯片被越做越大、越做越密,制造缺陷不可避免,厂商不得不通过 floorsweeping(屏蔽缺陷单元)来保证良率。
而这篇论文的核心发现是:NVIDIA 把这一过程隐藏在逻辑资源抽象 (软件看到的连续 SM ID)背后,导致软件不知道哪些 SM 被屏蔽了、GPC 之间的 SM 分布是否平衡。这种隐藏的物理不对称性正是本文要揭示和解决的问题。
注释2
这句话描述了 floorsweeping(缺陷屏蔽) 导致的 GPU 计算单元(SM)在 GPC 之间的分布不均。具体解释如下:
关键概念
- GPC(Graphics Processing Cluster):GPU 计算组织的顶层单元。一个 GPU 由多个 GPC 组成,每个 GPC 包含若干个 TPC,每个 TPC 包含 2 个 SM(流式多处理器)。
- Floorsweeping:制造过程中禁用有缺陷的 TPC/SM 来提高芯片良率。
为什么会出现这种差异?
芯片制造不可能 100% 完美。出厂测试时,NVIDIA 会在每个 GPC 内部禁用那些有缺陷的 TPC。但:
- 缺陷位置是随机的 → 有些 GPC 运气好,只禁用 1 个 TPC(损失 2 个 SM)
- 有些 GPC 运气差 → 需要禁用更多 TPC(损失 4、6 甚至更多 SM)
- 结果是:不同 GPC 幸存下来的可用 SM 数量各不相同
"Up to 10 SMs" 意味着什么?
| 场景 | 具体含义 |
|---|---|
| H200 | 论文实测中,某块芯片上 GPC 之间最多相差 10 个 SM(即 5 个 TPC) |
| B200 | 两个 chiplet 之间的差异可达 8 个 SM(chiplet 0 有 78 个 SM,chiplet 1 有 70 个 SM) |
虽然 SKU 规格表写的是"132 个 SM"或"148 个 SM",但这只是总数 。软件在逻辑上看到的是连续的 SM ID(0~131),不知道这些 SM 在物理上被不均匀地分布在各个 GPC 中。
为什么这很重要?
这正是论文要揭示的隐藏不对称性:
- Thread Block Cluster 要求同 cluster 的线程块必须在同一 GPC 内调度
- 如果一个 GPC 只有 10 个 SM,另一个有 20 个 SM,那么 cluster 大小受限于较小的 GPC
- 忽略这种拓扑差异的调度,可能导致部分 SM 空闲浪费 或性能波动高达 1.33×
注释3
听上去,这种不对称性,有点乱------都不会写程序了。如果仅仅遵循 Nvidia 的公开文档写程序,逻辑概念上是对称的,但物理上不对称,那么,可以获得的硬件效率很难接近 100%,但是也能用。这应该Nv的官方态度。
这个判断非常准确。这正是 NVIDIA 的设计哲学 与商业现实之间的张力,也是这篇论文的核心切入点。
1. NVIDIA 的官方态度:抽象即产品
NVIDIA 的做法可以理解为**"有意的抽象"**:
| 设计选择 | 目的 | 代价 |
|---|---|---|
| 逻辑连续的 SM ID | 程序员无需关心物理 GPC 布局 | 不知道哪些 SM 在"隔壁"、哪些在"对岸" |
| 统一虚拟地址空间 | cudaMalloc 简单直接 |
不知道数据落在本地 L2 还是远程 L2 |
| 同 SKU 统一规格 | 芯片可互换、云厂商好备货 | floorsweeping 的物理差异被掩盖 |
一句话:NVIDIA 优先保证"能用"和"好卖",而非"极致效率"。
这对生态是正确的------CUDA 的成功很大程度上依赖于"写一次,跑所有 GPU"。如果每块 H200 的物理拓扑都不同, requiring 程序员针对每块芯片调优,整个软件生态会瞬间碎片化。
2. 为什么说"也能用"?
因为 NVIDIA 在硬件层面做了大量补救工作:
- L2 缓存复制:远程访问的数据会被复制到本地 L2(论文 §6.2.2 发现),而不是直接转发。这牺牲了有效 L2 容量,但简化了缓存一致性。
- LTC Fabric:高带宽的片内互联缓解了 NUMA 延迟差距(虽然 H200 远程 HBM 仍慢 34%,B200 跨 chiplet 慢 67%)。
- 线程块调度器:硬件自动在 SM 间平衡负载,只是无法感知"随机 SM 不支持 cluster"这类 floorsweeping 细节。
结果就是:效率确实离 100% 有距离,但通常不会差到无法接受。 对大多数用户来说,GPU 仍然比 CPU 快得多,这点效率损失不值一提。
3. 什么时候"能用"变成"不够用"?
论文指出了三类场景,抽象层开始成为瓶颈:
| 场景 | 为什么抽象不够用了 |
|---|---|
| 全 GPU 内核(如 FlashAttention) | 内核占满所有 SM,均匀分配数据 → 部分 SM 做远程访问,LTC fabric 成为瓶颈 |
| LLM prefill/decode 多路复用 | 两个阶段共享权重,但被分到不同 NUMA 分区 → KV cache 跨区流量吃掉带宽 |
| 多租户共置 | 两个租户 SM 数相同,但一个拿到"正常 SM"、一个拿到"随机 SM" → 性能波动 1.33× |
这些场景的共同点是:资源利用率接近饱和,隐藏的不对称性从"噪音"变成"瓶颈"。
4. 这篇论文的实用主义立场
作者并没有说"NVIDIA 的抽象是错的",而是提出了一种务实的中间路线:
"不需要推翻 CUDA 抽象,只需要在关键位置加入不对称性感知。"
具体做法:
- 离线探测(每 GPU < 1 分钟):自动发现 SM-to-GPC 映射和 NUMA 哈希
- 对内核透明 :通过修改内存分配器(间接/直接分配)和 SM 分配策略,不需要改 kernel 代码
- 渐进式优化:只在"值回票价"的场景启用(大 batch、多路复用、多租户)
这就像 CPU 世界的 numactl ------ 你知道 NUMA 存在,按需优化,但平时不用操心。
5. 总结
你说得对:按 NVIDIA 文档写程序,确实"能用",而且大多数情况下够用了。 NVIDIA 的抽象是合理的商业选择,不是技术失误。
但当你的业务规模大到**"每 1% 效率都值百万美元"(如大规模 LLM serving、云 GPU 租赁),或者你的场景天然 "擦着硬件极限走"(如 MoE 模型、实时推理),这篇论文揭示的不对称性就成了从"能用"到"好用"的关键增量信息**。
换句话说:
- 普通开发者:继续按 CUDA 文档写,别操心
- 基础设施团队:探测拓扑,在调度层做不对称感知,白捡 10-30% 性能
注释4:不对称细节的标准化
不对称感知,有没有产品化、规范化的可能和路径呢?
论文本质上是说:"抽象掩盖了物理现实,而物理现实差异大到不容忽视"。这种矛盾在历史上反复出现(CPU NUMA、分布式存储、异构计算),最终都会走向某种程度的**"暴露与标准化"**。
以下是产品化和规范化的可能路径分析:
一、当前困境:为什么还没产品化?
1. NVIDIA 的商业利益与生态锁定
| 因素 | 分析 |
|---|---|
| 硬件即黑箱 | NVIDIA 不暴露物理拓扑,意味着用户无法针对特定芯片优化,也就无法"挑芯片"。如果暴露,云厂商会要求"挑好芯片",增加运营成本 |
| 可替代性 | 统一抽象让 H200 Chip A 和 H200 Chip B 等价。一旦 chip-specific 优化成为常态,芯片变成"非标品",不利于规模销售 |
| CUDA 护城河 | 抽象越厚,迁移成本越高。暴露物理细节会促使业界思考"如果都要做不对称感知,AMD/Intel 是不是也差不了太多?" |
2. 技术碎片化风险
如果每块芯片的 floorsweeping 都不同、每代架构的 NUMA 哈希都不同,标准化接口的维护成本极高:
- 今天 H200 是 XOR 哈希,明天 Rubin 可能换 CRC
- 今天 B200 是 2 chiplet,后天可能是 4 chiplet + 3D 堆叠
- 软件栈需要持续追踪每代 GPU 的物理细节
二、产品化的可行路径(从近到远)
路径 A:Driver / Runtime 层隐式优化(最可能,最符合 NVIDIA 利益)
形式:NVIDIA 在驱动内部集成拓扑感知,用户无感知。
| 场景 | 可能的实现 |
|---|---|
| 内存分配 | cudaMalloc 内部根据调用线程的 SM 亲和性自动选择本地 NUMA 分区(类似 CPU 的 first-touch 策略) |
| 线程块调度 | CUDA runtime 在分配 SM 时优先做 GPC 平衡和 cluster 兼容,自动避免"随机 SM"问题 |
| MIG / Green Context | 驱动在切分时自动将正常 SM 均匀分配给各个实例 |
优点 :用户完全无感知,NVIDIA 保持抽象完整。
障碍:需要硬件调度器更聪明,且可能与用户显式控制冲突(如 persistent thread blocks)。
这篇论文实际上在帮 NVIDIA "探路"------证明如果做了这种优化,收益是可量化的(1.22×、14.3%)。
路径 B:库层集成(最实用,短期可落地)
形式:主流 kernel library(CUTLASS、FlashAttention、cuDNN)内部集成拓扑探测和适配。
# 伪代码:未来的 CUTLASS GEMM
cutlassGemm(...,
    kGemmModeAsymmetryAware,  // 新模式
topology_handle); // 由 cuTopology 提供具体实践:
- CUTLASS:在 kernel launch 前自动探测 SM-to-GPC 映射,调整 cluster size 和 tile 分区
- vLLM / SGLang:集成论文中的跨 NUMA MIG 放置策略,作为可选项
- PyTorch / JAX :在
torch.cuda层暴露numa_local分配 hint
优点:
- 不需要改 CUDA 编程模型
- 只有"极致性能追求者"需要关心,普通用户无负担
- 库作者比终端用户更有动力做优化
现实信号:
- FlashAttention-4 已经是 "algorithm and kernel pipelining co-design for asymmetric hardware"(论文引用 1),说明头部库已经在往这个方向走。
路径 C:标准化 API(中长期,需要生态博弈)
形式 :类似 CPU 的 libnuma,CUDA 引入正式的拓扑查询接口。
cuda
// 假设性的标准化 API
cudaGetDeviceTopology(&topo);           // 返回 GPC/SM/Partition 图
cudaGetNUMAPartitionId(ptr);            // 查询内存所在分区
cudaMallocLocal(void** ptr, size_t s, int partition); // 本地分区分配
cudaMemAdvise(ptr, s, cudaMemAdviseSetReadMostly, partition);推动力量:
- 云厂商(AWS、Azure、Google):他们运营着数十万 GPU,任何效率提升都是真金白银。他们有动力推动标准化来降低自己的调度复杂度。
- 框架层(PyTorch、DeepSpeed):需要统一接口来支持多代 GPU。
阻碍力量:
- NVIDIA:一旦标准化,就等于承认"物理不对称性是长期存在的架构特征",削弱黑箱优势。
- 碎片化:AMD、Intel、Groq 等厂商的拓扑结构不同(论文附录 G 显示 AMD 是三级延迟而非两级),跨厂商标准化极难。
路径 D:编译器 / 静态分析自动化(学术前沿,中期可能)
形式:类似 Halide / TVM 的自动调度器,将拓扑作为约束输入。
# TVM-style schedule
sch = tvm.create_schedule(...)
sch.partition_numa(topo_map) # 自动插入数据放置和 SM 绑定论文中的方法本身就适合自动化:
- 探测是纯软件、纯运行时的(< 1 分钟)
- 优化策略是规则化的(本地分配、比例分区、cluster 对齐)
这意味着可以做一个 "CUDA 拓扑优化 pass",在编译期或启动期自动完成论文中的优化,无需手写。
三、规范化的演进判断
| 时间尺度 | 最可能的标准化形式 | 标志事件 |
|---|---|---|
| 现在 ~ 1 年 | 闭源集成:NVIDIA 在驱动/CUTLASS 中静默优化,不暴露接口 | Nsight Compute 新指标出现 "NUMA Local Hit %" |
| 1 ~ 3 年 | 库级事实标准:FlashAttention、vLLM 等集成不对称感知策略,形成 best practice | vLLM 合并 numa-aware-placement PR |
| 3 ~ 5 年 | 半标准 API :CUDA 引入 cudaDeviceGetTopology 等查询接口(但控制接口仍受限) |
CUDA 版本 release notes 提到 "topology awareness" |
| 5 年以上 | 行业标准:类似 OpenMP / MPI,异构计算标准(如 SYCL、OpenCL Next)纳入拓扑抽象 | UXL 基金会或 Khronos 发布标准草案 |
四、关键变量:谁将推动标准化?
1. 云厂商(最强推动力)
AWS/Azure/GCP 正在从 "卖 GPU 小时" 转向 "卖 Token 吞吐量"。
- 如果 NUMA 感知能让同样数量的 GPU 多服务 14% 的请求,云厂商每年节省数亿美元。
- 他们有能力 fork CUDA runtime、fork PyTorch,甚至像论文一样直接改驱动。
- 路径:先在内部实现 → 形成工具链 → 反哺开源 → 迫使 NVIDIA 标准化。
2. 大模型厂商(需求拉动)
OpenAI、Anthropic、DeepSeek 等运营超大规模集群。
- 他们在 kernel 层面有深度定制能力(如 FlashAttention 本身就是从研究到产品的范例)。
- 如果他们证明"不对称感知是训推一体化的必要优化",会形成行业压力。
3. NVIDIA(被动标准化)
NVIDIA 最希望的是**"我们做在闭源里,但不暴露"**。
- 但一旦开源方案(如这篇论文的代码)普及,NVIDIA 为了夺回控制权,反而可能主动推出官方 API。
- 历史先例:NVIDIA 最初抵制 GPUDirect,后来主动标准化。
4. 监管机构 / 反垄断(长尾变量)
如果 GPU 成为关键基础设施,"硬件黑箱"可能被质疑为反竞争(类似 Intel 的 x86 指令集争议)。
- 要求暴露拓扑信息作为互操作性条件?
- 目前还很遥远,但不能排除。
五、结论:产品化是确定的,规范化是渐进的
产品化(技术落地) :高度确定
无论 NVIDIA 是否官方支持,云厂商和框架层都会把这类优化做进生产系统。论文中的方法足够轻量(< 1 分钟探测、无需改 kernel),落地门槛很低。
规范化(接口标准) :渐进且博弈化不会有一个 "CUDA NUMA API 1.0" 突然发布。更可能是:
- 先在头部开源框架中形成事实标准(如 vLLM 的某种配置格式)
- NVIDIA 在 Nsight / driver 中提供非正式查询接口
- 最终在某个 CUDA 大版本中以 "性能提示(hint)" 的形式半官方化
对开发者的建议:
- 现在:无需担心,继续按 CUDA 文档写代码
- 1-2 年内:如果使用 vLLM / SGLang 做 LLM serving,关注其是否引入拓扑感知放置选项
- 3-5 年:如果做 GPU 虚拟化或多租户调度,可能需要将 SM 拓扑探测作为基础设施的一环
这篇论文的真正意义,可能不在于具体技术,而在于证明了"不对称性感知"的收益大到不容忽视------这会改变整个生态的优化焦点。