-1. 代码逻辑主线
针对 https://github.com/NVIDIA-DOCA/gpunetio/tree/main/examples/gpunetio_verbs_put_bw/
把服务器端和客户端,两端的核心逻辑分别提炼如下。
-1.1. 服务器端逻辑提炼(被动方)
概括:分配可被远端写的内存 → 把"钥匙"交给客户端 → 空转等待 → 校验数据。
执行流程(verbs_server())
① create_verbs_resources(cfg, &resources)
     └─ 打开本机 mlx5 网卡 + GPU 设备,创建 PD / CQ / QP(RC 模式)

② create_local_memory_object(&resources)
     └─ 对 16 档消息大小(1B~1MB):
         · calloc 分配 CPU 内存 buffer(大小 = 512线程 × 消息大小),清零
         · ibv_reg_mr 注册 MR,权限含 REMOTE_WRITE
         → 得到 16 组 (buffer地址, rkey)

③ oob_verbs_connection_server_setup()
     └─ socket + bind(INADDR_ANY:2000) + listen + accept
         → 阻塞等待客户端 TCP 连入,获得 conn_socket

④ exchange_params_with_remote_peer(&resources)
     └─ 通过 TCP:
         · 主动发送 16 组 (addr, rkey) 给客户端
         · 双向交换 QPN / GID / LID

⑤ connect_verbs_qp(&resources)
     └─ 用对端信息把 QP 状态机推到 RTS,RDMA 链路就绪

⑥ signal(SIGINT/SIGTERM, handler) + while(!server_force_quit);
     └─ ★ 测试全程空转------单边 RDMA WRITE 无需服务器参与
         退出完全依赖用户 Ctrl-C

⑦ server_validate_test(&resources)
     └─ 逐字节校验:第 idx 档 buffer 每字节应 == idx+1

⑧ 清理:dereg MR → free buffer → 销毁 QP/CQ/PD → 关 socket
关键特征
- 数据路径零参与:不 post receive、不 poll CQ、不发任何 RDMA 操作;
- 唯一"产出"是给客户端的 (addr, rkey);
- 唯一"验证"是结束时的内存内容比对;
- 退出方式是人工 Ctrl-C(无完成通知协议)。
-1.2. 客户端逻辑提炼(主动方)
概括:GPU 显存备好数据源 → 拿到服务器"钥匙" → 把 QP 交给 GPU kernel → CUDA 线程直接发 RDMA WRITE 并计时打表。
执行流程(verbs_client())
① create_verbs_resources(cfg, &resources)
     └─ 同服务器:建 PD/CQ/QP,另记录 nic_handler、exec_scope

② create_local_memory_object(&resources)
     └─ 对 16 档消息大小:
         · doca_gpu_mem_alloc 分配 GPU 显存 buffer
         · cudaMemset 填特征值 idx+1(供服务器校验)
         · GPUDirect 注册:优先 ibv_reg_dmabuf_mr,失败回退 ibv_reg_mr(nvidia-peermem)

③ oob_verbs_connection_client_setup(server_ip, &conn_socket)
     └─ TCP connect 到服务器(-c 参数):2000

④ exchange_params_with_remote_peer(&resources)
     └─ 接收服务器 16 组 (remote_addr, remote_rkey) + 交换 QPN/GID/LID

⑤ connect_verbs_qp(&resources)   → QP 推到 RTS

⑥ 准备 GPU 执行环境
     ├─ cudaStreamCreateWithFlags(cudaStreamNonBlocking)
     ├─ cuEventCreate(e_start, e_end)        ← kernel 计时
     ├─ doca_gpu_verbs_get_qp_dev() → qp_gpu  ← ★ 把 QP 导出为 GPU 设备侧句柄
     └─ 若 CPU_PROXY 模式:pthread 起一个代敲 Doorbell 的伴生线程

⑦ 主测试循环:for idx in 16 档消息大小
     ├─ gpunetio_verbs_put_bw(...)          ← warmup 一次
     ├─ cudaStreamSynchronize
     ├─ cuEventRecord(e_start)
     ├─ gpunetio_verbs_put_bw(...)          ← 正式测试
     ├─ cuEventRecord(e_end) → Synchronize → ElapsedTime → et_ms
     └─ 计算并打印:BW[Gbps] = size×iters×8/et_ms/1e9;MsgRate[Mpps]

⑧ 清理:停 proxy 线程 → 销毁 event/stream → dereg MR → 释放显存 → 关连接
GPU kernel 逻辑(put_bw,真正发数据的地方)
每个 CUDA 线程(全局编号 tidx):
  for idx = tidx; idx < num_iters; idx += 总线程数   ← grid-stride 均摊迭代
      ① doca_gpu_dev_verbs_put(qp_gpu,
             远端 = {remote_buf + size*tidx, rkey},     ← 写到服务器哪
             本地 = {gpu_buf  + size*tidx, lkey},       ← 从显存哪读
             size) → out_ticket
         即:GPU 线程直接组 WQE(RDMA_WRITE) + 敲 Doorbell
      ② poll CQ 确认完成:
         THREAD 模式 → 每线程 poll 自己的 ticket
         WARP  模式 → lane0 只 poll 全 warp 最后一张 ticket(批量确认)
      ③ __syncthreads()  ← 流控,防止 SQ 被打爆
关键特征
- CPU 只在控制路径(建链、计时、打表),数据路径全在 GPU;
- 每线程私有数据区(
+ size*tidx偏移)→ 天然无锁并发; - lkey/rkey 均
htobe32转大端(WQE 网络字节序要求); - 每档先 warmup 再正式测,CUDA event 精确计时。
-1.3. 两端对照一览
| 阶段 | 服务器端 | 客户端 |
|---|---|---|
| 内存 | CPU calloc,清零 | GPU 显存,填 idx+1 |
| MR 权限用途 | 被远端写(REMOTE_WRITE) | 被网卡读(GPUDirect DMA) |
| TCP 角色 | listen/accept,发 addr+rkey | connect,收 addr+rkey |
| QP→RTS | connect_verbs_qp | connect_verbs_qp |
| 测试中 | 空转(while 等 Ctrl-C) |
GPU kernel 发 WRITE + poll CQE |
| 完成机制 | 无(单边操作不感知) | 本地 CQE ticket 轮询 |
| 输出 | Ctrl-C 后校验结果 | 16 档 BW/Mpps 表格 |
| 退出 | 信号驱动 | 跑完自动退出 |
0. 运行example
0.1. 启动服务器端:
在终端1中,运行服务器端:
ruler@ruler-Super-Server:~/ex_latency_qlink/tmp01/local/lib$ ls
libdoca_gpunetio_host.so libdoca_gpunetio_host.so.4 libdoca_gpunetio_host.so.4.0.1
ruler@ruler-Super-Server:~/ex_latency_qlink/tmp01/local/lib export LD_LIBRARY_PATH=PWD
bash
#转入 gpunetio lib 的安装目录:

cd ruler@ruler-Super-Server:~/ex_latency_qlink/tmp01/local/lib
export LD_LIBRARY_PATH=$PWD
# 运行服务器端
DOCA_GPUNETIO_LOG=6 ./gpunetio_verbs_put_bw -g 41:00.0 -d mlx5_0
等待;
0.2. 运行客户端:
在终端2中,运行客户端,通过 -c 参数,既说明本进程是客户端,同时 -c 后边跟着 服务器端 IP 地址,即服务器上参与 RDMA 通信的 RoCE 网卡的 IP 地址:
bash
cd ruler@ruler-Super-Server:~/ex_latency_qlink/tmp01/local/lib
export LD_LIBRARY_PATH=$PWD
cd ../examples/
DOCA_GPUNETIO_LOG=6 ./gpunetio_verbs_put_bw -g 41:00.0 -d mlx5_0 -c 192.168.0.101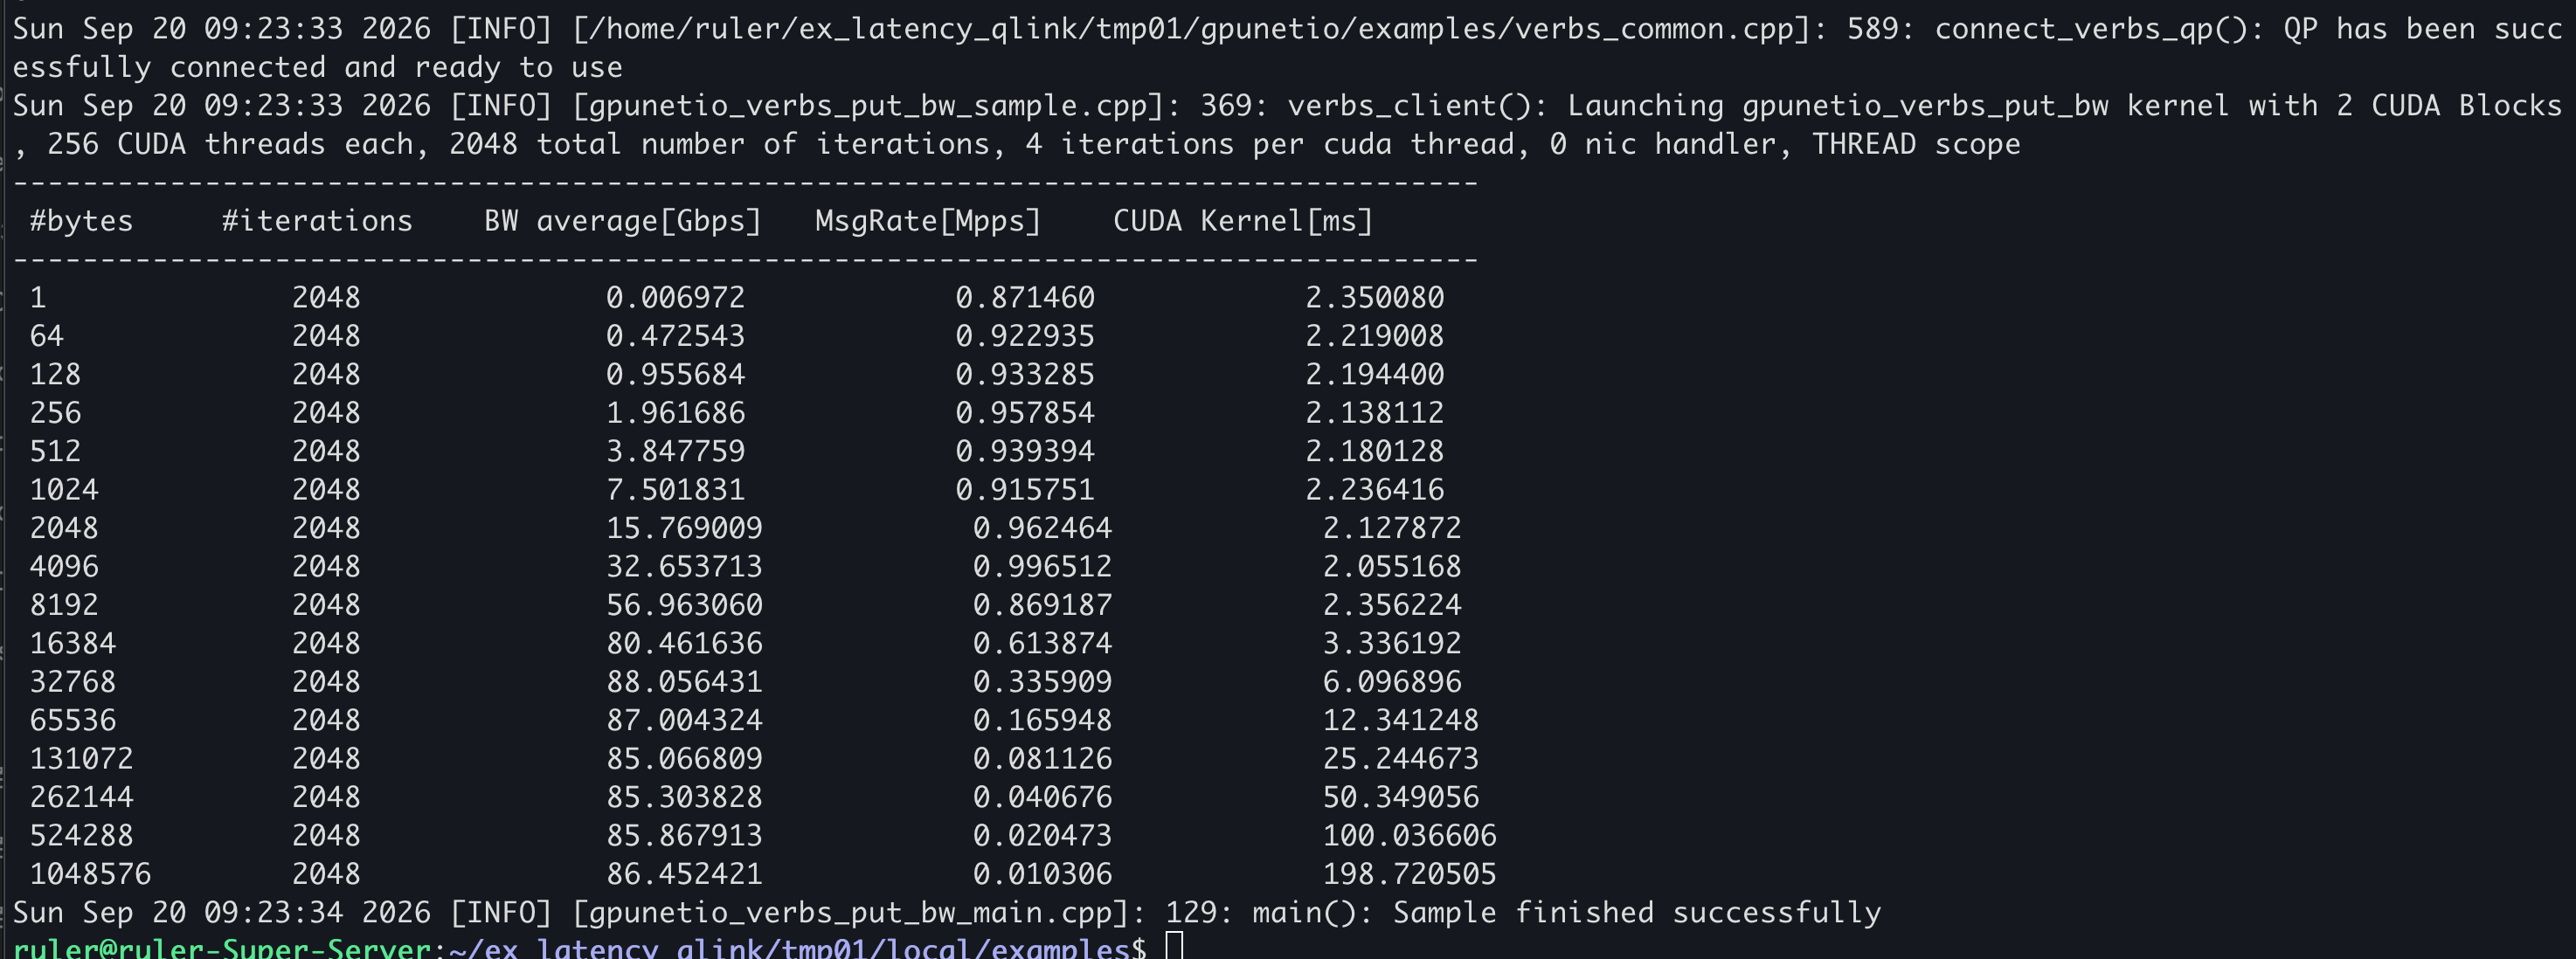
0.3. 参数解析
-g 和 -d 永远指运行该命令的本机自己的设备------在哪台机器上启动,就填哪台机器的 GPU 和网卡。
B 机器(服务器端)启动时:
bash
# 在 B 上执行
sudo ./gpunetio_verbs_put_bw \
    -d mlx5_0 \        # B 机器自己的 RDMA 网卡(在 B 上跑 ibv_devices 查到的名字)
    -g 17:00.0 \       # B 机器自己的 GPU PCIe 地址(在 B 上跑 nvidia-smi topo -m 查到)
    -l 3
A 机器(客户端)启动时:
bash
# 在 A 上执行
sudo ./gpunetio_verbs_put_bw \
    -c 192.168.100.2 \ # 这是 B 的 IP------整个命令行里唯一一个"对端"信息
    -d mlx5_0 \        # A 机器自己的网卡
    -g af:00.0 \       # A 机器自己的 GPU PCIe 地址
    -l 3
几个要点
-
整个命令行中,唯一涉及对端的参数就是客户端的
-c <服务器IP>。-d、-g、-l全是本机资源,两端可以完全不同:- A 的网卡可以叫
mlx5_0,B 的可以叫mlx5_2; - A 的 GPU 可以在
af:00.0,B 的可以在17:00.0; - 两端的 GID index 也可以不同(只要各自选对 RoCEv2 的那个)。
- A 的网卡可以叫
-
为什么服务器也要
-g? 虽然这个例子里服务器的数据 buffer 用的是 CPU 内存(calloc),但两端的 QP 都是通过 GPUNetIO verbs 的公共代码(create_verbs_resources)创建的,该函数会用-g指定的 PCIe 地址打开本机 GPU、初始化doca_gpu上下文。所以服务器端同样要填B 自己的 GPU,不能省略或乱填。 -
查询方法(各自在本机执行):
bashibv_devices # 查 -d 用的网卡名 nvidia-smi topo -m # 查 -g 用的 GPU PCIe 地址(左上角 GPU 行对应的 bus id) ls /sys/bus/pci/devices/ | grep -i nvidia # 备选
总结:-d = 本机网卡,-g = 本机 GPU,-c(仅客户端)= 对端 IP。
1. gpunetio_verbs_put_bw
这个示例共 3 个源文件:gpunetio_verbs_put_bw_main.cpp(入口/参数解析,通过-c 参数来确定为 客户端)、gpunetio_verbs_put_bw_sample.cpp(客户端与服务器端主逻辑)、gpunetio_verbs_put_bw_kernel.cu(GPU 侧 CUDA kernel)。下面先讲整体架构,再分别解析两端行为并逐行注释。
1.1. gpunetio_verbs_put_bw 的工作
gpunetio_verbs_put_bw 是一个 GPU 发起的单边 RDMA WRITE(PUT)带宽压测 程序,类似 perftest 里的 ib_write_bw,区别在于:
- 客户端 :RDMA Queue Pair(QP)和 Completion Queue(CQ)被"导出"到 GPU 显存,由 CUDA kernel 里的 GPU 线程直接构造 WQE、敲 Doorbell、轮询 CQE(GPUNetIO / GDRCopy 类技术),CPU 只负责建链和计时,完全不在数据路径上。
- 服务器端 :纯粹是被动接收方。它分配一块 CPU 内存注册成 MR,把地址和 rkey 通过 TCP 带外(OOB)通道发给客户端,然后空转等待------RDMA WRITE 是单边操作,服务器的 CPU/NIC 软件栈零参与,最后只做数据校验。
一次运行覆盖 16 种消息大小(1B → 1MB),每个大小先 warmup 再正式测,输出带宽(Gbps)和消息速率(Mpps)。
                TCP (OOB, 交换 addr/rkey/QPN/GID/LID)
   Server ═══════════════════════════════════════ Client
   (CPU buf)  ◄══════ RDMA WRITE (单边PUT) ══════  GPU kernel 直接发包
     被动收        NIC ◄──── PCIe ──── GPU 显存
1.2. 入口:main.cpp 逐行注释
cpp
int main(int argc, char **argv) {
    struct verbs_config verbs_cfg;          // 配置结构体(is_server、设备名、迭代数等)
    doca_error_t status;
    int exit_status = EXIT_FAILURE;
    int option;

    /* 默认配置 */
    verbs_cfg.is_server = true;             // 默认以服务器模式运行
    verbs_cfg.gid_index = DEFAULT_GID_INDEX;// RoCE 的 GID 索引(选 IP 版本/优先级)
    verbs_cfg.num_iters = NUM_ITERS;        // 每种消息大小的迭代次数,默认 2048
    verbs_cfg.cuda_threads = CUDA_THREADS_BW; // CUDA 线程总数(带宽测试默认值)
    verbs_cfg.nic_handler = DOCA_GPUNETIO_VERBS_NIC_HANDLER_AUTO; // Doorbell 由谁敲:自动
    verbs_cfg.exec_scope = DOCA_GPUNETIO_VERBS_EXEC_SCOPE_THREAD; // GPU 提交粒度:每线程

    while ((option = getopt(argc, argv, "c:d:e:g:i:l:p:")) != -1) {
        switch (option) {
            case 'c': {                     // -c <server_ip>:带此参数即为客户端
                verbs_cfg.server_ip_addr = optarg;
                verbs_cfg.is_server = false;
                break;
            }
            case 'd': {                     // -d mlx5_X:指定 RDMA 网卡
                verbs_cfg.nic_device_name = optarg;
                break;
            }
            case 'e': {                     // -e 执行范围:0=THREAD(每线程独立收发)
                int exec_scope = std::atoi(optarg);   // 1=WARP(整个 warp 协作)
                if (exec_scope != DOCA_GPUNETIO_VERBS_EXEC_SCOPE_THREAD &&
                    exec_scope != DOCA_GPUNETIO_VERBS_EXEC_SCOPE_WARP) {
                    DOCA_LOG(LOG_ERR, "Exec policy must be included between 0 and 2");
                    return 1;
                }
                verbs_cfg.exec_scope = (enum doca_gpu_dev_verbs_exec_scope)exec_scope;
                break;
            }
            case 'g': {                     // -g <GPU PCIe 地址>,如 03:00.0
                verbs_cfg.gpu_pcie_addr = optarg;
                break;
            }
            case 'i': {                     // -i 迭代次数,必须是 CUDA 线程数的整数倍
                verbs_cfg.num_iters = std::atoi(optarg);
                if ((verbs_cfg.num_iters % verbs_cfg.cuda_threads) != 0) { ... return 1; }
                break;
            }
            case 'l': {                     // -l GID 索引
                verbs_cfg.gid_index = std::atoi(optarg);
                break;
            }
            case 'p': {                     // -p NIC handler:0 AUTO / 1 CPU_PROXY /
                verbs_cfg.nic_handler = ...std::atoi(optarg);  // 2 GPU_SM_DB / 6 GPU_BF
                if (verbs_cfg.nic_handler == DOCA_GPUNETIO_VERBS_NIC_HANDLER_GPU_SM_BF) {
                    // 本示例不支持 BlueFlame 模式(GPU 直接写 BF 寄存器)
                    DOCA_LOG(LOG_ERR, "NIC handler BlueFlame not supported in this example");
                    return 1;
                }
                break;
            }
            default: ... /* 打印 Usage */
        }
    }

    if (verbs_cfg.is_server) {
        status = verbs_server(&verbs_cfg);  // 服务器路径(下文第四节)
        ...
    } else {
        status = verbs_client(&verbs_cfg);  // 客户端路径(下文第五节)
        ...
    }
    ...
}关键分叉就一个:不带 -c 就是 server,带 -c 就是 client,两端跑同一个二进制。
1.3. 两端共用的铺垫逻辑(sample.cpp 前半部分)
1.3.1 全局变量与报表格式
cpp
cudaStream_t cstream = NULL;                 // 客户端用的 CUDA stream
int message_size[NUM_MSG_SIZE] = {1, 64, 128, 256, 512, 1024, 2048, 4096,
                                  8192, 16384, 32768, 65536, 131072, 262144,
                                  524288, 1048576};  // 16 档消息大小
volatile bool server_force_quit = false;     // 服务器退出标志(信号处理器置位)
1.3.2 本地内存对象创建 create_local_memory_object() ------ 两端行为在此分叉
这是理解两端差异的核心函数:
cpp
static doca_error_t create_local_memory_object(struct verbs_resources *resources) {
    size_t host_page_size = get_page_size();
    ...
    for (int idx = 0; idx < NUM_MSG_SIZE; idx++) {     // 每种消息大小各建一个 buf+MR
        resources->data_mr[idx] = NULL;
        size = (size_t)(resources->cuda_threads * message_size[idx]);
        // 每个 CUDA 线程独占 message_size[idx] 字节,互不重叠 → 无需同步即可并发写
        ALIGN_SIZE(size, host_page_size);              // 按页对齐(注册 MR 需要)

        if (resources->cfg->is_server) {
            // ===== 服务器端:数据落在 CPU 内存 =====
            resources->data_buf[idx] = (uint8_t *)calloc(size, 1); // 分配并清零
            memset(resources->data_buf[idx], 0, size);
        } else {
            // ===== 客户端:数据落在 GPU 显存 =====
            status = doca_gpu_mem_alloc(resources->gpu_dev, size, host_page_size,
                                        DOCA_GPU_MEM_TYPE_GPU,
                                        (void **)&(resources->data_buf[idx]), NULL);
            cudaMemset(resources->data_buf[idx], idx + 1, size);
            // 源缓冲区按档位填 idx+1(第 0 档全填 1,第 1 档全填 2......)
            // → 服务器端校验时就知道每个 buffer 应该是什么值

            /* GPU 显存注册给网卡:优先走 dmabuf(新内核机制) */
            status = doca_gpu_get_dmabuf_fd(resources->gpu_dev, resources->data_buf[idx],
                                            size, &dmabuf_fd);
            if (status == DOCA_SUCCESS) {
                resources->data_mr[idx] = ibv_reg_dmabuf_mr(
                    resources->verbs_pd, 0, size, (uint64_t)resources->data_buf[idx],
                    dmabuf_fd,
                    IBV_ACCESS_LOCAL_WRITE | IBV_ACCESS_REMOTE_WRITE
                    | IBV_ACCESS_RELAXED_ORDERING);   // 允许网卡本地写/远端写/乱序
            }
        }

        if (resources->data_mr[idx] == NULL) {
            // 兜底:dmabuf 失败则走传统 ibv_reg_mr(GPU 显存时依赖 nvidia-peermem;
            // 服务器端 CPU 内存天然走这里)
            resources->data_mr[idx] = ibv_reg_mr(
                resources->verbs_pd, resources->data_buf[idx], size,
                IBV_ACCESS_LOCAL_WRITE | IBV_ACCESS_REMOTE_WRITE
                | IBV_ACCESS_RELAXED_ORDERING);
        }
        if (resources->data_mr[idx] == NULL) { ... goto exit_error; }
    }
    return DOCA_SUCCESS;
}注意这里体现的架构差异:
- 服务器 的 buffer 是
calloc出来的普通 CPU 内存------它是 RDMA WRITE 的目标 (被远端写),所以给了IBV_ACCESS_REMOTE_WRITE。 - 客户端 的 buffer 在 GPU 显存------它是 WRITE 的源,且需要 GPUDirect RDMA(dmabuf 或 nvidia-peermem)让网卡能直接 DMA 读显存。
1.3.3 带外参数交换 exchange_params_with_remote_peer()
RDMA 建链前必须通过 TCP socket 交换对端信息:
cpp
static doca_error_t exchange_params_with_remote_peer(struct verbs_resources *resources) {
    if (resources->cfg->is_server) {
        // 服务器主动发送:16 个 buffer 各自的 (地址, rkey)
        // ------客户端 RDMA WRITE 需要知道"往哪写、用什么钥匙"
        for (int idx = 0; idx < NUM_MSG_SIZE; idx++) {
            uint64_t local_addr = (uint64_t)resources->data_buf[idx];
            send(resources->conn_socket, &local_addr, sizeof(uint64_t), 0);
            send(resources->conn_socket, &resources->data_mr[idx]->rkey, sizeof(uint32_t), 0);
        }
    } else {
        // 客户端接收:存到 remote_data_buf[] / remote_data_mkey[],
        // 之后作为 kernel 里 put 操作的远端地址参数
        for (int idx = 0; idx < NUM_MSG_SIZE; idx++) {
            recv(resources->conn_socket, &resources->remote_data_buf[idx], ...);
            recv(resources->conn_socket, &resources->remote_data_mkey[idx], ...);
        }
    }

    // 双向交换 QP 号、GID(RoCE 路由用)、LID(IB 路由用),用于把 QP 状态机推到 RTS
    send(..., &resources->local_qp_number, ...);  recv(..., &resources->remote_qp_number, ...);
    send(..., &resources->gid.raw, ...);          recv(..., &resources->remote_gid.raw, ...);
    send(..., &resources->lid, ...);              recv(..., &resources->dlid, ...);
    return DOCA_SUCCESS;
}
1.4. 服务器端行为解析
1.4.1 服务器做了什么、没做什么
| 阶段 | 行为 |
|---|---|
| 初始化 | 创建 PD/CQ/QP 等 verbs 资源(create_verbs_resources);分配 CPU 内存并注册 MR(给远端写权限) |
| 建链 | 监听 TCP,接受客户端连接;把自己的 buf 地址 + rkey 发给客户端;交换 QPN/GID/LID;connect_verbs_qp 把 QP 推到 RTS |
| 测试期间 | 什么都不做 ------while (server_force_quit == false); 空转。RDMA WRITE 是单边操作,数据由客户端 GPU 主动推过来,网卡硬件直接 DMA 进服务器内存 |
| 结束 | 用户 Ctrl-C 后逐字节校验数据是否正确,然后清理资源 |
⚠️ 一个值得注意的设计:服务器没有任何"测试完成"的通知机制,靠用户观察客户端输出结束后按 Ctrl-C 退出,退出前顺手做数据校验。
1.4.2 verbs_server() 逐行注释
cpp
doca_error_t verbs_server(struct verbs_config *cfg) {
    doca_error_t status = DOCA_SUCCESS, tmp_status = DOCA_SUCCESS;
    struct verbs_resources resources = {0};  // 资源大杂烩:PD/QP/CQ/MR/socket 等
    int server_sock_fd = -1;

    resources.conn_socket = -1;
    resources.num_iters = cfg->num_iters;        // 校验时要知道每个 buffer 多大
    resources.cuda_threads = cfg->cuda_threads;  // 同上:buf 大小 = 线程数 × 消息大小
    resources.enable_umem_cpu = false;

    /* 1. 建 verbs 基本资源:打开 mlx5 设备、分配 PD、建 CQ、建 QP(RC 模式) */
    status = create_verbs_resources(cfg, &resources);
    if (status != DOCA_SUCCESS) { ...; return status; }

    /* 2. 分配 16 个 CPU buffer 并注册 MR(见 3.2 服务器分支) */
    status = create_local_memory_object(&resources);
    if (status != DOCA_SUCCESS) { ...; goto server_cleanup; }

    /* 3. TCP 带外通道:socket/bind/listen/accept,阻塞等客户端连入 */
    ret = oob_verbs_connection_server_setup(&server_sock_fd, &resources.conn_socket);
    if (ret != 0) { ...; goto server_cleanup; }

    /* 4. 通过 TCP 发送 16 组 (buf_addr, rkey),交换 QPN/GID/LID */
    status = exchange_params_with_remote_peer(&resources);
    if (status != DOCA_SUCCESS) { ...; goto server_cleanup; }

    /* 5. 用对端 QPN/GID/LID 把 QP 状态机 RESET→INIT→RTR→RTS,RDMA 链路就绪 */
    status = connect_verbs_qp(&resources);
    if (status != DOCA_SUCCESS) { ...; goto server_cleanup; }

    /* 6. 注册信号处理器:Ctrl-C / kill 时优雅退出 */
    server_force_quit = false;
    signal(SIGINT, signal_handler);
    signal(SIGTERM, signal_handler);

    /* 7. 测试期间服务器空转------RDMA WRITE 单边完成,无需服务器任何参与。
          唯一的"退出"方式是用户看到客户端打完后按 Ctrl-C */
    while (server_force_quit == false);

    /* 8. 校验收到的数据:第 idx 个 buffer 的每个字节都应等于 idx+1 */
    status = server_validate_test(&resources);
    if (status != DOCA_SUCCESS) DOCA_LOG(LOG_ERR, "Server data validation failed");

server_cleanup:
    /* 9. 清理:注销 MR、释放内存、销毁 QP/CQ/PD、关 socket */
    tmp_status = destroy_local_memory_objects(&resources);
    tmp_status = destroy_verbs_resources(&resources);
    oob_verbs_connection_server_close(server_sock_fd, resources.conn_socket);
    return status;
}
配套的两个小函数:
cpp
/* 数据校验:客户端把第 idx 档的源 buffer 全部填成 idx+1,
   所以服务器收到的第 idx 个 buffer 每字节都该等于 idx+1 */
static doca_error_t server_validate_test(struct verbs_resources *resources) {
    for (int idx = 0; idx < NUM_MSG_SIZE; idx++) {
        for (int pos = 0; pos < (int)resources->cuda_threads * message_size[idx]; pos++) {
            if (resources->data_buf[idx][pos] != (idx + 1)) {
                DOCA_LOG(LOG_ERR, "Validation error: buffer %d pos %d ...", ...);
                return DOCA_ERROR_BAD_STATE;
            }
        }
    }
    DOCA_LOG(LOG_WARNING, "Validation successfull! Data received correctly from client");
    return DOCA_SUCCESS;
}

/* 信号处理:置退出标志,主循环下一轮就会跳出 */
static void signal_handler(int signum) {
    if (signum == SIGINT || signum == SIGTERM) {
        DOCA_LOG(LOG_INFO, "Signal %d received, preparing to exit!", signum);
        server_force_quit = true;
    }
}
1.5. 客户端行为解析
1.5.1 客户端是"真正干活"的一端
| 阶段 | 行为 |
|---|---|
| 初始化 | 建 verbs 资源 + GPU 显存分配 16 个源 buffer(各填特征值 idx+1),经 GPUDirect RDMA 注册给网卡 |
| 建链 | TCP 连服务器;接收服务器的 16 组 (addr, rkey) 作为 RDMA WRITE 的目的地;交换 QPN/GID/LID;QP 推 RTS |
| 测试 | 把 QP 导出成 GPU 设备侧句柄 qp_gpu;对每种消息大小:warmup 一次 → 正式跑一次,用 CUDA event 精确测 kernel 耗时,算出 Gbps / Mpps 打表 |
| 收尾 | 停 CPU proxy 线程(如有)、销毁 event/stream、清理资源 |
1.5.2 verbs_client() 逐行注释
cpp
doca_error_t verbs_client(struct verbs_config *cfg) {
    struct verbs_resources resources = {0};
    CUevent e_start = NULL, e_end = NULL;   // CUDA event,用于给 kernel 计时
    float et_ms = 0.0f;
    const unsigned long num_messages = cfg->num_iters * NUM_QP; // 每种大小的总消息数
    pthread_t thread_id;                    // CPU proxy 模式下的轮询线程
    struct cpu_proxy_args args;
    struct doca_gpu_dev_verbs_qp *qp_gpu;   // QP 的 GPU 设备侧"影子"句柄

    resources.conn_socket = -1;
    resources.num_iters = cfg->num_iters;
    resources.cuda_threads = cfg->cuda_threads;
    resources.nic_handler = cfg->nic_handler;   // 谁敲 Doorbell:AUTO/CPU_PROXY/GPU_SM_DB
    resources.scope = (enum doca_gpu_dev_verbs_exec_scope)cfg->exec_scope; // THREAD/WARP
    resources.enable_umem_cpu = false;

    /* 1. 建 verbs 资源(含关联 GPU 设备 doca_gpu) */
    status = create_verbs_resources(cfg, &resources);
    ...

    /* 2. 分配 16 个 GPU 显存 buffer,填充特征值,dmabuf/reg_mr 注册(见 3.2 客户端分支) */
    status = create_local_memory_object(&resources);
    ...

    /* 3. TCP 主动连接服务器 */
    ret = oob_verbs_connection_client_setup(cfg->server_ip_addr.c_str(),
                                            &resources.conn_socket);
    ...

    /* 4. 收服务器的 (addr, rkey) × 16,交换 QPN/GID/LID */
    status = exchange_params_with_remote_peer(&resources);
    ...

    /* 5. QP 推到 RTS */
    status = connect_verbs_qp(&resources);
    ...

    /* 6. 创建非阻塞 CUDA stream(GPUNetIO 要求) */
    cuda_ret = cudaStreamCreateWithFlags(&cstream, cudaStreamNonBlocking);
    ...

    /* 7. 创建两个 CUDA event 用于 kernel 计时 */
    cu_result = cuEventCreate(&e_start, CU_EVENT_BLOCKING_SYNC);
    cu_result = cuEventCreate(&e_end, CU_EVENT_BLOCKING_SYNC);
    ...

    if (resources.qp == NULL) { ...; goto destroy_events; }

    DOCA_LOG(LOG_INFO, "Launching gpunetio_verbs_put_bw kernel with %d CUDA Blocks, ...", ...);

    /* 8. 若选 CPU_PROXY 模式:GPU 写 WQE 到内存,但 Doorbell 由这个 CPU 线程代敲
          (适用于网卡不支持 GPU 直通 Doorbell 的场景) */
    if (resources.nic_handler == DOCA_GPUNETIO_VERBS_NIC_HANDLER_CPU_PROXY) {
        args.qp_cpu = resources.qp->qp_gverbs;
        args.exit_flag = (uint64_t *)calloc(1, sizeof(uint64_t));
        *(args.exit_flag) = 0;
        int result = pthread_create(&thread_id, NULL, progress_cpu_proxy, (void *)&args);
        ...
    }

    /* 9. 打印表头 */
    printf(RESULT_LINE); printf(RESULT_FMT_G); printf("\n"); printf(RESULT_LINE);

    /* 10. 关键一步:把 CPU 侧 QP 导出为 GPU 设备侧对象。
           之后 kernel 里的 GPU 线程就能直接读写 SQ/CQ 的 doorbell record、WQE 区 */
    status = doca_gpu_verbs_get_qp_dev(resources.qp->qp_gverbs, &qp_gpu);
    ...

    /* 11. 主测试循环:16 档消息大小逐档测试 */
    for (int idx = 0; idx < NUM_MSG_SIZE; idx++) {

        /* 11a. Warmup:同一 kernel 先空跑一遍,预热 ICACHE / TLB / QP 流水线,
               也让服务器 buffer 被预先写入(保证后续校验有数据) */
        status = gpunetio_verbs_put_bw(
            cstream, qp_gpu,
            resources.num_iters,                       // 总迭代次数
            VERBS_CUDA_BLOCK,                          // block 数
            resources.cuda_threads / VERBS_CUDA_BLOCK, // 每 block 线程数
            message_size[idx],                         // 本档消息大小
            resources.data_buf[idx],                   // 本地 GPU 源地址
            htobe32(resources.data_mr[idx]->lkey),     // 本地 lkey(转大端,WQE 要求)
            (uint8_t *)(resources.remote_data_buf[idx]),   // 服务器目的地址
            htobe32(resources.remote_data_mkey[idx]),      // 服务器 rkey(大端)
            resources.scope);
        ...
        cudaStreamSynchronize(cstream);   // 等 warmup 完成

        /* 11b. 正式测试:event 打点 → 起 kernel → 打点 → 等结束 */
        cu_result = cuEventRecord(e_start, cstream);
        status = gpunetio_verbs_put_bw(cstream, qp_gpu, ... /* 参数同 warmup */);
        cu_result = cuEventRecord(e_end, cstream);
        cu_result = cuEventSynchronize(e_end);
        cu_result = cuEventElapsedTime(&et_ms, e_start, e_end);  // kernel 耗时(毫秒)

        /* 11c. 计算并打印结果
           bw(Gbps)   = 消息大小 × 总消息数 ÷ 耗时(ms→s) × 8 bit ÷ 1e9
           msgrate    = 总消息数 ÷ 耗时(ms→s) ÷ 1e6  → Mpps */
        double bw = (double)((double)((message_size[idx] * num_messages) / et_ms * 1000.0f) *
                             ((double)8.0) / BW_FORMAT_FACTOR);
        double msgrate = (double)(num_messages / et_ms * 1000.0f / 1000000.0f);
        printf(REPORT_FMT_EXT, message_size[idx], resources.num_iters, bw, msgrate, (double)et_ms);
        printf("\n");
    }

stop_thread:
    /* 12. 停 CPU proxy 线程:置退出标志 + join */
    if (resources.nic_handler == DOCA_GPUNETIO_VERBS_NIC_HANDLER_CPU_PROXY) {
        *((volatile uint64_t *)args.exit_flag) = 1;
        pthread_join(thread_id, NULL);
    }

destroy_events:
    /* 13. 销毁 CUDA 对象 */
    if (cstream != NULL) cudaStreamDestroy(cstream);
    if (e_start != NULL) cuEventDestroy(e_start);
    if (e_end != NULL) cuEventDestroy(e_end);

client_cleanup:
    /* 14. 关 TCP、注销 MR、释放 GPU 显存、销毁 verbs 资源 */
    oob_verbs_connection_client_close(resources.conn_socket);
    tmp_status = destroy_local_memory_objects(&resources);
    tmp_status = destroy_verbs_resources(&resources);
    return status;
}
1.6. CUDA kernel 逐行注释(只在客户端 GPU 上运行)
这是整个 example 的灵魂------网络 I/O 完全由 GPU 线程完成:
cpp
// scope 模板参数:THREAD(每线程独立完成一次 put+poll)或 WARP(一个 warp 协作)
template <enum doca_gpu_dev_verbs_exec_scope scope>
__global__ void put_bw(struct doca_gpu_dev_verbs_qp *qp,  // GPU 侧 QP(含 SQ/CQ/dbr 地址)
                       uint32_t num_iters, uint32_t data_size,
                       uint8_t *src_buf, uint32_t src_buf_mkey,   // 本地 GPU 源 + lkey
                       uint8_t *dst_buf, uint32_t dst_buf_mkey) { // 远端目的 + rkey
    doca_gpu_dev_verbs_ticket_t out_ticket;   // put 返回的"票号",之后按票号 poll CQE
    uint32_t lane_idx = doca_gpu_dev_verbs_get_lane_id();  // warp 内 lane 编号
    uint32_t tidx = threadIdx.x + (blockIdx.x * blockDim.x); // 全局线程号

    /* grid-stride 循环:num_iters 次迭代摊到所有线程,每次步进 gridDim×blockDim。
       由于 num_iters 是线程总数整数倍(main 中强制),每个线程分到相同迭代数 */
    for (uint32_t idx = blockIdx.x * blockDim.x + threadIdx.x; idx < num_iters;
         idx += (blockDim.x * gridDim.x)) {

        /* 核心:一次 RDMA WRITE(PUT)。
           GPU 线程直接:在 SQ 里写 WQE(RDMA_WRITE  opcode,含远端 addr/rkey、
           本地 addr/lkey、长度)→ 敲 Doorbell 通知网卡 → 网卡从 GPU 显存 DMA
           读出数据发向对端。CPU 全程不参与。
           - RESOURCE_SHARING_MODE_GPU:QP 专由 GPU 用
           - NIC_HANDLER_AUTO:自动选 Doorbell 提交方式
           - 每个线程写自己专属的 data_size 区域(src/dst 都按 tidx 偏移),无线程间冲突 */
        doca_gpu_dev_verbs_put<DOCA_GPUNETIO_VERBS_RESOURCE_SHARING_MODE_GPU,
                               DOCA_GPUNETIO_VERBS_NIC_HANDLER_AUTO, scope>(
            qp,
            doca_gpu_dev_verbs_addr{.addr = (uint64_t)(dst_buf + (data_size * tidx)),
                                    .key = (uint32_t)dst_buf_mkey},   // 远端地址 + rkey
            doca_gpu_dev_verbs_addr{.addr = (uint64_t)(src_buf + (data_size * tidx)),
                                    .key = (uint32_t)src_buf_mkey},   // 本地地址 + lkey
            data_size, &out_ticket);

        /* 完成轮询,两种 scope 二选一: */
        if (scope == DOCA_GPUNETIO_VERBS_EXEC_SCOPE_THREAD) {
            // THREAD 模式:每个线程 poll 自己那张票的 CQE,确认本次 WRITE 已被网卡取走完成
            if (doca_gpu_dev_verbs_poll_cq_at<
                    DOCA_GPUNETIO_VERBS_RESOURCE_SHARING_MODE_GPU>(qp, out_ticket) != 0) {
                // CQE 出错(非 0 状态),debug 时打印
            }
        }

        if (scope == DOCA_GPUNETIO_VERBS_EXEC_SCOPE_WARP) {
            // WARP 模式:整个 warp 32 线程协作提交,票号连续;
            // 只需 lane 0 poll 最后一张票(out_ticket + 31),
            // 其完成即隐含前 31 个也完成 → 减少 CQ 轮询开销
            if (lane_idx == 0) {
                if (doca_gpu_dev_verbs_poll_cq_at<
                        DOCA_GPUNETIO_VERBS_RESOURCE_SHARING_MODE_GPU>(
                        qp, out_ticket + DOCA_GPUNETIO_VERBS_WARP_SIZE - 1) != 0) {
                    // CQE 出错
                }
            }
        }

        __syncthreads();  // block 内同步,保证所有线程完成本轮后再进下一轮,
                          // 避免 SQ 被个别快线程冲爆(流控)
    }
}
kernel 启动封装(extern "C",供 sample.cpp 调用):
cpp
doca_error_t gpunetio_verbs_put_bw(cudaStream_t stream, struct doca_gpu_dev_verbs_qp *qp,
                                   uint32_t num_iters, uint32_t cuda_blocks,
                                   uint32_t cuda_threads, uint32_t data_size,
                                   uint8_t *src_buf, uint32_t src_buf_mkey,
                                   uint8_t *dst_buf, uint32_t dst_buf_mkey,
                                   enum doca_gpu_dev_verbs_exec_scope scope) {
    /* 先检查有无遗留 CUDA 错误,防止把旧错误算到本 kernel 头上 */
    result = cudaGetLastError(); ...

    /* 按 scope 选择模板实例化版本启动 kernel */
    if (scope == DOCA_GPUNETIO_VERBS_EXEC_SCOPE_THREAD)
        put_bw<DOCA_GPUNETIO_VERBS_EXEC_SCOPE_THREAD><<<cuda_blocks, cuda_threads, 0, stream>>>(
            qp, num_iters, data_size, src_buf, src_buf_mkey, dst_buf, dst_buf_mkey);
    else if (scope == DOCA_GPUNETIO_VERBS_EXEC_SCOPE_WARP)
        put_bw<DOCA_GPUNETIO_VERBS_EXEC_SCOPE_WARP><<<cuda_blocks, cuda_threads, 0, stream>>>(
            qp, num_iters, data_size, src_buf, src_buf_mkey, dst_buf, dst_buf_mkey);

    /* 检查启动本身是否出错(参数非法、资源不足等) */
    result = cudaGetLastError(); ...
    return DOCA_SUCCESS;
}
1.7. 两端行为对比总结
| 维度 | 服务器端 | 客户端 |
|---|---|---|
| 启动方式 | 不带 -c |
-c <server_ip> |
| 数据 buffer | CPU 内存(calloc),清零 | GPU 显存(doca_gpu_mem_alloc),按档填 idx+1 |
| 内存注册 | 普通 ibv_reg_mr,开放 REMOTE_WRITE |
优先 ibv_reg_dmabuf_mr(GPUDirect),失败回退 nvidia-peermem |
| OOB 角色 | TCP 服务端,发送 addr/rkey | TCP 客户端,接收 addr/rkey |
| 测试中角色 | 空转(单边操作零参与) | GPU kernel 直接发 RDMA WRITE 并 poll CQE |
| 计时/报表 | 无 | CUDA event 测 kernel 耗时,输出 Gbps/Mpps |
| 结束方式 | Ctrl-C → 校验数据 | 16 档跑完自动退出 |
几个设计要点值得记住:
- 每线程私有数据区 :
buf + data_size * tidx的偏移设计让所有 CUDA 线程的 RDMA 操作互不重叠,天然无锁。 - ticket 机制 :GPUNetIO 的
put异步返回票号,WARP 模式下只查最后一张票即可批量确认,这是warp 协作模式省 CQ 读开销的关键。 - 大端转换 :
htobe32(lkey/rkey)是因为 WQE 字段按网络字节序填写。 - 服务器无完成通知:这是单边 benchmark 的典型写法,代价是结束靠人工 Ctrl-C。
- CPU_PROXY 模式:当网卡/平台不支持 GPU 直敲 Doorbell 时,GPU 只写 WQE,由伴生 CPU 线程代敲 doorbell------这是 GPUNetIO 对硬件兼容性的兜底设计。
2. lkey 和 rkey 概述
lkey 和 rkey 都是注册内存区域(MR)时网卡返回的两把"钥匙",区别在于谁来用。结合这个 example 讲:
2.1. 基本概念
调用 ibv_reg_mr() / ibv_reg_dmabuf_mr() 注册一块内存后,返回的 struct ibv_mr 里有两个字段:
| 字段 | 全称 | 使用者 | 用途 |
|---|---|---|---|
lkey |
Local Key | 本机发起的操作 | 本机网卡访问这块内存的凭证 |
rkey |
Remote Key | 对端发起的单边操作 | 允许远端网卡读写这块内存的凭证 |
核心规则:
- 自己用自己的 lkey------任何 WQE 里引用的本地内存,都必须带本地 MR 的 lkey;
- rkey 要交给对方------别人想 RDMA READ/WRITE 你的内存,必须持有你的 rkey;
- rkey 同时承载了权限检查 :注册时给的
IBV_ACCESS_REMOTE_WRITE等 flag,决定了持 rkey 的远端能做什么操作。
2.2. 在本 example 中的具体流向
服务器端:注册 → 把 rkey 送出去
cpp
// 注册 CPU buffer,开放远端写权限 → 得到 mr->rkey
resources->data_mr[idx] = ibv_reg_mr(pd, buf, size,
    IBV_ACCESS_LOCAL_WRITE | IBV_ACCESS_REMOTE_WRITE | IBV_ACCESS_RELAXED_ORDERING);

// 通过 TCP 把 (buffer地址, rkey) 发给客户端
send(conn_socket, &local_addr, sizeof(uint64_t), 0);
send(conn_socket, &resources->data_mr[idx]->rkey, sizeof(uint32_t), 0);服务器从此不再使用这对 key------它不发起任何 RDMA 操作(lkey 用不上),rkey 的使命就是交给客户端。
客户端:收 rkey → 填进 WQE
cpp
// 收下来存着
recv(conn_socket, &resources->remote_data_buf[idx], ...);   // 远端地址
recv(conn_socket, &resources->remote_data_mkey[idx], ...);  // 远端 rkey

// 启动 kernel 时,两个 key 一起传进去
gpunetio_verbs_put_bw(...,
    resources.data_buf[idx],  htobe32(resources.data_mr[idx]->lkey),   // 本地:lkey
    remote_data_buf[idx],     htobe32(remote_data_mkey[idx]),          // 远端:rkey
    ...);
kernel 里:一次 put 同时用两把 key
cpp
doca_gpu_dev_verbs_put(qp,
    {.addr = dst_buf + ..., .key = dst_buf_mkey},   // ← 服务器的 rkey:授权"写到对方那"
    {.addr = src_buf + ..., .key = src_buf_mkey},   // ← 客户端自己的 lkey:授权"从我这读"
    data_size, &out_ticket);
最终生成的 RDMA WRITE WQE 里:
| WQE 字段 | 填的 key | 网卡动作 |
|---|---|---|
| 本地内存段(SGE) | 客户端的 lkey | 客户端网卡 DMA 读客户端显存 |
| 远端地址段 | 服务器的 rkey | 服务器网卡校验 rkey 权限后 DMA 写服务器内存 |
2.3. 为什么要分两把 key
- lkey 防本地错误:进程不能随便传个虚拟地址就让网卡 DMA------地址必须落在已注册的 MR 里且 key 匹配,防止越界访问和保护域(PD)间的串扰。
- rkey 防远端滥用:远端发起单边操作时,对端网卡硬件会检查 rkey 是否有效、对应地址范围是否覆盖本次访问、注册时是否给了 REMOTE_WRITE/READ 权限。没有 rkey 或权限不符,操作直接被网卡拒绝(产生 error CQE)。
- 解耦:一块内存可以只给远端读(只开放 REMOTE_READ)而不给写,权限模型清晰。
2.4. 本例中的两个细节
① 大端转换 :代码里两边都用了 htobe32(...):
cpp
htobe32(resources.data_mr[idx]->lkey)       // 本地 lkey
htobe32(resources.remote_data_mkey[idx])    // 远端 rkey
WQE 的字段按网络字节序(大端)填写,所以两个 key 进 WQE 前都要转换。
② 什么时候不需要 rkey :双边 SEND/RECV 操作只用 lkey(引用自己的收发 buffer),因为数据写到对端哪个 buffer 是由接收方预先 post 的 receive WQE 决定的,发起方无需知道对端 key。而本例是单边 PUT,发起方必须直接指定"远端地址 + rkey",这正是单边操作的标志性特征。
2.5. 总结
lkey 给自己用,rkey 给对方用;一次单边 RDMA WRITE,发起方的 WQE 里同时装着"自己的 lkey"(读哪)和"对端的 rkey"(写哪),两把钥匙分别由两端的网卡硬件校验。
3. lkey 和 rkey 详述
这个问题分两半:"如何使用"(软件层面怎么传递、填哪里)和**"如何验证"**(谁在什么时候检查、错了会怎样、怎么动手验证)。下面都结合本例讲。
3.1. 具体如何使用
3.1.1. 获取:注册 MR 的副产品
cpp
struct ibv_mr *mr = ibv_reg_mr(pd, buf, size,
        IBV_ACCESS_LOCAL_WRITE | IBV_ACCESS_REMOTE_WRITE | IBV_ACCESS_RELAXED_ORDERING);

uint32_t my_lkey = mr->lkey;   // 本机用
uint32_t my_rkey = mr->rkey;   // 给对端用
同一个 MR 同时产生两个 key。lkey/rkey 只在注册它的那个 PD(Protection Domain)内有效。
3.1.2. lkey 的使用:填进本地内存段(SGE)
任何 WQE 引用本地内存时,SGE(Scatter-Gather Entry)三要素是 {addr, length, lkey}:
本例客户端 put 的本地侧:  { gpu_buf + size*tidx,  size,  htobe32(lkey) }
双边 SEND 的本地 buffer: { recv_buf, size, lkey } ← 同样用 lkey规则:只要 WQE 碰到本机内存,就带本机 MR 的 lkey。
3.1.3. rkey 的使用:交换 + 填进远端地址段
注册方(服务器):ibv_reg_mr → rkey ──TCP带外──► 对端(客户端)
客户端:把 rkey 连同远端地址填进 WQE 的远端段:
        { remote_buf + size*tidx,  htobe32(rkey) }   ← 仅单边 READ/WRITE/ATOMIC 需要
注意:rkey 不能靠猜或计算 ,必须通过带外通道(TCP、RDMA CM、MPI 等)从对方那里拿到。这也是本例 exchange_params_with_remote_peer() 存在的唯一原因。
3.1.4. 字节序
WQE 按网络字节序填写,所以两个 key 进 WQE 前都要 htobe32()(本例客户端就是这么做的)。
3.2. 如何验证(校验机制)
lkey/rkey 的校验不在软件里,全部由网卡硬件(RNIC)在数据路径上完成,分两侧、四类检查:
3.2.1. 校验时机与主体
客户端发 WRITE:
  ┌─ 客户端网卡(校验 lkey)──────────────┐
  │ 处理 WQE 时,对本侧 SGE 检查:          │
  │  ① key 匹配:lkey 是否对应当前 PD 下某个有效 MR
  │  ② 范围:addr+len 是否完全落在 MR 注册区间内
  │  ③ 权限:该 MR 是否允许本地读(DMA 读默认允许,
  │         若 MR 注册时没给 LOCAL_WRITE 又被当写目标则拒)
  │  ④ 状态:MR 未被 dereg、PD 未销毁
  └────────────────────────────────────────┘
                    │ 网络上只传数据 + (远端addr, rkey)
                    ▼
  ┌─ 服务器网卡(校验 rkey)──────────────┐
  │ 数据包到达时检查:                      │
  │  ① key 匹配:rkey 是否对应本机有效 MR
  │  ② 范围:远端 addr+len 是否落在 MR 区间内
  │  ③ 权限:WRITE 操作要求 MR 注册时带
  │         IBV_ACCESS_REMOTE_WRITE(本例给了)
  │  ④ QP 状态、PSN 序列等链路层检查
└────────────────────────────────────────┘任何一项不过,本次操作被拒绝,后续行为见下。
3.2.2. 校验失败的后果
| 失败类型 | 产生什么 |
|---|---|
| lkey 错/越界/权限不足(本地侧) | 发起方收到 error CQE:IBV_WC_LOC_PROT_ERR |
| rkey 错/越界/权限不足(对端侧) | 发起方收到 error CQE:IBV_WC_REM_ACCESS_ERR(对端无任何 CQE------单边操作对端本来就不感知) |
| 任何 error CQE 出现后 | QP 进入 error 状态 ,之后 post 的所有 WQE 全部 flush(IBV_WC_WR_FLUSH_ERR),必须重建 QP |
本例 kernel 里的 doca_gpu_dev_verbs_poll_cq_at(...) != 0 检查的就是这个:非 0 即 CQE 带错误状态(示例里只在 ENABLE_DEBUG 时打印,生产代码应记录 status 字段)。
3.2.3. 动手验证实验(推荐,5 分钟见效)
在本例代码上改两处做对照实验:
实验 A:验证 rkey 校验------客户端把 rkey 故意改坏:
cpp
// verbs_client() 里,启动 kernel 前加一行
resources.remote_data_mkey[0] ^= 0x1;   // 篡改第 0 档的 rkey
预期现象:第 1 档(1B)测试时 poll_cq_at 返回非 0(REM_ACCESS_ERR),QP 崩溃,后续档位全部失败;服务器端数据校验报第 0 个 buffer 数据不对。
实验 B:验证权限检查------服务器注册时去掉写权限:
cpp
// create_local_memory_object() 服务器分支的 ibv_reg_mr 权限改为
IBV_ACCESS_LOCAL_WRITE   // 去掉 REMOTE_WRITE
预期:所有档位的 WRITE 都被服务器网卡拒绝,客户端全部 REM_ACCESS_ERR。
实验 C:验证范围检查------把远端地址偏移到 MR 之外:
cpp
(uint8_t *)(resources.remote_data_buf[idx]) + size // 越过一个 buffer 的边界预期:同样 REM_ACCESS_ERR(地址+长度超出 MR 注册区间)。
观察手段 :kernel 里打开 #define ENABLE_DEBUG 1 可以看到 "Error CQE!",或改用 CPU 侧 ibv_poll_cq 打印 ibv_wc_status_str(cqe.status) 拿到具体错误名。
3.2.4. 辅助认知:mlx5 上的一个常见巧合
在 Mellanox/NVIDIA 网卡上你会发现同一个 MR 的 lkey 和 rkey 数值往往相等 (硬件实现如此),但语义不同,不能互换依赖------跨厂商网卡时不保证相等,写代码时必须严格区分。
3.3. 总结
| lkey | rkey | |
|---|---|---|
| 怎么得到 | 本机 ibv_reg_mr 返回 |
对端注册后带外交换给你 |
| 填在哪 | WQE 本地 SGE 段 | WQE 远端地址段(仅单边操作) |
| 谁校验 | 本机网卡,处理 WQE 时 | 对端网卡,数据包到达时 |
| 校验内容 | key 匹配、地址范围、权限、MR 有效 | 同左 + 操作类型(READ/WRITE/ATOMIC)权限 |
| 失败表现 | LOC_PROT_ERR | REM_ACCESS_ERR,QP 进 error 态 |
| 软件要做什么 | 配对填对即可,校验不用管 | 正确交换、配对使用;poll CQE 检查错误 |
4. 如何生成和检验 lkey/rkey
从内核驱动源码确认了关键信息,可以完整回答了。先说结论:完整校验算法固化在网卡硬件里,厂商不公开全部细节;但 mlx5 的 key 结构和校验语义是公开可查的。
4.1. 先明确:校验发生在哪里
lkey/rkey 的校验不在 CPU、不在驱动,而在 RNIC 硬件的数据路径上------每次处理 WQE(本地侧)或收到 RDMA 包(远端侧)时由硬件流水线完成。这就是为什么它是零开销的:不是"算法被调用",而是"每个 DMA 请求都穿过多级硬件检查门"。
4.2. mlx5 的 key 结构(公开,来自内核源码)
32 位的 mkey 由两部分拼接而成:
mkey = (mkey_index << 8) | mkey_7_0
  ├─ 高 24 位 [31:8]:mkey index ------ 固件分配,是"内存保护表项"的下标
  └─ 低 8 位 [7:0] :mkey_7_0  ------ 驱动填入的 tag(代次/标签字节)
直接证据在 drivers/net/ethernet/mellanox/mlx5/core/mr.c 的 mlx5_core_create_mkey():固件返回 mkey_index,最终 key 由软件提供的 mkey_7_0 与 mlx5_idx_to_mkey(mkey_index) 按位或拼成。驱动里也有 #define MLX5_24BIT_MASK 印证 index 是 24 位宽。
这个结构直接决定了校验算法的第一层:不是哈希、不是搜索,而是 O(1) 的"索引 + 标签比对"。
4.3. 硬件校验的完整判定序列
以 mlx5 为例,每个 DMA 请求经过的检查(CREATE_MKEY 命令把 memory_key_mkey_entry(mkc)写入网卡,其中包含 start_addr、len、PD、访问权限位等字段):
输入:DMA 请求 {key, addr, len, 操作类型, 所属QP}

① 索引定位:index = key[31:8]
   → 直接下标访问网卡内的 MPT(Memory Protection Table)表项
   → 表项无效/已销毁 → 拒绝

② 标签比对:请求 key[7:0]  vs  表项中存储的 mkey_7_0
   → 不等 → 拒绝(这是防"陈旧 key"的机制:
     MR 注销后 index 可能被回收复用,但新 MR 的 tag 字节不同,
     旧 rkey 自然失效)

③ PD 匹配:QP 的 PD  ==  MR 表项里的 PD
   → 不等 → 拒绝(跨保护域隔离,进程 A 的 key 不能让进程 B 用)

④ 范围检查:addr ≥ mkc.start_addr  且  addr + len ≤ start_addr + mkc.len
   → 越界 → 拒绝(含 64 位地址回绕的边界处理)

⑤ 权限检查:操作类型 vs 表项权限位
   → 本地 DMA 读/写 → 需对应 local 权限
   → 远端 WRITE     → 需 REMOTE_WRITE 位(本例服务器注册时给的)
   → 远端 READ      → 需 REMOTE_READ 位
   → 不满足 → 拒绝

⑥ 地址转换:通过 MTT(Memory Translation Table)做
   虚地址 → 物理地址 的页级翻译,页表项也带访问位
   → 任何一页不可达/权限不符 → 拒绝
①~⑤ 全部通过才执行 DMA。远端 rkey 校验与本地 lkey 校验走的是同一套表项和逻辑,区别只是触发点不同:lkey 在处理 WQE 的 SGE 时查,rkey 在解析到达报文的 RETH(RDMA Extended Transport Header,里面携带远端地址+rkey+长度)时查。
4.4. 失败后的错误上报
硬件拒绝后会生成带 syndrome 的 error CQE,mlx5 侧的对应关系:
| 拒绝原因 | 发起方 CQE 状态 |
|---|---|
| ②~⑤ 任一失败(本地 lkey 侧) | IBV_WC_LOC_PROT_ERR |
| ②~⑤ 任一失败(远端 rkey 侧) | IBV_WC_REM_ACCESS_ERR |
| MR 已被注销后使用 | 同上(tag/表项失效) |
同时 mlx5 会在 dmesg/health buffer 里记录 "mkey violation" 类事件,之后 QP 进入 error 态,后续 WQE 全部被 flush。
4.5. 为什么这样设计(算法层面的总结)
| 设计点 | 目的 |
|---|---|
| index 高位直接索引 | 校验是 O(1),不打断线速 DMA 流水线 |
| tag 低 8 位 | 注销-重建场景下让旧 key 立刻失效(ABA 防护) |
| PD 字段绑定 | 进程/租户间的保护域隔离 |
| start_addr + len 范围检查 | 把"权限"精确限制在注册的字节区间 |
| 权限位与操作类型矩阵 | READ/WRITE/ATOMIC 粒度授权 |
总结:校验算法 = "高 24 位索引硬件保护表 → 低 8 位标签防伪 → PD/范围/权限三重比对 → MTT 页级翻译",全部在网卡内一次通过式完成;任何一环失败,发起方收到 LOC_PROT_ERR 或 REM_ACCESS_ERR。不同厂商(Intel irdma、Broadcom bnxt_re)的 key 位布局和表项格式各不相同,但语义上都是这同一件事。
如果你想深入某一部分(比如 verbs_common.h 里的 create_verbs_resources/connect_verbs_qp 具体怎么建 QP,或 GPUNetIO doca_gpu_dev_verbs_put 内部如何组 WQE),告诉我,我可以继续往下挖。
gpunetio/tree/main/examples