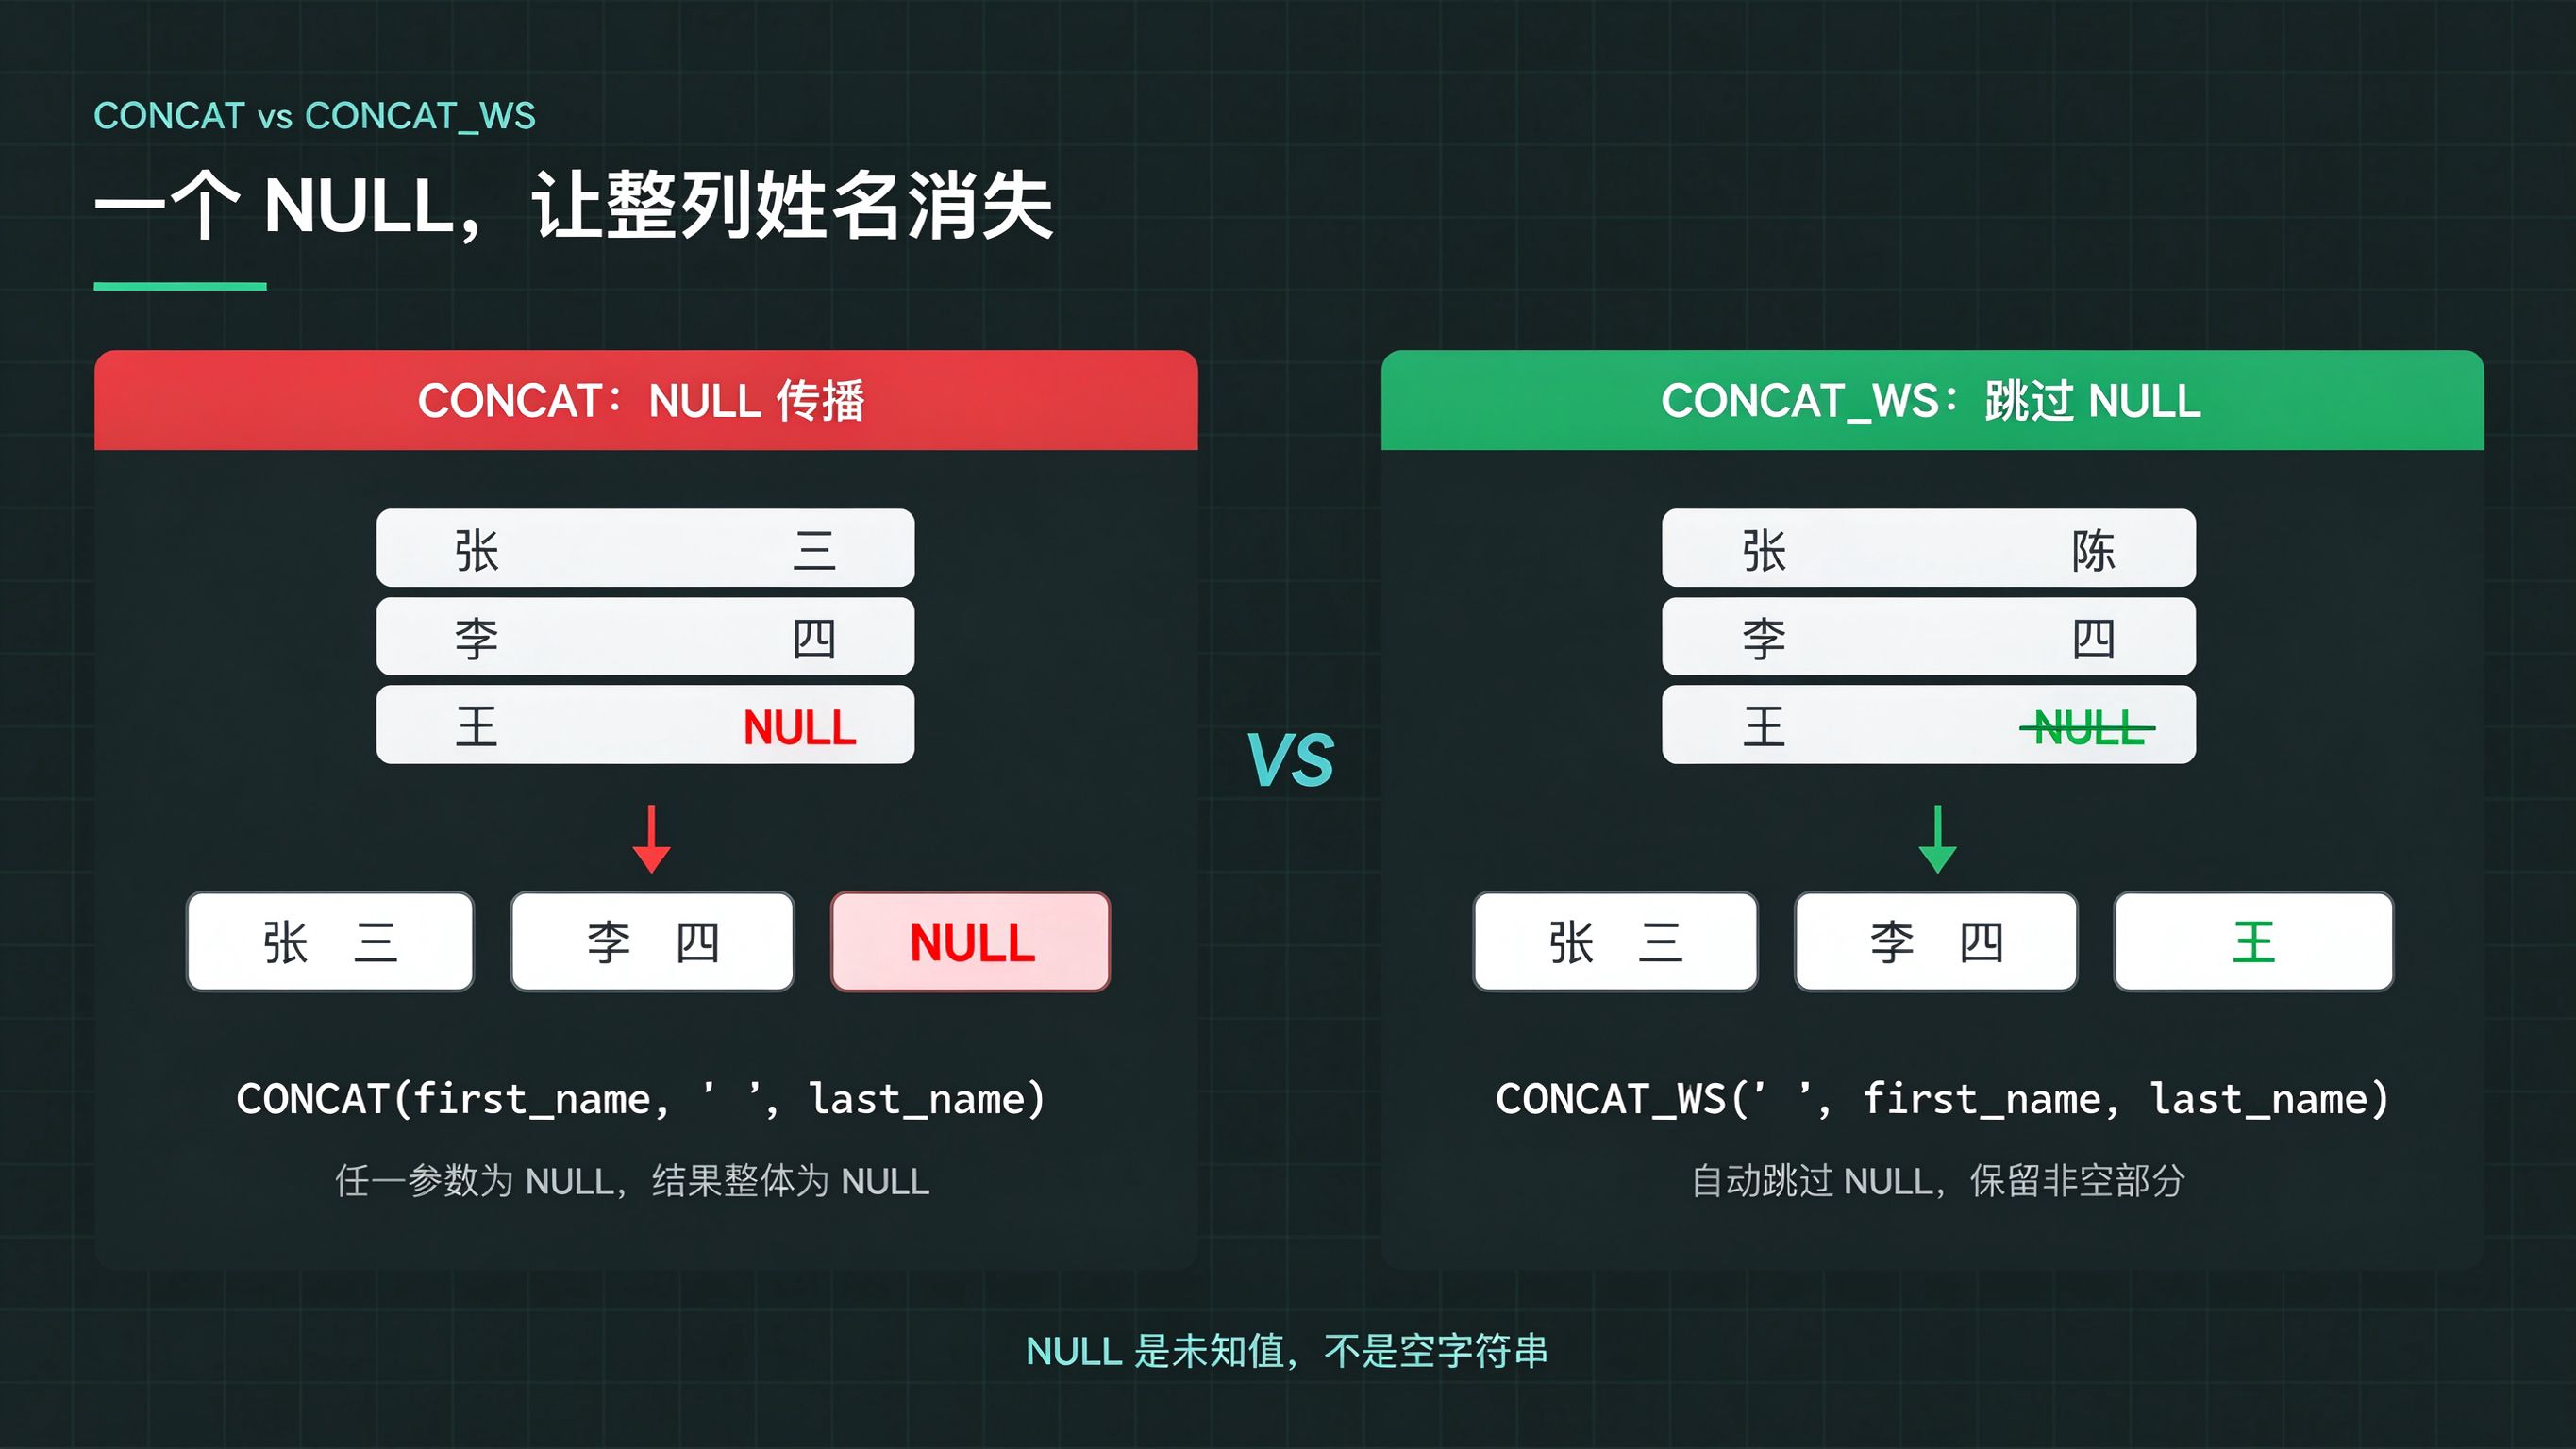
我用 CONCAT 拼员工姓名,库里只漏填了一个姓氏,整列结果全变成 NULL。
这篇我用一条报表处理链,把字符串、日期两类高频函数的坑点和标准写法一次讲清,代码全部可直接复制运行。
一、拼接一个完整姓名,结果为什么全是 NULL
报表要把员工的姓和名拼成一列展示,我写了一条最朴素的拼接语句:
plain
SELECT CONCAT(first_name, ' ', last_name) AS full_name FROM employees;注意单引号里的那个空格,它负责分隔姓和名;去掉它,「张」和「三」会紧贴成「张三」,这是拼接时最容易漏掉的细节。跑完结果对不上,第三个员工只是没填姓氏,整列直接变成 NULL:
| first_name | last_name | full_name |
|---|---|---|
| 张 | 三 | 张 三 |
| 李 | 四 | 李 四 |
| 王 | NULL | NULL |
问题来了:明明只有姓氏缺失,为什么连名字「王」也一起消失了?
NULL 表示「未知值」,不是空字符串。任何值与 NULL 运算,结果都为 NULL,这是 SQL 的三值逻辑(Three-Valued Logic)。CONCAT 逐个拼接参数,一旦碰到 NULL,整个结果就坍塌。
带分隔符拼接函数 CONCAT_WS(Concatenate With Separator)正好解决这个问题,第一个参数是分隔符,它会自动跳过值为 NULL 的参数:
plain
SELECT CONCAT_WS(' ', first_name, last_name) AS full_name FROM employees;
plain
+-----------+
| full_name |
+-----------+
| 张 三      |
| 李 四      |
| 王        |
+-----------+
第三个员工保留了 「王」,整列不再出现 NULL。你也可以用 IFNULL 把每个可空字段单独包成空串,但字段一多,包起来比 CONCAT_WS 啰嗦得多。
记住:NULL 不认亲戚,只要它在场,CONCAT 的结果就是 NULL。
二、姓名拼对了,字段清洗为什么还在出错
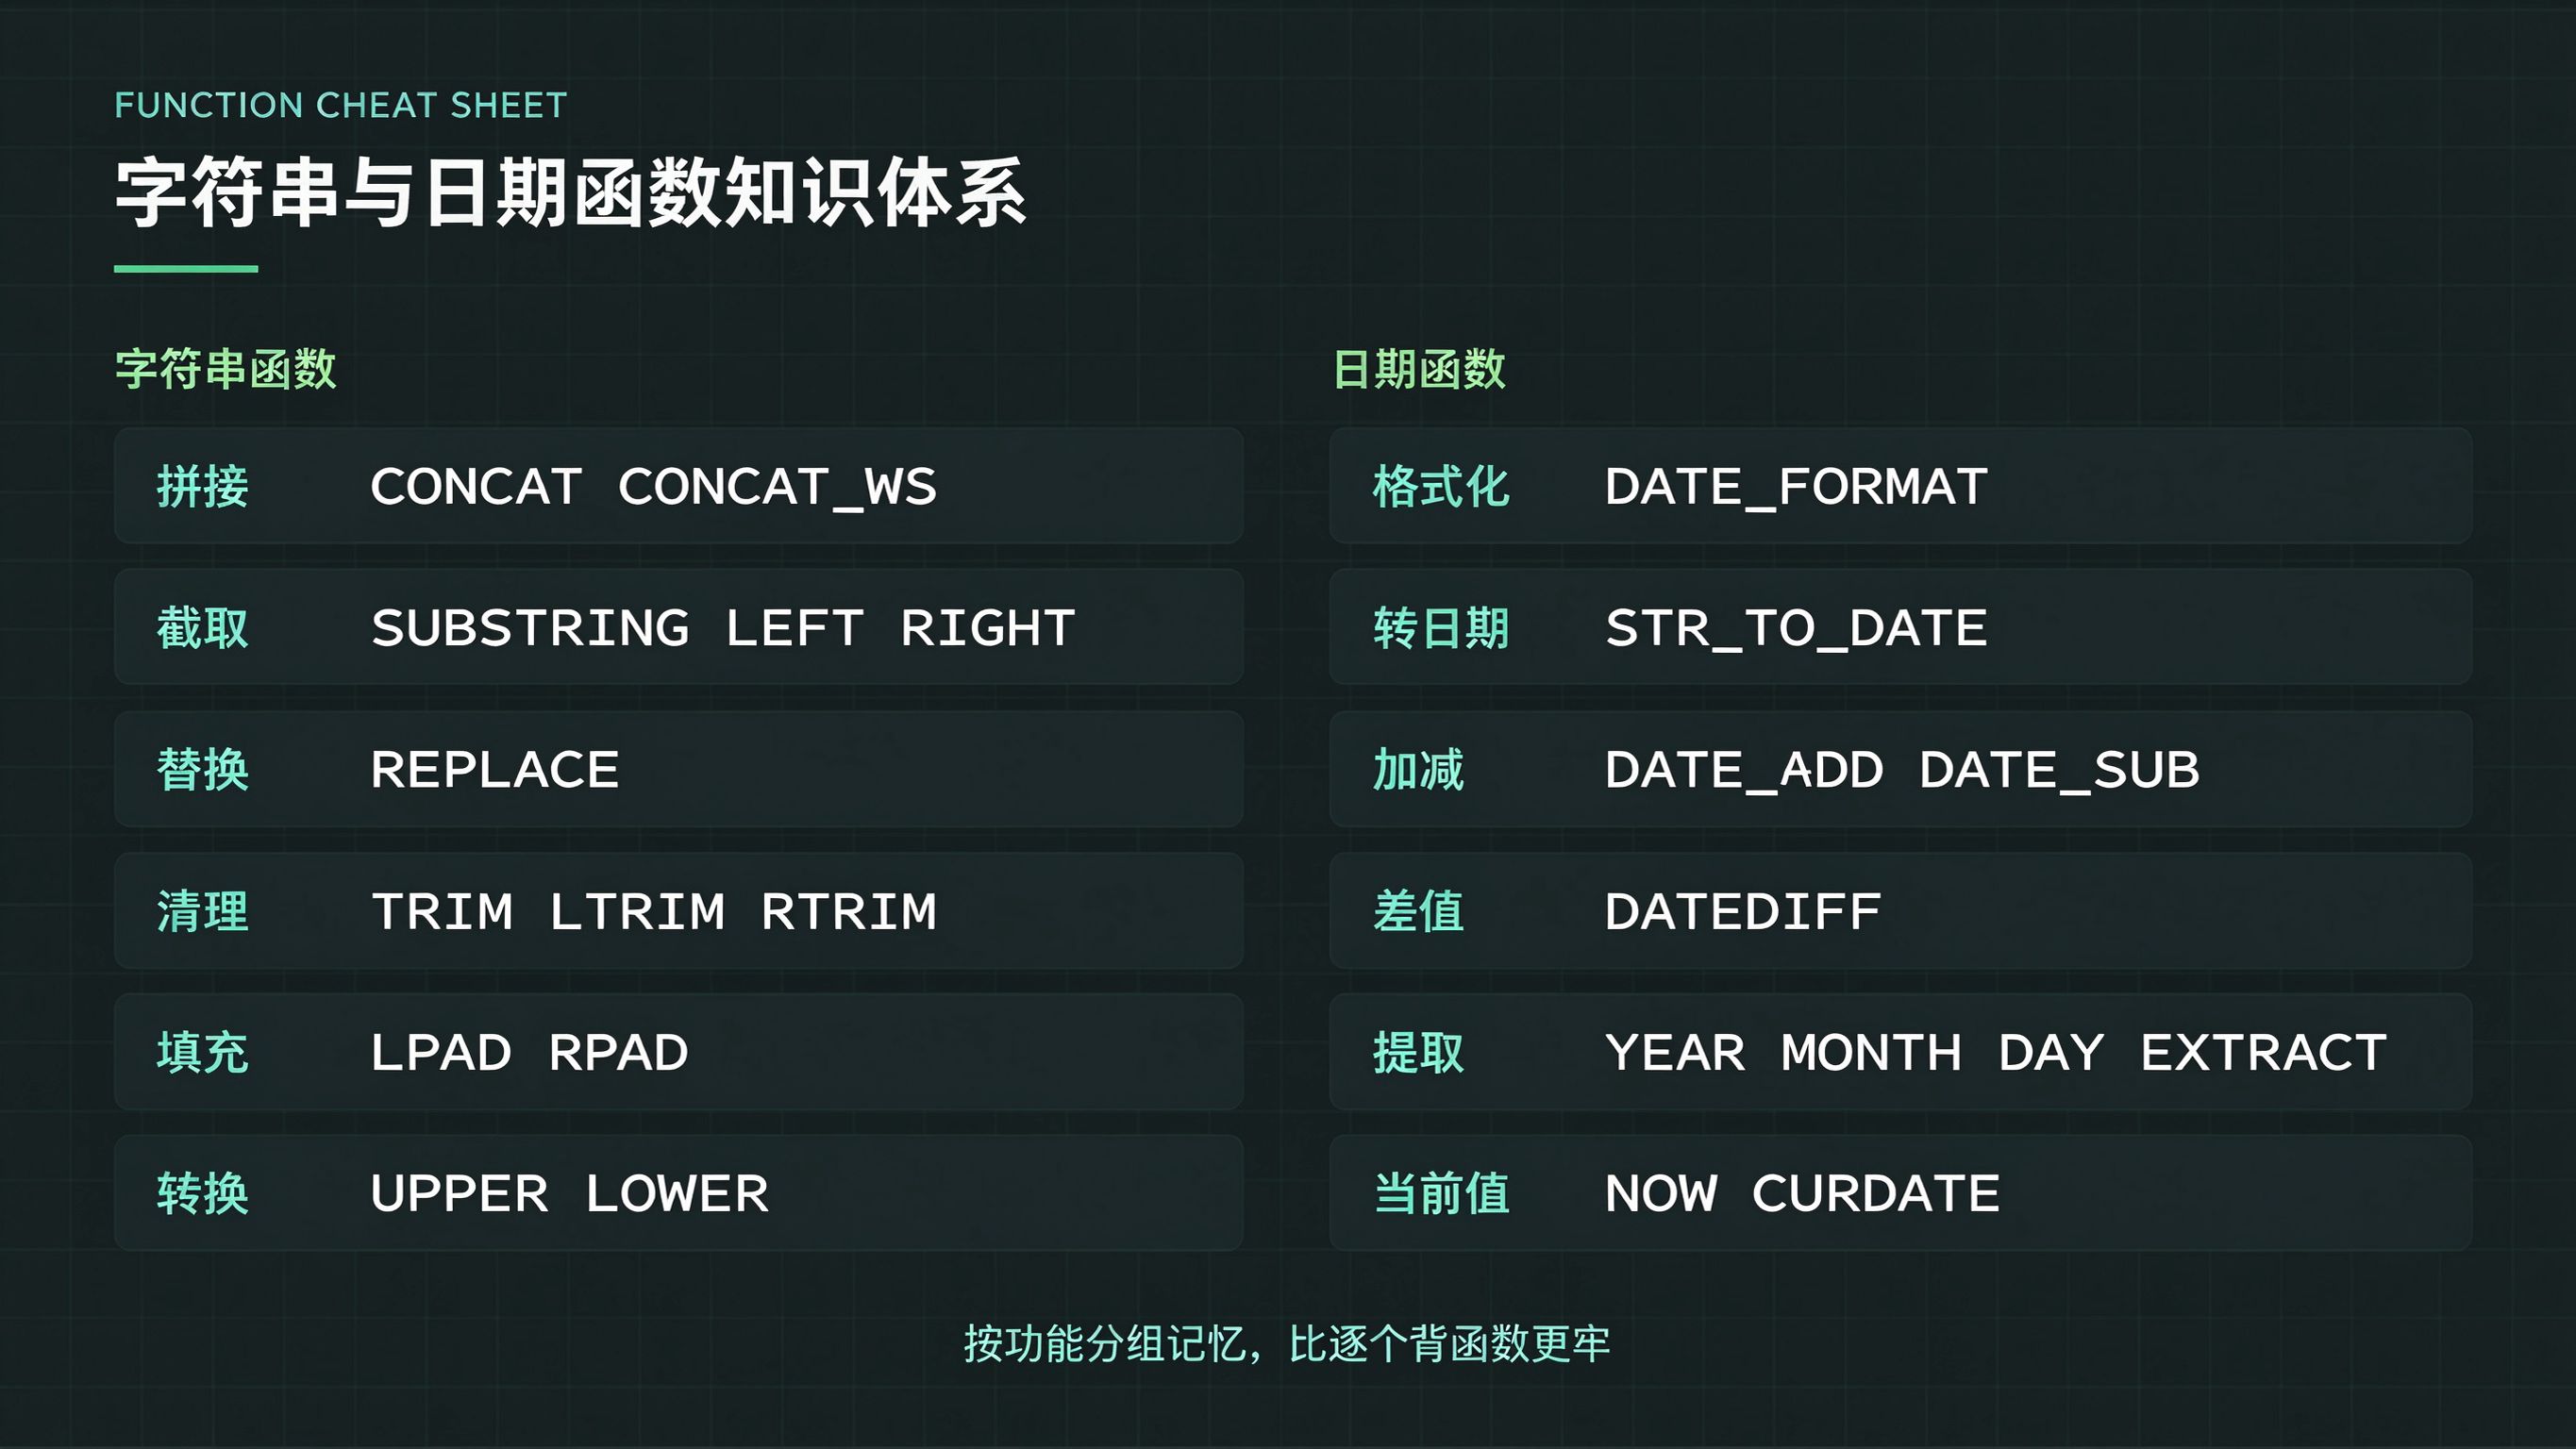
拼接只是第一步。真实报表里,工号要补零、手机号要截取、字段首尾还带着空格。高频字符串函数我整理成一张清单,你可以直接当速查表用:
| 函数 | 作用 | 易错点 |
|---|---|---|
| CONCAT_WS(sep, s1, ...) | 带分隔符拼接 | 自动跳过 NULL |
| SUBSTRING(str, start, len) | 截取子串 | 索引从 1 开始 |
| REPLACE(str, a, b) | 字符串替换 | 替换所有匹配位置 |
| TRIM(str) | 去首尾空白 | 只去首尾,不去中间 |
| LPAD / RPAD(str, len, pad) | 左 / 右填充 | 长度不足才补 |
| UPPER / LOWER(str) | 大小写转换 | 常用于统一格式 |
| LENGTH / CHAR_LENGTH(str) | 求长度 | 字节数 / 字符数 |
我最容易记错的是 SUBSTRING 的起始位置。刚从 Java 切过来时顺手写成 0,结果把第一个字符丢了:
plain
SELECT SUBSTRING('ABC123', 1, 3);  -- ABC
SELECT SUBSTRING('ABC123', 0, 3);  -- 空串,SQL 位置从 1 开始
SQL 字符串位置从 1 开始计数;省略第三个参数时,截取到字符串末尾,起始位置也支持负数,从末尾往前数。
REPLACE 会把所有匹配位置都替换掉,而不是只替换第一个;只想改特定位置的字符,得换其他思路。TRIM 还支持 TRIM('x' FROM str) 的写法,可以去掉首尾指定字符,不限于空格。
plain
SELECT REPLACE('a-b-a-b', 'a', 'x');  -- x-b-x-b,全部替换
SELECT TRIM('-' FROM '--hello--');    -- hello,去掉首尾横线
长度函数要分清口径:LENGTH 返回字节数,CHAR_LENGTH 返回字符数。中文是多字节字符,两者能差好几倍,统计「多少个字」时用错,结果直接翻倍。
工号补零是填充函数最典型的场景,把不足 5 位的工号统一补齐:
plain
UPDATE emp SET workno = LPAD(workno, 5, '0');
-- 1 号员工:1 变为 00001
记住:SQL 的字符串从 1 开始数,索引错一位,整列数据都错。
三、文本干净了,日期格式化为什么对不上
字段清洗完成,报表还要求把 2024-04-06 显示成「2024 年 04 月 06 日」。日期格式化函数 DATE_FORMAT 接收一个日期和一个格式串,按格式符输出文本:
plain
SELECT DATE_FORMAT('2024-04-06 22:23:01', '%Y年%m月%d日');
-- 2024年04月06日
格式符(Format Specifier)以百分号 % 开头,大小写是两套完全不同的语义。我把容易混淆的几对整理如下:
| 格式符 | 含义 | 格式符 | 含义 |
|---|---|---|---|
| %Y | 四位年份 2024 | %y | 两位年份 24 |
| %m | 月份数字 04 | %M | 月份名 April |
| %d | 日期数字 06 | %D | 带后缀 6th |
| %H | 24 小时制 22 | %h | 12 小时制 10 |
| %i | 分钟 23 | %s | 秒 01 |
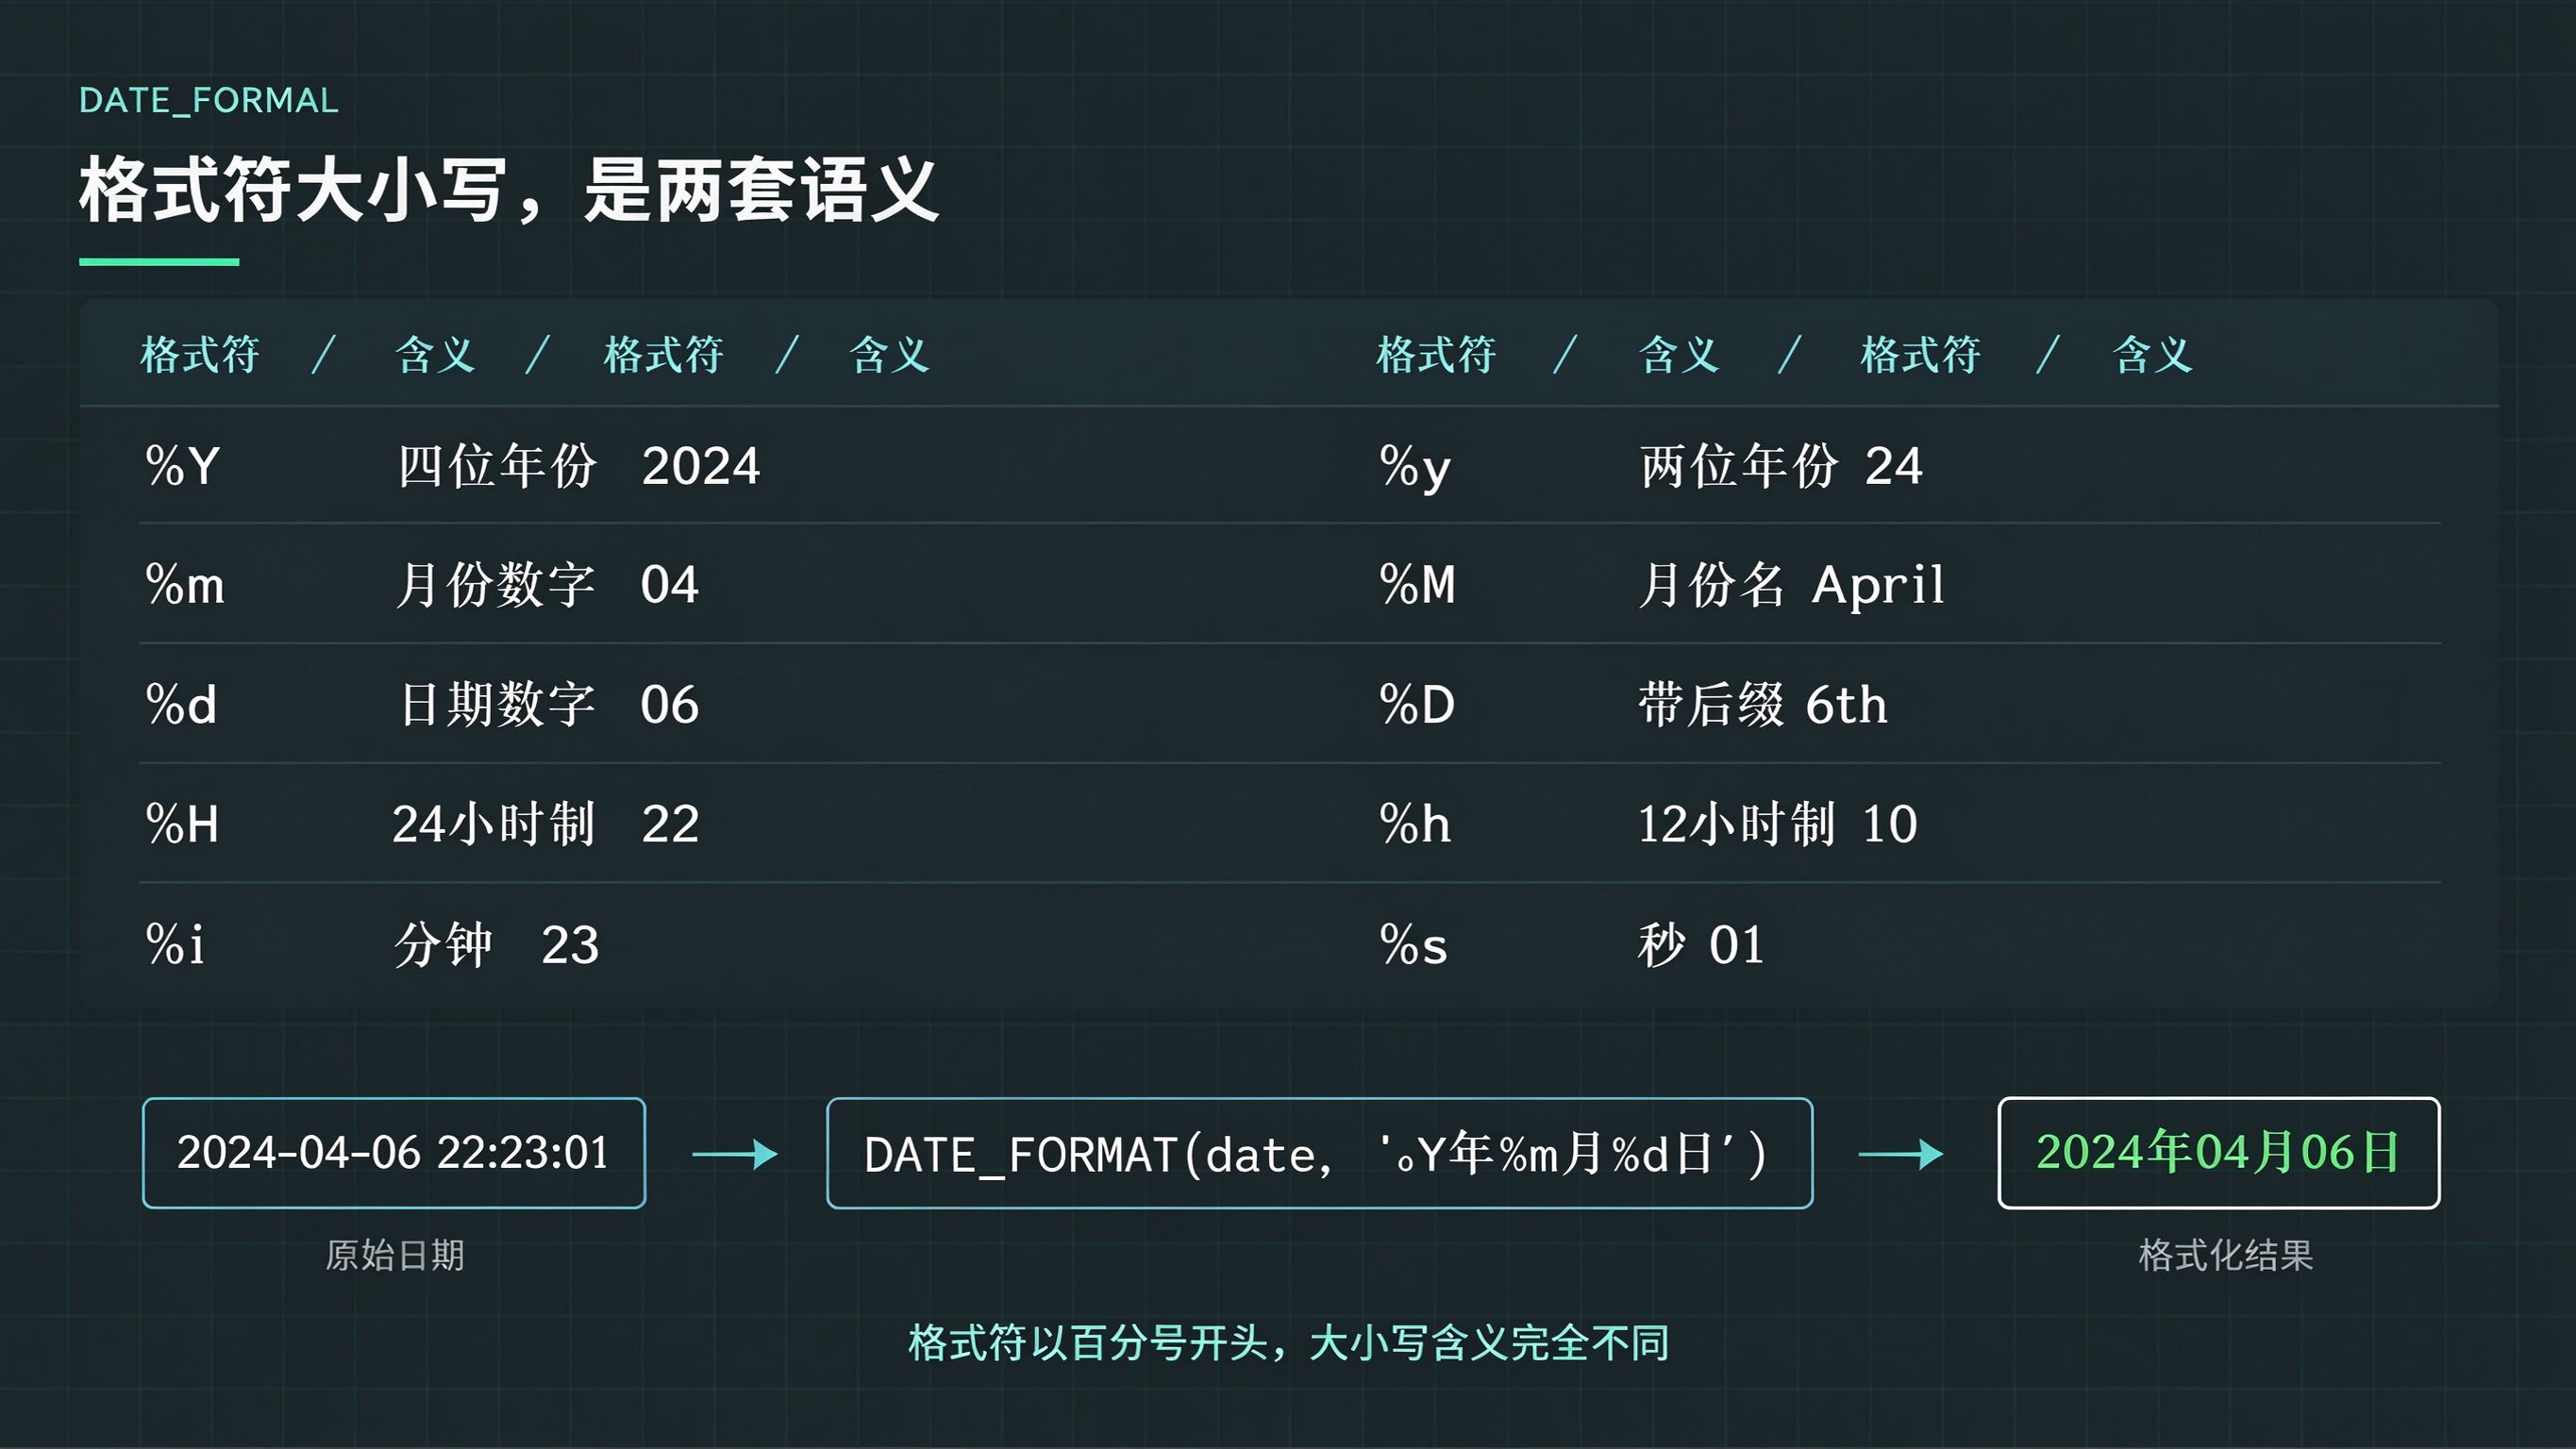
需要紧凑时间戳时,把年月日时分秒连起来,格式串写 %Y%m%d%H%i%s,一条函数输出 20240406222301,常用于生成编号前缀或落表分区。
取当前时间也要看粒度:NOW () 返回日期加时间,CURDATE () 只返回日期。做日报统计用 CURDATE () 就够,带上时分秒反而会干扰匹配。
记住:格式符大小写不是风格问题,% m 是月份,% M 是月份名。
四、反过来想,字符串怎么变回日期去比较
外部导入的数据往往是 06/04/2024 这样的文本,没法直接和日期字段比较。字符串转日期函数 STR_TO_DATE 是 DATE_FORMAT 的逆操作,按格式串把文本解析成日期:
plain
SELECT STR_TO_DATE('06/04/2024', '%m/%d/%Y');
-- 2024-04-06
它有一个隐蔽的静默失败(Silent Failure):文本和格式串对不上时,返回 NULL 并产生警告,而不是直接报错。我在一次数据导入中就被它悄悄塞了一整列空值。拿到文本后的处理分支可以这样判断:
plain
外部文本
  │
  ▼
STR_TO_DATE 按格式解析
  │
  ├─ 解析成功 ──► 合法日期 ──► DATE_ADD / DATEDIFF 运算
  │
  └─ 解析失败 ──► NULL + 警告(不报错)──► 先查空值
拿到合法日期后,常用的日期运算有三个:
| 函数 | 作用 | 注意 |
|---|---|---|
| DATE_ADD(d, INTERVAL n unit) | 日期加 | unit 取 DAY / MONTH / YEAR |
| DATE_SUB(d, INTERVAL n unit) | 日期减 | 同上 |
| DATEDIFF(d1, d2) | 相差天数 | 只算日期,忽略时间 |
plain
SELECT DATE_ADD('2025-12-17', INTERVAL 7 DAY);  -- 2025-12-24
SELECT DATEDIFF('2025-12-17', '2025-12-01');    -- 16
加减的单位 INTERVAL 不止 DAY,按月、按年写成 MONTH、YEAR 即可,算到期日、续费日都用它。传入带时分秒的 DATETIME 时,DATEDIFF 只比较日期部分;要精确到小时、分钟,改用 TIMESTAMPDIFF。
按年月分组统计时,提取函数最顺手。YEAR ()、MONTH ()、DAY () 是 EXTRACT 的简写,EXTRACT 能提取的部分更全:
plain
SELECT YEAR('2019-07-02');                 -- 2019
SELECT EXTRACT(YEAR_MONTH FROM '2019-07-02 01:02:03');  -- 201907
记住:STR_TO_DATE 解析失败只给 NULL 不报错,导入后必须先查空值。
五、串起来:一条 SQL 生成标准订单号
单个函数都不复杂,真实业务里它们是组合出现的。订单号要求「前缀 + 当天日期 + 5 位流水号」,一条 SQL 就能拼出:
plain
SELECT CONCAT('ORD-', DATE_FORMAT(NOW(), '%Y%m%d'), '-', LPAD(order_id, 5, '0')) AS order_no
FROM orders;
plain
+--------------------+
| order_no           |
+--------------------+
| ORD-20261001-00007 |
+--------------------+
再比如,把用户注册信息拼成一句话:
plain
SELECT CONCAT(username, ' 注册于 ', DATE_FORMAT(created_at, '%Y年%m月%d日'),
              ',距今 ', DATEDIFF(NOW(), created_at), ' 天') AS info
FROM users;
这一条链路里,拼接、格式化、填充、日期差值全部串了起来。你只要替换前缀、格式串和流水号位数,就能改成自己业务的编号规则。
六、总结
整条链路收束成三句话:
- 拼接遇 NULL 用 CONCAT_WS,字符串位置从 1 开始数
- 日期展示用 DATE_FORMAT,文本转日期用 STR_TO_DATE,运算用 DATE_ADD / DATEDIFF
- 函数按功能分组记忆,比逐个背诵效率更高
术语速查表
| 术语 | 说明 |
|---|---|
| 三值逻辑(Three-Valued Logic) | 谓词结果为真、假、未知三种;NULL 参与比较结果为未知 |
| NULL | 未知值,区别于空字符串 '' 和 0 |
| 格式符(Format Specifier) | DATE_FORMAT 中以 % 开头的占位符号 |
| 静默失败(Silent Failure) | 不抛错误,以 NULL 或警告体现的失败方式 |
| DATETIME | 同时包含日期和时间的类型 |
参考链接
- MySQL 8.0 字符串函数与运算符:https://dev.mysql.com/doc/refman/8.0/en/string-functions.html
- MySQL 8.0 日期和时间函数:https://dev.mysql.com/doc/refman/8.0/en/date-and-time-functions.html
- MySQL 8.0 Working with NULL Values:https://dev.mysql.com/doc/refman/8.0/en/working-with-null.html