NeRF 原理详解
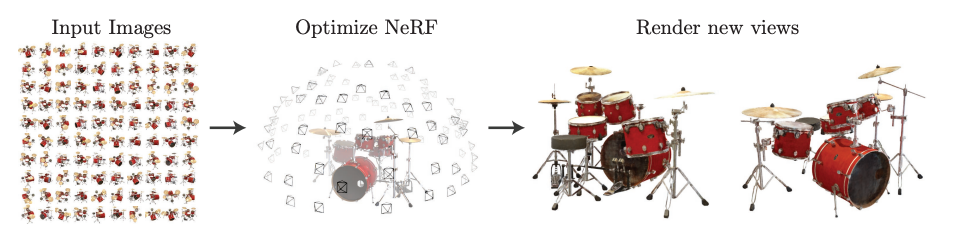
面向"从零理解 NeRF"的说明文档。内容结合本仓库(Ben Mildenhall 等人的官方 TensorFlow 实现,ECCV 2020)的代码,回答一系列常见疑问:它解决什么问题、5D 坐标是什么、MLP 长什么样、为什么输入是射线、为什么做 3D 重建却输出 2D 图、以及粗/细网络分别是什么。
目录
- [1. 这个项目是什么](#1. 这个项目是什么)
- [2. 它解决了之前的什么问题](#2. 它解决了之前的什么问题)
- [3. 核心概念:5D 坐标](#3. 核心概念:5D 坐标)
- [4. 整体流程:从输入到输出](#4. 整体流程:从输入到输出)
- [5. 为什么是"按像素生成射线"](#5. 为什么是"按像素生成射线")
- [6. 输入向量:63 维 = 60 编码 + 原始 3](#6. 输入向量:63 维 = 60 编码 + 原始 3)
- [7. 网络结构:就是一个 MLP 吗](#7. 网络结构:就是一个 MLP 吗)
- [8. 输出与损失:2D 预测 vs 2D 真实](#8. 输出与损失:2D 预测 vs 2D 真实)
- [9. 粗网络与细网络](#9. 粗网络与细网络)
- [10. 为什么做 3D 重建却输出 2D 图像](#10. 为什么做 3D 重建却输出 2D 图像)
1. 这个项目是什么
本仓库是 NeRF(Neural Radiance Fields,神经辐射场) 的官方 TensorFlow 实现,对应论文:
NeRF: Representing Scenes as Neural Radiance Fields for View Synthesis
Ben Mildenhall, Pratul P. Srinivasan, Matthew Tancik, Jonathan T. Barron, Ravi Ramamoorthi, Ren Ng
ECCV 2020(Oral,最佳论文荣誉提名)
一句话:用一个全连接神经网络(权重约 5MB)表示单个场景,让网络直接记住这个场景,从而从任意新视角渲染出照片级图像。
主要文件:
| 文件 | 作用 |
|---|---|
run_nerf.py |
主训练 / 渲染脚本 |
run_nerf_helpers.py |
网络结构、位置编码、体积渲染等辅助函数 |
load_blender.py |
合成数据集(Blender)加载 |
load_deepvoxels.py |
DeepVoxels 数据集加载 |
load_llff.py |
真实前向场景(LLFF)数据加载 |
config_fern.txt 等 |
示例配置 |
tiny_nerf.ipynb |
教学版 Colab 教程 |
extract_mesh.ipynb |
用 marching cubes 从 NeRF 提取网格 |
2. 它解决了之前的什么问题
NeRF 处理的核心任务是 新视角合成(novel view synthesis) :给一组 2D 图片,重建场景并生成任意新视角的图像。之前的方法在质量、连续性、存储上难以兼顾:
| 之前的方法 | 局限 |
|---|---|
| 基于图像的插值 / 光场 | 视角一变、遮挡关系一变就失效,不理解三维结构 |
| 显式几何重建(mesh / 点云 / 体素) | 分辨率受内存限制;难处理毛发、半透明、反光;重建误差直接体现为伪影 |
| 离散化的体表示(如 Neural Volumes) | 内存随分辨率三次方增长,分辨率上不去,表示不连续 |
| 纯 2D 神经网络渲染 | 视角间不一致,难表达复杂遮挡与光照 |
NeRF 的贡献:
- 连续隐式函数表示场景:MLP 把 5D 坐标映射为颜色 + 密度,不受离散分辨率限制。
- 可微体积渲染 :只用多视角 2D 图像的渲染损失端到端训练,无需 3D 监督、无需显式几何。
- 位置编码:把坐标映射到高频正弦基,克服 MLP 的"频谱偏置"(倾向学低频、结果过度平滑),这是质量飞跃的关键。
- 分层采样:粗网络 + 细网络,把采样点集中到真正有内容的地方,提升细节且不过度增加算力。
- 视角相关效果:颜色依赖观察方向,可表达镜面高光、反光。
代价与后续:训练慢(数小时~两天)、渲染慢、每个场景单独训练无法跨场景泛化。后续工作:Instant-NGP(哈希网格加速)、Mip-NeRF(抗锯齿)、Plenoxels / 3D Gaussian Splatting(换显式表示换速度)。
3. 核心概念:5D 坐标
"5D" 指的是 5 个数字,描述"看哪个点、从哪个方向看":
- 3D 位置
(x, y, z):空间中的一个点,即"光线走到哪儿"。 - 2D 方向
(θ, φ)/ 归一化方向向量:观察方向,即"从哪个角度看这个点"。
方向本来是 3 个分量,但单位向量满足 dx² + dy² + dz² = 1,自由度只有 2(球面经纬度),所以 3 + 2 = 5D。
网络映射:
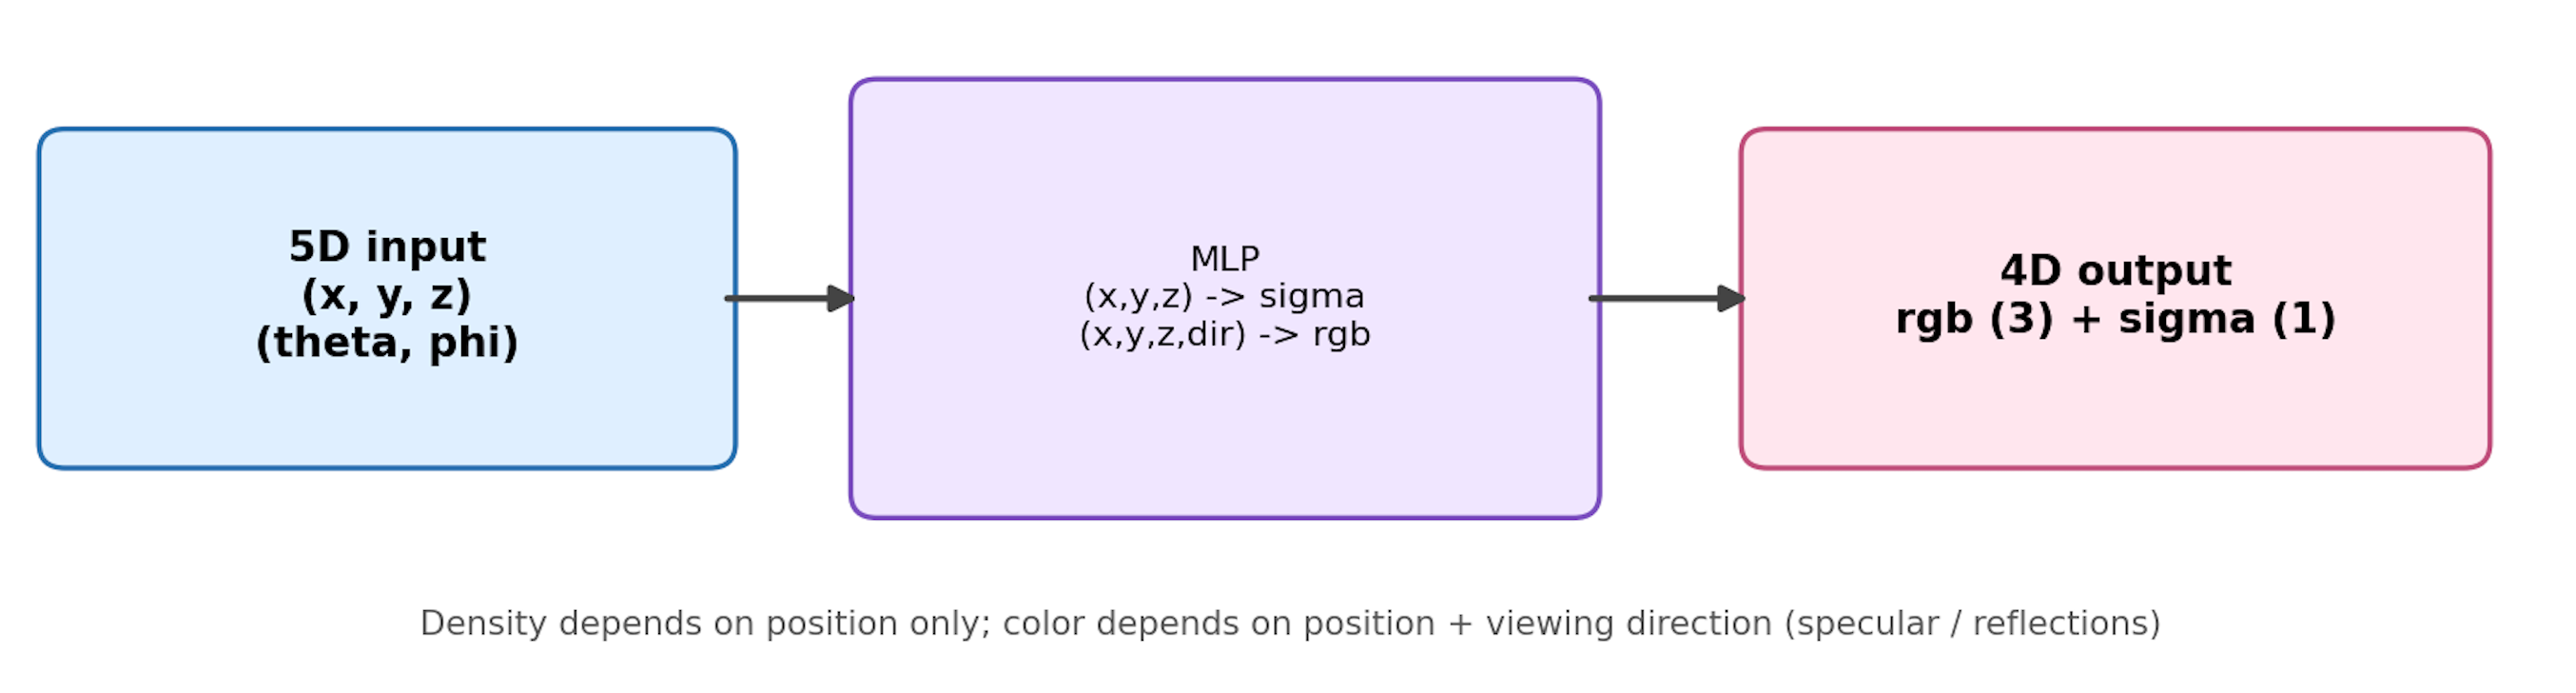
F: (x, y, z, θ, φ) -> (r, g, b, σ)- 输出 rgb 是颜色,σ 是体积密度(该点有多"不透明")。
- 密度只用位置
(x,y,z)决定,与观察方向无关;颜色用位置 + 方向共同决定,用来表达高光/反光。
4. 整体流程:从输入到输出
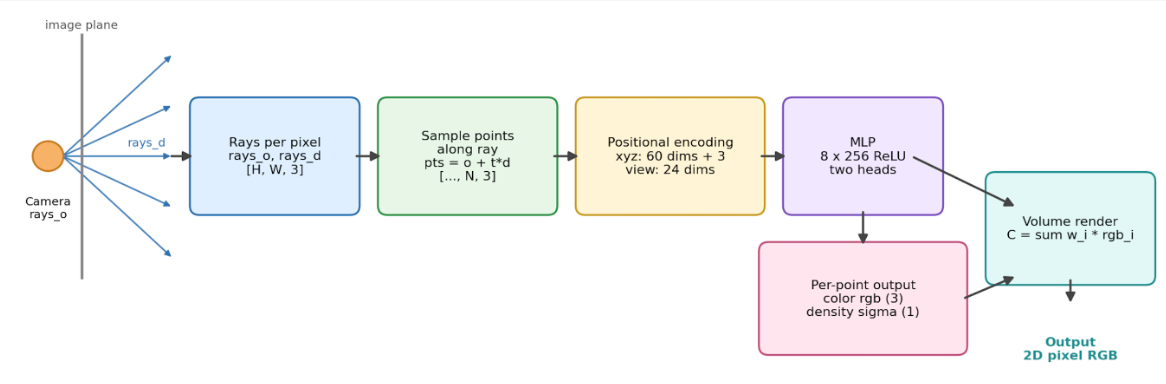
一句话概括:
一批图像 + 相机位姿 -> 每个像素发一条射线 -> 射线上采样若干点 -> 每点送进 MLP 得到颜色和密度 -> 沿射线做体积渲染积分 -> 得到像素颜色 -> 与真实像素算 L2 损失 -> 反向传播更新网络。
逐步拆解(对应 run_nerf.py / run_nerf_helpers.py):
- 射线 :对每个像素,根据相机位姿得到起点
rays_o(相机光心)和方向rays_d(单位向量)。对应get_rays/get_rays_np;真实前向场景再做ndc_rays变换。 - 采样点 :在
near到far之间分层采样N_samples个点,加抖动。每个点坐标pts = rays_o + t * rays_d。 - 位置编码 :坐标
xyz编码为 60 维(10 频段 × sin/cos × 3),方向编码为 24 维(4 频段)。 - MLP 前向:主干 8 层 × 256 通道 ReLU,第 5 层后跳连接,输出分两支(密度 / 颜色)。
- 体积渲染 (
raw2outputs):δ_i = t_{i+1} - t_iα_i = 1 - exp(-σ_i · δ_i)T_i = exp(-Σ_{j<i} σ_j · δ_j)w_i = T_i · α_i- 像素颜色
C = Σ w_i · rgb_i,深度= Σ w_i · t_i
- 分层采样 :用粗网络的权重
w_i做逆变换采样,在物体处加密,再跑细网络。 - 损失:粗、细输出都与真实像素算 L2,加和反传。
5. 为什么是"按像素生成射线"
关键点:NeRF 的输入输出不是"图 -> 图",而是"几何光线 -> 颜色"。
- 普通 CNN(分类、超分、生成):一次"看到"整张
H×W×C张量,用卷积处理像素间关系。 - NeRF:网络一次前向只回答**"空间中某一点,从某方向看,是什么颜色、多密"。它不认识"图像",也不认识"第几行第几列"。要渲染一张图,就必须逐像素发一条射线"问"网络**。
一条射线 = 从相机光心出发、穿过某像素、射向场景的一条直线:
rays_o:起点(相机光心,所有像素共用)。rays_d:方向(由像素位置决定,每个像素不同)。
一张 H×W 的图 → H×W 条射线。
为什么必须这样 :场景是连续的 3D 场,不是 2D 图。网络定义在 3D 空间上,只有"一条穿过空间的线"才有意义。渲染新视角时只要换一套相机位姿重新发射线即可,无需重新训练------这正是 NeRF 能做新视角合成的原因。
类比:传统 CNN 像"看照片";NeRF 像"逐个像素发射雷达探测线",问 3D 空间中每一点的颜色与透明度,再沿途累加成一个像素。
6. 输入向量:63 维 = 60 编码 + 原始 3
一个 3D 采样点坐标经过位置编码后,送进主干网络的向量是 63 维:
-
原始 3 :采样点世界坐标
(x, y, z),原样保留,保证网络能拿到未经变换的绝对位置。 -
60 编码 :对
x, y, z每个坐标分别做位置编码:γ(p) = [ sin(2^0·π·p), cos(2^0·π·p), ..., sin(2^(L-1)·π·p), cos(2^(L-1)·π·p) ]
每个坐标用 L = 10 个频段,每频段产生 sin、cos 各一个 -> 每个坐标 20 维 -> 三个坐标共 60 维。
代码对应 run_nerf_helpers.py 的 Embedder / get_embedder:
python
freq_bands = 2.**np.linspace(0., max_freq, num_freqs)  # [1, 2, 4, ..., 512]
x_enc = x * freq_bands                                  # 每个频段缩放一次
# sin、cos 各拼一份为什么要编码:MLP 存在"频谱偏置",偏爱低频、会过度平滑;把坐标升到高频正弦基上,网络才能表达头发丝、边缘、纹理等高频细节。低频 sin/cos 抓大结构,高频抓细节。
方向编码对比 :方向 (dx,dy,dz) 通常用 multires=4,即 3 × 2 × 4 = 24 维,不加原始 3 维 (方向已归一化到单位球,原始值信息冗余)。颜色分支的输入是 256(第 8 层特征)+ 24(方向编码)。
7. 网络结构:就是一个 MLP 吗
是,NeRF 的骨干就是一个相当"朴素"的 MLP------没有卷积、没有注意力、没有循环。但它有几处关键设计:
| 特点 | 说明 |
|---|---|
| 纯 MLP | 主干 8 层全连接,每层 256 单元,激活 ReLU |
| 输入是位置编码 | 63 维高频编码,而非原始 (x,y,z) |
| 跳连接 | 第 5 层后把原始输入(63 维)再拼回来,类似残差,防止深层丢失空间信息 |
| 双分支 | 密度 σ:只用第 8 层特征 -> 1 维(ReLU 保证非负);颜色 rgb:第 8 层特征 + 方向编码 -> 一层 128 通道 -> 3 维(sigmoid) |
| 共享权重 / 连续函数 | 对射线上所有采样点分别查询,网络是"连续函数求值器" |
关键创新不在网络架构 ,而在 表示方式(连续隐式场)+ 位置编码 + 可微体积渲染。每个场景单独训练,网络只需"记住"这一个场景,不需要泛化,普通 MLP 够用。
这也是它的局限来源:逐点前向慢、每场景单独训练、无法跨场景泛化。后续工作(Instant-NGP、Plenoxels、3DGS)主要是在换表示、加速,网络反而更简单甚至被去掉。
8. 输出与损失:2D 预测 vs 2D 真实
- 输入 :一批射线上的 3D 采样点 ,每个点是 5D 坐标
(x, y, z, θ, φ)。 - 输出 :这些点经体积渲染积分后,得到 2D 图像上的像素颜色。
- 损失:渲染出的 2D 像素 vs 真实照片对应的 2D 像素,做 L2(均方误差)。
run_nerf.py 训练循环:
python
# 随机采一批像素(如 1024 条射线),取真实颜色 target_s
# 渲染出预测颜色:粗 rgb_0 + 细 rgb
loss = mean((rgb   - target)**2) + mean((rgb_0 - target)**2)
要点:
- 每次迭代只随机采一部分像素(不是整张图),省显存、加速。
- 监督信号只有 2D 图像,没有任何 3D 几何 / 深度 / 体素标签。
- 梯度从 2D 像素一路反传到 3D 场:像素颜色是射线上各点颜色的加权和,因此每个点的颜色与密度都能收到梯度------这就是 3D 结构被"逼"出来的机制。
术语修正:输入应说"3D 空间中的采样点",而不是"3D 采样图"(后者易被误解为体素/3D 图像)。
9. 粗网络与细网络
粗、细是同一个场景的两个渲染版本,区别只在"沿射线如何采样点"。
粗网络 rgb_0
- 用均匀采样 在
[near, far]取N_coarse(默认 64)个点,加抖动。 - 送进网络,做体积渲染,输出
rgb_0、视差disp_0、累计不透明度acc_0。 - 特点:快、粗糙;主要价值不只是出图,而是给出每条射线上哪一段有物体 (权重
w_i)。
细网络 rgb
- 用粗网络的权重
w_i归一化成概率密度,做逆变换采样 ,在高权重区域加密采N_importance(默认 128)个点。 - 把这些新点与粗采样点合并后再渲染一次,输出
rgb------最终结果,细节更清楚。
代码(render_rays):
python
# 1) 粗:均匀采样 + 前向
z_vals = uniform(near, far, N_coarse)
rgb_0, disp_0, acc_0, ..., weights = raw2outputs(network_fn(pts), z_vals, ...)

# 2) 用粗权重决定精细采样位置
z_samples = sample_pdf(z_vals_mid, weights, N_importance)

# 3) 细:合并点后重跑
z_vals = sort(cat([z_vals, z_samples]))
rgb, disp, acc, ... = raw2outputs(network_fn(new_pts), z_vals, ...)损失同时监督两者:
python
loss = L2(rgb, target) + L2(rgb_0, target)监督粗网络是为了让它估计的权重更准(它决定细采样往哪儿放),监督细网络是为了最终渲染质量。N_importance=0 可关闭细网络。
10. 为什么做 3D 重建却输出 2D 图像
容易误解的地方:"重建"和"输出"是两件事。
| 是什么 | 维数 | |
|---|---|---|
| 网络内部学到的表示 | 连续的神经辐射场 | 3D(+ 方向) |
| 训练监督信号 | 多视角照片 | 2D |
| 渲染输出 | 某个视角的图像 | 2D |
| 可导出的几何 | 用 marching cubes 提取 mesh | 3D |
- NeRF 确实在做三维重建 ,只是重建对象是隐式的 3D 场(不是显式网格/点云)。
- 但它的任务本质是新视角合成,相机拍出来的画面本来就是 2D 的,所以渲染输出天生是 2D。
- 这不是"只做了 2D",而是"用 2D 监督逼出 3D 表示,再渲染回 2D"。
为什么 2D 监督能学出 3D :靠多视角一致性。同一个 3D 点从不同角度看颜色应一致(密度也一致)。网络为了同时解释几十上百张不同视角的照片,被迫把"记忆"放到统一的 3D 结构中,而不是各记各的;配合可微体积渲染,梯度能从 2D 像素传回 3D 场。
想拿到显式 3D :见 extract_mesh.ipynb------在 3D 网格上查询密度,用 marching cubes 提等值面,导出 mesh/点云。
一句话:3D 是它"学到的东西",2D 是它"用来学的东西"和"给人看的结果"。
参考
- 论文:https://arxiv.org/abs/2003.08934
- 项目主页:http://matthewtancik.com/nerf
- 代码:本仓库
run_nerf.py、run_nerf_helpers.py