26年9月来自浙大、中南大学和中科院软件所的论文"EmbodiedMemory-Bench: Benchmarking Embodied Memory for Long-Horizon Embodied Tasks"。
它的主要贡献在于建立具身记忆的评测体系,并证明结构化记忆能够改善行动决策;模型方法本身属于设计清晰、效果可观的系统整合,尚未解决真实环境中的长期记忆问题。
一、论文解决什么问题
作者认为,具身智能体需要记住的不只是"看见过什么",还包括:
物体现在在哪里,之前的位置是否已经失效;
动作失败揭示了哪些视觉上看不到的约束;
多次交互和纠正能否形成可迁移的经验。
例如,"抽屉打不开"既是一次动作结果,也是后续规划应当遵守的环境约束。如果系统只保存画面或对话摘要,就可能再次执行同样的失败动作。
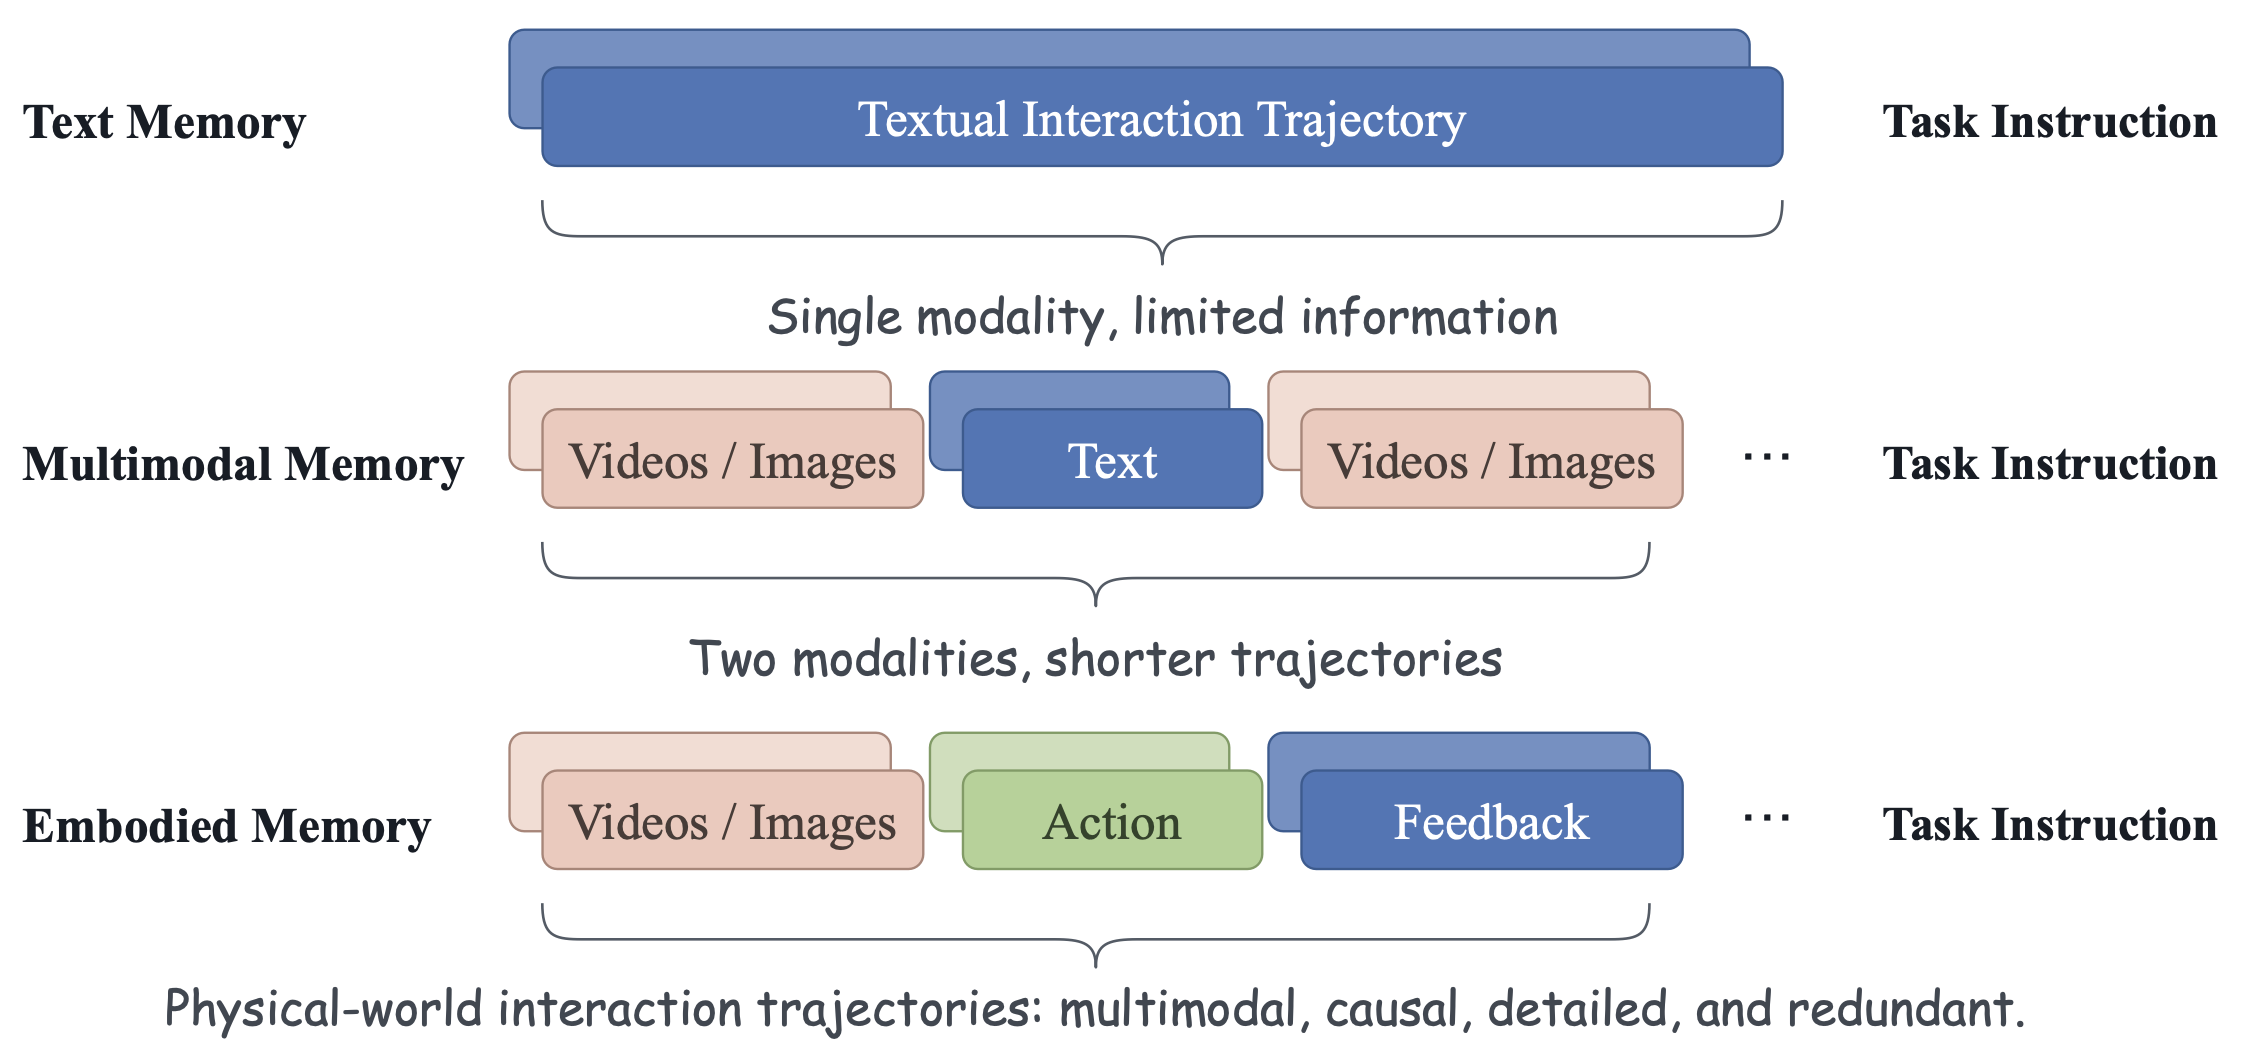
如图 1 所示文本中心型记忆、多模态记忆与具身记忆的比较。具身记忆将视觉观察、动作及反馈联系起来,形成因果交互历史,从而支持在不断变化的物理世界中执行后续任务。
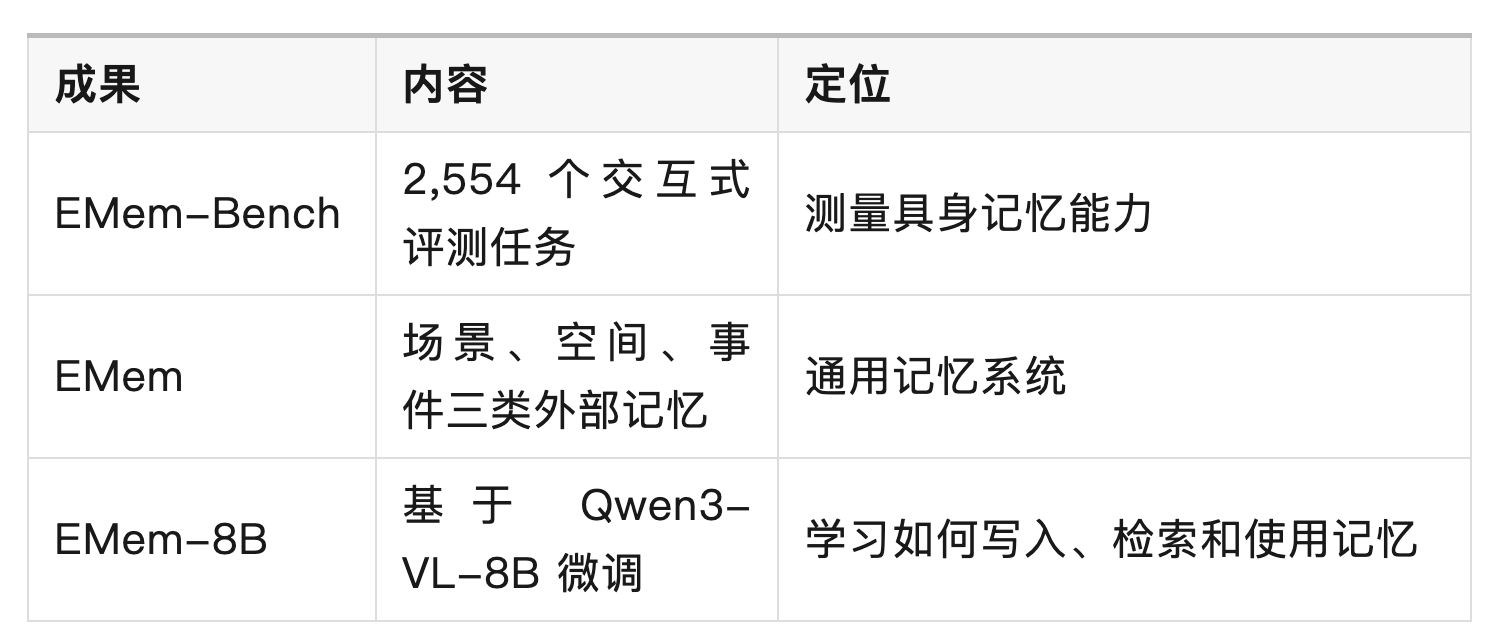
论文包含三个层次的成果:
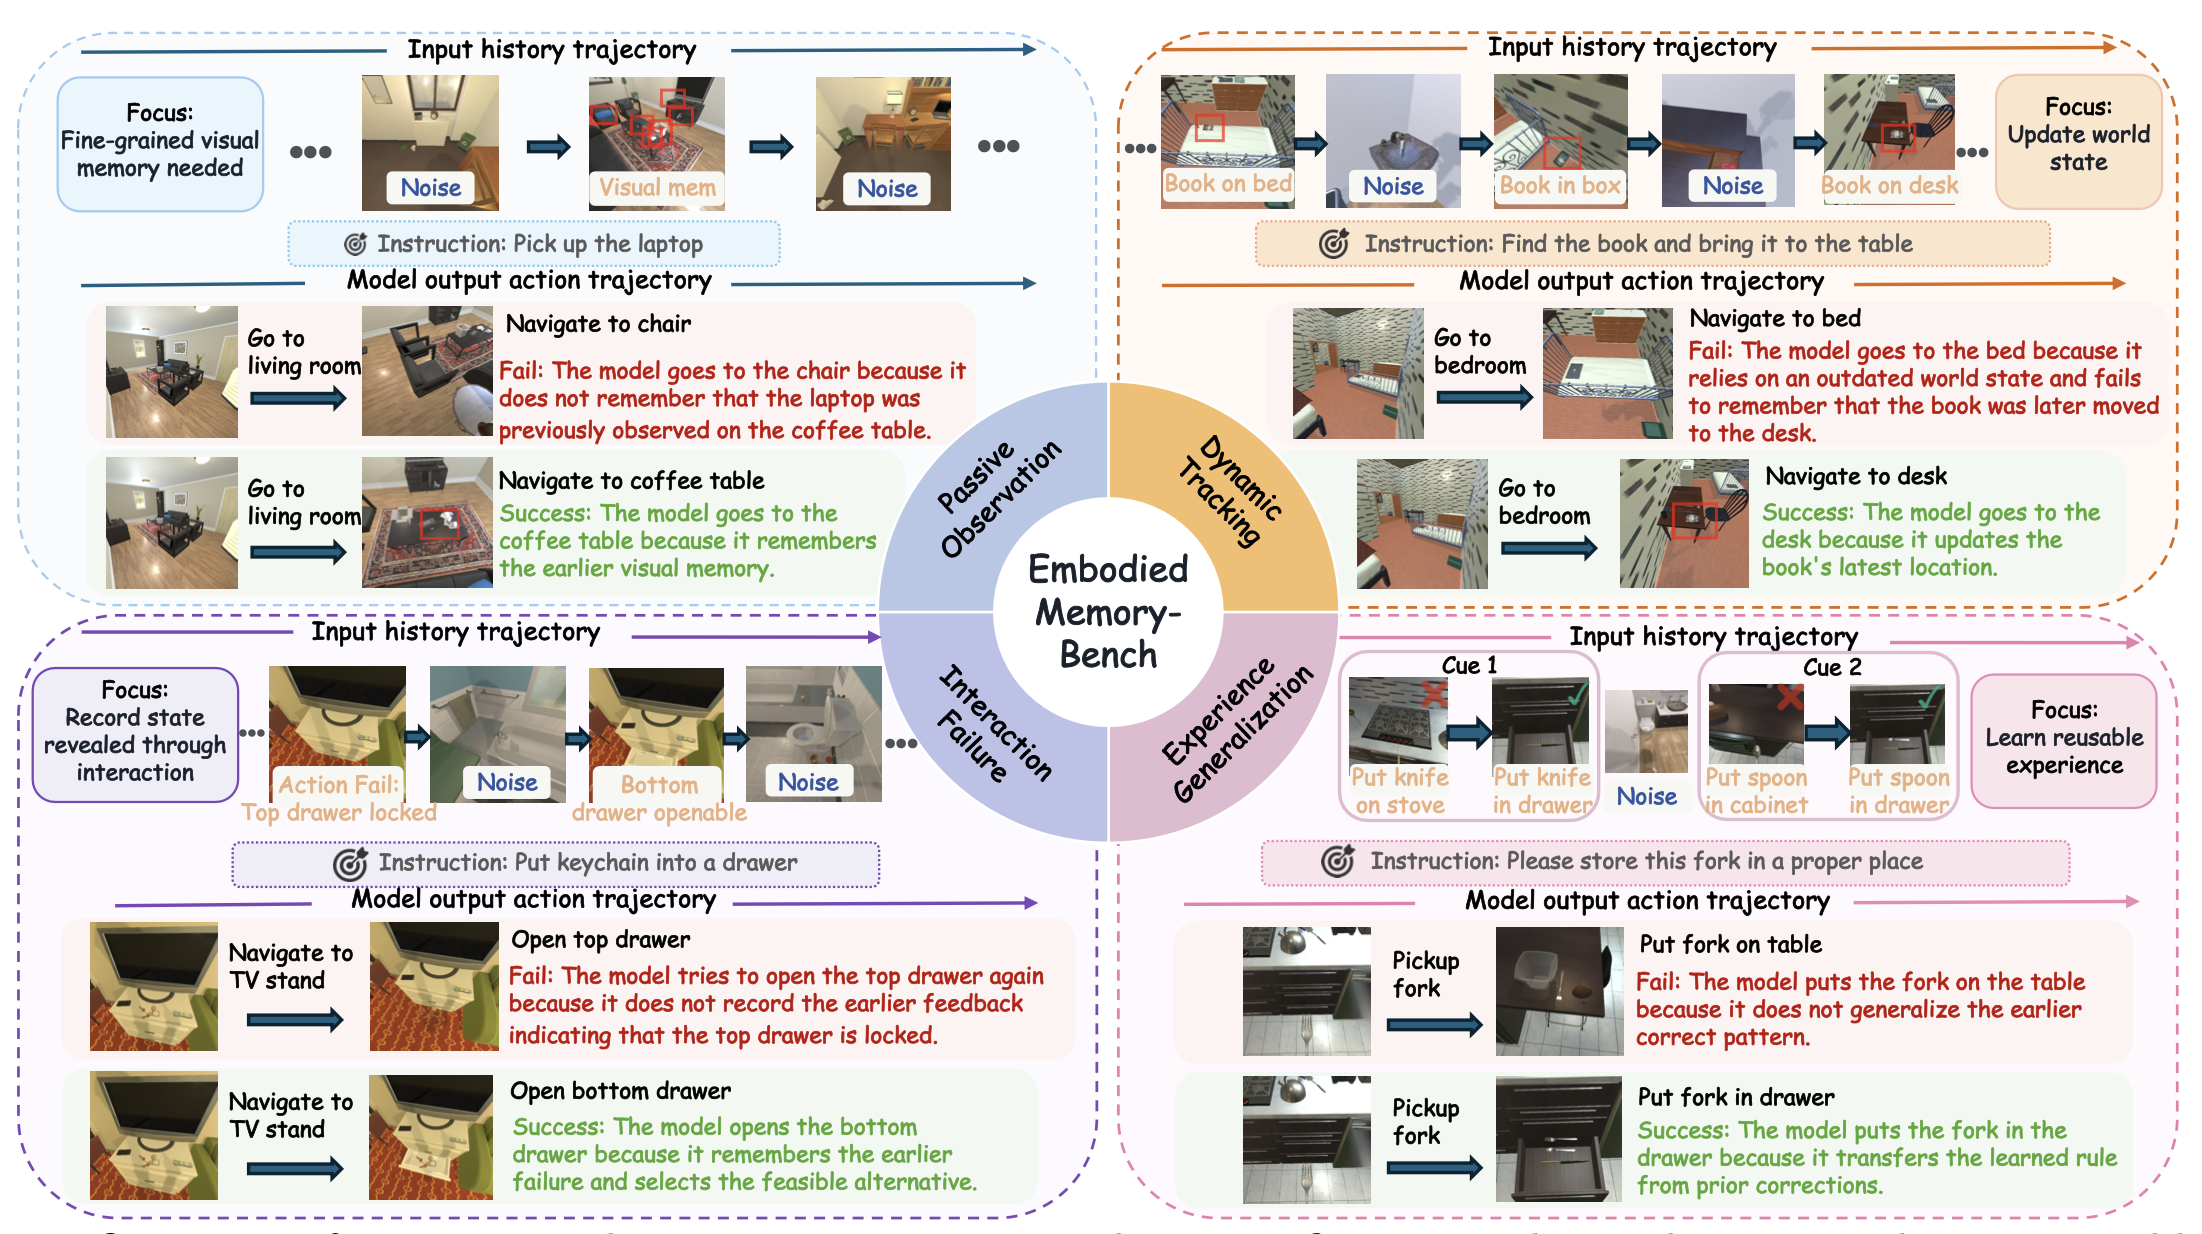
如图 3所示EMem-Bench 概览。其代表性示例涵盖了细粒度视觉记忆、动态世界状态追踪、通过交互记录世界状态以及经验泛化。
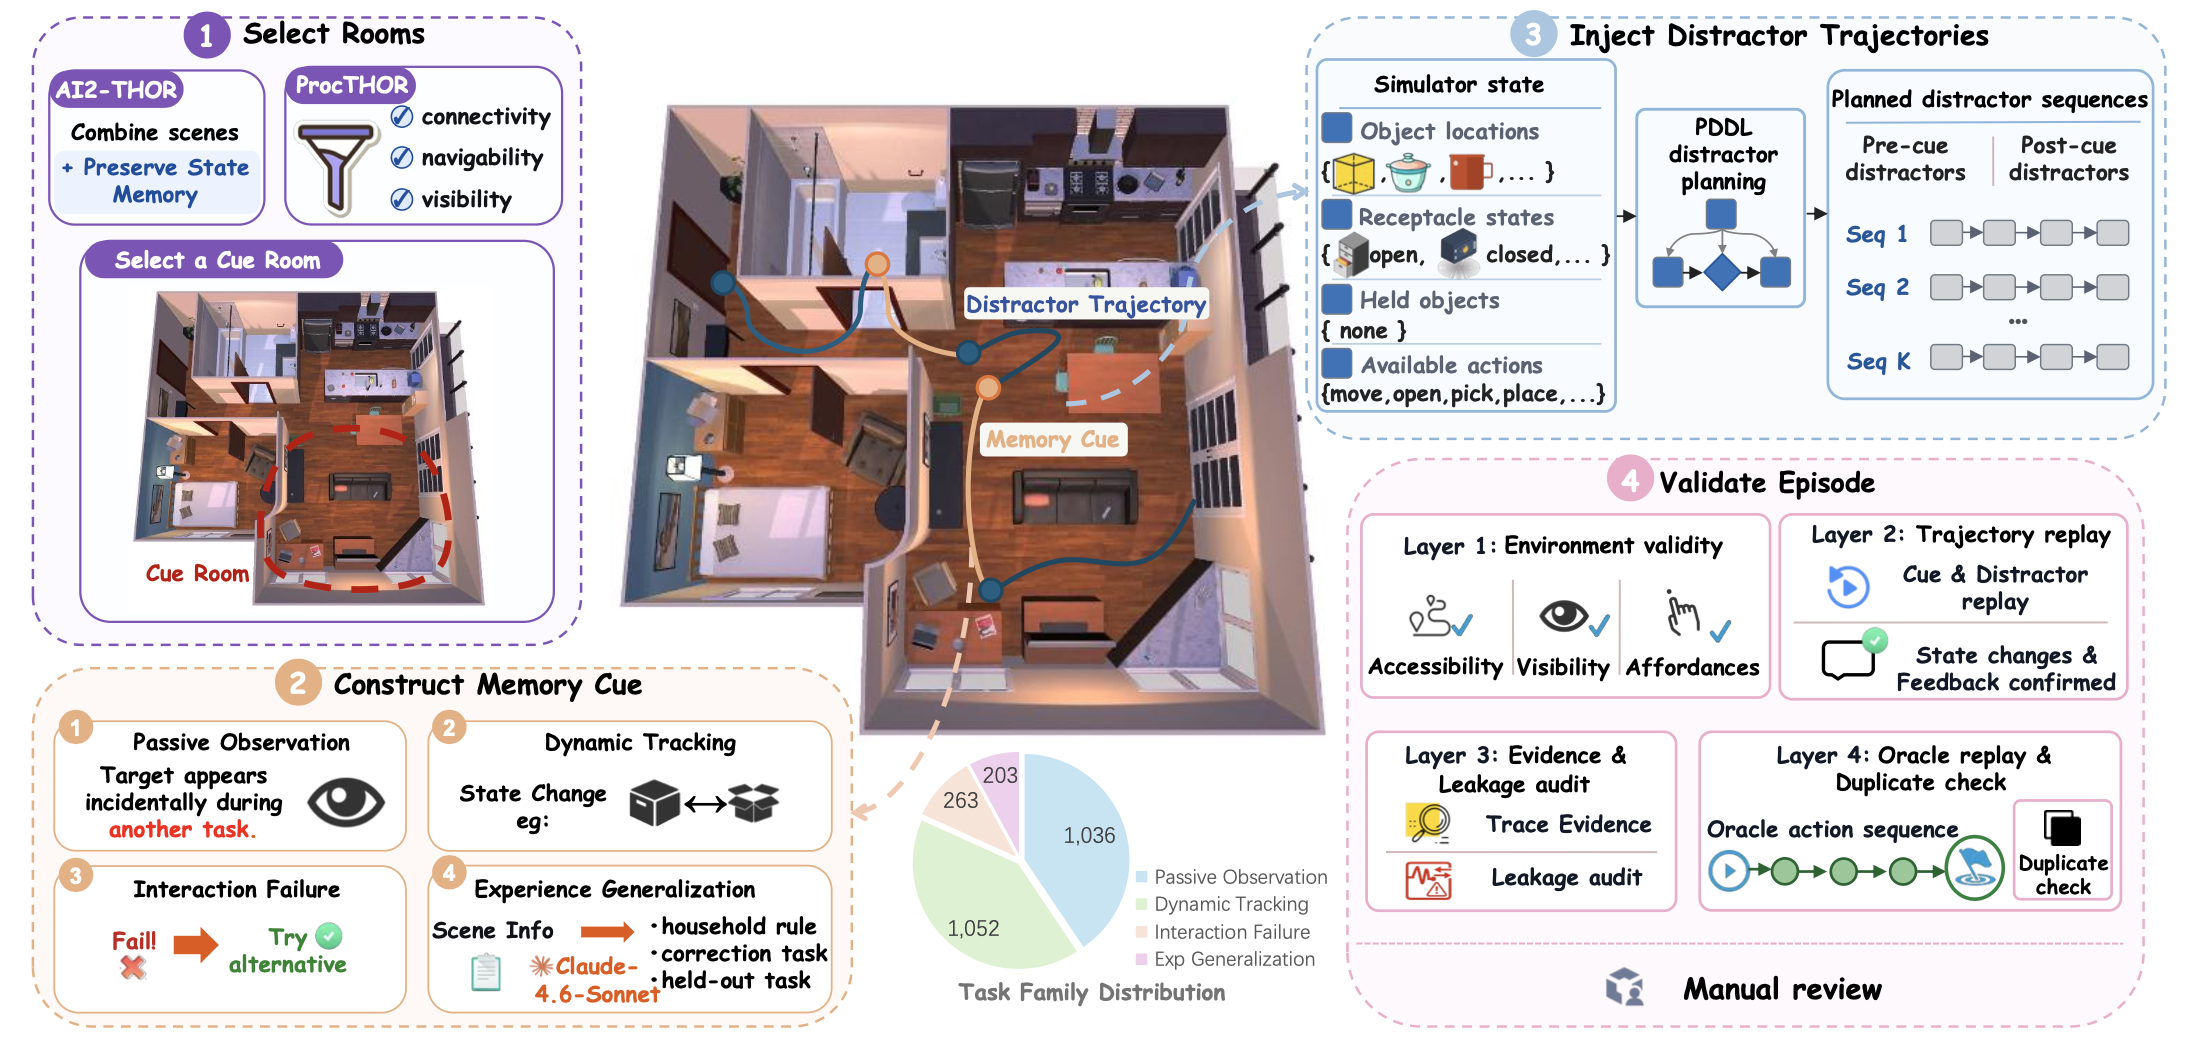
如图 4 所示EMem-Bench 的构建流程。每个实验回合(episode)结合基于实际环境的场景、特定任务的记忆线索以及干扰轨迹,随后进行自动验证与人工审核。
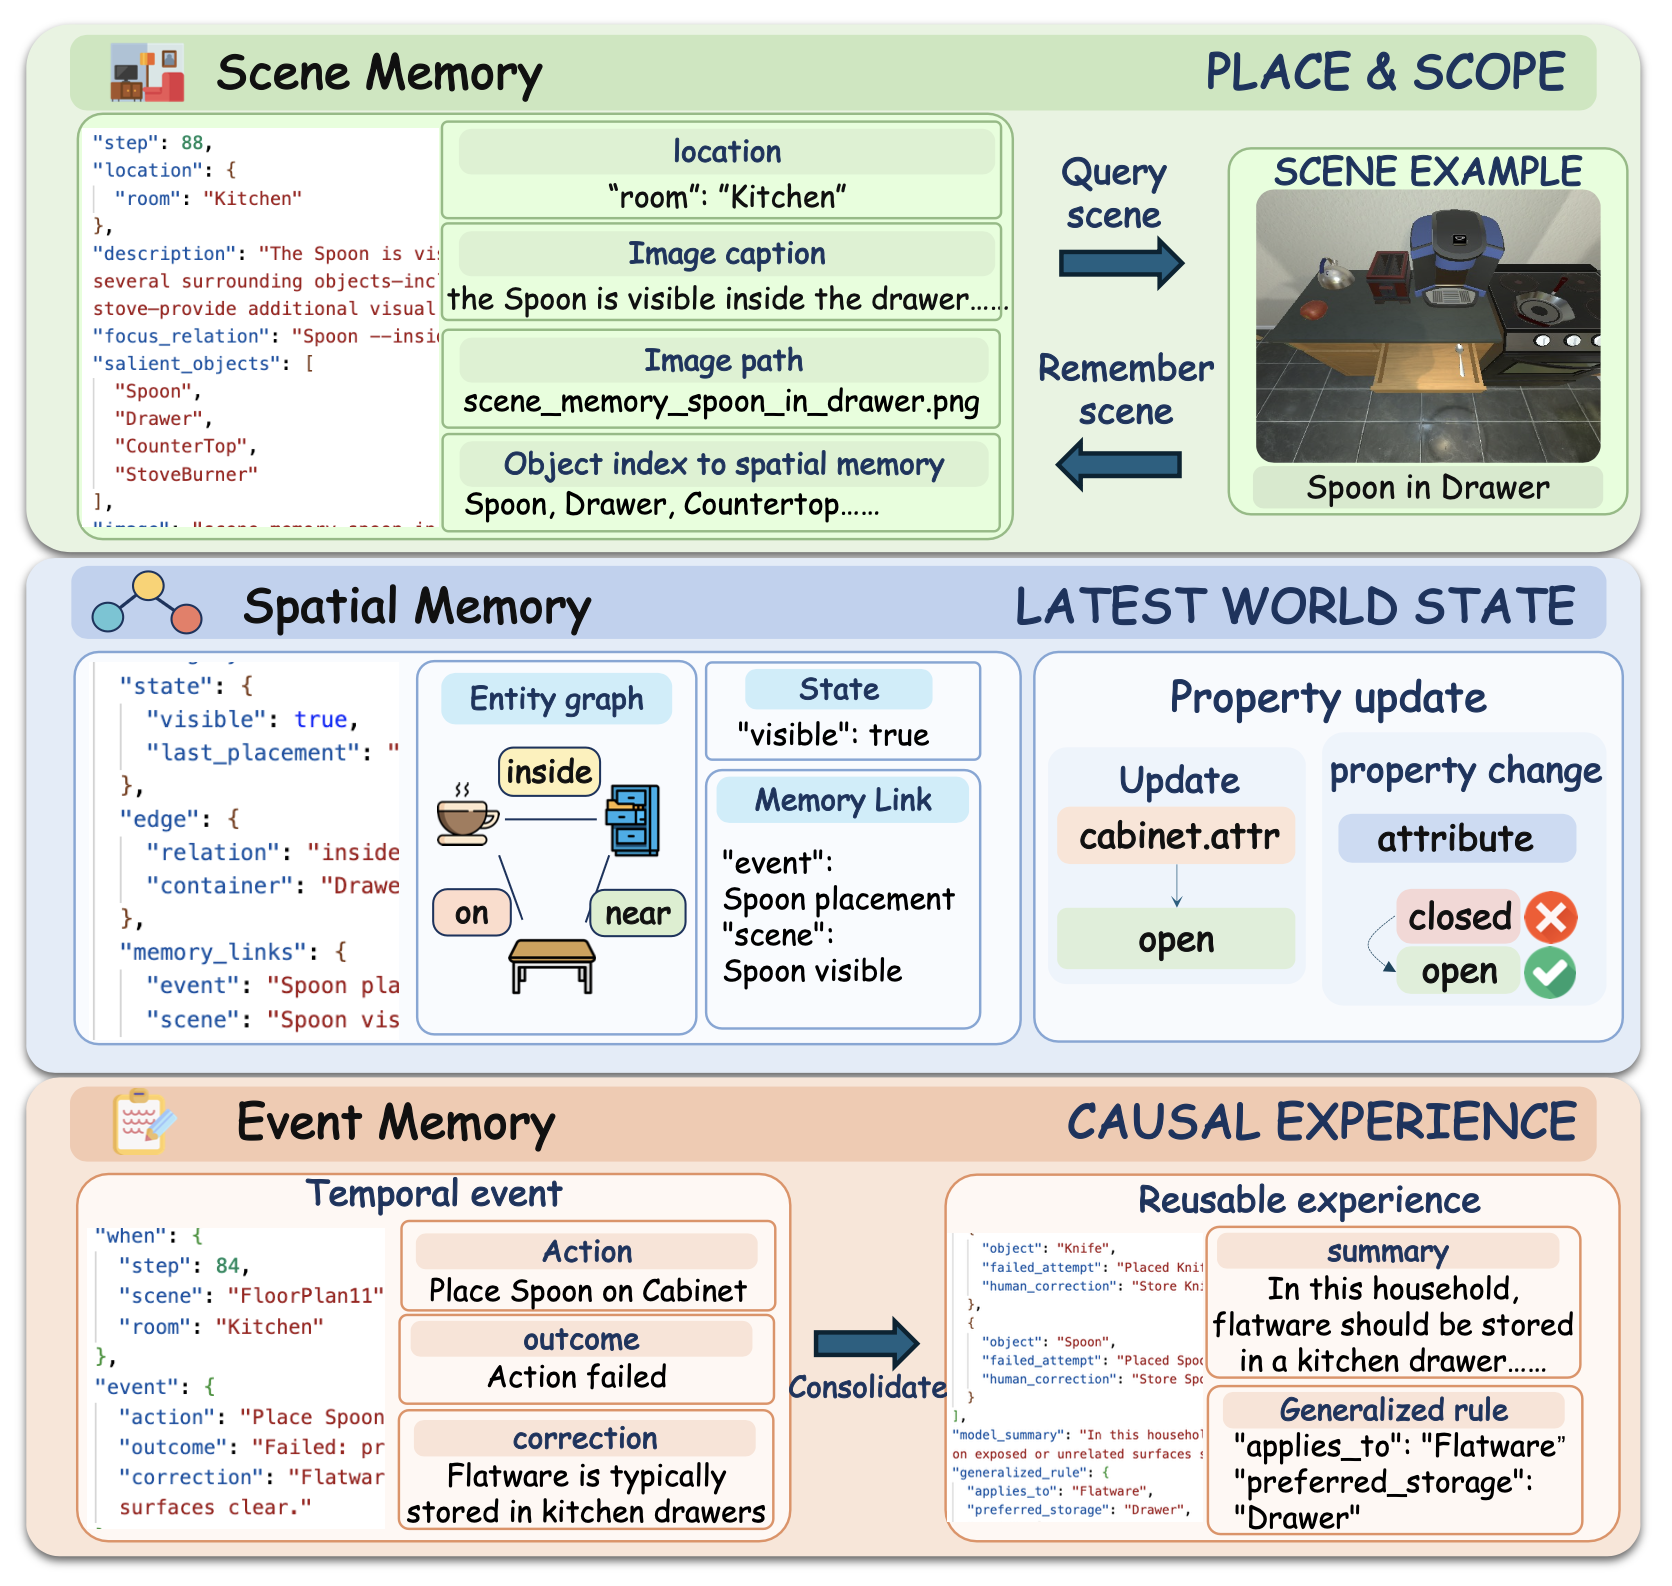
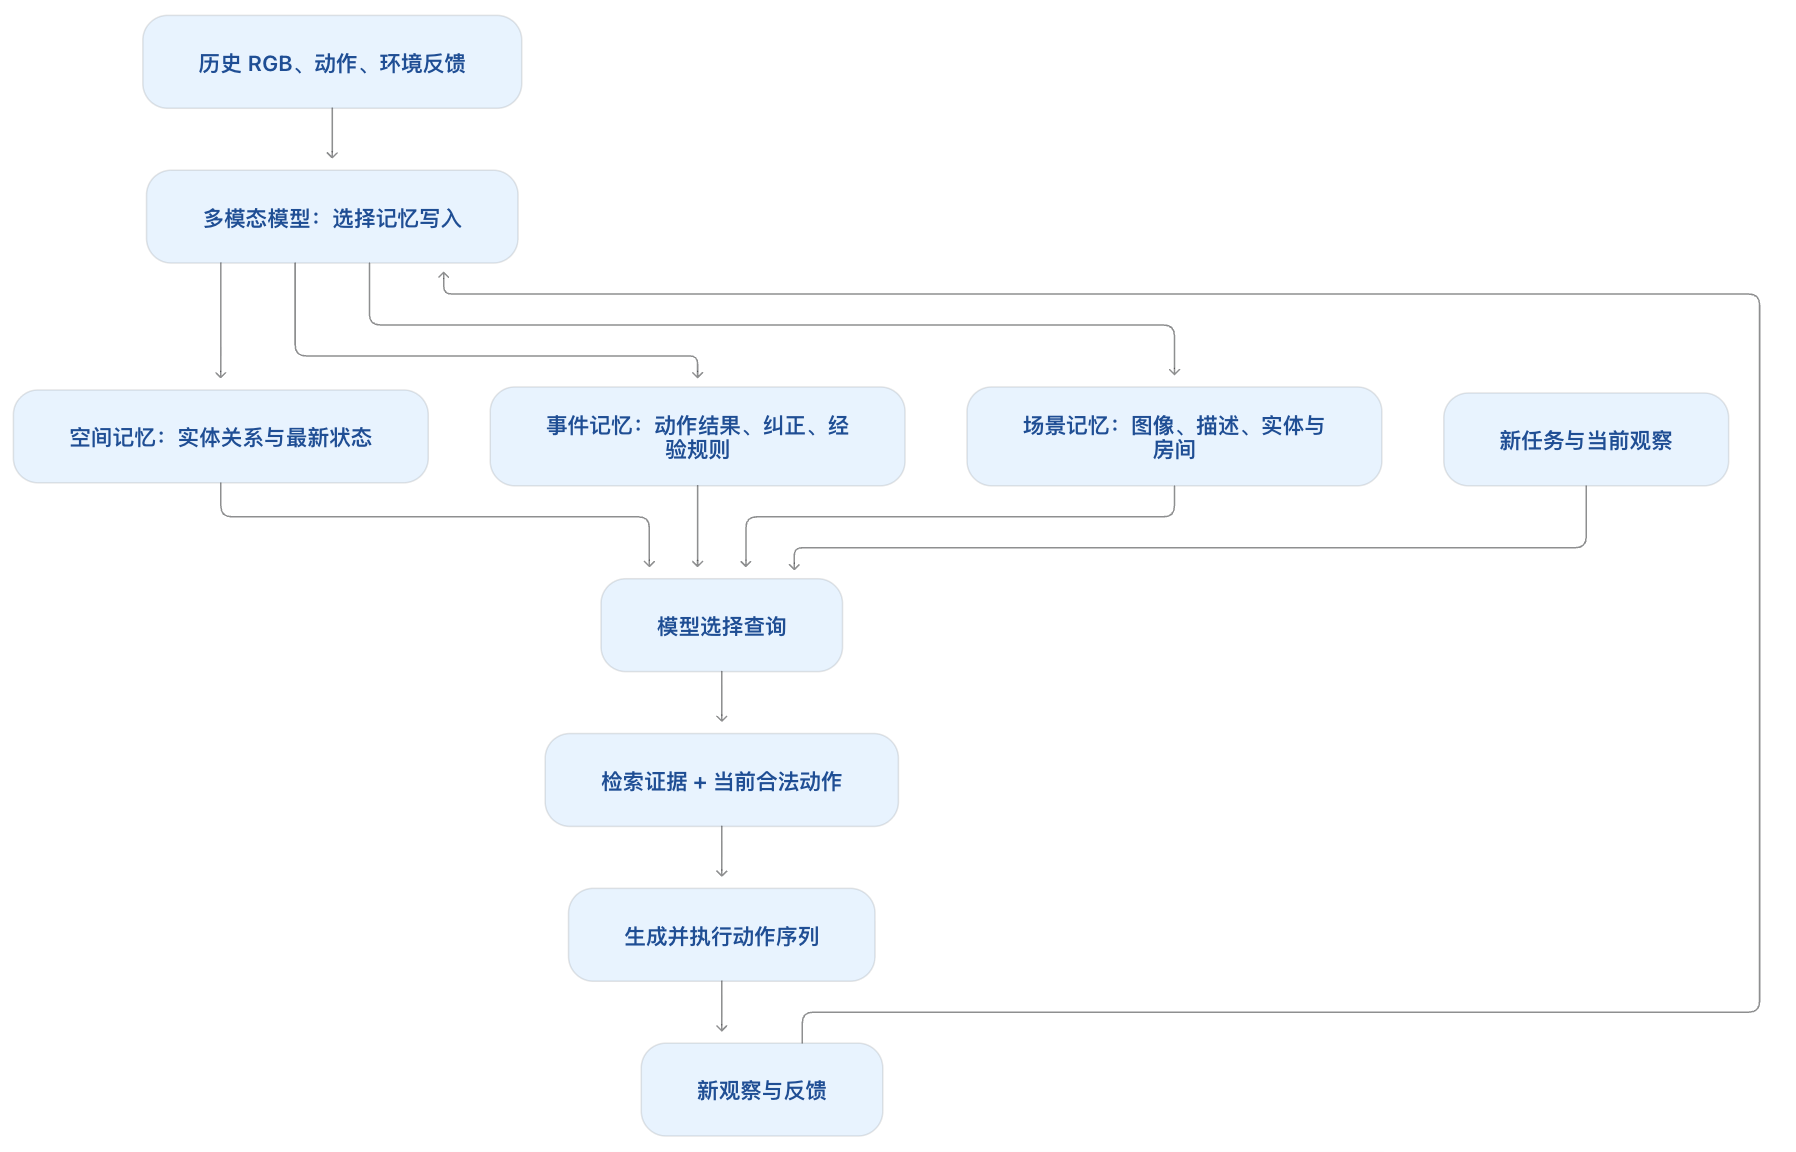
如图 6 所示EMem 架构。场景记忆存储视觉上下文,空间记忆维护当前物体状态,事件记忆记录交互过程及可复用的经验。
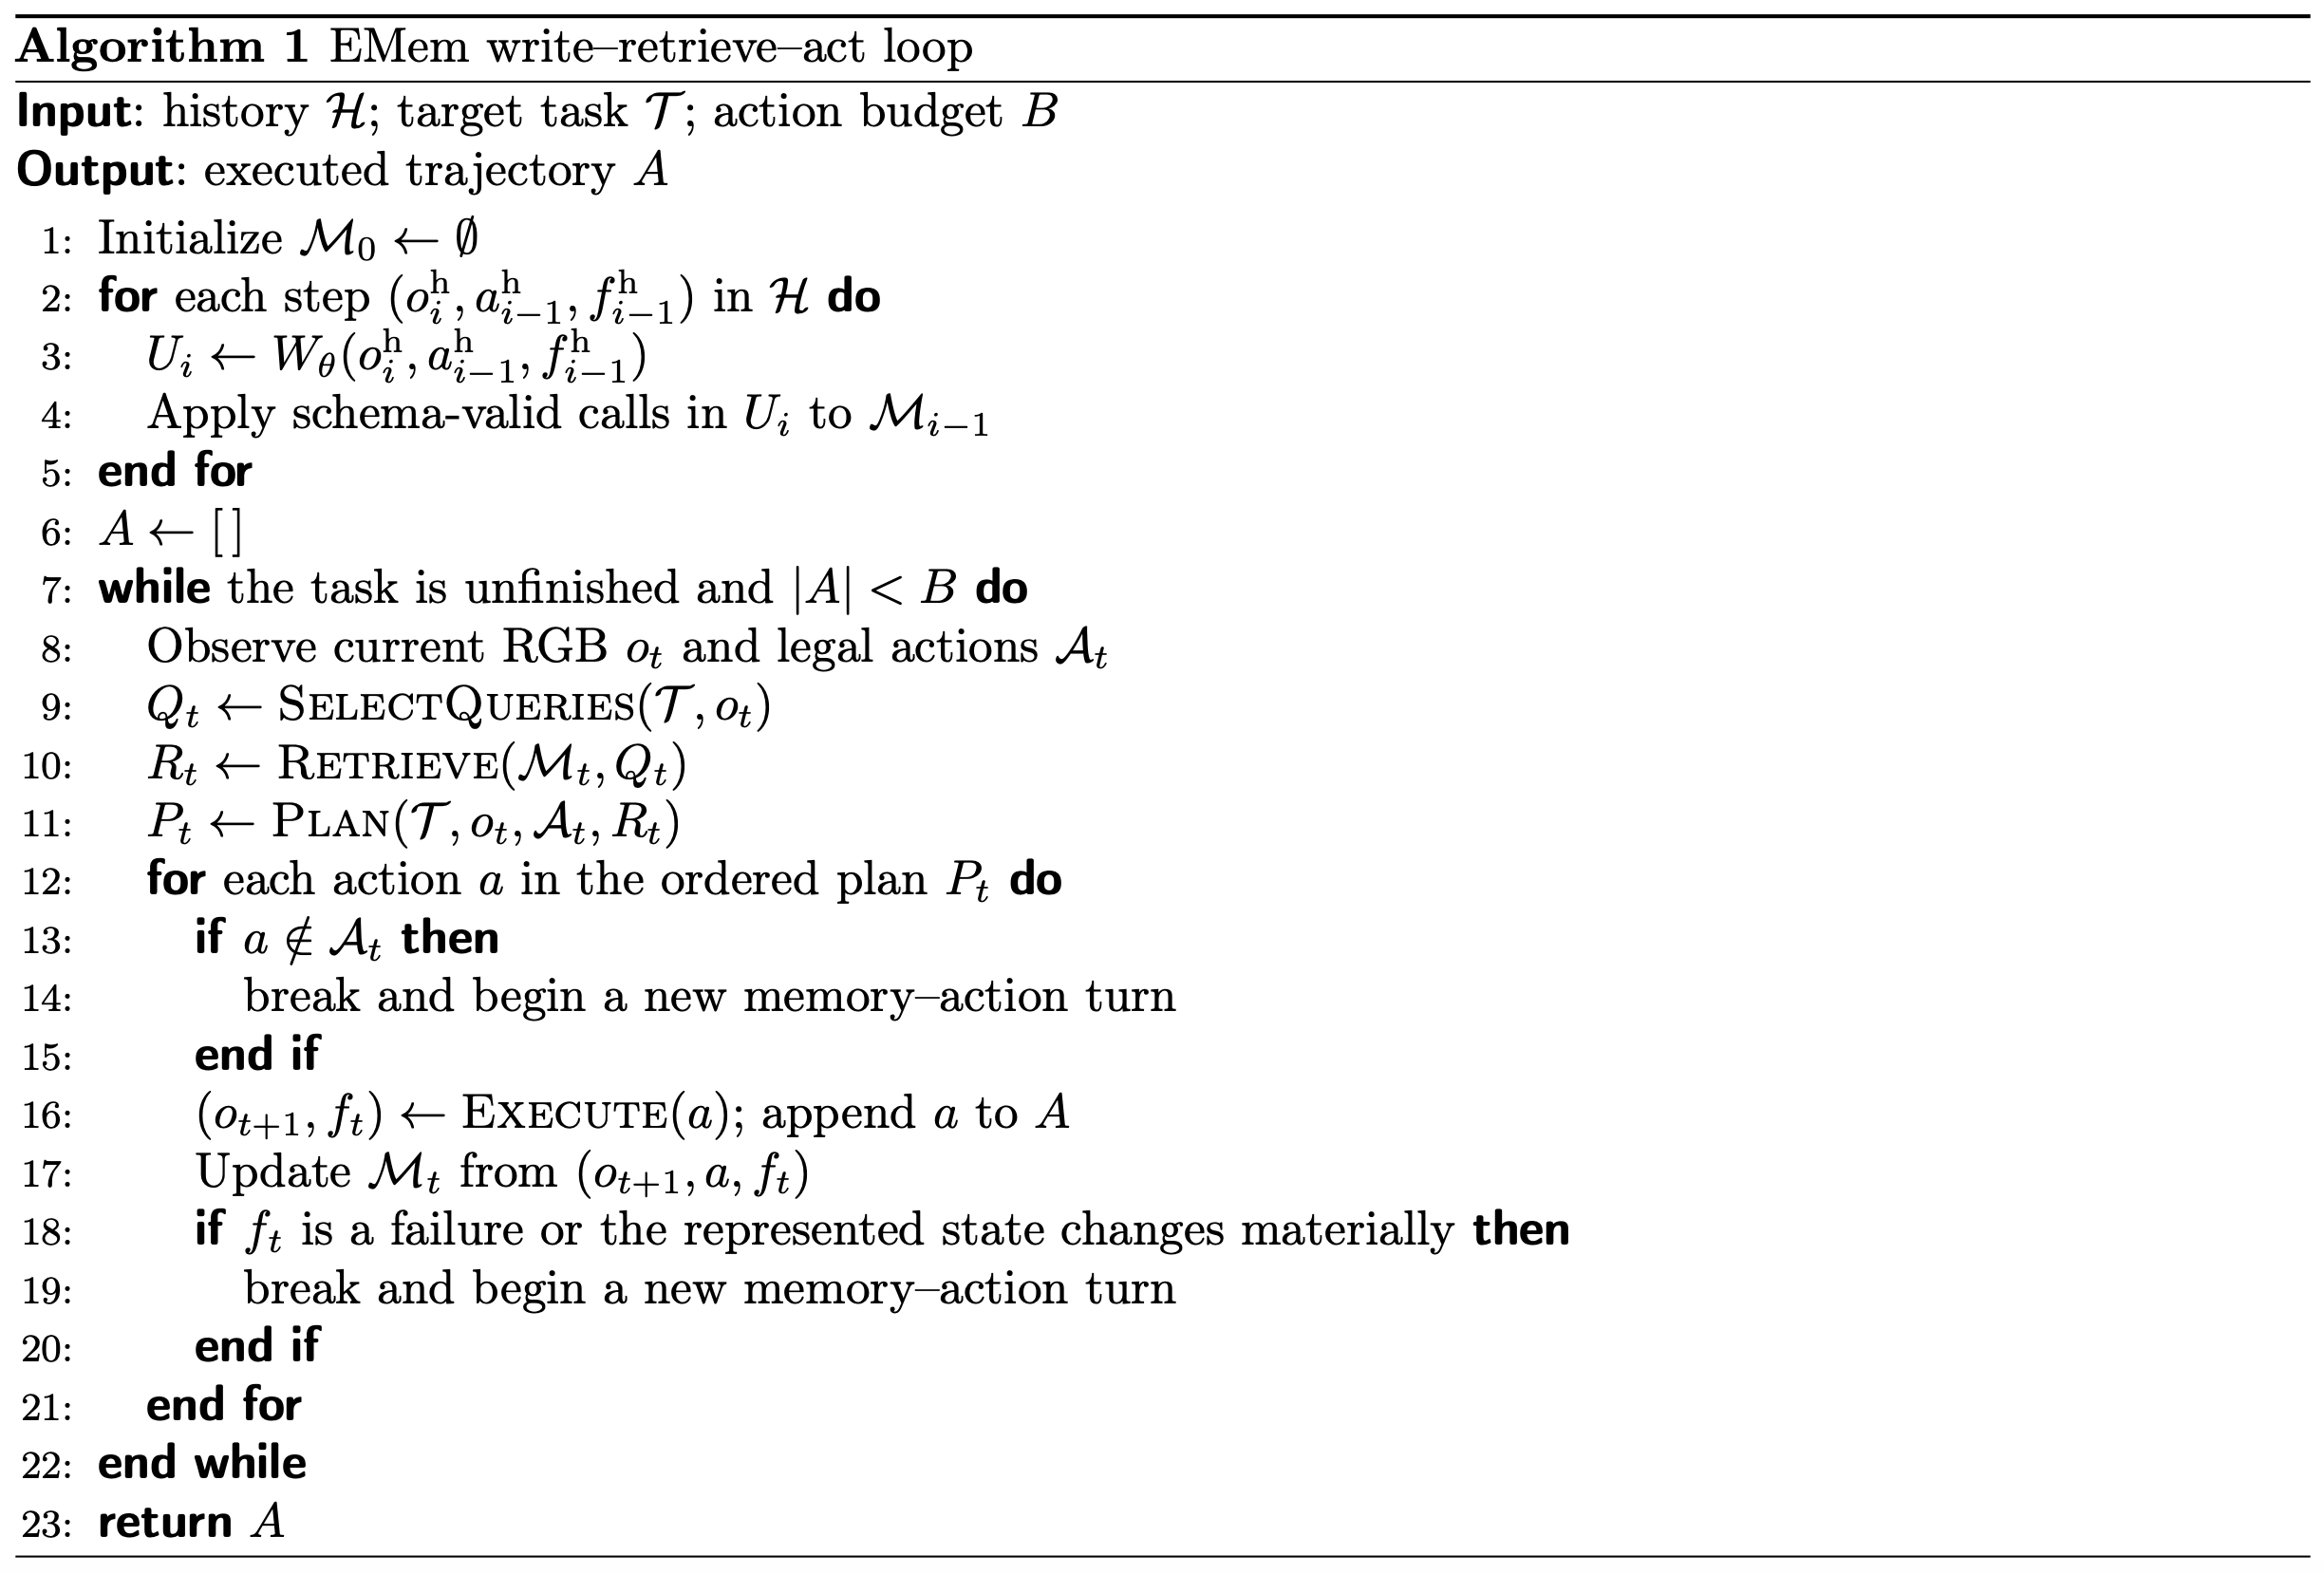
如下算法 1 是EMem 写入-检索-动作循环:
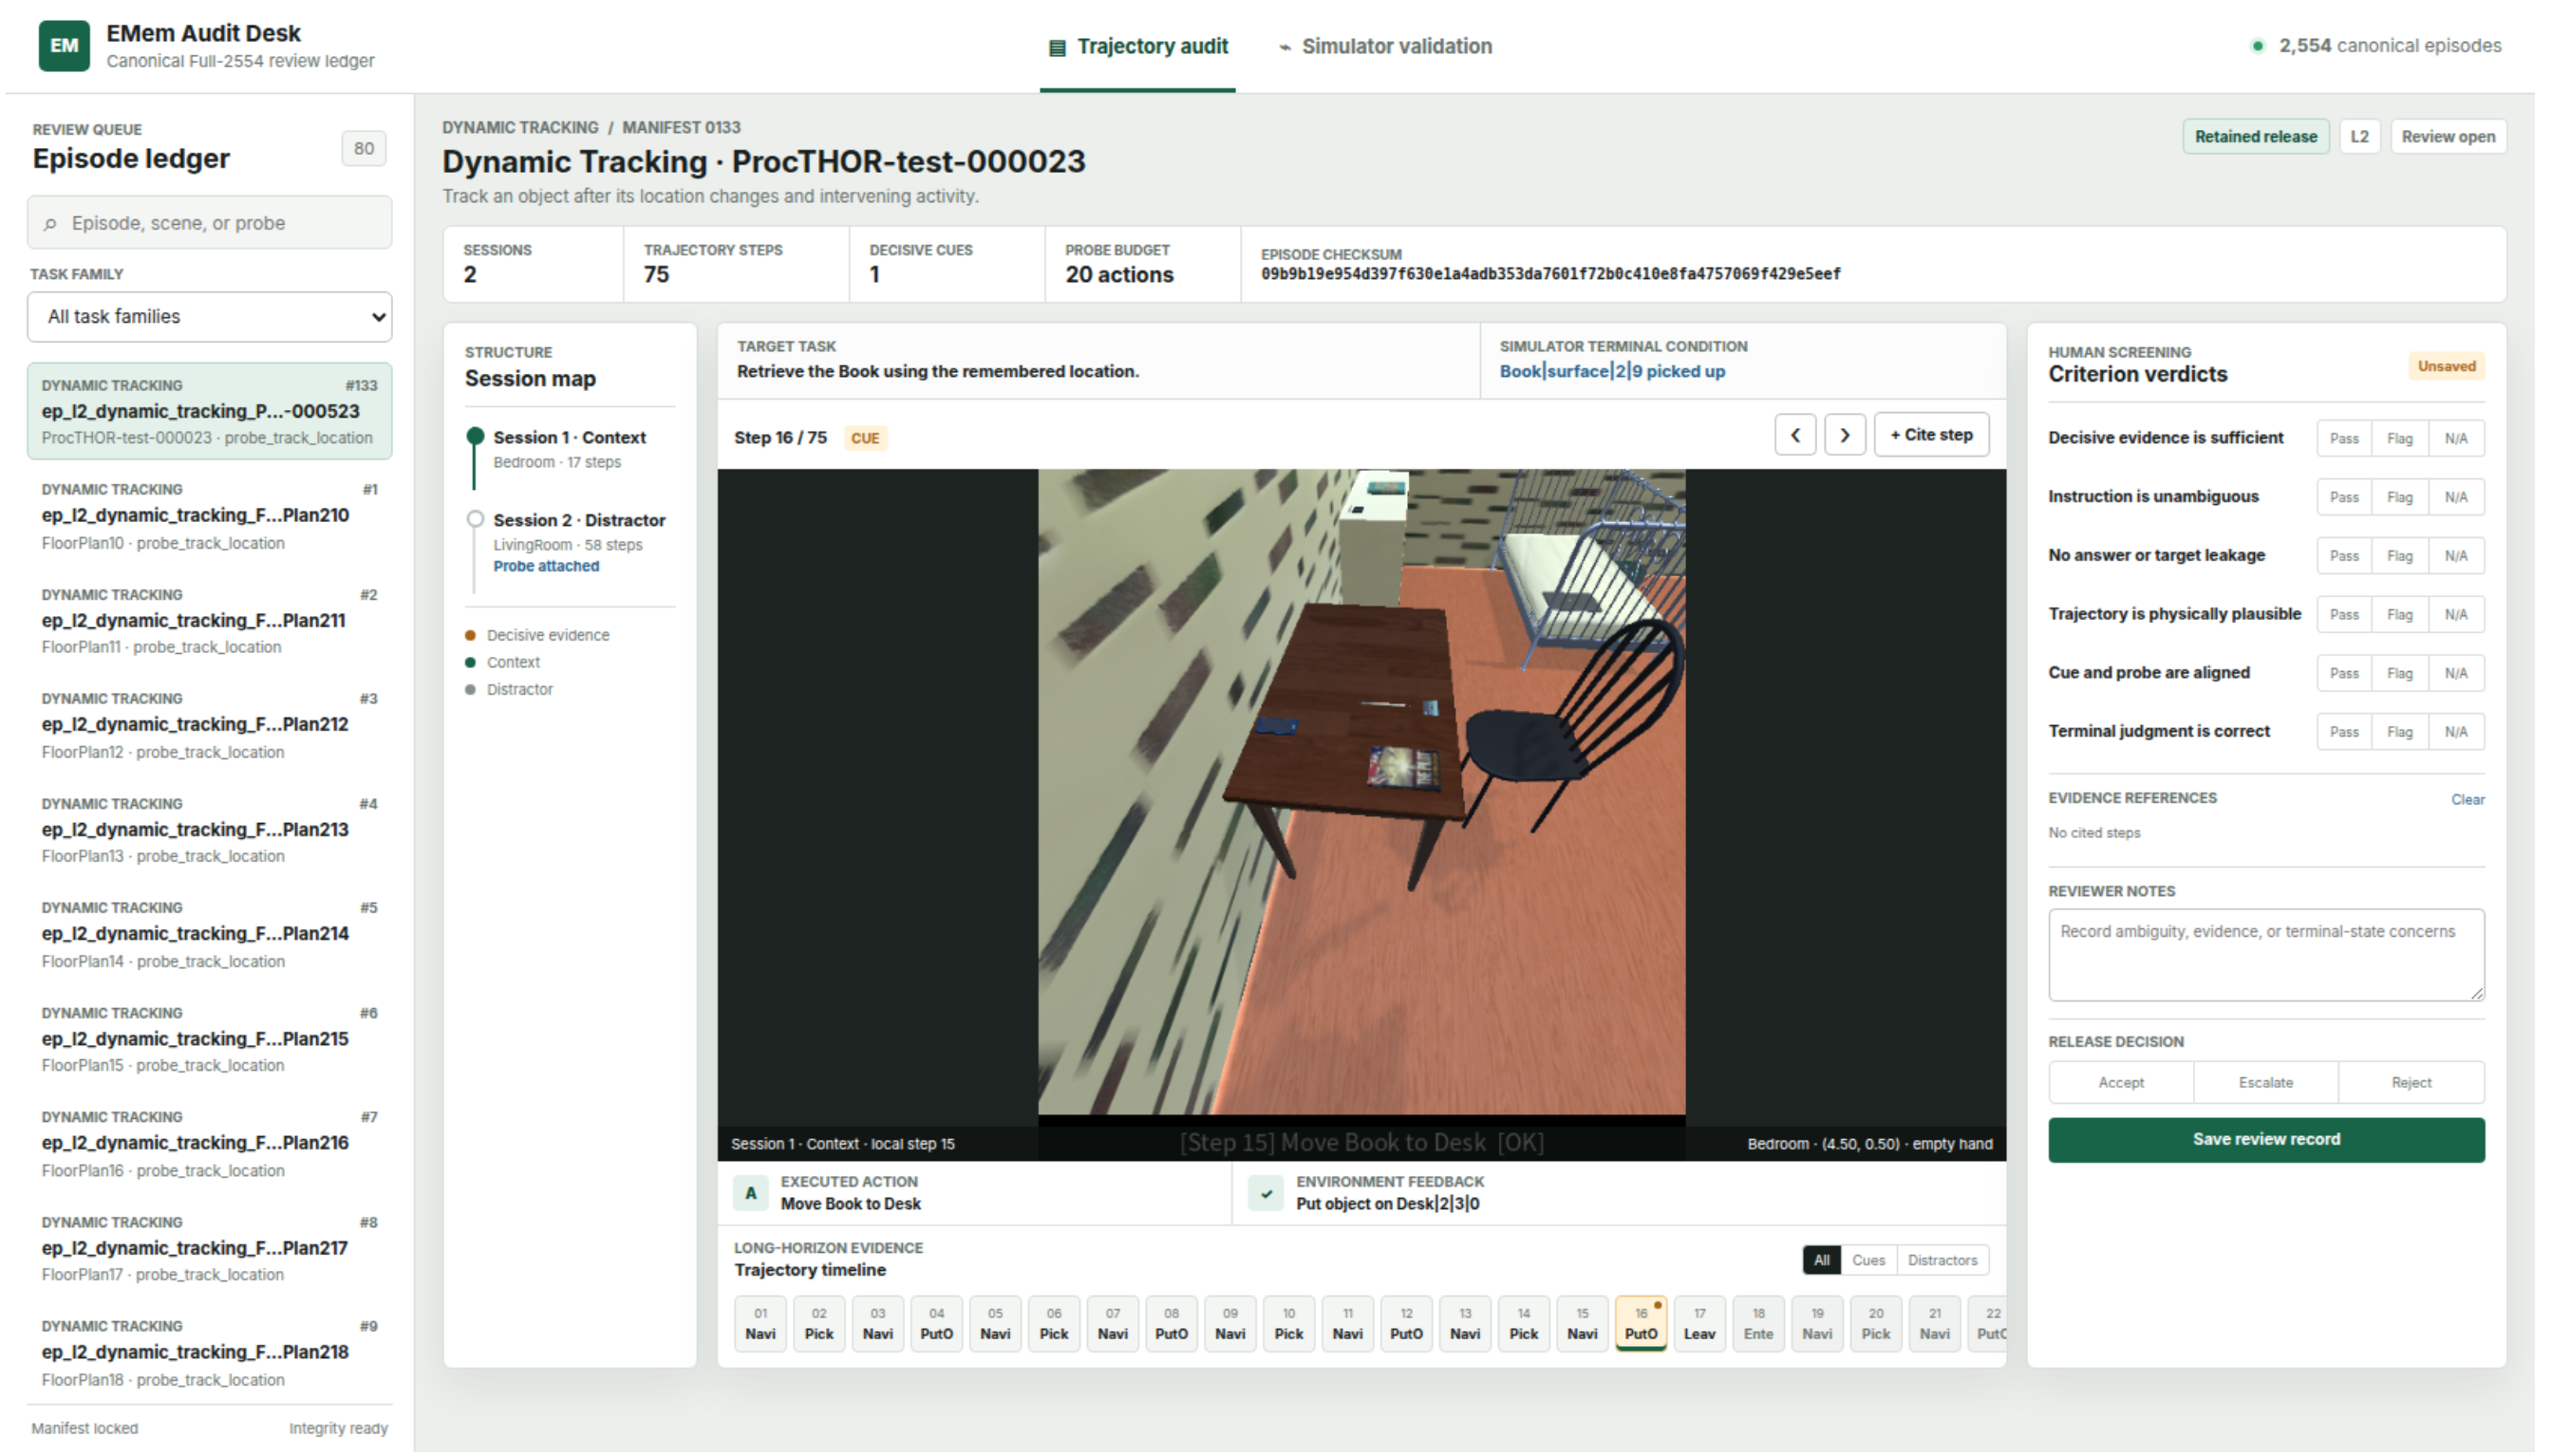
如图 11 所示EMem-Bench 在一个典型的"动态追踪"(Dynamic Tracking)任务片段上的人工审核界面。左侧队列用于在固定的任务清单(manifest)中定位特定片段,会话图(session map)则保留上下文与噪声的边界信息。中间区域通过放大显示的观测画面、动作-反馈对以及完整的 75 步时间轴,将目标状态与终止条件进行对齐;其中高亮显示的步骤记录"书"(Book)从原先所在的"箱子"(Box)位置移动到"书桌"(Desk)的过程。右侧面板记录了针对各项标准的判定结果、引用的证据步骤、备注信息以及最终的发布决策。模拟器验证模式利用同一工作区执行符合基准规范的动作,并实时查看任务进度及终止状态的判定情况。
二、方法要点:先积累经历,再用记忆完成任务
每个评测样本包含历史交互轨迹、后来给出的目标任务,以及可执行动作集合。智能体必须从过去的图像、动作和反馈中恢复关键信息,再通过实际行动完成任务。
四类任务分别是:
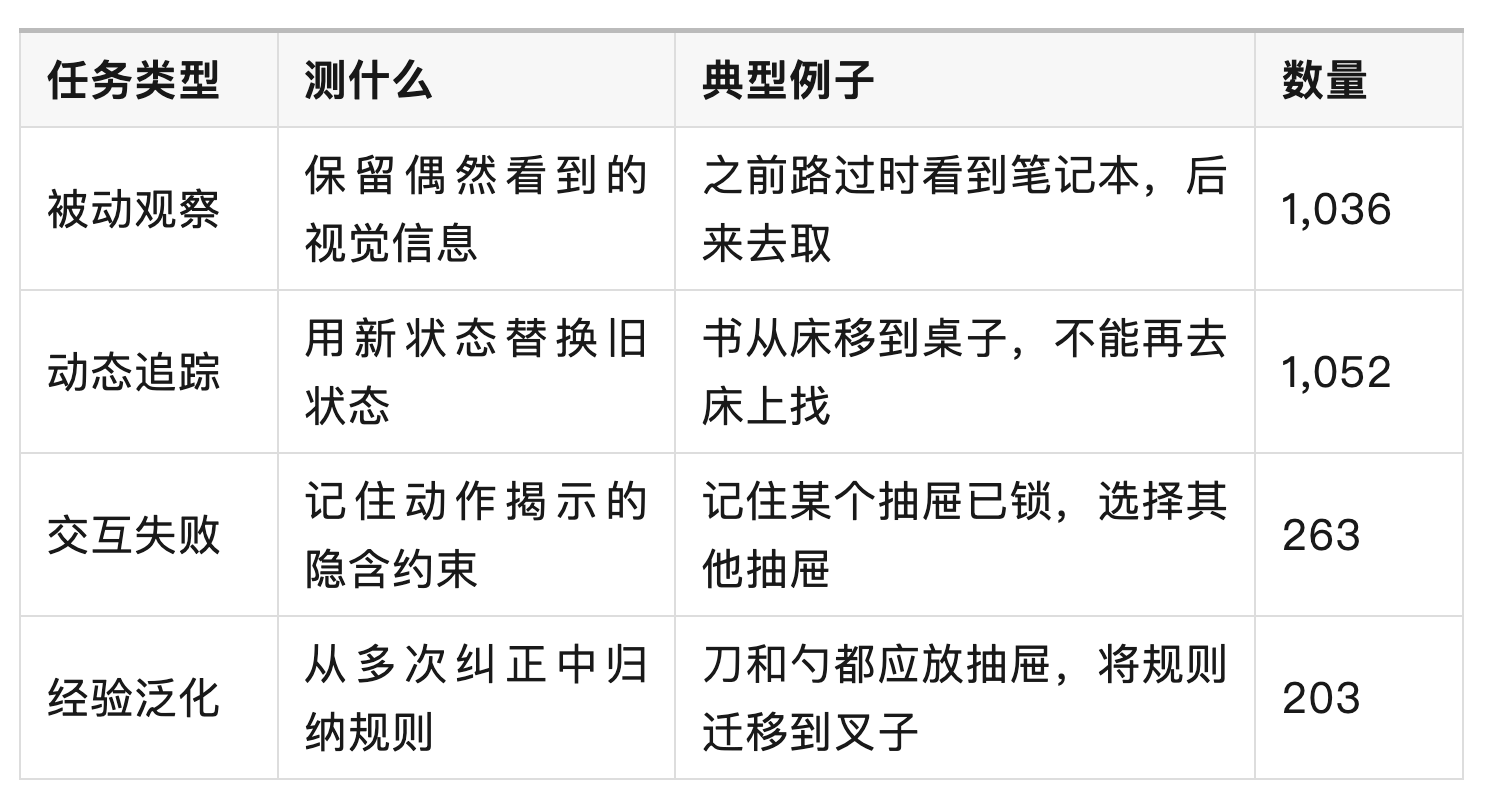
任务在 AI2-THOR 和 ProcTHOR 中构建,通过规划器插入无关活动,拉开关键线索与目标任务的距离。作者还进行了可执行性、线索泄漏等自动检查和人工审核。
主要指标是任务成功率 SR,整体成绩为四类任务的等权平均。另设错误复现率 ERR,衡量智能体是否犯下历史信息本应帮助其避免的错误。
这里需要明确:论文的"长时程"主要体现在历史输入很长,而后续目标任务最多只有 8 步动作。 四类历史平均约为 72---113 步,因此它更准确地测量"长历史条件下的记忆驱动执行"。
三、模型框架:三类记忆与一个闭环
EMem 的核心是多模态模型负责决定"记什么、查什么、怎么行动",外部后端负责实际存储、更新和检索。它不是全新神经网络架构,也不是端到端机器人控制模型。
三类记忆的分工如下。
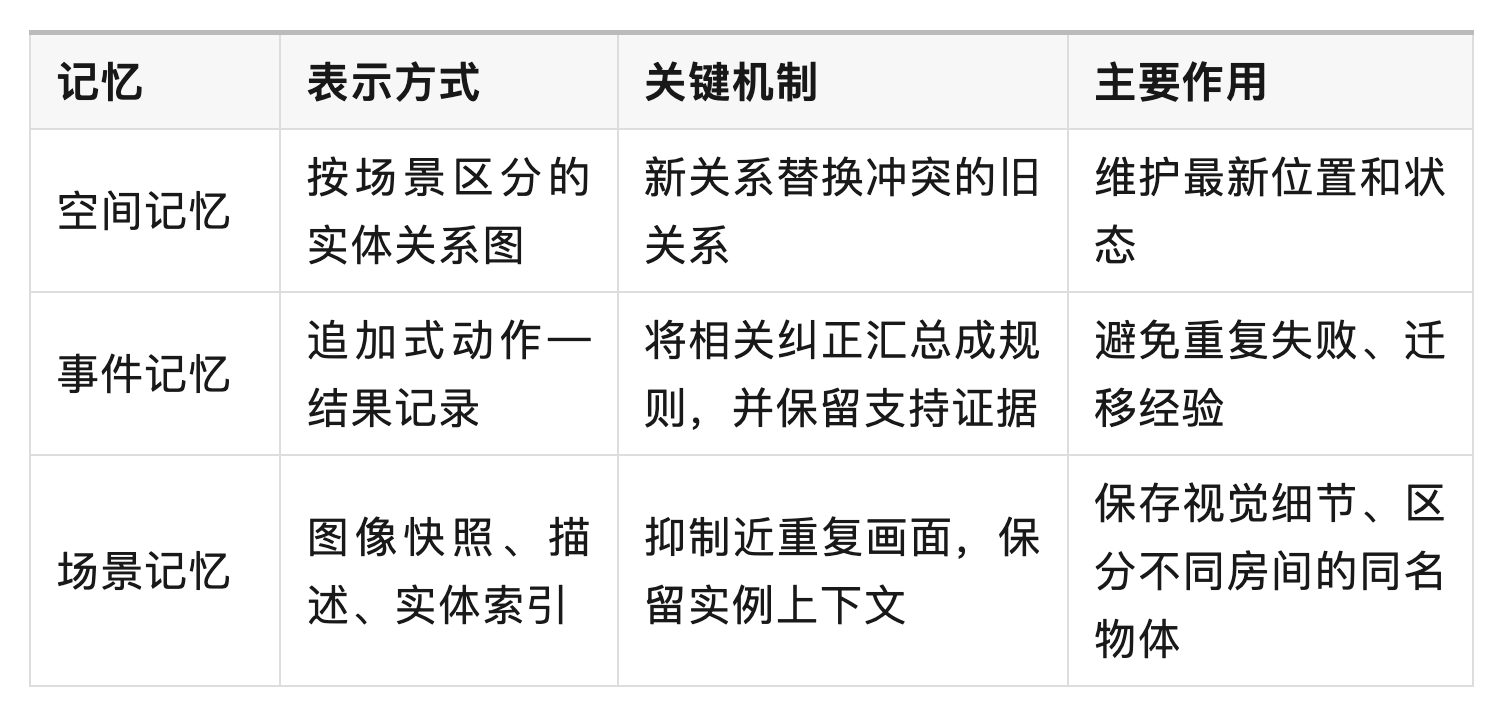
其中几个实现细节尤其重要:
1 写入时不知道未来任务。
模型按时间顺序处理历史,只能依据当前观察和反馈保存信息。这避免了提前知道目标后,有针对性地整理答案。
2 空间记忆执行显式状态替换。
当书的新位置是桌子时,后端删除与之冲突的旧位置关系,同时保留不冲突的属性。动态追踪的改善,部分来自这一明确的工程机制。
3 检索以结构化匹配为主。
先按场景、实体、关系、动作等过滤,再进行精确匹配和词汇匹配,语义相似度作为补充。每次查询主要返回最多 12 条记录。
4 执行后继续更新记忆。
动作失败、不可执行或状态发生显著变化时,中断剩余计划,重新检索并规划。
EMem-8B 则通过监督微调学习三类输出:记忆写入、记忆查询和动作生成。附录报告共 93 条母轨迹、8,852 个监督轮次,使用 LoRA 微调一个 epoch。它学习的是记忆工具使用策略,后端的关系替换和检索机制仍由程序实现。
四、实验支持了什么贡献
最有说服力的贡献有三点。
首先,评测把记忆与实际行动结果联系起来。
仅能回答"书在哪里",不代表能正确取回书。该基准要求通过模拟器中的最终状态判断成功,比单纯问答更接近具身任务需求。
附录的历史干预实验也支持这种设计。对同一组 800 个任务,GPT-5.4-mini 的成绩为:
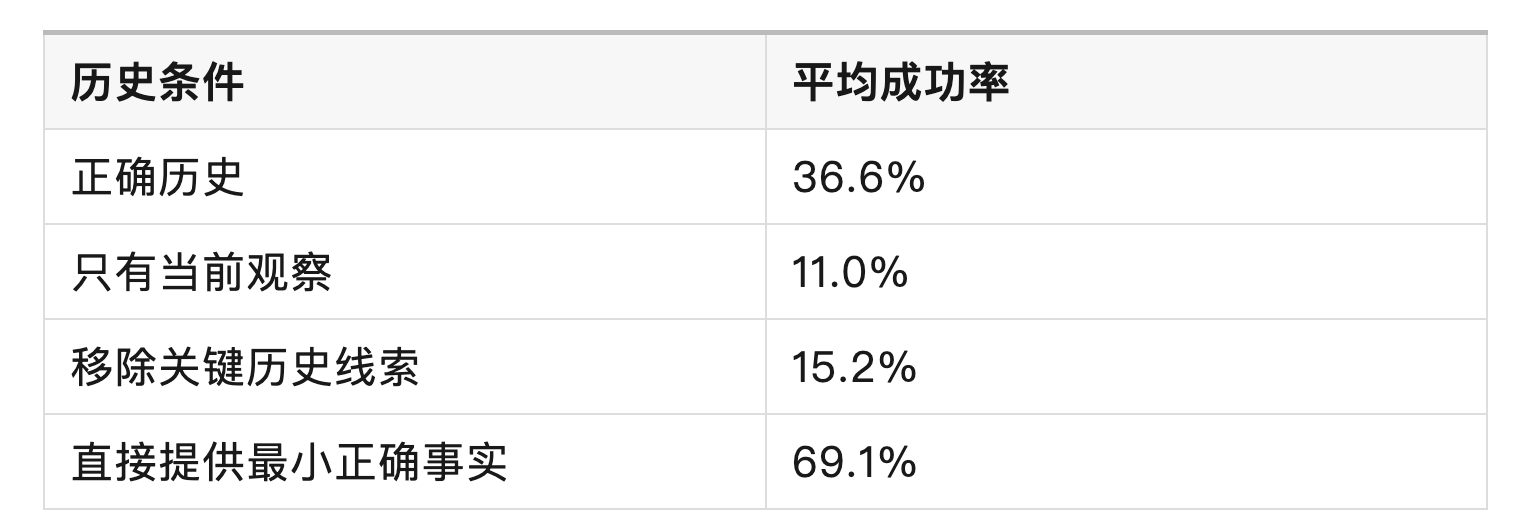
这说明历史线索整体上确实有用,而"从复杂历史中恢复关键事实"是明显瓶颈。
其次,结构化记忆在多个骨干上产生了较大收益。
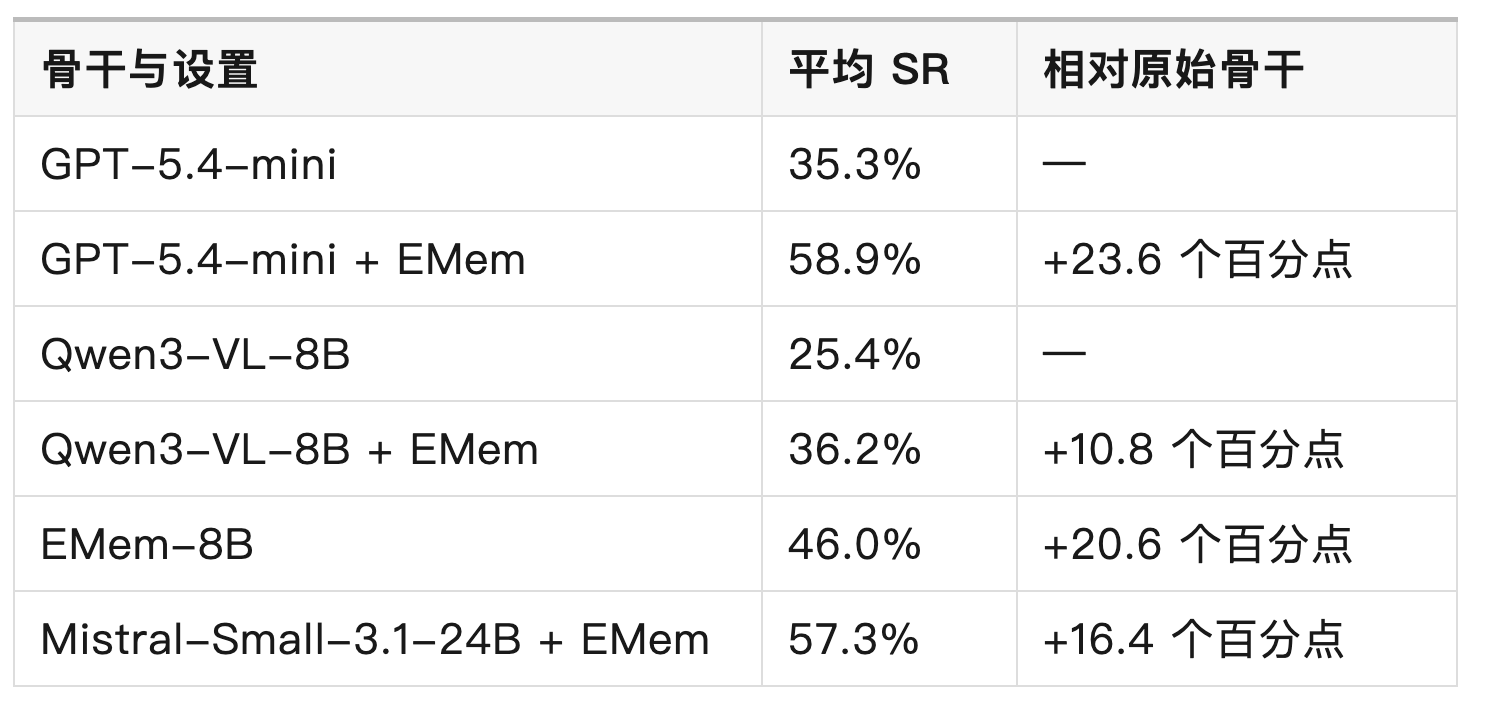
这里应区分两部分收益:Qwen3-VL-8B 加入外部记忆带来 10.8 个百分点,进一步训练记忆操作又带来 9.8 个百分点。
再次,消融结果支持三类记忆具有互补性。
完整系统为 58.9%;分别移除空间、事件、场景记忆后,降至 47.9%、46.9%、47.3%。事件记忆对失败处理与经验泛化尤其重要,场景记忆对被动观察尤其重要。
但 EMem 并非所有设置下都最优:它在同一 GPT-5.4-mini 骨干的记忆系统比较中平均成绩最好,仍低于论文中 Gemini-3-Flash 的 64.2%;动态追踪单项也低于 TeleMem。
五、主要问题与结论边界
- 基线与 EMem 的信息处理和计算量不完全对齐。
标准 full_context 基线接收完整历史文字和当前图像,没有完整历史 RGB;EMem 则逐步读取历史 RGB,并额外调用模型整理记忆。
因此,相对标准基线的提升同时包含:
历史视觉信息的利用;
额外推理计算;
结构化存储和状态更新;
检索与执行流程的改变。
论文增加了"尽量塞入历史图像"的实验,但这不足以隔离上述因素。更有说服力的比较,应统一历史信息、总模型调用预算及执行控制器,再比较不同记忆结构。
- "增加上下文无效"的结论应收窄。
在 GPT-5.4-mini 的 800 个任务上,增加大量历史图像使 SR 从 36.6% 降至 26.2%,输入量和延迟明显增加。
这支持:对该模型和输入策略,无选择地追加历史图像效果不好。
它并不能证明更长上下文本身无用,也不能排除关键帧选择、分层视觉摘要或更强视频理解模型的收益。
- 记忆依赖性在四类任务中并不均衡。
表 12 有一个值得重视的细节:交互失败任务中,GPT-5.4-mini 在正确历史、只有当前观察、移除线索时分别为 19.0%、19.0%、20.5%。
也就是说,宏观平均上的线索效应明显,但这一任务族没有呈现相同趋势。可能是执行瓶颈掩盖了历史作用,也可能存在探测设计或信息利用问题,需要进一步拆解。
即便直接给出正确事实,该任务族也只有 48.0% 成功率,说明其困难不能全部归因于记忆检索。
- 最新观测覆盖旧状态,在噪声环境中可能出错。
目前的机制隐含假设:新写入的关系足够可靠。如果模型把物体认错,一次错误观察就可能覆盖原本正确的位置。
论文尚未充分处理:
新旧证据冲突;
观察置信度;
状态随时间失效;
同一房间内多个同类物体;
物体跨房间移动后的身份连续性。
这些是从模拟器走向真实机器人时的关键难点。
- 经验泛化主要是局部规则迁移。
将刀、勺的收纳纠正迁移到叉子,证明了从少量案例归纳家庭规则的能力。但这距离复杂技能迁移还有明显差距,例如多步骤操作、条件性规则、规则冲突和失败恢复策略。
事件记录也保留了动作与结果的联系,但论文没有建立严格的因果模型,不能把它直接理解为已具备因果推理能力。
- ERR 存在解释限制。
附录说明,当前所有任务的主要记忆决策点数都是 1,因此 ERR 实际上接近"本任务是否至少触发一次指定错误"的比例。重复犯一次和多次错误,最终都计为 1。
此外,无效动作、执行失败等另行统计,不一定触发 ERR。于是,低 ERR 不必然代表记忆好,也可能是智能体没有有效执行到触发错误的步骤。 应与 SR 和无效动作率联合分析。
- 长期学习与训练收益的证据仍有限。
每个 episode 的记忆都从空开始,尚未测量跨任务、跨天的持续积累、遗忘和污染。训练数据也只有 93 条母轨迹,不能把 8,852 个监督轮次视为同等数量的独立经历。
跨基准中 EB-ALF 提升 5 个百分点较有意义;其他通用多模态基准变化较小,缺少相应不确定性分析,不宜据此作很强的泛化判断。
六、未来最值得推进的工作
可以按以下优先级推进。
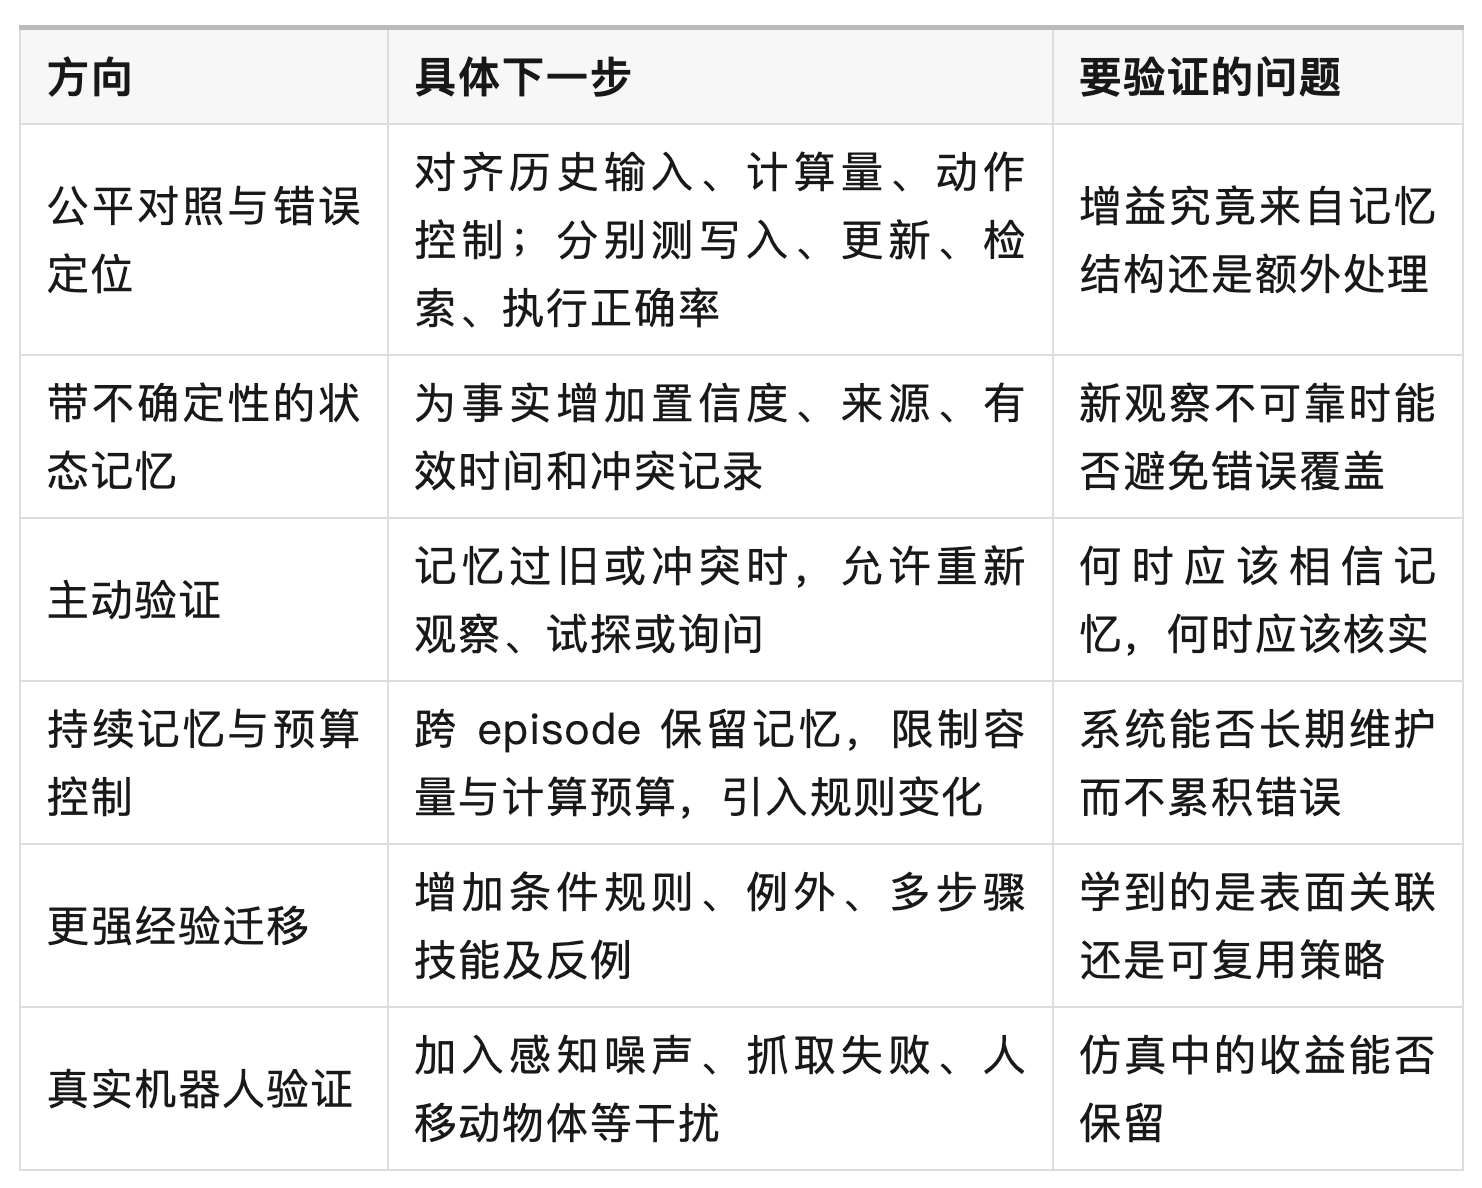
如果以此为基础开展一篇后续研究,我最看好 "具有置信度与有效期的具身记忆,以及由记忆不确定性触发的主动验证"。
具体可以让每条事实保存"内容---对象身份---来源---时间---置信度",遇到矛盾时保留多个假设,并让智能体权衡重新观察的成本与直接行动的风险。实验则控制物体移动频率、感知错误率和记忆陈旧程度,同时报告成功率、错误覆盖率、重复失败次数及额外观察成本。
这条路线直接针对本文"最新记录就是当前事实"的薄弱环节,也能把研究从保存和检索经历推进到判断记忆是否仍然可信,并据此行动。