📖标题:Qwen3.8-Omni: Towards Native Omni-Modal Agents
🌐来源:arXiv, 2609.25611v1
🛎️文章简介
🔸研究问题:现有的多模态模型大多只擅长"看"和"听",但在处理长视频理解、复杂推理以及需要长期规划的自动化任务(如自动剪辑视频、生成音乐MV)时表现不足,如何解决这一短板?
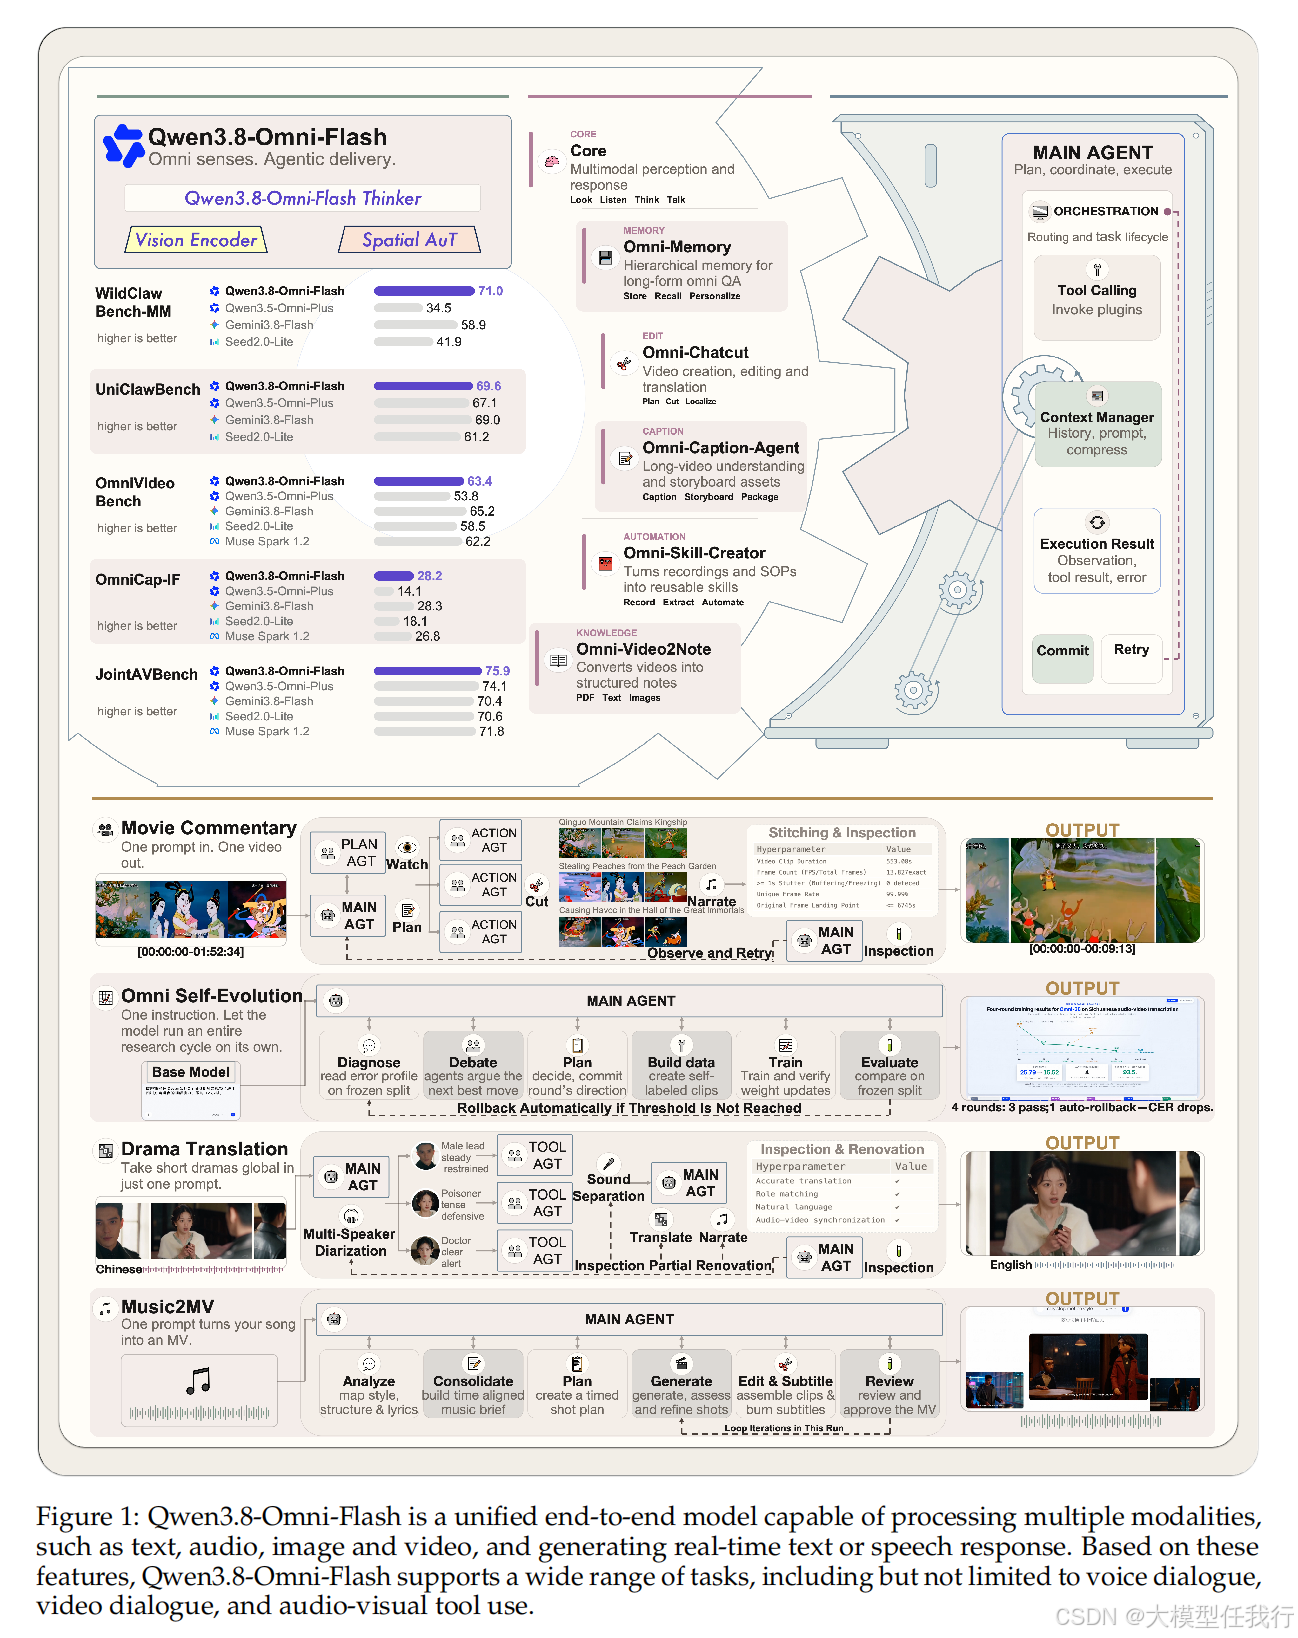
🔸主要贡献:论文发布了Qwen3.8-Omni-Flash,这是一个原生支持文本、图像、音频和视频的全能智能体模型,具备百万级上下文窗口,能进行长程规划和推理,并配套开源了实时交互框架和多模态插件。
📝重点思路
🔸采用原生多模态协同训练策略,在保持强大文本能力的同时,将推理和智能体能力迁移到音视频任务中,使用稀疏混合专家(MoE)架构提升效率。
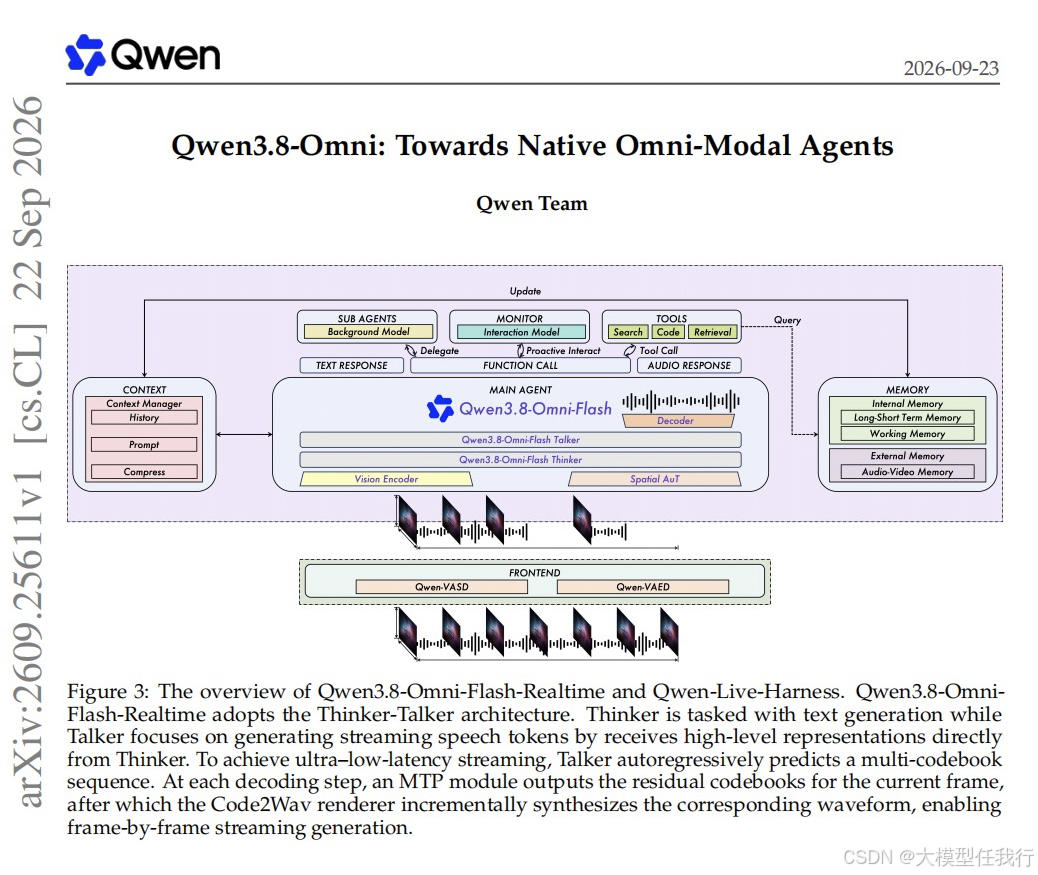
🔸引入空间音频编码器,不仅能听懂内容,还能感知声音的方向和空间位置,结合视觉编码器实现真正的视听融合理解。
🔸将上下文窗口扩展至一百万token,支持超长视频和音频的处理,并通过信息抽象模块(如视频转笔记)降低处理成本,实现按需加载证据。
🔸采用多教师蒸馏和强化学习进行后训练,整合不同领域的专家能力,解决跨模态干扰问题,提升在真实交互中的稳定性和指令遵循能力。
🔸发布Qwen-MM-Plugins和Qwen-Live-Harness两个开源框架,前者帮助现有智能体接入音视频能力,后者支持低延迟的实时多模态交互和异步工具调用。
🔎分析总结
🔸在多项基准测试中,该模型在音频推理、视听理解和长程智能体执行任务上的平均得分比上一代提升了25%以上,性能显著优于同类竞品。
🔸通过智能体模式主动检索证据,模型在长视频理解任务上的准确率大幅提升,同时每个查询的token消耗量减少了约45%,实现了精度与效率的双赢。
🔸在实时交互方面,模型能在保持极低延迟(首字音频延迟约1秒)的同时,提供高质量的语音回复和声音克隆效果,自然度和稳定性处于行业领先水平。
🔸在实际应用场景中,模型能够独立完成从音乐分析到MV生成的全流程,或自动将长会议视频转化为结构化纪要和行动项,证明了其在生产力工作流中的实用价值。
💡个人观点
论文打破了传统多模态模型仅作为"感知器"的局限,真正赋予了模型"行动力"。它不再只是被动地描述视频内容,而是能像人类助理一样,主动规划、调用工具、处理长达数小时的音视频素材,并完成复杂的创作或分析任务。