前言
前三讲建立了一套几何:相机位姿 T 住在 SE(3) 上,可以用李代数扰动求导和更新;三维路标 P_w 经过 T 和内参 K 投影成像素 p_uv。现在假设我们拿到了一段视频,每一帧都提取了特征点、并且知道哪些特征点对应同一个路标。问题是:这些位姿和路标到底是多少?
这个问题之所以难,不是因为公式复杂,而是因为数据有噪声 。每个像素位置都有半个像素左右的误差,IMU 每个读数都带噪声。如果没有噪声,几个方程联立就能解出来;有了噪声,方程彼此矛盾,没有一组位姿和路标能让所有方程同时成立。我们只能问一个更弱的问题:哪一组位姿和路标,最有可能产生我们看到的这些带噪数据?
这是一个概率问题。这一讲的前半部分从概率出发,一步步推导,最后发现它等价于一个形式非常干净的数学问题:最小化一堆误差项的加权平方和,也就是最小二乘。后半部分讲怎么解这个最小二乘------由于观测方程里有除以深度、有旋转矩阵,它是非线性的,没有闭式解,只能迭代。高斯牛顿法和列文伯格-马夸尔特(LM)法是两种标准的迭代算法,几乎所有 SLAM 后端都用其中之一。
如果你在 EMF 项目里写过卡尔曼滤波,请留意:卡尔曼滤波解的是同一个概率问题,只是采用了"每来一个数据更新一次"的递推方式;这一讲的批量最小二乘则是"把所有数据攒在一起一次性求解"。两者的关系书会在第 10 讲详细比较,这里先把共同的根------最大后验估计------讲清楚。
第一章 状态估计问题
1.1 把 SLAM 写成两个带噪声的方程
回顾第 2 讲的运动方程和观测方程,加上噪声项:
x_k = f(x_{k−1}, u_k) + w_k (运动方程:上一时刻状态 + 输入 → 当前状态)
z_{k,j} = h(y_j, x_k) + v_{k,j} (观测方程:在状态 x_k 看路标 y_j → 观测 z_{k,j})
x_k 是第 k 时刻的位姿,u_k 是输入(例如 IMU 读数或轮速计),y_j 是第 j 个路标,z*{k,j} 是在 k 时刻对 j 路标的观测(例如一个像素坐标)。w_k 和 v*{k,j} 是噪声,假设它们是零均值高斯的:
w_k ~ N(0, R_k), v_{k,j} ~ N(0, Q_{k,j})对视觉 SLAM 来说,观测方程就是上一讲的投影:h(y_j, x_k) = (1/Z) K (R_k y_j + t_k),z 是像素。如果没有 IMU 或轮速计,运动方程可以不要(或者用一个很弱的匀速假设)。
1.2 两种解法:滤波与批量
有了这两个方程和一堆数据,怎么估计 x 和 y?历史上有两条路。
滤波器(增量/渐进式):维持一个"当前状态的估计",每来一个新数据,就用它更新这个估计,然后把数据丢掉。扩展卡尔曼滤波(EKF)是代表。它的特点是只关心当前时刻,计算量恒定,适合实时;缺点是过去的状态一旦确定就不能再改,早期的误差会一直留着。
批量(Batch):把一段时间内的所有数据攒起来,一次性求解这段时间内所有的位姿和路标。它的特点是可以用后面的数据修正前面的估计("向后看"),精度更高;缺点是数据越多计算量越大,不能无限攒下去。
现代 SLAM 的主流是批量方法,但做了折中------只攒最近的一段(滑动窗口 ),或者只在关键帧上做(关键帧 BA)。第 10 讲会讲滑动窗口。这一讲先讲最纯粹的批量问题。
设从 1 到 N 时刻,有 M 个路标。把所有位姿记为 x = {x₁, ..., x_N},所有路标记为 y = {y₁, ..., y_M},所有输入记为 u,所有观测记为 z。批量估计要回答的问题是:**已知 u 和 z,x 和 y 的分布是什么?**用条件概率写就是 P(x, y | z, u)。
1.3 最大后验与最大似然
直接算 P(x, y | z, u) 很难,用贝叶斯公式把它翻过来:
P(x, y | z, u) = P(z, u | x, y) P(x, y) / P(z, u)分母 P(z, u) 与待估计的 x、y 无关,是个常数,求最优解时可以扔掉。于是
P(x, y | z, u) ∝ P(z, u | x, y) · P(x, y)右边第一项 P(z, u | x, y) 叫似然 (Likelihood):如果状态真的是 x、y,产生这组数据 z、u 的概率有多大。第二项 P(x, y) 叫先验 (Prior):在没看任何数据之前,我们对 x、y 的信念。左边叫后验(Posterior)。
求使后验最大的 x、y,叫最大后验估计(Maximum A Posteriori,MAP):
(x, y)*_MAP = argmax P(z, u | x, y) P(x, y)如果我们对 x、y 一无所知(没有先验),P(x, y) 是均匀的,可以也扔掉,问题退化成最大似然估计(Maximum Likelihood Estimation,MLE):
(x, y)*_MLE = argmax P(z, u | x, y)MLE 可以用一句话理解:**"在什么样的状态下,最可能产生现在观测到的数据。"**这是整个状态估计最朴素的出发点。
1.4 从最大似然到最小二乘
现在的问题是:似然 P(z, u | x, y) 具体长什么样?
先看一个最简单的情形:只有一次观测 z*{k,j} = h(y_j, x_k) + v*{k,j},噪声 v ~ N(0, Q)。由于噪声是高斯的,给定 x_k、y_j,观测 z_{k,j} 也服从高斯分布,均值是 h(y_j, x_k),协方差是 Q:
P(z_{k,j} | x_k, y_j) = N( h(y_j, x_k), Q_{k,j} )要最大化这个高斯分布。回忆 N 维高斯分布的密度函数:
P(x) = 1 / sqrt( (2π)^N det Σ ) · exp( −½ (x − μ)ᵀ Σ⁻¹ (x − μ) )它是一个指数函数,最大化它等价于最大化它的对数,也等价于最小化它的负对数:
−ln P(x) = ½ ln( (2π)^N det Σ ) + ½ (x − μ)ᵀ Σ⁻¹ (x − μ)第一项和 x 无关,是常数。所以最大化高斯分布 = 最小化第二项,也就是
(x − μ)ᵀ Σ⁻¹ (x − μ)这个量叫马氏距离 (Mahalanobis distance),它是 x 到均值 μ 的距离,但用协方差的逆 Σ⁻¹ 加了权------噪声大的方向权重小,噪声小的方向权重大。Σ⁻¹ 叫信息矩阵。
代回我们的问题:
(x_k, y_j)* = argmin ( z_{k,j} − h(y_j, x_k) )ᵀ Q_{k,j}⁻¹ ( z_{k,j} − h(y_j, x_k) )把 z − h 记作误差 e,这就是"最小化误差的加权平方"------最小二乘。
现在推广到全部数据。假设所有噪声彼此独立(不同时刻、不同路标的噪声互不相关)。独立事件的联合概率等于各自概率的乘积,所以
P(z, u | x, y) = Π_k P(u_k | x_{k−1}, x_k) · Π_{k,j} P(z_{k,j} | x_k, y_j)取负对数,乘积变成求和。定义两类误差:
e_{u,k} = x_k − f(x_{k−1}, u_k)               (运动误差:实际状态与运动方程预测之差)
e_{z,j,k} = z_{k,j} − h(x_k, y_j)              (观测误差:实际观测与观测方程预测之差)
那么最小化负对数似然等价于最小化
min J(x, y) = Σ_k e_{u,k}ᵀ R_k⁻¹ e_{u,k} + Σ_k Σ_j e_{z,k,j}ᵀ Q_{k,j}⁻¹ e_{z,k,j}**这就是 SLAM 的目标函数。**整个 SLAM 后端,归根结底就是在最小化这个 J------所有运动误差和观测误差的、以信息矩阵加权的平方和。
1.5 这个最小二乘问题的几个特点
书里指出了这个问题的几个结构性特点,它们决定了后面的算法怎么设计。
**第一,整个问题的目标函数是许多小误差项的和,每一项只和少数几个变量有关。**一个观测误差 e_{z,k,j} 只涉及位姿 x_k 和路标 y_j 两个变量,与其他几千个位姿、几万个路标无关。用图的语言说,这个问题的"关联结构"非常稀疏------第 9 讲的稀疏 BA 全靠这一点才能跑得动。
**第二,变量住在流形上。**位姿是 SE(3) 的元素,不能直接加增量。所以优化过程中的"x += Δx"要换成上一讲的"T ← exp(Δξ^) T"。这是 SLAM 的优化和一般数值优化教科书的最大不同。
**第三,用信息矩阵加权而不是简单求和。**噪声小的观测(信息矩阵大)在目标函数中权重大,噪声大的权重小。这也意味着:如果你把所有信息矩阵都设成单位阵,相当于认为所有观测一样可信,结果会被噪声大的那些观测带偏。
**第四,它是非线性的。**h 里有旋转、有除以深度,f 里也可能有三角函数。所以没有闭式解,只能迭代。
1.6 一个线性的例子
书 6.1.3 节用一个一维小例子说明"批量估计就是解一个线性方程组"。考虑一个在直线上运动的物体:
x_k = x_{k−1} + u_k + w_k,     w_k ~ N(0, Q_k)
z_k = x_k + n_k,               n_k ~ N(0, R_k)
k = 1, 2, 3。状态是 x = x₀, x₁, x₂, x₃,输入 u = u₁, u₂, u₃,观测 z = z₁, z₂, z₃。把所有方程堆在一起写成
y = H x + e, 其中 y = [u; z],e ~ N(0, Σ)H 是一个由 0、1、−1 组成的 6×4 矩阵(每一行对应一个方程),Σ 是由各 Q_k、R_k 拼成的对角阵。这是一个线性最小二乘,最优解有闭式:
x* = ( Hᵀ Σ⁻¹ H )⁻¹ Hᵀ Σ⁻¹ y这个式子在线性情形下一步到位。SLAM 的问题是非线性的,但每一次迭代本质上就是在当前点把问题线性化,解一次这种形式的方程。下一章就讲怎么做。
第二章 非线性最小二乘
2.1 问题形式与迭代思路
把目标函数写成一般形式:
min F(x) = ½ ‖f(x)‖²f(x) 是一个把 n 维状态映射到 m 维残差的非线性函数(上一章的 J 可以看作这种形式,把各项的信息矩阵开方后吸收进 f)。前面的 ½ 是为了求导方便,不影响最优解。
如果 f 很简单,令导数 dF/dx = 0,解方程即可。但当 f 是相机投影这类复杂非线性函数时,这个方程解不出来。于是改用迭代:
-
给一个初值 x₀;
-
在当前 x_k 处,寻找一个增量 Δx_k,使得 F(x_k + Δx_k) 比 F(x_k) 小;
-
如果 Δx_k 足够小,停止;否则令 x_{k+1} = x_k + Δx_k,回到第 2 步。
迭代把"解一个方程"变成了"不断寻找下降方向"。问题的核心变成:**每一步的 Δx 怎么算?**不同的算法区别就在这里。
2.2 一阶和二阶梯度法
最直接的想法是把 F(x) 在 x_k 处泰勒展开:
F(x_k + Δx) ≈ F(x_k) + J(x_k)ᵀ Δx + ½ Δxᵀ H(x_k) ΔxJ 是 F 对 x 的一阶导(梯度),H 是二阶导(海森矩阵)。
一阶法(最速下降):只保留一阶项,让 Δx 沿负梯度方向走:Δx = −J。思路是"哪里下降最快就往哪里走"。它的问题是太贪心------每一步都走当前最陡的方向,在狭长的山谷里会左右来回"锯齿",收敛很慢。
二阶法(牛顿法):保留二阶项,对 Δx 求导令其为零,得到
H Δx = −J这一步相当于用一个二次曲面拟合 F 在 x_k 附近的形状,然后直接跳到这个二次曲面的最低点。收敛快,但要算 H。对 SLAM 这种变量上万维的问题,海森矩阵是上万乘上万的,而且每个元素是二阶导,算起来极其昂贵。
两种方法各有问题:一阶太慢,二阶太贵。接下来的两个算法就是在二者之间找平衡------不算真正的 H,而是用一阶导数构造一个 H 的近似。
2.3 高斯牛顿法
高斯牛顿的关键一步是:不对 F(x) 做泰勒展开,而是对 f(x) 做。
f(x + Δx) ≈ f(x) + J(x) Δx这里 J(x) 是 f 对 x 的雅可比,m×n 矩阵(f 有 m 个分量,x 有 n 个分量)。代入目标函数:
½ ‖f(x) + J Δx‖²
  = ½ ( f + J Δx )ᵀ ( f + J Δx )
  = ½ ( fᵀf + 2 fᵀ J Δx + Δxᵀ Jᵀ J Δx )
对 Δx 求导令为零:
Jᵀ f + Jᵀ J Δx = 0即
Jᵀ J Δx = −Jᵀ f这个方程叫增量方程 ,也叫高斯牛顿方程 或正规方程(Normal Equation)。把左边的系数记作 H = JᵀJ,右边记作 g = −Jᵀf,它就是
H Δx = g和牛顿法的 H Δx = −J 形式一样,但这里的 H 不是真正的海森矩阵,而是用 JᵀJ 近似的。这样一来只需要一阶导数就够了,省去了算二阶导的代价。这就是高斯牛顿名字里"牛顿"的由来------它是牛顿法的一个廉价近似。
高斯牛顿的完整步骤:
-
给初值 x₀;
-
在 x_k 处计算 f(x_k) 和雅可比 J(x_k);
-
解增量方程 (JᵀJ) Δx_k = −Jᵀ f;
-
若 Δx_k 足够小,停止;否则 x_{k+1} = x_k + Δx_k,回到第 2 步。
高斯牛顿的缺陷有两条,都来自"用 JᵀJ 近似 H"这一步。
第一,JᵀJ 只是半正定的,不一定可逆。实际中常常遇到它接近奇异或病态(条件数很大)的情况,这时解出来的 Δx 会很大、很不稳定,甚至算法发散。
第二,即使 JᵀJ 可逆,解出的 Δx 可能太大,大到泰勒展开 f(x + Δx) ≈ f(x) + J Δx 已经不成立------我们是在"局部近似"下算的步长,走出局部范围近似就失效了,F 可能不降反升。
这两个问题的本质是一样的:高斯牛顿不控制步长。下一个算法就是给它加上步长控制。
2.4 列文伯格-马夸尔特法
LM 法(Levenberg-Marquardt)的思想叫信赖区域(Trust Region):泰勒近似只在 x_k 附近的一个小范围内可信,那就只在这个范围里找 Δx,不许跑出去。范围大小根据近似的好坏动态调整------近似得好就把范围放大,近似得差就缩小。
怎么衡量近似好不好?定义一个指标
ρ = [ f(x + Δx) − f(x) ] / [ J(x) Δx ]分子是实际下降量 ,分母是近似模型预测的下降量。ρ 接近 1 说明近似很准;ρ 远小于 1(甚至为负)说明实际下降远不如预期,近似失效,应该缩小范围;ρ 大于 1 说明实际下降比预期还多,近似保守了,可以放大范围。
LM 的每一步是解一个带约束的最小二乘:
min ½ ‖f(x_k) + J Δx‖², s.t. ‖D Δx‖² ≤ μμ 是信赖区域的半径,D 是一个系数矩阵(后面说)。用拉格朗日乘子把约束吸收进目标函数:
min ½ ‖f + J Δx‖² + (λ/2) ‖D Δx‖²对 Δx 求导令为零,得到
( JᵀJ + λ DᵀD ) Δx = −Jᵀ f比高斯牛顿方程多了一项 λDᵀD。最简单的取法是 D = I:
( H + λ I ) Δx = g这个式子非常有解释力。当 λ 很小时 ,λI 可以忽略,它就是高斯牛顿------二阶近似好,步子大,收敛快。当 λ 很大时 ,H 可以忽略,方程变成 λ Δx ≈ g,即 Δx ≈ g/λ,就是沿负梯度走一小步------一阶最速下降。所以 LM 是在高斯牛顿和最速下降之间自动切换:近似好的时候像高斯牛顿一样大步走,近似差的时候像梯度下降一样稳扎稳打。
同时,λI 这一项还解决了 JᵀJ 奇异的问题:给对角线加上一个正数,矩阵就一定正定可逆了。
马夸尔特的改进是把 D 取成 JᵀJ 对角元素的平方根构成的对角阵,而不是 I。这样信赖区域不是一个球,而是一个椭球------在梯度大的方向上步子小、梯度小的方向上步子大,对各维度尺度差异大的问题(比如旋转用弧度、平移用米)效果更好。
LM 的完整流程:
-
给初值 x₀ 和初始信赖半径 μ;
-
解 (H + λDᵀD) Δx = g 得到 Δx;
-
算 ρ;
-
若 ρ > 3/4,μ = 2μ(扩大);若 ρ < 1/4,μ = 0.5μ(缩小);
-
若 ρ 大于某个阈值(近似可信),接受这一步 x_{k+1} = x_k + Δx;否则拒绝,保持 x_k 不动,用新的 μ 重算;
-
判断收敛,否则回到第 2 步。
2.5 几点工程经验
**初值决定一切。**非线性最小二乘是非凸的,有很多局部极小值。高斯牛顿和 LM 都只能保证找到初值附近的局部极小,初值离真解远就会掉进错的坑。所以 SLAM 里的优化从来不是从零开始的:PnP、ICP、对极几何这些"几何方法"(第 7 讲)先给出一个还不错的初值,然后优化再把它精细化。
**增量方程的求解是计算瓶颈。**H 是 n×n 的,n 是变量总数,SLAM 里几千到几十万。直接求逆不可能。但第 1.5 节说过 H 是稀疏的,利用稀疏性可以用 Cholesky 分解、QR 分解或共轭梯度法高效求解。第 9 讲的 Schur 消元专门针对 BA 的结构。
除了高斯牛顿和 LM,还有 Dog-Leg 等方法,思路类似,都是在信赖区域内组合高斯牛顿步和梯度步。g2o 和 Ceres 都提供了多种选择,大多数情况下 LM 是默认的稳妥选项。
与卡尔曼滤波的关系。 EKF 的更新步在数学上等价于:以预测值为初值,对当前时刻的观测误差做一步高斯牛顿迭代(不迭代到收敛)。迭代扩展卡尔曼滤波(IEKF,FAST-LIO 用的就是它)则是迭代多步。所以滤波和优化不是两套理论,而是对同一个最小二乘问题采用了不同的"迭代次数"和"回看范围"。你在 EMF 里调过的 Q、R,就是这里的信息矩阵的逆。
第三章 实践:曲线拟合
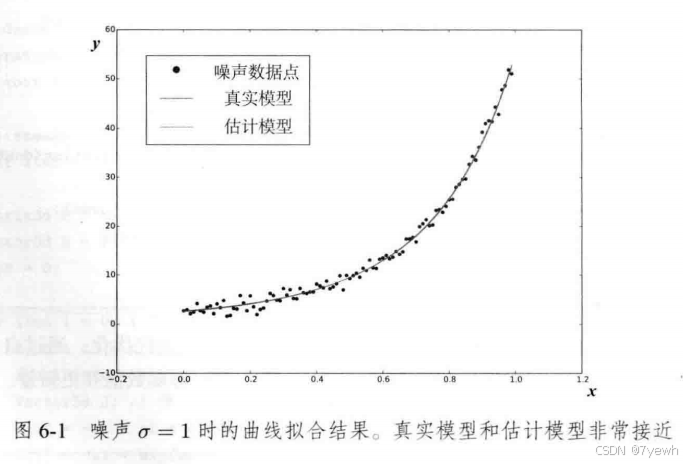
书用同一个问题------拟合一条带噪声的指数曲线------分别用手写高斯牛顿、Ceres 和 g2o 做了三遍。问题本身很简单,目的是让读者熟悉两个库的"思维方式",因为后面所有 SLAM 优化都用它们。
3.1 问题
曲线模型
y = exp( a x² + b x + c ) + w, w ~ N(0, σ²)真实参数 a = 1,b = 2,c = 1,噪声 σ = 1。在 x ∈ 0, 1 上均匀采 100 个点,得到数据 {(x_i, y_i)}。任务:从数据估计 a、b、c。
写成最小二乘:
min_{a,b,c} ½ Σ_{i=1}^{100} ‖ y_i − exp(a x_i² + b x_i + c) ‖²每个数据点贡献一个残差
e_i = y_i − exp(a x_i² + b x_i + c)残差对三个参数的导数(注意链式法则,exp 的导数是它自己):
∂e_i/∂a = −x_i² · exp(a x_i² + b x_i + c)
∂e_i/∂b = −x_i  · exp(a x_i² + b x_i + c)
∂e_i/∂c = −      exp(a x_i² + b x_i + c)
把它们排成 3×1 的 J_i。高斯牛顿方程中的 H 和 g 由所有点累加:
H = Σ_i J_i J_iᵀ / σ², g = −Σ_i J_i e_i / σ²(1/σ² 就是信息矩阵,这里所有点的噪声一样,它只是个公共系数,不影响解。)
3.2 手写高斯牛顿
核心循环大致是:
for (int iter = 0; iter < iterations; iter++) {
    Eigen::Matrix3d H = Eigen::Matrix3d::Zero();
    Eigen::Vector3d b = Eigen::Vector3d::Zero();
    double cost = 0;
    for (int i = 0; i < N; i++) {
        double xi = x_data[i], yi = y_data[i];
        double error = yi - exp(ae * xi * xi + be * xi + ce);
        Eigen::Vector3d J;
        J[0] = -xi * xi * exp(ae * xi * xi + be * xi + ce);
        J[1] = -xi * exp(ae * xi * xi + be * xi + ce);
        J[2] = -exp(ae * xi * xi + be * xi + ce);
        H += inv_sigma * inv_sigma * J * J.transpose();
        b += -inv_sigma * inv_sigma * error * J;
        cost += error * error;
    }
    Eigen::Vector3d dx = H.ldlt().solve(b);     // Cholesky 分解解增量方程
    if (isnan(dx[0])) break;
    if (iter > 0 && cost >= lastCost) break;    // 代价不再下降,停止
    ae += dx[0]; be += dx[1]; ce += dx[2];
    lastCost = cost;
}
从初值 a = 2,b = −1,c = 5 出发,几次迭代就收敛到约 a ≈ 0.89,b ≈ 2.17,c ≈ 0.94------不是精确的 (1, 2, 1),因为数据有噪声,这是从这 100 个带噪数据能得到的最优估计。
两个细节值得注意:解方程用 ldlt()(Cholesky 分解的变体)而不是 inverse(),这是上一册 3.4 节的建议;停止条件用了"代价不再下降",这是高斯牛顿没有步长控制时的一种保护。
3.3 用 Ceres
Ceres 是 Google 开发的最小二乘库,广泛用于 SfM 和 SLAM(VINS-Mono 用它)。它的抽象是:
-
参数块(Parameter Block):待优化的变量,一个 double 数组;
-
残差块(Residual Block):一个误差项,输入若干参数块,输出一个残差向量;
-
代价函数(Cost Function):残差块的具体计算方式;
-
核函数(Loss Function):可选,用于抑制外点(第 9 讲)。
用户只需要定义残差怎么算,Ceres 负责求导、构建 H、解方程、迭代。残差定义成一个带模板 operator() 的结构体:
struct CURVE_FITTING_COST {
    CURVE_FITTING_COST(double x, double y) : _x(x), _y(y) {}
    template<typename T>
    bool operator()(const T *const abc, T *residual) const {
        residual[0] = T(_y) - ceres::exp(abc[0] * T(_x) * T(_x) + abc[1] * T(_x) + abc[2]);
        return true;
    }
    const double _x, _y;
};
为什么是模板?因为 Ceres 的自动求导(Automatic Differentiation)会用一种特殊的数值类型(Jet)代替 double 调用这个函数,Jet 在计算的同时自动记录导数。所以用户不用手写雅可比,只要用模板类型 T 把残差写出来,导数就自动有了。这是 Ceres 最受欢迎的特性。
构建问题并求解:
double abc[3] = {ae, be, ce};
ceres::Problem problem;
for (int i = 0; i < N; i++) {
    problem.AddResidualBlock(
        new ceres::AutoDiffCostFunction<CURVE_FITTING_COST, 1, 3>(   // 残差 1 维,参数 3 维
            new CURVE_FITTING_COST(x_data[i], y_data[i])),
        nullptr,     // 核函数,这里不用
        abc);        // 参数块
}
ceres::Solver::Options options;
options.linear_solver_type = ceres::DENSE_NORMAL_CHOLESKY;  // 增量方程怎么解
options.minimizer_progress_to_stdout = true;
ceres::Solver::Summary summary;
ceres::Solve(options, &problem, &summary);
AutoDiffCostFunction<..., 1, 3> 的两个数字是残差维度和参数块维度,写错会在运行时报错。Ceres 默认用 LM。输出里能看到每次迭代的 cost 下降。
Ceres 也支持数值求导 (有限差分,慢且不精确)和解析求导(用户手写雅可比,最快但最费事)。SLAM 里对性能敏感的部分(比如 VINS 的 IMU 因子)会手写解析雅可比,其他地方用自动求导。
3.4 用 g2o
g2o(General Graph Optimization)是另一个常用库,ORB-SLAM 全系列用它。它的抽象是图:
-
顶点(Vertex):待优化的变量;
-
边(Edge):误差项,连接它所涉及的顶点。一元边连一个顶点,二元边连两个,以此类推。
这个抽象和 1.5 节说的"每个误差项只涉及少数变量"完全对应------画出来就是一张图,顶点是位姿和路标,边是观测。这种图叫图优化(Graph Optimization),第 9、10 讲会大量使用。
曲线拟合里只有一个变量(a、b、c 合成一个 3 维顶点),100 个一元边(每个数据点一条)。定义顶点:
class CurveFittingVertex : public g2o::BaseVertex<3, Eigen::Vector3d> {   // 3 维,用 Vector3d 存
public:
    virtual void setToOriginImpl() override { _estimate << 0, 0, 0; }      // 重置
    virtual void oplusImpl(const double *update) override {                 // 更新:x ← x + Δx
        _estimate += Eigen::Vector3d(update);
    }
    virtual bool read(istream &in) {}
    virtual bool write(ostream &out) const {}
};
oplusImpl 是整个 g2o 最重要的函数。 它定义了"给这个顶点加一个增量"是什么意思。对普通向量就是加法;对 SE(3) 顶点,这里要写成 _estimate = Sophus::SE3d::exp(update) * _estimate------上一讲的左乘扰动更新就放在这里。g2o 的设计把"流形上怎么更新"这件事完全交给了用户,这正是它能处理李群变量的原因。
定义边:
class CurveFittingEdge : public g2o::BaseUnaryEdge<1, double, CurveFittingVertex> {  // 1 维残差,观测是 double,连 1 个顶点
public:
    CurveFittingEdge(double x) : BaseUnaryEdge(), _x(x) {}
    virtual void computeError() override {                 // 残差
        const CurveFittingVertex *v = static_cast<const CurveFittingVertex *>(_vertices[0]);
        const Eigen::Vector3d abc = v->estimate();
        _error(0, 0) = _measurement - std::exp(abc(0) * _x * _x + abc(1) * _x + abc(2));
    }
    virtual void linearizeOplus() override {               // 雅可比
        const CurveFittingVertex *v = static_cast<const CurveFittingVertex *>(_vertices[0]);
        const Eigen::Vector3d abc = v->estimate();
        double y = exp(abc[0] * _x * _x + abc[1] * _x + abc[2]);
        _jacobianOplusXi[0] = -_x * _x * y;
        _jacobianOplusXi[1] = -_x * y;
        _jacobianOplusXi[2] = -y;
    }
    virtual bool read(istream &in) {}
    virtual bool write(ostream &out) const {}
public:
    double _x;
};
computeError 算残差,linearizeOplus 算雅可比(如果不写,g2o 会用数值求导)。然后搭建优化器:
typedef g2o::BlockSolver<g2o::BlockSolverTraits<3, 1>> BlockSolverType; // 顶点 3 维,残差 1 维
typedef g2o::LinearSolverDense<BlockSolverType::PoseMatrixType> LinearSolverType; // 稠密线性求解器
auto solver = new g2o::OptimizationAlgorithmGaussNewton( // 也可换 LM / DogLeg
g2o::make_unique<BlockSolverType>(g2o::make_unique<LinearSolverType>()));
g2o::SparseOptimizer optimizer;
optimizer.setAlgorithm(solver);
CurveFittingVertex *v = new CurveFittingVertex();
v->setEstimate(Eigen::Vector3d(ae, be, ce));
v->setId(0);
optimizer.addVertex(v);
for (int i = 0; i < N; i++) {
CurveFittingEdge *edge = new CurveFittingEdge(x_data[i]);
edge->setId(i);
edge->setVertex(0, v);
edge->setMeasurement(y_data[i]);
edge->setInformation(Eigen::Matrix<double, 1, 1>::Identity() * 1 / (w_sigma * w_sigma)); // 信息矩阵
optimizer.addEdge(edge);
}
optimizer.initializeOptimization();
optimizer.optimize(10);三层结构要记住:线性求解器 (解增量方程,稠密/稀疏 Cholesky/PCG)→ 块求解器 (管理 H 的分块结构,模板参数是顶点维度和残差维度)→ 优化算法(GN/LM/DogLeg,决定每步 Δx 怎么算)。后面 SLAM 里换成 SE(3) 顶点和重投影边,这个骨架不变。
setInformation 设的就是 1.4 节的信息矩阵 Q⁻¹。
3.5 三种做法的比较
| 手写 GN | Ceres | g2o | |
|---|---|---|---|
| 雅可比 | 手推 | 自动求导(也可手写) | 手写(不写则数值求导) |
| 流形变量 | 自己处理 | LocalParameterization / Manifold | oplusImpl |
| 适合 | 理解原理 | 快速原型、因子图式问题 | 图结构明显的问题(位姿图、BA) |
| 代表用户 | --- | VINS-Mono、Cartographer | ORB-SLAM 系列 |
三者解的是同一个方程 (H + λI)Δx = g,结果一致。选哪个主要看项目惯例和你需要多少控制权。