写在前面
欢迎大家关注Rocky的知乎:Rocky Ding
《三年面试五年模拟》AIGC/LLM/AI Agent算法工程师/开发工程师求职面试秘籍独家资源:【三年面试五年模拟】WeThinkIn/AIGC-Interview-Book,欢迎大家Star~
Rocky最新撰写的10万字AI Agent(AI智能体)深入浅出全维度解析文章: 深入浅出完整解析AI Agent(AI智能体)的核心基础知识
AIGC/LLM/AI Agent算法岗/开发岗求职面试内推学习社群 (涵盖AIGC、LLM大模型、AI Agent、传统深度学习、自动驾驶、机器学习、计算机视觉、自然语言处理、强化学习、大数据挖掘、具身智能、元宇宙、AGI等AI行业最新面试干货经验与核心知识)欢迎大家加入:https://t.zsxq.com/33pJ0
大家好,我是Rocky。
1. 核心判断:Muse改变的是视觉生成的决策顺序
图像生成并不天然要求从左上角开始,把每个视觉token按顺序写完。如果一部分位置已经足够确定,模型能否同时补全其余位置,并把高置信度结果逐轮固定下来?Muse围绕这一问题,把MaskGIT式掩码生成、预训练语言表示和多尺度视觉建模组合成一套文生图系统。
Muse的核心,是让模型学习"在任意可见视觉上下文和文字条件下补全缺失token",再用少量并行迭代完成生成。 这一训练任务既服务速度,也自然支持局部修补、扩图和无需用户指定掩码的编辑。
不过,论文中的"3B""1.3秒""2.7倍偏好"分别对应不同统计口径:3B主要描述基础视觉生成主干,系统还使用4.6B的冻结T5-XXL文本编码器;1.3秒绑定TPUv4及当时的推理设置;2.7倍来自16个候选经CLIP挑选后的特定人类评测。把这些限定条件写清,才能理解Muse真正的研究贡献。
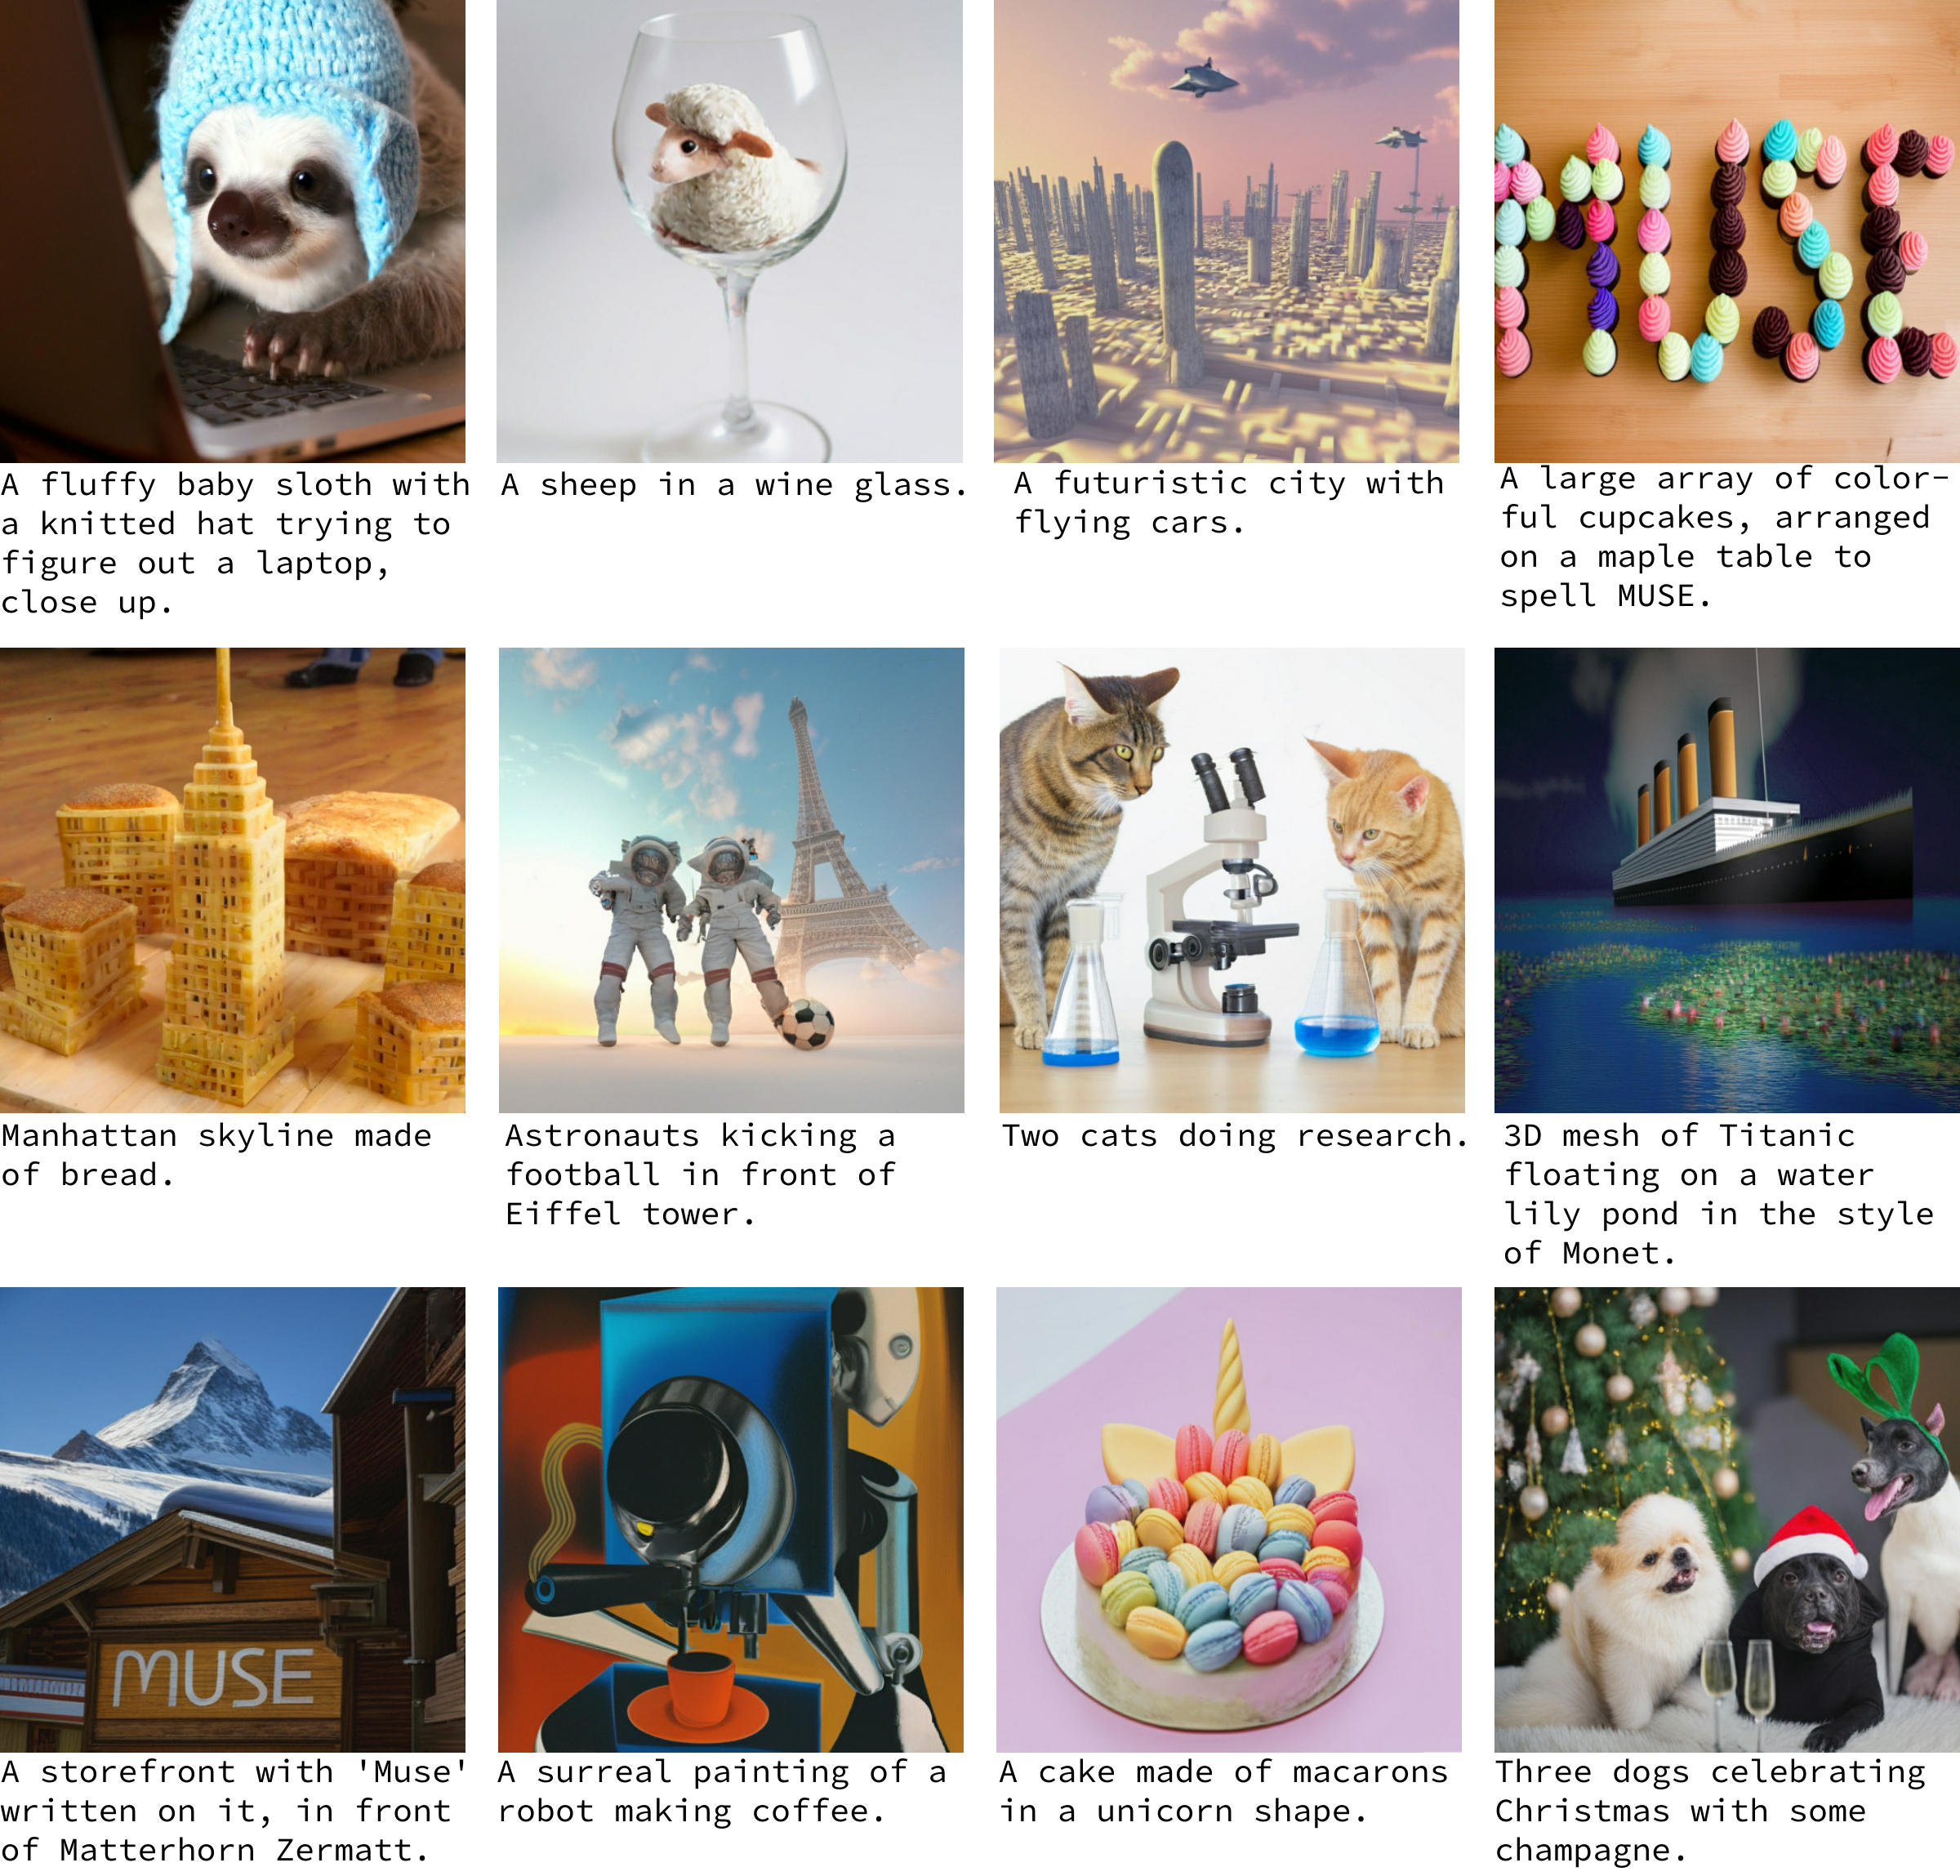
图1展示512分辨率的多题材生成,图内保留各自提示词。它说明系统能够组合风格、对象和场景,但精选展示不等于随机请求上的成功率。
本文讨论2023年论文《Muse: Text-To-Image Generation via Masked Generative Transformers》的v1版本。涉及扩散与自回归模型的比较均限定于该版本实验,不外推为当前算法或产品的速度排名。
2. Muse架构:冻结语言编码器、两级视觉token与两个生成器
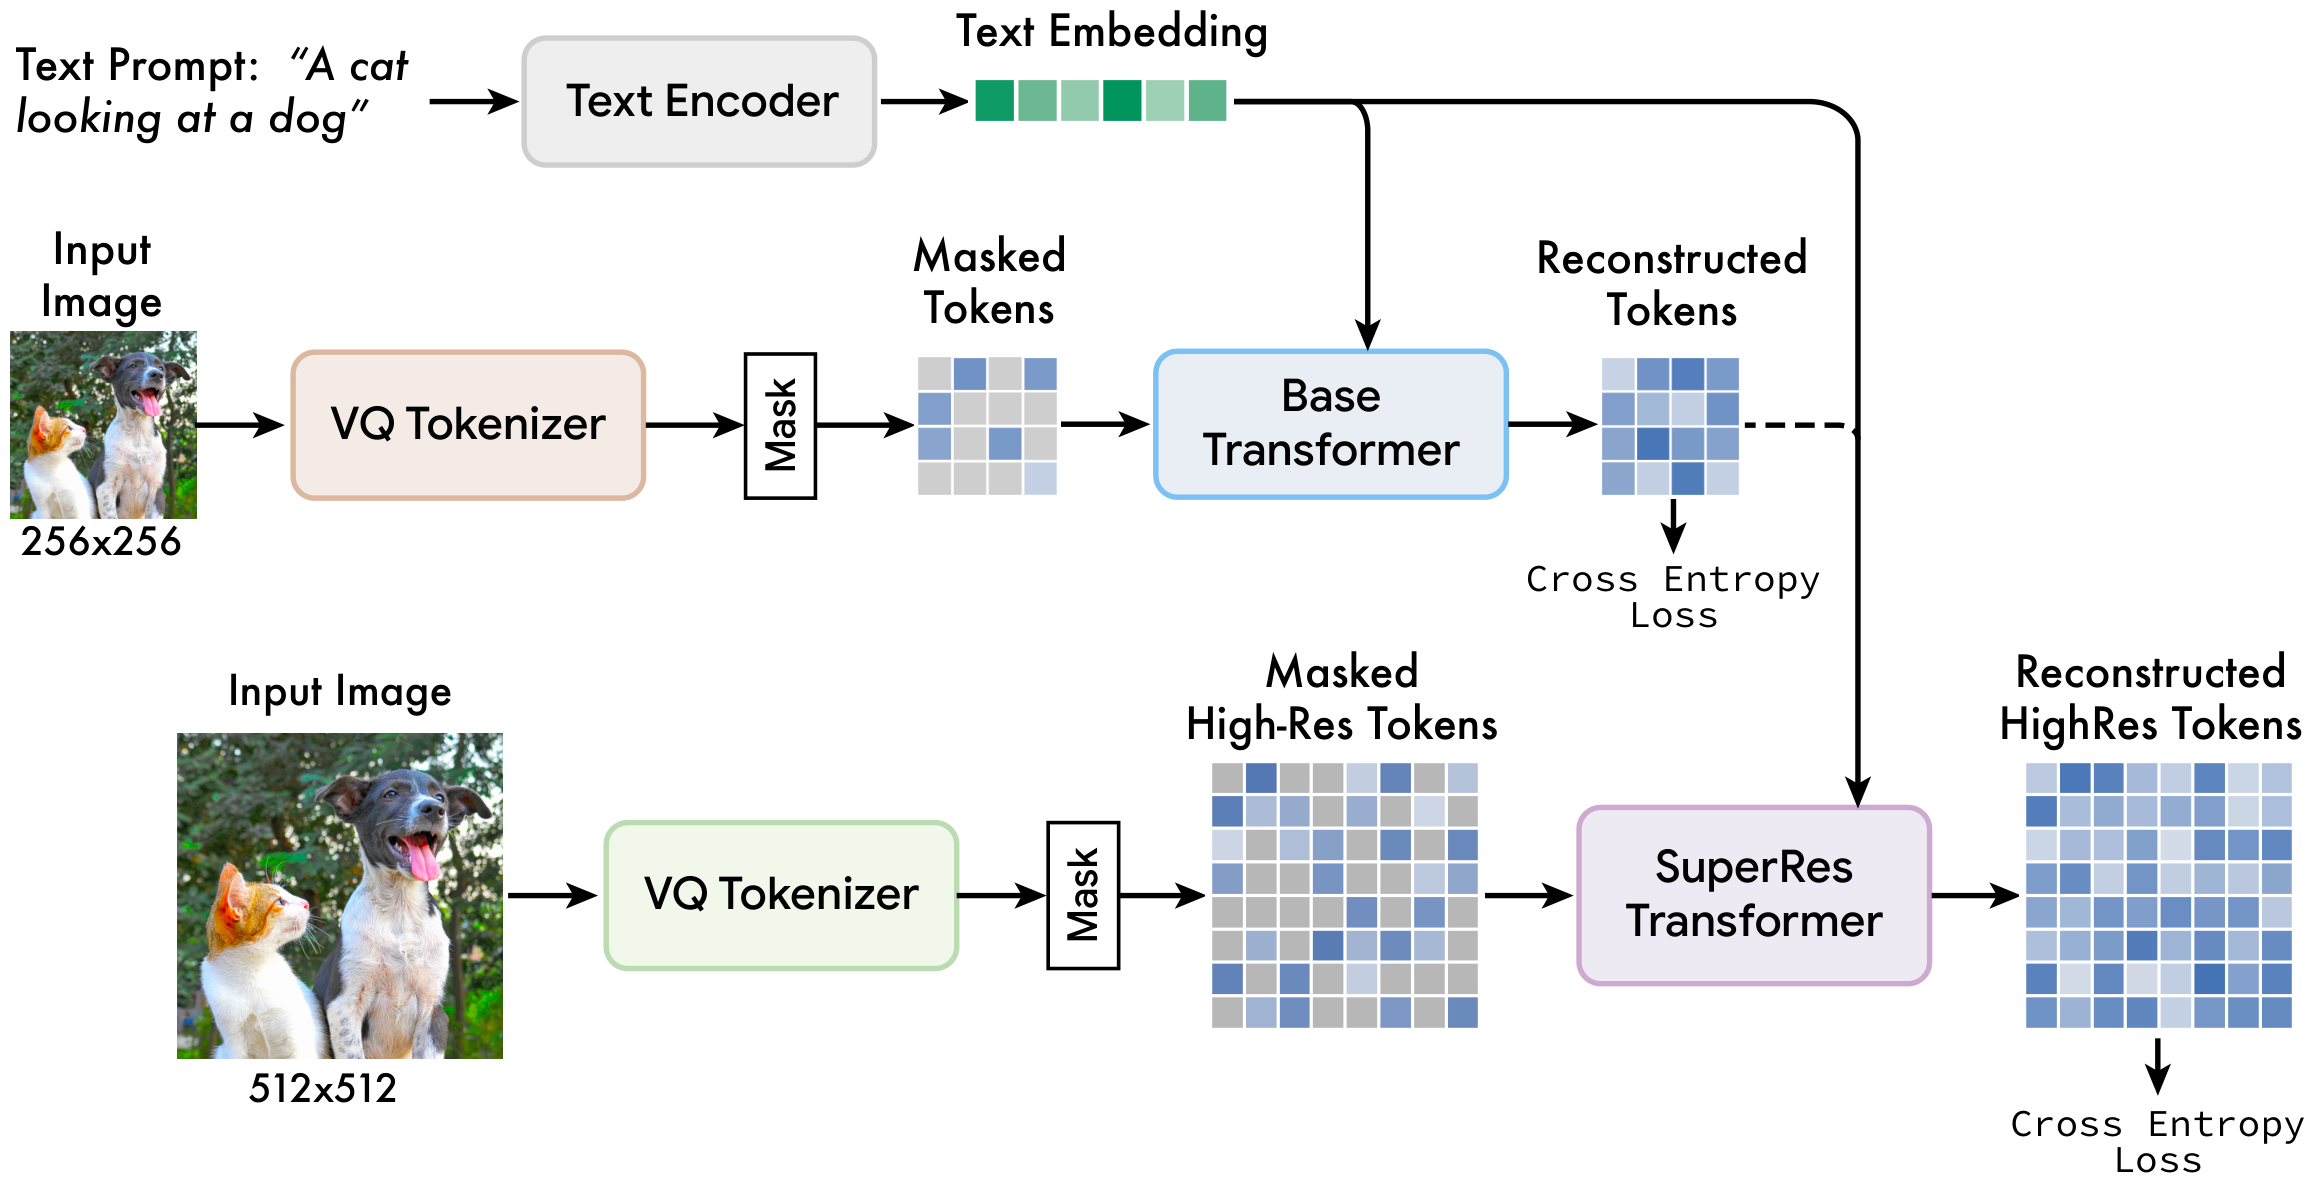
图3展示三个主要部分:T5-XXL提供文字embedding;基础模型预测低分辨率视觉token;超分模型在文字与低分辨率token条件下,预测高分辨率token。两级视觉空间由两个VQGAN分别编码和解码。
T5-XXL输出4,096维的文字向量,再线性投影到生成器隐藏维度。基础模型与超分模型都通过cross-attention使用这些文字表示。T5被冻结,因此训练重点是学习视觉token与已有语言表示之间的对应关系,而不是从图文数据中重新学习完整语言能力。
这种设计保留了一个有价值的分工:语言编码器提供对象、动作、属性及关系的语义线索,视觉生成器学习这些线索应如何落实到画面。论文认为预训练语言表示对长提示和罕见词尤其重要,但它没有由此证明模型已经获得可迁移到全部任务的抽象推理能力。
Muse不是一个3B模块独自完成全部工作。论文中的较小系统是632M基础模型加268M超分模型;大型系统的基础模型约3B,此外还有冻结文本编码器、超分生成器和视觉编解码器。比较参数效率时,应分别列出被训练的参数、总驻留参数和每个阶段实际参与的参数。
3. Muse视觉tokenizer:分辨率只翻倍,序列长度却增加十六倍
低分辨率VQGAN的下采样倍数为16, 256 × 256 256\times256 256×256图像对应 16 × 16 = 256 16\times16=256 16×16=256个视觉token。高分辨率VQGAN的下采样倍数为8, 512 × 512 512\times512 512×512图像对应 64 × 64 = 4096 64\times64=4096 64×64=4096个视觉token。
一般地,对于高宽为 H , W H,W H,W、下采样倍数为 f f f的图像,token数量为:
N = H f W f . N=\frac{H}{f}\frac{W}{f}. N=fHfW.
这里从256图像到512图像,边长翻倍,同时下采样从16倍变为8倍,所以token总数从256上升到4,096。超分阶段面对的离散位置数是基础阶段的16倍,而不是4倍。
视觉码本大小为8,192。VQGAN将连续特征映射为码本索引,模型输出位置上的类别分布,因而可使用交叉熵训练。离散token能降低直接像素建模的难度,但也带来压缩损失;"语义token"不意味着所有细节都已经无损保存。
表5|VQGAN配置与训练参数。
| Configuration | Value |
|---|---|
| Perceptual loss weight | 0.05 |
| Adversarial loss weight | 0.1 |
| Codebook size | 8192 |
| Optimizer | Adam |
| Discriminator learning rate | 1e-4 |
| Generator learning rate | 1e-4 |
| Weight decay | 1e-4 |
| Optimizer momentum | β 1 = 0.9 , β 2 = 0.99 \beta_1=0.9, \beta_2=0.99 β1=0.9,β2=0.99 |
| Batch size | 256 |
| Learning rate schedule | cosine decay |
| Warmup steps | 10000 |
| Training steps | 1M |
视觉编解码器采用全卷积结构,移除non-local块以支持不同尺寸。基础VQGAN在各分辨率层使用2个残差块,基础通道数128;后续强化的解码器使用4个残差块和256基础通道。表中码本与优化配置,应与语言生成器的配置分开理解。
4. Muse掩码训练:学习任意上下文中的补全能力
给定完整视觉token序列 x x x,从中选取位置集合 M M M替换为[MASK]。文字条件保持可见,图像中未遮盖位置也保持可见。Transformer使用双向视觉self-attention与文字cross-attention,对被遮盖位置预测真实码本索引。
用便于理解的数学记号,这一目标可写为:
L m a s k = − E x , c , M ∑ i ∈ M log p θ ( x i ∣ x M ˉ , c ) . \mathcal L_{\mathrm{mask}}=-\mathbb E_{x,c,M}\sum_{i\in M}\log p_\theta(x_i\mid x_{\bar M},c). Lmask=−Ex,c,Mi∈M∑logpθ(xi∣xMˉ,c).
这是对训练机制的展开,论文没有将其列为编号公式。它与固定顺序自回归的差别,在于可见上下文不必是序列前缀。模型可以看到目标位置左边、右边以及更远位置的已知视觉token。
随机掩码比例不是固定50%。论文使用密度为下式的分布:
p ( r ) = 2 π 1 − r 2 , 0 ≤ r < 1. p(r)=\frac{2}{\pi\sqrt{1-r^2}},\qquad 0\le r<1. p(r)=π1−r2 2,0≤r<1.
等价地,可令 u ∼ U ( 0 , 1 ) u\sim\mathcal U(0,1) u∼U(0,1),再取 r = cos ( π u / 2 ) r=\cos(\pi u/2) r=cos(πu/2)。其期望为 2 / π ≈ 0.6366 2/\pi\approx0.6366 2/π≈0.6366,对应论文描述的平均掩码率约0.64。高掩码率样本更常见,使模型有机会学习在视觉线索很少时依靠文字与分布先验完成预测。
这种训练学习的是不同可见子集下的条件分布 P ( x i ∣ x Λ , c ) P(x_i\mid x_\Lambda,c) P(xi∣xΛ,c),并不等于一次前向传播已经精确建模所有未知位置的联合分布。多个未知token之间仍然相关,迭代推理正是为了逐步提供新上下文,缓解同时预测造成的不一致。
5. Muse并行推理:先接受确定的部分,再补全困难的部分
生成开始时,所有视觉位置都处于掩码状态。每一轮,模型为当前被遮盖的位置并行预测分布、采样候选,根据置信度和余弦调度接受其中一部分;被接受的位置在之后轮次保持可见,剩余位置继续预测。
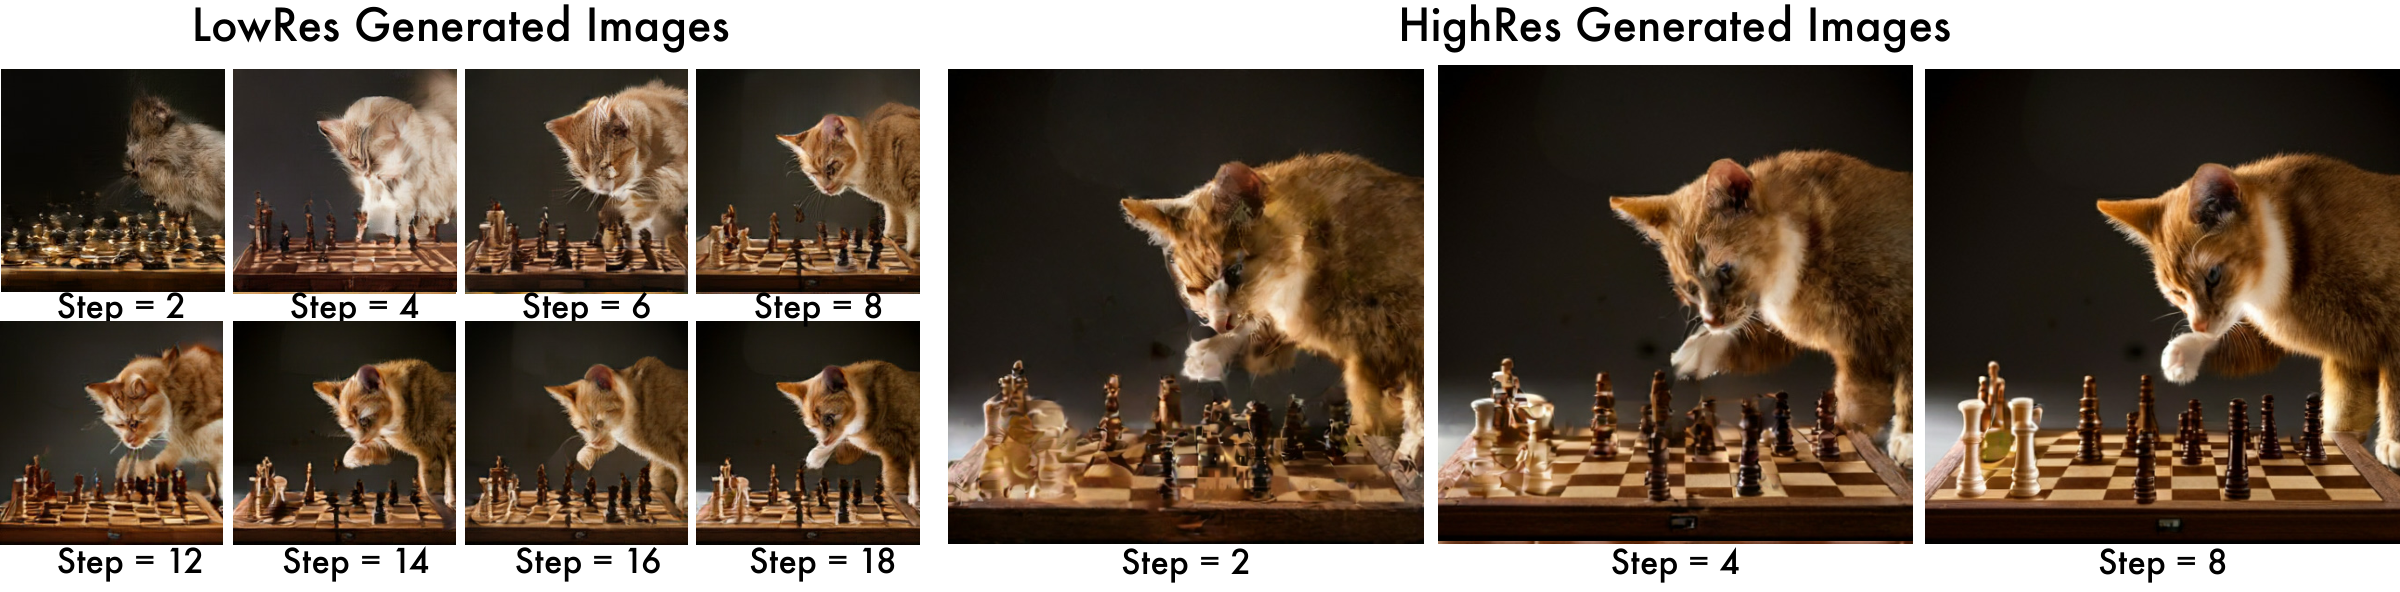
图5展示从高掩码状态逐步得到完整结果的过程。基础模型使用24轮生成256个token;超分阶段在已知低分辨率结构条件下,使用8轮生成4,096个token。后者预测位置更多,却不需要从零推断完整场景结构。
并行预测建立在一种近似上:给定足够上下文,部分未知位置可以相对独立地确定。论文将其描述为Markovian性质,但这不是对任意图像数据分布成立的严格独立性证明。复杂计数、长文字和跨区域关系,正是这一近似更容易受挑战的地方。
可以用下面的概念伪代码理解生成过程;这里省略置信度扰动及具体调度实现:
python
tokens = all_masked_tokens()
for step in range(num_steps):
    logits = transformer(tokens, text_condition)
    proposals, confidence = sample_masked_positions(logits)
    accepted = select_high_confidence_positions(
        confidence, target_remaining_masks=cosine_schedule(step)
    )
    tokens[accepted] = proposals[accepted]
image = visual_decoder(tokens)
少轮次意味着减少串行决策环节,不意味着每轮成本相同,也不意味着4,096个位置的全模型前向与一次自回归单token解码可以按次数直接等价。推理速度最终还取决于注意力实现、硬件、batch及上下文长度。
6. Muse的CFG:同一个术语,不同论文可能采用不同参数定义
训练中随机去掉10%样本的文字条件,使模型学习无条件视觉补全。推理时,条件logits为 ℓ c \ell_c ℓc,无条件logits为 ℓ u \ell_u ℓu,论文的编号公式为:
ℓ g = ( 1 + t ) ℓ c − t ℓ u . \ell_g=(1+t)\ell_c-t\ell_u. ℓg=(1+t)ℓc−tℓu.
式(1)|Muse的classifier-free guidance。
这一写法与常见的 ℓ u + s ( ℓ c − ℓ u ) \ell_u+s(\ell_c-\ell_u) ℓu+s(ℓc−ℓu)等价,但对应关系是 s = 1 + t s=1+t s=1+t。因此,跨论文比较"CFG=4"时,应先看参数定义,不能只比较同一个数字。
Muse在采样过程中线性增加引导强度。前期让全局构图有较大探索空间,后期再加强文字约束,以缓解过强引导对多样性的影响。作者还用负面提示条件替换无条件分支,使组合logits倾向远离负面提示关联的特征。
CFG并不保证某个对象属性必然满足,也不保证越大越好。它重新分配生成概率,会改变保真度、文字对齐与分布覆盖之间的折中,必须与采样温度、步数共同选择。
7. Muse超分与解码器微调:把全局语义和局部细节拆开优化
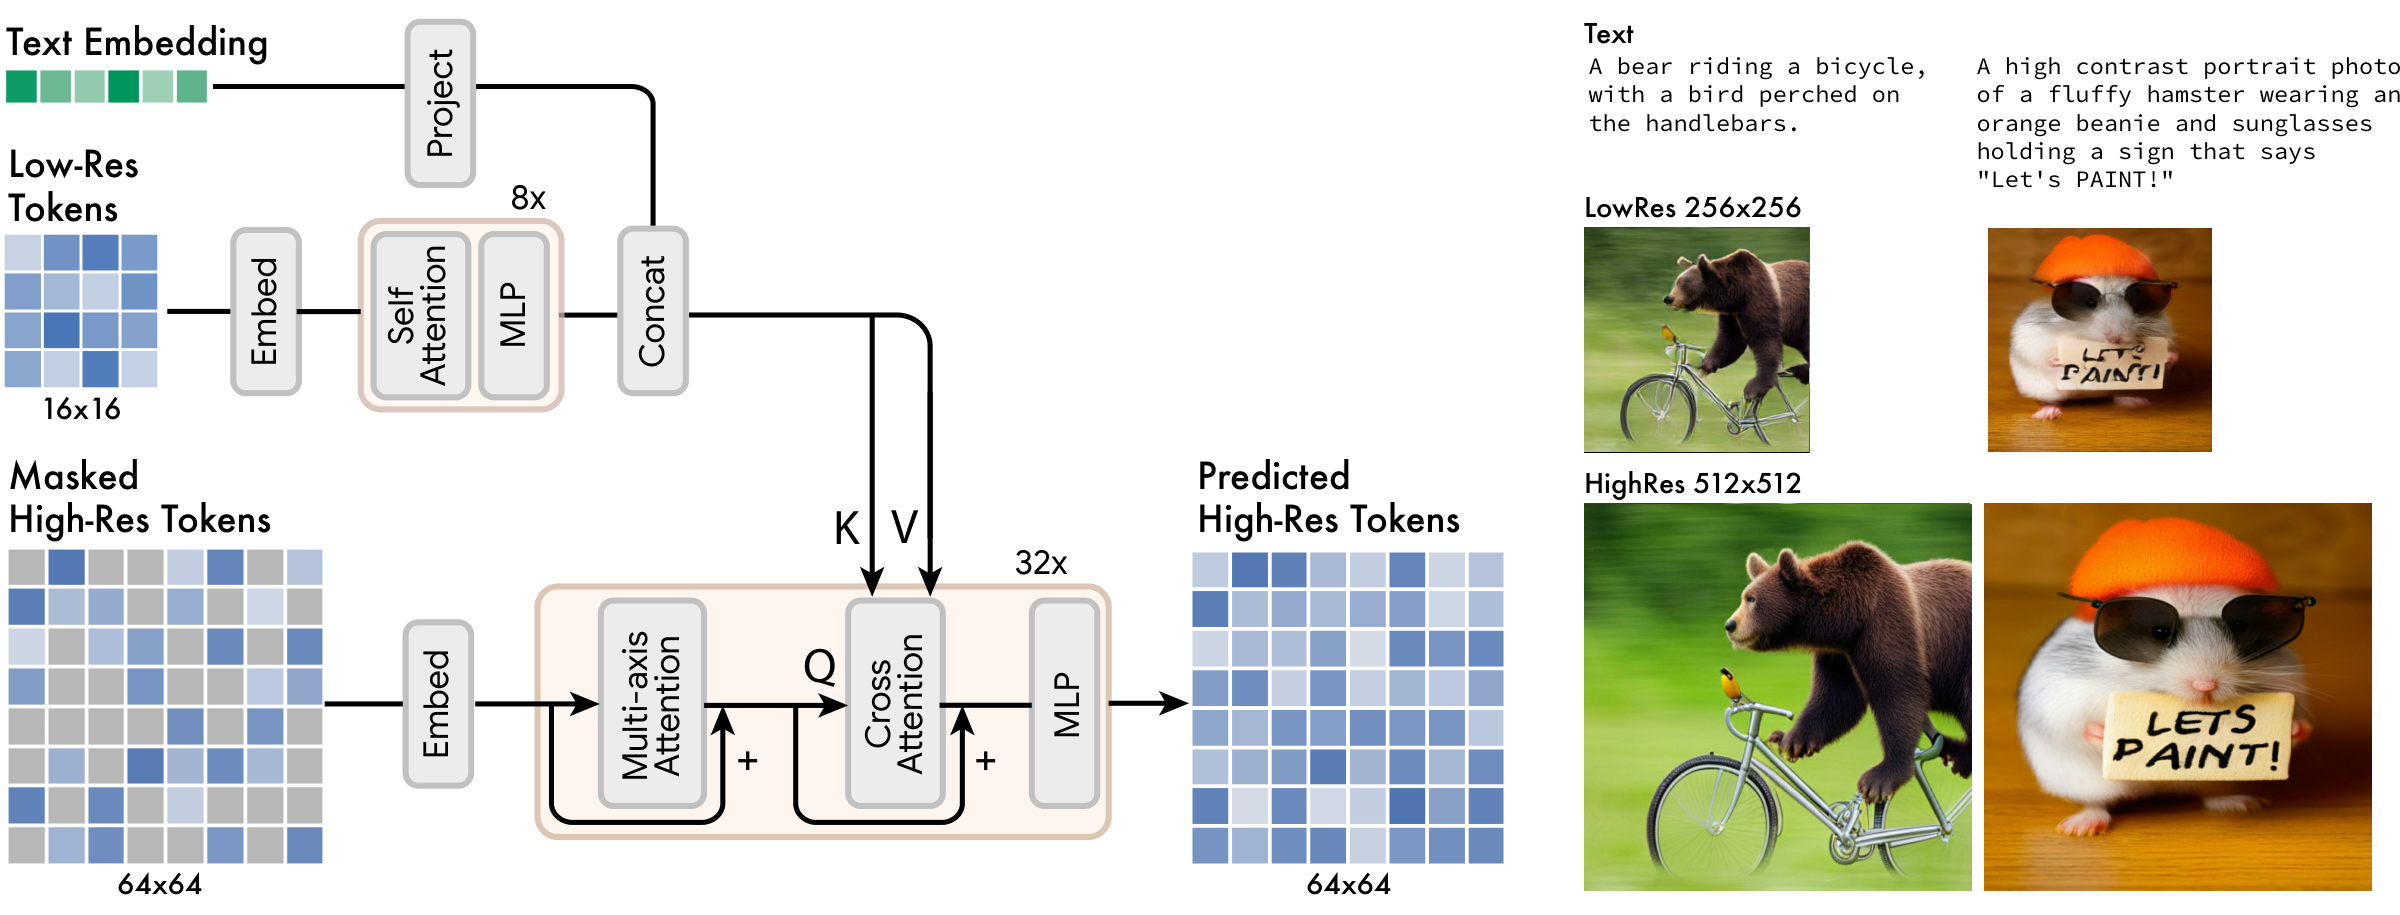
图4左侧展示低分辨率token经过编码后,与文字embedding一起作为高分辨率预测的条件;右侧给出超分前后的样例。高分辨率token作为查询读取条件表示,同时在自身网格中建模空间关系。不能因图示把条件流向画向高分辨率位置,就误读为文字token负责查询并输出所有像素。
论文发现,直接预测512分辨率容易使模型把能力用于低层细节,因此采用先低分辨率建构语义、再补充细节的级联方式。这是任务分解,不是简单把低分辨率码字复制或插值成更大的网格。两个tokenizer的码字空间不同,超分模型学习的是条件下的跨表示预测。
表6|超分模型配置。
| Configuration | Value |
|---|---|
| LowRes Encoder Transformer Layers | 16 |
| Number of Transformer layers | 32 |
| Transformer Hidden Dimension | 1024 |
| Transformer MLP Dimension | 4096 |
| Optimizer | AdaFactor |
| Base learning rate | 1e-4 |
| Weight decay | 0.045 |
| Optimizer momentum | β 1 = 0.9 , β 2 = 0.96 \beta_1=0.9, \beta_2=0.96 β1=0.9,β2=0.96 |
| Batch size | 512 |
| Learning rate schedule | cosine decay |
| Warmup steps | 5000 |
| Training steps | 1M |
附录表6将低分辨率编码器写为16层,而架构示意图的相应模块标注为8×。v1没有进一步解释这一差异,本文保留图与配置表,不把示意图当作足以唯一确定全部实现细节的说明。
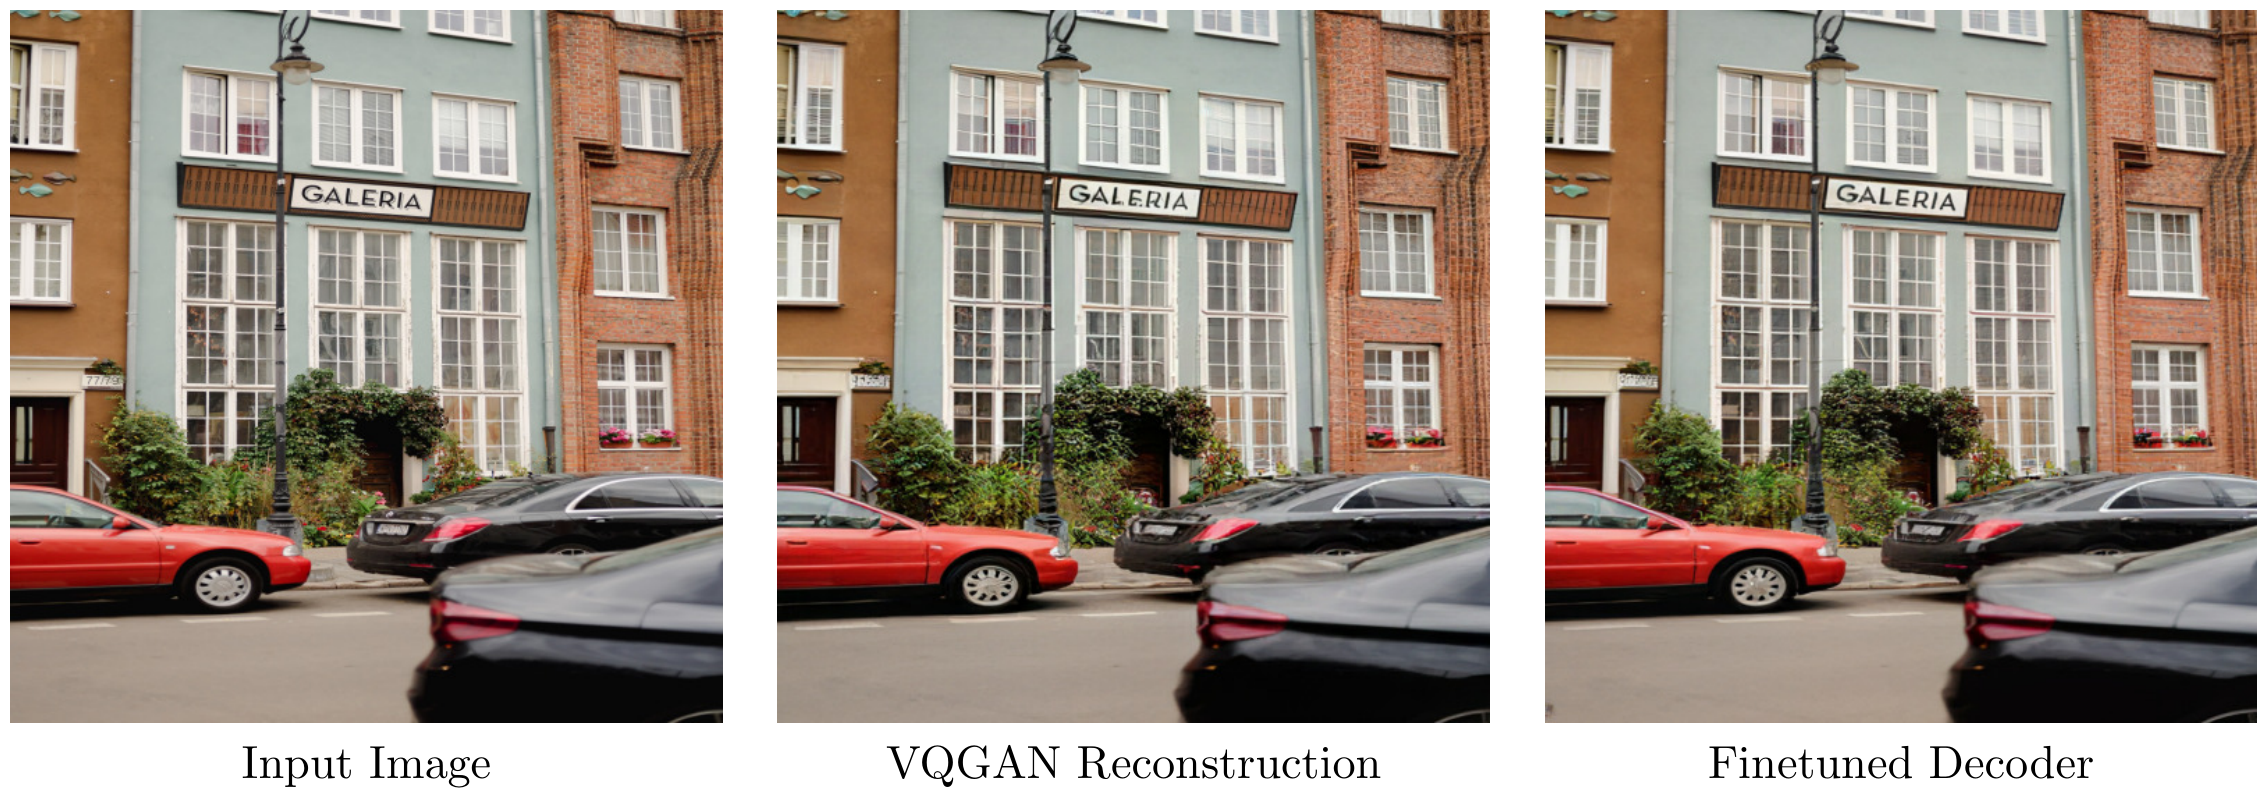
图13比较输入、VQGAN重建及增强解码器重建。解码器微调时,视觉编码器、码本和两个生成Transformer都保持冻结,只扩展并调优解码器,从同一套视觉token中恢复更清晰的细节。
这一点有直接工程价值:只要token含义不变,改善解码器就不必重新训练整个生成器。但它不能凭空恢复编码中已经完全丢失的信息,也不等于每一处小字都能忠实还原。判断重建提升时,应看局部清晰度与内容准确性是否同时改善。
8. Muse训练规模与复现:参数表能解释结构,不能消除版本差异
大型模型使用与Imagen相同的460M图文对数据集,基础模型具有48层Transformer。训练使用Adafactor减少优化器内存,在线不保留EMA副本,而是每5,000步保存检查点,再对检查点权重离线执行衰减因子0.7的EMA。
这类离线EMA的衰减单位是保存的检查点,不能把0.7直接等价成逐梯度更新步使用相同衰减率。训练资源比较也需要考虑冻结文本编码、视觉tokenizer与超分阶段的开销。
表4|3B基础模型配置。
| Configuration | Value |
|---|---|
| Number of Transformer layers | 48 |
| Transformer Hidden Dimension | 2048 |
| Transformer MLP Dimension | 8192 |
| Optimizer | AdaFactor |
| Base learning rate | 1e-4 |
| Weight decay | 0.045 |
| Optimizer momentum | β 1 = 0.9 , β 2 = 0.96 \beta_1=0.9, \beta_2=0.96 β1=0.9,β2=0.96 |
| Batch size | 512 |
| Learning rate schedule | cosine decay |
| Warmup steps | 5000 |
| Training steps | 1.5M |
正文写训练1M步、batch 512,在512-core TPU-v4上约一周;附录表4则写基础模型训练1.5M步。这是v1内部不一致。本文不将"一周"与"1.5M步"拼接成一个确定训练预算,也不猜测哪一个数字代表所有最终实验。
对于复现者,参数表、训练数据说明和推理流程足以理解方法,但无法替代完整训练代码、数据过滤和实验配置。该版本明确表示当时不发布代码或公开演示,因此应把论文可分析性与官方模型可完整复现性分开讨论;这里不对后续第三方实现或当前资源状态作未经核对的推断。
9. Muse实验:FID改善与文字对齐需要同时阅读
表1|CC3M结果。 各视觉生成模型按该表在CC3M上训练和评估;Muse仍使用外部预训练并冻结的文本编码器,因此不能据此断言各系统完整预训练知识来源相同。
| Approach | Model Type | Params | FID | CLIP |
|---|---|---|---|---|
| VQGAN | Autoregressive | 600M | 28.86 | 0.20 |
| ImageBART | Diffusion+Autogressive | 2.8B | 22.61 | 0.23 |
| LDM-4 | Diffusion | 645M | 17.01 | 0.24 |
| RQ-Transformer | Autoregressive | 654M | 12.33 | 0.26 |
| Draft-and-revise | Non-autoregressive | 654M | 9.65 | 0.26 |
| Muse(base model) | Non-autoregressive | 632M | 6.8 | 0.25 |
| Muse(base + super-res) | Non-autoregressive | 632M + 268M | 6.06 | 0.26 |
Muse基础模型FID为6.8,加入超分模型后改善到6.06;CLIP从0.25提高至0.26。这支持两级生成提高该基准分布匹配质量。0.26与表中其他若干方法相同,不应写成CLIP独占最高。
表2|MS-COCO的256分辨率评估。 普通FID与zero-shot FID分列保留;参数空缺仍标为未提供,不能在表内自行补齐不同口径的总参数。
| Approach | Model Type | Params | FID-30K | Zero-shot FID-30K |
|---|---|---|---|---|
| AttnGAN | GAN | --- | 35.49 | - |
| DM-GAN | GAN | --- | 32.64 | - |
| DF-GAN | GAN | --- | 21.42 | - |
| DM-GAN + CL | GAN | --- | 20.79 | - |
| XMC-GAN | GAN | --- | 9.33 | - |
| LAFITE | GAN | --- | 8.12 | - |
| Make-A-Scene | Autoregressive | --- | 7.55 | - |
| DALL-E | Autoregressive | --- | - | 17.89 |
| LAFITE | GAN | --- | - | 26.94 |
| LDM | Diffusion | --- | - | 12.63 |
| GLIDE | Diffusion | --- | - | 12.24 |
| DALL-E 2 | Diffusion | --- | - | 10.39 |
| Imagen-3.4B | Diffusion | --- | - | 7.27 |
| Parti-3B | Autoregressive | --- | - | 8.10 |
| Parti-20B | Autoregressive | --- | 3.22 | 7.23 |
| Muse-3B | Non-Autoregressive | --- | - | 7.88 |
Muse-3B zero-shot FID为7.88,略优于Parti-3B的8.10,但高于Imagen的7.27和Parti-20B的7.23。Parti-20B的3.22位于非zero-shot列,不能拿它直接与Muse的zero-shot成绩作同协议排序。
Muse报告CLIP为0.32。论文还指出,Imagen的CLIP随着采样参数及FID工作点变化,不能把某模型最优FID和另一个工作点的最高CLIP拼成一个不存在的结果组合。
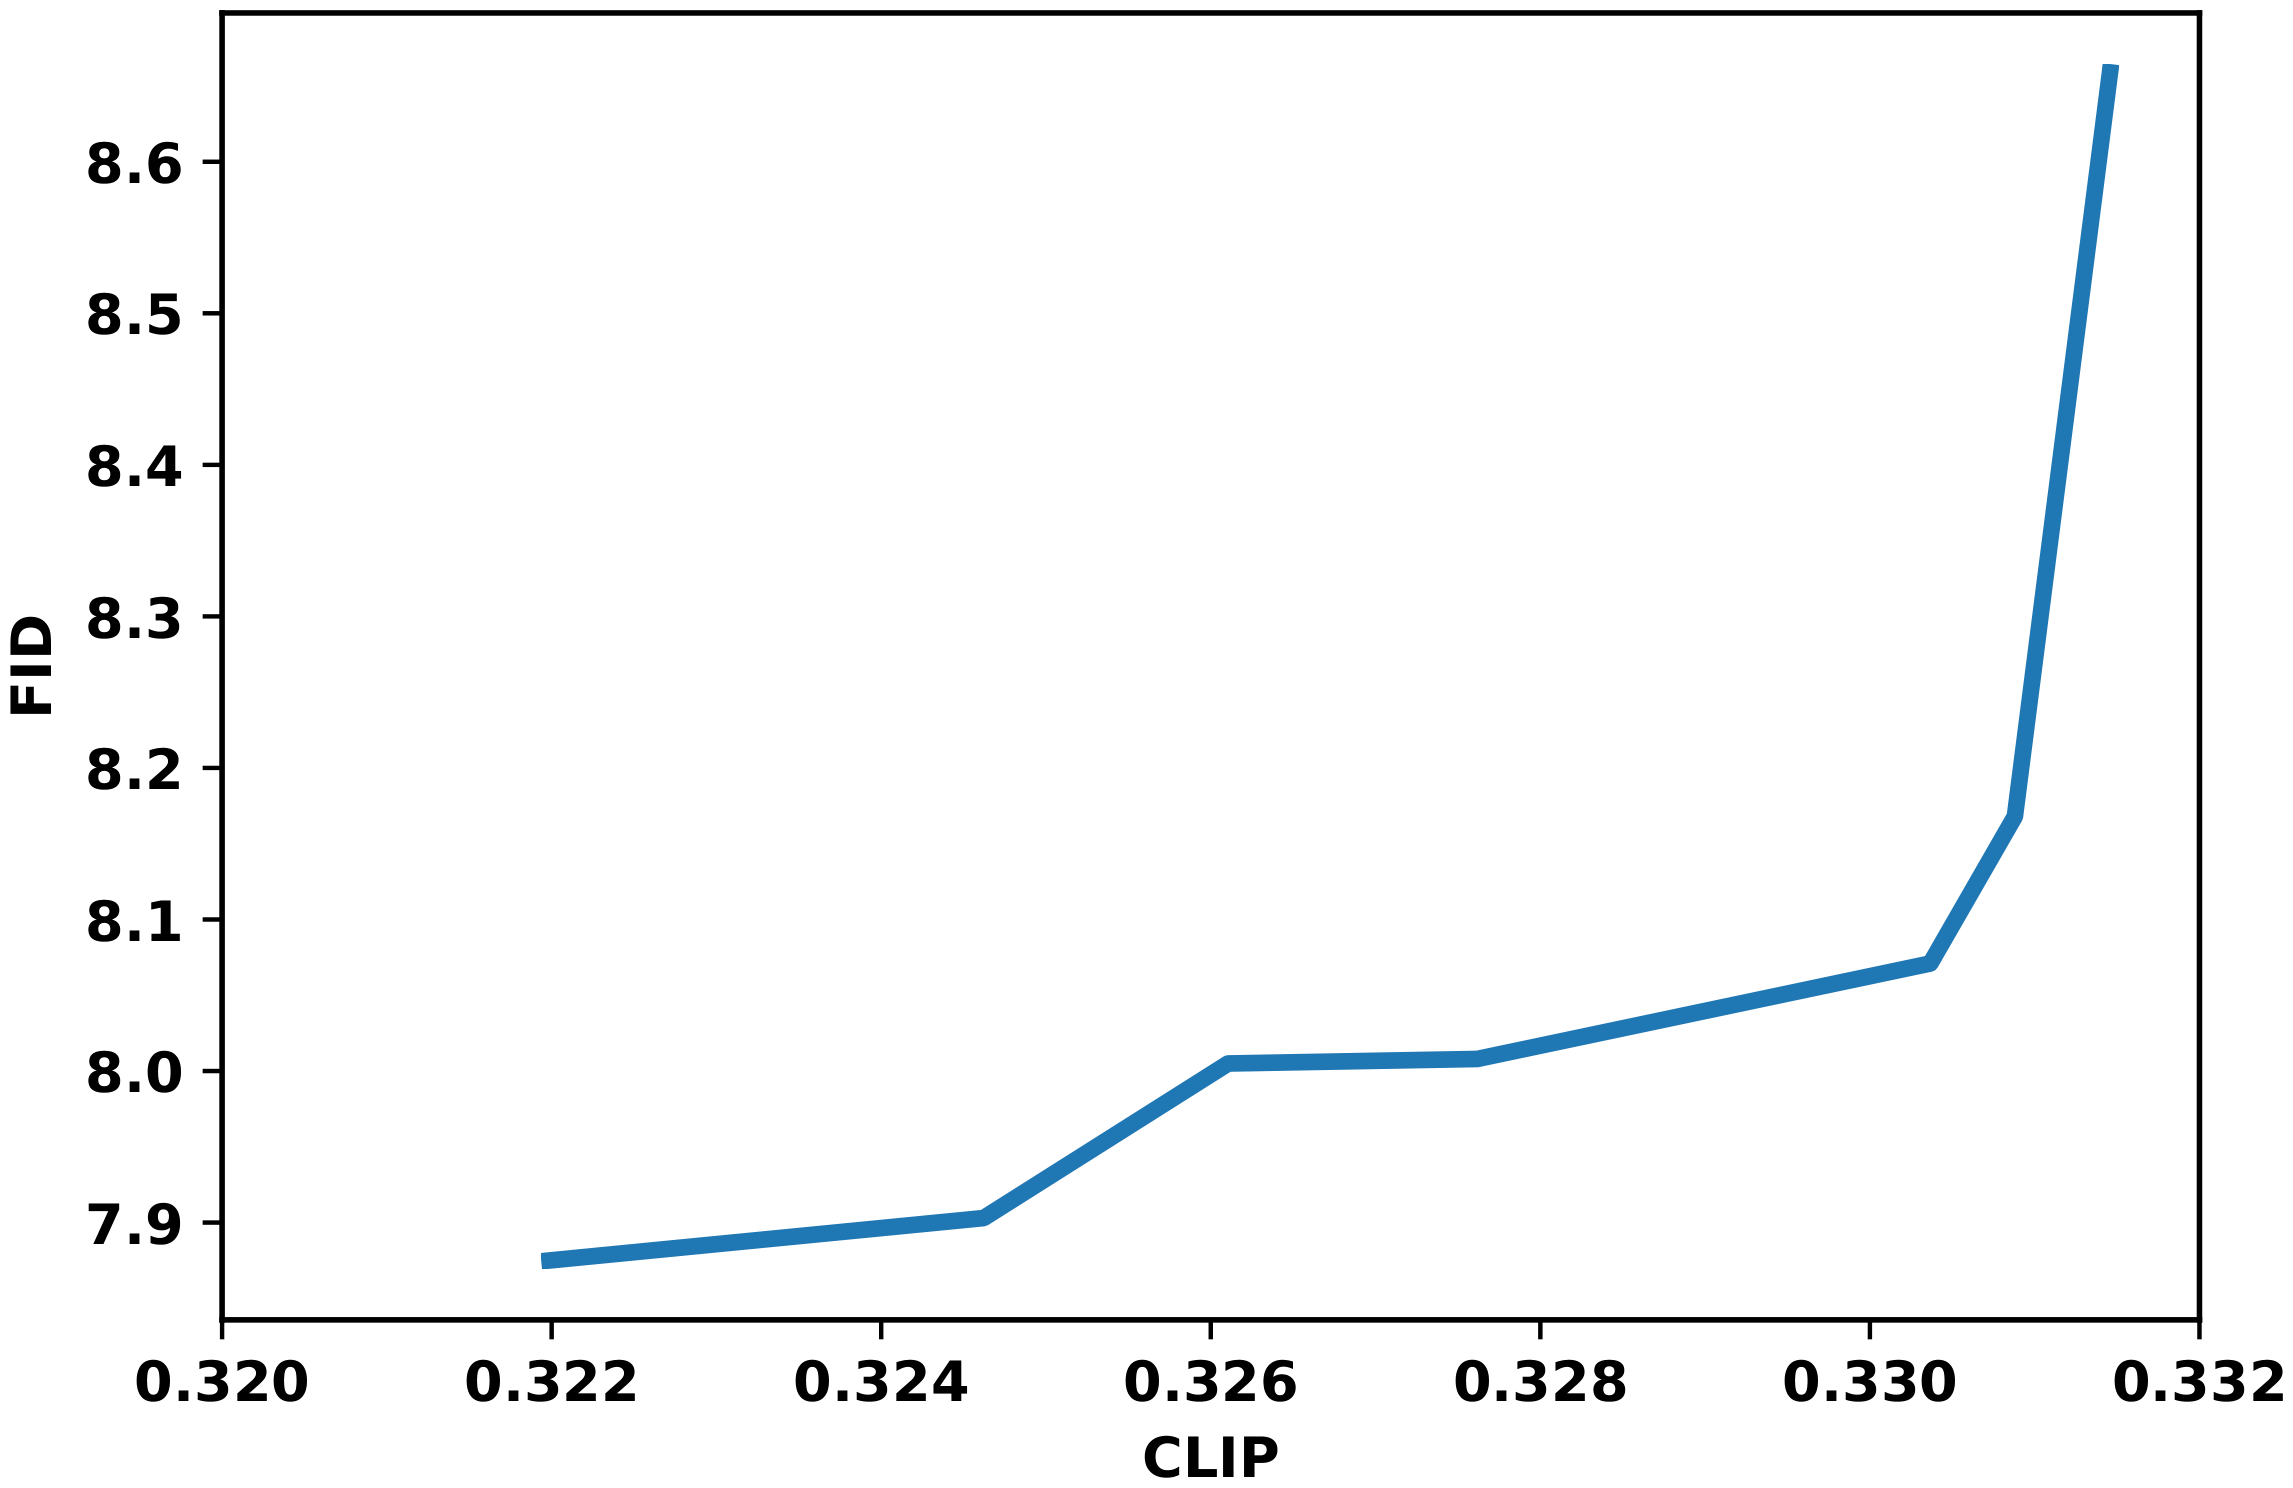
图8通过扫描采样设置得到Pareto前沿:沿着曲线提高文字对齐,可能损害FID。这里的"前沿"只相对于已测试的采样配置与该模型成立,不代表所有模型、全部提示分布上的理论最优边界。
Rocky认为,生成系统评估最有用的输出应是一组可选择的工作点。产品需要的可能是更强的指令遵循、更高多样性或更低成本,单独追逐一个最小FID会把这些目标冲突藏起来。
10. Muse定性能力与人类评测:16选1是结果的一部分
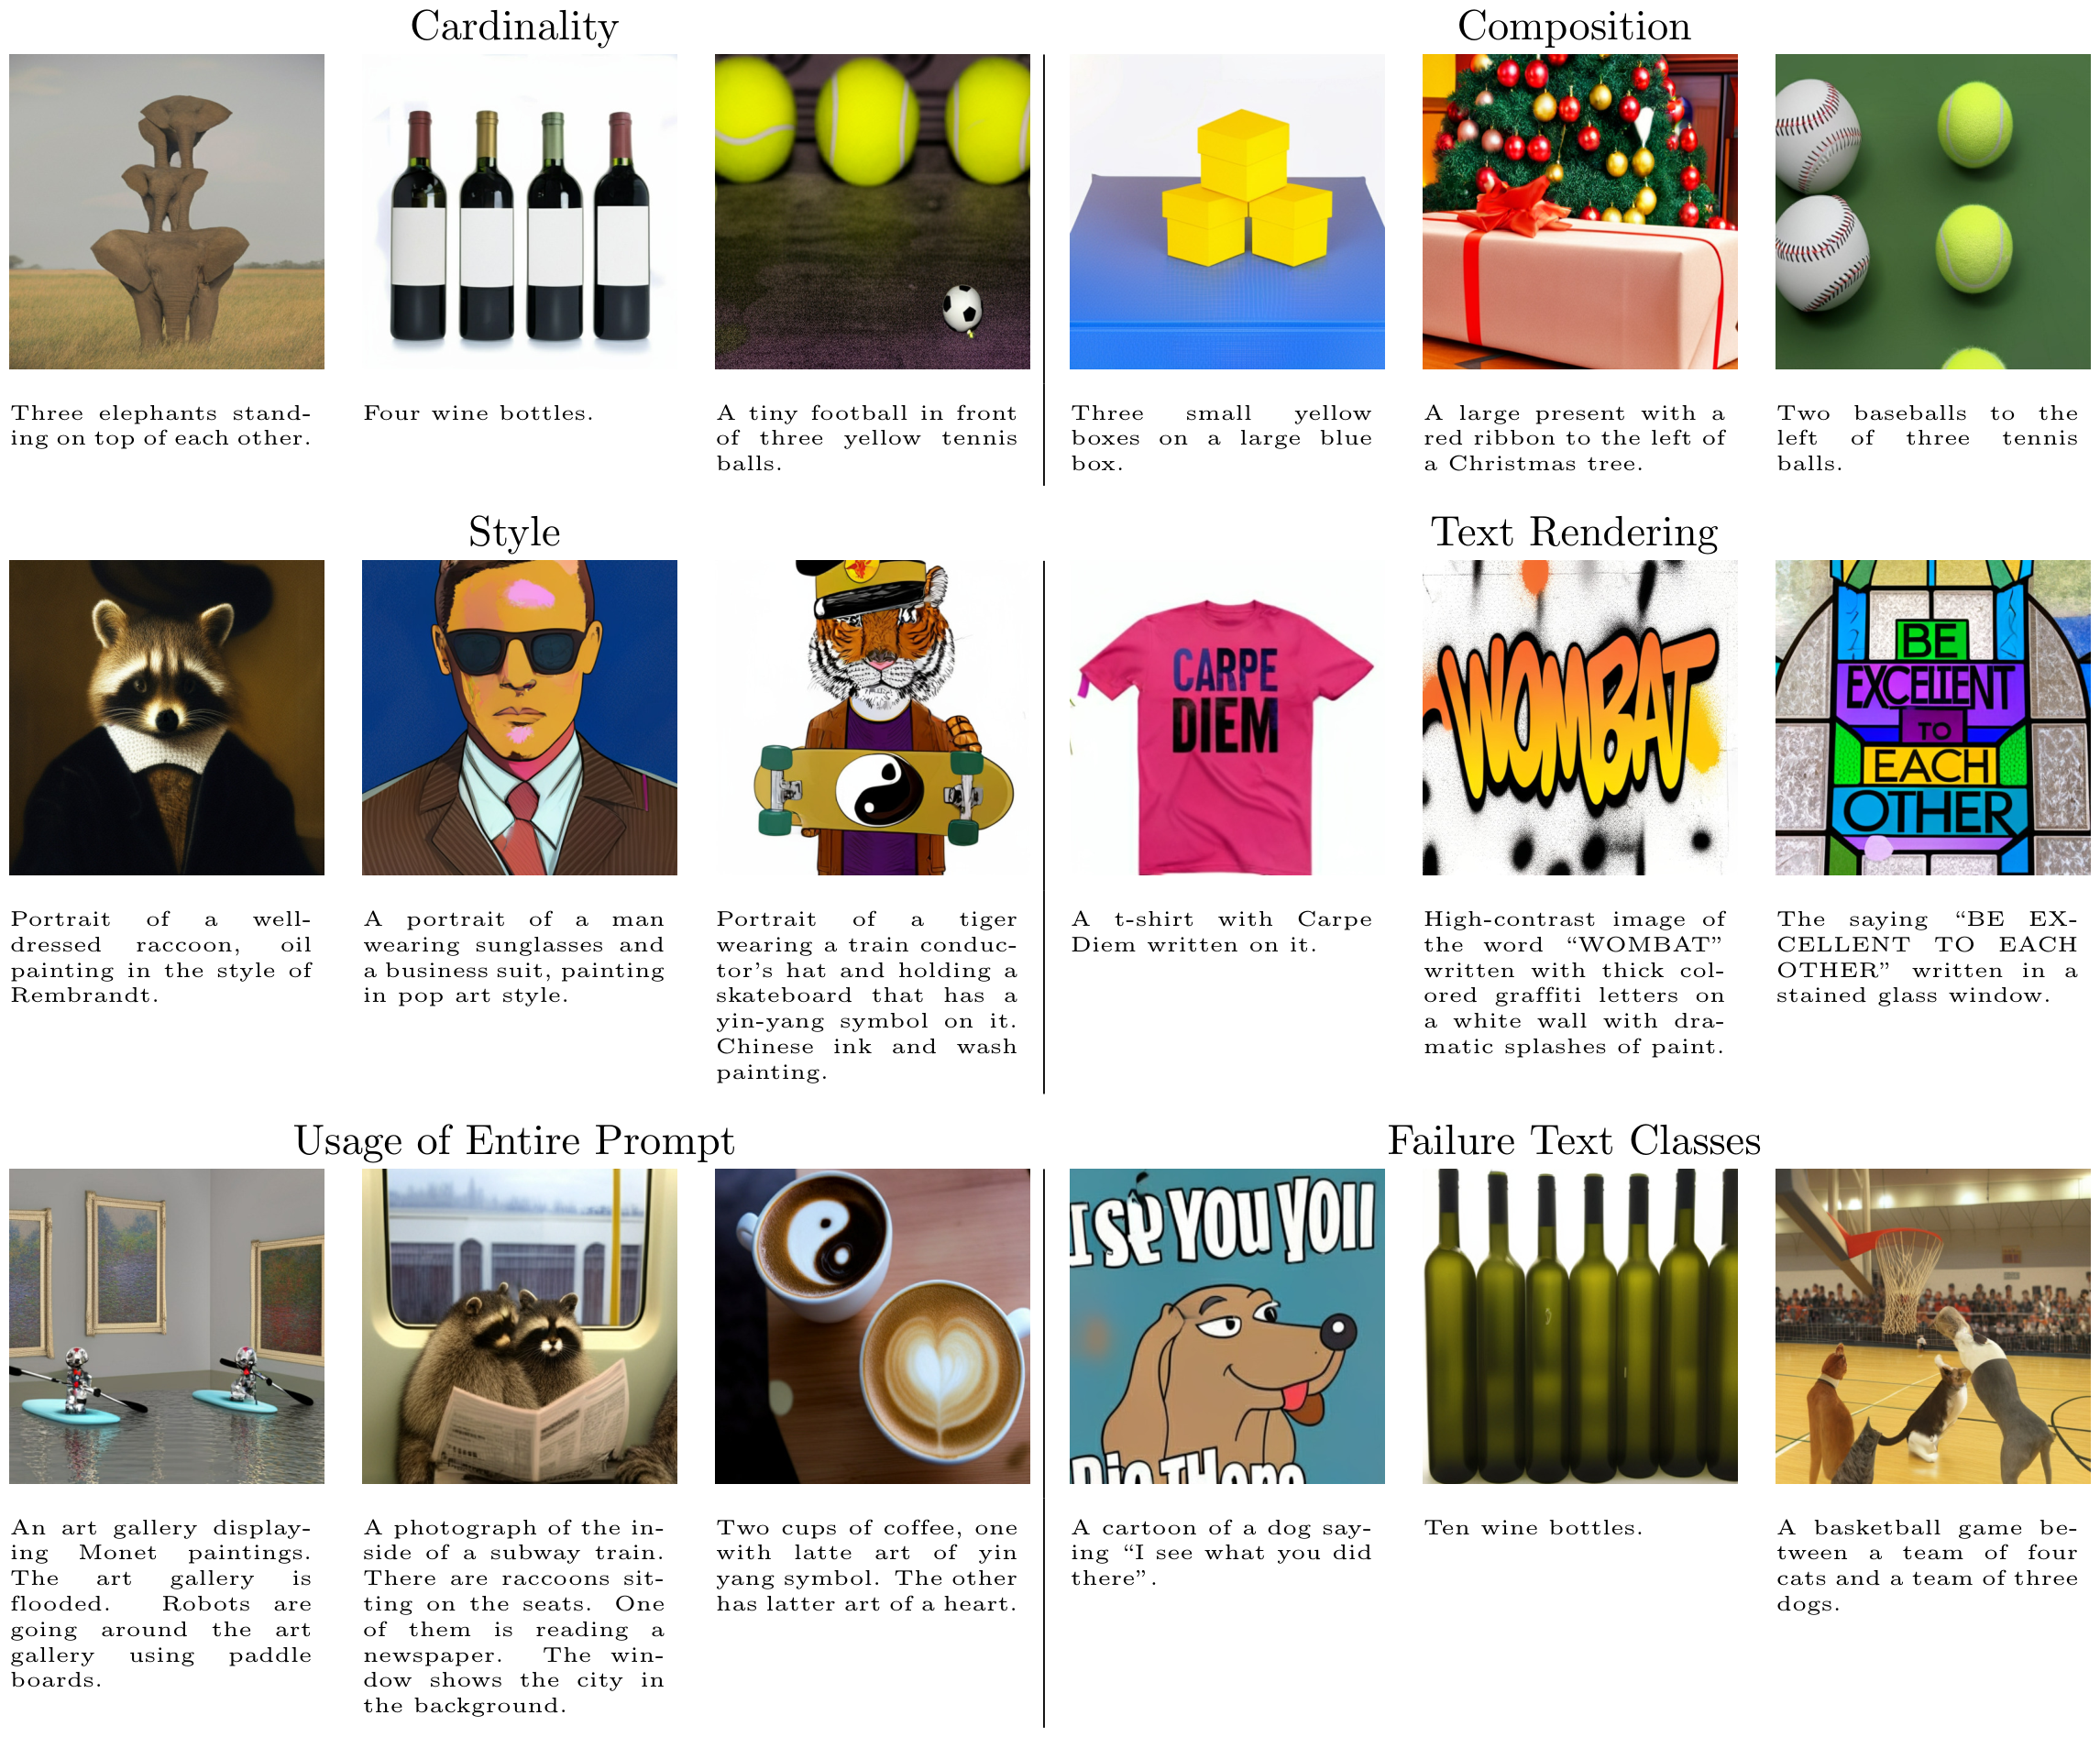
图6完整保留成功与失败案例。模型能够生成多种对象组合、风格和部分文字,但长句、较大数量以及多种对象分别计数仍然困难。更关键的是:这些例子每条提示生成16个候选,再选择CLIP最高的一张。它们展示的是带筛选流程的能力,而非一次采样即成功的概率。
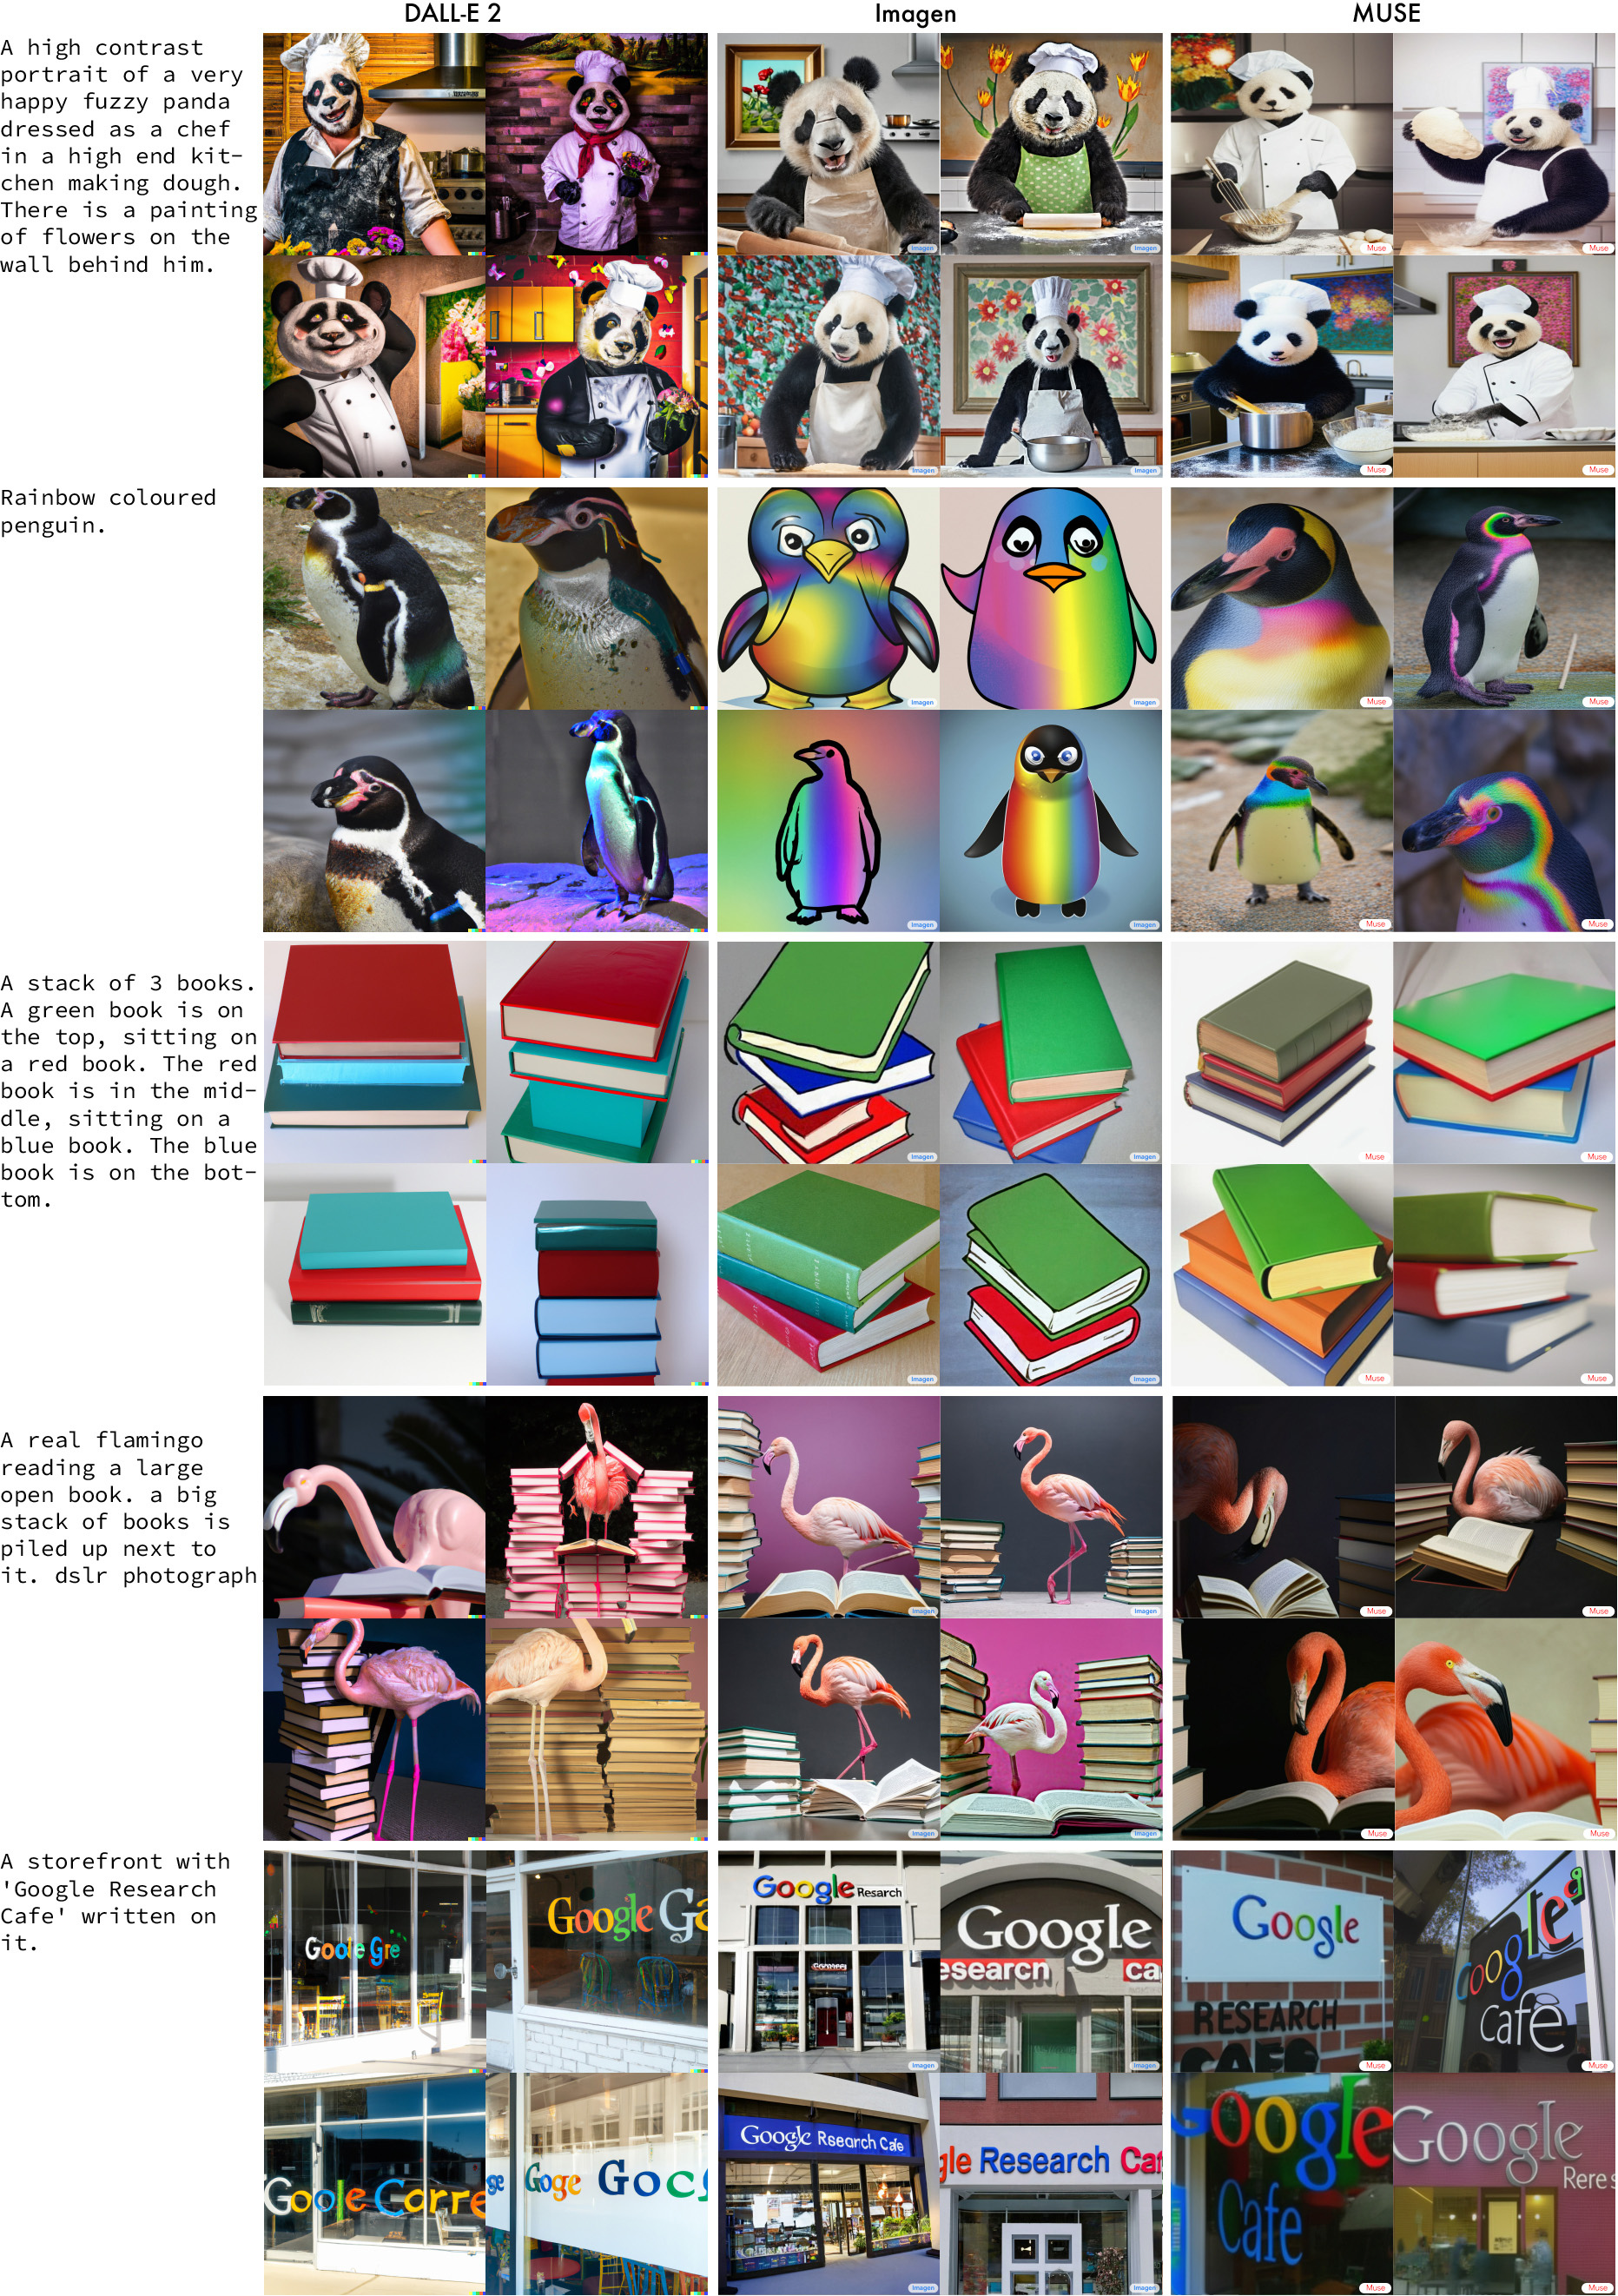
图7比较相同提示下的若干结果,可以帮助读者观察对象、文字和布局差异。精选案例不是随机化全面评测,不能只凭这些画面断言一种架构在所有提示上更强。
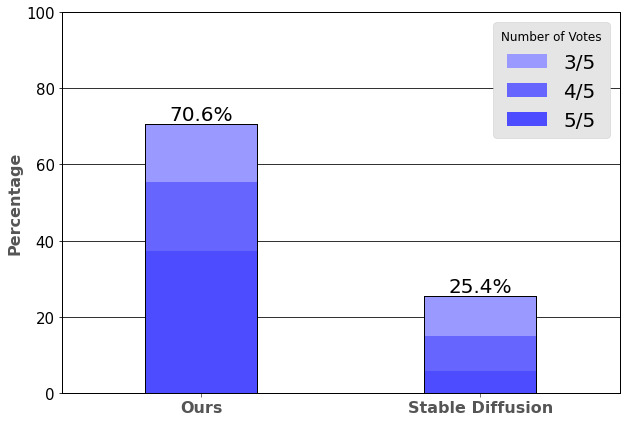
人类评测使用1,650条PartiPrompts,每个模型每条提示生成16张并经CLIP选一张,再由5名独立评价者比较"哪张图更符合描述"。图片匿名、左右顺序随机,至少3人一致才计入偏好。
Muse在70.6%的提示上获得多数偏好,Stable Diffusion v1.4为25.4%,其余4%没有形成偏好共识。70.6除以25.4约为2.78,论文概括为约2.7倍。这是获偏好提示比例的比值,不是图像质量提高2.7倍,更不是任务成功率提高2.7倍。
该评测没有另外测量人类真实感偏好。作者认为,当文字对齐明显不同时,单独询问"哪张更真实"可能偏爱忽略提示但画面逼真的输出。可以认同这一评测问题,同时保留证据边界:本实验主要支持文字对齐偏好,不直接证明全部维度的用户体验领先。
11. Muse速度:并行解码有效,硬件与筛选成本仍需统一
表3|论文报告的批次推理时间。 Muse、Imagen、Parti在TPUv4上内部测试,LDM来自A100基准;LDM 250步的18.5秒由50步的3.7秒乘5估算。
| Model | Resolution | Time |
|---|---|---|
| Imagen | 256 × 256 | 9.1s |
| Imagen | 1024 × 1024 | 13.3s |
| LDM (50 steps) | 512 × 512 | 3.7s |
| LDM (250 steps) | 512 × 512 | 18.5s |
| Parti-3B | 256 × 256 | 6.4s |
| Muse-3B | 256 × 256 | 0.5s |
| Muse-3B | 512 × 512 | 1.3s |
在256分辨率行中,Muse报告0.5秒、Parti-3B为6.4秒、Imagen为9.1秒;512分辨率Muse为1.3秒。这与减少串行迭代的机制一致,但跨硬件的LDM比较不能被视为严格等硬件测试,推算出的250步耗时也不是独立实测值。
图1按单张样例描述1.3秒,表3标题使用per-batch口径,正文没有提供足够完整的batch、编译和服务链条信息来消除所有差异。因此,这些数字适合说明当时实现中的速度量级与相对趋势,不宜直接换算成任意GPU上的单请求SLA。
还应区分生成一张候选图与得到评测中最终展示图的成本。如果评价协议需要生成16张再用CLIP筛选,端到端流程就包括多候选生成和评分;真实时延取决于并行batch、显存与调度,不能简单把1.3秒当作整套筛选流程的固定耗时。
论文承认,扩散蒸馏与更高效ODE求解器已经能减少扩散采样步数,但没有完成与所有这些加速方法的比较。由此可见,"Muse比扩散快"应解释为该版本对所测实现的结果,而非对两类方法的永久复杂度判决。
12. Muse图像编辑:训练目标直接提供了可用的操作接口
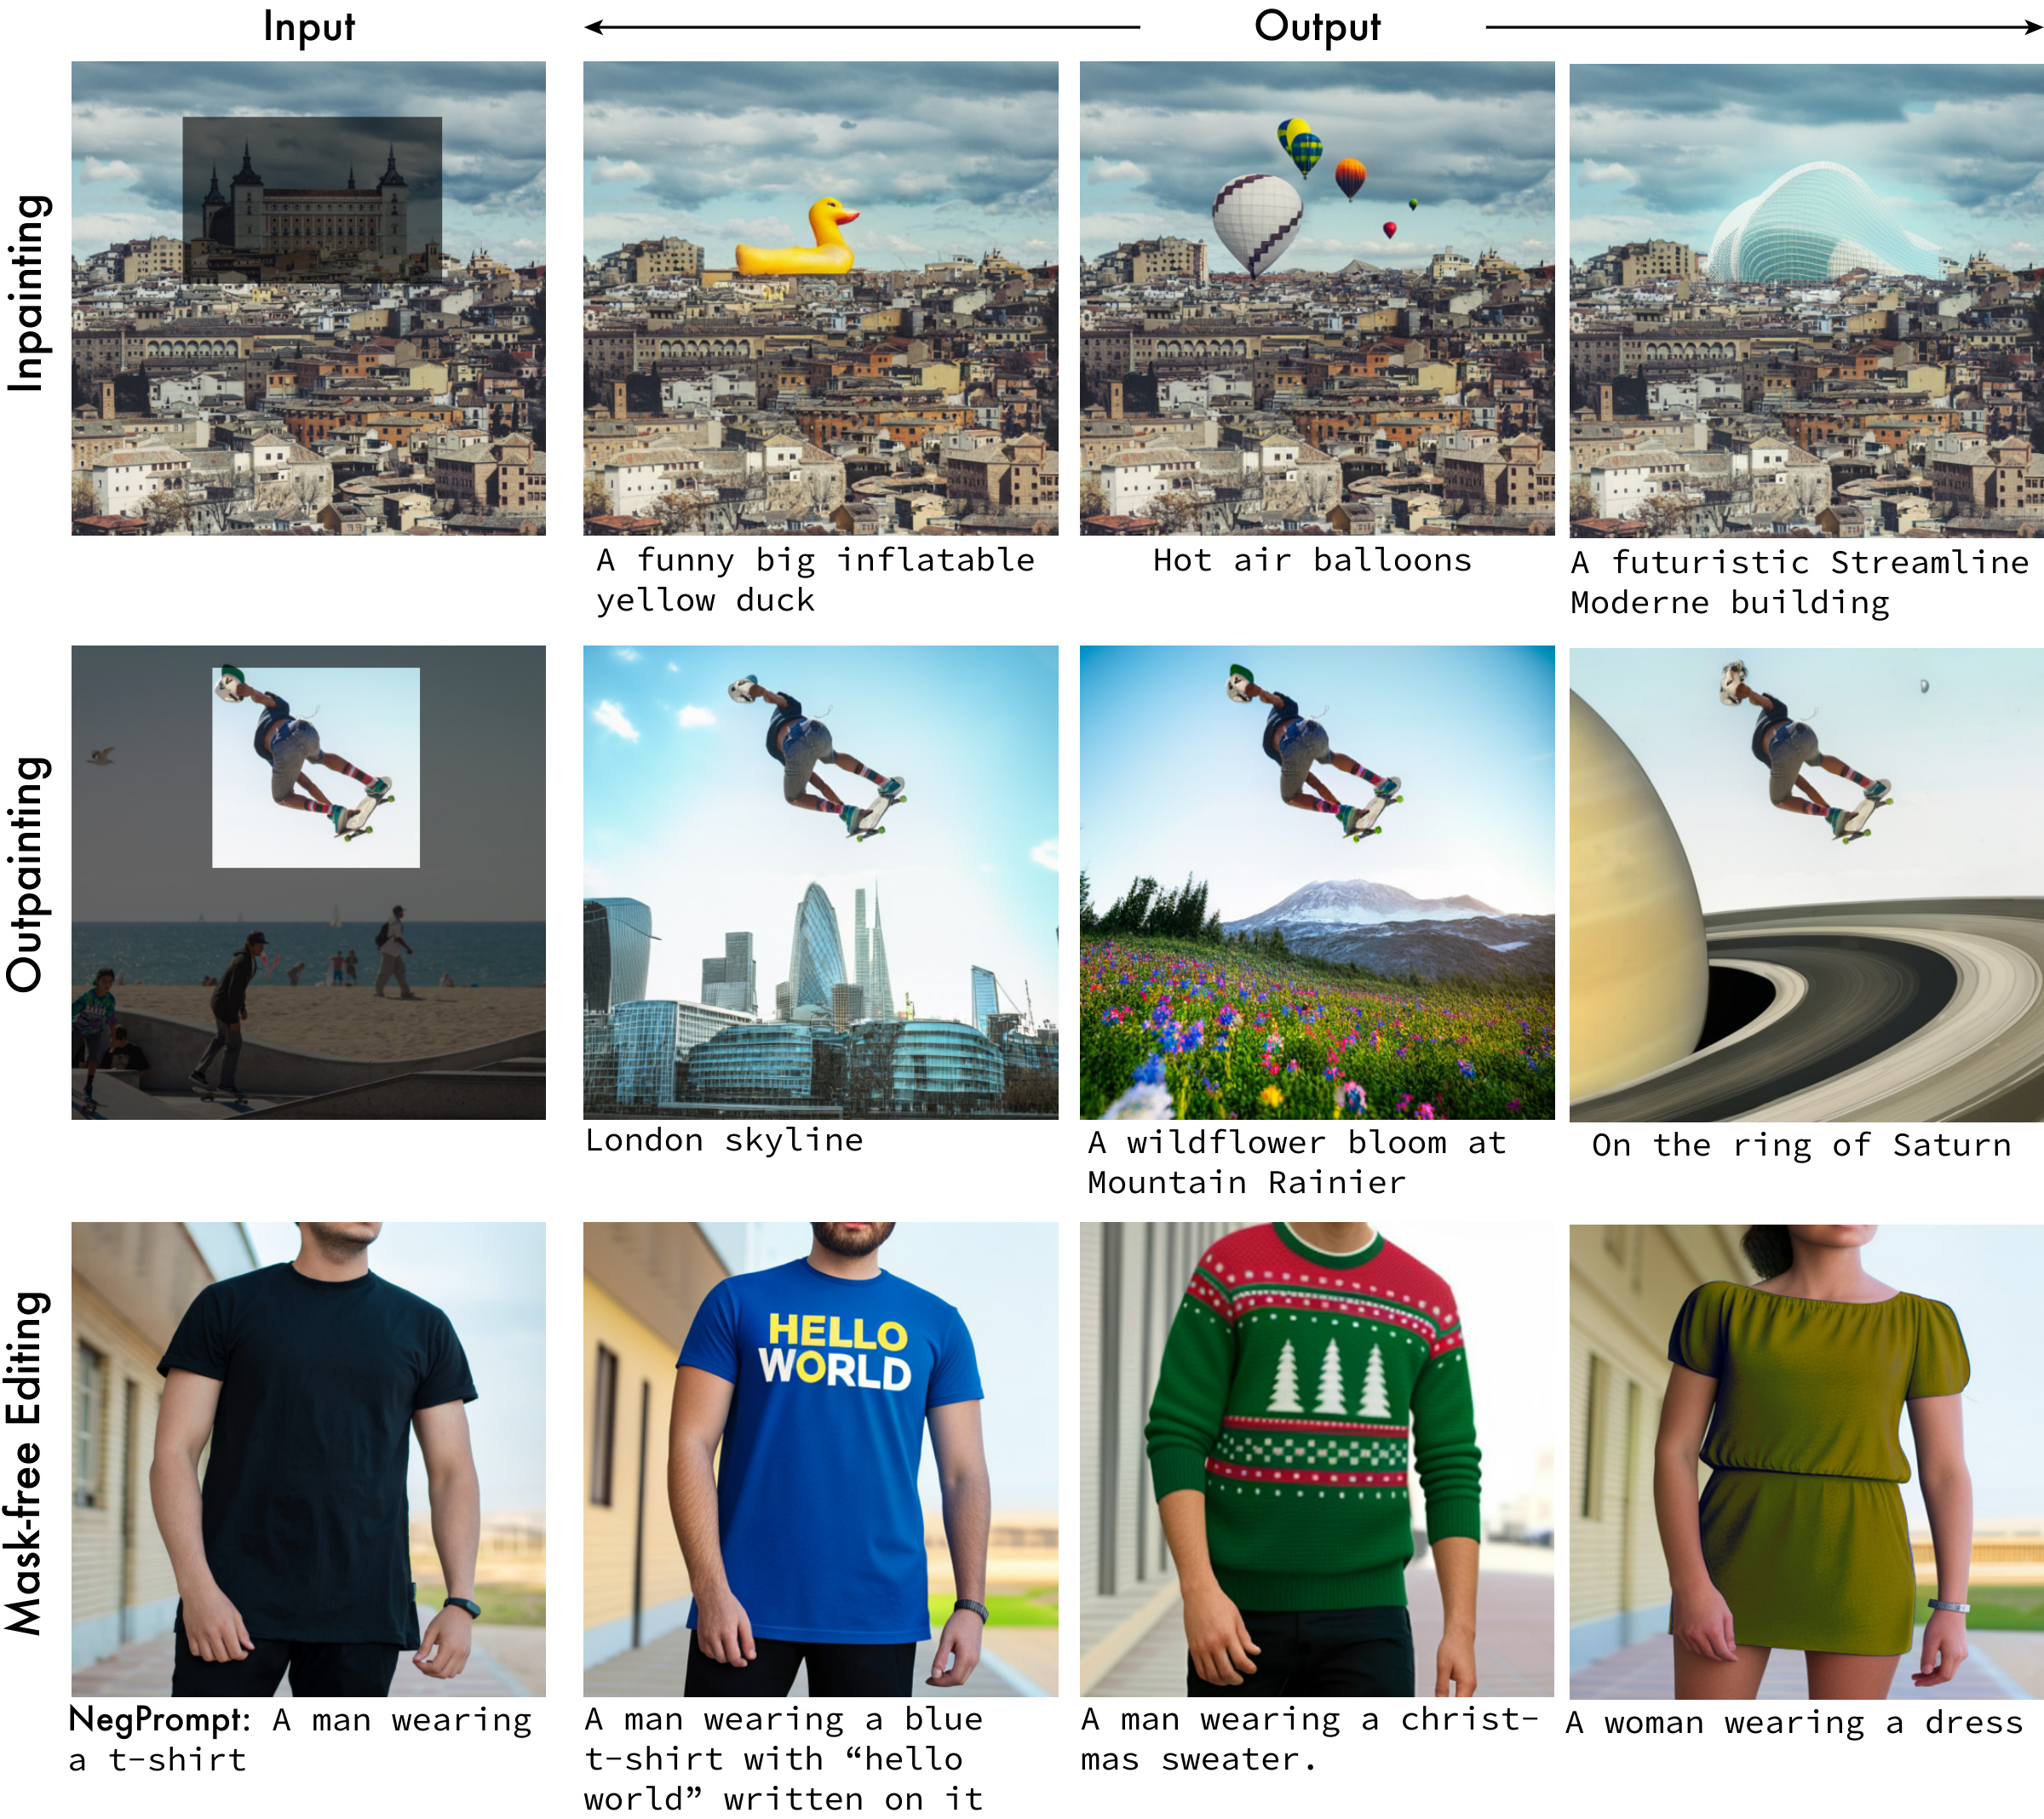
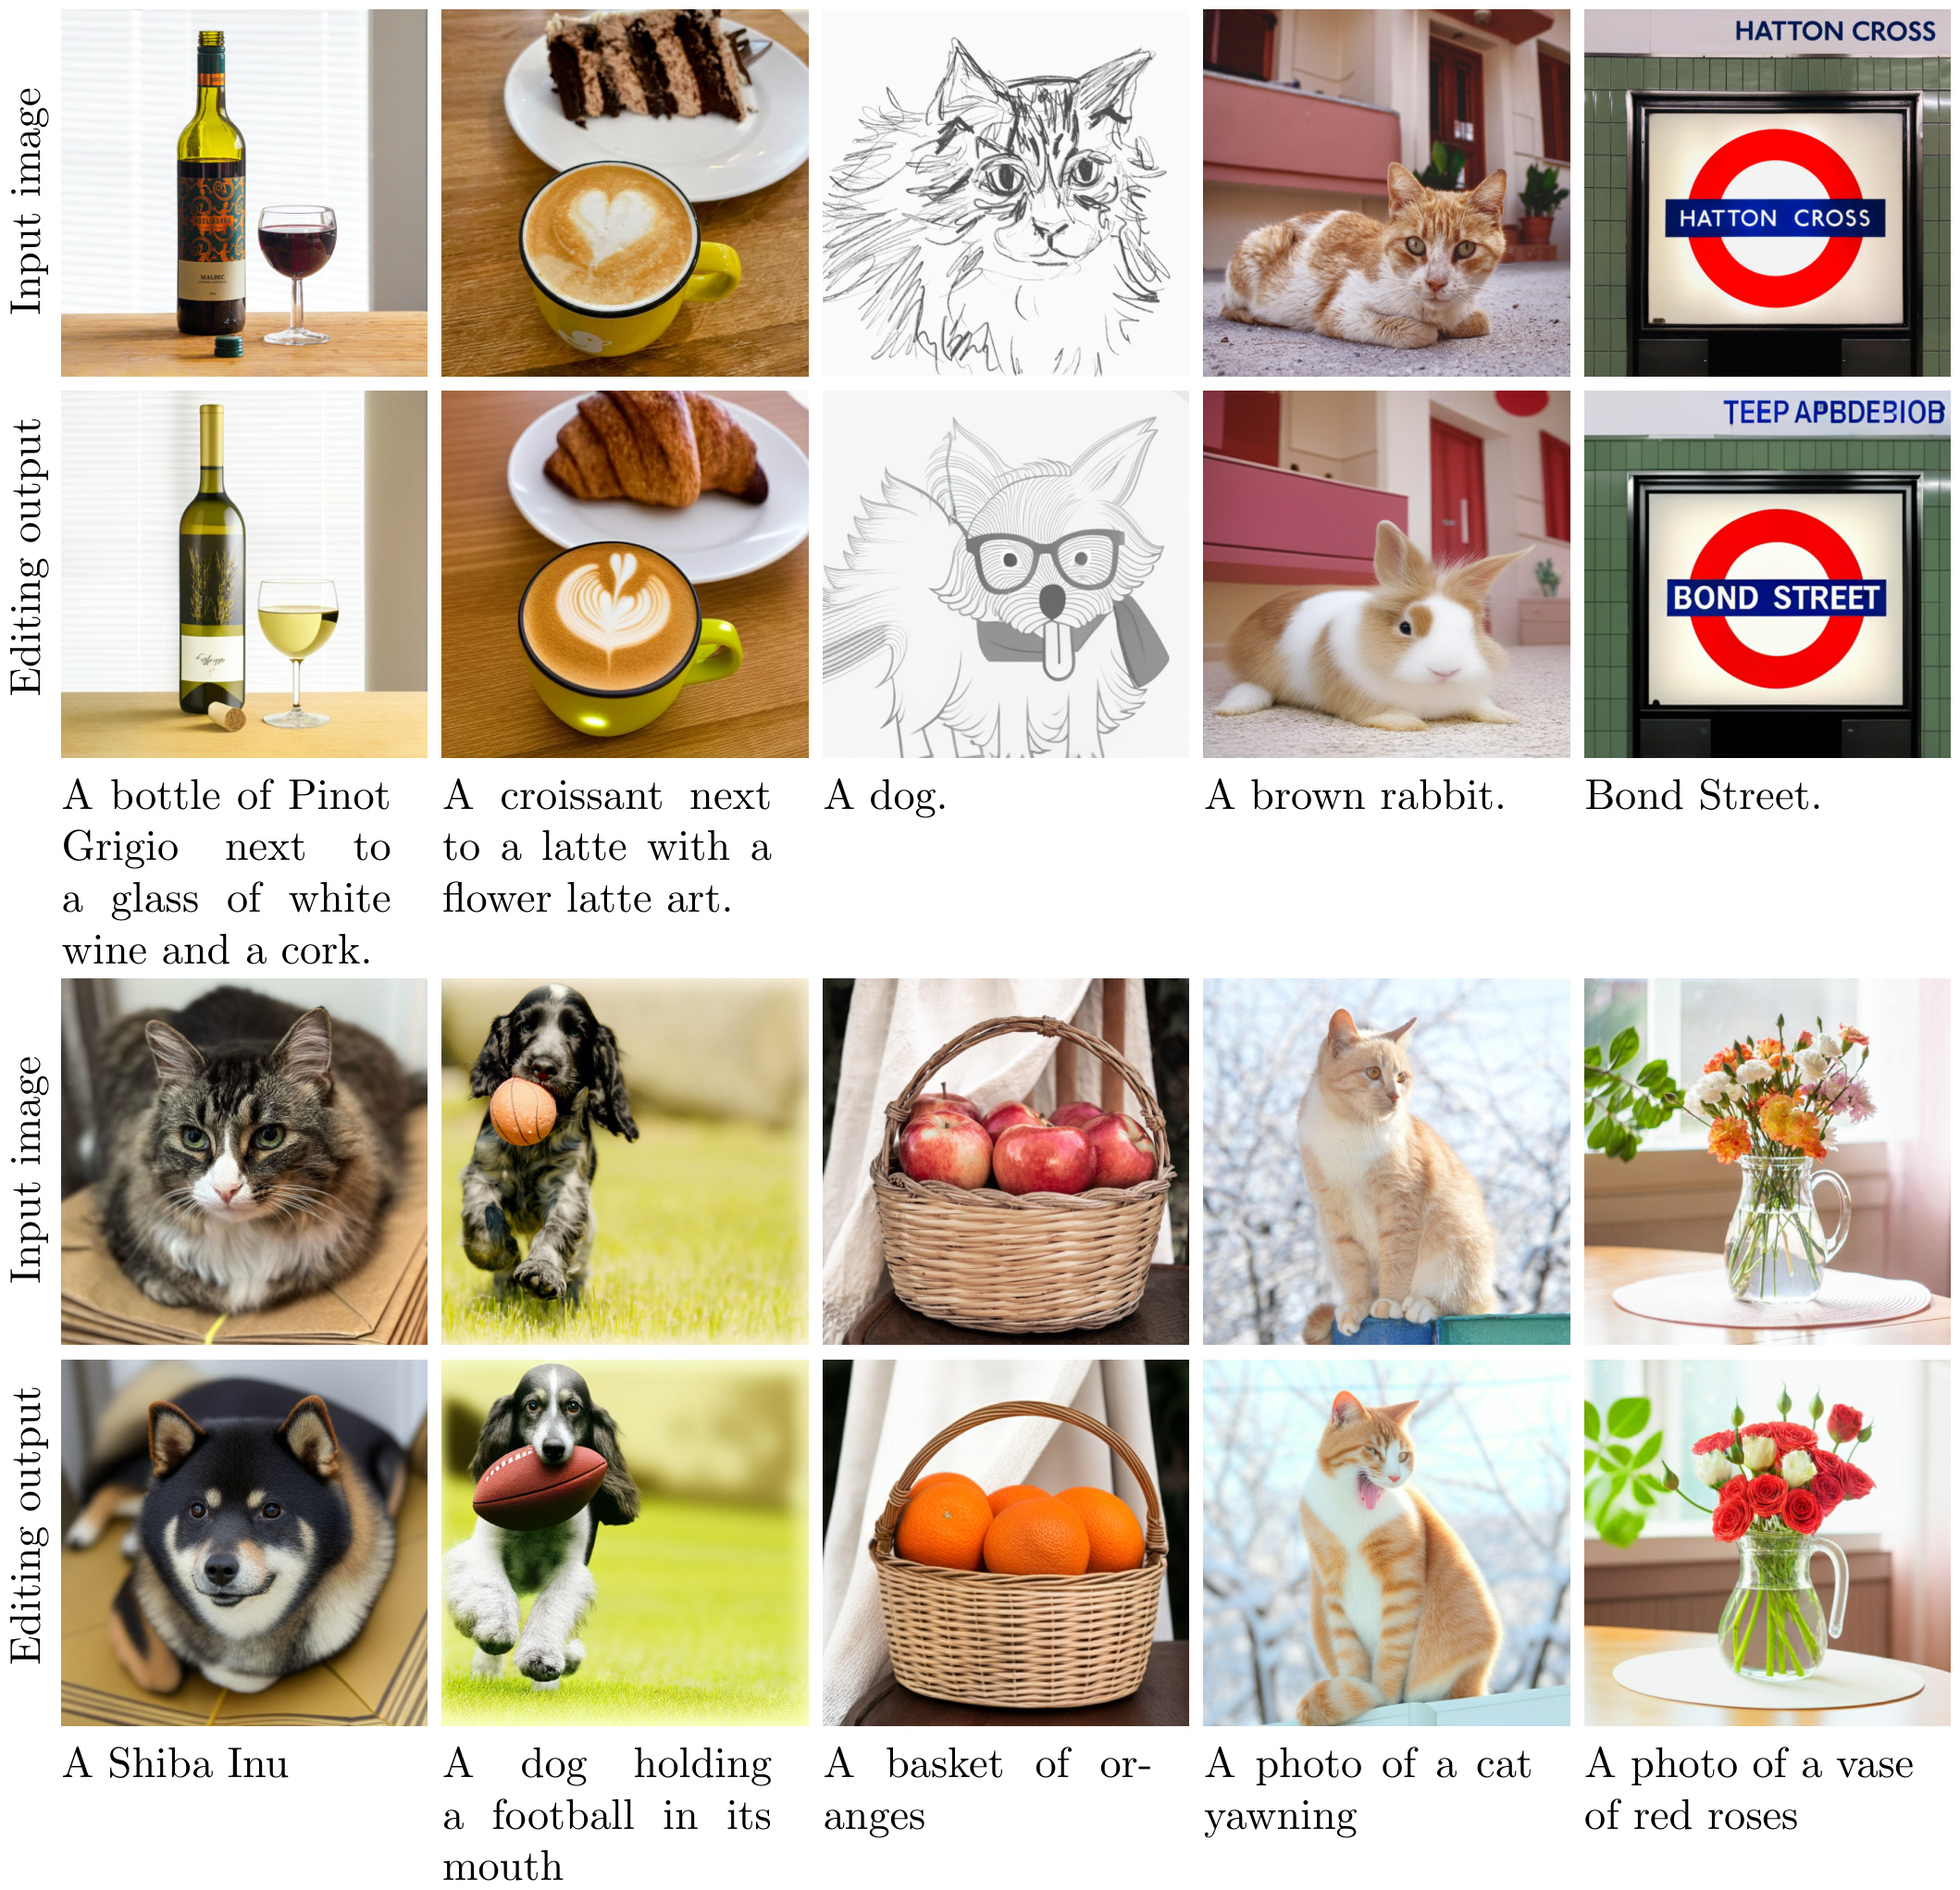
图2展示真实输入上的编辑。只要模型学会根据任意可见子集补全,就可以将需要修改的部分设为未知,利用保留区域和新提示共同约束生成。这里"零样本"表示不需要针对这些编辑任务另做训练,不表示没有预训练或没有计算成本。
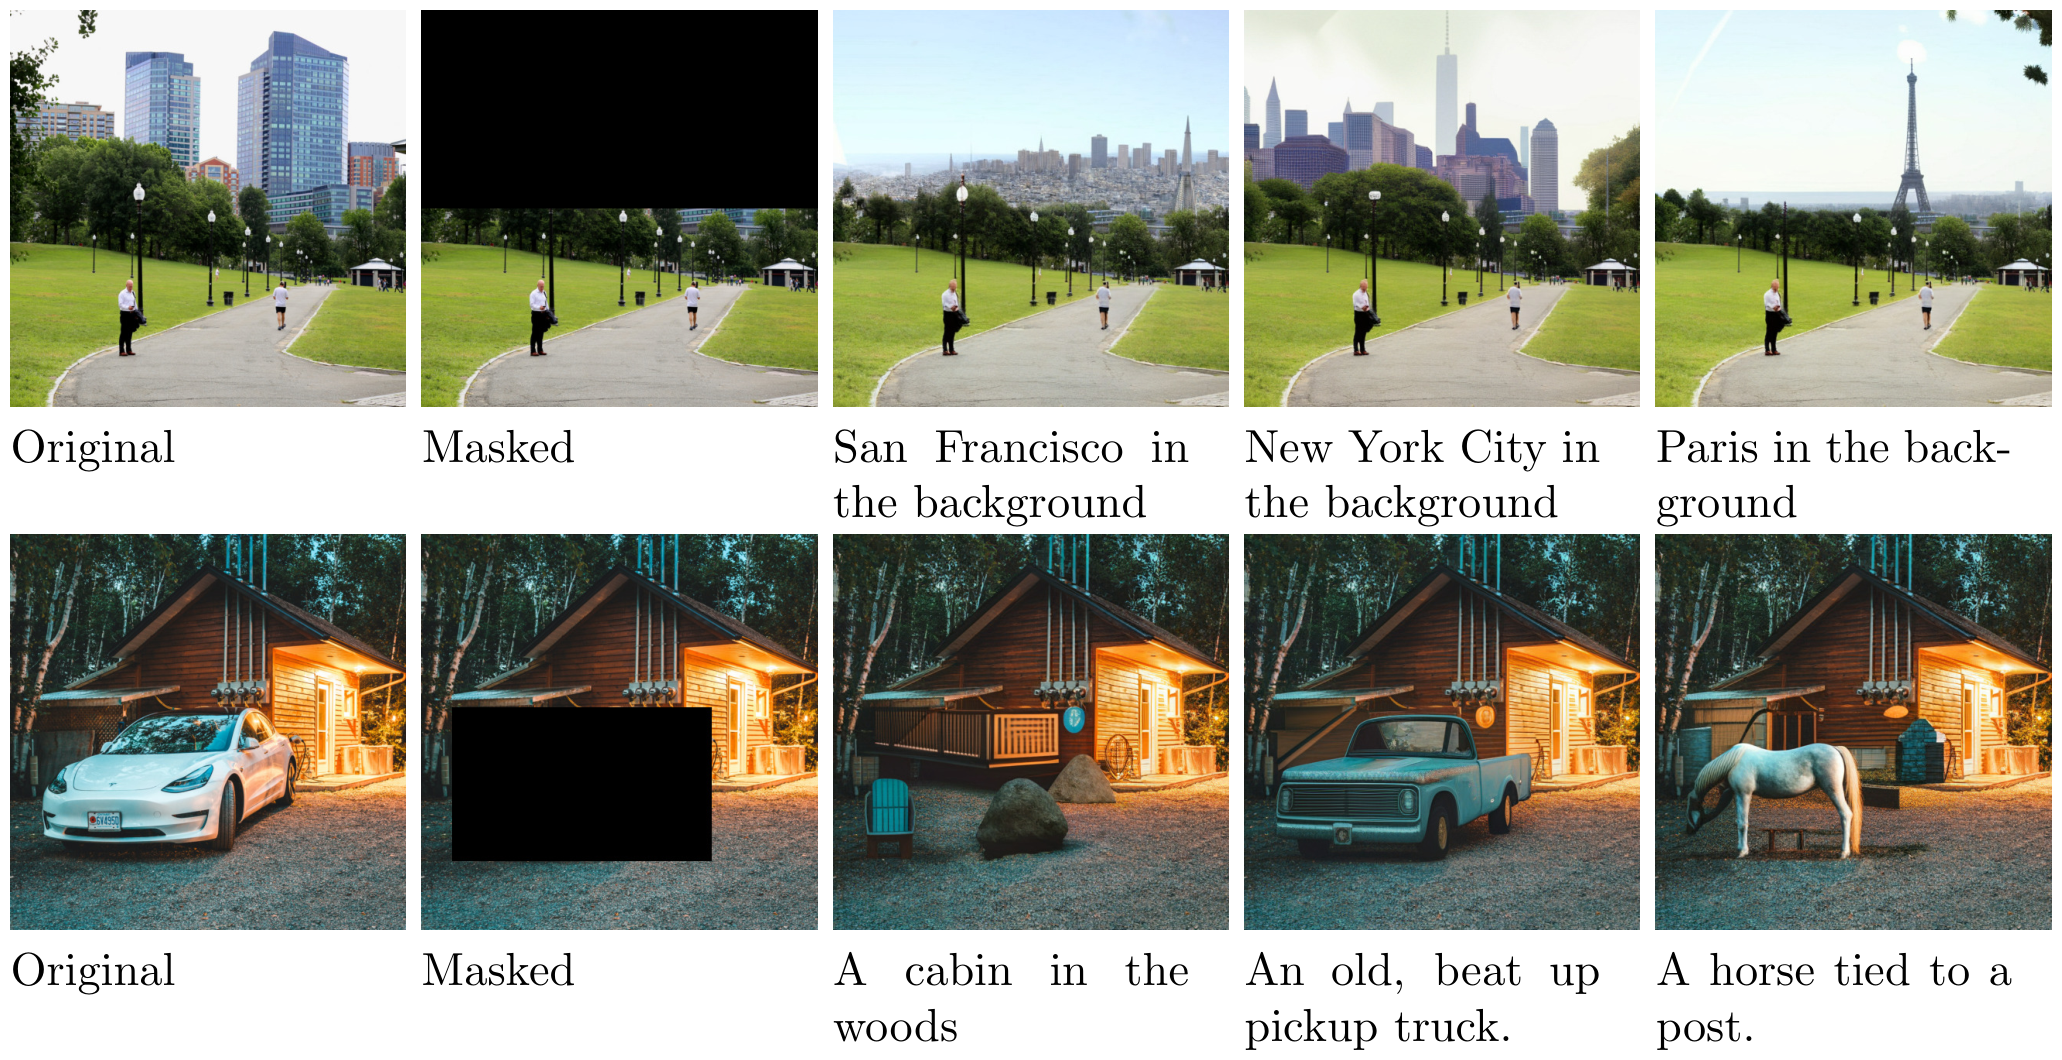
图10第二列展示用户指定的掩码。对于512输入,先同时得到高、低分辨率token,在两级空间标记相应区域;先补全低分辨率结构,再以其为条件补全高分辨率细节。扩图则把原有图像外的token设为待预测区域。
token级不修改某个位置,并不保证输出像素完全不变。视觉量化与卷积解码可能引入重建误差和边界影响。若产品要求未编辑区域逐像素保持,应额外设计像素合成或保护机制,不能把掩码训练目标自动等价成这样的保证。
无掩码编辑首先把真实输入编码为视觉token,然后每轮随机选择8%的位置重新预测,执行100轮,guidance参数为4,并将Top-k限制为3以减少偏离原图。最后对基础模型的编辑结果执行超分。
"无掩码"指不要求用户画出目标区域;算法内部仍然持续掩码和重采样。 这与普通生成中已接受token持续固定的过程不同:编辑通过不断重采样局部位置,使图像逐渐向新文字条件移动。论文将其类比为Gibbs采样,但没有证明所有学习到的条件分布都精确对应同一个联合分布,或该过程已收敛到严格目标分布。
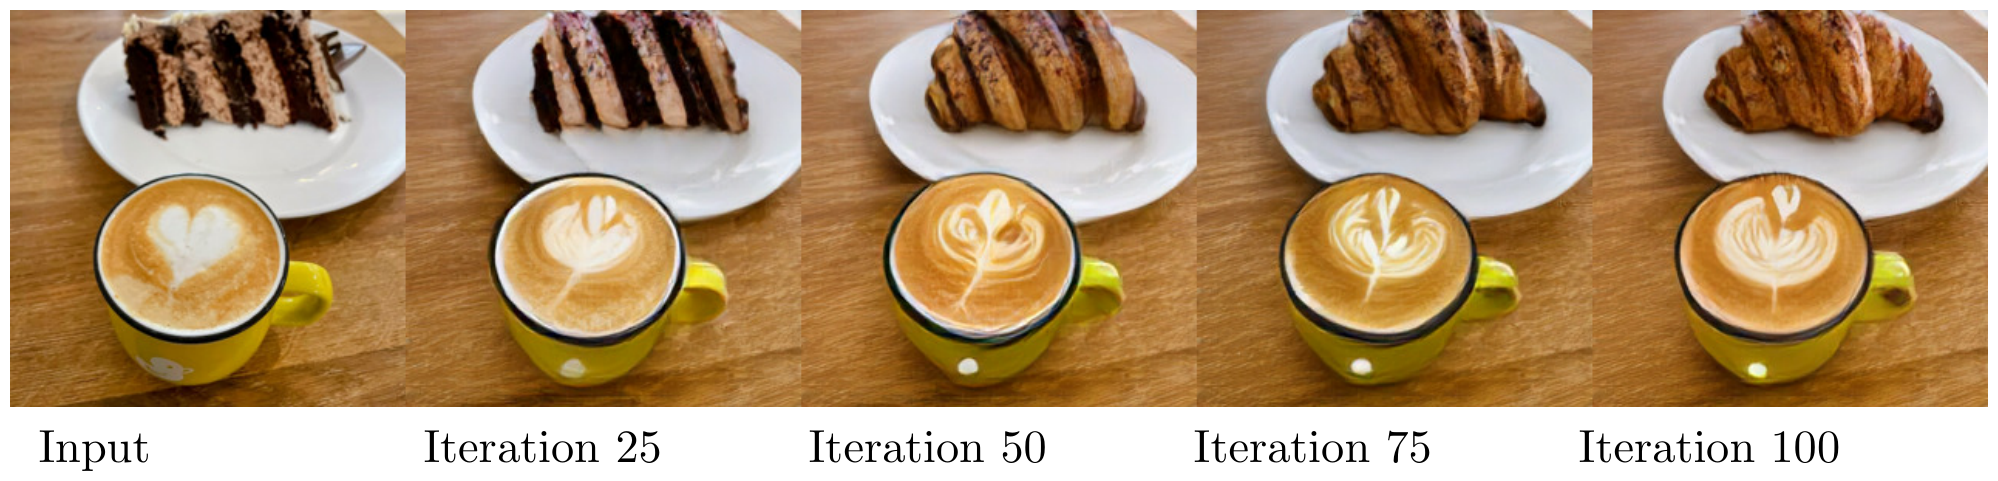
图12展示输入及25、50、75、100轮的变化。某个中间结果可能更符合用户对"适度修改"的要求。编辑越久并不必然越好,100轮编辑的速度也不能沿用24轮基础生成的宣传数字。
它带来的产品启发是:编辑强度、局部保留、迭代次数与提示遵循应成为可以联合控制的变量。比起只给用户一个最终结果,展示可撤回的中间状态,往往更接近实际创作流程。
13. Muse的长期价值:用统一补全接口连接生成、速度与编辑
Muse证明,视觉token的掩码建模可以同时服务三个方向:通过并行预测减少串行生成步骤,通过冻结语言表示改善文本条件,通过任意子集条件化支持多种编辑操作。这三者共享同一训练机制,因此形成了一套有内在联系的方法。
它的限制也来自同一机制:并行未知位置之间仍有依赖,离散表示仍有损失,置信度高并不必然语义正确。计数、长文字和多对象关系的失败提醒我们,视觉上合理与精确遵循条件并不是同一个目标。
对研究者,下一步值得拆开的变量包括mask调度、语言表示、tokenizer质量和解码器容量。对工程师,需要测量所有子模型及候选筛选的真实成本。对产品团队,需要用原图保持、修改准确率和用户选择偏好评价编辑,而不是只把生成FID搬到编辑任务上。
Rocky的判断是:Muse最有复用价值的思想,是让模型学习一个可操作的条件补全接口,再围绕它设计生成与编辑流程。 速度提升来自决策顺序的改变,实际价值则取决于这种改变能否在完整系统里兑现为更低成本、更强控制和更稳定的输出。
推荐阅读
1. 深入浅出完整解析AI Agent(AI智能体)的核心基础知识
2025年可以说是AI Agent全面落地应用的元年,因此Rocky在持续撰写对AI Agent的全维度解析文章:
深入浅出完整解析AI Agent(AI智能体)的核心基础知识
2. 深入浅出完整解析扩散模型DDPM、DDIM、Score-Based、SDE、LDM、Classifier/Classifier-Free Guidance、Rectified Flow核心基础知识
Rocky对扩散模型的本质原理与和核心基础知识进行了全面系统的深入浅出分析讲解,同时不断跟进补充扩散模型的最新技术发展,希望能给大家带来帮助:
深入浅出完整解析扩散模型DDPM、DDIM、Score-Based、SDE、LDM、Classifier/Classifier-Free Guidance、Rectified Flow核心基础知识
3. 入浅出完整解析FLUX.2、Seedream(即梦)、Z-image、GLM-Image核心基础知识
Rocky对AIGC时代"中场时刻"之后的主流AIGC创作大模型的核心基础知识进行了全面系统的深入浅出分析讲解,力求让大家通俗易懂理解AIGC时代的技术浪潮的本质价值:
入浅出完整解析FLUX.2、Seedream(即梦)、Z-image、GLM-Image核心基础知识
4. 深入浅出完整解析FLUX.1 Kontext和FLUX.1 Krea核心基础知识
Rocky对FLUX.1 Kontext和FLUX.1 Krea的核心基础知识作了全面系统的梳理与解析:
深入浅出完整解析FLUX.1 Kontext和FLUX.1 Krea核心基础知识
5. 深入浅出完整解析DeepSeek系列核心基础知识
Rocky对DeepSeek系列模型的核心基础知识作了全面系统的梳理与解析:
6. 深入浅出完整解析Stable Diffusion 3(SD 3)和FLUX.1系列核心基础知识
Rocky对Stable Diffusion 3和FLUX.1的核心基础知识作了全面系统的梳理与解析:
深入浅出完整解析Stable Diffusion 3(SD 3)和FLUX.1系列核心基础知识
7. 深入浅出完整解析Stable Diffusion XL(SDXL)核心基础知识
Rocky对Stable Diffusion XL的核心基础知识作了全面系统的梳理与解析:
深入浅出完整解析Stable Diffusion XL(SDXL)核心基础知识
8. 深入浅出完整解析Stable Diffusion(SD)核心基础知识
Rocky对Stable Diffusion 1.x-2.x系列模型的核心基础知识做了全面系统的梳理与解析:
深入浅出完整解析Stable Diffusion(SD)核心基础知识
9. 深入浅出完整解析Stable Diffusion中U-Net的前世今生与核心知识
Rocky对Stable Diffusion中最为关键的U-Net结构进行了深入浅出的全面解析,包括其在传统深度学习中的价值和在AIGC中的价值:
深入浅出完整解析Stable Diffusion中U-Net的前世今生与核心知识
10. 深入浅出完整解析LoRA(Low-Rank Adaptation)模型核心基础知识
对于AIGC时代中的"ResNet"------LoRA模型,Rocky进行了深入浅出的全面讲解:
深入浅出完整解析LoRA(Low-Rank Adaptation)模型核心基础知识
11. 深入浅出完整解析ControlNet核心基础知识
AIGC图像创作开源社区已经形成以Stable Difffusion/FLUX为核心,ConrtolNet和LoRA作为首要AI辅助工具的变化万千的AIGC图像创作工作流。
ControlNet正是让AI图像创作社区无比繁荣的关键一环,它让AIGC图像创作过程更加的可控,更有助于广泛地将AIGC算法解决方案应用到各行各业中:
12. 深入浅出完整解析Sora、Seedance、keling等AI视频大模型核心基础知识
AI绘画和AI视频是两个互相促进、相互交融的领域,2024年无疑是AI视频领域的爆发之年,Rocky对AI视频领域核心的Sora、Seedance、Keling等大模型进行了全面系统的梳理与解析:
深入浅出完整解析Sora、Seedance、keling等AI视频大模型核心基础知识
13. 深入浅出完整解析AIGC时代Transformer核心基础知识
在AIGC时代中,Transformer为AI行业带来了深刻的变革。Transformer架构正在一步一步重构所有的AI技术方向,成为AI技术架构大一统与多模态整合的关键核心基座,大有一统"AI江湖"之势。Rocky也对Transformer模型进行持续的深入浅出梳理与解析:
深入浅出完整解析AIGC时代Transformer核心基础知识
14. 深入浅出完整解析ComfyUI、Diffusers、Stable Diffusion WebUI等主流AIGC创作框架核心基础知识
AIGC创作框架正是AIGC算法工作流的运行载体,目前主流的AIGC创作框架有ComfyUI、Diffusers、Stable Diffusion WebUI等 。在传统深度学习时代,PyTorch、TensorFlow以及Caffe是传统深度学习模型的基础运行框架,到了AIGC时代,Rocky相信ComfyUI就是AIGC时代的"PyTorch"、Stable Diffusion WebUI就是AIGC时代的"TensorFlow"、Diffusers就是AIGC时代的"Caffe":
深入浅出完整解析ComfyUI、Diffusers、Stable Diffusion WebUI等主流AIGC创作框架核心基础知识
15. 深入浅出完整解析ComfyUI、Diffusers、Stable Diffusion WebUI等主流AIGC创作框架核心基础知识
在AIGC时代中,如何快速转身,入局AIGC产业?如何成为AIGC/LLM/AI Agent算法/开发工程师?如何在学校中系统性学习AIGC/LLM/AI Agent知识,斩获心仪的AIGC/LLM/AI Agent算法/开发offer?
Don't worry,Rocky为大家总结整理了全面的AIGC/LLM/AI Agent算法/开发工程师成长秘籍,为大家答疑解惑,希望能给大家带来帮助:
手把手教你成为AIGC/LLM/AI Agent算法/开发工程师,斩获AIGC/LLM/AI Agent算法/开发offer!
16. AIGC产业的深度思考与分析
2023年3月21日,微软创始人比尔·盖茨在其博客文章《The Age of AI has begun》中表示,自从1980年首次看到图形用户界面(graphical user interface)以来,以OpenAI为代表的科技公司发布的AIGC模型是他所见过的最具革命性的技术进步。
Rocky也认为,AIGC及其生态,会成为AI行业重大变革的主导力量。AIGC会带来一个全新的红利期,未来随着AIGC的全面落地和深度商用,会深刻改变我们的工作、生活、学习以及交流方式,各行各业都将被重新定义,过程会非常有趣。
那么,在此基础上,我们该如何更好的审视AIGC的未来?我们该如何更好地拥抱AIGC引领的革新?Rocky准备从技术、产品、商业模式、长期主义等维度持续分享一些个人的核心思考与观点,希望能帮助各位读者对AIGC有一个全面的了解:
深入浅出全面解析AIGC时代核心价值与发展趋势(2025年版)
17. AI算法工程师的独孤九剑秘籍
为了方便大家实习、校招以及社招的面试准备,同时帮助大家提升扩展技术基本面,Rocky将符合大厂和AI独角兽价值的算法高频面试知识点撰写总结成《三年面试五年模拟》之独孤九剑秘籍:
【三年面试五年模拟】AIGC时代的算法工程师的求职面试秘籍(持续更新中)
18. 深入浅出完整解析AIGC时代中GAN(Generative Adversarial Network)系列模型核心基础知识
GAN系列模型作为传统深度学习时代的最热门生成式Al模型,在AIGC时代继续繁荣,作为Stable Diffusion/FLUX系列大模型的"得力助手",广泛活跃于AlGC图像创作的产品与工作流中:
深入浅出完整解析AIGC时代中GAN(Generative Adversarial Network)系列模型核心基础知识