【数据结构】堆
概览
- 二叉树的顺序存储与下标关系
- 完全二叉树与父子大小
- 向下调整算法
- 从最后一个非叶子结点开始建堆
- 建堆为什么是 O(N)
- 向上调整与插入、删除堆顶
- 堆排序
- TOP-K问题
核心知识
一、二叉树的顺序存储
二叉树的存法有两种:链式结构给每个结点配左右两个指针,再奇怪的形状都能存下来;顺序结构把结点按层序放进数组,父子关系靠下标算出来,省掉了指针,代价是只适合完全二叉树。
下标的对应关系是固定的:下标 i 的左孩子是 2i + 1,右孩子是 2i + 2,父结点是 (i - 1) / 2,这里的除法是整数除法。下标 0 那个结点就是根,它没有父结点。这几个式子需要记熟,后面所有堆的代码都建立在这几个式子上。
这三个式子的来历可以自己推一遍:完全二叉树里第 k 层(根算第 0 层)的第一个结点下标是 2 的 k 次方减一,因为前 k 层一共 2 的 k 次方减一个结点。第 k 层的第 j 个结点(j 从 0 数起)下标是 2^k - 1 + j,它的左孩子是下一层的第 2j 个结点,下标是 2^(k+1) - 1 + 2j,把 i = 2^k - 1 + j 代进去正好等于 2i + 1,右孩子比它多一,就是 2i + 2。父结点反过来解这个方程,(i - 1) / 2 向下取整。
用数组还有一层性能上的好处:所有结点挨着放,向下调整走的是一条从根到叶的路径,访问的下标是 2i+1、2i+2 这样的位置,跳的幅度越来越大,但每次跳过的都是连续内存。换成链式结构,每往下一层都要跟着一个指针跳到堆上另一块内存去,缓存命中率会差不少。堆这种几乎不做随机访问的结构,用数组来存比链式结构更合适。
普通二叉树用数组存会浪费空间:只有右孩子的链状二叉树,节点分布在第 0、2、6、14 这些下标上,中间大片位置空着,一棵一千个结点的树可能要开上百万个位置。完全二叉树没有这个问题,结点按层从左到右挨着排,数组里一个空位都不会有。
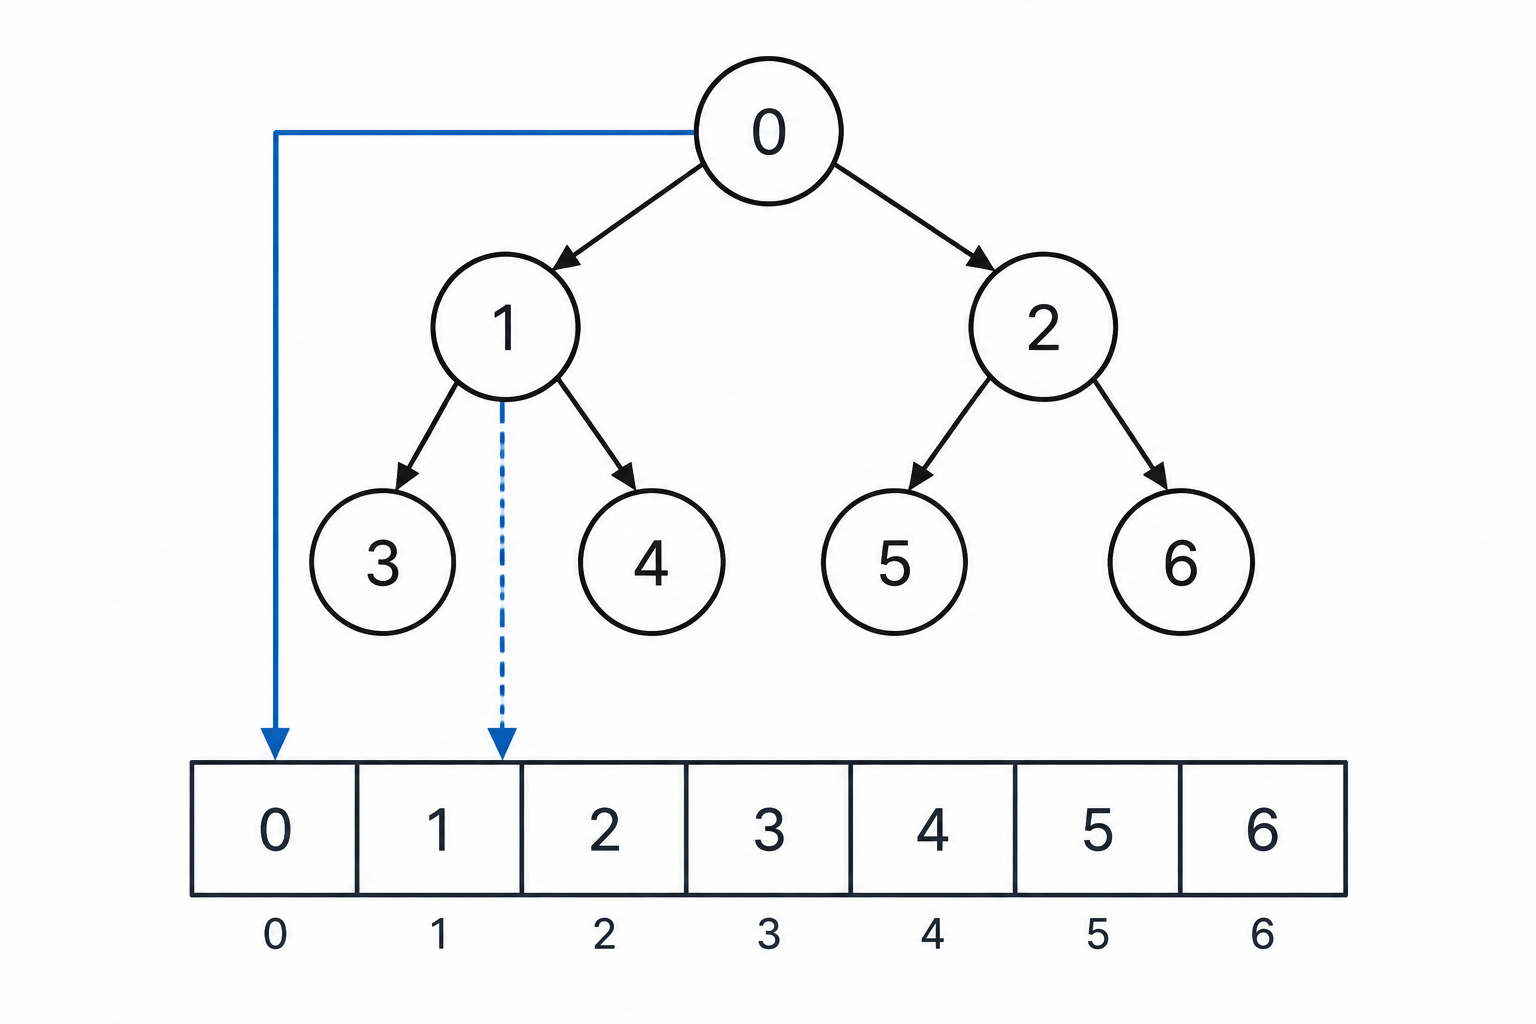
图 1 完全二叉树的数组存储与下标关系
二、堆是什么
堆是一棵完全二叉树,并且满足一条额外的大小关系:任意一个结点的值都不大于它的两个孩子(这叫小堆),或者都不小于它的两个孩子(这叫大堆)。这两条性质缺一不可,形状上必须是完全二叉树,数值上必须处处满足父子关系。
小堆的根是整棵树里最小的元素,大堆的根是最大的,堆顶因此永远是极值,取它的代价只有 O(1)。堆里其他位置的顺序没有约定,兄弟之间谁大谁小都可以,只要父结点和两个孩子之间的大小关系成立。
| 叫法 | 别称 | 根结点 | 父子关系 |
|---|---|---|---|
| 小堆 | 小根堆、最小堆 | 最小值 | 父结点不大于任一孩子 |
| 大堆 | 大根堆、最大堆 | 最大值 | 父结点不小于任一孩子 |
判断一个序列是不是堆,就是逐个检查这几个父子关系。拿 100、60、70、50、32、65 试一下:
| 父结点 | 下标 | 两个孩子 | 是否满足父结点不小于孩子 |
|---|---|---|---|
| 100 | 0 | 60、70 | 满足 |
| 60 | 1 | 50、32 | 满足 |
| 70 | 2 | 65 | 满足 |
三个父结点都满足条件,所以这是一个大堆。换成 60、70、65、50、32、100 就不行了:下标 0 的孩子是 70 和 65,都大于 60,第一条检查就破。检查堆的时候只看父子关系,兄弟之间、堂兄弟之间的大小不参与判断。
这里的堆和操作系统里的堆是两个不同的概念。操作系统讲内存管理时说的堆,是进程地址空间里由 malloc 管理的那一段区域;数据结构里的堆是一种树形结构,两者只是共用了一个名字。
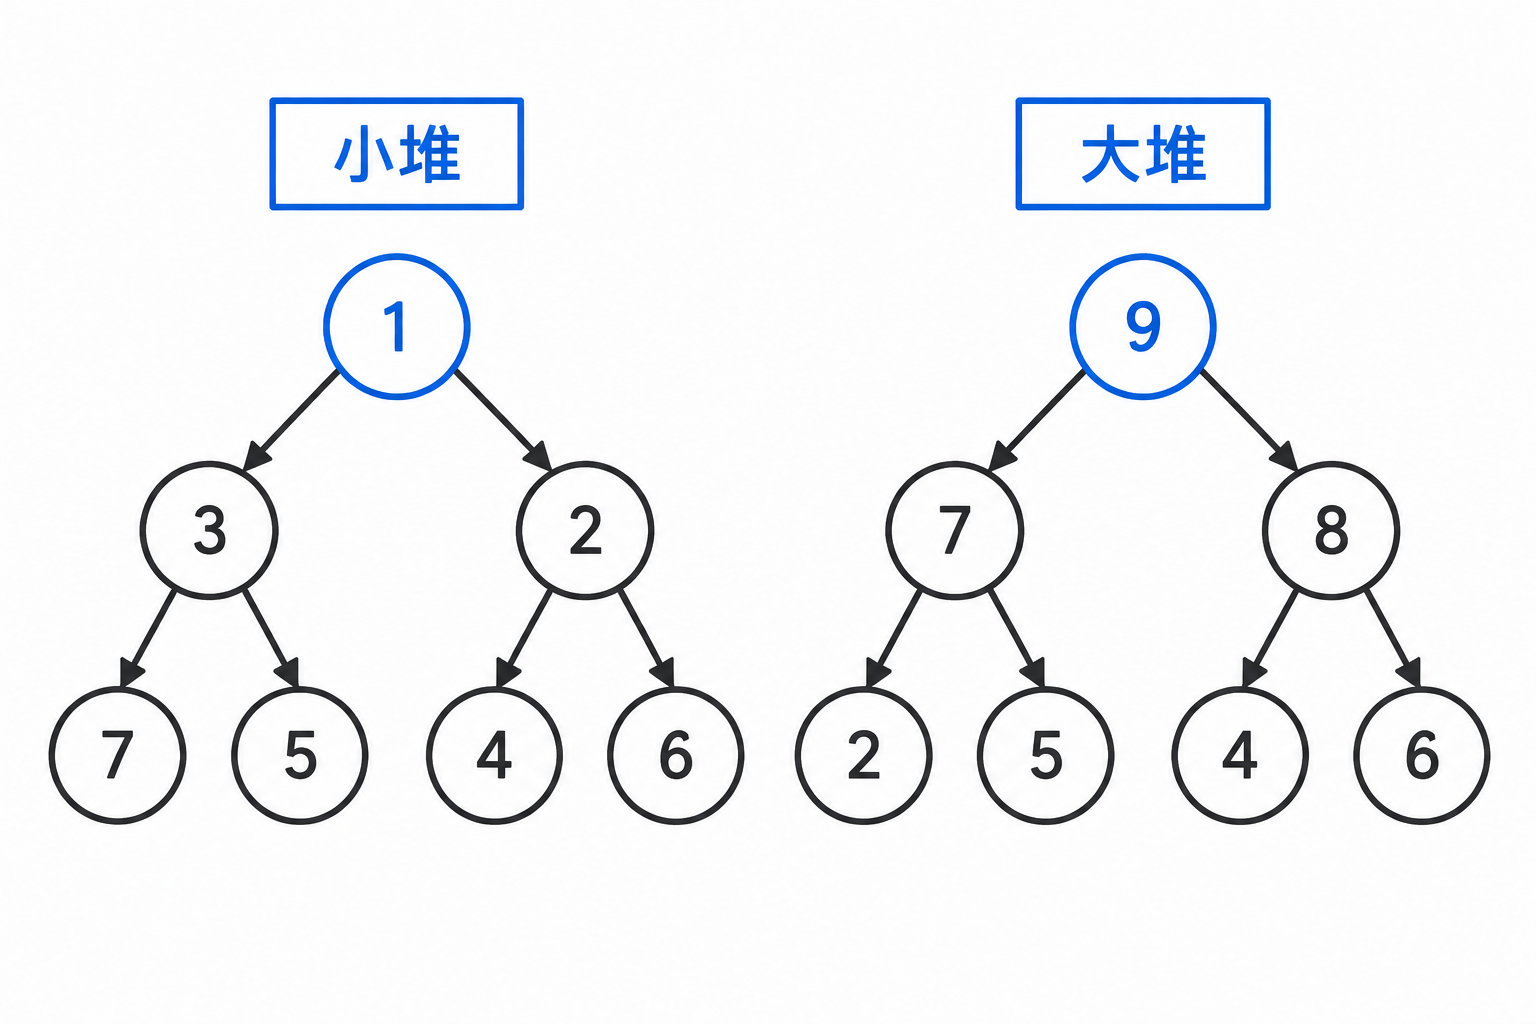
图 2 大堆与小堆
三、向下调整算法
向下调整是堆里所有操作的基础,它解决的问题是:某个结点的左右子树都已经满足堆的性质,只有这个结点自己可能不对,把它放到合适的位置上去。
做法是让这个结点和它两个孩子里较小的那个比。如果是小堆,孩子比它小就交换,交换之后它落到孩子的位置上,继续和新的两个孩子比;直到它比两个孩子都小,或者已经落到叶子结点。整个过程沿着一条从根到叶的路径走,长度是树的高度,所以是 O(log N)。
这个函数的代码是怎么写出来的,概念清楚之后,落到代码上还有四个问题要解决:拿谁和谁比、比完怎么往下走、什么时候停、用什么结构写。按这四步依次定下来,整段代码也就写出来了。
第一步是拿谁和谁比:父结点的下标是 parent,两个孩子是 2 * parent + 1 和 2 * parent + 2。这里先要判断右孩子是否存在,因为最后一个非叶子结点可能只有一个左孩子,直接访问 2 * parent + 2 就跑到数组外面去了。判断写完,再从两个孩子里挑出更小的那个,用 child 记住它的下标。
比完怎么往下走,是第二步要定的事:如果父结点比 child 大,就把这两个位置交换。交换之后原来的父结点跑到了 child 的位置上,它还要继续和新的两个孩子比,所以要把 parent 挪到刚才 child 的位置,再重新算出新的孩子下标。这一步是整段代码里最容易写错的地方,下面单独说。
什么时候停,同样有两种情况:孩子已经不存在了(child >= n,说明已经落到叶子),或者父结点不比孩子大(已经就位)。第一种情况用循环条件挡住,第二种用 break 跳出。
用什么结构写,是最后一步:循环的次数事先不知道,要一路探到底,所以 while 最自然。写成递归也行,但每层递归要压一次栈,而向下调整的路径本来就不长,用循环可以把这部分开销省掉。
第一次尝试:只写一次比较,不写循环,这是最容易想到的写法,把上面第一步和第二步各写一遍就结束了:
c
/* 第一版:只下沉一层 */
if (child + 1 < n && a[child + 1] < a[child])
{
	child++;
}
if (a[child] < a[parent])
{
	Swap(&a[child], &a[parent]);
}
这版代码编译能过,拿两层的树试也看不出问题,因为两层树的根底下只有一层孩子。实际的堆往往不止两层,父结点换下去之后还要继续往下走,比如文章前面那张推演表里的 27,从下标 0 一路换到了下标 8,中间走了三步。只做一次比较的话,它换到下标 1 就停住了,那里仍然是 27 大于它的两个孩子,堆的性质并没有恢复。实测中出现的现象是:建堆之后堆顶看着是对的,随机取几个下标检查父子关系却会发现不对。
第二次尝试:循环写上了,但交换之后忘了挪 parent,这是认识到需要循环之后最容易写成的样子:
c
/* 第二版:循环写上了,但交换之后没有更新 parent */
int child = parent * 2 + 1;
while (child < n)
{
	if (child + 1 < n && a[child + 1] < a[child])
	{
		child++;
	}
	if (a[child] < a[parent])
	{
		Swap(&a[child], &a[parent]);
		child = child * 2 + 1;   /* 少了 parent = child */
	}
	else
	{
		break;
	}
}
这版的问题在于 parent 一直停在下标 0 上。交换一次之后,aparent 里装的是刚被换下去的那个大值,后面每一轮都拿它去和新的孩子比,比出来的结论自然是错的。跑出来的结果和只比较一次的版本一样:15 27 19 18 28 34 65 49 25 37,判定「不是堆」。改法就是把落点补上,两句写在一起:
c
	parent = child;              /* 落到孩子的位置上 */
	child = parent * 2 + 1;      /* 从新的位置算左孩子 */
一个看起来像错、实际没错的写法 :有人会把上面两句写成先更新 child、再算 child = parent * 2 + 1,或者干脆写成 child = child * 2 + 1,担心 child 之前因为「右孩子更小」被加过一,算出来的位置会偏。这个担心并不成立:parent = child 先执行之后,parent 指的就是刚刚落下去的那个结点,与它原来是左孩子还是右孩子无关;再从它算左孩子,两种写法结果完全相同。这一点用对照版单独试过,建出来的堆和从 parent 算的版本一模一样(15 18 19 25 28 34 65 49 27 37)。真正会出错的是漏掉 parent 的更新,而不是用谁来算孩子。
第三次尝试:终止条件只写了一半,把 while (child < n) 写成 while (1),指望循环里的 break 兜底。这样写下去,如果父结点一直比孩子大,最后 parent 落到叶子,child 算出来是 n 甚至更大,再去读 achild 就是越界。循环条件里带上 child < n,等于在每轮开头先挡一道,比事后补判断稳妥。
第四次尝试:比较符号写反,挑孩子的时候写成 achild + 1 > achild,或者和父结点比较时写成 achild > aparent,都会建出方向相反的堆。这两处符号一改就是大堆,改完方向之后两种堆都要各跑一遍,不能只试其中一种。
四次尝试揉在一起,就是最终的样子:
c
# 文件:/home/cocatrice/ds10/heap.c
static void AdjustDown(HPDataType* a, int n, int parent)
{
	int child = parent * 2 + 1;          /* 先假设只有左孩子 */
	while (child < n)                    /* 孩子没有了就到叶子了,停 */
	{
		if (child + 1 < n && a[child + 1] < a[child])
		{
			child++;                     /* 右孩子存在且更小,换成右孩子 */
		}
		if (a[child] < a[parent])        /* 父结点比孩子大,往下换 */
		{
			Swap(&a[child], &a[parent]);
			parent = child;              /* 落到孩子的位置上 */
			child = parent * 2 + 1;      /* 从新的位置重新算左孩子 */
		}
		else
		{
			break;                       /* 不比孩子大,已经就位 */
		}
	}
}
十行代码里有四处判断,每一处都对应上面的一次尝试:循环条件挡住叶子、右孩子判断挡住越界、交换那行决定方向、赋值那两行决定能不能继续往下走。这几处只要改坏一处,程序都不会报错,只会在某些数据上悄悄给出错误的堆。
递归写法:同一个算法也能写成递归,处理完当前结点之后,把落下去的那个位置再交给下一层。
c
static void AdjustDownRecur(HPDataType* a, int n, int parent)
{
	int child = parent * 2 + 1;
	if (child >= n)
	{
		return;
	}
	if (child + 1 < n && a[child + 1] < a[child])
	{
		child++;
	}
	if (a[child] < a[parent])
	{
		Swap(&a[child], &a[parent]);
		AdjustDownRecur(a, n, child);
	}
}
递归版的代码读起来更接近数学上的定义,代价是每下沉一层就压一次栈。堆的路径长度是 O(log N),一万个元素的堆也不过压十几层,两种写法在这个规模上看不出差别;元素涨到几百万时,循环版省下的函数调用开销才会体现出来。调试上还有一个区别:递归版在 gdb 里用 bt 能看到完整的下沉路径,循环版只能一行行 next,初学阶段用递归版对着调试更容易看清算法在做什么。
有两个地方容易写错:一是比较之前要判断右孩子是否存在,否则读的是数组外面的一块内存,valgrind 会直接报越界读;二是每次要挑较小的那个孩子换,挑错了会让那个较大的孩子仍然小于它,堆的性质还是破的。
拿文章后面实验里那组数据走一遍最直观。数组是 27、15、19、18、28、34、65、49、25、37,现在对下标 0 做一次向下调整:
| 步 | 当前结点 | 两个孩子 | 较小的孩子 | 动作 | 数组变成 |
|---|---|---|---|---|---|
| 1 | 下标 0,值 27 | 15、19 | 15 | 27 比 15 大,交换 | 15 27 19 18 28 34 65 49 25 37 |
| 2 | 下标 1,值 27 | 18、28 | 18 | 27 比 18 大,交换 | 15 18 19 27 28 34 65 49 25 37 |
| 3 | 下标 3,值 27 | 49、25 | 25 | 27 比 25 大,交换 | 15 18 19 25 28 34 65 49 27 37 |
| 4 | 下标 8,值 27 | 没有孩子 | 无 | 到叶子,结束 | 不变 |
四步走完,数组变成 15、18、19、25、28、34、65、49、27、37,正是功能测试里插入那十个数之后打印出来的顺序。27 这个元素从根一路换到了下标 8,路径长度是三,小于树高。
向下调整有一个前提:左右子树本身已经是堆。这个前提决定了建堆时不能从根开始往下调,也决定了后面几个操作的顺序。
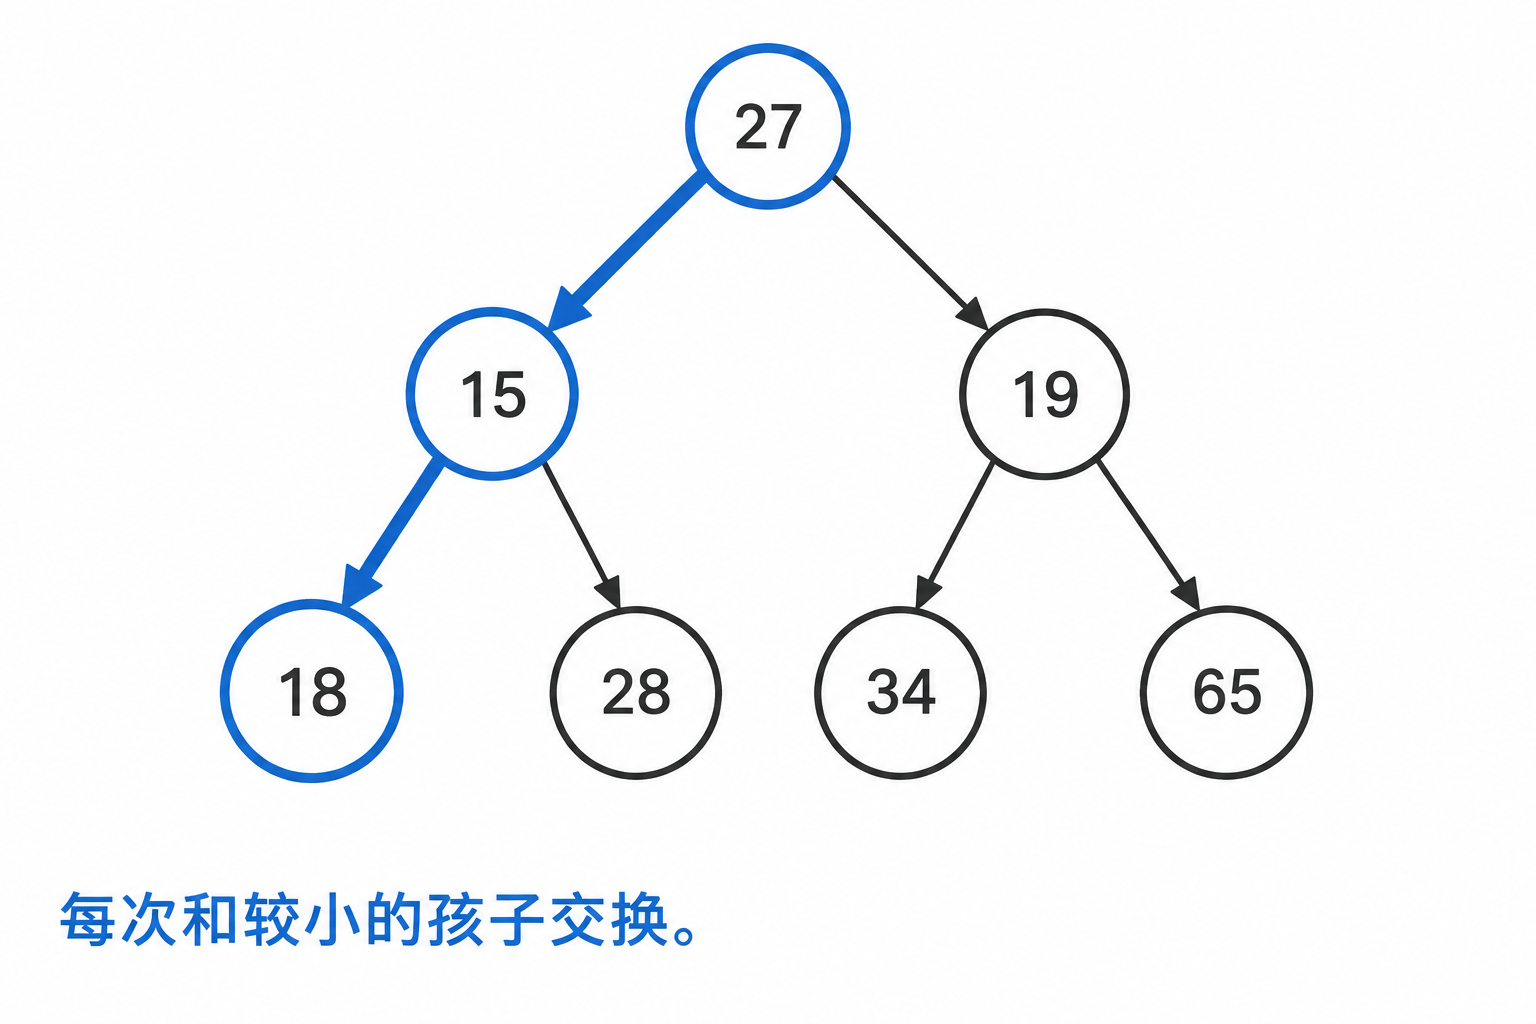
图 3 向下调整的路径
四、建堆
把一个杂乱的数组整理成堆,依据的是向下调整的前提:左右子树已经是堆。叶子结点没有孩子,天然满足这个条件,因此建堆从最后一个非叶子结点开始往前逐个调整;轮到某个结点时,它的两棵子树都已经整理完毕。
最后一个非叶子结点的下标是 n / 2 - 1,这个式子可以自己推一遍:最后一个结点是 n - 1,它的父结点 ((n - 1) - 1) / 2 就是最后一个有孩子的结点。循环因此写成:
c
# 文件:/home/cocatrice/ds10/heap.c
for (i = n / 2 - 1; i >= 0; i--)
{
	AdjustDown(hp->a, hp->size, i);
}循环怎么写出来的:这个循环只有三行,可是三行里每一处都能写错,下面挨个说明。
最先想到的是从根开始调,因为直觉上「整理一棵树」应该从根往下走。这一版错得比较隐蔽,代码能跑,很多数据上还能得到看着像样的结果,但前提被破坏了:向下调整要求左右子树已经是堆,根的两个子树当时还是乱的,调完根只是把最小的那个数换到顶上,下面的问题一个都没解决。用实验里那组 1、9、2、8、7、3、4 一试就暴露出来,调完根什么都没变,而下标 1 那棵子树里 9 比它的两个孩子都大。
把起点改成最后一个非叶子结点之后,下标又容易算错成 n / 2。这样会多调整一个结点:下标 n/2 在完全二叉树里是叶子,叶子没有孩子,向下调整进去走一圈就退出来,不报错,也不影响正确性,只是多做了一次无效的调整。要是下标再往前错得多一点,比如漏掉了最后一个非叶子结点,那才会真正出错,那棵子树没有被整理,如果它的孩子比它小,整个数组就不是堆。三种起点的区别写出来是这样的:
| 起点 | 结果 | 说明 |
|---|---|---|
| i = 0(只有根) | 错 | 左右子树还没整理,前提不成立 |
| i = n / 2 | 多跑一个叶子 | 不算错,但这个结点没有孩子,白调 |
| i = n / 2 - 1 | 正确 | 最后一个真正有孩子的结点 |
循环变量本身还有一处易错的地方:写成 size_t i 的话,循环条件 i >= 0 永远成立(无符号数不会小于零),i-- 到 0 之后会绕回到一个极大的值,程序直接卡死或者越界崩溃。这类死循环看起来莫名其妙,原因出在类型上:
c
/* 错误写法:i 是无符号,i >= 0 恒真 */
for (size_t i = n / 2 - 1; i >= 0; i--)

/* 正确写法:下标用有符号的 int */
for (int i = n / 2 - 1; i >= 0; i--)
最后一处易错点在循环里的范围参数上:AdjustDown 的第二个参数是「堆里当前有多少个元素」,传 hp->size,不要传 hp->capacity。容量是数组申请了多大,随着扩容会比实际元素个数大,传进去等于让调整跑到没数据的格子里去。
四处都对齐之后,循环就是最终的样子:
c
# 文件:/home/cocatrice/ds10/heap.c
for (i = n / 2 - 1; i >= 0; i--)    /* 从最后一个非叶子结点往前 */
{
	AdjustDown(hp->a, hp->size, i); /* 范围是元素个数,不是容量 */
}
倒着走是这段代码的关键:从后往前处理到下标 i 时,它的两个孩子下标一定比 i 大,早就处理完了,「左右子树已经是堆」这个前提因此天然成立。反过来从前往后走,孩子还没有被整理,每一层都得重复处理,复杂度也就退回去了。
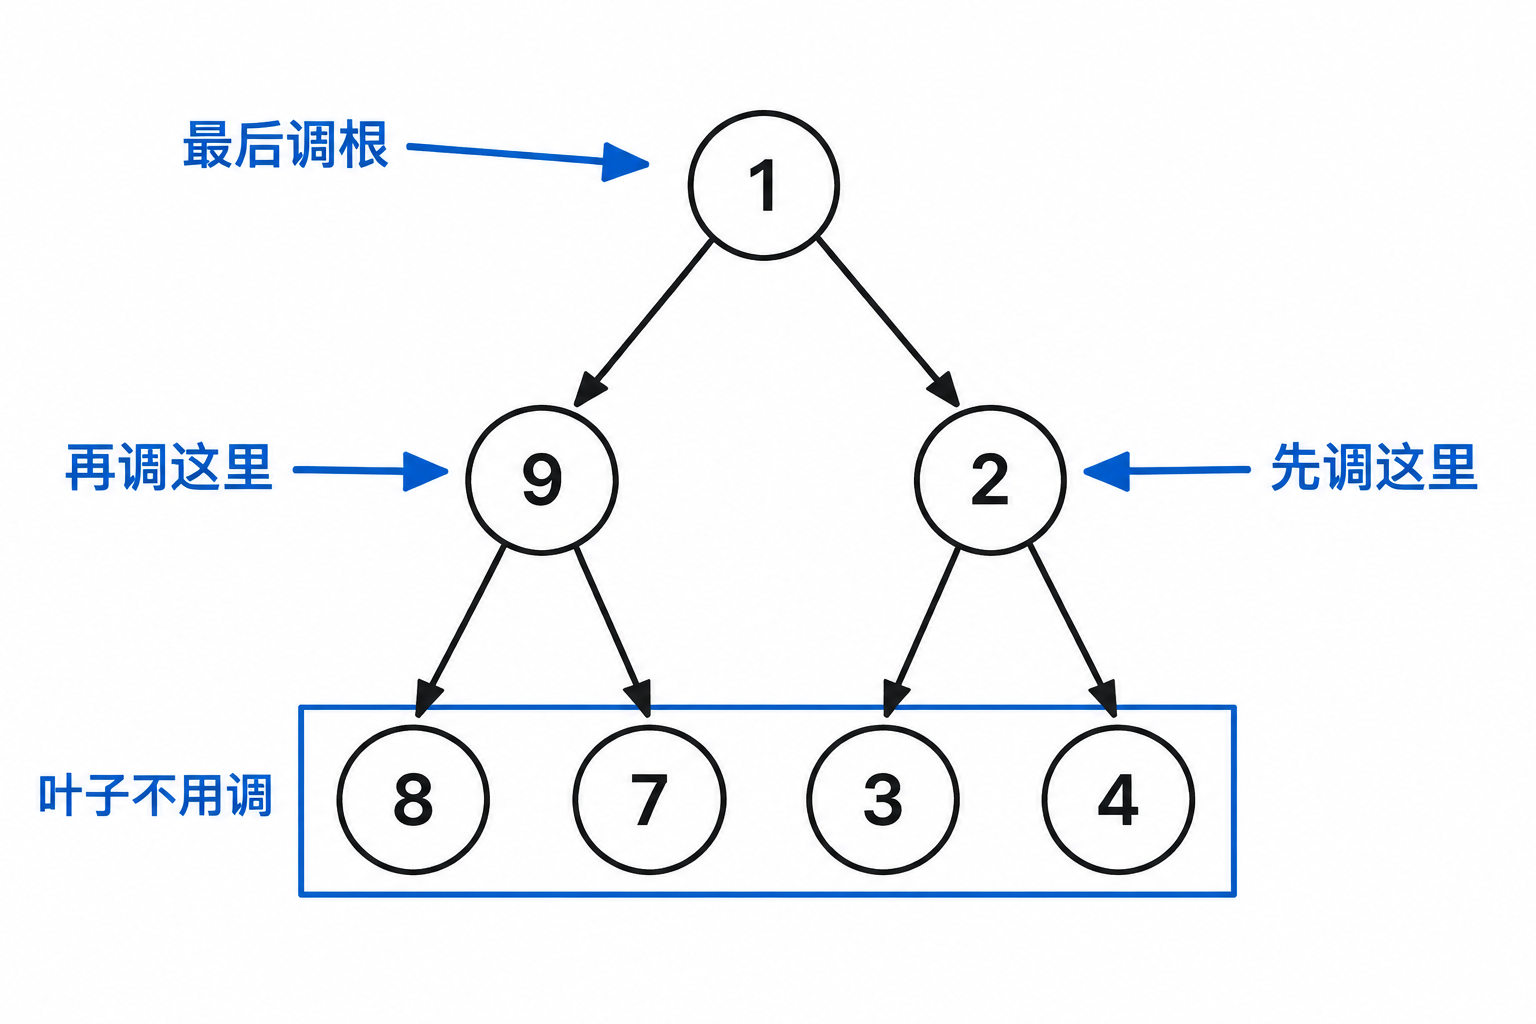
图 4 建堆的调整顺序
五、建堆为什么是 O(N)
常见的估计是 N 个结点、每个往下调最多走 log N 层,于是得到 O(N log N)。这个估计过粗,实际算下来是 O(N)。
原因在不同高度的结点数量差别很大:完全二叉树里越靠下的结点越多,最后一层大约占一半,倒数第二层占四分之一;而往下调整的代价跟结点的高度成正比,叶子结点一次都不用调,倒数第二层的结点最多走一层。把两项乘起来再求和:
| 结点所在层 | 结点个数 | 每个最多下调层数 | 这一层的总代价 |
|---|---|---|---|
| 最后一层(叶子) | n/2 | 0 | 0 |
| 倒数第二层 | n/4 | 1 | n/4 |
| 倒数第三层 | n/8 | 2 | n/4 |
| 再往上一层 | n/16 | 3 | 3n/16 |
| 一直往上 | ...... | ...... | ...... |
把每一列的乘积加起来是 n/4 + n/4 + 3n/16 + ...,这个级数收敛到 n 的量级,建堆因此是 O(N)。越靠下的结点越多,而它们几乎不需要调整,正是这一点把 log N 这个因子抵消掉了。
另一种常见的说法是「向下调整是 log N,所以建堆是 N log N」,它错在把每个结点都当成了要走满整棵树的高度。真正走满高度的只有根结点一个,下一层两个,再往下四个;数量越多的结点走的路越短,加权平均下来每个结点走不到两步。
实测也能看出这个结果:同样是建 n 个元素的堆,一次建堆的耗时随着 n 翻倍几乎正好翻倍,逐个插入的耗时虽然也在涨,两者的比值却不固定,下面实测数据一节会列出这组数字。
六、向上调整与插入
插入新元素时,先把它放到数组末尾,这样形状上仍是一棵完全二叉树(新结点是最后一个叶子的下一个位置)。然后从这个位置往上和父结点比,比父结点小就交换,一直走到根或者不再比父结点小为止。这条路也是一条从叶到根的路径,长度是树高,O(log N)。
向上调整比向下调整简单,因为它只需要看一个父结点,不用在孩子里挑。它的代价也和高度成正比,只不过刚插入的结点在最底下,最坏情况下要一路走到根。
这个函数的代码怎么写:骨架和向下调整一样,同样是「比、换、更新位置」三件事,不同的只是更新的方向朝上。
c
# 文件:/home/cocatrice/ds10/heap.c
static void AdjustUp(HPDataType* a, int child)
{
	int parent = (child - 1) / 2;
	while (child > 0)                  /* 走到根就停 */
	{
		if (a[child] < a[parent])      /* 比父结点小就往上换 */
		{
			Swap(&a[child], &a[parent]);
			child = parent;            /* 自己顶到父结点的位置上 */
			parent = (child - 1) / 2;  /* 再从新位置算父结点 */
		}
		else
		{
			break;                     /* 不比父结点小,已经就位 */
		}
	}
}
写这个函数时遇到的坑和向下调整很不一样,有三条要单独记下来。
第一条是循环条件,写成 while (parent >= 0) 看着合理,实际不会按预想的方式结束:child 走到 0 的时候,(0 - 1) / 2 在 C 语言里是 0(整数除法向零截断),parent 还是 0,于是拿 a0 和 a0 比,条件不成立走 break,恰好也能停下来,但逻辑已经绕了一圈。用 child > 0 直接把「到了根」写清楚,读代码的人不需要再推导这一层。
第二条是顺序:交换之后要先更新 child,再根据新的 child 算 parent。写成先算 parent 再更新 child,用的是旧的下标算出来的父结点,位置会一直偏。这和向下调整里「必须从 parent 重新算孩子」是同一类错误,方向相反而已。
第三条出现在插入那一段,插入要先把元素放到末尾、元素个数加一,然后对新元素做向上调整:
c
void HeapPush(Heap* hp, HPDataType x)
{
	HeapReserve(hp, hp->size + 1);   /* 先确保有位置,再写下标 size */
	hp->a[hp->size] = x;
	hp->size++;
	AdjustUp(hp->a, hp->size - 1);   /* 调整的是刚放进去那个 */
}
这里有三处顺序不能乱:扩容要在写数据之前,写数据用的是自增前的 size,向上调整传的是自增后的 size 减一。常见的写错方式是把 size++ 提到最前面,那样写进去的位置变成了下一个空格,刚插入的元素反而没有参与调整。
这里还有一处细节:对一个随机序列逐个插入建堆,每次插入平均只往上走一两层,很少一路走到根。单次插入的最坏代价虽然是 O(log N),n 次插入的实际总代价却接近 O(N),和一次建堆的差距只有两倍左右。把输入换成降序序列,每次插入都会升到堆顶,最坏情况才真正出现,实测里那次差距拉到了 3.3 倍。
七、删除堆顶
堆只能删堆顶,也就是删掉当前的最值,做法分三步:把堆顶和数组最后一个元素交换,把元素个数减一(相当于删掉了原来的堆顶),再对新的堆顶做一次向下调整。左右子树仍然是堆,不满足性质的只有新的堆顶,一次向下调整就够了。
不能直接把堆顶删掉然后整体前移,那样虽然数组还在,但树的结构被打乱,父子关系全部错位,重新整理比一次向下调整贵得多。交换再调整这个做法保住了子树的结构,代价是 O(log N)。
c
# 文件:/home/cocatrice/ds10/heap.c
void HeapPop(Heap* hp)
{
	Swap(&hp->a[0], &hp->a[hp->size - 1]);
	hp->size--;
	AdjustDown(hp->a, hp->size, 0);
}三行代码里有三处顺序,删除这个操作的代码不长,三步之间的顺序却一处都不能调换,调换之后程序照样能跑,堆却在悄悄变坏。
第一次尝试容易写成「先把元素个数减一,再交换」。这样写,交换的时候末尾那个位置已经被排除在堆之外,换过去的实际上是上一轮留下的旧值,堆顶和末尾相当于没有交换。正确的顺序是先交换、再减一:
c
Swap(&hp->a[0], &hp->a[hp->size - 1]);   /* 先换,此时末尾还是有效元素 */
hp->size--;                              /* 再把原来的堆顶排除出去 */
AdjustDown(hp->a, hp->size, 0);          /* 范围已经是新的元素个数 */
第二次尝试是交换和自减都写对了,却漏掉了最后那次向下调整。删完之后数组看着没坏,元素个数也少了一个,可是堆顶换上来的是原来末尾那个元素,它多半比孩子大,堆的性质已经不再成立。这种错误最难查,因为后续的插入删除还会继续「正常工作」,只是取出来的最值慢慢就不对了。要确认有没有出错,可以在删完之后从堆顶往下检查一遍父子关系,或者在测试里对每次删除都断言。
第三次尝试是没给空堆留保护,HeapPop 和 HeapTop 都要求堆非空,写成 assert 是让错误在第一次发生时立刻停下:
c
void HeapPop(Heap* hp)
{
	assert(hp);
	assert(!HeapEmpty(hp));   /* 空堆上没有堆顶可删 */
	...
}
去掉这两行断言,空堆上调用 HeapPop 会拿 size - 1 去当下标,那是 -1,直接越界。断言在这里的作用是让错误尽量早地暴露,把出错位置从几百行之后提前到调用现场,而不只是「防止用户犯错」。
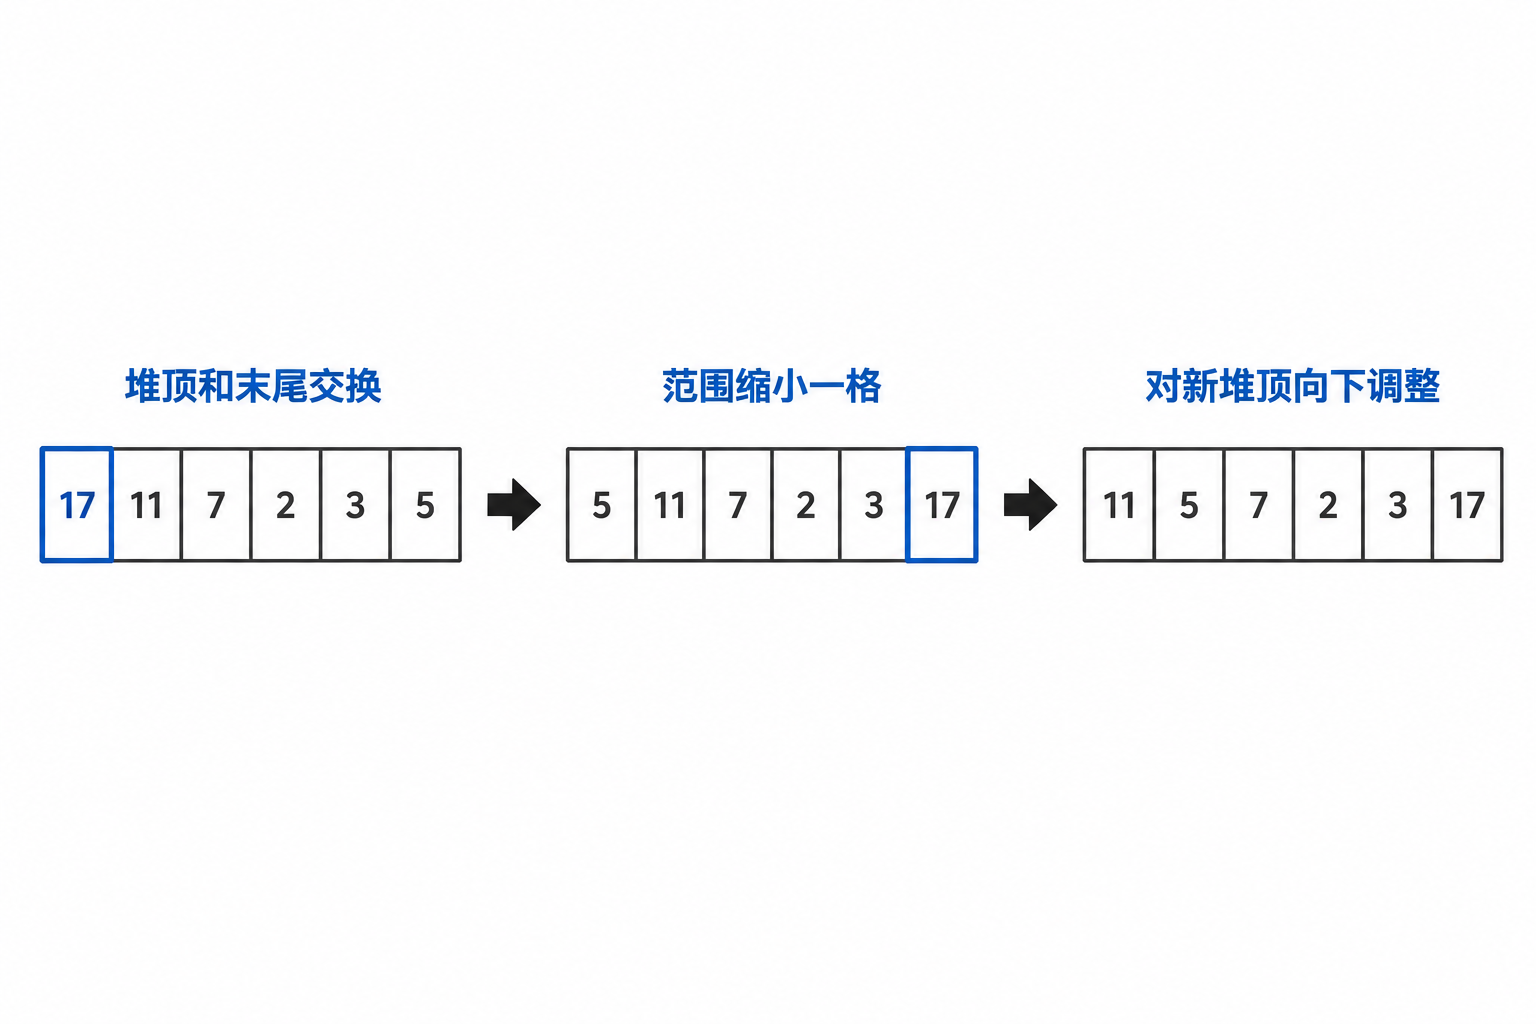
图 5 删除堆顶的三步
八、堆排序
堆排序把建堆和删堆顶这两个动作串起来:先建一个堆,然后反复把堆顶(当前最值)换到末尾、缩小堆的范围、对新的堆顶做一次向下调整。每换一次,就有一个元素落到了它最终的位置上。
升序要建大堆:建好大堆之后堆顶是最大值,把它和末尾交换,最大值就待在了数组最后一格,这一格不用再动;接着把堆的范围缩小一格,对新的堆顶向下调整,堆顶又变回剩余元素里的最大值;如此反复,元素从后往前依次就位,数组最后是升序。如果建的是小堆,第一次换到末尾的是最小值,位置就反了,还得再想办法倒过来。
| 排序要求 | 建的堆 | 每轮换到末尾的是 | 结果 |
|---|---|---|---|
| 升序 | 大堆 | 剩余元素里的最大值 | 从后往前依次就位,最后升序 |
| 降序 | 小堆 | 剩余元素里的最小值 | 从后往前依次就位,最后降序 |
堆排序是原地排序,除了几个临时变量不再申请内存,空间是 O(1);时间上建堆 O(N),后面 N 次调整每次 O(log N),合计 O(N log N)。它不稳定,两个相等的元素在交换过程中可能调换先后。
拿 5、11、7、2、3、17 这组数走一遍。先建大堆,得到 17、11、7、2、3、5,然后开始换:
| 轮次 | 当前堆的范围 | 动作 | 换完之后的数组 | 已就位 |
|---|---|---|---|---|
| 建堆后 | 6 个 | 堆顶是 17 | 17 11 7 2 3 5 | 无 |
| 1 | 6 个 | 堆顶 17 和下标 5 的 5 交换,范围缩到 5 | 5 11 7 2 3 17 | 17 |
| 2 | 5 个 | 调整后堆顶是 11,和下标 4 的 3 交换 | 3 5 7 2 11 17 | 11、17 |
| 3 | 4 个 | 调整后堆顶是 7,和下标 3 的 2 交换 | 2 5 3 7 11 17 | 7、11、17 |
| 4 | 3 个 | 调整后堆顶是 5,和下标 2 的 3 交换 | 3 2 5 7 11 17 | 5、7、11、17 |
| 5 | 2 个 | 调整后堆顶是 3,和下标 1 的 2 交换 | 2 3 5 7 11 17 | 全部就位 |
堆排序的代码就是建堆加一个循环,把向下调整的比较方向换成大堆的版本:
c
# 文件:/home/cocatrice/ds10/exp/heap_sort.c
static void HeapSort(int* arr, int n)
{
	int i;
	// 第一步:建大堆
	for (i = n / 2 - 1; i >= 0; i--)
	{
		AdjustDownBig(arr, n, i);
	}
	// 第二步:反复把堆顶换到末尾,再对新堆顶向下调整
	for (i = n - 1; i > 0; i--)
	{
		Swap(&arr[0], &arr[i]);
		AdjustDownBig(arr, i, 0);
	}
}
第二个循环里向下调整的范围是 i,不能写成 n:已经换到后面的元素属于排好序的部分,不能再参与调整,否则会被重新搅乱,这里同样有三次典型的错法。
第一次:建了小堆,小堆的堆顶是最小值,第一轮换到末尾的就是最小的那个数,排在数组最后面。后面每一轮同理,最后得到的是从大到小。想要升序就必须建大堆,这个结论落到代码上,就是 AdjustDownBig 里两处比较符号的方向。
第二次:调整范围传了 n,交换之后堆的有效范围是 i,写成 AdjustDown(arr, n, 0) 就会把已经排好的后半段重新卷进来。这种现象很难察觉:程序不崩,也不报错,只是排序结果偶尔对、偶尔错。原因是排好的元素本来就不比堆里的元素小,大多数时候卷进来也不会被换到前面去,只有在某些数据分布下才会被换乱。这种「大部分用例都对」的错误最容易被漏掉,排完之后一定要整体检查一遍是否有序。
第三次:循环边界写成 i >= 0,最后一轮 i 等于 0,交换 a0 和 a0,再对空堆做一次向下调整,多跑一轮无效动作,换成无符号下标还会变成死循环。
排完序之后拿 qsort 的结果逐个比一遍,是最直接的自检方式:
c
for (i = 0; i < n; i++)
{
	if (a[i] != b[i])
	{
		printf("第 %d 个元素不一致\n", i);
		break;
	}
}
堆排序不稳定这一点在代码里也能看出来:交换 a0 和 ai 是一个长距离的跳跃,值相等的两个元素谁先谁后,完全取决于它们当时在堆里的位置。
实测里对两百万个随机整数排序,手写的堆排序用了 275.3 毫秒,标准库的 qsort 用了 267.2 毫秒,两者结果完全一致,比值 1.03。堆排序在这个规模上的耗时和 qsort 基本相当,它真正的优势在空间:qsort 内部要递归,堆排序只用常数个变量。
九、TOP-K
TOP-K 问题是从一大堆数据里找出最大(或最小)的 K 个。数据量小的时候直接排序再取前 K 个就行,数据量大到内存装不下时,排序这条路就走不通了:全排一遍不仅要 O(N log N) 的时间,还要把整份数据都拿在手里。
堆的解法只需要 K 个元素的空间:求最大的 K 个,先用前 K 个元素建一个小堆,然后依次读剩下的元素,每读一个就和堆顶比一次,堆顶是当前这 K 个里最小的那个,也就是最该被替换掉的一个,新元素如果比它大,就把堆顶替换掉,再向下调整一次。全部读完,堆里剩下的就是最大的 K 个。
为什么求最大的 K 个反而要建小堆,这一处容易想岔。堆里放的始终是「目前见过的最大的 K 个」,堆顶是这 K 个里最小的,正好用来当门槛:比门槛小的元素进不来,比门槛大的把门槛挤掉。如果建的是大堆,堆顶是这 K 个里最大的,拿它当门槛会让大量本该留下的元素被排除在外。
| 做法 | 时间 | 额外空间 | 能不能处理内存装不下的数据 |
|---|---|---|---|
| 全部排序后取前 K | O(N log N) | O(N) | 不能,得先把数据全读进来 |
| K 个元素建堆再扫描 | O(N log K) | O(K) | 能,数据可以一个一个读 |
用一个短一点的例子走一遍,数据是 3、1、4、1、5、9、2、6,要求最大的 3 个:
| 读到的元素 | 堆顶(当前门槛) | 比门槛大吗 | 动作 | 堆里的三个数 |
|---|---|---|---|---|
| 前三个 3、1、4 | 无 | 无 | 建小堆 | 1 3 4 |
| 1 | 1 | 不大于 | 跳过 | 1 3 4 |
| 5 | 1 | 大于 | 换掉堆顶再下调 | 3 4 5 |
| 9 | 3 | 大于 | 换掉堆顶再下调 | 4 5 9 |
| 2 | 4 | 不大于 | 跳过 | 4 5 9 |
| 6 | 4 | 大于 | 换掉堆顶再下调 | 5 6 9 |
读完八个元素,堆里留下 5、6、9,正是这组数据里最大的三个。中间那个 2 比门槛 4 小,进不了堆;1 这种更小的元素同样会被门槛挡掉,一次调整都不会触发。
核心代码只有十几行,先用前 K 个建小堆,再拿剩下的元素挨个和堆顶比:
c
# 文件:/home/cocatrice/ds10/exp/topk.c
static void TopKByHeap(int* a, int n, int k, int* out)
{
	int i;
	for (i = 0; i < k; i++)
	{
		out[i] = a[i];
	}
	for (i = k / 2 - 1; i >= 0; i--)      // 前 k 个建小堆
	{
		AdjustDownSmall(out, k, i);
	}
	for (i = k; i < n; i++)
	{
		if (a[i] > out[0])                // 比门槛大才换
		{
			out[0] = a[i];
			AdjustDownSmall(out, k, 0);
		}
	}
	qsort(out, (size_t)k, sizeof(int), cmpInt);
}
最后那句 qsort 只是为了输出好看,把 K 个结果排好序,方便和全排序的结果逐个比对,真实场景里不需要。函数用到的额外内存就是 out 这块 K 个元素的数组,和 n 无关。
写这段代码时有四处容易出错的地方,下面逐个说明。
第一次:沿用前面的习惯建了大堆,堆排序那一节反复强调升序建大堆,写 TOP-K 时很容易沿用同一个方向,建出一个大堆。结果堆顶变成了这 K 个里最大的,它当门槛会把后面所有比它小的元素全部挡掉,最后留下的反而是最小的那批。判断的依据是:门槛要卡在「候选里最差的那个」上,求最大 K 个时最差的就是最小的那个,所以要建小堆。
第二次:比较的方向写反,把 if (ai > out0) 写成 if (ai < out0),堆里留下的就变成了最小的 K 个。这一处和建堆方向是两回事,两个方向都要正确:建小堆,并且比堆顶大才换。
第三次:K 比数据量还大,代码里先用前 K 个建堆,如果 K 大于 n,这个循环就会跑到数组外面去。稳妥的写法是在函数开头加一句判断,把 K 截到 n:
c
if (k > n)
{
	k = n;
}第四次:扫描条件写成大于等于,把 if (ai > out0) 写成 >=,逻辑上不算错,但相等的元素会被反复换进堆里,每一次都要多做一轮向下调整。数据里有大量重复值时,这个多余的判断会让耗时明显上升,而结果不会有任何变化。
实测从一百万个随机数里取最大的 100 个:全部排序用了 132.744 毫秒,小堆扫描用了 0.620 毫秒,差了 214 倍,两种做法给出的结果完全一致。
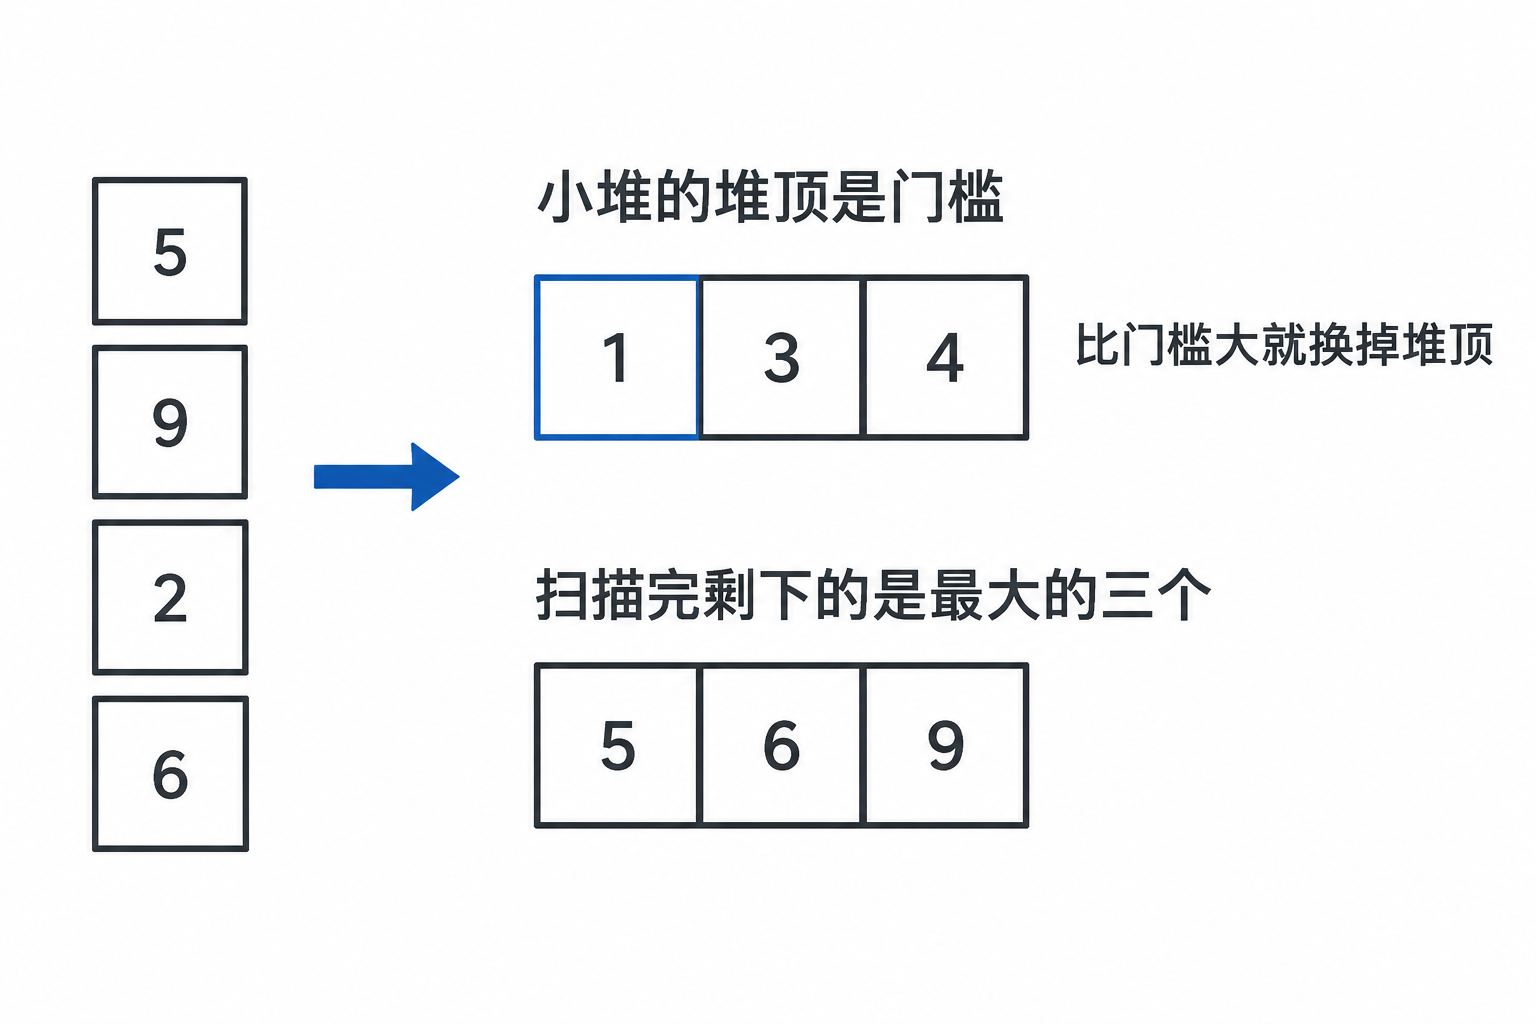
图 6 TOP-K 的小堆扫描
十、堆在系统里的应用
优先队列:堆最普遍的用途就是实现优先队列,入队对应插入,出队对应删堆顶,取最值对应取堆顶,三个操作分别是 O(log N)、O(log N) 和 O(1)。C++ 标准库里的 priority_queue 默认就是大堆,底层用的是 vector 加堆算法。
任务调度与超时管理:网络库里的定时器常常维护一个小堆,堆顶是最近要到期的那个任务,每一轮只检查堆顶,到点就执行并弹出。任务数量上万时,这样做的代价远小于每轮遍历一遍所有定时器。
排行榜与统计:实时榜单只关心前 K 名,用堆维护一份 K 个元素的候选集,新数据进来和堆顶比较一次就能决定要不要替换,内存占用和数据总量无关。
堆排序:空间紧张又需要 O(N log N) 的场合,堆排序是少数几个原地就能做到的算法,代价是常数因子比快排略大,而且不稳定。
这些场景有一个共同点:它们只需要反复取最值,不需要全部数据有序,这也是判断该不该用堆的依据。如果一次就要拿到排好序的全量结果,直接排序更合适;如果只是不断地问「现在最紧急的是哪一个」,堆就是干这个的。榜单这类需求介于两者之间,K 很小而数据源源不断,用堆维护一份候选集,比每来一条数据就重排一次的代价小得多。
实例代码
下面这些程序都能直接复制编译,回显全部来自一台 CentOS 7 机器,gcc 4.8.5,工作目录 /home/cocatrice/ds10。
工程结构
text
ds10/
├── heap.h        堆的结构体与接口声明
├── heap.c        堆的实现:向下调整、向上调整、建堆、插入、删除
├── test.c        功能测试与边界
└── exp/
    ├── build_time.c   两种建堆方式的耗时对照,含最坏情况
    ├── heap_sort.c    堆排序与 qsort 对照
    ├── topk.c         TOP-K 两种做法结果核对与计时
    ├── prio_task.c    用堆做的优先级任务调度小例子
    ├── err_build.c    故意从根开始调整的建堆
    ├── err_child.c    故意漏判右孩子是否存在的向下调整
    └── attempts.c     几种错误写法与正确版本并排跑一遍
编译命令统一是 gcc -std=gnu99 -Wall -Wextra -g,耗时的三个实验另外带 -O2。
完整代码
c
# 文件:/home/cocatrice/ds10/heap.h
typedef int HPDataType;

typedef struct Heap
{
	HPDataType* a;
	int size;
	int capacity;
} Heap;

void HeapInit(Heap* hp);
void HeapDestroy(Heap* hp);
void HeapCreate(Heap* hp, HPDataType* a, int n);
void HeapPush(Heap* hp, HPDataType x);
void HeapPop(Heap* hp);
HPDataType HeapTop(Heap* hp);
int HeapSize(Heap* hp);
bool HeapEmpty(Heap* hp);
实现里最核心的两个函数是向下调整和向上调整,其余接口都是它们的组合:
c
# 文件:/home/cocatrice/ds10/heap.c
// 想改成大堆,把两个 "<" 换成 ">"、"<=" 换成 ">=" 即可
static void AdjustDown(HPDataType* a, int n, int parent)
{
	int child = parent * 2 + 1;
	while (child < n)
	{
		if (child + 1 < n && a[child + 1] < a[child])
		{
			child++;
		}
		if (a[child] < a[parent])
		{
			Swap(&a[child], &a[parent]);
			parent = child;
			child = parent * 2 + 1;
		}
		else
		{
			break;
		}
	}
}

static void AdjustUp(HPDataType* a, int child)
{
	int parent = (child - 1) / 2;
	while (child > 0)
	{
		if (a[child] < a[parent])
		{
			Swap(&a[child], &a[parent]);
			child = parent;
			parent = (child - 1) / 2;
		}
		else
		{
			break;
		}
	}
}
两个函数里的交换方向决定了这是小堆还是大堆。整套代码只在小堆上写一遍,需要大堆时把这几处比较反过来,而不是再抄一份。
八个接口分成三组:初始化和销毁管内存,建堆和插入负责往里放数据(一个从现成数组整理,一个从末尾追加),取堆顶、删堆顶、取个数、判空负责往外拿数据。它们的代价分别是:
| 接口 | 做什么 | 时间复杂度 |
|---|---|---|
| HeapCreate | 用现成数组建堆 | O(N) |
| HeapPush | 末尾插入再向上调整 | O(log N) |
| HeapPop | 首尾交换再向下调整 | O(log N) |
| HeapTop | 读下标 0 | O(1) |
| HeapSize、HeapEmpty | 读成员变量 | O(1) |
剩下的接口都是这两个函数的组合,扩容那段和顺序表里写过的几乎一样:
c
# 文件:/home/cocatrice/ds10/heap.c
// 用一个现成的数组建堆:从最后一个非叶子结点开始往前,每个结点向下调整一次
void HeapCreate(Heap* hp, HPDataType* a, int n)
{
	int i;
	HeapInit(hp);
	HeapReserve(hp, n);
	for (i = 0; i < n; i++)
	{
		hp->a[i] = a[i];
	}
	hp->size = n;
	for (i = n / 2 - 1; i >= 0; i--)
	{
		AdjustDown(hp->a, hp->size, i);
	}
}

void HeapPush(Heap* hp, HPDataType x)
{
	HeapReserve(hp, hp->size + 1);
	hp->a[hp->size] = x;
	hp->size++;
	AdjustUp(hp->a, hp->size - 1);
}

void HeapPop(Heap* hp)
{
	Swap(&hp->a[0], &hp->a[hp->size - 1]);
	hp->size--;
	AdjustDown(hp->a, hp->size, 0);
}

HPDataType HeapTop(Heap* hp)
{
	return hp->a[0];
}
四个操作加起来不到三十行,插入走一遍向上调整,删除走一遍向下调整,建堆是把向下调整按从后往前的顺序跑一遍。
正常情况
先看插入和删除的结果:往空堆里依次压入十个数,每压一个做一次向上调整,压完之后数组的顺序是 15 18 19 25 28 34 65 49 27 37,堆顶 15 正是这十个数里最小的。
text
[cocatrice@hcss-ecs-4cd1 ds10]$ ./test
===== 插入与删除 =====
依次插入 27 15 19 18 28 34 65 49 25 37 之后:
堆里的元素(数组顺序): 15 18 19 25 28 34 65 49 27 37
堆顶 = 15,元素个数 = 10

连续取堆顶并删除: 15 18 19 25 27 28 34 37 49 65

===== 用现成数组建堆 =====
用数组 1 5 3 8 7 6 直接建堆:
堆里的元素(数组顺序): 1 5 3 8 7 6
堆顶 = 1
逐个弹出来: 1 3 5 6 7 8
连续取堆顶并删除,拿到的序列是 15 18 19 25 27 28 34 37 49 65,已经从小到大排好。这一点并不是巧合:小堆的堆顶永远是最小值,每次弹掉一个,下一个最小值就顶上来,「反复取堆顶」因此等价于从小到大排序,堆排序就是把这个过程原地做出来。
用现成数组建堆的那一组也能说明问题:1 5 3 8 7 6 本来就是一个小堆,从最后一个非叶子结点往前调的过程中一次交换都没有发生,数组保持原样。已经满足堆性质的数据不会被建堆过程打乱。
常见报错
报错一:建堆从根开始调,向下调整的前提是左右子树已经是堆,从根开始调的时候这个前提不成立。拿 1 9 2 8 7 3 4 试一下:根本来就是 1,比两个孩子都小,一次交换都不会发生,可下标 1 那棵子树里 9 比它的两个孩子都大,整个数组仍然不是堆。
text
[cocatrice@hcss-ecs-4cd1 ds10]$ ./exp/err_build
从根调整一次的结果: 1 9 2 8 7 3 4
  这是一个小堆吗:不是
从最后一个非叶子结点往前调整的结果: 1 7 2 8 9 3 4
  这是一个小堆吗:是
改法就是把循环从 n / 2 - 1 开始倒着走,每调一个结点时,它的左右子树都已经处理完了。
报错二:找孩子时漏判右孩子,向下调整里比较两个孩子之前要写 child + 1 < n,漏掉这一句,最后一个只有左孩子的结点就会去读数组外面的内存。
text
[cocatrice@hcss-ecs-4cd1 ds10]$ valgrind ./exp/err_child
==26565== Invalid read of size 4
==26565==    at 0x400673: AdjustDownBad (err_child.c:20)
==26565==    by 0x400778: main (err_child.c:48)
==26565==  Address 0x5205050 is 0 bytes after a block of size 16 alloc'd
==26565==    at 0x4C29F73: malloc (vg_replace_malloc.c:309)
==26565==    by 0x40072A: main (err_child.c:39)
程序本身不一定崩,读到的垃圾值会让它在某些数据下悄悄给出错误答案,valgrind 直接指出了出错的位置:读的地方就在那块 16 字节内存的后面 0 字节处。这类错误靠肉眼看代码很难发现,跑一遍 valgrind 只要几秒。
把几种错法放在一起跑一遍,exp 下还有一个 attempts.c,把文章里讲到的错误写法各写一份,和正确的版本并排跑:
text
[cocatrice@hcss-ecs-4cd1 ds10]$ ./attempts
数据:27 15 19 18 28 34 65 49 25 37

正确版本建堆:
  结果                 15 18 19 25 28 34 65 49 27 37
  是小堆吗:是

错版一(只比较一次,不循环):
  结果                 15 27 19 18 28 34 65 49 25 37
  是小堆吗:不是

错版二(交换之后忘了把 parent 挪下去):
  结果                 15 27 19 18 28 34 65 49 25 37
  是小堆吗:不是

错版三(删除堆顶之后不调整):
  结果                 37 18 19 25 28 34 65 49 27
  是小堆吗:不是(正确版本删完仍然是堆)

对照(child = child * 2 + 1,parent 已经挪过):
  结果                 15 18 19 25 28 34 65 49 27 37
  是小堆吗:是(和正确版本完全一致)

数据:3 1 4 1 5 9 2 6,求最大的 3 个
  错版四(建大堆): 9 1 3
  正确结果(建小堆): 5 6 9
  小堆扫描的结果:     5 6 9
三个错版的建堆结果都停在 15 27 19 18 28 34 65 49 25 37 或者更糟的位置上,判定函数给出的结论都是「不是堆」。TOP-K 那个错版留下的是 9、1、3:最大值确实进来了,另外两个却是最早那批没有被挤掉的元素,与正确答案 5、6、9 完全不符。建堆方向搞反的后果不是少找一个答案,而是找出一批完全无关的数。
边界情况
| 输入 | 结果 | 说明 |
|---|---|---|
| 只有一个元素 42 | 堆顶 42,弹掉之后堆为空 | 建堆循环从 n/2 - 1 算起是 -1,一次都不调 |
| 五个 7 | 数组顺序不变,连续弹出五个 7 | 所有父子关系都取等号,一次交换都不发生 |
| 升序数组 1 2 3 4 5 | 建堆后仍是 1 2 3 4 5 | 已经满足小堆性质 |
| 降序数组 5 4 3 2 1 | 建堆后是 1 2 3 5 4 | 交换集中在前几个结点 |
| TOP-K 里 K 取 1 | 等价于求最大值 | 堆里只有一个元素,堆顶就是答案 |
| TOP-K 里 K 取 20(等于数组长度) | 和全排序结果一致 | 堆里装下了全部数据 |
| 全部相同的随机数据 | 两种建堆方式堆顶一致 | 六个规模逐个核对过 |
实测数据
两种建堆方式的耗时对比用的是同一组规模:一次建堆是 O(N),逐个插入在随机数据下接近 O(N),在降序数据下退化成 O(N log N)。
| 元素个数 | 随机数据逐个插入 | 随机数据一次建堆 | 降序数据逐个插入 | 降序/一次建堆 |
|---|---|---|---|---|
| 100000 | 1.918 毫秒 | 0.934 毫秒 | 2.399 毫秒 | 2.6 |
| 200000 | 3.718 毫秒 | 1.849 毫秒 | 5.079 毫秒 | 2.7 |
| 400000 | 7.377 毫秒 | 3.815 毫秒 | 10.875 毫秒 | 2.9 |
| 800000 | 14.819 毫秒 | 7.492 毫秒 | 23.120 毫秒 | 3.1 |
| 1600000 | 29.480 毫秒 | 15.577 毫秒 | 48.800 毫秒 | 3.1 |
| 3200000 | 59.191 毫秒 | 31.007 毫秒 | 102.971 毫秒 | 3.3 |
三列数据都随着元素个数翻倍而翻倍,三种做法在这一档规模上都是线性的。差别在常数上:随机数据下逐个插入的耗时是一次建堆的两倍左右,因为每次插入平均只往上走一两层;换成降序数据,每次插入都要升到堆顶,倍数从 2.6 涨到 3.3,log N 这一项在这里显现出来。
堆排序与 qsort 的对照用两百万个随机整数,两种做法各跑一遍。
| 做法 | 耗时 | 结果 |
|---|---|---|
| 手写堆排序 | 275.373 毫秒 | 与 qsort 完全一致 |
| qsort | 267.240 毫秒 | 基准 |
手写堆排序是 qsort 的 1.03 倍,略慢一些。堆排序的额外空间是 O(1),qsort 内部要递归,两者在空间上的区别很明显。
TOP-K 这一组是在一百万个随机整数里取最大的 100 个。
| 做法 | 耗时 | 额外空间 |
|---|---|---|
| 全部排序后取前 K | 132.744 毫秒 | 一百万个 int,约 4 MB |
| K 个元素建小堆扫描 | 0.620 毫秒 | 100 个 int,400 字节 |
小堆扫描快了 214 倍,结果与全排序完全一致。数据量再大一个数量级,这个差距还会继续拉开,因为全排序是 O(N log N) 而小堆扫描是 O(N log K)。
内存检查用的是功能测试那支程序,交给 valgrind 跑一遍。
text
==26328== HEAP SUMMARY:
==26328==     in use at exit: 0 bytes in 0 blocks
==26328==   total heap usage: 8 allocs, 8 frees, 256 bytes allocated
==26328== All heap blocks were freed -- no leaks are possible
==26328== ERROR SUMMARY: 0 errors from 0 contexts
八次申请八次释放,退出时占用 0 字节,没有泄漏也没有越界。
实例:用堆做一个优先级任务调度
前面讲的都是抽象的数据,最后看一个能用的场景。任务有名字和优先级,优先级数字越大越先执行,把任务全部放进一个大堆,每次取堆顶就是当前最该执行的那个。
text
[cocatrice@hcss-ecs-4cd1 ds10]$ ./exp/prio_task
六个任务按优先级从高到低执行:
  优先级 9  修线上 bug
  优先级 5  回消息
  优先级 4  改样式
  优先级 3  编译
  优先级 2  写周报
  优先级 1  下载依赖

再压一个插队的高优先级任务:
  第一个执行的是:老板来了(优先级 10)
这个例子的堆代码和前面几乎一样,只把数据从 int 换成了结构体,比较的地方改成比优先级:
c
# 文件:/home/cocatrice/ds10/exp/prio_task.c
static void TaskHeapPush(TaskHeap* h, const char* name, int prio)
{
	int child = h->size;
	int parent;
	strncpy(h->a[child].name, name, sizeof(h->a[child].name) - 1);
	h->a[child].name[sizeof(h->a[child].name) - 1] = 0;
	h->a[child].prio = prio;
	h->size++;

	parent = (child - 1) / 2;
	while (child > 0 && h->a[child].prio > h->a[parent].prio)
	{
		SwapTask(&h->a[child], &h->a[parent]);
		child = parent;
		parent = (child - 1) / 2;
	}
}
堆里的元素换成任何类型都行,只要有一个能比较大小的字段。C 语言没有模板,比较的那一行要按类型重写;C++ 的 priority_queue 把这一层用模板和比较器包了起来。
六个任务压进去的顺序是乱的,取出来严格按优先级从高到低。后面又演示了一次插队:已经排好的三个任务里新压进一个优先级 10 的,它立刻排到了最前面。用数组每次扫一遍找最大也能做到同样的事,代价是每次 O(N);堆把插入和取出的代价都压到了 O(log N),任务数量上万时两者的差别很明显。
踩坑点
- 建堆要从最后一个非叶子结点往前调,从根开始调是错的:向下调整要求左右子树已经是堆,根的两个子树还没整理过。
- 最后一个非叶子结点的下标是 n / 2 - 1。n 为 1 时这个式子是 -1,循环一次都不进,正好对应「单个元素已经是堆」。
- 向下调整比较两个孩子之前必须判断右孩子是否存在,写成 child + 1 < n。漏掉这一句会读数组外面的内存,程序未必崩,但答案会悄悄出错。
- 每次拿父结点和较小的那个孩子换(大堆里是较大的那个)。挑错了孩子,换完之后另一个孩子仍然小于父结点,堆的性质仍然不成立。
- 建堆的时间复杂度是 O(N),不是 O(N log N)。越靠下的结点越多,而它们几乎不用往下走,把每层结点数当成一样多会把结论估大。
- 删除堆顶的步骤是「和最后一个元素交换、元素个数减一、对新的堆顶向下调整」,不能直接删掉堆顶再整体前移,那会打乱整棵树的结构。
- 插入之后向上调整的起点是新元素的下标 size - 1,写完 size++ 再拿 size 去调,调整的就不是刚插进去的那个元素了。
- 父结点的下标是 (i - 1) / 2,写成 i / 2 在下标为偶数时会指错。下标 2 的父结点是 0,i / 2 却算成 1。
- 升序建大堆、降序建小堆,方向反了元素会从前往后按倒序就位,结果整个反过来。
- 求最大的 K 个建小堆、求最小的 K 个建大堆,两者容易记反。判断依据是堆顶要当门槛用,它得是这批候选里最差的那个。
- 小堆和大堆的差别只在几处比较符号,复制一份改方向很容易漏掉其中一处比较,改完要把两种堆的方向都跑一遍。
- 数组越界读在 Release 下往往看不出问题,堆类的代码改完建议过一遍 valgrind,它会精确指出越界的位置和偏移。
本篇总结(模拟面试问题)
问:堆和二叉搜索树有什么区别?
核心要点:堆和二叉搜索树在形状和用途上都不一样。堆是完全二叉树,用数组存,只保证父结点和孩子之间的大小关系,兄弟之间没有约定,所以它能 O(1) 取到最值,却没法按顺序遍历。二叉搜索树保证左子树全部小于根、右子树全部大于根,中序遍历能得到有序序列,但形状会退化,需要平衡树来兜底。
问:建堆为什么要从最后一个非叶子结点开始?
核心要点:向下调整的前提是左右子树已经是堆。叶子结点没有孩子,天然满足这个前提,所以从最后一个非叶子结点开始往前,每处理一个结点时它的两棵子树都已经整理好了。从根开始调的话这个前提不成立,调完根,下面没处理过的子树里的问题还在。
问:建堆的时间复杂度为什么是 O(N) 而不是 O(N log N)?
核心要点:完全二叉树里越靠下的结点越多,最后一层占了大约一半,而向下调整的代价和结点高度成正比,叶子一次都不用调。把每层的「结点个数乘以下调层数」加起来是 n/4 + n/4 + 3n/16 这样的级数,收敛到 n 的量级。估算时把每层结点数当成一样多,才会得到 N log N 这个偏大的结果。
问:删除堆顶为什么要先和最后一个元素交换?
核心要点:直接删掉堆顶会让整棵树的父子关系错位,重新整理一遍比一次向下调整贵得多。和最后一个元素交换再减掉元素个数,形状上仍然是一棵完全二叉树,而且除了新的堆顶之外,其他结点的子树都还是堆,只需要一次向下调整,代价 O(log N)。
问:堆排序为什么升序要建大堆?
核心要点:堆排序靠反复把堆顶换到未排序部分的末尾来就位。升序要求末尾依次放的是最大值、次大值,所以堆顶得是最大值,也就是要建大堆。建小堆的话每次换到末尾的是最小值,从后往前就变成了降序。
问:TOP-K 为什么求最大的 K 个反而要建小堆?
核心要点:堆里放的是「目前见过的最大的 K 个」,堆顶是这 K 个里最小的那个,它正好是一道门槛:新元素比它小就进不来,比它大就把堆顶替换掉。如果建的是大堆,堆顶是这批里最大的,拿它当门槛会把大量本该留下的元素挡在外面。
问:向上调整和向下调整分别用在什么场合?
核心要点:向上调整用在末尾新增元素的场合,只需要和父结点比,路径是从叶到根,插入用它。向下调整用在「某个结点的左右子树已经是堆、只有它自己可能不对」的场合,需要在两个孩子里挑一个换,路径是从根到叶,删除堆顶和建堆用它。两者的代价都是树高,O(log N)。
问:堆这种结构在实际的系统里用在哪些地方?
核心要点:优先队列是它最普遍的用途,入队、出队、取最值三个操作分别对应插入、删堆顶和取堆顶。其他用途还有网络库的定时器(堆顶是最近到期的任务)、实时榜单(维护 K 个候选,新数据和堆顶比一次就行),以及空间紧张时的原地排序。
参考
- 二叉堆的概念、实现与常见操作:https://oi-wiki.org/ds/heap/
- C++ 优先队列的接口说明,默认就是大堆:https://en.cppreference.com/cpp/container/priority_queue
- 堆的数据结构综述与图解:https://www.geeksforgeeks.org/dsa/heap-data-structure/
- 二叉堆的结构、数组存储与建堆复杂度的推导:https://www.geeksforgeeks.org/dsa/binary-heap/
- qsort 手册页,实测里用来和堆排序对照:https://man7.org/linux/man-pages/man3/qsort.3.html