前言
前两讲一直在讲"位姿":机器人在哪、朝哪。可是 SLAM 的输入不是位姿,是传感器数据。对视觉 SLAM 来说,传感器数据就是一张张图像------每张图像是几十万到几百万个像素,每个像素是一个 0~255 的亮度值。从这堆数字到"机器人在哪",中间隔着一个必须回答的问题:三维世界里的一个点,是怎么变成图像上某个位置的一个像素的?
这个问题的答案叫相机模型。它是一个确定的几何过程:光线从物体出发,穿过镜头,打在感光芯片上,芯片把光强量化成数字。如果我们能用数学写出这个过程,就能做两件事------正向:已知三维点和相机位姿,预测它会出现在图像的哪里;反向:已知它出现在图像的哪里,反推它在三维空间的位置(或至少是方向)。前者是后面所有"重投影误差"的基础,后者是三角测量和建图的基础。
这一讲还要回答一个相机模型本身回答不了的问题:**深度从哪里来。**一张照片把三维压成了二维,丢掉了一个维度------沿着视线方向的距离。单目相机天生不知道物体离它多远。要把这个维度找回来,要么用两只眼睛(双目),要么主动打光去测(RGB-D),要么靠相机自己运动起来从不同角度看(单目 SLAM 的办法,第 7 讲)。这一讲讲前两种。
最后,这一讲会用 OpenCV 做几个实践:读图、访问像素、去畸变、从双目图像算点云、把多帧 RGB-D 拼成一张地图。这些实践不难,但它们建立的直觉------"图像在内存里是什么样"、"深度图的一个像素值代表多少米"、"点云是怎么拼起来的"------是后面写任何视觉代码的前提。
第一章 针孔相机模型
1.1 小孔成像
最简单的相机模型就是初中物理的小孔成像:在一个暗箱前壁开一个小孔,物体发出的光线穿过小孔,在后壁成一个倒立的像。
把这个装置抽象成几何。建立相机坐标系 O-x-y-z:原点 O 是小孔(光心),z 轴指向相机正前方(光轴方向),x 轴向右,y 轴向下------注意是向下,这和图像坐标的约定一致。后壁(成像平面)与光轴垂直,距离光心的距离是 f,叫焦距。
空间中一点 P = X, Y, Z,它发出的光线穿过 O,打在成像平面上的 P′ = X′, Y′, Z′。由于成像平面在 z = −f 处,Z′ = −f。看 X 方向上的相似三角形:
Z / f = −X / X′ = −Y / Y′负号来自成像是倒立的。这个负号在数学上很烦人,所以通常做一个处理:把成像平面对称地搬到相机前方 z = +f 处。这样像就是正立的,负号消失,几何关系不变:
Z / f = X / X′ = Y / Y′整理得
X′ = f X / Z
Y′ = f Y / Z
这就是针孔模型的核心:**三维点的坐标除以它的深度 Z,再乘以焦距,就是它在成像平面上的位置。**除以 Z 这一步是整个相机模型的灵魂------它是非线性的,也是"深度丢失"的根源:X 和 Z 同时放大两倍,X′ 不变。
1.2 从成像平面到像素
成像平面上的 P′ 还是用米(或毫米)为单位的物理坐标。真正的图像是一个像素阵列,所以还要做一步转换。
像素坐标系 o-u-v 定义在成像平面上:原点 o 在图像左上角,u 轴向右,v 轴向下。它和成像平面坐标的区别有两点:一是原点不同(成像平面坐标原点在光轴与平面的交点,像素坐标原点在左上角),二是单位不同(一个是米,一个是像素)。所以从 P′ 到像素 u, v 要经过一次缩放和一次平移:
u = α X′ + cx
v = β Y′ + cy
α、β 的单位是"像素/米",表示每米物理长度对应多少个像素(由感光芯片的像元尺寸决定,通常 α ≈ β 但不完全相等);cx、cy 的单位是像素,是光轴与成像平面交点在像素坐标系下的位置,理想情况下是图像中心,实际会有偏差。
把 1.1 节的式子代进来,并令 fx = α f、fy = β f:
u = fx · X / Z + cx
v = fy · Y / Z + cy
现在 fx、fy 的单位也是像素。这四个数 fx、fy、cx、cy 叫相机的内参(intrinsics),它们由相机出厂时决定,使用过程中不变(除非你调焦或换镜头)。一台相机买回来,第一件事是用标定板把这四个数标出来;SLAM 数据集都会给出它们。
1.3 内参矩阵
上面的式子里有一个除以 Z,不是线性的。用上一讲的齐次坐标技巧可以把它写成矩阵形式。把像素坐标写成齐次的 u, v, 1,并在两边乘上 Z:
      ┌ u ┐   ┌ fx   0   cx ┐ ┌ X ┐
  Z · │ v │ = │  0  fy   cy │ │ Y │   ≜   K P
      └ 1 ┘   └  0   0    1 ┘ └ Z ┘
中间这个 3×3 矩阵 K 叫内参矩阵。你可以验证:右边乘出来第三行就是 Z,前两行是 fx X + cx Z 和 fy Y + cy Z,除以 Z 正好是 u 和 v。
习惯上把左边的 Z 挪到右边,写成
p_uv = (1/Z) K P读法是:三维点 P 先乘以 K,再除以深度 Z,得到齐次像素坐标。有时也省略那个 1/Z,直接写 p_uv = K P,这时等号的含义是"在相差一个尺度因子的意义下相等",齐次坐标允许这样做。
1.4 加上外参:从世界系到像素
上面的 P 是相机坐标系 下的坐标。路标点在地图里是以世界坐标系存的,叫 P_w。两者之间差一个相机位姿------就是前两讲一直在说的 T_cw:
P = T_cw P_w = R P_w + t把它代进投影公式:
Z p_uv = K (R P_w + t) = K T_cw P_w最后一个等号把 P_w 看作齐次坐标、T_cw 看作 4×4 矩阵,并隐含了"乘完之后取前三维"的操作------书里把这个过程叫"齐次坐标到非齐次坐标的转换",公式里不写出来,读者要自己记得。
这个式子就是视觉 SLAM 的观测方程 :给定相机位姿 T_cw(待估计的 x)和路标 P_w(待估计的 y),预测出像素位置 p_uv(观测 z)。相机位姿 T_cw 在这个语境下叫相机的外参 (extrinsics)。内参标定一次就固定;外参随着相机运动不断变化,SLAM 估计的就是外参。
1.5 归一化平面与深度丢失
把投影分成两步看,会更清楚。
第一步:把 P 除以 Z,得到
P_c = [X/Z, Y/Z, 1]这个点在 z = 1 的平面上,这个平面叫归一化平面,P_c 叫归一化坐标。它是"把三维点沿着视线方向推到距离光心 1 米处"的结果。
第二步:对归一化坐标乘 K,得到像素坐标。
这样拆开有两个好处。其一,归一化坐标与内参无关------不同的相机看同一个点,归一化坐标是一样的,只是最后乘的 K 不同;所以很多算法(对极几何、三角化)都在归一化平面上做,先把像素用 K⁻¹ 变回归一化坐标,算完再变回去。其二,它把"深度丢失"看得很明白:P = X, Y, Z 和 λP = λX, λY, λZ 的归一化坐标完全相同。一个像素对应的不是一个点,而是一条从光心出发的射线,射线上所有点都投影到同一个像素。单目相机只知道射线,不知道点在射线上的哪里。
1.6 畸变:真实镜头不是小孔
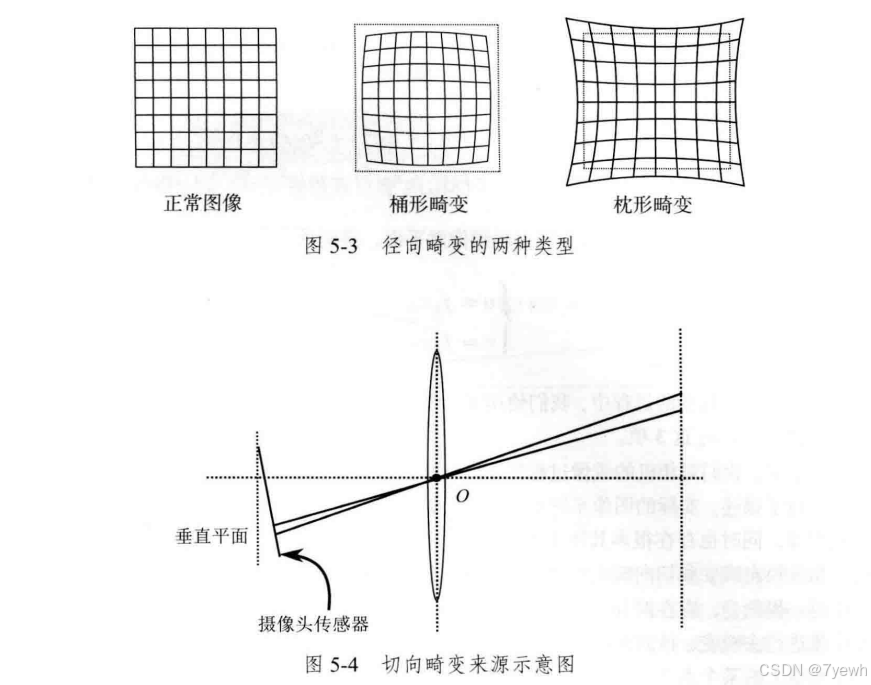
小孔不透光量太小,真实相机都用透镜。透镜带来两个后果:一是光线不再严格走直线,二是透镜与感光芯片装配时不可能完全平行。它们分别导致径向畸变 和切向畸变。
径向畸变 是透镜形状造成的:光线离光轴越远,弯折越厉害。表现为直线在图像边缘变弯------向外弯叫桶形畸变 (广角镜头常见),向内弯叫枕形畸变。由于它关于光轴对称,畸变量只和到光心的距离 r 有关,用 r 的多项式描述。
切向畸变是透镜与成像平面不平行造成的,它在切线方向上拉扯像点。
畸变在归一化平面上描述。设无畸变的归一化坐标是 x, y,r² = x² + y²,畸变后的归一化坐标是
x_distorted = x (1 + k₁ r² + k₂ r⁴ + k₃ r⁶) + 2 p₁ x y + p₂ (r² + 2 x²)
y_distorted = y (1 + k₁ r² + k₂ r⁴ + k₃ r⁶) + p₁ (r² + 2 y²) + 2 p₂ x y
括号里是径向项,k₁、k₂、k₃ 叫径向畸变系数(普通镜头只用 k₁、k₂,鱼眼才需要 k₃);后面两项是切向项,p₁、p₂ 叫切向畸变系数。这五个数和 fx、fy、cx、cy 一起构成相机的完整内参,标定时一起标出。
然后把畸变后的归一化坐标投影到像素:
u = fx x_distorted + cx
v = fy y_distorted + cy有了这个模型,处理畸变有两种策略。一种是先把整张图去畸变 ,之后所有算法都在无畸变图上跑,当成理想针孔相机;另一种是不动图像,只在用到特征点时把点的坐标去畸变。前者简单,视觉 SLAM 实践中最常用;后者省计算,ORB-SLAM 用的是它。
鱼眼和全景相机的畸变太大,上面的多项式模型不够用,要换成 MEI 模型或 Kannala-Brandt 模型(ORB-SLAM3 支持后者)。书里只提了一句,这里不展开。
1.7 小结:一个点的完整旅程
把这一章串起来,一个世界系三维点 P_w 变成像素的全过程是:
-
用外参变到相机系:P = R P_w + t;
-
除以深度得归一化坐标:P_c = X/Z, Y/Z, 1;
-
用畸变模型得畸变后的归一化坐标 x_d, y_d;
-
用内参变到像素:u = fx x_d + cx,v = fy y_d + cy。
第 1 步用了前两讲的东西,第 2~4 步是这一讲的东西。SLAM 的后端要优化的是第 1 步里的 R、t 和 P_w,而第 2~4 步在这个过程中是固定的函数。
第二章 深度从哪里来:双目与 RGB-D
2.1 双目相机:用视差测距
人靠两只眼睛判断远近,双目相机也是。两台一模一样的相机水平并排放置,光心距离叫基线 b。同一个空间点 P 在左右两张图上的成像位置不同------它在左图的横坐标是 u_L,右图是 u_R。由于右相机在左相机右边,P 在右图上会偏左,所以 u_R < u_L。两者之差
d = u_L − u_R叫视差(disparity)。
现在看几何。左右相机光心 O_L、O_R 和点 P 构成一个三角形,成像平面在光心前方 f 处。由相似三角形(书中图 5-6),
(z − f) / z = (b − u_L + u_R) / b = (b − d) / b整理得
z = f b / d深度与视差成反比:视差越大,物体越近。f 和 b 已知(标定得到),只要在右图里找到左图某像素对应的点、算出视差 d,就能得到深度。这就是双目测距的全部原理。
公式简单,难点全在"找到对应点"上。这个过程叫立体匹配,要在右图同一行上搜索与左图某像素最相似的位置------因为两相机已经做了"校正"(rectification),对应点一定在同一行,搜索从二维降为一维。但即便如此,在纹理重复(白墙、地砖)或无纹理的地方,匹配仍然经常出错。OpenCV 的 SGBM(半全局块匹配)是常用算法,计算量大,通常要靠 GPU 或 FPGA 才能实时。
双目还有两个固有限制。第一,视差是整数像素 (或亚像素插值后精度有限),而 z = fb/d,d 每变化 1 个像素,近处 z 变化很小、远处 z 变化很大。所以双目对远处物体的深度精度急剧下降,有效测距范围由基线决定------基线越长测得越远,但基线长了相机就大了,近处的物体又可能只在一边的视野里。第二,量化:d 最小是 1 像素,所以能测的最远深度是 f b / 1 = f b;更远的物体视差为 0,相当于无穷远。
2.2 RGB-D 相机:主动测距
双目靠算,RGB-D 靠测。RGB-D 相机在普通彩色相机旁边加一个深度传感器,主动向外发射红外光并接收回波,直接给出每个像素的深度。按原理分两类:
结构光(Structured Light):投射一组已知图案的红外光斑到场景上,用红外相机拍下光斑在物体表面的变形,根据变形程度算出深度。本质上是把双目里"找对应点"这个难题用已知图案替代了。第一代 Kinect、早期 RealSense 用它。
飞行时间(Time-of-Flight,ToF):向场景发射光脉冲,测量光从发出到被反射回来的时间,乘以光速除以二就是距离。第二代 Kinect、现在大多数手机上的深度相机用它。
RGB-D 的输出是一张深度图,和彩色图一一对应:彩色图 (u, v) 处的像素,在深度图同样位置存着它的深度(通常以毫米为单位、16 位无符号整数)。有了深度 Z,加上内参,就能把每个像素还原成相机系下的三维点:
X = (u − cx) · Z / fx
Y = (v − cy) · Z / fy
这是针孔模型的反向使用。于是一张 RGB-D 图像直接给出一片带颜色的三维点云,不需要任何计算。
RGB-D 的缺点也很明确:红外发射功率有限,测距范围短 (几米以内);阳光下的红外干扰 让它在室外基本不可用;透明、反光、吸光的材质(玻璃、镜子、黑色绒布)测不到或测错;深度图通常有不少空洞和噪声;相机本身比单目贵、大、耗电。所以 RGB-D SLAM 主要用在室内机器人和 AR 场景。
2.3 三种相机的对比
| 单目 | 双目 | RGB-D | |
|---|---|---|---|
| 深度来源 | 无(靠运动三角化,第 7 讲) | 左右视差计算 | 主动红外测量 |
| 尺度 | 未知(差一个全局缩放) | 已知(由基线给出) | 已知 |
| 计算量 | 小 | 大(立体匹配) | 小 |
| 室外 | 可 | 可 | 基本不可 |
| 测距范围 | --- | 由基线决定,远处精度差 | 几米以内 |
| 成本/体积 | 最低 | 中 | 高 |
单目 SLAM 的尺度不确定性是它独有的麻烦------上一讲的 Sim(3) 就是为它准备的。但单目便宜、小、功耗低,手机和无人机上几乎只能用它,所以单目 SLAM 一直是研究热点。
第三章 图像在计算机里是什么
3.1 图像是一个二维数组
一张灰度图在数学上是一个函数 I(x, y):输入像素位置,输出亮度。在计算机里它就是一个二维数组,每个元素是一个 0~255 的整数(8 位无符号字符 unsigned char)。宽 w、高 h 的图像占 w × h 个字节。
两个容易搞混的约定:
坐标顺序。 数学上写 I(x, y),x 是横坐标(列)、y 是纵坐标(行)。但二维数组是先行后列 存储的,访问时写 image[y][x]------先给行号再给列号。OpenCV 的 image.at<uchar>(y, x) 同样是 (行, 列) 顺序,而 cv::Point(x, y) 又是 (列, 行) 顺序。写代码时这里出错的概率极高,看到异常的转置图像就先查这个。
**原点与方向。**像素坐标原点在图像左上角,x(u)向右,y(v)向下。这和数学中 y 向上的习惯相反,和 1.1 节相机坐标系 y 轴向下的约定一致------相机模型里把 y 轴定义成向下,正是为了与图像坐标对齐。
内存上,图像是行主序连续存放的:第 0 行的所有像素、接着第 1 行的所有像素......所以按行遍历比按列遍历快得多(缓存友好),这在实时 SLAM 里不是小事。
3.2 三种常见图像类型
灰度图 :每像素 1 字节,CV_8UC1。
深度图 :每像素 2 字节无符号整数(unsigned short,CV_16UC1),单位通常是毫米,最大能表示 65535 mm ≈ 65 m,足够了。TUM 数据集的深度图乘了一个因子 5000,即像素值除以 5000 才是以米为单位的深度------读数据集时一定要查它的缩放因子。
彩色图 :每像素 3 字节,分别是三个颜色通道。OpenCV 默认通道顺序是 B、G、R ,不是 RGB------这是历史遗留,和大多数其他库相反。CV_8UC3。用 image.channels() 可以查通道数。
3.3 OpenCV 基本操作
cv::Mat image = cv::imread(argv[1]);        // 读图,默认读成 BGR 三通道
if (image.data == nullptr) { /* 文件不存在 */ }
image.cols, image.rows, image.channels()    // 宽、高、通道数
cv::imshow("image", image);  cv::waitKey(0);
遍历像素的高效写法是用行指针:
for (size_t y = 0; y < image.rows; y++) {
    unsigned char *row_ptr = image.ptr<unsigned char>(y);   // 第 y 行首地址
    for (size_t x = 0; x < image.cols; x++) {
        unsigned char *data_ptr = &row_ptr[x * image.channels()];
        for (int c = 0; c != image.channels(); c++) {
            unsigned char data = data_ptr[c];   // 第 (y,x) 像素第 c 通道
        }
    }
}
书里实测遍历一张 640×480 彩色图大约 10 ms 量级(取决于机器和优化等级),这是写实时视觉程序时要心里有数的基准。
cv::Mat 的拷贝陷阱 :cv::Mat image_another = image; 不会 复制图像数据,两个变量指向同一块内存,改一个另一个也变。这是 OpenCV 为了避免大数组频繁拷贝的刻意设计(引用计数)。要真的复制必须用 image.clone()。这个坑和 Eigen "矩阵赋值就是深拷贝"的行为正好相反,两个库混用时特别容易出错。
3.4 实践:手写去畸变
书的 5.3.2 节不用 OpenCV 的 cv::undistort,而是手写去畸变过程,目的是让读者亲手走一遍 1.6 节的公式。思路是反向映射:
-
新建一张和原图同样大小的空图,作为去畸变后的图;
-
对去畸变图的每一个像素 (u, v):
-
用内参变回归一化坐标:x = (u − cx)/fx,y = (v − cy)/fy;
-
用畸变模型算出它加上畸变后会在哪:x_d、y_d;
-
用内参变回像素:u_d = fx x_d + cx,v_d = fy y_d + cy;
-
去原图的 (u_d, v_d) 处取像素值(取整或双线性插值),填到去畸变图的 (u, v)。
-
为什么是"去畸变图的每个像素去原图找",而不是"原图的每个像素算它该去哪"?因为后者会在目标图上留下空洞(多个原像素映到同一处、有些位置没人映)。反向映射保证目标图每个像素都有值。这是图像几何变换的通用做法,后面光流和直接法的图像变形也是这样。
第四章 实践:从图像到三维
4.1 双目:从视差到点云
书的 5.4.1 节用一对双目图像(来自 KITTI 数据集,已校正)生成点云:
-
用
cv::StereoSGBM计算视差图。几个关键参数:minDisparity和numDisparities限定搜索范围(后者必须是 16 的倍数),blockSize是匹配窗口大小,P1、P2是平滑惩罚。参数需要按场景调,书给的一组是经验值。 -
SGBM 输出的视差是放大了 16 倍的定点数,要除以 16 转成浮点。
-
对每个视差有效(d > 0 且在范围内)的像素,先算深度 z = f b / d,再用 2.2 节的反投影公式得到 X、Y,与灰度一起存为一个点。
-
用 Pangolin 显示点云。
视差图里会有大片无效区域(黑色)------无纹理或遮挡处匹配不到。这是双目的常态,不是 bug。
4.2 RGB-D:多帧点云拼接
书的 5.4.2 节是整讲最接近 SLAM 的一个实践:有 5 对彩色图和深度图,以及每帧对应的相机位姿 T_wc(TUM 格式,四元数实部在后,用 Eigen::Isometry3d 或 Sophus::SE3d 存),把 5 帧的点云拼成一张全局地图。
对第 i 帧的每个像素 (u, v):
-
读深度 d = depth(v, u),为 0 表示无效,跳过;
-
相机系三维点:Z = d / 5000(TUM 缩放因子),X = (u − cx) Z / fx,Y = (v − cy) Z / fy;
-
变到世界系:P_w = T_wc,i · X, Y, Z;
-
取彩色图同位置的 BGR 值作为颜色,存入全局点云。
5 帧全部处理完,全局点云就是这五个视角拼起来的场景。这个实践的意义在于:它就是 SLAM 中"建图"那一环的最简版本------如果位姿是对的,点云就能严丝合缝地拼起来;如果位姿错了,墙会出现两层、桌子会错位。书给的位姿是真值,所以拼出来很干净;到了第 12 讲,位姿换成 SLAM 自己估计的,你就能直观地看到估计误差长什么样。
它也示范了"相机系 → 世界系"的方向:这里用的是 T_wc(相机到世界),因为我们手上是相机系的点、要去世界系。如果数据集给的是 T_cw,要先求逆。这是上一册 2.6 节的内容在实际代码里的样子。
第五章 预告:投影函数的雅可比
上一讲推出了"相机系三维点对位姿的导数":∂(T p)/∂δξ = I, −q\^(取前三行)。这一讲的投影函数提供了雅可比链条的另一半------像素坐标对相机系三维点的导数。
设相机系点 P = X, Y, Z(已去畸变,或假设无畸变),像素
u = fx X / Z + cx
v = fy Y / Z + cy
对 X、Y、Z 分别求偏导(注意 Z 在分母上):
                    ┌  fx/Z     0     −fx X/Z² ┐
  ∂[u, v] / ∂P  =   │                          │     (2×3)
                    └   0      fy/Z   −fy Y/Z² ┘
把它和上一讲的 3×6 矩阵 I, −P\^(P 对 δξ 的导数,取前三行)链式相乘,就得到像素对位姿的 2×6 雅可比:
∂[u, v] / ∂δξ = ( ∂[u, v]/∂P ) · ( ∂P/∂δξ ) = (2×3) · (3×6) = 2×6这个 2×6 矩阵是第 7 讲 PnP 的 BA 解法和第 9 讲 BA 的核心,书会在 7.7.3 节把它完整写出来。这里先把它的来源说清楚:它是"投影"和"位姿变换"两步各自雅可比的乘积,前者来自这一讲,后者来自上一讲。
同样地,像素对路标点世界坐标 P_w 的导数是 (∂u, v/∂P) · R,因为 P = R P_w + t,∂P/∂P_w = R。这个 2×3 矩阵是 BA 里优化路标点时用的。
至此,视觉 SLAM 几何部分的全部构件都齐了:位姿(第 3 讲)、位姿的导数与更新(第 4 讲)、观测模型及其导数(第 5 讲)。下一讲(第 6 讲)讲优化器本身------有了残差和雅可比之后,高斯牛顿和 LM 怎么一步步把误差压下去。