本文面向正在落地 LLM 应用的工程师,系统梳理多 Agent 工作流的核心概念、编排模式、工程实践与常见陷阱。不堆砌概念,只讲能用起来的东西。
一、为什么需要多 Agent
单个 LLM Agent 能做的事情是有限的。当你开始用它做真正复杂的任务时,很快会遇到几个天花板:
- 上下文爆炸:一个任务既需要读大量资料、又需要分析、还需要产出,所有东西塞进一个上下文里,token 越用越贵,模型也开始「忘事」。
- 职责混杂:一个 Prompt 既要管调研、又要管写作、还要管审校,指令之间互相干扰,输出质量不稳定。
- 能力边界:有些任务天然需要「反思」「对比」「多角度审视」,单个模型自问自答的效果远不如多个独立视角互相质询。
- 可维护性差:巨型 Prompt 改一处牵动全身,难以测试和迭代。
多 Agent 的核心思想很朴素:像组织一个团队一样组织你的模型调用。把大任务拆成小角色,让每个 Agent 专注一件事,通过约定的方式通信、协作、交接。
二、核心概念
在开始写代码之前,先明确几个反复出现的术语:
| 概念 | 说明 |
|---|---|
| Agent | 一个有明确角色、目标、可用工具(或技能)和系统提示词的独立单元 |
| Orchestrator | 编排者,决定「谁在什么时候做什么」,可以是代码逻辑,也可以是一个 Agent |
| 共享状态 / 黑板 | Agent 之间交换信息的公共存储(内存、文件、数据库) |
| 工具 / 技能 | Agent 可调用的外部能力,如搜索、读写文件、执行代码、调用 API |
| 上下文传递 | 上一个 Agent 的产出如何变成下一个 Agent 的输入 |
| 终止条件 | 什么时候停止协作,避免无限循环 |
这些概念本身不复杂,真正决定成败的是如何组合。
三、五种常见编排模式
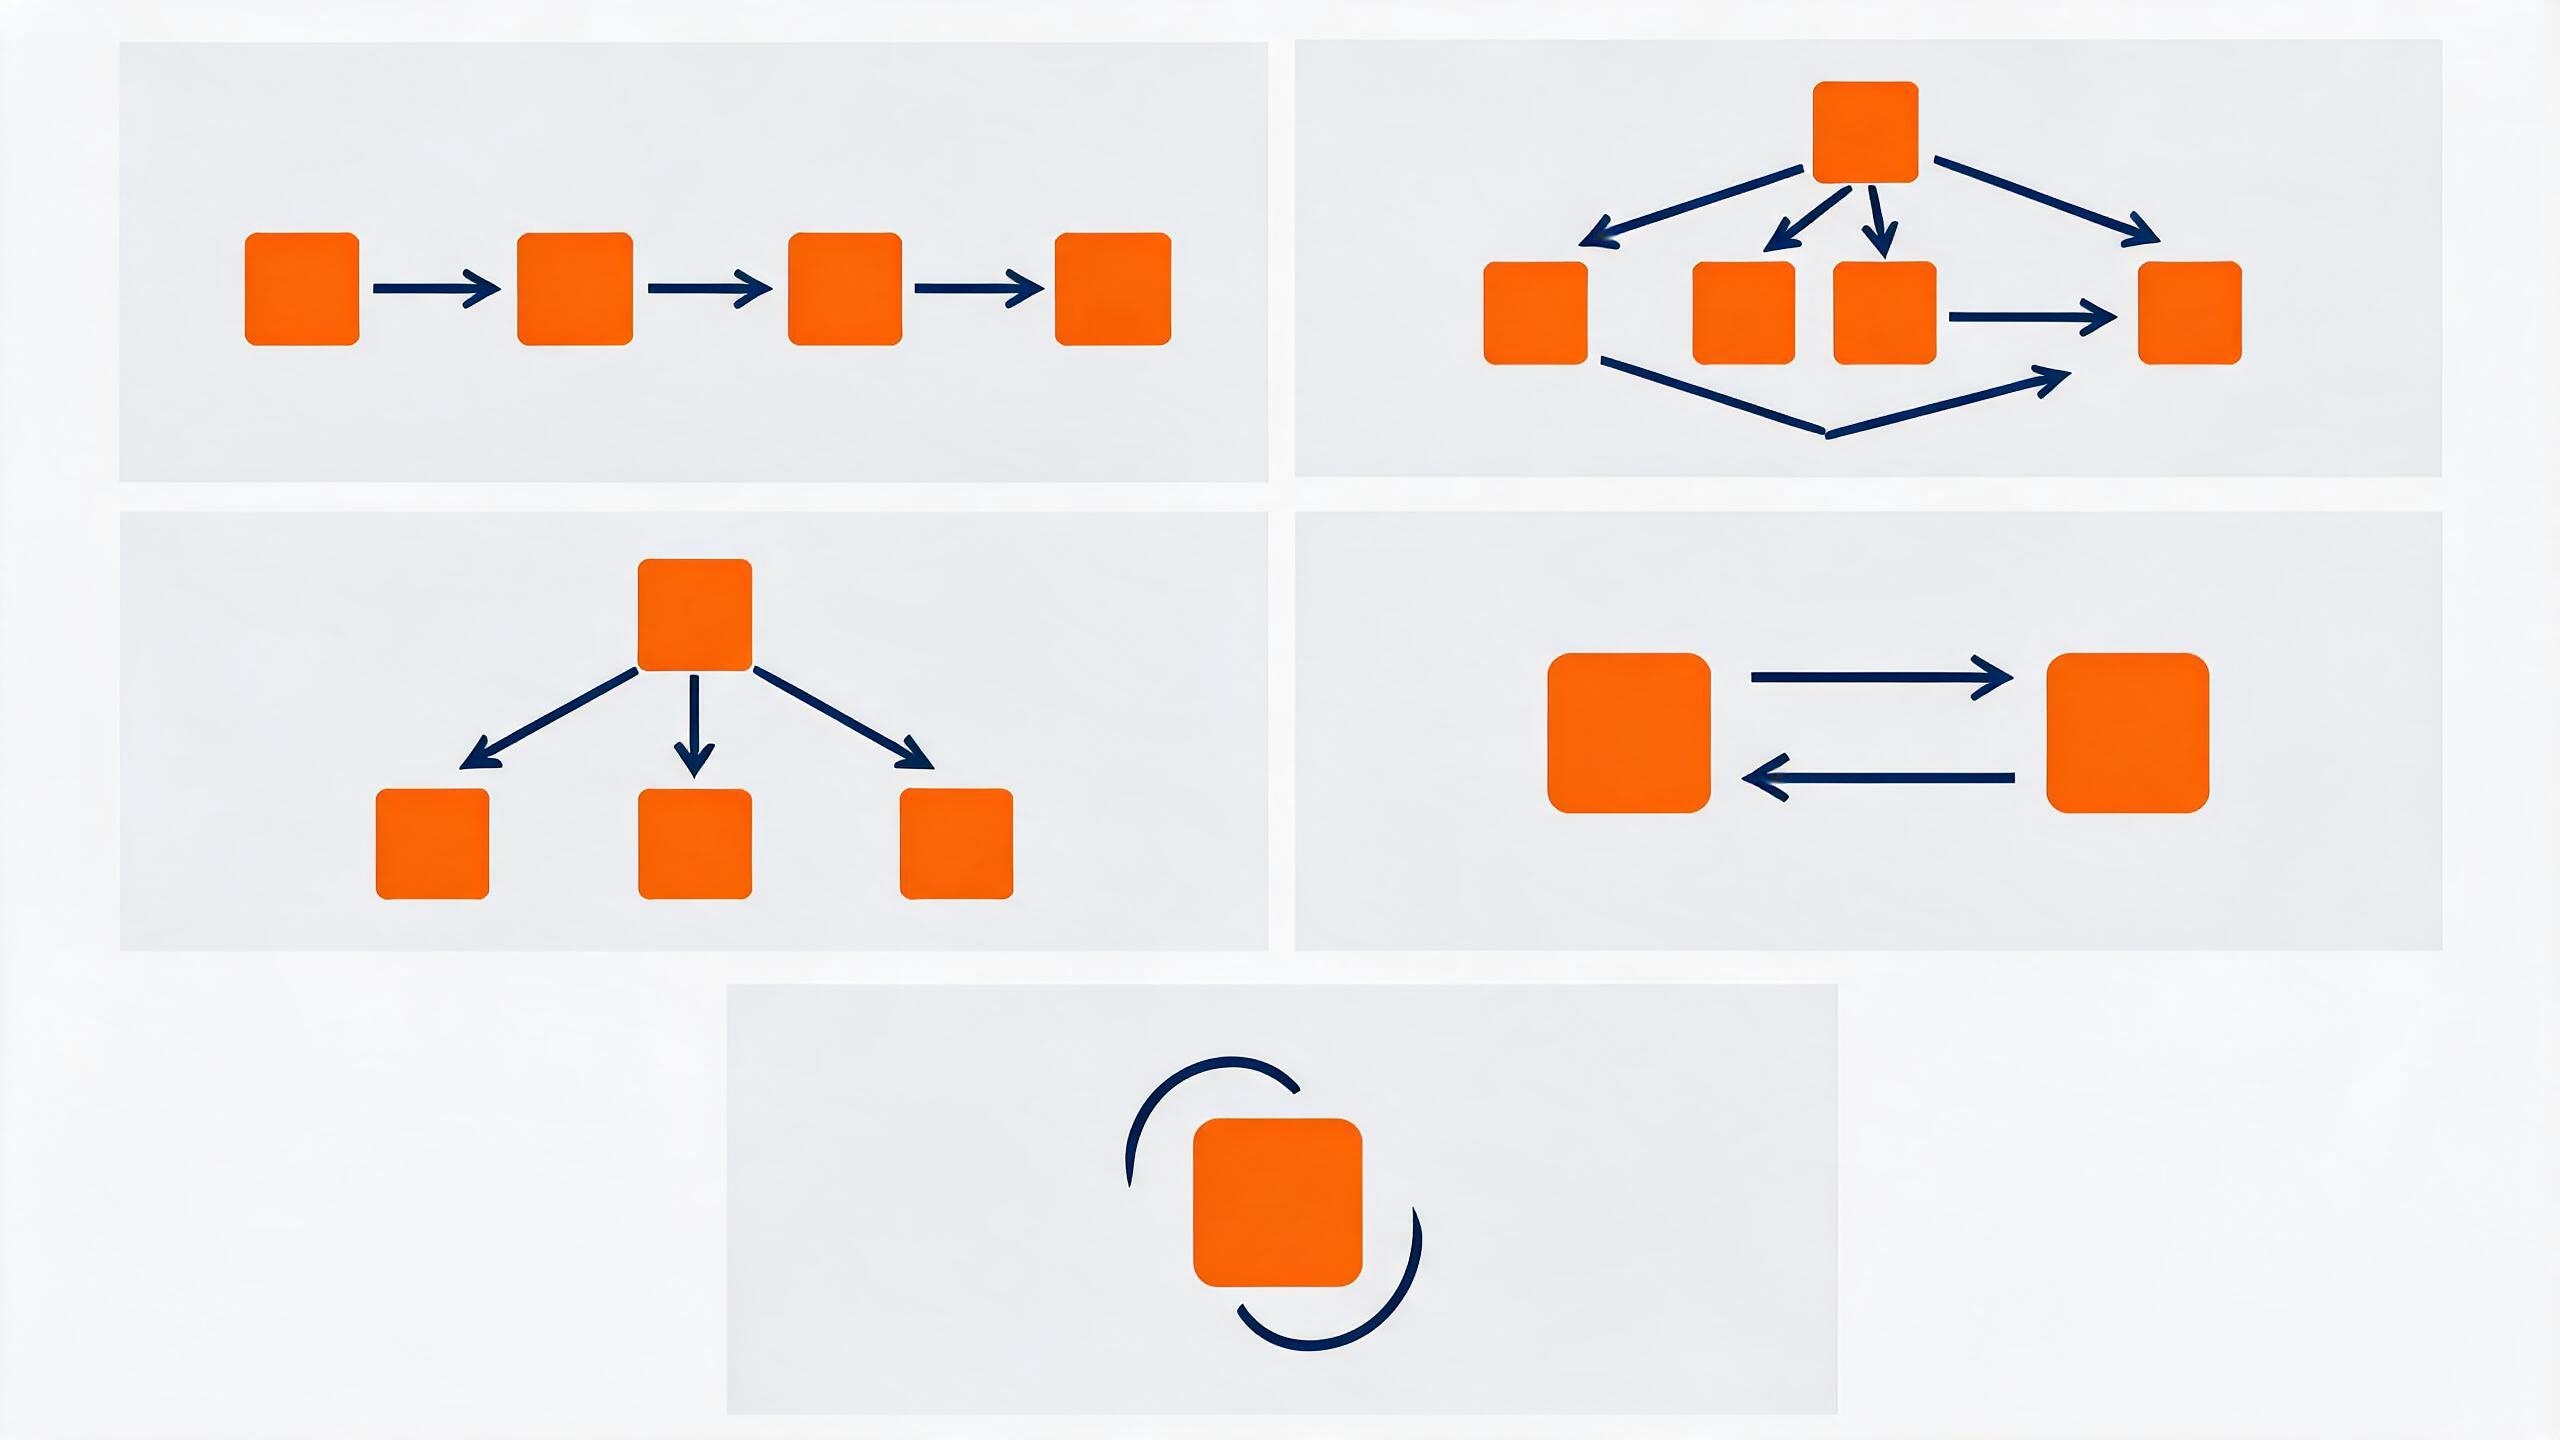
1. 顺序流水线(Sequential Pipeline)
最简单的模式:Agent A 的原始输出直接变成 Agent B 的输入,像流水线一样。
[ 撰写 ] → [ 审校 ] → [ 排版 ]适用场景 :任务可清晰分阶段,后一步强依赖前一步。
优点 :易实现、易调试、成本可控。
缺点:无法并行,错误会一路向下传递。
2. 并行分发(Parallel Fan-out)
把一个任务拆成多个互不依赖的子任务,同时分发,最后汇总。
           ┌─→ [调研 A]
[ 调度 ] ──┼─→ [调研 B]
           └─→ [调研 C]  ─→ [汇总]
适用场景 :信息收集、多角度分析、独立模块的并行生成。
优点 :速度快,天然适合多视角。
缺点:需要一个靠谱的「汇总者」,各分支质量参差不齐时需处理。
3. 层级监督(Hierarchical / Manager-Worker)
一个「管理者」Agent 负责任务分解、分配给「执行者」Agent,并审核结果。不满足要求就打回重做。
        [管理者]
        /  |  \
   [执行者1][执行者2][执行者3]
        \  |  /
      [结果汇总]
适用场景 :任务复杂、需要质量把关、子任务较多。
优点 :质量可控,有天然的「质检」环节。
缺点:层级越深,延迟和 token 成本越高。
4. 协作辩论(Collaborative Debate / Reflection)
多个 Agent 分别从不同立场表达观点,互相质询,最终由「仲裁者」给出结论。
[正方] ⇄ [反方]
   ↓ 汇总观点 ↓
[仲裁者 / 综合者]
适用场景 :方案选型、风险评估、需要对抗性思维的决策场景。
优点 :能显著减少「一言堂」的盲区。
缺点:成本高,容易陷入无意义的来回拉扯,必须有明确终止条件。
5. 迭代循环(Iterative Loop)
执行 → 检查 → 反馈 → 再执行,直到满足退出条件。
[生成] → [评分] → 达标? ──否──→ [反馈/修订] → [生成]
                    └──是──→ [输出]
适用场景 :代码生成、文案优化、任何「先出草稿再打磨」的任务。
优点 :质量收敛效果好。
缺点:循环次数必须设上限,否则烧钱又不见得更好。
实际项目中很少只用一种模式,通常是混合编排:外层是顺序流水线,某个环节内部用并行分发,生成环节再叠加迭代循环。
四、一个端到端实践案例
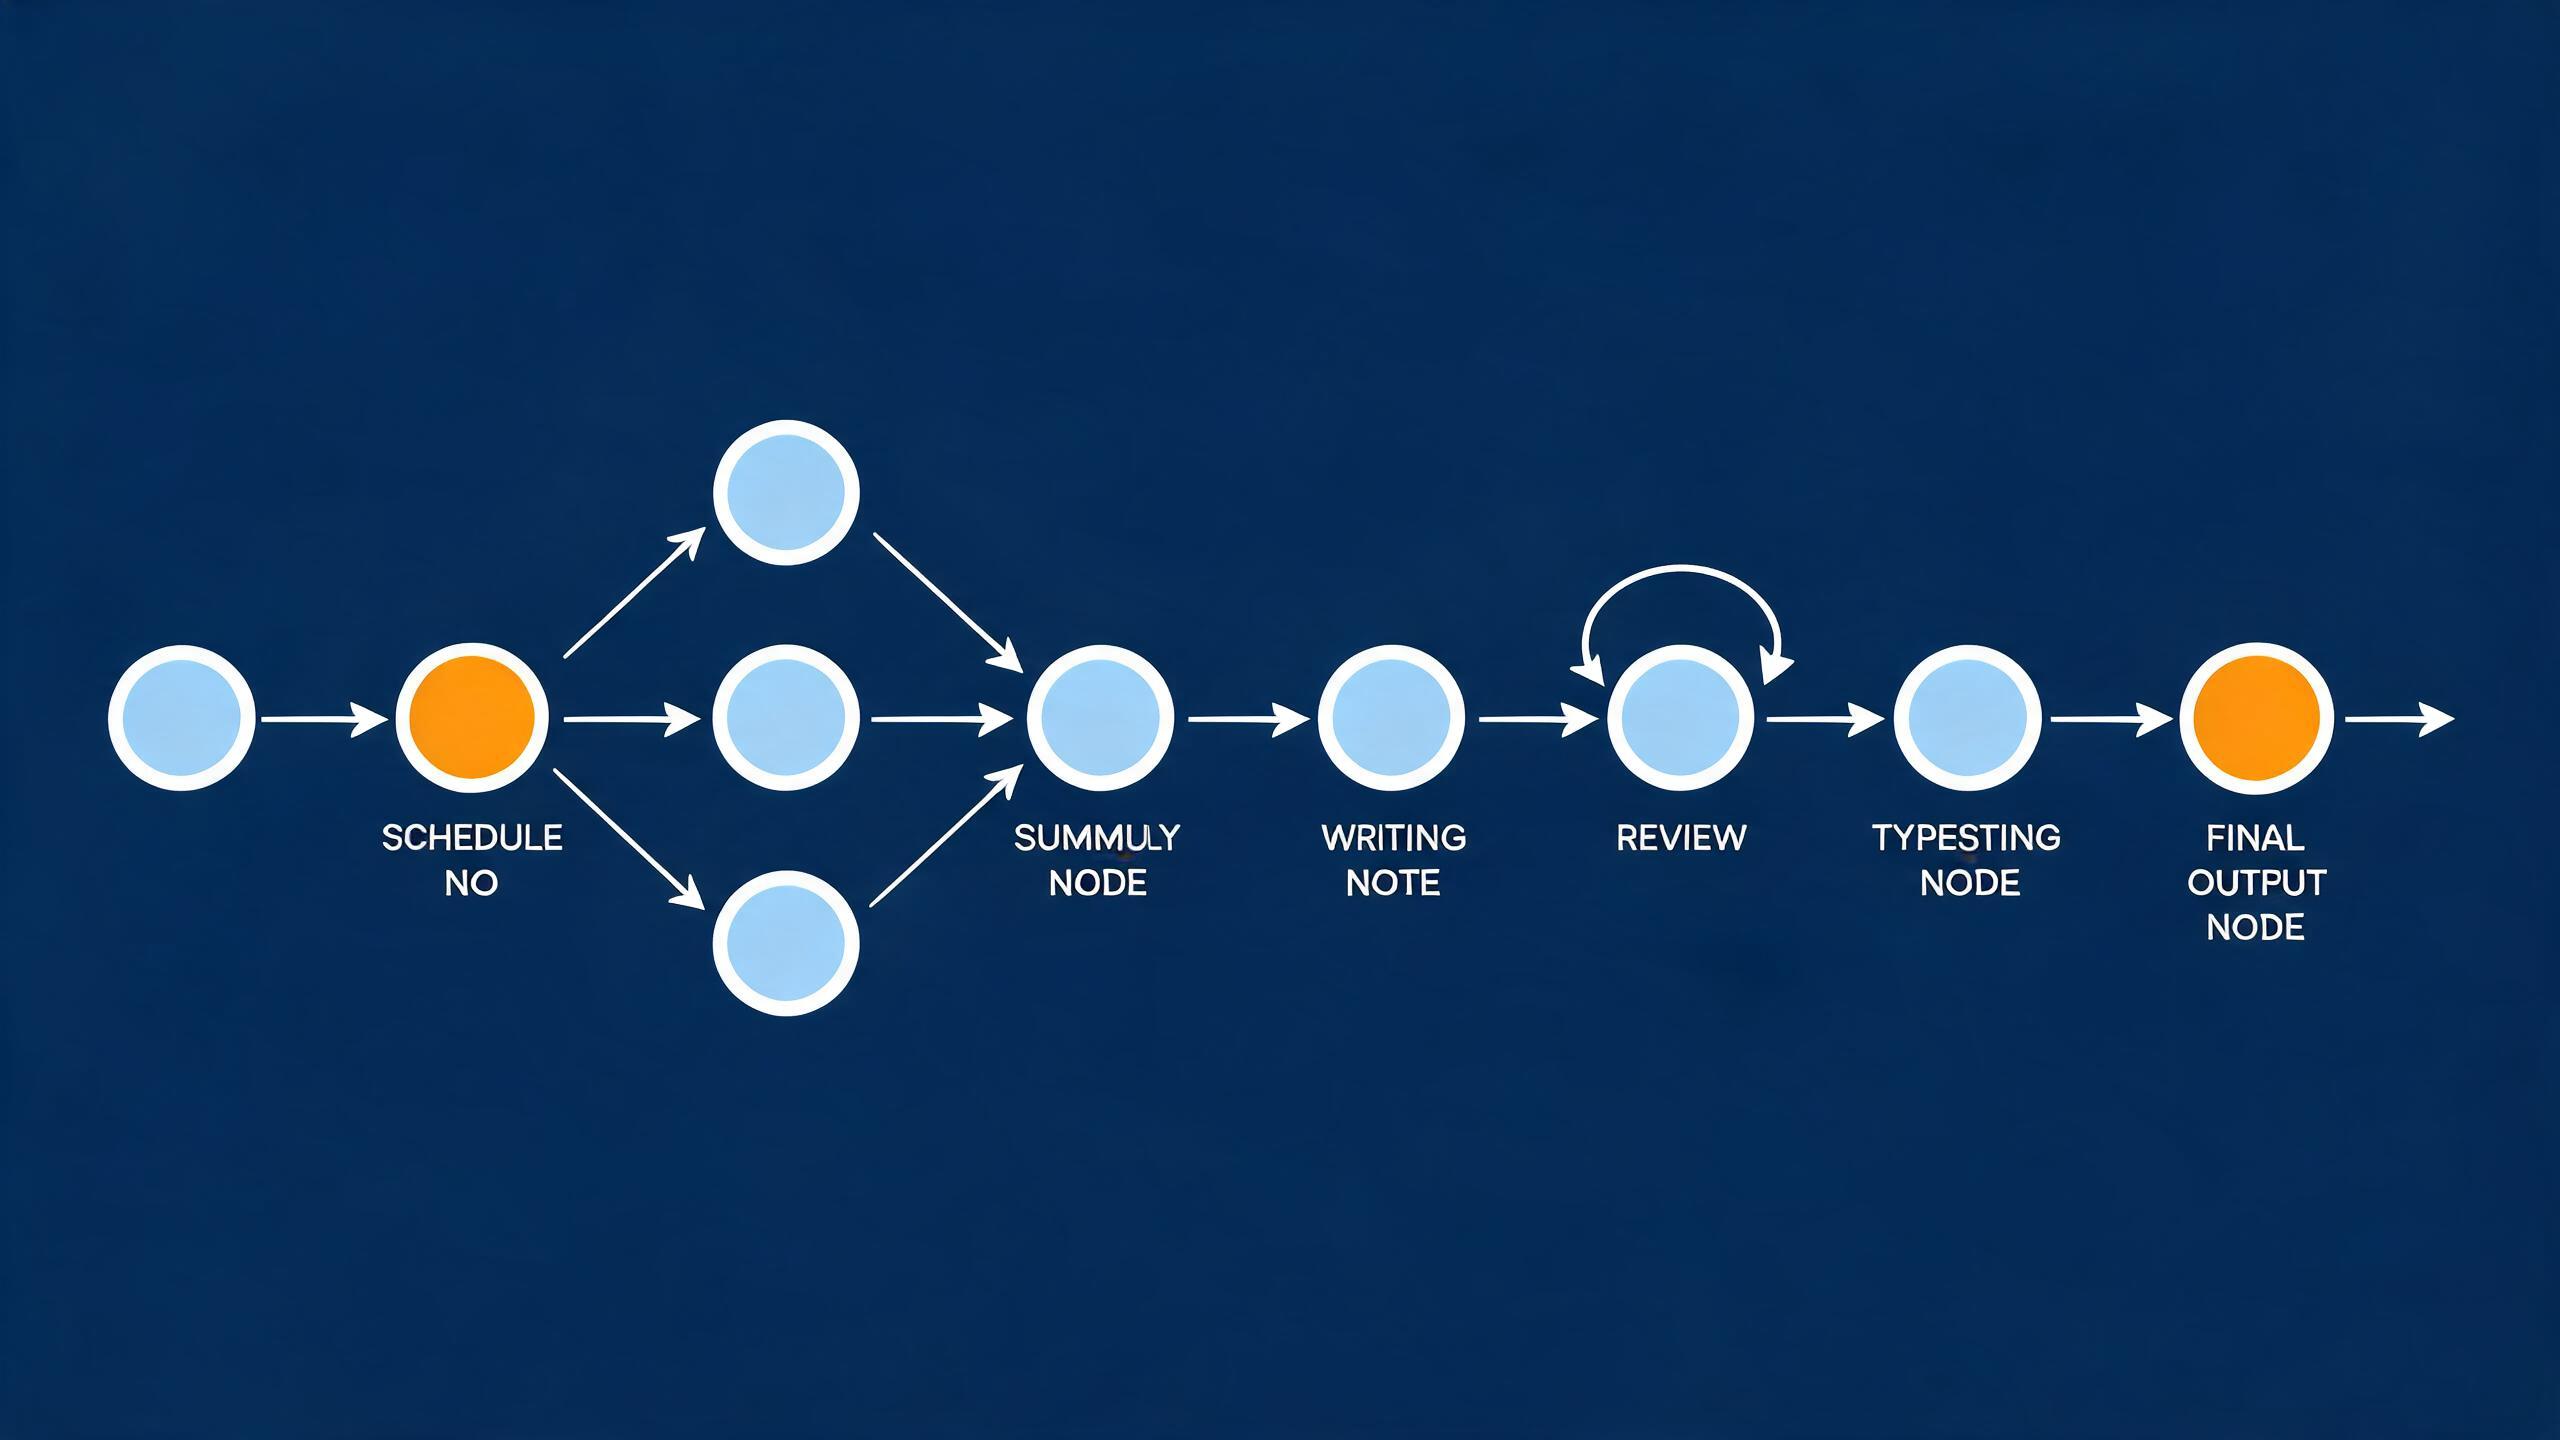
以一个「技术博客写作」任务为例,说明如何组合上述模式。
任务目标
根据给定主题,产出一篇结构完整、事实准确、可直接发布的博客文章。
编排设计
                    ┌─→ [信息调研 Agent]
[主题 & 大纲] → [调度] ─┼─→ [竞品/资料 Agent]  ─→ [汇总 Agent]
                    └─→ [案例搜集 Agent]           │
                                                  ↓
                         [撰写 Agent] ← [大纲 & 素材]
                              ↓
                    [审校/事实核对 Agent]
                              ↓ (不达标则回退)
                         [排版 Agent]
                              ↓
                          [最终输出]
关键实现要点
-
角色分离
- 调研 Agent:只负责「找信息和提炼」,提示词里禁止它写正文。
- 撰写 Agent:只负责「基于给定素材写作」,不负责扩搜索。
- 审校 Agent:只负责「挑毛病」,输出结构化的问题清单而不是改好的文章。
-
结构化交接
不要让 Agent 之间传「一大段自然语言」。用结构化数据交接:
json{ "outline": ["一、背景", "二、方案", "三、总结"], "facts": [ {"claim": "Python 3.12 发布", "source": "https://...", "confidence": 0.9} ], "requirements": "面向工程师,篇幅 2500 字,中文" } -
带「评分」的迭代终止条件
审校 Agent 不只输出意见,还要给一个
score(0--10)和blocking_issues列表。仅当score >= 8或迭代次数到达 3 次时才停止,避免无限返工。 -
事实核对的「证据约束」
要求审校 Agent 标出每个关键事实是否有来源支撑,未标注来源的断言默认降级为「作者观点」,防止模型一本正经地胡说。
成本与质量的平衡
实测经验:同样的写作任务,多 Agent 协作比单 Agent 一次生成,token 成本约高出 1.5--3 倍,但「事实错误率」和「结构散乱率」显著下降。多 Agent 不是免费的午餐,它买的是质量和可控性。
五、常见陷阱与对策
1. 上下文爆炸
现象 :层层传递时把历史对话全文转发,越往后 token 越贵。
对策:传递「提炼后的结构化结果」而非「原始对话」;长文档用摘要或索引,需要细节时再针对性检索。
2. 职责越权
现象 :撰写 Agent 偷偷把审校的活也干了,或审校 Agent 把文章重写一通。
对策:在系统提示词里明确「你只能做什么、禁止做什么」,并约定输出格式;必要时用代码层校验输出结构。
3. 错误级联
现象 :上游一个错误事实,下游全部基于它发挥,越错越离谱。
对策 :关键事实要求附带 source;下游 Agent 对上游输入做「可信度标注」而非全盘接受。
4. 无限循环 / 来回拉扯
现象 :两个 Agent 意见不合,陷入无限辩论。
对策:显式设置最大轮次;引入「仲裁者」一票终止;约定辩论新增信息量太低就强制结束。
5. 可观测性不足
现象 :出了问题不知道是哪个 Agent、哪一步错的。
对策:为每个 Agent 的输入/输出打日志;记录 token 消耗、耗时、迭代次数;给每一步一个唯一 ID。
六、工具与框架选型
| 工具/框架 | 特点 | 适合 |
|---|---|---|
| LangGraph | 图结构编排,状态管理清晰,支持循环与分支 | 需要精细控制流程的工程团队 |
| AutoGen | 多 Agent 对话天然内置,开箱即用 | 快速验证多 Agent 对话场景 |
| CrewAI | 角色化抽象(Agent/Task/Crew),易上手 | 中小项目、快速原型 |
| 自研编排 | 完全可控,无框架束缚 | 对流程与成本有极致要求的团队 |
选型的核心判断不是「哪个框架最火」,而是:你需要的是「对话式协作」还是「流程式编排」。前者适合 AutoGen 类,后者适合 LangGraph 或自研。
七、总结
多 Agent 工作流的价值,不在于「堆更多的模型」,而在于:
- 把复杂任务拆解成可管理、可测试的小单元;
- 用明确的角色和协议,取代含糊的巨型 Prompt;
- 用结构化的交接和显式的终止条件,换取工程上的可控性。
落地时记住几个原则:先从最简单的流水线开始 ,验证有效后再加并行和迭代;让交接结构化 ;给每个 Agent 划清边界 ;永远设置终止条件。
多 Agent 不是银弹,但当你把「团队协作的思维方式」用在模型编排上时,很多原本做不动的复杂任务,会突然变得可拆、可做、可交付。