目录
前言:
C++ STL 中的 map 与 set 是经典的关联式容器,底层基于红黑树实现,具备自动有序、高效查找的特性。set 负责元素的有序去重存储,map 维护键值对映射关系。掌握 map 与 set,能够高效解决数据检索、统计去重等常见编程问题。接下来我们就一起学习它们的接口、原理与使用场景。
一,序列式容器和关联式容器
前⾯我们已经接触过STL中的部分容器如:string、vector、list、deque、array、forward_list等,这 些容器统称为序列式容器 ,因为逻辑结构为线性序列的数据结构 ,两个位置存储的值之间⼀般没有紧 密的关联关系,⽐如交换⼀下,他依旧是序列式容器。顺序容器中的元素是按他们在容器中的存储位 置来顺序保存和访问的。
关联式容器也是⽤来存储数据的,与序列式容器不同的是,关联式容器逻辑结构通常是⾮线性结构, 两个位置有紧密的关联关系,交换⼀下,他的存储结构就被破坏了。顺序容器中的元素是按关键字来 保存和访问的。关联式容器有map/set系列有unordered_map /unordered_set系列。
本章节讲解的map和set底层是红⿊树,红⿊树是⼀颗平衡⼆叉搜索树**(左右均衡程度接近完全二叉树)** 。set是key搜索场景的结构, map是key/value搜索场景的结构。
二,set系列的使用
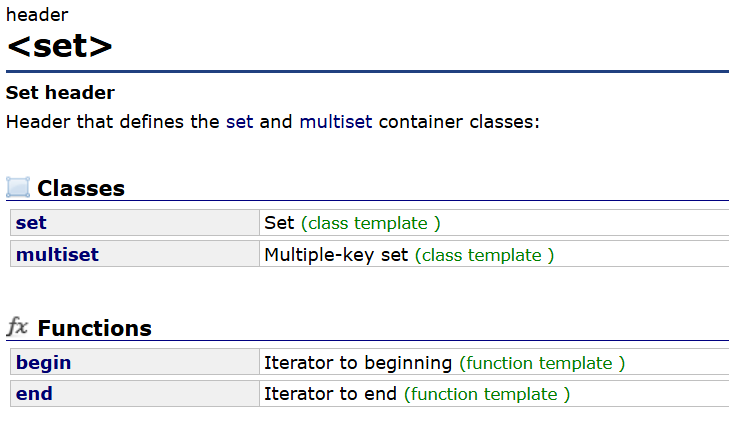
set和multiset参考⽂档
注意:set不允许冗余(没有重复数据),multiiset允许冗余(可以有重复数据)
set类的介绍
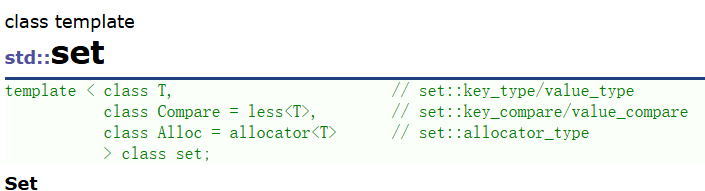
set的声明如下,T就是set底层关键字的类型。
set默认要求T⽀持⼩于⽐较,如果不⽀持或者想按⾃⼰的需求⾛可以⾃⾏实现仿函数传给第⼆个模 版参数。
set底层存储数据的内存是从空间配置器申请的,如果需要可以⾃⼰实现内存池,传给第三个参 数。
⼀般情况下,我们都不需要传后两个模版参数。
set底层是⽤红⿊树实现,增删查效率是 O(logN) ,迭代器遍历是⾛的搜索树的中序,所以是有序 的。
前⾯部分我们已经学习了vector/list等容器的使⽤,STL容器接⼝设计,⾼度相似,所以这⾥我们 就不再⼀个接⼝⼀个接⼝的介绍,⽽是直接带着⼤家看⽂档,挑⽐较重要的接⼝进⾏介绍。
set的构造
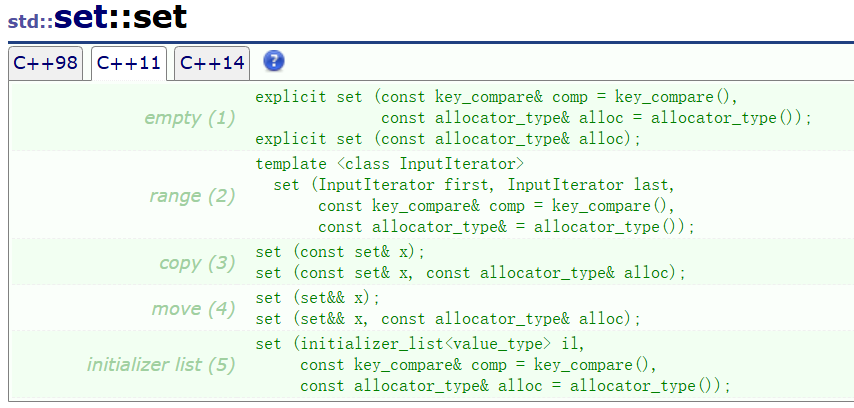
set的构造我们关注以下⼏个接⼝即可。
cpp
// empty (1)
⽆参默认构造

explicit set (const key_compare& comp = key_compare(),
const allocator_type& alloc = allocator_type());
// range (2)
迭代器区间构造

template <class InputIterator>
set (InputIterator first, InputIterator last,
const key_compare& comp = key_compare(),
const allocator_type& = allocator_type());
// copy (3)
拷⻉构造

set (const set& x);
// initializer list (5) initializer
列表构造

set (initializer_list<value_type> il,
const key_compare& comp = key_compare(),
const allocator_type& alloc = allocator_type())
set的迭代器
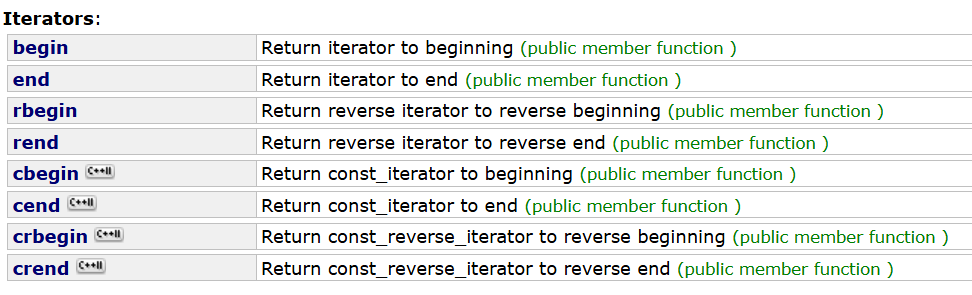
set是一个双向迭代器,看下图:

set的⽀持正向和反向迭代遍历 ,遍历默认按升序顺序 ,因为底层是⼆叉搜索树 ,迭代器遍历⾛的中 序; ⽀持迭代器就意味着**⽀持范围for** ,set的iterator和const_iterator都不⽀持迭代器修改数据,修改 关键字数据,破坏了底层搜索树的结构。
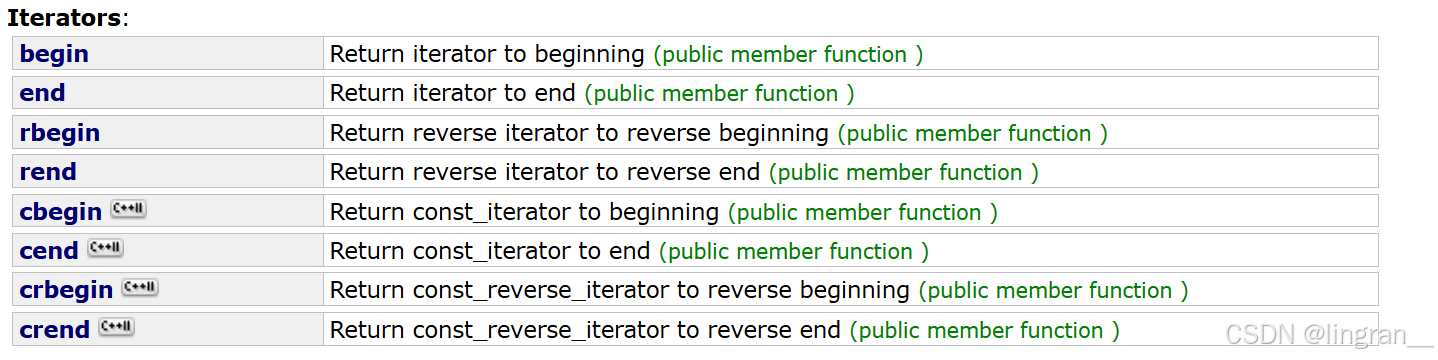
因为是双向迭代器,所以有begin和end还有rbegin和rend,如下图:
set的增删查
set的增删查关注(insert,find,erase)这⼏个接⼝即可:
cpp
Member types
key_type -> The first template parameter (T)
value_type -> The first template parameter (T)

// 单个数据插⼊,如果已经存在则插⼊失败
pair<iterator,bool> insert (const value_type& val);
// 列表插⼊,已经在容器中存在的值不会插⼊
void insert (initializer_list<value_type> il);
// 迭代器区间插⼊,已经在容器中存在的值不会插⼊
template <class InputIterator>
void insert (InputIterator first, InputIterator last);
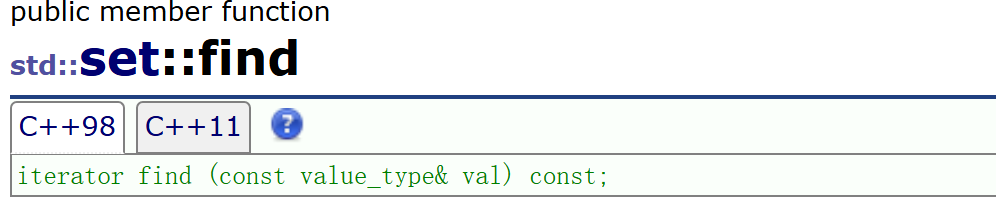
// 查找val,返回val所在的迭代器,没有找到返回end()
iterator find (const value_type& val);
// 查找val,返回Val的个数
size_type count (const value_type& val) const;
// 删除⼀个迭代器位置的值
iterator erase (const_iterator position);
// 删除val,val不存在返回0,存在返回1
size_type erase (const value_type& val);
// 删除⼀段迭代器区间的值
iterator erase (const_iterator first, const_iterator last);
// 返回⼤于等于val位置的迭代器
iterator lower_bound (const value_type& val) const;
// 返回⼤于val位置的迭代器
iterator upper_bound (const value_type& val) const;
insert和迭代器遍历使⽤样例
set的迭代器是一个双向迭代器,如下图

这里有个小技巧,在明显知道这个容器不是随机迭代器的情况下,只有看库函数有没有rbegin和rend就可以了,因为反向迭代器是正向迭代器封装的,有的话就是双向迭代器,没有的话就是单向迭代器
set迭代器支持正向和反向遍历,遍历默认按升序顺序,因为底层是二叉搜索树,迭代器遍历走的中序。支持迭代器就意味着支持范围for,set的iterator和const_iterator都不支持迭代器修改数据,修改关键字数据会破坏底层搜索树结构
find和erase使⽤样例
cpp
#include<iostream>
#include<set>
using namespace std;
int main()
{
	set<int> s = { 4,2,7,2,8,5,9 };
	for (auto e : s)
	{
		cout << e << " ";
	}
	cout << endl;
	// 删除最⼩值
	s.erase(s.begin());
	for (auto e : s)
	{
		cout << e << " ";
	}
	cout << endl;
	// 直接删除x
	int x;
	cin >> x;
	int num = s.erase(x);
	if (num == 0)
	{
		cout << x << "不存在!" << endl;
	}
	for (auto e : s)
	{
		cout << e << " ";
	}
	cout << endl;
	// 直接查找在利⽤迭代器删除x
	cin >> x;
	auto pos = s.find(x);
	if (pos != s.end())
	{
		s.erase(pos);
	}
	else
	{
		cout << x << "不存在!" << endl;
	}
	for (auto e : s)
	{
		cout << e << " ";
	}
	cout << endl;
	// 算法库的查找 O(N)
	auto pos1 = find(s.begin(), s.end(), x);
	// set⾃⾝实现的查找 O(logN)
	auto pos2 = s.find(x);
	// 利⽤count间接实现快速查找
	cin >> x;
	if (s.count(x))
	{
		cout << x << "在!" << endl;
	}
	else
	{
		cout << x << "不存在!" << endl;
	}
	return 0;
}
lower_bound和upper_bound应用实例
lower_bound找第一个 >= 目标值的元素位置。
upper_bound找第一个 > 目标值的元素位置。
lower_bound和upper_bound不是从头到尾找,而是通过搜索二叉树的规则来进行查找。
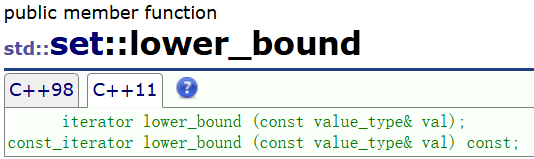
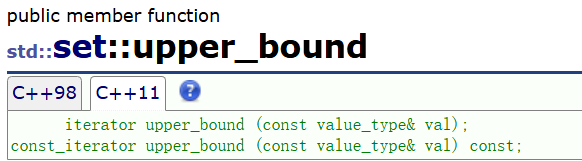
为什么需要设计一个都是大于的接口,而不是一大一小呢?
因为可以
[lower_bound, upper_bound)这个左闭右开区间,就是所有等于 val 的元素。
cpp
#include<iostream>
#include<set>
using namespace std;
int main()
{
	std::set<int> myset;
	for (int i = 1; i < 10; i++)
		myset.insert(i * 10); // 10 20 30 40 50 60 70 80 90
	for (auto e : myset)
	{
		cout << e << " ";
	}
	cout << endl;
	// 实现查找到的[itlow, itup)包含[30, 60]区间
	// 返回>= 30
		auto itlow = myset.lower_bound(30);
	// 返回> 60
		auto itup = myset.upper_bound(60);
	// 删除这段区间的值

			myset.erase(itlow, itup);
		for (auto e : myset)
		{
			cout << e << " ";
		}
		cout << endl;
		return 0;
}
三,map系列的使用
map和multimap参考文档
map类的介绍
map的声明如下,Key就是map底层关键字的类型 ,T是map底层value的类型 ,map默认要求Key⽀持 ⼩于⽐较 ,如果不⽀持或者需要的话可以⾃⾏实现仿函数传给第三个模版参数,map底层存储数据的 内存是从空间配置器申请的。⼀般情况下,我们都不需要传后两个模版参数。map底层是⽤红⿊树实 现,增删查改效率是,迭代器遍历是⾛的中序,所以是按key有序顺序遍历的。map内部成员指向的结构体的内部成员其实是pair类型的。
cpp
pair<const Key, T>
cpp
template < class Key,                                     // map::key_type
           class T,                                       // map::mapped_type
           class Compare = less<Key>,                     // map::key_compare
           class Alloc = allocator<pair<const Key,T> >    //
map::allocator_type
           > class map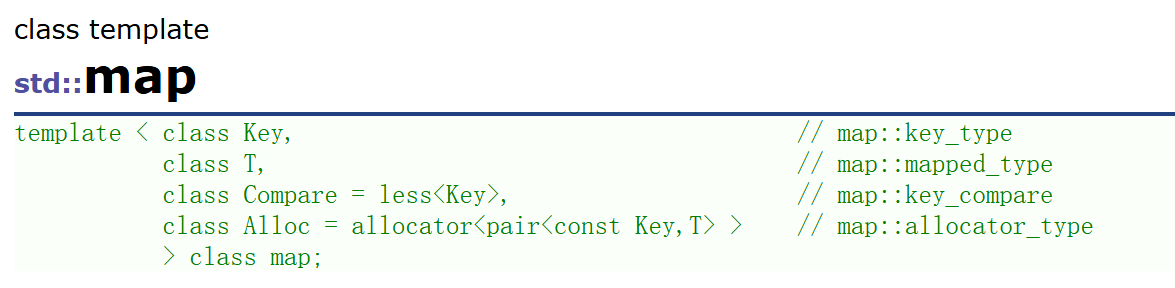
pair类型介绍
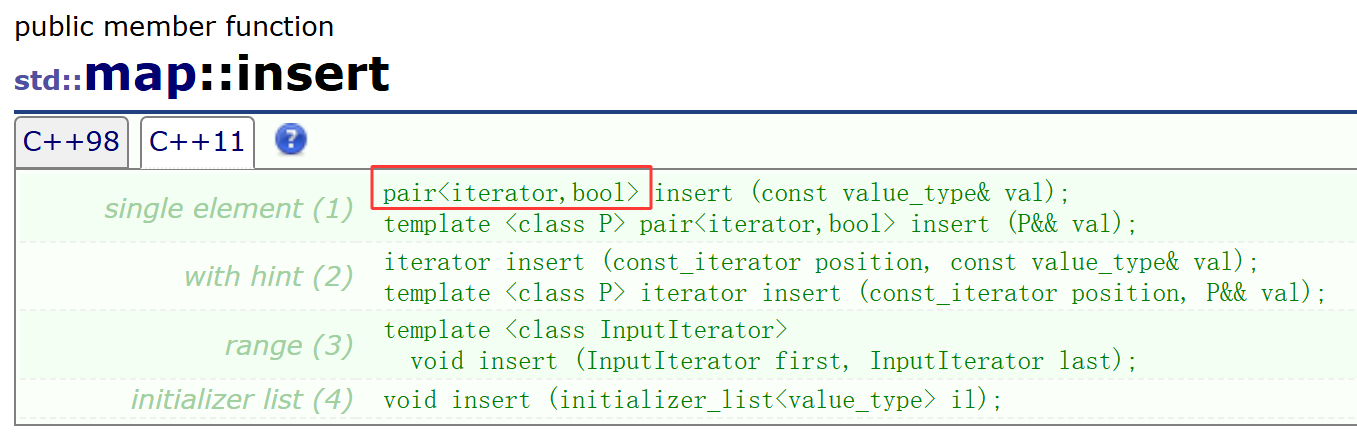
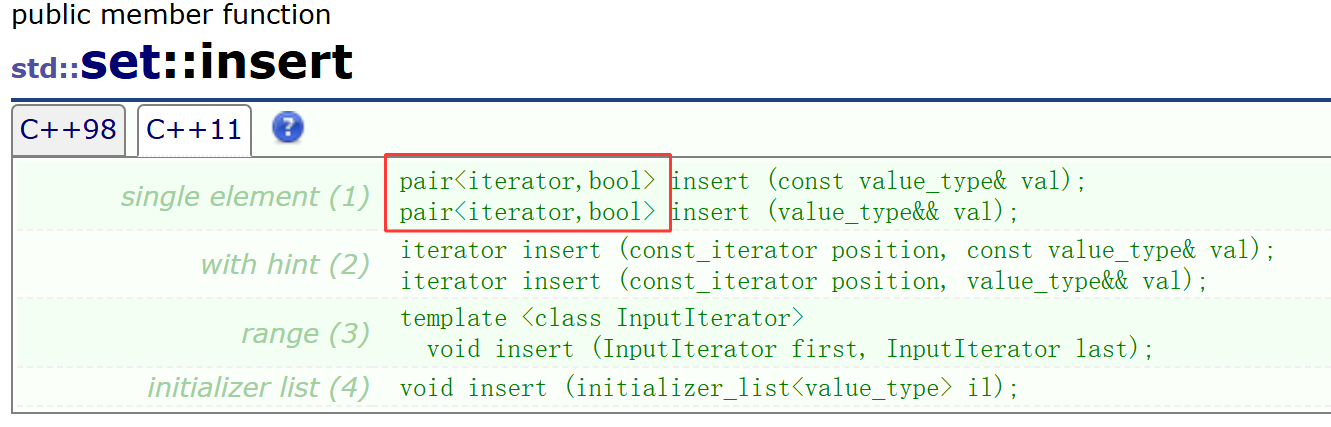
map和set的insert都会返回一个pair的东西,这里我来详细讲讲pair
map
set
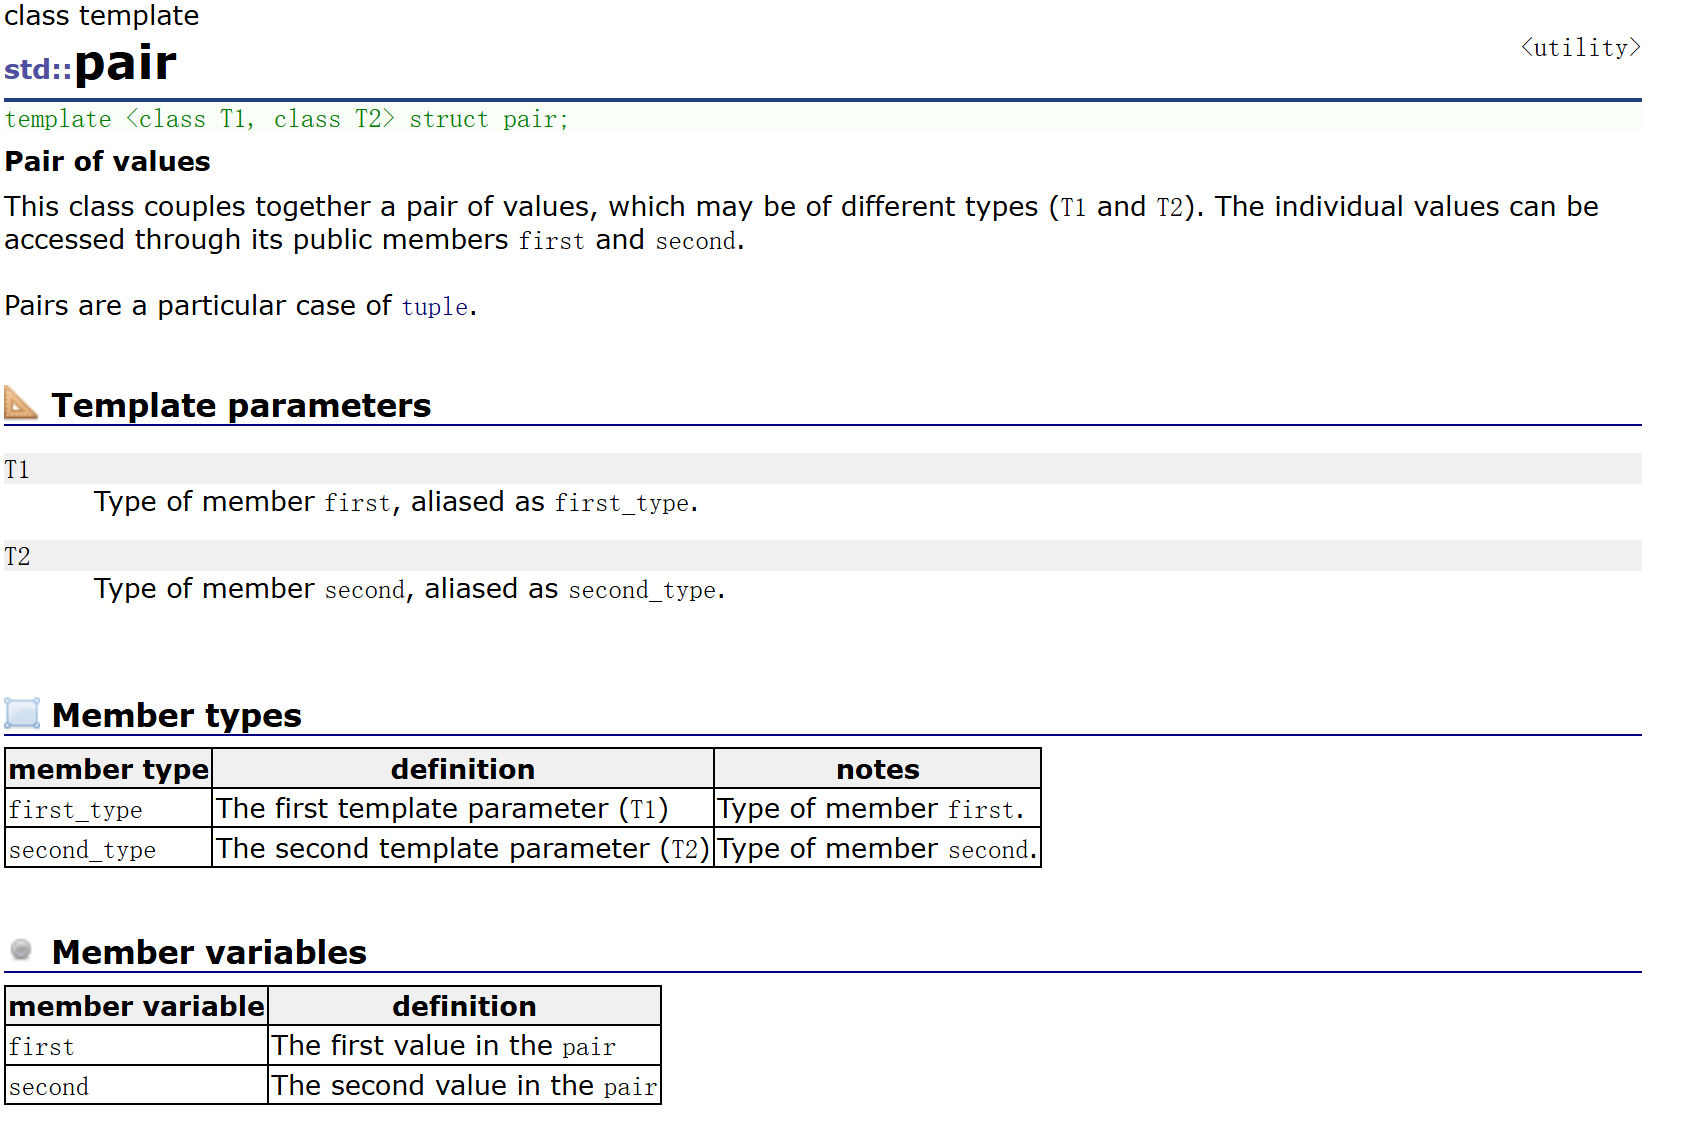
**pair就是个类模板,**他里面有俩个成员first和second,first就是T1类型,second就是T2类型。
pair链接:pair - C++ Reference
map
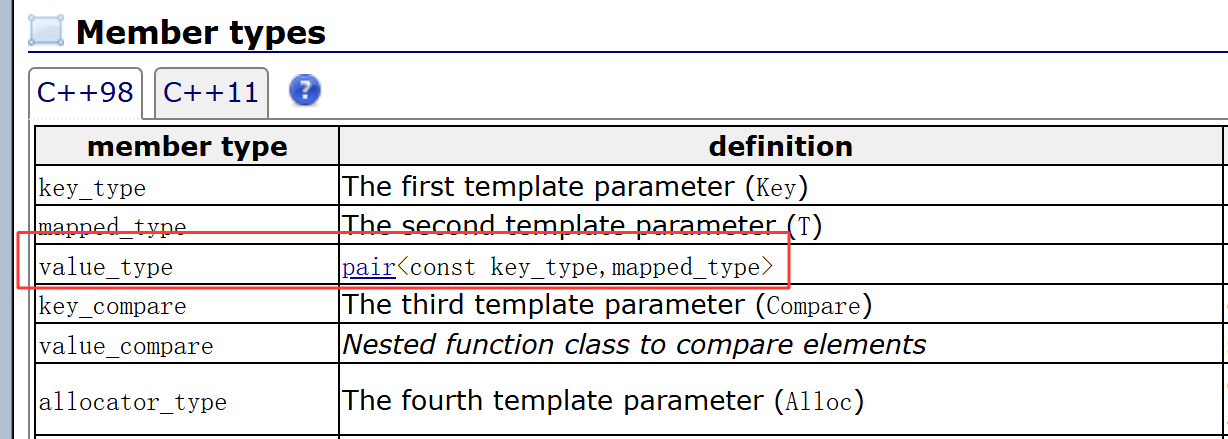
set
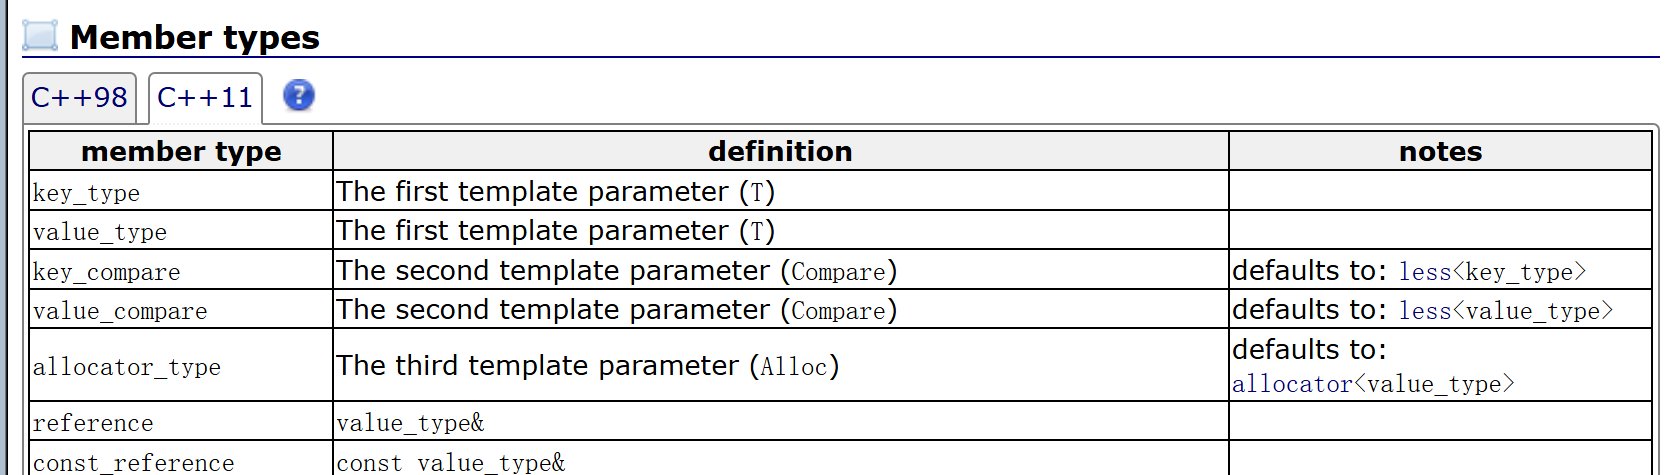
我这里把pair的底层扒出来了,我们来研究下,最上面一行是传过去的类型(set的key_type和value_type都是T类型(key),map的key_type是Key类型,value_type是pair类型),这也能看出map内部的成员指向的结构体的内部成员其实是pair类型的。
cpp
typedef pair<const Key, T> value_type;


template <class T1, class T2>
struct pair
{
	typedef T1 first_type;
	typedef T2 second_type;
	T1 first;
	T2 second;

	pair() : first(T1()), second(T2())
	{}

	pair(const T1& a, const T2& b) : first(a), second(b)
	{}

	template<class U, class V>
	pair(const pair<U, V>& pr) : first(pr.first), second(pr.second)
	{}
};
template <class T1, class T2>
inline pair<T1, T2> make_pair(T1 x, T2 y)
{
	return (pair<T1, T2>(x, y));
}
T1就是const Key,T2就是T,然后first就是const Key类型,second就是T类型,其实这就相当于是------我们先前在二叉搜索树部分实现的时候是给了俩个成员变量,他这里将俩个成员变量封装到了一个结构体里。
就这么简单,然后make_pair就相当于是通过调用这个函数自己构造一个对应的pair对象返回。
cpp
#include<map>

int main()
{
	//map<string, string> dict;
	map<string, string> dict = { {"left", "左边"}, {"right", "右边"}, {"insert", "插入"},{ "string", "字符串" } };

	//pair<string, string> kv1("first", "第一个");
	//map<string, string> dict = {kv1, pair<string, string>("second", "第二个")};

	pair<string, string> kv1("first", "第一个");
	dict.insert(kv1);

	dict.insert(pair<string, string>("second", "第二个"));

	dict.insert(make_pair("sort", "排序"));

	// C++11
	dict.insert({ "auto", "自动的" });


	return 0;
}
注意
pair是没有重载流插入流提取的
所以不可以使用之前的输入输出的方法,应该使用下面这两种,//部分是因为有operator->,将其展开了,"."与"->"的区别就不说了。
cpp
    map<string, string>::iterator it = dict.begin();
	while (it != dict.end())
	{

		cout << (*it).first <<":"<< (*it).second<< endl;
		cout << it->first << ":" << it->second << endl;
		//cout << it.operator->()->first << ":" << it.operator->()->second << endl;
		++it;
	}
	cout << endl;
key与value的改变对输出是有区别的,更新与value是没有关系的,只看key,key改变才会更新,否则不会。
cpp
// 插入时只看key,value不相等不会更新
	dict.insert({ "auto", "自动的xxxx" });
first是不可以修改的而second是可以修改的
因为first的底层是const
可以修改value,不支持修改key
cpp
pair<const key_type,mapped_type>
cpp
// 可以修改value,不支持修改key
		//it->first += 'x';
		it->second += 'x';
map的构造
map的构造我们关注以下⼏个接⼝即可。
map的⽀持正向和反向迭代遍历,遍历默认按key的升序顺序,因为底层是⼆叉搜索树,迭代器遍历⾛ 的中序;⽀持迭代器就意味着⽀持范围for,map⽀持修改value数据,不⽀持修改key数据,修改关键 字数据,破坏了底层搜索树的结构。
cpp
// 1.无参默认构造
explicit map (const key_compare& comp = key_compare(),
 const allocator_type& alloc = allocator_type());

// 2.迭代器区间构造
template <class InputIterator>
 map (InputIterator first, InputIterator last,
 const key_compare& comp = key_compare(),
 const allocator_type& = allocator_type());

// 3.拷贝构造
map (const map& x);

// 4.initializer_list初始化列表构造
map (initializer_list<value_type> il,
 const key_compare& comp = key_compare(),
 const allocator_type& alloc = allocator_type());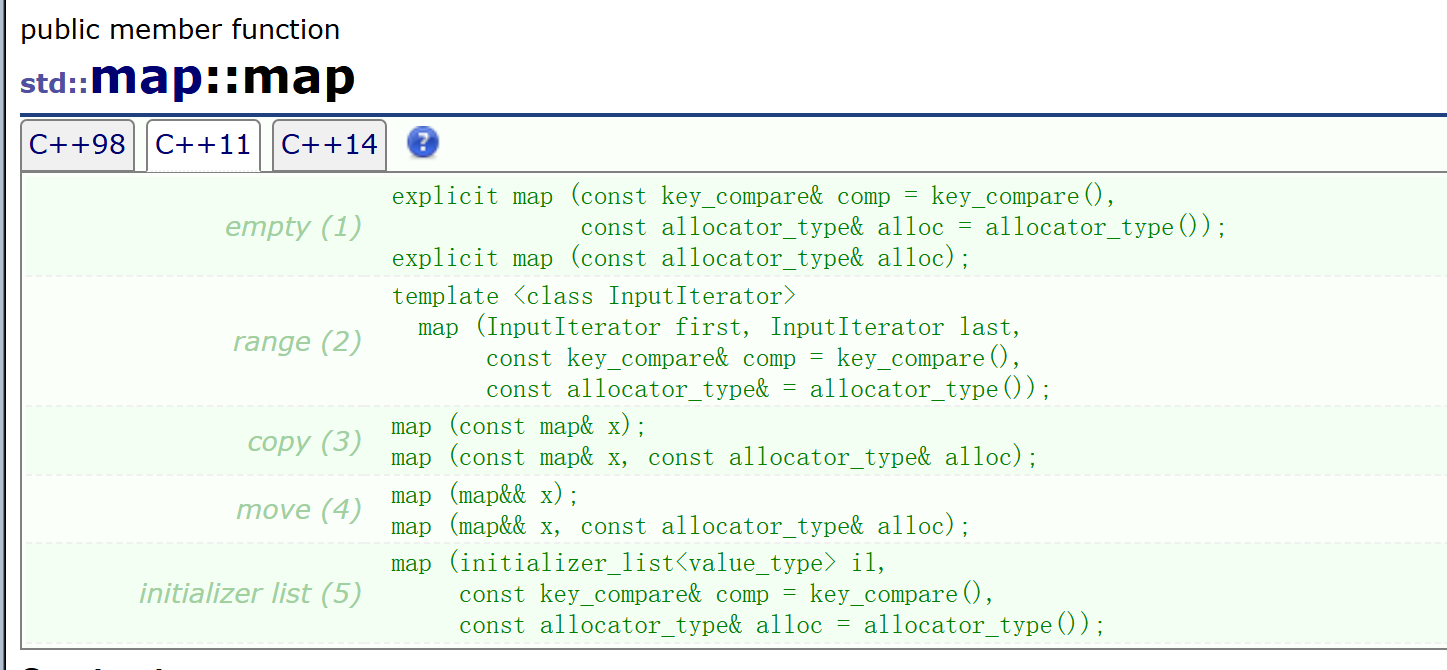

cpp
map<string, string> dict = { {"left", "左边"}, {"right", "右边"}, {"insert", "插入"},{ "string", "字符串" } };map 的迭代器属于双向迭代器。 迭代器指向的是节点的结构体,然后因为 * 重载,在这个函数的操作下,返回的是节点的结构体内部的 pair 成员
cpp
//正向迭代器
iterator begin();
iterator end();

//反向迭代器
reverse_iterator rbegin();
reverse_iterator rend();
map的增删查
map的增删查关注以下⼏个接⼝即可:
map增接⼝,插⼊的pair键值对数据,跟set所有不同,但是查和删的接⼝只⽤关键字key跟set是完全 类似的,不过find返回iterator,不仅仅可以确认key在不在,还找到key映射的value,同时通过迭代 还可以修改value。
cpp
// 单个数据插入,key已经存在则插入失败;即便key相同、value不同,同样插入失败
pair<iterator,bool> insert (const value_type& val);

// initializer_list列表插入,容器中已存在的key不会重复插入
void insert (initializer_list<value_type> il);

// 迭代器区间插入,容器中已存在的key不会重复插入
template <class InputIterator>
void insert (InputIterator first, InputIterator last);

// 根据key查找,找到返回对应迭代器,找不到返回end()
iterator find (const key_type& k);

// 统计key的个数,map中结果只能是0或者1
size_type count (const key_type& k) const;

// 删除迭代器指向位置的元素
iterator erase (const_iterator position);

// 根据key删除元素,不存在返回0,存在返回1
size_type erase (const key_type& k);

// 删除迭代器区间 [first, last) 内的所有元素
iterator erase (const_iterator first, const_iterator last);

// 返回第一个大于等于k的元素的迭代器
iterator lower_bound (const key_type& k);
const_iterator lower_bound (const key_type& k) const;

//返回k的迭代器区间(左闭右开)pair------主要用于multi版本
pair<const_iterator,const_iterator> equal_range (const key_type& k) const;
pair<iterator,iterator>             equal_range (const key_type& k);
map的数据修改
前面讲了可以修改value部分,但是不可以修改key部分,一旦修改 key,就会破坏底层红黑搜索树的有序结构。修改value可以使用find查找然后进行修改value部分,第二种是使用operator 进行修改,与第一种有区别,如果map中不存在修改的key部分,那么会会自动插入一个默认构造的键值对,而第一种不会。
operator 它不只是用来做修改,同时兼具插入、查找、修改多重能力,是一个复合功能接口。
成员类型回顾:
key_type:map 第一个模板参数 Key,关键字类型
mapped_type:map 第二个模板参数 T,映射值类型
value_type:pair<const key_type,mapped_type>,容器节点存储的元素类型
注意区分两个类型概念:
map 模板第二个参数 T 被 typedef 为mapped_type,也就是我们日常说的映射 value;
而value_type是红黑树节点内部存储的完整键值对类型:pair<const key_type, mapped_type>。 平时开发习惯依旧把 T 这个映射值叫做 value。
对 insert 返回值说明:单个元素版本返回一个 pair 对象。 pair::first是迭代器,指向新插入的元素,或者 map 中已经存在的等价 key 的元素; pair::second为 true 代表成功插入新元素;false 代表 key 已存在,插入失败。
拆解 insert 的返回:
如果 map 中已经存在该 key:插入失败。返回pair<iterator,bool>,first指向原有 key 节点的迭代器,second为false。
如果 map 中不存在该 key:插入成功。返回pair<iterator,bool>,first指向新插入节点的迭代器,second为true。
无论插入成功还是失败,返回 pair 的 first 永远指向这个 key 对应的节点迭代器。 正是这个特性,让 insert 可以实现operator\[\]的底层逻辑。
cpp
	map<string, string> dict;
	dict.insert(make_pair("sort", "排序"));

	// key不存在->插入 {"insert", string()}
	dict["insert"];

	// key不存在 -> 插入+修改
	dict["left"] = "左边";

	// key存在 -> 修改
	dict["left"] = "左边,剩余";

	// 查找, 确定key在才能这么用, 否则就是插入了
	cout << dict["left"] << endl;

	// 插入, 因为sort不在
	cout << dict["right"] << endl;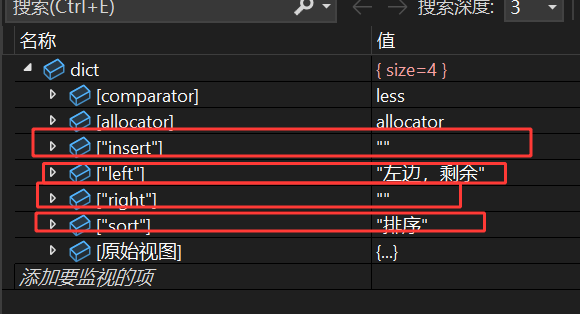
通过图片与代码方便理解operator 这个接口。
注意:
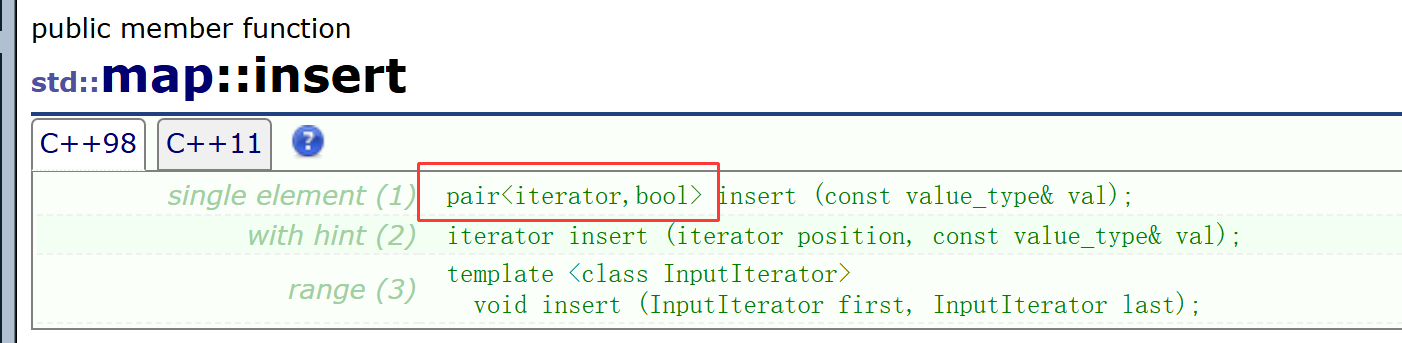
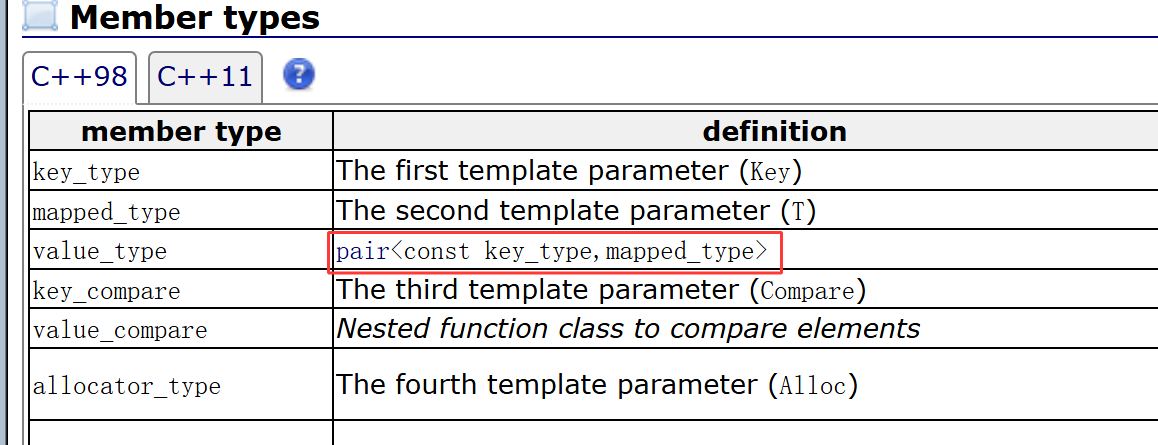
这里有两个不同的pair,
insert的pair的底层是:
有点难懂所以优化一下,如下:
cpp
mapped_type& operator[] (const key_type& k)
{
    // k不存在:insert插入k+mapped_type默认构造对象,返回新节点迭代器,返回value引用,支持后续修改
    // k存在:insert插入失败,但拿到原有key节点迭代器,返回value引用,完成查找修改
    pair<iterator, bool> ret = insert({ k, mapped_type() });
    iterator it = ret.first;
    return it->second;
}
重点:
key不存在,执行插入,以 key+value 默认值创建节点,返回 value 的引用,支持后续修改,实现【插入 + 修改】。
key存在,insert 插入失败,拿到原有节点迭代器,返回已有 value 的引用,实现【查找 + 修改】。
构造遍历及增删查使⽤样例
insert部分:
cpp
map<string, string>dict;
//1
pair<string, string>a("wxd", "666");
dict.insert(a);

//2
dict.insert(pair<string, string>("qyh", "sb"));

//3
dict.insert(make_pair("yfh", "sb"));

//4 C++11
dict.insert({ "sjc", "sb" });
需要注意的是,迭代器指向的是节点的地址,节点的结构体内部存着pair成员,*和->重载内部是对这个paiir成员的操作
cpp
#include<iostream>
#include<map>
using namespace std;


int main()
{
	// initializer_list构造及迭代遍历
	map<string, string> dict = { {"left", "左边"}, {"right", "右边"},
   {"insert", "插入"},{ "string", "字符串" } };

	//map<string, string>::iterator it = dict.begin();
	auto it = dict.begin();
	while (it != dict.end())
	{
		//cout << (*it).first <<":"<<(*it).second << endl;

		// map的迭代基本都使用operator->,这里省略了一个->
		// 第一个->是迭代器运算符重载,返回pair*,第二个箭头是结构指针解引用取pair数据
		//cout << it.operator->()->first << ":" << it.operator->()-> second << endl;
		cout << it->first << ":" << it->second << endl;
		++it;
	}
	cout << endl;
	// insert插入pair对象的4种方式,对比之下,最后一种最方便
	pair<string, string> kv1("first", "第一个");
	dict.insert(kv1);
	dict.insert(pair<string, string>("second", "第二个"));
	dict.insert(make_pair("sort", "排序"));//调用make_pair库函数
	dict.insert({ "auto", "自动的" });//C++11新增的,多参数隐式类型转换,C++98支持的是单参数隐式类型转换
	// "left"已经存在,插入失败
	dict.insert({ "left", "左边,剩余" });

	// 范围for遍历
	for (const auto& e : dict)
	{
		cout << e.first << ":" << e.second << endl;
	}
	cout << endl;

	string str;
	while (cin >> str)
	{
		auto ret = dict.find(str);
		if (ret != dict.end())
		{
			cout << "->" << ret->second << endl;
		}
		else
		{
			cout << "无此单词,请重新输入" << endl;
		}
	}

	// erase等接口跟set完全类似,这里就不演示讲解了
	return 0;
}
multimap和map的差异
multimap:multimap - C++ Reference
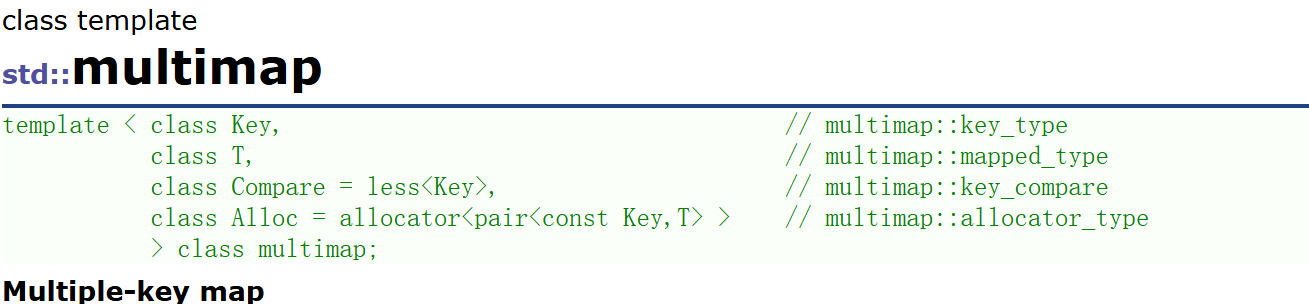
multimap与map的区别是multimap允许键值冗余,像set与multiset一样。
multimap与map的接口基本是一样的(没有operator )。
不支持operator 是因为不好实现,因为有多个相同的key,不好实现。
insert部分:
cpp
multimap<string, string>dict;

dict.insert({ "wxd","1" });
dict.insert({ "wxd","2" });
dict.insert({ "wxd","3" });
dict.insert({ "wxd","4" });
dict.insert({ "wxd","5" });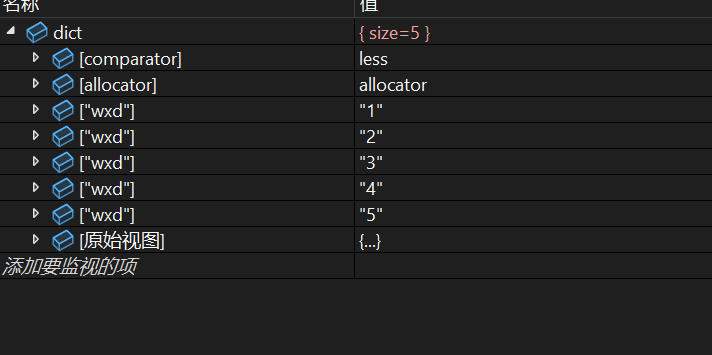
erase部分:
cpp
multimap<string, string>dict;

dict.insert({ "wxd","1" });
dict.insert({ "wxd","2" });
dict.insert({ "wxd","3" });
dict.insert({ "wxd","4" });
dict.insert({ "wxd","5" });

dict.erase("wxd");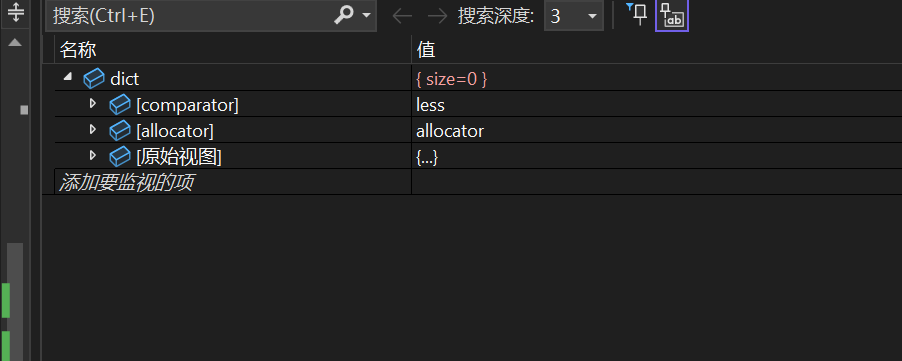
使用erase删除wxd部分,会将所有的wxd部分全部删除。
结语:
希望可以给你提供帮助,谢谢观看!!!