第1题:位运算------& 和 | 到底在计算什么?
正确答案:C(8)
1. 题目内容
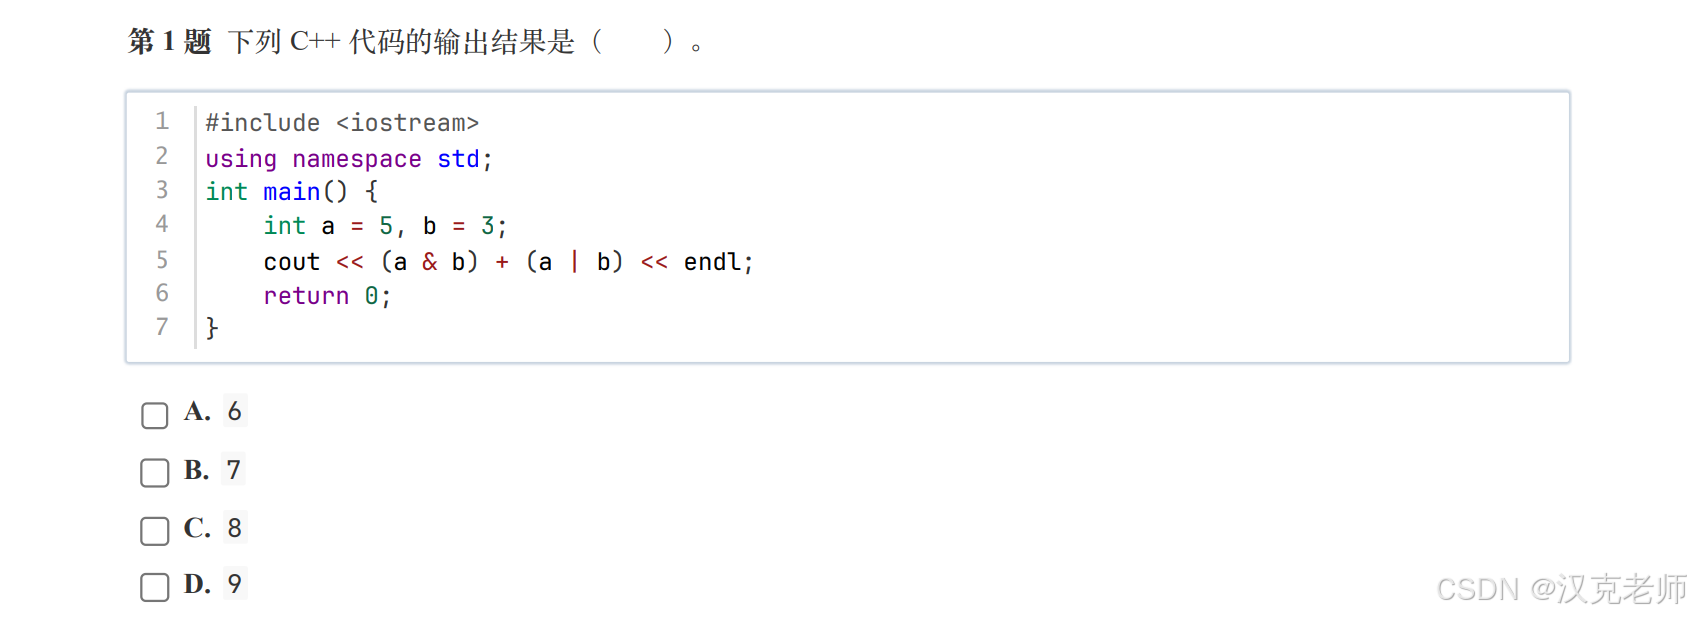
给出下面的 C++ 程序:
#include <iostream>
using namespace std;

int main() {
    int a = 5, b = 3;
    cout << (a & b) + (a | b) << endl;
    return 0;
}
问:程序最后输出什么?
选项:
-
A. 6
-
B. 7
-
C. 8
-
D. 9
2. 先理解:计算机为什么喜欢二进制?
同学们,我们平时使用十进制数字,比如:
-
5
-
3
-
10
-
100
但是计算机内部更喜欢使用二进制,也就是只有两个数字:
0 和 1。
我们先把数字5和3转换成二进制。
| 十进制 | 二进制 |
|---|---|
| 5 | 0101 |
| 3 | 0011 |
这里为了方便观察,我们统一写成4位。
3. 第一个运算符:& 按位与
& 的名字叫作按位与(Bitwise AND)。
它的规则非常简单:
两个位置上的数字都为1,结果才是1,否则就是0。
我们来看一个小表格:
| 左边 | 右边 | 左边 & 右边 |
|---|---|---|
| 0 | 0 | 0 |
| 0 | 1 | 0 |
| 1 | 0 | 0 |
| 1 | 1 | 1 |
现在计算:
5 & 3把两个数字写成二进制:
  0101
& 0011
------
  0001
逐位观察:
| 位数 | 5 | 3 | 结果 |
|---|---|---|---|
| 第4位 | 0 | 0 | 0 |
| 第3位 | 1 | 0 | 0 |
| 第2位 | 0 | 1 | 0 |
| 第1位 | 1 | 1 | 1 |
所以:
5 & 3 = 1
4. 第二个运算符:| 按位或
| 的名字叫作按位或(Bitwise OR)。
它的规则是:
两个位置上,只要有一个是1,结果就是1。
| 左边 | 右边 | 左边 | 右边 |
|---|---|---|
| 0 | 0 | 0 |
| 0 | 1 | 1 |
| 1 | 0 | 1 |
| 1 | 1 | 1 |
现在计算:
5 | 3二进制计算:
  0101
| 0011
------
  0111
而二进制 0111 转换成十进制:
4 + 2 + 1 = 7
因此:
5 ∣ 3 = 7
5. 最后计算整个表达式
原来的表达式是:
(a & b) + (a | b)我们已经知道:
a & b = 1
a | b = 7
所以:
1 + 7 = 8
最终答案:C(8)
本题最重要的知识点
-
&:两个都是1,结果才是1。 -
|:两个只要有一个是1,结果就是1。 -
位运算是对二进制的每一位分别进行运算。
举一反三:
如果:
int a = 6, b = 3;
cout << (a & b) << endl;
cout << (a | b) << endl;
请同学们先自己计算,再用程序验证。
第2题:数学函数------cmath 中的函数究竟返回什么?
正确答案:D
1. 题目内容
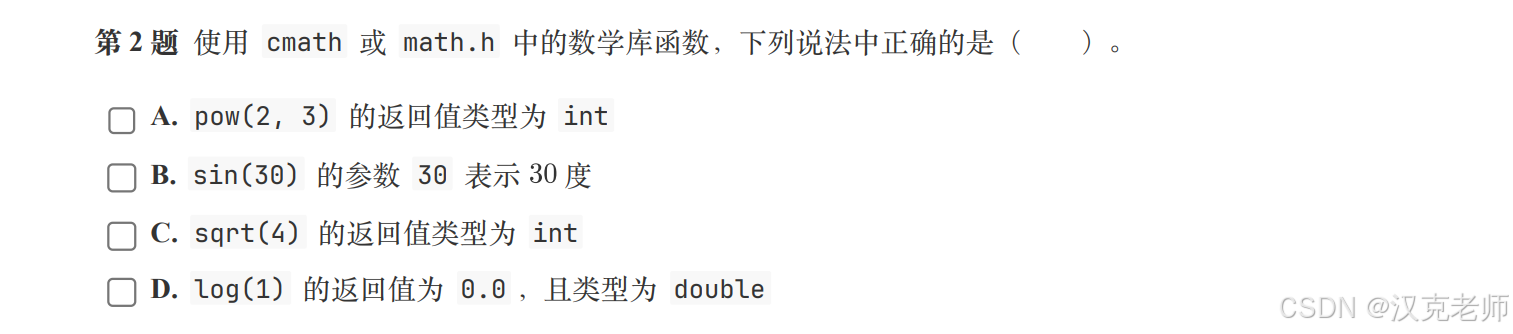
使用 cmath 或 math.h 中的数学库函数,下列说法正确的是:
A. pow(2, 3) 的返回值类型为 int
B. sin(30) 的参数30表示30度
C. sqrt(4) 的返回值类型为 int
D. log(1) 的返回值为 0.0,且类型为 double
这道题主要考查我们对 C++ 数学函数的理解。
2. 先认识四个数学函数
C++ 提供了很多数学工具,就像我们数学课上的计算器一样。
| 函数 | 数学意义 | 示例 |
|---|---|---|
pow(a,b) |
a 的 b 次方 | pow(2,3) |
sqrt(x) |
x 的平方根 | sqrt(4) |
sin(x) |
正弦函数 | sin(0) |
log(x) |
自然对数 | log(1) |
使用这些函数时,通常需要:
#include <cmath>3. 逐个分析选项
选项A:pow(2,3) 返回 int?
我们先算一下:
2 ^ 3 = 8
但是,pow() 函数的返回值类型是 double,而不是 int。
例如:
double x = pow(2, 3);
cout << x;
结果为:
8注意:虽然屏幕上显示8,但它的返回值类型仍然是 double。
所以A错误。
选项B:sin(30) 表示30度?
这里有一个非常容易出错的知识点!
C++ 的三角函数使用的是弧度制,不是角度制。
我们知道:
180∘ = π (弧度)
因此:
30∘ = π / 6 (弧度)
如果想计算30度的正弦值,应该写:
#include <iostream>
#include <cmath>
using namespace std;

int main() {
    double x = sin(30.0 * acos(-1.0) / 180.0);
    cout << x << endl;
    return 0;
}
其中 acos(-1.0) 可以用来获得圆周率 π。
而:
sin(30)实际上计算的是30弧度的正弦值,并不是30度。
所以B错误。
选项C:sqrt(4) 返回 int?
我们知道:
但是:
sqrt(4)返回类型依然是 double。
也就是说,虽然计算结果是2,但类型不是 int。
例如:
double x = sqrt(4);所以C错误。
选项D:log(1) 返回0.0,类型为double?
我们先回忆一下自然对数:
因此:
double x = log(1);结果为:
0返回类型为 double。
所以D正确。
最终答案:D
七级考试需要记住:
-
pow()返回double。 -
sqrt()返回double。 -
sin()、cos()使用弧度制。 -
log()表示自然对数,log(1)=0。
课堂小练习:
下面四个表达式分别是多少?
pow(3, 2)
sqrt(25)
log(1)
sin(0)
答案分别是:
9.0
5.0
0.0
0.0
它们的返回类型都是 double。
第3题:哈夫曼树------出现次数少的字符,为什么编码更长?
正确答案:C(3)
1. 题目内容
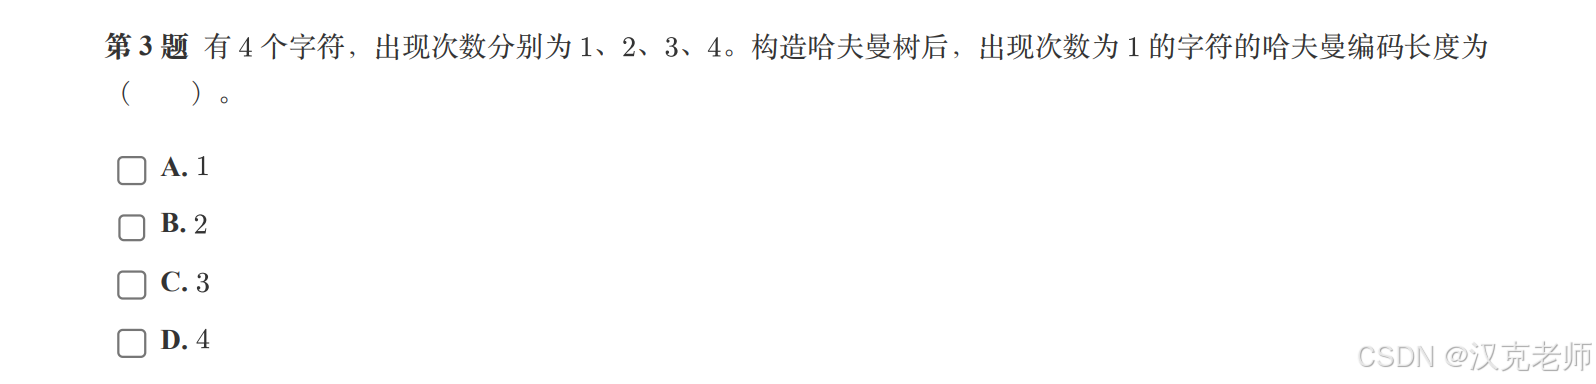
有4个字符,出现次数分别为:
1, 2, 3, 4
构造哈夫曼树后,出现次数为1的字符的哈夫曼编码长度是多少?
选项:
-
A. 1
-
B. 2
-
C. 3
-
D. 4
这道题考查的是哈夫曼树(Huffman Tree)。
2. 先讲一个故事:魔法王国的密码传递
假设有一个魔法王国,国王每天都要向四个村庄发送消息。
四个村庄收到消息的次数分别是:
| 村庄 | 收到消息次数 |
|---|---|
| A村 | 1次 |
| B村 | 2次 |
| C村 | 3次 |
| D村 | 4次 |
国王想设计一种二进制密码:
-
每个村庄对应一个编码。
-
编码只能使用0和1。
-
不同村庄的编码不能产生前缀冲突。
-
经常收到消息的村庄,最好使用短编码。
-
很少收到消息的村庄,可以使用长编码。
为什么呢?
因为经常发送的消息,如果每次都使用很长的编码,就会浪费很多空间。
这就是哈夫曼编码的核心思想:
出现频率越高的字符,通常越靠近树根;出现频率越低的字符,通常越靠近树叶。
3. 哈夫曼树的构造规则
请记住一个非常重要的口诀:
哈夫曼树口诀
每次选两个最小的,合并成一个新的,再放回去重新排序。
现在开始构造。
原始数据:
1 2 3 4第一步:选出最小的两个数。
最小的是1和2。
合并:
1 + 2 = 3
现在剩下:
3 3 4注意:这里的第一个3是新合并出来的节点,第二个3是原来出现次数为3的字符。
第二步:继续选出最小的两个数。
现在有:
3 3 4选择两个3:
3 + 3 = 6
剩下:
4 6第三步:继续合并。
4+6=10
最终得到一棵哈夫曼树。
4. 画出哈夫曼树
为了更清楚,我们把每次合并画成树:
                  10
                /    \
               6      4
             /   \
            3     3
          /  \
         1    2
现在观察频率为1的字符。
从根节点10出发,到达字符1:
10 → 6 → 3 → 1一共经过了3条边。
因此,它的哈夫曼编码长度就是:
5. 为什么不是4?
因为编码长度看的是从根节点到叶子节点经过的边数,而不是节点的数量。
例如:
根节点
  |
中间节点
  |
叶子节点
经过2条边,编码长度就是2,而不是3。
最终答案:C(3)
本题记忆: 哈夫曼树每次合并两个最小权值,某个字符的编码长度等于它在哈夫曼树中的深度。

第4题:排列组合------网格中一共有多少条不同的走法?
正确答案:B(35)
1. 题目内容
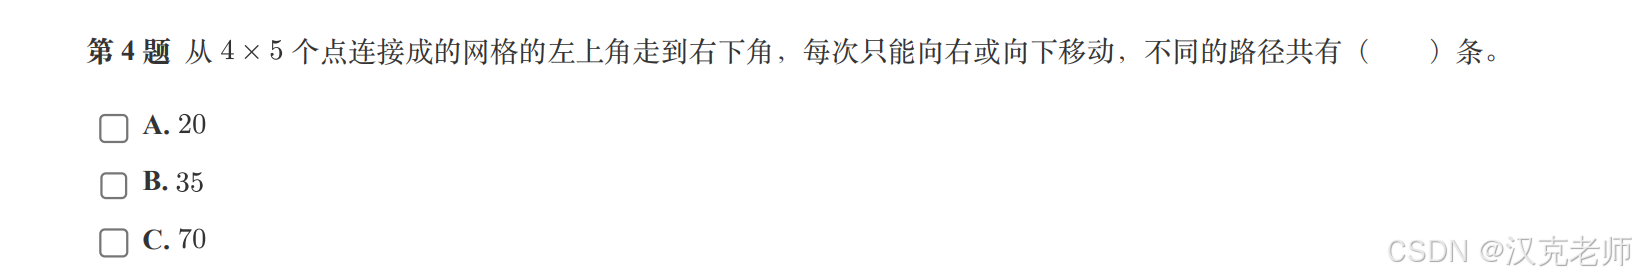
从一个 4×54\times54×5 个点连接成的网格的左上角走到右下角,每次只能向右或者向下移动。
问:不同的路径共有多少条?
选项:
-
A. 20
-
B. 35
-
C. 70
-
D. 126
2. 先看懂网格
这里有一个非常容易出错的地方:
题目说的是:
4×5个点,而不是4×5个小方格!
我们把网格画出来:
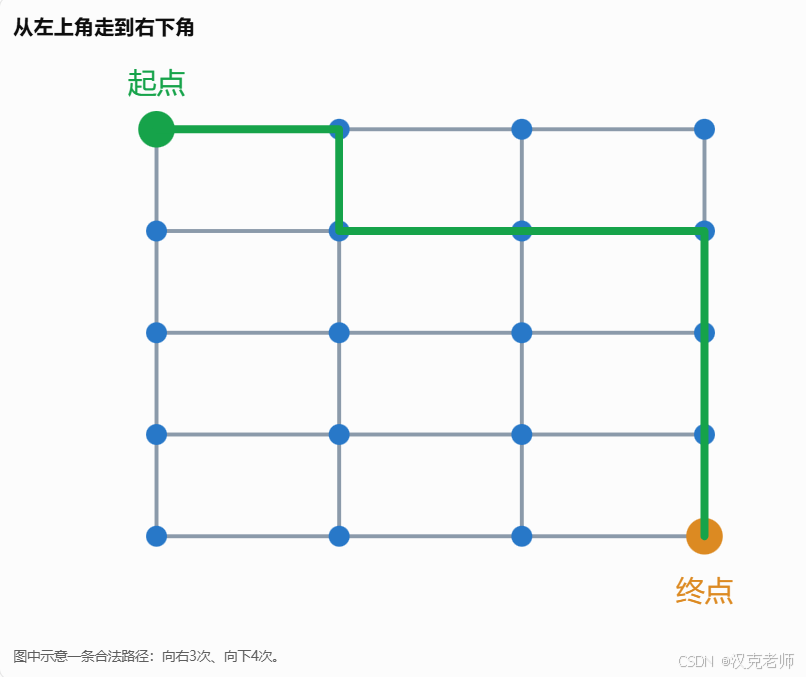
从最左上角到最右下角:
-
横向需要走4列之间的间隔,也就是向右3次。
-
纵向需要走5行之间的间隔,也就是向下4次。
所以,无论怎么走,必须完成:
3 + 4 = 7
一共7步。
3. 把走路问题变成排列问题
假设我们用:
-
R 表示向右走一步。
-
D 表示向下走一步。
那么一条合法路径就相当于排列下面7个字母:
R R R D D D D例如:
R R R D D D D
R D R D R D D
D D R R R D D
这些都是不同的走法。
问题变成:
7个位置中,选出3个位置放R,剩下4个位置自然放D,有多少种选择?
这就是组合数学中的组合数:
计算:
= 35
所以一共有35条不同路径。
4. 也可以使用动态规划理解
同学们也可以使用动态规划来解决。
设:
dpij
表示从起点走到第 i 行、第 j 列的不同路径数量。
每个位置只能从两个方向到达:
-
上面的格子向下走过来。
-
左边的格子向右走过来。
因此:
dpij = dpi−1j + dpij−1
边界条件:
dp11 = 1
我们得到下面的表格:
| 第1列 | 第2列 | 第3列 | 第4列 | |
|---|---|---|---|---|
| 第1行 | 1 | 1 | 1 | 1 |
| 第2行 | 1 | 2 | 3 | 4 |
| 第3行 | 1 | 3 | 6 | 10 |
| 第4行 | 1 | 4 | 10 | 20 |
| 第5行 | 1 | 5 | 15 | 35 |
这里表格是按4列、5行的点排列的。
右下角的答案就是35。
最终答案:B(35)
本题记忆点: 网格路径题,先数清楚必须向右几次、向下几次,再使用组合数,或者使用动态规划。
第5题:二叉搜索树------查找一个数需要多少时间?
正确答案:A
1. 题目内容
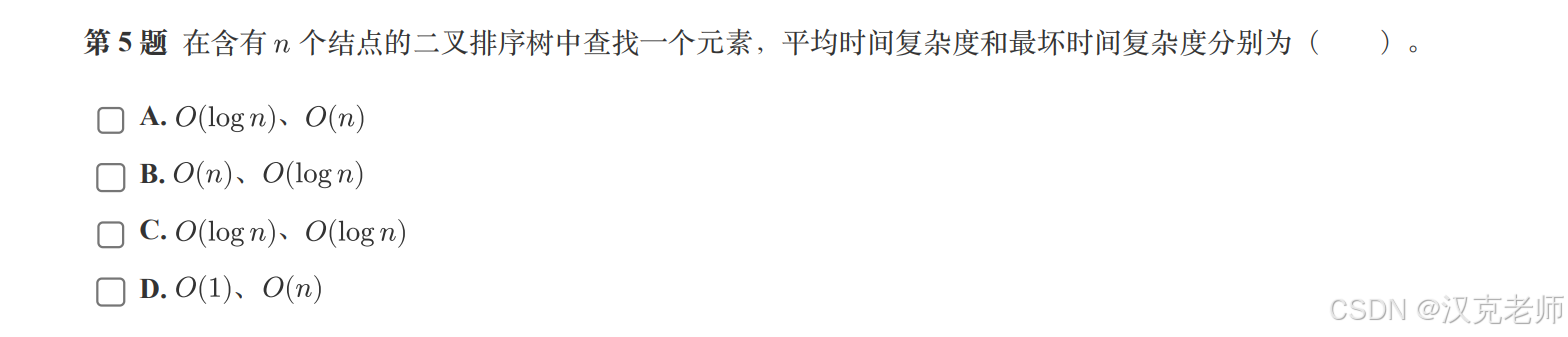
在含有 nnn 个结点的二叉排序树中查找一个元素,平均时间复杂度和最坏时间复杂度分别为:
A. O(logn),O(n)
B. O(n),O(logn)
C. O(logn),O(logn)
D. O(1),O(n)
这道题主要考查二叉搜索树(Binary Search Tree,简称BST)和时间复杂度。
2. 什么是二叉搜索树?
先讲一个故事。
假设森林里有一棵神奇的数字树,每个节点都遵守一个规定:
-
左边的数字比自己小。
-
右边的数字比自己大。
这就是二叉搜索树的基本规则。
例如,我们依次插入:
        8
       / \
      4   12
     / \  / \
    2  6 10 14
我们想查找数字10。
应该怎么做?
3. 查找数字10的过程
第一步:从根节点8开始。
因为:
10 > 8
所以往右边走。
第二步:来到12。
因为:
10 < 12
所以往左边走。
第三步:来到10。
找到了!
一共只需要访问3个节点。
如果这棵树有15个节点:
          8
       /     \
      4       12
     / \     /  \
    2   6   10  14
只要树保持比较均衡,我们每次都能排除掉大约一半的搜索范围。
这就像猜数字游戏:
老师心里想一个1到100之间的数字,你每次都猜中间的数字,老师告诉你大了还是小了。
每猜一次,可能范围缩小一半。
因此,平均查找时间复杂度可以达到:
O(logn)
4. 最坏情况:树变成一条长链
但是,同学们需要注意!
二叉搜索树不一定永远长得这么漂亮。
如果我们按照下面的顺序插入数字:
1、2、3、4、5可能形成:
1
 \
  2
   \
    3
     \
      4
       \
        5
这时候,二叉搜索树就变成了一条链。
如果我们要查找数字5:
1 → 2 → 3 → 4 → 5可能需要访问所有节点。
假设有 nnn 个节点,就可能访问 nnn 个节点。
所以最坏时间复杂度是:
O(n)
5. 对比总结
| 情况 | 树的形状 | 查找复杂度 |
|---|---|---|
| 平均情况 | 比较均衡 | O(logn) |
| 最坏情况 | 退化成链 | O(n) |
最终答案:A
平均时间复杂度:O(logn)
最坏时间复杂度:O(n)
第6题:贪心算法------相邻石子的合并问题
正确答案:B(19)
1. 题目内容
有4堆石子,数量分别为:
1, 2, 3, 4
每次可以合并相邻两堆。
合并代价为两堆石子数量之和。
将所有石子合并成一堆的最小总代价是多少?
选项:
-
A. 17
-
B. 19
-
C. 20
-
D. 23
这道题非常有意思!
它考查的是贪心思想,而且有一个容易混淆的地方:
只能合并相邻的两堆!
不能随便挑选任意两堆。
2. 先理解合并代价
我们有:
第1堆:1颗
第2堆:2颗
第3堆:3颗
第4堆:4颗
如果合并第一堆和第二堆:
1 + 2 = 3
这次的合并代价就是3。
合并完成后:
3 3 4注意:原来的两堆已经变成一堆3颗石子。
最终,我们要把所有石子合并成一堆,并且让每次合并代价的总和最小。
3. 尝试不同的合并方案
我们来当一回石子合并小队长!
方案一:先合并最左边的两堆。
初始状态:
1 2 3 4第一次:
1 + 2 = 3
代价为3。
剩余:
3 3 4第二次:
3 + 3 = 6
代价为6。
剩余:
6 4第三次:
6 + 4 = 10
代价为10。
总代价:
3 + 6 +10 =19
方案二:先合并中间两堆。
初始状态:
1 2 3 4第一次:
2 + 3 = 5
代价为5。
剩余:
1 5 4第二次,合并相邻的5和4:
5 + 4 = 9
代价为9。
剩余:
1 9第三次:
1+9=10
代价为10。
总代价:
5+9+10=24
方案三:先合并最右边的两堆。
初始状态:
1 2 3 4第一次:
3 + 4 = 7
代价为7。
剩余:
1 2 7第二次:
1+2=3
代价为3。
剩余:
3 7第三次:
3+7=10
代价为10。
总代价:
7+3+10=20
4. 三种方案比较
| 合并方案 | 第一次 | 第二次 | 第三次 | 总代价 |
|---|---|---|---|---|
| 方案一 | 3 | 6 | 10 | 19 |
| 方案二 | 5 | 9 | 10 | 24 |
| 方案三 | 7 | 3 | 10 | 20 |
方案一得到19。
但是,仅仅比较这三个方案,还不能证明19一定是最小值。
我们还需要理解它与哈夫曼树的关系。
5. 为什么这道题不能直接套普通哈夫曼算法?
普通哈夫曼树的规则是:
每次选取全局最小的两个权值合并。
而本题要求:
只能合并相邻的两堆。
这两种限制并不相同!
对于本题的四堆石子:
-
可以先合并1和2。
-
可以先合并2和3。
-
可以先合并3和4。
-
不能直接合并1和4。
本题属于带有相邻限制的合并问题。
在这组数据中,方案一的19确实是最小总代价。
最终答案:B(19)
本题关键: 每次合并必须选择相邻的两堆,而且要考虑后续合并造成的总代价,不能只看眼前哪一次最便宜。
6. 进一步拓展:区间DP
如果石子数量变多,例如:
4 5 9 2 7 3 8我们就不能仅靠简单地尝试几种方案来解决。
可以使用区间动态规划。
设:
sumij
表示第 i 堆到第 j 堆石子的总数量。
设:
dpij
表示将第 i 堆到第 j 堆合并成一堆的最小总代价。
状态转移:
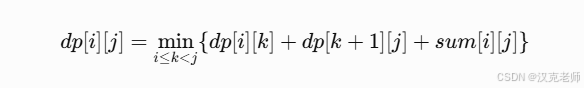
这里的 k 表示最后一次合并时,左边和右边的分界位置。
这道题是一个区间DP。
第7题:BFS广度优先搜索------dist究竟代表什么?
正确答案:A
1. 题目内容
在无权图中,使用 BFS 从起点开始遍历,并在访问由结点 uuu 扩展的相邻结点 vvv 时记录:
dist[v] = dist[u] + 1;起点的 dist 为0。
问:最终 dist[v] 表示什么?
选项:
A. 起点到结点v的最少边数
B. 结点v的度数
C. 从起点到结点v的路径上经过的最大边权
D. 包含结点v的连通块大小
2. 先回忆:什么是图?
我们把图想象成一个城市交通网络。
-
每个城市是一个顶点。
-
城市之间的道路是边。
例如:
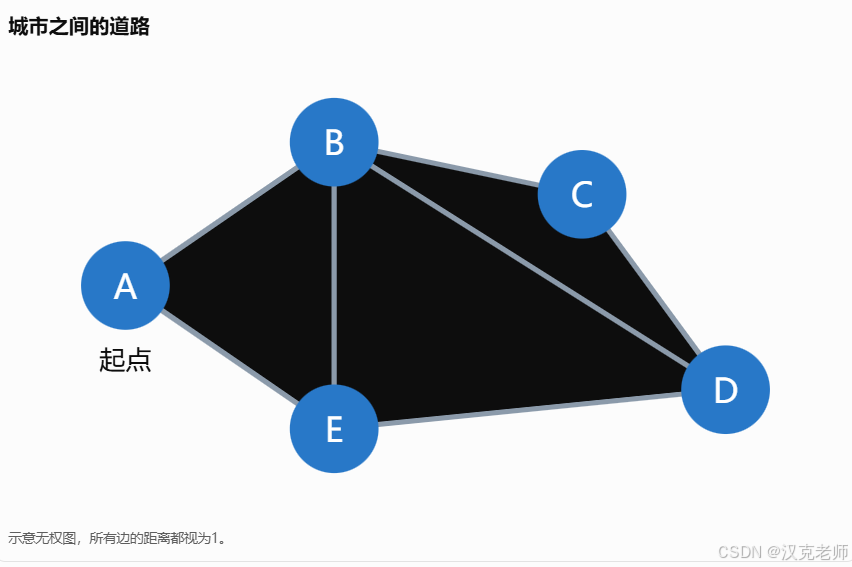
假设我们从A城市出发,希望找到其他城市。
问题是:
从A到其他城市,最少需要经过多少条道路?
这就是 BFS 的经典应用。
3. BFS为什么使用队列?
BFS 的英文全称是:
Breadth First Search,中文叫作广度优先搜索。
它有一个重要特点:
先访问距离起点近的节点,再访问距离起点远的节点。
这就像水滴落在池塘里:
-
第一圈水波最先到达附近位置。
-
第二圈水波再向外扩散。
-
第三圈继续向外扩散。
所以 BFS 也可以理解为一层一层地搜索。
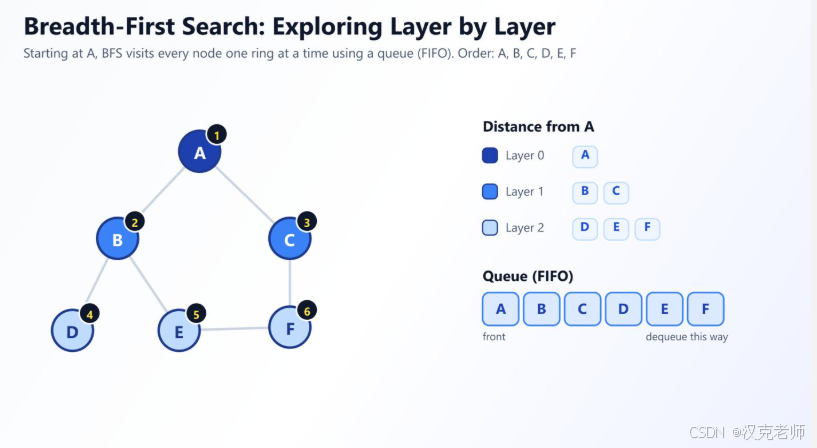
为什么使用队列?
因为队列遵守:
先进先出(FIFO)。
先进入队列的节点,先被取出来扩展。
这样就能保证先处理距离近的节点。
4. 重点理解dist数组
我们先看一个简单的图:
A ------ B ------ D
|
C ------ E
从A出发:
-
A到自己的距离是0。
-
A到B只需要1条边。
-
A到C只需要1条边。
-
A到D需要2条边。
-
A到E需要2条边。
因此:
| 节点 | dist值 | 含义 |
|---|---|---|
| A | 0 | 自己到自己,不需要走边 |
| B | 1 | 最少经过1条边 |
| C | 1 | 最少经过1条边 |
| D | 2 | 最少经过2条边 |
| E | 2 | 最少经过2条边 |
所以:
dist[v] = dist[u] + 1;实际上表示:
我们从距离起点为 dist[u] 的节点u出发,再经过一条边,到达节点v。
因此,v的距离比u多1。
5. 为什么一定是最少边数?
这是本题最重要的地方。
因为图是无权图,每条边都看成长度1。
BFS按照距离从小到大的顺序访问:
第0层:起点
第1层:距离起点1条边的节点
第2层:距离起点2条边的节点
第3层:距离起点3条边的节点
当我们第一次访问到某个节点时,已经通过最少边数到达了它。
所以 dist[v] 就是:
起点 到 节点v 的最少边数
6. BFS的标准C++模板
同学们,下面这份BFS代码一定要熟悉。
#include <iostream>
#include <queue>
#include <vector>
using namespace std;

const int N = 1005;

vector<int> g[N];
int dist[N];

int main() {
    int n, m;
    cin >> n >> m;

    for (int i = 1; i <= m; i++) {
        int u, v;
        cin >> u >> v;

        g[u].push_back(v);
        g[v].push_back(u);
    }

    int start;
    cin >> start;

    for (int i = 1; i <= n; i++) {
        dist[i] = -1;
    }

    queue<int> q;

    dist[start] = 0;
    q.push(start);

    while (!q.empty()) {
        int u = q.front();
        q.pop();

        for (int i = 0; i < (int)g[u].size(); i++) {
            int v = g[u][i];

            if (dist[v] == -1) {
                dist[v] = dist[u] + 1;
                q.push(v);
            }
        }
    }

    for (int i = 1; i <= n; i++) {
        cout << dist[i] << " ";
    }

    return 0;
}
这里有三个非常重要的操作:
dist[start] = 0;起点距离自己为0。
dist[v] = dist[u] + 1;新节点距离比当前节点多1。
q.push(v);把新发现的节点加入队列,等待后续扩展。
最终答案:A
dist[v] 表示起点到结点v的最少边数,也就是无权图中的最短距离。
7. 一个特别重要的拓展:无权图和有权图
这里要提醒同学们:
BFS求最短路,有一个重要前提:每条边的权值相同,通常都是1。
如果道路长度不同:
A --2-- B
A --1-- C --1-- B
从A到B:
-
直接走:距离2。
-
经过C:距离1+1=2。
如果换成:
A --10-- B
A --1-- C --2-- B
那么最短距离就变成3。
这时候不能简单地使用普通BFS来求加权最短路,需要学习Dijkstra等算法。
七道题中最值得注意的几个易错点
第1题:不要把位运算当成逻辑运算。
-
&是按位与。 -
&&是逻辑与。 -
|是按位或。 -
||是逻辑或。
这四个符号一定要区分。
第2题:数学函数的结果和返回类型是两回事。
例如:
sqrt(4)虽然结果是2,但是返回类型是 double。
第3题:哈夫曼树不能直接看出现次数判断编码长度。
必须先按照规则构造整棵树,再计算叶子节点的深度。
第4题:一定要分清楚点和格子。
4×5个点,不代表4×5个小方格。
第5题:普通二叉搜索树不一定平衡。
平均复杂度和最坏复杂度不能混淆。
第6题:相邻合并不能直接套用普通哈夫曼算法。
本题有相邻限制,扩展到更多堆时需要考虑区间DP。
第7题:BFS求最短路,需要注意无权图这个前提。
有权图不能直接照搬普通BFS的最短路方法。