目录
[1.3 defult和delete](#1.3 defult和delete)
[1.4 final和override](#1.4 final和override)
一.新的类功能
1.1默认的移动构造和移动赋值
- 原来 C++ 类中,有 6 个默认成员函数:构造函数 / 析构函数 / 拷贝构造函数 / 拷贝赋值重载 / 取地址重载 /const 取地址重载,最后重要的是前 4 个,后两个用处不大,默认成员函数就是我们不写编译器会生成一个默认的。C++11 新增了两个默认成员函数,移动构造函数和移动赋值运算符重载。
- 如果你没有自己实现移动构造函数,且没有实现析构函数、拷贝构造、拷贝赋值重载中的任意一个。那么编译器会自动生成一个默认移动构造。默认生成的移动构造函数,对于内置类型成员会执行逐成员按字节拷贝,自定义类型成员,则需要看这个成员是否实现移动构造,如果实现了就调用移动构造,没有实现就调用拷贝构造。
- 如果你没有自己实现移动赋值重载函数,且没有实现析构函数、拷贝构造、拷贝赋值重载中的任意一个,那么编译器会自动生成一个默认移动赋值。默认生成的移动构造函数,对于内置类型成员会执行逐成员按字节拷贝,自定义类型成员,则需要看这个成员是否实现移动赋值,如果实现了就调用移动赋值,没有实现就调用拷贝赋值。(默认移动赋值跟上面移动构造完全类似)
- 如果你提供了移动构造或者移动赋值,编译器不会自动提供拷贝构造和拷贝赋值。
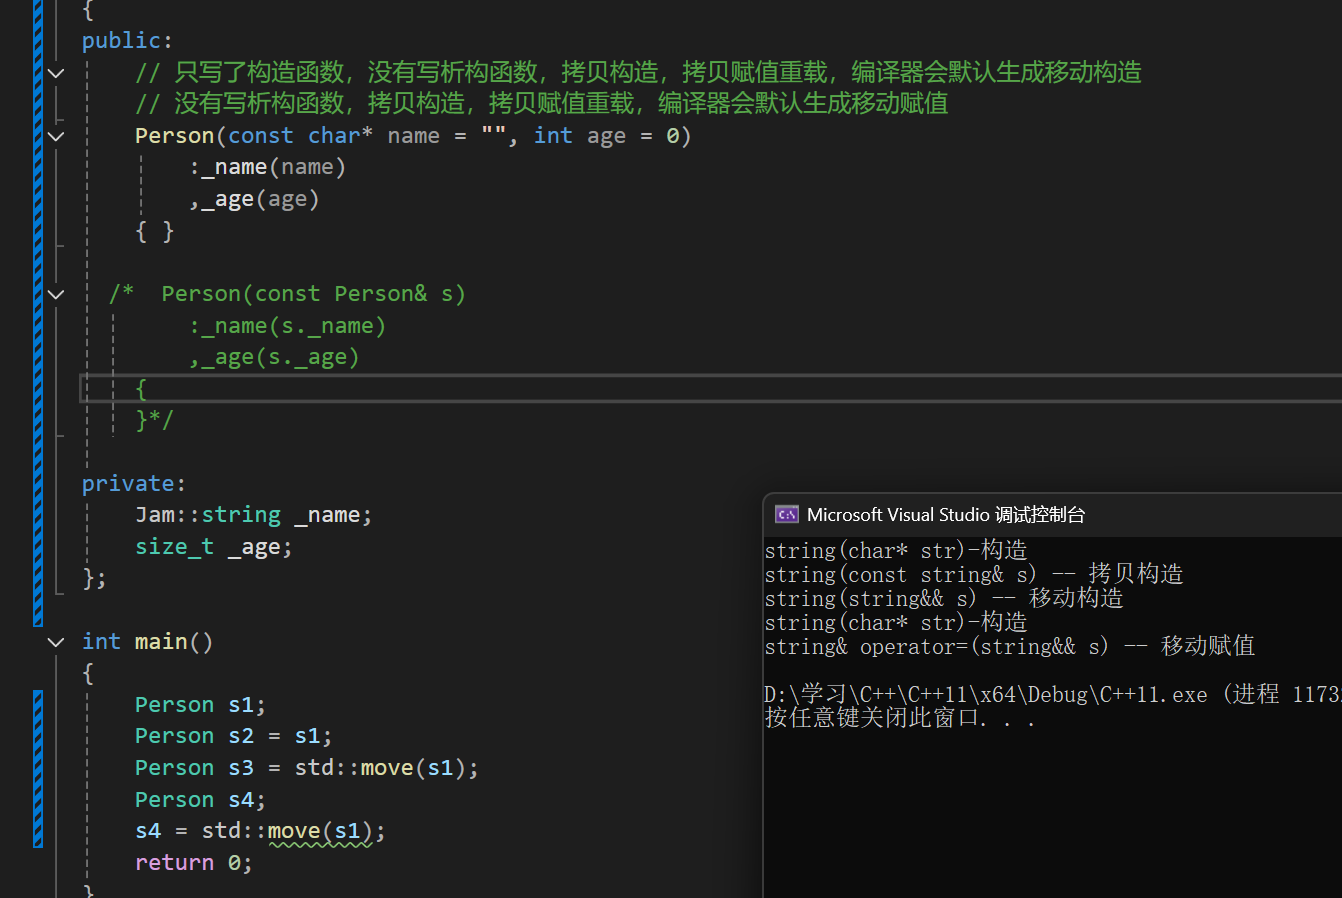
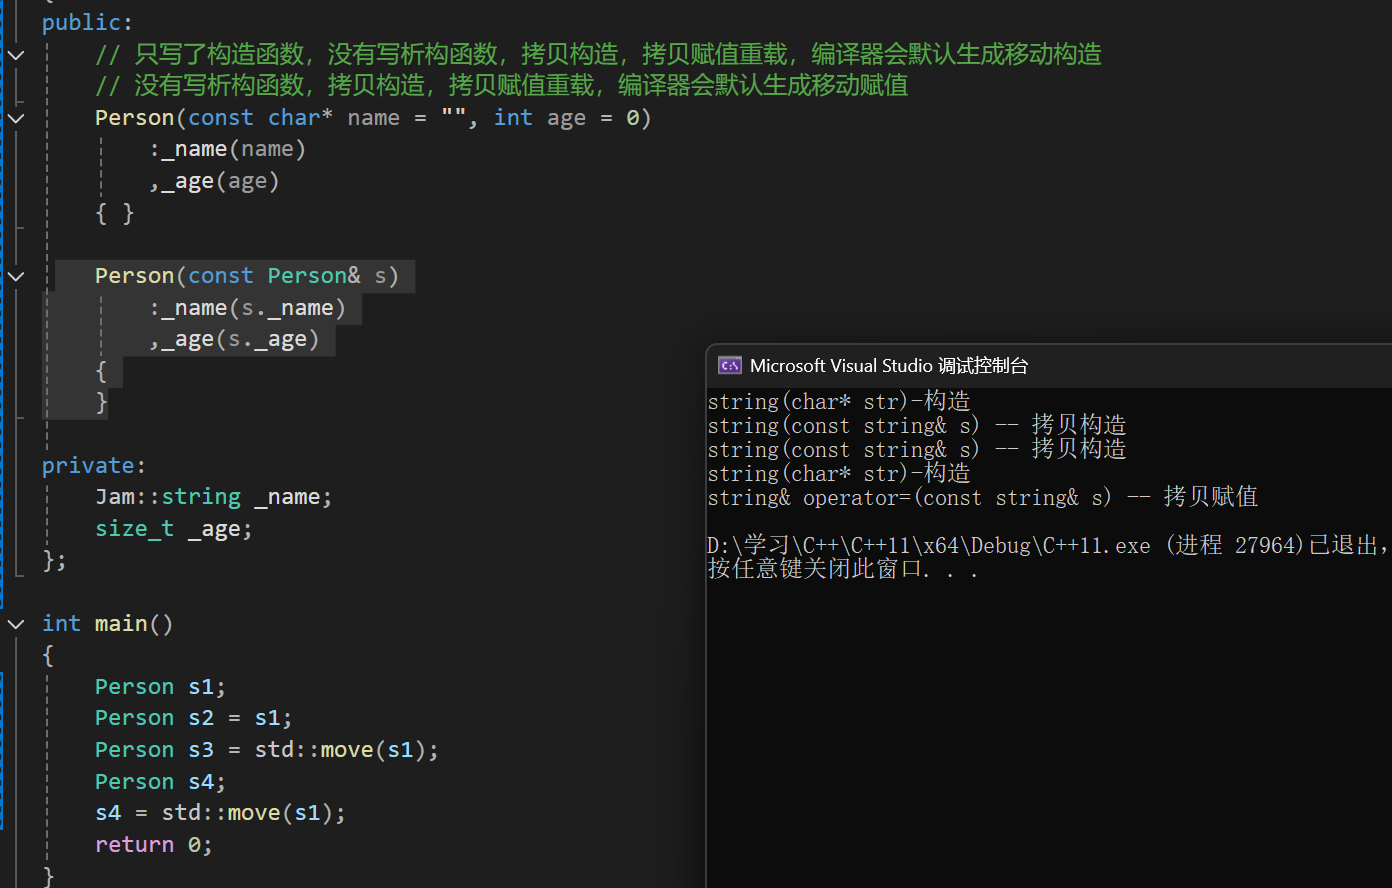
注:这里用自定义的string可以更加方便我们观察出调用哪一个函数类型,string代码在上一篇文章中已经写过,不知道的可以看上一个文章
| 默认成员函数 | 编译器何时自动生成 | 关键抑制条件(只要满足,不再自动生成) |
|---|---|---|
| 默认构造函数 | 用户没有手写任何构造函数 | 自己实现任意构造(拷贝构造、移动构造、普通构造等) |
| 析构函数 | 用户没有手写析构函数 | 显式定义析构函数 |
| 拷贝构造函数 | 用户没有手写拷贝构造 | 1. 显式定义拷贝构造2. 显式定义移动构造 / 移动赋值(C++11 规则) |
| 拷贝赋值运算符 | 用户没有手写拷贝赋值 | 1. 显式定义拷贝赋值2. 显式定义移动构造 / 移动赋值(C++11 规则) |
| 移动构造函数(C++11) | 同时满足全部 3 条:① 无自定义移动构造② 无自定义析构③ 无自定义拷贝构造④ 无自定义拷贝赋值 | 只要定义下面任意一个:析构 / 拷贝构造 / 拷贝赋值 / 移动构造 |
| 移动赋值运算符(C++11) | 同时满足全部 3 条:① 无自定义移动赋值② 无自定义析构③ 无自定义拷贝构造④ 无自定义拷贝赋值 | 只要定义下面任意一个:析构 / 拷贝构造 / 拷贝赋值 / 移动赋值 |
现代 C++ 推荐:能使用 =default / =delete 显式声明,避免编译器隐式行为带来坑。
1.2成员变量给缺省值
1、基础语法(C++11 新增)
只能给非静态成员变量写缺省值,两种写法:
struct Node
{
    int _a = 10;         // 等号形式
    double _b{3.14};     // 列表初始化(推荐,防止隐式转换)
    int* _ptr = nullptr;

    static int _c = 1;   // ❌ 错误!静态成员不能这样写(静态只能类外初始化)
};
2、核心优先级规则【面试高频】
构造函数初始化列表 > 类内缺省值 逻辑:
- 如果构造函数初始化列表显式列出该成员 → 使用列表的值,类内缺省值直接失效;
- 如果初始化列表没有写这个成员 → 自动使用类内缺省值初始化;
- 构造函数体内赋值不参与初始化!只是赋值,初始化早已完成。
示例演示:
struct Node
{
    int _x = 100;
    Node() : _x(1) {}   // 初始化列表覆盖 → _x = 1
    Node(int a) {}      // 列表没写_x → 使用缺省值 _x = 100
};
3、初始化顺序(重中之重)
成员初始化顺序 只按照类中从上到下声明顺序 和:初始化列表书写顺序、类内缺省值书写顺序无关!
struct Test
{
    int a = 1;
    int b = a; // 合法,a先初始化
};
4、和八大默认成员函数的关系
-
类内缺省值 ≠ 默认构造函数 类内缺省值只是 "后备初始化方案",不会强制编译器生成默认构造函数 。 只要你手写任意构造函数,编译器不再合成默认构造;就算写了成员缺省值也没用。
概念 要求 调用方式 默认构造函数 调用时允许不传参数(无参 / 全部参数带缺省) A obj;合法普通有参构造函数 必须提供实参,无法无参调用 A obj;报错;A obj(10);合法 -
编译器合成的默认构造 / 默认移动构造 / 默认拷贝构造 在逐个初始化成员时: 如果成员没有在隐式初始化列表中指定,就采用类内缺省值初始化。
-
⚠️ 易错区分
struct listNode
{
T _data;
Node* _next = nullptr;
Node* _prev = nullptr;
};
当你创建 listNode 对象: 只要构造函数没有初始化 _next、_prev,自动初始化为 nullptr; 不用在每一个构造函数初始化列表重复写 _next(nullptr),_prev(nullptr) 👉 这就是工程上最常用的好处!减少重复代码。
5、常见限制与坑
-
不能初始化引用成员、const 成员 引用 & /const T 成员必须在构造初始化列表显式初始化,类内缺省值无法满足。
struct A
{
const int x = 5; // ❌ 编译报错
int& r = x; // ❌ 编译报错
}; -
类内缺省值不是赋值!是初始化 区分:
struct A
{
int a = 10; // 初始化
A(){ a = 20; } // 先初始化为10,随后赋值修改为20(低效,尽量避免)
}; -
模板类(你的
listNode<T>)完全支持类内缺省值,写法一样。
1.3 defult和delete
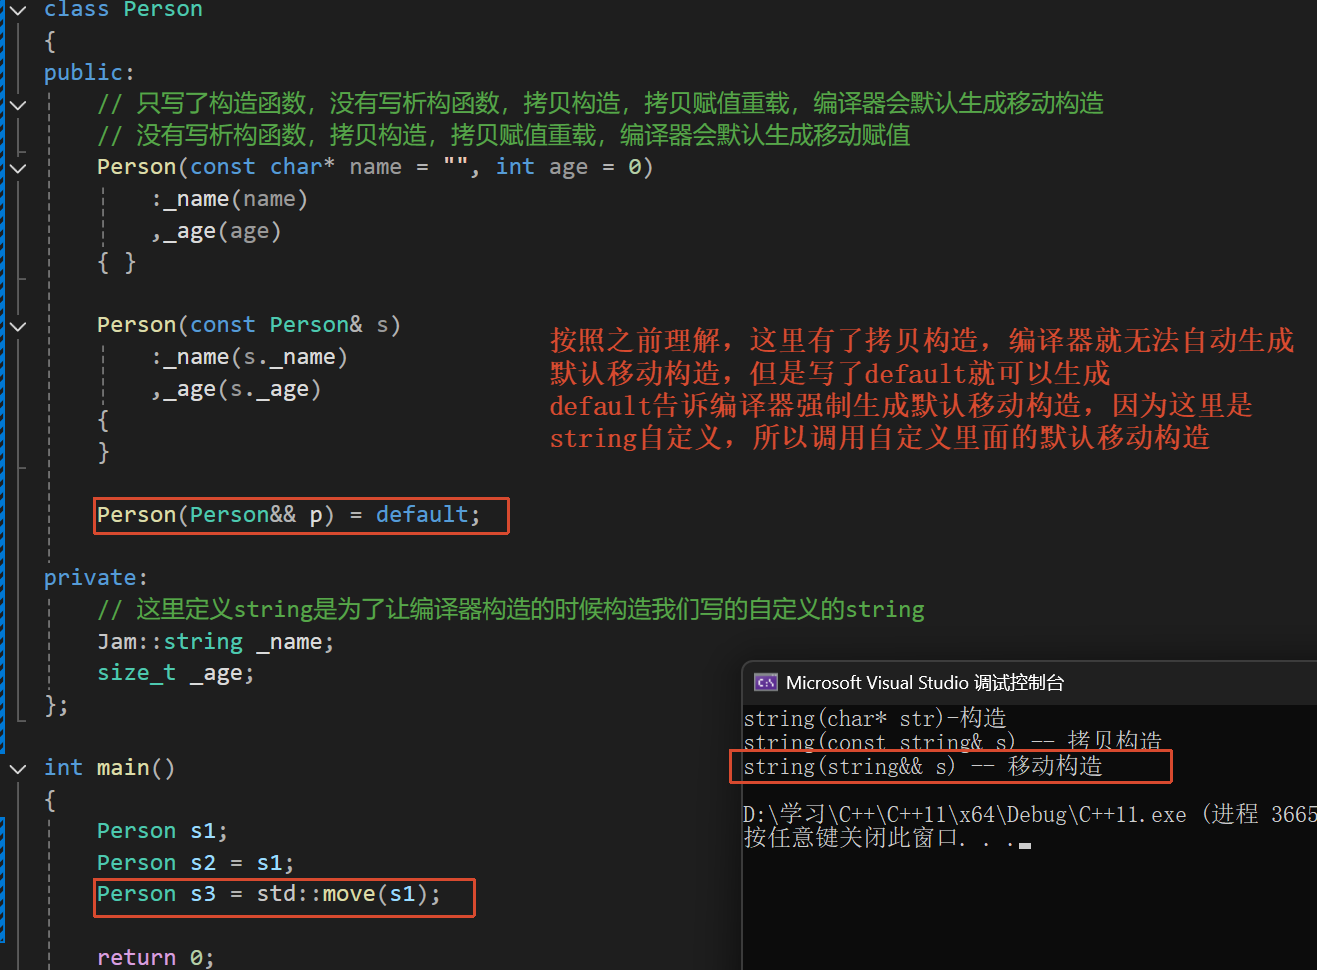
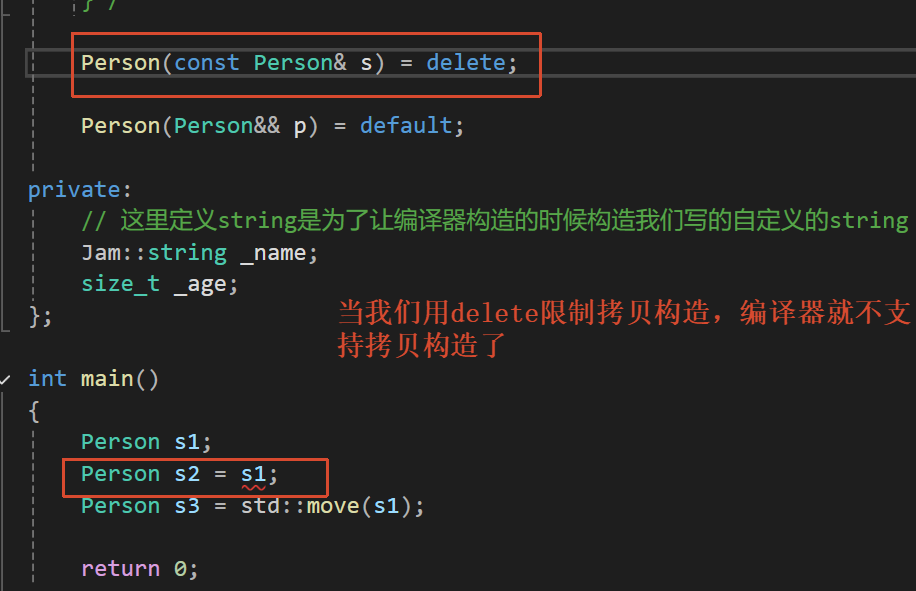
- C++11 可以让你更好的控制要使用的默认函数。假设你要使用某个默认的函数,但是因为一些原因这个函数没有默认生成。比如:我们提供了拷贝构造,就不会生成移动构造了,那么我们可以使用 default 关键字显式指定移动构造生成。
- 如果想要限制某些默认函数的生成,在 C++98 中,是该函数设置成 private,并且只声明不定义,这样只要其他人想要调用就会报错。在 C++11 中更简单,只需在该函数声明加上
=delete即可,该语法指示编译器不生成对应函数的默认版本,称=delete修饰的函数为删除函数。
1.4 final和override
1、override
作用
显式声明:这个函数是用来重写父类虚函数的 让编译器帮忙检查语法是否合法;防止写错函数签名导致没有成功重写。
使用位置
只能写在虚成员函数声明末尾
class Base
{
public:
    virtual void func()
    {
    }
};

class Derive : public Base
{
public:
    // ✅ 正确,明确重写父类虚函数
    void func() override
    {
    }

    // ❌ 报错:父类没有 void func(int),重写失败,override直接揪出错误
    void func(int) override
    {
    }
};
核心要点
- 只能修饰虚函数;普通函数写 override → 编译报错
- 不会改变程序行为,仅做编译期检查
- 强烈建议:所有重写虚函数都加上 override,规避笔误
参数、返回值、const、引用限定只要和父类虚函数不一致,就无法构成重写,变成隐藏(overload/hide),override 会直接报错提醒。
class Base
{
public:
    virtual void func() const {}
};

class Derive : public Base
{
public:
    // ❌ 缺少const,不是重写,override触发编译错误
    void func() override {}
};
2、final
final 有两种用法
用法 1:修饰虚函数
含义:这个虚函数不能被子类继续重写
class Base
{
public:
    virtual void func() final
    {
    }
};

class Derive : public Base
{
public:
    void func() override // ❌ 编译报错,func被final禁止重写
    {
    }
};
用法 2:修饰类(写在类名后面)
含义:该类禁止被继承,不能当父类
class Base final
{
};

class Derive : public Base // ❌ 报错,Base被final,禁止继承
{
};
注意区分位置
void func() final;   // final修饰函数:禁止子类重写
class A final {}; // final修饰类:禁止被继承| 关键字 | 作用对象 | 核心功能 |
|---|---|---|
| override | 派生类虚函数 | 告诉编译器:我要重写父类虚函数,帮忙校验签名 |
| final | 1. 基类虚函数2. 类 | 函数:禁止子类重写类:禁止被继承 |
二.lambda
2.1lambda表达式语法及应用
2.1.1lambda的表达是语法
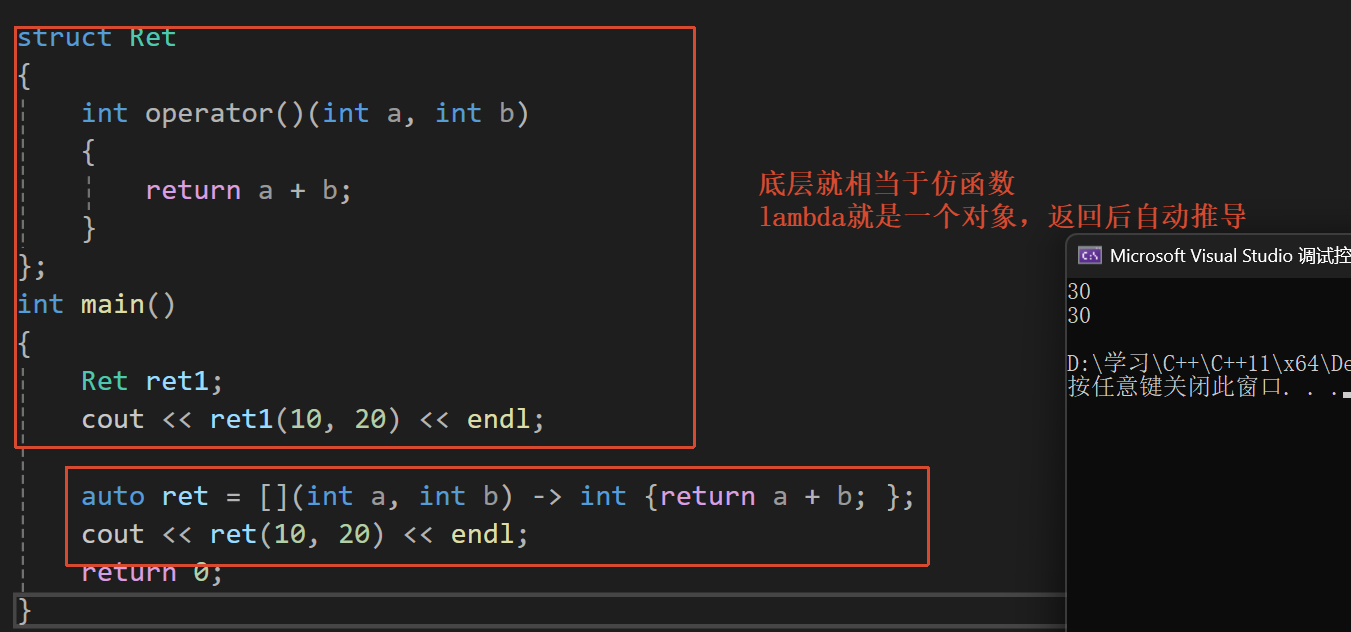
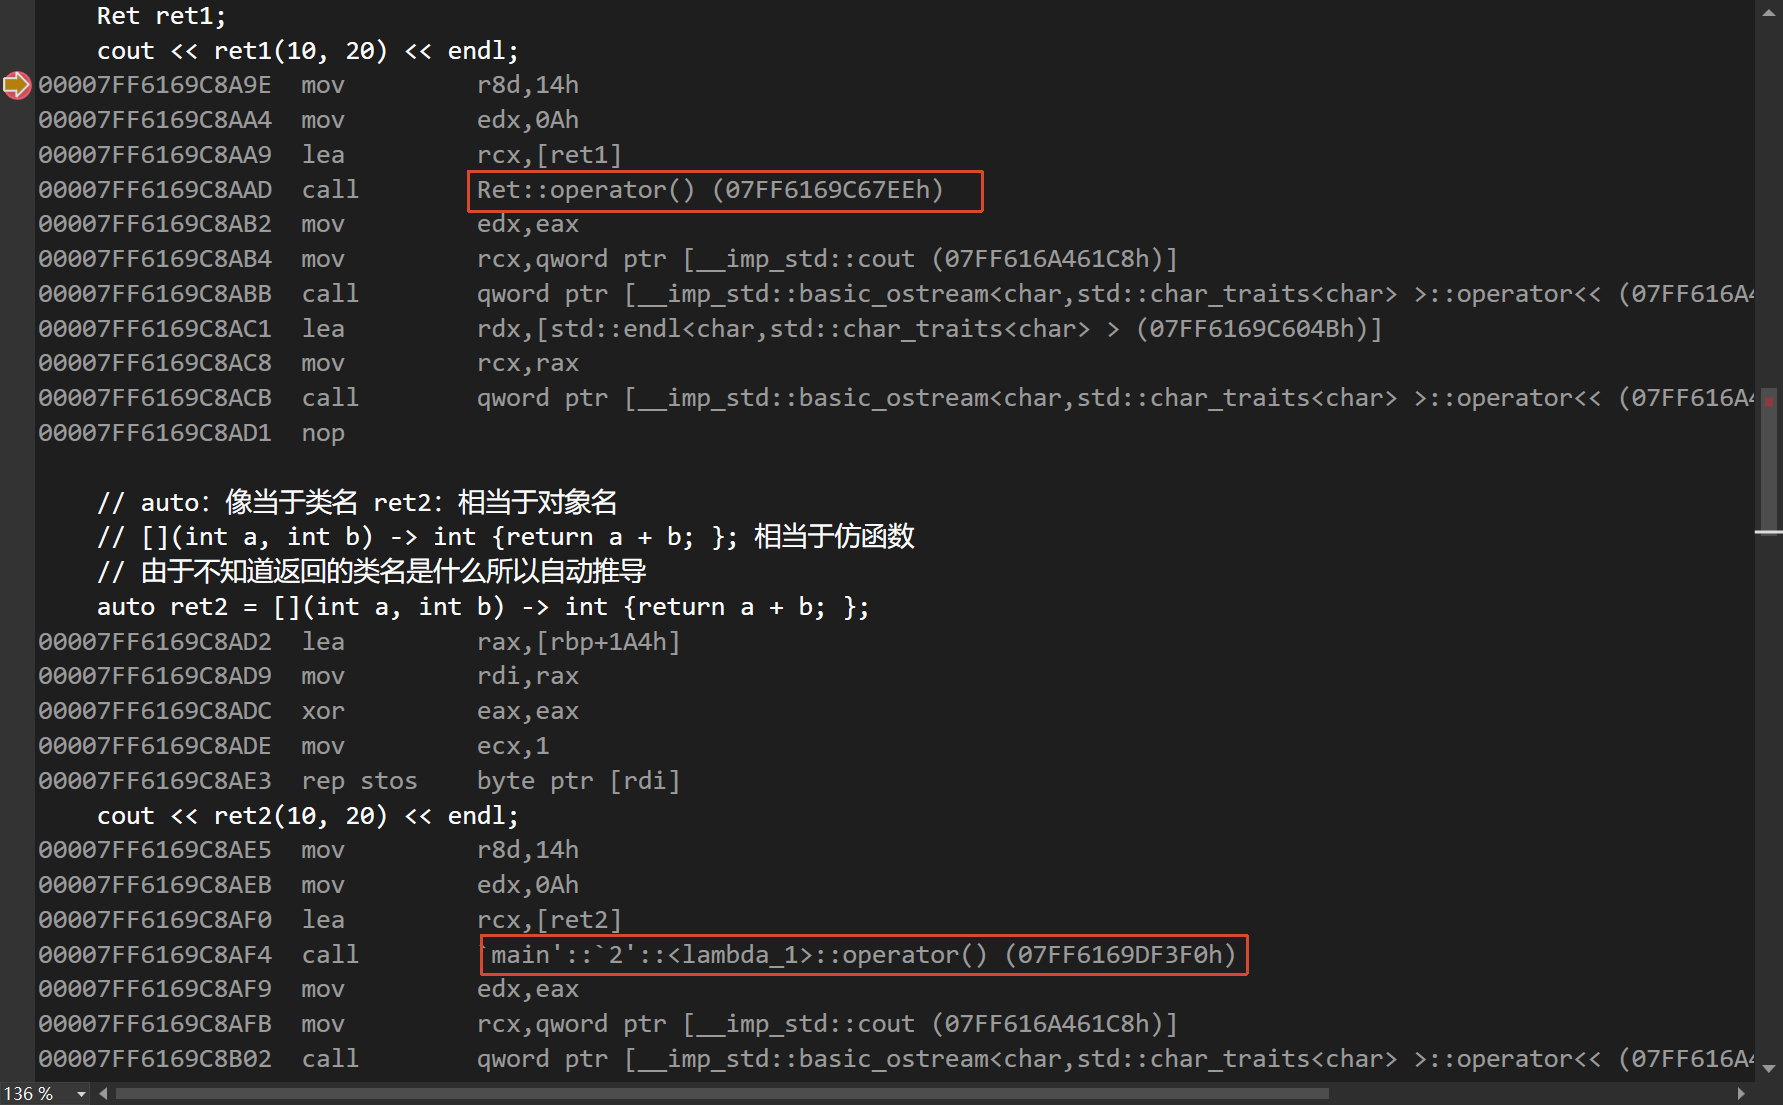
Lambda = 匿名函数对象
编译器遇到[],自动生成一个重载了operator()的类;创建这个类的临时对象,就是 lambda。
没有原生类型,只能用
auto、std::function、模板接收。
- lambda 表达式本质是一个匿名函数对象,跟普通函数不同的是他可以定义在函数内部。lambda 表达式语法使用层而言没有类型,所以我们一般是用 auto 或者模板参数定义的对象去接收 lambda 对象。
- lambda 表达式的格式:
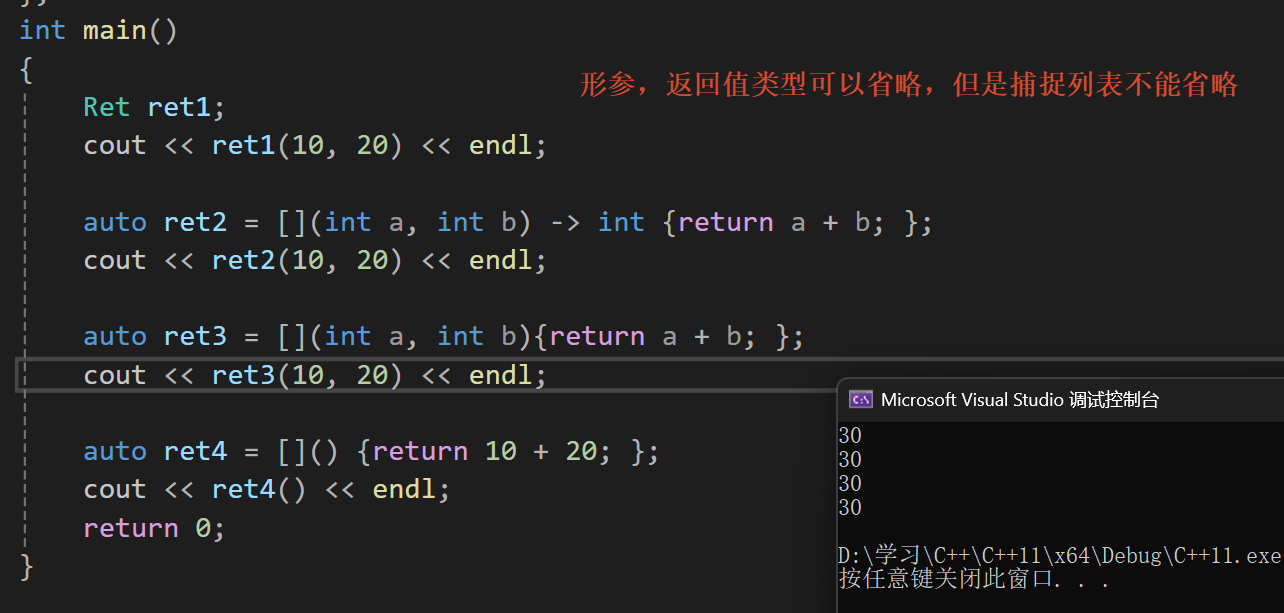
[capture-list] (parameters)-> return type { function boby } [capture-list]:捕捉列表,该列表总是出现在 lambda 函数的开始位置,编译器根据[]来判断接下来的代码是否为 lambda 函数,捕捉列表能够捕捉上下文中的变量供 lambda 函数使用,捕捉列表可以传值和传引用捕捉,具体细节 7.2 中我们再细讲。捕捉列表为空也不能省略。(parameters):参数列表,与普通函数的参数列表功能类似,如果不需要参数传递,则可以连同()一起省略->return type:返回值类型,用追踪返回类型形式声明函数的返回值类型,没有返回值时此部分可省略。一般返回值类型明确情况下,也可省略,由编译器对返回类型进行推导。{function boby}:函数体,函数体内的实现跟普通函数完全类似,在该函数体内,除了可以使用其参数外,还可以使用所有捕获到的变量,函数体为空也不能省略。
lambda 能不能递归?
直接不行! lambda 内部不能调用自身,因为定义之前变量还不存在。 两种解决方案:
-
使用
std::functionfunction<int(int)> fib = [&](int n){
if(n<=1) return 1;
return fib(n-1)+fib(n-2);
};
2.2.2lambda的应用
常见实战场景
配合算法库sort排序
vector<int> v={3,1,2};
sort(v.begin(),v.end(),[](int a,int b){
    return a>b; //降序
});
cpp
#include<algorithm>

struct Goods
{
    string _name;  // 名字
    double _price; // 价格
    int _evaluate; // 评价
    // ...

    Goods(const char* str, double price, int evaluate)
        :_name(str)
        , _price(price)
        , _evaluate(evaluate)
    {
    }
};

struct Compare1
{
    bool operator()(const Goods& gl, const Goods& gr)
    {
        return gl._price < gr._price;
    }
};

struct Compare2
{
    bool operator()(const Goods& gl, const Goods& gr)
    {
        return gl._price > gr._price;
    }
};

int main()
{
	vector<Goods> v = { { "苹果", 2.1, 5 }, { "香蕉", 3, 4 }, { "橙子", 2.2, 3}, { "菠萝", 1.5, 4 } };
	// 类似这样的场景,我们实现仿函数对象或者函数指针支持商品中
	// 不同项的比较,相对还是比较麻烦的,那么这里lambda就很好用了

	// 价格升序
	//sort(v.begin(), v.end(), Compare1());

	// 价格降序
	//sort(v.begin(), v.end(), Compare2());

	sort(v.begin(), v.end(), [](const Goods& g1, const Goods& g2) {
		return g1._price < g2._price;});

	sort(v.begin(), v.end(), [](const Goods& g1, const Goods& g2) {
		return g1._price > g2._price; });

	sort(v.begin(), v.end(), [](const Goods& g1, const Goods& g2) {
		return g1._evaluate < g2._evaluate; });

	sort(v.begin(), v.end(), [](const Goods& g1, const Goods& g2) {
		return g1._evaluate > g2._evaluate; });

	return 0;
}
2.2捕捉列表
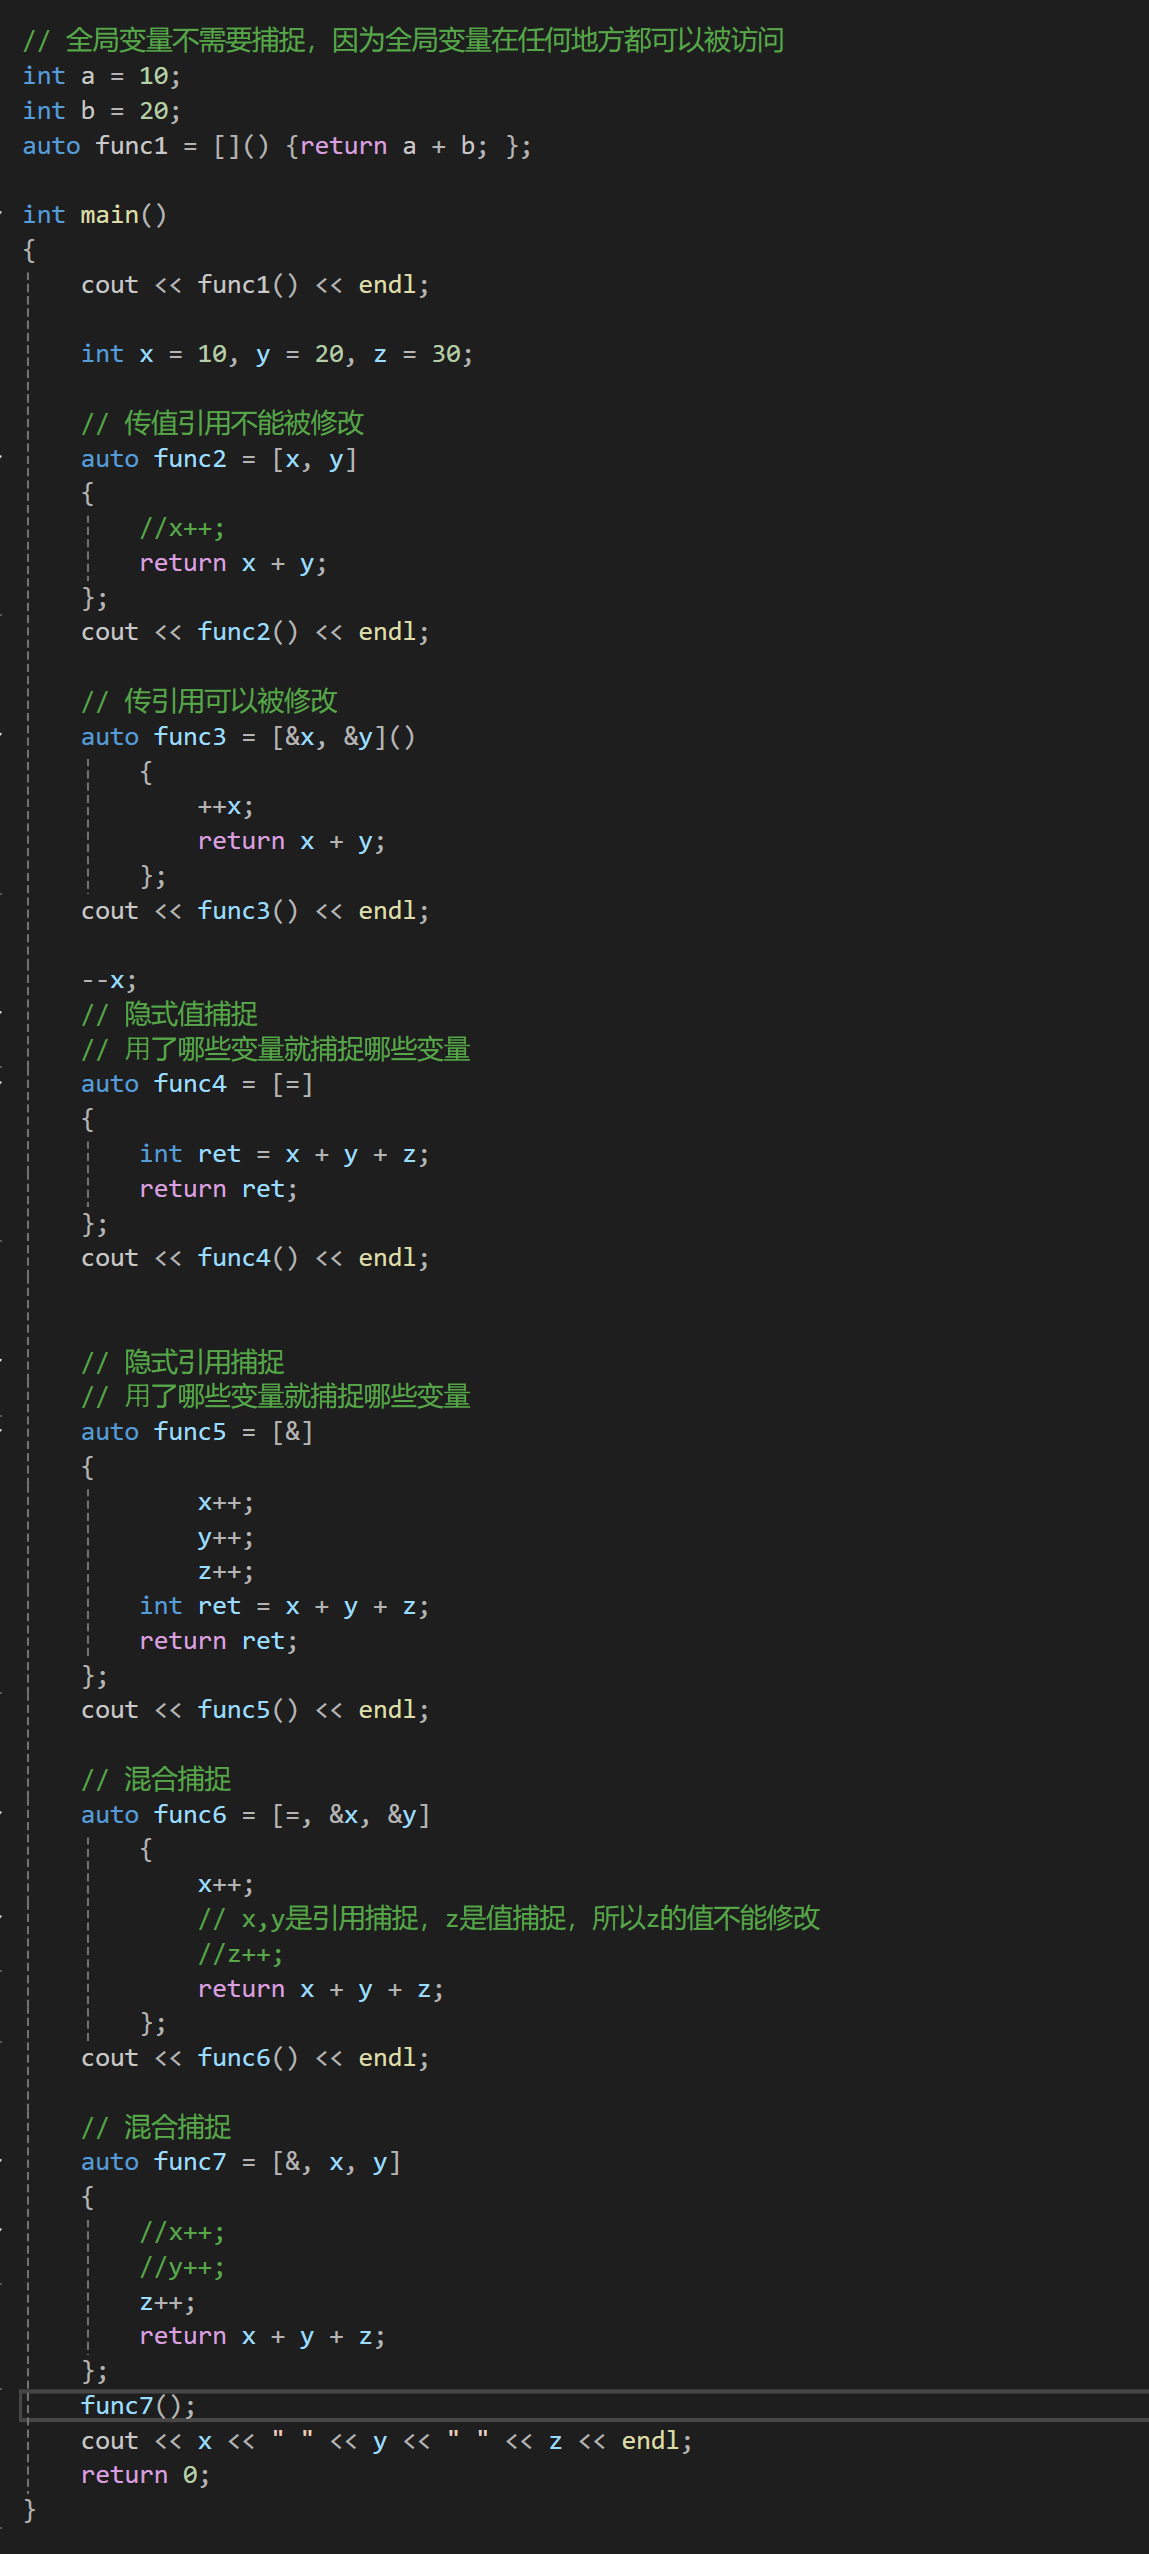
- lambda 表达式中默认只能用 lambda 函数体和参数中的变量,如果想用外层作用域中的变量就需要进行捕捉
- 第一种捕捉方式是在捕捉列表中显式的传值捕捉和传引用捕捉,捕捉的多个变量用逗号分割。
[x, y, &z]表示 x 和 y 值捕捉,z 引用捕捉。 - 第二种捕捉方式是在捕捉列表中隐式捕捉,我们在捕捉列表写一个
=表示隐式值捕捉,在捕捉列表写一个&表示隐式引用捕捉,这样我们 lambda 表达式中用了那些变量,编译器就会自动捕捉那些变量。 - 第三种捕捉方式是在捕捉列表中混合使用隐式捕捉和显式捕捉。
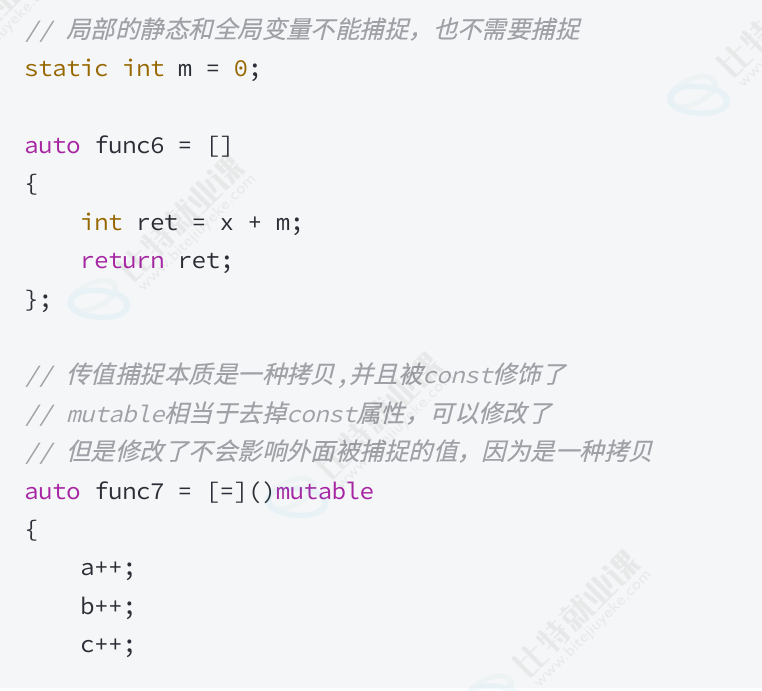
[=, &x]表示其他变量隐式值捕捉,x 引用捕捉;[&, x, y]表示其他变量引用捕捉,x 和 y 值捕捉。当使用混合捕捉时,第一个元素必须是&或=,并且&混合捕捉时,后面的捕捉变量必须是值捕捉,同理=混合捕捉时,后面的捕捉变量必须是引用捕捉。 - lambda 表达式如果在函数局部域中,他可以捕捉 lambda 位置之前定义的变量,不能捕捉静态局部变量和全局变量,静态局部变量和全局变量也不需要捕捉,lambda 表达式中可以直接使用。这也意味着 lambda 表达式如果定义在全局位置,捕捉列表必须为空。
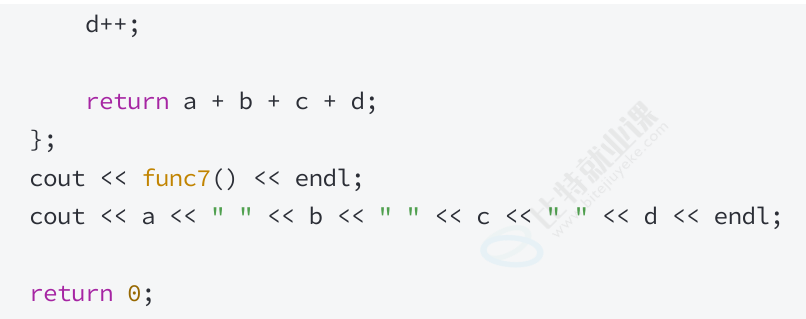
- 默认情况下,lambda 捕捉列表是被 const 修饰的,也就是说传值捕捉过来的对象不能修改,mutable 加在参数列表的后面可以取消其常量性,也就是说使用该修饰符后,传值捕捉的对象就可以修改了,但是修改还是形参对象,不会影响实参。使用该修饰符后,参数列表不可省略 (即使参数为空)。
三.包装器
3.1function包装器
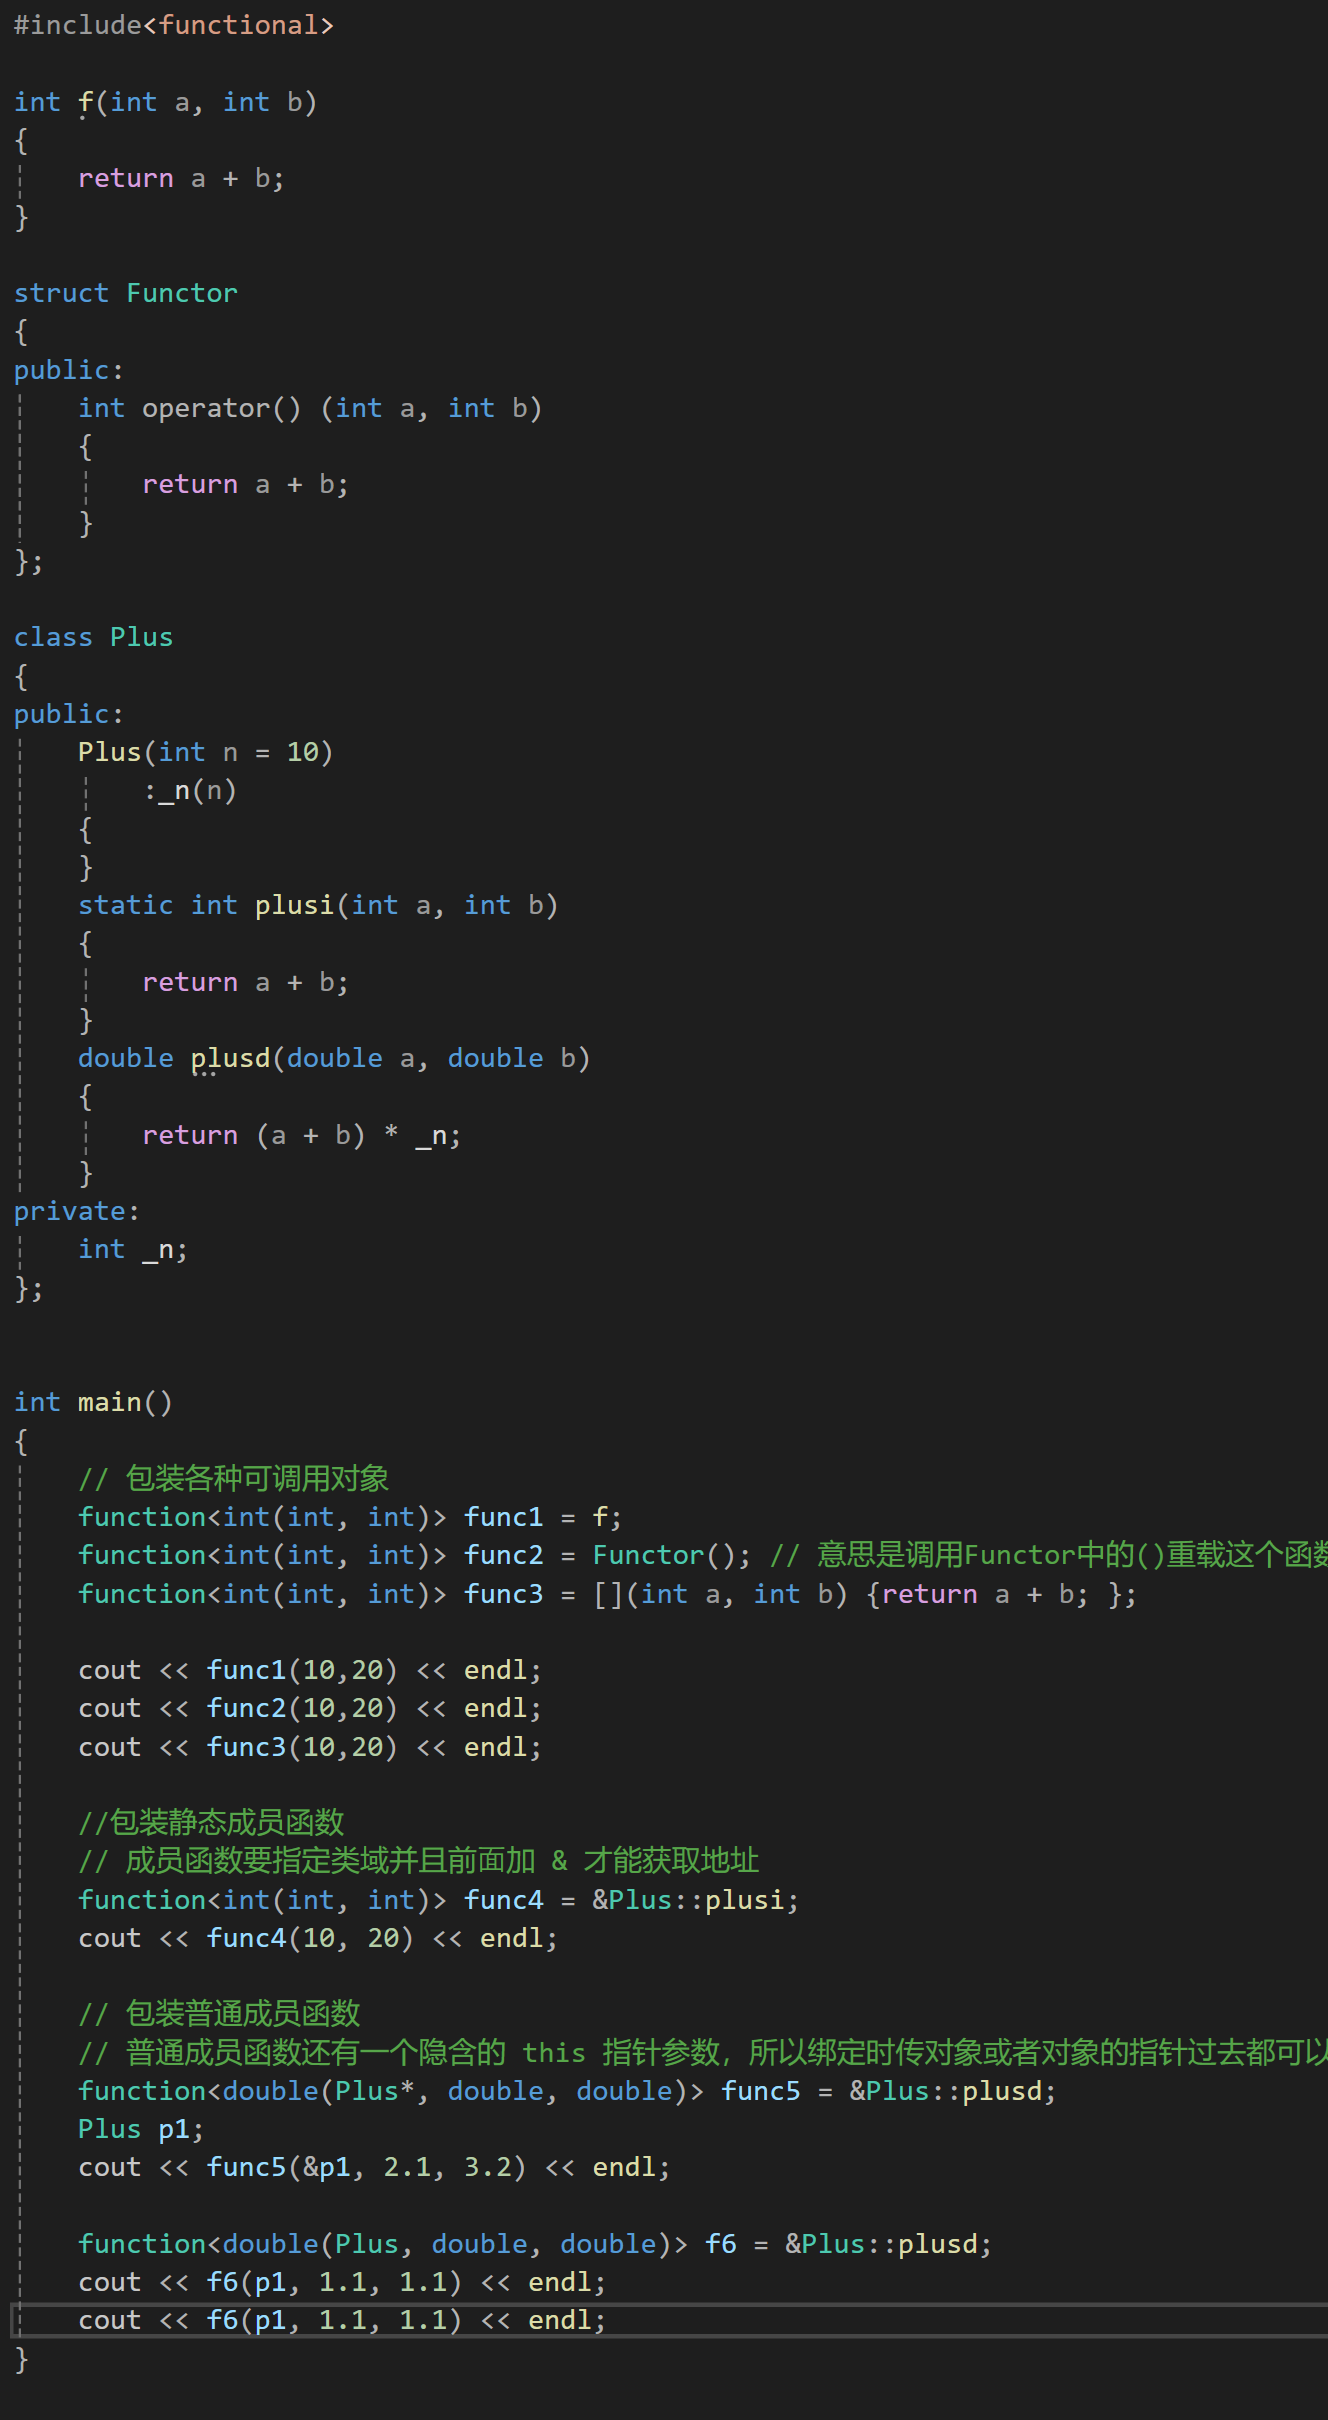
std::function通过类型擦除,把不同类型的可调用对象(函数指针、lambda、仿函数、bind 结果)包装成同一个std::function<R(Args...)>类型,对外提供统一的operator()调用接口。
std::function是一个类模板,也是一个包装器。std::function的实例对象可以包装存储其他的可以调用对象,包括函数指针、仿函数、lambda、bind 表达式等,存储的可调用对象被称为std::function的目标。若std::function不含目标,则称它为空。调用空std::function的目标导致抛出std::bad_function_call异常。- 以上是
function的原型,他被定义在<functional>头文件中。std::function - cppreference.com 是 function 的官方文件链接。 - 函数指针、仿函数、lambda 等可调用对象的类型各不相同,
std::function的优势就是统一类型,对他们都可以进行包装,这样在很多地方就方便声明可调用对象的类型,下面的第二个代码样例展示了std::function作为 map 的参数,实现字符串和可调用对象的映射表
1. 将可调用对象存入容器(vector/map)
lambda、仿函数各自类型独一无二,不能直接放进容器; std::function 是固定模板类型,可以存进 vector、map,实现函数映射表、事件分发。 示例:
map<string, function<void()>> opMap;
opMap["add"] = [](){cout << "加法";};
opMap["sub"] = [](){cout << "减法";};
2. 实现 Lambda 递归
lambda 定义前自身变量尚未创建,内部不能直接调用自己。 借助 std::function 中转实现递归:
function<int(int)> fib;
fib = [&](int n){
    if(n <= 2) return 1;
    return fib(n-1)+fib(n-2);
};
3.2bind包装器
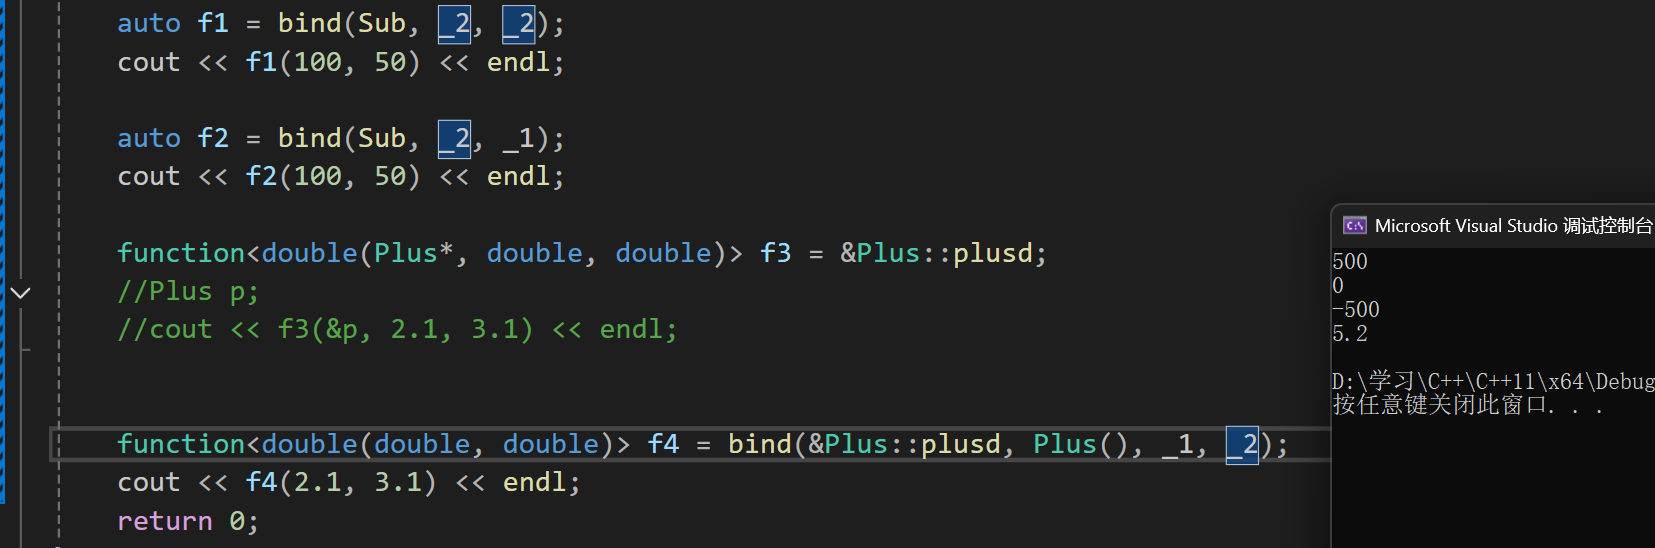
- bind 是一个函数模板,它也是一个可调用对象的包装器,可以把他看做一个函数适配器,对接收到的 fn 可调用对象进行处理后返回一个可调用对象。bind 可以用来调整参数个数和参数顺序。bind 也在
<functional>这个头文件中。 - 调用 bind 的一般形式:
auto newCallable = bind(callable,arg_list);其中 newCallable 本身是一个可调用对象,arg_list 是一个逗号分隔的参数列表,对应给定的 callable 的参数。当我们调用 newCallable 时,newCallable 会调用 callable,并传给它 arg_list 中的参数。 - arg_list 中的参数可能包含形如
_n的名字,其中 n 是一个整数,这些参数是占位符,表示 newCallable 的参数,它们占据了传递给 newCallable 的参数的位置。数值 n 表示生成的可调用对象中参数的位置:_1为 newCallable 的第一个参数,_2为第二个参数,以此类推。_1/_2/_3....这些占位符放到 placeholders 的一个命名空间中。
cpp
#include<functional>
#include<iostream>
using namespace std;

using placeholders::_1;
using placeholders::_2;
using placeholders::_3;

int Sub(int a, int b)
{
    return (a - b) * 10;
}

int SubX(int a, int b, int c)
{
    return (a - b - c) * 10;
}

class Plus
{
public:
    static int plusi(int a, int b)
    {
        return a + b;
    }

    double plusd(double a, double b)
    {
        return a + b;
    }
};

int main()
{
    auto sub1 = bind(Sub, _1, _2);
    cout << sub1(10, 5) << endl;

    // bind 本质返回的一个仿函数对象
    // 调整参数顺序(不常用)
    // _1代表第一个实参
    // _2代表第二个实参
    // ...
    auto sub2 = bind(Sub, _2, _1);
    cout << sub2(10, 5) << endl;

    // 调整参数个数 (常用)
    auto sub3 = bind(Sub, 100, _1);
    cout << sub3(5) << endl;

    auto sub4 = bind(Sub, _1, 100);
    cout << sub4(5) << endl;

    // 分别绑死第123个参数
    auto sub5 = bind(SubX, 100, _1, _2);
    cout << sub5(5, 1) << endl;

    auto sub6 = bind(SubX, _1, 100, _2);
    cout << sub6(5, 1) << endl;

    auto sub7 = bind(SubX, _1, _2, 100);
    cout << sub7(5, 1) << endl;

    // 成员函数对象进行绑死,就不需要每次都传递了
    function<double(Plus&&, double, double)> f6 = &Plus::plusd;
    Plus pd;
    cout << f6(move(pd), 1.1, 1.1) << endl;
    cout << f6(Plus(), 1.1, 1.1) << endl;

    // bind一般用于,绑死一些固定参数
    function<double(double, double)> f7 = bind(&Plus::plusd, Plus(), _1, _2);
    cout << f7(1.1, 1.1) << endl;

    // 计算复利的lambda
    auto func1 = [](double rate, double money, int year)->double {
        double ret = money;
        for (int i = 0; i < year; i++)
        {
            ret += ret * rate;
        }
        return ret - money;
    };

    // 绑死一些参数,实现出支持不同年利率,不同金额和不同年份计算出复利的结算利息
    function<double(double)> func3_1_5 = bind(func1, 0.015, _1, 3);
    function<double(double)> func5_1_5 = bind(func1, 0.015, _1, 5);
    function<double(double)> func10_2_5 = bind(func1, 0.025, _1, 10);
    function<double(double)> func20_3_5 = bind(func1, 0.035, _1, 30);

    cout << func3_1_5(1000000) << endl;
    cout << func5_1_5(1000000) << endl;
    cout << func10_2_5(1000000) << endl;
    cout << func20_3_5(1000000) << endl;

    return 0;
}std::bind作用:函数适配器,可以固定参数、调换参数顺序、减少调用时传入参数数量_1、_2占位符:std::placeholders命名空间,代表调用 bind 返回对象时传入的第 1、2 个实参- 绑定普通成员函数 :必须额外传入类对象 / 对象指针(成员函数隐含
this) - bind 返回类型极其复杂,通常使用
auto或者std::function接收 - 典型业务场景:把一部分参数预先绑定,生成签名更简单的回调函数(示例里的复利计算器)
下面是bind的重要用途