欢迎来到我的频道!【点击跳转专栏】
本文所有代码已托管至码云:【点此转跳】
文章目录
- [1. 认识TCP协议](#1. 认识TCP协议)
- [1.1 理解TCP报头的相关问题(先了解 知道有就行)](#1.1 理解TCP报头的相关问题(先了解 知道有就行))
- [1.2 TCP协议段格式](#1.2 TCP协议段格式)
- [1.3 对可靠性的正确认识](#1.3 对可靠性的正确认识)
- [1.4 确认应答(ACK)机制](#1.4 确认应答(ACK)机制)
- [1.5 超时重传机制(序号的一个作用)](#1.5 超时重传机制(序号的一个作用))
- [1.6 TCP通信的两种模式(通过序号、确认序号解决接收方的乱序问题)](#1.6 TCP通信的两种模式(通过序号、确认序号解决接收方的乱序问题))
- [1.7 窗口大小的作用](#1.7 窗口大小的作用)
- [1.8 6位标志位](#1.8 6位标志位)
- [1. ACK](#1. ACK)
- [2. SYN(简单理解一下三次握手建立链接、什么是链接)](#2. SYN(简单理解一下三次握手建立链接、什么是链接))
- [3. FIN(4次挥手)](#3. FIN(4次挥手))
- [4. 链接断开链接总结](#4. 链接断开链接总结)
- [5. RST](#5. RST)
- [6. PSH](#6. PSH)
- [7. URG](#7. URG)
- [8. 16位紧急指针](#8. 16位紧急指针)
- [2. TCP协议的一些机制细节](#2. TCP协议的一些机制细节)
- [2.1 超时重传机制时间的设置](#2.1 超时重传机制时间的设置)
- [2.2 连接管理机制](#2.2 连接管理机制)
- [2.2.1 再次聊聊3次握手](#2.2.1 再次聊聊3次握手)
- [2.2.2 再次聊聊4次挥手](#2.2.2 再次聊聊4次挥手)
- [2.2.3 shutdown(在应用层做到局部关闭)](#2.2.3 shutdown(在应用层做到局部关闭))
- [2.2.4 理解listen第二个参数](#2.2.4 理解listen第二个参数)
- [2.2.5 理解连理链接断开链接的状态转换](#2.2.5 理解连理链接断开链接的状态转换)
- [2.2.6 理解TIME_WAIT状态](#2.2.6 理解TIME_WAIT状态)
- [2.2.7 解决TIME_WAIT状态引起的bind失败的⽅法](#2.2.7 解决TIME_WAIT状态引起的bind失败的⽅法)
- [2.3 流量控制](#2.3 流量控制)
- [2.4 滑动窗口](#2.4 滑动窗口)
- [2.4.1 理解滑动窗口](#2.4.1 理解滑动窗口)
- [2.4.2 滑动窗口的工作过程](#2.4.2 滑动窗口的工作过程)
- [2.4.3 出现了丢包, 如何进⾏重传](#2.4.3 出现了丢包, 如何进⾏重传)
- [2.4.4 滑动窗口越界问题](#2.4.4 滑动窗口越界问题)
- [2.5 拥塞控制](#2.5 拥塞控制)
- [2.6 延迟应答](#2.6 延迟应答)
- [2.7 捎带应答](#2.7 捎带应答)
- [2.8 TCP小结](#2.8 TCP小结)
- [3. TCP常见面试题](#3. TCP常见面试题)
- [3.1 ⾯向字节流](#3.1 ⾯向字节流)
- [3.2 粘包问题](#3.2 粘包问题)
- [3.3 TCP异常问题](#3.3 TCP异常问题)
1. 认识TCP协议
TCP 全称为 "传输控制协议( Transmission Control Protocol ") . ⼈如其名, 要对数据的传输进⾏⼀个详细的控制
1.1 理解TCP报头的相关问题(先了解 知道有就行)
- TCP报头本质: 结构体
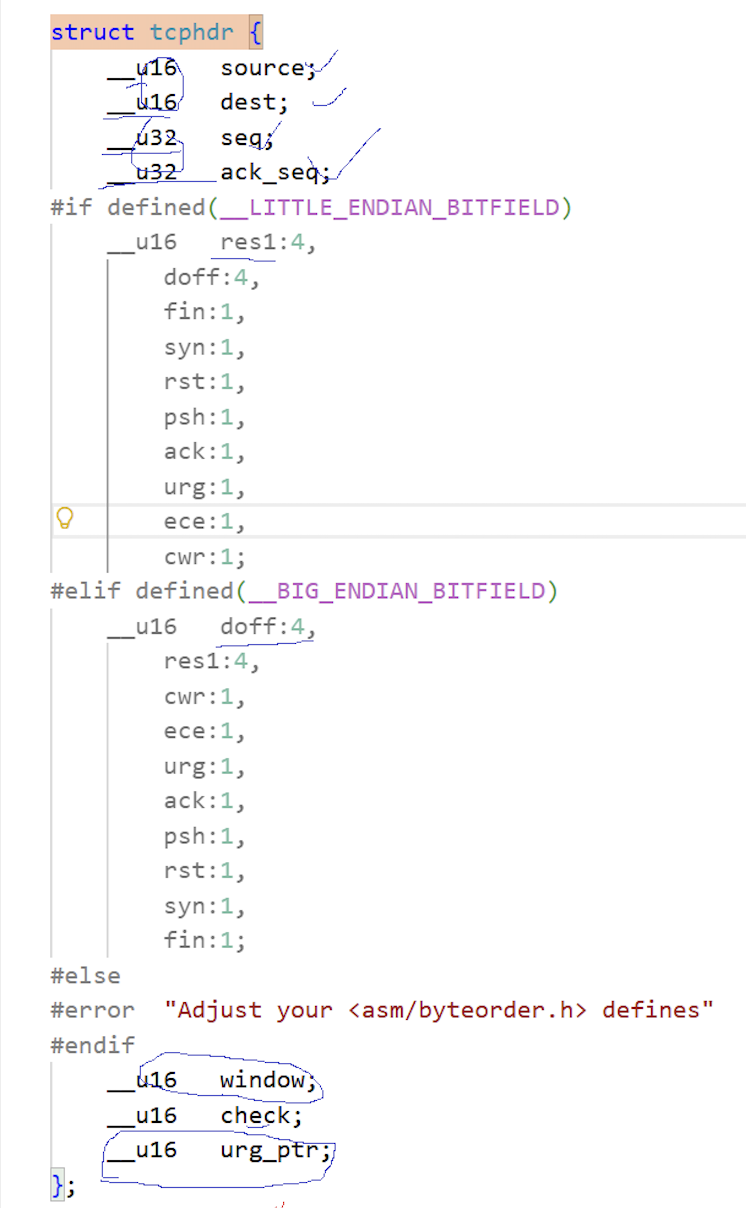
1.2 TCP协议段格式
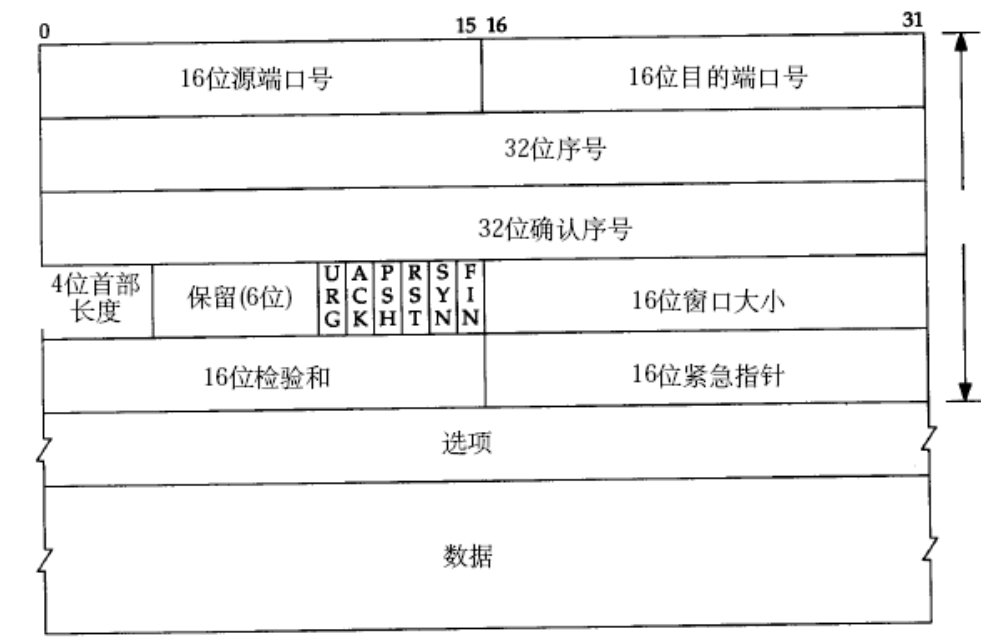
源/目的端口号: 表示数据是从哪个进程来,到哪个进程去;32位序号/32位确认号: 后面详细讲;4位TCP报头长度: 表示该TCP头部有多少个32位bit(有多少个4字节);所以TCP头部最大长度是15 * 4 = 606位标志位:
URG: 紧急指针是否有效ACK: 确认号是否有效PSH: 提示接收端应用程序立刻从TCP缓冲区把数据读走RST: 对方要求重新建立连接; 我们把携带RST标识的称为复位报文段SYN: 请求建立连接; 我们把携带SYN标识的称为同步报文段FIN: 通知对方, 本端要关闭了, 我们称携带FIN标识的为结束报文段16位窗口大小: 后面再说16位校验和: 发送端填充,CRC校验。接收端校验不通过,则认为数据有问题。此处的检验和不光包含TCP首部,也包含TCP数据部分。16位紧急指针: 标识哪部分数据是紧急数据;40字节头部选项: 暂时忽略;
TCP这块为什么没有告诉我,它的数据多长??
- 因为
TCP是面向字节流的,TCP只需要保证它的分片是排第几个,然后放在缓冲区里,将来读的时候让用户按顺序去读就可以了!它的性质就不需要长度!- 对
TCP来说只需要去掉报头,后面就是数据,至于后面数据是否是完整的,我TCP不管!TCP不为数据完整性负责!只需要保证报文给你了 后面多个报文组合形成更大TCP,你慢慢读就行,报文和报文边界由更上层觉定TCP不管!
1.3 对可靠性的正确认识
所谓可靠性:就是对发出去的报文,要有应答!只要收到应答,历史报文100%被对方收到!!
极端情况:我们还需要对应答做应答 !但是你怎么保证对应答做应答能收到呢??这样就还要对应答的应答做应答。。。。。无限套娃下去!!!
有一点需要和大家说: 这个世界上是不存在100%可靠的协议的,因为 最新的报文永远没有应答!(处于不确定状态!)
但是,我们对历史报文的可靠性是可以100%确定的!基于这一点我们就可以设计TCP可靠性了!(因为我们只需要确保第一条发送的消息是可靠的就行了)
1.4 确认应答(ACK)机制
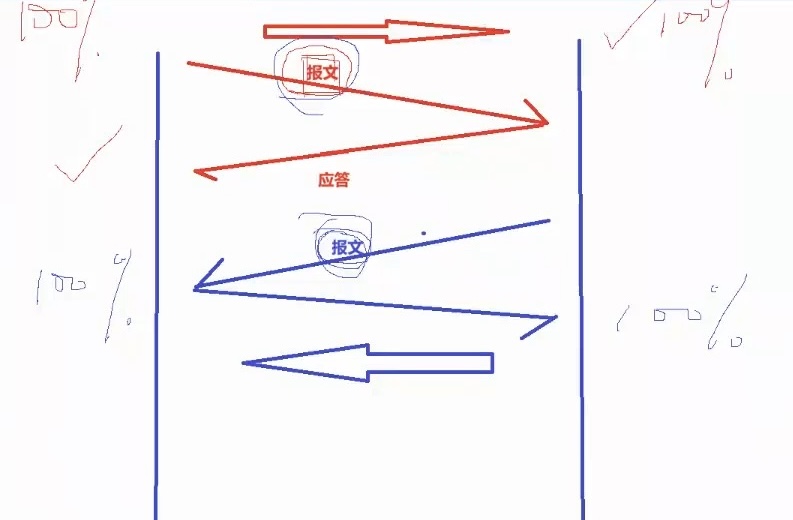
两个朝向上,发送报文,只要对报文进行应答,那么报文本身就是可靠的!!这个就叫确认应答机制!
这个不就是 全双工的可靠性!,其实 TCP可靠性主要体现在 你收到了,我得知道!而不是保证报文一定给你传过去(因为能不能收到主要看的是网络,不是TCP能解决的)!
如果A给B发,A没收到应答:
- 情况1:报文真丢了,A不会收到应答。
- 情况2:报文被B收到了,但是应答丢了。
最终表现:A没收到应答,A就会判断报文丢了!
那么A怎么知道虽然现在没有收到应答,未来不会收到呢?
所以
A会设置一个deadline(超时时间)!超过时间则判定为丢包!!
所以丢包只能是被规定出来的!(因为站在发送方视角,无法判断数据是真丢了还是应答丢了)
⚠️:确认应答机制的核心,不是保证数据100%发送给对方(这是网络决定的);而是对于发送方,对方有无收到报文,发送方有一个确定的结果!
1.5 超时重传机制(序号的一个作用)
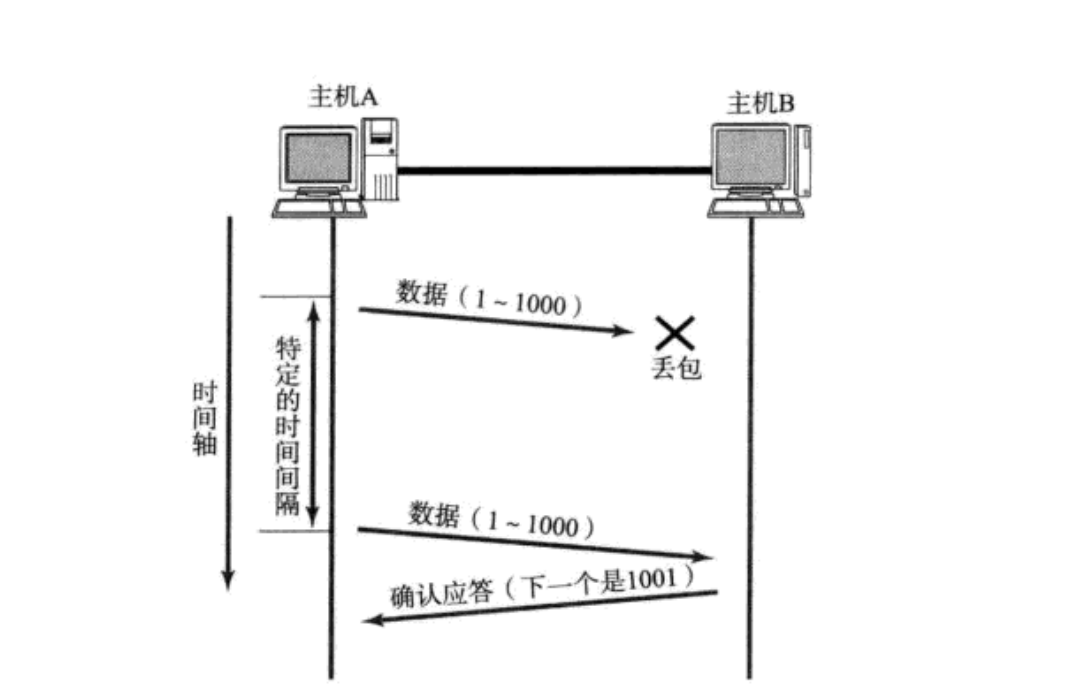
主机A发送数据给B之后, 可能因为⽹络拥堵等原因, 数据⽆法到达主机B;如果主机A在⼀个特定时间间隔内没有收到B发来的确认应答, 就会进⾏重发!
但是, 主机A未收到B发来的确认应答, 也可能是因为ACK丢失了!
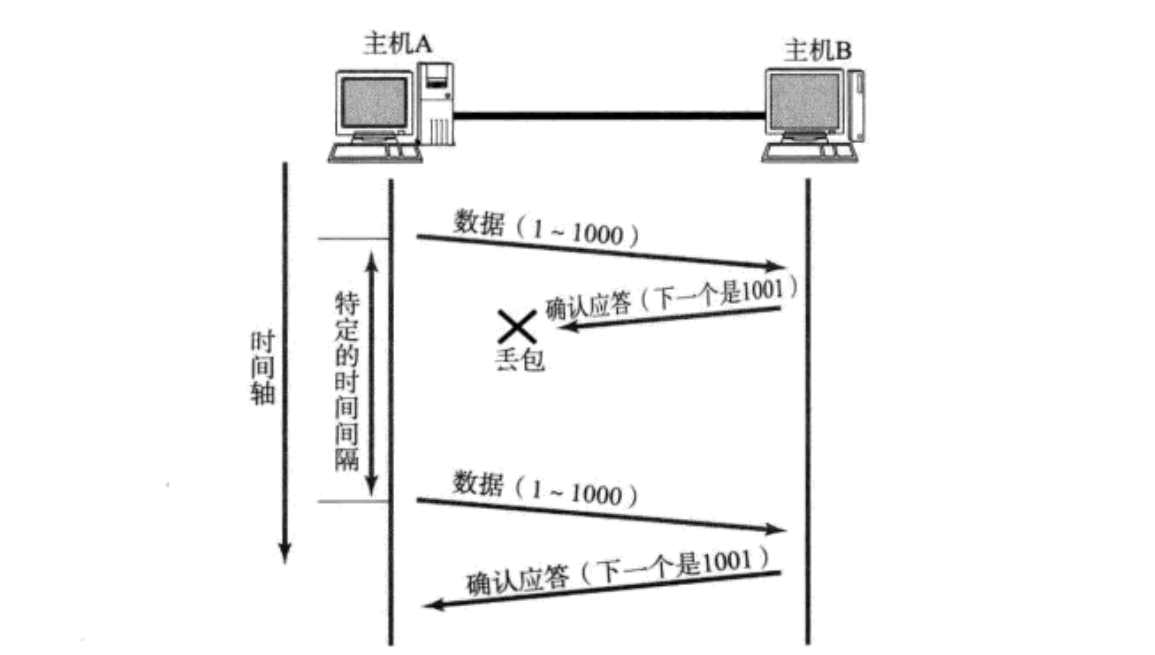
因此主机B会收到很多重复数据. 那么TCP协议需要能够识别出那些包是重复的包, 并且把重复的丢弃掉!!
这个就是32位序列号所做的工作了(目的就是去重!出现序列号相同报文咱们就丢掉,一般是丢掉老的那个!然后再发个应答就行)
1.6 TCP通信的两种模式(通过序号、确认序号解决接收方的乱序问题)
- 串行: 发一个,收到应答再发一个
- 流水线: 一次性连续发一串报文;只要收到其中某个 ACK,可以继续发新报文,不用等全部 ACK 回来(先了解后面会详细解析)
由于网络情况的复杂性,无法保证先发的报文就一定先到,这样就会导致报文的乱序问题!
于是,就有了序号!于是主机A给B发报文,通过序号排序,就能保证接收方最终收到的所有信息顺序是正确的!
问题又来了:发了4个报文,拿到了3个应答,我们怎么知道哪个报文丢了??
于是报头有了个确认序号这个东西!
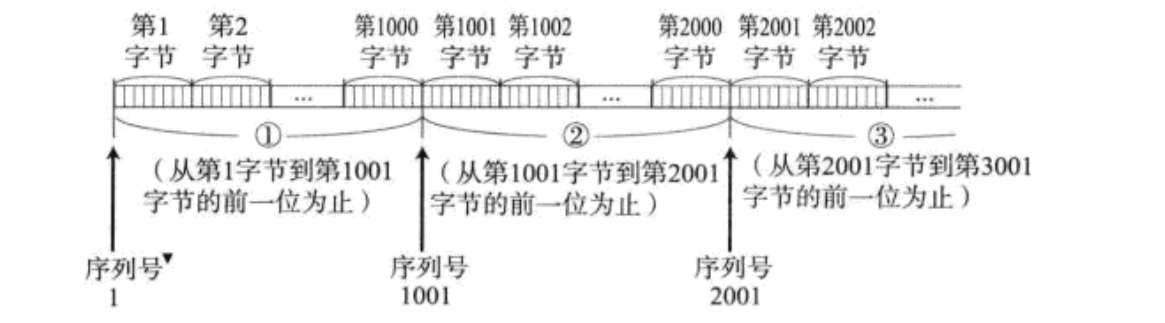
- 确认序号:自己收到的序号+1,就是确认信号!
- 含义:该序号之前的
所有数据我收到了!(这个含义可以有效减少报文重发次数) - 比如:收到了
1001、2001、4001的应答,于是我们就知道是序号3000的应答丢失了!!但是因为 我们收到4001的应答,于是 我们就知道丢的不是报文而是应答!就不对报文进行重传了!这个确认序号4001就是在告诉发送方,下次发送报文可以从4001开始发!!!
ps:如果
1000、2000、3000、4000报文,3000丢了,此时序号4000的报文的应答就是2001(它有特殊机制,会让4000的报文不重传,后面会说)
一些细节问题(发送什么报文和应答)
站在传输层 ,发送的是TCP报文 = 报头 + 有效载荷!【本质就是结构体变量啊!!】
发送的是这个:
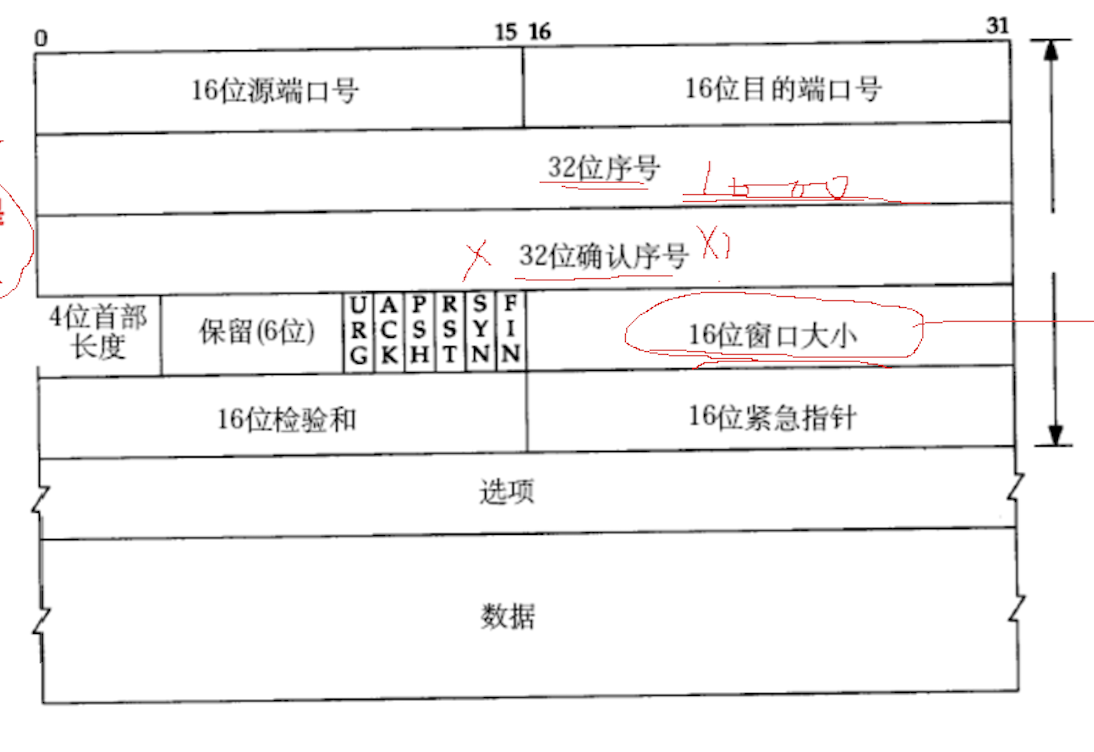
那么应答呢?应答是不是至少是这个:
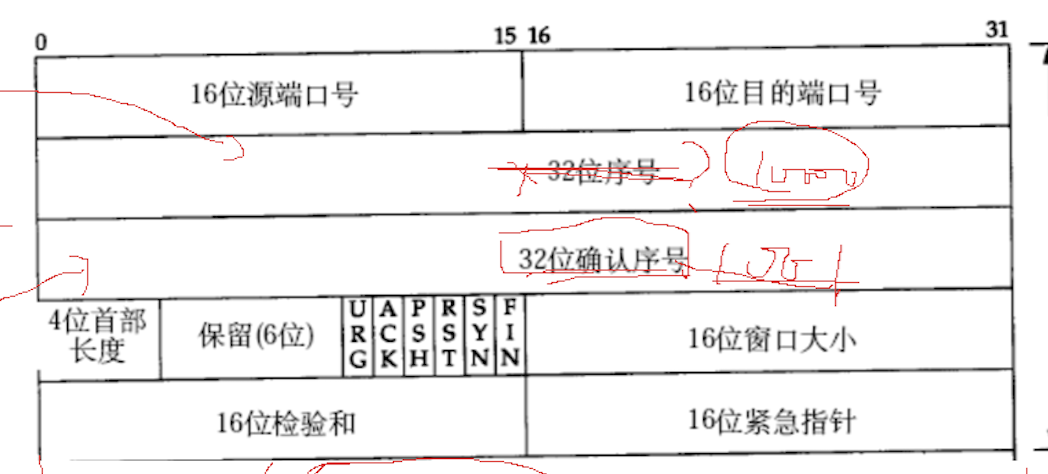
问题又来了:那为什么序号和确认序号要分开呢??明明只需要一个啊?
主机A给B发消息,那么B也可以给A发消息(假设序号一个1000 一个10000开头)。A给B发消息的时候,B收到后准备给A发消息,同时也要应答,反正都是要发,为什么不能消息和应答放在一起呢??这个就叫
捎带应答!!!
⚠️:我们看到的应答 可能既是消息也是应答,这种 序号和分离序号分别设计的机制,就可以让发送数据和发送确认同时进行了!
序号的作用
所以综上 两个序号的作用:
- 去重
- 按序到达
- 捎带应答
- 超时充传(传谁)
1.7 窗口大小的作用
接收端处理数据的速度是有限的. 如果发送端发的太快, 导致接收端的缓冲区被打满, 这个时候如果发送端继续发送, 就会造成丢包, 继而引起丢包重传等等一系列连锁反应.
因此TCP支持根据接收端的处理能力, 来决定发送端的发送速度. 这个机制就叫做流量控制(Flow Control);
问题1: 接收方,如何衡量自己的接收能力?
接收缓冲区,剩余空间的大小。
问题2:发送方如何得知对方的接收能力?
把自己的接受能力,填写到
应答报文的16位窗口大小中!
- 接收端将 自己可以接收的缓冲区剩余空间大小 放入 TCP 首部中的 "
窗口大小" 字段, 通过ACK端通知发送端; - 接收端一旦发现自己的缓冲区快满了, 就会将窗口大小设置成一个更小的值通知给发送端;
- 发送端接受到这个窗口之后, 就会减慢自己的发送速度;
问题3:如果发送方发的太慢呢??
ACK里面窗口大小调大一点,也能让发送方发快一点!
所以流量控制是涵盖 可靠性和效率的~!
如果接收端缓冲区满了, 就会将窗口置为0; 这时发送方不再发送数据, 但是需要定期发送一个窗口探测数据段, 使接收端把窗口大小告诉发送端.
1.8 6位标志位
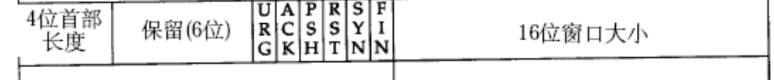
报文分好多种,应答报文、建立连接的、断开链接的、数据报文等。TCP通过标志位来区别报文。
1. ACK
该标志位为1,则表明是应答报文!
由于携带应答的存在,大部分报文的ACK标志位都是置1的!
2. SYN(简单理解一下三次握手建立链接、什么是链接)
当该标志位为1时,表示该报文为链接建立的请求报文!
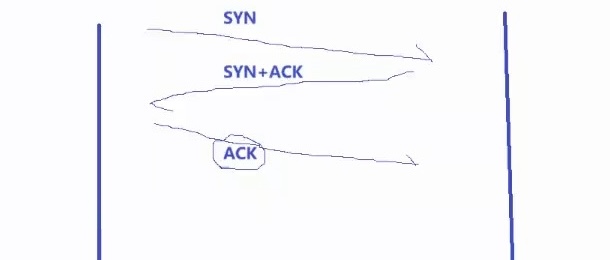
建立连接(connect) 需要进行 三次握手! 那么什么是 三次握手?
- 主机A向主机B发送报文,标志位为
SYN(注意: 发送的是TCP协议的报头 ) - 主机B向主机A发送报文,标志位为
ACK+SYN - 随后主机A向主机B发送报文,标志位为
ACK
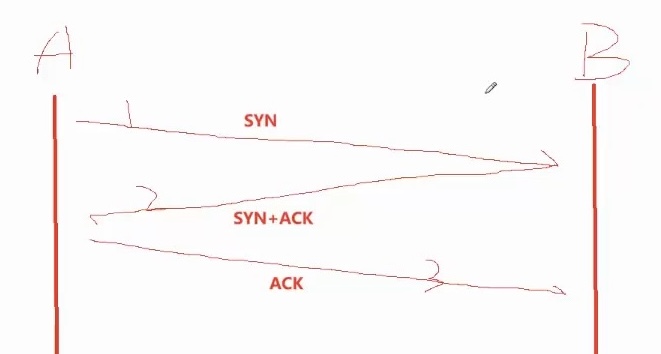
这个过程,就叫 三次握手!
怎么理解三次握手?
举个简单的列子:男孩怎么最快向女孩告白
- 男:可不可以做我女朋友(SYN)
- 女:好啊(SYN),什么时候(ACK)
- 男:就现在(ACK)
至此以最少字数,完成了建立链接的过程!
问题又来了:什么是链接?双方OS内部都会有大量链接,OS要怎么管理?
先描述再组织,构建
链接结构体!
链接建立最明显的表现就是 当代码connect成功,就会返回文件描述符!,所谓的 链接 不就是 文件吗?即 tcp_sock
点进
inet_connection_sock inet_conn里面就会有建立链接时的请求队列,以及超时充传的定时器相关内容。其中里面的
inet_sock,则是保存了套接字相关信息!
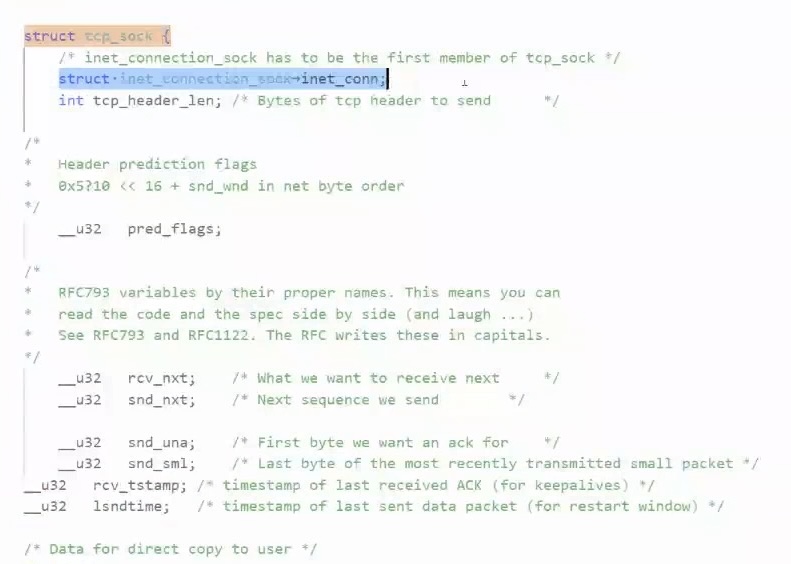
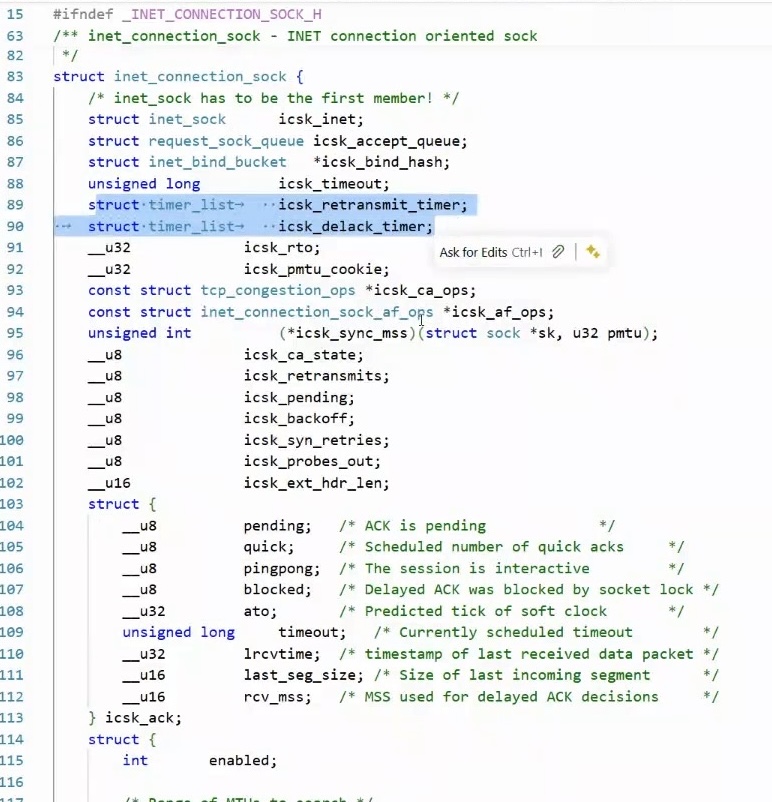
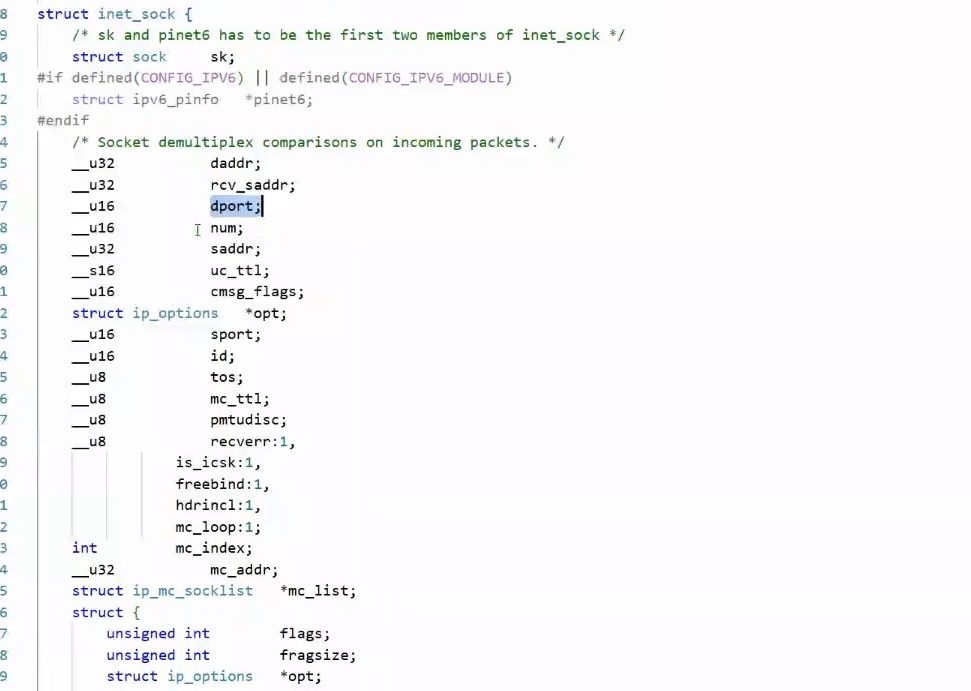
所以说 建立链接时有成本的!时间+空间 明显比UDP复杂的多!
那么为什么要有三次握手?
在通信前,要保证什么? 网络是通畅的! 站在A、B角度因为B会发
SYN+ACK、然后A会回发ACK,这个过程就保证了 A、B两端都是可以发数据、收数据的!以三次握手的方式, 用最小次数验证全双工!!
3. FIN(4次挥手)
如果想要断开通信呢?需要经历4次挥手!
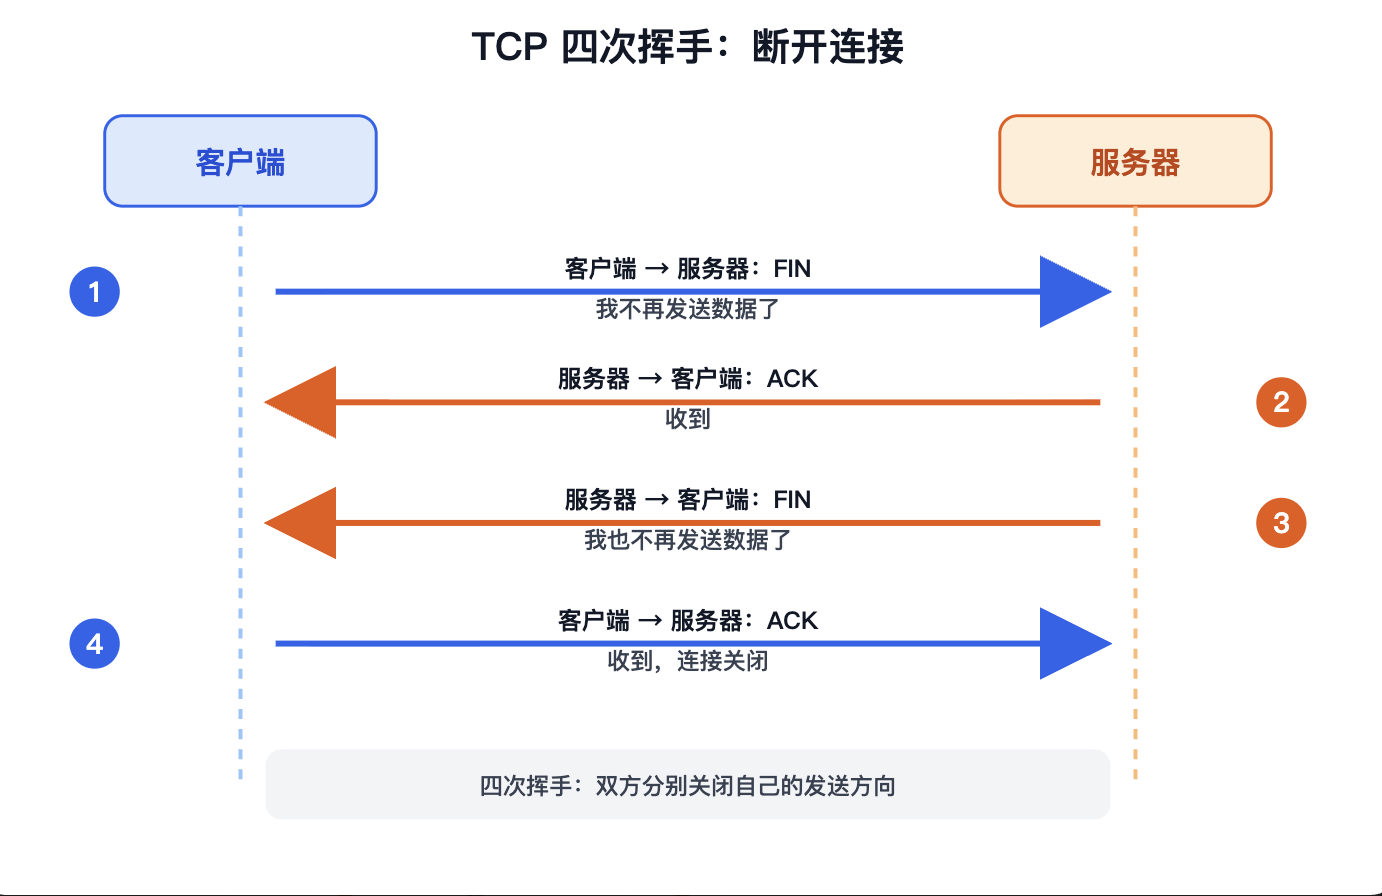
FIN: 通知对方, 本端要关闭了, 我们称携带FIN标识的为结束报文段
为什么断开链接要进行4次挥手?
离婚需要双方都签字是不是(防止一方不愿意啊)?? 那么4次挥手,则是一方发出断开请求,一方同意,分手时双方都要同意的,所以要来回各一次!以最小成本争得双方同意,不再有纠纷赖账的事情了!
此时双方链接结构体也都释放了,代码 层面你只是做了个
close(fd),实际上 是进行了4次挥手 断开链接 文件系统上则是关闭文件!
4次挥手
本质是关闭全双工,A发SYN表示我再也不给你发消息了,B发ACK和SYN表示我知道了,我也再也不给你发消息了,A回答ACK,至此全双工关闭!! 这么做是防止一端关闭一端还给你发信息这种极端情况!
当然 4次挥手中的中间两次 ACK和FIN可以合并成一次 捎带应答!即 4次挥手也可以变成3次挥手。
那么同理 把三次握手中的SYN和ACK拆开不就是 4次握手了!因为建立关系也要双方同意!
4. 链接断开链接总结
总结:你要结婚(建立链接),需要双方同意(双端),双方家长同意(网络),即 双方主机建立通信共识,验证全双工(即网络畅通)!至此无人能阻挡你们通信了!!断开链接也是同理!
常见情况:为什么喜欢建立链接说3次握手;断开说4次挥手?明明建立断开本质都是一回事(即双方建立共识 )
虽然 4次挥手经常会变成3次挥手,但是3次握手很少会变成4次握手,因为 你服务器基本上必须无条件答应建立链接,所以
SYN+ACK可以压缩在一起!!但是断开链接不一定了!你服务器有消息没发完(上层业务的事),经常会等发完消息,再断开链接,所以常常会分开来发 (类比 你要离婚 其中一方最常说的就是 等娃高考完咱再离婚(同意,但不立刻断开链接!))
5. RST
对于
A端发出SYN收到SYN+ACK,并发出ACK即3次握手完毕,但对于B端呢?是不是必须收到SYN,发出SYN+ACK,并收到ACK才三次握手完毕。这就会导致最后一次
ACK因为没应答,B端不一定能100%收到啊!但是对于A端来说已经握手完成,就有可能直接发送消息!B端收到消息后,发现明明没握手完成啊??于是B端就会发送RST!告诉A端链接出现意外了, 该重新建立链接了!!
这也反向说明 TCP建立链接本质上是在赌,赌你最后一次ACK收到了
6. PSH
众所周知 接收端缓冲区满了, 就会将窗口置为0; 这时发送方不再发送数据,就会等!等是等多久呢?
我们知道 发送端此时会发送 一个窗口探测数据段(不发数据不代表不能发报头),然后接受端就会不断发ACK同时更新窗口大小,告诉发送端此时缓冲区大小!
那么如果窗口大小 一直是0呢??那么此时发送端就会开始 "不耐烦"了,就把自己 报头中的PSH标志位置为1 ,那么 接受端意识到 对面 忍耐度到极限了!于是通知应用层,尽快将数据取走!!
当然 上面的例子 有点极端了 !在常规通信中,PSH也能携带,比如说xshell、xterminal中,每次通信会把PSH带上,目的就是告诉bash,尽快把命令解析完把结果给我!
所以 应用层最好以读取数据为第一优先级,正常情况下OS都会等你有一定数据量的时候再统一调度进程进行读取(减少IO),那么PSH本质就是 让你的进程从等待队列放到就绪队列,你上层决定怎么读取,什么时候读取就不关OS的事情了!
7. URG
在TCP报头中 有16位紧急指针 URG说人话就是: 判断你紧急指针有没有效!
那么 紧急指针是什么呢?
8. 16位紧急指针
具有唯一且有一定指向型的数据都可以称为指针!(类似数组下标)!这里的指针本质是一段偏移量!
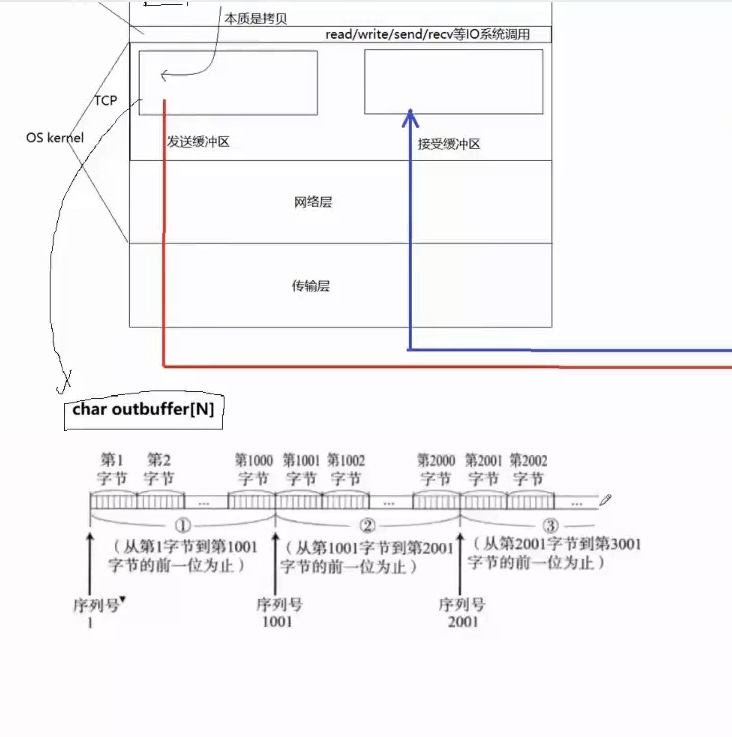
我们可以将 发送缓冲区 理解成char outbuffer[N],那么每一个字节不就天然拥有序号了吗??
那么我先发送前1000个字节(只算数据部分),那么我的序号不就1000吗?(当然真实情况底层会有一个随机启始序号,通过一定转换变成下标), 而我们只需要把 紧急指针理解成 应用层缓冲区的偏移量!【这里的偏移量 我们要理解成转换后的第N个字节!就是不管你是序号是多少,看的是你缓冲区的第几个!】
一般情况下,紧急指针指向数据 只有一个字节!
因为TCP是通过序号控制顺序,按序处理数据,如果有些数据突然要提前处理呢?
例如,客户端正在发送大量数据时,用户突然按下"停止"按钮,程序可以发送一段紧急数据,并设置:
text
URG = 1
Urgent Pointer = 紧急数据的位置服务器看到后,就知道这是一条需要优先处理的消息。【本质就是插队用的! 】
那么 OS怎么优先读取呢?
在recv接口中的flags参数中 ,有一个参数叫MSG_OOB
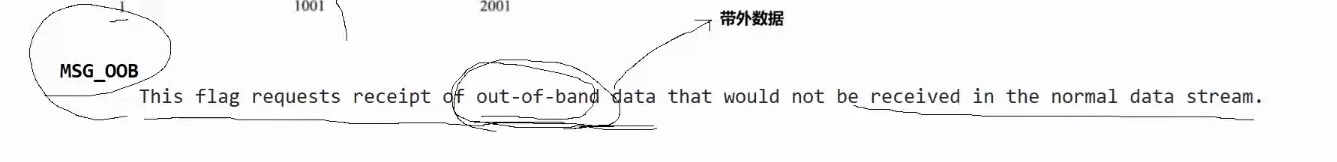
图中讲的是 MSG_OOB,它是 recv() 接收函数的一个标志,用来读取 TCP 的"带外数据"(Out-of-Band Data)。
cpp
recv(sockfd, buffer, size, MSG_OOB);普通情况下:
cpp
recv(sockfd, buffer, size, 0);只能读取正常数据流;如果发送方发送了紧急数据,接收方可以使用 MSG_OOB 单独读取它。
例如:
text
普通数据:ABCDEF
紧急数据:STOP
使用 MSG_OOB 就是请求读取 STOP 这类紧急数据,而不是从普通数据流中读取。这就需要上层程序员要在应用层可以有处理紧急指针对应的逻辑!
当然现在程序很少用了,因为建立两条链接也能解决!
2. TCP协议的一些机制细节
2.1 超时重传机制时间的设置
- 最理想的情况下,找到一个最小的时间,保证 "确认应答一定能在这个时间内返回".
- 但是这个时间的长短,随着网络环境的不同,是有差异的, 所以必须随网络状态进行波动!
- 如果 超时时间设的太长,会影响整体的重传效率;
- 如果 超时时间设的太短,有可能会频繁发送重复的包;
TCP为了保证无论在任何环境下都能比较高性能的通信,因此会 动态计算这个最大超时时间.
- Linux中(BSD Unix和Windows也是如此),超时以
500ms为一个单位进行控制,每次判定超时重发的超时时间都是500ms的整数倍. - 如果重发一次之后,仍然得不到应答,等待
2*500ms后再进行重传. - 如果仍然得不到应答,等待
4*500ms 进行重传.依次类推,以指数形式递增. - 累计到一定的重传次数,TCP认为网络或者对端主机出现异常,强制关闭连接.
2.2 连接管理机制
在正常情况下, TCP要经过三次握⼿建⽴连接, 四次挥⼿断开连接
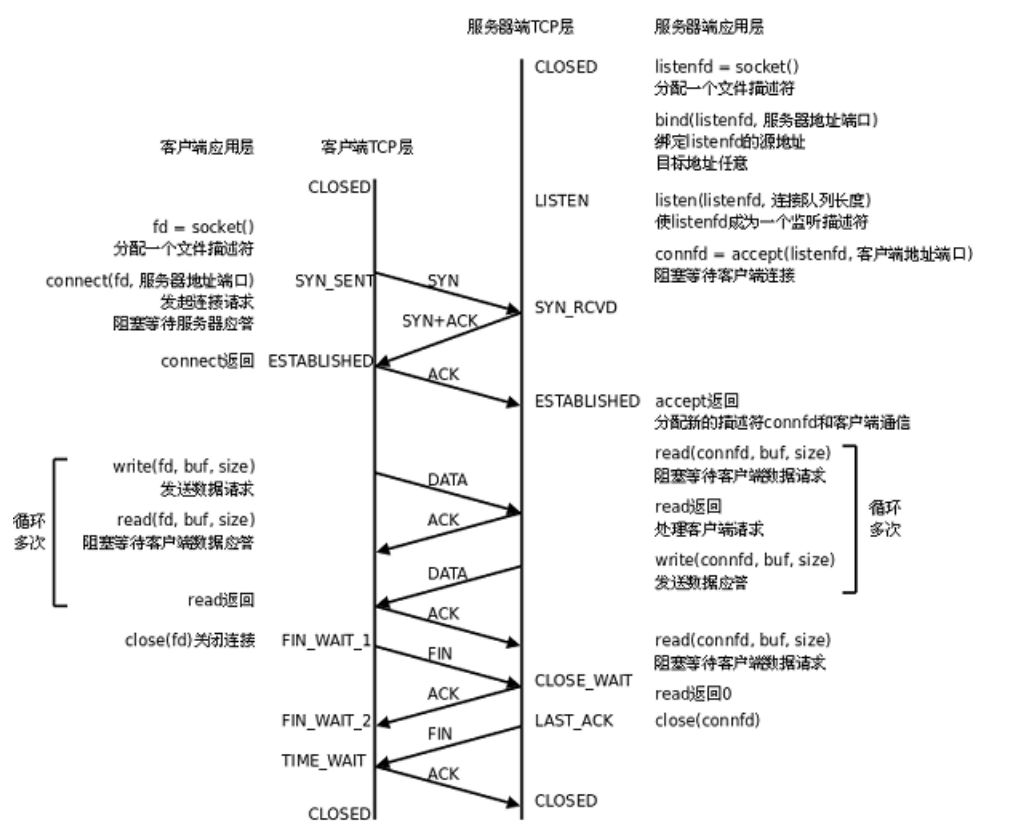
2.2.1 再次聊聊3次握手
结论: 三次握手,只考虑自己一方,每一次都是从发出或者收到开始的!由双方TCP层,自主完成!所以说应用层的connect并不关心三次握手细节,只是告诉底层要建立握手!而accept本质是获取已经建立好的链接!(自身是不参与链接过程的)
为什么是3次握手?(前面写过,这里总结答案)
阻碍通信的情况:
- 双方意愿
- 网络问题
三次握手,可以验证网络问题, 以最小次数验证全双工(本质就是以最小成本验证网络问题)!
一方的发送的SYN收到ACK,相当于得到了对端的许诺,该过程双方各进行了一次 相当于互相得到了许诺! 以最小成本验证双方意愿问题!
因为我们已经证明了3次可行,4次、5次就没必要了!我们现在只需要证明为什么2次不行即可!
那为什么2次不行?
A给B发SYN,B收到发ACK,A收到ACK!
该过程可以证明 对A来说 我能发、我能收;但对B来说 只能证明我能收,无法说明我能发给A(因为B不知道A会不会收ACK!不确定)
对B来说,无法验证B到A网络是否通畅,更无法验证A意愿问题(打个简单比方 万一A是渣男呢?我发起请求但是不接受你的信息),在网络中 必须双方都有明确请求回应才行!
⚠️:在目前网络中 发起建立链接的99.9%是客户端,而服务端不会拒绝!
2.2.2 再次聊聊4次挥手
要有个理解:双方都可以作为主动断开链接的一方!(我们后面以客户端主动断开为例子)
那么断开链接本质是什么?本质就是 只是一方不写数据了!
客户端发送完了(关闭了到服务端的信道),给服务端发FIN,但是服务端未必发完了,中间过程服务端还会给客户端持续发送数据,等服务端发完了,向客户端发FIN,意思是我也不写了(关闭到客户端的信道)
等双方信道都关闭了,那么通信也就没必要了!所以 此时链接结构体才正式关了!
所谓的断开链接,不是彻底释放链接,只是将链接标志位进行修改了!而一方释放链接,只是不写数据了,不是不发报头和 标志位了!!!
对于代码close只是应用层关闭了fd,关闭了读写端,对os来说就是告诉TCP层要进行4次挥手!
2.2.3 shutdown(在应用层做到局部关闭)
shutdown() 是用来关闭 socket 某个方向的通信接口,比 close() 更细致。
cpp
#include <sys/socket.h>

int shutdown(int sockfd, int how);
how 有三种取值:
cpp
SHUT_RD    // 关闭读方向
SHUT_WR    // 关闭写方向
SHUT_RDWR  // 读写方向都关闭
例如:
cpp
shutdown(sockfd, SHUT_WR);表示"我不再向对方发送数据了",但仍然可以继续接收对方的数据( 此时底层触发挥手! )。对方收到后,读取数据时通常会得到 0,表示对方已经关闭了发送方向。
shutdown(sockfd, SHUT_RDWR) 会关闭读写两个方向;而:
cpp
close(sockfd);通常是直接关闭文件描述符和 socket。简单说,shutdown() 用于控制通信方向,close() 用于彻底释放 socket。
2.2.4 理解listen第二个参数
cpp
#include <sys/socket.h>

int listen(int sockfd, int backlog);在没有accept前,链接依然能够建立成功
但是接受端维持的暂时不用accept到应用层的链接的个数是有限的,backlog+1!
而底层维持暂时不用accept到应用层的链接 叫 全链接队列(上限就是backlog+1)!
全连接队列可以理解为服务器门口的"等候区",本质是OS内部的一个
缓冲结构:客户端完成 TCP 三次握手后,连接已经建立成功,但服务器程序还没来得及调用accept()把它取走时,这个连接就先放在全连接队列里等待。服务器调用一次accept(),就从队列中取出一个已建立的连接进行通信;如果队列满了,后续客户端可能连接失败、超时或被延迟处理。
2.2.5 理解连理链接断开链接的状态转换
服务端状态转化:
- `CLOSED -> LISTEN` 服务器端调用
listen后进入LISTEN状态,等待客户端连接; - `LISTEN -> SYN_RCVD` 一旦监听到连接请求(同步报文段),就将该连接放入内核等待队列中,并向客户端发送
SYN确认报文。 - `SYN_RCVD -> ESTABLISHED` 服务端一旦收到客户端的确认报文,就进入
ESTABLISHED状态,可以进行读写数据了。 - `ESTABLISHED -> CLOSE_WAIT` 当客户端主动关闭连接(调用
close),服务器会收到结束报文段,服务器返回确认报文段并进入CLOSE_WAIT; - `CLOSE_WAIT -> LAST_ACK` 进入
CLOSE_WAIT后说明服务器准备关闭连接(需要处理完之前的数据);当服务器真正调用close关闭连接时,会向客户端发送FIN,此时服务器进入LAST_ACK状态,等待最后一个ACK到来(这个ACK是客户端确认收到了FIN) - `LAST_ACK -> CLOSED` 服务器收到了对
FIN的ACK,彻底关闭连接。
客户端状态转化:
- `CLOSED -> SYN_SENT` 客户端调用
connect,发送同步报文段; - `SYN_SENT -> ESTABLISHED`
connect调用成功,则进入ESTABLISHED状态,开始读写数据; - `ESTABLISHED -> FIN_WAIT_1` 客户端主动调用
close时,向服务器发送结束报文段,同时进入FIN_WAIT_1; - `FIN_WAIT_1 -> FIN_WAIT_2` 客户端收到服务器对结束报文段的确认,则进入
FIN_WAIT_2,开始等待服务器的结束报文段; - `FIN_WAIT_2 -> TIME_WAIT` 客户端收到服务器发来的结束报文段,进入
TIME_WAIT,并发出LAST_ACK; - `TIME_WAIT -> CLOSED` 客户端要等待一个
2MSL(Max Segment Life,报文最大生存时间)的时间,才会进入CLOSED状态。
MSL(Maximum Segment Lifetime)是 TCP 的"报文最大生存时间",表示一个 TCP 报文段在网络中最多可以存在多久,超过这个时间就会失效!
下图是TCP状态转换的⼀个汇总
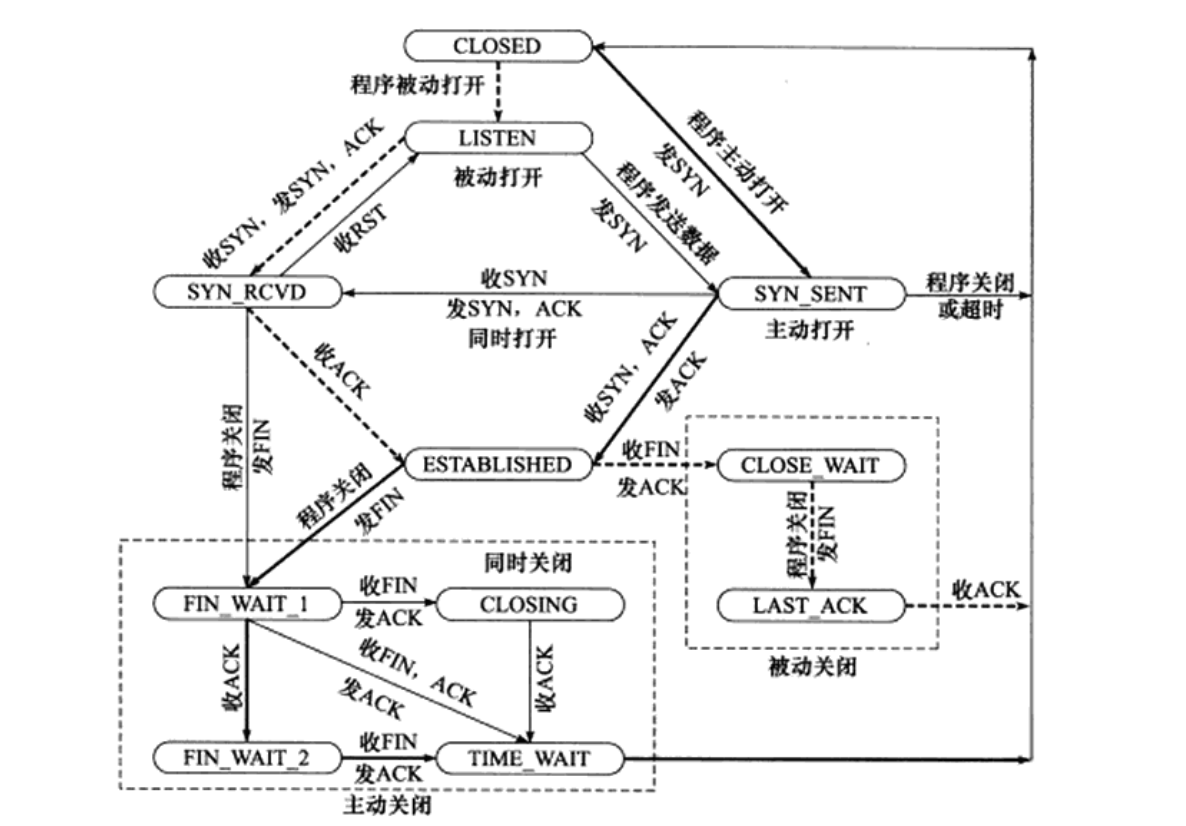
- 较粗的虚线表⽰服务端的状态变化情况;
- 较粗的实线表⽰客⼾端的状态变化情况;
2.2.6 理解TIME_WAIT状态
现在做⼀个测试,⾸先启动server,然后启动client,然后⽤Ctrl-C使server终⽌,这时⻢上再运⾏server, 结果是:
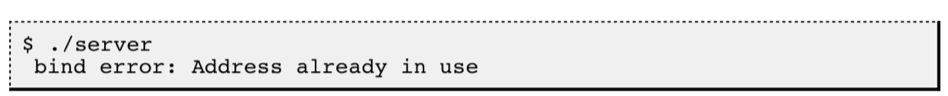
这是因为,虽然server的应⽤程序终⽌了,但TCP协议层的连接并没有完全断开,因此不能再次监 听同样的server端⼝. 我们⽤netstat命令查看⼀下
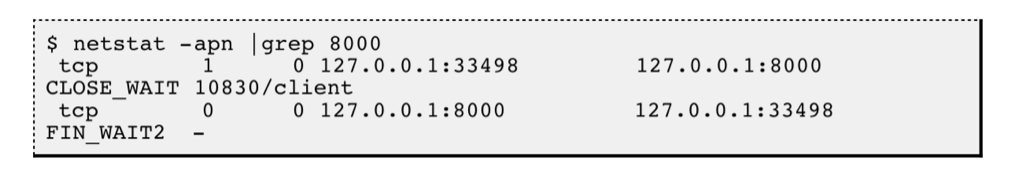
- TCP协议规定,主动关闭连接的⼀⽅要处于
TIME_ WAIT状态,等待两个MSL(maximum segment lifetime)的时间后才能回到CLOSED状态. - 我们使⽤
Ctrl-C终⽌了server, 所以server是主动关闭连接的⼀⽅, 在TIME_WAIT期间仍然不能再次监听同样的server端⼝;
可以通过
cat /proc/sys/net/ipv4/tcp_fin_timeout查看msl的值(不同系统该值不同)

为什么是 TIME_WAIT 的时间是 2MSL ?
text
主动关闭方                         被动关闭方
    FIN  ------------------------>
        <------------------------  ACK
        <------------------------  FIN
    ACK  ------------------------>
             进入 TIME_WAIT
等待 2MSL 主要有两个原因:
- 确保最后的 ACK 能让对方收到
如果最后一个ACK丢失,对方可能会重新发送FIN。处于TIME_WAIT的一方虽然客⼾端的进程不在了, 但是TCP连接还在, 仍然可以重发LAST_ACK;如果立即关闭,就无法处理这个重传。 - 让网络中的旧报文消失
旧连接中可能还有延迟或重复的报文。 如果马上使用相同的 IP、端口和序列号建立新连接,旧报文可能被误认为是新连接的数据。等待2MSL可以降低这种风险。
例如,假设系统设置:
text
MSL = 60 秒那么主动关闭方通常需要保持:
text
TIME_WAIT = 2MSL = 120 秒简单说,MSL 就是"旧 TCP 报文最多在网络中存在多久",而 TIME_WAIT 等待 2MSL, 是为了确认连接真正结束,并防止旧报文干扰新连接。
将上述答案总结成两点就是:
- 确保双方4次挥手都尽可能正确完成
- 让陈旧报文,在网络中尽可能消散
2.2.7 解决TIME_WAIT状态引起的bind失败的⽅法
在 server 的 TCP 连接没有完全断开之前不允许重新监听, 某些情况下可能是不合理的:
高并发短连接场景下,如果服务端主动关闭TCP连接 ,会生成大量
TIME_WAIT状态连接。
TIME_WAIT会占用通信五元组,服务端IP、端口固定,当新客户端的五元组和处于TIME_WAIT的连接发生复用冲突时,就会引发网络异常。
使⽤ setsockopt ()设置 socket 描述符的 选项SO_REUSEADDR 为 1 , 表⽰允许创建端⼝号相同,但IP地址不同的多个 socket 描述符
setsockopt() 用来设置 socket 的各种属性,让我们调整它的行为。
cpp
#include <sys/socket.h>

int setsockopt(
    int sockfd,
    int level,
    int optname,
    const void *optval,
    socklen_t optlen
);
例如:
cpp
int opt = 1;
setsockopt(sockfd, SOL_SOCKET, SO_REUSEADDR,
           &opt, sizeof(opt));
这表示允许 socket 重用本地地址,服务器重启时可以更快重新绑定端口。
2.3 流量控制
接收端处理数据的速度是有限的. 如果发送端发的太快, 导致接收端的缓冲区被打满, 这个时候如果发送端继续发送, 就会造成丢包, 继⽽引起丢包重传等等⼀系列连锁反应。
因此TCP⽀持根据接收端的处理能⼒, 来决定发送端的发送速度. 这个机制就叫做流量控制(FlowControl);
- 接收端将自己可以接收的缓冲区剩余空间大小放入 TCP 首部中的 "窗口大小" 字段, 通过
ACK端通知发送端;- 窗口大小字段越大, 说明网络的吞吐量越高; ( 例如,窗口只有 10 KB,发送完 10 KB 就必须等 ACK;窗口为 1 MB,就能先连续发送 1 MB,再等待确认,网络利用率更高。)
- 接收端一旦发现自己的缓冲区快满了, 就会将窗口大小设置成一个更小的值通知给发送端;
- 发送端接受到这个窗口之后, 就会减慢自己的发送速度;
- 如果接收端缓冲区满了, 就会将窗口置为0; 这时发送方不再发送数据, 但是需要定期发送一个
窗口探测数据段(报头), 使接收端把窗口大小告诉发送端.(这一段可以看看1.8 的PSH部分 )
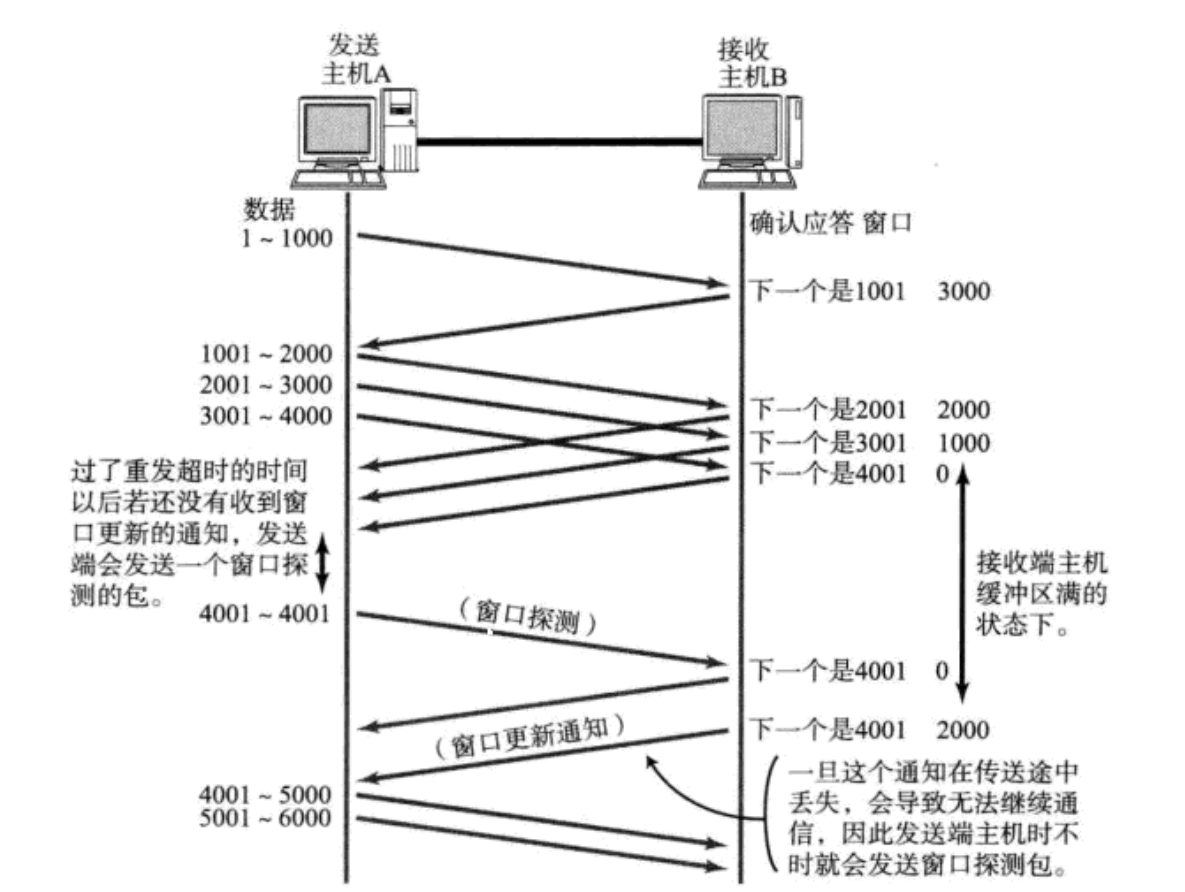
那么问题来了, 16位数字最⼤表⽰65535, 那么TCP窗⼝最⼤就是65535字节(64kb左右)么?
实际上, TCP⾸部40字节选项中还包含了⼀个窗⼝扩⼤因⼦M, 实际窗⼝⼤⼩是 窗⼝字段的值左移 M 位;
那么 当我三次握手完成,第一次发送数据的时候,应该发送多大的数据??
在三次握手的的时候,双方都互相交换过
ACK,不就交换过窗口大小了嘛!
2.4 滑动窗口
对每⼀个发送的数据段, 都要给⼀个ACK确认应答. 收到ACK后再发送下⼀个数据段. 这样做有⼀个⽐较⼤的缺点, 就是性能较差. 尤其是数据往返的时间较⻓的时候
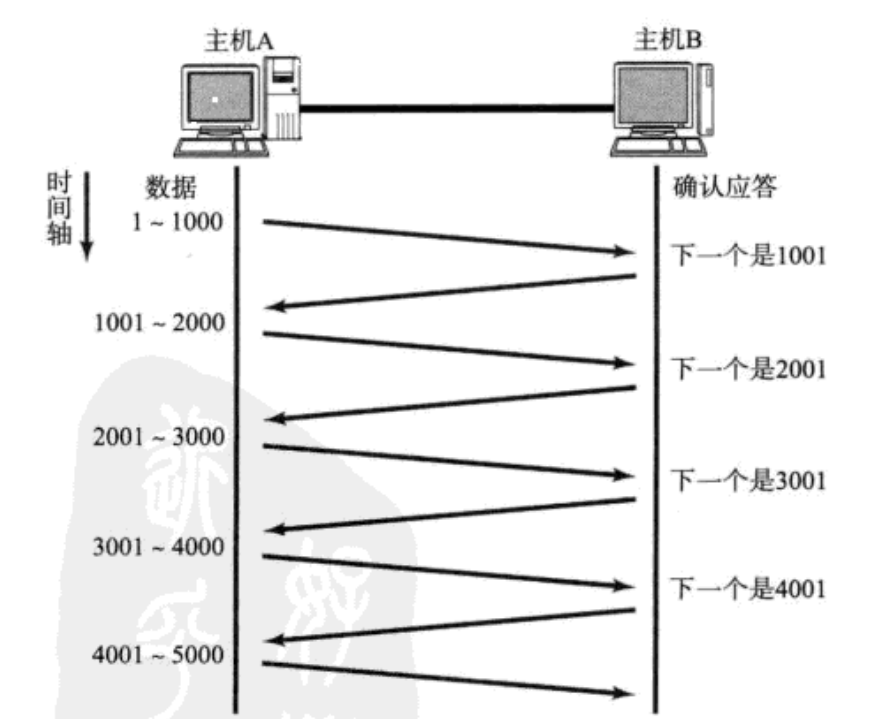
既然这样⼀发⼀收的⽅式性能较低, 那么我们⼀次发送多条数据, 就可以⼤大提⾼性能(其实是将多个段的等待时间重叠在⼀起了).
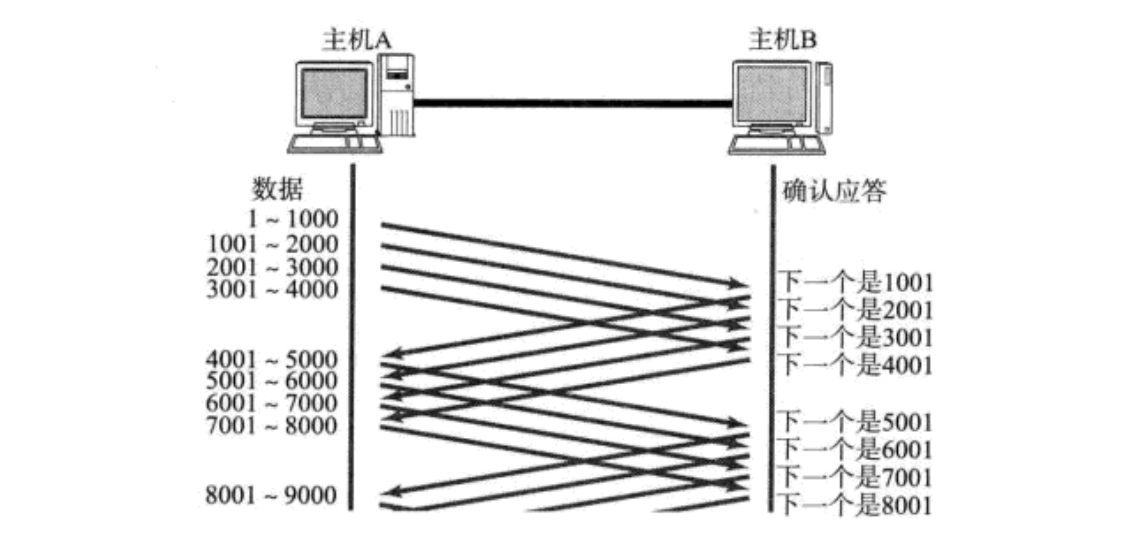
2.4.1 理解滑动窗口
那么 滑动窗口在哪里呢?
滑动窗口就是 发送缓冲区的一部分区域!
⚠️:为了方便理解,我们将发送接受缓冲区都当作数组 char buffer[N]看!(OS内核实际怎么做的咱们不考虑!因为逻辑上是线形结构的)
那么,什么是滑动窗口?
滑动窗口 实际上可以理解成就是
start、end两组数组下标!表示在【start,end】这个区间内的数据,即 该区域内数据可以直接发出,暂时不收应答!
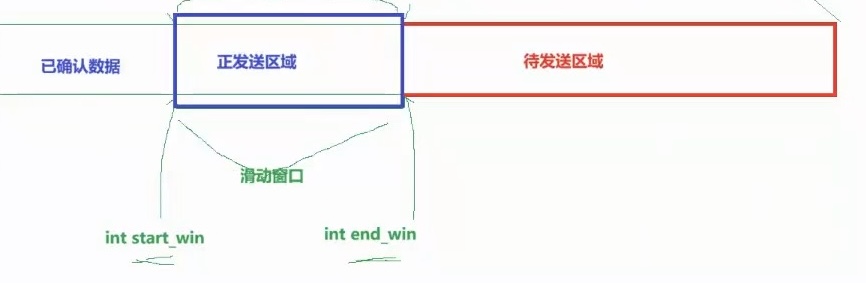
当然,也不能将其单纯理解成一纬数组,而是要理解成 以一纬数组为载体的被划分为三个区域的相关结构!
text
已确认数据 | 已发送未确认数据 | 未发送窗口随着 ACK 到达向右移动:
text
原来:已确认 | 未确认 | 未发送
后来:已确认更多 | 未确认 | 未发送
综上: 滑动窗口是一种逻辑上的一维序列模型,数据按照序列号被划分成多个区域;窗口随着确认信息到达不断向右移动。
2.4.2 滑动窗口的工作过程
窗⼝⼤⼩指的是 ⽆需等待确认应答⽽可以继续发送数据的最⼤值!
问题:最开始的时候滑动窗口的大小应该怎么确定?
窗口大小 = min(ACK带来的窗口大小,真实发送的数据量)!
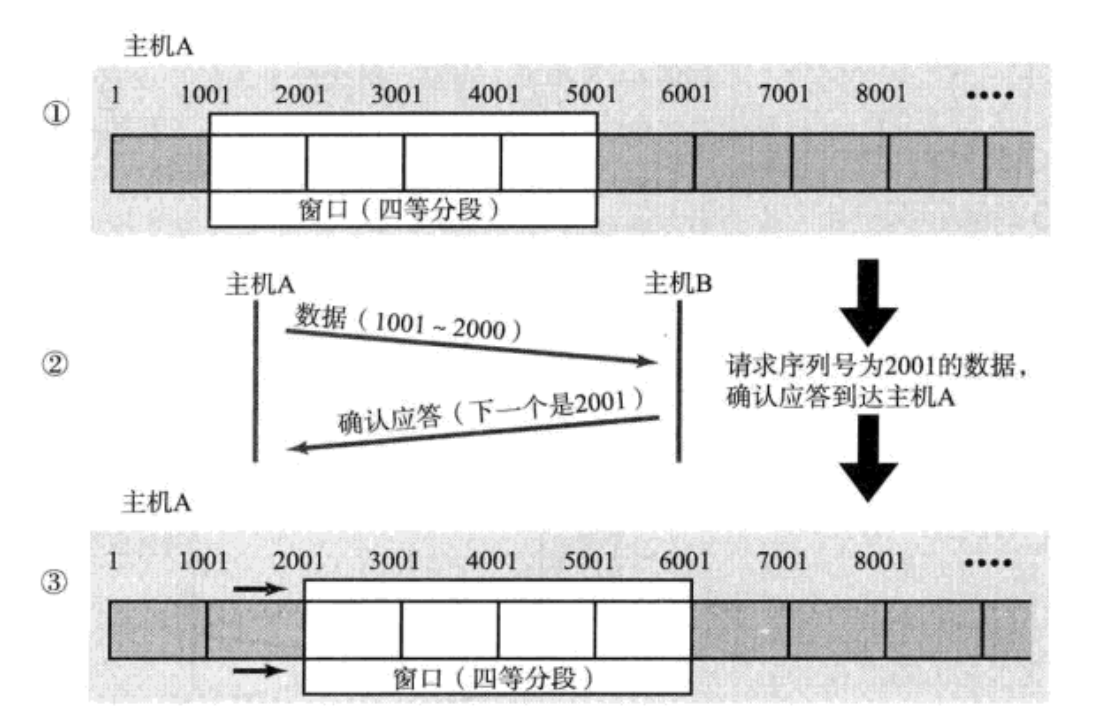
主机 A 一开始允许发送序号
1001~5000的数据,窗口分成四个部分。A 先发送1001~2000的数据给主机 B。B 收到后返回确认消息,表示前面的数据已经收到,并请求下一个序号为2001的数据。A 收到确认后,窗口向右滑动,新的可发送范围变成2001~6000,这样就可以继续发送后面的数据。
⚠️:实际滑动窗口区域会随
ACK应答所带窗口大小进行动态调整,还是接上面例子 再接到2001的确认序号,实际窗口大小会变成【2001,2001+ min(ACK带来的窗口大小,真实发送的数据量)】!,最极端的情况就是右边窗口不变(即接收方一直不读)而这种变化不就是流量控制底层的实现吗!
2.4.3 出现了丢包, 如何进⾏重传
情况1:数据包已经抵达, ACK被丢了
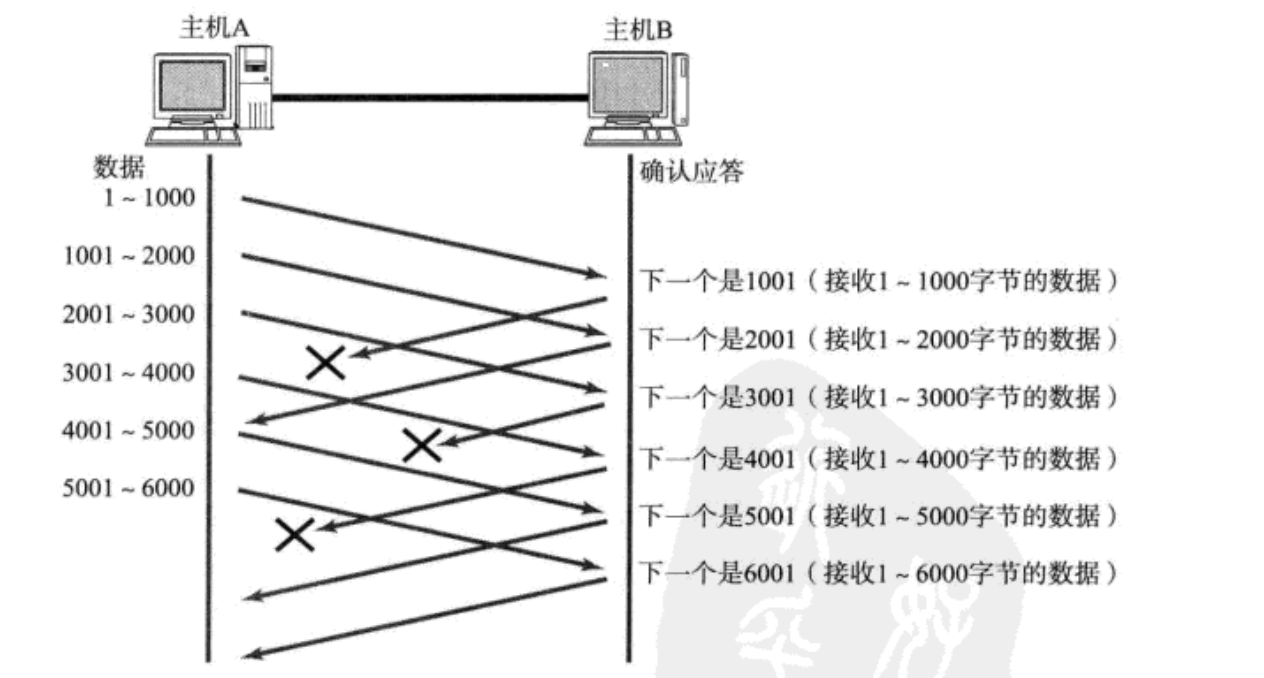
这种情况下, 部分ACK丢了并不要紧, 因为可以通过后续的ACK进⾏确认。
情况⼆: 数据包就直接丢了.
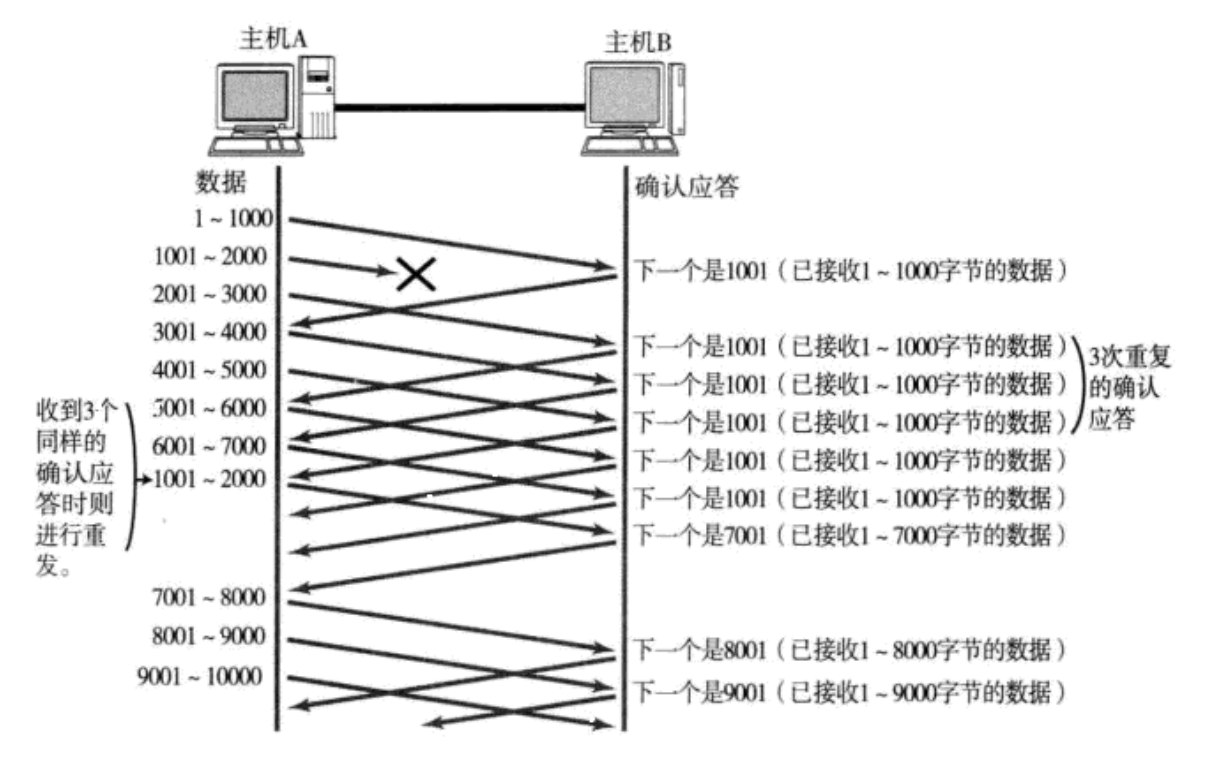
- 当某一段报文段丢失之后,发送端会一直收到
1001 这样的ACK,就像是在提醒发送端 "我想要的是1001" 一样; - 如果发送端主机连续收到了3个
"1001"这样的应答,就会将对应的数据1001‑2000立刻重新发送; - 这个时候接收端收到了
1001之后,再次返回的ACK就是7001了(因为2001‑7000)接收端其实之前就已经收到了,被放到了接收端操作系统内核的接收缓冲区中;
这种机制被称为 "高速重发控制"(也叫 "快重传")。
PS:快重传本质是提高传输效率的机制,不管怎么样都会有超时重传机制的兜底!
问题:那么在没有被ACK确认序号确认前,这些报文要保存起来,保存在哪里?
其实就是保存在滑动窗口内部!当滑动窗口区域数据被滑动到滑动窗口左侧后,本质就是对数据进行删除!【下次用户再次写数据的时候,用户就可以直接覆盖写了!】
2.4.4 滑动窗口越界问题
滑动窗口属于一个建立在发送缓冲区逻辑上的数组结构,那么是数组就可能越界,那怎么办? 其实你只需要把滑动窗口理解成逻辑上的 循环数组,里面会有一些特殊机制(如%运算)解决越界问题即可!
2.5 拥塞控制
虽然TCP有了滑动窗⼝这个⼤杀器, 能够⾼效可靠的发送⼤量的数据. 但是如果在刚开始阶段就发送⼤量的数据, 仍然可能引发问题
- 如果10000个报文,丢2~3个,这是正常情况 ------ 直接重传即可
- 如果10000个报文,丢9998个,这个肯定就是网络的问题(现实生活可能是底层路由器出问题了 ,但是TCP会统一会判定为
网络拥堵【不是它先判断网络拥堵,而是作为TCP协议,它只能判断网络拥堵,更底层的问题它无法解决】)!,那么此时就不能重传了! )
因为⽹络上有很多的计算机, 可能当前的⽹络状态就已经⽐较拥堵. 在不清楚当前⽹络状态下, 贸然发送⼤量的数据, 是很有可能引起雪上加霜的(因为世界上的机子成百上千,如果真的是拥堵引起的,大家都少传一点,让网络将堆积的报文解决掉,网络问题自然就解决了!)
TCP引⼊ 慢启动 机制, 先发少量的数据, 探探路, 摸清当前的⽹络拥堵状态, 再决定按照多⼤的速度传输数据
此处引⼊⼀个概念称为 拥塞窗⼝ !在TCP 协议栈,存在一个整型变量,用来衡量当前网络的拥塞情况,当发送报文大于这个变量时,就会判定为会可能会发生网络拥塞!即 衡量网络拥塞的指标!
而TCP就是根据这个指标来控制发送数据的多少的一个依据!
在TCP中 存在win窗口(即报头窗口的大小字段)、滑动窗口、拥塞窗口,在发送的报文足够大时,这三个窗口有什么关系呢?
滑动窗口 = min(win窗口,拥塞窗口)
拥塞控制的具体方式:
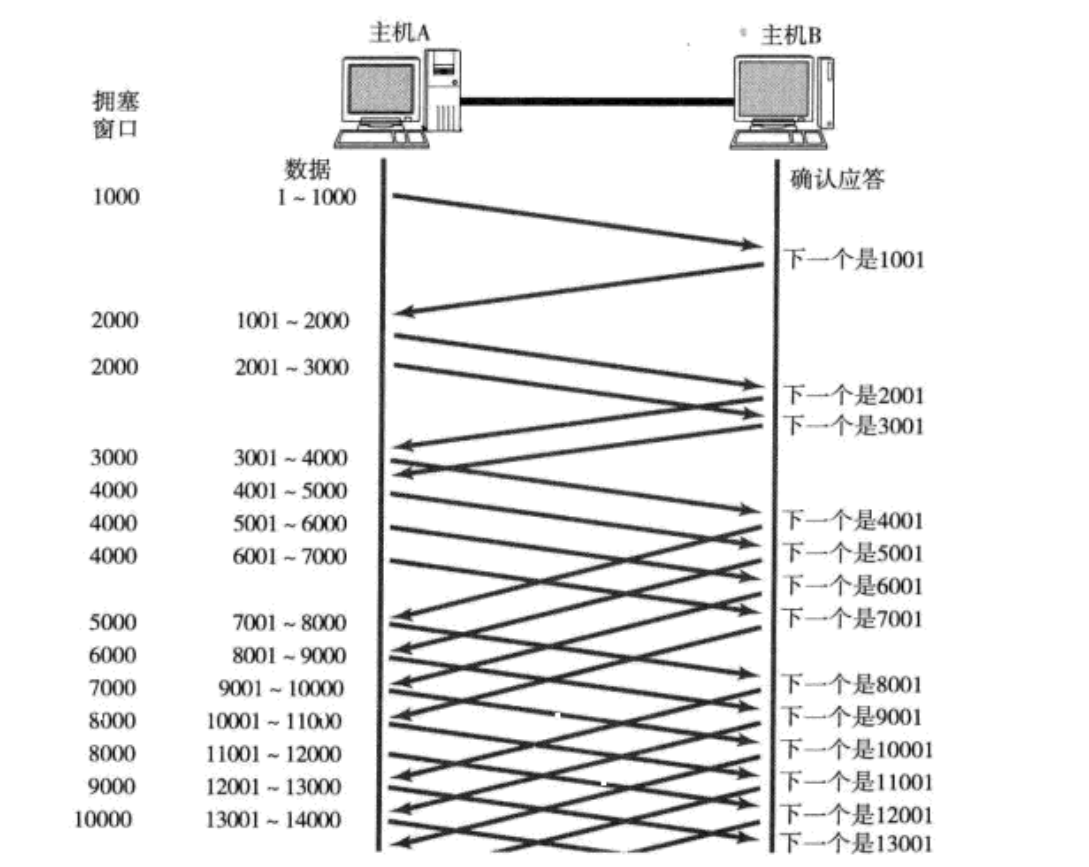
- 发送开始的时候,定义拥塞窗口大小为
2的0次方; - 每次收到一个ACK应答,拥塞窗口
次方数➕1; - 每次发送数据包的时候,将 拥塞窗口和接收端主机反馈的窗口大小做比较,取较小的值作为实际发送的窗口;
这种指数增长的特点就是: 前期增长慢,后期增长快的特点!
像上面这样的拥塞窗口增长速度,是指数级别的的。"慢启动"只是指初使时慢,但是增长速度非常快。
- 为了不增长的那么快,因此不能使拥塞窗口单纯的加倍。
- 此处引入一个叫做
慢启动的阈值(ssthresh) - 当拥塞窗口超过这个阈值的时候,不再按照指数方式增长,而是 按照线性方式增长
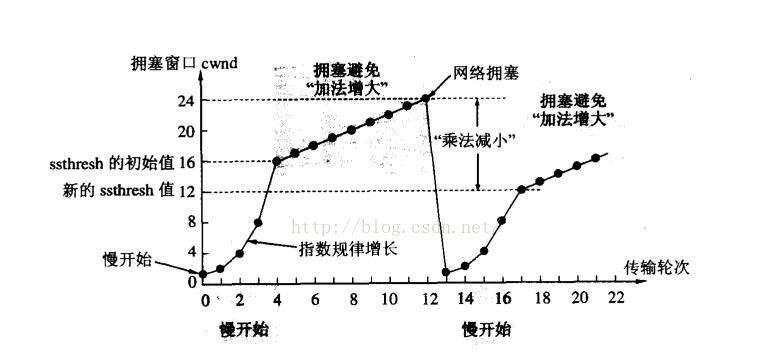
- 当TCP开始启动的时候, 慢启动阈值等于接收窗口最大值;
- 在
每次超时重发的时候, 慢启动阈值会变成原来的一半,同时拥塞窗口置回1;
问题来了:为什么拥塞窗口大小时变化的?
因为网络状态是变化的,也说明了当前网络发生拥堵的情况也一定是变化的!
那么TCP怎么知道,这个拥塞窗口大小应该是多少?
所以
TCP只能通过不断的试,才能知道 所以拥塞窗口指数变化、线性变化、减法减少的过程本质就是在探索当前网络的接受能力!!
总结:正常情况下,丢包1%~1.5%就是正常;丢包3%则认为拥堵,5%则是非常拥堵!拥塞控制, 归根结底是TCP协议想尽可能快的把数据传输给对⽅, 但是⼜要避免给⽹络造成太⼤压⼒的折中⽅案!
2.6 延迟应答
如果接收数据的主机立刻返回 ACK 应答,这时候返回的窗口可能比较小。
- 假设接收端缓冲区为
1M,一次收到了500K的数据;如果立刻应答,返回的窗口就是500K; - 但实际上可能处理端处理的速度很快,
10ms之内就把500K数据从缓冲区消费掉了; - 在这种情况下,接收端处理还远没有达到自己的极限,即使窗口再放大一些,也能处理过来;
- 如果接收端稍微等一会再应答,比如等待
200ms再应答,那么这个时候返回的窗口大小就是1M。
一定要记得: 窗口越大,网络吞吐量就越大,传输效率就越高。 我们的目标是在保证网络不拥塞的情况下尽量提高传输效率。
那么所有的包都可以延迟应答么?肯定也不是:
- 数量限制 :每隔
N个包就应答一次; - 时间限制:超过最大延迟时间就应答一次。
具体的数量和超时时间,依操作系统不同也有差异;一般 N 取 2,超时时间取 200ms。
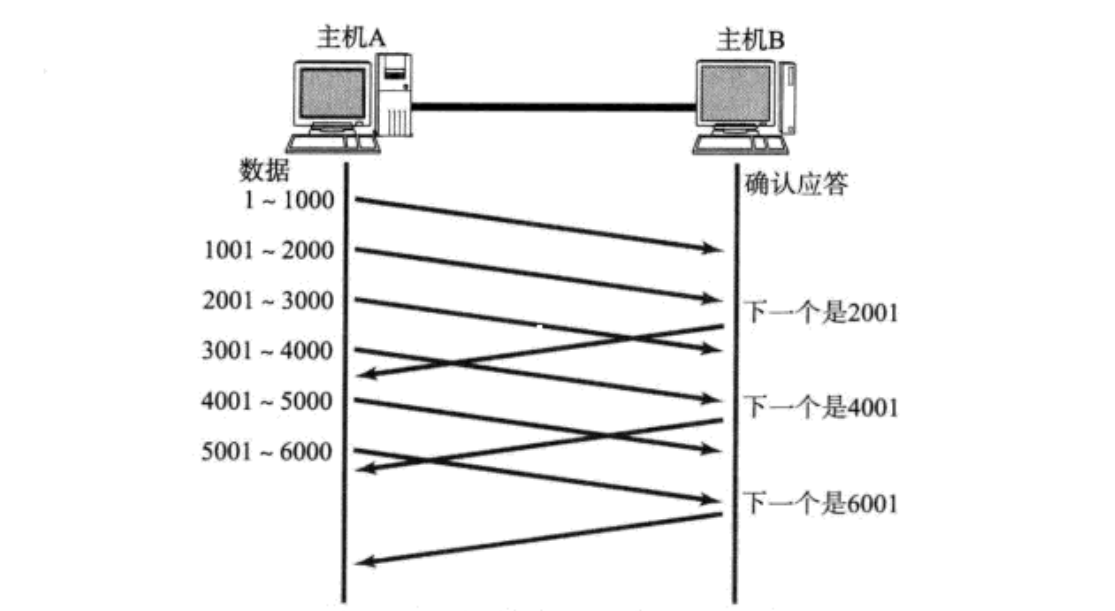
延迟应答本质:通过延时,一定概率可以给发送方通告一个更大的接受窗口!
2.7 捎带应答
在延迟应答的基础上, 我们发现, 很多情况下, 客⼾端服务器在应⽤层也是 "⼀发⼀收" 的. 意味着客⼾端给服务器说了 "How are you", 服务器也会给客⼾端回⼀个 "Fine, thank you";
那么这个时候ACK就可以搭顺⻛⻋, 和服务器回应的 "Fine, thank you" ⼀起回给客⼾端。
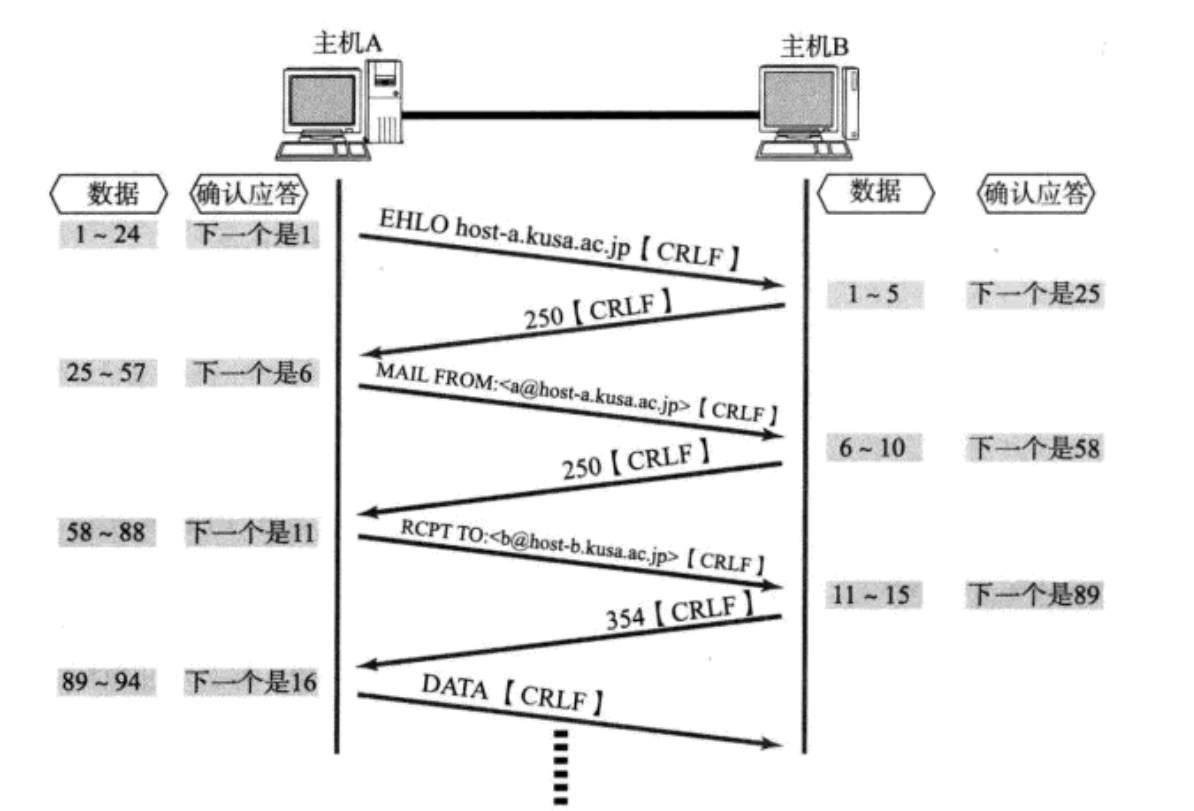
那么3次握手的时候可以带数据吗?
在三次握手未能完成前,是不能进行通信的,但是对于客户端而言发送
ACK的时候 三次握手已经完成了,所以客户端发送ACK的时候是可以带数据的!
所以捎带应答的本质是提高TCP传输数据的效率!
2.8 TCP小结
为什么 TCP 这么复杂?因为要保证可靠性 ,同时又尽可能提高性能。
可靠性
- 校验和:检测数据在传输中是否损坏
- 序列号:保证按序到达、去重
- 确认应答:确认对方已收到报文
- 超时重发:超时未收到应答则重传
- 连接管理:三次握手建立、四次挥手断开
- 流量控制:根据接收端能力调整发送速度
- 拥塞控制:根据网络状况动态调整发送量
提高性能
- 滑动窗口:批量发送,无需逐包等待应答
- 快速重传:连续收到 3 个重复 ACK 立即重传
- 延迟应答:稍等再应答,通告更大的接收窗口
- 捎带应答:数据与 ACK 合并发送,减少报文数量
其他
- 定时器:超时重传定时器、保活定时器、TIME_WAIT 定时器等
核心结论 : TCP 的复杂性源于它在可靠性与性能之间寻求平衡------可靠性机制保证数据不丢、不乱、不错,性能机制则让传输尽可能高效,二者共同构成了 TCP 的完整设计。
3. TCP常见面试题
3.1 ⾯向字节流
创建一个TCP的socket,同时在内核中创建一个发送缓冲区 和一个接收缓冲区;
- 调用
write时,数据会先写入 发送缓冲区中; - 如果发送的字节数太长, 会被拆分成多个TCP的数据包发出;
- 如果发送的字节数太短 ,就会先在缓冲区里等待,等到缓冲区长度差不多了,或者其他合适的时机发送出去;
- 接收数据的时候, 数据也是从网卡驱动程序到达内核的接收缓冲区;
- 然后应用程序可以调用
read从 接收缓冲区拿数据; - 另一方面,TCP的一个连接,既有发送缓冲区,也有接收缓冲区,那么对于这一个连接,既可以读数据,也可以写数据. 这个概念叫做 全双工
由于缓冲区的存在,TCP程序的读和写不需要一一匹配,例如:
- 写100个字节数据时,可以调用一次
write写100个字节,也可以调用100次write,每次写一个字节; - 读100个字节数据时,也完全不需要考虑写的时候是怎么写的,既可以一次
read100个字节,也可以一次read一个字节,重复100次;
这种读写次数无规律,而且报文与报文之间的解释与边界问题,TCP不判定,而是由应用层来判断!
字节流式的服务,一般需要自定义应用层协议,或者使用现成的基于TCP的应用层协议如HTTP(HTTP 本身不会 "额外解决" TCP 粘包,HTTP 依靠自己的协议格式,天然规避了粘包带来的解析错误)。
3.2 粘包问题
⾸先要明确, 粘包问题中的 "包" , 是指的应⽤层的数据包
传输层视角下TCP收到一个个报文,会依据序号排序存到缓冲区;但对应用层而言,只能读到一串连续字节,无法区分哪里是一条完整应用层数据包的边界,这就是TCP粘包问题的根源。
那么如何避免粘包问题呢? 归根结底就是⼀句话, 明确两个包之间的边界.
- 采用固定长度的报文
- 添加描述字段:如有效载荷的长度(HTTP 里面
请求报头就有数据的长度) - 特殊字符:类似用
空格、空行、\r\n 那样来划分边界(像HTTP) - 采用上面多种组合的方式(如UDP就是1、2组合,HTTP就是2、3组合)
3.3 TCP异常问题
进程终止: 进程终止会释放文件描述符,仍然可以发送FIN. 和正常关闭没有什么区别。机器重启: 和进程终止的情况相同,重启前会杀死进程。机器掉电/网线断开:
- 此时
客户端没有发送FIN的机会,链接回直接自动关闭不挥手。站在服务端不知道对方链接关闭! 所以服务端会维持一段时间链接。 - TCP层为了避免这种情况占用大量链接资源,就会内置一个
保活定时器(一般10~20分钟),每次收到客户端报文就会将时间进行一次重置,如果对端一直在该时间内不活跃,服务端就会开始定时不断发送报头询问对⽅是否还在,如果连续多次询问收不到ACK,服务端就会自动释放链接! - 如果出问题的是
服务端呢?客户端依然会向服务器发送数据(或者进行保活询问),如果此时服务端刚好恢复,服务端就会发送RST,与客户端重新进行三次握手!
虽然TCP有保活机制,但是保活一般都是应用层的某些协议做的,如HTTP每隔10s没有收到对端报文,就发送一个最简单的GET请求,得到最简单的response则说明链接活着,这个机制叫 心跳机制!该机制本质就是在保证对端活着!