C反应性蛋白原甘油三酯葡萄糖指数(CTI)由Ruan等首次提出,它巧妙地结合了胰岛素抵抗和炎症,从而在临床研究中得到了广泛的应用。CTI对个体的癌症、恶病质结局和心脏病发作风险具有同样的预后意义。
既往我发布了自己编写的chrals.CTI函数和chrals.cuCTI函数,用于提取charls数据CTI和累计CTI(cuCTI)。
目前最新文章Composite C-reactive protein-triglyceride-glucose adiposity indices and incident cardiovascular-liver-metabolic multimorbidity: a prospective cohort study(if=15)介绍九种基于CTI的脂肪含量指数,包括CTI、CTI-BMI、CTI-WC、CTI-WHtR、CTI-BRI、CTI-WWI、CTI-CVAI、CTI-ABSI和CTI-CI与葡萄糖脂肪指数及心血管-肝-代谢多病相关(CLMM)。
我升级了chrals.CTI函数,目前可以轻松提取九种基于CTI的脂肪含量指数,包括CTI、CTI-BMI、CTI-WC、CTI-WHtR、CTI-BRI、CTI-WWI、CTI-CVAI、CTI-ABSI。
下面我来演示一下
r
#setwd("E:/公众号文章2024年/charls数据库/class2/2011") #设置你放数据文件的地址
setwd("E:/公众号文章2024年/charls数据库/class2")
library(haven)
library(tidyverse)
library(scitable)
library(sciclhls)

household_roster<-read_dta('household_roster.dta')  #家庭户
family<-read_dta('family_information.dta')   #大家庭
housing<-read_dta('housing_characteristics.dta')   #房屋特点
psu<-read_dta('psu.dta',encoding = "GBK")   #psu
information<-read_dta('family_information.dta')  #家庭信息
transfer<-read_dta('family_transfer.dta')  #家庭交往
household_income<-read_dta('household_income.dta')  #家庭收入
#############3
demographic<-read_dta('demographic_background.dta')  #基线表
health_status_and_functioning<-read_dta('health_status_and_functioning.dta')  #健康状况和功能
biomarkers<-read_dta('biomarkers.dta')  #体检数据
Blood_20140429<-read_dta('Blood_20140429.dta')  #血检数据
weight<-read_dta('weight.dta')  #权重
health_care_and_insurance<-read_dta('health_care_and_insurance.dta')  #医疗保健
work_retirement<-read_dta('work_retirement_and_pension.dta')  #工作、退休、养老金

###########
data<-demographic  %>%
  left_join(housing, by='householdID',suffix = c("", ".right")) %>%
  left_join(household_roster, by='householdID',suffix = c("", ".right")) %>%
  left_join(psu, by='communityID',suffix = c("", ".right")) %>%
  left_join(health_care_and_insurance, by='ID',suffix = c("", ".right")) %>%
  left_join(health_status_and_functioning,by='ID',suffix = c("", ".right")) %>%
  left_join(biomarkers,by='ID',suffix = c("", ".right")) %>%
  left_join(Blood_20140429,by='ID',suffix = c("", ".right")) %>%
  left_join(weight,by='ID',suffix = c("", ".right")) %>%
  left_join(information,by='ID',suffix = c("", ".right")) %>%
  left_join(transfer,by='ID',suffix = c("", ".right")) %>%
  left_join(household_income,by='householdID',suffix = c("", ".right")) %>%
  left_join(work_retirement,by='ID',suffix = c("", ".right"))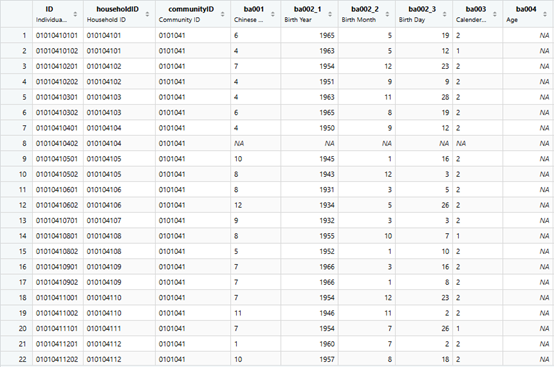
导入数据后提取变量非常简单,一句话代码
r
out<-chrals.CTI(data,year="data2011")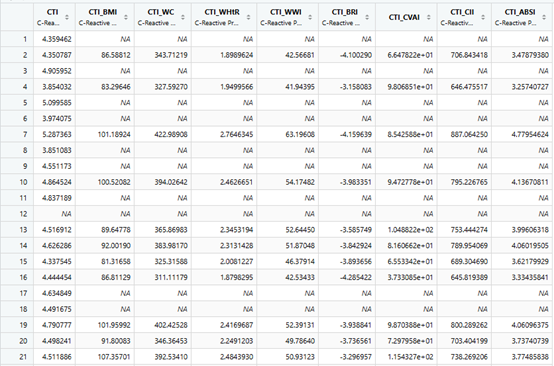
如上图所示CTI及其衍生脂肪指数全部提取出来了
假如我想提取2015年的
r
out<-chrals.CTI(data2015,year="data2015")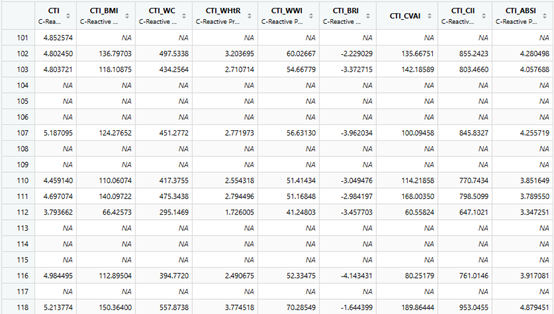
对于这种指数,咱们都可以通过我写的ggexplore函数对它进行数据挖掘,就是看哪个结局变量和它相关,这里我就不挖了,有兴趣的看我既往文章。