1深度学习
深度学习(Deep learning),英⽂缩写为DL,是⼀种机器学习的分⽀,它是通过构建多层神经⽹络来实现⾃主学习和预测的能⼒。深度学习的核⼼是深度神经⽹络,它由多个层次的神经元组成,每⼀层都可以提取出不同的特征信息,从⽽实现对复杂数据的学习和预测。深度学习的应⽤范围⾮常⼴泛,
包括图像识别、语⾳识别、⾃然语⾔处理等领域。
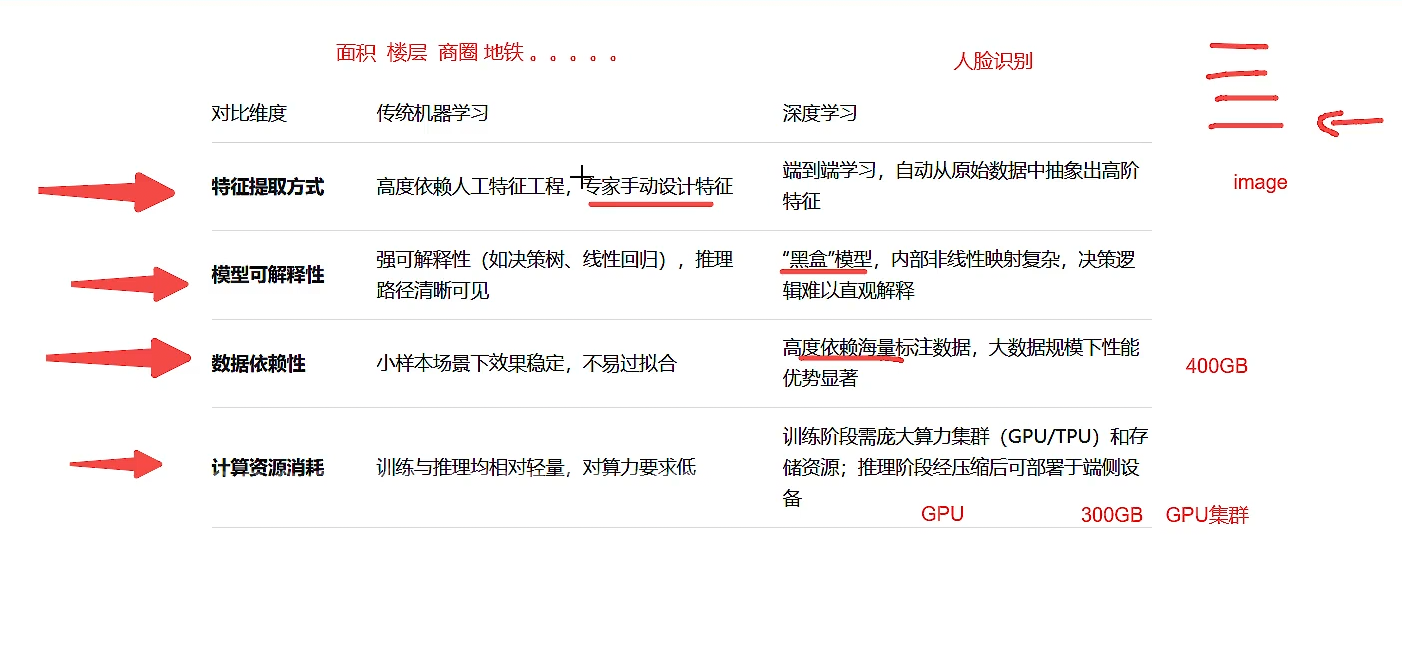
相⽐于传统机器学习(如SVM、决策树)需要⼈⼯设计特征(特征⼯程),深度学习的本质区别在于,它不仅能⾃动学习参数(权重),更重要的是,它能通过多层结构⾃动从原始数据中逐层构建出⾼层次的抽象特征(如从像素到边缘,再到轮廓,最后到物体部件),从⽽避免了传统机器学习中繁
琐的⼈⼯特征⼯程。"
机器学习我们知道学习了⼏百上千万的参数,这些参数如何表⽰呢,就是⽬前流⾏的神经⽹络(neural network),神经⽹络的参数学习就是深度学习,典型的神经⽹络架构如下所⽰。
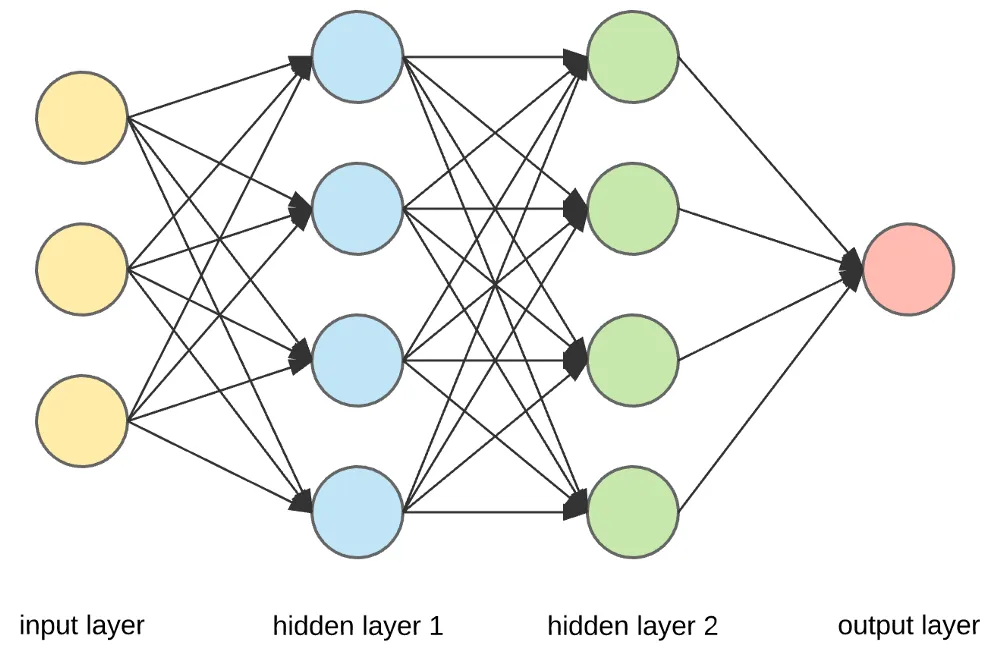
输⼊层和输出层之间的层被称为隐藏层,层与层之间的连接密度和类型构成了⽹络的配置。
神经⽹络由多个层组成,包括:
• 输⼊层(Input Layer):接收原始输⼊数据。
• 隐藏层(Hidden Layer):对输⼊数据进⾏处理,可以有多个隐藏层。
• 输出层(Output Layer):产⽣最终的输出结果。
如果⽤数学语⾔描述深度学习的本质,它不再是简单的 y=f(x),⽽是:
y = f(...f(f(x))...)
这⾥的每个f通常代表神经⽹络的⼀层(Layer),⽽整个模型就是这些层功能的逐级嵌套。
案例:AI如何判断西红柿炒鸡蛋的呢?
你开了⼀家外卖平台,需要开发⼀个AI系统:⽤⼾上传⼀道菜的照⽚,AI⾃动判断它是不是"西红柿炒鸡蛋"。
这个AI的⼤脑是⼀个深度神经⽹络,它的判断过程就像⼀条后厨品控流⽔线,每个师傅只负责⼀道极简单的⼯序,然后传给下⼀个⼈:
第⼀站:输⼊层(接收原始照⽚)
你上传了⼀张⼿机拍的菜品的照⽚。
输⼊层的⼯作:啥也不⼲,就是把这张照⽚拆解成计算机能认的像素值(数字矩阵),原封不动地传给下⼀个师傅。
第⼆站:第⼀个隐藏层(找基本颜⾊)
第⼀个师傅接过这堆数字,他的任务很简单:图⽚⾥有没有"红⾊"和"⻩⾊"
他扫描⼀遍,发现有⼤量红⾊像素(西红柿)和⼤量⻩⾊像素(鸡蛋)。于是他在报告上写:"检测到⼤量红⾊+⼤量⻩⾊。"
这⼀步学到的是:最基本的"颜⾊"特征。?
第三站:第⼆个隐藏层(找形状)
第⼆个师傅不看原图,只看第⼀份报告。他的任务是:这些红⾊和⻩⾊是不是"块状"的
他发现红⾊聚成不规则的⼤块(西红柿块),⻩⾊聚成⼩块的絮状(鸡蛋块),⽽不是均匀涂抹的红⾊酱汁(⽐如番茄酱)或⻩⾊流质(⽐如咖喱)。于是他写:"红⾊呈块状+⻩⾊呈絮状。"
这⼀步学到的是:中级的"形状"特征(块状vs糊状)。
第四站:第三个隐藏层(判断组合关系)
第三个师傅只看第⼆份报告,他的任务是:这两种颜⾊有没有"混合在⼀起"?
他发现红⾊块和⻩⾊块是交错混杂的(西红柿和鸡蛋是炒在⼀起的),⽽不是分开放置的(⽐如红⻩各占⼀半的拼盘)。于是他写:"红⻩交错混合。"
这⼀步学到的是:⾼级的"空间关系"特征(是否混合)。
第五站:输出层(最终判断)
最后⼀个师傅(输出层)只看第三份报告。他的脑⼦⾥只有⼀个对照表:
• 如果满⾜"红⾊+⻩⾊+块状+絮状+混合"→输出"是西红柿炒鸡蛋"✅
• 如果不满⾜→输出"不是西红柿炒鸡蛋"❌
他看完报告,果断敲章:"结论:是西红柿炒鸡蛋!"
🔁把"嵌套公式"映射到这个菜谱⾥
y=f₃(f₂(f₁(x)))
| 数学符号 | 对应后厨流⽔线 |
|---|---|
| x(输⼊) | ⽤⼾上传的照⽚(原始像素矩阵) |
| f₁(x)(第⼀层) | 第⼀个师傅:提取"红⾊+⻩⾊"(颜⾊特征) |
| f₂(f₁(x))(第⼆层) | 第⼆个师傅:判断"块状+絮状"(形状特征) |
| f₃(f₂(f₁(x)))(第三层) | 第三个师傅:判断"红⻩交错混合"(组合特征) |
| y(输出) | 最终结果:"是/不是西红柿炒鸡蛋" |
每⼀层都在上⼀层的结果上继续加⼯,信息越来越抽象,越来越接近最终答案。
💡这个例⼦让你彻底悟透的三个点
为什么叫"隐藏层"? 你在APP上只能看到"是/不是"的结果,但永远看不到中间师傅们写的"有红⾊"、"有块状"这些内部报告------这些中间步骤是"隐藏"的。
什么是"⾃动学习特征"? 这些师傅不是⼈类教他们"什么叫块状"、"什么叫混合"的,⽽是AI看了⼏万张菜品的照⽚后,⾃⼰总结出来的。
什么是"嵌套"?? 如果不经过"像素→颜⾊→形状→混合关系"这条链,AI不可能直接从原始像素蹦到最终判断。⼀层包⼀层,后⼀层必须以前⼀层为基础。
为什么叫深度呢?
深度=层数多,深度学习"这个名字⾮常直⽩,就是在描述这类⽹络层次很深的特点。我们来看下下表⼤模型常⻅的层数。
| 模型(Model) | 层数(Layers) | 说明 |
|---|---|---|
| 原始 Transformer Base | 6层编码器+6层解码器 | 原始论⽂中的标准配置,共12层。 |
| GPT-1 | 12层 | 初代GPT模型。 |
| GPT-3 | (175B) 96层 | 拥有1750亿参数的超⼤型模型。 |
| GPT-4 | **120层 | ⽬前⼴为流传的层数,但具体技术细节并未完全公开。 |
1.1计算机视觉
计算机视觉是⼈⼯智能的核⼼领域之⼀,⽬标是让机器"看懂"世界------从图像或视频中提取信息、理解内容,并做出决策。它涉及多个交叉学科,包括计算机科学、数学、神经科学等。
常⻅任务
图像分类
图像分类(Image Classification)是计算机视觉中最基础也是最核⼼的任务:给定⼀张输⼊图像,算法需要从预定义的类别集合中指定⼀个最能描述该图像内容的标签。直⽩点就是识别图中"是什么"。
⽬标检测
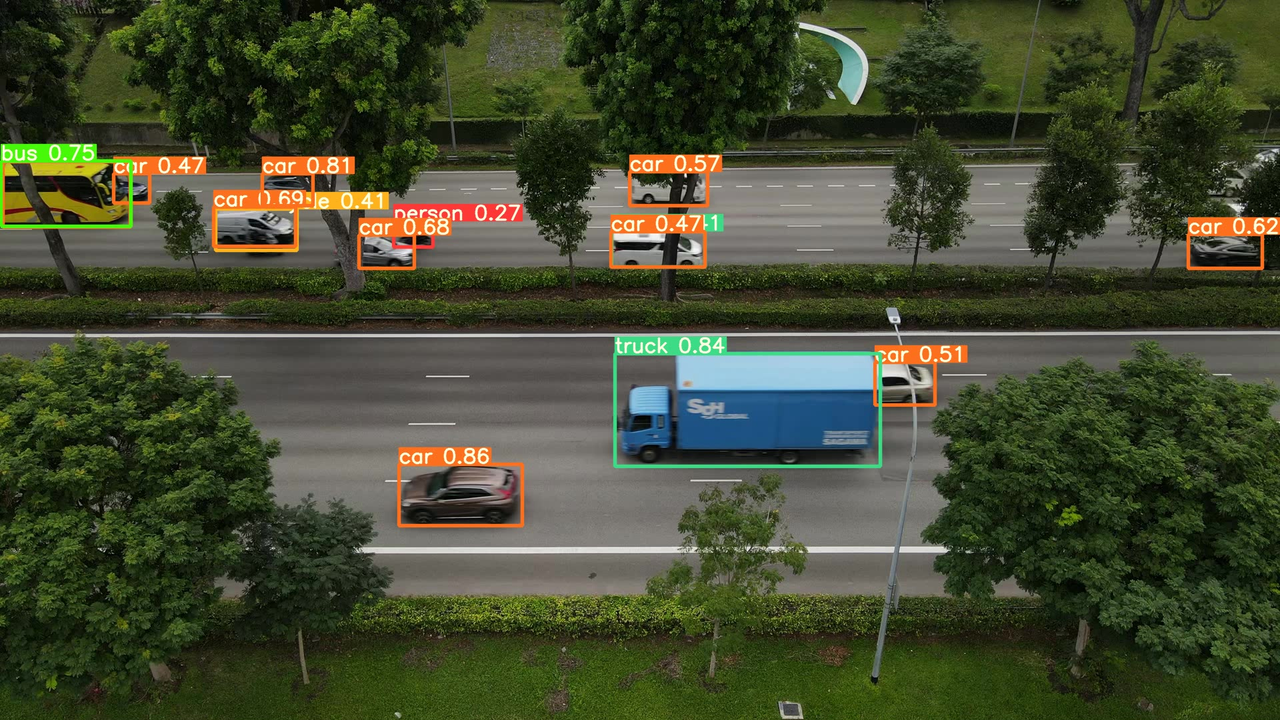
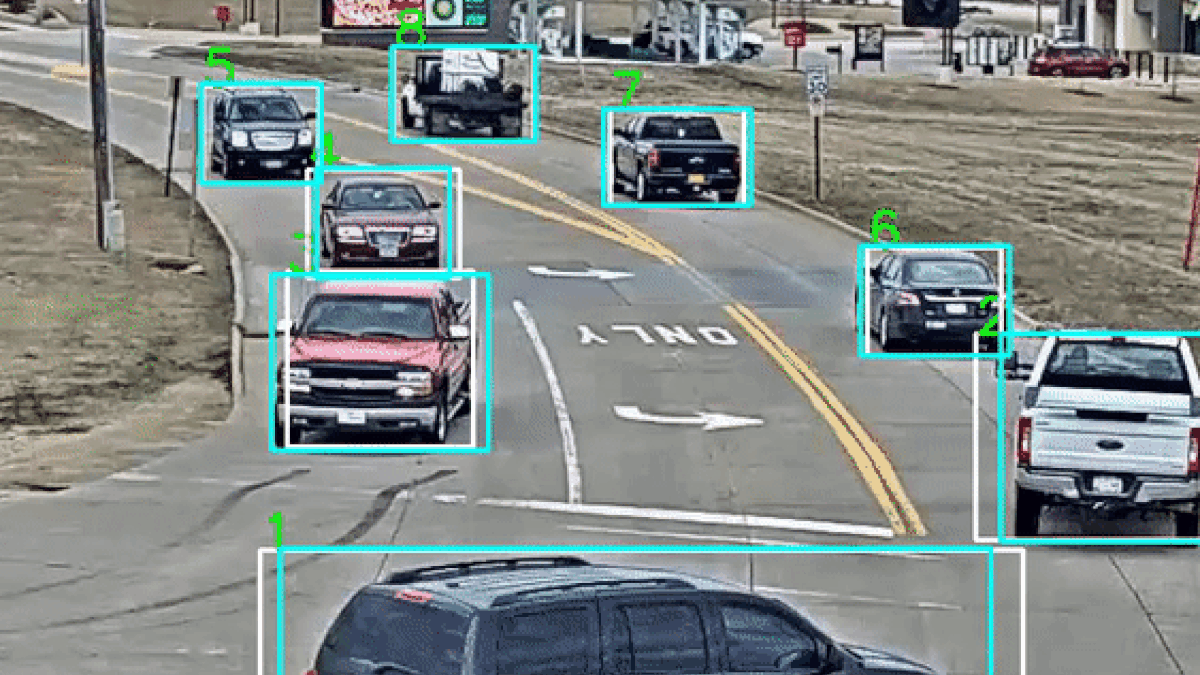
⽬标检测可以理解为⼀个核⼼问题:它不仅需要回答"图像⾥有什么?",还要回答"它们在哪⾥?"。
简单来说,⽬标检测的任务是:
• 识别(What):确定图像中物体的类别(如⼈、⻋、猫)。
• 定位(Where):⽤⼀个边界框精确框出每个物体的位置。
语义分割
语义分割是计算机视觉中⽐⽬标检测更进⼀步的任务。如果说⽬标检测关⼼的是"在哪⾥有什么(画框)",那么语义分割关⼼的是"每个像素是什么"。
简单来说,语义分割的⽬标是:将图像中的每⼀个像素点,都划分到对应的类别中(如⼈、⻋、天空、道路等)。
实例分割
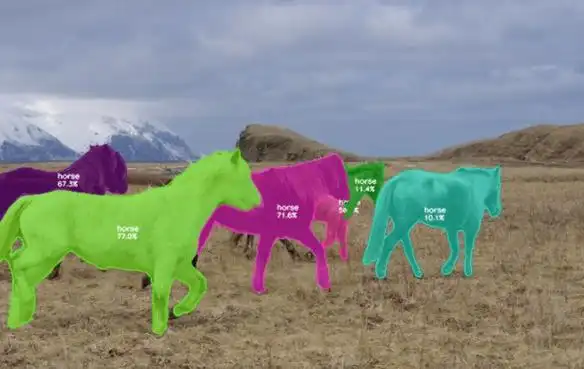
在图像或视频中,实例分割(Instance?Segmentation)是将每个感兴趣的物体的轮廓精确描绘出来,并且区分开同⼀类别的不同个体。
⽬标跟踪
⽬标检测关注的是单张图⽚,⽽⽬标跟踪关注的是视频流。在视频的第⼀帧给定⼀个⽬标(或者模型⾃动检测出⽬标),在后续的帧中持续定位这个⽬标的位置。核⼼在于建⽴时序上的关联,知道"这⼀帧的物体就是上⼀帧的那个物体"。
关键点检测
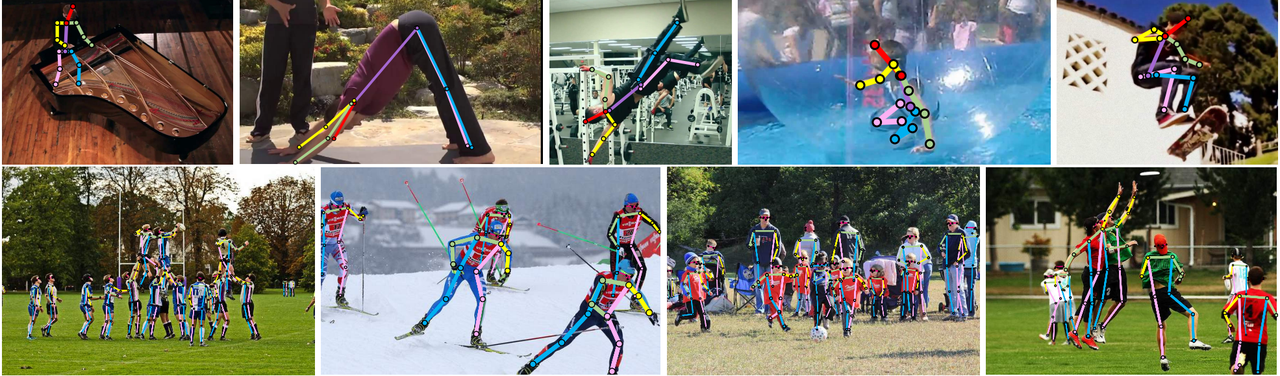
关键点检测不关⼼物体的轮廓,它只寻找那些能定义形状的特定坐标(x,y)。
⽂字与符号识别(OCR)
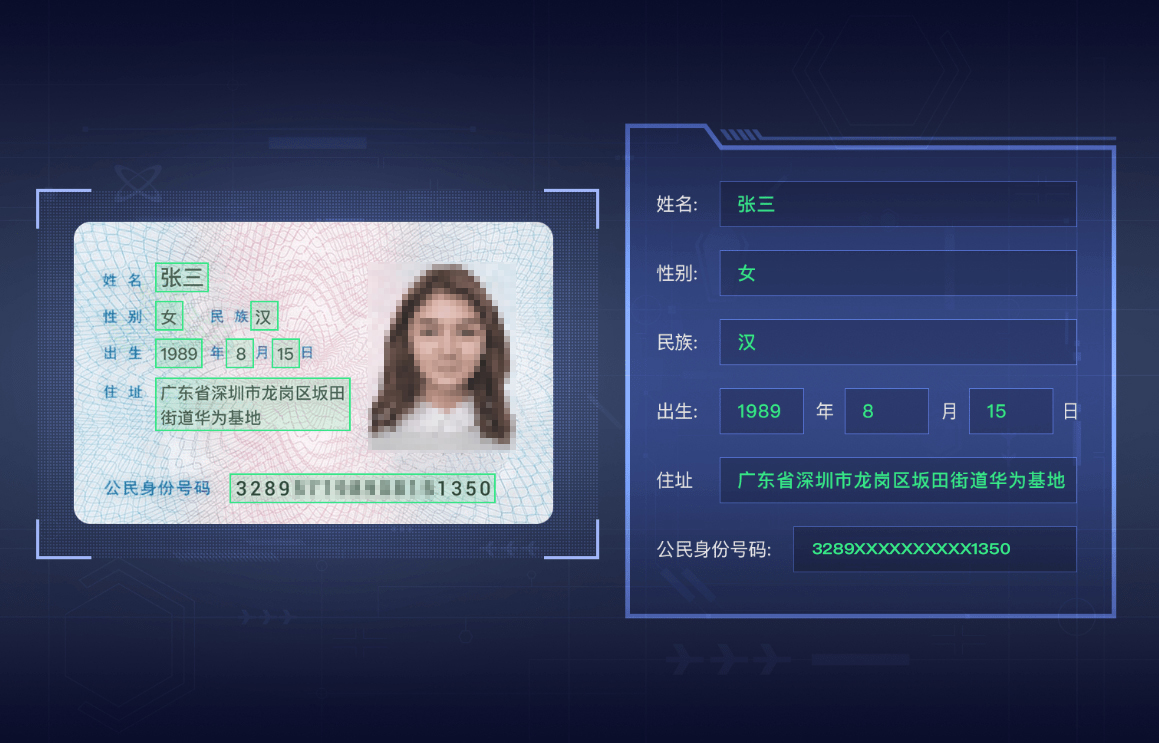
⽂字与符号识别,通常被归为光学字符识别(OCR,Optical Character Recognition)的范畴,是计算机视觉中专⻔处理图像中的⽂字和符号的任务。它的⽬标是:让计算机像⼈⼀样,从图⽚、视频帧或扫描⽂档中"读"出⽂本内容,并转化为可编辑、可搜索的字符信息。
1.2自然语言处理
⾃然语⾔处理(NLP)是⼈⼯智能领域中以⾃然语⾔⽂本(离散符号)为核⼼处理对象,研究如何建⽴⼈类语⾔形式与机器可计算语义之间可逆映射关系的学科。它旨在赋予计算机具备对语⾔符号进⾏形态分析、语义理解、逻辑推理及连贯⽣成的能⼒,从⽽消除⼈类⾃然语⾔的模糊性、歧义性与机器
严格指令系统之间的鸿沟。
研究⽅向
• ⾃然语⾔理解(NLU):让机器理解⼈类想表达的意思。
◦ 重点在于语义和意图。
◦ 例如:判断"我想吃苹果"是指⽔果,还是指⼿机?
• ⾃然语⾔⽣成(NLG):让机器根据数据或意图,⽣成⼈类可读的⽂本。
◦ 重点在于流畅度和准确性。
◦ 例如:写新闻稿、写邮件回复、⽣成诗歌。
常⻅任务
NLU(⾃然语⾔理解)
⽂本分类
将⼀段不定⻓的⽂本,⾃动打上⼀个或多个预先设定好的类别标签。它是NLP最基础、最成熟的任务。
技术本质:通常是⼀个多分类或多标签问题。
• 主题分类:输⼊"中国乒乓球拿下奥球会⼤满贯" →输出 体育 。
• 意图分类(智能客服):输⼊"我想改⼀下收货地址" →输出 修改订单 。
• 新闻打标:输⼊ "央⾏宣布降低存款准备⾦率" →输出财经 、 政策 (多标签)
情感分析
它是⽂本分类的⼀个特殊⼦集,专⻔⽤来判断⽂本背后的主观情绪、观点或态度(通常是极性或强度)。
例⼦:
• 细粒度情感:输⼊"酒店位置绝佳,但房间隔⾳差到离谱" →输出 位置正向,隔⾳负向。
• 电商评价:输⼊ "这⼿机电池太不耐⽤了" →输出 负向(Negative)。
• 社交媒体舆情:输⼊ "XXX明星官宣结婚,祝福!" →输出 正(Positive)且情绪喜悦。
命名实体识别(NER)
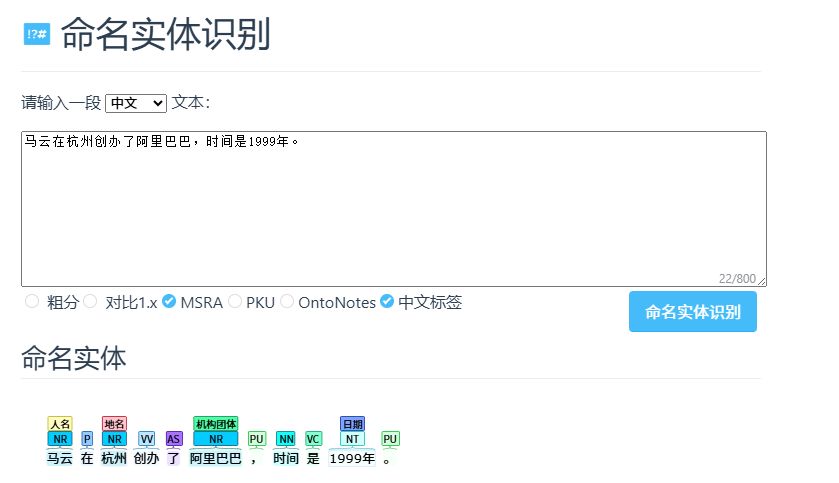
从⾮结构化的⽂本中,识别出具有特定意义的实体指代,并将其归⼊预定义的类别(如⼈名、地名、组织名、⽇期、专有名词等)。它是信息抽取的基⽯。
例⼦:
• 输⼊: ⻢云在杭州创办了阿⾥巴巴,时间是1999年。
• 识别结果: ⻢云 (⼈名)/杭州 (地名)/阿⾥巴巴 (组织机构)/1999年 (时间)
语义相似度
计算两段⽂本在含义层⾯上的相近程度(⽽不是字⾯重复程度)。这是搜索、问答和智能推荐的核⼼算法。
例⼦:
• 句⼦A: "如何给⼿机快速充电?"
• 句⼦B: "⼿机快充有哪些技巧?" →相似度:0.95(极⾼,语义⼀致)
• 句⼦C: "今天⼿机电量消耗很快。" →相似度:0.15(极低,话题不同)
• 注:如果只是字⾯重叠,"快充"和"充电"有重叠,但模型会发现"技巧"和"消耗"语义完全不同,这就是该任务的难点。
NLG(⾃然语⾔⽣成)
机器翻译将⼀种语⾔的⽂本⾃动翻译成另⼀种语⾔。
例⼦:
• 输⼊(中⽂): "今天天⽓很好"
• 输出(英⽂): "The weather is very nice today."
对话⽣成
对话系统指的是构建能与⼈类进⾏多轮交互的聊天机器⼈。
例⼦:
◦ ⽤⼾: "帮我查⼀下明天的天⽓。"
◦ 系统: "您所在的城市是哪⾥?"
◦ ⽤⼾: "上海。"
◦ 系统: "明天上海晴转多云,22℃〜28℃。"
我们可以借助⾖包(https://www.doubao.com/)来创建漫画,ppt等,下⾯是我让⾖包⽣成的⼀个⼩红书爆款⽂案,⽂章摘要
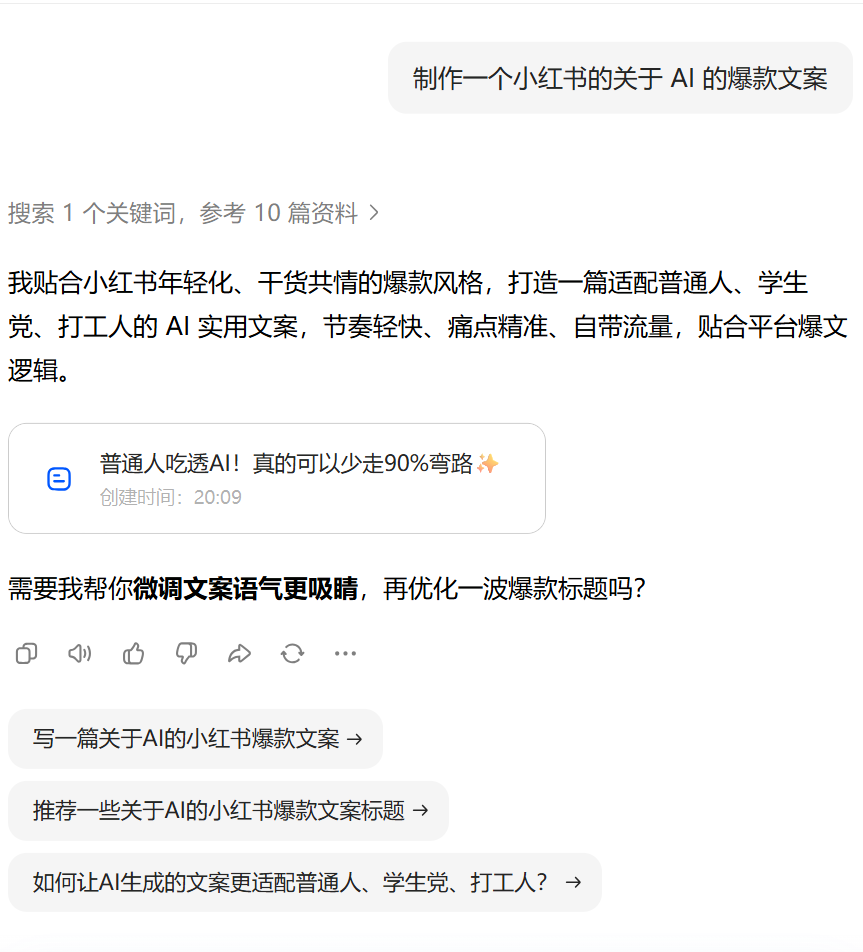
将⻓⽂本压缩成包含关键信息的短⽂本。
• 抽取式:直接从原⽂中摘取重要句⼦。
• ⽣成式:重新组织语⾔⽣成新句⼦。
例⼦:输⼊⼀篇数千字的新闻,输出摘要为 "5⽉6⽇,XX公司发布新款⼿机,配备最新AI芯⽚,起售价5999元。"
现在的⼤模型已经具备⽂章摘要能⼒,我们来看下如果摘
要⽂章
提⽰词
总结下这个博客的核⼼内容输出
https://claude.com/blog/common-workflow-patterns-for-ai-agents-and-when-to-use-them
注意:
从"任务分类"到"⼤模型统⼀":过去,上述每个任务都需要单独训练⼀个⼩模型。但现在,⼤语⾔模型(LLMs,如GPT系列、⽂⼼⼀⾔)已经通过"预训练+微调/提⽰词"的⽅式,⼏乎能⽤同⼀个模型完成以上所有任务。
1.3语音处理
语⾳处理是⼀⻔涉及信号处理、计算机科学、语⾔学和⼈⼯智能的交叉学科,核⼼⽬标是让机器能够分析、理解、合成和处理⼈类的语⾳信号。
常⻅任务
语⾳识别
语⾳识别(ASR,Automatic?Speech?Recognition):即语⾳转⽂字是将⼈类语⾳中的词汇内容转换为计算机可读的⽂本或指令的过程。⽬前的系统通常基于Whisper、Paraformer等先进架构。
常⻅的应⽤智能⾳箱(如⼩爱同学、Alexa)、会议纪要⾃动⽣成、语⾳输⼊法、⽆障碍辅助(为听障⼈⼠提供字幕)、⻋载语⾳控制。
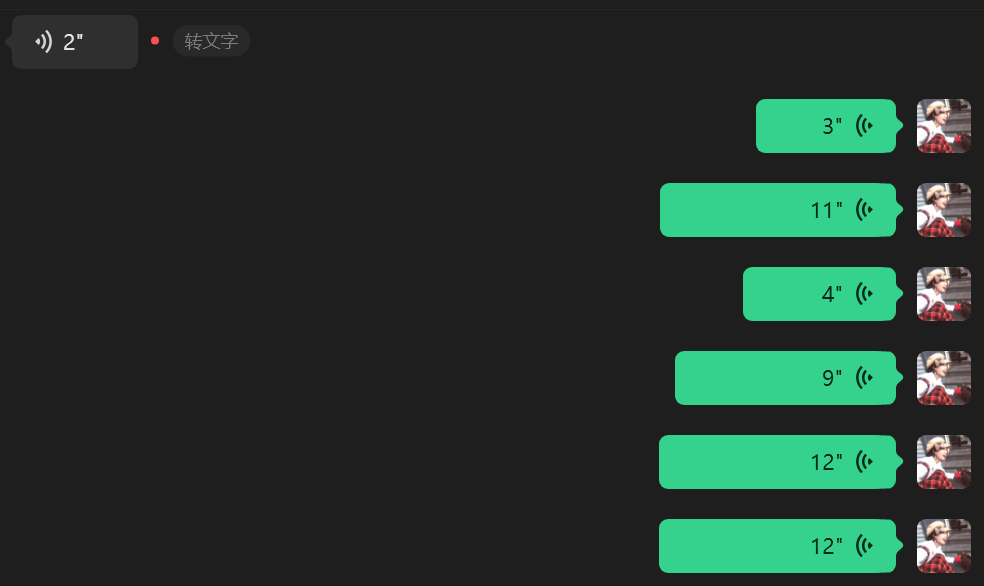
我们⽇常使⽤的微信语⾳转⽂字就是典型的语⾳识别应⽤。
语⾳合成
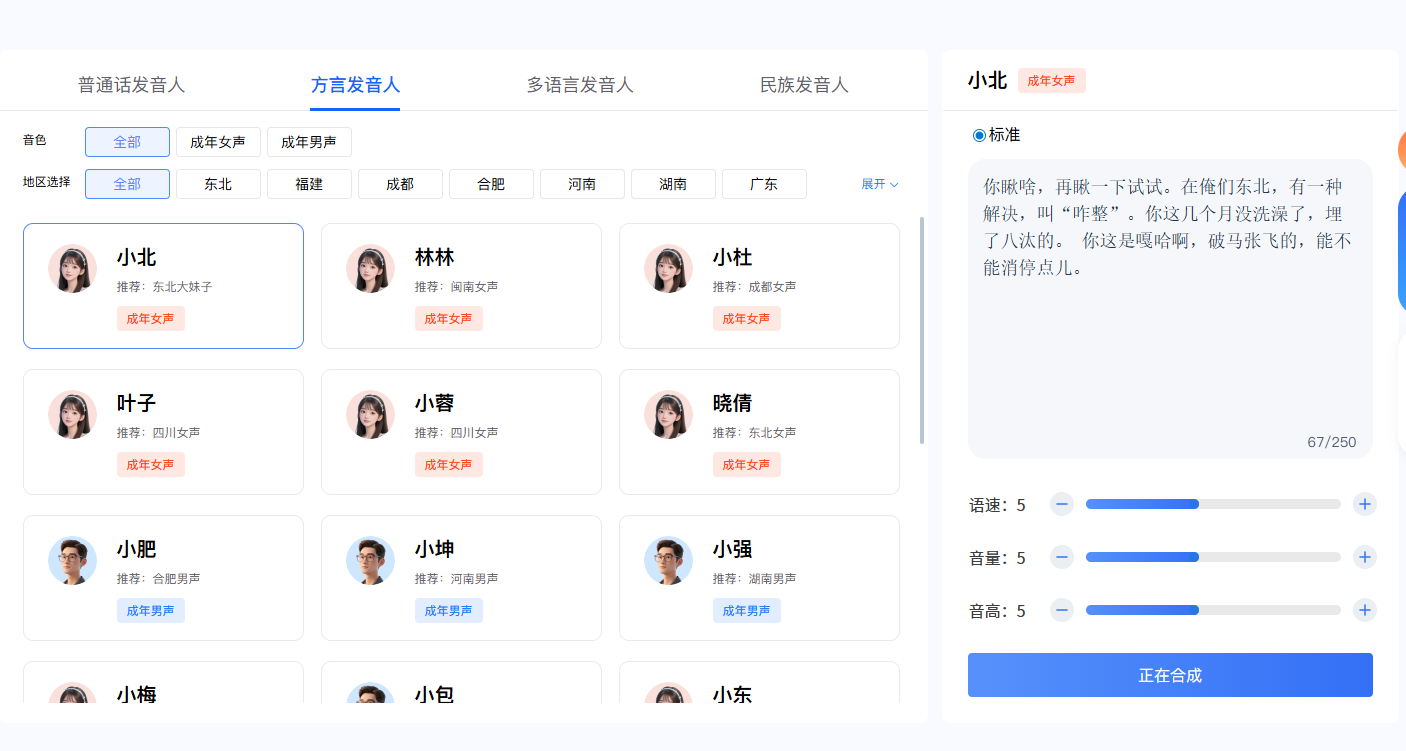
语⾳合成(TTS,Text-to-Speech):即⽂字转语⾳是让计算机将⽂本转换为⾃然、流畅且富有表现⼒的语⾳。⽬前的TTS模型(如VITS、NaturalSpeech、ChatTTS)能够⽣成⾼度拟⼈、带有情感和韵律的语⾳,甚⾄可以⽀持少样本克隆(仅需⼏秒样本即可模仿特定⼈声)。
下图是讯⻜(https://www.xfyun.cn/services/online_tts)推出的在线语⾳服务,点击播放就可以把⽂字转换为声⾳,⽽且⽀持⽅⾔。
1.4多模态
多模态"是⼈⼯智能领域的⼀个核⼼概念,指同时处理、理解或⽣成两种及以上不同类型数据(模态)的技术。在⼈类认知中,我们天然就是多模态的------通过视觉、听觉、触觉等多种感官来理解世界。
常⻅的模态包括:
• 视觉:图像、视频、图表、⼿势
• 听觉:语⾳、⾳乐、环境声⾳
• ⽂本:⾃然语⾔、符号、代码
• 传感器数据:触觉(压⼒、振动)、深度图(如激光雷达)、惯性测量单元数据、体温等
常⻅任务
多模态AI主要解决三类问题:
• 理解与推理:从多种数据中提取含义。
◦ 例⼦ :给出⼀张图⽚和⼀句相关的问题("图中穿红⾐服的⼈在做什么?"),模型需要结合视觉(找红⾊)和⽂本(理解问题)来回答。
• ⽣成与创作:根据⼀种模态⽣成另⼀种模态。
◦ 例⼦ :⽂本⽣成图像 (如Stable Diffusion、Midjourney)、⽂本⽣成视频 (Sora)、图像⽣成⽂本 (看图写话)、⽂本⽣成⾳乐 。
• 对⻬与检索:找到不同模态之间的对应关系。
◦ 例⼦ :⽤⽂字描述"⼀只在沙滩上的⾦⽑⽝",从海量图⽚库中找出匹配的图⽚。
下⾯看2个模态常⻅的例⼦:
⽂⽣图/视频/⾳频
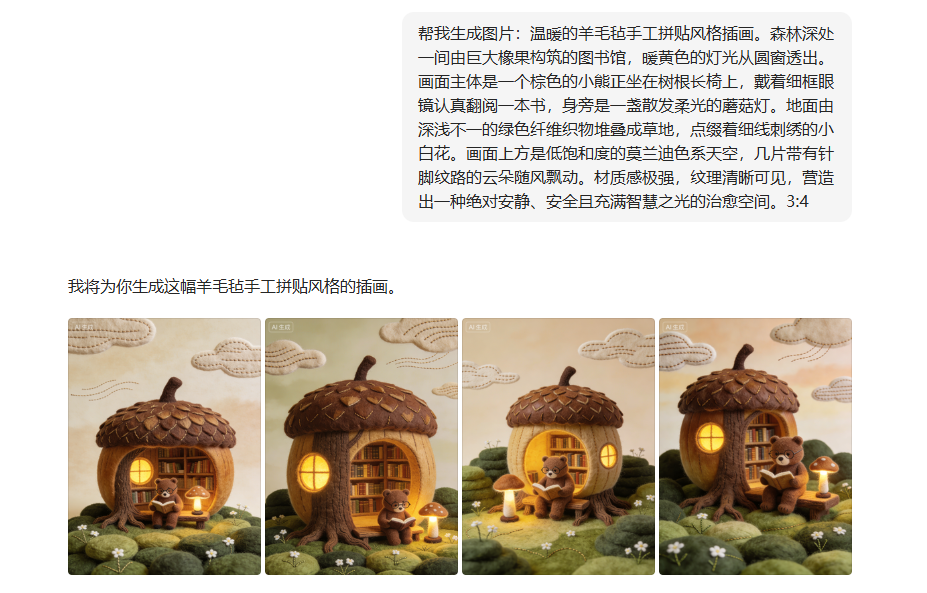
图像⽣成的⽬标是:让计算机从随机噪声、⽂本描述、条件图像或其他模态输⼊中,⾃动创建出逼真、多样且符合要求的图像。
视觉问答(VQA)
视觉问答(VQA)不仅仅是识别出图像中的物体,⽽是要对整个场景进⾏语义层⾯的解析。它综合了感知(Perception)、推理(Reasoning)和知识(Knowledge),试图回答关于图像的⾼阶问题。图像理解追求的是:让计算机像⼈⼀样,看懂图像中到底发⽣了什么,并能够⽤⾃然语⾔描述、推理或回答关于图像的问题。
2深度学习和传统机器学习的区别
3生成式人工智能
⽣成式⼈⼯智能(Generative AI,简称GenAI)是⼈⼯智能(AI)的⼀个分⽀,它能够根据⽤⼾的输⼊,⾃主地创造全新的内容,例如⽂本、图像、⾳频、视频和代码等。它标志着AI从"分析世界"到"创造世界"的跨越。
⽣成式⼈⼯智能是⼈⼯智能领域的重要分⽀,⼀类通过学习数据中的内在规律和分布,能够⽣成在结构上复杂、在组织上符合逻辑、在表现上具有整体⼀致性的全新内容的⼈⼯智能系统。这⾥的"内容"可以是⽂本、图像、⾳频、代码、视频等。
传统AI和⽣成式AI的核⼼区别在于"分析"与"创造"。
• 传统AI(分析式AI):像⼀个"精准的检索员"或"判断者"。它擅⻓从已有数据中识别模式、进⾏分类和预测。例如,⼈脸识别解锁⼿机、搜索引擎匹配关键词、电商平台推荐商品。
• ⽣成式AI(⽣成式AI):像⼀个"创意的创作者"。它通过学习海量数据中的内在规律,能⾃主⽣成全新的、从未存在过的内容。例如,根据⼀句话⽣成⼀幅画、⼀段⽂章或⼀⾸⾳乐。
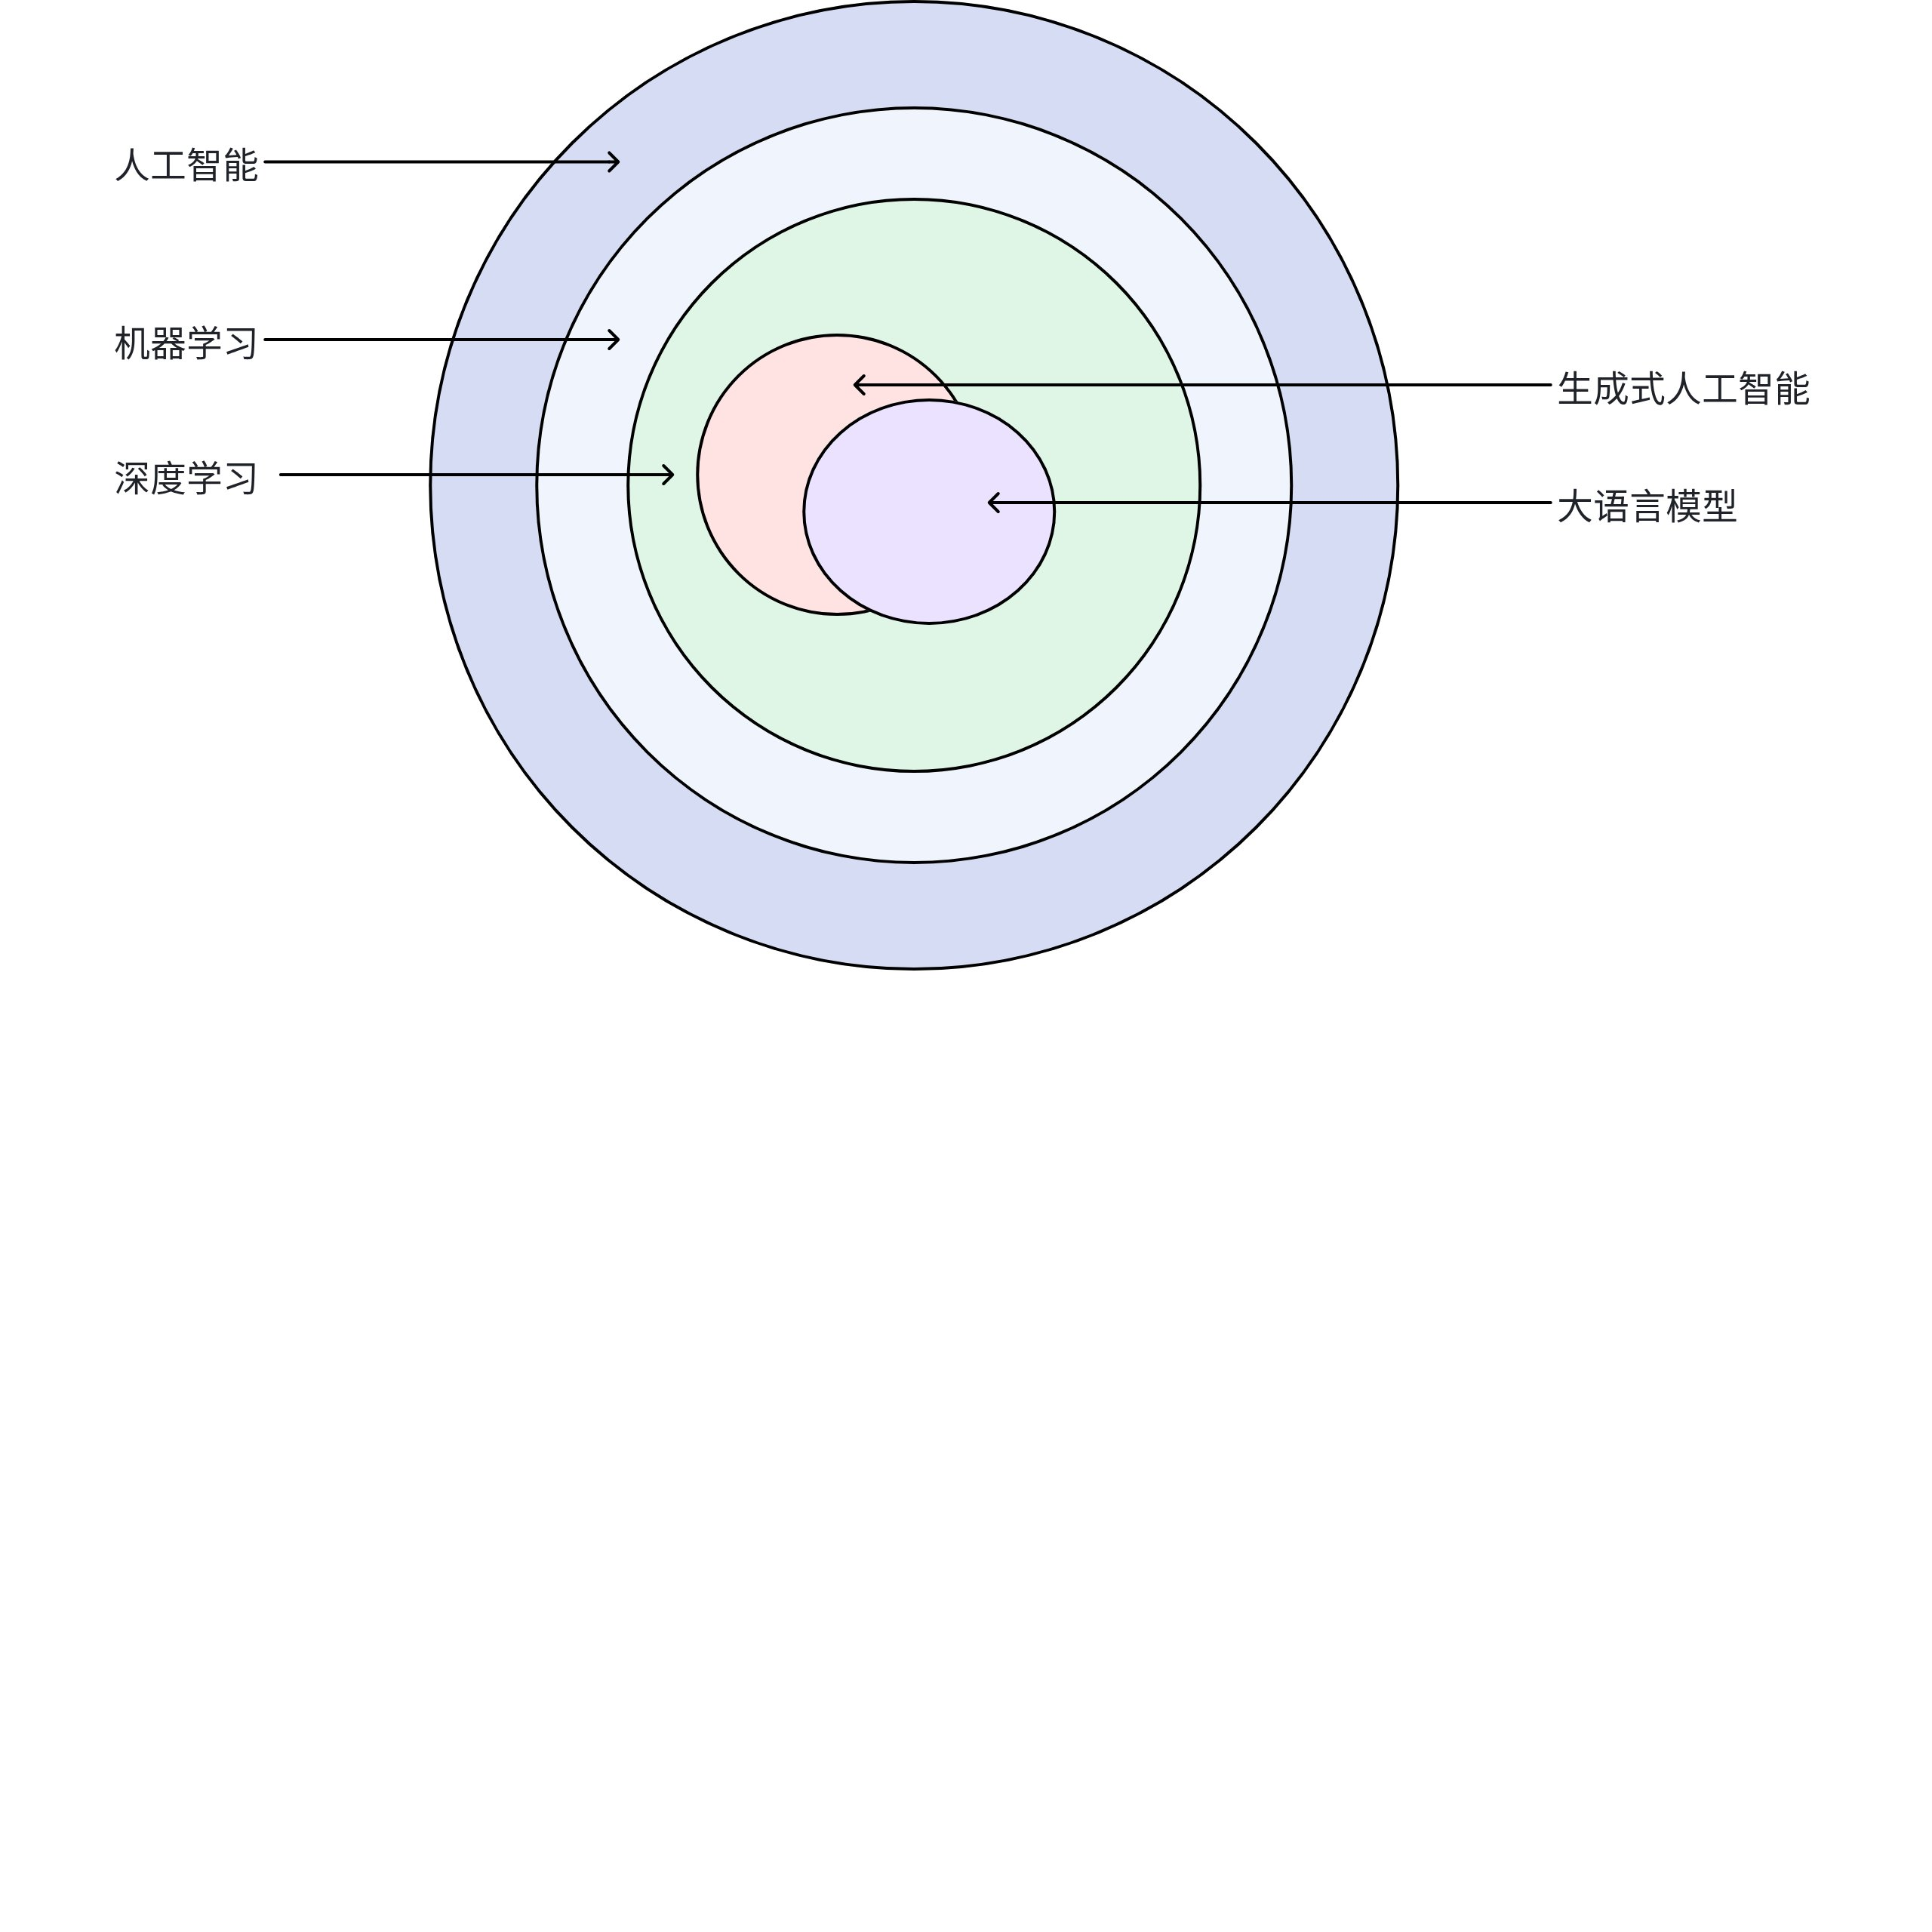
我们可以借助深度学习的⼿段来实现GenAI,当然也可以不借助深度学习,严格意义上GenAI并不属于深度学习但是⽣成式⼈⼯智能太复杂了,⽬前的实现都是基于深度学习,所以⼤家谈论的深度学习都是归结于深度学习。
假设现在不打⻋了,我们来预测明天会不会下⾬。
传统的机器学习(分类)是:输⼊今天的天⽓数据x x ,输出y=1(下⾬)或y=0(不下⾬)。这还是y=f(x)。
但⽣成式AI不这么⼲。它学到的不是y=ax+b,⽽是学到⼀个"概率抽奖机"。
• 它⼼⾥的公式变成了:
结果=随机抽奖(概率列表)
举个例⼦:模型看了海量数据后,算出"明天下⾬"概率60%,"不下⾬"概率40%。
⽣成式AI的本质不是直接告诉你"下⾬",⽽是根据这60%和40%的⽐例去掷⼀次骰⼦。如果骰⼦落在60%范围,它就⽣成"下⾬";落在40%,就⽣成"晴天"。
所以,它的数学本质不再是固定的y=f(x),⽽是:
y∼P(x)(读作:y服从于x x 的概率分布)
通俗理解:以前的ML是"计算器"(按2+3必得5);GenAI是"⼀个懂⾏的赌徒"(根据历史胜率下注,这次押赢,下次可能押输,结果不固定)。这就是为什么同样的问题问ChatGPT,它每次回答的字眼都不完全⼀样。
3.1按⽣成内容分类
⽂本⽣成
让AI根据你的要求写出⽂字内容。它可以写⽂章、诗歌、代码、邮件、剧本,也可以帮你总结⽂档、翻译语⾔、进⾏逻辑推理。就像拥有⼀个知识渊博、⽂笔流畅的助⼿。DeepSeek,ChatGPT,Kimi都都是业界知名的产品。
图像⽣成(跨模态)
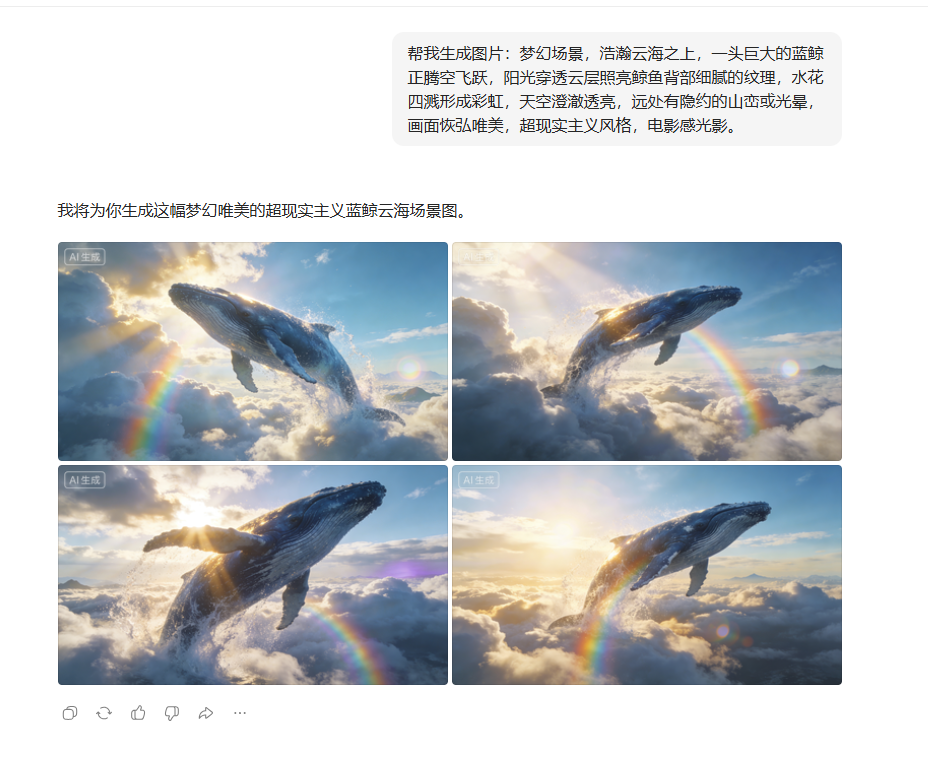
AI根据你的⽂字描述或参考图,⽣成图⽚、插画、海报、产品设计图等视觉内容。它可以帮助设计师快速出图、修改细节、拓展创意,让"脑洞"直接变成画⾯。业界知名产品,Midjourney,DALL·E3,Stable Diffusion,⾖包等。
下⾯是我⽤⾖包⽣成的⼀个图⽚,⾸先我是⽤deepseek优化了下提⽰词,原始提⽰词"把下⾯的提⽰词的细节写丰富些⽣成⼀个云上⻜跃的蓝鲸"。
⾳频⽣成(跨模态)
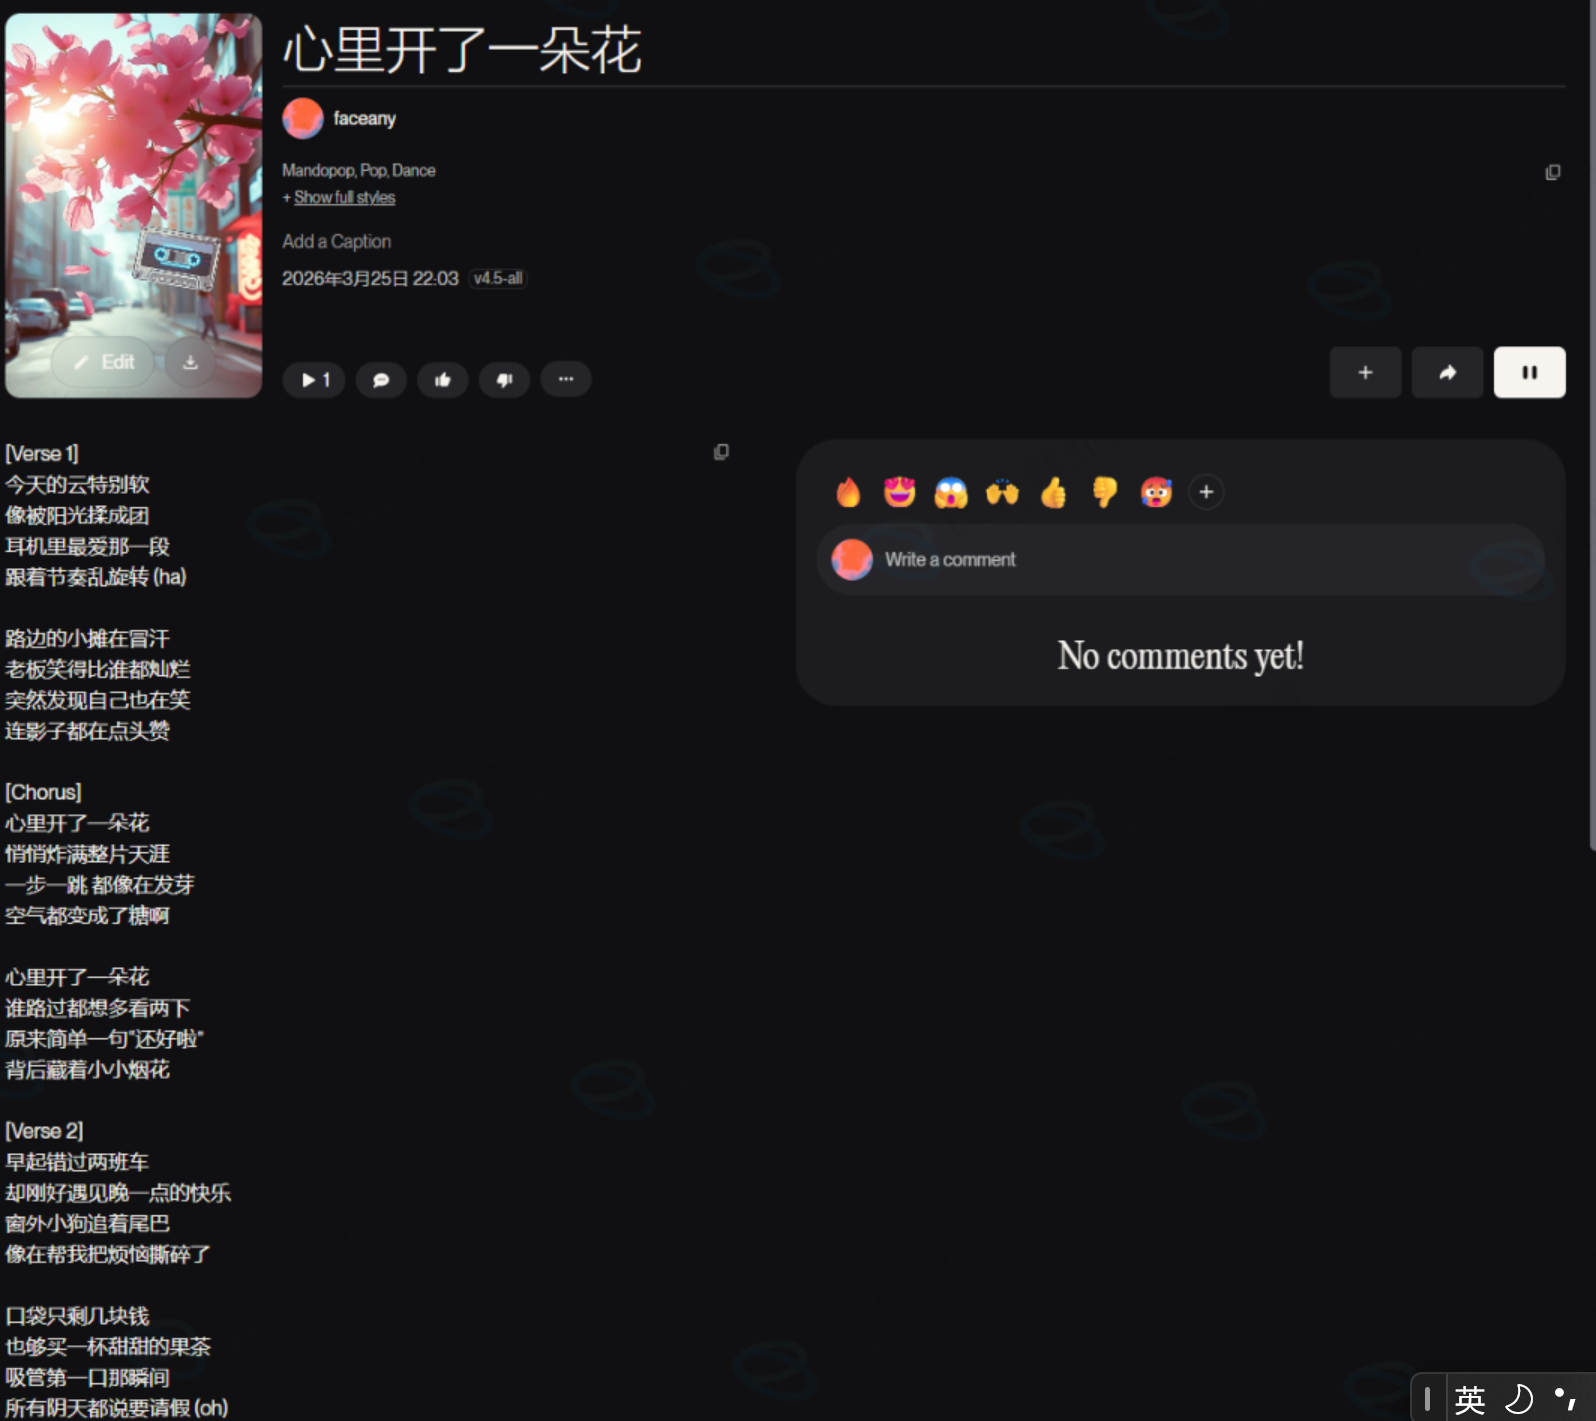
借助AI⽣成声⾳内容。包括:克隆某个⼈的声⾳(语⾳合成)、⽣成背景⾳乐、创作歌曲(包括⼈声演唱)、⾳效制作、甚⾄让⼀段录⾳换成另⼀种语⾔但保留原声线。业界知名产品如Suno,Udio,⾖包。
我⽤suno(https://suno.com/)⽣成了⼀⾸歌曲,⼤家可以听⼀下,还是⾮常的动听,⽽且还有对应的歌词,歌词的意境也表述的很清楚。
提⽰词可以看下很简单
视频⽣成(跨模态)
AI根据⽂字或图⽚⽣成动态视频、创建3D模型、数字⼈播报,业界知名产品有可灵,⾖包,即梦,Runway,Veo等。
2大语言模型
"⼤语⾔模型"(Large Language Model,简称LLM)是当前⼈⼯智能领域的核⼼突破,它通过海量的⽂本数据训练,参数规模达数⼗亿以上,使机器能够像⼈类⼀样理解、⽣成和处理语⾔。⼤语⾔模型可以理解为:⼀个通过海量⽂本训练⽽成的、拥有巨量参数的、能理解和⽣成⼈类语⾔的概率模
型。
⽣成式⼈⼯智能是⼀个⼴泛的领域或技术类别,⽽⼤语⾔模型是实现这个领域⽬标的最核⼼、最成熟的⼀种技术路径,特别专注于⽂本的⽣成。
2.1有多⼤
之所以叫"⼤"语⾔模型,主要体现在三个⽅⾯:
• 数据⼤:它学习过⼈类互联⽹上⼏乎所有的公开⽂本,包括书籍、维基百科、新闻、论⽂、代码等,规模可达数万亿单词(Token)的量级。
• 参数⼤:参数可以理解为模型的"脑细胞"或"记忆抽屉"。参数越多,模型越"聪明"。从早期的⼏亿参数,发展到今天主流模型拥有数千亿甚⾄上万亿的参数。
• 算⼒⼤:训练这样⼀个模型需要成千上万张顶级显卡,耗费数⽉时间,电费成本⾼达数百万甚⾄数千万美元。
我们以GPT3和DeepSeek为例
chatgpt3(2020年)核⼼数据如下:
数据来源于OpenAI在2020年发布的原始论⽂Language Models are Few-Shot Learners
• 原始数据量:约45TB的压缩⽂本数据,这是清洗前的规模。
• 清洗后数据量:约570GB,经过过滤和去重后实际⽤于训练的有效语料。
• 模型参数:1750亿(175billion),是当时最⼤的密集参数语⾔模型
| 数据集 | 原始规模(Tokens) | 训练权重 | 说明 |
|---|---|---|---|
| Common Crawl | 4100亿 | 60% | 互联⽹⽹⻚爬取,质量参差不⻬,经过过滤后使⽤,但权重较低 |
| WebText2 | 190亿 | 22% | 从互联⽹平台精⼼挑选的⾼质量⽹⻚内容 |
| Books1 | 120亿 | 8% | 互联⽹书籍语料库(具体来源未完全公开) |
| Books2 | 550亿 | 8% | 另⼀个规模更⼤的书籍语料库 |
| Wikipedia | 30亿 | 3% | 英⽂维基百科,质量最⾼,因此在训练中会被多次重复学习 |
DeepSeek-V3的核⼼数据如下
数据来源DeepSeek-V3技术报告(arXiv:2412.19437)
DeepSeekV3预训练数据量14.8万亿(14.8trillion)tokens,总参数量:671B(6710亿)。
有哪⼏种
按照模型架构分类,模型处理信息的"逻辑回路",分为以下⼏类
| 类别 | 核⼼特点 | 代表模型 | 适⽤场景 |
|---|---|---|---|
| 仅解码器(Decoder-only) | 主流架构具有极强的⽣成和推理能⼒。 | GPT4,Llama3,DeepSeek-V3 | 聊天机器⼈、代码⽣成、复杂推理。 |
| 仅编码器(Encoder-only) | 擅⻓理解双向上下⽂,将⽂本转化为⾼质量向量(Embedding | ||
| )。 | BERT,RoBERTa | ⽂本分类、情感分析、RAG中的向量检索。 | |
| 编码器-解码器(Enc-Dec) | 擅⻓处理"输⼊-输出"的映射关系。 | T5,BART | 机器翻译、⻓⽂本摘要。 |
仅编码器(Encoder-only)------"阅读理解⼤师"
• 核⼼能⼒:双向理解。它能同时看到句⼦"左边"和"右边"的上下⽂,像做阅读理解⼀样,把⼀整段话完整地吸收、消化,然后输出⼀个"语义理解结果"。
• 通俗案例:给你的商品评论做"情感分析"。
◦ 你输⼊⼀句话:"这家餐厅的菜虽然贵,但是好吃到爆。"
◦ 模型只有输⼊,没有"⽣成"的过程。它把整句话看完(既看到"贵",也看到"好吃"),综合判断出你的真实情感是:"正向(好评)"。
• 代表模型:BERT。常⽤于⽂本分类、命名实体识别(如提取简历中的"姓名、学校")。
仅解码器(Decoder-only)------?"天才续写家"
• 核⼼能⼒:单向预测。它只看得⻅"之前"写过的内容,看不⻅"未来"的词。它的⼯作就是根据上⽂,⼀个字⼀个字地"接⻰"往下编,直到编完。
• 通俗案例:你雇了⼀个帮你"写周报"的AI助⼿。
◦ 你输⼊开头:"本周主要完成了项⽬A的测试,发现了⼀个Bug......"
◦ 模型是⾃回归⽣成。它只能看着你给的提⽰词,然后预测下⼀个最可能出现的字("并"),再预测下⼀个字("且"),⼀路推演下去,最终产出⼀篇完整的、你从未⻅过的新周报。
• 代表模型:GPT系列。常⽤于聊天机器⼈(ChatGPT)、写代码、写邮件。
编码器-解码器(Enc-Dec)------"⾼级同声传译"
• 核⼼能⼒:信息转换。输⼊和输出的序列⻓度或语⾔完全不同。编码器负责"读完"并压缩原始信息,解码器负责把这个压缩包"解压"成另⼀种形式的输出。
• 通俗案例:把⼀篇中⽂新闻"翻译"成英⽂。
◦ 编码器(读):把整段中⽂语法和语义吃透,压缩成⼀个"中间语义向量"。
◦ 解码器(写):拿着这个向量,像写英⽂作⽂⼀样,⼀个词⼀个词地⽣成对应的英⽂句⼦。输⼊是中⽂(3个字),输出是英⽂(10个字⺟)。
• 代表模型:T5、BART。常⽤于机器翻译、⽂本摘要(把⻓⽂章读进去,输出短摘要)。
注意:从技术⼴义上讲,BERT是LLM;但在⽬前的⾏业语境下,⼤家聊的"LLM"通常特指以GPT为代表的⽣成式模型。
3⼈⼯智能、机器学习、深度学习、⽣成式AI和⼤语⾔模型的关系
4主流的人工智能大模型
国内外大模型