【数据结构】链表_OJ题
概览
- 单链表题:改指针、快慢指针、哨兵位
- 删除类:移除元素、删除重复元素、分割链表
- 反转类:整条反转、K 个一组反转、回文判断
- 相交与成环:两个链表的公共结点、判断有环、找入环点
- 合并与相加:两条有序链表合并、两数相加
- 复制类:带随机指针的链表怎么深拷贝
核心知识
一、基本动作
链表的题几乎全在考指针怎么改。数组题还能想想数学性质,链表题绕不开那几个固定动作:把 next 指向别人、让两个指针一快一慢、在头上加一个哨兵位。
链表题的解法花样多,落到代码上只有三类动作。
第一类,改指针。 链表的一切操作最终都是「让某个节点的 next 指向另一个节点」。删除节点是让前驱跳过它,插入节点是让新节点接上后面、再让前面接上新节点,反转是让每个节点的 next 指向前一个。写链表题的时候,一定要画图:现在哪些指针是对的,改完哪一个之后哪一段还连着。
第二类,快慢指针。 两个指针同时从头出发,一个每次走一步,一个每次走两步。这个技巧解决四类问题:找中间节点(快指针到尾时慢指针在中间)、找倒数第 k 个(让快指针先走 k 步)、判断有没有环(有环时快指针一定会追上慢指针)、找入环点(相遇之后一个指针回到起点,两个再同步走,相遇处就是入环点)。
第三类,哨兵位。 在真正的头节点前面加一个不存数据的节点,把头部的特殊情况变成普通情况。删除类题目里哨兵位几乎是标配:要删的节点可能就是头节点,加一个哨兵位之后,所有节点都有前驱,删除逻辑就统一了,不用再单独处理头节点。
二、边界值
链表题能出的边界比数组题集中,常见的就下面这五类。
第一类,空链表。 头指针是 NULL。删除、反转、找中间节点,第一件事都得考虑它。空链表返回什么,先定下来再写循环。
第二类,只有一个节点。 这时头节点既是头也是尾,找前驱、找中间、成环判断都会退化。反转一个节点的链表应该原样返回;删除倒数第一个节点就是删除头节点。
第三类,要动的是头节点。 删除等于 val 的节点时,头节点本身可能就是要删的;合并两个链表时,结果的头节点可能来自任意一条链。哨兵位处理的正是这一类情况。
第四类,长度关系。 倒数第 k 个节点里 k 等于链表长度(删的就是头节点)、k 大于长度(非法输入);合并两条链时一条为空;旋转链表时 k 比长度大,要先取模。
第五类,成环。 有环的链表不能直接遍历打印,会死循环。判断有环、找入环点这两道题,验证的时候要特别小心,先确认没有环再打印,或者只打印关键节点。
三、题目总览
| 题号 | 题目 | 套路 | 时间 | 空间 |
|---|---|---|---|---|
| 203 | 移除链表元素 | 哨兵位 + 改指针 | O(n) | O(1) |
| 206 | 反转链表 | 三指针迭代 / 递归 | O(n) | O(1) / O(n) |
| 876 | 链表的中间结点 | 快慢指针 | O(n) | O(1) |
| 面试题 02.02 | 返回倒数第 k 个节点 | 快慢指针 | O(n) | O(1) |
| 21 | 合并两个有序链表 | 哨兵位 + 双指针 / 递归 | O(m+n) | O(1) / O(m+n) |
| 面试题 02.04 | 分割链表 | 两条子链 + 哨兵位 | O(n) | O(1) |
| 面试题 02.06 | 回文链表 | 快慢指针 + 反转后半段 | O(n) | O(1) |
| 160 | 相交链表 | 双指针走对方的路 | O(m+n) | O(1) |
| 141 | 环形链表 | 快慢指针 | O(n) | O(1) |
| 142 | 环形链表 II | 快慢指针 + 同步走 | O(n) | O(1) |
| 138 | 随机链表的复制 | 复制节点插在原节点后 | O(n) | O(n) |
| 83 | 删除排序链表中的重复元素 | 一次遍历 | O(n) | O(1) |
| 2 | 两数相加 | 模拟竖式加法 | O(max(m,n)) | O(max(m,n)) |
| 61 | 旋转链表 | 接成环再断开 | O(n) | O(1) |
| 25 | K 个一组翻转 | 分组 + 局部反转 | O(n) | O(1) |
十五道题里,空间是 O(1) 的有十二道,两道递归写法的空间是 O(n)(递归栈),一道需要额外建表。链表题的方向就是「别开额外空间」,能改指针解决就别建新表。
题目详解
十五道题放在同一个目录下,共用一个 listnode.h(建表、打印、释放、造节点),每题一个 .c 文件,编译命令统一是 gcc -std=c99 -Wall -Wextra -g,每道题下面贴的那段 bash 就是编译和运行用的两条命令。
第一题 移除链表元素(203)
题目:删除链表里所有等于 val 的节点,返回新的头节点。
原题链接: leetcode 203 Remove Linked List Elements
思路。 直白写法要分两段:先循环删掉开头的连续 val(因为头节点没有前驱,只能挪头指针),再循环删中间和末尾的。两段逻辑几乎一样,写第二段的时候很难保证和第一段的判断完全对齐,但只要漏一处就出错。
加一个哨兵位就统一了。 在头节点前面接一个不存数据的节点,让它的 next 指向原来的头。这样每个节点都有前驱 ,删除只剩一套逻辑:遍历,发现 next 的值等于 val 就跳过它,否则往前走。最后返回 guard->next。
c
struct ListNode* removeElements(struct ListNode* head, int val)
{
	struct ListNode guard;              //哨兵位,放在栈上,不用 malloc
	guard.next = head;

	struct ListNode* cur = &guard;
	while (cur->next)
	{
		if (cur->next->val == val)
		{
			struct ListNode* del = cur->next;
			cur->next = del->next;      //跳过它
			free(del);                  //题目要求删掉,就得真的释放
		}
		else
		{
			cur = cur->next;
		}
	}
	return guard.next;
}
哨兵位用栈上的局部变量,不用申请堆内存,也就没有对应的 free。cur 从哨兵位出发,判断的是 cur->next->val,因为要删的是 cur 的下一个,得先拿到它的前驱才能跳过它。
用例走一遍。 删 6,链表是 1->2->6->3->4->5->6:
| 步骤 | cur 停在 | cur->next | 判断 | 链表变成 |
|---|---|---|---|---|
| 1 | 哨兵位 | 1 | 不等于 6 | 不动,cur 走到 1 |
| 2 | 1 | 2 | 不等于 6 | 不动,cur 走到 2 |
| 3 | 2 | 6 | 等于 6 | 2 直接指向 3,释放 6 |
| 4 | 2 | 3 | 不等于 6 | cur 走到 3 |
| 5 | 4 | 5 | 不等于 6 | cur 走到 5 |
| 6 | 5 | 6 | 等于 6 | 5 的 next 置空,释放 6 |
bash
# 所属目录:/home/cocatrice/ds05
gcc -std=c99 -Wall -Wextra -g p01_remove_elements.c -o p01
./p01
text
输入 1->2->6->3->4->5->NULL 删 6
输出 1->2->3->4->5->NULL

输入 NULL 删 6
输出 NULL

输入 6->6->6->NULL 删 6
输出 NULL
边界值。
- 空链表:哨兵位的 next 是 NULL,循环一次都不进,返回 NULL。
- 全是要删的:一路删完,哨兵位的 next 变成 NULL,返回空链表。
- 要删的是头节点:哨兵位保证了头节点也有前驱,走的是和中间节点一样的分支。
- 一个都不用删:每个节点都走 else 分支,链表原样返回。
复杂度:时间 O(n),每个节点最多看两次;空间 O(1),哨兵位在栈上。
第二题 反转链表(206)
题目:把单链表反转,返回新的头节点。
原题链接: leetcode 206 Reverse Linked List
思路。 反转的本质是把每个节点的 next 从「指向后一个」改成「指向前一个」。麻烦在于改指针的时候,后面的节点就找不到了,所以要多存一个后继指针。
迭代版用三个指针:pre 记前驱、cur 走当前、next 存后继。每一轮先把 cur 的后继存进 next,再把 cur->next 改成 pre,然后 pre 和 cur 一起前移。走完之后 pre 指向原来的尾节点,也就是新的头。
c
//迭代版:三个指针,一轮改一个
struct ListNode* reverseList(struct ListNode* head)
{
	struct ListNode* pre = NULL;
	struct ListNode* cur = head;
	while (cur)
	{
		struct ListNode* next = cur->next;   //先存后继
		cur->next = pre;                     //掉头
		pre = cur;                           //pre 前移
		cur = next;                          //cur 前移
	}
	return pre;
}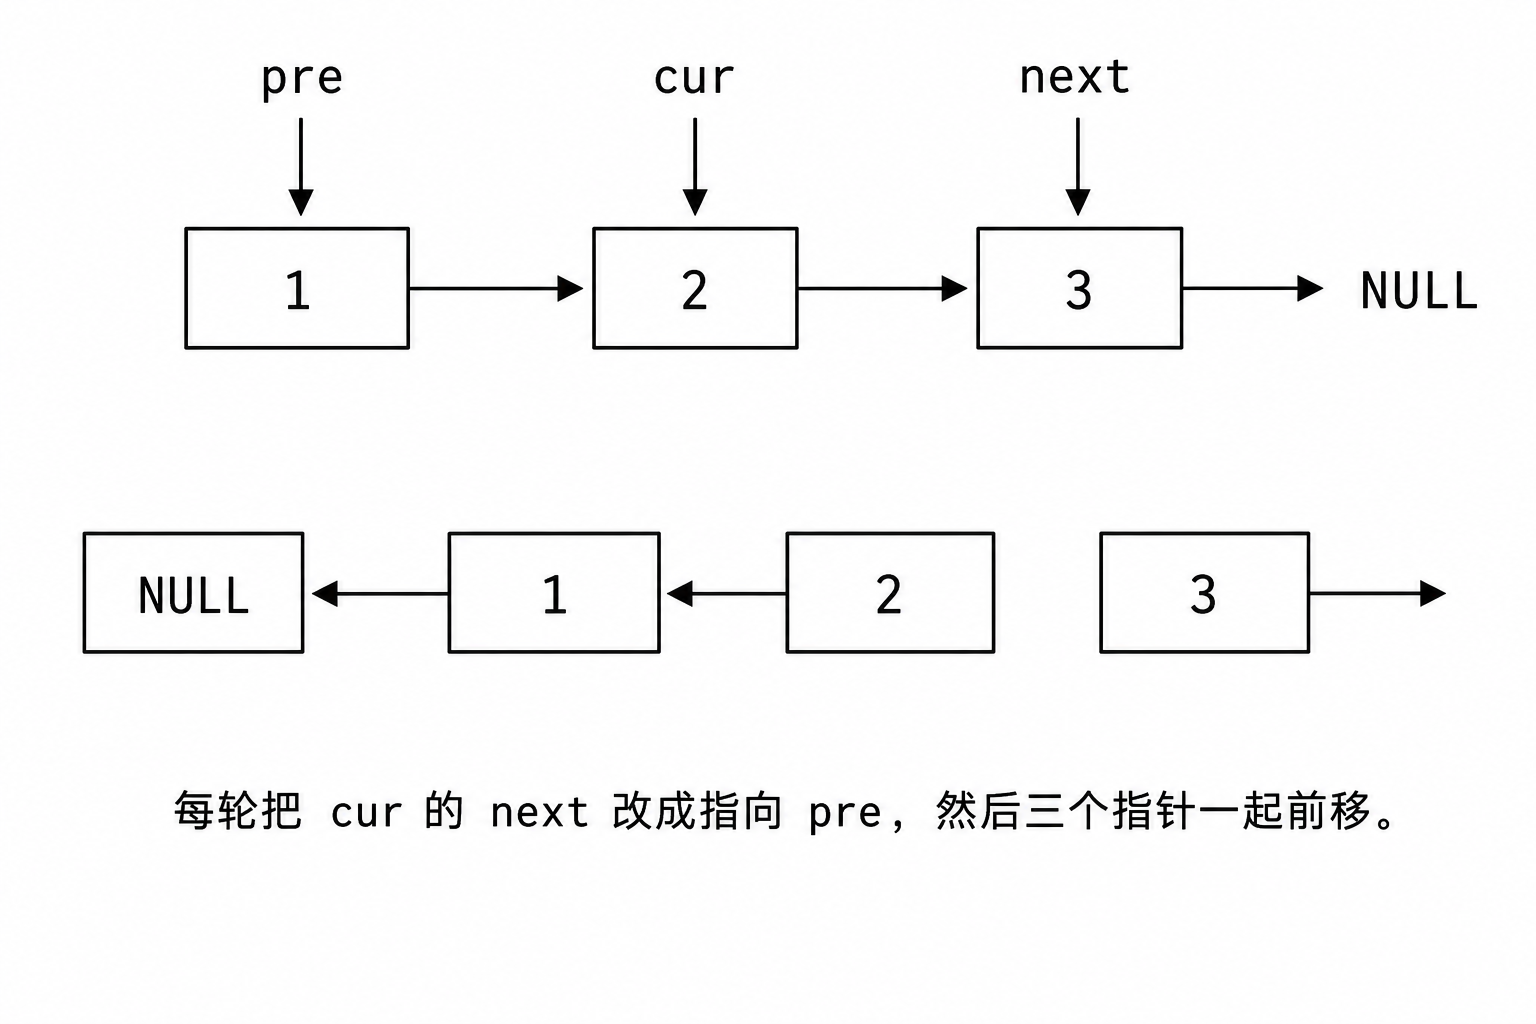
图 1 反转链表的三个指针
递归版反过来做 :把头节点之后的部分交给递归去反转,回来的时候后半段已经是反的,头节点成了那条反转好的链之外剩下的节点。这时只要让原来的第二个节点的 next 指回头节点,再把头节点的 next 置空,整条链就接完了。
c
//递归版:先把后面的反转好,再把自己接上去
struct ListNode* reverseListRec(struct ListNode* head)
{
	if (head == NULL || head->next == NULL)
	{
		return head;                 //空表或者只剩一个节点,直接返回
	}
	struct ListNode* newHead = reverseListRec(head->next);   //后面那段先反转
	head->next->next = head;         //原来的第二个节点回头指我
	head->next = NULL;               //我变成尾节点
	return newHead;
}
递归版的错都出在最后两句赋值上。 head->next->next = head 是让自己变成后继,head->next = NULL 是断掉原来的正向指针。第二句漏了就会成环:1 和 2 互相指着,遍历的时候死循环。
用例走一遍。 1->2->3->NULL,迭代版的每一步:
| 轮次 | pre | cur | next | 改完之后 |
|---|---|---|---|---|
| 起始 | NULL | 1 | --- | 1->2->3 |
| 1 | 1 | 2 | 2 | NULL<-1 2->3 |
| 2 | 2 | 3 | 3 | NULL<-1<-2 3 |
| 3 | 3 | NULL | --- | NULL<-1<-2<-3 |
循环在 cur 变成 NULL 时结束,返回 pre,也就是 3。
bash
# 所属目录:/home/cocatrice/ds05
gcc -std=c99 -Wall -Wextra -g p02_reverse_list.c -o p02
./p02
text
[迭代版]
输入 1->2->3->4->5->NULL
输出 5->4->3->2->1->NULL

[递归版]
输入 1->2->3->4->5->NULL
输出 5->4->3->2->1->NULL

[迭代版]
输入 7->NULL
输出 7->NULL

[递归版]
输入 7->NULL
输出 7->NULL

[迭代版]
输入 NULL
输出 NULL

[递归版]
输入 NULL
输出 NULL
两个版本用的是各建一条同样的链,所以输入输出逐字相同,可以对着比。
边界值。
- 空链表:迭代版 cur 一开始就是 NULL,循环不进,返回 pre 也就是 NULL;递归版在第一个判断里就返回。
- 只有一个节点:迭代版改一次自己指自己(然后被 pre 覆盖),返回它;递归版直接返回。
- 两个节点:递归版最能暴露问题的情况,漏了
head->next = NULL就在这里成环。
复杂度 :迭代版时间 O(n)、空间 O(1);递归版时间 O(n)、空间 O(n),多出来的 n 是递归栈的深度。链表很长的时候递归会爆栈,如果被追问,面试里要主动把这句补上。
第三题 链表的中间结点(876)
题目:返回链表的中间节点,有两个中间节点时返回靠后的那个。
原题链接: leetcode 876 Middle of the Linked List
思路。 先遍历一遍数出长度,再走一半,要两趟。快慢指针一趟就够:慢指针每次走一步,快指针每次走两步,快指针走到尾时,慢指针停在中间。
c
struct ListNode* middleNode(struct ListNode* head)
{
	struct ListNode* slow = head;
	struct ListNode* fast = head;
	while (fast && fast->next)
	{
		slow = slow->next;       //慢的走一步
		fast = fast->next->next; //快的走两步
	}
	return slow;
}
循环条件里的 fast 和 fast->next 各挡一种情况。 只写 fast,快指针停在最后一个节点上时,fast->next->next 会在 NULL 上解引用;只写 fast->next,快指针本身是 NULL 时第一件事就是解引用空指针。而且这两个条件的顺序也不能换:先判 fast 再判 fast->next。
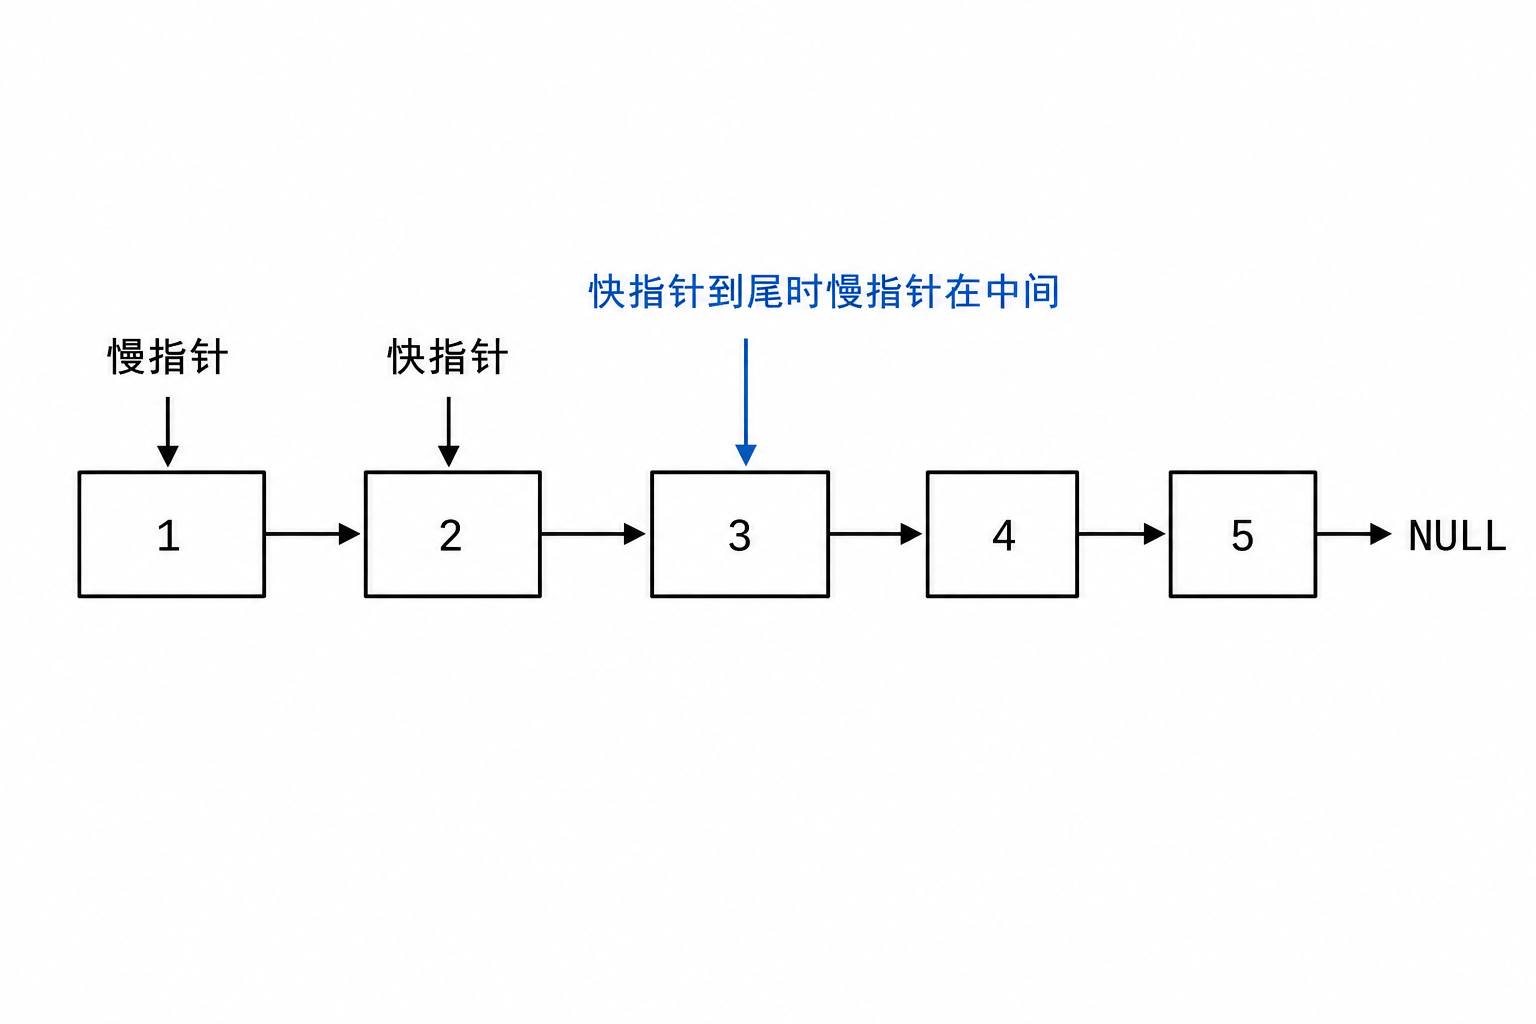
图 2 快慢指针找中间节点
偶数个节点的返回值落在后半段。 五个节点时 fast 从 1 走到 3 再到 5,走到 5 时 fast->next 是 NULL,循环停下,slow 在 3,落在正中间。六个节点时 fast 从 1 走到 3 再到 5 再越过 NULL,最后一步 fast 变成 NULL 循环才停 ,slow 走到了 4,正是靠后的那个中间节点,条件里那个 fast 就是处理这一步的。
bash
# 所属目录:/home/cocatrice/ds05
gcc -std=c99 -Wall -Wextra -g p03_middle_node.c -o p03
./p03
text
输入 1->2->3->4->5->NULL
输出 3->4->5->NULL

输入 1->2->3->4->5->6->NULL
输出 4->5->6->NULL

输入 1->NULL
输出 1->NULL
边界值。
- 空链表:循环不进,返回 NULL。
- 一个节点:返回它自己。
- 两个节点:返回第二个(靠后的中间节点)。
- 奇数个:返回正中间那个。
复杂度:时间 O(n),快指针走完 n/2 步;空间 O(1)。
第四题 返回倒数第 k 个节点(面试题 02.02)
题目:返回链表倒数第 k 个节点,k 保证有效。
原题链接: leetcode 面试题 02.02 Kth Node From End of List LCCI
思路。 正着数第 k 个容易,倒着数不知道总长度。让快指针先走 k 步,这样快慢指针之间就固定差了 k 个节点;然后两个一起走,快指针到尾时,慢指针落在倒数第 k 个上。
c
int kthToLast(struct ListNode* head, int k)
{
	struct ListNode* fast = head;
	struct ListNode* slow = head;
	while (k--)                       //快指针先走 k 步
	{
		fast = fast->next;
	}
	while (fast)                      //两个一起走,快指针到尾就停
	{
		fast = fast->next;
		slow = slow->next;
	}
	return slow->val;
}
两个指针的间距从头到尾都固定在 k 上。 快指针先走掉 k 步,之后每轮两个一起前移,差值不变。快指针走到末尾时,它走过的总路程是 k 加上同步走的距离,正好是整条链;慢指针只走了同步的那一段,等于总长度减 k,停在倒数第 k 个节点上。
用例走一遍。 1->2->3->4->5,找倒数第 2 个:快指针先走 2 步停在 3,然后两个同步走,快指针从 3 到 4 到 5 再到 NULL,慢指针从 1 到 2 到 3 到 4,停在 4,正是倒数第二个。
bash
# 所属目录:/home/cocatrice/ds05
gcc -std=c99 -Wall -Wextra -g p04_kth_to_last.c -o p04
./p04
text
输入 1->2->3->4->5->NULL k=2
输出 4

输入 1->2->3->4->5->NULL k=1
输出 5

输入 1->2->3->4->5->NULL k=5
输出 1
边界值。
- k 等于 1:返回尾节点。
- k 等于链表长度:返回头节点,慢指针一步都没走。
- k 大于长度:题目保证不会出现;如果面试要求处理,快指针先走的时候会走到 NULL,得先判断。
- 只有一条长度为 1 的链、k 等于 1:返回那个节点。
复杂度:时间 O(n),两个指针加起来走的路程不到 2n;空间 O(1)。
第五题 合并两个有序链表(21)
题目:把两个升序链表合并成一个升序链表。
原题链接: leetcode 21 Merge Two Sorted Lists
思路。 两条链都有序,所以只要每次从两条链的开头挑小的那个接上去,接完往后走一步。结果链表的头节点来自哪一条是不确定的 ,接的过程中还得一直记住结果的头。先摆一个哨兵位,这个头最后自然落在 guard.next 上。
c
//迭代版:哨兵位 + 双指针
struct ListNode* mergeTwoLists(struct ListNode* list1, struct ListNode* list2)
{
	struct ListNode guard;
	guard.next = NULL;
	struct ListNode* tail = &guard;      //tail 是结果链的尾

	while (list1 && list2)
	{
		if (list1->val <= list2->val)
		{
			tail->next = list1;
			list1 = list1->next;
		}
		else
		{
			tail->next = list2;
			list2 = list2->next;
		}
		tail = tail->next;               //尾指针往后挪
	}
	tail->next = list1 ? list1 : list2;  //剩下那条整条接上
	return guard.next;
}
循环结束之后不用逐个接剩下的。 两个指针里必有一个先到 NULL,另一条链剩下的那一段本来就有序,每个值都不小于已经接上的,整段挂在尾部就行,不用再搬一遍。
递归版更短:挑出小的那个当头,剩下的交给递归。
c
//递归版:谁小谁当头,剩下的递归合并
struct ListNode* mergeTwoListsRec(struct ListNode* l1, struct ListNode* l2)
{
	if (l1 == NULL) return l2;
	if (l2 == NULL) return l1;
	if (l1->val <= l2->val)
	{
		l1->next = mergeTwoListsRec(l1->next, l2);
		return l1;
	}
	else
	{
		l2->next = mergeTwoListsRec(l1, l2->next);
		return l2;
	}
}
递归的空间是 O(m+n),最多递归 m+n 层;迭代版全程只有四个局部指针,O(1)。两个版本的时间都是 O(m+n)。
bash
# 所属目录:/home/cocatrice/ds05
gcc -std=c99 -Wall -Wextra -g p05_merge_two_lists.c -o p05
./p05
text
[迭代版]
输入 1->2->4->NULL 和 1->3->4->NULL
输出 1->1->2->3->4->4->NULL

[递归版]
输入 1->2->4->NULL 和 1->3->4->NULL
输出 1->1->2->3->4->4->NULL

[迭代版]
输入 NULL 和 NULL
输出 NULL

[递归版]
输入 NULL 和 NULL
输出 NULL

[迭代版]
输入 NULL 和 0->NULL
输出 0->NULL

[递归版]
输入 NULL 和 0->NULL
输出 0->NULL
边界值。
- 两条都空:返回 NULL。
- 一条空:返回另一条,两种情况都测了。
- 值相等:迭代版用
<=挑 list1,保证相等时先接第一条,结果稳定。 - 一条链全部小于另一条:循环里一直挑同一条,另一条最后整条挂上。
复杂度:时间 O(m+n),每个节点恰好被接一次;迭代版空间 O(1),递归版 O(m+n)。
第六题 分割链表(面试题 02.04)
题目:把链表分成两部分,小于 x 的节点排在前面,大于等于 x 的排在后面,两部分内部保持原来的相对顺序。
原题链接: leetcode 面试题 02.04 Partition List LCCI
思路。 不能像数组那样前后对调,因为链表要求保持相对顺序。开两条子链分别收:一条收小于 x 的,一条收大于等于 x 的,遍历原链表时按值把节点接到对应的链尾,最后把两条链接起来。
两条子链都要记尾指针,否则每接一个节点都得从头找尾。哨兵位在这里的作用和删除类题目一样:不用再判断「第一条符合条件的节点是不是链头」。
c
struct ListNode* partition(struct ListNode* head, int x)
{
	struct ListNode small, big;          //两条子链的哨兵位
	struct ListNode* sTail = &small;
	struct ListNode* bTail = &big;
	small.next = big.next = NULL;

	while (head)
	{
		if (head->val < x)
		{
			sTail->next = head;          //接到小链尾部
			sTail = head;
		}
		else
		{
			bTail->next = head;          //接到大链尾部
			bTail = head;
		}
		head = head->next;               //原链表上继续走
	}
	bTail->next = NULL;                  //大链收尾,断掉后面的残留
	sTail->next = big.next;              //小链尾部接上大链
	return small.next;
}
漏掉大链的收尾赋值,两条链会串成环。 大链的最后一个节点,它的 next 还指向原链表里的下一个节点,而那个节点可能已经被接到小链上去了。不收尾的话,两条链会串成一个环或者重复一段。
用例走一遍。 1->4->3->2->5->2,x 等于 3:
| 节点 | 判断 | 小链 | 大链 |
|---|---|---|---|
| 1 | 小于 3 | 1 | 空 |
| 4 | 大于等于 | 1 | 4 |
| 3 | 大于等于 | 1 | 4->3 |
| 2 | 小于 3 | 1->2 | 4->3 |
| 5 | 大于等于 | 1->2 | 4->3->5 |
| 2 | 小于 3 | 1->2->2 | 4->3->5 |
最后小链尾部接大链:1->2->2->4->3->5。
bash
# 所属目录:/home/cocatrice/ds05
gcc -std=c99 -Wall -Wextra -g p06_partition_list.c -o p06
./p06
text
输入 1->4->3->2->5->2->NULL x=3
输出 1->2->2->4->3->5->NULL

输入 2->1->NULL x=2
输出 1->2->NULL

输入 3->5->8->1->NULL x=4
输出 3->1->5->8->NULL
边界值。
- 全部小于 x:大链是空的,小链尾部接上空的
big.next(NULL),链表原样返回。 - 全部大于等于 x:小链是空的,返回大链,顺序也不变。
- 空链表:两条链都是空的,返回 NULL。
- 值是 x 本身:归到大链(判断用的是小于,不是小于等于)。
复杂度:时间 O(n),一趟遍历;空间 O(1),只有两对指针。
第七题 回文链表(面试题 02.06)
题目:判断链表是不是回文,要求 O(n) 时间和 O(1) 空间。
原题链接: leetcode 面试题 02.06 Palindrome Linked List LCCI
思路。 回文就是正着读和反着读一样。数组里可以双指针从两头往中间比,链表回不去,所以要把后半段反转过来,这样从两端往中间比就变成从中间往两边比。
做法是快慢指针先找到中间节点,把后半段反转,再从两头往中间逐个比。比较完可以把后半段再翻回去,让链表恢复原样。
c
static struct ListNode* reverseList(struct ListNode* head)
{
	struct ListNode* pre = NULL;
	while (head)
	{
		struct ListNode* next = head->next;
		head->next = pre;
		pre = head;
		head = next;
	}
	return pre;
}

bool isPalindrome(struct ListNode* head)
{
	if (head == NULL || head->next == NULL) return true;

	struct ListNode* slow = head;
	struct ListNode* fast = head;
	while (fast->next && fast->next->next)     //slow 停在中间
	{
		slow = slow->next;
		fast = fast->next->next;
	}

	struct ListNode* second = reverseList(slow->next);   //后半段反转
	struct ListNode* p1 = head;
	struct ListNode* p2 = second;
	bool ok = true;
	while (p2)                                  //后半段走完就够了
	{
		if (p1->val != p2->val)
		{
			ok = false;
			break;
		}
		p1 = p1->next;
		p2 = p2->next;
	}

	slow->next = reverseList(second);            //翻回去,恢复原链表
	return ok;
}
找中点的循环条件和上一题不一样。 这里写的是 fast->next && fast->next->next,让 slow 停在前半段的最后一个节点 上,这样 slow->next 就是后半段的开头。第三题要的是「靠后的中间节点」,条件得让快指针一路越过 NULL,两边的差别就在这里,而同样是快慢指针,停在哪一格是由用途倒推出来的。
比较的循环只判 p2,因为后半段比前半段短或者等长,走完后半段就够了。长度是奇数时,正中间那个节点不参与比较,被循环条件直接跳过去。
bash
# 所属目录:/home/cocatrice/ds05
gcc -std=c99 -Wall -Wextra -g p07_palindrome_list.c -o p07
./p07
text
输入 1->2->2->1->NULL
输出 true

输入 1->2->NULL
输出 false

输入 1->NULL
输出 true
边界值。
- 空链表和单节点:直接返回 true,不用反转。
- 两个节点:走一轮反转加一轮比较。
- 奇数长度:中间节点被跳过,实测里没单独列,逻辑上由「只判 p2」保证。
复杂度:时间 O(n),找中点、反转、比较各一趟;空间 O(1)。
第八题 相交链表(160)
题目:判断两条链表是否相交,相交就返回第一个公共节点。
原题链接: leetcode 160 Intersection of Two Linked Lists
思路。 暴力解法是固定一条链上的每个节点,去另一条上找,O(mn)。换个角度想:如果两条链从某个节点开始合并,那么从这个节点到结尾的长度是一样的。所以只要把「长的那条先走掉长度差」,两个指针就会同时到达公共节点。
但求长度又要两趟。更巧的写法是让两个指针互相走对方的路 :A 的指针走完 A 就去走 B,B 的指针走完 B 就去走 A。这样两个指针的总路程都是 m+n,如果相交,它们会在公共节点相遇;如果不相交,会同时变成 NULL。
c
struct ListNode* getIntersectionNode(struct ListNode* headA, struct ListNode* headB)
{
	if (headA == NULL || headB == NULL) return NULL;

	struct ListNode* p1 = headA;
	struct ListNode* p2 = headB;
	while (p1 != p2)                 //比较的是节点地址,不是值
	{
		p1 = p1 ? p1->next : headB;  //走完自己的就换对方的
		p2 = p2 ? p2->next : headA;
	}
	return p1;                       //相交点,或者两条都走完时的 NULL
}
循环一定会结束。 两个指针每轮各走一步,换过路线之后各自的总步数都卡在 m+n 上,走到头要么相遇,要么同时变成 NULL。不存在一个已经走完、另一个还在走的情况。
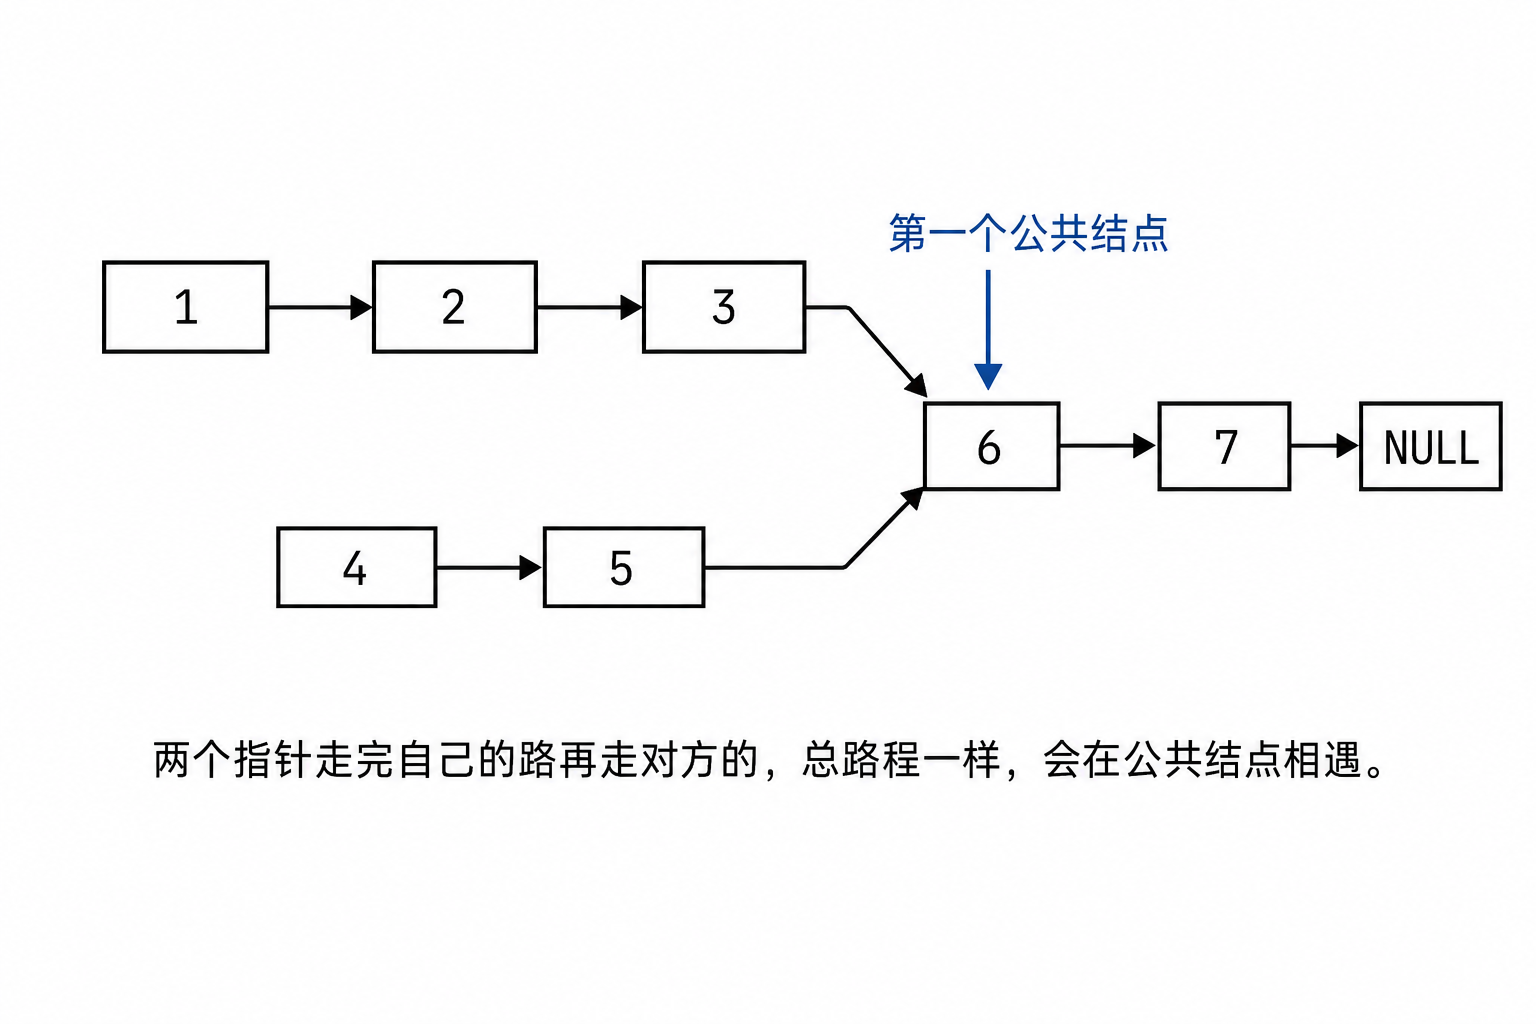
图 3 两个链表相交
相交比的是节点地址,不是值。 相交的定义是同一个节点被两条链共用,地址相同;两个不同节点上的值碰巧相等不算相交。
bash
# 所属目录:/home/cocatrice/ds05
gcc -std=c99 -Wall -Wextra -g p08_intersection_node.c -o p08
./p08
text
输入 4->1->8->4->5->NULL 与 5->6->1->8->4->5->NULL
输出 8->4->5->NULL

输入 2->6->4->NULL 与 1->5->NULL
输出 NULL
第一组两条链长度不同,短的先走完就去走长的,正好补上长度差。
边界值。
- 不相交:两个指针都变成 NULL 时循环结束,返回 NULL。
- 任一条为空:直接返回 NULL。
- 相交点就是头节点:第一次比较就相等,循环不进。
- 两条链长度相同且不相交:同时变成 NULL,不会死循环。
复杂度:时间 O(m+n),空间 O(1)。
第九题 环形链表(141)
题目:判断链表里有没有环。
原题链接: leetcode 141 Linked List Cycle
思路。 有环的话,从头遍历永远不会结束。快慢指针:慢的走一步,快的走两步,如果有环,快的会在环里绕回来追上慢的;如果没环,快的先走到 NULL。
c
bool hasCycle(struct ListNode* head)
{
	struct ListNode* slow = head;
	struct ListNode* fast = head;
	while (fast && fast->next)
	{
		slow = slow->next;
		fast = fast->next->next;
		if (slow == fast) return true;   //相遇就是有环
	}
	return false;                        //快的走到头了,没环
}
快指针每轮只多走一步,所以不会从慢指针头上跳过去。 两个指针都进环之后,两者在环上的距离每轮缩小 1。环长是有限的,这个距离迟早缩到 0,也就是相遇。快指针要是每轮多走两步以上,就可能整轮跨过慢指针所在的位置,永远追不上;多走一步没有这个问题。
验证有环的链表,打印之前得先判环。 直接遍历会死循环。测试程序里的做法是:先调 hasCycle 判环,有环就用「最多打印 n 个节点」的安全打印,输出里能看到 ...(后面就是环了,不再往下遍历) 这个提示。
bash
# 所属目录:/home/cocatrice/ds05
gcc -std=c99 -Wall -Wextra -g p09_has_cycle.c -o p09
./p09
text
输入 3->2->0->-4->...(后面就是环了,不再往下遍历)
输出 true

输入 1->2->NULL
输出 false

输入 1->...(后面就是环了,不再往下遍历)
输出 true
第三组是自环,一个节点指向自己。慢指针走一步到它,快指针走两步也到它,第一次循环就相遇。
边界值。
- 空链表和单节点无环:
fast或fast->next为 NULL,循环不进,返回 false。 - 单节点自环:第一轮就相遇。
- 环在中间:两个指针都在环里绕,一定会追上。
- 整条链是一个大环:同样成立。
复杂度:时间 O(n),慢指针进环后最多绕一圈就被追上;空间 O(1)。
第十题 环形链表 II(142)
题目:有环就返回入环的第一个节点,没环返回 NULL。
原题链接: leetcode 142 Linked List Cycle II
思路。 先用上一题的办法找到相遇点,然后让一个指针回到起点,两个指针都改成每次走一步,它们再次相遇的地方就是入环点。
为什么一定会相遇,先把四段距离定下来。
text
                      ┌──────────── 环,长度 L = b + c ────────────┐
                      │                                            │
头 ─────── a ────► 入环点 ─────── b ───────► 相遇点 ─── c ─────┘- a:从头节点走到入环点经过的步数
- b:从入环点走到相遇点经过的步数
- c:从相遇点继续往前走到入环点经过的步数
- L:环长,等于 b 加 c
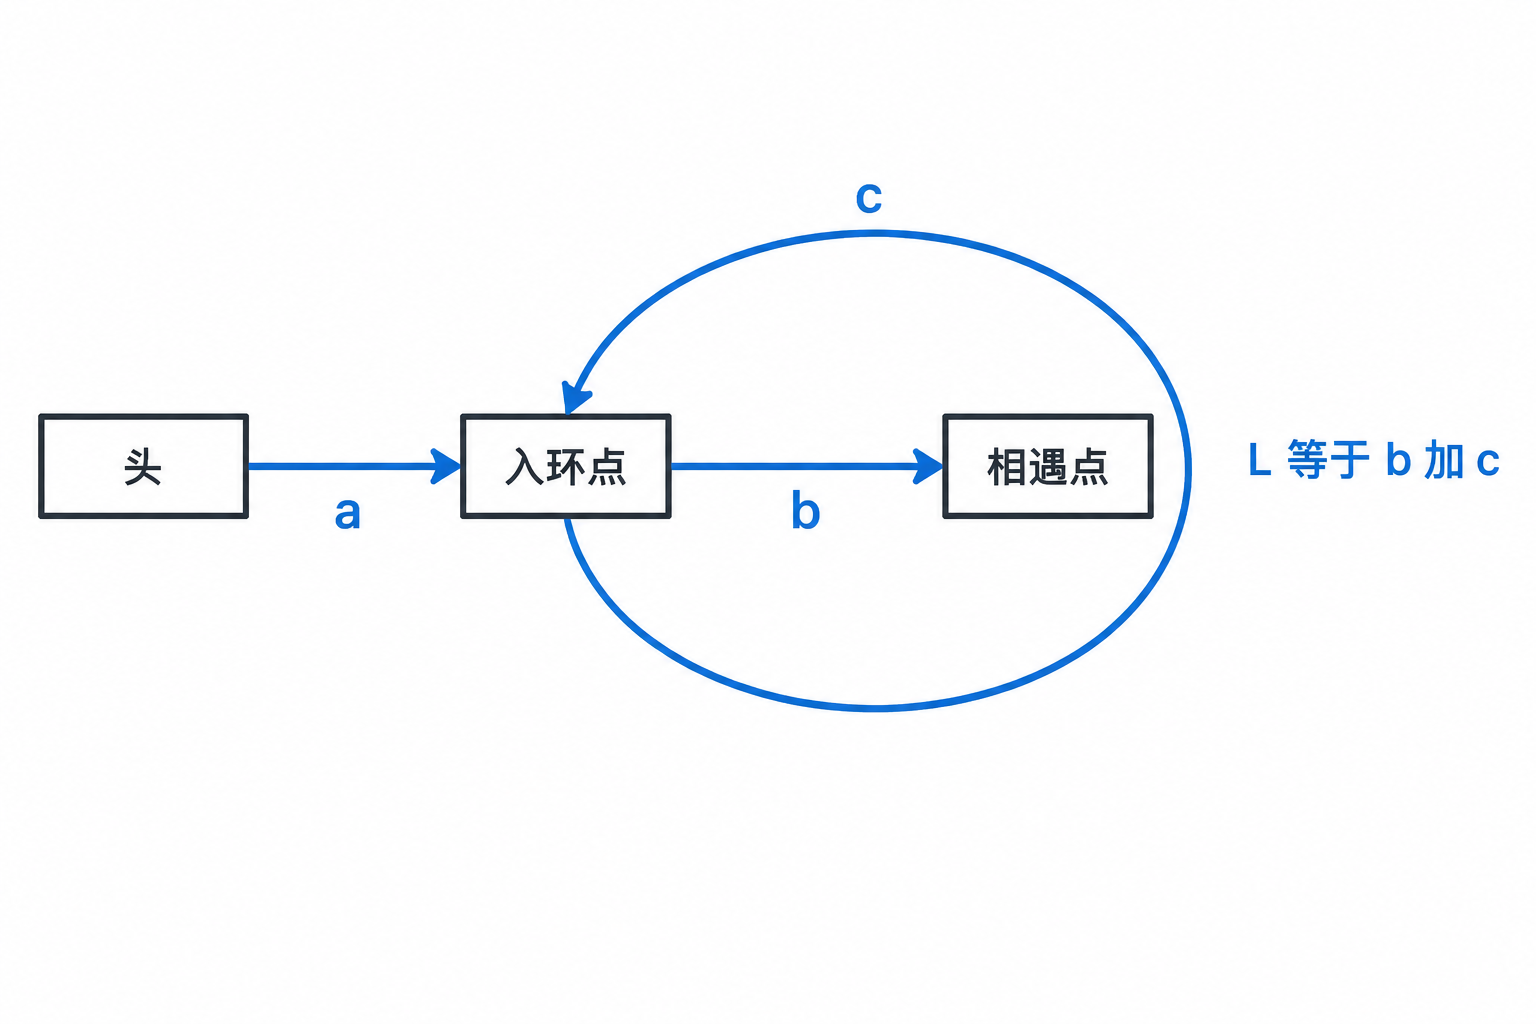
图 4 a、b、c、L 四段距离
**第一步,慢指针进环的时候两个指针差多远。 **慢指针每次走一步,快指针每次走两步。慢指针走到入环点时一共走了 a 步,这期间快指针已经走了 2a 步:它也是先用 a 步走到入环点,剩下的 a 步在环里绕,所以它此刻在环上的坐标是 a mod L。把两个指针的差距(从慢指针沿前进方向数到快指针)记作 d,于是 d 等于 a 对 L 取余,取值范围是 0 到 L 减 1。
第二步,差距每轮怎么变。 两个指针之后都在环里,每走一轮,快指针两步、慢指针一步,**差距每轮增加 1。**走一轮是 d 加 1,两轮是 d 加 2,一直加下去,超过 L 就在环上绕回来。差距要变成 L 的整数倍,需要走 L 减 d 轮。关键在于差距是一步一步加上去的,不可能从 L 减 1 直接跳到 L 加 1,所以它一定会精确地取到 L 这个值。 这就是必然相遇的全部理由,不是碰巧,是差距每次只变 1,扫过了每一个可能的值。
第三步,慢指针在环里走了多远。 上面算出来的 L 减 d 轮,就是慢指针进环之后走的步数:
bash
b = L - dd 最小是 0、最大是 L 减 1,所以 b 最大是 L 减 1,**慢指针进环之后走不满一圈就相遇了。**快指针则至少多绕了一整圈,因为它比慢指针先进环。
入环点为什么正好在相遇点往回数 c 步的位置。 相遇那一刻两个指针花的时间一样,快指针速度是慢指针的两倍,所以快指针走的路程是慢指针的两倍。慢指针走了 a 加 b,快指针走了 a 加 b 再加 m 个整圈:
bash
2(a + b) = a + b + m × L

两边同时减去 a + b:

    a + b = m × L

所以:

    a = m × L - b
这个等式就是全部答案,把它翻译成走 a 步会落在哪。从头节点出发走 a 步,按定义正好落在入环点;从相遇点出发走 a 步,把 a 换成 m 乘 L 减 b,因为 b 加 c 等于 L,所以 L 减 b 就是 c:
bash
a = m × L - b = c + (m - 1) × L也就是先走 c 步回到入环点,再绕 m 减 1 个整圈,走整圈会回到原地,所以落点还是入环点。两个指针一个在头、一个在相遇点,同时出发、速度都是每次一步、走的都是 a 步,落点又都是入环点,那它们必然在入环点碰面。而且不会更早碰面:从头出发的那个指针在到达入环点之前一直在环外,两个指针不可能落在同一个节点上。
两个常见的追问。
**快指针为什么每次走两步,走三步行不行?**不行,这正是上面「差距每次只加 1」的意义。如果快指针每次走三步,差距每轮加 2,环长 L 是偶数的时候差距的奇偶性永远不变:假设 d 是奇数,差距就一直落在奇数上,而 0 和 L 都是偶数,差距永远取不到它们,两个指针在环里绕多久都遇不上。相对速度必须是 1,也就是快指针每次只比慢指针多走一步,才能保证扫过每一个余数。
**慢指针为什么不能也走两步?**两个都走两步的话相对速度变成 2,又回到上面那个奇偶性问题;而且每次只差一步还有个额外好处,相邻两轮之间两个指针只错开一个节点,不会跳过正确的相遇点。
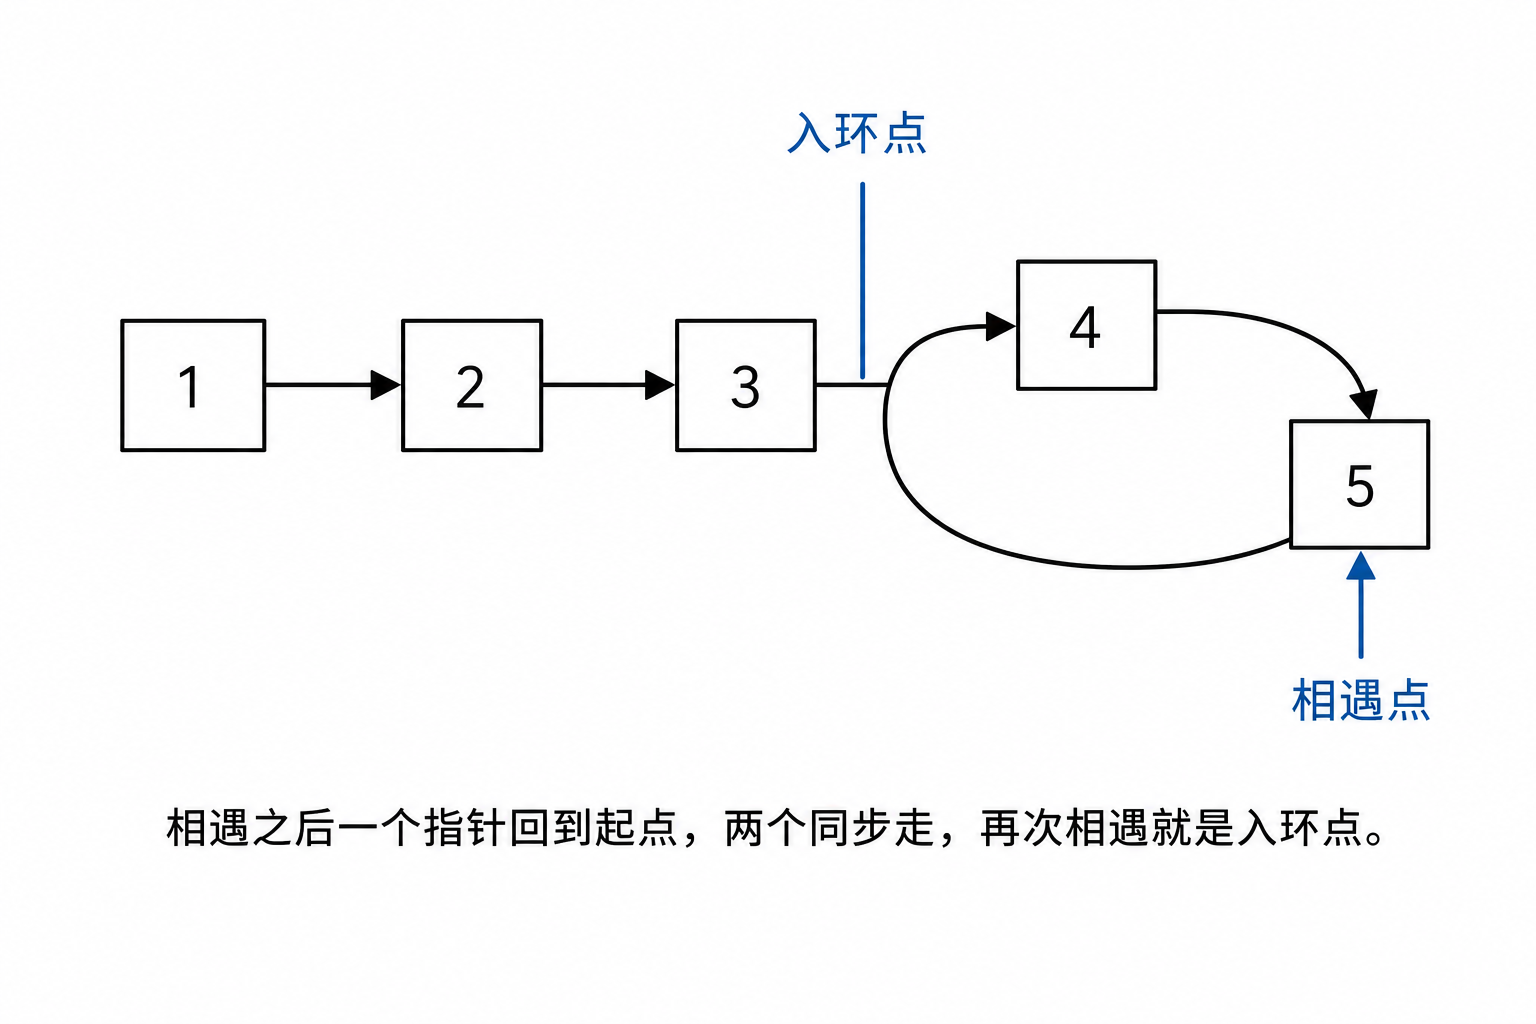
图 5 带环链表与入环点
c
struct ListNode* detectCycle(struct ListNode* head)
{
	struct ListNode* slow = head;
	struct ListNode* fast = head;
	while (fast && fast->next)
	{
		slow = slow->next;
		fast = fast->next->next;
		if (slow == fast)                    //找到相遇点
		{
			struct ListNode* p = head;
			while (p != slow)                //一个从头,一个从相遇点,同步走
			{
				p = p->next;
				slow = slow->next;
			}
			return p;                        //入环点
		}
	}
	return NULL;                             //没环
}
bash
# 所属目录:/home/cocatrice/ds05
gcc -std=c99 -Wall -Wextra -g p10_detect_cycle.c -o p10
./p10
text
输入 3->2->0->-4->...(后面就是环了,不再往下遍历)
输出 入环点 2

输入 1->2->...(后面就是环了,不再往下遍历)
输出 入环点 1

输入 1->2->NULL
输出 NULL(无环)第二组的入环点就是头节点,a 等于 0。相遇点落在环里,所以 p 一开始并不等于 slow,但同步走若干轮之后两者会在头节点碰面,代码里不用为这种情况写特例。
边界值。
- 无环:返回 NULL,实测第三组就是。
- 入环点是头节点:上面的第二组。
- 自环:入环点就是那个节点本身。
- 环很长、头很短:推导里 a 很小、c 很大,一样成立。
复杂度:时间 O(n),两段循环加起来不超过两圈;空间 O(1)。
第十一题 随机链表的复制(138)
题目:每个节点除了 next 还有一个 random 指针,可以指向链表里任意节点或者 NULL。深拷贝整条链表,新链表的 random 也要指向新链表里的对应节点。
原题链接: leetcode 38 Copy List with Random Pointer
思路。 麻烦在 random 上:复制节点的 random 应该指向「原节点 random 对应的那个复制节点」,可复制节点还没建出来的时候,这个关系是断的。
最直接的解法是用一张哈希表记「原节点到复制节点」的映射,第一趟建节点,第二趟连 next 和 random,时间 O(n)、空间 O(n)。
不用哈希表的做法,是把映射关系直接藏进链表结构:
- 复制节点插在原节点后面:1 后面插 1',2 后面插 2'。这样「原节点的下一个」就是它的复制节点,要找映射关系,看 next 就够了。
- 连 random :原节点 node 的复制是 node->next,那么
node->next->random = node->random ? node->random->next : NULL。翻译成人话就是:原节点的 random 的下一个,正好是那个节点的复制。 - 拆链:把复制的节点摘出来串成新链,同时把原链恢复原样。
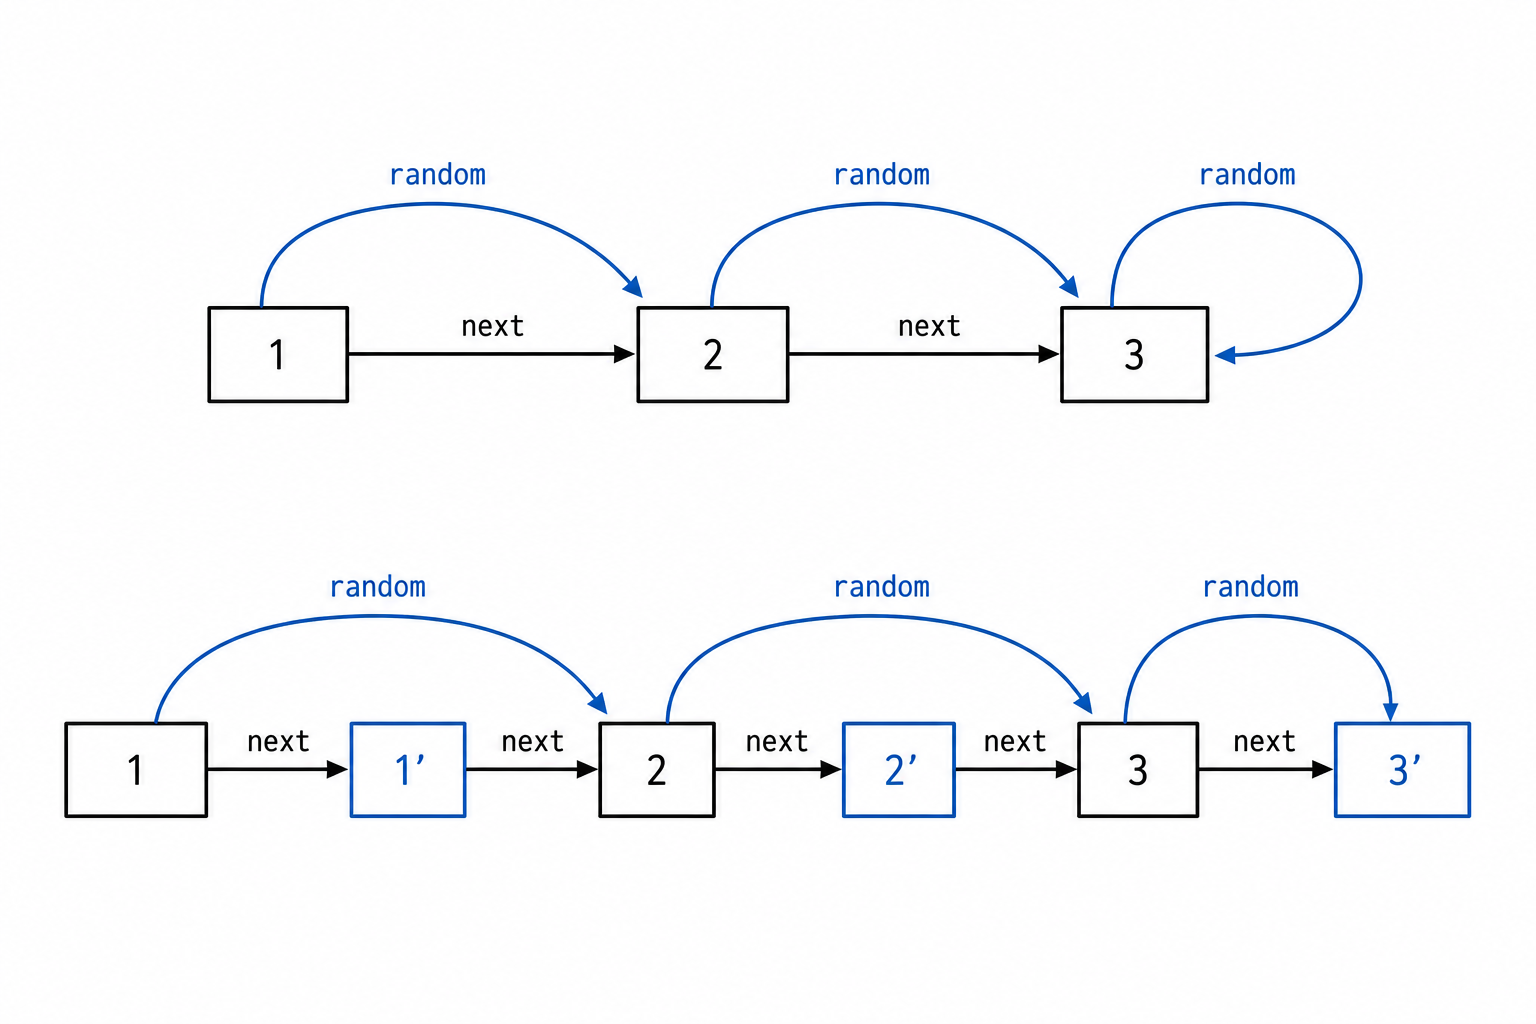
图 6 随机链表的复制过程
c
struct Node* copyRandomList(struct Node* head)
{
	if (head == NULL) return NULL;

	//第一步:复制节点插在原节点后面
	struct Node* cur = head;
	while (cur)
	{
		struct Node* copy = (struct Node*)malloc(sizeof(struct Node));
		copy->val = cur->val;
		copy->next = cur->next;
		copy->random = NULL;
		cur->next = copy;
		cur = copy->next;
	}

	//第二步:把 random 接对
	cur = head;
	while (cur)
	{
		struct Node* copy = cur->next;
		copy->random = cur->random ? cur->random->next : NULL;   //random 可能是 NULL
		cur = copy->next;
	}

	//第三步:拆成两条链,顺手把原链恢复
	struct Node* newHead = head->next;
	cur = head;
	while (cur)
	{
		struct Node* copy = cur->next;
		cur->next = copy->next;            //原链跳过复制节点
		copy->next = copy->next ? copy->next->next : NULL;   //复制链也跳过原节点
		cur = cur->next;
	}
	return newHead;
}
第二步的三目判断是为 random 等于 NULL 准备的 ,直接写 cur->random->next 会在 NULL 上解引用。第三步的两个 next 也都要判断,链表尾部的复制节点后面已经没有原节点了。
bash
# 所属目录:/home/cocatrice/ds05
gcc -std=c99 -Wall -Wextra -g p11_copy_random_list.c -o p11
./p11
valgrind --leak-check=full ./p11
text
输入 7(random=NULL)->13(random=7)->11(random=1)->10(random=11)->1(random=7)
输出 7(random=NULL)->13(random=7)->11(random=1)->10(random=11)->1(random=7)

输入 1(random=2)->2(random=2)
输出 1(random=2)->2(random=2)

输入 3(random=3)
输出 3(random=3)

输入 NULL
输出 NULL
第一组是这道题的官方例子,五个节点里有两个的 random 指向同一个节点,还有一个指向 NULL;第三组是自指。输出里打印的 random 是节点的值,验证的是「复制的 random 指向复制链里的对应节点」,如果指向了原链的节点,值也会一样,所以程序里另外比对了地址。
text
==29837==     in use at exit: 0 bytes in 0 blocks
==29837==   total heap usage: 19 allocs, 19 frees, 448 bytes allocated
==29837== All heap blocks were freed -- no leaks are possible
==29837== ERROR SUMMARY: 0 errors from 0 contexts (suppressed: 0 from 0)
嫌三步走绕的话,哈希表的解法更直白。 开一张表记「原节点到复制节点」的映射,第一趟建节点、把映射存进去,第二趟连 next 和 random。C 里没有现成的哈希表,得自己开一张,这里用开放寻址,键是指针。
c
typedef struct
{
	Node* key;      //原链表的节点地址
	Node* val;      //对应的复制节点
} Pair;

//把指针当成键做哈希,指针按 8 字节对齐,右移几位再取模
static unsigned int HashFunc(Node* p, int cap)
{
	return (unsigned int)(((unsigned long)p >> 4) % (unsigned long)cap);
}

static Node* Lookup(Pair* table, int cap, Node* key)
{
	unsigned int h = HashFunc(key, cap);
	while (table[h].key)
	{
		if (table[h].key == key) return table[h].val;
		h = (h + 1) % cap;
	}
	return NULL;
}

static void Insert(Pair* table, int cap, Node* key, Node* val)
{
	unsigned int h = HashFunc(key, cap);
	while (table[h].key) h = (h + 1) % cap;
	table[h].key = key;
	table[h].val = val;
}

Node* copyRandomListHash(Node* head)
{
	if (head == NULL) return NULL;

	int n = 0;
	for (Node* p = head; p; p = p->next) n++;    //数节点个数
	int cap = 4;
	while (cap < n * 2) cap <<= 1;               //表长开成两倍,冲突少
	Pair* table = (Pair*)calloc(cap, sizeof(Pair));

	for (Node* p = head; p; p = p->next)         //第一趟:建节点、存映射
	{
		Node* copy = (Node*)malloc(sizeof(Node));
		copy->val = p->val;
		copy->next = NULL;
		copy->random = NULL;
		Insert(table, cap, p, copy);
	}

	Node* newHead = Lookup(table, cap, head);
	for (Node* p = head; p; p = p->next)         //第二趟:连 next 和 random
	{
		Node* copy = Lookup(table, cap, p);
		copy->next = p->next ? Lookup(table, cap, p->next) : NULL;
		copy->random = p->random ? Lookup(table, cap, p->random) : NULL;
	}

	free(table);
	return newHead;
}
bash
# 所属目录:/home/cocatrice/ds05
gcc -std=c99 -Wall -Wextra -g p11b_copy_random_hash.c -o p11b
./p11b
用 STL 的哈希表更直白 C++ 的 unordered_map 直接就是一张哈希表,键用节点指针,值用复制节点,第一趟建节点、把映射存进去,第二趟连 next 和 random。C 里没有现成的哈希表,这种题就该换 C++ 写,手写一张开放寻址的表要四十行,用 STL 只要十行。
cpp
#include <unordered_map>
using namespace std;

struct Node
{
	int val;
	Node* next;
	Node* random;
	Node(int v) : val(v), next(NULL), random(NULL) {}
};

//用 STL 的 unordered_map 记「原节点 -> 复制节点」
Node* copyRandomListSTL(Node* head)
{
	if (head == NULL) return NULL;

	unordered_map<Node*, Node*> mp;

	for (Node* p = head; p; p = p->next)          //第一趟:建节点,存映射
	{
		mp[p] = new Node(p->val);
	}
	for (Node* p = head; p; p = p->next)          //第二趟:连 next 和 random
	{
		mp[p]->next = p->next ? mp[p->next] : NULL;
		mp[p]->random = p->random ? mp[p->random] : NULL;
	}
	return mp[head];
}
两趟遍历,第二趟里的两个问号表达式处理 next 和 random 可能是空的情况。mpp 用的是下标访问,这里每一个键都是第一趟亲手插进去的,所以不会意外创建新条目。
bash
# 所属目录:/home/cocatrice/ds05
g++ -std=c++11 -Wall -Wextra -g p11b_copy_random_stl.cpp -o p11b
./p11b
bash
原链表  7(random=NULL)->13(random=7)->11(random=1)->10(random=11)->1(random=7)
复制之后7(random=NULL)->13(random=7)->11(random=1)->10(random=11)->1(random=7)
复制链和原链的节点地址有没有重合: 没有重合

原链表  3(random=3)
复制之后3(random=3)
bash
==21610==     in use at exit: 0 bytes in 0 blocks
==21610== All heap blocks were freed -- no leaks are possible
==21610== ERROR SUMMARY: 0 errors from 0 contexts (suppressed: 0 from 0)
两版的取舍。 时间都是 O(n)。空间上三步走那份的 n 全是返回结果本身的节点,STL 这份还要多搭一张哈希表,装 n 个键值对,常数和内存都更大。三步走赢在省空间,STL 赢在十几行写完、不容易写错,面试里先说三步走、再补一句 STL 怎么写,两条路都摆在桌面上。
**为什么三步走复制出来的一定是对的。 **把三条不变量摆出来,每一步都在维持它们。
text
第一步之后(副本插在原节点后面):
    1 -> 1' -> 2 -> 2' -> 3 -> 3' -> NULL

    不变量一:对每个原节点 p,p->next 就是 p 的副本,
    而且副本的 next 指向 p 原来的下一个节点。
    于是「找 p 的副本」变成一次 p->next,不用查表。

第二步:把每个副本的 random 接对
    副本的 random = 原节点 random 的下一个
    由不变量一,「原节点 random 的下一个」正好是它的副本,
    所以副本的 random 落在复制链上,和原节点一一对应。

第三步之后(拆成两条):
    原链:1 -> 2 -> 3 -> NULL        结构完全恢复
    新链:1' -> 2' -> 3' -> NULL     random 也一一对应
一步一步看:
**第一步保住的是「映射可查」。 **副本紧跟在原节点后面,原节点和副本的对应关系用 next 就能算出来,不需要额外的表。这一步改动了原链表,所以后面必须把结构还回去。
第二步保住的是「random 落在新链上」。 赋值那句是三目表达式:原节点的 random 不是 NULL 时,取 p->random->next。由不变量一,这个地址就是 random 指向的那个节点的副本;是 NULL 时直接给 NULL,不取 next。
第三步同时完成两件事。 cur->next = copy->next 把原链表的 next 还原(copy->next 在第一步之后就是原链表的下一个节点);copy->next = copy->next ? copy->next->next : NULL 把副本串成新链(副本的 next 指向原节点的下一个原节点,再取一次 next 就是那个原节点的副本)。
结论:原链表的节点顺序和每个节点的 random 都回到复制前的状态;新链表与原链表节点个数相同、结构同构,第 i 个副本的 next 指向第 i 加 1 个副本,random 指向原链表对应位置上那个节点的副本;两条链没有任何共用节点,副本全是 malloc 出来的新地址。
结构同构的比法值得一提:**把指针换算成序号。**先遍历原链表,把每个节点的 next 和 random 记成「指向第几个节点」(NULL 记成 -2),复制完之后对新链表按同样的规则取一遍序号,逐个比对。这样比直接比地址可靠,因为新链表的地址本来就该和原链表不同。
c
//把一条链的结构记下来:每个节点的 next 序号和 random 序号
static void Snapshot(Node* head, int* nextIdx, int* randIdx, int n)
{
	int i = 0;
	for (Node* p = head; p && i < n; p = p->next, i++)
	{
		nextIdx[i] = IndexOf(head, p->next);
		randIdx[i] = IndexOf(head, p->random);
	}
}

//检查一条链的结构和记录是否一致
static int StructureSame(Node* head, int* nextIdx, int* randIdx, int n)
{
	int i = 0;
	for (Node* p = head; p && i < n; p = p->next, i++)
	{
		if (IndexOf(head, p->next) != nextIdx[i]) return 0;
		if (IndexOf(head, p->random) != randIdx[i]) return 0;
	}
	return i == n;
}
bash
# 所属目录:/home/cocatrice/ds05
gcc -std=c99 -Wall -Wextra -g p11c_verify_copy.c -o p11c
./p11c
bash
随机造了 500 条链表,每条检查五项:节点数、结构同构、值相同、无共用节点、原链未被破坏
不通过的有 0 条
空链表:copyRandomList(NULL) 返回 NULL五百条一条不通过的都没有,说明前面那三条不变量在实际代码里确实成立了。验证程序本身也过了 valgrind,0 错误 0 泄漏。 边界值。
- 空链表:直接返回 NULL。
- 只有自环节点(random 指向自己):复制节点的 random 也指向自己。
- random 全是NULL:第二步的三目判断每次都走 NULL 分支。
- 多个节点指向同一个 random:复制之后它们指向同一个复制节点,靠地址比对确认。
边界值。
- 空链表:直接返回 NULL。
- 只有自环节点(random 指向自己):复制节点的 random 也指向自己。
- random 全是 NULL:第二步的三目判断每次都走 NULL 分支。
- 多个节点指向同一个 random:复制之后它们指向同一个复制节点,靠地址比对确认。
复杂度:时间 O(n),三趟遍历;空间 O(n),这 n 个节点全是返回结果本身,除此之外没有辅助结构。哈希表的写法也要这 n 个节点,另外再搭一张表。
第十二题 删除排序链表中的重复元素(83)
题目:链表已经按升序排好,删掉重复的元素,每个值只留一个。
原题链接: leetcode 83 Remove Duplicates from Sorted List
思路。 有序是个大前提:重复的元素一定挨在一起,所以只要比较当前节点和下一个节点的值,相等就跳过下一个,不相等就往前走,一趟遍历解决。
和数组那一篇的去重是同一个思路,区别在于链表不需要慢指针:数组版本要两个下标,一个读一个写;这里 cur 停在最后一个保留的节点上,写位置就是它的 next。
c
struct ListNode* deleteDuplicates(struct ListNode* head)
{
	struct ListNode* cur = head;
	while (cur && cur->next)
	{
		if (cur->val == cur->next->val)
		{
			struct ListNode* del = cur->next;
			cur->next = del->next;       //跳过重复的那个
			free(del);
		}
		else
		{
			cur = cur->next;             //不重复才往前走
		}
	}
	return head;
}
删除之后 cur 不往前走。 因为新的 next 可能还是重复值:1->1->1 里,第一次删掉第二个 1,cur 还停在第一个 1 上,第三轮发现新的 next 又是 1,继续删。要是删完就 cur = cur->next,中间的重复就漏了。
bash
# 所属目录:/home/cocatrice/ds05
gcc -std=c99 -Wall -Wextra -g p12_delete_duplicates.c -o p12
./p12
text
输入 1->1->2->NULL
输出 1->2->NULL

输入 1->1->2->3->3->NULL
输出 1->2->3->NULL

输入 1->1->1->NULL
输出 1->NULL

输入 NULL
输出 NULL
第三组就是「连删两次」的情况,验证的正是删完不前进这个细节。
边界值。
- 空链表:循环不进,返回 NULL。
- 只有一个节点:
cur->next是 NULL,循环不进。 - 全部相同:一路删到只剩第一个。
- 没有重复:每个节点都走 else 分支,原样返回。
复杂度:时间 O(n);空间 O(1)。
第十三题 两数相加(2)
题目:两个链表分别表示两个非负整数,数字是逆序存的(个位在头节点),返回它们的和,也用同样的方式存。
原题链接: leetcode 2 Add Two Numbers
思路。 逆序存反而省事:个位在头节点,正好从低位往高位加,和竖式加法的方向一致,一路往右走就行,不用先反转链表。
每一位做的是「两个数位相加再加上进位」:写进新节点的是和对 10 取余,新的进位是和除以 10。
c
struct ListNode* addTwoNumbers(struct ListNode* l1, struct ListNode* l2)
{
	struct ListNode guard;               //哨兵位,省掉结果头节点的特判
	guard.next = NULL;
	struct ListNode* tail = &guard;
	int carry = 0;                       //进位

	while (l1 || l2 || carry)            //三个条件,缺一不可
	{
		int sum = carry;
		if (l1) { sum += l1->val; l1 = l1->next; }
		if (l2) { sum += l2->val; l2 = l2->next; }

		carry = sum / 10;
		struct ListNode* node = (struct ListNode*)malloc(sizeof(struct ListNode));
		node->val = sum % 10;
		node->next = NULL;
		tail->next = node;
		tail = node;
	}
	return guard.next;
}
最后一次进位可能发生在两条链都走完之后。 只写 l1 || l2 就会漏掉它:9999999 加 9999 得到 10009998,最高位那个 1 是进位产生的,两条链都已经走完了,靠 carry 这个条件才把最后一位补上。实测的第三组就是这种情况。
bash
# 所属目录:/home/cocatrice/ds05
gcc -std=c99 -Wall -Wextra -g p13_add_two_numbers.c -o p13
./p13
text
输入 2->4->3->NULL + 5->6->4->NULL
输出 7->0->8->NULL

输入 0->NULL + 0->NULL
输出 0->NULL

输入 9->9->9->9->9->9->9->NULL + 9->9->9->9->NULL
输出 8->9->9->9->0->0->0->1->NULL
第一组是 342 加 465 等于 807,输出 7->0->8;第三组是 9999999 加 9999 等于 10009998,输出 8->9->9->9->0->0->0->1,最高位多出来的那个 1 就是靠 carry 条件补上的。
边界值。
- 两个都是 0:走一轮,sum 是 0,carry 是 0,输出单个 0。
- 一条链比另一条长:短的走完之后两个 if 只进一个。
- 最后一位有进位:上面第三组。
- 长度相同但结果多一位:比如 5 加 5,输出 0->1。
复杂度:时间 O(max(m,n)),实际还要多走一轮处理进位;空间 O(max(m,n)),返回的新链表。
第十四题 旋转链表(61)
题目:把链表每个节点向右移动 k 个位置。
原题链接: leetcode 61 Rotate List
思路。 和数组那一篇的轮转数组是同一件事,但链表不能按下标算地址,链表版本可以原地接成环再断开:先遍历一遍求出长度 n 并记住尾节点,把尾节点的 next 接回头节点成环,然后从新的尾节点位置断开。
新头节点是原来的第 n-k 个节点的下一个(k 先对 n 取模)。走 n-k-1 步停在新的尾节点上,把它的 next 置空,后面那段就是新的头。
c
struct ListNode* rotateRight(struct ListNode* head, int k)
{
	if (head == NULL || head->next == NULL) return head;

	int n = 1;
	struct ListNode* tail = head;
	while (tail->next)                    //求长度并找到尾节点
	{
		tail = tail->next;
		n++;
	}
	k %= n;                               //k 可能比长度大
	if (k == 0) return head;              //不用动

	tail->next = head;                    //接成环
	struct ListNode* newTail = head;
	for (int i = 0; i < n - k - 1; i++)   //走到新的尾节点
	{
		newTail = newTail->next;
	}
	struct ListNode* newHead = newTail->next;
	newTail->next = NULL;                 //断开
	return newHead;
}
k 取模之后等于 0 要直接返回。 不返回也能得到正确结果,但白白多跑一趟接环和断环;更要紧的是 k 是 n 的整数倍时,接成环之后如果不及时断开,返回的链表就是一个环。
bash
# 所属目录:/home/cocatrice/ds05
gcc -std=c99 -Wall -Wextra -g p14_rotate_list.c -o p14
./p14
text
输入 1->2->3->4->5->NULL k=2
输出 4->5->1->2->3->NULL

输入 0->1->2->NULL k=4
输出 2->0->1->NULL

输入 NULL k=1
输出 NULL
第二组的 k 是 4,比长度 3 大,取模之后等于 1,等价于右移一位,输出 2->0->1。
边界值。
- 空链表或只有一个节点:直接返回,不用处理。
- k 是长度的整数倍:取模后 k 等于 0,直接返回原链表(这也是最容易变成环的情况)。
- k 比长度大:先取模。
- k 等于 1:新头是原来的尾节点。
复杂度:时间 O(n),求长度一趟、走位一趟;空间 O(1)。
第十五题 K 个一组翻转链表(25)
题目:每 k 个节点一组翻转,不足 k 个的最后一组保持原样。
原题链接: leetcode 25 Reverse Nodes in k-Group
思路。 反转链表的加强版。多出来的麻烦有两个:动手之前要先数够 k 个节点 ,还有组与组之间要接得上。
做法是:每次从当前组的头开始往后数 k 个,数不够就结束(剩下的原样保留);够的话把这一组反转,反转完原来的头变成了尾,要接上下一组的头;再让上一组的尾指向这一组新的头。
c
struct ListNode* reverseKGroup(struct ListNode* head, int k)
{
	if (head == NULL || k <= 1) return head;

	struct ListNode guard;                 //哨兵位,统一第一组的处理
	guard.next = head;
	struct ListNode* groupPrev = &guard;   //上一组的尾

	while (1)
	{
		//先看这一组够不够 k 个
		struct ListNode* kth = groupPrev;
		for (int i = 0; i < k && kth; i++) kth = kth->next;
		if (kth == NULL) break;            //不足 k 个,剩下的不动
		struct ListNode* groupNext = kth->next;   //下一组的头

		//反转这一组:从 groupPrev->next 到 kth
		struct ListNode* pre = groupNext;
		struct ListNode* cur = groupPrev->next;
		while (cur != groupNext)
		{
			struct ListNode* next = cur->next;
			cur->next = pre;
			pre = cur;
			cur = next;
		}

		//接回去:原来的组头变成了组尾
		struct ListNode* newGroupTail = groupPrev->next;
		groupPrev->next = kth;             //上一组接这一组反转后的头
		groupPrev = newGroupTail;          //这一组的尾成为下一组的上一组
	}
	return guard.next;
}
反转的循环收尾指向 groupNext,不是 NULL ,这是和整条链表反转最大的区别:这一组的新尾节点要接上下一组的头。把 pre 初始化成 groupNext,这一步就自动完成了。
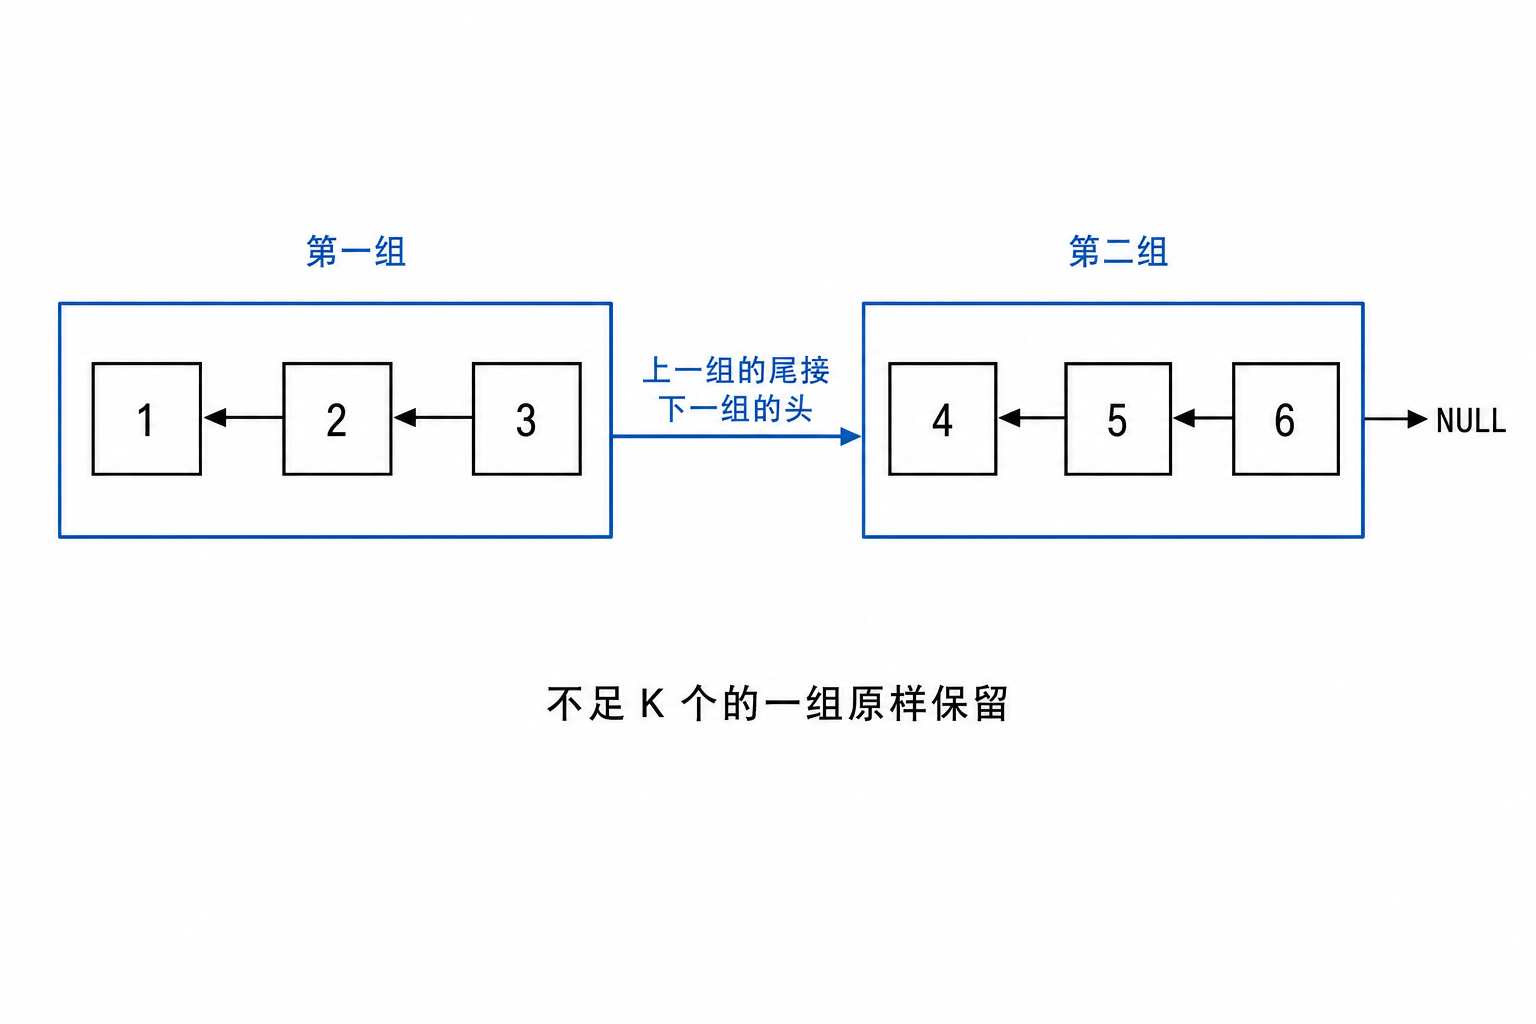
图 7 K 个一组翻转
bash
# 所属目录:/home/cocatrice/ds05
gcc -std=c99 -Wall -Wextra -g p15_reverse_k_group.c -o p15
./p15
text
输入 1->2->3->4->5->NULL k=2
输出 2->1->4->3->5->NULL

输入 1->2->3->4->5->NULL k=3
输出 3->2->1->4->5->NULL

输入 1->2->3->4->5->NULL k=5
输出 5->4->3->2->1->NULL
三组用例分别对应三种情况:k 等于 2 时最后一组不足(5 保持原样)、k 等于 3 时最后一组剩两个不足、k 等于 5 时刚好凑满一组。
text
==29845==     in use at exit: 0 bytes in 0 blocks
==29845==   total heap usage: 15 allocs, 15 frees, 240 bytes allocated
==29845== All heap blocks were freed -- no leaks are possible
==29845== ERROR SUMMARY: 0 errors from 0 contexts (suppressed: 0 from 0)
边界值。
- k 等于 1:直接返回,不用翻转。
- k 大于链表长度:第一组就不够,整个链表保持原样。
- 长度是 k 的整数倍:最后一组也能翻转。
- 空链表:直接返回 NULL。
复杂度:时间 O(n),每个节点被数一次、翻转一次;空间 O(1),翻转是原地改指针。
踩坑点
- 要删的节点可能是头节点,删除类题目先想清楚要不要加哨兵位。
- 改指针的顺序颠倒,先把前驱的 next 改掉,后面那段就找不到了。
- 释放节点之前先把它的 next 存下来,不然就是 use after free。
- 快慢指针的循环条件写成
while (fast && fast->next),少判一个都会在偶数长度的链表上解引用空指针。 - 有环的链表不能直接遍历打印,会死循环,验证的时候先判环。
- 反转链表时忘了把原头节点的 next 置空,新链表的尾部会带着一整条旧链,变成环。
- 递归写法的空间是 O(n),链表很长时会爆栈,面试里要主动说清楚。
- 相交链表不能用「比较值相等」来判断相交,要比较节点地址。
- 随机指针的深拷贝里,random 可能指向 NULL,复制的时候要单独判。
- 旋转链表的 k 要先对长度取模,k 是长度的整数倍时结果和原链表一样。
- K 个一组翻转要处理最后不足 K 个的那一组,题目要求原样保留。
- 两数相加最后可能有进位,循环结束之后还要判断一次。
- 哨兵位的作用是让「要动的节点是头节点」这种情况变成普通情况。
- 反转链表用三个指针:pre 记前驱、cur 走当前、next 存后继。
- 反转的最后一步必须让原头节点的 next 指向 NULL,否则尾端成环。
- 快慢指针找中间节点,偶数长度时返回的是靠后的那个。
- 找倒数第 k 个节点,快指针先走 k 步,然后两个一起走。
- 判断有环用快慢指针相遇;找入环点是相遇之后一个指针回到起点,两个同步走。
- 相交链表的解法是两个指针走完自己的路再走对方的,走的总长度一样。
- 回文链表要先把后半段反转再比较,比较完可以再翻回来。
- 分割链表用两条子链分别接小的和大的,最后接起来。
- 删除排序链表的重复元素,比较的是当前节点和下一个节点的值。
- 两数相加要处理最后一位进位多出来的节点。
- 随机链表的复制用「复制节点插在原节点后面」的办法,省掉一张哈希表。
- 旋转链表先把尾接到头上成环,再从正确的位置断开。
- K 个一组翻转,每组内部是反转,组之间要接好。
本篇总结(模拟面试问题)
问:反转单链表有几种写法,各自的复杂度是多少?
核心要点:迭代和递归两种。迭代用三个指针,pre、cur、next,每轮把 cur 的 next 指向 pre,然后三个一起前移,时间 O(n)、空间 O(1);递归是先把后面的部分反转好,再让下一个节点的 next 指回自己、自己的 next 置空,时间 O(n)、空间 O(n),因为递归栈有 n 层。
问:怎么找单链表的中间节点?
核心要点:快慢指针,都从头出发,慢指针每次走一步,快指针每次走两步;快指针走到尾时,慢指针正好落在中间。偶数个节点时快指针先到 NULL,这时慢指针停在后半段的第一个节点上。时间 O(n),空间 O(1)。
问:怎么判断单链表有没有环?
核心要点:快慢指针。两个指针从头出发,慢的走一步,快的走两步,如果有环,快的会在环里绕回来追上慢的;如果没环,快的先走到 NULL。时间和空间分别是 O(n) 和 O(1)。
问:删除链表节点时为什么常常先加一个哨兵位?
核心要点:因为要删的节点可能是头节点,头节点没有前驱,删除逻辑要单独写一套。加一个不存数据的哨兵位之后,原来的头节点也有了前驱,删除逻辑只剩一套,最后返回哨兵位的 next 就是新的头。多花的是一个节点的空间。
问:快慢指针为什么一定能相遇?
核心要点:有环时两个指针都会进环。快指针每次比慢指针多走一步,一旦都进了环,两者之间的距离每一轮缩小 1,而环的长度是有限的,所以距离一定会缩到 0,也就是相遇。不会出现快指针跳过慢指针的情况,因为它只多走一步。
问:入环点是怎么推出来的?
核心要点:设头到入环点的距离是 a,入环点到相遇点是 b,相遇点绕回入环点还有 c,环长 b 加 c。慢指针走了 a 加 b,快指针走了 a 加 b 再加若干个整圈,而快指针的总路程是慢指针的两倍,化简得到 a 等于 c 加上若干个环长。所以让一个指针从相遇点继续走、另一个从头开始同步走,两者一定在入环点相遇。
问:两个链表相交那道题,为什么两个指针各走一遍对方的路就能相遇?
核心要点:两个指针走的总路程都是「自己的长度加对方的长度」,所以走完这么多步之后,它们要么同时到达相交点,要么同时到达 NULL。循环写成走完自己的就跳到对方头上去重走,就是为了让两边步数相同;比较的是节点地址,不是值。
问:随机指针的深拷贝为什么可以不用哈希表?
核心要点:把每个复制出来的节点直接插在原节点的后面,这样新节点的 random 就是原节点 random 的 next,一步就能找到对应的复制节点,省掉一张记录「原节点到新节点」的哈希表。最后把两条链拆开就行。时间 O(n),空间是返回结果本身的 O(n)。
问:K 个一组翻转链表,最后一组不足 K 个怎么办?
核心要点:原样保留,不翻转。所以每组翻转之前要先数够 K 个节点,不够就结束。另外组和组之间的连接要处理好:上一组的尾要接到这一组翻转后的头上,这一组原来的头翻转变成了尾,要接下一组的头。
问:把链表 1->2->3->4->5 反转,结果是什么?
核心要点:5->4->3->2->1。迭代法三个指针走一遍就得到。
问:链表 1->2->3->4 的中间节点是哪个?
核心要点:3。长度是偶数时返回靠后的那个,快慢指针走完时快指针刚好到尾。
问:怎么在 O(1) 空间里删除链表里某个已知节点(不给头指针)?
核心要点:把下一个节点的值复制到当前节点,然后删掉下一个节点。前提是它不是尾节点。
问:下面这段反转链表的代码有什么问题?
text
ListNode* reverseList(ListNode* head)
{
    ListNode* pre = NULL;
    ListNode* cur = head;
    while (cur)
    {
        ListNode* next = cur->next;
        cur->next = pre;
        pre = cur;
        cur = next;
    }
    return pre;
}
核心要点:这段是对的。它没有把原头节点的 next 置空,但这里不需要:第一轮就把 head 的 next 改成了 NULL,原头节点就是反转后的尾节点。如果写成递归版本,就必须显式写 head->next->next = head; head->next = NULL;,少一句就会成环。
问:一个链表长度未知,怎么在只遍历一次的前提下找到倒数第 k 个节点?
核心要点:快慢指针。快指针先走 k 步,然后两个指针一起走,快指针到尾时慢指针落在倒数第 k 个位置上。空间 O(1)。
参考
- 链表通用介绍:https://oi-wiki.org/ds/linked-list/
- 反转链表的迭代与递归两种实现:https://www.geeksforgeeks.org/reverse-a-linked-list/
- 合并两个有序链表:https://leetcode.cn/problems/merge-two-sorted-lists/
- 环形链表的判断,题解里有快慢指针的严格证明:https://leetcode.cn/problems/linked-list-cycle/
- 环形链表 II,入环点的推导过程:https://leetcode.cn/problems/linked-list-cycle-ii/
- 删除排序链表中的重复元素:https://leetcode.cn/problems/remove-duplicates-from-sorted-list/
- 两数相加,模拟竖式加法的进位处理:https://leetcode.cn/problems/add-two-numbers/
- 旋转链表,接成环再断开:https://leetcode.cn/problems/rotate-list/
- K 个一组翻转链表,分组处理的典型题:https://leetcode.cn/problems/reverse-nodes-in-k-group/