文章目录
-
- 一、动态链接的性能问题
- [二、PLT 是什么](#二、PLT 是什么)
- [三、GOT 和 PLT 如何配合](#三、GOT 和 PLT 如何配合)
- 四、第一次调用动态库函数时发生什么
- 五、第二次调用为什么更快
- 六、为什么叫延迟绑定
- [七、GOT 默认指向什么](#七、GOT 默认指向什么)
- [八、用 objdump 查看 PLT](#八、用 objdump 查看 PLT)
- [九、用 readelf 查看重定位项](#九、用 readelf 查看重定位项)
- [十、用 LD_DEBUG 观察绑定过程](#十、用 LD_DEBUG 观察绑定过程)
- 十一、LD_BIND_NOW:关闭延迟绑定
- 十二、延迟绑定的优缺点
- [十三、GOT、PLT、PIC 三者关系](#十三、GOT、PLT、PIC 三者关系)
- 十四、为什么这对理解动态库很重要
- 十五、总结
上一篇我们讲了 GOT 和 PIC。GOT 让动态链接器可以把运行时确定的函数地址、变量地址填到一张可写表中,代码通过查表完成访问。
但还有一个性能问题:如果程序启动时就把所有动态库函数的真实地址都解析好,会不会太慢?毕竟一个程序依赖的动态库可能很多,库里的函数更多,其中很多函数可能整个运行期间都不会被调用。
为了解决这个问题,动态链接引入了 PLT 和延迟绑定。
一、动态链接的性能问题
动态链接把一部分链接工作推迟到了程序加载和运行阶段。
这带来了灵活性:
text
可执行文件更小
动态库可以共享
库可以独立升级
但也带来成本:
text
程序启动时需要加载库
需要解析符号
需要做重定位
如果启动时把所有外部函数地址都解析完,程序启动可能变慢。
例如一个程序链接了 libc,但它不一定会调用 libc 中的所有函数。提前解析所有函数没有必要。
所以更合理的思路是:
text
函数真正第一次被调用时,再解析它的真实地址。这就是延迟绑定。
二、PLT 是什么
PLT 是 Procedure Linkage Table,过程链接表。
它可以理解为动态函数调用的"中转站"或"跳板"。
当程序调用外部动态库函数时,往往不是直接跳到真实函数地址,而是先跳到对应的 PLT 项。
例如反汇编时经常看到:
text
call puts@plt
call printf@plt
这里的 puts@plt、printf@plt 就是 PLT 中的入口。
三、GOT 和 PLT 如何配合
GOT 保存运行时地址,PLT 负责调用过程中的跳转和第一次解析。
可以先用一句话理解:
text
GOT 负责存地址;PLT 负责第一次调用时去解析地址。更具体一点:
text
第一次调用函数:
call 函数@plt
-> PLT 发现 GOT 里还不是最终函数地址
-> 跳到动态链接器的解析逻辑
-> 动态链接器找到真实函数地址
-> 更新 GOT 表项
-> 跳转到真实函数

第二次调用函数:
call 函数@plt
-> PLT 通过 GOT 直接跳到真实函数
这就是延迟绑定的核心。
四、第一次调用动态库函数时发生什么
假设程序调用 printf。
第一次调用:
c
printf("hello\n");底层大致流程:
text
1. 程序执行 call printf@plt
2. 进入 printf 对应的 PLT 项
3. PLT 通过 GOT 表项发现还没有绑定真实 printf 地址
4. 跳到动态链接器的符号解析逻辑
5. 动态链接器在 libc.so 中找到 printf 的真实地址
6. 动态链接器把真实地址写入 GOT 表项
7. 跳转到 libc.so 中的 printf 执行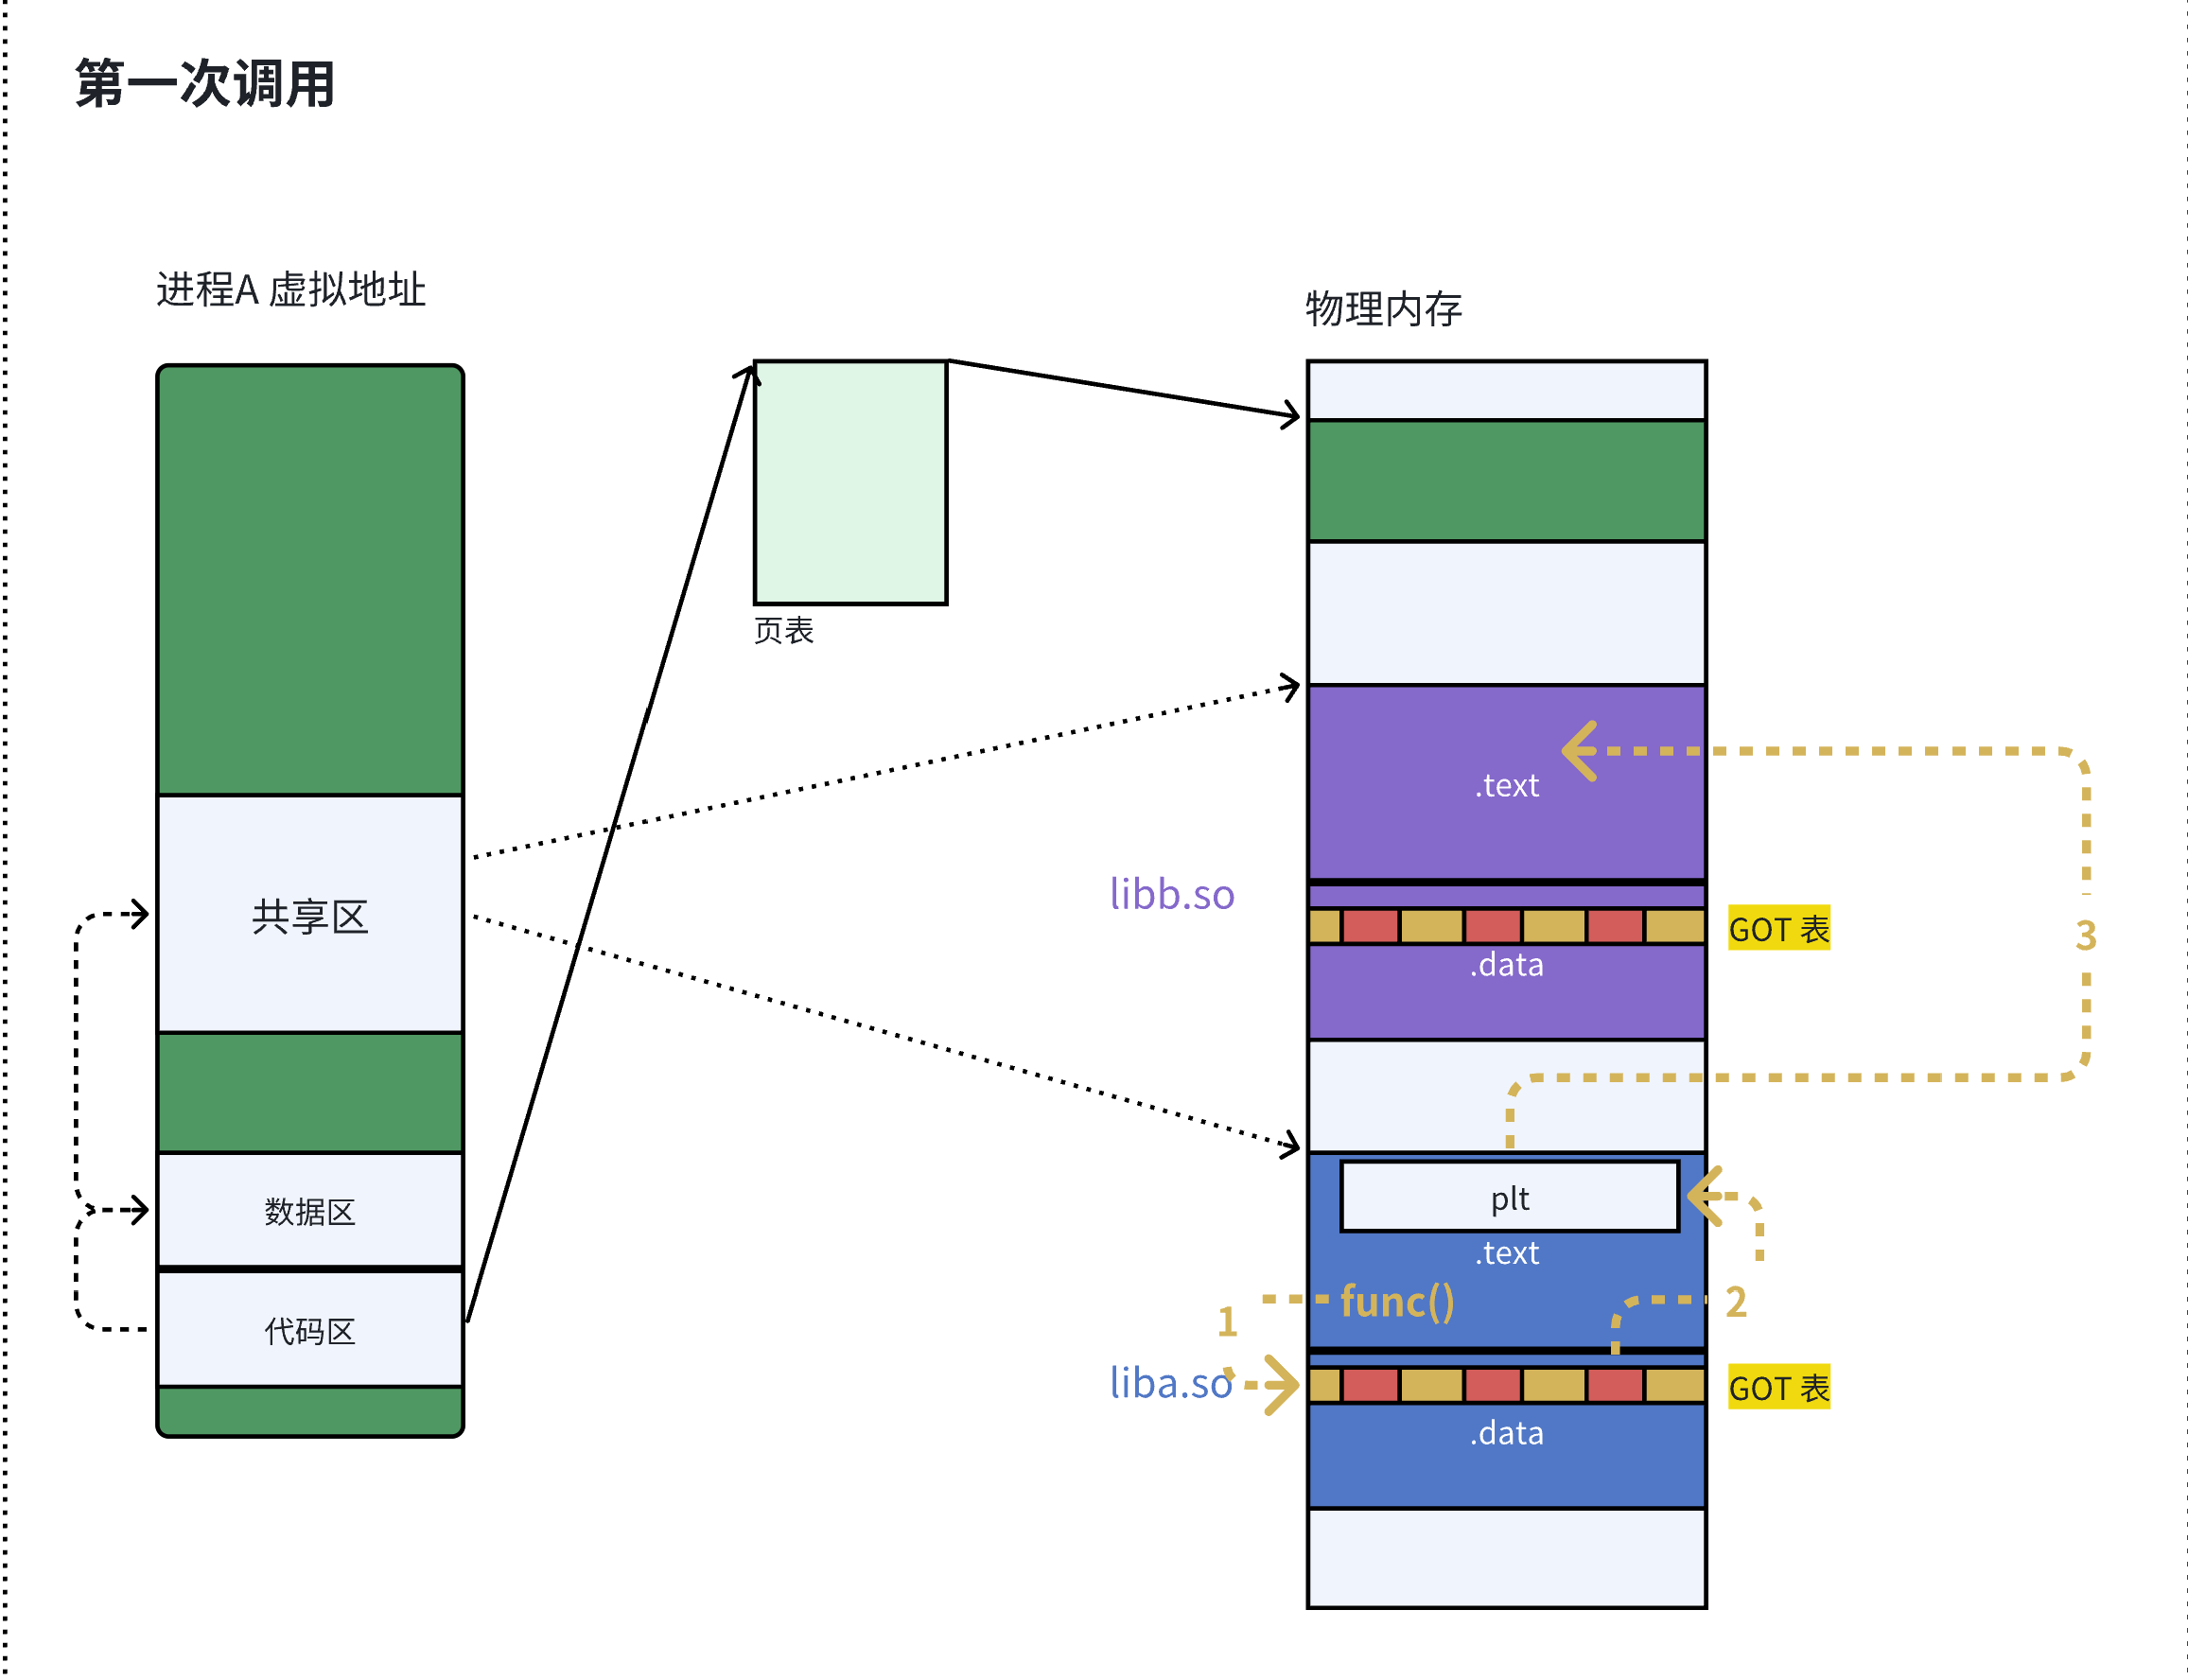
这一步完成后,GOT 中已经保存了 printf 的真实地址。
五、第二次调用为什么更快
第二次再调用:
c
printf("world\n");流程就简化了:
text
1. 程序执行 call printf@plt
2. PLT 通过 GOT 表项直接拿到 printf 真实地址
3. 直接跳转到 libc.so 中的 printf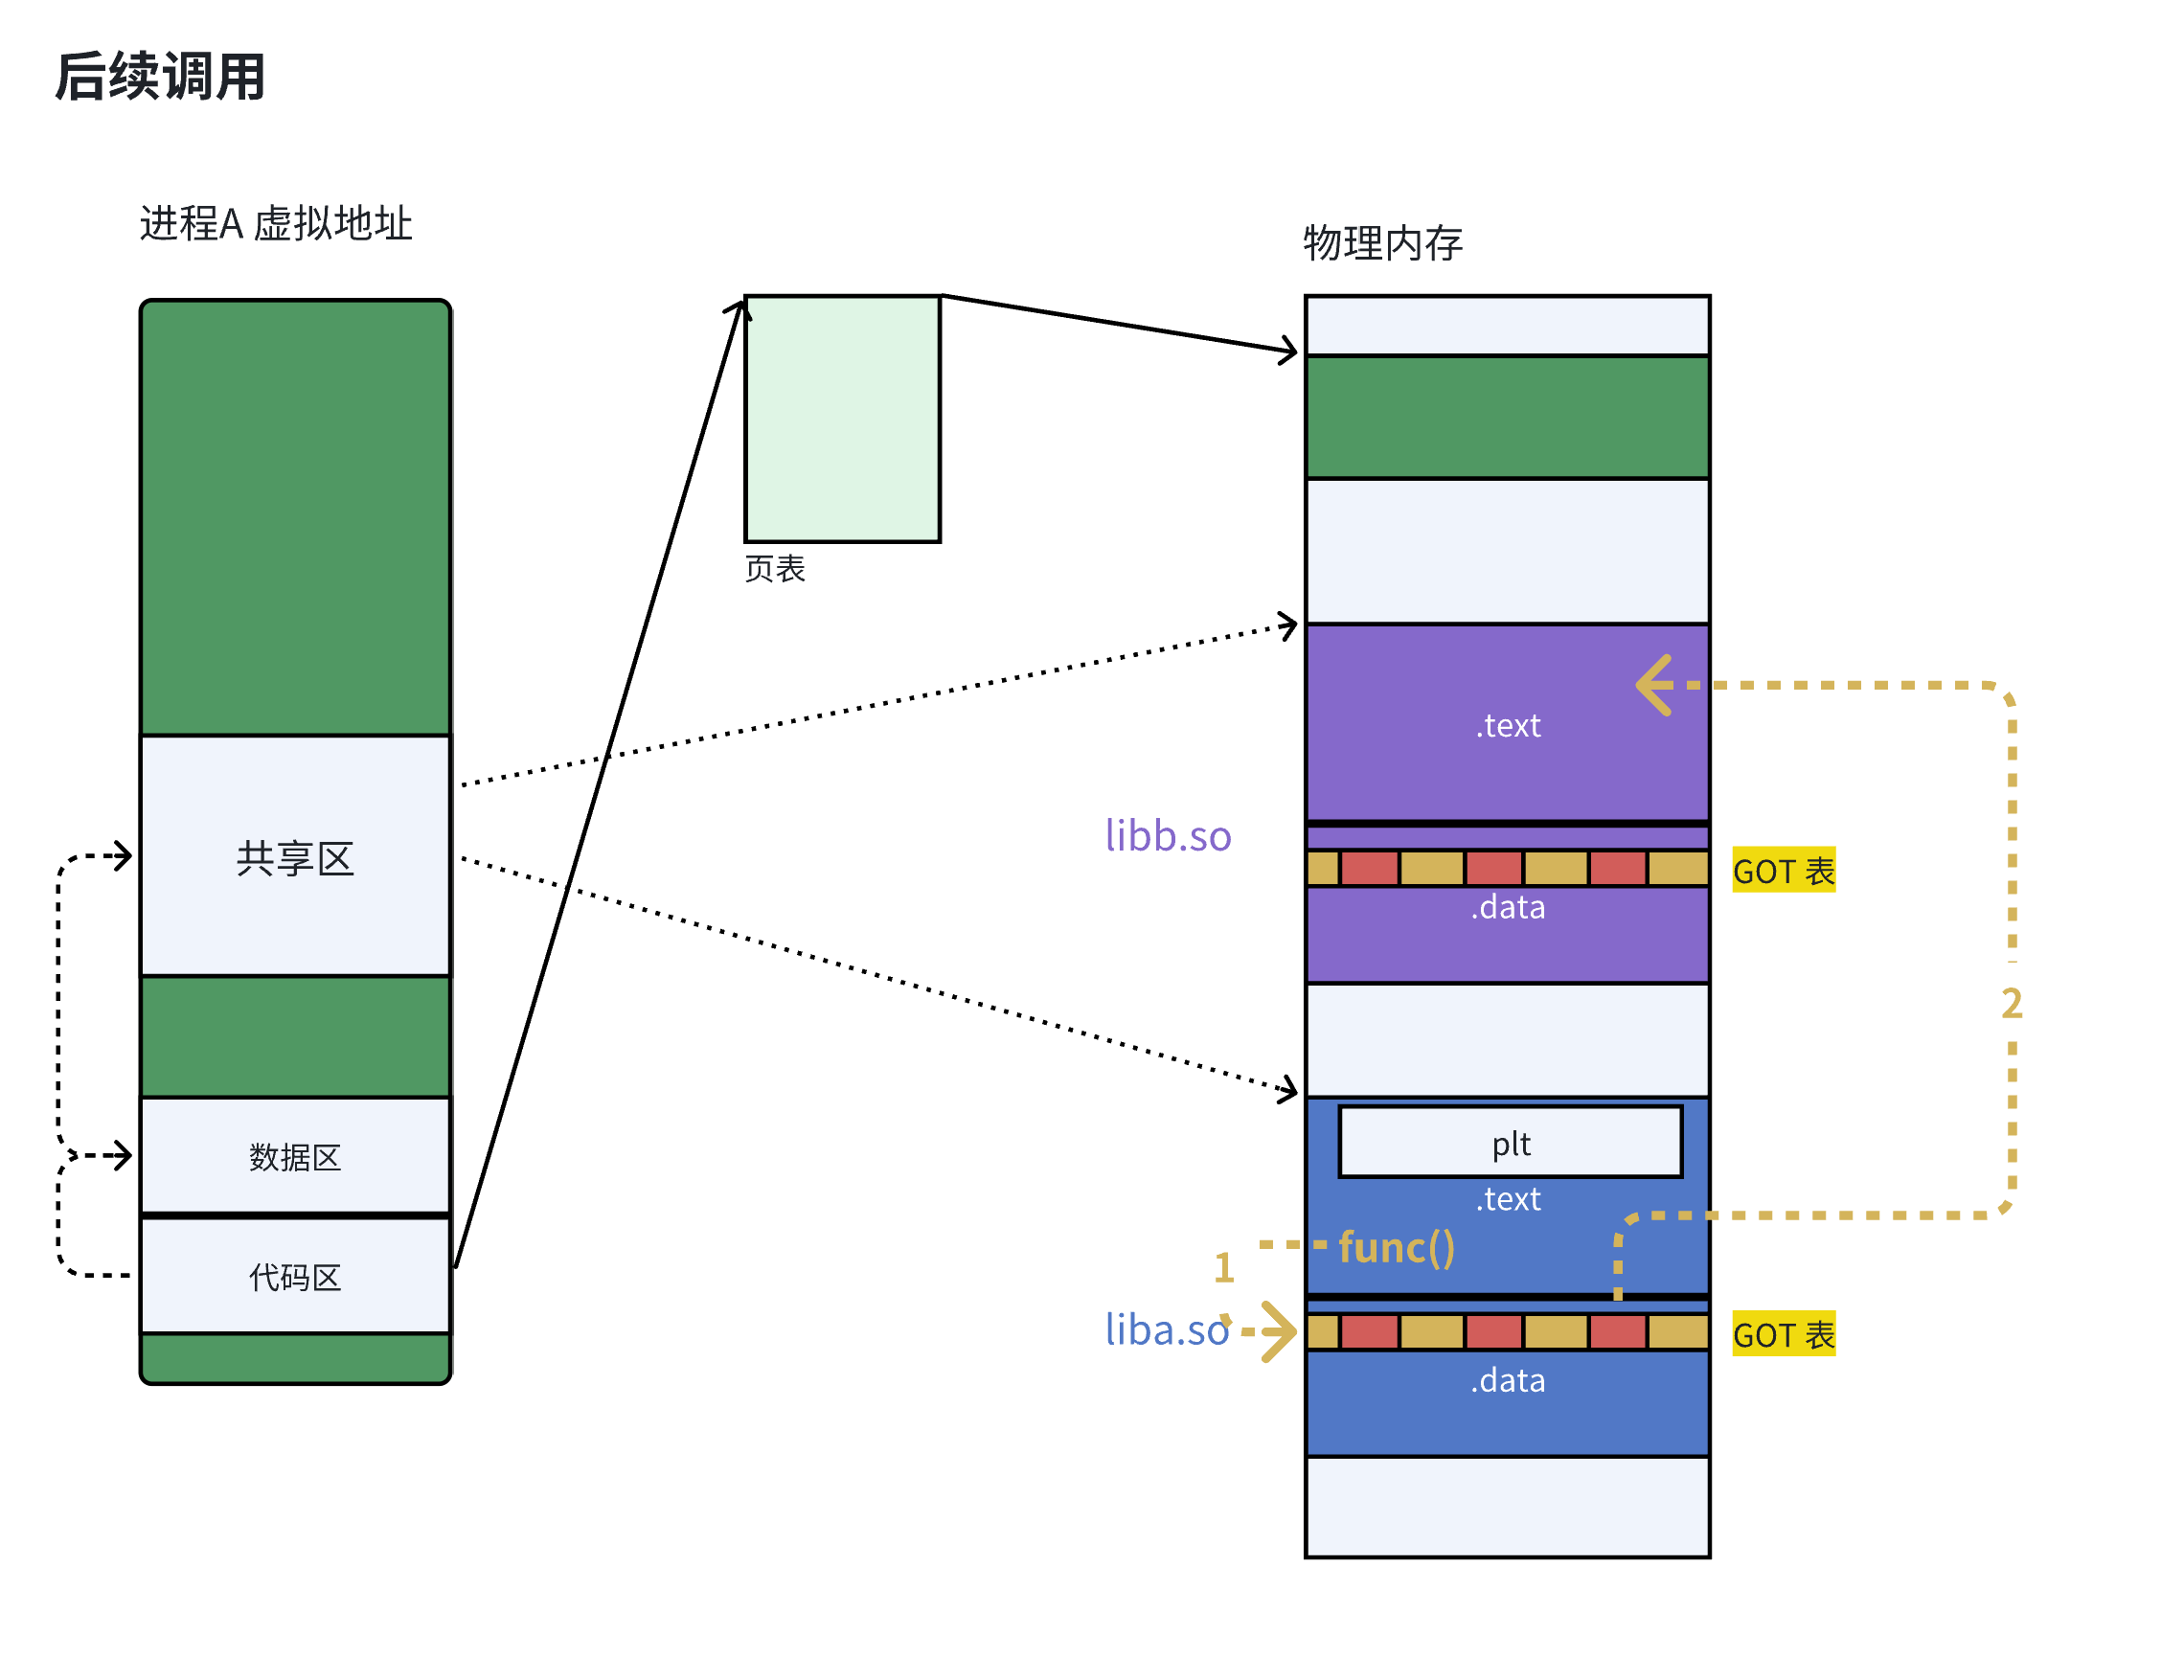
不需要再次让动态链接器解析符号。
所以延迟绑定的优势是:
text
没有调用过的函数不解析;
调用过的函数只在第一次付出解析成本。
六、为什么叫延迟绑定
绑定可以理解为:
text
把一个符号引用和它的真实函数地址建立关系。普通立即绑定:
text
程序启动时绑定所有需要的函数延迟绑定:
text
函数第一次被调用时才绑定所以它叫 lazy binding,也就是延迟绑定。
七、GOT 默认指向什么
在延迟绑定机制下,程序刚启动时,某些 GOT 表项里并不是最终函数地址,而是指向一段辅助解析代码。
这段辅助代码有时也被称为桩代码。
第一次调用函数时,流程会绕到这段代码,再进入动态链接器解析符号。
解析完成后,动态链接器会把 GOT 表项改成真实函数地址。
因此 GOT 表项的内容会发生变化:
text
第一次调用前:指向解析辅助逻辑
第一次调用后:指向真实函数地址
这就是为什么 GOT 必须位于可写区域。
八、用 objdump 查看 PLT
可以反汇编程序:
bash
objdump -d main | grep -A10 "@plt"可能看到:
text
0000000000001030 <puts@plt>:
   ...
或者:
text
callq puts@plt这些就是动态库函数调用的 PLT 入口。
不需要一开始完全看懂每条汇编,但要抓住:
text
外部函数调用先进入 xxx@plt,而不是直接写死真实地址。九、用 readelf 查看重定位项
可以查看动态重定位信息:
bash
readelf -r main你可能看到和 PLT/GOT 相关的重定位项,例如:
text
R_X86_64_JUMP_SLOT这类重定位项通常和函数调用的延迟绑定有关。
动态链接器会根据这些重定位信息,知道哪些 GOT 表项需要在运行时处理。
十、用 LD_DEBUG 观察绑定过程
LD_DEBUG 可以让动态链接器输出调试信息。
例如:
bash
LD_DEBUG=libs,bindings ./main可能会输出大量库加载和符号绑定信息。
学习时可以重点观察:
text
加载了哪些库
查找了哪些符号
绑定了哪些函数
输出可能比较多,可以配合:
bash
LD_DEBUG=bindings ./main 2>&1 | grep printf不同系统输出略有差异,但能帮助你直观看到动态链接器确实在运行时参与符号解析。
十一、LD_BIND_NOW:关闭延迟绑定
如果希望程序启动时就完成所有动态符号绑定,可以设置:
bash
LD_BIND_NOW=1 ./main这会让动态链接器倾向于立即绑定,而不是等第一次调用再解析。
这在某些调试、安全或性能分析场景中有用。
也可以在链接时使用相关选项控制绑定策略,但初学阶段知道 LD_BIND_NOW 即可。
十二、延迟绑定的优缺点
优点:
- 降低程序启动时的符号解析成本。
- 没用到的函数不必解析。
- 大型程序和大型动态库中收益明显。
缺点:
- 第一次调用某个函数时会多一次解析开销。
- 调试动态链接问题时链路更复杂。
- 某些安全机制需要额外处理 GOT/PLT 可写带来的风险。
真实系统中,还会涉及 RELRO、符号劫持、ASLR 等安全机制。本文先不展开,后续可作为拓展内容。
十三、GOT、PLT、PIC 三者关系
现在可以把三个概念放在一起:
text
PIC:让代码不依赖固定加载地址
GOT:保存运行时需要修正的真实地址
PLT:外部函数调用的跳板,支持第一次调用时解析
动态库能工作,依赖的是一整套机制,而不是单独某个概念。
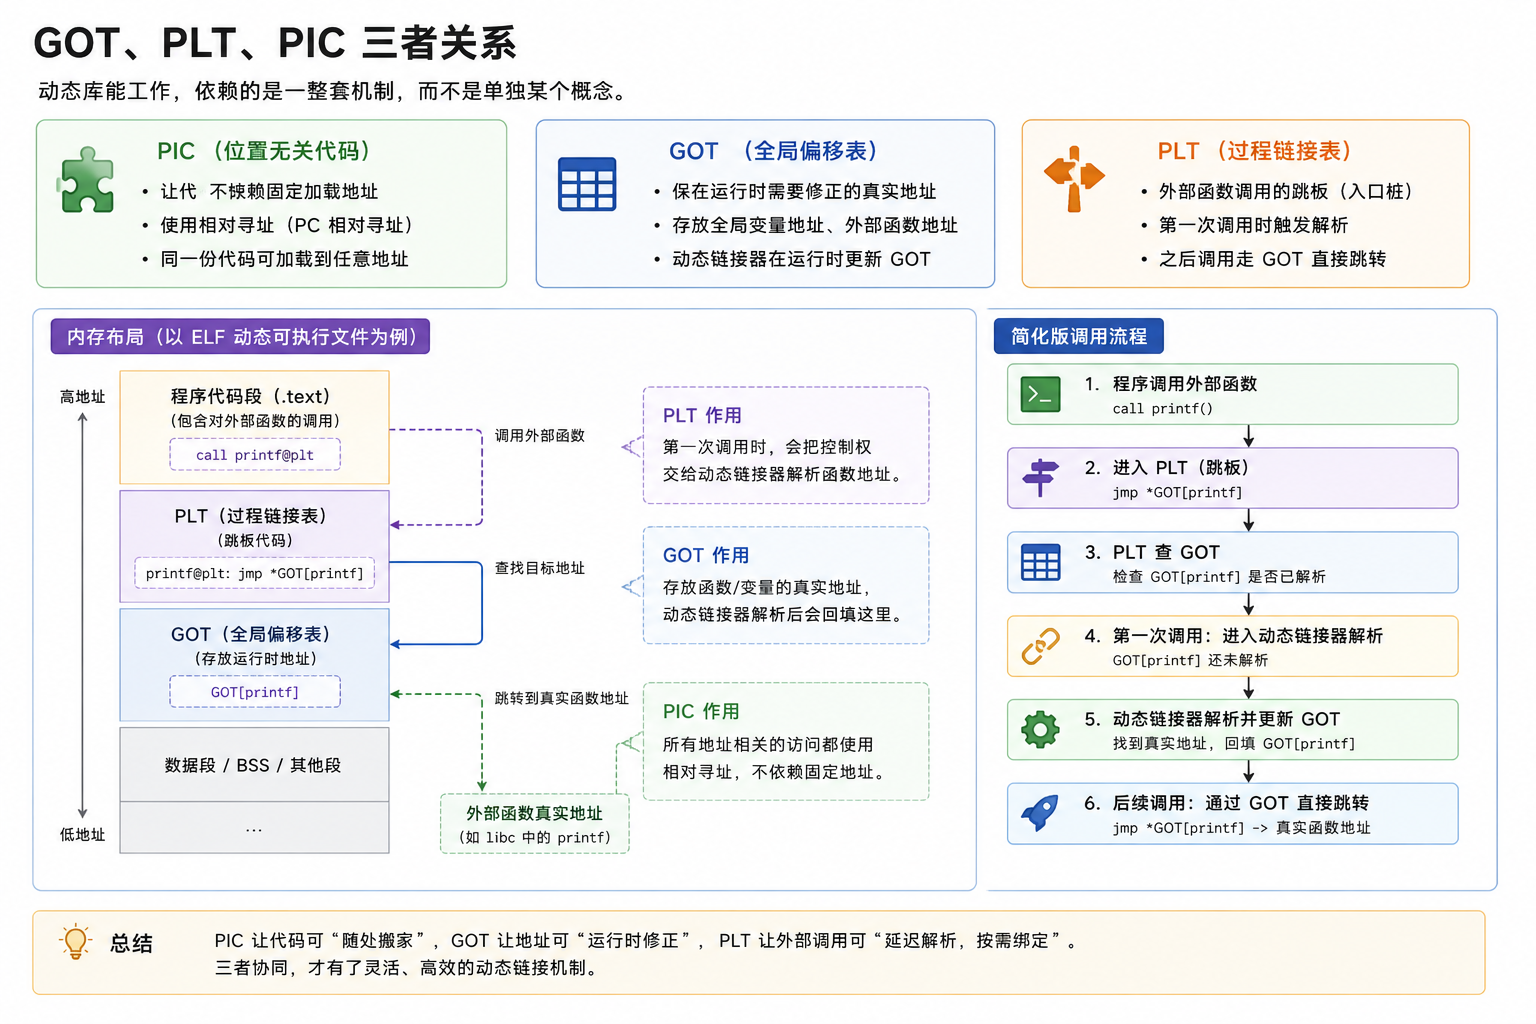
简化版调用流程:
text
程序调用外部函数
-> 进入 PLT
-> PLT 查 GOT
-> 第一次调用时进入动态链接器解析
-> 动态链接器更新 GOT
-> 后续调用通过 GOT 直接跳转真实函数
十四、为什么这对理解动态库很重要
前面制作动态库时,我们只是记住:
bash
gcc -fPIC -c xxx.c
gcc -shared -o libxxx.so xxx.o
现在我们知道背后的原因:
text
-fPIC 是为了让动态库适应不同加载地址;
GOT 是为了把可变地址放到可写表中;
PLT 是为了让函数调用可以延迟解析;
动态链接器负责在运行时填表和绑定。
这就把"命令怎么写"和"系统为什么需要这样做"连起来了。
十五、总结
PLT 和延迟绑定解决的是动态链接的性能问题。
如果启动时解析所有动态库函数,开销可能很大;延迟绑定把解析推迟到函数第一次调用时。第一次调用通过 PLT 进入动态链接器,解析真实地址后更新 GOT;后续调用直接通过 GOT 跳转。
到这里,我们已经从库的制作使用,一路讲到了 ELF、重定位、动态库映射、GOT/PIC、PLT。下一篇作为主线收束,把这些知识落到真实工程:如何组织库工程、如何发布、如何排查常见错误。