一、问题背景
我的项目是一个餐饮外卖平台,用户端有一个「按分类查菜品」的接口。用户点进分类页,就会调这个接口,返回该分类下的菜品列表,每个菜品还带口味信息。
一开始没做缓存,接口每次都查数据库。本地压测用 JMeter 模拟 100 并发、每个线程循环 100 次,总请求 10000 次。结果 P99 响应时间 33ms,平均 12ms。 这个数字看着不高,但我看了一次 MyBatis 的 SQL 日志,发现 100 个请求执行了 502 次 SQL。这明显有问题。
二、问题出在哪:N+1
把日志拆开看:
| SQL 类型 | 次数 |
|---|---|
select * from dish |
100 |
select ... from dish_flavor where dish_id = ? |
400 |
| 其他 | 2 |
| 合计 | 502 |
每个分类下有 4 个菜品。100 个请求,每个请求先查一次菜品列表(100 次),然后对列表里的每个菜品单独查一次口味(100 × 4 = 400 次)。
这就是典型的 N+1 问题:一次查询拿到列表,然后对列表里每一条数据再发一次查询。
N+1 本身可以通过 SQL 的 join 优化掉,但对于读多写少的菜品数据,更好的方案是加缓存------把整个列表缓存起来,后续请求直接读缓存,一次 SQL 都不用。
三、第一版:加 Redis 缓存
思路很简单:查询时先查 Redis,命中直接返回;未命中就查库,把结果写进 Redis。
java
ini
String key = "dish_" + categoryId;

// 1. 查缓存
Object cached = redisTemplate.opsForValue().get(key);
if (cached != null) {
    return (List<DishVO>) cached;
}

// 2. 未命中,查库
List<DishVO> list = dishMapper.listWithFlavor(dish);

// 3. 写缓存
redisTemplate.opsForValue().set(key, list);
return list;
缓存 key 按分类维度设计,dish_{categoryId}。同一个分类下的所有菜品作为一个整体缓存,粒度合适------既不会太大(不会把全部分类塞一个 key),也不会太碎(不用给每个菜品单独缓存)。
改完压测,SQL 从 502 次降到了个位数。但我没有就此停下,因为这一版有两个明显的问题。
四、第二版:TTL 随机化 + 空值缓存
1. TTL 随机化,防雪崩
第一版代码里 set(key, list) 没设过期时间,缓存永久有效。这有两个问题:
- 如果删除缓存的逻辑漏了某次更新,脏数据会一直存在
- Redis 内存只增不减
所以必须加 TTL。但如果所有缓存都设固定的 30 分钟过期,就会出现另一个问题:某一时刻大量 key 同时失效,请求全部打到数据库------这就是缓存雪崩。
解决方案是让 TTL 随机化:
java
ini
long ttl = BASE_TTL + ThreadLocalRandom.current().nextInt(-5, 6);
redisTemplate.opsForValue().set(key, list, ttl, TimeUnit.MINUTES);
基础 30 分钟,加减 0~5 分钟随机。这样过期时间被打散在 25-35 分钟之间,不会同一时刻集体失效。
2. 空值缓存,防穿透
如果用户查一个不存在的分类 ID,数据库返回空列表,这个空结果如果不写缓存,下次同样的请求还会打到数据库。如果攻击者用脚本反复请求大量不存在的 ID,数据库会被打崩------这就是缓存穿透。
解决方案是给空结果也写缓存,用一个特殊标记:
java
kotlin
if (list == null || list.isEmpty()) {
    redisTemplate.opsForValue().set(key, "__NULL__", 2, TimeUnit.MINUTES);
    return Collections.emptyList();
}
查询时先判断这个标记:
java
csharp
if ("__NULL__".equals(cached)) {
    return Collections.emptyList();
}
为什么用 __NULL__ 字符串,不直接写空列表?
因为空列表在 Java 里 cached != null 是 true,但 size() == 0。如果写空列表,判断逻辑容易搞混------到底是因为「缓存没命中」还是「命中了空结果」。写一个明确的字符串标记,"__NULL__".equals(cached) 判断清晰。
为什么空值缓存的 TTL 只有 2 分钟?
如果设太长,数据库后来真的插入了这条数据,缓存里的空值会导致短期内数据不可见。2 分钟是权衡后的经验值,既能挡住穿透攻击,又不会让数据长时间不一致。
五、第三版:缓存一致性
1. 更新时删除缓存,不更新缓存
菜品数据变更时,需要处理缓存。有两个选择:更新缓存、删除缓存。
我选了删除缓存。原因是并发场景下更新缓存有风险:两个线程同时更新,A 先写库再写缓存,B 后写库再写缓存,但 B 的缓存可能先落地,导致缓存里是 A 的旧数据。
删除缓存更安全:下次查询会重新从 DB 加载,不会出现「旧数据覆盖新数据」的问题。配合「先更新 DB 再删缓存」的顺序,能覆盖绝大多数场景。
2. 精确删除,不用 keys
项目原版是这么删缓存的:
java
ini
Set keys = redisTemplate.keys("dish_*");
redisTemplate.delete(keys);
这有两个问题:
keys是 O(N) 命令,会遍历 Redis 所有 key,key 数量大时阻塞 Redis 主线程- 一次更新把所有分类的缓存全删了,命中率骤降,下次所有分类的请求都会打到数据库
我改成了精确删除:
java
typescript
private void cleanCache(Long categoryId) {
    if (categoryId == null) {
        return;
    }
    redisTemplate.delete("dish_" + categoryId);
}
新增、修改、删除菜品时,只删对应分类的缓存。如果菜品的分类变了,新旧分类的缓存都删。
批量删除菜品时,先收集这些菜品涉及的所有分类 ID,然后逐个删。因为删除前本来就查了菜品列表(用来校验状态和套餐关联),分类 ID 直接从查询结果里取,不额外查 SQL。
六、第四版:分层改进
改到这里我发现一个问题:缓存逻辑写在 Controller 里。
java
typescript
@GetMapping("/list")
public Result<List<DishVO>> list(Long categoryId) {
    // 缓存逻辑在 Controller
    String key = "dish_" + categoryId;
    Object cached = redisTemplate.opsForValue().get(key);
    // ...
}
这违反了分层原则。Controller 的职责是接收请求、返回响应,业务逻辑应该在 Service 层。缓存读写是业务逻辑的一部分,写在 Controller 里有两个问题:
- 换个调用入口,缓存逻辑要复制一遍
- 单元测试没法单独测 Service 的缓存逻辑
我把缓存逻辑全部挪到 Service 层,Controller 只负责接收请求:
java
ini
@GetMapping("/list")
public Result<List<DishVO>> list(Long categoryId) {
    Dish dish = new Dish();
    dish.setCategoryId(categoryId);
    dish.setStatus(StatusConstant.ENABLE);

    List<DishVO> list = dishService.listWithFlavor(dish);
    return Result.success(list);
}
缓存读写全在 DishServiceImpl.listWithFlavor 里。
七、压测数据
压测环境:本机 Windows,MySQL 本地,Redis 本地单机。JMeter 100 线程 × 100 循环 = 10000 请求。
| 指标 | 无缓存 | 有缓存 | 优化幅度 |
|---|---|---|---|
| P99 响应时间 | 33 ms | 4 ms | ↓ 88% |
| 平均响应时间 | 12 ms | 1 ms | ↓ 92% |
| 总 SELECT 次数 | 501 | 5 | ↓ 99% |
| dish 查询 | 100 | 1 | ↓ 99% |
| dish_flavor 查询 | 400 | 4 | ↓ 99% |
无缓存前: 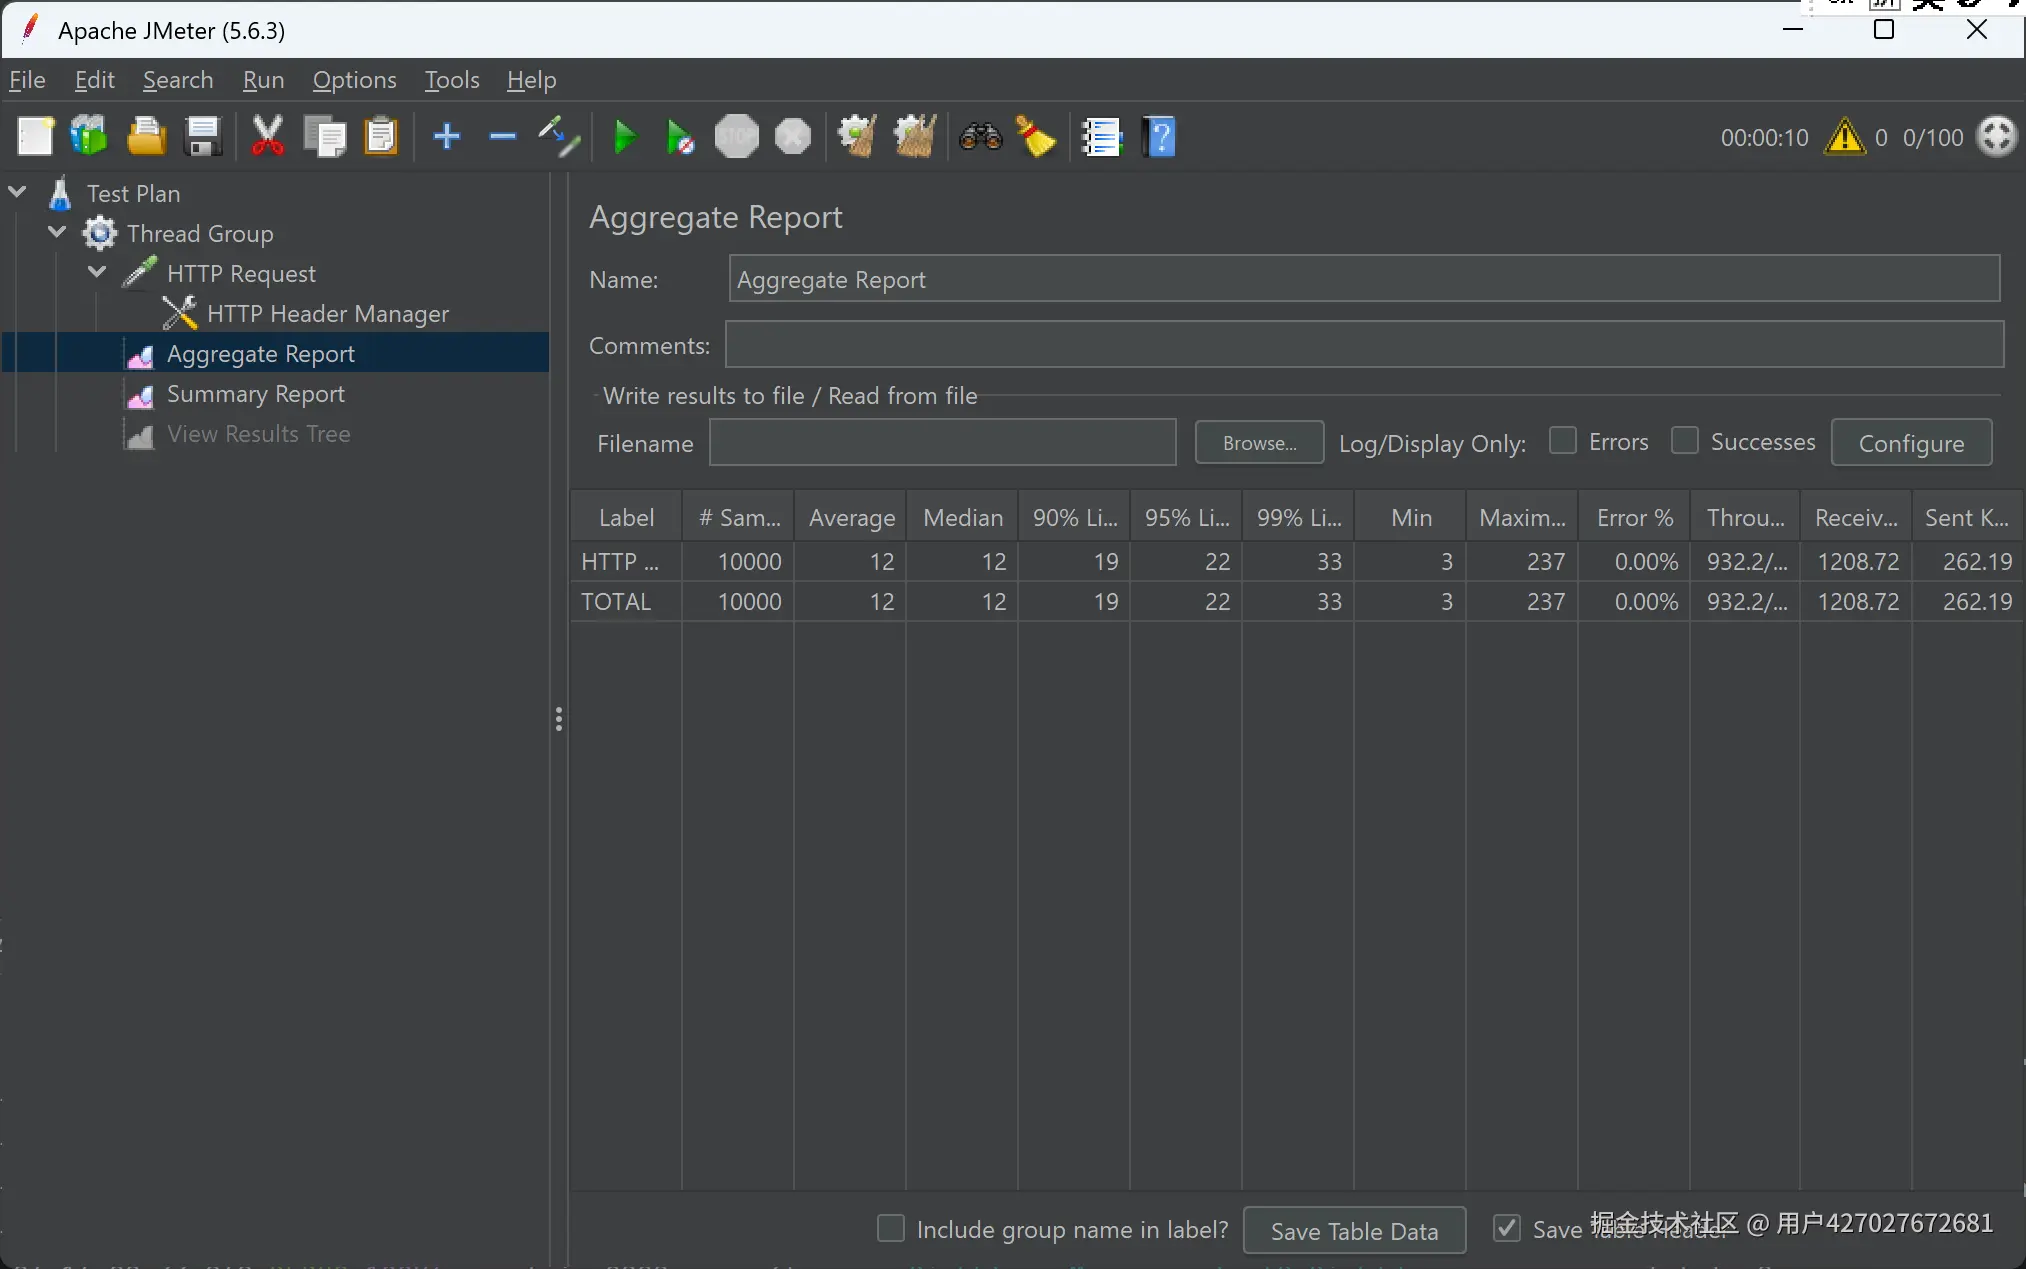
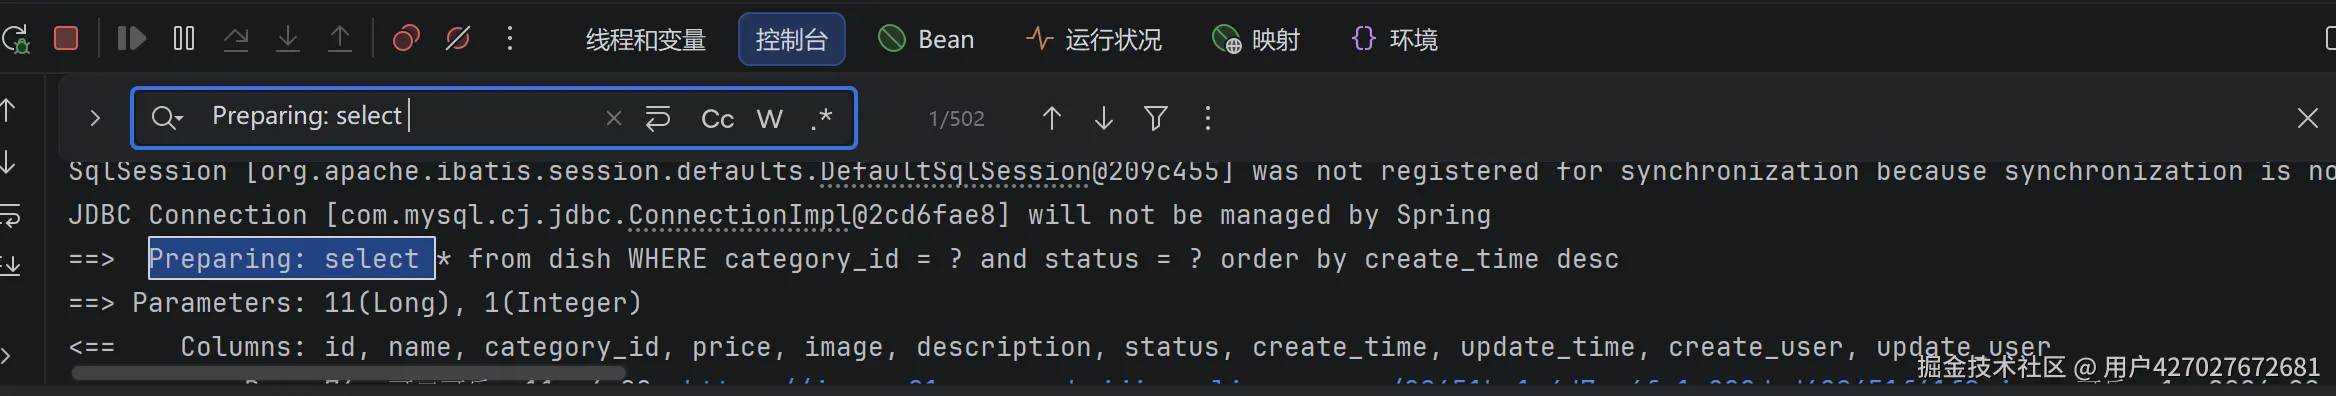
有缓存后: 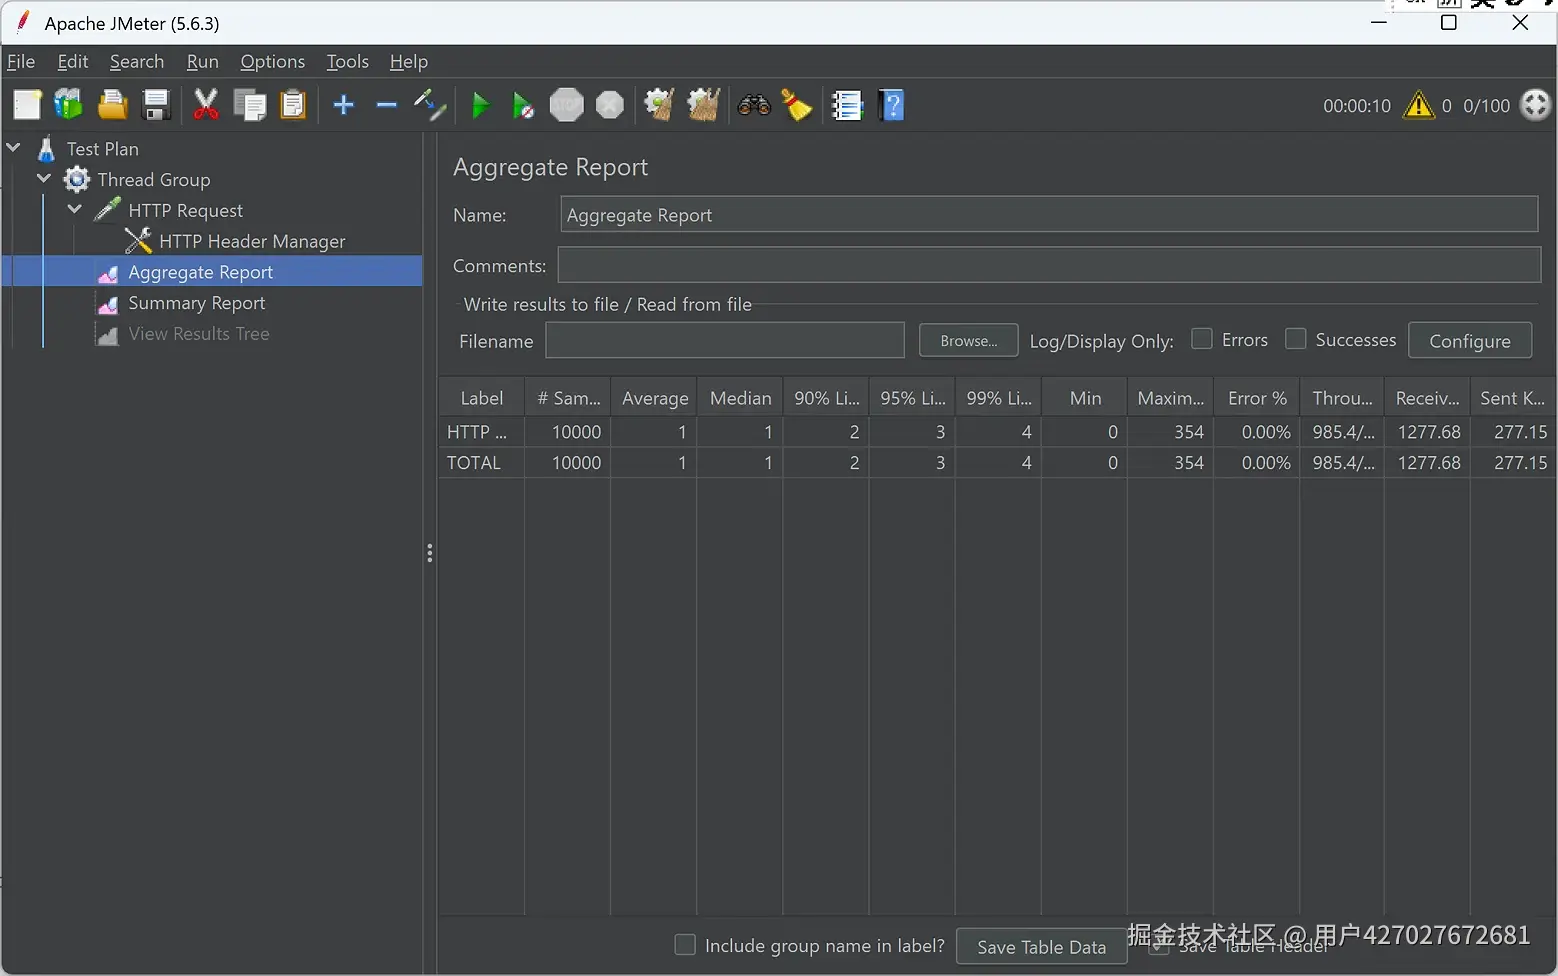
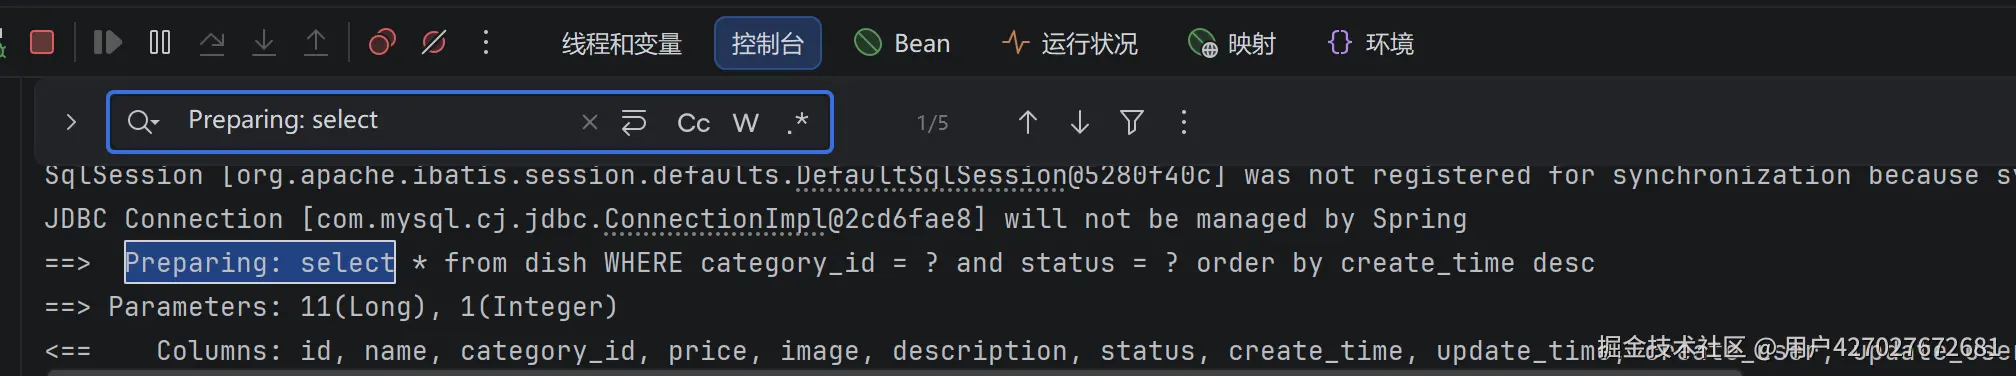 SQL 次数为什么从 502 降到 5?
100 个请求,压测前清空了 Redis。第一个请求未命中缓存,查库并写缓存(1 次 dish 查询 + 4 次 dish_flavor 查询 = 5 次)。后面 99 个请求全部命中缓存,0 次 SQL。所以总数是 5。
如果不清空 Redis,压测前就预热好缓存,那 100 个请求的 SQL 次数应该是 0。
为什么 QPS 没有明显提升?
我压测时 QPS 从 932 涨到 985,只涨了 5.7%。原因是 JMeter 单机在本机跑,发送请求的能力本身就有限,大概就在 1000 QPS 左右,压测工具成了瓶颈。后端处理变快了,但工具发不了更多请求。
如果要测出更大的 QPS 差距,需要用分布式压测或者换更高性能的压测工具(比如 wrk)。但 P99 和平均响应时间的对比已经足够说明问题了。
八、总结与取舍
核心结论:
- 缓存能大幅降低数据库查询量和响应时间。这次优化把 SQL 从 502 次降到 5 次,P99 从 33ms 降到 4ms。
- 但缓存引入了新问题:雪崩、穿透、一致性。每个问题都有对应的解决方案。
- TTL 随机化防雪崩、空值缓存防穿透、精确删除保证一致性,是三个基础但有效的实践。
生产环境还有一些要补充的:
- 单机 Redis 不够,生产要做主从 + 哨兵或 Cluster
- 删除缓存如果失败,应该有重试或补偿机制
- 极端并发下,删除缓存和写缓存之间有窗口,可以加延迟双删(删缓存后延迟几百毫秒再删一次)
- 空值缓存只能挡住同一个 key 的重复穿透,如果攻击者用大量不同的不存在的 key 攻击,需要用布隆过滤器在入口层拦截
这次优化的过程让我理解了缓存不是「加上去就行」,而是要处理它带来的一系列问题。每个方案都有边界,知道边界在哪里,才能在实际场景里做取舍。