文章目录
- 一、前言
- 二、思路
- 三、canal使用前,mysql配置
- 四、详细介绍Kafka模式
- 五、简单介绍TCP模式
-
- (1)启动tcp模式
- [(2)spring boot程序编写](#(2)spring boot程序编写)
一、前言
最近有一个项目,存在着从Mysql数据库同步到oracle数据库。我有不希望在主程序上编写。因此希望用同步工具。后来发现canal可以实现以上目标
canal 分为 canal‑server(抓取 MySQL binlog)、canal‑adapter(可选,同步数据库),但是因为我的数据库表结构不一样,因此本次项目只用到canal-server。
二、思路
canal-server通过抓取binlog实现文件的解析,有两种模式:
- TCP模式:该模式提供11111端口,用Spring boot编写canal-client,实现自定义处理数据
- Kafka模式:把数据直接推送到kafka中,然后其他程序用springboot消费kafka
我选择用第二种模式。这样7天的kafka数据还起到了增量备份的作用。
三、canal使用前,mysql配置
- (1) mysql必须开启日志,并且日志是row类型,添加以下两行。
ini
[mysqld]
binlog-format=ROW            # 必须行模式
binlog-row-image=FULL # 必须FULL,update要有before镜像,delete要有完整行- (2) 新建一个用户,有replication client权限
sql
CREATE USER canal@'%' IDENTIFIED BY 'Canal@123456';
GRANT SELECT, REPLICATION SLAVE, REPLICATION CLIENT ON *.* TO canal@'%';
FLUSH PRIVILEGES;
四、详细介绍Kafka模式
(1)启动kafka模式
bash
docker run -d \
--name canal-server-kafka \
-p 11111:11111 \
-e canal.serverMode=kafka \
-e kafka.bootstrap.servers=192.168.1.200:9092 \
-e canal.mq.topic=canal-bus-topic \
-e canal.mq.partition=0 \
-e canal.instance.master.address=192.168.1.100:3306 \
-e canal.instance.dbUsername=canal \
-e canal.instance.dbPassword=Canal@123456 \
-e canal.instance.filter.regex=bus_db\\.bus_info_.* \
-e canal.instance.gtidon=true \
canal/canal-server:v1.1.7- 此时 TCP 端口 11111 虽然映射,但是
serverMode=kafka,TCP 客户端不能连接消费,全部消息输出 Kafka - 这时候去看kafka的topic,发现已经有了canal-bus-topic
(2)持久化点位(重要)
默认 docker 容器位点 meta.dat 存在容器内部,容器删除位点丢失,会重新从头消费 binlog。
生产必须挂载配置目录到宿主机,持久化 instance 位点文件 。
canal 容器内部配置目录:/home/admin/canal-server/conf
- (2.1)把容器中的配置copy出来
bash
# 先启动临时容器,把conf拷贝出来
docker run --rm --name temp-canal canal/canal-server:v1.1.7  true
docker cp temp-canal:/home/admin/canal-server/conf /opt/canal-docker/- (2.2) 带挂载启动
bash
docker run -d \
--name canal-server-persist \
-p 11111:11111 \
-v /opt/canal-docker/conf:/home/admin/canal-server/conf \
-e canal.serverMode=kafka \
-e kafka.bootstrap.servers=192.168.1.200:9092 \
-e canal.mq.topic=canal-bus-topic \
canal/canal-server:v1.1.7
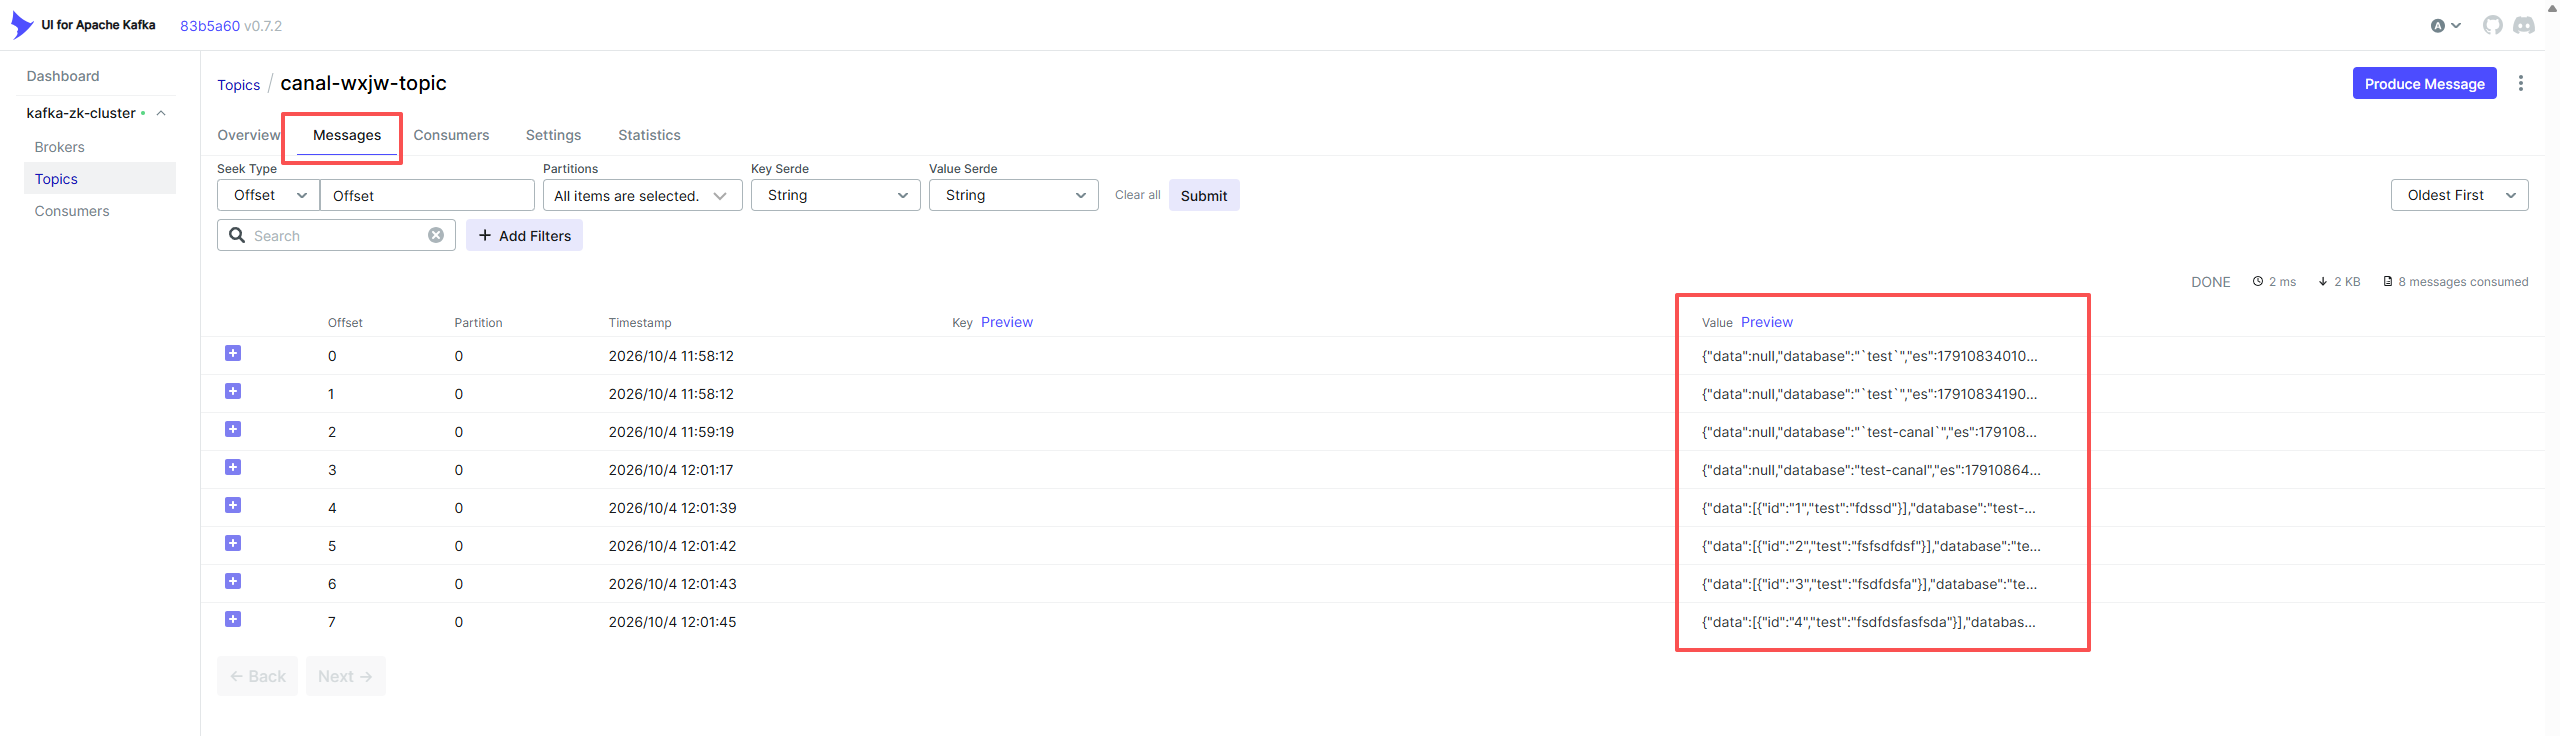
随便到数据库里面操作一下,看看kafka里是不是有数据
五、简单介绍TCP模式
本文的重点是kafka模式。这里稍微带过一下TCP模式
(1)启动tcp模式
bash
docker run -d \
--name canal-server \
-p 11111:11111 \
-e canal.serverMode=tcp \
-e canal.instance.master.address=192.168.1.100:3306 \
-e canal.instance.dbUsername=canal \
-e canal.instance.dbPassword=Canal@123456 \
-e canal.instance.gtidon=true \
# 下面这个表示只定义bus_info开头的表。实际应用的时候可以不要
-e canal.instance.filter.regex=bus_db\\.bus_info_.* \
canal/canal-server:v1.1.7
(2)spring boot程序编写
pom.xml
xml
<?xml version="1.0" encoding="UTF-8"?>
<project>
    <dependencies>
        <dependency>
            <groupId>org.springframework.boot</groupId>
            <artifactId>spring‑boot‑starter</artifactId>
        </dependency>
        <!-- canal java客户端 -->
        <dependency>
            <groupId>com.alibaba.otter</groupId>
            <artifactId>canal‑client</artifactId>
            <version>1.1.7</version>
        </dependency>
        <!-- protobuf,canal数据序列化依赖,必须引入 -->
        <dependency>
            <groupId>com.google.protobuf</groupId>
            <artifactId>protobuf‑java</artifactId>
            <version>3.21.9</version>
        </dependency>
    </dependencies>
</project>
application.yml
yaml
canal:
  server-host: 127.0.0.1
  server-port: 11111
  destination: example
  batch-size: 1000 # 一次批量拉取多少条
核心代码配置类CanalConfig.java
java
import com.alibaba.otter.canal.client.CanalConnector;
import com.alibaba.otter.canal.client.CanalConnectors;
import org.springframework.beans.factory.annotation.Value;
import org.springframework.context.annotation.Bean;
import org.springframework.context.annotation.Configuration;
import java.net.InetSocketAddress;

@Configuration
public class CanalConfig {

    @Value("${canal.server-host}")
    private String host;
    @Value("${canal.server-port}")
    private int port;
    @Value("${canal.destination}")
    private String destination;

    @Bean(destroyMethod = "disconnect")
    public CanalConnector canalConnector(){
        CanalConnector connector = CanalConnectors.newSingleConnector(
                new InetSocketAddress(host, port),
                destination,
                "", ""
        );
        connector.connect();
        // 订阅过滤,也可以在canal‑server配置,这里客户端再次过滤
        connector.subscribe(".*\\..*");
        connector.rollback();
        return connector;
    }
}
监听任务 CanalMessageTask.java
java
import com.alibaba.otter.canal.client.CanalConnector;
import com.alibaba.otter.canal.protocol.CanalEntry;
import com.alibaba.otter.canal.protocol.Message;
import org.springframework.beans.factory.annotation.Autowired;
import org.springframework.beans.factory.annotation.Value;
import org.springframework.scheduling.annotation.EnableScheduling;
import org.springframework.scheduling.annotation.Scheduled;
import org.springframework.stereotype.Component;
import javax.annotation.PostConstruct;
import java.util.List;

@Component
@EnableScheduling
public class CanalMessageTask {

    @Autowired
    private CanalConnector canalConnector;

    @Value("${canal.batch-size}")
    private int batchSize;

    @PostConstruct
    public void startTask(){
        // 启动单独线程循环消费,不要用@Scheduled定时,会丢消息
        new Thread(this::processLoop,"canal‑consumer‑thread").start();
    }

    public void processLoop(){
        while(!Thread.currentThread().isInterrupted()){
            try {
                // 拉取一批消息,不阻塞
                Message message = canalConnector.getWithoutAck(batchSize);
                long batchId = message.getId();
                int size = message.getEntries().size();

                if(batchId != -1 && size>0){
                    // 解析每一条binlog entry
                    processEntry(message.getEntries());
                }
                // ✅消费完成提交ack,推进位点;异常不要ack,下次重启重新消费这批数据
                canalConnector.ack(batchId);

            }catch (Exception e){
                e.printStackTrace();
                // 消费异常,回滚,下次重新拉取
                canalConnector.rollback();
                try {
                    Thread.sleep(1000);
                } catch (InterruptedException ex) {
                    Thread.currentThread().interrupt();
                }
            }
        }
    }

    /**
     * 解析Entry,拿到行变更数据
     */
    private void processEntry(List<CanalEntry.Entry> entryList){
        for (CanalEntry.Entry entry : entryList) {
            // 只处理ROWDATA,忽略事务开始、事务结束、DDL
            if(entry.getEntryType() != CanalEntry.EntryType.ROWDATA){
                continue;
            }
            CanalEntry.RowChange rowChange;
            try {
                rowChange = CanalEntry.RowChange.parseFrom(entry.getStoreValue());
            }catch (Exception e){
                throw new RuntimeException("parse row change error",e);
            }

            String database = entry.getHeader().getSchemaName();
            String tableName = entry.getHeader().getTableName();
            // DDL语句,这里打印,canal客户端可以拿到DDL
            if(rowChange.getIsDdl()){
                System.out.println("DDL语句:"+rowChange.getSql());
                continue;
            }

            // 遍历每一行变更
            for (CanalEntry.RowData rowData : rowChange.getRowDatasList()) {
                CanalEntry.EventType eventType = rowChange.getEventType();
                System.out.printf("【%s】库:%s 表:%s%n",eventType,database,tableName);

                if(eventType == CanalEntry.EventType.INSERT){
                    // insert:after列
                    printColumns(rowData.getAfterColumnsList());
                }else if(eventType == CanalEntry.EventType.UPDATE){
                    // update:before旧值,after新值
                    System.out.println("---before---");
                    printColumns(rowData.getBeforeColumnsList());
                    System.out.println("---after---");
                    printColumns(rowData.getAfterColumnsList());
                }else if(eventType == CanalEntry.EventType.DELETE){
                    // delete:before旧值
                    printColumns(rowData.getBeforeColumnsList());
                }

                // =====================
                // 【这里写你的业务逻辑】
                // 1. 判断database、tableName过滤(bus_info_xxxx分表)
                // 2. 取出rowData里面字段,做类型转换
                // 3. 组装实体,调用Mapper写入Oracle / 其他逻辑
                // =====================
            }
        }
    }

    /**
     * 打印列名和值
     */
    private void printColumns(List<CanalEntry.Column> columns){
        for (CanalEntry.Column col : columns) {
            System.out.print(col.getName() + "=" + col.getValue() + "  ");
        }
        System.out.println();
    }
}