文章目录
- [ICLR | 2019 | DARTS:可微架构搜索](#ICLR | 2019 | DARTS:可微架构搜索)
ICLR | 2019 | DARTS:可微架构搜索
- 论文:https://arxiv.org/pdf/1806.09055
- 代码:https://github.com/quark0/darts
- 会议:ICLR
- 年份:2019
创新点
本文主要贡献总结如下:
- 提出一种基于双层优化的可微网络架构搜索算法,同时支持卷积、循环网络架构。
- 在图像分类、语言建模任务上开展充分实验:基于梯度的架构搜索在 CIFAR‑10 上取得极具竞争力结果,在 PTB 数据集上刷新 SOTA。以往顶尖架构搜索大多采用强化学习、进化这类不可微搜索手段;本文将架构搜索的计算开销降低至数 GPU 天,核心原因是使用梯度优化替代非可微搜索。
- 证明 DARTS 在 CIFAR‑10、PTB 上学到的架构单元,能够分别迁移到 ImageNet、WikiText‑2 数据集。
可微架构搜索
2.1 节以通用形式描述搜索空间,将网络单元(cell)的计算流程表示为有向无环图;2.2 节介绍搜索空间的连续松弛方案,得到可微损失目标,联合优化架构与网络权重;2.3 节提出近似技术,让算法计算可行、提升效率。
2.1搜索空间
与 NASNet、AmoebaNet 等工作一致,本文搜索网络基础计算单元 cell,最终网络由该 cell 堆叠而成:卷积网络重复堆叠 cell,循环网络将 cell 循环连接。
一个 cell 是包含 N 个有序节点的有向无环图。每个节点 x ( i ) x^{(i)} x(i)代表隐表示(卷积网络中即特征图);每条有向边 ( i , j ) (i,j) (i,j)绑定算子 o ( i , j ) o^{(i,j)} o(i,j),对输入 x ( i ) x^{(i)} x(i)做变换。cell 包含两个输入节点、一个输出节点。
- 卷积 cell:输入节点是前两层 cell 的输出;
- 循环 cell:输入分别为当前时刻输入、上一时刻传递过来的状态。
cell 输出由全部中间节点经过聚合操作(例如拼接)得到。
每个中间节点由它所有前驱节点计算而来:
x ( j ) = ∑ i < j o ( i , j ) ( x ( i ) ) (1) x^{(j)}=\sum_{i<j}o^{(i,j)}\left(x^{(i)}\right) \tag{1} x(j)=i<j∑o(i,j)(x(i))(1)
还定义特殊的零算子(zero operation),代表两个节点之间不存在连接。学习 cell 的任务等价于学习每条边上对应的算子。
2.2 连续松弛与优化
记 O \mathcal O O为候选算子集合(卷积、最大池化、零算子等),每个算子代表对输入 x ( i ) x^{(i)} x(i)的变换函数 o ( ⋅ ) o(\cdot) o(⋅)。
为使搜索空间连续,把 "选择某一个算子" 的离散分类选择,松弛为所有候选算子上的 softmax 加权混合:
o ˉ ( i , j ) ( x ) = ∑ o ∈ O e x p ( α o ( i , j ) ) ∑ o ′ ∈ O e x p ( α o ′ ( i , j ) ) o ( x ) (2) \bar{o}^{(i,j)}(x)=\sum_{o \in \mathcal{O}}\frac{exp\left(\alpha_{o}^{(i,j)}\right)}{\sum_{o'\in \mathcal{O}}exp\left(\alpha_{o'}^{(i,j)}\right)}o(x) \tag{2} oˉ(i,j)(x)=o∈O∑∑o′∈Oexp(αo′(i,j))exp(αo(i,j))o(x)(2)
节点对 ( i , j ) (i,j) (i,j)对应的算子混合权重由维度为 ∣ O ∣ |\mathcal O| ∣O∣的向量 α ( i , j ) \boldsymbol{\alpha}^{(i,j)} α(i,j)参数化。架构搜索转化为学习一组连续变量 α = { α ( i , j ) } \boldsymbol{\alpha}=\{\boldsymbol{\alpha}^{(i,j)}\} α={α(i,j)}。搜索结束后得到离散架构:每条混合边替换成权重最大的算子:
o ( i , j ) = arg max o ∈ O α o ( i , j ) o^{(i,j)}=\argmax_{o\in \mathcal{O}}\alpha_{o}^{(i,j)} o(i,j)=o∈Oargmaxαo(i,j)
下文将 α \boldsymbol{\alpha} α称作架构的编码。
松弛之后,目标是联合学习架构 α \boldsymbol{\alpha} α,以及混合算子内部权重w(卷积核参数等)。强化学习、进化算法把验证集性能作为奖励 / 适应度;DARTS 同样优化验证损失,但是依靠梯度下降完成。
记 L t r a i n \mathcal{L}{train} Ltrain、 L v a l \mathcal{L}{val} Lval分别为训练损失、验证损失,两者同时依赖架构 α \boldsymbol{\alpha} α和网络权重 w w w。架构搜索目标:找到 α ∗ \boldsymbol{\alpha}^* α∗最小化验证损失 L v a l ( w ∗ ( α ∗ ) , α ∗ ) \mathcal{L}_{val}(w^*(\boldsymbol{\alpha}^*),\boldsymbol{\alpha}^*) Lval(w∗(α∗),α∗);其中对应架构的最优权重 w ∗ w^* w∗是训练损失的极小解:
w ∗ ( α ) = arg max w L t r a i n ( w , α ) w^*(\boldsymbol{\alpha})=\argmax_{w}L_{train}(w,\boldsymbol{\alpha}) w∗(α)=wargmaxLtrain(w,α)
由此得到双层优化(bilevel optimization)问题:上层变量为架构 α \boldsymbol{\alpha} α,下层变量为网络权重 w w w:
min α L v a l ( w ∗ ( α ) , α ) (3) \min_{\boldsymbol{\alpha}}\mathcal{L}_{val}(w^*(\boldsymbol{\alpha}),\boldsymbol{\alpha}) \tag{3} αminLval(w∗(α),α)(3)
s . t . w ∗ ( α ) = arg min w L t r a i n ( w , α ) (4) s.t. w^*(\boldsymbol{\alpha})=\argmin_{w}\mathcal{L}_{train}(w,\boldsymbol{\alpha}) \tag{4} s.t.w∗(α)=wargminLtrain(w,α)(4)
这种嵌套形式同样出现在基于梯度的超参数优化研究中。可以把架构 α \boldsymbol{\alpha} α理解成一类特殊超参数;但它维度远高于学习率这类标量超参数,优化难度更大。
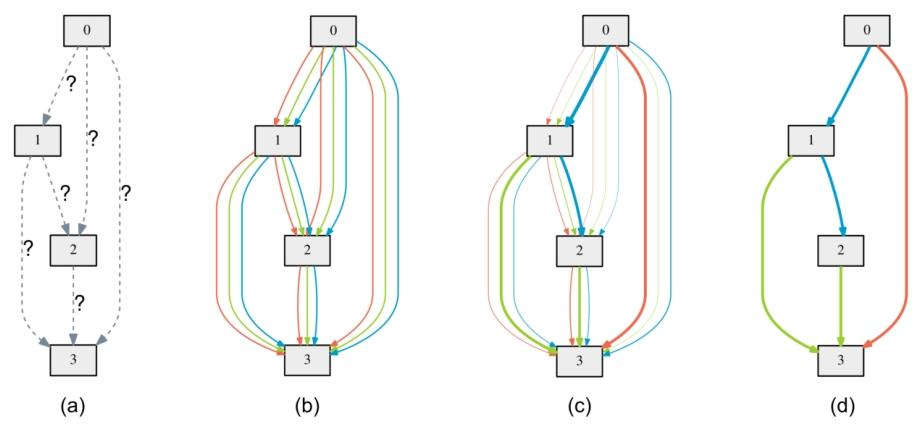
图 1 DARTS 整体流程:(a) 边上算子未知;(b) 每条边放置候选算子的加权混合,完成搜索空间连续松弛;© 求解双层优化,联合优化算子混合概率与网络权重;(d) 基于学到的混合概率,导出离散最终架构。
2.3 近似架构梯度
直接精确求解架构梯度,内层优化开销巨大,实际不可行。本文提出近似方案:
∇ α L v a l ( w ∗ ( α ) , α ) ≈ ∇ α L v a l ( w − ξ ∇ w L t r a i n ( w , α ) , α ) (5) \nabla_{\boldsymbol{\alpha}}\mathcal{L}{val}(w^*(\boldsymbol{\alpha}),\boldsymbol{\alpha}) \approx \nabla{\boldsymbol{\alpha}}\mathcal{L}{val}\left(w-\xi\nabla{w}\mathcal{L}_{train}(w,\boldsymbol{\alpha}),\boldsymbol{\alpha}\right) \tag{5} ∇αLval(w∗(α),α)≈∇αLval(w−ξ∇wLtrain(w,α),α)(5)
式中 w w w是算法当前维护的权重; ξ \xi ξ是内层优化单步更新的学习率。核心思想:不去完整求解内层优化直到收敛,仅做一步训练更新后的权重,近似代替理论最优权重 w ∗ ( α ) w^*(\boldsymbol{\alpha}) w∗(α) 。该思路在元学习、梯度超参调优、展开 GAN 等工作中已有应用。
当权重已经到达内层优化局部最优, ∇ w L t r a i n = 0 \nabla_w L_{train}=0 ∇wLtrain=0,公式退化为 ∇ α L v a l ( w , α ) \nabla_{\boldsymbol{\alpha}} L_{val}(w,\boldsymbol{\alpha}) ∇αLval(w,α)。
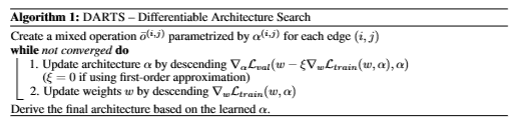
对近似架构梯度使用链式求导得到:
∇ α L v a l ( w ′ , α ) − ξ ∇ α , w 2 L t r a i n ( w , α ) ∇ w ′ L v a l ( w ′ , α ) (6) \nabla_{\boldsymbol{\alpha}} \mathcal{L}{val }\left(w', \boldsymbol{\alpha}\right)-\xi \nabla{\boldsymbol{\alpha}, w}^{2} \mathcal{L}{train }(w, \boldsymbol{\alpha}) \nabla{w'} \mathcal{L}_{val }\left(w', \boldsymbol{\alpha}\right) \tag{6} ∇αLval(w′,α)−ξ∇α,w2Ltrain(w,α)∇w′Lval(w′,α)(6)
其中, w ′ = w − ξ ∇ w L v a l ( w ′ , α ) w'=w-\xi \nabla_{w}\mathcal{L}{val}(w',\boldsymbol{\alpha}) w′=w−ξ∇wLval(w′,α)代表单步前向模型权重。第二项包含代价很高的矩阵‑向量乘积。本文用有限差分近似降低复杂度。设 ϵ \epsilon ϵ为小标量, w ± = w ± ϵ ∇ w ′ L v a l ( w ′ , α ) w^{\pm}=w \pm \epsilon \nabla{w'} L_{val}(w',\boldsymbol{\alpha}) w±=w±ϵ∇w′Lval(w′,α):
∇ α , w 2 L t r a i n ( w , α ) ∇ w ′ L v a l ( w ′ , α ) ≈ ∇ α L t r a i n ( w + , α ) − ∇ α L t r a i n ( w − , α ) 2 ϵ \nabla_{\boldsymbol{\alpha}, w}^{2} \mathcal{L}{train }(w, \boldsymbol{\alpha}) \nabla{w'} \mathcal{L}{val }\left(w', \boldsymbol{\alpha}\right) \approx \frac{\nabla{\boldsymbol{\alpha}} \mathcal{L}{train }\left(w^{+}, \boldsymbol{\alpha}\right)-\nabla{\boldsymbol{\alpha}} \mathcal{L}_{train }\left(w^{-}, \boldsymbol{\alpha}\right)}{2 \epsilon} ∇α,w2Ltrain(w,α)∇w′Lval(w′,α)≈2ϵ∇αLtrain(w+,α)−∇αLtrain(w−,α)
有限差分只需要 2 次权重前向传播、2 次 α \boldsymbol{\alpha} α反向传播;计算复杂度从 O ( ∣ α ∣ ∣ w ∣ ) O(|\boldsymbol{\alpha}||w|) O(∣α∣∣w∣)下降至 O ( ∣ α ∣ + ∣ w ∣ ) O(|\boldsymbol{\alpha}|+|w|) O(∣α∣+∣w∣)。
一阶近似
当 ξ = 0 \xi=0 ξ=0,式 (6) 二阶导数项消失。架构梯度直接取 ∇ α L v a l ( w , α ) \nabla_{\boldsymbol{\alpha}}\mathcal{L}_{val}(w,\boldsymbol{\alpha}) ∇αLval(w,α),简单假设当前 w w w就等于最优 w ∗ ( α ) w^*(\boldsymbol{\alpha}) w∗(α)。速度更快,但实验显示效果会变差。
下文称 ξ = 0 \xi=0 ξ=0为一阶近似; ξ > 0 \xi>0 ξ>0的梯度形式称为二阶近似。
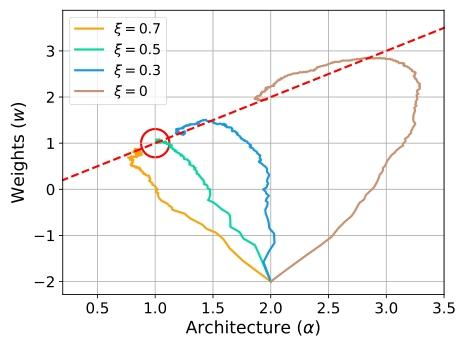
图 2 迭代算法的学习动力学示例,损失: L v a l ( w , α ) = α w − 2 α + 1 \mathcal{L}{val}(w,\alpha)=\alpha w-2\alpha+1 Lval(w,α)=αw−2α+1, L t r a i n ( w , α ) = w 2 − 2 α w + α 2 \mathcal{L}{train}(w,\alpha)=w^2-2\alpha w+\alpha^2 Ltrain(w,α)=w2−2αw+α2;初始点 ( α ( 0 ) , w ( 0 ) ) = ( 2 , − 2 ) (\alpha^{(0)},w^{(0)})=(2,-2) (α(0),w(0))=(2,−2)。该双层优化解析最优解 ( α ∗ , w ∗ ) = ( 1 , 1 ) (\alpha^*,w^*)=(1,1) (α∗,w∗)=(1,1)(红圈标记)。红色虚线是严格满足内层约束的可行集。示例说明合适的 ξ \xi ξ有助于收敛到更优局部最优点。
2.4 导出离散架构
构造离散架构每个节点时,从所有前驱节点中保留权重最强的前 k k k个非零算子 。算子强度定义为 softmax 输出概率
e x p ( α o ( i , j ) ) ∑ o ′ ∈ O e x p ( α o ′ ( i , j ) ) \frac{exp\left(\alpha_{o}^{(i,j)}\right)}{\sum_{o'\in \mathcal{O}}exp\left(\alpha_{o'}^{(i,j)}\right)} ∑o′∈Oexp(αo′(i,j))exp(αo(i,j))
为和过往工作对齐:卷积 cell 取 k = 2 k=2 k=2,循环 cell 取 k = 1 k=1 k=1。
导出时排除零算子,两点原因:
- 为和已有模型公平对比,每个节点必须恰好k条非零输入边;
- 零算子的权重没有明确意义:增大零算子对应的 logit 只会改变节点特征幅值;批归一化存在的情况下,不会改变最终分类结果。
解释
A. α \alpha α是什么?
原文中表示,对于节点 i , j i,j i,j之间的一条边,混合权重由一个 ∣ O ∣ |\mathcal{O}| ∣O∣维向量 α ( i , j ) \alpha^{(i,j)} α(i,j)参数化;整个架构搜索就是学习连续变量 α \alpha α。
例如,候选操作集合是
O = { 3 × 3 c o n v , 5 × 5 c o n v , max p o o l , s k i p , ⋯ } \mathcal{O}=\{ 3\times3 \,conv,5\times5 \,conv,\max pool,skip, \cdots \} O={3×3conv,5×5conv,maxpool,skip,⋯}
那么边 ( i , j ) (i,j) (i,j)上,每一种操作都有一个对应的 α \alpha α:
α ( i , j ) = α 3 × 3 c o n v , α 5 × 5 c o n v , α max p o o l , α s k i p , ⋯ \alpha^{(i,j)}=\\alpha_{3\\times3 conv},\\alpha_{5\\times 5 conv},\\alpha_{\\max pool},\\alpha_{skip},\\cdots α(i,j)=α3×3conv,α5×5conv,αmaxpool,αskip,⋯
DARTS 对它做 softmax:
p o ( i , j ) = e x p ( α o ( i , j ) ) ∑ o ′ ∈ O e x p ( α o ′ ( i , j ) ) p_{o}^{(i,j)}=\frac{exp\left(\alpha_{o}^{(i,j)}\right)}{\sum_{o'\in \mathcal{O}}exp\left(\alpha_{o'}^{(i,j)}\right)} po(i,j)=∑o′∈Oexp(αo′(i,j))exp(αo(i,j))
这个 p o ( i , j ) p_{o}^{(i,j)} po(i,j)才可以理解成操作 (o) 在这条边上的"权重/选择倾向"。所以公式
o ‾ ( i , j ) ( x ) = ∑ o ∈ O exp ( α o ( i , j ) ) ∑ o ′ ∈ O exp ( α o ′ ( i , j ) ) ⏟ softmax 后的操作权重 o ( x ) \overline{o}^{(i,j)}(x)=\sum_{o\in\mathcal O}\underbrace{ \frac{\exp(\alpha_o^{(i,j)})} {\sum_{o'\in\mathcal O}\exp(\alpha_{o'}^{(i,j)})} }_{\text{softmax 后的操作权重}} o(x) o(i,j)(x)=o∈O∑softmax 后的操作权重 ∑o′∈Oexp(αo′(i,j))exp(αo(i,j))o(x)
本质上在说 → \to →先别急着选某一个操作,让所有候选操作都执行,然后根据 α \alpha α 算出来的权重,把它们的结果加权求和。
这就是 DARTS 所谓的 continuous relaxation(连续松弛):原本"卷积 / 池化 / skip 三选一"这种离散选择,变成了可微分的加权混合。论文也是这样描述式 (2) 的。
举个非常具体的例子。假设一条边只有三个候选操作:
O = { c o n v , p o o l , s k i p } \mathcal{O}=\{ conv, pool,skip\} O={conv,pool,skip}
当前学到
α ( i , j ) = 2 , 1 , 0 \alpha^{(i,j)}=2, 1, 0 α(i,j)=2,1,0
经过softmax之后大约是
0.665 , 0.245 , 0.090 \] \[0.665,0.245,0.090\] \[0.665,0.245,0.090
于是这条边实际上计算的是:
o ˉ ( x ) = 0.665 C o n v ( x ) + 0.245 P o o l ( x ) + 0.090 S k i p ( x ) \bar{o}(x)=0.665Conv(x)+0.245Pool(x)+0.090Skip(x) oˉ(x)=0.665Conv(x)+0.245Pool(x)+0.090Skip(x)
训练过程中, α \alpha α 会通过梯度下降不断变化。搜索结束之后,就不需要这种"全都做一点"的混合状态了,而是选择 α \alpha α 最大的操作:
o ( i , j ) = arg max o ∈ O α o ( i , j ) o^{(i,j)}=\argmax_{o\in \mathcal{O}}\alpha_{o}^{(i,j)} o(i,j)=o∈Oargmaxαo(i,j)
论文也是通过这种方式从连续的混合操作恢复离散架构。