文章目录
- 前言
- 零、论文基本信息
- 一、背景与问题:长记忆的瓶颈不仅是内容多,而是表示昂贵
-
- [1. 长上下文为什么难以成为无限记忆](#1. 长上下文为什么难以成为无限记忆)
- [2. 传统 Agent Memory 仍然以文本为中心](#2. 传统 Agent Memory 仍然以文本为中心)
- [3. 视觉压缩为什么有吸引力](#3. 视觉压缩为什么有吸引力)
- [4. 单纯把文档转成图片仍然不够](#4. 单纯把文档转成图片仍然不够)
- [二、相关工作:VizoMem 改变的是记忆介质](#二、相关工作:VizoMem 改变的是记忆介质)
-
- [1. Agentic Memory](#1. Agentic Memory)
- [2. 视觉文本压缩](#2. 视觉文本压缩)
- [3. 多模态记忆与视觉 RAG](#3. 多模态记忆与视觉 RAG)
- [4. 最近邻方法:Glyph 与 MIRIX](#4. 最近邻方法:Glyph 与 MIRIX)
- 三、方法总览
-
- [1. Interaction:决定写入还是查询](#1. Interaction:决定写入还是查询)
- [2. Memory Management:连接文本查询和视觉记忆](#2. Memory Management:连接文本查询和视觉记忆)
- [3. Visual Hierarchical Memory:图片不是一个无结构图库](#3. Visual Hierarchical Memory:图片不是一个无结构图库)
- 四、文本如何变成视觉记忆
-
- [1. 渲染不是截图,而是固定编码协议](#1. 渲染不是截图,而是固定编码协议)
- [2. 写入单位的选择](#2. 写入单位的选择)
- 五、ColGlyph:为文本渲染图像定制的检索器
-
- [1. 为什么通用视觉检索器不够](#1. 为什么通用视觉检索器不够)
- [2. GraphMARCO 数据集](#2. GraphMARCO 数据集)
- [3. 模型结构](#3. 模型结构)
- [4. L2 归一化](#4. L2 归一化)
- [5. Late Interaction MaxSim](#5. Late Interaction MaxSim)
- [ \\operatorname{score}(Q,P)](# \operatorname{score}(Q,P))
-
- [6. Batch 内负样本与训练目标](#6. Batch 内负样本与训练目标)
- [ \\mathcal{L}_{\\mathrm{Train}}](# \mathcal{L}_{\mathrm{Train}})
- [六、Alignment Mechanism:识别"内容相同但图文表示不一致"的记忆](#六、Alignment Mechanism:识别“内容相同但图文表示不一致”的记忆)
-
- [1. 跨模态错位从哪里来](#1. 跨模态错位从哪里来)
- [2. 双向自相似度](#2. 双向自相似度)
- [3. Alignment Score](#3. Alignment Score)
- [ \\operatorname{Align}(p)](# \operatorname{Align}(p))
-
- [4. 调整最终检索分数](#4. 调整最终检索分数)
- [ \\operatorname{score}'(q,p)](# \operatorname{score}'(q,p))
- [七、两种视觉记忆 Agent:DVR 与 ViHM](#七、两种视觉记忆 Agent:DVR 与 ViHM)
-
- [1. Direct Visual Retrieval](#1. Direct Visual Retrieval)
- [2. Visual Hierarchical Memory](#2. Visual Hierarchical Memory)
- [八、为什么视觉 Token 可能比文本 Token 更密集](#八、为什么视觉 Token 可能比文本 Token 更密集)
-
- [1. 文本处理器:原子离散化](#1. 文本处理器:原子离散化)
- [2. 视觉处理器:局部复合聚合](#2. 视觉处理器:局部复合聚合)
- [3. 对检索的影响](#3. 对检索的影响)
- 九、实验设置
-
- [1. LoCoMo](#1. LoCoMo)
- [2. LongMemEval](#2. LongMemEval)
- [3. 基线](#3. 基线)
- [4. 模型与评估](#4. 模型与评估)
- [十、LoCoMo 主结果:视觉记忆能否保住准确率](#十、LoCoMo 主结果:视觉记忆能否保住准确率)
-
- [1. 直接视觉检索与早期文本记忆方法](#1. 直接视觉检索与早期文本记忆方法)
- [2. 分层视觉记忆与强基线](#2. 分层视觉记忆与强基线)
- [3. 三次运行稳定性](#3. 三次运行稳定性)
- [十一、Token 消耗:主要价值来自效率---准确率折中](#十一、Token 消耗:主要价值来自效率—准确率折中)
- 十二、LongMemEval:更长上下文下视觉记忆是否仍然有效
- 十三、推理延迟与记忆构建成本
-
- [1. 长上下文推理延迟](#1. 长上下文推理延迟)
- [2. 记忆构建 Token](#2. 记忆构建 Token)
- 十四、消融实验:专用检索器与对齐机制分别贡献多少
- [十五、图片大小与 DPI:视觉记忆不是越大越清楚](#十五、图片大小与 DPI:视觉记忆不是越大越清楚)
- 十六、失败案例:视觉记忆在哪里丢失信息
-
- [1. 超长小说中的字符级混淆](#1. 超长小说中的字符级混淆)
- [2. DVR:保留原话,但无法连接分散证据](#2. DVR:保留原话,但无法连接分散证据)
- [3. ViHM:建立连接,但摘要可能制造错误](#3. ViHM:建立连接,但摘要可能制造错误)
- [4. 两种变体的核心权衡](#4. 两种变体的核心权衡)
- [十七、与已有 Agent Memory 方法的横向比较](#十七、与已有 Agent Memory 方法的横向比较)
- [十八、对 Coding Agent、Tool Agent 与 Multi-Agent 的启发](#十八、对 Coding Agent、Tool Agent 与 Multi-Agent 的启发)
-
- [1. Coding Agent:将长文档和日志保存为视觉 Resource Memory](#1. Coding Agent:将长文档和日志保存为视觉 Resource Memory)
- [2. Tool Agent:视觉记忆适合说明书,不适合凭证](#2. Tool Agent:视觉记忆适合说明书,不适合凭证)
- [3. Multi-Agent:共享视觉记忆库](#3. Multi-Agent:共享视觉记忆库)
- [4. 双轨记忆比纯视觉替换更可靠](#4. 双轨记忆比纯视觉替换更可靠)
- 十九、论文局限性
-
- [1. 视觉记忆不能完全替代结构化操作](#1. 视觉记忆不能完全替代结构化操作)
- [2. 仍然是文本中心,而非通用多模态记忆](#2. 仍然是文本中心,而非通用多模态记忆)
- [3. 依赖 LLM-as-a-Judge](#3. 依赖 LLM-as-a-Judge)
- [4. 基线与 VizoMem 的重复次数不一致](#4. 基线与 VizoMem 的重复次数不一致)
- [5. 多跳推理仍然是明显短板](#5. 多跳推理仍然是明显短板)
- [6. 渲染参数敏感](#6. 渲染参数敏感)
- [7. 缺少完整系统成本](#7. 缺少完整系统成本)
- [8. Table 2 存在数字不一致](#8. Table 2 存在数字不一致)
- [9. 字符级精度和事实拼接风险](#9. 字符级精度和事实拼接风险)
- 二十、我的理解与启发
-
- [1. VizoMem 的价值是"换介质",不是"换结构"](#1. VizoMem 的价值是“换介质”,不是“换结构”)
- [2. 图片在这里更像一种压缩编码,而不是传统"视觉内容"](#2. 图片在这里更像一种压缩编码,而不是传统“视觉内容”)
- [3. Alignment Score 是记忆级质量控制信号](#3. Alignment Score 是记忆级质量控制信号)
- [4. 最合理的设计不是全视觉,而是按记忆类型选择介质](#4. 最合理的设计不是全视觉,而是按记忆类型选择介质)
- [5. DVR 与 ViHM 揭示了记忆系统中的经典矛盾](#5. DVR 与 ViHM 揭示了记忆系统中的经典矛盾)
- [6. 下一步应该是可验证的视觉记忆](#6. 下一步应该是可验证的视觉记忆)
- 二十一、总结
- 参考资料
前言
Agent 的记忆越来越长时,我们通常会思考两个方向:
- 怎样把文本记忆压缩得更短;
- 怎样只检索当前问题需要的部分。
但 VizoMem 提出了一个更激进的问题:长期记忆一定要以文本 Token 的形式保存和读取吗?
假设一个 Agent 已经积累了几十万 Token 的历史对话。即使模型支持超长上下文,把全部历史放入 Prompt 仍会带来显存、注意力计算和响应延迟问题。传统记忆系统会将历史拆成文本片段,建立向量或图索引,再检索少量片段。
这种方式减少了输入长度,却没有改变记忆的基本表示单位:写入的是文本,索引的是文本,取回后仍然以文本 Token 交给 LLM。
与此同时,Glyph、DeepSeek-OCR 等工作发现,将密集文本排版成图片后,视觉编码器可以用更少的视觉 Token 处理相同内容。单纯视觉压缩通常能达到约 3--4 倍压缩,但对一本约 130 万词的小说,即使压缩后仍可能产生近 60 万视觉 Token,依然超过常见 VLM 的上下文窗口。
所以,视觉压缩本身也不能解决无限增长的记忆问题。它需要与 Agent Memory 的分块、组织、更新和检索能力结合。
VizoMem 正是在这里完成了关键转变:它不把图片仅仅当作进入模型前的临时压缩格式,而是把文本渲染图像作为可以长期保存、分层管理和按需检索的一等记忆单元。
为了让文本查询能在大规模视觉记忆中找到正确图片,论文又训练了专用检索器 ColGlyph,并设计跨模态 Alignment Score,降低不同字体、DPI 和图片尺寸造成的图文表示错位。
因此,这篇论文的唯一核心增量可以概括为:
VizoMem 将 Agent Memory 的底层存储和检索单位从文本片段替换为文本渲染的视觉笔记,并用专用跨模态检索与一致性校准,使视觉压缩第一次真正进入可持续更新和检索的长期记忆系统。
全文中的 DVR、ViHM、GraphMARCO、ColGlyph 和 Alignment Mechanism 都在支撑这一件事:前两者验证视觉记忆可以怎样接入不同复杂度的 Memory Agent,后三者解决视觉笔记如何被可靠检索。
零、论文基本信息
- 论文名称:VizoMem: A Visual-Textual Memory Framework for Efficient Long-Horizon Reasoning
- 发表平台:Findings of the Association for Computational Linguistics: ACL 2026
- 代码仓库:论文与 ACL Anthology 页面暂未提供官方代码仓库
- 作者:Weijie Liang、Yuanfeng Song、Xing Chen、Caleb Chen Cao、Sirui Han、Yike Guo
一、背景与问题:长记忆的瓶颈不仅是内容多,而是表示昂贵
1. 长上下文为什么难以成为无限记忆
Transformer 的注意力计算会随上下文长度迅速增长。即使模型声称支持几十万乃至上百万 Token,实际系统仍要承担:
- 更高的 KV Cache 占用;
- 更长的 Prefill 延迟;
- 大量与当前问题无关的注意力计算;
- 长上下文中的信息定位和推理退化。
因此,把所有历史持续拼接到上下文中,并不是可扩展的长期记忆方案。
2. 传统 Agent Memory 仍然以文本为中心
Mem0、A-MEM、Zep、MIRIX 等方法会提取重要信息,将其组织成独立笔记、知识图、不同记忆类型或层级结构。
它们解决了"哪些内容值得保存"和"如何定位相关记忆",但保存后的基本单元仍然是文本。检索到的若干条记忆最终还要转化成语言 Token,放入 LLM 的 Prompt。
因此,系统虽然减少了记忆数量,却没有改变单条记忆的编码成本。
3. 视觉压缩为什么有吸引力
文本 Tokenizer 将字符串切成离散词元。视觉编码器则会将二维局部区域聚合成 Patch 表示,一个视觉 Token 可能覆盖多个字符或词。
例如,页面中的标题、段落、列表和表格都可以通过二维位置表达结构,不需要把每个字都作为独立语言 Token 展开。
已有工作表明,在保持问答能力的情况下,文本渲染图像可以达到约 3--4 倍 Token 压缩。
4. 单纯把文档转成图片仍然不够
下面这张图说明了视觉压缩和视觉记忆之间的差别。
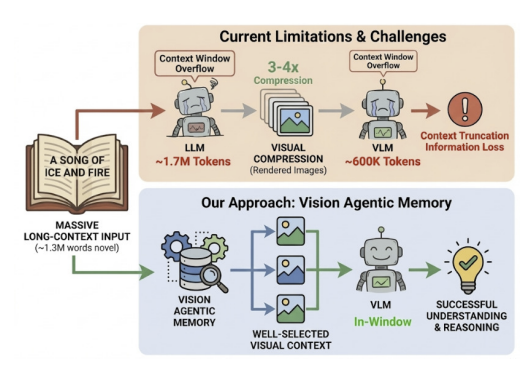
Figure 1:从视觉压缩到视觉 Agent Memory。 一本约 130 万词的小说需要约 170 万文本 Token,即使压缩成约 60 万视觉 Token 仍超过 VLM 窗口;VizoMem 通过视觉记忆检索,只把相关视觉内容送入模型。
这张图指出:压缩和检索必须同时存在。
text
只有视觉压缩:170 万文本 Token → 60 万视觉 Token → 仍然放不下

视觉 Agent Memory:
170 万文本 Token → 多张视觉笔记 → 检索少量相关图片 → VLM 推理
VizoMem 的目标并不是让 VLM 一次看完整个视觉化文档,而是像文本 RAG 一样管理大量图像记忆,并只加载当前问题所需的部分。
二、相关工作:VizoMem 改变的是记忆介质
1. Agentic Memory
Agent Memory 通常把信息划分为事实记忆、情景记忆、程序记忆和工作记忆,再由专门的管理器完成写入、合并、检索和遗忘。
代表方法包括:
- A-MEM:使用类似 Zettelkasten 的动态笔记网络组织记忆;
- Zep:用时间感知知识图维护实体关系;
- MemOS:将文本记忆、激活记忆和参数记忆统一进 Memory OS;
- MIRIX:将记忆分为 Core、Episodic、Resource、Procedural、Semantic 和 Knowledge Vault 六类。
VizoMem 并没有提出一种完全新的上层记忆分类,而是研究能否把这些系统中的文本笔记换成视觉笔记。
2. 视觉文本压缩
Text or Pixels、DeepSeek-OCR、Glyph 等工作证明,渲染后的文本图像能够成为长文本的高密度输入。
但这些方法一般把视觉化当作一次性预处理:给定一段文档,渲染成图片,然后直接送进模型。它们不负责持续写入、记忆演化和跨海量图片检索。
3. 多模态记忆与视觉 RAG
REVEAL、RA-CM3、ColPali 等方法能够检索或利用原生图像、图表和混合页面。它们处理的是本来就包含视觉信息的材料。
VizoMem 的对象不同:原始信息是纯文本,系统主动将其渲染成图像,再把这种人为生成的图像作为基本记忆单元。
4. 最近邻方法:Glyph 与 MIRIX
VizoMem 可以看成两条技术路线的结合:
- Glyph 提供文本转视觉表示和 VLM 阅读能力;
- MIRIX 提供成熟的分层 Agent Memory 架构。
论文真正新增的部分是:在两者之间补上一套专门面向文本渲染图片的检索与对齐机制,并验证视觉介质可以替代 MIRIX 中的大部分文本记忆内容。
三、方法总览
VizoMem 的系统结构分为交互、记忆管理和视觉分层记忆三部分。
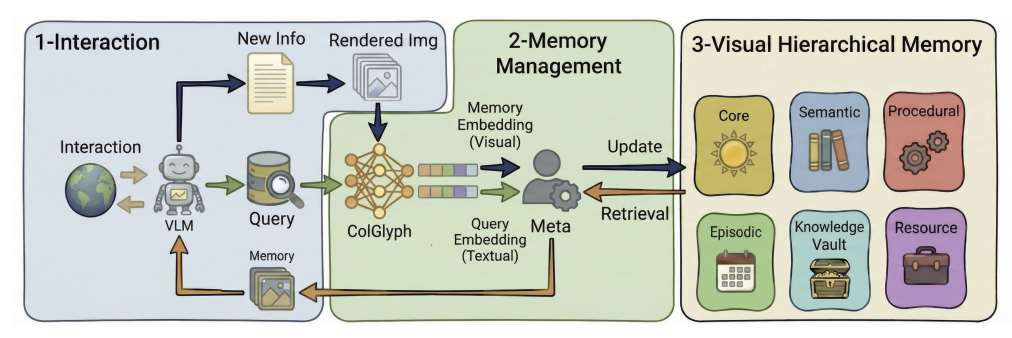
Figure 2:VizoMem 整体架构。 新信息被渲染为视觉笔记并编码,文本查询则由文本塔编码;Meta Manager 负责将更新与检索请求路由到 Core、Semantic、Procedural、Episodic、Knowledge Vault 和 Resource 六类视觉记忆。
1. Interaction:决定写入还是查询
Agent 与环境持续交互。产生新信息时,系统将文本渲染为图片,形成视觉笔记;需要历史信息时,Agent 发出文本查询。
这意味着 VizoMem 是一种不对称系统:
- 记忆内容以图像形式保存;
- 查询仍然以自然语言文本提出;
- 回答由 VLM 根据取回图片生成。
2. Memory Management:连接文本查询和视觉记忆
ColGlyph 同时包含视觉塔和语言塔:
- 视觉笔记经过视觉塔得到多向量嵌入;
- 文本查询经过语言塔得到多向量嵌入;
- 二者使用 Late Interaction 计算相关性。
Meta Manager 接收查询或新记忆,并决定应该更新、检索哪些记忆模块。
3. Visual Hierarchical Memory:图片不是一个无结构图库
ViHM 继承 MIRIX 的六类记忆:
- Core Memory:用户偏好、行为模式和重要个人信息;
- Episodic Memory:按时间组织的事件和交互日志;
- Resource Memory:文件、文档和任务资料;
- Procedural Memory:步骤、操作指南和工作流;
- Semantic Memory:概念、定义、事实和实体;
- Knowledge Vault:凭证、标识符、URL、配置值等结构化事实。
视觉笔记进入这些分层模块,而不是混在一个统一向量库中。
四、文本如何变成视觉记忆
1. 渲染不是截图,而是固定编码协议
系统将文本按照统一版式渲染为图片。论文附录给出的主要参数包括:
| 参数 | 设置 |
|---|---|
| Page size | 595 × 842 |
| DPI | 96 |
| Margin | 10 × 10 |
| Font | Verdana.ttf |
| Font size | 9 |
| Line height | 10 |
| Text alignment | LEFT |
| Background | #FFFFFF |
| Auto-crop width | True |
| Auto-crop last page | True |
| Newline markup | <br/> |
Table 6:文本转图像的渲染参数。 训练数据统一使用 96 DPI 和固定字体、字号、页面尺寸;作者特别指出,不同换行编码也会影响检索和后续推理。
固定渲染协议很重要,因为 ColGlyph 学到的不只是文字语义,也会受到字体形状、行距、页面尺度和空间布局影响。
2. 写入单位的选择
在最简单的 DVR 中,系统按照数据集给出的 Session 边界,将每个对话 Session 渲染为一张图片。
在 ViHM 中,原始对话先经过对应记忆 Agent 的提取、合并和分类,然后将生成的记忆内容渲染为视觉笔记。
因此,两种变体的区别不只是检索器相同、存储结构不同,还在于渲染之前是否进行信息抽象:
text
DVR:原始 Session → 图片

ViHM:原始对话 → 提取/合并/分类 → 记忆笔记 → 图片
这也解释了实验中两种方法不同的失败模式:DVR 保留细节但缺少跨片段连接;ViHM 能建立关系,却可能在摘要和合并中丢失原话。
五、ColGlyph:为文本渲染图像定制的检索器
1. 为什么通用视觉检索器不够
ColPali、ColQwen 等模型可以检索包含图像、布局、表格和文字的页面,但文本渲染图像是一种特殊分布:
- 内容几乎全部是小字号文字;
- 视觉外观由固定渲染参数决定;
- 查询是纯文本,候选记忆是图片;
- 检索目标通常是细粒度事实,而不是整体图像语义。
通用视觉检索器没有专门针对这种跨模态、密集文字场景优化。
2. GraphMARCO 数据集
作者基于 MS MARCO v1.1 构建 GraphMARCO。处理后包含 74,089 个训练实例,每个实例由:
- 一个文本查询;
- 一个正样本 Passage;
- 一个负样本 Passage组成。
Passage 按 Glyph 配置渲染为图片,从而把原本的文本检索训练数据转化为"文本查询---视觉 Passage"配对数据。
3. 模型结构
ColGlyph 以 Glyph 的视觉塔和语言塔为基础。在 Token 级隐藏状态上增加单层 MLP,将 4,096 维特征投影到 128 维。
训练时:
- 冻结视觉塔;
- 对语言塔的 q p r o j q_{proj} qproj、 k p r o j k_{proj} kproj、 v p r o j v_{proj} vproj 和 o p r o j o_{proj} oproj 使用 rank 16 LoRA;
- 训练 1 个 epoch;
- 使用 Batch 内负样本。
所以 ColGlyph 并不是完整微调一个大型 VLM,而是保留视觉编码能力,主要让文本查询空间适配视觉记忆空间。
4. L2 归一化
给定批量查询嵌入:
Q ∈ R B × N q × d Q\in\mathbb{R}^{B\times N_q\times d} Q∈RB×Nq×d
以及视觉 Passage 嵌入:
P ∈ R B × N p × d P\in\mathbb{R}^{B\times N_p\times d} P∈RB×Np×d
先对每个 Token 向量做 L2 归一化:
Q ^ i = Q i ∥ Q i ∥ 2 , P ^ j = P j ∥ P j ∥ 2 \hat Q_i=\frac{Q_i}{\lVert Q_i\rVert_2}, \qquad \hat P_j=\frac{P_j}{\lVert P_j\rVert_2} Q^i=∥Qi∥2Qi,P^j=∥Pj∥2Pj
归一化避免向量模长差异主导相似度,使后续点积更接近方向匹配。
5. Late Interaction MaxSim
查询与一张候选视觉笔记的相关性为:
$$
\operatorname{score}(Q,P)
\sum_{i=1}^{N_q}
\max_{j=1,\ldots,N_p}
\hat Q_i\cdot\hat P_j
对每个查询 Token,系统在整张图片的视觉 Token 中找到最匹配的一个,再对所有查询 Token 的最大匹配分数求和。 这种方式与先把整张图片压成单一向量不同。它允许查询中的不同概念分别对齐到页面不同位置,例如"Gina""tattoo""when"可以匹配不同视觉区域。 ### 6. Batch 内负样本与训练目标 一个 Batch 中第 m m m 个查询与第 n n n 个 Passage 的得分为: S m n = score ( Q m , P n ) S_{mn}=\\operatorname{score}(Q_m,P_n) Smn=score(Qm,Pn) 同一索引的 Passage 是正样本,其余 Passage 自动成为负样本。训练损失为: ##
\mathcal{L}_{\mathrm{Train}}
-\frac{1}{B}
\sum_{m=1}^{B}
\log
\frac{\exp(S_{mm})}
{\sum_{n=1}^{B}\exp(S_{mn})}
这迫使文本查询与正确图片靠近,并与同批次其他文本图片拉开距离。 *** ** * ** *** ## 六、Alignment Mechanism:识别"内容相同但图文表示不一致"的记忆 ### 1. 跨模态错位从哪里来 同一段文本同时存在两种表示: L = E t e x t ( p l ) L=E_{\\mathrm{text}}(p_l) L=Etext(pl) V = E v i s i o n ( p v ) V=E_{\\mathrm{vision}}(p_v) V=Evision(pv) p l p_l pl 是原始文本, p v p_v pv 是渲染图片。理想情况下,两者表达相同内容;现实中,字体、DPI、图片大小、OCR 能力和视觉塔/语言塔的不对称会造成差异。 ### 2. 双向自相似度 使用同一 MaxSim 函数计算: s L → V = score ( L , V ) s_{L\\rightarrow V}=\\operatorname{score}(L,V) sL→V=score(L,V) s V → L = score ( V , L ) s_{V\\rightarrow L}=\\operatorname{score}(V,L) sV→L=score(V,L) Late Interaction 并不对称,因为"文本中的每个 Token 找最佳视觉 Token"和"视觉中的每个 Token 找最佳文本 Token"不是同一个问题。 如果两个方向得分差异很大,说明该视觉笔记没有稳定保留原始文本的信息结构。 ### 3. Alignment Score 作者使用类似调和一致性的形式: ##
\operatorname{Align}§
\frac{2\cdot\min(s_{L\rightarrow V},s_{V\rightarrow L})}
{s_{L\rightarrow V}+s_{V\rightarrow L}+\epsilon}
它由较弱的方向决定上限:只要一个方向明显较差,Alignment Score 就会下降。 ### 4. 调整最终检索分数 查询 q q q 的文本嵌入为: Q = E t e x t ( q ) Q=E_{\\mathrm{text}}(q) Q=Etext(q) 原始查询---视觉记忆得分经过一致性置信度修正: ##
\operatorname{score}'(q,p)
\operatorname{score}(Q,V)
\cdot
\operatorname{Align}§^{\alpha}
$$
论文设置 α = 0.5 \alpha=0.5 α=0.5。
Alignment Score 低的记忆会被降权。直观上,这相当于告诉检索器:"这张图片虽然表面上与查询相似,但它自己的文本表示和视觉表示并不一致,因此不要过度相信它。"
需要注意,论文正文称"较小的 α \alpha α 会施加更强惩罚",但当 0 < Align < 1 0<\operatorname{Align}<1 0<Align<1 时,指数越小,结果越接近 1,数学上实际惩罚越弱。这是论文表述与公式之间的一处不一致;本文按公式含义理解。
七、两种视觉记忆 Agent:DVR 与 ViHM
1. Direct Visual Retrieval
DVR 是最简单的实现:
- 按 Session 切分原始对话;
- 每个 Session 渲染成一张图片;
- 用 ColGlyph 检索固定数量的图片;
- 将图片交给 VQA/VLM 回答。
它不做摘要、合并和记忆类型划分,因此能最大程度保留原始措辞。
2. Visual Hierarchical Memory
ViHM 在 LoCoMo 上采用 MIRIX 式分层架构。Meta Manager 先将输入分派给相关记忆 Agent:
x → ρ M A ∗ ⊆ A x\xrightarrow{\rho_M}A^*\subseteq A xρM A∗⊆A
其中:
A = { α C , α E , α R , α P , α S , α K } A=\{\alpha_C,\alpha_E,\alpha_R,\alpha_P,\alpha_S,\alpha_K\} A={αC,αE,αR,αP,αS,αK}
分别对应六类记忆。
每个被激活的 Agent 先从输入中提取结构化记忆:
e = Extraction ( x ∣ ρ i ) e=\operatorname{Extraction}(x\mid\rho_i) e=Extraction(x∣ρi)
然后决定对已有状态执行哪种操作:
o p ← Decide ( S i , t , e ∣ ρ i ) op\leftarrow\operatorname{Decide}(S_{i,t},e\mid\rho_i) op←Decide(Si,t,e∣ρi)
动作集合为:
Ω = { INSERT , REPLACE , MERGE , SKIP } \Omega= \{\operatorname{INSERT}, \operatorname{REPLACE}, \operatorname{MERGE}, \operatorname{SKIP}\} Ω={INSERT,REPLACE,MERGE,SKIP}
最终更新记忆状态:
S i , t + 1 = U ( S i , t , e , o p ) S_{i,t+1}=U(S_{i,t},e,op) Si,t+1=U(Si,t,e,op)
ViHM 的记忆组织和更新决策仍由文本 Prompt 与 LLM 完成,只有底层记忆内容被渲染成图片保存和检索。
这也是论文在局限性中承认的事实:纯视觉表示还不能替代 Agent Memory 中的结构化操作。
八、为什么视觉 Token 可能比文本 Token 更密集
1. 文本处理器:原子离散化
文本 Tokenizer 将输入 X X X 映射成长度为 L t L_t Lt 的序列:
τ L : X → Z t e x t = ( t 1 , ... , t L t ) \tau_L:X\rightarrow Z_{\mathrm{text}}=(t_1,\ldots,t_{L_t}) τL:X→Ztext=(t1,...,tLt)
确定性 Tokenizer 满足:
I ( Z t e x t ; X ) = H ( Z t e x t ) I(Z_{\mathrm{text}};X)=H(Z_{\mathrm{text}}) I(Ztext;X)=H(Ztext)
每个 Token 指向固定词表 V \mathcal{V} V 中的一个条目,其熵上限为:
H ( t i ) ≤ log ∣ V ∣ H(t_i)\le\log|\mathcal{V}| H(ti)≤log∣V∣
因此,总表示容量随 Token 数线性增长:
I ( Z t e x t ; X ) ≤ L t log ∣ V ∣ I(Z_{\mathrm{text}};X) \le L_t\log|\mathcal{V}| I(Ztext;X)≤Ltlog∣V∣
2. 视觉处理器:局部复合聚合
文本先被渲染为二维图像:
ϕ : X → R H × W \phi:X\rightarrow\mathbb{R}^{H\times W} ϕ:X→RH×W
视觉 Tokenizer 再把局部区域编码为视觉向量:
τ V : R H × W → Z v i s u a l = ( v 1 , ... , v L v ) , L v ≪ L t \tau_V: \mathbb{R}^{H\times W} \rightarrow Z_{\mathrm{visual}}=(v_1,\ldots,v_{L_v}), \qquad L_v\ll L_t τV:RH×W→Zvisual=(v1,...,vLv),Lv≪Lt
一个视觉 Patch 可以同时覆盖多个字符,并利用二维位置编码顺序和版面结构。因此,它不是词表中的原子条目,而是多个局部符号的复合表示。
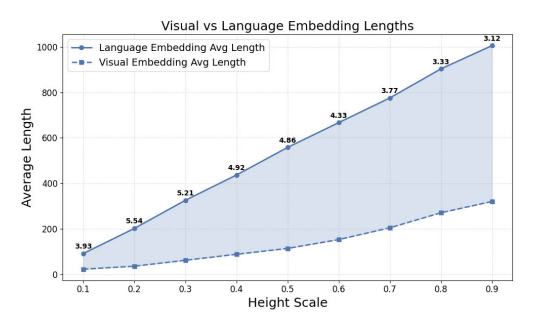
Figure 3:文本与视觉表示的平均长度。 随输入高度尺度增加,文本嵌入长度增长更快;图中标注的文本/视觉长度比约为 3.12--5.54。
作者由此提出:若任务相关信息近似保持不变,压缩比例为 k k k,则每个视觉 Token 的任务信息密度近似提高为:
I ( v ; Y ) ≈ k ⋅ I ( t ; Y ) I(v;Y)\approx k\cdot I(t;Y) I(v;Y)≈k⋅I(t;Y)
这是一种解释性分析,而不是严格证明。视觉压缩减少序列长度的同时必然形成信息瓶颈;任务表现能否保持,取决于被丢失的信息是否与问题相关。
3. 对检索的影响
文本 Passage 中每个查询 Token 的最大匹配为:
max 1 ≤ j ≤ L t ⟨ q i , p j ⟩ \max_{1\le j\le L_t}\langle q_i,p_j\rangle 1≤j≤Ltmax⟨qi,pj⟩
视觉记忆中变为:
max 1 ≤ j ≤ L v ⟨ q i , v j ⟩ \max_{1\le j\le L_v}\langle q_i,v_j\rangle 1≤j≤Lvmax⟨qi,vj⟩
如果一个 v j v_j vj 聚合了约 k k k 个文本 Token 的语义,它可能减少词元级碎片化,让查询与更完整的局部语义匹配。
但复合表示也可能把细粒度字符混淆,例如后面的案例中 black claws 被读成 black paws。压缩和信息保真并不是无条件兼得。
九、实验设置
1. LoCoMo
LoCoMo 包含最长 35 个 Session 的长期对话,每段对话平均有数百轮、约 26K Token,并配套约 200 个问题。
问题类型包括:
- Single Hop;
- Multi-Hop;
- Temporal;
- Open Domain。
论文排除了 Adversarial 类别,因为其中不可回答问题可能让没有记忆的模型偶然得到正确判定。
2. LongMemEval
LongMemEval 包含 500 个问题,每个问题对应一段平均约 115K Token 的超长对话。
它比 LoCoMo 更长,但目标陈述和干扰内容之间的连贯性较弱,记忆组织难度并不一定更高。
3. 基线
LoCoMo 上比较:
- Mem0 / Mem0g;
- A-MEM;
- LangMem;
- OpenAI Memory 风格基线;
- Zep;
- MemOS;
- MIRIX;
- Full-Context。
LongMemEval 还加入 Supermemory。
4. 模型与评估
为尽量公平,候选方法的 Backbone 统一替换为 GPT-4.1-mini,Judge 也使用 GPT-4.1-mini。
主要指标为 LLM-as-a-Judge:Judge 根据问题、标准答案和模型回答判断 CORRECT 或 WRONG。消融实验还报告 BLEU-1、F1、ROUGE-L、METEOR 和 SBERT。
基线按照官方实现只运行一次;VizoMem 运行三次并报告平均值。因此,基线没有同等的重复运行方差,比较的统计证据强度有限。
十、LoCoMo 主结果:视觉记忆能否保住准确率
1. 直接视觉检索与早期文本记忆方法
| 方法 | Single Hop | Multi-Hop | Open Domain | Temporal | Overall |
|---|---|---|---|---|---|
| Mem0 | 68.97 | 51.42 | 72.92 | 56.07 | 63.31 |
| Mem0g | 69.32 | 51.77 | 73.96 | 59.19 | 64.29 |
| A-MEM | 39.24 | 26.60 | 54.17 | 49.84 | 40.06 |
| LangMem | 70.27 | 57.09 | 55.21 | 56.39 | 64.03 |
| OpenAI | 61.24 | 58.87 | 62.50 | 24.92 | 53.31 |
| VizoMem DVR | 85.10 | 59.69 | 52.08 | 59.50 | 73.05 |
Table 1:LoCoMo 上 DVR 与第一组记忆基线。 DVR 在 Single Hop、Multi-Hop、Temporal 和 Overall 上取得该组最高分,但 Open Domain 明显低于 Mem0 与 Mem0g。
DVR 的 Single Hop 达到 85.10,比 Mem0g 高 15.78 个百分点。这说明原始 Session 渲染成图片后,ColGlyph 能非常有效地找到包含直接事实的页面。
但 Open Domain 只有 52.08,而 Mem0g 为 73.96。开放域问题往往需要从上下文推断未直接陈述的答案,DVR 只检索原始页面,缺少记忆抽象和关系连接。
2. 分层视觉记忆与强基线
| 方法 | Single Hop | Multi-Hop | Open Domain | Temporal | Overall |
|---|---|---|---|---|---|
| Zep | 80.26 | 71.99 | 70.83 | 82.87 | 78.70 |
| MemOS | 78.12 | 67.02 | 63.51 | 80.06 | 75.58 |
| MIRIX | 83.95 | 82.27 | 63.54 | 86.92 | 82.99 |
| VizoMem ViHM | 83.63 | 76.24 | 65.62 | 86.09 | 81.67 |
| Full-Context | 88.59 | 78.01 | 71.88 | 92.83 | 86.49 |
Table 1(续):LoCoMo 上 ViHM 与分层记忆基线。 ViHM 的 Overall 为 81.67,接近 MIRIX 的 82.99,同时在 Open Domain 上略高于 MIRIX;Multi-Hop 则从 82.27 降到 76.24。
这张表给出的结论不是"视觉记忆全面超过文本记忆",而是:将 MIRIX 的记忆内容换成视觉形式后,整体准确率下降 1.32 个百分点,但能显著降低 Token 开销。
Multi-Hop 是最明显的退化项,低 6.03 个百分点。多跳问题需要同时找回多个证据并正确组合;任何一次视觉读取或检索偏差都会沿推理链累积。
Full-Context 为 86.49,仍然是上限。LoCoMo 平均约 26K Token,可以直接放入模型窗口,所以视觉记忆在这里主要展示效率---准确率折中,而不是在无法输入全文的情况下取胜。
3. 三次运行稳定性
| 变体 | Run 1 | Run 2 | Run 3 | 平均值 |
|---|---|---|---|---|
| DVR Overall | 72.99 | 73.70 | 72.47 | 73.05 |
| ViHM Overall | 81.17 | 82.73 | 81.10 | 81.67 |
Table 7:VizoMem 三次独立运行的 Overall。 DVR 的三次结果范围为 72.47--73.70,ViHM 为 81.10--82.73,整体波动较小。
十一、Token 消耗:主要价值来自效率---准确率折中
| 方法 | Token Consumption | Overall |
|---|---|---|
| LangMem | 185 | 67.86 |
| OpenAI | 4,324 | 53.31 |
| Mem0 | 1,291 | 63.31 |
| DVR | 2,683 | 73.80 |
| MemOS | 1,731 | 75.58 |
| Zep | 2,231 | 78.70 |
| MIRIX | 18,803 | 82.99 |
| ViHM | 4,612 | 81.17 |
| Full-Context | 23,587 | 86.49 |
Table 2:LoCoMo Token 消耗与总体表现。 ViHM 使用 4,612 Token,约为 MIRIX 的 24.5%,而表中 Overall 只低 1.82 个百分点;Full-Context 准确率最高,但输入为 23,587 Token。
ViHM 相比 MIRIX 节省约 75.5% 的输入 Token,这是论文最有说服力的结果。
但需要指出,Table 2 与 Table 1 存在内部数字不一致:
- Table 1 的 DVR 三次平均 Overall 是 73.05,Table 2 写成 73.80;
- Table 1 的 ViHM 三次平均是 81.67,Table 2 使用 81.17,与 Run 1 相同。
论文没有解释 Table 2 是否来自不同统计批次。本文在性能分析中以明确标注三次平均的 Table 1 / Table 7 为准,在效率比较中保留 Table 2 原值。
LangMem 的 Token 最少,却只有 67.86,说明极小上下文并不自动意味着高质量记忆。Full-Context 最高,但无法扩展到数十万或百万 Token。VizoMem 的目标是位于两者之间:以较小准确率代价获得明显压缩。
十二、LongMemEval:更长上下文下视觉记忆是否仍然有效
| 方法 | Content Tokens | Preference | Assistant | Temporal | Multi-Session | Knowledge Update | User | Overall |
|---|---|---|---|---|---|---|---|---|
| MIRIX | --- | 46.7 | 60.7 | 23.3 | 24.8 | 61.5 | 72.9 | 42.2 |
| Zep | 1.7K | 60.0 | 73.2 | 54.9 | 44.4 | 71.8 | 87.1 | 61.8 |
| Supermemory | 1.5K | 86.7 | 51.8 | 50.4 | 57.1 | 62.8 | 81.4 | 60.8 |
| MemOS | 1.4K | 93.3 | 66.1 | 71.4 | 69.9 | 73.1 | 94.3 | 75.2 |
| DVR | 0.9K | 63.3 | 26.8 | 58.7 | 66.9 | 79.5 | 98.6 | 66.4 |
| ViHM | 0.4K | 90.0 | 44.6 | 68.4 | 69.2 | 75.6 | 90.0 | 71.4 |
| Mem0 | 1.1K | 90.0 | 46.4 | 69.2 | 70.7 | 73.1 | 88.6 | 71.6 |
Table 8:LongMemEval 结果。 ViHM 用 0.4K Content Token 获得 71.4 Overall,几乎追平其文本架构基础 Mem0 的 71.6;MemOS 以 75.2 获得最高总体成绩,但使用 1.4K Token。
在 LongMemEval 上,作者没有使用 MIRIX 作为 ViHM 基础,而是选择第二名 Mem0。原因是表现最好的 MemOS 涉及 KV Cache 和参数级记忆,难以直接替换成视觉表示。
这也说明 ViHM 不是一套固定架构,而是一种"把当前可视觉化的文本记忆模块换成视觉笔记"的适配策略。
DVR 在 Knowledge Update 和 Single-Session User 类别表现最好,但 Assistant 类只有 26.8。ViHM 通过信息提取和结构化组织显著改善总体结果,却仍没有超过 MemOS。
十三、推理延迟与记忆构建成本
1. 长上下文推理延迟
| 上下文规模 | Glyph-Visual | Render | Glyph-Text | Qwen3-8B |
|---|---|---|---|---|
| ≈1K | 3.71s | 0.15s | 2.71s | 0.74s |
| ≈10K | 5.17s | 0.54s | 5.99s | 4.41s |
| ≈50K | 7.85s | 2.32s | 8.83s | 27.41s |
| ≈75K | 8.58s | 3.48s | 16.02s | 56.09s |
| ≈100K | 10.27s | 4.54s | 21.85s | 84.58s |
Table 3:不同上下文长度下的延迟。 在约 100K Token 时,Glyph-Visual 为 10.27 秒,Glyph-Text 为 21.85 秒,Qwen3-8B 为 84.58 秒;视觉路径的延迟增长更平缓。
1K 输入时,视觉方案并不占优:Glyph-Visual 的 3.71 秒高于 Qwen3-8B 的 0.74 秒。视觉编码存在固定成本,只有上下文足够长时,压缩收益才覆盖这部分开销。
Table 3 单独列出 Render 时间,但正文称 10.27 秒"包括 rendering"。表头和描述之间不够清楚,无法确定是否应再把 4.54 秒加到 Glyph-Visual 上。因此,这组延迟更适合说明增长趋势,而不是作为严格端到端系统基准。
2. 记忆构建 Token
| 数据集 | 压缩前 → 压缩后 | 节省比例 |
|---|---|---|
| LongMemEval | ≈252.12M → ≈102.86M | 59.2% |
| LoCoMo | ≈4.47M → ≈1.92M | 57.0% |
Table 4:记忆构建阶段的 Token 使用量。 将文本记忆转为视觉输入后,LongMemEval 和 LoCoMo 的构建 Token 分别减少 59.2% 和 57.0%。
这说明视觉压缩不仅减少最终问答时的输入,也能降低构建、抽取和更新记忆时 VLM 需要处理的序列长度。
但图片生成、图片存储、视觉编码和向量索引也会产生成本。论文主要报告 Token 和延迟,没有给出磁盘占用、GPU 显存、索引规模及总费用。
十四、消融实验:专用检索器与对齐机制分别贡献多少
| 方法 | LLM-Judge | BLEU-1 | F1 | ROUGE-L | METEOR | SBERT |
|---|---|---|---|---|---|---|
| ColGlyph + Alignment | 0.738 | 0.433 | 0.513 | 0.518 | 0.382 | 0.698 |
| w/o Alignment | 0.719 | 0.420 | 0.497 | 0.497 | 0.369 | 0.671 |
| w/o ColGlyph(ColQwen2)& Alignment | 0.693 | 0.403 | 0.489 | 0.494 | 0.355 | 0.673 |
Table 5:ColGlyph 与 Alignment 消融。 用通用 ColQwen2 替换 ColGlyph 并去掉对齐后,LLM-Judge 从 0.738 降到 0.693;只去掉 Alignment 则降到 0.719。
ColGlyph 带来的提升更大,说明专门针对文本渲染图像训练检索空间是核心;Alignment 是进一步校准,不是主要能力来源。
不同自动指标的趋势基本一致。不过,w/o Alignment 的 SBERT 为 0.671,而同时去掉 ColGlyph 和 Alignment 为 0.673,后者反而略高。这说明个别自动指标并没有严格单调支持所有模块,不能只用"所有指标一致提升"概括结果。
十五、图片大小与 DPI:视觉记忆不是越大越清楚
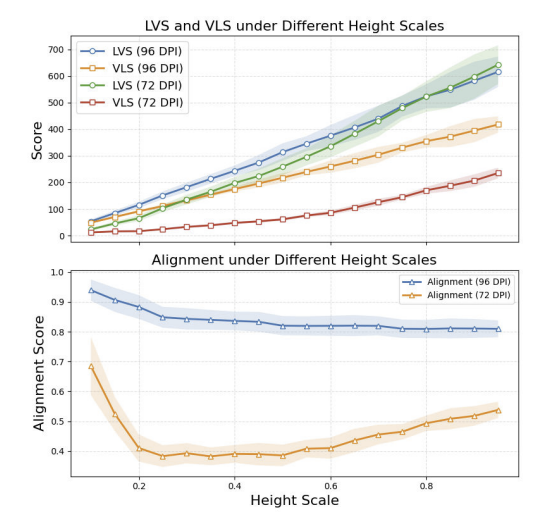
Figure 4:图片尺度、DPI 与 Alignment Score。 上图展示两个方向相似度随图片高度增大而增长,下图显示跨模态一致性总体下降;72 DPI 的得分明显低于且不如 96 DPI 稳定。
直觉上,图片越大、分辨率越高,文字应该越容易识别。但检索需要的不只是视觉可读性,还要求视觉塔和语言塔在同一个表示空间中保持一致。
随着页面尺度变化:
- 视觉 Token 数量和局部布局改变;
- 两个方向的 Late Interaction 得分增长速度不同;
- 低 DPI 会引入更明显的字形模糊;
- Alignment Score 因双向差异而下降。
因此,VizoMem 的性能依赖渲染分布。若生产环境随意切换字体、字号、DPI 或页面宽度,训练好的 ColGlyph 可能发生分布偏移。
十六、失败案例:视觉记忆在哪里丢失信息
1. 超长小说中的字符级混淆
作者使用约 130 万词、约 170 万文本 Token 的《冰与火之歌》做定性测试。即使视觉化后仍有近 60 万视觉 Token,因此必须先检索再问答。
三个问题中出现两类错误:
- 将 Ghost 的
black claws回答为black paws; - 在 Eddard Stark 死亡相关问题中,把 Lady Olenna Tyrell 错误拼接进答案,并生成虚构描述。
前者可能来自渲染或视觉编码造成的细粒度文字损失;后者则是检索证据与生成模型之间的错误组合。
这说明视觉记忆在事实级问答中不仅会"找不到",也可能"看错字"和"拼错关系"。
2. DVR:保留原话,但无法连接分散证据
LoCoMo 多跳案例询问 Caroline 四年前从哪里搬来。
一条证据说:
我认识这些朋友四年了,从我的祖国搬来以后。
另一条证据说:
这是祖母从我的祖国瑞典送的礼物。
DVR 找到了第一条,却没有把 home country 与 Sweden 连接起来,只回答"从她的祖国搬来"。
3. ViHM:建立连接,但摘要可能制造错误
ViHM 能通过 Core Memory 和 Knowledge Vault 将两条证据绑定,正确回答 Sweden。
但分层记忆也会过度抽象:
- Single-Hop 中,"为了吸引目光、让人微笑"被合并成"表达情感与创造力",丢失直接答案;
- Open Domain 中,将 policymaking、education、infrastructure 强行组合,错误推断学位是 mechanical engineering;
- Temporal 中,
a few years ago被认为不重要并丢弃,最后回答没有具体时间。
4. 两种变体的核心权衡
| 变体 | 优势 | 主要失败模式 |
|---|---|---|
| DVR | 保留原始措辞,Single Hop 强 | 跨 Session 关系不足,多跳证据连接失败 |
| ViHM | 能抽象、合并并连接证据 | 过度摘要、错误合并、模糊时间信息丢失 |
Table 10:DVR 与 ViHM 的案例差异。 原始视觉检索更忠于局部事实,分层视觉记忆更擅长跨片段整合,但会引入记忆演化本身的信息损失和错误推断。
这类失败并非视觉模态独有。文本 Agent Memory 同样会在摘要和合并中丢失信息;VizoMem 又额外增加了图像渲染和视觉读取误差。
十七、与已有 Agent Memory 方法的横向比较
| 方法 | 主要记忆单位 | 核心解决问题 | 与 VizoMem 的关键差异 |
|---|---|---|---|
| A-MEM | 文本笔记及动态链接 | 让离散记忆形成可演化网络 | VizoMem 改变笔记介质,可与链接结构结合 |
| MAGMA | 多维记忆图 | 联合建模语义、时间、因果等关系 | MAGMA 关注关系组织,VizoMem 关注底层表示密度 |
| CoM | 压缩后的上下文记忆 | 从长历史中保留高价值文本 | CoM 在语言空间压缩,VizoMem 转入视觉空间压缩 |
| ReMemR1 | 可回访历史记忆 | 写入时回看过去,减少不可逆遗漏 | ReMemR1 改进形成过程,VizoMem 改进存储与读取介质 |
| Mem²Evolve | 可持续演化的记忆 | 根据反馈更新记忆内容和结构 | VizoMem 可承载演化结果,但自身不提出新的演化学习目标 |
| TokMem | 一个程序对应一个向量 Token | 程序性记忆的紧凑调用与组合 | TokMem 压缩技能控制信号,VizoMem 压缩可读文本内容 |
| Skill-Pro | 显式可执行技能 | 从交互中生成、验证并淘汰技能 | Skill-Pro 学习程序,VizoMem 可将程序说明渲染成视觉记忆 |
| VizoMem | 文本渲染的视觉笔记 | 降低长期记忆存储、构建与推理 Token | 不重新定义记忆内容,主要改变表示层和检索器 |
VizoMem 是一种横向能力:它理论上可以与多种文本型 Memory Architecture 结合。论文已经用 MIRIX 和 Mem0 展示了这种替换,但没有证明所有记忆类型都适合视觉化。
例如,凭证、JSON、代码和需要精确字符匹配的内容可能更适合结构化文本存储,而叙事型对话和长文档更适合视觉压缩。
十八、对 Coding Agent、Tool Agent 与 Multi-Agent 的启发
以下内容是基于论文机制的工程推演,不是论文已经完成的实验。
1. Coding Agent:将长文档和日志保存为视觉 Resource Memory
Coding Agent 经常处理:
- 大型设计文档;
- 长测试日志;
- 构建报告;
- API 文档;
- 历史 Issue 和代码审查记录。
这类内容可以按页面渲染为视觉 Resource Memory,先通过 ColGlyph 式检索定位相关页面,再交给 VLM 阅读。
但源代码、堆栈地址、变量名和补丁属于字符精度敏感内容。claws→paws 的案例说明,不能只保留视觉版本。更安全的设计是:视觉表示用于粗召回,命中后回到原始文本或文件行做精确读取。
2. Tool Agent:视觉记忆适合说明书,不适合凭证
工具使用手册、网页帮助文档和复杂表格适合保留页面布局,视觉检索可能比纯文本切块更好。
但 API Key、函数名、参数 Schema 和配置值应保留结构化原文。视觉 Knowledge Vault 一旦发生单字符错误,可能直接造成调用失败或安全问题。
3. Multi-Agent:共享视觉记忆库
不同 Agent 可以共享同一视觉 Memory Bank:
- 检索 Agent 负责定位相关视觉笔记;
- 阅读 Agent 负责提取事实;
- 验证 Agent 回查原始文本;
- 规划 Agent 使用结构化结果决策。
图像作为统一介质有利于跨语言和跨模型共享,但不同 VLM 的视觉阅读能力差异可能导致同一记忆被不同 Agent 解读成不同事实。
4. 双轨记忆比纯视觉替换更可靠
一个更稳妥的生产架构是:
text
原始文本 / 结构化数据:事实来源与精确回查
              ↓
视觉笔记:压缩表示与高效粗检索
              ↓
Alignment Score:跨模态置信度
              ↓
命中视觉笔记后回查原文:精确回答与引用
VizoMem 当前主要让 VLM直接基于图片回答。若加入原文回查,可以同时利用视觉压缩的召回效率和文本的字符级精度。
十九、论文局限性
1. 视觉记忆不能完全替代结构化操作
作者明确承认,记忆分类、合并、替换、跳过以及不同模块协调仍依赖文本 Schema、Prompt 或 LLM 工具调用。视觉化主要替换存储内容,并没有让整个 Memory OS 都转为视觉计算。
2. 仍然是文本中心,而非通用多模态记忆
所有图片都由纯文本渲染而来。论文没有处理真实照片、音频、视频、传感器流以及它们与文本记忆的共同索引。
3. 依赖 LLM-as-a-Judge
主结果由 GPT-4.1-mini 判断 CORRECT / WRONG。即使使用统一 Prompt,Judge 仍可能存在偏差和方差。自动指标只在消融中完整报告,主表没有同时给出人工评价。
4. 基线与 VizoMem 的重复次数不一致
基线只运行一次,VizoMem 运行三次。没有统一重复试验、置信区间和显著性检验,因而无法严格判断 1--2 个百分点差距是否可靠。
5. 多跳推理仍然是明显短板
ViHM 在 LoCoMo Multi-Hop 上比 MIRIX 低 6.03 个百分点。视觉读取误差、检索误差和证据组合误差会沿推理链累积。
6. 渲染参数敏感
DPI、图片尺寸、字体和换行都会影响跨模态一致性。ColGlyph 在固定 96 DPI 分布上训练,对不同语言、特殊符号、小字号代码和复杂排版的泛化尚未验证。
7. 缺少完整系统成本
论文报告 Token 和部分延迟,但没有系统比较:
- 图片文件磁盘占用;
- 视觉嵌入索引体积;
- 写入时渲染与编码吞吐;
- GPU 显存;
- 端到端美元成本;
- 视觉笔记更新后的重编码成本。
8. Table 2 存在数字不一致
Table 2 的 DVR/ViHM Overall 与三次运行平均不一致,延迟表对 Render 是否包含在 Glyph-Visual 中也不够明确。这降低了效率数字的可复核性。
9. 字符级精度和事实拼接风险
超长小说案例已经出现词级混淆和虚构关系拼接。对法律、医疗、配置、代码等高风险内容,视觉版本不能作为唯一事实来源。
二十、我的理解与启发
1. VizoMem 的价值是"换介质",不是"换结构"
很多 Agent Memory 论文改进记忆生命周期中的某个决策:写什么、如何合并、怎样链接、何时删除。
VizoMem 的特别之处在于,它改的是更底层的表示介质:同一条记忆不再必须以语言 Token 形式被保存和消费。
这使它可以作为 A-MEM、MIRIX、Mem0 等架构的插件,而不必替代它们的上层逻辑。
2. 图片在这里更像一种压缩编码,而不是传统"视觉内容"
VizoMem 的图片没有新增原始文本之外的信息。它的作用类似一种能被 VLM原生读取的二维压缩编码:
- 字体形状编码字符;
- 二维位置编码顺序和布局;
- 视觉 Patch 聚合多个语言单位;
- VLM 负责解码并推理。
因此,评价它时不应只问"VLM 看图能力强不强",还要问这种有损编码保留了哪些任务相关信息。
3. Alignment Score 是记忆级质量控制信号
Alignment 不只可以用于检索降权,还可以扩展为写入质量门:
- Alignment 太低时重新渲染;
- 尝试更高 DPI 或更小字号密度;
- 将低置信度记忆保留为文本;
- 回答时触发原文复核。
论文当前只用它调整排名,但它实际上提供了一种判断"这条记忆是否适合视觉化"的信号。
4. 最合理的设计不是全视觉,而是按记忆类型选择介质
不同内容对精度和压缩的需求不同:
| 记忆内容 | 更合适的介质 |
|---|---|
| 长对话、文档、历史日志 | 视觉笔记 + 原文回查 |
| 用户偏好、概念摘要 | 文本或视觉均可 |
| 程序流程 | 显式文本技能、代码或 TokMem Token |
| API Key、ID、时间、数值 | 结构化数据库 / 原始文本 |
| 图片、截图、视频帧 | 原生多模态记忆 |
VizoMem 的真正启发不是"全部转图片",而是 Agent Memory 不必被单一 Token 介质限制。
5. DVR 与 ViHM 揭示了记忆系统中的经典矛盾
DVR 忠于原始证据,却不擅长跨片段连接;ViHM 形成抽象关系,却会丢失细节甚至制造错误。
这与视觉表示无关,是所有长期记忆系统都会遇到的矛盾:
记忆越原始,越准确但越难推理;记忆越抽象,越容易复用但越可能失真。
理想系统需要让摘要节点始终链接回原始证据,回答时根据风险决定是否回溯。
6. 下一步应该是可验证的视觉记忆
未来可以为每条视觉笔记保留:
- 原始文本哈希与位置;
- 渲染参数;
- Alignment Score;
- OCR 回读结果;
- 被问答引用的区域;
- 回查原文后的验证状态。
这样,视觉记忆就不只是节省 Token 的图片库,而是具有来源、置信度和可追溯性的长期记忆层。
二十一、总结
VizoMem 将文本渲染图像从一次性的长上下文压缩格式,提升为 Agent 可以持续写入、分层管理和按需检索的长期记忆单元。
它的完整流程包括:
- 将新文本信息按照固定版式渲染为视觉笔记;
- 使用基于 Glyph 构建的 ColGlyph 编码文本查询和视觉记忆;
- 通过 Token 级 MaxSim 实现细粒度 Late Interaction 检索;
- 使用双向图文一致性 Alignment Score 降低跨模态错位;
- 以 DVR 直接检索原始 Session,或将视觉笔记接入 MIRIX/Mem0 式分层记忆;
- 最终只将少量相关图片交给 VLM 回答。
实验表明,ViHM 在 LoCoMo 上以 4,612 Token 达到约 81.67 的三次平均 Overall,接近 MIRIX 的 82.99,而 MIRIX 使用 18,803 Token;在 LongMemEval 上,ViHM 只使用 0.4K Content Token,取得 71.4,几乎追平 Mem0 的 71.6。
但视觉记忆不是无损替换:LoCoMo 多跳推理明显下降;超长小说案例出现字符混淆和事实拼接幻觉;ViHM 的摘要合并还会丢失时间与原始动机。论文的主评估依赖 LLM Judge,基线只运行一次,部分结果表也存在数字不一致。
最后用一句话概括本文:
VizoMem 证明了 Agent Memory 不必永远以文本 Token 为基本介质:将文本组织成可检索的视觉笔记,可以用少得多的上下文承载长期记忆,但真正可靠的系统仍需要保留结构化操作、原文追溯和跨模态质量校验。
参考资料
- VizoMem: A Visual-Textual Memory Framework for Efficient Long-Horizon Reasoning
- VizoMem 正式论文 PDF
- Cheng et al. Glyph: Scaling Context Windows via Visual-Text Compression, 2025.
- Faysse et al. ColPali: Efficient Document Retrieval with Vision Language Models, 2025.
- Maharana et al. Evaluating Very Long-Term Conversational Memory of LLM Agents, ACL 2024.
- Wu et al. LongMemEval: Benchmarking Chat Assistants on Long-Term Interactive Memory, ICLR 2025.
- Xu et al. A-MEM: Agentic Memory for LLM Agents, 2025.
- Wang and Chen. MIRIX: Multi-Agent Memory System for LLM-Based Agents, 2025.