为什么要做数据清洗?因为真实数据都是脏的。有空值、有重复、有格式不对的、有错别字。直接拿脏数据分析,结果肯定不靠谱。这是数据分析里最花时间的一步,但也是最基础的一步。
🍃 这么说吧------数据清洗就像洗菜。菜上有泥、有烂叶子、有虫子,你不能直接下锅。得先洗干净了,炒出来的菜才能吃。数据分析也是一个道理。
今天这篇,咱们用一份"个人账单"数据当例子,把最常见的四类脏数据问题一次性讲透:
- 缺失值(空值)
- 重复值
- 数据类型不对
- 字符串格式乱
每一种都告诉你:怎么发现、怎么处理、什么时候用哪种方法。
一、先造一份脏数据,跟着练
光说不练假把式。咱们先自己造一份有各种问题的账单数据,你可以把下面这段代码复制到 Jupyter 或者 Python 文件里跑一下。
python
import pandas as pd
import numpy as np

# 造一份脏数据------模拟真实场景下的个人账单
data = {
    '日期': ['2024-01-05', '2024/01/06', '2024-01-07', '2024-01-08',
            '2024/01/09', '2024-01-10', '2024-01-05', '2024-01-11',
            '2024-01-12', '2024-01-13'],
    '类别': ['餐饮 ', '餐饮', ' 交通', '购物', '餐饮', '娱乐',
            '餐饮 ', ' 交通 ', '购物', np.nan],
    '金额': ['¥35.5', '¥128', '¥15.00', '¥299', '88元',
            '¥56.8', '¥35.5', '¥20', '¥199.9', '¥66'],
    '支付方式': ['微信', '支付宝', '微信', np.nan, '微信',
               '支付宝', '微信', '微信', '银行卡', '微信'],
    '备注': ['午餐', '火锅', '地铁', np.nan, '奶茶',
            '电影票', '午餐', '打车', '衣服', '超市']
}

df = pd.DataFrame(data)
print("原始脏数据:")
print(df)
跑出来你会看到这份数据里藏了好几个坑:
- 日期格式不统一 :有的是
2024-01-05,有的是2024/01/06 - 类别列有空格 :
'餐饮 '和'餐饮'看起来一样,但实际不一样 - 金额是字符串 :还带了
¥符号,甚至有一个写的是'88元' - 有缺失值:支付方式、类别、备注里都有空值
- 有重复行:第7行和第1行(索引0和6)几乎一模一样,就是重复录入了
真实工作中你拿到的 Excel、CSV,大概率比这个还脏。
咱们一个一个来收拾。
二、第一类问题:缺失值(空值)
缺失值就是数据里缺了一块,Pandas 里一般显示为 NaN 或者 None。
1. 怎么发现缺失值
先看看每列缺了多少个:
python
# 查看每列缺失值数量
print(df.isnull().sum())
输出大概长这样:
日期      0
类别      1
金额      0
支付方式    1
备注      1
dtype: int64df.isnull()会把整个表格变成 True/False,空的地方就是 True.sum()把每列的 True 加起来,就是缺失的数量
还可以用 df.info() 一次性看整体情况:
python
df.info()2. 处理方式一:直接删除
如果缺失的很少,而且那一列不是特别关键,可以直接删掉。
python
# 删除所有包含空值的行
df_drop = df.dropna()
⚠️ 注意 :dropna() 不会改变原来的 df,它返回一个新的 DataFrame。你得赋值回去,或者加 inplace=True。
python
# 方式1:赋值回去
df = df.dropna()

# 方式2:inplace=True 直接修改原数据
df.dropna(inplace=True)
还可以按列删,或者只删全是空的行:
python
# 删除整行都是空的
df.dropna(how='all')

# 删除指定列有空值的行
df.dropna(subset=['支付方式'])
什么时候用删除? 缺得很少(比如1000条里缺了3条)、删掉不影响整体分析的时候。
3. 处理方式二:填充值
有时候不能删,得填上。比如金额列缺了,你可以填0;类别缺了,可以填"其他"。
python
# 全部空值填成0
df.fillna(0)

# 全部空值填成"未知"
df.fillna('未知')
4. 处理方式三:按列分别处理
实战中一般不会所有列都用同一种方式填,而是一列一列来:
python
# 字典形式,指定每列填什么
df_filled = df.fillna({
    '类别': '其他',
    '支付方式': '未知',
    '备注': '无备注'
})
这样更合理------类别缺了就归到"其他",支付方式缺了就标"未知",备注缺了就写"无备注"。
5. 进阶玩法
用前一个值填充(向前填充):
python
# 前面的值是什么,空的就填什么
df.ffill()  # 或者 df.fillna(method='ffill')
这个适合时间序列数据,比如前一天的温度是空的,就用后一天的补上。
用平均值/中位数填充:
python
# 注意:金额现在还是字符串,转成数字之后才能算均值
# 先转成数字(后面会讲),然后:
df['金额'].fillna(df['金额'].mean())
数值型数据缺了,用均值或者中位数填,也是很常见的做法。
三、第二类问题:重复值
重复值就是同一行数据出现了好几次。常见于手动录入、多次导入合并的时候。
1. 怎么发现重复值
python
# 看有多少行重复
print(df.duplicated().sum())

# 把重复的行显示出来
df[df.duplicated(keep=False)]duplicated()返回每一行是不是重复的(True/False)keep=False表示把所有重复的都标出来,默认只标第一次出现之后的
2. 怎么删除重复值
python
# 删除完全重复的行
df_unique = df.drop_duplicates()
和 dropna() 一样,默认不会改原数据,要赋值回去或者加 inplace=True。
3. 按指定列去重
有时候不是整行都重复,而是某几列重复就算重复。比如同一天同一金额的账单,可能就是录重了。
python
# 按"日期"和"金额"两列来去重
df.drop_duplicates(subset=['日期', '金额'], keep='first')subset指定按哪些列判断重复keep='first'保留第一次出现的,删掉后面的keep='last'保留最后一次的keep=False重复的全删掉
四、第三类问题:数据类型不对
这个是新手最容易踩坑的地方。看着像数字,但其实是字符串,一算就报错。
咱们这份数据里,金额列带了 ¥ 符号,肯定是字符串类型。先确认一下:
python
print(df.dtypes)你会看到金额列是 object 类型(Pandas 里字符串就是 object),日期列也是 object。
1. 金额列:字符串转数字
首先得把 ¥ 符号和 元 字去掉,然后再转成数字。
python
# 去掉¥符号
df['金额'] = df['金额'].str.replace('¥', '', regex=False)

# 去掉"元"字
df['金额'] = df['金额'].str.replace('元', '', regex=False)

# 转成浮点数
df['金额'] = df['金额'].astype(float)
⚠️ 新手常见坑 :如果数据里有奇怪的字符(比如 '待定'、'--' 这种),直接 astype(float) 会报错。这时候用 pd.to_numeric() 更安全:
python
# 转不了的就变成空值(NaN)
df['金额'] = pd.to_numeric(df['金额'], errors='coerce')
errors='coerce' 的意思是------转不了就拉倒,给我变成空值。后面再统一处理空值就行。
2. 日期列:字符串转日期类型
python
df['日期'] = pd.to_datetime(df['日期'], format='mixed')Pandas 的 to_datetime() 能识别 2024-01-05 和 2024/01/06 这种混合格式,新版 Pandas(3.x)需要加 format='mixed' 告诉它不要纠结格式。
转换完再检查一下:
python
print(df.dtypes)
print("---")
print(df['日期'].dt.year.head())  # 现在可以直接取年份了
看到日期列变成 datetime64[ns] 类型,金额列变成 float64,就对了。
五、第四类问题:字符串规整
字符串的问题五花八门------前后有空格、大小写不一致、格式乱七八糟。Pandas 的 str 系列方法就是专门干这个的。
1. 去空格
python
# 去掉前后空格
df['类别'] = df['类别'].str.strip()

# 只去左边空格  str.lstrip()
# 只去右边空格 str.rstrip()咱们的账单数据里,'餐饮 ' 和 ' 交通 ' 这种,strip 之后就变成正常的 '餐饮'、'交通' 了。
2. 统一大小写
英文列很常用,比如类别如果是 'Food'、'food'、'FOOD' 混着来,先统一了再说:
python
# 全部转小写
df['类别'] = df['类别'].str.lower()

# 全部转大写
df['类别'] = df['类别'].str.upper()
3. 替换内容
前面转金额的时候已经用过了,就是 str.replace():
python
# 把"¥"换成空
df['金额'] = df['金额'].str.replace('¥', '', regex=False)
⚠️ 注意:Pandas 新版本里 replace 默认是正则表达式模式,如果你就是想替换普通字符串,加上 regex=False 更安全。
4. 字符串分列
比如你想把"2024-01-05"拆成年、月、日三列,或者从"2024-01"里提取年和月。
python
# 先确保是字符串,然后用 split 拆分
df['年'] = df['日期'].dt.year   # 日期类型直接取年更方便
df['月'] = df['日期'].dt.month

# 如果是纯字符串列,比如"2024-01"这种格式:
# df[['年', '月']] = df['年月'].str.split('-', expand=True)
expand=True 的意思是把拆分结果展开成多列,而不是变成一个列表。
六、完整清洗流程演示
上面是拆开来一个一个讲,现在咱们从头到尾完整走一遍。从最脏的原始数据,到最后干干净净的成品。
python
import pandas as pd
import numpy as np

# ========== 第一步:读取数据 ==========
data = {
    '日期': ['2024-01-05', '2024/01/06', '2024-01-07', '2024-01-08',
            '2024/01/09', '2024-01-10', '2024-01-05', '2024-01-11',
            '2024-01-12', '2024-01-13'],
    '类别': ['餐饮 ', '餐饮', ' 交通', '购物', '餐饮', '娱乐',
            '餐饮 ', ' 交通 ', '购物', np.nan],
    '金额': ['¥35.5', '¥128', '¥15.00', '¥299', '88元',
            '¥56.8', '¥35.5', '¥20', '¥199.9', '¥66'],
    '支付方式': ['微信', '支付宝', '微信', np.nan, '微信',
               '支付宝', '微信', '微信', '银行卡', '微信'],
    '备注': ['午餐', '火锅', '地铁', np.nan, '奶茶',
            '电影票', '午餐', '打车', '衣服', '超市']
}
df = pd.DataFrame(data)
print("【清洗前】共", len(df), "条数据")
print(df)
print()

# ========== 第二步:去重 ==========
# 先去重,因为重复行后面处理也是白忙活
df = df.drop_duplicates()
print("【去重后】还剩", len(df), "条数据")
print()

# ========== 第三步:字符串规整 ==========
# 类别列去空格
df['类别'] = df['类别'].str.strip()

# 金额列清理符号
df['金额'] = df['金额'].str.replace('¥', '', regex=False)
df['金额'] = df['金额'].str.replace('元', '', regex=False)
print("【字符串规整后】")
print(df[['类别', '金额']].head())
print()

# ========== 第四步:类型转换 ==========
# 金额转数字
df['金额'] = pd.to_numeric(df['金额'], errors='coerce')

# 日期转日期类型
df['日期'] = pd.to_datetime(df['日期'], format='mixed')
print("【类型转换后】各列类型:")
print(df.dtypes)
print()

# ========== 第五步:处理缺失值 ==========
# 金额列有空值填0
df['金额'] = df['金额'].fillna(0)

# 类别列空值填"其他"
df['类别'] = df['类别'].fillna('其他')

# 支付方式填"未知"
df['支付方式'] = df['支付方式'].fillna('未知')

# 备注填"无"
df['备注'] = df['备注'].fillna('无')

print("【缺失值处理后】空值数量:")
print(df.isnull().sum())
print()

# ========== 第六步:看看最终成果 ==========
print("=" * 50)
print("【清洗完成!最终数据】")
print(df)
你可以完整跑一遍这段代码,看着数据一步一步变干净,还是挺有成就感的 🍃
真实运行效果
把上面的完整清洗流程代码直接跑一遍,终端输出如下,能看到数据是怎么一步一步变干净的:
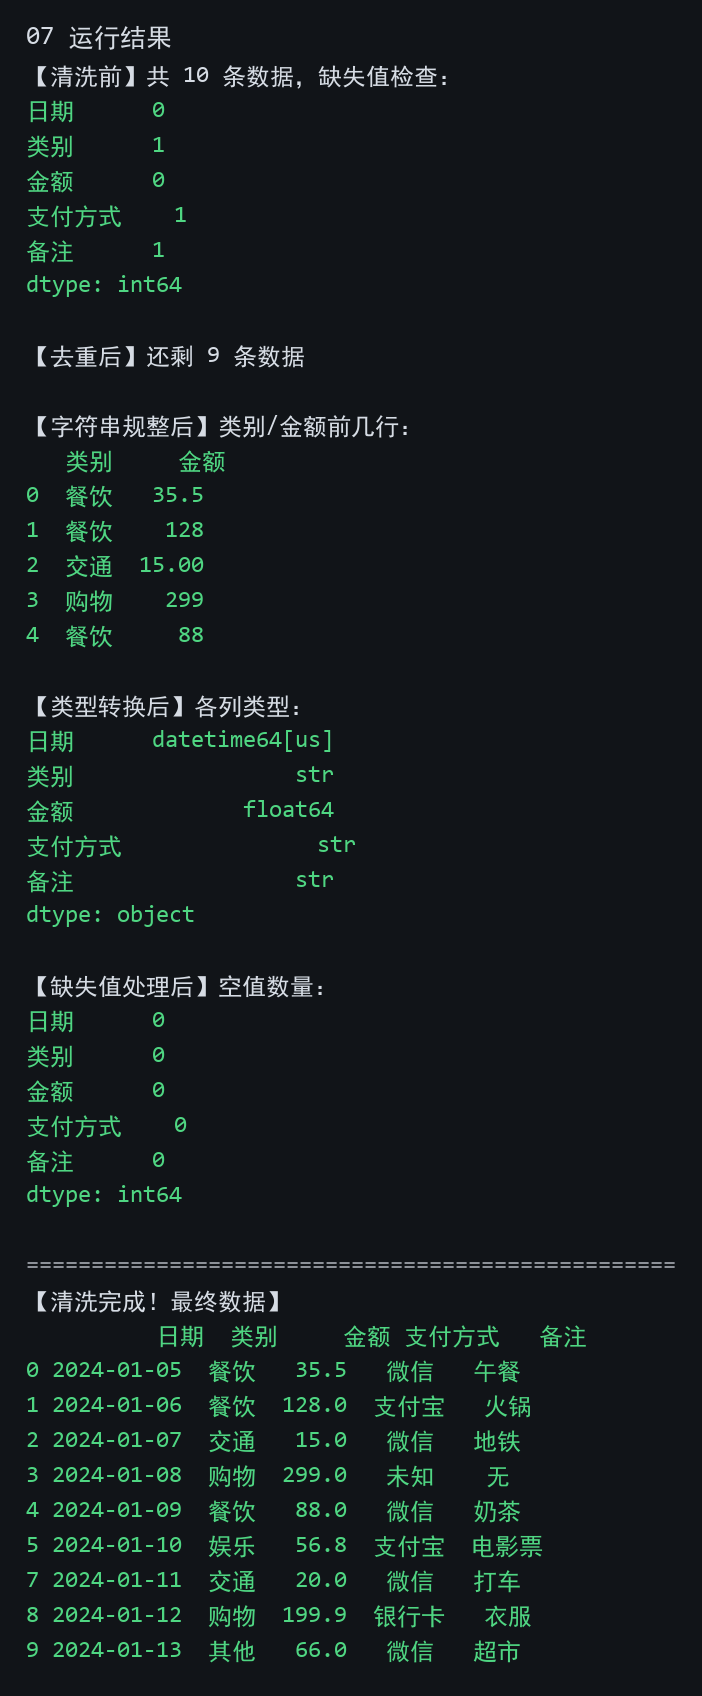
截图里依次是:清洗前各类空值统计、去重后 10 条变 9 条、金额列转成 float64 / 日期转成 datetime64、补完后空值全部归零,最后是 9 条干干净净的账单。
七、清洗后的检查
洗完了不能直接就拿去分析,得验一验干不干净。
三查原则
一查类型对不对:
python
df.info()看看每列的类型是不是你想要的------金额是数字、日期是 datetime、分类是字符串或者 category。
二查还有没有空值:
python
df.isnull().sum()全部是0就说明没空值了。
三查肉眼看几行:
python
df.head(10)就直接打印前10行,用眼睛扫一遍,有时候明显的问题一眼就能看出来。
八、新手最容易踩的三个坑
坑1:操作完忘了赋值
python
# ❌ 错的------dropna 返回了新的 DataFrame,但你没接住
df.dropna()

# ✅ 对的------赋值回去
df = df.dropna()

# ✅ 或者用 inplace
df.dropna(inplace=True)
Pandas 里绝大多数操作都是返回新对象,不改变原数据。新手经常写完 df.dropna() 就以为搞定了,结果后面一看原数据一点没变。
坑2:清洗顺序搞错了
先去重还是先补空?这个顺序很重要。
举个例子:两行数据几乎一样,但其中一行某个列是空的。如果你先补空,这两行就变得完全一样了,去重的时候会删掉一条。但如果你先去重,空的那行可能就被保留下来了,补空之后数据还是一条。
一般建议:先去重 → 再类型转换 → 最后补空值。
原因很简单:重复的行处理了也是白处理,先干掉省得后面白费功夫。类型转换可能会产生新的空值(errors='coerce'),所以补空放在最后。
坑3:类型转换失败不知道怎么办
python
# ❌ 如果数据里有奇怪的字符,会直接报错
df['金额'].astype(float)

# ✅ 用 to_numeric + errors='coerce',转不了的变空值,后面再处理
df['金额'] = pd.to_numeric(df['金额'], errors='coerce')真实数据里什么妖魔鬼怪都有------'--'、'待定'、'N/A'、甚至空格。用 errors='coerce' 先统一转成空值,再按缺失值的思路处理,就稳了。
九、小结一下
今天这篇讲了数据清洗的四大类问题:
| 问题类型 | 怎么发现 | 怎么处理 |
|---|---|---|
| 缺失值 | isnull().sum() |
删除 dropna() / 填充 fillna() / 按列分别填 |
| 重复值 | duplicated().sum() |
drop_duplicates() / 按指定列去重 |
| 类型不对 | dtypes / info() |
astype() / pd.to_numeric() / pd.to_datetime() |
| 字符串乱 | 肉眼看 / 去重时发现 | str.strip() / str.replace() / str.lower() / 分列 |
记住一个口诀:先去重,再转类型,最后补空值。
数据清洗这东西说难不难,就是琐碎。但这一步做扎实了,后面的分析才能靠谱。就像做饭------菜洗干净了,怎么炒都不会太差。
下一篇我们讲分组统计------groupby 怎么用,怎么按类别算出每一类花了多少钱。
梅雅达编程工作室 · Python数据实战系列第7篇
清洗看着琐碎,但数据干不干净,决定后面的分析靠不靠谱。这一步值得多花点时间。