一,理解硬件
机械硬盘(Hard Disk Drive,简称 HDD)是一种基于磁存储原理的非易失性数据存储设备,通过磁头在高速旋转的磁性盘片上读写数据,是计算机发展史上最经典、应用最广泛的存储介质之一。相比固态硬盘(SSD),HDD 以单位容量成本低、总容量大、数据可恢复性强等优势,至今仍是大容量数据存储场景的主流选择。
1.1,磁盘的存储结构
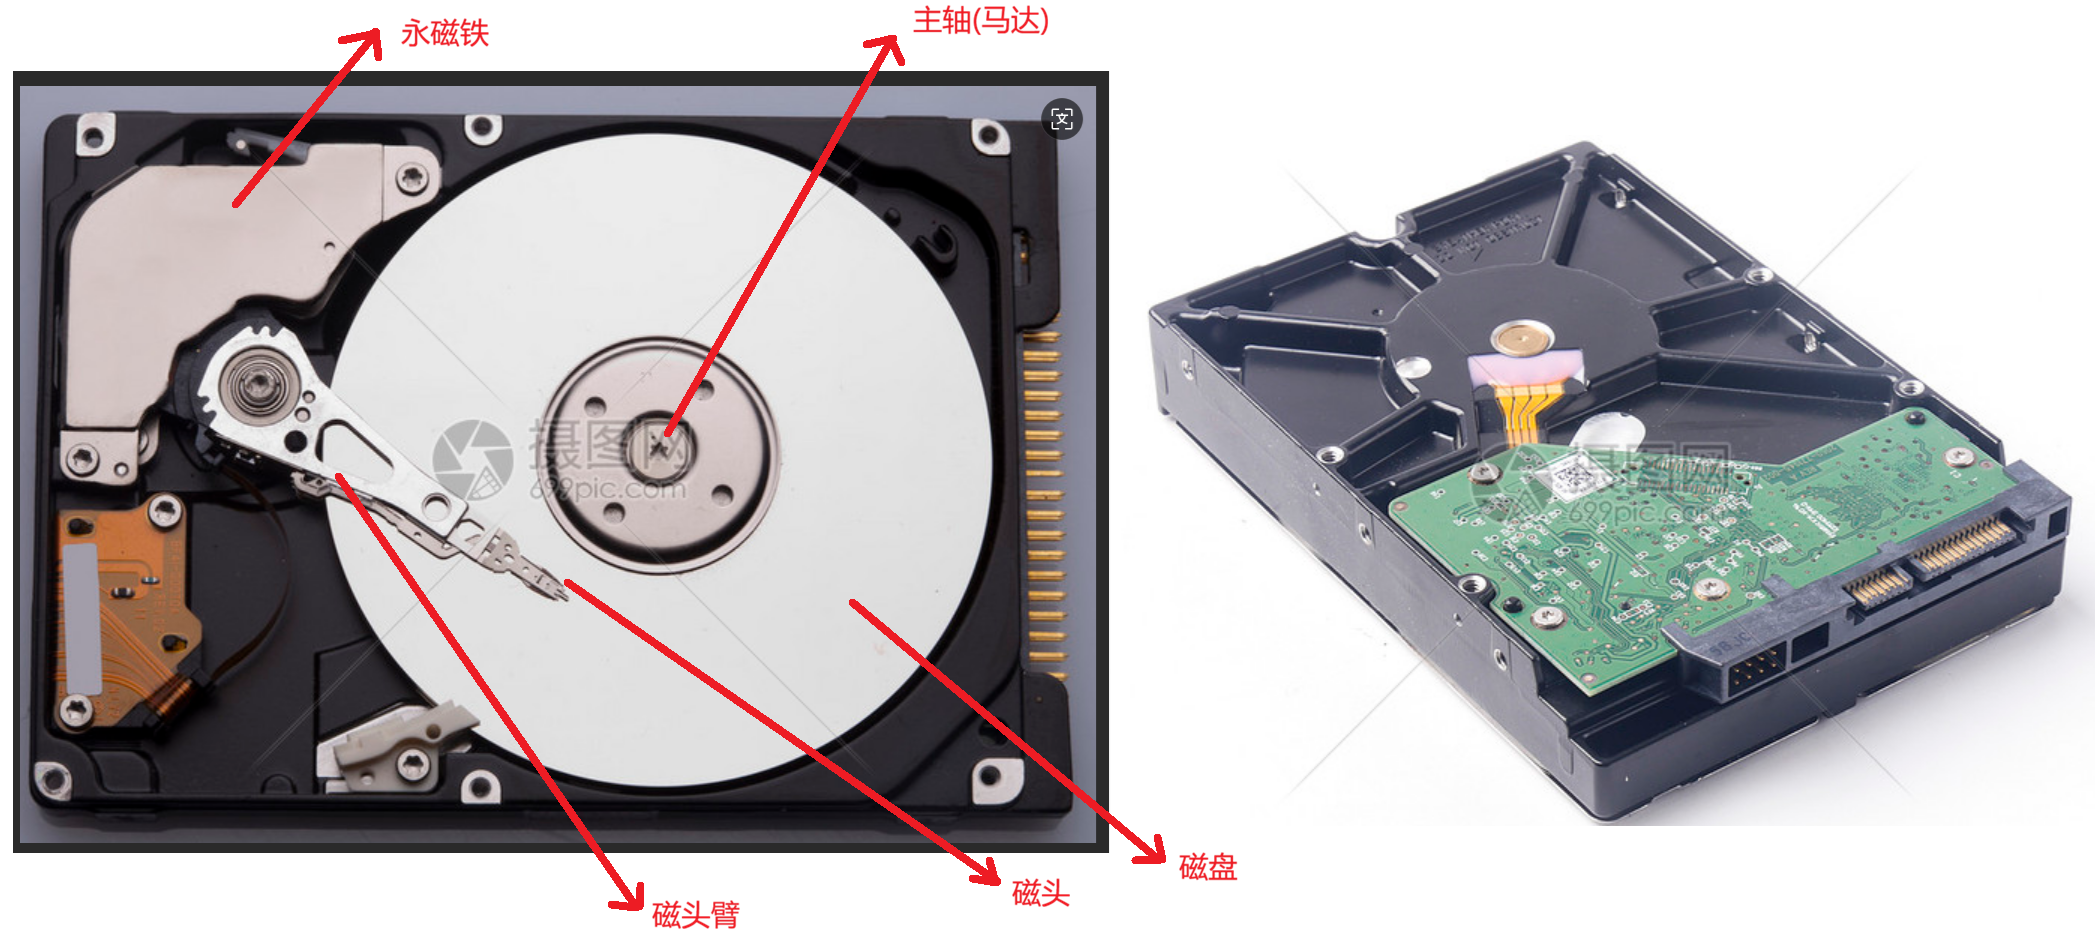
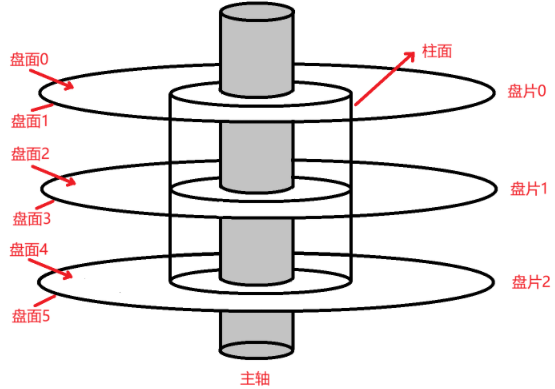
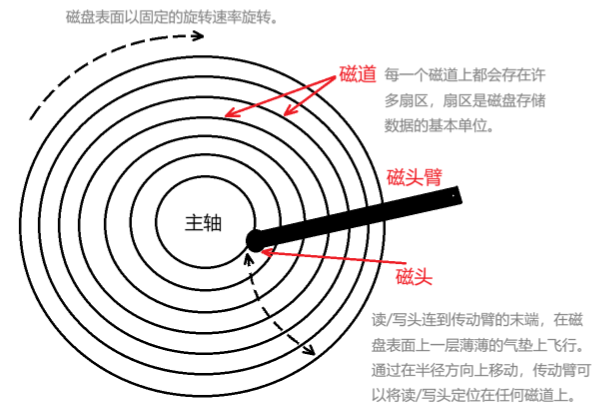
盘片旋转的本质:是为了让磁头定位到指定扇区。读取一个扇区,选定其中一个磁头即可。
磁头摆动的意义:本质是访问哪一个磁道或者柱面。
磁盘存储数据的基本单位是扇区,一个扇区的大小至少为 512 字节,读写操作必须以 512 字节为单位进行。任何修改或读写操作,都必须先将数据加载到内存中。
如何定位一个扇区?
CHS地址定位,可以定位一个扇区。1,确定磁头要访问哪一个柱面(磁道)。2,定位磁头。3,定位一个扇区。定位了一个扇区,也就可以一次定位多个扇区。使用命令 fdisk -l ,可以查看系统中每个磁盘的使用情况。
扇区是从磁盘读出和写入信息的最小单位,通常大小为512字节。
磁头(head)数:每个盘片一般有上下两面,分别对应 1 个磁头,共 2 个磁头。
磁道(track)数:磁道是从盘片外圈往内圈编号 0 磁道,1 磁道...,靠近主轴的同心圆用于停靠磁头,不存储数据。
柱面(cylinder)数:磁道构成柱面,数量上等同于磁道个数。
扇区(sector)数:每个磁道都被切分成很多扇形区域,每道的扇区数量看做相同。
圆盘(platter)数:就是盘片的数量。
磁盘容量:磁头数 * 柱面数(磁道数) * 每个磁道的扇区数 * 每个扇区的字节数
传动臂上的磁头是共进退的。
有了柱面(cylinder),磁头(head),扇区(sector),就可以定位数据了,这就是数据定位(寻址)方式之一,CHS寻址方式。
1.2,磁盘的逻辑结构
1.2.1,理解过程
磁带上面可以存储数据,我们可以把磁带"拉直",形成线性结构。虽然磁盘是硬质的,但是逻辑上可以把磁盘想象成为卷在一起的磁带,
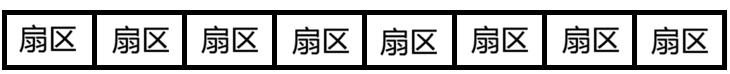
这样每一个扇区,就有了一个线性地址(其实就是数组下标),这种地址叫做LBA。
1.2.2,真实过程
磁盘在进行访问的时候,传动臂上的磁头是共进退的。
柱面是一个逻辑上的概念,其实就是每一面上,相同半径的磁道逻辑上构成柱面。逻辑上,磁盘整体是由"柱面"卷起来的。
所以,磁盘的真实情况是:
磁道:
某一盘面的某一个磁道展开:

即:一维数组。
柱面:
整个磁盘中相同半径的所有磁道,即柱面展开:
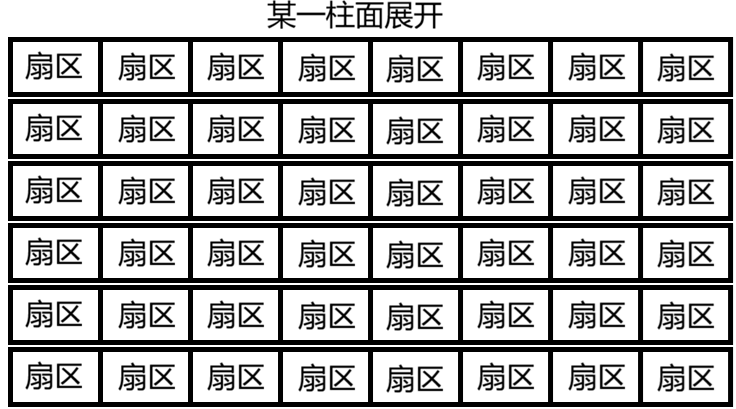
柱面上的每个磁道,扇区个数都是一样的。
即:二维数组。
整盘:
整个磁盘是由多个柱面组成,可以将整个磁盘看做是由多个二维数组组成,也就是三维数组。
所以,寻址一个扇区:先找到是在哪一个柱面(Cylinder),再确定是哪一个磁道(磁头位置,Head),再确定扇区(Sector)。就有了CHS寻址。
可以将二维数据看成一个一位数组,那么也可以将三维数组看成一个一维数组。磁盘在逻辑上,就被抽象成一维数组。每个扇区都有一个下标(LBA)地址,就是线性地址。
通过每个扇区的LBA地址,转换成CHS地址,就可以确定出一个扇区在磁盘中的位置。
1.3,CHS地址和LBA地址的相互转换
扇区编号从1开始,柱面号从0开始。
CHS 转成 LBA:
磁头数 * 每磁道扇区数 = 单个柱面的扇区总数
LBA = 柱面号 C * 单个柱面的扇区总数 + 磁头号 H * 每磁道扇区数 + 扇区号 S - 1
即:LBA = 柱面号 C * (磁头数 * *每磁道扇区数) + 磁头号 H **每磁道扇区数 + 扇区号 S - 1
扇区号通常是从 1 开始的,而在 LBA 中,地址是从 0 开始的
柱面和磁道都是从 0 开始编号的
总柱面,磁道个数,扇区总数等信息,在磁盘内部会自动维护,上层开机的时候,会获取到这些参数。
LBA 转成 CHS:
柱面号 C = LBA // (磁头数 * 每磁道扇区数)【就是单个柱面的扇区总数】
*磁头号 H = (LBA % (磁头数 **每磁道扇区数)) // 每磁道扇区数
扇区号 S = (LBA % 每磁道扇区数) + 1
"//": 表示除取整
所以:从此往后,在磁盘使用者看来,根本就不关心 CHS 地址,而是直接使用 LBA 地址,磁盘内部自己转换。所以: 从现在开始,磁盘就是一个 元素为扇区 的一维数组,数组的下标就是每一个扇区的 LBA 地址。OS 使用磁盘,就可以用一个数字访问磁盘扇区了。
二,文件系统
2.1,"块"
硬盘是典型的"块"设备,操作系统读取硬盘数据的时候,是不会一个一个扇区地读写,这样效率太低,而是一次性连续读取多个扇区,即一次性读取一个"块"(block)。
硬盘的每个分区是被划分为一个个的"块"。一个"块"的大小是由格式化的时候确定的,并且不可以更改,最常见的是4KB,即连续八个扇区组成一个"块"。"块"是文件存取的最小单位。
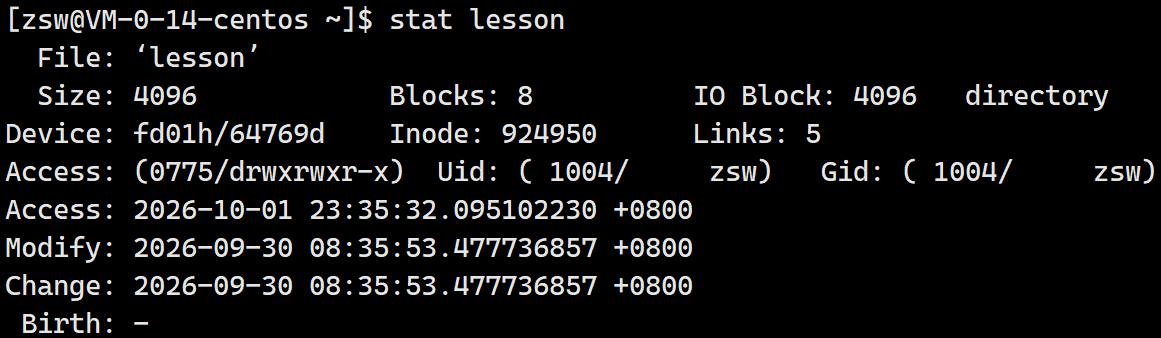
这样做可以提高效率,使软硬件解耦。
1,磁盘就是一个三维数组,可以把它看成一个"一维数组",数组下标就是LBA,每个元素都是扇区。
2,每个扇区都有LBA,那么八个扇区为一个块,每一个块的地址也能算出来。
3,知道LBA:块号=LBA / 8 。
4,知道块号:LBA地址=块号 * 8 + n .(n是块内第几个扇区)。
2.2,"分区"
磁盘是可以被分成多个分区的,在windows可以将磁盘分区成C,D,E盘。C,D,E就是分区。分区从实质上说就是对硬盘的一种格式化。但是Linux的设备都是以文件形式存在,那应该怎么分区呢?
柱面是分区的最小单位,可以利用柱面号来进行分区,本质就是设置每个区的起始柱面和结束柱面号。
2.3,引入"inode"
文件=数据+文件属性,使用 ls -l 命令除了可以看到文件名,还能看到文件元数据(属性)。
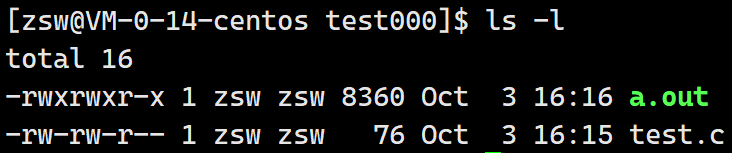
文件类型和权限 硬链接数 文件所有者 组 文件大小 最后修改时间 文件名
文件数据都存储在"块"中,那么还得找一个地方存储文件的元信息(属性信息),比如文件的创建者,文件的创建日期,文件的大小等。这种存储文件属性信息的区域叫做inode,"索引节点"。
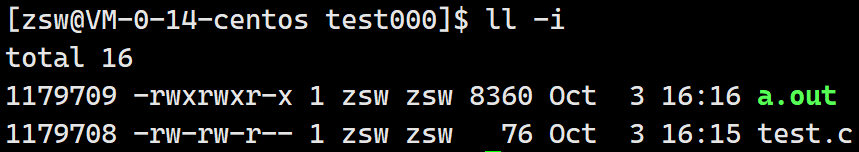
每一个文件都有对应的inode,里面包含了与该文件有关的一些信息。为了能解释清楚inode,必须深入了解文件系统。
1,Linux系统,文件内容和文件属性是分开存储的。
2,一个组应包含的内容:文件数据,管理文件数据的信息。
3,Linux下,保存文件属性的集合叫做inode,一个文件,一个inode,inode内有一个唯一的标识符,叫做inode号。
 2.6.18版本
cpp
#include<stdio.h>
#define	EXT2_NDIR_BLOCKS		12
#define	EXT2_IND_BLOCK			EXT2_NDIR_BLOCKS
#define	EXT2_DIND_BLOCK			(EXT2_IND_BLOCK + 1)
#define	EXT2_TIND_BLOCK			(EXT2_DIND_BLOCK + 1)
#define	EXT2_N_BLOCKS			(EXT2_TIND_BLOCK + 1)
struct ext2_inode
{
	unsigned short   i_mode;		/* File mode */
	unsigned short	i_uid;		/* Low 16 bits of Owner Uid */
	unsigned int	i_size;		/* Size in bytes */
	unsigned int	i_atime;	/* Access time */
	unsigned int	i_ctime;	/* Creation time */
	unsigned int	i_mtime;	/* Modification time */
	unsigned int	i_dtime;	/* Deletion Time */
	unsigned short	i_gid;		/* Low 16 bits of Group Id */
	unsigned short	i_links_count;	/* Links count */
	unsigned int	i_blocks;	/* Blocks count */
	unsigned int	i_flags;	/* File flags */
	union {
		struct {
			unsigned int  l_i_reserved1;
		} linux1;
		struct {
			unsigned int  h_i_translator;
		} hurd1;
		struct {
			unsigned int  m_i_reserved1;
		} masix1;
	} osd1;				/* OS dependent 1 */
	unsigned int	i_block[EXT2_N_BLOCKS];/* Pointers to blocks */
	unsigned int	i_generation;	/* File version (for NFS) */
	unsigned int	i_file_acl;	/* File ACL */
	unsigned int	i_dir_acl;	/* Directory ACL */
	unsigned int	i_faddr;	/* Fragment address */
	union {
		struct {
			unsigned char	l_i_frag;	/* Fragment number */
			unsigned char	l_i_fsize;	/* Fragment size */
			unsigned short	i_pad1;
			unsigned short	l_i_uid_high;	/* these 2 fields    */
			unsigned short	l_i_gid_high;	/* were reserved2[0] */
			unsigned int	l_i_reserved2;
		} linux2;
		struct {
			unsigned char	h_i_frag;	/* Fragment number */
			unsigned char	h_i_fsize;	/* Fragment size */
			unsigned short	h_i_mode_high;
			unsigned short	h_i_uid_high;
			unsigned short	h_i_gid_high;
			unsigned int	h_i_author;
		} hurd2;
		struct {
			unsigned char	m_i_frag;	/* Fragment number */
			unsigned char	m_i_fsize;	/* Fragment size */
			unsigned short	m_pad1;
			unsigned int	m_i_reserved2[2];
		} masix2;
	} osd2;				/* OS dependent 2 */
};
int main()
{
	printf("%zd\n", sizeof(struct ext2_inode));// 128
	return 0;
}
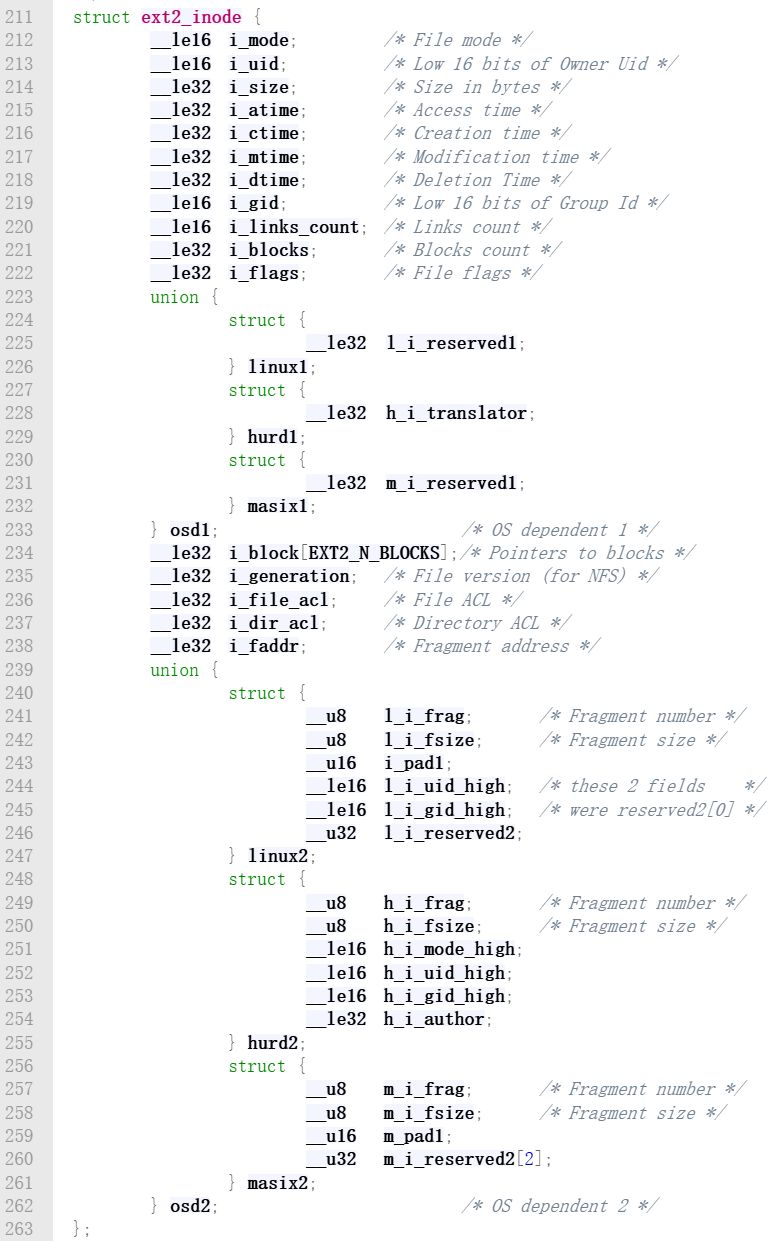
这是 ext2 文件系统的磁盘索引节点(inode)结构体定义,出自 Linux 内核源码,是 ext2 文件系统在磁盘上存储文件元数据的核心结构。下面从结构设计、字段含义、技术特点三个维度进行解读。
(一),整体设计特点
1,字节序约定:所有字段前缀 __le16 /__le32 表示字段以小端序(little-endian) 存储在磁盘上,内核读取到内存时会转换为主机字节序,保证磁盘格式的跨架构一致性。
2,联合体兼容设计:结构体中包含 osd1、osd2 两个联合体(OS Dependent),通过复用同一块内存空间,实现 Linux、Hurd、Minix 三类系统对同一份磁盘 inode 的差异化解读,不额外占用磁盘空间。
3,分层结构:分为通用元数据、系统私有字段、数据块指针、扩展属性四大部分,是经典 Unix 文件系统 inode 的典型设计范式。
(二),核心字段逐段解析
1,通用基础元数据(跨系统通用)
| 字段 | 宽度 | 含义 |
|---|---|---|
i_mode |
16 位 | 文件模式,高 4 位存储文件类型(普通文件 / 目录 / 符号链接 / 设备文件等),低 12 位存储访问权限位(rwx)。 |
i_uid |
16 位 | 文件所有者用户 ID 的低 16 位。 |
i_size |
32 位 | 文件大小,单位为字节;32 位上限对应 4GB,配合间接块指针可支持更大文件。 |
i_atime / i_ctime / i_mtime / i_dtime |
32 位 | 分别为访问时间、创建时间、修改时间、删除时间,均为 Unix 秒级时间戳。 |
i_gid |
16 位 | 文件所属用户组 ID 的低 16 位。 |
i_links_count |
16 位 | 硬链接计数,记录有多少个目录项指向该 inode,计数为 0 时 inode 可被回收。 |
i_blocks |
32 位 | 文件占用的扇区数(以 512 字节为单位,而非文件系统块大小,属于历史设计)。 |
i_flags |
32 位 | 文件属性标志位,比如不可修改、仅追加、压缩等特性标记。 |
2,联合体 osd1(系统私有字段 1)
三个分支共用 4 字节空间,不同系统读取对应分支:linux1:Linux 系统保留字段,预留用于后续扩展。hurd1:Hurd 系统的翻译器指针字段。masix1:Minix 系统的保留字段。
3,数据块指针 i_block[EXT2_N_BLOCKS]
这是 inode 的核心寻址区,数组长度通常为 15,采用「直接 + 间接」的混合寻址模式:
前 12 项:直接块指针,直接指向文件数据块,适合小文件快速寻址。
第 13 项:一级间接块,指向一个存储块指针的间接块。
第 14 项:二级间接块,指向一级间接块的索引块。
第 15 项:三级间接块,支持大文件的深层寻址。
4,扩展元数据
i_generation:文件版本号,主要用于 NFS 场景,避免 inode 复用导致的文件句柄错乱i_file_acl / i_dir_acl:文件 / 目录的访问控制列表(ACL)块号,用于扩展权限管理。i_faddr:碎片地址,ext2 早期设计的文件碎片(fragment)支持字段,现代场景基本不再使用。
5,联合体 osd2(系统私有字段 2)
同样是多系统兼容设计,三个分支共用内存:
linux2:包含碎片信息、UID/GID 的高 16 位(l_i_uid_high / l_i_gid_high),用于扩展支持 32 位 UID/GID,弥补前面 i_uid/i_gid 只有 16 位的限制。
hurd2:Hurd 系统对应的碎片字段、权限高位、作者字段等。
masix2:Minix 系统的碎片字段与保留位。
(三),补充背景
磁盘 inode 与内存 inode:图中是磁盘存储格式,Linux 内核运行时会使用 struct ext2_inode_info 封装它,补充运行时状态、缓存指针等内存字段,读写磁盘时做字节序转换。
演进关系:ext3、ext4 的磁盘 inode 都基于此结构扩展,比如新增 64 位文件大小、纳秒级时间戳、扩展属性空间等,基础设计逻辑保持兼容。
尺寸:标准 ext2 inode 大小为 128 字节,后续版本也支持 256 字节的大 inode 以容纳更多扩展属性。
注:
1,文件名属性未纳入到inode数据结构内部。
2,inode的大小一般是128字节或者256字节,后面统一为128字节。
3,任何文件的内容大小可以不同,但是属性大小一定是相同的。
我们已经知道硬盘是典型的 "块" 设备,操作系统读取硬盘数据的时候,读取的基本单位是" 块"。"块" 又是硬盘的每个分区下的结构,难道 "块" 是随意的在分区上排布的吗?那要怎么找到 "块" 呢? 还有就是上面提到的存储文件属性的 inode,又是如何放置的呢? 文件系统就是为了组织管理这些的!!
三,ext2文件系统
要想在硬盘上存储文件,必须先把硬盘格式化为某种格式的文件系统,才能存储文件。文件系统的目的就是组织和管理硬盘中的文件。
ext2文件系统将整个分区划分成若干个同样大小的块组(Block Group)。只要能管理一个分区就能管理所有分区,也就能管理所有磁盘文件。
3.1,初步认识
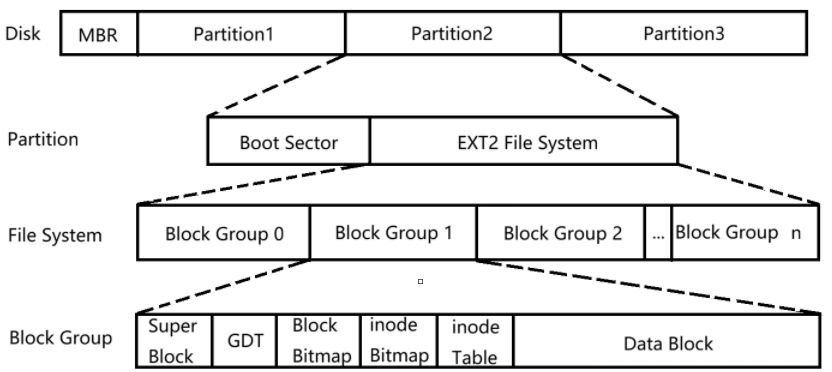
这是EXT2(第二扩展文件系统)的磁盘存储分层架构图,它是 Linux 系统经典的原生文件系统,也是后续 EXT3、EXT4 的设计基础。整张图从宏观到微观,将磁盘空间划分为 4 个层级进行管理,各层的结构与作用如下:
(1),Disk 层:整块物理磁盘
磁盘最起始位置是 MBR(主引导记录),占磁盘第一个扇区,存储系统引导程序和磁盘分区表,定义了磁盘上各个分区的位置、大小和类型。
MBR 之后是若干独立的磁盘分区(图中 Partition 1~3),分区是磁盘的逻辑划分单元,每个分区可以独立部署一套文件系统。
(2),Partition 层:单个磁盘分区
分区开头是 Boot Sector(引导扇区),存放分区级的引导代码,支持操作系统从该分区启动。
引导扇区之后是 EXT2 文件系统的主体区域,占据分区的绝大多数存储空间。
(3), File System 层:EXT2 文件系统
EXT2 会把整个分区的空间,均匀划分为多个连续的块组(Block Group),从 0 开始顺序编号。
分块组的核心意义:将大磁盘分段管理,缩短文件数据的寻址范围,减少磁盘碎片,同时提升元数据检索和空间分配的效率。
(4),Block Group 层:块组内部结构
每个块组都包含一套完整的管理元数据 + 数据存储区,从左到右依次为:
1,Super Block(超级块) 存储整个文件系统的全局核心参数:块大小、总数据块数、总 inode 数、块组总数、文件系统版本与挂载状态等。所有块组都会保存超级块的冗余副本,避免单一点损坏导致整个文件系统失效。
2,GDT(块组描述符表) 记录所有块组的描述信息,包括每个块组的块位图、inode 位图、inode 表的起始位置,以及各组的空闲块、空闲 inode 计数。
3,Block Bitmap(块位图) 用二进制位映射当前块组内所有数据块的使用状态:每一位对应一个数据块,标记该块是 0 空闲 还是 1 已占用 ,是磁盘块分配、回收的核心索引结构。
4,inode Bitmap(inode 位图) 原理与块位图一致,每一位对应一个 inode 节点,标记 inode 的0 空闲 / 1 占用状态,用于文件 inode 的分配与释放。
5,inode Table(inode 表) 存放块组内所有的 inode(索引节点)。每个 inode 对应一个文件 / 目录,记录文件的元数据:大小、权限、所有者、时间戳、数据块指针等,但不存储文件名。
6,Data Block(数据块) 块组中占比最大的区域,用于实际存储文件的内容数据,以及目录项(文件名与 inode 编号的映射关系)。
MBR:
主引导记录(Master Boot Record,缩写:MBR),又叫做主引导扇区,是计算机开机后访问硬盘时所必须要读取的首个扇区,里面保存着启动代码和硬盘分区信息。
Boot Sector:
详解:
引导扇区_百度百科https://baike.baidu.com/item/%E5%BC%95%E5%AF%BC%E6%89%87%E5%8C%BA/7444926https://baike.baidu.com/item/%E5%BC%95%E5%AF%BC%E6%89%87%E5%8C%BA/7444926 https://baike.baidu.com/item/%E5%BC%95%E5%AF%BC%E6%89%87%E5%8C%BA/7444926上图中启动块(Boot Block/Sector)的大小是确定的,为 1KB,由 PC 标准规定,用来存储磁盘分区信息和启动信息,任何文件系统都不能修改启动块。启动块之后才是 ext2 文件系统的开始。
3.2,核心元数据结构详解
3.2.1,超级块(Super Block)
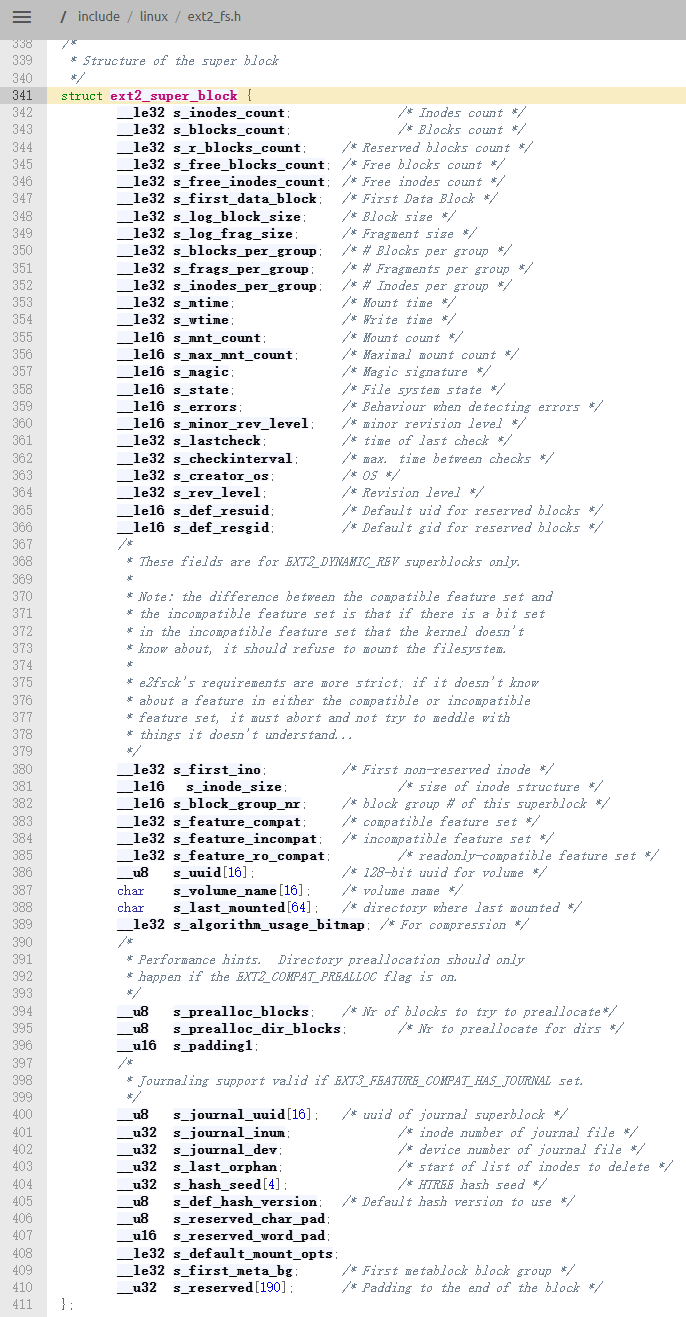
超级块是整个文件系统的 "元数据的元数据",记录全局配置与统计信息,是挂载文件系统的核心依据。存放文件系统本身的结构信息,描述整个分区的文件系统信息。记录的信息主要有:block 和 inode 的总量,未使用的 block 和 inode 的数量,一个 block 和 inode 的大小,最近一次挂载的时间,最近一次写入数据的时间,最近一次检验磁盘的时间等其他文件系统的相关信息。Super Block 的信息被破坏,可以说整个文件系统结构就被破坏了。
超级块在每个块组的开头都有一份拷贝(第一个块组必须有,后面的块组可以没有)。 为了保证文件系统在磁盘部分扇区出现物理问题的情况下还能正常工作,就必须保证文件系统的 super block 信息在这种情况下也能正常访问。所以一个文件系统的 super block 会在多个 block group 中进行备份,这些 super block 区域的数据保持一致。
位置:
主副本位于分区起始偏移 1024 字节处(即第 0 个块的后半部分或第 1 个块),存放在块组 0 的开头。为了容错,ext2 会在编号为0、1、3^n、5^n、7^n的块组中存放超级块备份(稀疏超级块特性),避免块组 0 损坏导致整个文件系统失效。kernel.org/doc/html/v6.12/_sources/filesystems/ext2.rst.txt?f_link_type=f_linkinlinenote&flow_extra=eyJpbmxpbmVfZGlzcGxheV9wb3NpdGlvbiI6MCwiZG9jX3Bvc2l0aW9uIjowLCJkb2NfaWQiOiIxOThjNGRiNmJlMGMzODgyLTMxZmExZDVkZjI4OThlOTEifQ%3D%3Dhttps://www.kernel.org/doc/html/v6.12/_sources/filesystems/ext2.rst.txt?f_link_type=f_linkinlinenote&flow_extra=eyJpbmxpbmVfZGlzcGxheV9wb3NpdGlvbiI6MCwiZG9jX3Bvc2l0aW9uIjowLCJkb2NfaWQiOiIxOThjNGRiNmJlMGMzODgyLTMxZmExZDVkZjI4OThlOTEifQ%3D%3Dhttps://www.kernel.org/doc/html/v6.12/_sources/filesystems/ext2.rst.txt?f_link_type=f_linkinlinenote&flow_extra=eyJpbmxpbmVfZGlzcGxheV9wb3NpdGlvbiI6MCwiZG9jX3Bvc2l0aW9uIjowLCJkb2NfaWQiOiIxOThjNGRiNmJlMGMzODgyLTMxZmExZDVkZjI4OThlOTEifQ%3D%3Dhttps://www.kernel.org/doc/html/v6.12/_sources/filesystems/ext2.rst.txt?f_link_type=f_linkinlinenote&flow_extra=eyJpbmxpbmVfZGlzcGxheV9wb3NpdGlvbiI6MCwiZG9jX3Bvc2l0aW9uIjowLCJkb2NfaWQiOiIxOThjNGRiNmJlMGMzODgyLTMxZmExZDVkZjI4OThlOTEifQ%3D%3D
核心字段:
s_magic:魔数,固定值0xEF53,用于标识 ext2 文件系统
s_log_block_size:块大小(通常为 1KB、2KB、4KB,格式化时指定)
s_blocks_count / s_free_blocks_count:总块数 / 空闲块数
s_inodes_count / s_free_inodes_count:总 inode 数 / 空闲 inode 数
s_blocks_per_group:每个块组包含的数据块数量
s_inodes_per_group:每个块组包含的 inode 数量
s_inode_size:单个 inode 的字节大小(默认 128 字节)
文件系统状态、挂载次数、检查间隔、时间戳、版本号等。
3.2.2,GDT,组描述符表(Group Descriptor Table, GDT)
块组描述符表,描述块组属性信息,整个分区分成多少个块组就对应有多少个块组描述符。每个块组描述符存储一个块组的描述信息,如在这个块组中从哪里开始是 inode Table,从哪里开始是 Data Blocks,空闲的 inode 和数据块还有多少个等等。块组描述符在每个块组的开头都有一份拷贝。
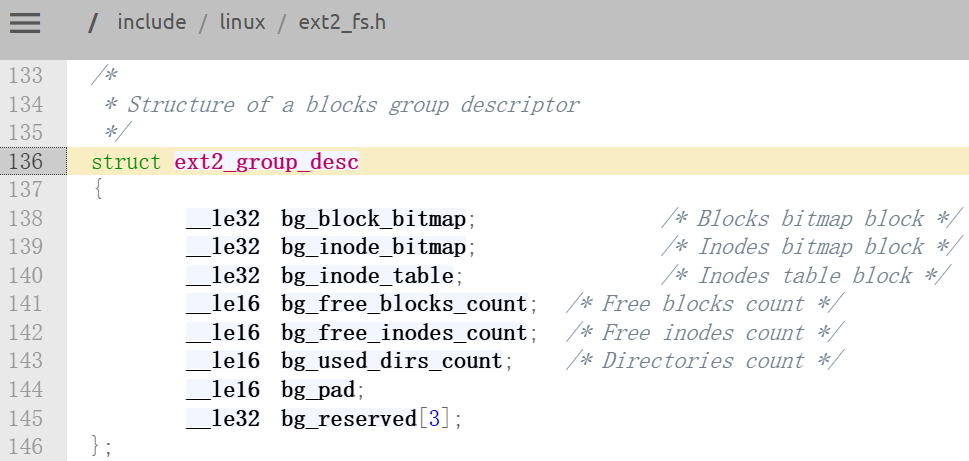
组描述符表由所有块组的描述符顺序排列而成,每个块组对应一个组描述符,用于索引该块组内所有元数据的位置。
位置:
紧跟超级块之后,主副本在块组 0,与超级块同步备份到其他块组。
单个组描述符核心字段:
| 字段 | 含义 |
|---|---|
bg_block_bitmap |
该块组的块位图所在的块号 |
bg_inode_bitmap |
该块组的 inode 位图所在的块号 |
bg_inode_table |
该块组的 inode 表起始块号 |
bg_free_blocks_count |
该块组空闲数据块数量 |
bg_free_inodes_count |
该块组空闲 inode 数量 |
bg_used_dirs_count |
该块组内的目录数量 |
3.2.3,位图(Bitmap)
位图是资源分配的核心结构,用二进制位标记资源是否空闲,实现 O (1) 级别的分配与释放。每个块组包含两张独立的位图:
块位图(Block Bitmap):占用 1 个数据块,每一位对应块组内的一个数据块。位值为1表示已占用,0表示空闲。以 4KB 块大小为例,1 个块有 32768 位,因此每个块组最多管理 32768 个数据块。对Data Block做管理,bit位位置代表块编号,bit位的内容(1/0)代表Data Block中的一个块是否被使用。
inode 位图(inode Bitmap):占用 1 个数据块,每一位对应块组内 inode 表中的一个 inode。位值为1表示已分配,0表示空闲。对inode Table做管理。
3.2.4,文件属性表(inode 表,inode Table)
inode(索引节点)是 ext2 的核心,一个文件对应唯一一个 inode,文件的所有元数据(属性)都存储在 inode 中,inode 不包含文件名。所有 inode 按顺序连续存储,形成 inode 表。
位置:
每个块组一个 inode 表,起始位置由组描述符的bg_inode_table指定。
inode 核心元数据:
i_mode:文件类型(普通文件、目录、设备、管道等)+ 访问权限。
i_uid / i_gid:文件所有者用户 ID / 组 ID。
i_size:文件的字节大小。
i_atime / i_mtime / i_ctime:文件访问时间 / 修改时间 / 元数据变更时间。
i_links_count:硬链接计数,即有多少个目录项指向该 inode。
i_blocks:文件占用的 512 字节扇区总数。
i_block[15]:数据块指针数组,共 15 个条目,用于寻址文件内容。
inode 编号规则:inode 号在单个分区内唯一,0 号保留为无效值,1 号为坏块列表专用 inode,2 号固定为根目录/的 inode,系统保留前 10 个 inode,用户文件通常从 11 号开始分配。
inode 编号的分配分为两个核心阶段:文件系统格式化时的全局预分配(确定编号总池与分段规则)和文件创建时的动态分配(从空闲池中选取可用编号)。编号总池就是inode Bitmap。
inode编号以分区为单位,整体划分,不可跨分区。
3.2.5,文件内容(数据块,Data Blocks)
数据块是文件系统存储实际内容的最小单位,由4KB为单位的数据块,每个块都有唯一的编号。根据文件类型存储不同内容:
普通文件:直接存储数据。
目录文件:存储目录项(directory entry)列表。每个目录项是变长结构,包含:inode 号、文件名长度、文件类型、文件名(最长 255 字节)。目录本质也是文件,其数据块就是目录项的集合。
特殊文件(字符设备、块设备、管道、套接字等):不占用实际数据块,设备号等信息直接存储在 inode 中。
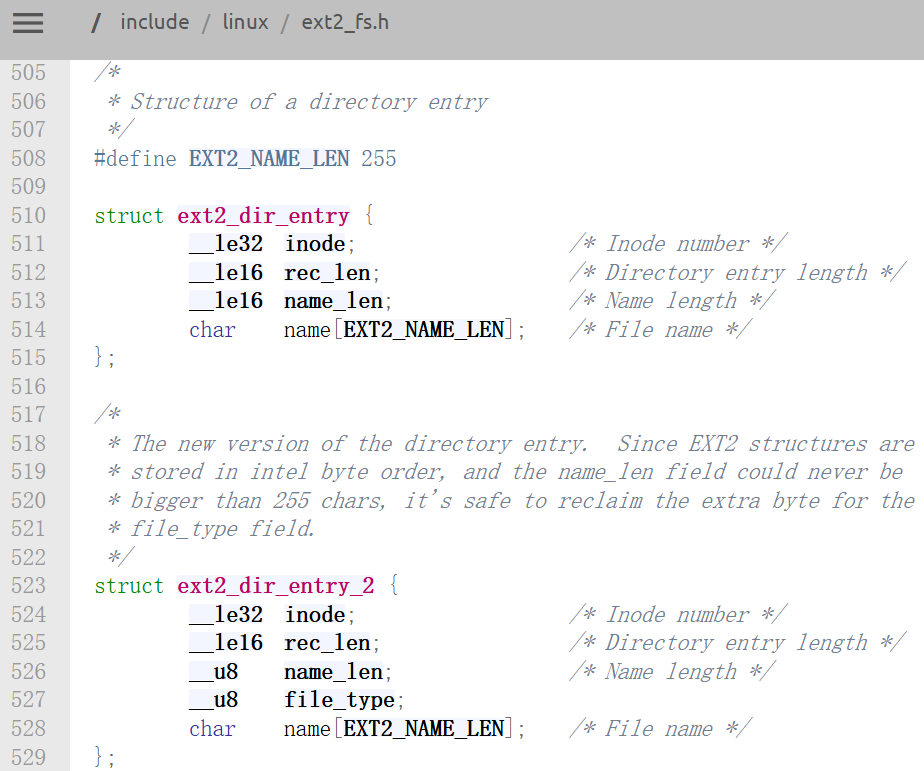
Block号按照分区划分,不可跨分区。
3.3,inode和Data Block中的数据块的映射
inode内部存在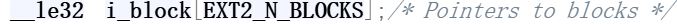 ,EXT2_N_BLOCKS=15,就是用来进行inode和数据块的映射的。文件 = 属性+内容。
解释一个问题:
在知道inode号的情况下,在指定分区,解释一下对文件进行增,删,读,改具体要做什么?
(1),增(创建文件):
创建文件的过程本质上是为文件分配 inode 和数据块,并建立两者之间的映射关系。具体步骤如下:
第一步,分配 inode。先将 inode Bitmap 加载到内存,遍历 inode Bitmap,从前往后查找第一个值为 0 的 bit 位,将其由 0 变为 1,表示该 inode 已被占用,随即分配一个 inode 编号【inode号 = 块组号 × s_inodes_per_group(超级块结构中保存) + 位图中的位偏移 + 1(加 1 是因为 ext2 的 inode 从 1 开始编号,0 号为保留值)】,若当前块组无空闲 inode,则按距离远近向相邻块组继续查找。接着初始化 inode 结构体(在内存中初始化磁盘格式的 inode 结构体),设置权限、所有者、所属组、硬链接数(初始为 1)、创建时间(时间戳)以及文件大小等属性。需要注意的是,文件名属性不会存储在当前这个结构体中,而是存放在目录项(directory entry)里。
第二步,分配数据块。根据文件初始大小,从块位图(Block Bitmap)中查找空闲的数据块,将其标记为已占用(由0变成1),并把对应的块号写入 inode 的 i_block 指针数组中。对于小文件,通常使用直接块指针即可完成映射;若文件较大,则可能需要使用一级、二级甚至三级间接块指针。将新创建文件的inode存放在inode Table里,将inode信息从内存中拷贝到对应的inode Table的位置上。
第三步,建立目录项。在父目录的数据块中新增一个目录项,记录文件名与 inode 编号的对应关系,同时将父目录的硬链接计数相应更新。至此,文件创建完成,用户即可通过文件名访问到该文件的内容和属性。
(2),删(删除文件):
1,定位文件的 inode,检查删除权限。
2。从父目录的数据块中删除对应的目录项,更新父目录的时间戳。
3,将 inode 的i_links_count(硬链接数)减 1。
如果链接数变为 0:释放该 inode 占用的所有数据块:遍历i_block,将对应块位图的位标记为空闲。释放 inode 本身:在 inode 位图中将对应位标记为空闲。更新超级块和组描述符的空闲块数、空闲 inode 数。
如果链接数仍大于 0:仅删除目录项,不释放 inode 和数据块(其他硬链接仍可正常访问)。
4,删除操作本质是 "解除映射 + 标记空闲",不会立即清空数据块内容,数据会保留到被新文件覆盖。
(3),读(读文件):
1,通过路径解析或直接传入 inode 号,定位目标 inode,检查访问权限。
2,根据文件访问偏移量,通过i_block指针数组计算对应的数据块号:
偏移在直接块范围内:直接取出块号读取。
超过直接块范围:逐级读取间接索引块,最终找到数据块号。
3,读取对应数据块的内容,返回给用户进程。
4,更新 inode 的i_atime(访问时间)。
(4),改(修改文件):
分为属性修改和内容修改两类场景:
1,仅修改属性(如权限、所有者):直接更新 inode 中对应字段,更新i_ctime,无需操作数据块。
2,覆盖写(大小不变):根据偏移找到对应数据块,直接覆盖写入新内容,更新i_mtime和i_ctime。
3,扩容写(大小增加):
计算需要新增的数据块数量。
扫描块位图,优先在同一块组分配空闲数据块,标记为已占用。
将新块号填入 inode 的i_block数组,直接块满则自动启用间接索引。
写入数据到新分配的数据块。
更新 inode 的i_size、i_blocks、i_mtime、i_ctime。
同步更新超级块和组描述符中的空闲块计数。
4,缩容写(大小减小):
计算并释放冗余的数据块,在块位图中标记为空闲。
从i_block数组中移除对应块号。
更新 inode 的大小、时间戳等字段,同步更新统计信息。
3.4,路径解析
路径解析是将字符串路径转换为目标 inode 的过程,本质是从根目录出发,逐层匹配目录项的递归过程。当我们要访问任何文件的时候,Linux内核都要为我们做从 / 目录开始的路径解析(用户打开的文件,Linux是会做路径缓存的,是为了提高效率)。打开文件,要做路径解析。
以解析/etc/passwd为例:
1,系统默认根目录/的 inode 号为 2,读取 inode 2 的信息,获取根目录的数据块位置。
2,遍历根目录的数据块中的所有目录项,查找名为etc的条目,得到etc目录的 inode 号(假设为 100)。
3,读取 inode 100 的信息,获取/etc目录的数据块位置。
4,遍历/etc的目录项,查找名为passwd的条目,得到目标文件的 inode 号(假设为 200)。
5,读取 inode 200 的属性和数据块,完成路径解析。
每进入一层目录都需要检查目录的执行权限(x 权限),访问文件前还要检查对应的读 / 写权限。
3.5,路径缓存
纯磁盘路径解析需要多次 IO,性能极低。Linux 内核通过目录项缓存(dcache)将已访问的路径映射缓存在内存中,大幅提升二次访问速度。所以,访问任何文件,并不会都从 / 目录开始进行路径解析,如果都从 / 目录开始进行路径解析,这样效率太慢,Linux会缓存历史路径结构(如果打开的文件是目录,由OS自己在内存中进行路径维护)。
Linux中,在内核中维护树状路径结构的内核结构体叫做:struct dentry
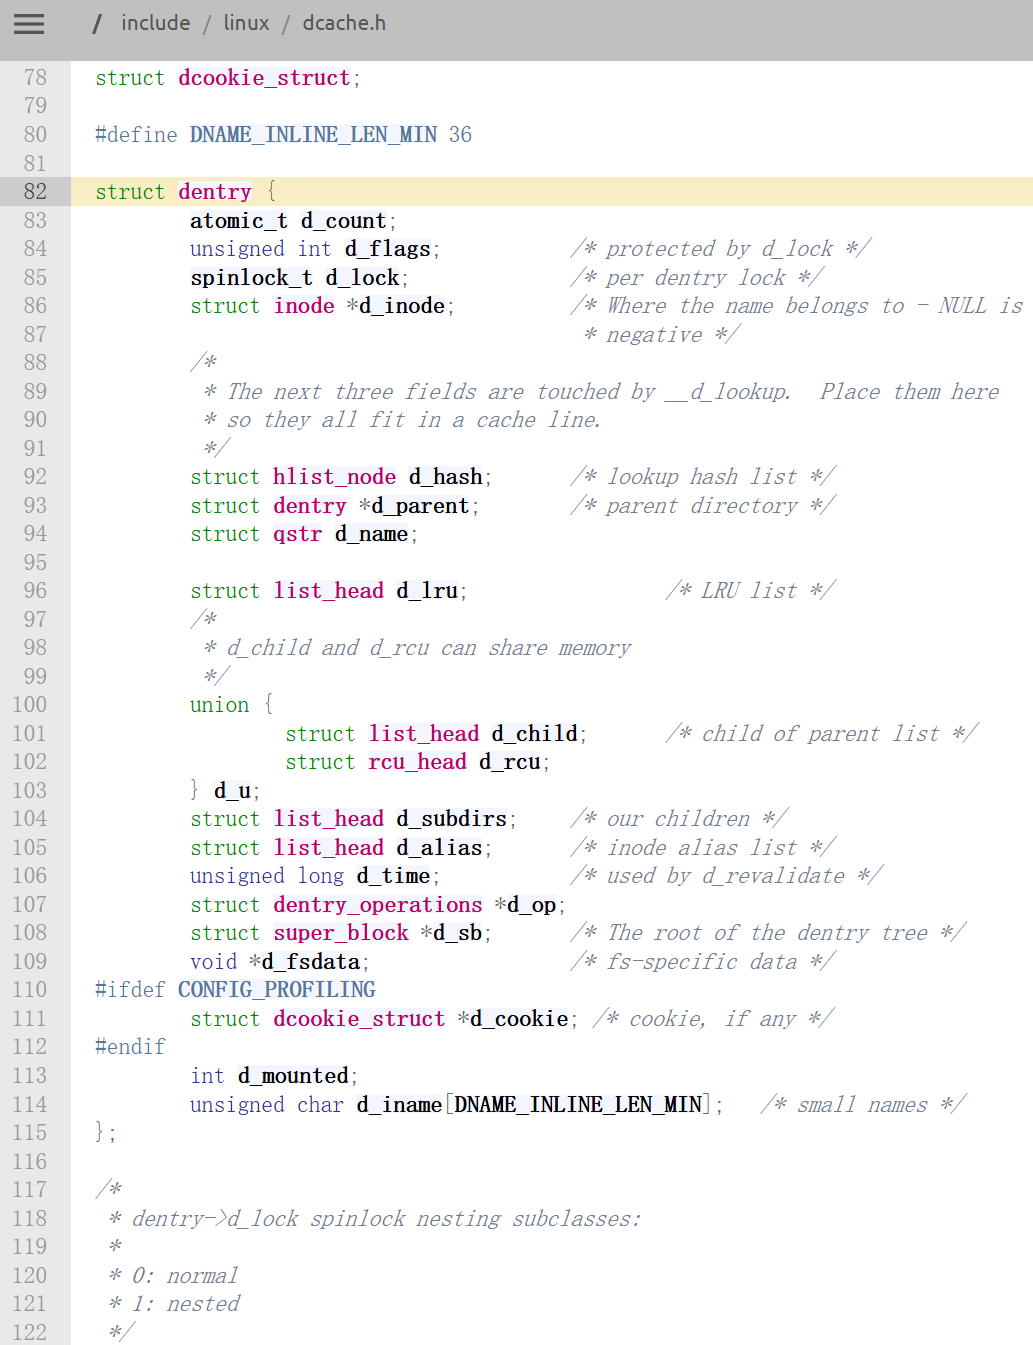
核心结构:struct dentry(目录项结构体),包含:
d_parent:指向父目录的 dentry 指针,构建层级树。
d_inode:指向对应 inode 的指针。
d_name:文件名。
哈希链表节点、LRU 链表节点等。
组织方式:
全局哈希表:以【父 dentry 地址 + 文件名哈希值】为键,实现近似 O (1) 的查找效率。
目录树结构:通过d_parent指针形成完整的路径树。
LRU 淘汰链表:内存不足时,淘汰最久未访问的 dentry,控制内存占用。
作用:缓存 "路径名→inode" 的映射关系,首次访问路径需要磁盘 IO,后续访问直接命中内存缓存;同时维护文件系统挂载点的关联关系。
每个文件其实都要有对应的 dentry 结构,包括普通文件。这样所有被打开的文件,就可以在内存中形成整个树形结构。
整个树形节点也同时会隶属于 LRU (Least Recently Used,最近最少使用) 结构中,进行节点淘汰。
整个树形节点也同时会隶属于 Hash,方便快速查找。
更重要的是,这个树形结构,整体构成了 Linux 的路径缓存结构,打开访问任何文件,都在先在这棵树下根据路径进行查找,找到就返回属性 inode 和内容,没找到就从磁盘加载路径,添加 dentry 结构,缓存新路径。
注:
1,目录的 dentry:内部节点(非叶子),下面可以挂载子 dentry(子目录、普通文件、软链接等),有子节点链表。
2,普通文件的 dentry:叶子节点,没有子 dentry,普通文件内部不能再存放文件 / 目录,所以不会再有子节点。
3.6,挂载分区
inode 不能跨分区,Linux 有多个分区,怎么知道是在哪一个分区?
回答:
inode 号只在当前分区(文件系统)内唯一,跨分区 inode 号会重复;内核依靠 super_block 来区分分区。
1,关键点:inode 不全局唯一,仅分区内唯一
每一个 ext2/ext4 文件系统(一个分区),独立拥有一套:超级块、块组、inode 表。分区 A 的 inode=123,和分区 B 的 inode=123,不是同一个文件,二者毫无关系。 所以不能只靠 inode 号定位文件。
2,内核如何知道文件属于哪个分区?
当访问文件时,路径查找走 dentry,dentry 会关联对应的inode 结构体(内存里的 inode),内存 inode 里记录了它所属文件系统的super_block指针。 super_block就代表一个独立分区上的文件系统。内存 inode → 指向所属的 super_block → 就能确定是哪个分区。
举个路径查找流程(dentry 阶段):
解析路径,逐级查找 dentry 树; 每个目录项 dentry 绑定一个 inode; 这个 inode 内部记录它属于哪个 super_block(哪个分区); 如果路径里遇到挂载点:dentry 会触发挂载跳转,切换到另一个 super_block(另一个分区)的根 inode。
挂载(mount)的本质:把另一个分区文件系统的根 inode,挂到某个目录 dentry 上。一旦进入挂载点,后续所有查找都使用新分区的 super_block 和它自己的 inode 编号空间。
结论:
分区写入文件系统,无法直接使用,需要和指定的目录关联,进行挂载才能使用。 所以,可以根据访问目标文件的 "路径前缀" 准确判断我在哪一个分区。(理解到这个层面)。
做个实验:
1,制作一个大的磁盘块,当做一个分区。

2,格式化写入文件系统(管理信息)
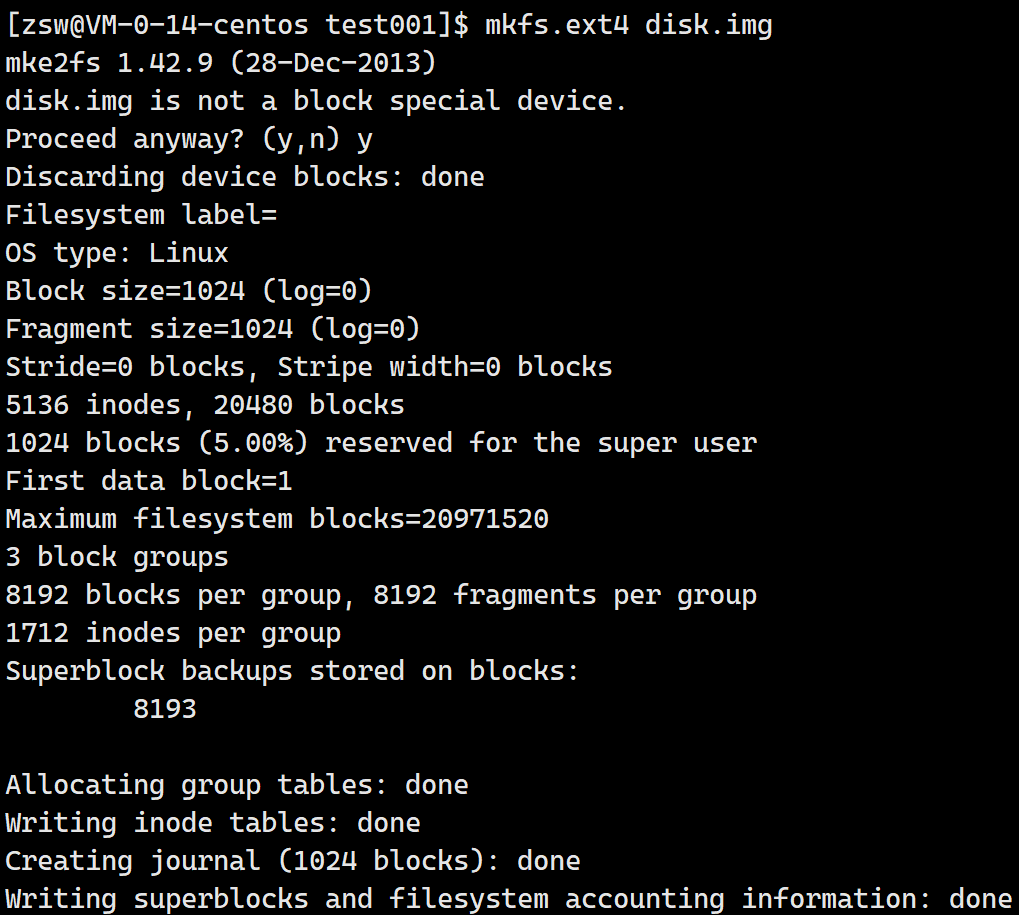
写入文件系统后,无法直接使用,需要和指定的目录关联,进行挂载才能使用。
3,建立空目录

4,查看可以使用的分区
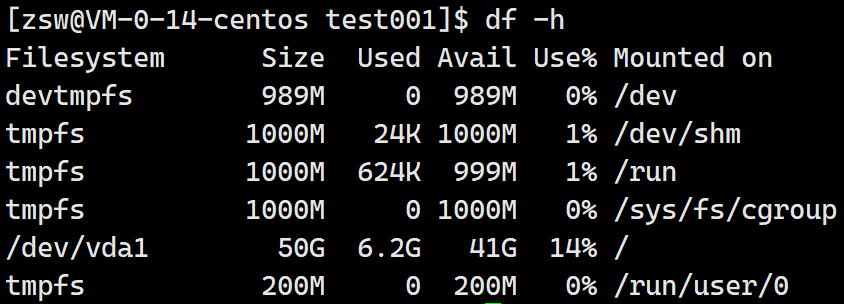
5,将分区挂载到指定的目录
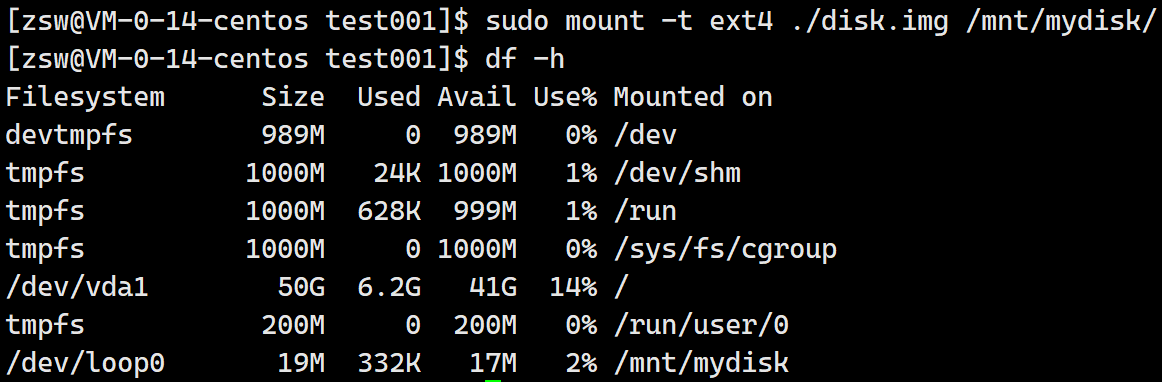
6,卸载分区