一.查询执行基础概述
1.为什么SQL不能直接执行?
因为SQL是一种声明式语言,只告诉数据库我要什么结果,但不说"具体怎么找",数据库是无法执行查询操作的,所以我们必须把SQL翻译成一张施工图纸 ,这张图纸就叫做查询计划。
整个查询步骤可以理解成:用户写一条 SQL → 数据库分析它 → 制定执行方案 → 调用底层算子处理数据 → 返回结果
- 查询计划长得像一棵倒过来的树(DAG 有向无环图),由一个个算子(封装了特定数据操作逻辑的数据处理执行单元)搭成。
- 数据从叶子往上流,最顶上(根节点)输出的就是最终看到的结果。
2.流水线与阻断算子
流水线: 数据像流水一样,从一个算子流向下一个算子。来一行、处理一行、输出一行,不用攒数据,边输入边输出。
阻断算子: 必须等前面所有数据处理完,才能继续向后输出结果。
这样设计的好处与代价:
优点 树状结构分工清楚、算子能复用;流水线让数据"流着走",不用反复落地存盘,又快又省
缺点 一旦碰上排序、连接这类"阻断算子",流水线就得暂停、还得腾出内存先存数据,整体就慢下来了
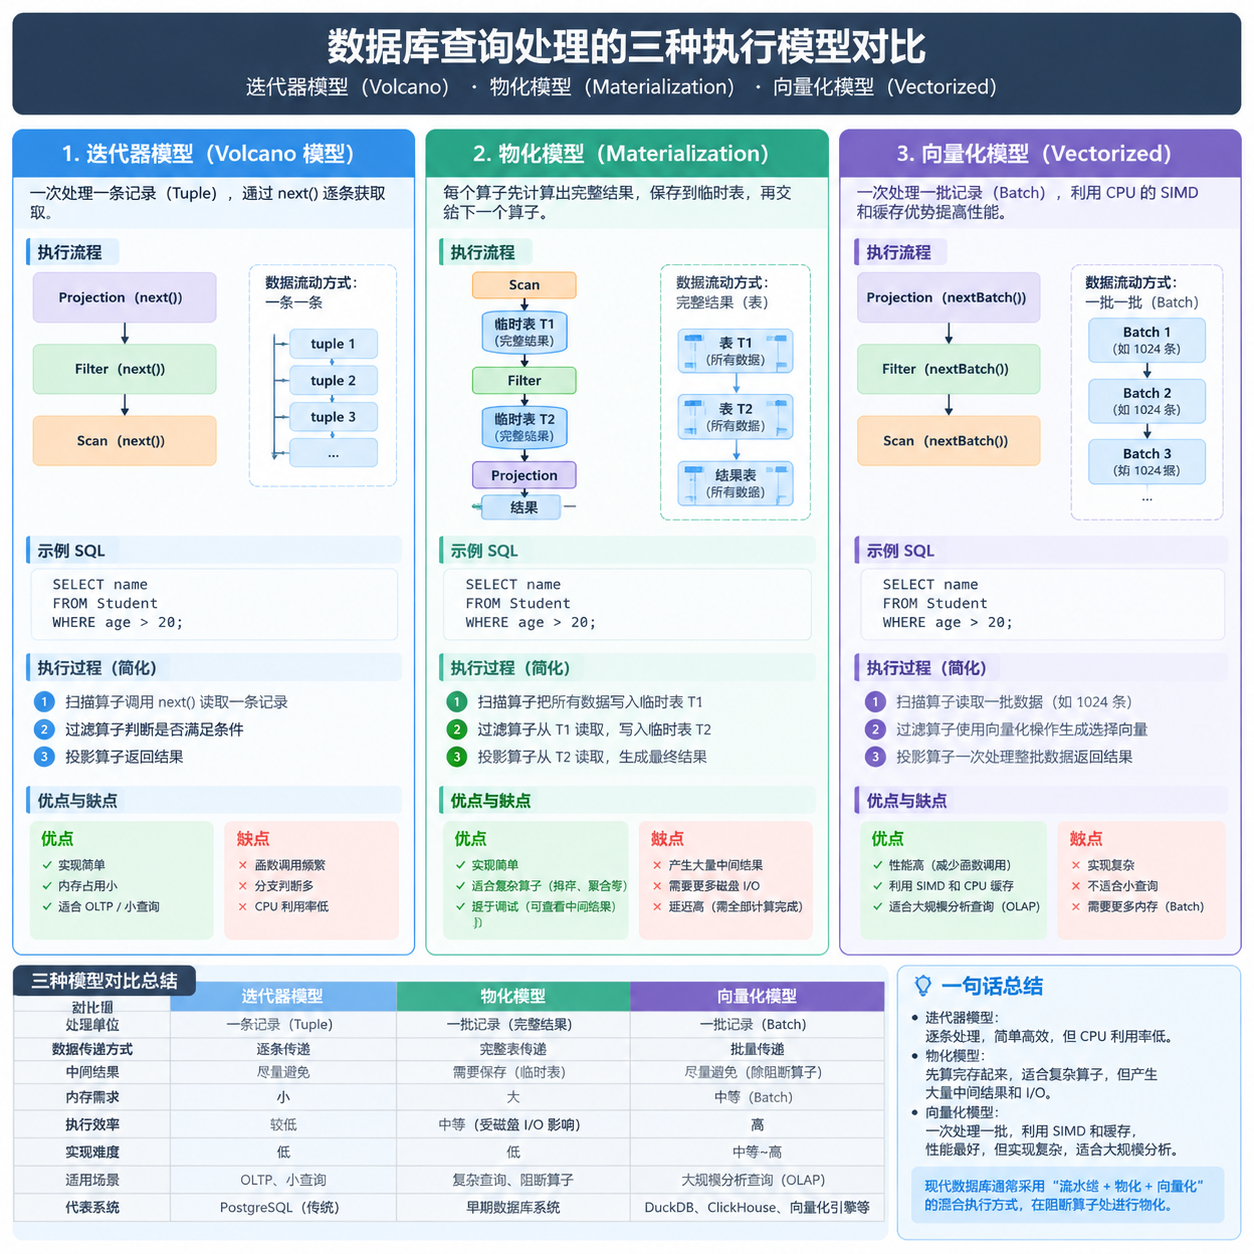
二.数据库查询处理模型
查询处理模型 = 数据库执行 SQL 时,各个算子之间如何传递数据、如何调用、如何运行。
1.为什么需要"处理模型"?
不同业务场景数据库负载差异极大,OLTP事务型业务追求低延迟、少量数据读写;OLAP分析型业务适配海量数据批量扫描。对于不同的场景,数据库实际干的活完全不一样,没法用单一模式适配这两种场景,于是业界迭代出了三类主流处理模型(迭代器 / 物化 / 向量化)
2.处理模型核心逻辑(控制流+数据流)
处理模型定义了查询计划的执行方式与数据流动机制,其核心由控制流和数据流两部分构成:控制流 决定算子的调用与调度方式,数据流决定数据在算子间的传递模式。
3.迭代器模型(火山模型)
迭代器模型是关系数据库查询执行引擎的经典架构 ,因为数据从底层逐层向上流动、像火山喷发一样,也被称为火山模型 。它的核心设计思想是:所有算子都实现一套统一的迭代器接口,上层算子只需要调用下层算子的接口,就能逐行获取处理好的数据。整个执行计划就是一棵由迭代器算子组成的树,通过递归调用完成数据处理。所有算子统一实现Open()、Next()、Close()三类函数,Open()初始化算子资源,Next()单次调取一条元组,无数据时返回结束标记,Close()释放资源
(1)执行流程
- 初始化阶段 :从根节点开始,递归调用
open(),一直传递到最底层的扫描算子,完成所有资源初始化。 - 数据处理阶段 :从根节点开始调用
next(),递归向下层要数据;下层处理完一行,就向上层返回一行;层层处理,最终从根节点输出一行结果。 - 结束阶段 :当
next()返回空时,从根节点递归调用close(),逐层释放资源。
(2)例子
示例SQL:
sql
SELECT name, salary
FROM employees
WHERE department = '研发部'
ORDER BY salary DESC;
执行计划树:
plaintext
Sort(salary DESC)       ------ 阻断算子(根节点)
  └── Project(name, salary)  ------ 流水线算子
        └── Select(department='研发部')  ------ 流水线算子
              └── SeqScan(employees)    ------ 流水线算子(叶子节点)
原始数据:
| id | name | department | salary |
|---|---|---|---|
| 1 | 张三 | 研发部 | 18000 |
| 2 | 李四 | 市场部 | 15000 |
| 3 | 王五 | 研发部 | 22000 |
| 4 | 赵六 | 研发部 | 16000 |
| 5 | 孙七 | 人事部 | 13000 |
| 6 | 周八 | 研发部 | 20000 |
执行全过程
1. 初始化:递归 open()
从根节点自上而下调用 open(),逐层初始化资源,最终扫描算子打开表文件,行指针指向第 1 行。
2. 核心迭代:递归 next()
客户端反复调用根节点 next(),每次获取一行结果。
- 第 1 次调用
Sort.next()(阻断逻辑触发)
Sort 是阻断算子,必须先拿到全部数据才能输出。它循环调用下层拉取数据:- 数据沿
SeqScan → Select → Project逐行流动:扫描读一行 → 过滤部门 → 提取目标列,符合条件的行存入 Sort 内部缓冲区。 - 扫描到文件末尾返回
null后,Sort 对 4 条有效数据执行全量降序排序:
王五(22000) → 周八(20000) → 张三(18000) → 赵六(16000) - 返回排序后的第 1 行给客户端。
- 数据沿
- 第 2~4 次调用
Sort.next()
直接从内部缓冲区按指针逐行返回,无需再访问下层算子。 - 第 5 次调用
Sort.next()
缓冲区读取完毕,返回null,查询结束。
3. 收尾:递归 close()
从根节点自上而下调用 close(),逐层释放资源、关闭文件。
(3)优缺点
优点:1.简单统一(所有算子接口统一) 2.支持流水线 3.节省内存,不用保存大量中间结果
缺点:频繁进行函数调用。开销大
4.物化模型
(1)执行流程
物化模型:每个算子把自己的全部结果计算出来,保存下来,再交给下一个算子。也就是:先算完 → 存起来 → 再传给下一层 。对比迭代器的「逐行流动」,物化模型的核心是:每个算子一次性处理完所有输入,生成完整的中间结果集,再整体交付给上层算子。每层都是 "全量输入→全量输出",没有逐行迭代的过程。
(2)例子
第 1 步:全表扫描 → 物化全量原始数据
SeqScan 算子一次性读取 employees 表全部 6 行数据,生成中间结果集 R1(完整原始表),整体交付给 Select 算子。
中间结果 R1:全部 6 行原始数据
第 2 步:选择过滤 → 物化过滤后结果
Select 算子拿到完整的 R1 后,一次性对所有 6 行执行条件过滤,保留研发部的 4 行,生成中间结果集 R2,整体交付给 Project 算子。
中间结果 R2:4 行符合条件的完整数据(张三、王五、赵六、周八)
第 3 步:列投影 → 物化简选列结果
Project 算子拿到完整的 R2 后,一次性去掉多余列,只保留 name 和 salary 两列,生成中间结果集 R3,整体交付给 Sort 算子。
中间结果 R3:4 行两列数据 ------ (张三,18000)、(王五,22000)、(赵六,16000)、(周八,20000)
第 4 步:排序 → 物化最终结果
Sort 算子拿到完整的 R3 后,一次性执行全量降序排序,生成最终结果集 R4,整体返回给客户端。
最终结果 R4:王五 (22000) → 周八 (20000) → 张三 (18000) → 赵六 (16000)
(3)核心特点
- 全量交付,无逐行交互
算子之间只有一次完整结果的交付,没有反复的next()调用,不存在行级流水线。 - 所有算子本质都是阻断式
每个算子都必须等下层全部做完才能开始工作,没有流水线算子与阻断算子的区分。 - 内存占用高
每一层都会产生一份完整的物化中间结果,n 层算子就会有 n 份全量数据副本,数据量大时内存压力极大。 - 结果返回延迟高
必须等从最底层到最顶层所有算子全部执行完,才能返回结果,无法像迭代器模型那样边执行边输出第一行。
5.向量化模型
(1)执行流程
向量化执行 = 不再一次处理一条记录,而是一次处理一批记录,利用CPU高速计算能力提升查询性能。
(2)例子
1. 初始化:递归 open()
与迭代器模型逻辑一致,自上而下递归初始化,每层算子分配批次缓冲区,用于存放一批列向量数据。
2. 核心迭代:逐批拉取与处理
客户端反复调用根节点next(),每次获取一批结果,而非单行。
第 1 次调用 Sort.next()(批级阻断触发)
Sort 是阻断算子,需收集全部批次数据后排序输出。它循环调用下层算子拉取批次:
- 第 1 批数据流转
SeqScan.next () → 读取前 2 行,返回列向量批次:name=[张三, 李四],department=[研发部, 市场部],salary=[18000, 15000]
Select.next () → 批量判断 department 向量,一次性过滤掉不符合条件的李四,输出过滤后批次:name=[张三],department=[研发部],salary=[18000]
Project.next () → 批量剔除 department 列,输出投影后批次:name=[张三],salary=[18000]
Sort 将该批数据存入全局缓冲区。 - 第 2 批数据流转
SeqScan.next () → 读取中间 2 行,返回批次:name=[王五, 赵六],department=[研发部, 研发部],salary=[22000, 16000]
Select 批量过滤(全部符合)→ Project 批量投影 → Sort 存入缓冲区。 - 第 3 批数据流转
SeqScan.next () → 读取最后 2 行,返回批次:name=[孙七, 周八],department=[人事部, 研发部],salary=[13000, 20000]
Select 过滤掉孙七 → Project 投影 → Sort 存入缓冲区。 - 全量排序
SeqScan.next () 返回空批次,Sort 确认数据拉取完毕。此时缓冲区共 4 行数据,一次性执行全量降序排序,得到最终有序结果:王五(22000) → 周八(20000) → 张三(18000) → 赵六(16000)
排序完成后,Sort 按批次大小拆分结果,返回第 1 批:name=[王五, 周八],salary=[22000, 20000]
第 2 次调用 Sort.next()
直接从排序后的结果缓冲区返回第 2 批:name=[张三, 赵六],salary=[18000, 16000]
第 3 次调用 Sort.next()
缓冲区读取完毕,返回空批次,查询结束。
3. 收尾:递归 close()
自上而下逐层释放资源,清空批次缓冲区,关闭数据文件。
(3)优缺点
优点:大幅减少函数调用次数,适配海量数据扫描;紧凑循环处理数组,编译器可深度优化,CPU缓存利用率高。
缺点:小批量轻量查询存在批次等待开销,延迟高于迭代器模型。