✍✍计算机毕设指导师**
⭐⭐个人介绍:自己非常喜欢研究技术问题!专业做Java、Python、小程序、安卓、大数据、爬虫、Golang、大屏等实战项目。
⛽⛽实战项目:有源码或者技术上的问题欢迎在评论区一起讨论交流!也可以在主页上或文末下与博主交流~~
⚡⚡Java、Python、小程序、大数据实战项目集](https://blog.csdn.net/2301_80395604/category_12487856.html)
⚡⚡文末获取源码
温馨提示:文末有CSDN平台官方提供的博客联系方式!
温馨提示:文末有CSDN平台官方提供的博客联系方式!
温馨提示:文末有CSDN平台官方提供的博客联系方式!
病毒式社交媒体趋势和参与度分析系统-简介
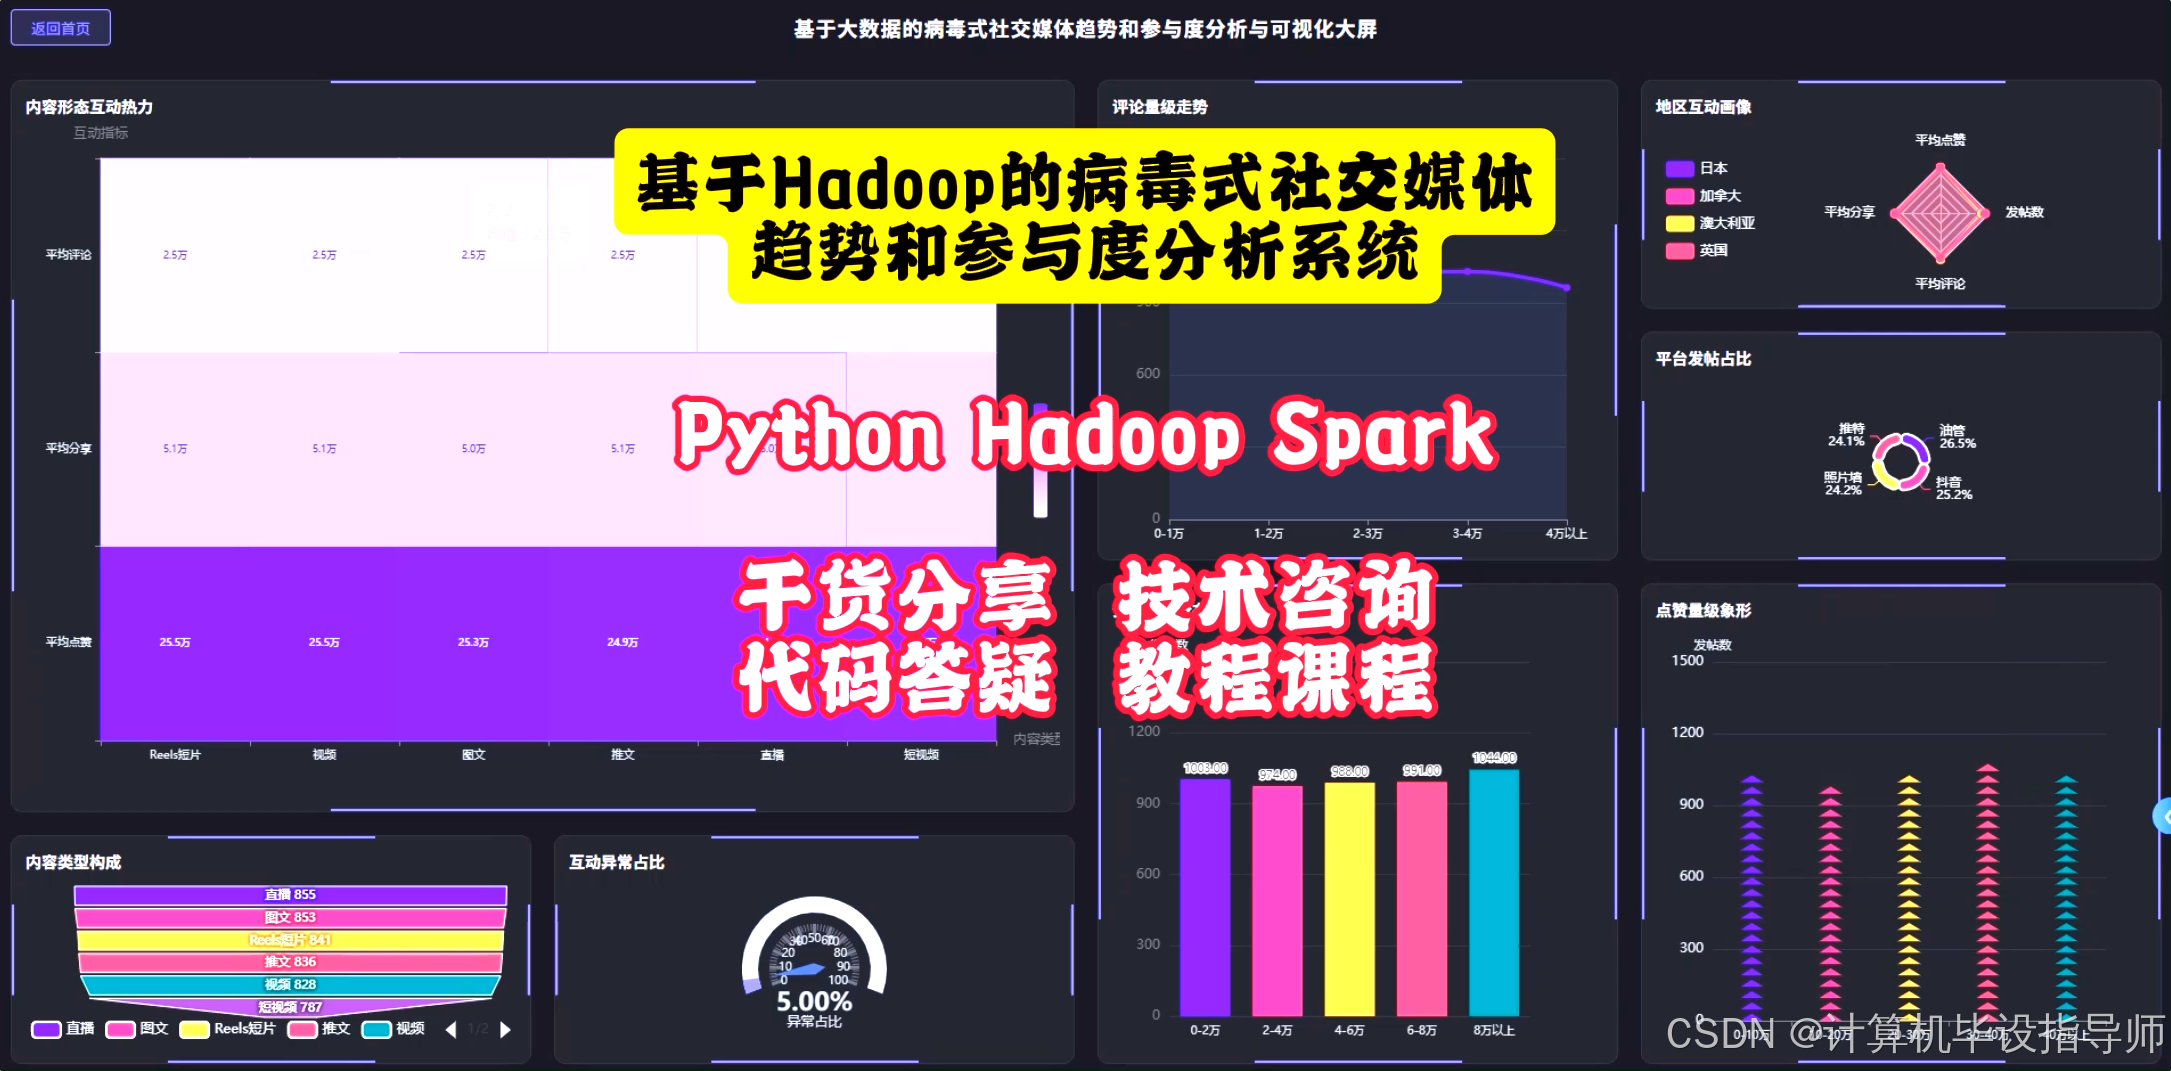
本系统是一个基于Python语言开发的病毒式社交媒体趋势和参与度分析系统,底层依托Hadoop与Spark大数据框架处理海量社交数据,后端采用Django框架提供稳定的数据接口服务,前端则通过Vue结合Echarts将分析结果以丰富的图表形式呈现。系统围绕社交媒体平台的传播趋势与用户参与行为,精心设计了16个核心功能模块。在基础数据统计方面,系统支持平台分布量、话题标签榜、内容形式比等维度的占比分析,并通过按区域、互动等级、播放量、点赞量等指标进行分组聚合与分桶统计,精准刻画内容曝光分布形态与各地区的互动效率差异,比如对比四大平台的平均点赞分享评论数据,或者交叉分析各地区在不同平台上的内容量分布。在进阶分析层面,系统引入了三种核心算法来揭示数据背后的深层规律。利用K-Means算法对帖子的观看、点赞、分享和评论等多维互动指标进行标准化聚类,将帖子分为高播低赞、均衡型等典型画像群体,支撑精准运营决策。借助FP-Growth算法挖掘平台、话题标签、内容形式与互动等级之间的频繁项集与关联规则,发现病毒传播的潜在模式,评估哪些组合更容易带来高参与度。同时,采用Isolation Forest算法对互动指标组合异常的帖子进行检测,有效识别极低播放却极高点赞等数据异常情况,帮助排查刷量行为。整套系统从数据清洗、分布式计算到可视化展示形成完整闭环,全面展现了大数据技术在社交媒体业务场景中的实际落地效果。
病毒式社交媒体趋势和参与度分析系统-技术
大数据框架:Hadoop+Spark(本次没用Hive,支持定制)
开发语言:Python+Java(两个版本都支持)
后端框架:Django+Spring Boot(Spring+SpringMVC+Mybatis)(两个版本都支持)
前端:Vue+ElementUI+Echarts+HTML+CSS+JavaScript+jQuery
数据库:MySQL
病毒式社交媒体趋势和参与度分析系统-背景
如今各种社交媒体平台早就成了大家日常分享和获取信息的主要阵地,一条帖子要是火了,那传播速度和影响力是真不小。不过面对海量的帖子数据,光靠人工去翻看根本摸不清整体传播趋势,也说不清到底哪种内容形式更容易被大家转发点赞。对于很多做内容的人来说,怎么从成堆的数据里找出规律,看看不同平台和地区的用户喜欢啥,一直是个挺让人头疼的事。这就需要有一套靠谱的大数据系统来帮忙梳理。结合Hadoop和Spark这些大数据工具,把那些零散的社交媒体数据汇总到一块儿算一算,其实就能看出很多门道,这也是咱们做这个病毒式社交媒体趋势和参与度分析系统的初衷,就是想通过数据把社交媒体的传播热度看明白。
做这个系统的实际意义,其实就是帮着把杂乱无章的社交媒体数据理出个头绪来。一方面,它能把各个平台的帖子分布、不同话题的点赞情况算得清清楚楚,让看数据的人一眼就能知道哪个平台或者哪个话题更受待见。另一方面,系统里加了聚类和关联规则这些算法,能找出帖子互动里的隐藏规律,比如哪种内容形式搭配啥话题更容易火,或者哪些地方的用户更爱评论,这对实际做内容运营还是挺有参考价值的。加上异常检测功能,也能帮忙揪出一些看着就不正常的数据。整体来说,作为一个毕业设计,虽然算不上多宏大,但确实能把大数据知识串起来落地练一练,对咱们弄懂分布式计算怎么解决实际问题挺有帮助,也希望能给同样做这类项目的人一点思路。
病毒式社交媒体趋势和参与度分析系统-视频展示
基于Hadoop的病毒式社交媒体趋势和参与度分析系统源码
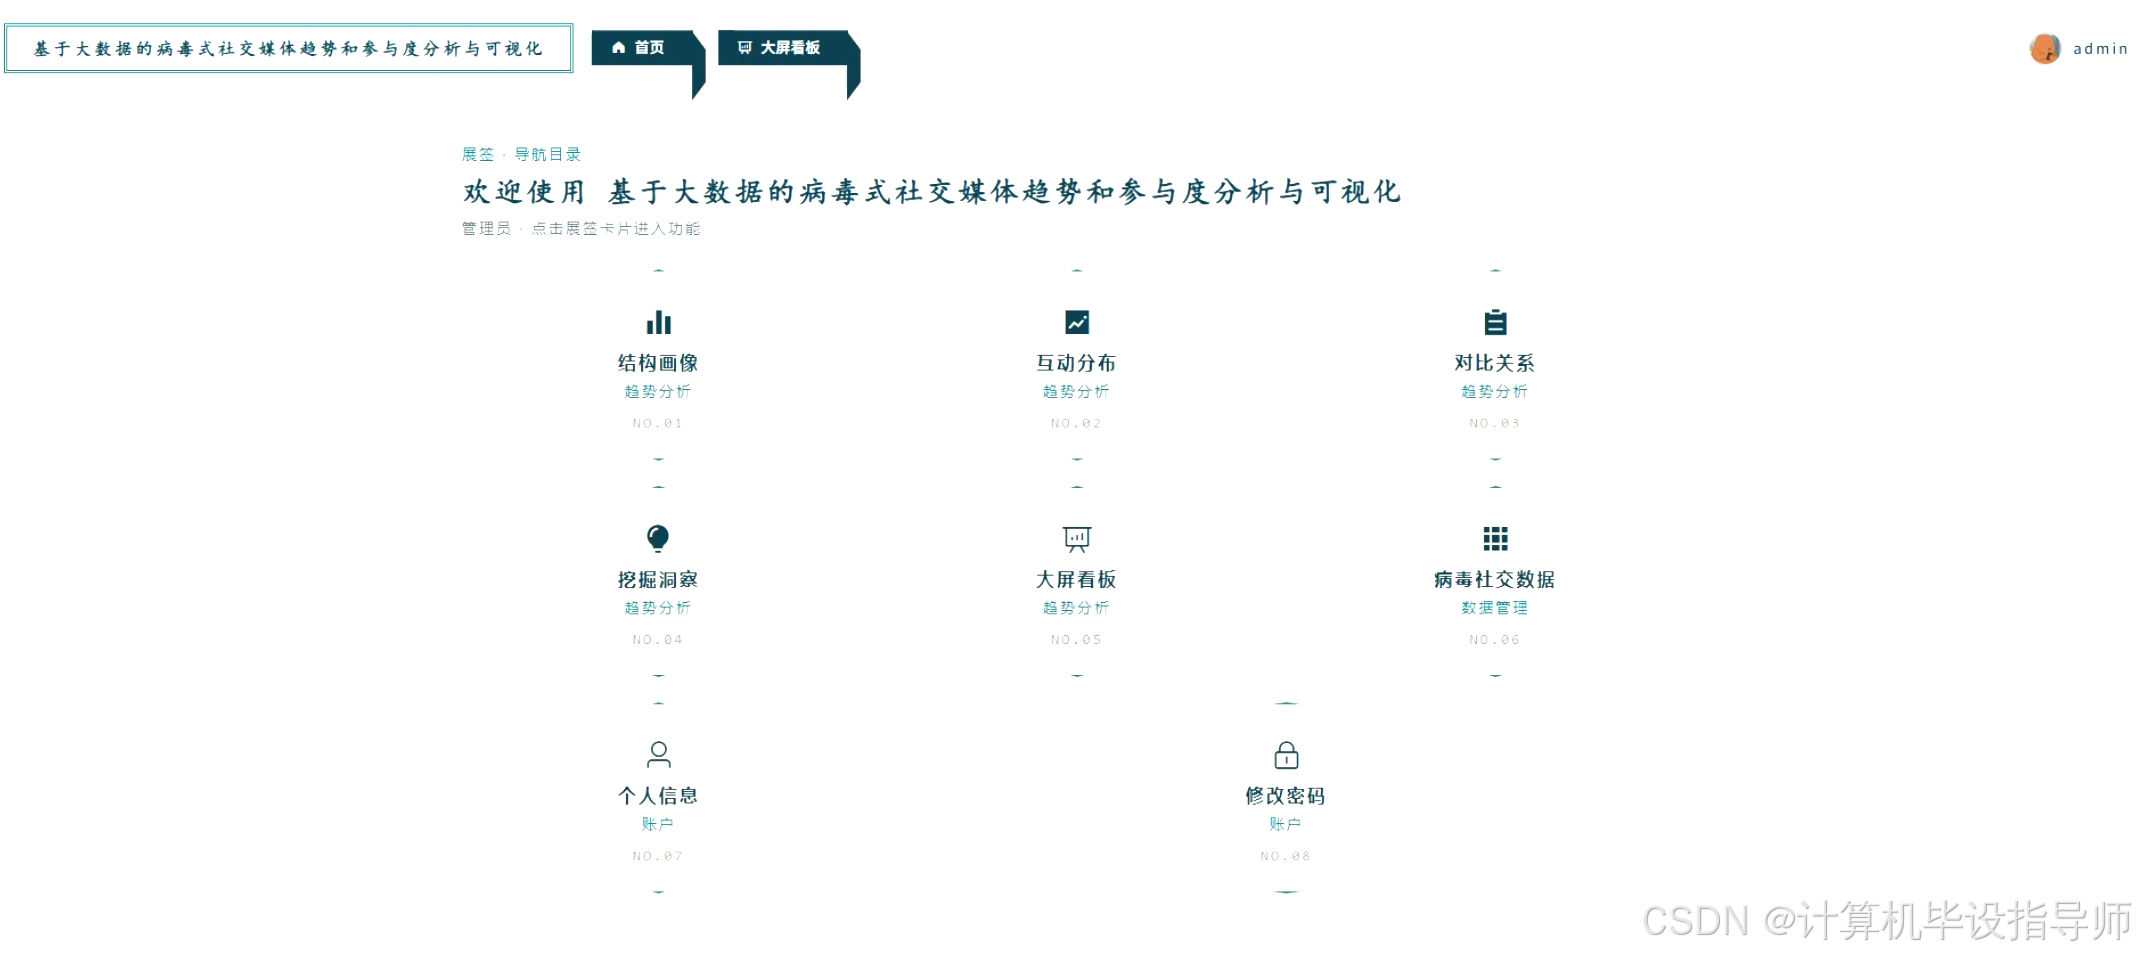
病毒式社交媒体趋势和参与度分析系统-图片展示
病毒式社交媒体趋势和参与度分析系统-代码展示
python
spark = SparkSession.builder.appName("ViralSocialMediaAnalysis").config("spark.driver.memory", "4g").getOrCreate()
def analyze_hashtag_engagement(df):
    df.createOrReplaceTempView("social_media_data")
    result = spark.sql("""
        SELECT Hashtag, COUNT(Post_ID) as post_count, AVG(Views) as avg_views, AVG(Likes) as avg_likes, AVG(Shares) as avg_shares, AVG(Comments) as avg_comments
        FROM social_media_data GROUP BY Hashtag ORDER BY avg_likes DESC
    """)
    result_pd = result.toPandas()
    result_pd['engagement_rate'] = (result_pd['avg_likes'] + result_pd['avg_shares'] + result_pd['avg_comments']) / result_pd['avg_views']
    result_pd['engagement_rate'] = result_pd['engagement_rate'].fillna(0)
    return result_pd.to_dict('records')
def process_kmeans_clustering(df):
    feature_cols = ['Views', 'Likes', 'Shares', 'Comments']
    vec_assembler = VectorAssembler(inputCols=feature_cols, outputCol="features")
    assembled_df = vec_assembler.transform(df)
    scaler = StandardScaler(inputCol="features", outputCol="scaled_features", withStd=True, withMean=True)
    scaler_model = scaler.fit(assembled_df)
    scaled_df = scaler_model.transform(assembled_df)
    kmeans = KMeans(featuresCol="scaled_features", predictionCol="cluster_id", k=4, seed=42)
    model = kmeans.fit(scaled_df)
    clustered_df = model.transform(scaled_df)
    cluster_summary = clustered_df.groupBy("cluster_id").agg(count("Post_ID").alias("post_count"), avg("Views").alias("avg_views"), avg("Likes").alias("avg_likes"), avg("Shares").alias("avg_shares"))
    return cluster_summary.toPandas().to_dict('records')
def mine_tag_association_rules(df):
    items_df = df.select(col("Platform"), col("Hashtag"), col("Content_Type"), col("Engagement_Level"))
    items_rdd = items_df.rdd.map(lambda row: [str(row.Platform), str(row.Hashtag), str(row.Content_Type), str(row.Engagement_Level)])
    transactions = items_rdd.map(lambda row: (row,)).toDF(["items"])
    fpgrowth = FPGrowth(itemsCol="items", minSupport=0.05, minConfidence=0.3)
    model = fpgrowth.fit(transactions)
    freq_itemsets = model.freqItemsets
    association_rules = model.associationRules
    rules_pd = association_rules.toPandas()
    rules_pd['antecedent'] = rules_pd['antecedent'].apply(lambda x: ','.join(x))
    rules_pd['consequent'] = rules_pd['consequent'].apply(lambda x: ','.join(x))
    return rules_pd[['antecedent', 'consequent', 'confidence', 'lift']].to_dict('records')
病毒式社交媒体趋势和参与度分析系统-结语
计算机毕设季写代码确实不容易,踩坑、报错、熬夜都是常态😭。如果这套系统的思路和代码能帮大家少走一些弯路,这篇文章就很有价值了。
觉得内容有用的话,顺手点赞、收藏、关注支持一下,你们的鼓励是我持续更新的最大动力。
有任何关于大数据技术或毕设的问题,欢迎在评论区留言讨论,我看到都会尽量回复。咱们一起交流、共同进步,争取都能顺利毕业、轻松通过答辩!🎓
实战项目:有源码或者技术上的问题欢迎在评论区一起讨论交流!
如果遇到具体的技术问题或其他需求,你也可以问我,我会尽力帮你分析和解决问题所在,支持我记得点赞、收藏,再点个关注,学习不迷路!~~