【声明】本博客所有内容均为个人业余时间创作,所述技术案例均来自公开开源项目(如Github,Apache基金会),不涉及任何企业机密或未公开技术,如有侵权请联系删除
标题
17、【数学】【基础】泰勒级数是什么:用多项式逼近函数
背景
上篇 blog
把级数讲清了:无穷级数不是"加无穷多次",而是部分和 S n S_n Sn 的极限 ------ S n S_n Sn 有落点则收敛、该落点就是和;几何级数在 ∣ r ∣ < 1 |r|<1 ∣r∣<1 时收敛( ∑ k ≥ 0 r k = 1 1 − r \sum_{k\ge0}r^{k}=\dfrac{1}{1-r} ∑k≥0rk=1−r1、 ∑ k ≥ 1 r k = r 1 − r \sum_{k\ge1}r^{k}=\dfrac{r}{1-r} ∑k≥1rk=1−rr, 1 2 + 1 4 + ⋯ = 1 \frac12+\frac14+\cdots=1 21+41+⋯=1 即是后者),而调和级数 ∑ 1 / n \sum1/n ∑1/n 虽然项趋于 0 0 0、却依然发散。还留下一条判据:项趋于 0 0 0 只是收敛的必要条件,不充分。
上篇讲的级数,每一项都是常数 。本篇把级数用到函数 上:能不能把一个函数写成一串常数乘以 x x x 的各次幂之和?这就是泰勒级数 ------它把 sin \sin sin、 e x e^{x} ex 这些函数,变成一串"最好算"的多项式。
为什么想用多项式逼近函数
原因很功利:多项式是最好算的函数。
它只含加法和乘法------没有开方、没有指数、没有三角函数。计算机的硬件恰好就擅长这两件事(一次乘加就是一条指令)。如果能把 sin x \sin x sinx、 e x e^{x} ex、 ln x \ln x lnx 这些"高级函数"换成一串多项式之和,那么:
- 数值计算:计算器、CPU 里的三角函数/指数,就是靠这种多项式近似实现的;
- 估计与近似 :小量时用前一两项就能得到很好的近似(如 sin x ≈ x \sin x\approx x sinx≈x);
- 求导、积分:对多项式逐项做即可,比直接处理复杂函数容易得多。
以 e x e^{x} ex 为例,它在 AI 里出现的频率极高------softmax 的分子就是 e z e^{z} ez、log-sum-exp 也要反复算指数。能用一个只含乘加的式子去逼近它,对硬件实现和数值稳定都意味着实实在在的好处。
更一般地说,只要函数在某点足够光滑(能求各阶导数),就可以在那里做泰勒展开 。这是一条非常通用的工具:物理里的小角近似 sin θ ≈ θ \sin\theta\approx\theta sinθ≈θ、工程上把非线性系统"线性化",背后用的都是它。
问题是:凭什么一个光滑函数能写成一串多项式之和? 先看它怎么"一点点贴合"。
从切线开始:一点处的逐阶贴合
固定一个点(通常取 x = 0 x=0 x=0),用多项式去"复制"函数在这一点附近的样子。阶数越高,复制得越全:
- 0 阶 :只要求函数值 相同------用一条水平线 f ( 0 ) f(0) f(0);
- 1 阶 :再要求斜率 相同------用切线 f ( 0 ) + f ′ ( 0 ) x f(0)+f'(0)x f(0)+f′(0)x;
- 2 阶 :再要求弯曲程度 (二阶导)相同------加上 f ′ ′ ( 0 ) 2 x 2 \frac{f''(0)}{2}x^{2} 2f′′(0)x2;
- 依次匹配三阶导、四阶导......
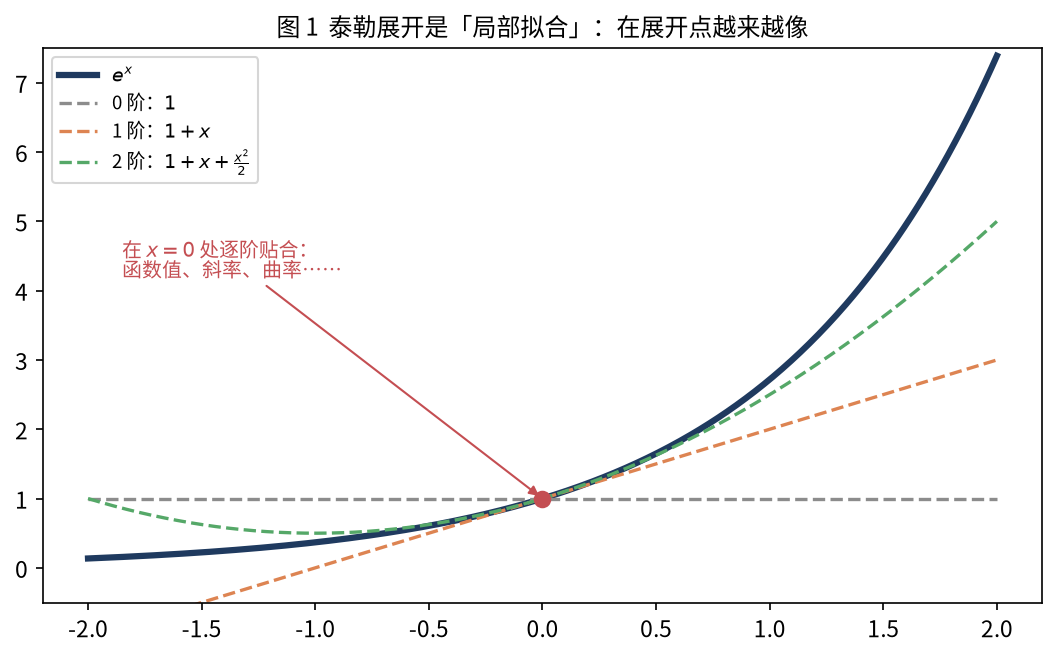
图 1 用 e x e^{x} ex 演示:0 阶、1 阶、2 阶多项式在 x = 0 x=0 x=0 处都经过同一点、且随阶数升高越来越贴合。注意它们都是局部地像------离展开点越远,低阶多项式偏得越多;要靠更高阶、更多项把它"拉回来"。
泰勒级数与麦克劳林级数
把这个"逐阶匹配"写成级数,就得到泰勒级数(Taylor series) :在点 a a a 处展开,
f ( x ) = ∑ n = 0 ∞ f ( n ) ( a ) n ! ( x − a ) n f(x)=\sum_{n=0}^{\infty}\frac{f^{(n)}(a)}{n!}\,(x-a)^{n} f(x)=n=0∑∞n!f(n)(a)(x−a)n
当 a = 0 a=0 a=0(在原点展开)时,它有个专门名字------麦克劳林级数(Maclaurin series):
f ( x ) = ∑ n = 0 ∞ f ( n ) ( 0 ) n ! x n f(x)=\sum_{n=0}^{\infty}\frac{f^{(n)}(0)}{n!}\,x^{n} f(x)=n=0∑∞n!f(n)(0)xn
其中 f ( n ) ( a ) f^{(n)}(a) f(n)(a) 表示在 a a a 处的 n n n 阶导数、 n ! n! n! 是阶乘。取前若干项,就是一个多项式 ------它正是级数的部分和:
S N ( x ) = ∑ n = 0 N f ( n ) ( 0 ) n ! x n S_N(x)=\sum_{n=0}^{N}\frac{f^{(n)}(0)}{n!}\,x^{n} SN(x)=n=0∑Nn!f(n)(0)xn
所以"泰勒多项式"就是"泰勒级数的部分和" ,而级数本身则是这些多项式的极限。各项含义也很直观:函数值给出常数项、一阶导给出一次项系数、二阶导给出二次项系数......至于系数里的 f ( n ) ( 0 ) / n ! f^{(n)}(0)/n! f(n)(0)/n! 到底怎么来的,下一篇专门推导;这里先把结论用起来。
三个名字:泰勒多项式、泰勒级数、麦克劳林级数
刚接触时容易混,一次分清:
| 名字 | 指什么 |
|---|---|
| 泰勒多项式 | 截断到第 N N N 项的那个多项式 S N S_N SN(有限项、能直接算) |
| 泰勒级数 | 让 N → ∞ N\to\infty N→∞ 后的无穷级数 |
| 麦克劳林级数 | 展开点取 a = 0 a=0 a=0 的泰勒级数(原点处的特例) |
三者的关系就是上篇"部分和 ↔ 级数"的关系:泰勒多项式是部分和,泰勒级数是要逼近的极限。 实际计算时永远只用多项式(有限项),级数是它背后的"完整版";所以日常说的"泰勒展开",通常指"取若干项做一个多项式近似"。
几个最常用的展开
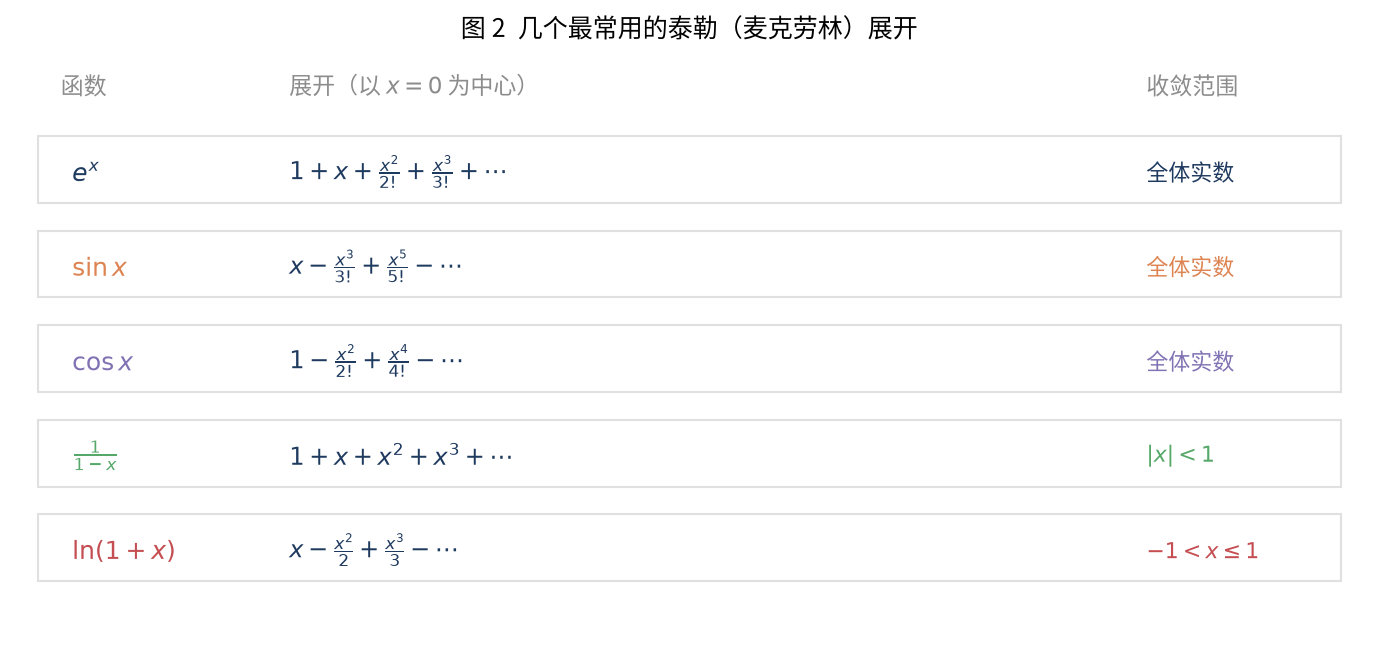
图 2 列了五个最常用的麦克劳林展开。有两个观察:
- e x e^{x} ex、 sin x \sin x sinx、 cos x \cos x cosx 的展开都非常规整(阶乘作分母),而且对全体实数都成立;
- 1 1 − x = 1 + x + x 2 + ⋯ \dfrac{1}{1-x}=1+x+x^{2}+\cdots 1−x1=1+x+x2+⋯ 其实就是上篇的几何级数 ------这也解释了它为什么只在 ∣ x ∣ < 1 |x|<1 ∣x∣<1 内有效。
这两点也说明工程实现里最"敢用"的就是 e x e^{x} ex、 sin \sin sin、 cos \cos cos 的展开------它们处处有效;而 1 1 − x \frac{1}{1-x} 1−x1、 ln ( 1 + x ) \ln(1+x) ln(1+x) 必须先确认变量落在收敛范围内,否则越算越错。
部分和逼近
拿 sin x \sin x sinx 试一遍。它的展开是 x − x 3 3 ! + x 5 5 ! − ⋯ x-\frac{x^{3}}{3!}+\frac{x^{5}}{5!}-\cdots x−3!x3+5!x5−⋯,逐项加上去:
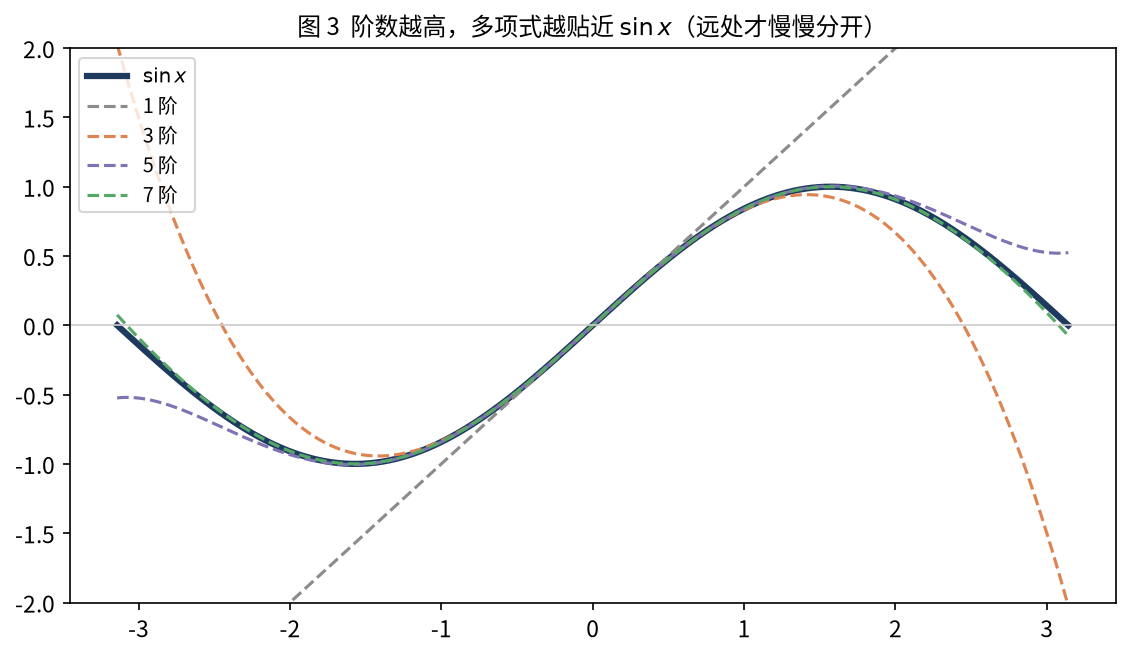
图 3 里,1 阶(直线)只在原点附近像;3 阶就能盖住一大段;5 阶、7 阶几乎和 sin x \sin x sinx 重合,直到离原点很远才慢慢分开。项数越多、覆盖的范围越广 ------这正是"用多项式逼近函数"的直观画面,也是第 15 篇图 2 里 cos / sin \cos/\sin cos/sin 部分和收敛的来源。
手算一个例子更实在:用 sin x = x − x 3 3 ! + x 5 5 ! − ⋯ \sin x=x-\frac{x^3}{3!}+\frac{x^5}{5!}-\cdots sinx=x−3!x3+5!x5−⋯ 估 sin ( 0.1 ) \sin(0.1) sin(0.1),前两项是 0.1 0.1 0.1 与 − 0.1 3 6 ≈ − 0.0001667 -\frac{0.1^3}{6}\approx-0.0001667 −60.13≈−0.0001667,相加得 0.0998333 0.0998333 0.0998333;而真值约 0.0998334 0.0998334 0.0998334------两项就准到小数点后 7 位 。小量附近泰勒多项式收敛极快,"前面几项就够用"。截断后剩下的尾巴叫余项(remainder),它的大小决定近似的好坏,下一篇专门处理。
一句话:泰勒展开不是"一次性"给出答案,而是在"项数---精度---范围"之间做权衡。
收敛范围:不是到处都灵
但泰勒级数未必在整个数轴上等于原函数。图 4 是最典型的例子:
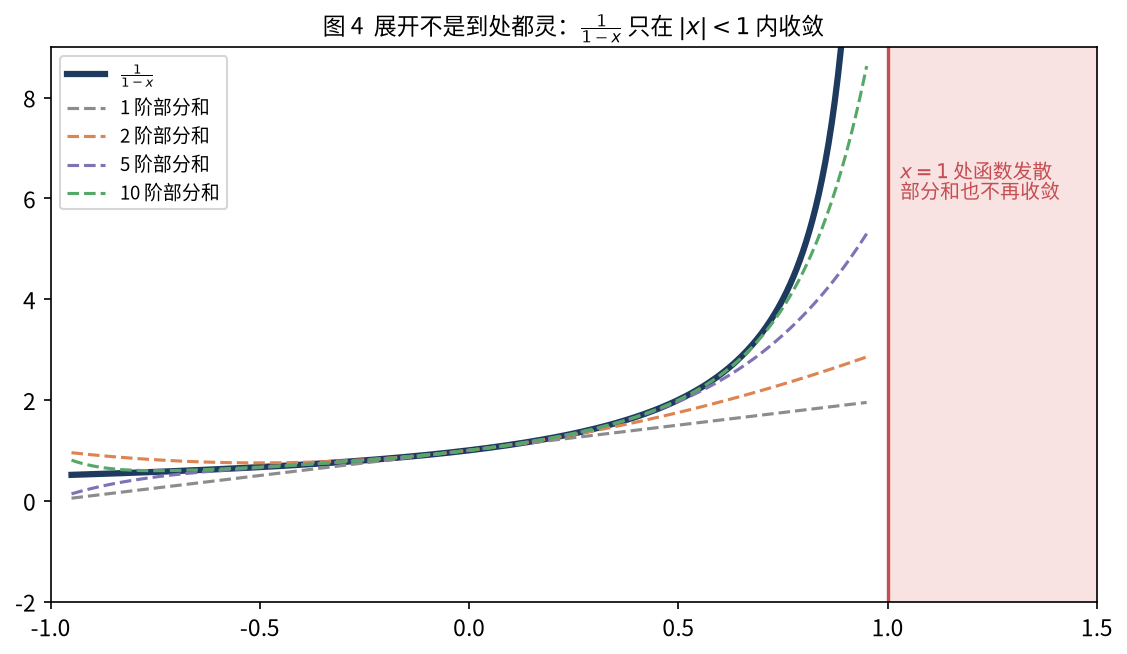
1 1 − x \dfrac{1}{1-x} 1−x1 的展开只在 ∣ x ∣ < 1 |x|<1 ∣x∣<1 内收敛;一旦 x ≥ 1 x\ge1 x≥1,部分和越加越大,和原函数彻底对不上。这引出一个关键概念------收敛半径:展开有效的范围是一个以展开点为中心的区间(复数下是圆盘),超出它,级数就发散。
从图 2 能看到两类情况:
| 函数 | 收敛范围 |
|---|---|
| e x , sin x , cos x e^{x},\ \sin x,\ \cos x ex, sinx, cosx | 全体实数(半径 ∞ \infty ∞) |
| 1 1 − x \dfrac{1}{1-x} 1−x1 | ∣ x ∣ < 1 |x|<1 ∣x∣<1 |
| ln ( 1 + x ) \ln(1+x) ln(1+x) | − 1 < x ≤ 1 -1<x\le1 −1<x≤1 |
为什么有的"处处收敛"、有的"只在某段收敛"?一个直观判据是:收敛半径 = 展开点到"最近的坏点"的距离 。 1 1 − x \frac{1}{1-x} 1−x1 在 x = 1 x=1 x=1 处有个无穷大的坏点,离原点距离为 1 1 1,所以半径是 1 1 1;而 e x e^{x} ex、 sin x \sin x sinx、 cos x \cos x cosx 处处光滑、没有这种坏点,半径就是 ∞ \infty ∞。这条判据的严格版本,留到第 19 篇。
再看图 4 的曲线:在 ∣ x ∣ < 1 |x|<1 ∣x∣<1 内,阶数越高越贴;可无论加到多少阶,一过 x ≥ 1 x\ge1 x≥1 就全都不管用------逼近能力在一条看不见的边界前戛然而止 ,这就是收敛半径的边界效应。(在复数域里,这个"区间"会变成一个以展开点为圆心的圆盘,半径同样由"最近的坏点"决定。)
三个常见疑问
- "为什么一定要在某一点展开?":因为导数是"一点处"的性质;泰勒展开就是把这些局部信息打包成多项式,去复制函数在该点附近的形状;
- "阶数越高一定越好吗?":在收敛范围内越贴近;但超出收敛半径怎么加都没用(图 4),而且高次多项式在远处还可能剧烈振荡;
- "泰勒级数一定等于原函数吗?":不一定。级数可能收敛到一个与原函数不同的值,甚至只在部分区间才等于它------所以"能展开"与"等于原函数"是两件事;
- " ( x − a ) n (x-a)^n (x−a)n 里的 a a a 怎么选?" : a a a 是展开点;离它越近、逼近越好,所以通常取"关心的位置"附近的值,最常见的就是 a = 0 a=0 a=0。
和前几篇的关系
回头看,前几篇用的其实是同一件事:第 11 篇的 e = ∑ 1 / k ! e=\sum1/k! e=∑1/k! 就是 e x e^{x} ex 在 x = 1 x=1 x=1 处的取值;第 15 篇把 i θ i\theta iθ 代进 e x e^{x} ex 的级数,才有了欧拉公式。它们都依赖本篇这条通路------把一个函数写成一串幂。
小结
泰勒级数回答的是"能不能用一个函数在某点的各阶导数,把函数写成多项式之和 ":把 ∑ f ( n ) ( 0 ) n ! x n \sum \frac{f^{(n)}(0)}{n!}x^{n} ∑n!f(n)(0)xn 截断到第 N N N 项,就得到一个多项式(部分和);阶数越高、在展开点附近贴合得越好。它对 e x e^{x} ex、 sin x \sin x sinx、 cos x \cos x cosx 在全实数域成立,对 1 1 − x \frac{1}{1-x} 1−x1 只在 ∣ x ∣ < 1 |x|<1 ∣x∣<1 成立------展开不是到处都灵,有效性由收敛半径决定 。三个名字的关系记住一句话:泰勒多项式是部分和、泰勒级数是极限、麦克劳林级数是原点展开;能不能用、能用到哪,由收敛半径划定。 它把难算的函数换成一串"只有加乘"的多项式,这正是计算器与 CPU 计算这些函数的底层办法。下一篇把公式里那个 f ( n ) ( 0 ) n ! \frac{f^{(n)}(0)}{n!} n!f(n)(0) 是怎么来的讲清楚。
OK,本篇先到这里,如有疑问,欢迎评论区留言讨论,祝各位功力大涨,技术更上一层楼!!!