【声明】本博客所有内容均为个人业余时间创作,所述技术案例均来自公开开源项目(如Github,Apache基金会),不涉及任何企业机密或未公开技术,如有侵权请联系删除
标题
14、【数学】【线性代数】one-hot 与基向量:分类目标为什么能当概率分布
背景
上篇 blog
【数学】【信息论】信息量、熵与交叉熵:从 − log p -\log p −logp 到 KL 散度
把信息量、熵、交叉熵、KL 散度串成了一条链:信息量 − log p -\log p −logp 按真实分布加权平均得到熵,换成预测分布算得到交叉熵,两者之差是 KL;并且在最后用了一个关键的事实------当真实标签是 one-hot 时,交叉熵塌缩成负对数似然:
H ( P , Q ) = − log Q ( 正确 ) H(P,Q) = -\log Q(\text{正确}) H(P,Q)=−logQ(正确)
但上篇是"拿来就用":直接假设 one-hot 就是真实分布 P P P,却没交代它是什么、凭什么能当分布、它在计算里到底在干什么。 本篇专门补上这一块。答案藏在一个双重身份里:one-hot 既是线性代数里的基向量,又是概率论里的退化分布。
起点:标签本是一个编号
分类任务的标签,最初只是一个"第几类"的编号:
- 手写数字识别: y = 3 y=3 y=3(第 4 个类别);
- 语言模型: y = 1024 y=1024 y=1024(词表里的第 1025 个 token)。
它就是个索引(index) ,用一个整数表示"从 n n n 个类别里选了哪一个"。
但模型输出的不是编号------它输出的是长度为 n n n 的一串概率 (对每个类别的预测)。一边是标量(编号),一边是向量(分布),两者对不上。one-hot 就是用来补上这一步的。
one-hot 在干什么
one-hot(独热编码)把"第 i i i 个"展开成一个长度等于类别数的向量 :第 i i i 位是 1 1 1,其余全是 0 0 0。以 5 类、正确答案是第 3 个为例:
y = 2 ⟶ 0 , 0 , 1 , 0 , 0 y=2 \quad\longrightarrow\quad 0,\\ 0,\\ 1,\\ 0,\\ 0 y=2⟶0, 0, 1, 0, 0
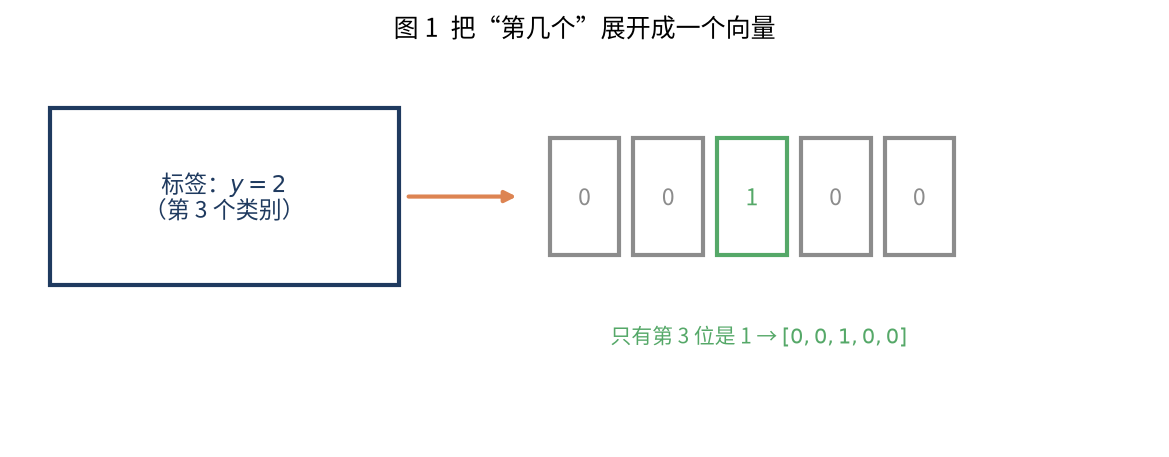
图 1 就是这一步展开。它干了三件事:
- 把标量变成向量 ------这样才能和模型输出的概率向量一一对齐、逐位比较;
- 标记"选中的是谁" ------独一个位置是"热"的( 1 1 1),一眼能看出答案;
- 能参与线性运算------是向量就能做矩阵乘法(后面 embedding 会用到)。
一句话:one-hot 是"类别编号"的向量化表示,目的就是让标签能和模型输出处在同一个空间里。
身份一:它是线性代数里的基向量
0 , 0 , 1 , 0 , 0 0,0,1,0,0 0,0,1,0,0 在数学上有个精确的名字------标准基向量(standard basis vector) e 3 e_3 e3。
在 R n \mathbb{R}^n Rn 里,标准基是一组"每个只有一个 1 1 1"的向量 { e 1 , e 2 , ... , e n } \{e_1,e_2,\dots,e_n\} {e1,e2,...,en},它们的作用是:任何向量都能用它们线性组合出来。
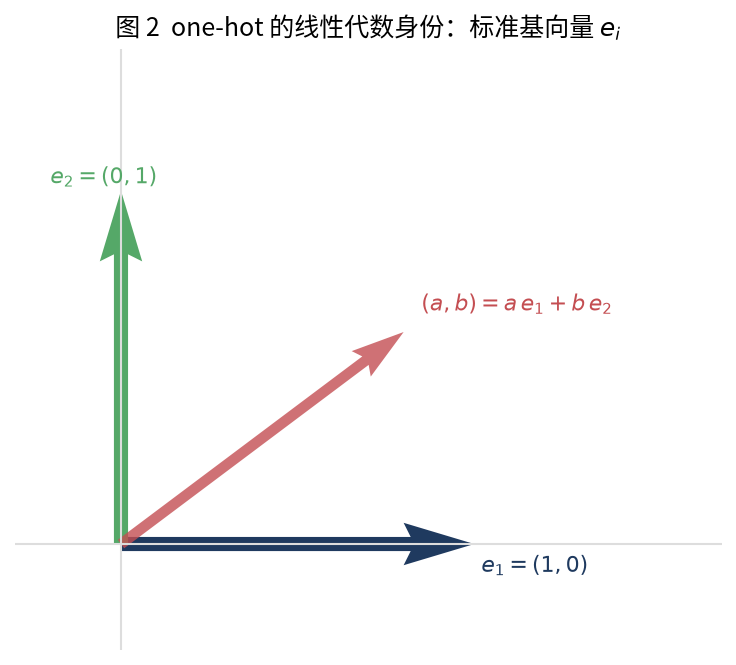
图 2 是最简单的二维情形: e 1 = ( 1 , 0 ) e_1=(1,0) e1=(1,0)、 e 2 = ( 0 , 1 ) e_2=(0,1) e2=(0,1),平面里任何一个向量都能写成 ( a , b ) = a e 1 + b e 2 (a,b)=a\,e_1+b\,e_2 (a,b)=ae1+be2。one-hot 就是 n n n 维空间里这样一支"坐标轴方向的单位向量"------这是它的线性代数身份。
这个身份马上带来一个漂亮的推论:用 e i e_i ei 去乘一个矩阵,等于把矩阵的第 i i i 行取出来(见第 6 节)。
身份二:它是概率论里的退化分布
同样的 0 , 0 , 1 , 0 , 0 0,0,1,0,0 0,0,1,0,0,换个视角看,它又是一个概率分布:
- 每一项都非负;
- 加起来等于 1 1 1;
- 它表示"以 100 % 100\% 100% 的概率押在第 3 个类别上"。
这种把全部概率压在一个点 上的分布,叫退化分布(degenerate distribution)或点质量分布(point mass)------它是所有分布里**最"确定"**的:没有任何犹豫。
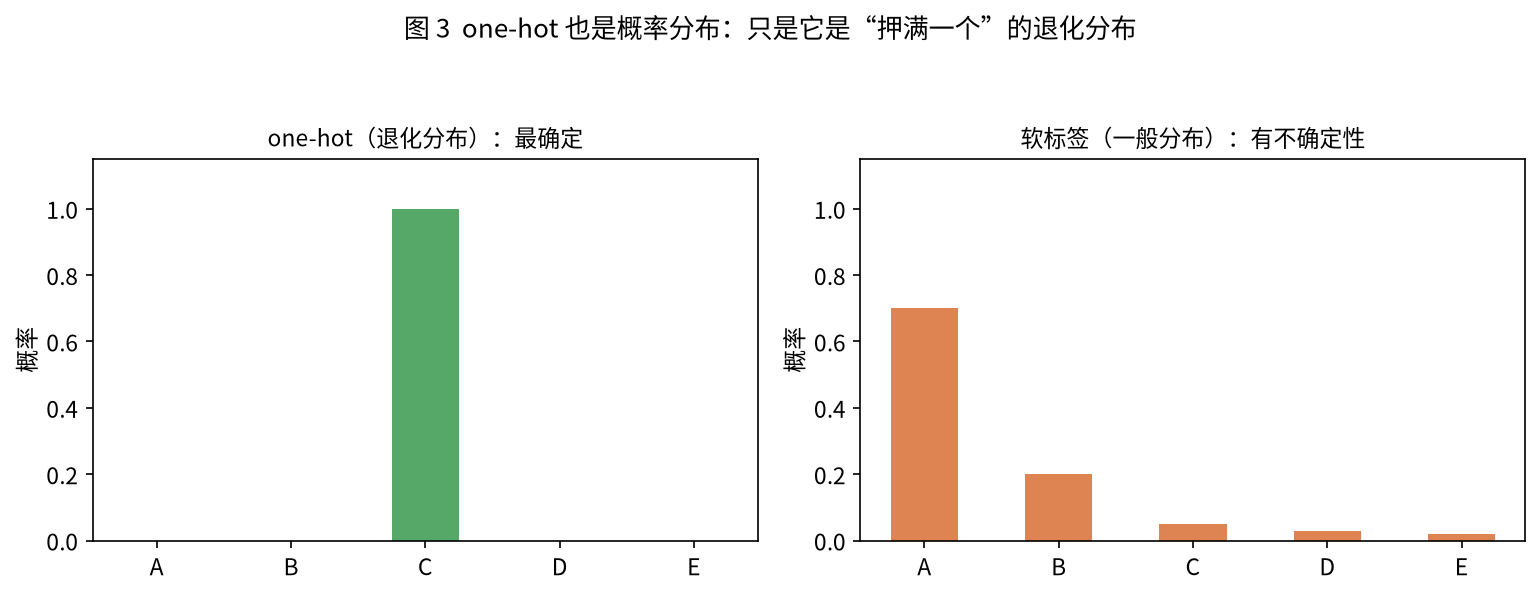
图 3 对比了两个分布:左边是 one-hot(一根柱到顶,其余为 0),右边是软标签 0.7 , 0.2 , 0.05 , ... 0.7,0.2,0.05,\\dots 0.7,0.2,0.05,...(散布在几类上、有不确定性)。正因为 one-hot 是一个合法的概率分布,它才能充当交叉熵里的"真实分布 P P P"。
两个身份合流:熵为 0,损失塌缩
把上面两条合起来,就解释了上篇那个"塌缩"。
它的熵是 0。 熵度量不确定性,而 one-hot 既然 100% 确定,不确定性自然为零:
H ( P ) = − ∑ x P ( x ) log P ( x ) = − 1 ⋅ log 1 = 0 H(P) = -\sum_x P(x)\log P(x) = -1\cdot\log 1 = 0 H(P)=−x∑P(x)logP(x)=−1⋅log1=0
( 0 ⋅ log 0 0\cdot\log 0 0⋅log0 按惯例取 0。)代进上篇的关系 H ( P , Q ) = H ( P ) + K L ( P ∥ Q ) H(P,Q)=H(P)+\mathrm{KL}(P\|Q) H(P,Q)=H(P)+KL(P∥Q),立刻得到:
H ( P , Q ) = K L ( P ∥ Q ) = − log Q ( 正确 ) H(P,Q) = \mathrm{KL}(P\|Q) = -\log Q(\text{正确}) H(P,Q)=KL(P∥Q)=−logQ(正确)
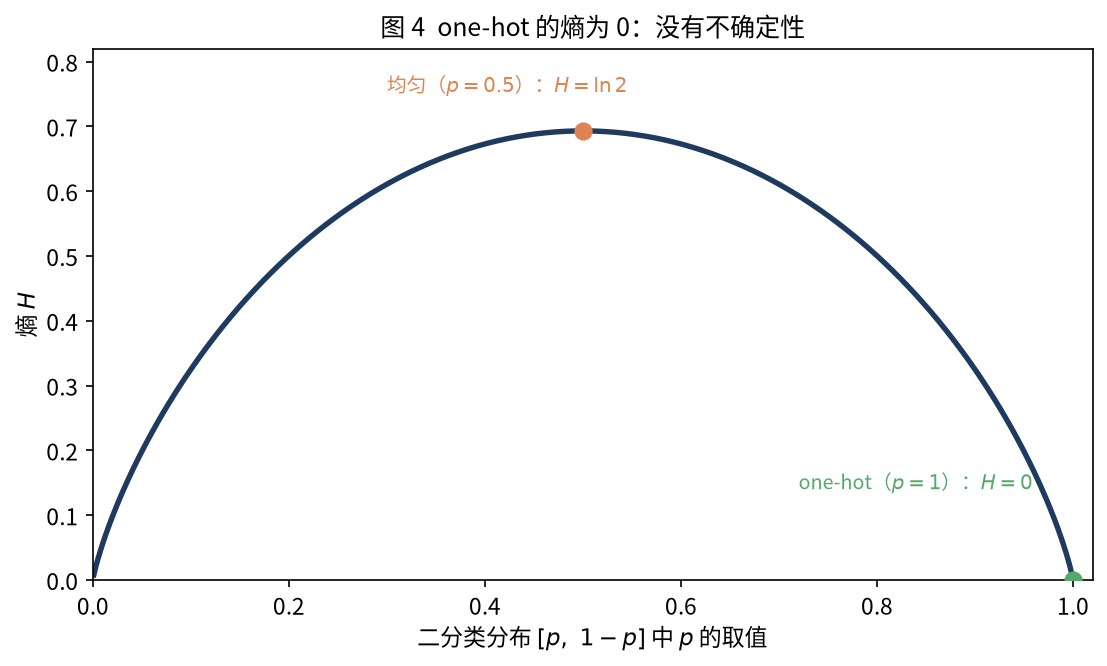
图 4 用二分类分布 p , 1 − p p,1-p p,1−p 画出熵曲线:两端( p = 0 p=0 p=0 或 p = 1 p=1 p=1,即 one-hot)熵为 0 0 0,中间(均匀)熵最大。one-hot 落在熵的最低点 ,所以此时交叉熵、KL、负对数似然三者合一------模型要做的,就是让预测分布 Q Q Q 逼近这个最"尖"的分布,也就是把正确类的概率推向 1。
这就是上篇那句"损失只取决于给正确 token 的概率"的完整来历。
用基向量身份看 embedding
线性代数身份还有一个非常实用的推论。设嵌入矩阵 W W W 有 n n n 行(每个类别一行),用 one-hot e i e_i ei 去乘它:
e i × W = W 的第 i 行 e_i \times W = W \text{ 的第 } i \text{ 行} ei×W=W 的第 i 行
因为 e i e_i ei 只有第 i i i 位是 1 1 1,矩阵乘法里其它行都被 0 0 0 乘没了,剩下的正是第 i i i 行。
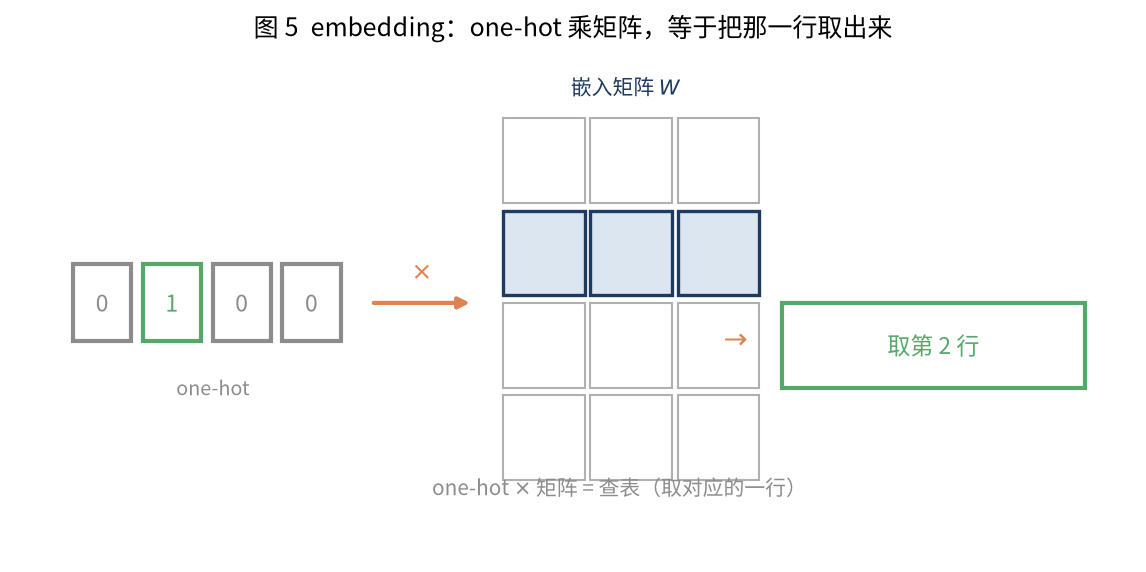
图 5 就是这个动作。"one-hot 乘矩阵"= "按编号取某一行"= 查表(lookup) ------这正是**嵌入(embedding)**层的本质:把第 i i i 个 token 映射成第 i i i 行向量。
谱系:标签的向量表示家族
one-hot 不是孤例,它是一整个"标签表示"家族里最基础的一员:
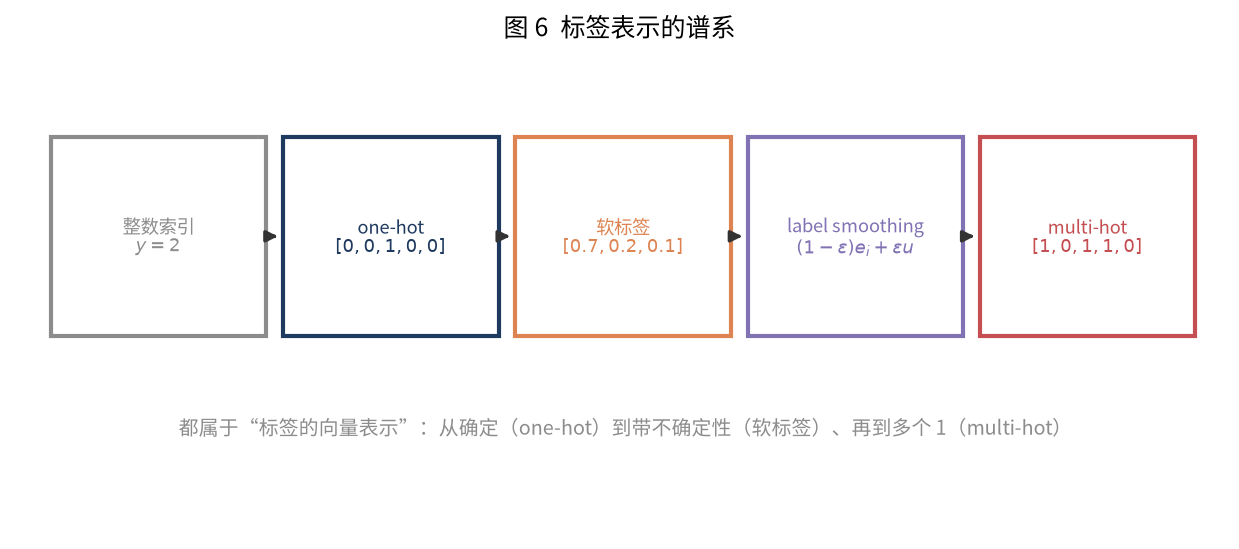
| 表示 | 形式 | 含义 |
|---|---|---|
| 整数索引 | y = 2 y=2 y=2 | 最省空间的原始标签 |
| one-hot | 0 , 0 , 1 , 0 , 0 0,0,1,0,0 0,0,1,0,0 | 展开成基向量/退化分布 |
| 软标签 | 0.7 , 0.2 , 0.1 0.7,0.2,0.1 0.7,0.2,0.1 | 一般概率向量(如蒸馏时老师的输出),求和不塌缩 |
| 标签平滑(label smoothing) | ( 1 − ϵ ) e i + ϵ u (1-\epsilon)e_i+\epsilon\,\mathbf{u} (1−ϵ)ei+ϵu | one-hot 与均匀分布 u \mathbf{u} u 的凸组合,防过拟合 |
| multi-hot | 1 , 0 , 1 , 1 , 0 1,0,1,1,0 1,0,1,1,0 | 多个 1 1 1,表示"多标签";和为 3 ≠ 1 3\ne1 3=1,不是概率分布 |
图 6 把它们连成谱系。两点值得记住:
- one-hot → 软标签 :从"确定"过渡到"带不确定性"。蒸馏就是用老师的软标签 P P P 代替 one-hot,此时交叉熵不再塌缩,而在所有类别上求和------这正是交叉熵作为一般定义的价值;
- one-hot → label smoothing :把 one-hot 和均匀分布按 ( 1 − ϵ ) : ϵ (1-\epsilon):\epsilon (1−ϵ):ϵ 混合。凸组合仍是一个合法分布,但不再"尖"到 log 0 \log 0 log0,能缓解模型过度自信;
- one-hot vs multi-hot :前者"从 n n n 类里选 1 个",后者"一个样本同属多类",所以 multi-hot 有多个 1 1 1、和不为 1 1 1,只在多标签任务里用。
工程视角:sparse,但不必真的构造
大词表下 one-hot 会非常稀疏且巨大 : V = 15 V=15 V=15 万的词表,一个 one-hot 就是 15 万维、只有一个非零------既占内存又浪费计算。
所以实践中存的是整数索引 (y=2),需要时再由框架内部隐式 地当成 one-hot 处理。比如 F.cross_entropy(logits, y) 直接吃索引,内部只取正确那一项,根本不会真的构造出一个 15 万维向量;embedding 层也是"按索引取行",而不是真的做稀疏矩阵乘法。
数学上用 one-hot 理解,工程上用索引执行------两者是同一件事。
小结
one-hot 有两个等价的身份:线性代数上,它是标准基向量 e i e_i ei (任何向量都能由这组基线性组合);概率论上,它是退化分布/点质量 (100% 押在一类,最确定)。正因为它是合法的概率分布,才能当交叉熵里的真实分布 P P P;又因为它的熵为 0 0 0,交叉熵才塌缩成 K L = − log Q ( 正确 ) \mathrm{KL}=-\log Q(\text{正确}) KL=−logQ(正确),即负对数似然。它的基向量身份还顺手解释了 embedding------ e i e_i ei 乘矩阵就是取第 i i i 行,所谓"查表"。从 one-hot 出发,还能推广到软标签、标签平滑、multi-hot 一整个标签表示家族;而工程实现上,用整数索引就够了,one-hot 是理解它的数学视角。
OK,本篇先到这里,如有疑问,欢迎评论区留言讨论,祝各位功力大涨,技术更上一层楼!!!