目录
[1.1 背景](#1.1 背景)
[1.2 评估对象](#1.2 评估对象)
[1.3 评估目标](#1.3 评估目标)
[2.1 核心评估指标](#2.1 核心评估指标)
[2.2 辅助指标(可选)](#2.2 辅助指标(可选))
[2.3 指标定义详解](#2.3 指标定义详解)
[3.1 数据来源](#3.1 数据来源)
[3.2 数据预处理流程](#3.2 数据预处理流程)
[3.3 关键处理步骤](#3.3 关键处理步骤)
[4.1 候选方法对比](#4.1 候选方法对比)
[4.2 最终选择:熵权-VIKOR](#4.2 最终选择:熵权-VIKOR)
[5.1 实验设置](#5.1 实验设置)
[5.2 指标计算结果(示意)](#5.2 指标计算结果(示意))
[5.3 结果解读](#5.3 结果解读)
[5.3.1 连贯性分析](#5.3.1 连贯性分析)
[5.3.2 指令遵循率](#5.3.2 指令遵循率)
[5.3.3 废话率](#5.3.3 废话率)
[5.4 任务类型细分对比](#5.4 任务类型细分对比)
[5.5 优化建议](#5.5 优化建议)
[5.6 小结](#5.6 小结)
摘要 :针对当前通用聊天助手在长对话、复杂指令场景下表现参差不齐的问题,本文构建了一套以连贯性、指令遵循、废话率 为核心指标的效能评估体系。基于真实对话日志完成数据预处理,采用熵权-VIKOR模型进行多指标综合排序,并通过实例分析不同模型在三类任务下的表现差异,为聊天助手的能力评测与迭代优化提供可复现的量化框架。
一、场景介绍
1.1 背景
通用聊天助手(如各类大语言模型对话产品)已从"问答工具"演变为"协作伙伴",应用场景覆盖:
- 多轮知识问答
- 复杂指令执行(格式约束、步骤编排)
- 长文档写作与改写
- 角色扮演与创意生成
然而,当前评估多依赖主观打分或单一准确率,缺乏可量化、可横向对比、可工程落地的效能评价体系。尤其在实际使用中,用户最在意的三个痛点恰恰是:
- 聊着聊着就"断片"(连贯性差)
- 说了很多但没听清指令(指令遵循弱)
- 车轱辘话来回说(废话率高)
1.2 评估对象
本文选取三类典型任务,对主流通用聊天助手进行效能评估:
| 任务类型 | 示例 | 核心挑战 |
|---|---|---|
| 多轮知识问答 | 连续追问技术概念并追问细节 | 上下文一致性、逻辑递进 |
| 复杂指令执行 | "用JSON输出,字段不超过5个,值用英文" | 格式约束、条件组合遵循 |
| 长文改写/创作 | 将一段500字说明改写为3种风格 | 内容保真、冗余控制 |
1.3 评估目标
围绕三个核心问题展开量化:
- 助手在多轮对话中能否保持语义与逻辑连贯?
- 面对复合指令时,约束满足率如何?
- 输出中无效信息(重复、套话、无意义填充)占比多少?
二、指标体系构建
2.1 核心评估指标
| 指标名称 | 符号 | 单位 | 指标性质 | 计算逻辑 |
|---|---|---|---|---|
| 连贯性 | 分(0~1) | 正向指标 | 基于语义相似度+逻辑衔接度综合评分 | |
| 指令遵循率 | % | 正向指标 | 满足约束条件数 / 总约束条件数 × 100% | |
| 废话率 | % | 负向指标 | 无效token数 / 总输出token数 × 100% |
2.2 辅助指标(可选)
| 指标 | 说明 |
|---|---|
| 首字响应时间 | 用户发送后至首个字符输出的延迟 |
| 任务完成率 | 人工判定是否达成用户意图 |
| 重复率 | n-gram重复占比 |
2.3 指标定义详解
连贯性 :
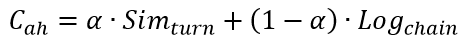
:相邻轮次语义相似度(余弦相似度,基于句向量)
指令遵循率:
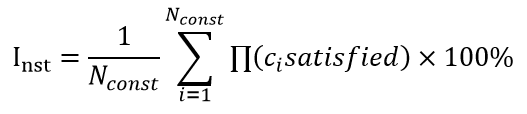
废话率 V_{erb}:
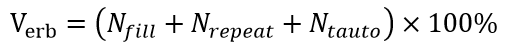
三、指标数据处理
3.1 数据来源
- 对话日志:从测试平台导出500组真实对话(含用户指令、助手回复、轮次标记)
- 标注数据:3名标注员对连贯性进行1~5分标注,取均值归一化至0,1
- 约束解析:使用规则引擎+LLM辅助拆解指令中的约束条件
3.2 数据预处理流程
Matlab
原始对话 → 格式清洗 → 轮次切分 → 约束条件提取 → 指标计算 → 归一化3.3 关键处理步骤
1. 连贯性计算(自动化):
- 使用sentence-transformers生成每轮回复的句向量
- 计算相邻轮次余弦相似度,滑动窗口平滑
- 结合逻辑衔接词检测(如"因此""然而""另外"等)加权
2. 指令约束解析:
- 规则层:正则匹配格式类约束(JSON/XML/长度/语言)
- LLM层:用轻量模型(如7B)拆解复杂指令中的隐含约束
- 人工校验:抽样10%进行一致性检查
3. 废话检测:
- 填充套话词典匹配(可配置)
- n-gram重复检测(n=3,4,阈值Jaccard>0.7)
- 同义反复检测(基于语义相似度聚类)
四、评估模型选择
4.1 候选方法对比
| 方法 | 优点 | 缺点 | 适用性 |
|---|---|---|---|
| 加权平均 | 简单直观 | 权重主观 | 快速筛选 |
| TOPSIS | 考虑正负理想解 | 对指标分布敏感 | 中等样本 |
| VIKOR | 兼顾群体效用与个体遗憾,排序稳定 | 需预设决策机制系数 | ✅ 推荐 |
| GRA | 适合小样本 | 分辨力有限 | 辅助验证 |
4.2 最终选择:熵权-VIKOR
选择理由:
- 熵权法确定客观权重,避免主观偏差
- VIKOR 同时考虑:
- 群体效用(整体表现)
- 个体遗憾(最差指标)
- 通过折衷系数
模型公式:
1. 熵权法:
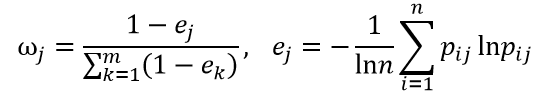
2. VIKOR核心:
- 加权化矩阵:
- 正理想解
- 群体效用
- 个体遗憾
- 综合指标
- 按
五、评估结果分析
5.1 实验设置
选取4个主流通用聊天助手(匿名化表示为A、B、C、D),在三类任务上各测试50组对话,共600组样本。
5.2 指标计算结果(示意)
| 助手 | 连贯性 |
指令遵循率 |
废话率 |
综合得分 |
排名 |
|---|---|---|---|---|---|
| A | 0.82 | 88.5 | 12.3 | 0.214 | 1 |
| B | 0.79 | 92.1 | 8.7 | 0.287 | 2 |
| C | 0.75 | 76.4 | 18.6 | 0.563 | 3 |
| D | 0.71 | 69.8 | 24.2 | 0.791 | 4 |
5.3 结果解读
5.3.1 连贯性分析
- 助手A、B表现优异(>0.79),在多轮追问中能保持语义一致性和逻辑递进
- 助手D在长对话(>10轮)后连贯性明显下降,出现"遗忘前文"和"话题跳跃"现象
- 连贯性与模型参数量、上下文窗口长度正相关,但非唯一决定因素
5.3.2 指令遵循率
- 助手B指令遵循率最高(92.1%),尤其在格式约束(JSON/XML)和复合条件指令上表现突出
- 助手D在复杂指令(≥3个约束条件)上遵循率骤降至52%
- 常见失败模式:忽略长度限制、混淆语言要求、格式嵌套错误
5.3.3 废话率
- 助手B废话率最低(8.7%),输出简洁精准
- 助手D废话率高达24.2%,主要表现为:
- 开头套话("好的,我明白了...")
- 结尾冗余("希望这个回答对您有帮助...")
- 中间重复解释同一概念
- 废话率与模型"对齐训练"强度相关,过度对齐可能导致输出冗余
5.4 任务类型细分对比
| 任务类型 | 最佳助手 | 关键优势 | 最差助手 | 主要短板 |
|---|---|---|---|---|
| 多轮知识问答 | A | 上下文记忆强,逻辑链完整 | D | 第5轮后开始偏离 |
| 复杂指令执行 | B | 约束解析准确,格式严格 | D | 多条件组合失败率高 |
| 长文改写 | A | 内容保真度高,改写幅度可控 | C | 过度改写或改写不足 |
5.5 优化建议
基于评估结果,针对不同助手类型给出改进方向:
| 问题类型 | 优化建议 | 适用对象 |
|---|---|---|
| 连贯性衰减 | 增强长上下文记忆机制,引入对话状态跟踪 | D、C |
| 指令遵循弱 | 强化约束解析训练,增加格式约束微调数据 | D、C |
| 废话率高 | 优化对齐策略,引入简洁性奖励信号 | D、B |
| 综合效能提升 | 平衡连贯性、遵循率与简洁性,避免单指标过拟合 | 全部 |
5.6 小结
- 连贯性、指令遵循、废话率三个指标能有效区分通用聊天助手的实际效能差异
- 当前最优助手A在综合效能上领先,但各助手在不同任务类型上各有优劣
- 熵权-VIKOR模型提供了稳定的多指标排序,避免了单一维度评价的片面性
- 评估结果可直接指导模型迭代方向:优先降低废话率、提升复杂指令遵循能力
六、总结与展望
本文构建的通用聊天助手效能评估体系具有以下特点:
- 指标聚焦:围绕用户最敏感的三个维度,避免评估泛化
- 方法客观:熵权-VIKOR组合兼顾权重客观性与排序稳定性
- 工程可行:基于日志数据自动化计算,可嵌入CI/CD评测流程
未来工作:
- 引入用户满意度反馈作为校准信号
- 扩展至多模态对话场景
- 构建动态评估基准,跟踪模型迭代轨迹