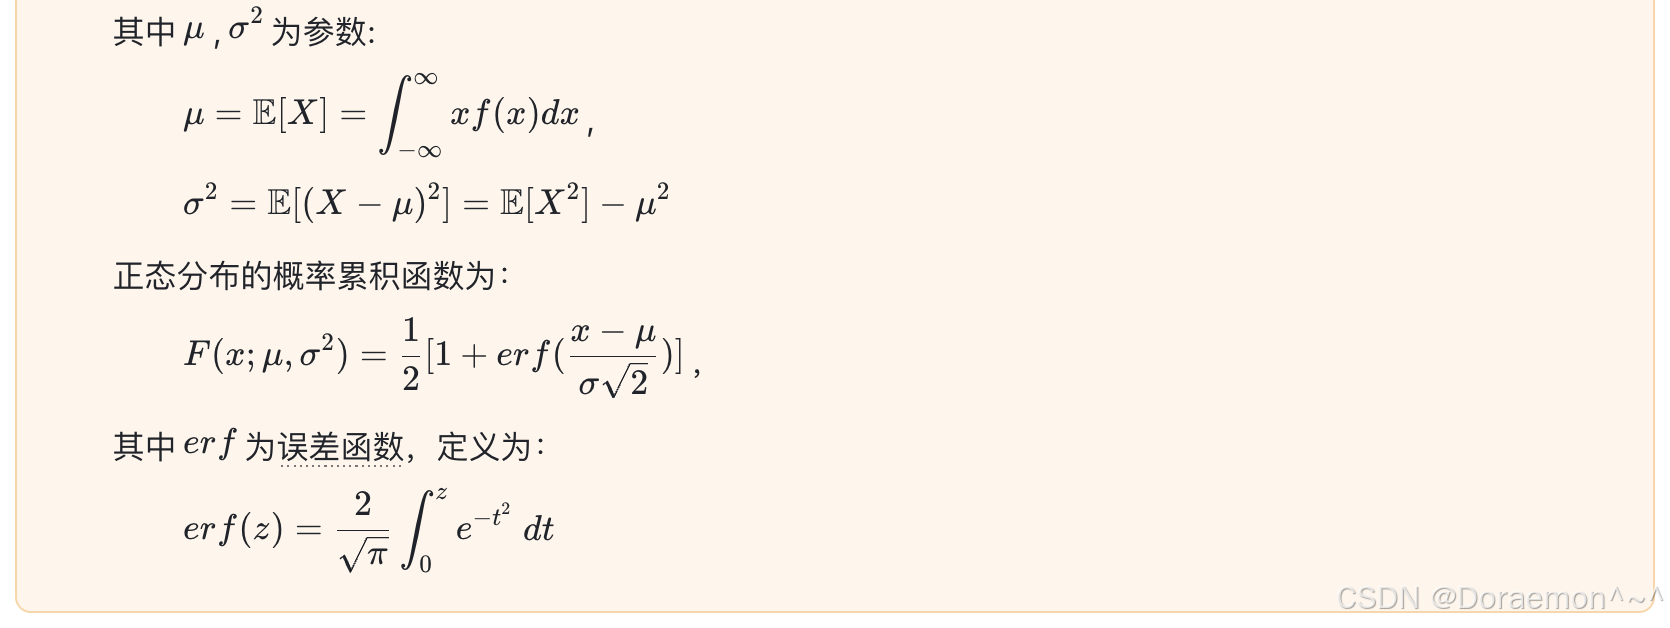目录
Transformer架构于2017年在"Attention Is All You Need"这篇文章中提出,是Google Brain的工作。Transformer网络由多个Transformer Block堆叠而成。原文提出的是一个Encoder-Decoder架构,如下图所示。Encoder和Decoder分别由多个相同结构的Block(但参数是不同的)组成(串连,上一个block的输出作为下一个block的输入),分别称为Encoder Block(编码器,分类任务,提取特征)和Decoder Block(解码器,生成任务,预测)。先分别介绍Encoder Block和Decoder Block的结构。
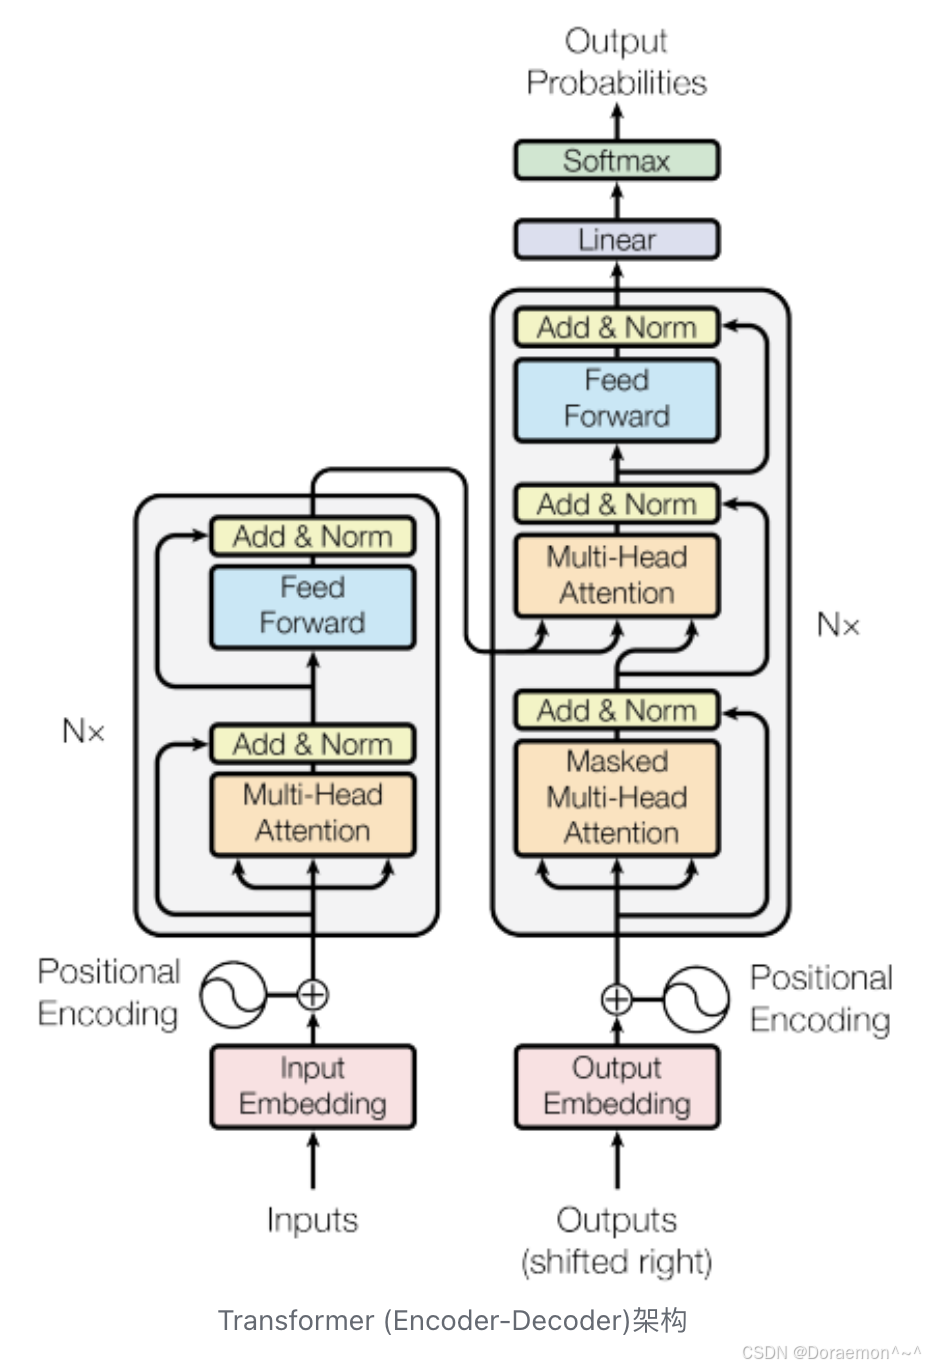
Transformer Encoder Block由两个子层组成,分别为多头自注意力 (multi-head self-attention) 子层和前馈 (Feed-Forward Network) 子层。多头自注意力子层的计算公式在第2节已经讲解过,而FFN的计算公式如下:
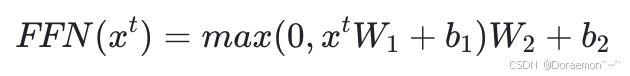
其中x为序列中任意一个位置的输入向量。FFN层的参数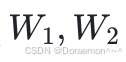 在各个位置之间是共享的 (因此被称为 Position-Wise Feed-Forward Network),可以看作是每个位置的特征表示依次经过了:
(1) 参数为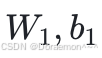 的线性层Linear-1。
(2) ReLU。
(3) 参数为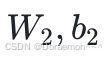 的线性层Linear-2。
一般来说Linear-1的输出层节点数量 > Linear-2的输出层节点数量。在Transformer的原创论文中,每个token的特征向量长度为512,Linear-1输出节点数量为2048,Linear-2的输出又恢复到512。Linear-1先通过升维提供更多的非线性特征,Linear-2类似于一个特征选择的过程,从中又组合出与原特征数量相同的新特征。
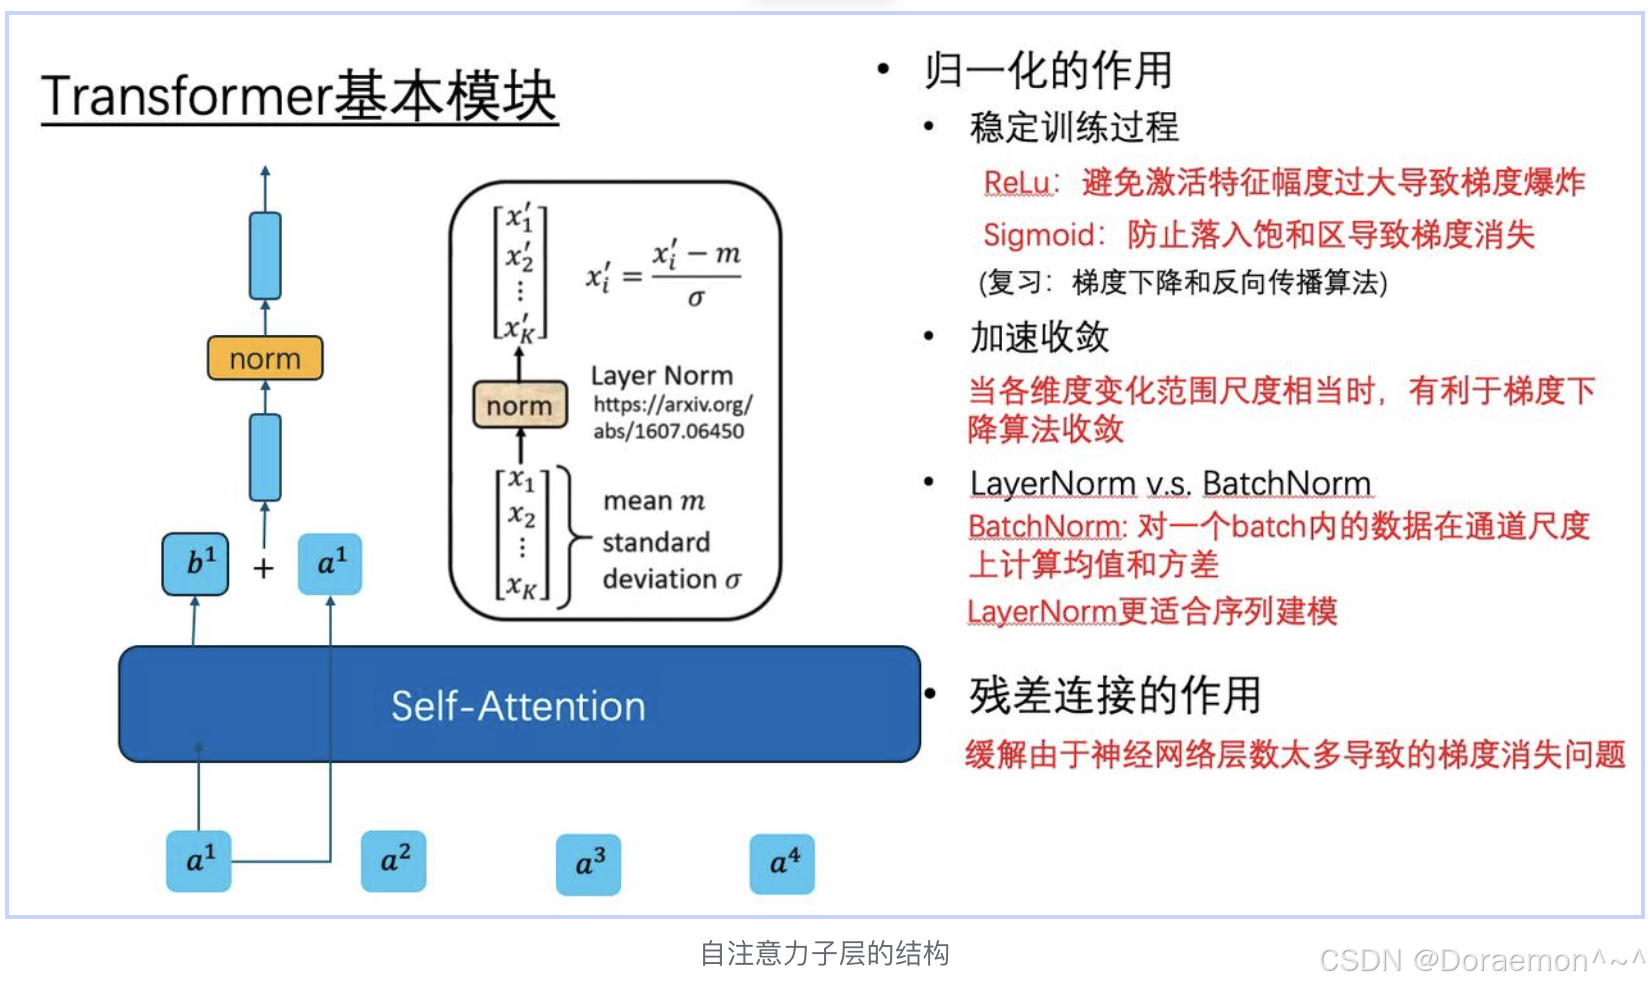
Transformer Encoder Block中每一个子层的输出为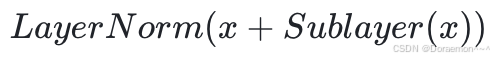 ,其中Sublayer为多头自注意力或者是FFN。下图以自注意力子层为例,显示了Encoder Block Sublayer的结构:
1. 结合 word2vec 说明什么是预训练模型,以及预训练模型的作用。
预训练的概念是通过对预训练任务的学习,学习出语义特征,保存在预训练模型中。预训练任务的设计需要同时考虑以下两点:1)标注容易获得,从而可以在海量数据上学习;2)学习任务能够训练语义特征。预训练的结果保存在预训练模型中,即用于抽取语义特征部分的模型。在预训练模型的基础上,只需要少量的下游任务的训练数据,就可以得到较好的下游任务的模型。这个过程可以看作是一种迁移学习。
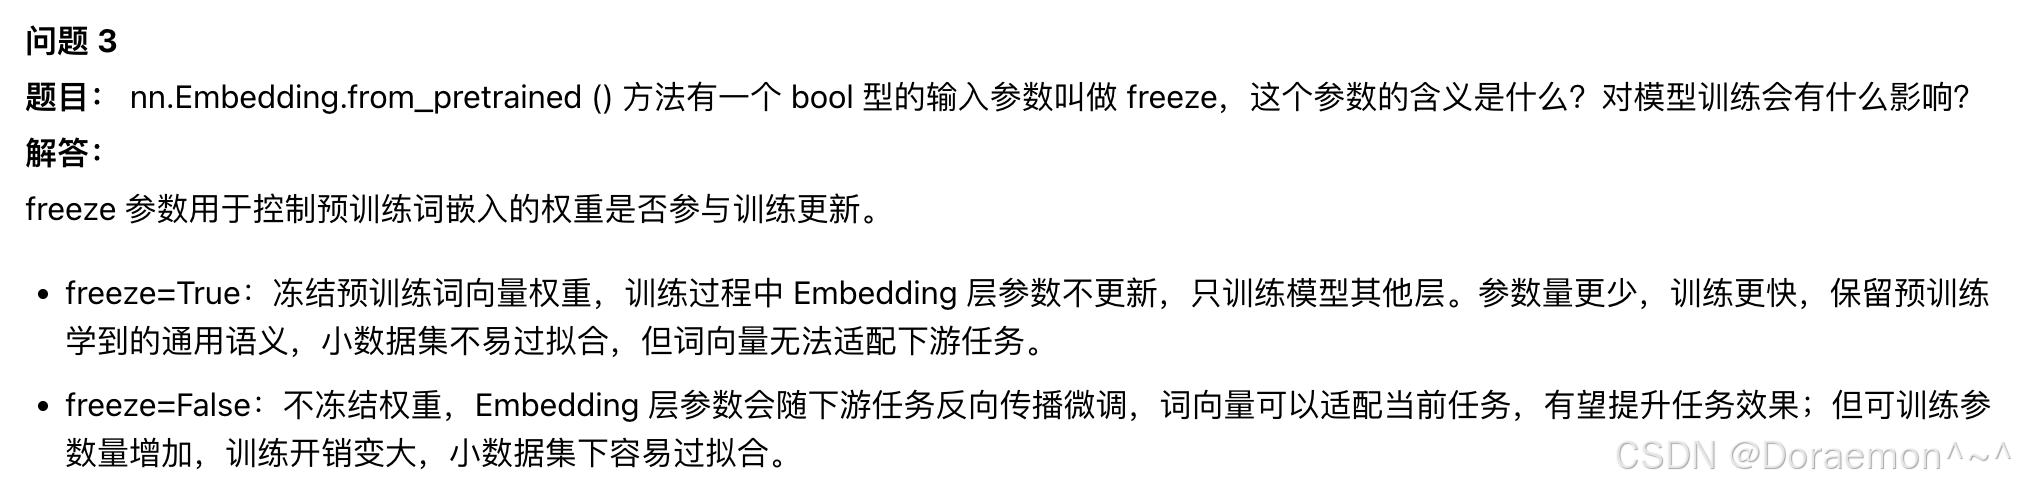
Word2vec 的预训练任务有两种:1) CBOW:在局部上下文窗口中,用两边的单词预测中间的词;2) skip-gram:用中间的词预测两边的词。学习得到的预训练模型就是 word embedding model。下游任务可以以 word embedding 作为起点继续学习,学习过程中可以继续调整 word embedding 的参数。
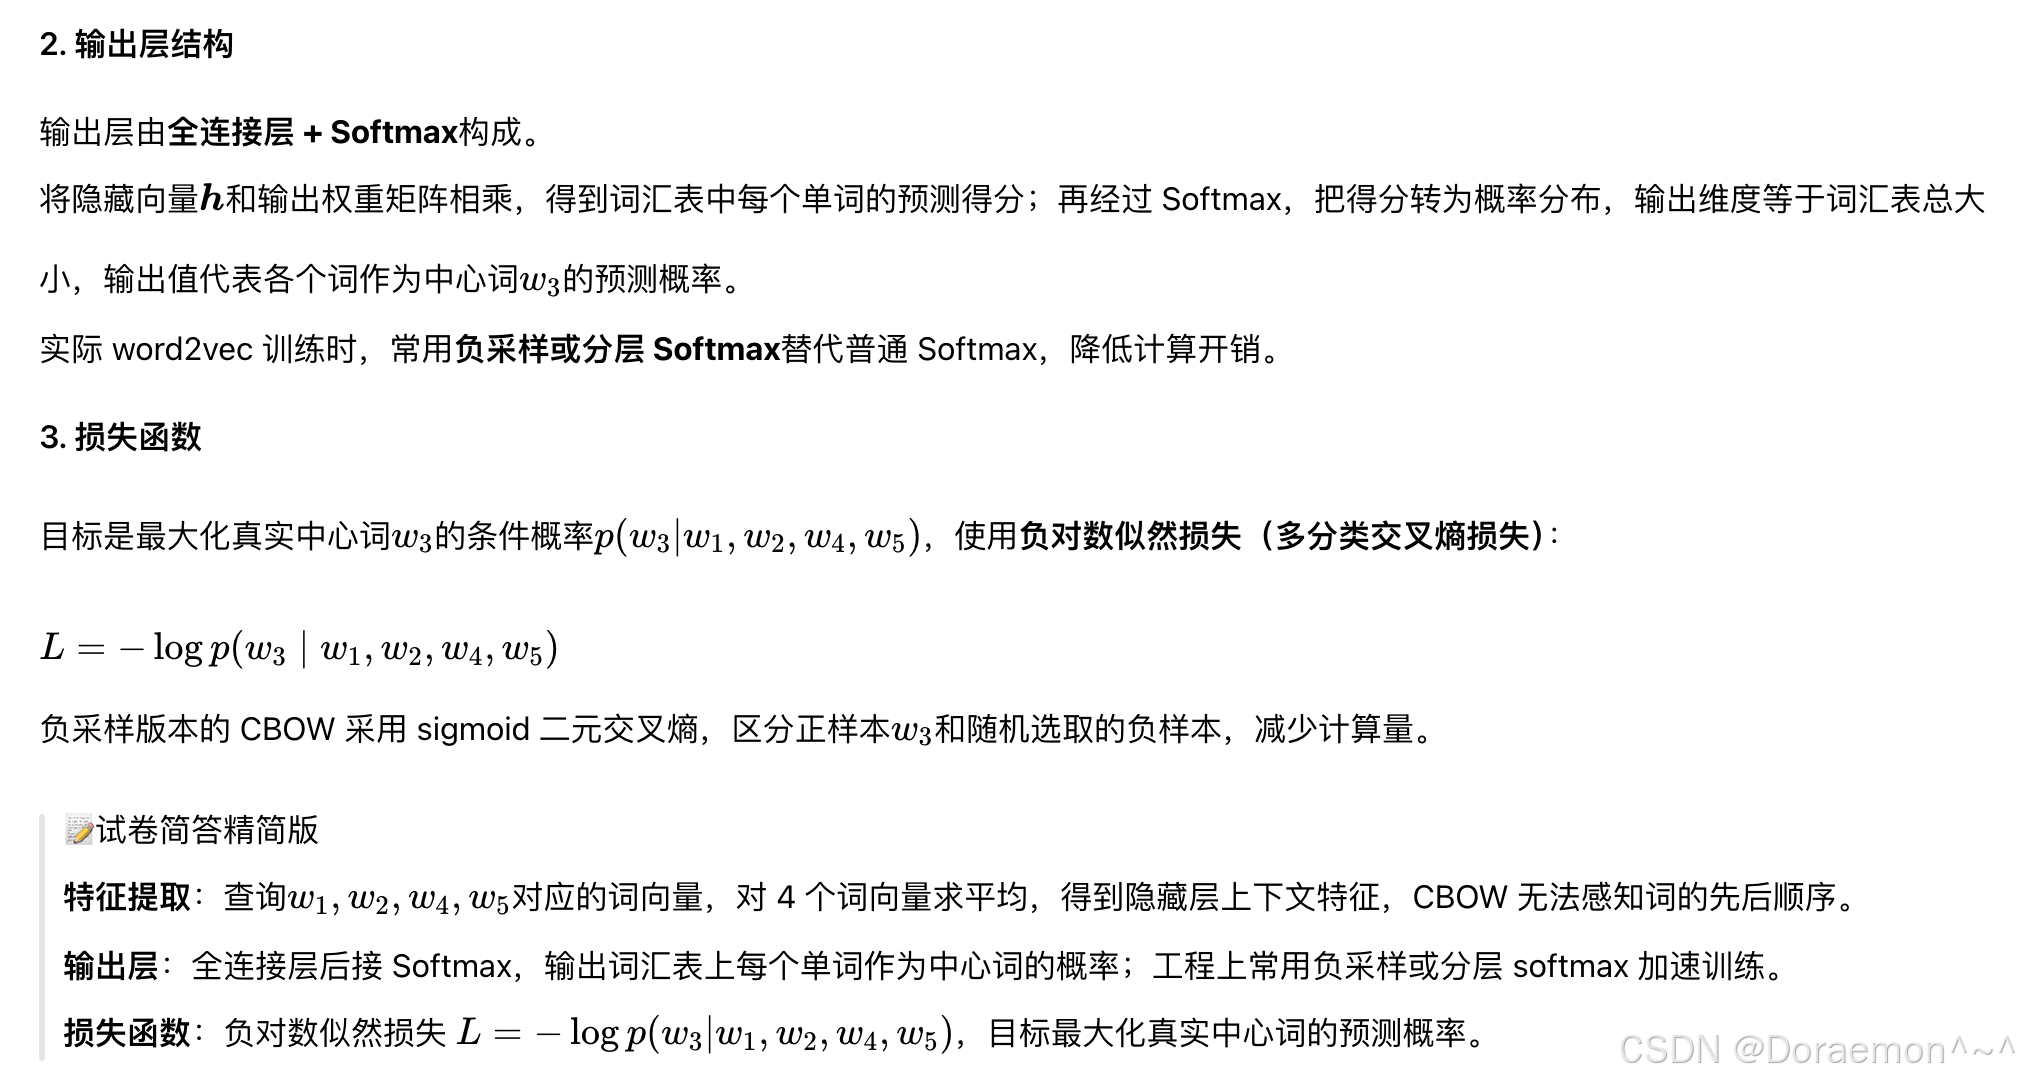
2. CBOW 任务是用局部上下文窗口中两边的词预测中间的词。例如,在上下文窗口中的词为 (w1,w2,w3,w4,w5),那么 CBOW 任务就是用 (w1,w2,w4,w5) 来预测 w3,其中下标表示词在上下文窗口中出现的顺序。结合上边的例子,简述 CBOW 特征提取的过程,以及输出层的结构和损失函数。
特征提取的过程:(w1,w2,w4,w5) 中的每个词先转化为词 ID,再通过
nn.Embedding()获得每个词的词向量(300 维),之后 4 个词的词向量相加,作为预测模型的特征。预测 w3 的输出层节点数等于
vocab_size,每个节点对应于一个词。输出层的激活函数是softmax,损失函数是CrossEntropy。
1.层归一化
论文:https://arxiv.org/pdf/1607.06450
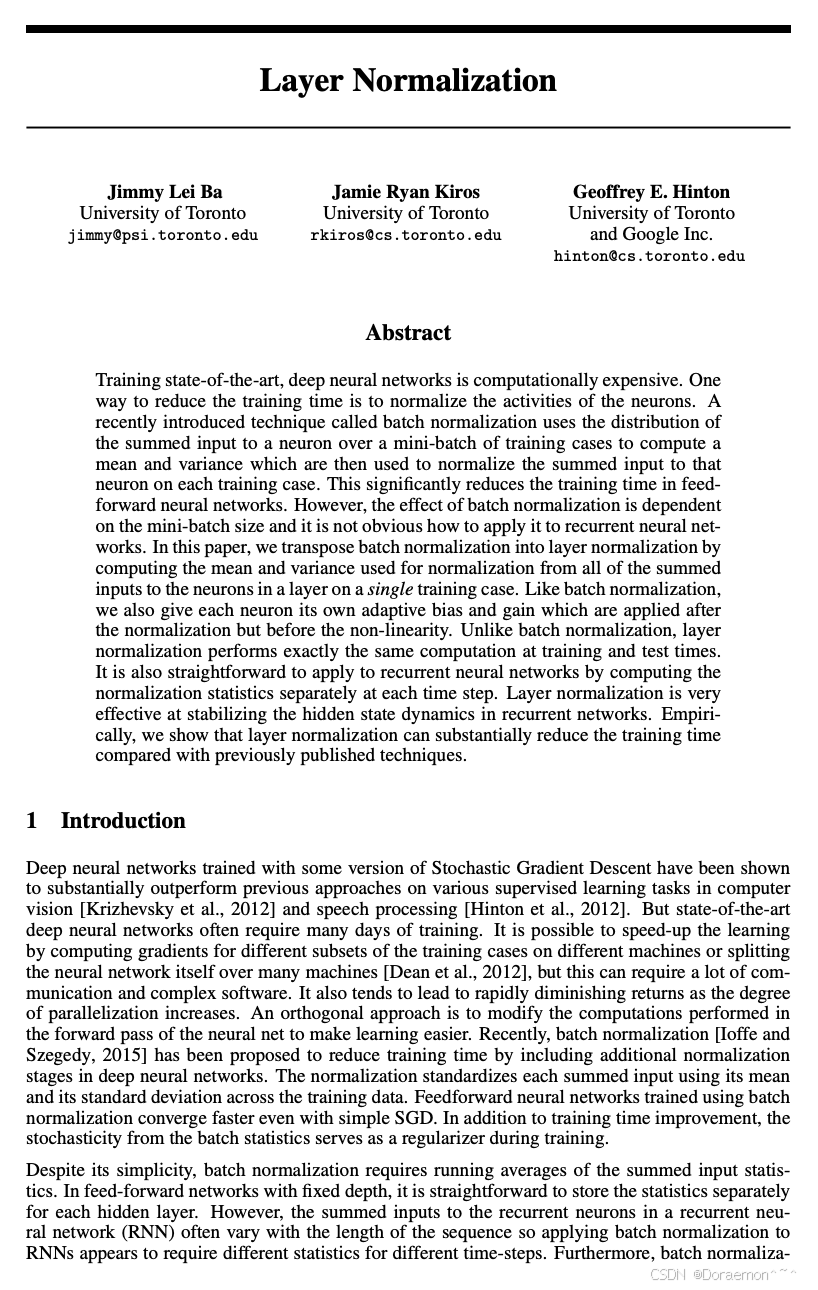
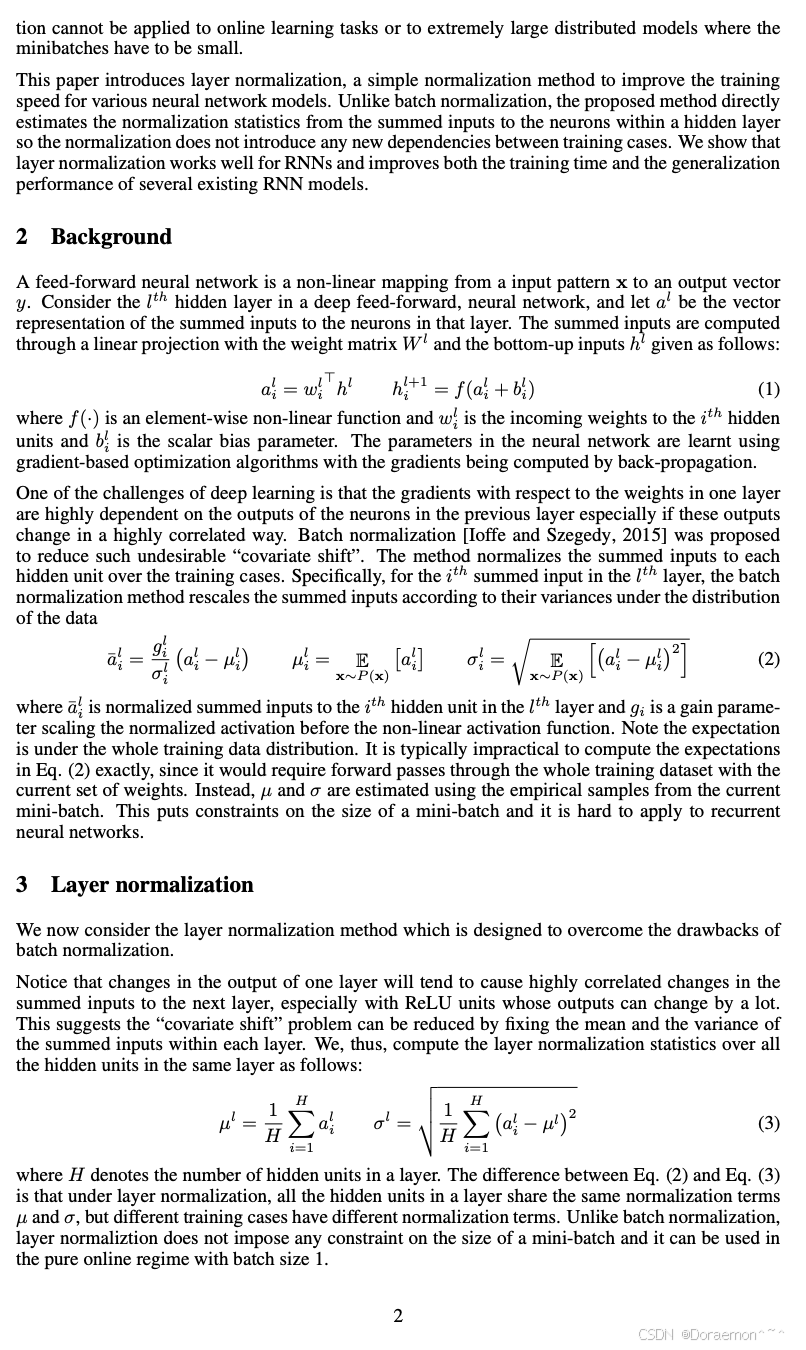
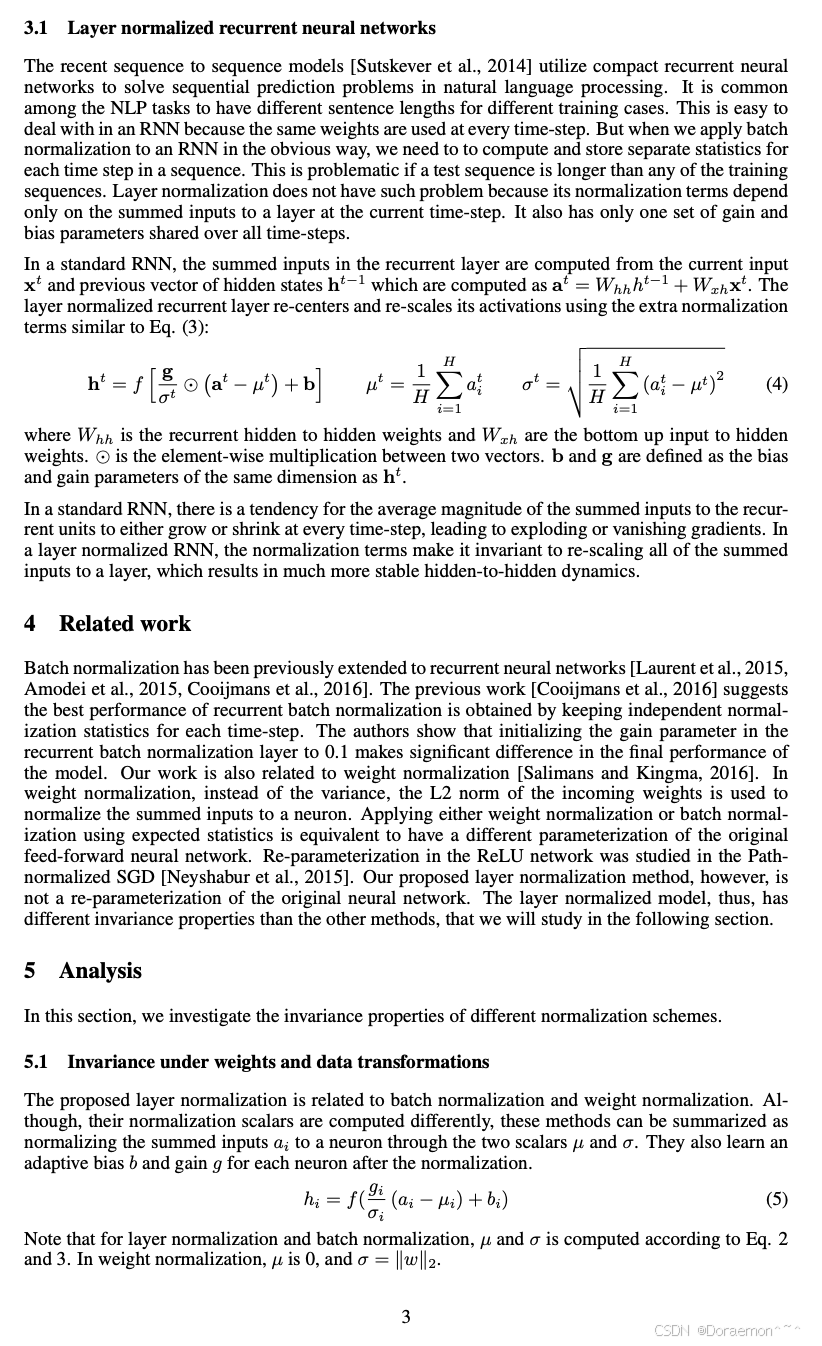
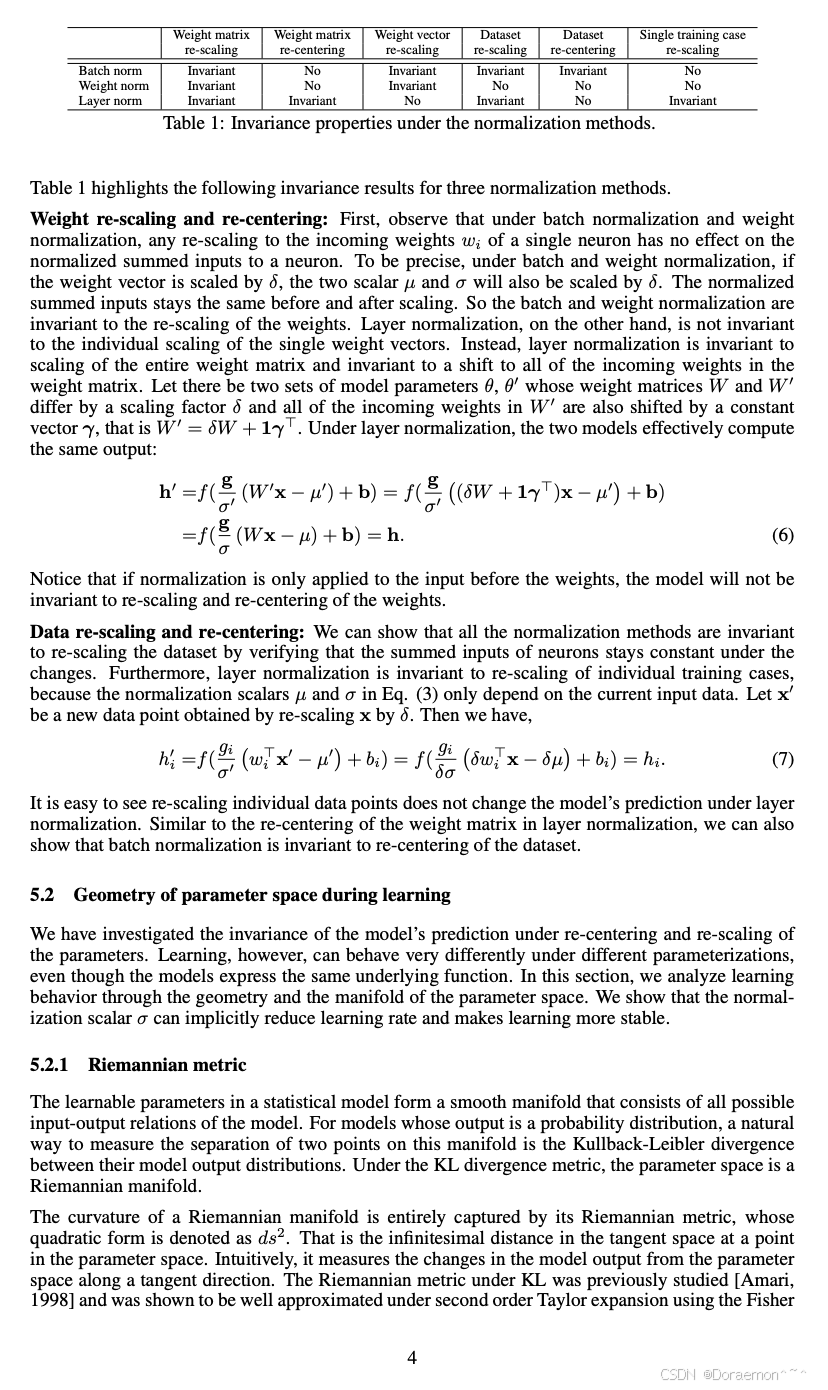
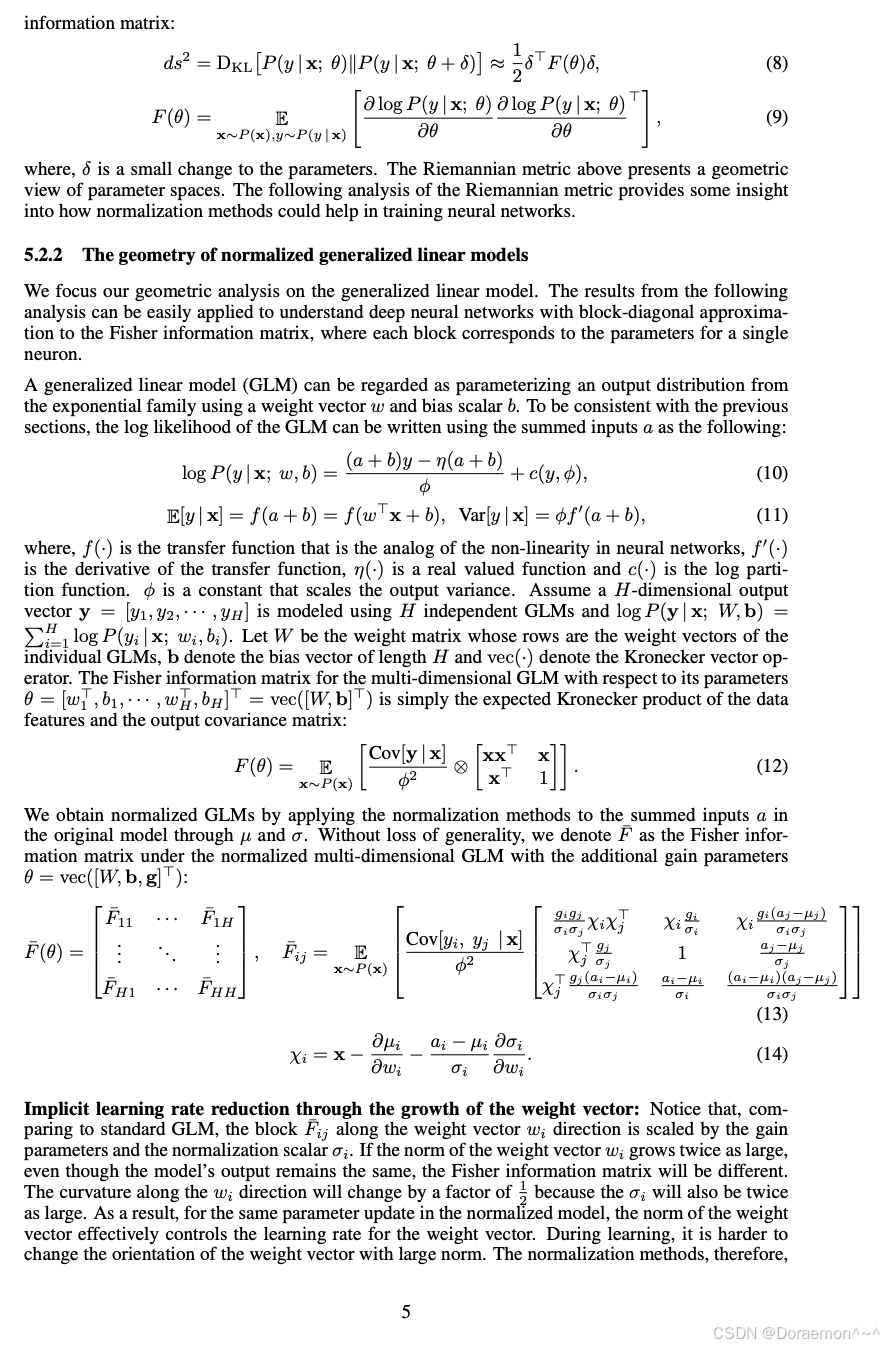
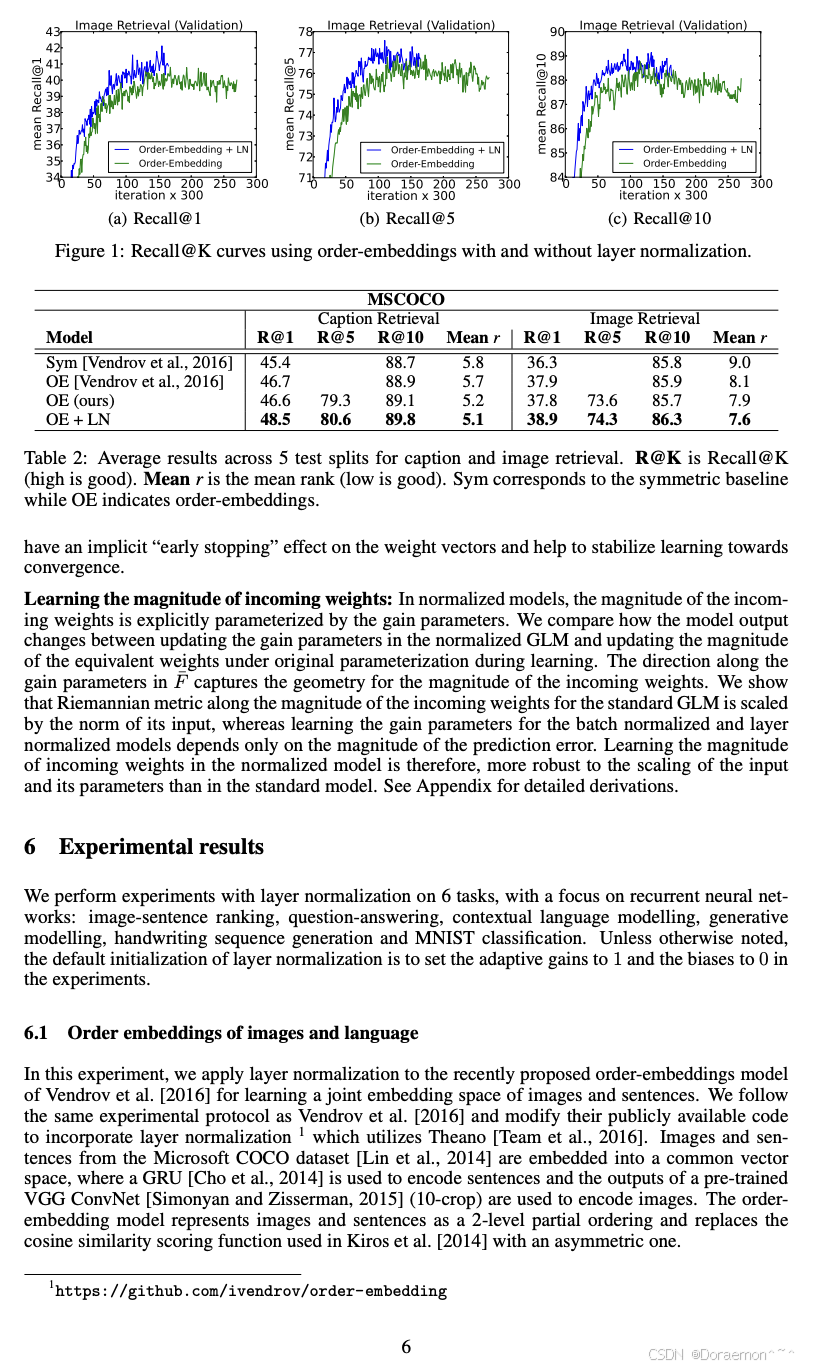
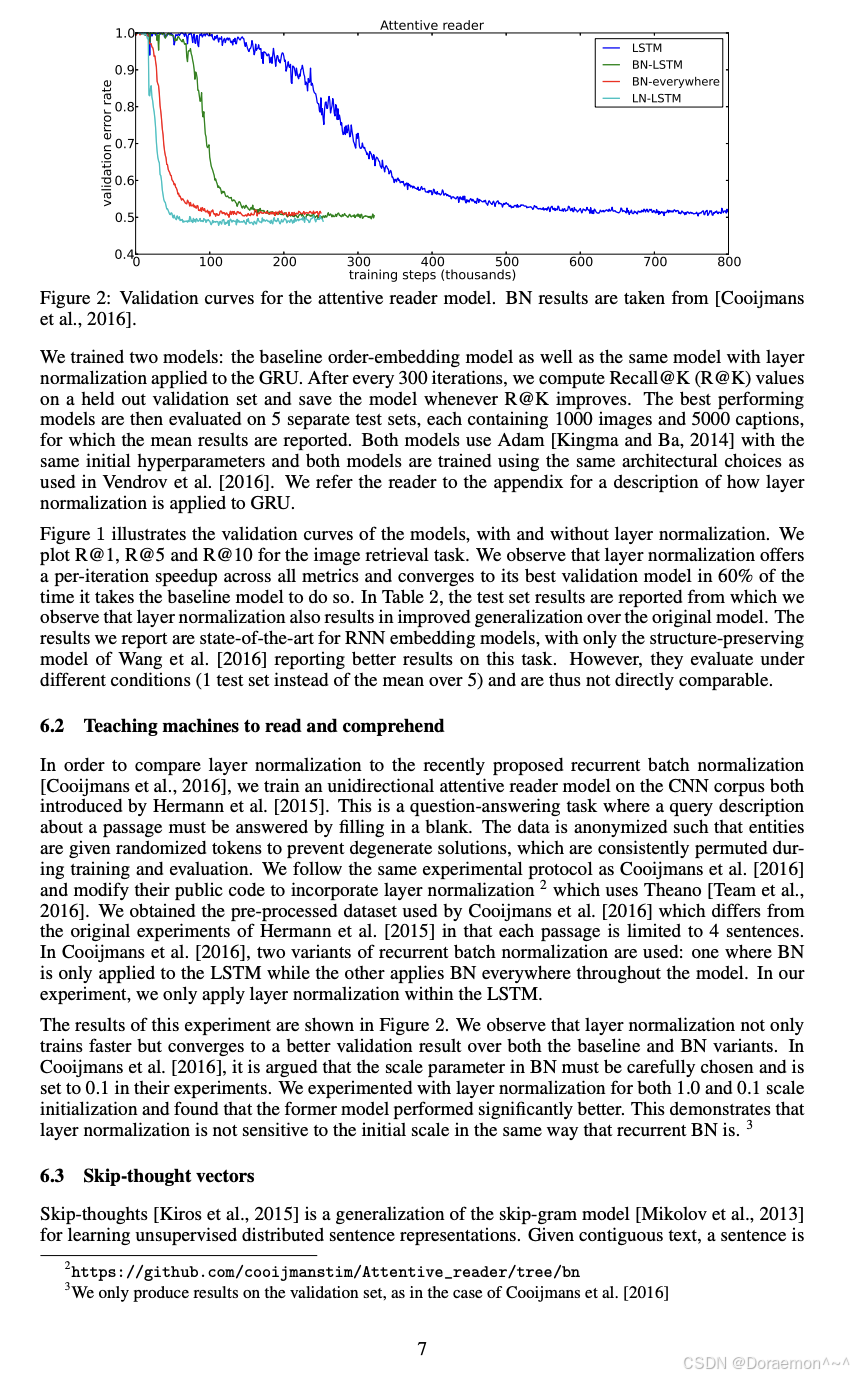
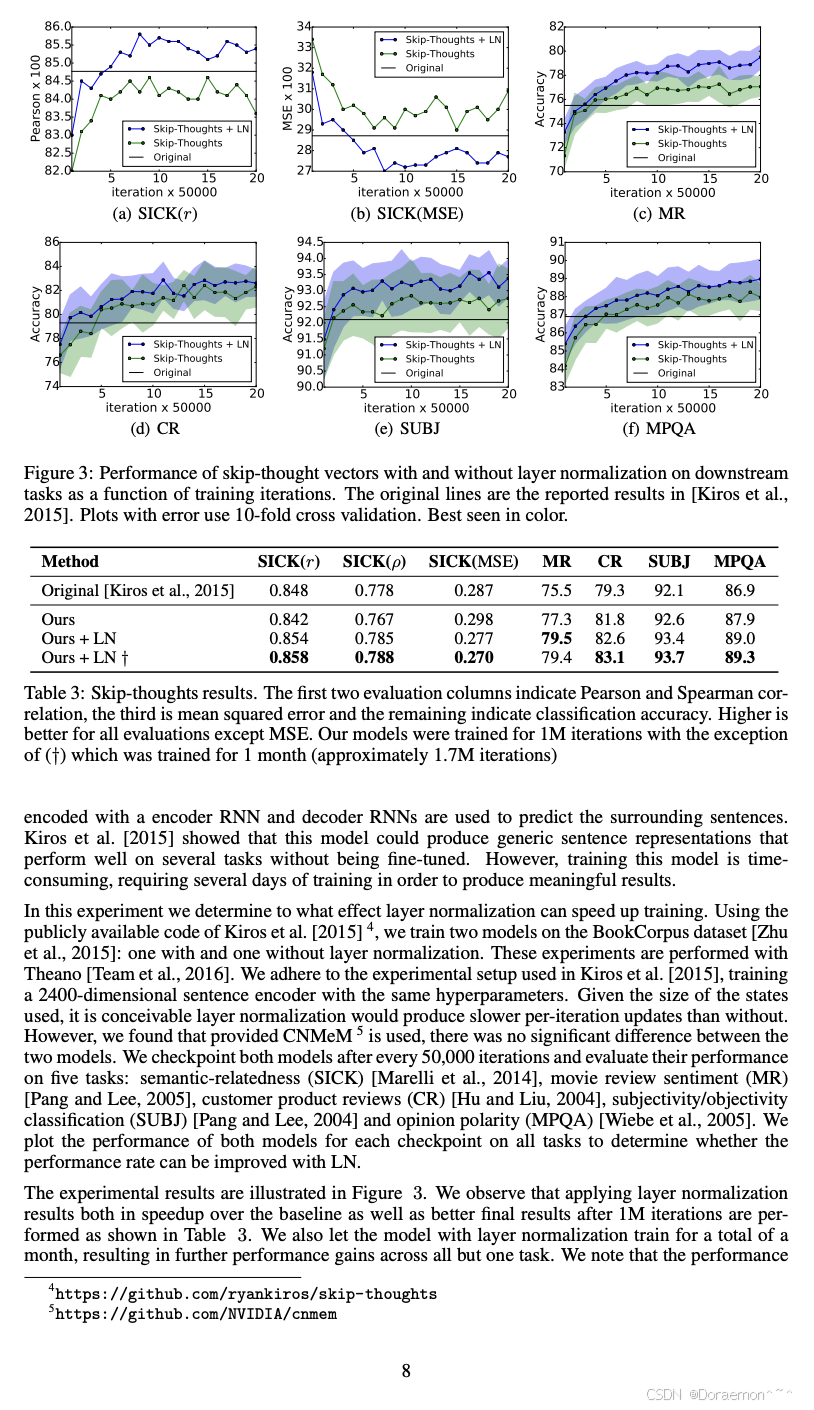
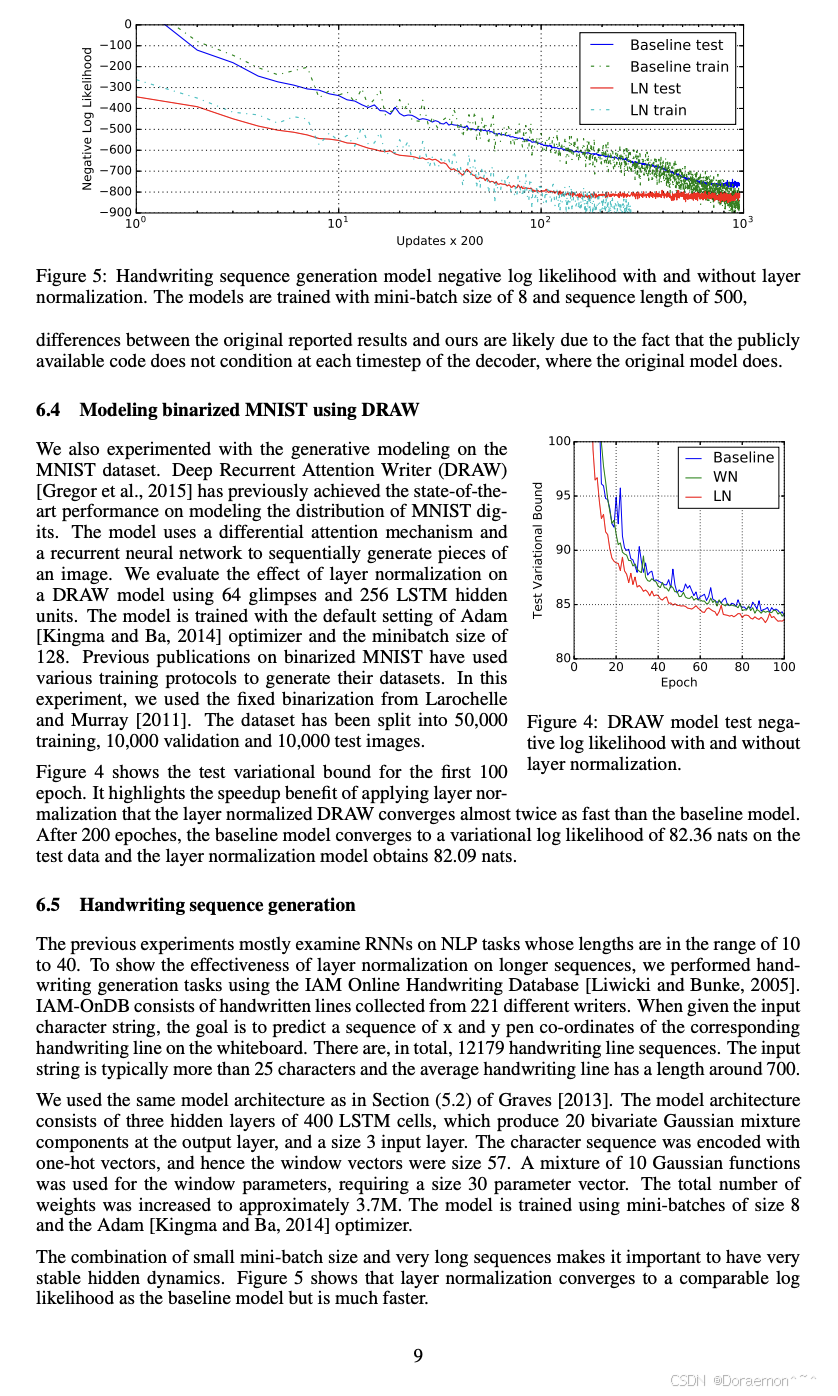
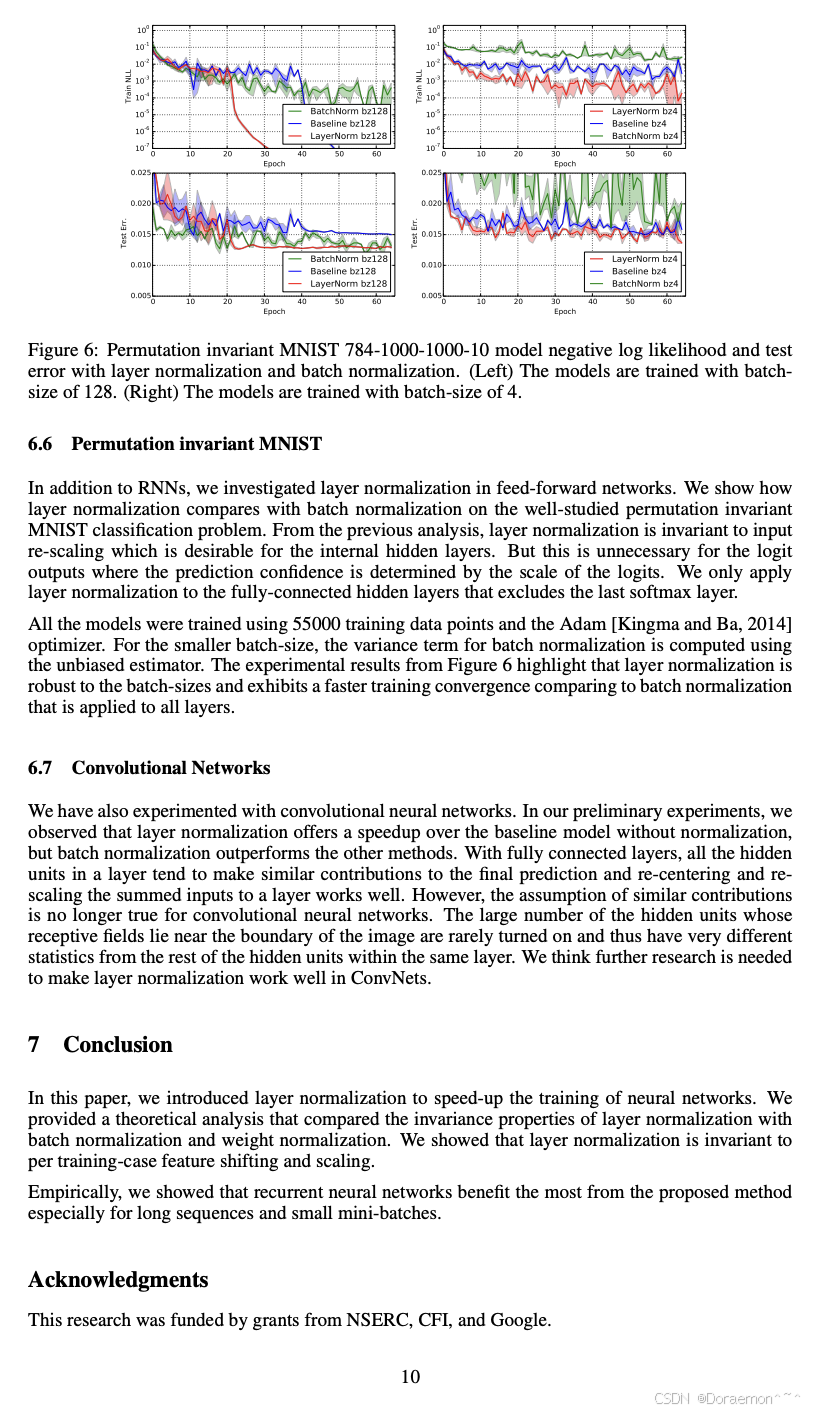
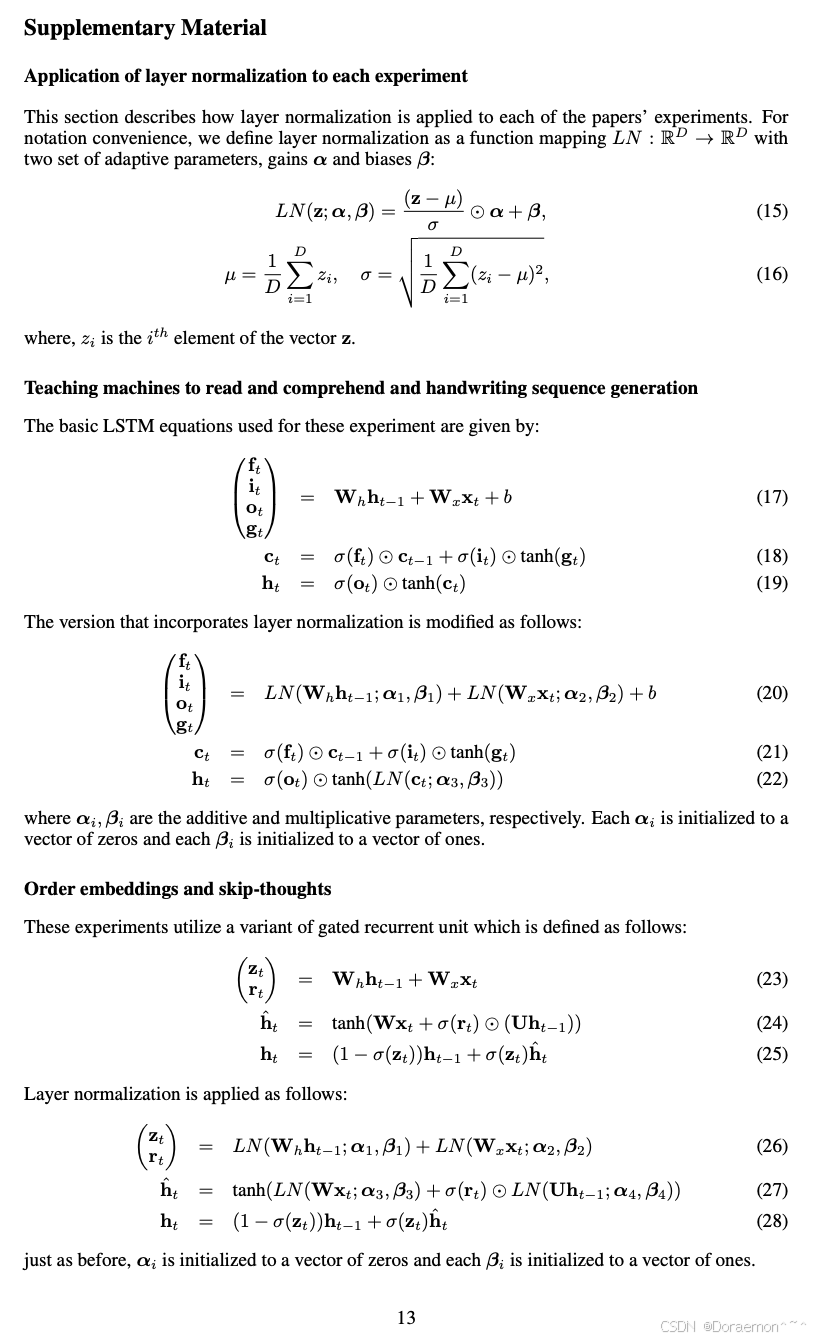
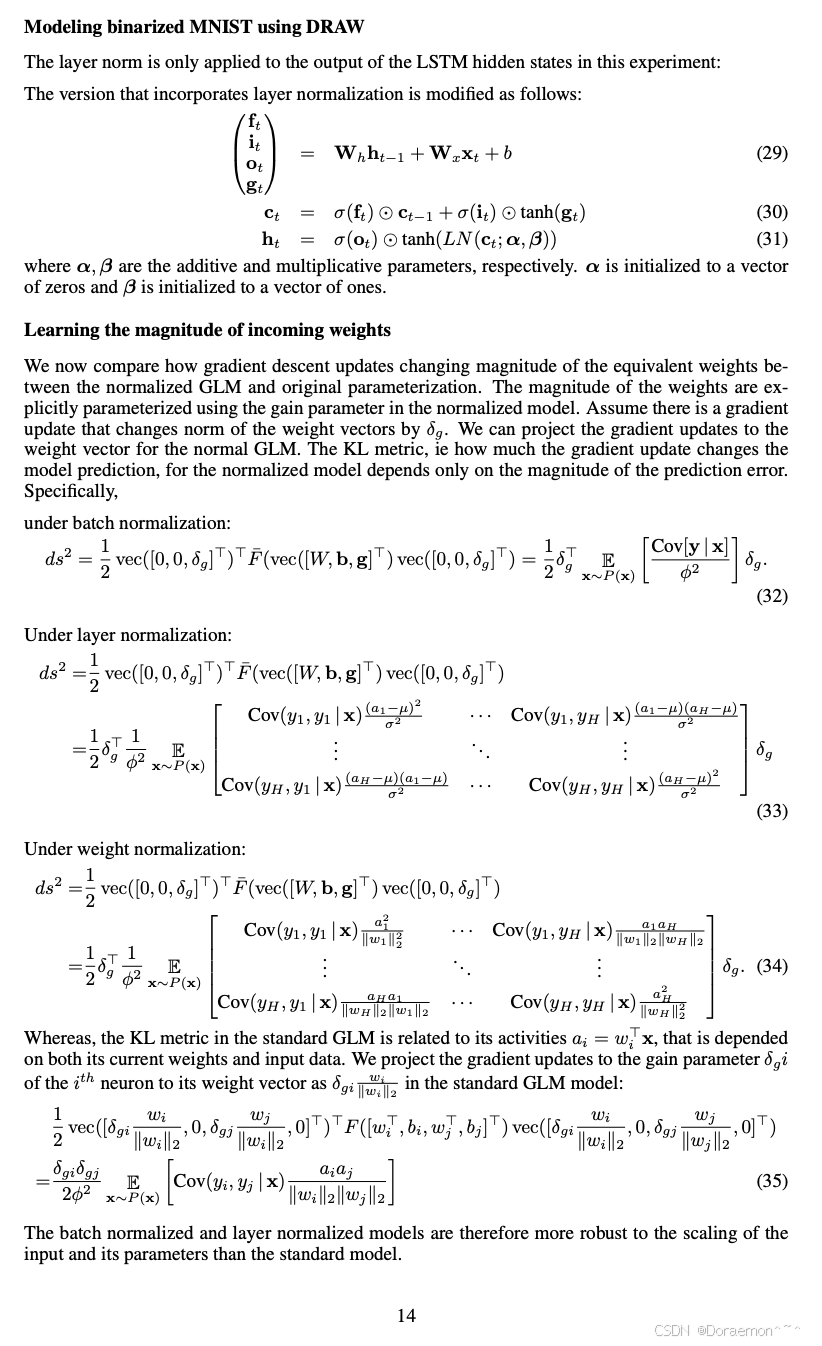
LayerNorm即层归一化,它与BatchNorm的作用相似,都是用来约束网络中间层的输入数据分布,有利于提高深度神经网络的训练稳定性和加快收敛速度。Batch Normalization (简称为BN) 和Layer Normalization (简称为LN) 的本质差异在于归一化的统计维度不同:
-
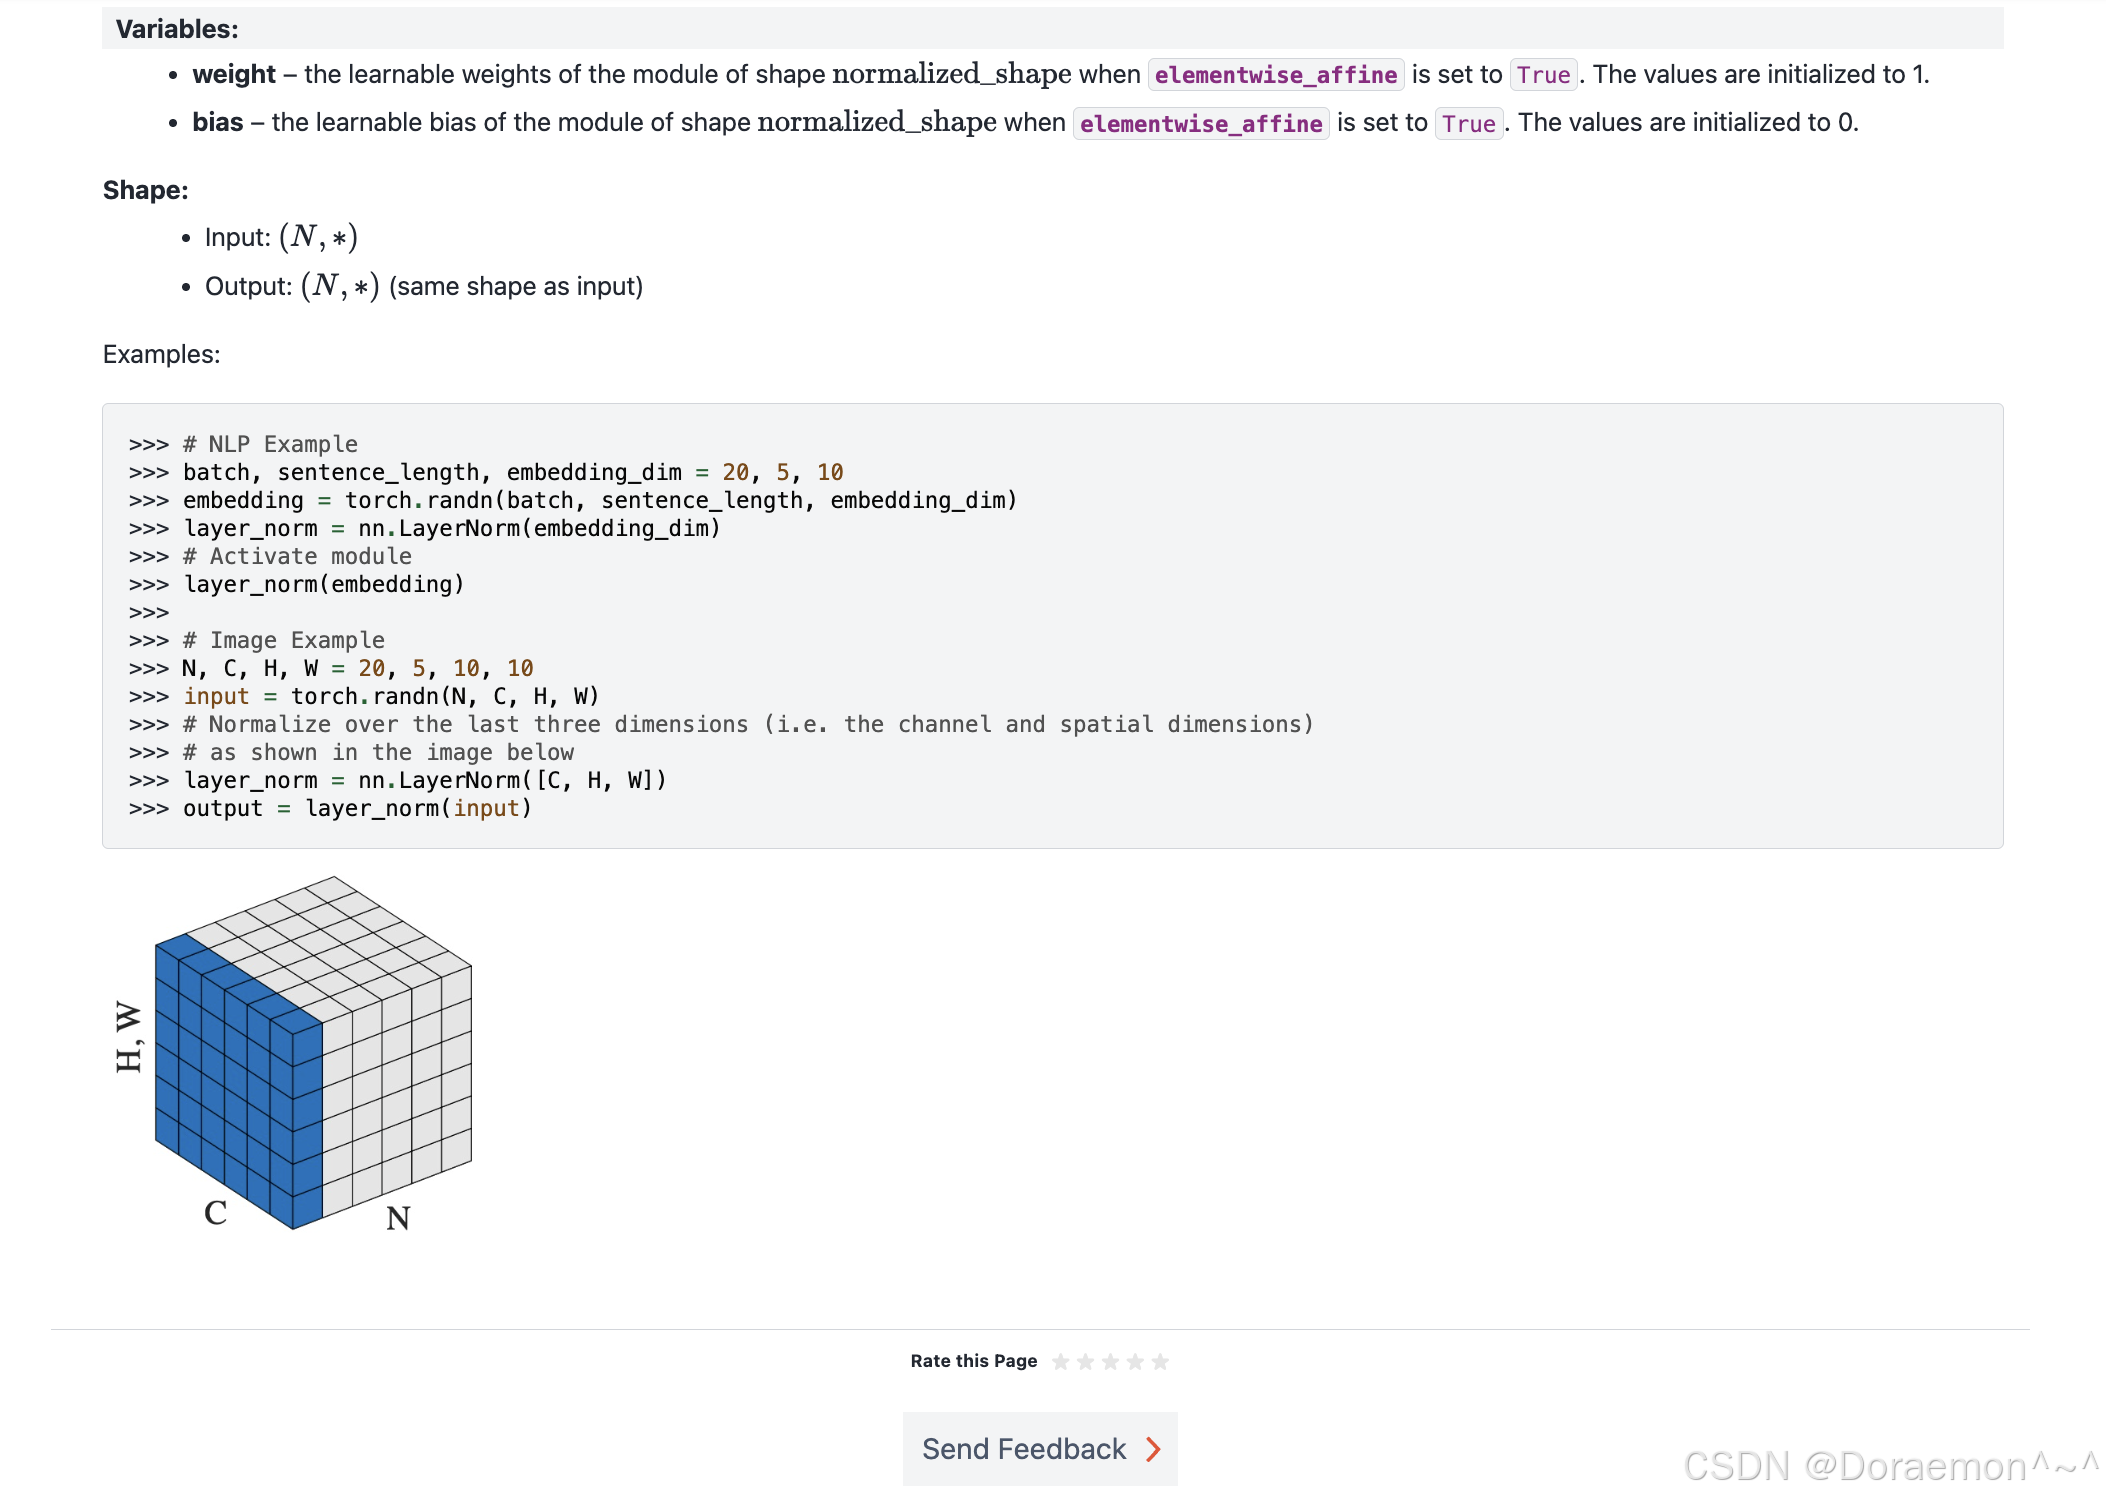
BN的统计是沿着Batch维度和Height、Width维度进行的,换言之,只保留了channel特征通道的维度 (每个特征通道一套均值和方差)。
-
LN的统计是沿着特征维度进行的,换言之,保留了Batch和序列维度 (每个序列的每个token对应一套均值和方差)。
BN(批量归一化): 拿一批样本里,同一个通道上所有空间像素一起算均值方差。 简单说:同一个特征通道,跨多张图片 / 样本算统计量。
例:一批 8 张 RGB 图,对所有图的 R 通道全部像素算一套均值方差,G 通道一套,B 通道一套。 缺点:依赖批次大小,batch 太小效果差;Transformer 时序模型不适合。
LN(层归一化): 对单个样本自己内部的全部特征维度算均值方差。 简单说:每一个 token / 每一个样本,单独算自己特征的均值方差,不和其他样本互通。
例:一句话里的某个词(token),把它对应的所有特征通道放一起,单独算一套均值方差。 优点:不依赖 batch 大小,Transformer 标配。
一句话总结
✅ BN:跨样本、按通道归一化(同通道,看这一批所有样本)
✅ LN:单样本、按特征归一化(单独一个 token,看它自己所有特征)
补充小提示
CNN 多用 BN;Transformer(NLP、大模型)多用 LN
BN 统计范围:Batch + H + W;LN 统计范围:特征通道维度
在LN中,各个序列的每一个位置的所有输入之间进行归一化。设LN层的输入序列为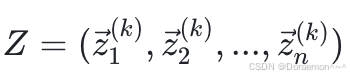 ,其中上标表示样本(即序列)的序号,下标表示在序列中的位置。则归一化所需的统计量计算为:
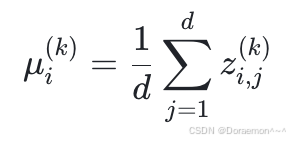
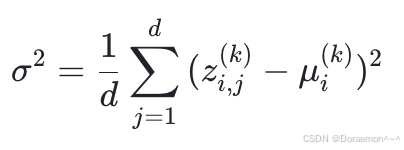
归一化的计算单元为 ,即每个序列中的每个位置的输入向量:
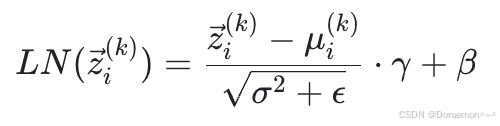
 同样是可学习的参数,主要是避免在使用Sigmoid作为激活函数时,输入过于集中在准线性区而失去非线性拟合能力。
在进行了层归一化之后,每个向量在特征空间中相对原点的方向不变,只是模发生了变化。层归一化之后,输出向量的模期望为 。实验研究证明,层归一化更适合于自然语言处理任务。
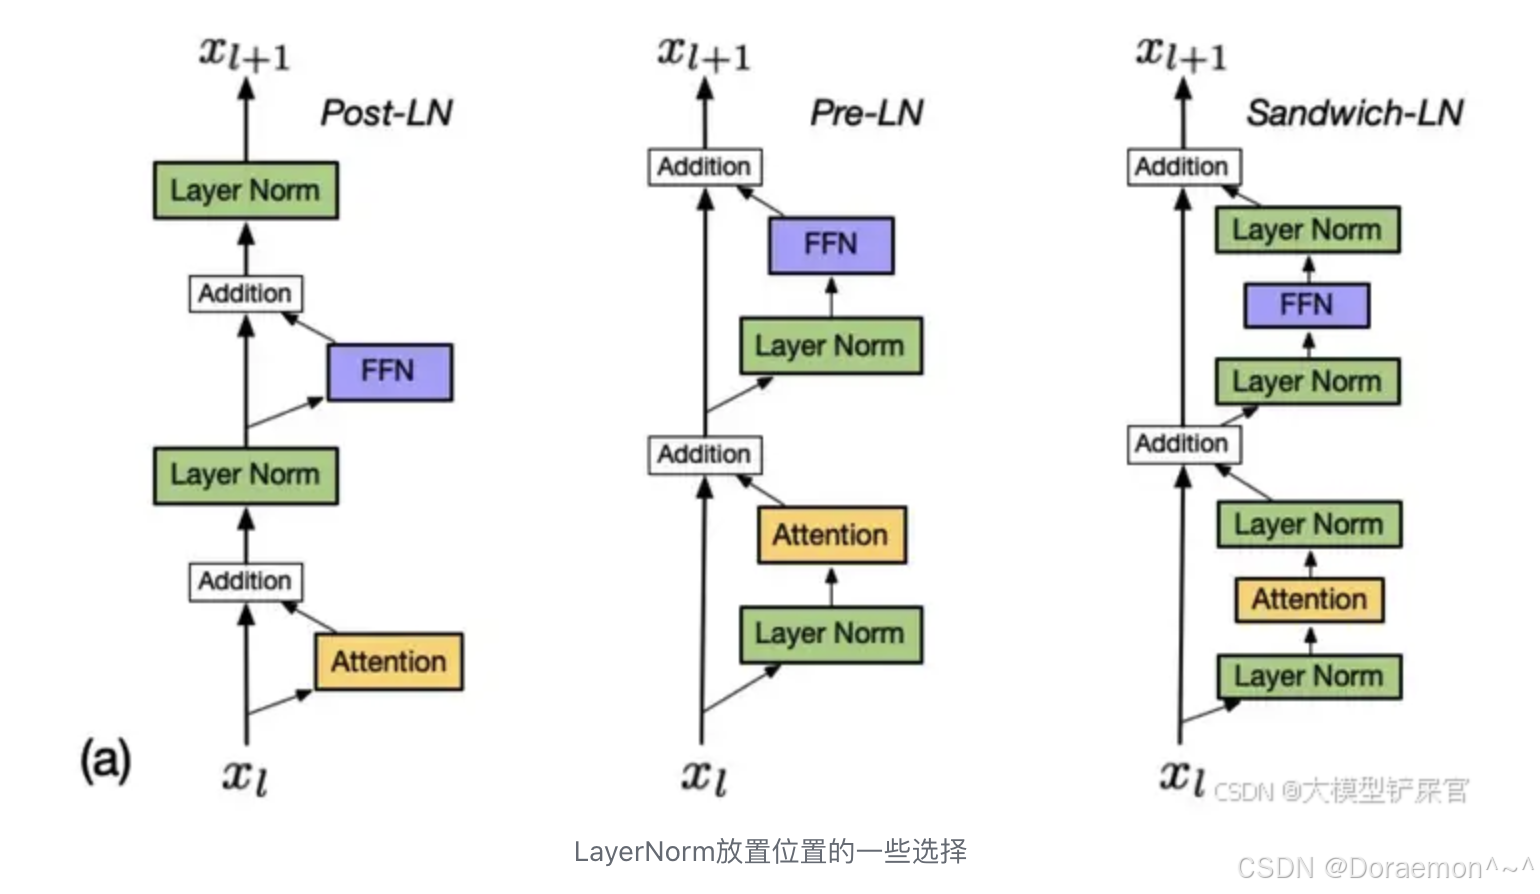
LN层在Transformer block中的位置也有一些变种,在经典的Transformer结构(以及Bert预训练模型中)采用的是Post-LN,而在LLM中大多采用Pre-LN。这些选择主要是在实践中获得的。
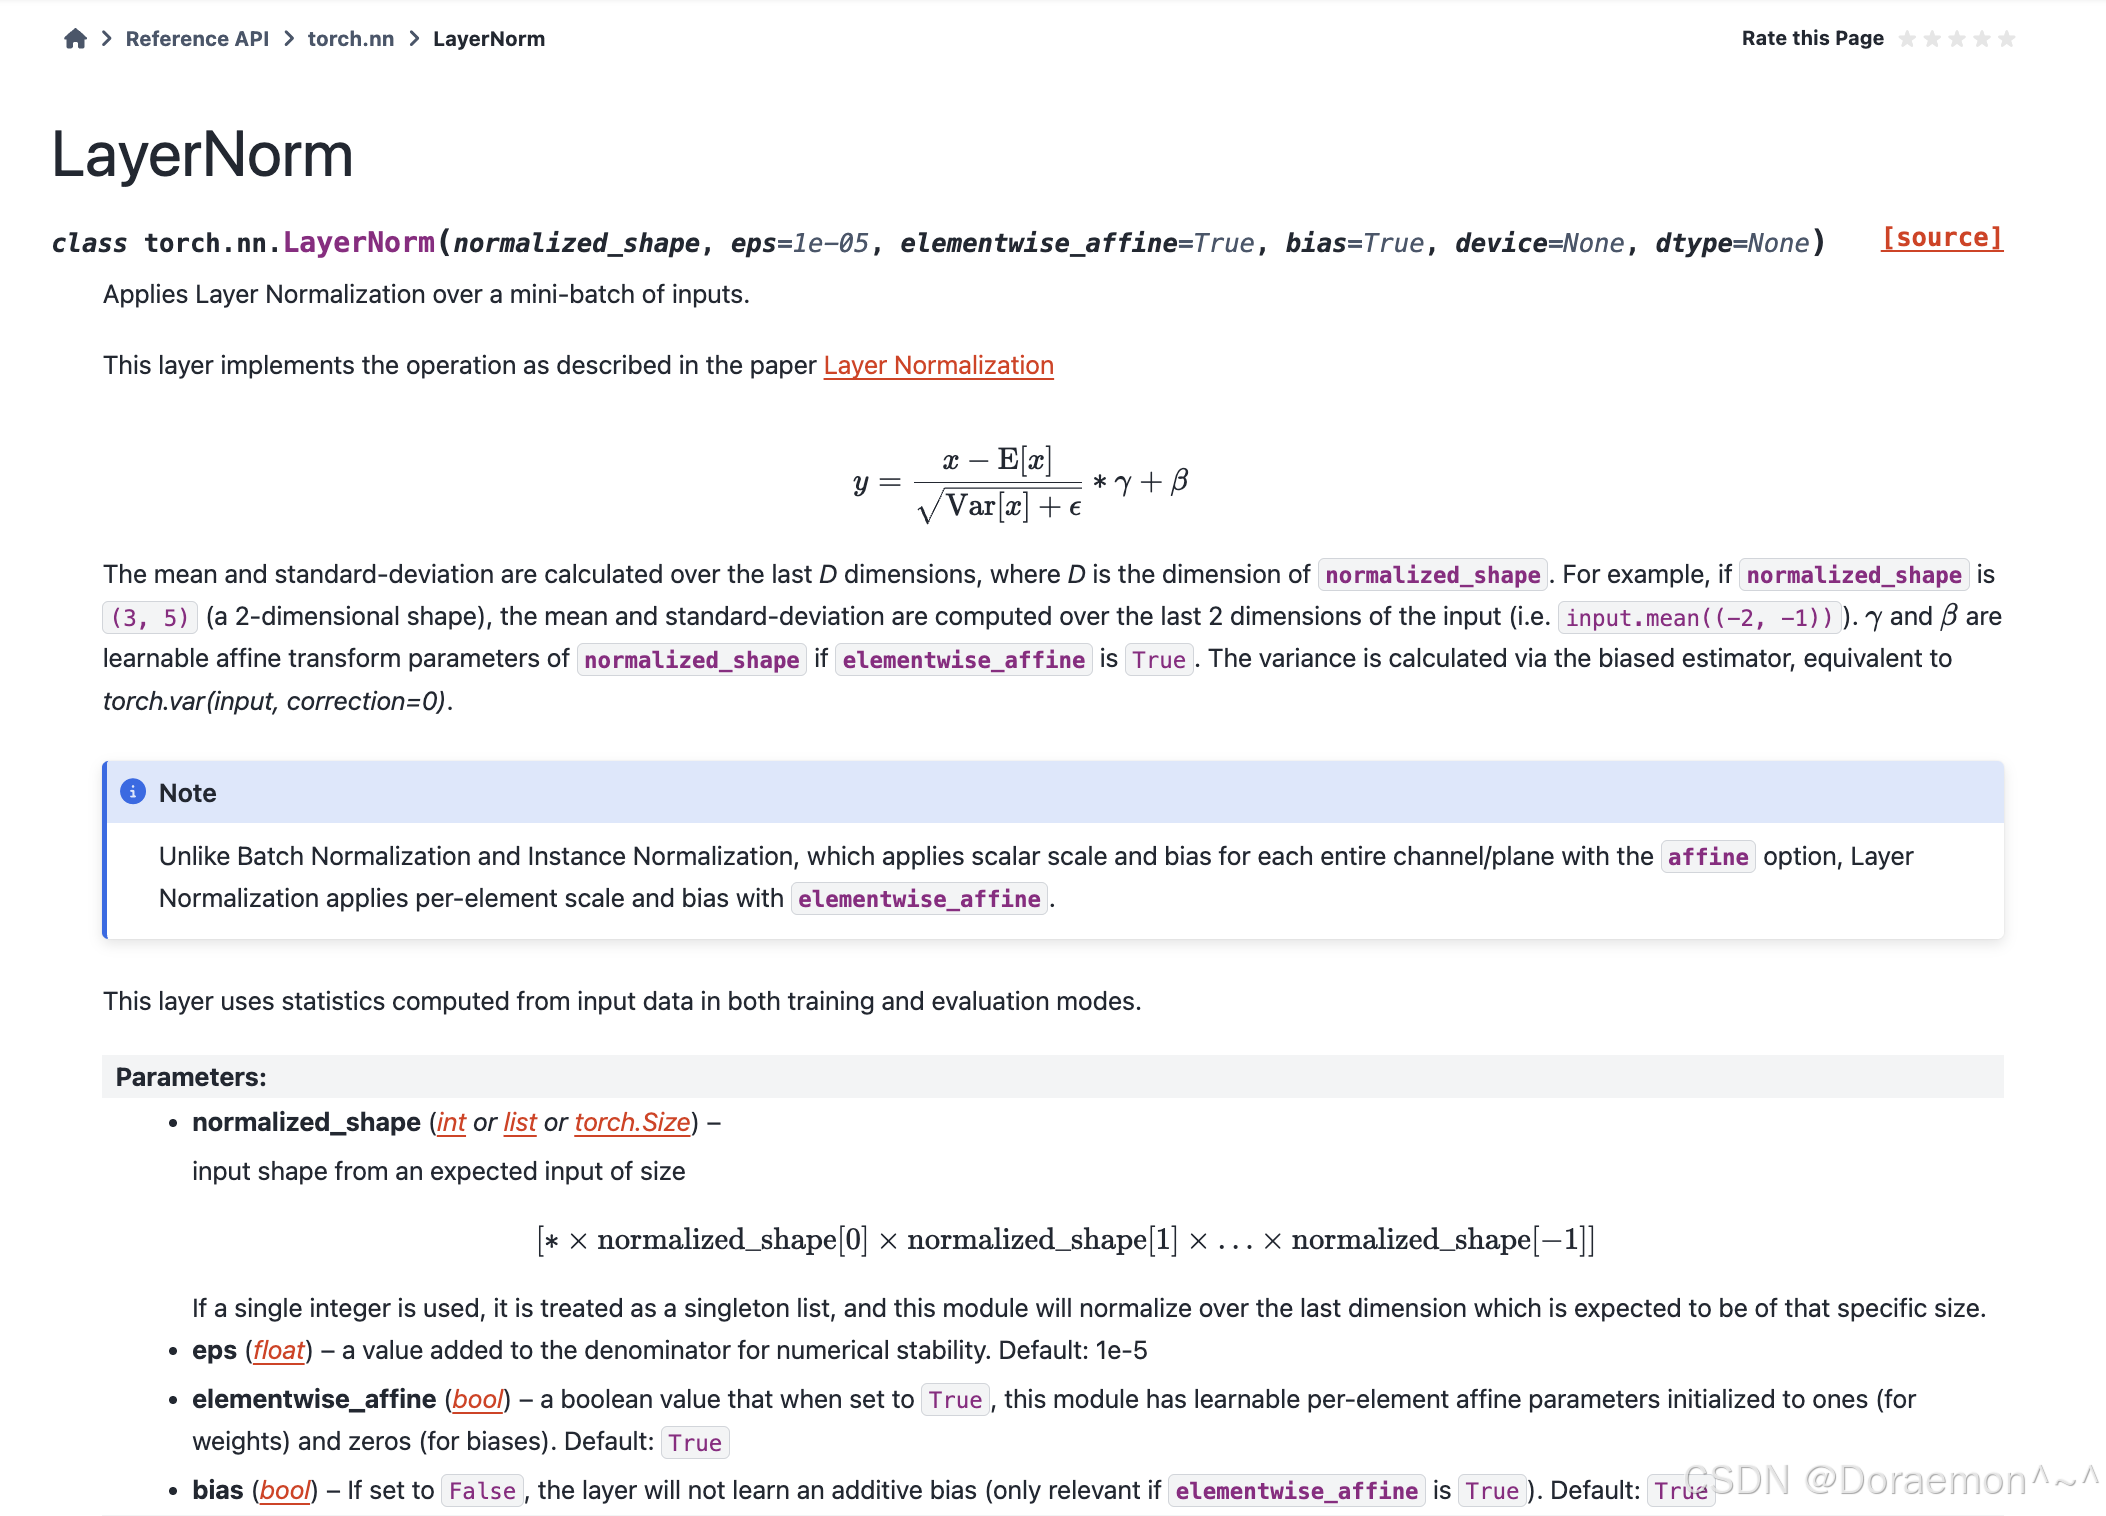
pytorch的LN层 (nn.LayerNorm)文档:LayerNorm --- PyTorch 2.14 documentation
2.残差连接
在Transformer Encoder Block中,自注意力或FFN Layer的输入和输出被加到一起,之后再输入给LayerNorm Layer。x+Sublayer(x)的结构即残差连接 (Residual Connection) 。残差连接的核心思想是通过引入"捷径" (在有的论文中又被称为"highway"),将输入直接传递到后边的层,这在实际上减小了梯度传播的层数。
output = input + sublayer(input)
sublayer(input) = output - input
极深的神经网络 (上百层甚至上千层) 由于梯度连乘的作用,容易发生梯度消失。残差连接最主要的作用是通过引入捷径,减小反向传播过程中梯度幅度衰减的程度,从而缓解梯度消失的影响,改善神经网络的训练效果。
3.位置编码
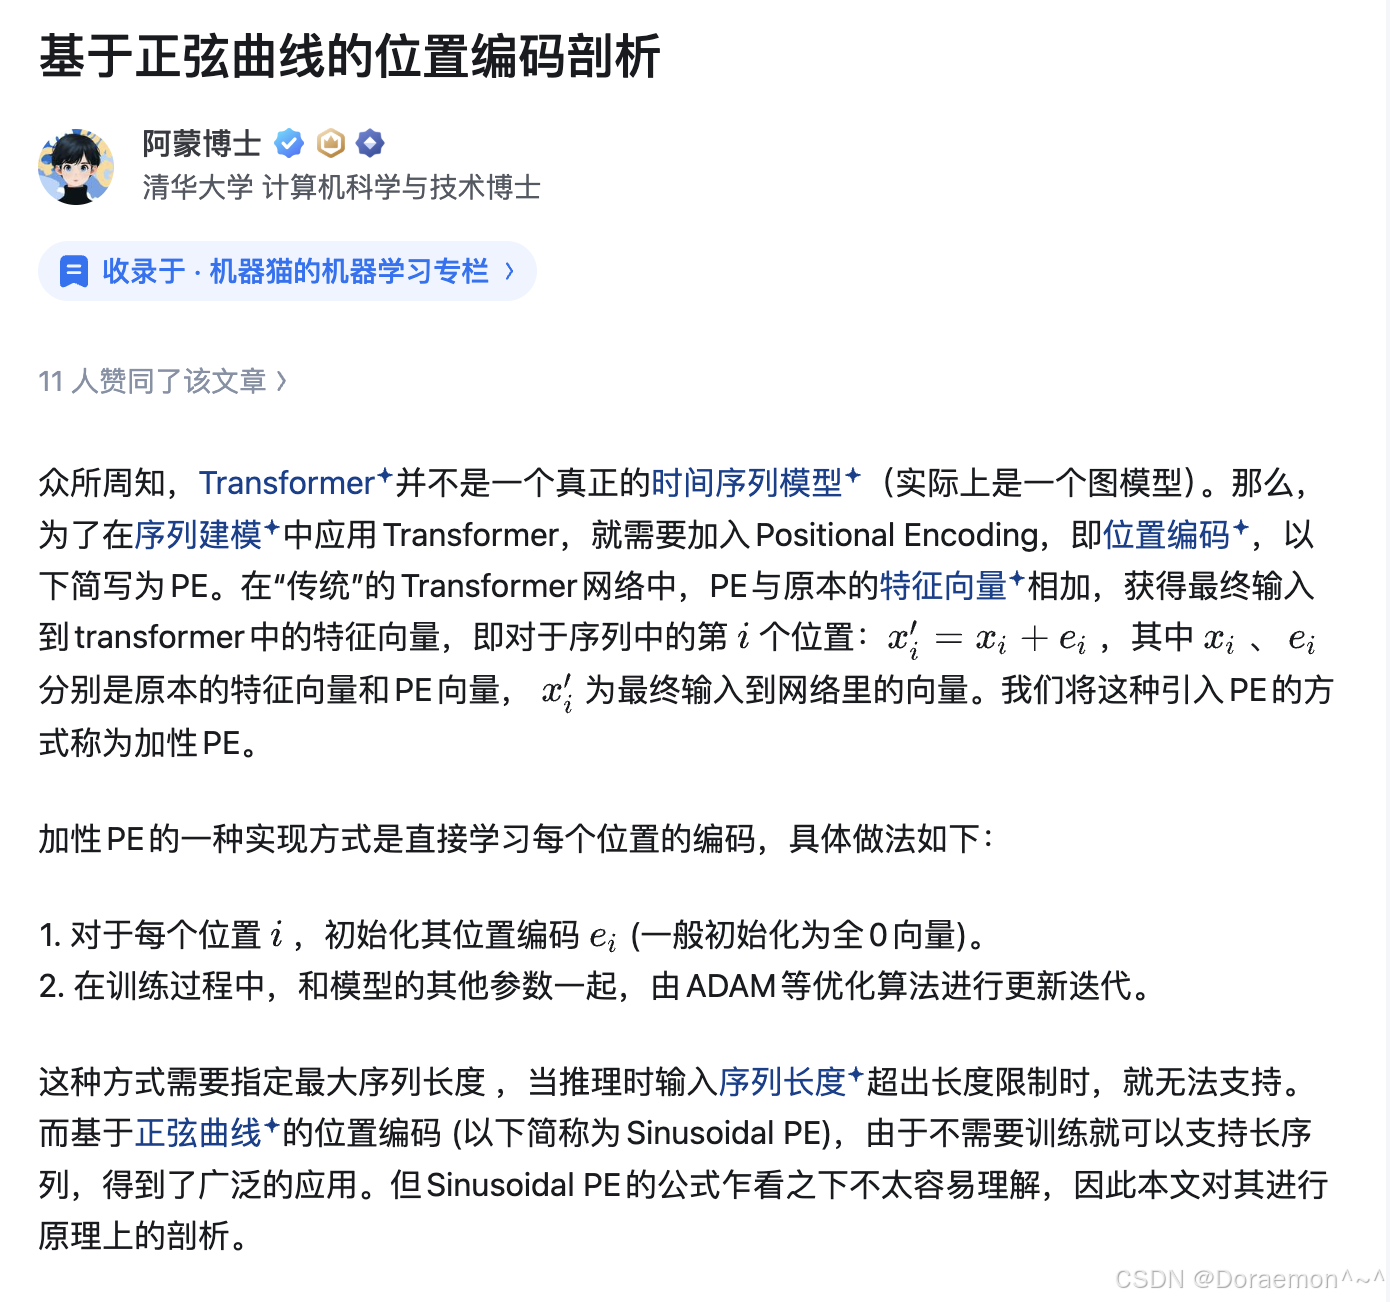
Transformer并不是一个时间序列模型。实际上,如果我们将序列中第i个位置和第j个位置上的token互换,那么最后计算得到的输出,也只是同样在i,j位置上发生了互换而已,除此以外每个位置上的输出特征都和之前完全一样。但显然,句子中token的顺序会严重影响语义。因此,Transformer的输入特征中增加了对token所在位置的编码,用公式表示为:
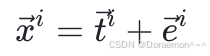
其中 为第i个token的嵌入向量 (Embedding Vector),
 为位置i的位置编码。
位置编码可以通过增加位置嵌入词典的方式直接学到,即增加一个嵌入词典,每个位置i对应一个嵌入向量。Embedding权重随机初始化,作为模型参数在训练过程中进行更新。BERT采用了这种位置编码策略,Embedding的行数为512,即支持0~511位置的位置编码。这种方式无法在推理阶段扩展序列长度。
test_pe.py:
pythonimport torch import torch.nn as nn # -------------------------- # 参数定义 # -------------------------- vocab_size = 10000 # 词表大小,一共10000个不同token # 构造token序列:生成长度为512的token id序列,每个id范围 [0, vocab_size-1] tok_seq = torch.randint(0, vocab_size, [512]) print(tok_seq.shape) # 输出 shape: torch.Size([512]) # 构造位置索引序列:0,1,2,...,511,代表序列中每个token的位置编号 pos_seq = torch.arange(512) print(pos_seq.shape) # 输出 shape: torch.Size([512]) # -------------------------- # 嵌入层定义(可学习位置编码) # -------------------------- token_embedding = nn.Embedding(vocab_size, 768) # Token嵌入层:词表->768维向量 pos_embedding = nn.Embedding(512, 768) # 位置嵌入层:位置id->768维向量,可学习位置编码 # -------------------------- # Transformer输入构造 # -------------------------- # token向量 + 位置向量逐元素相加,得到最终输入embedding inputs = token_embedding(tok_seq) + pos_embedding(pos_seq)
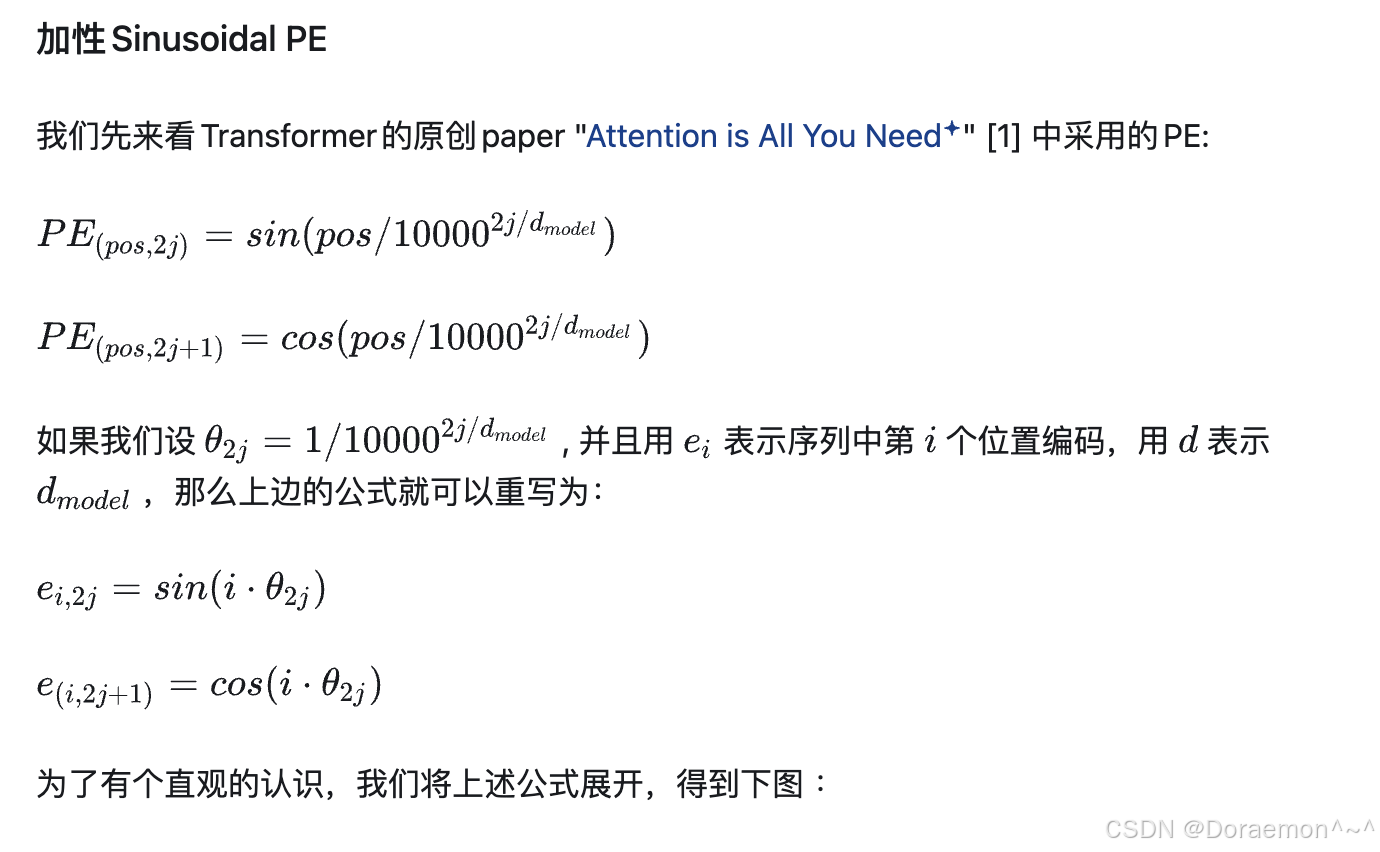
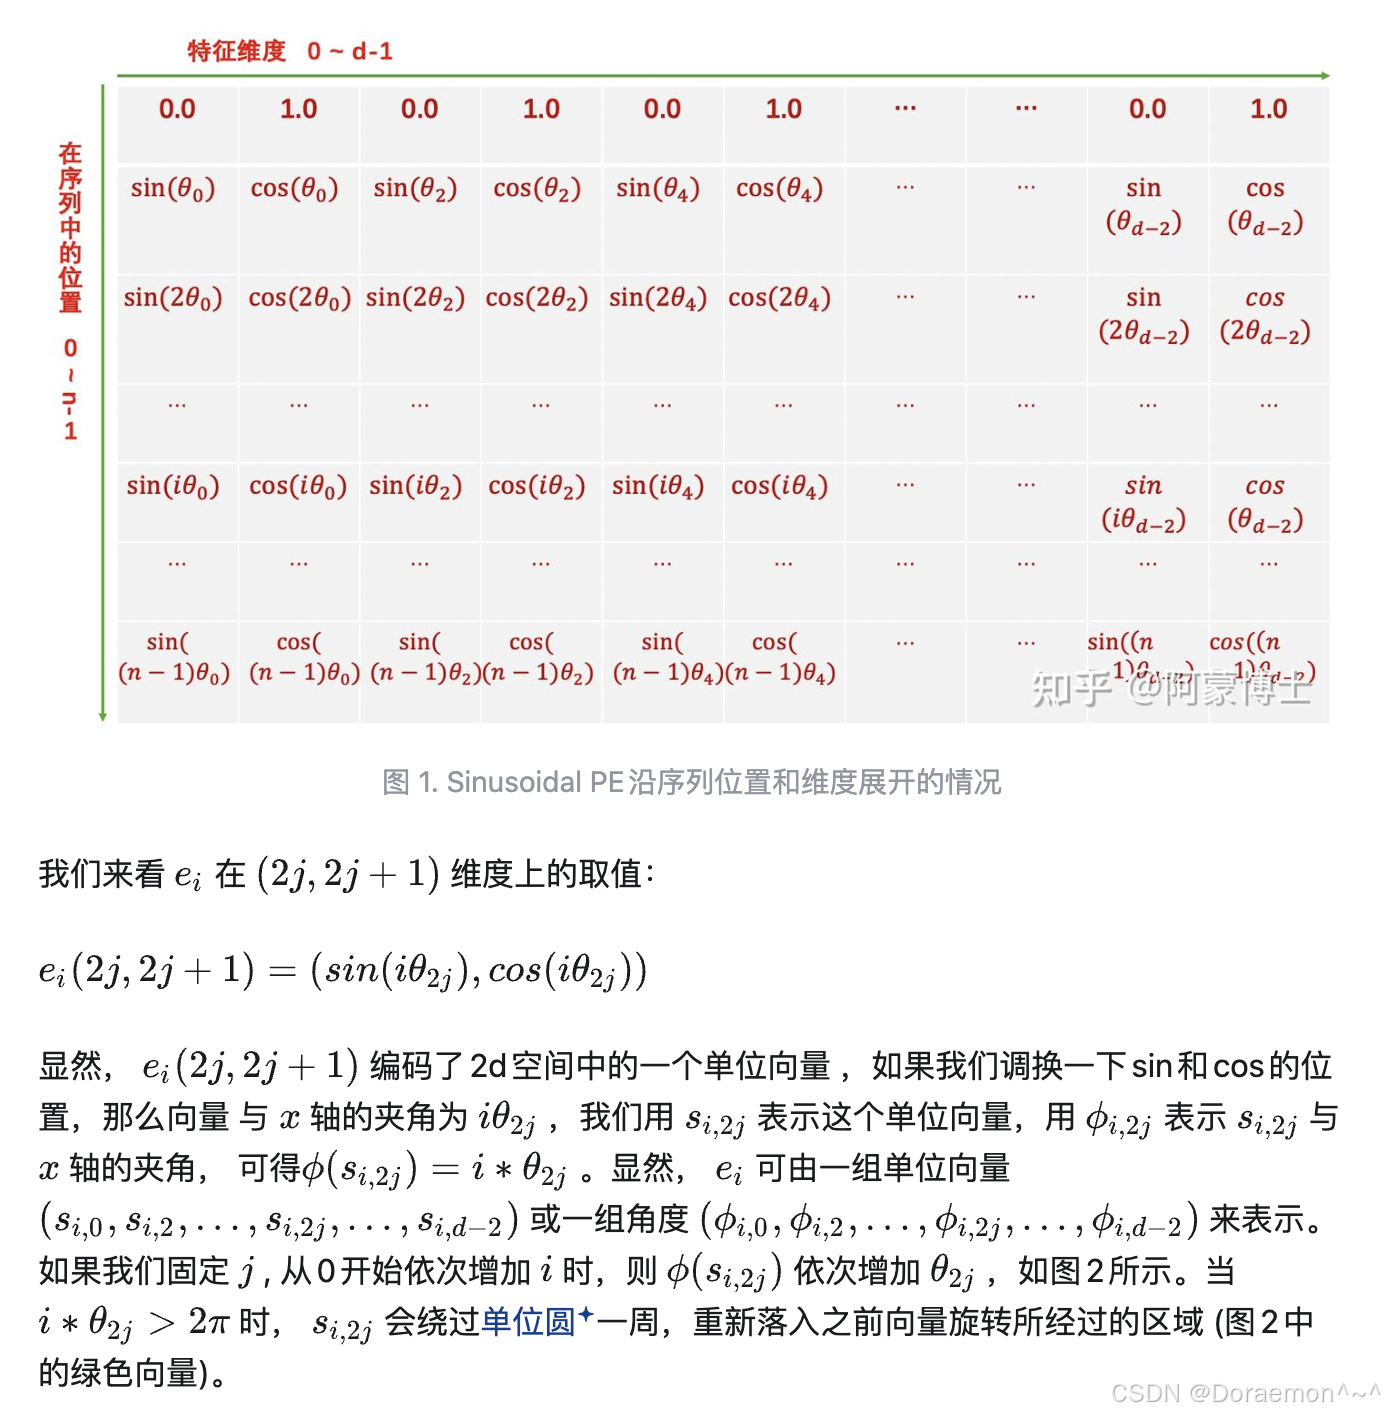
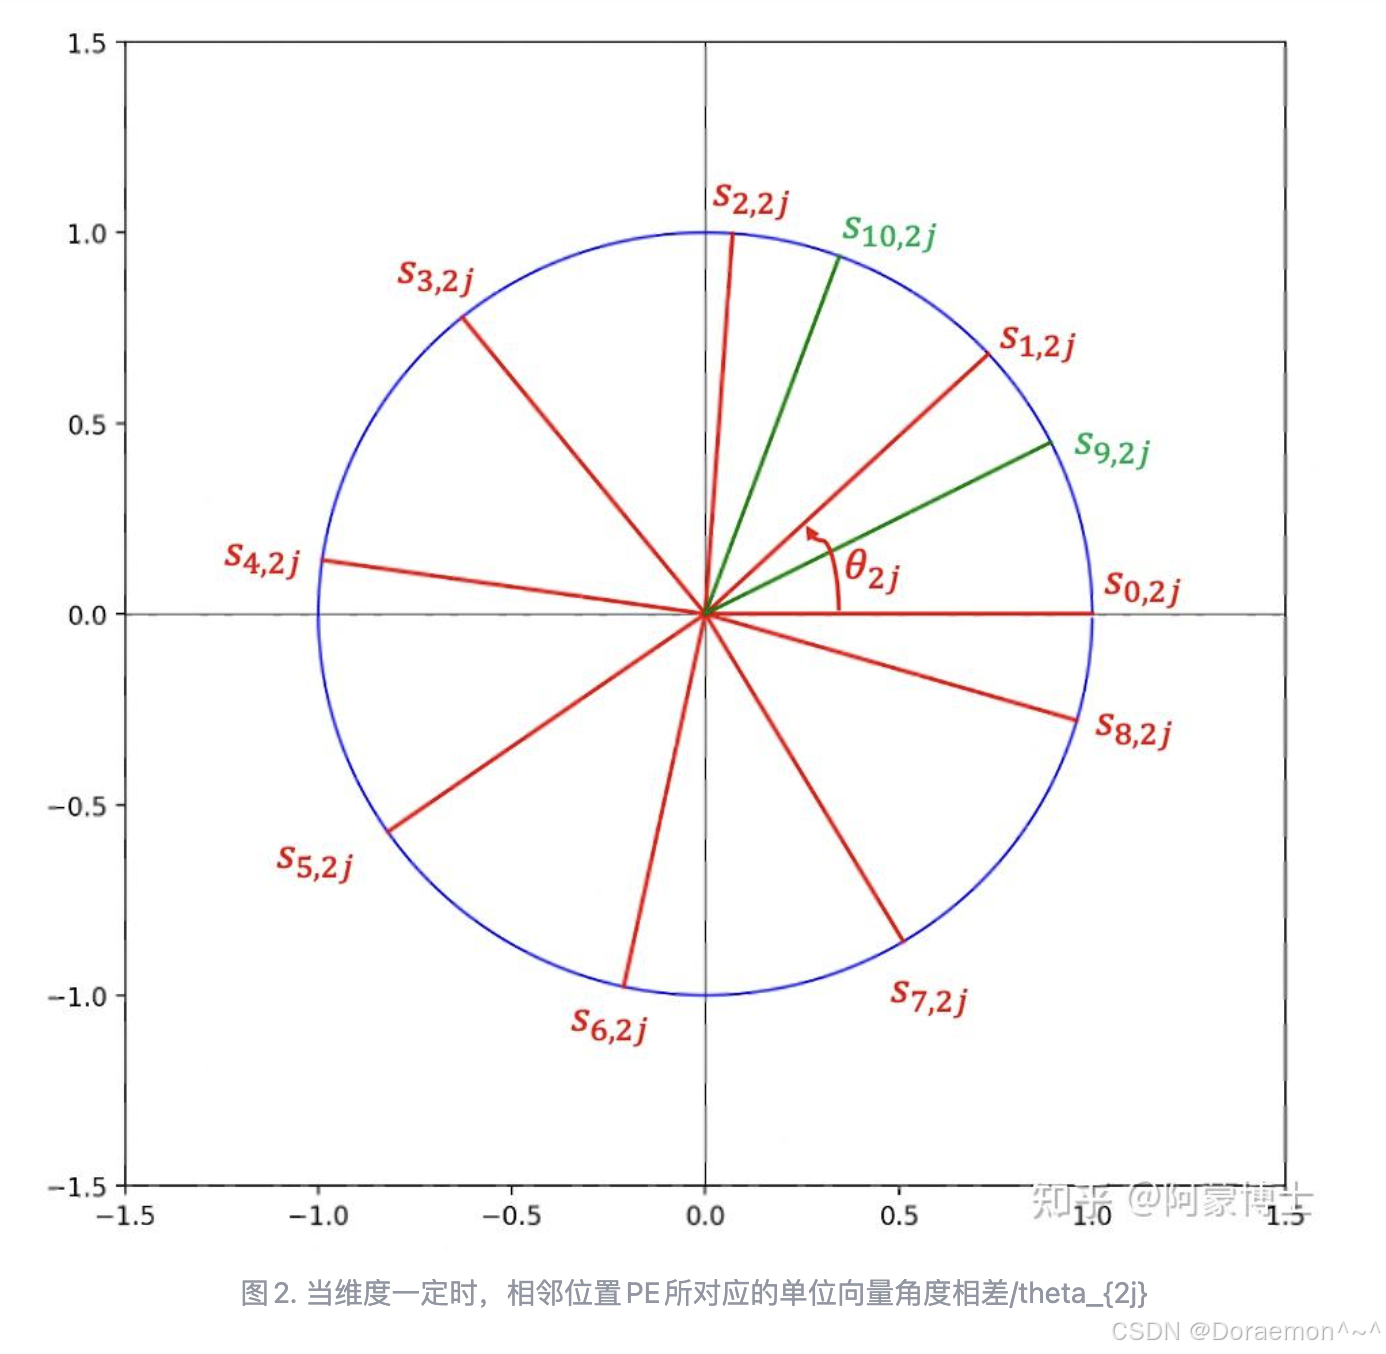
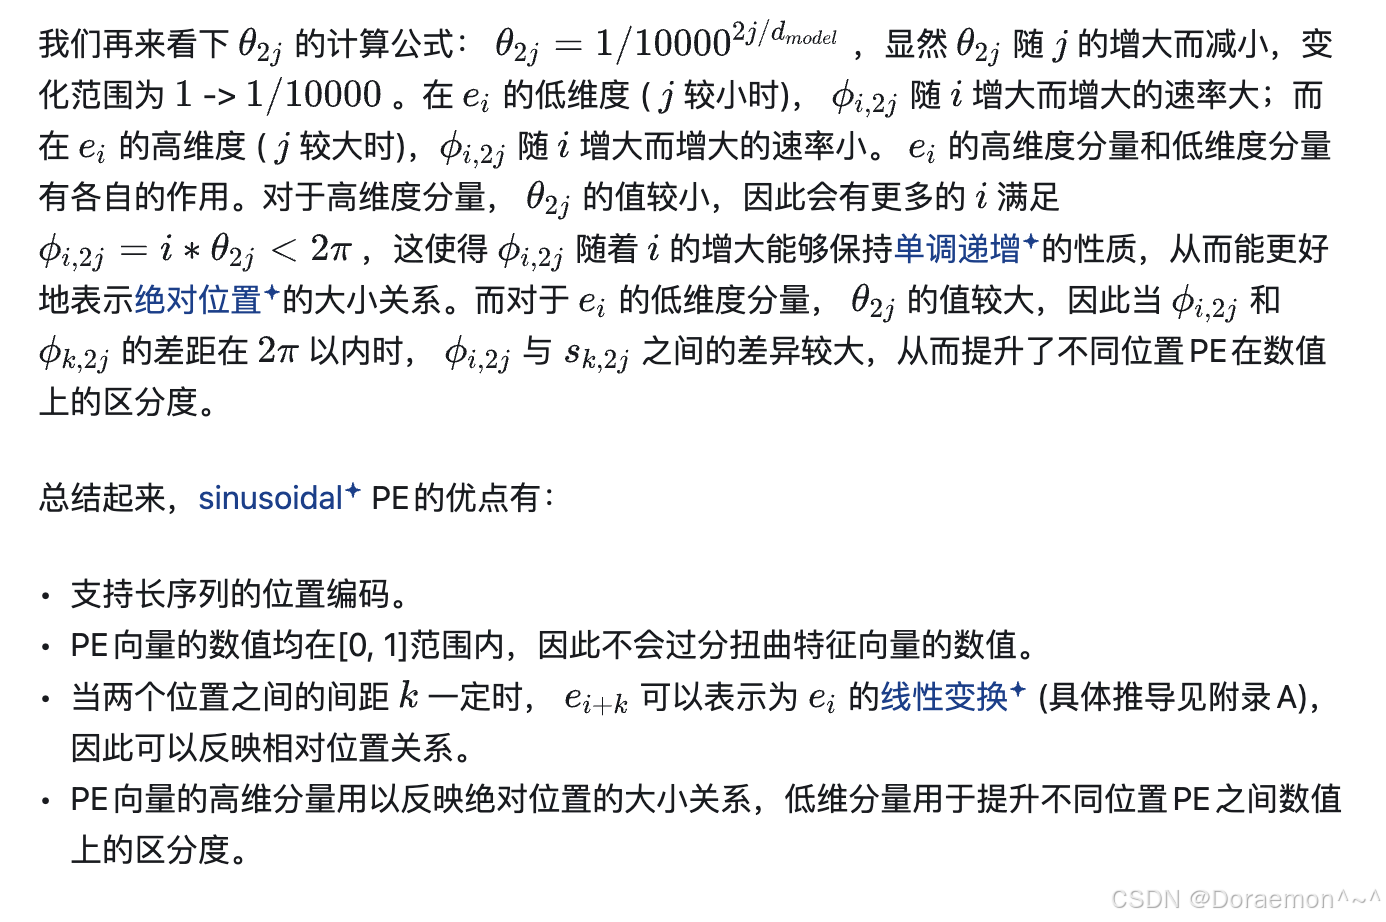
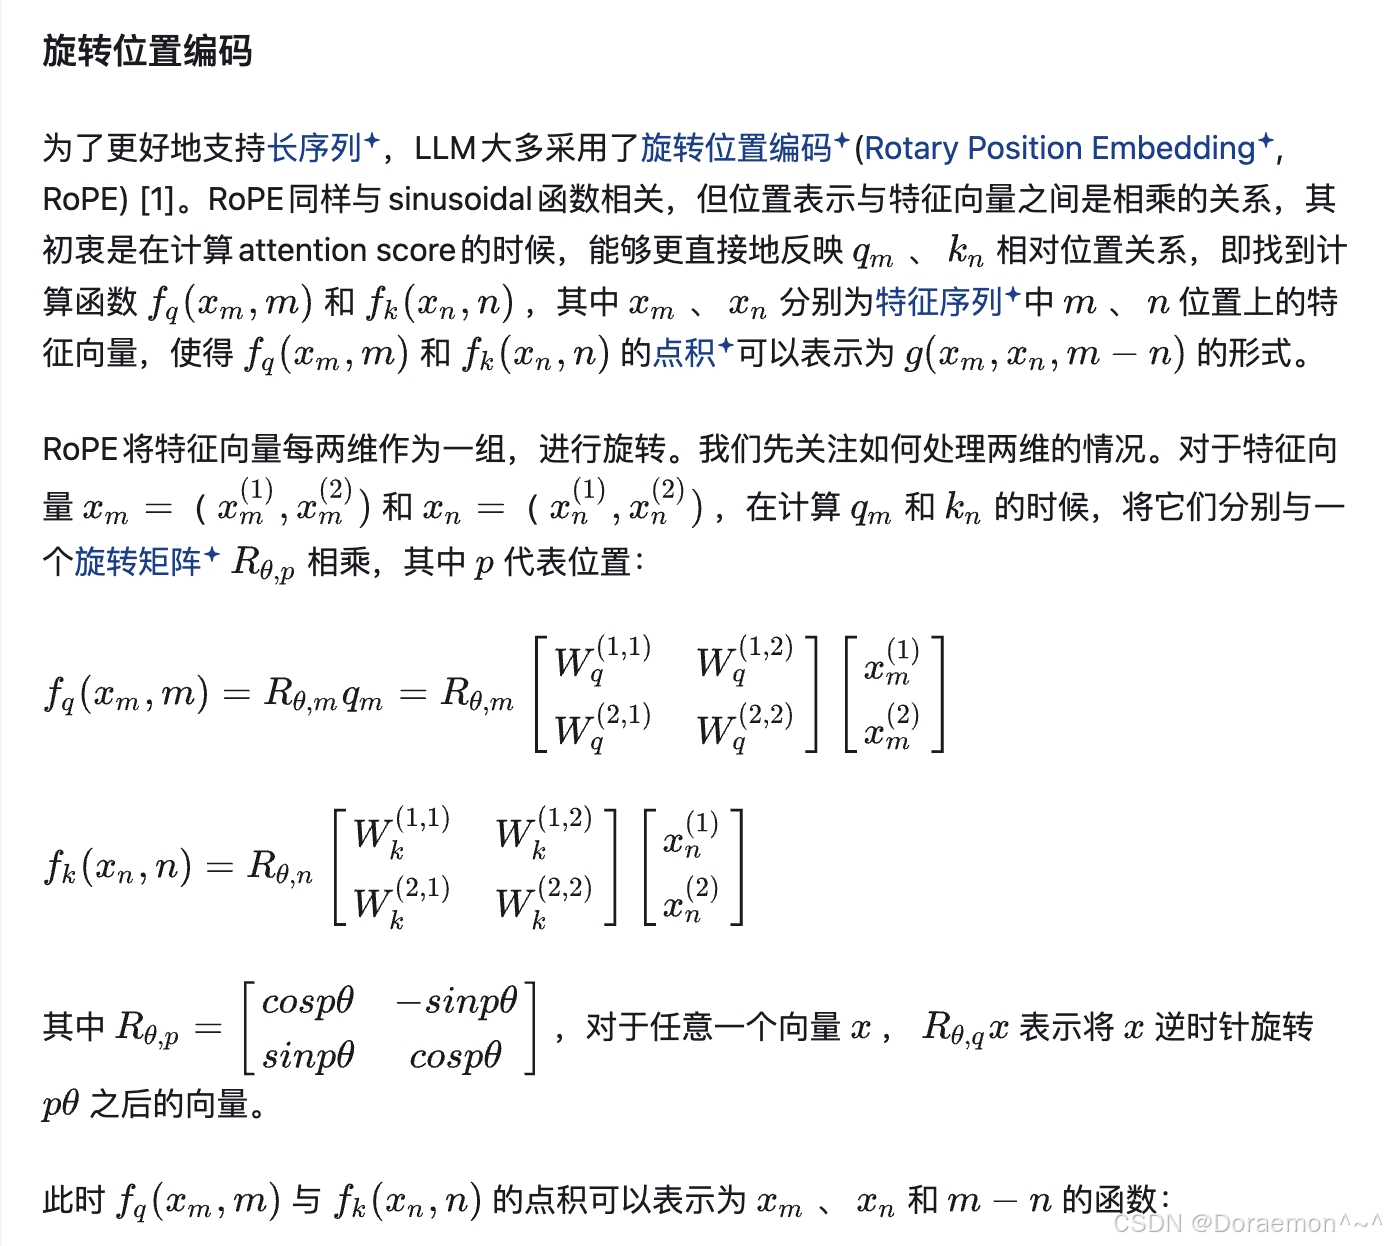
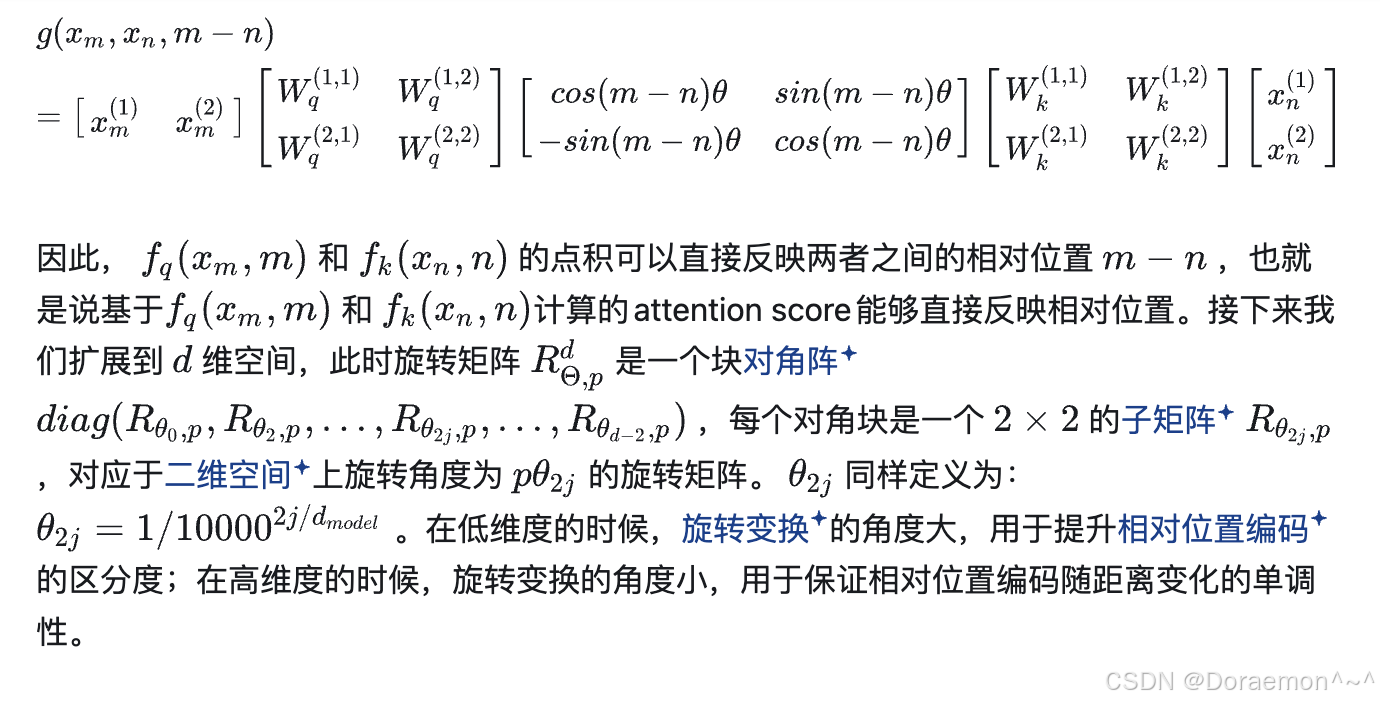
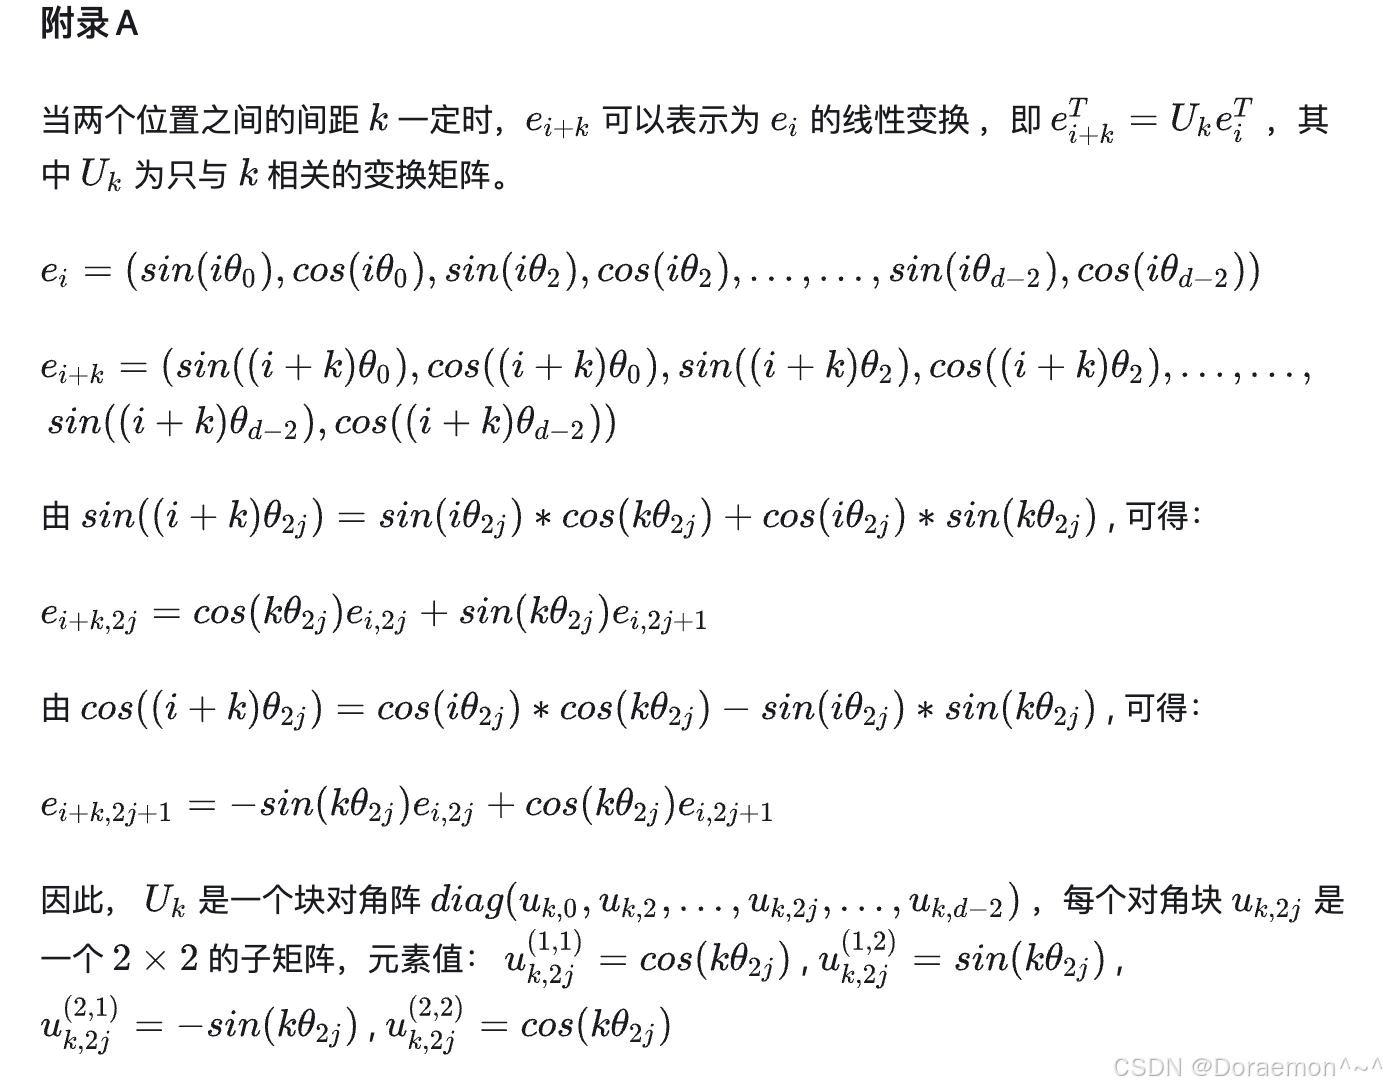
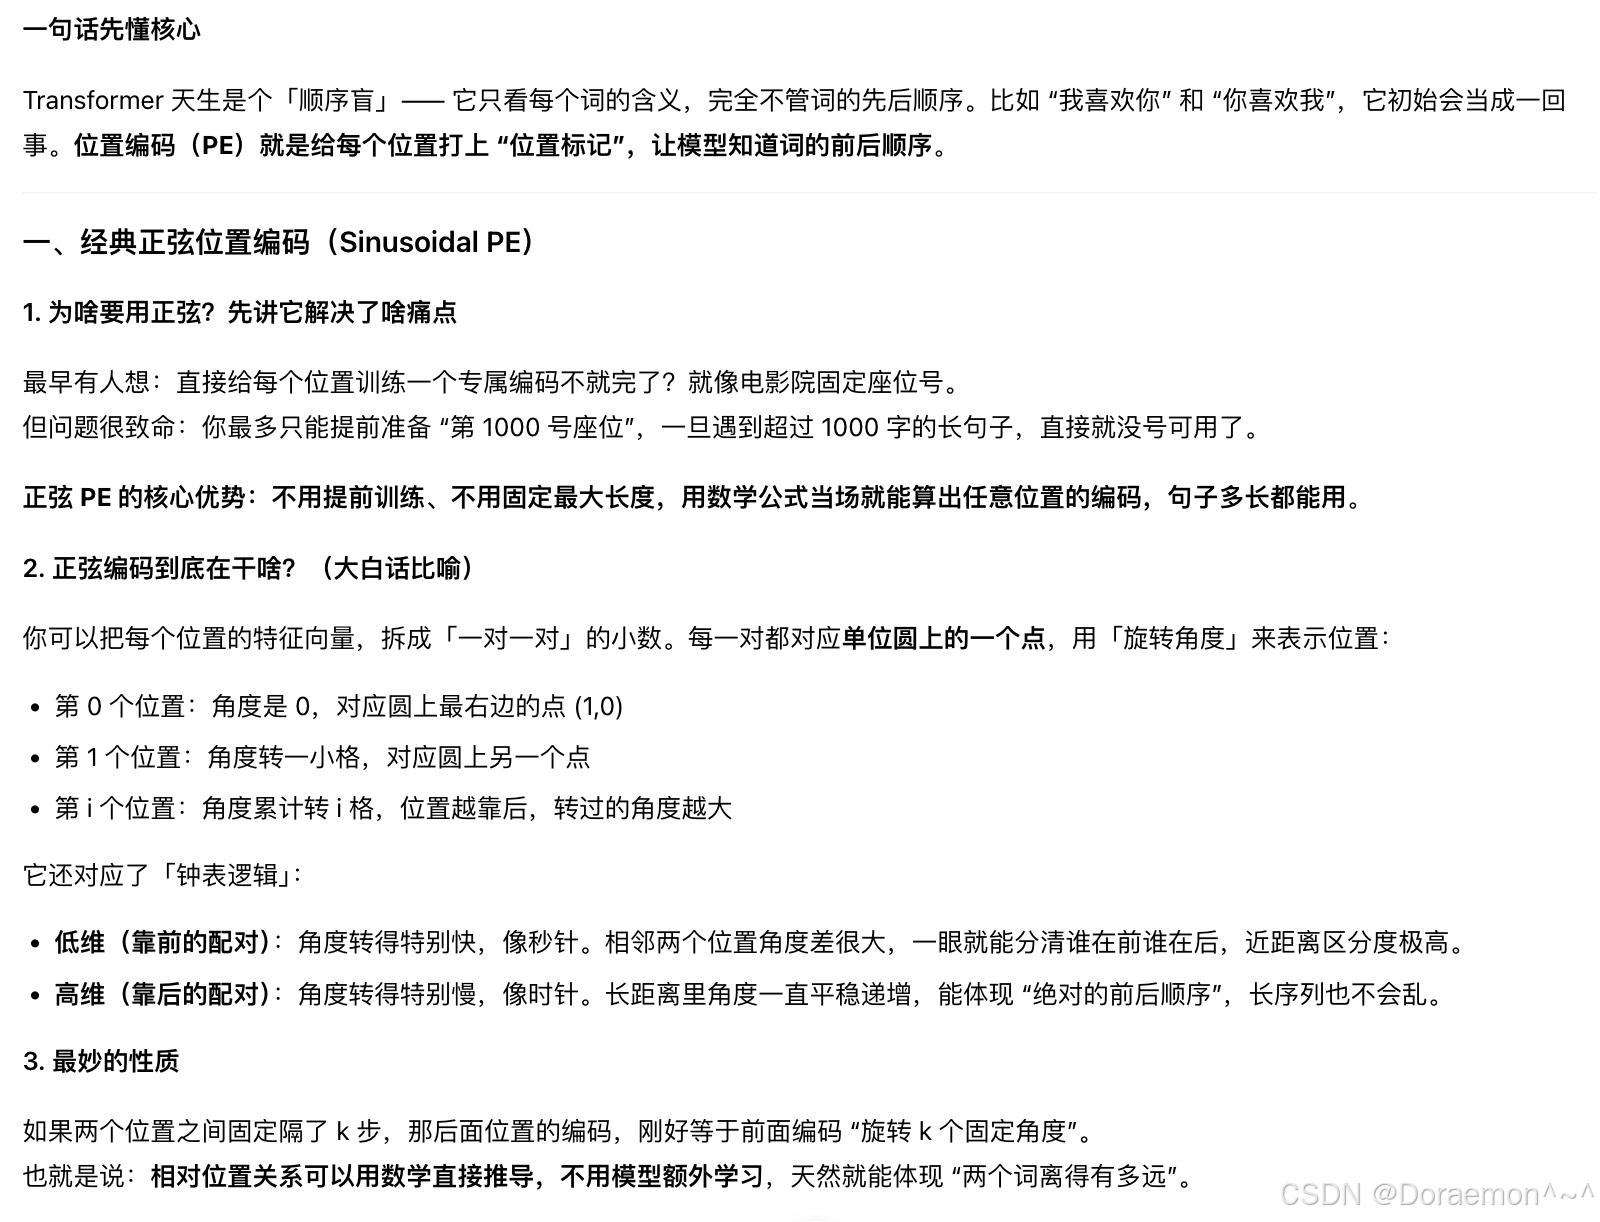
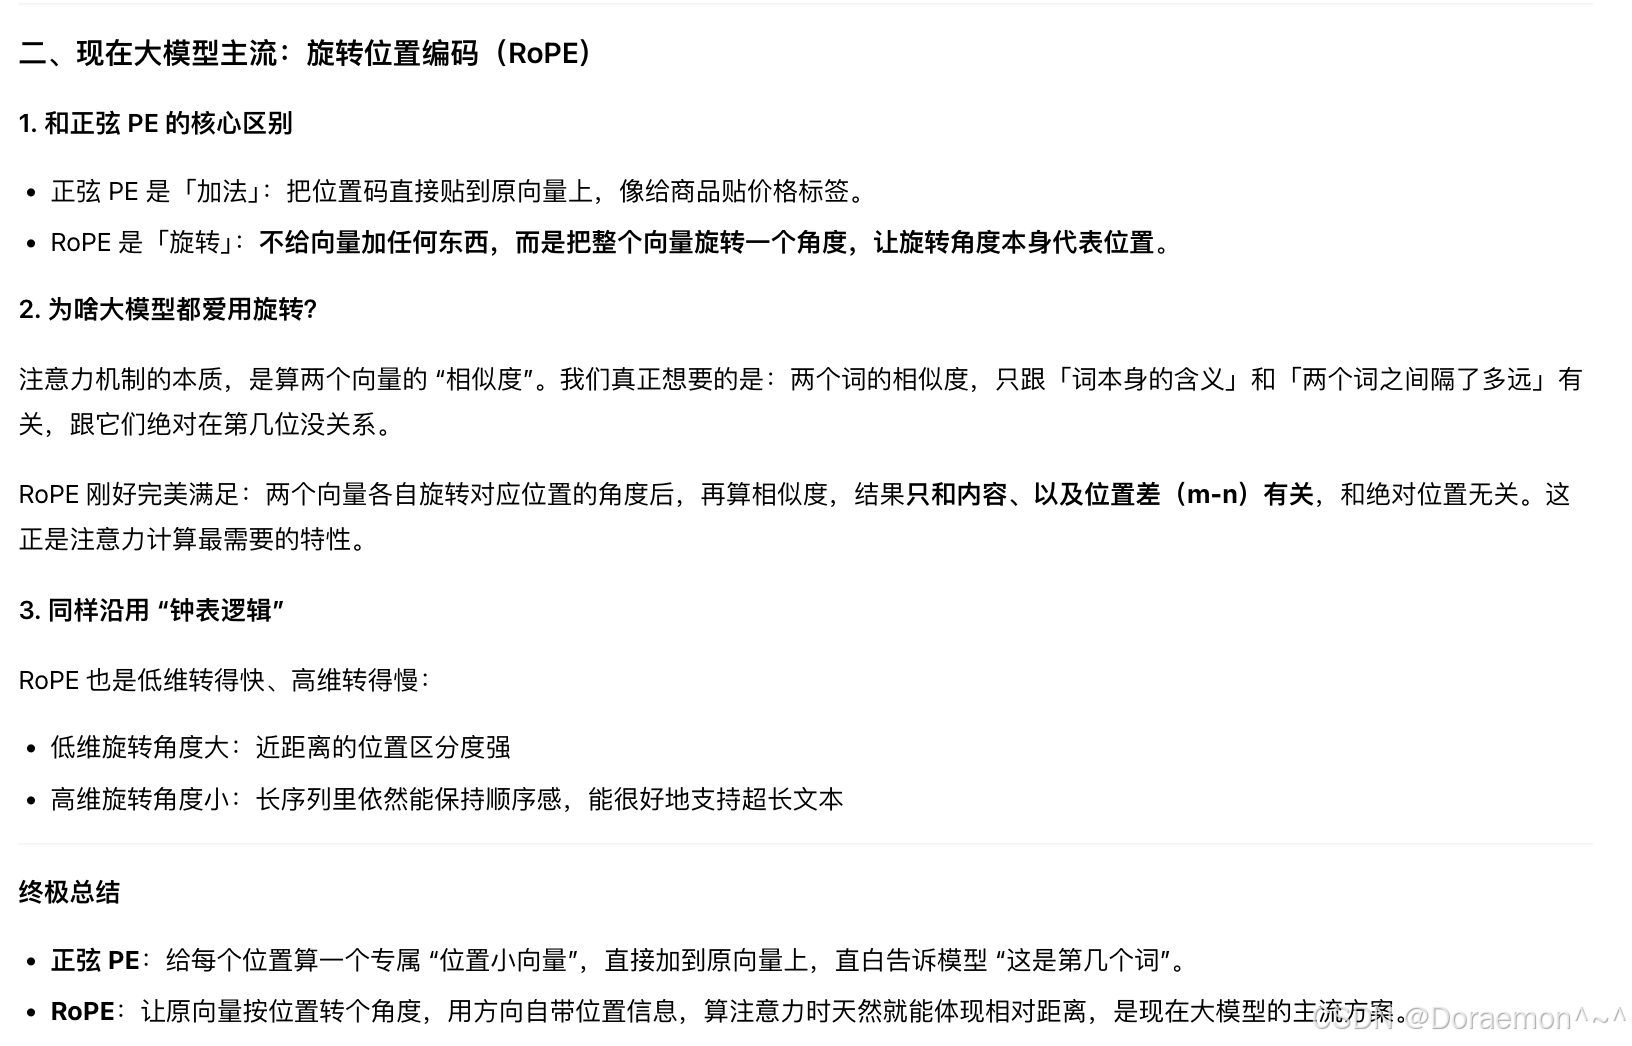
另外一种方式是基于正弦曲线计算位置编码,详见:https://zhuanlan.zhihu.com/p/714974046
类比时钟-时针分针秒针,越低维度时间分辨率越高,越高维度时间分辨率越低。
4.Dropout (暂退法)
论文:https://dl.acm.org/doi/pdf/10.5555/2627435.2670313
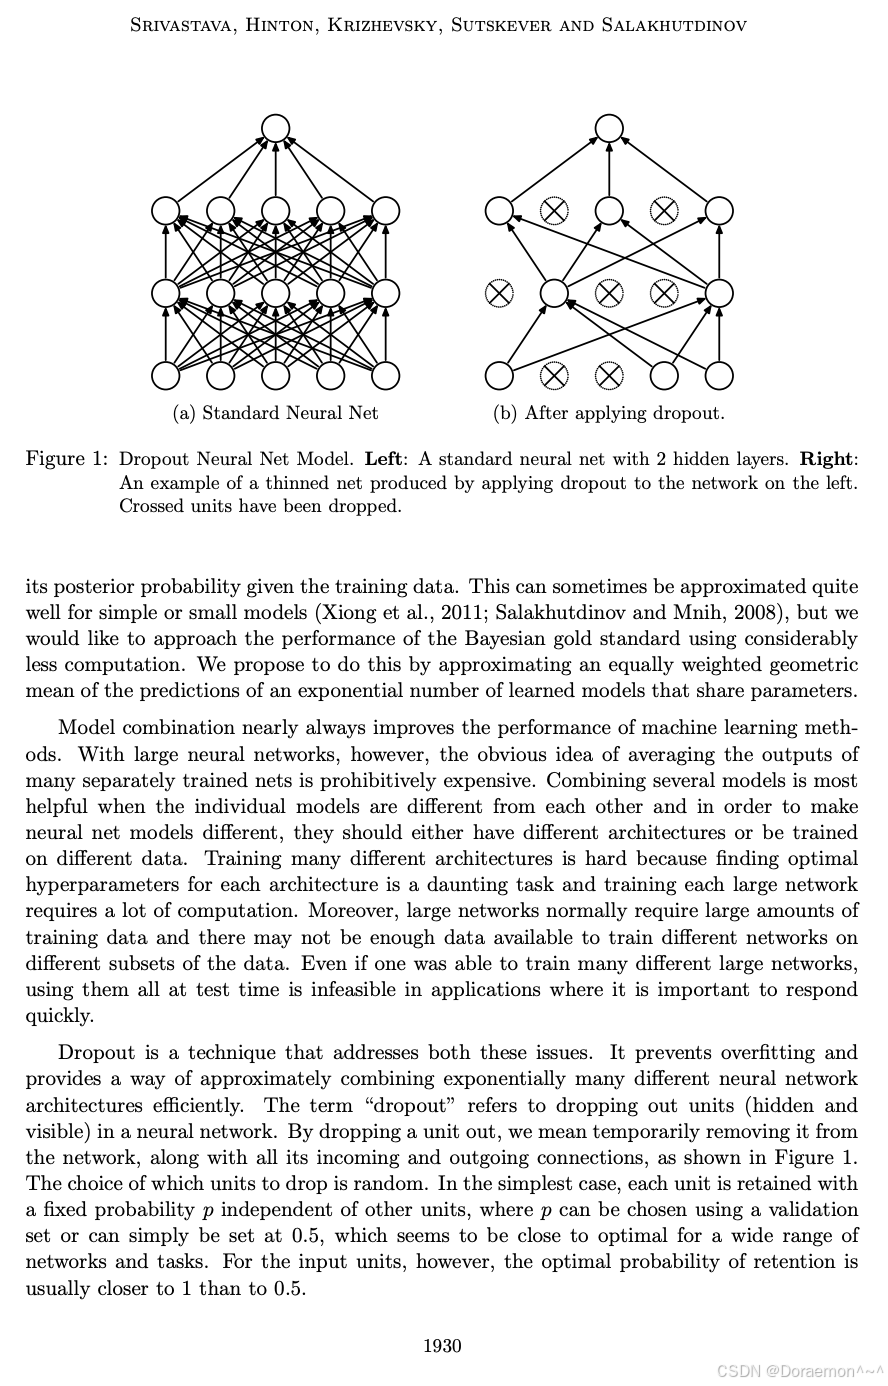
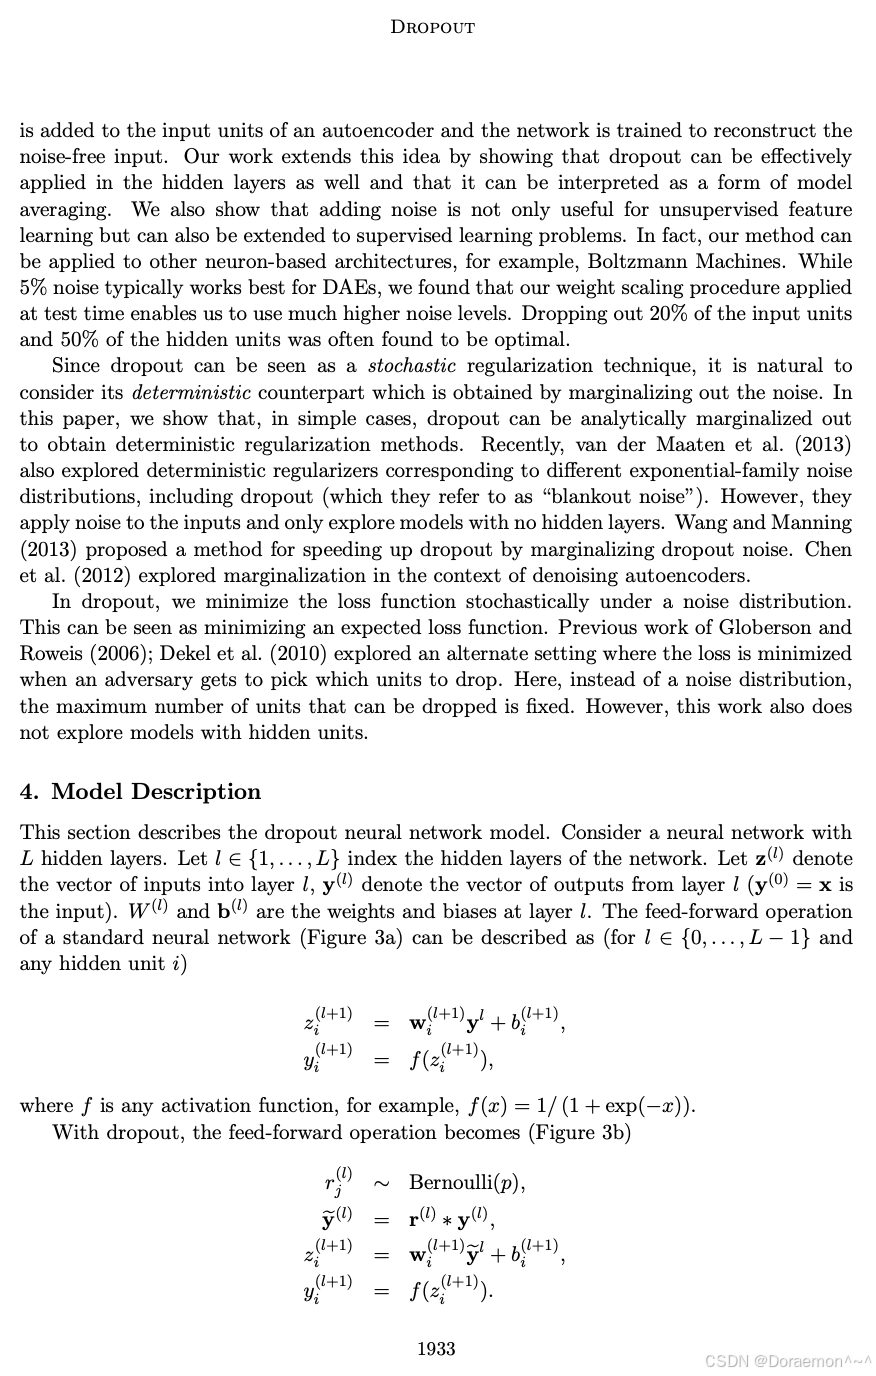
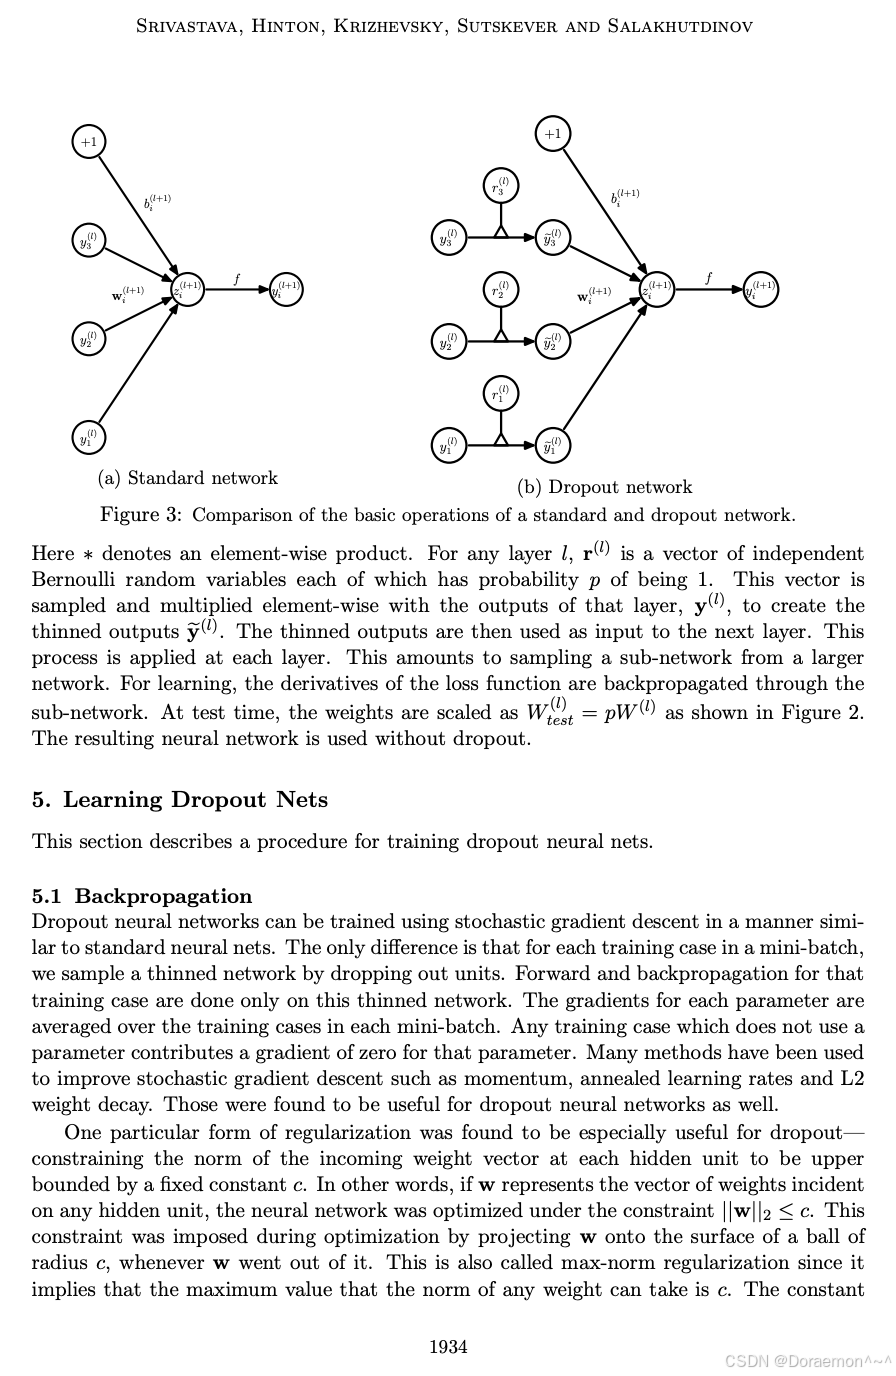
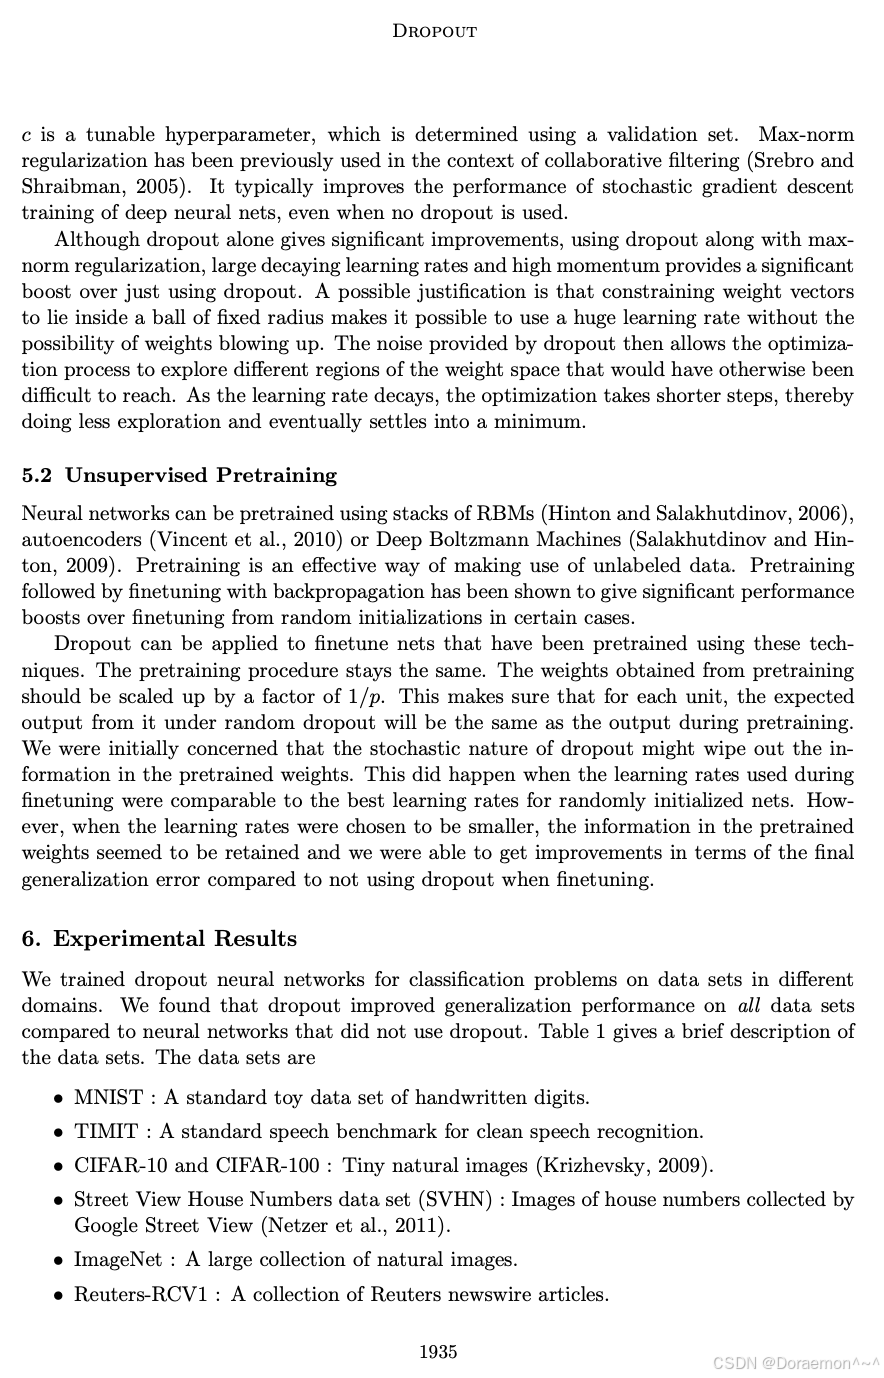
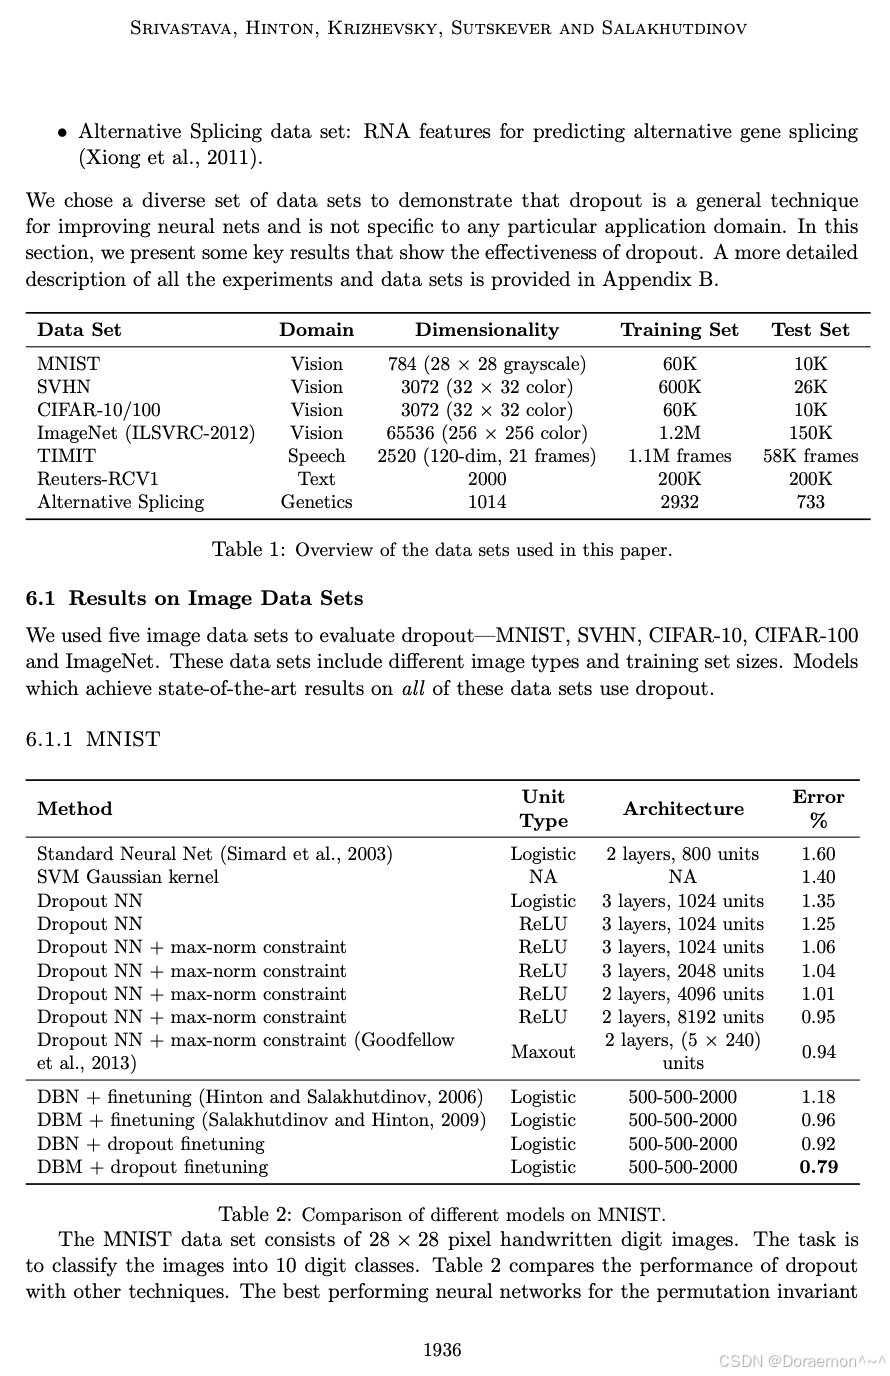
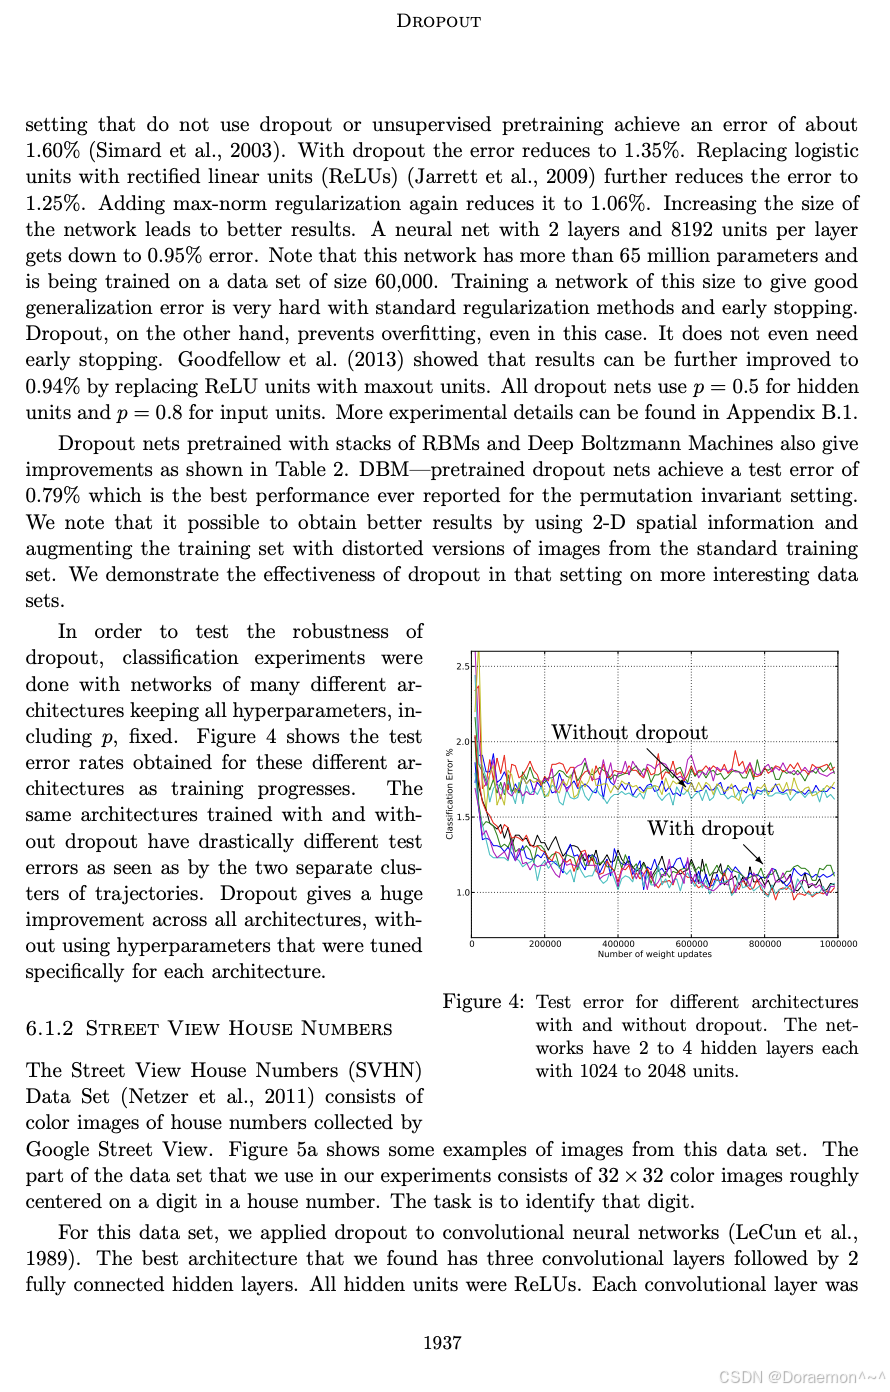
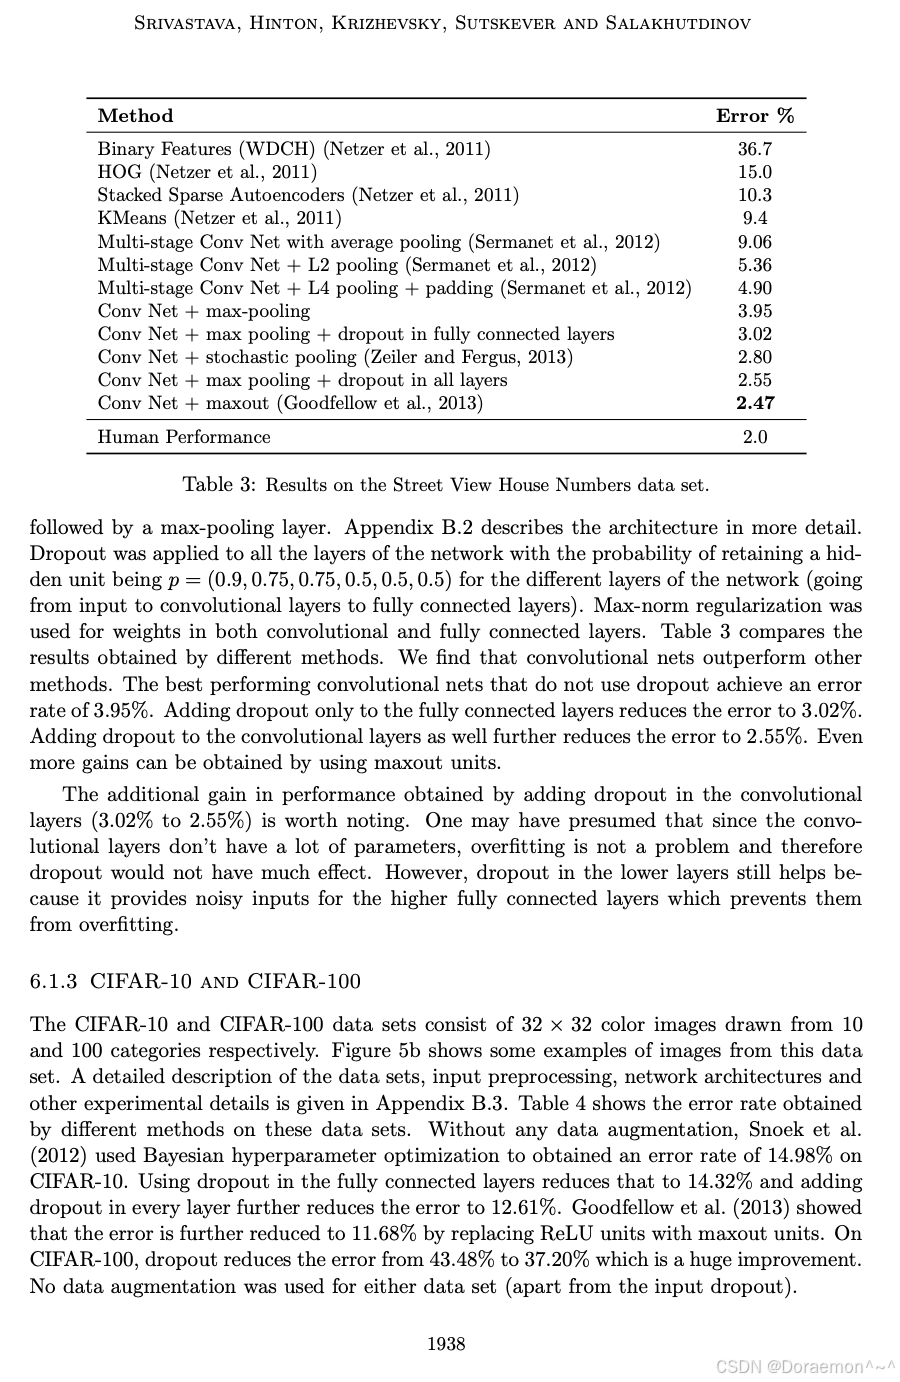
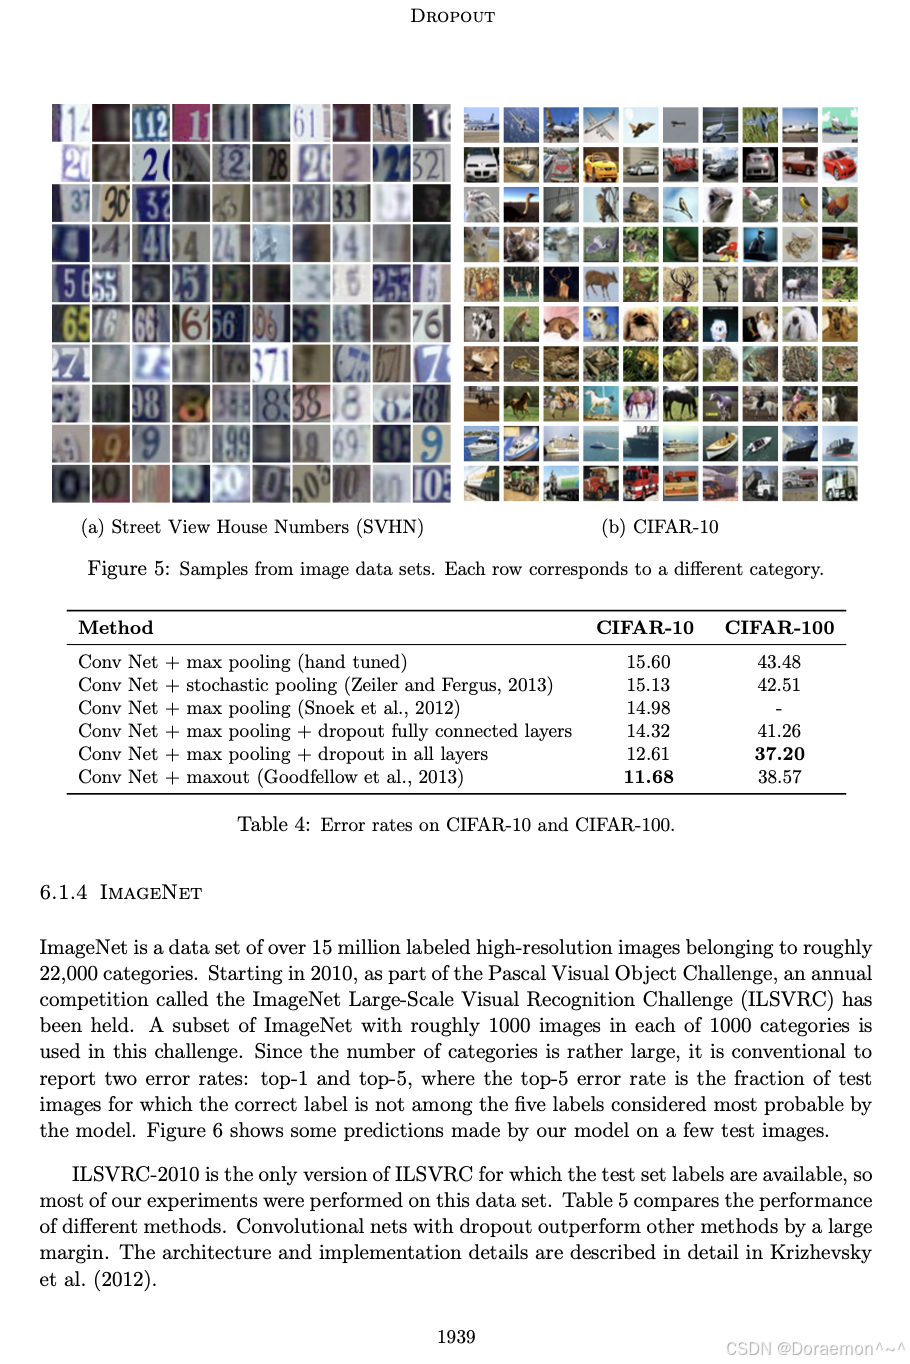
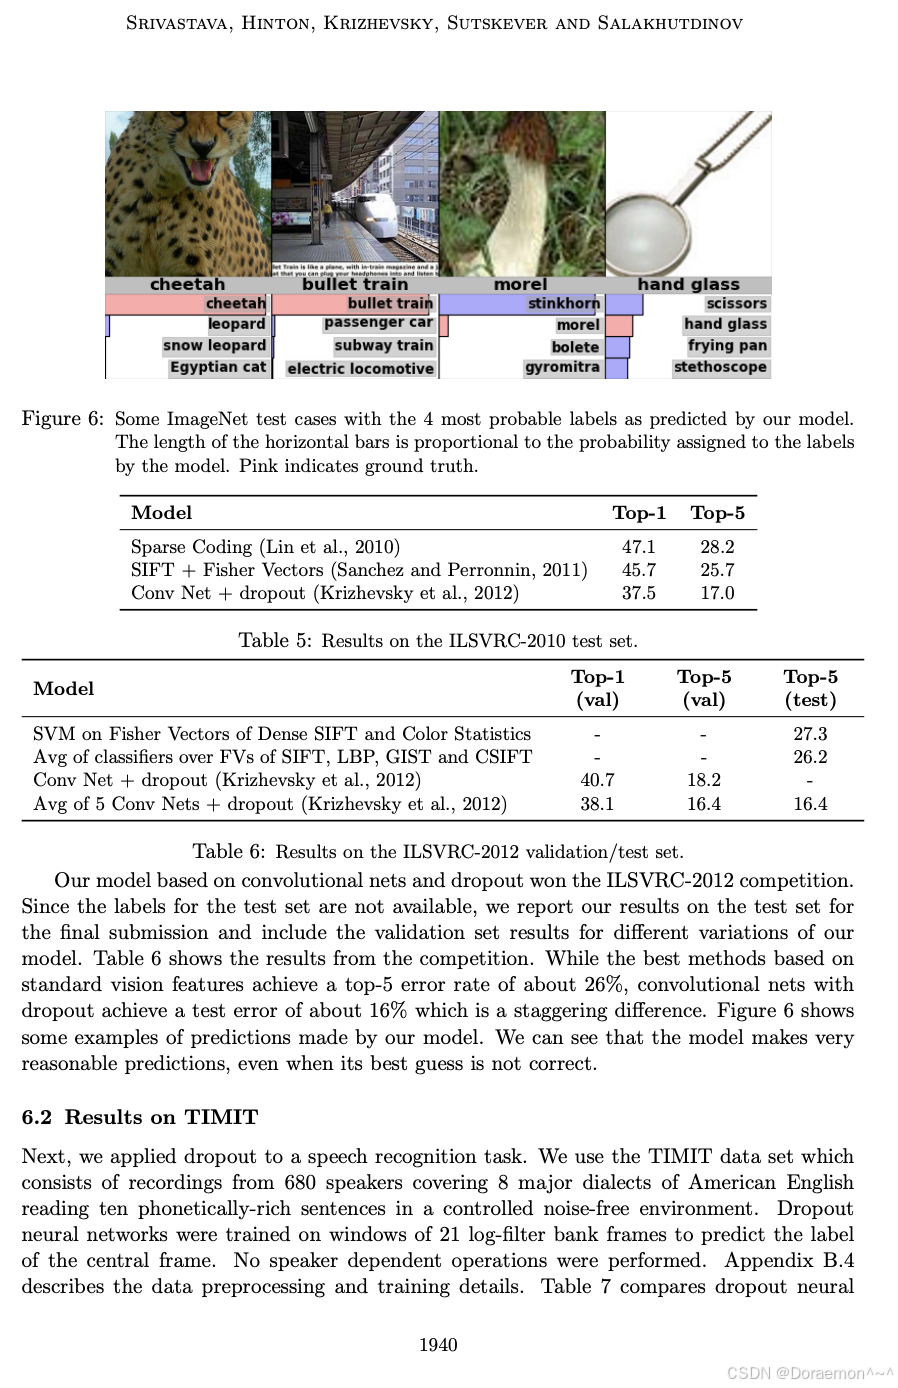
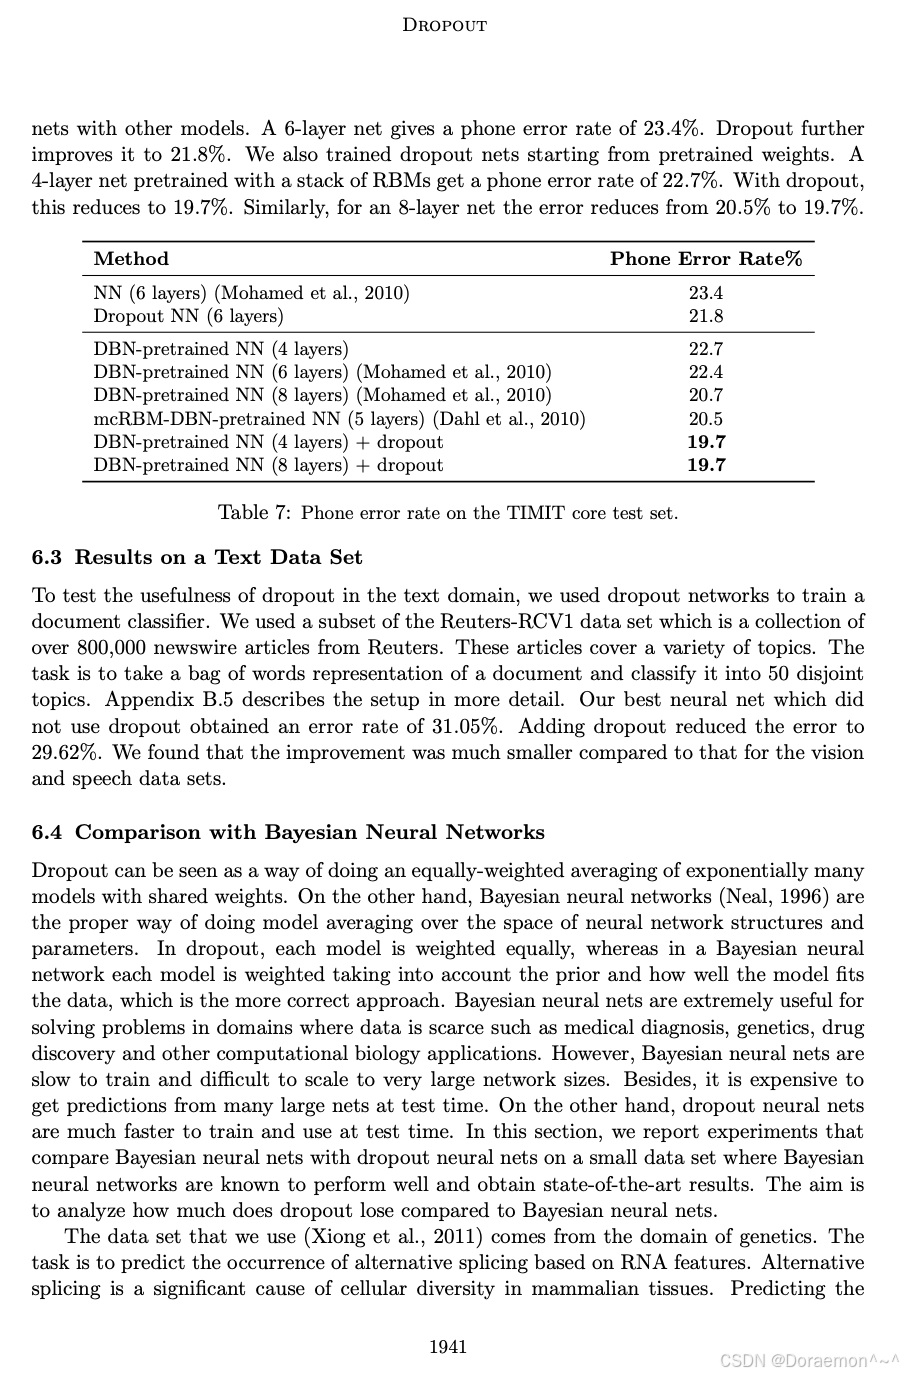
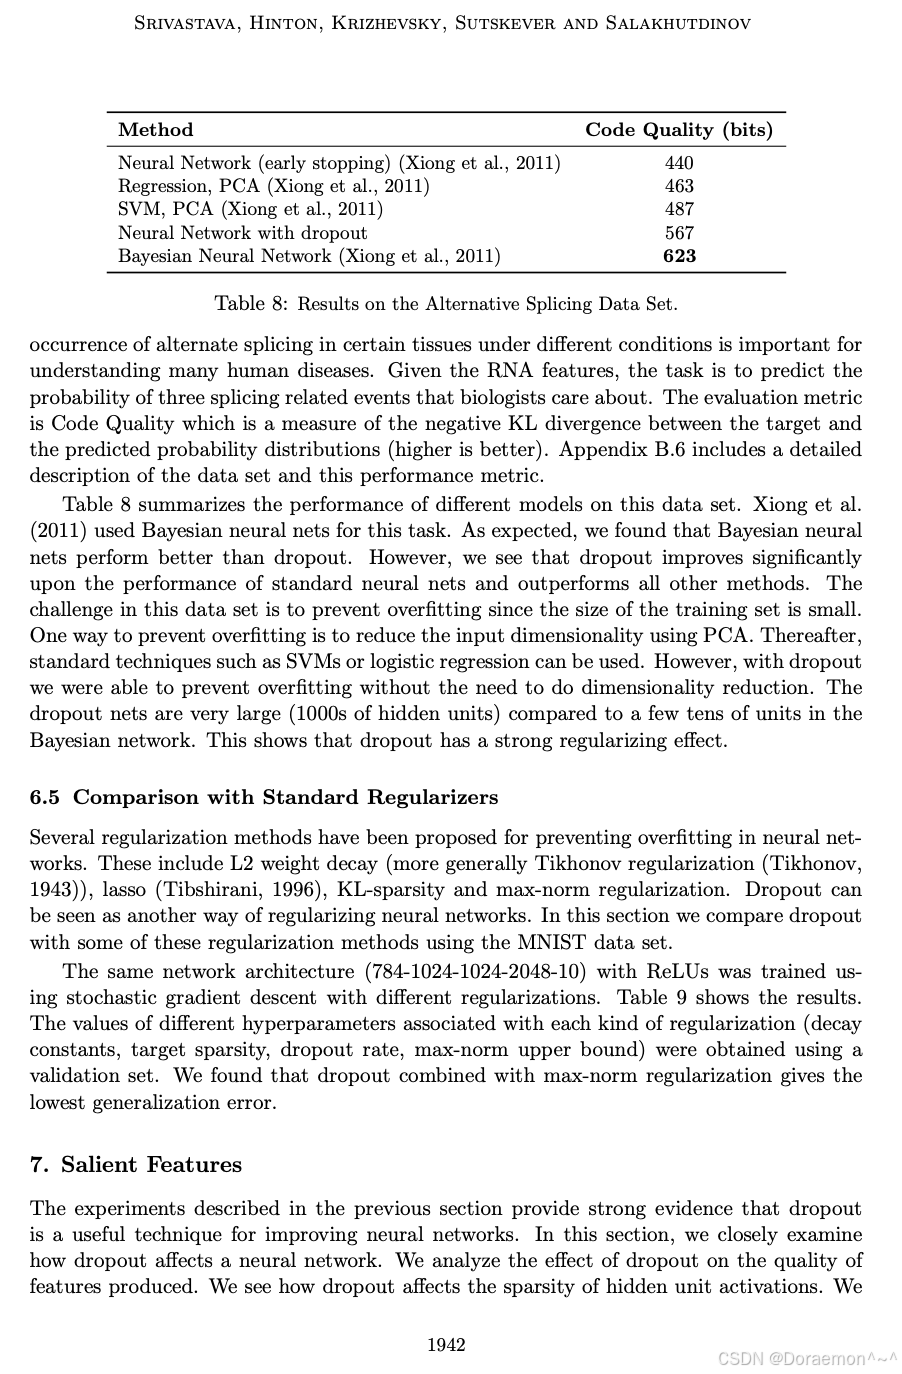
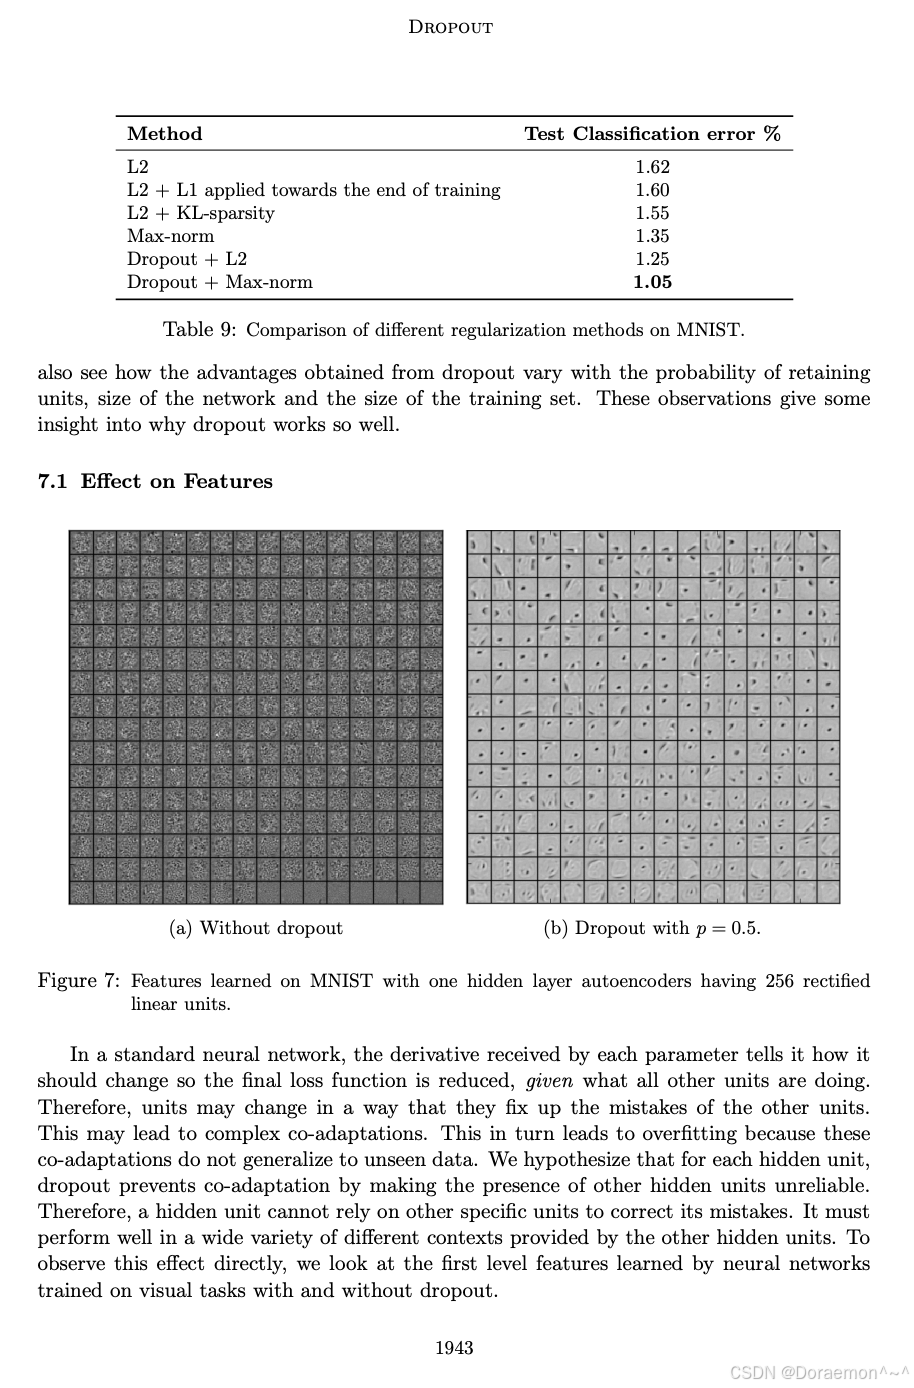
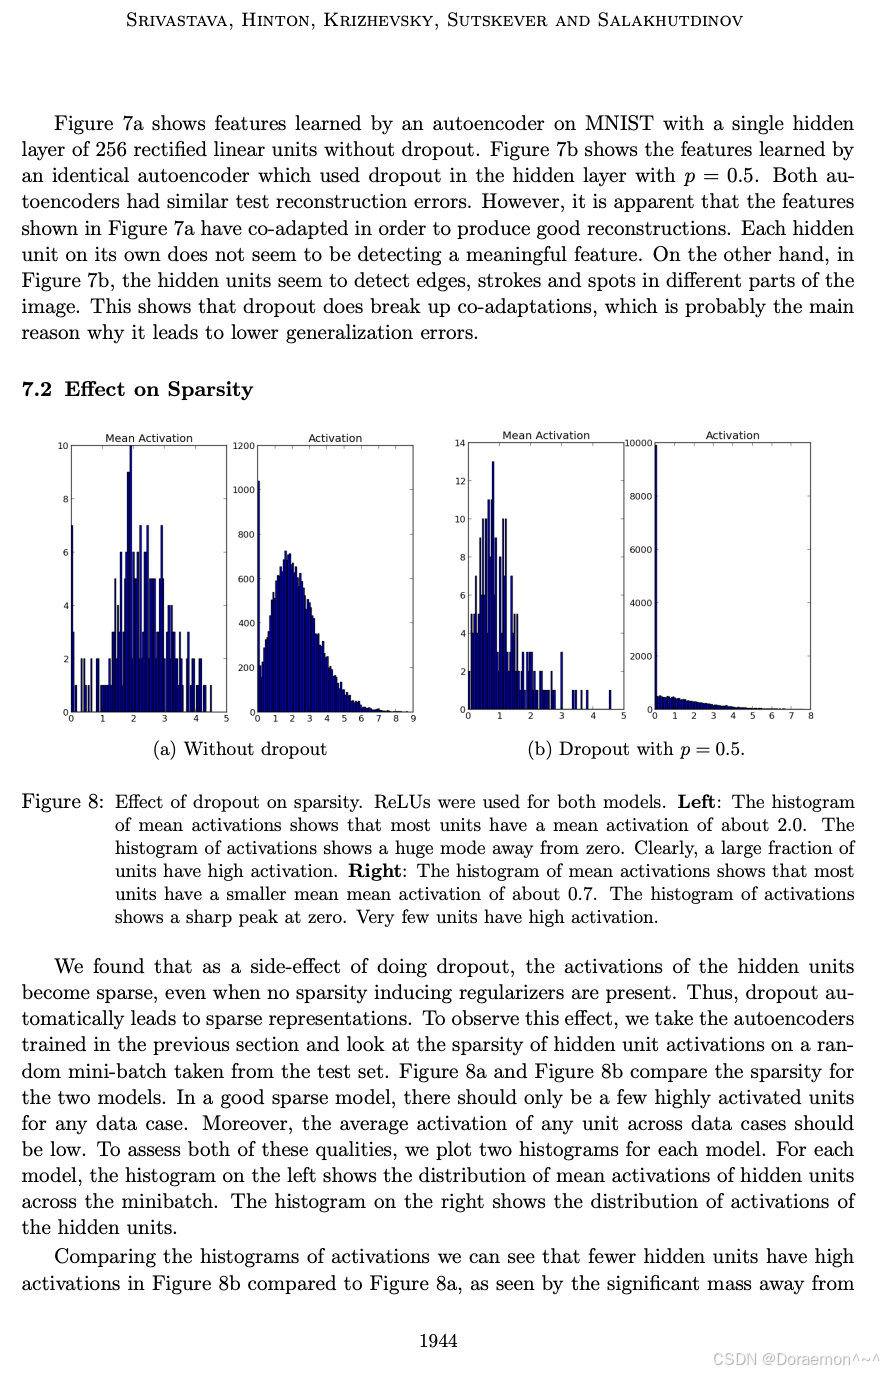
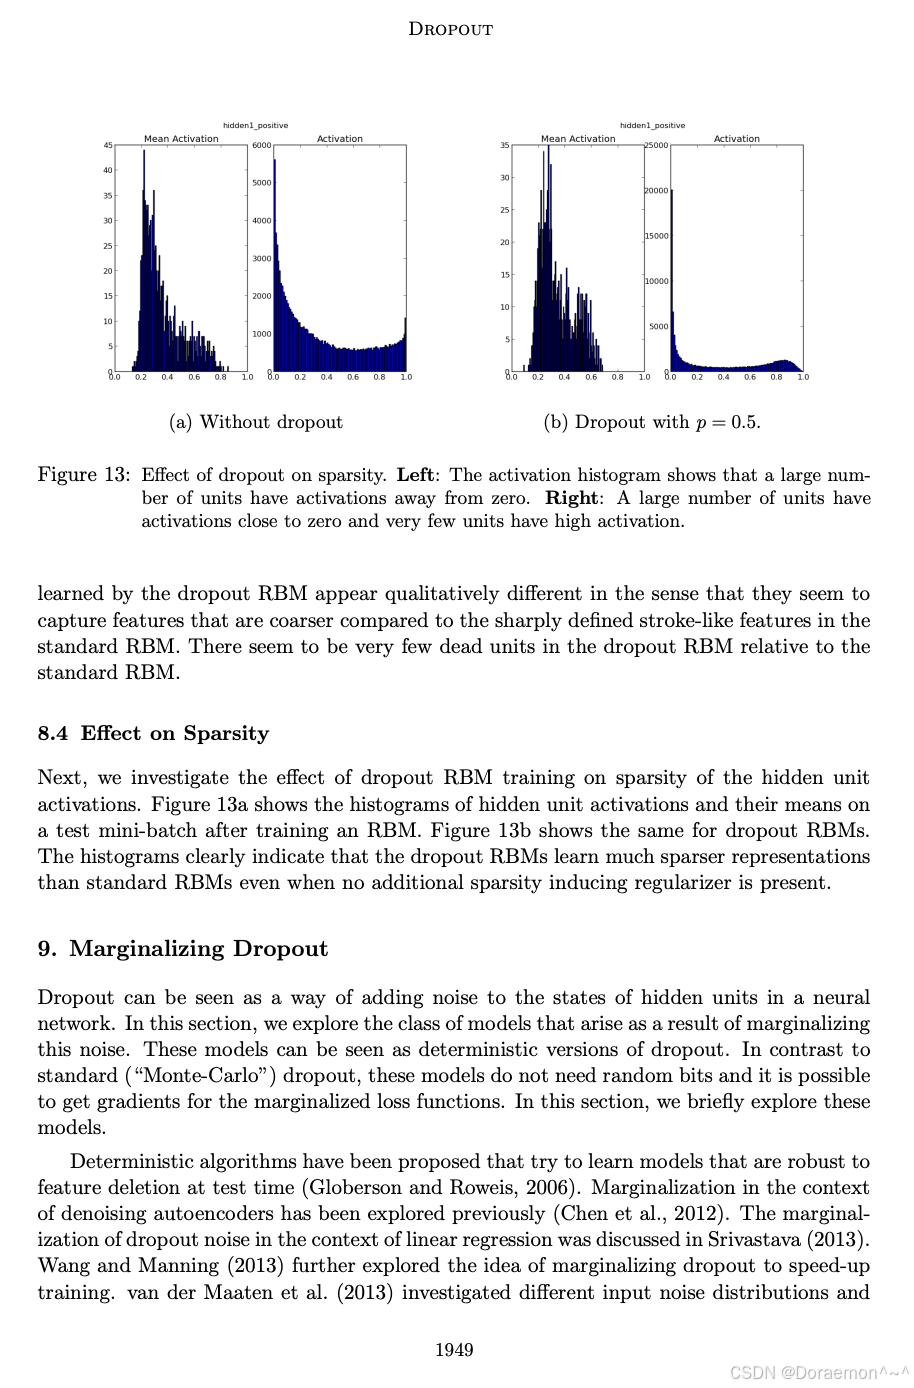
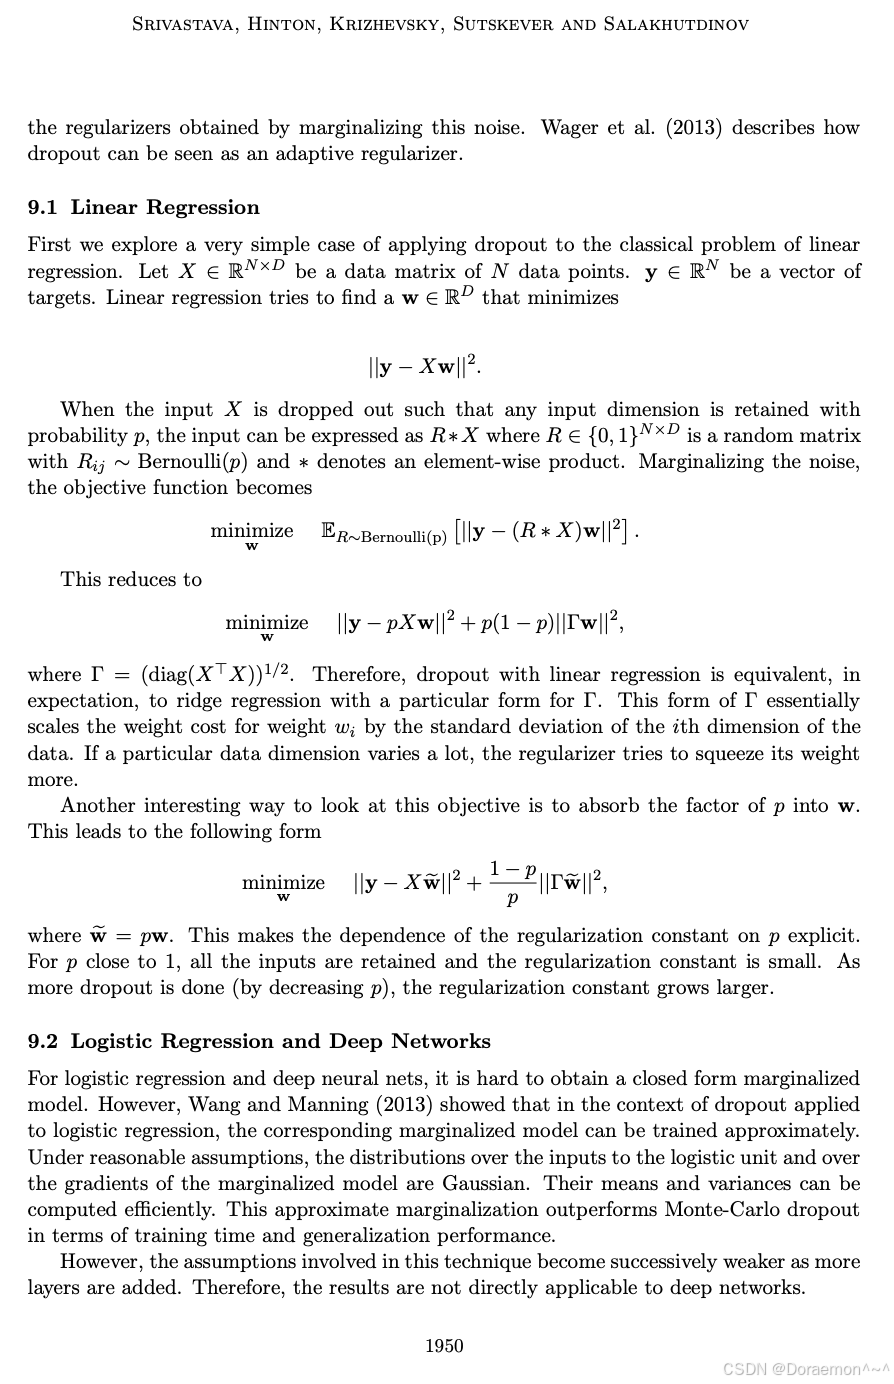
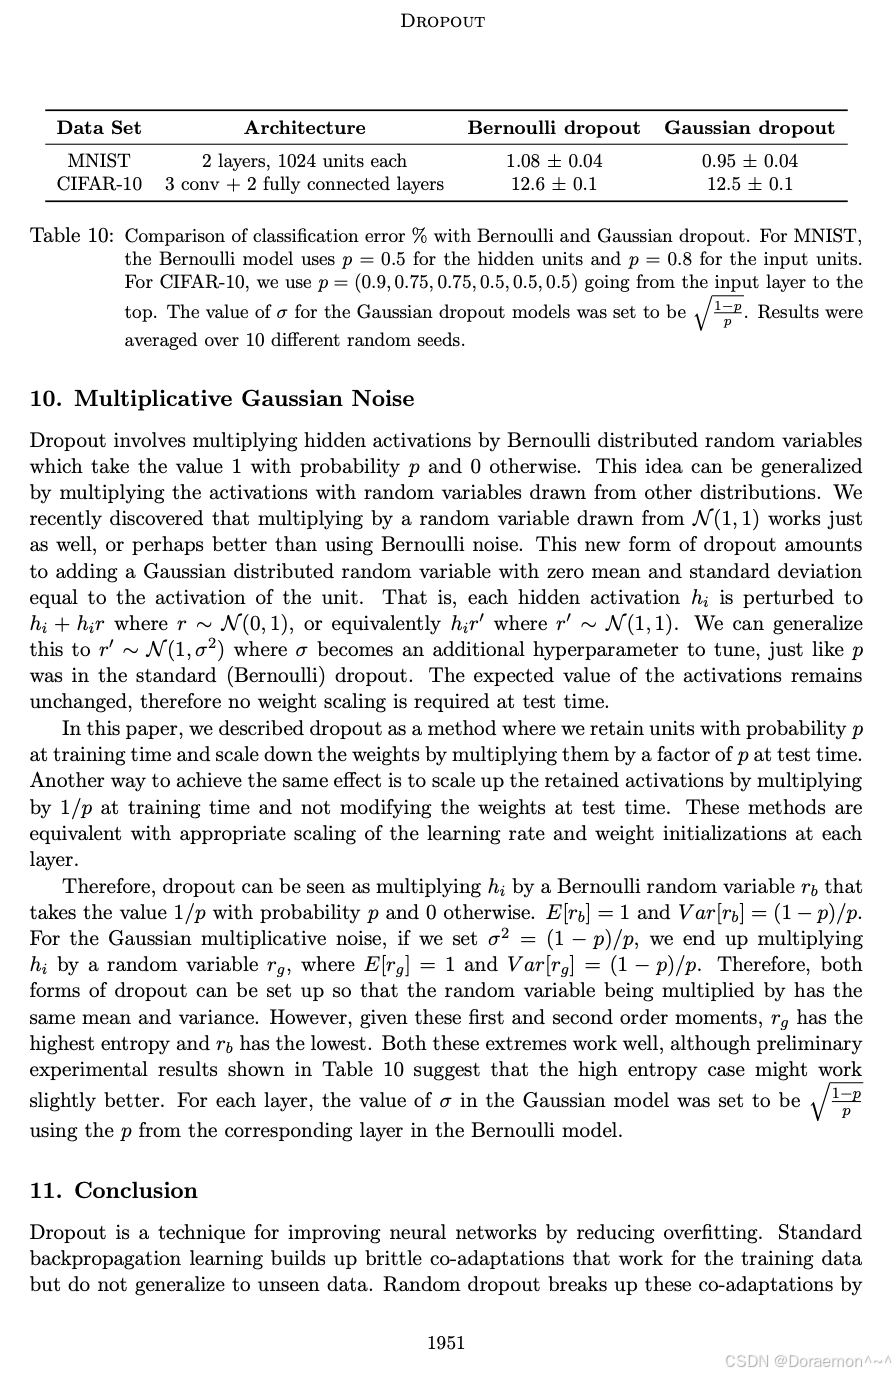
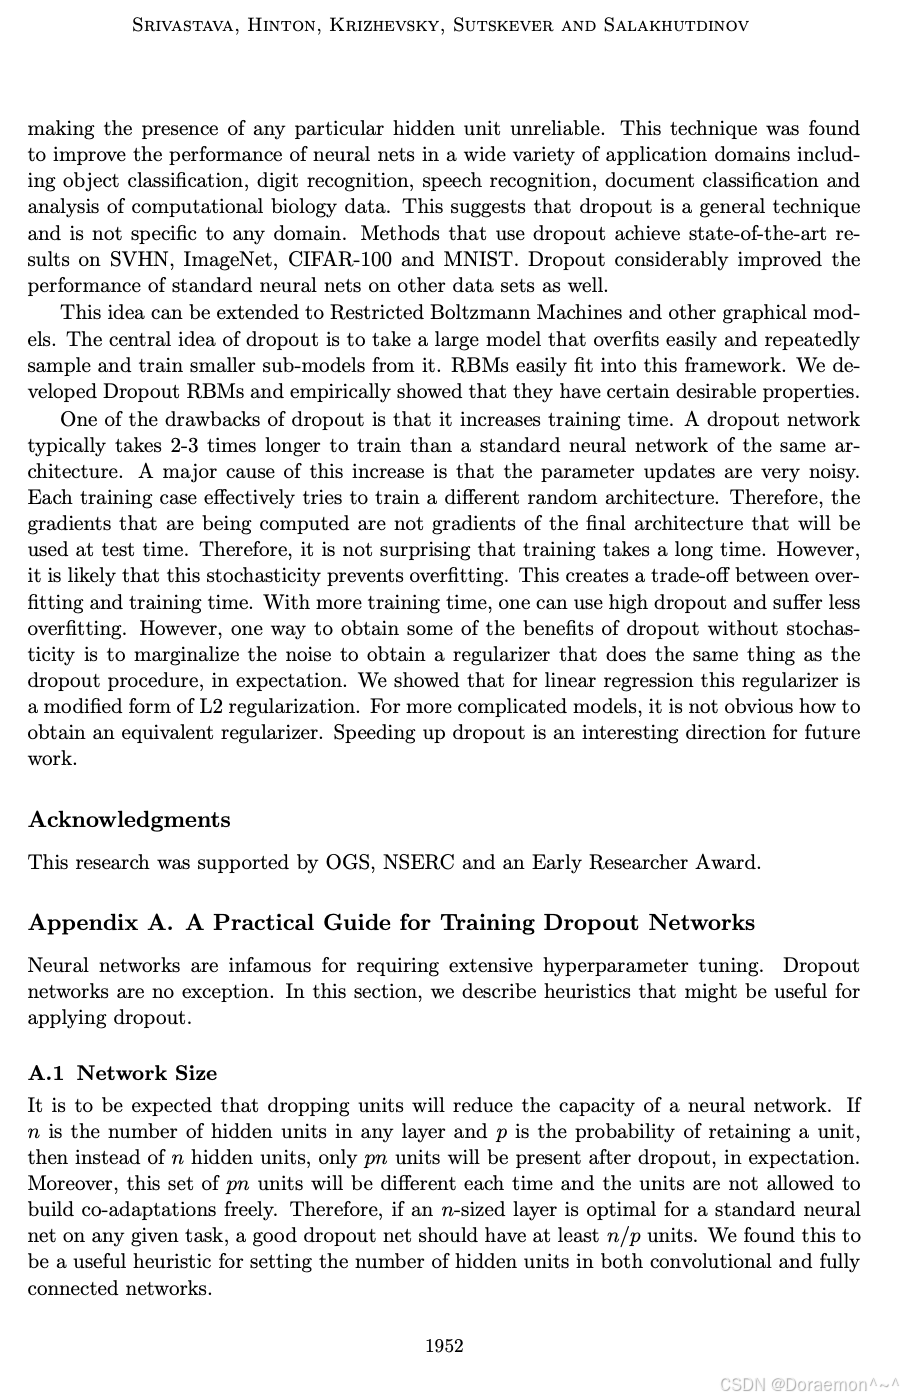
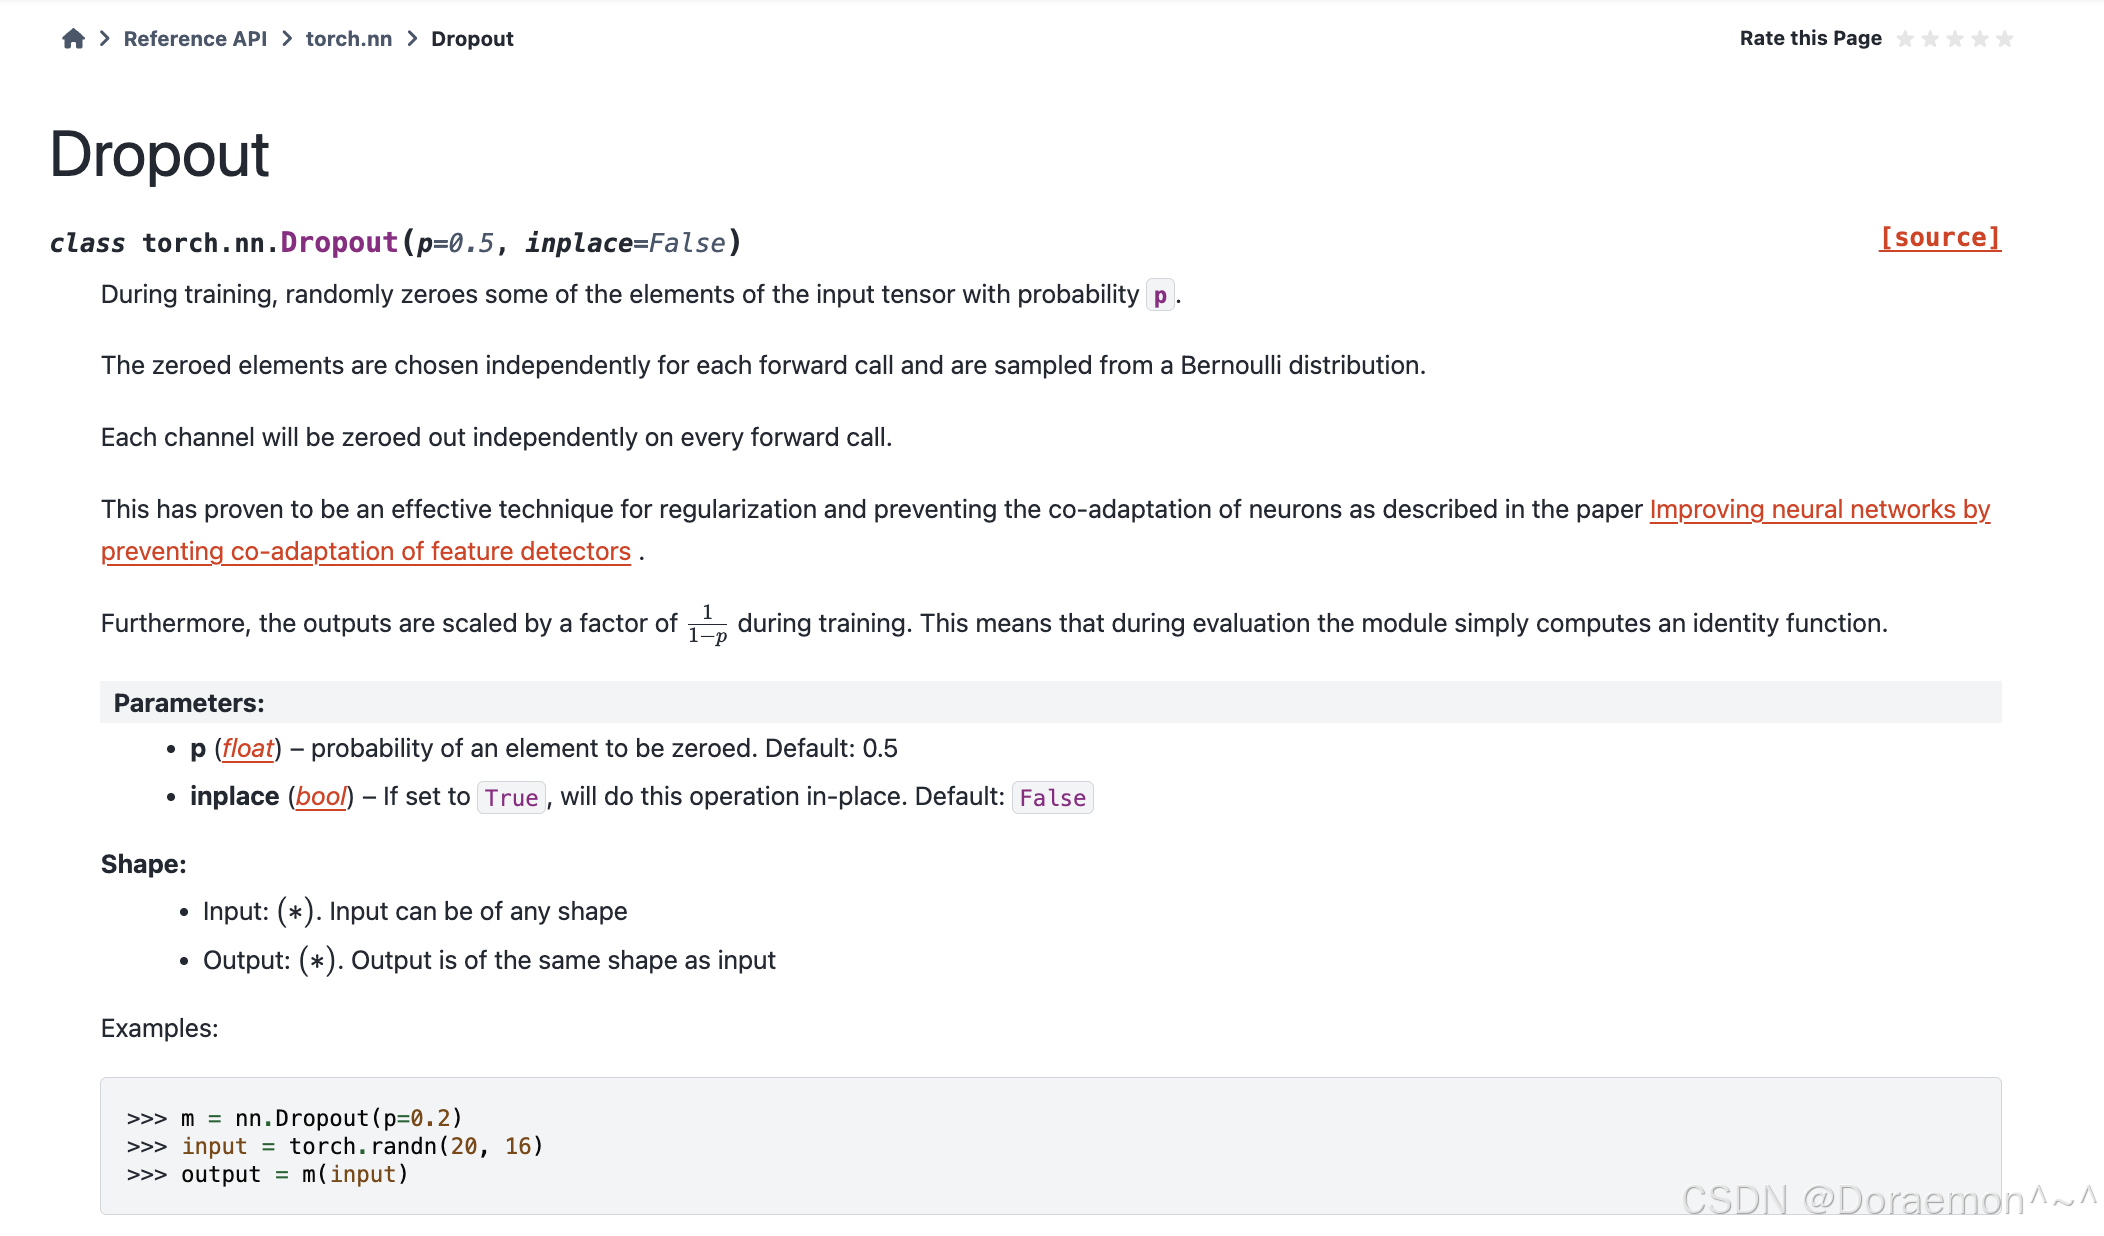
Dropout是一种在深度学习中广泛使用的技术,用于防止 神经网络 的 过拟合。它的做法是在训练过程中随机丢弃(即置为零)一部分神经元的输出,从而减少模型对特定输入特征的依赖,增强模型的泛化能力。
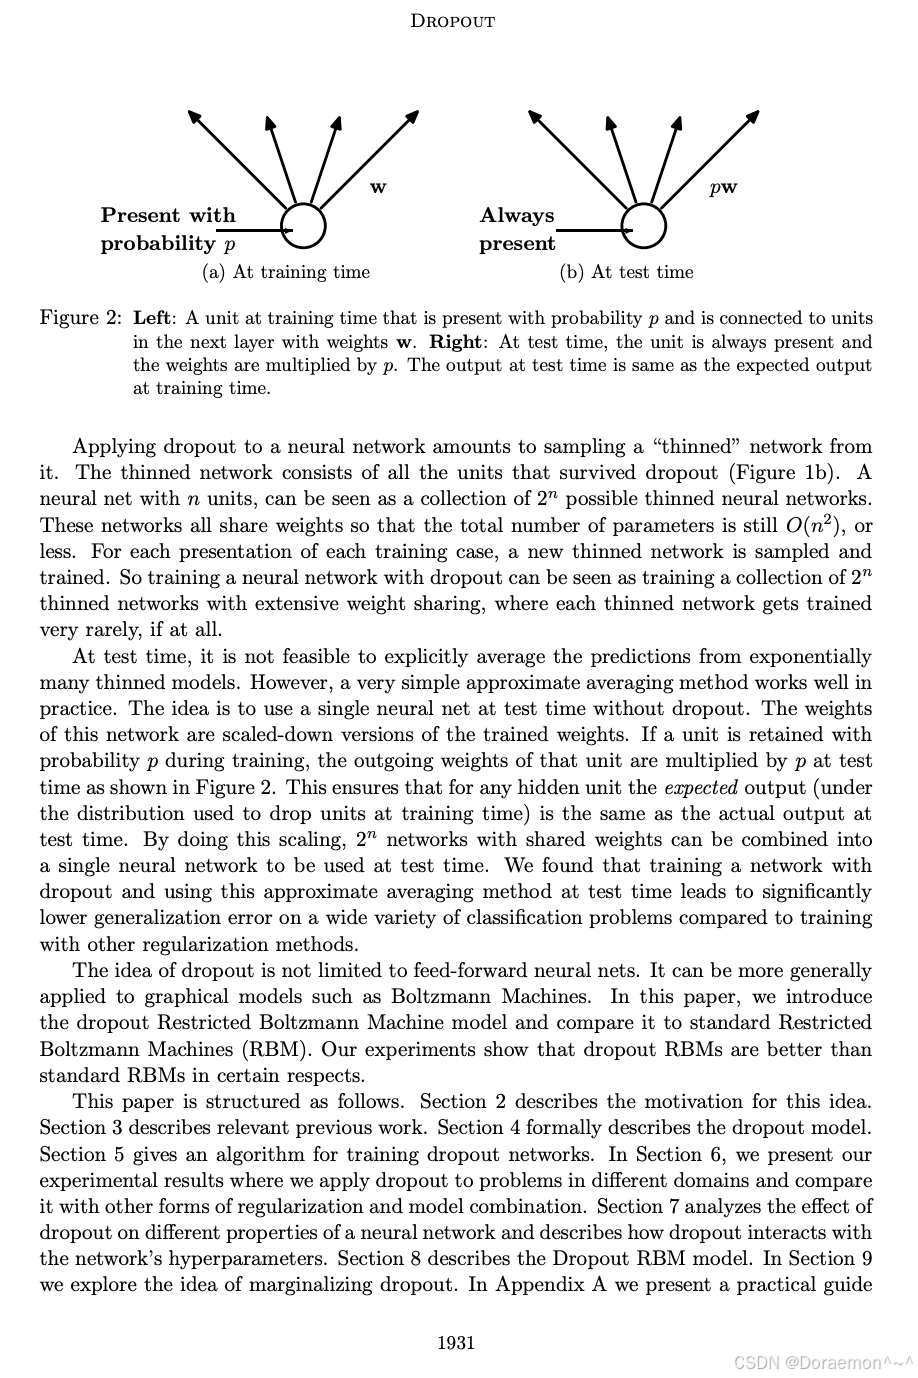
Dropout层在训练阶段和评测(推理)阶段的计算逻辑不同。在训练阶段,Dropout层会基于一定的概率(dropout_rate)随机地将一部分神经元的输出设置为0,那么这些被置为0(即丢弃)的神经元不再会有梯度传播下去。而被保留的特征会除以 (1-dropout\_rate),使得dropout的输出和之前大致在同一个数量水平上。在随机丢弃了一部分特征之后,神经网络只能依靠余下的特征进行预测,这可以看作是一种集成学习的策略。
在推理阶段,Dropout层直接透传输入(等价于没有dropout)。
Transformer中应用Dropout的模块有:
-
每个子层的输出 (在与子层输入相加之前)
-
Embedding层的输出 (在Word Embedding与Position Embeeding相加之后)
-
Attention Dropout: 在每个query的attention score中随机drop,相当于对应位置的value不会被加到最后的输出中了。
PyTorch中的Dropout层:Dropout --- PyTorch 2.14 documentation
5.GELU激活函数
论文:https://arxiv.org/pdf/1606.08415
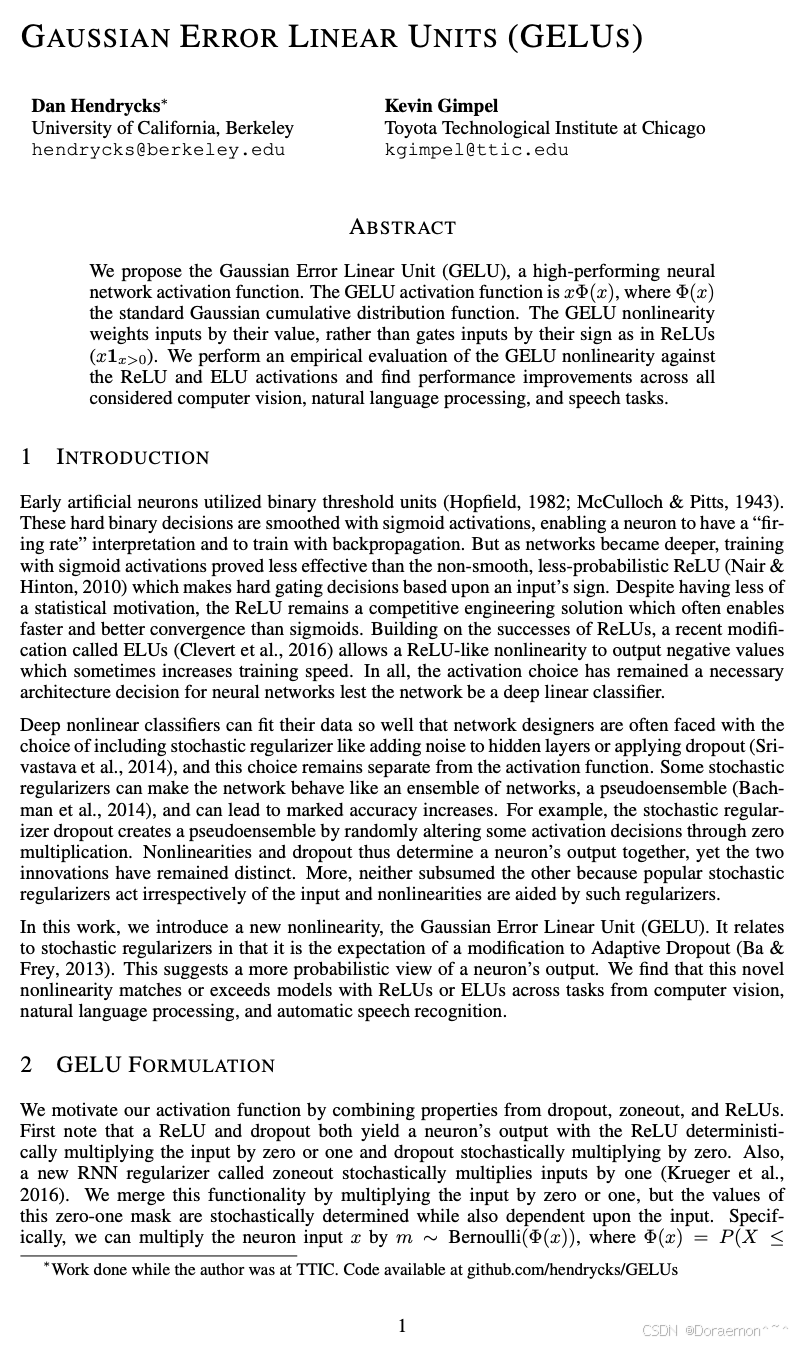
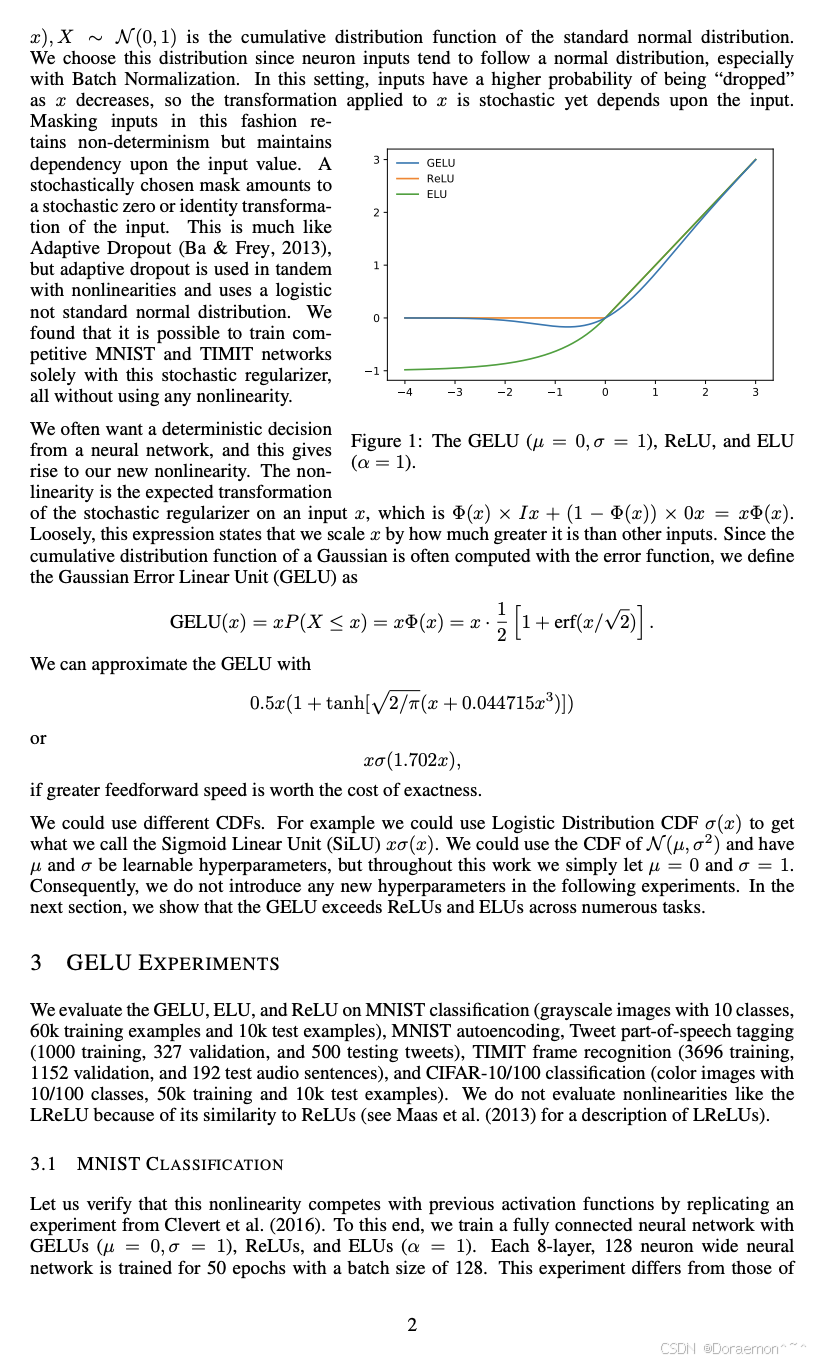
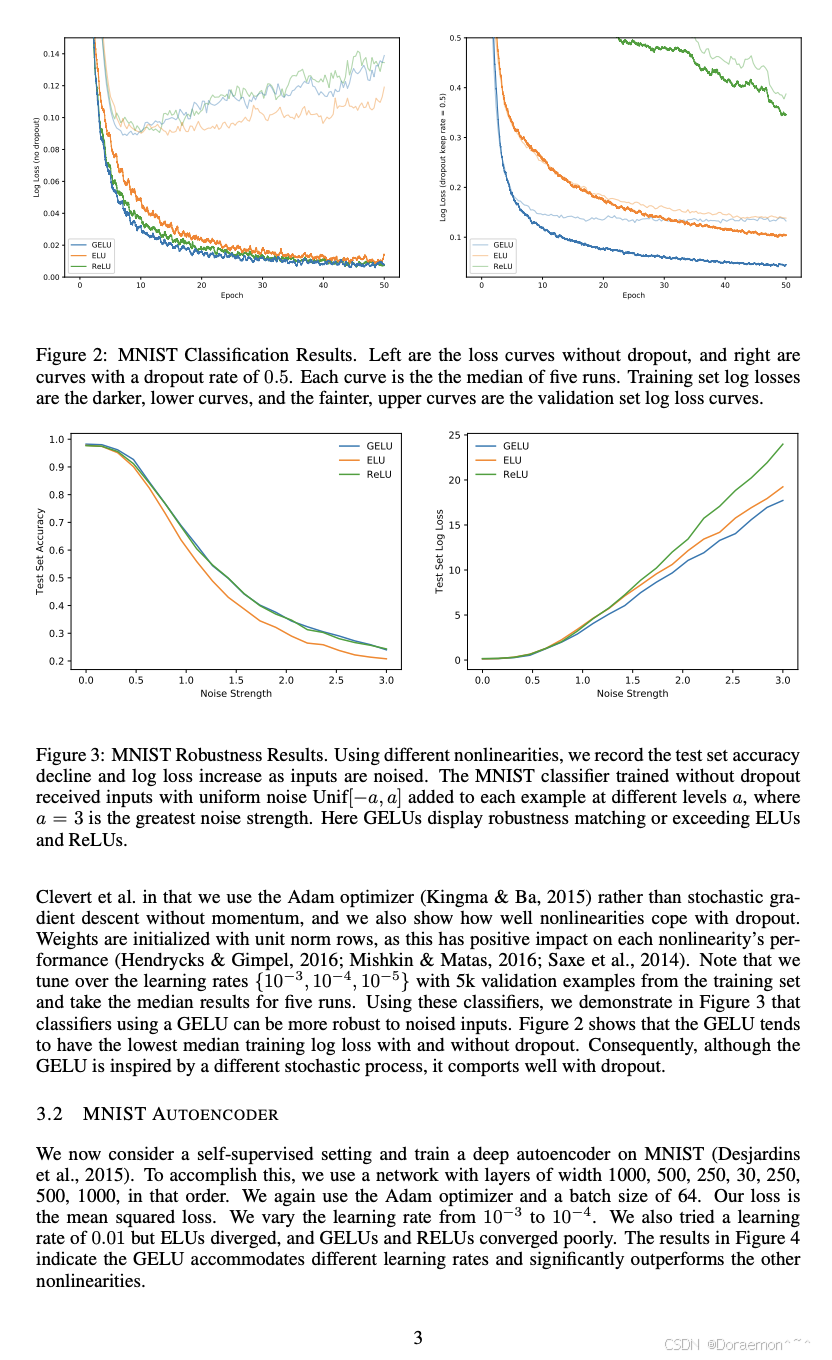
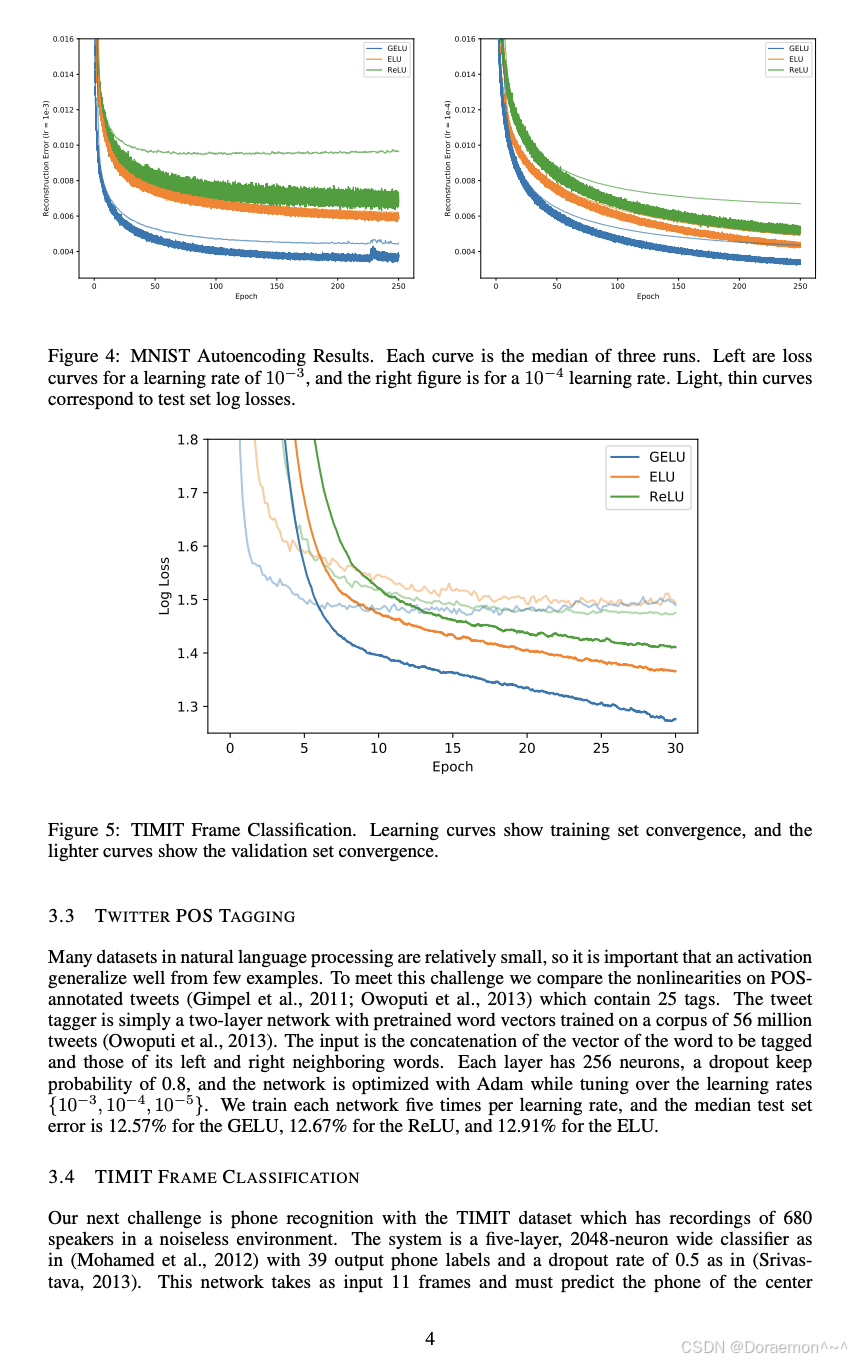
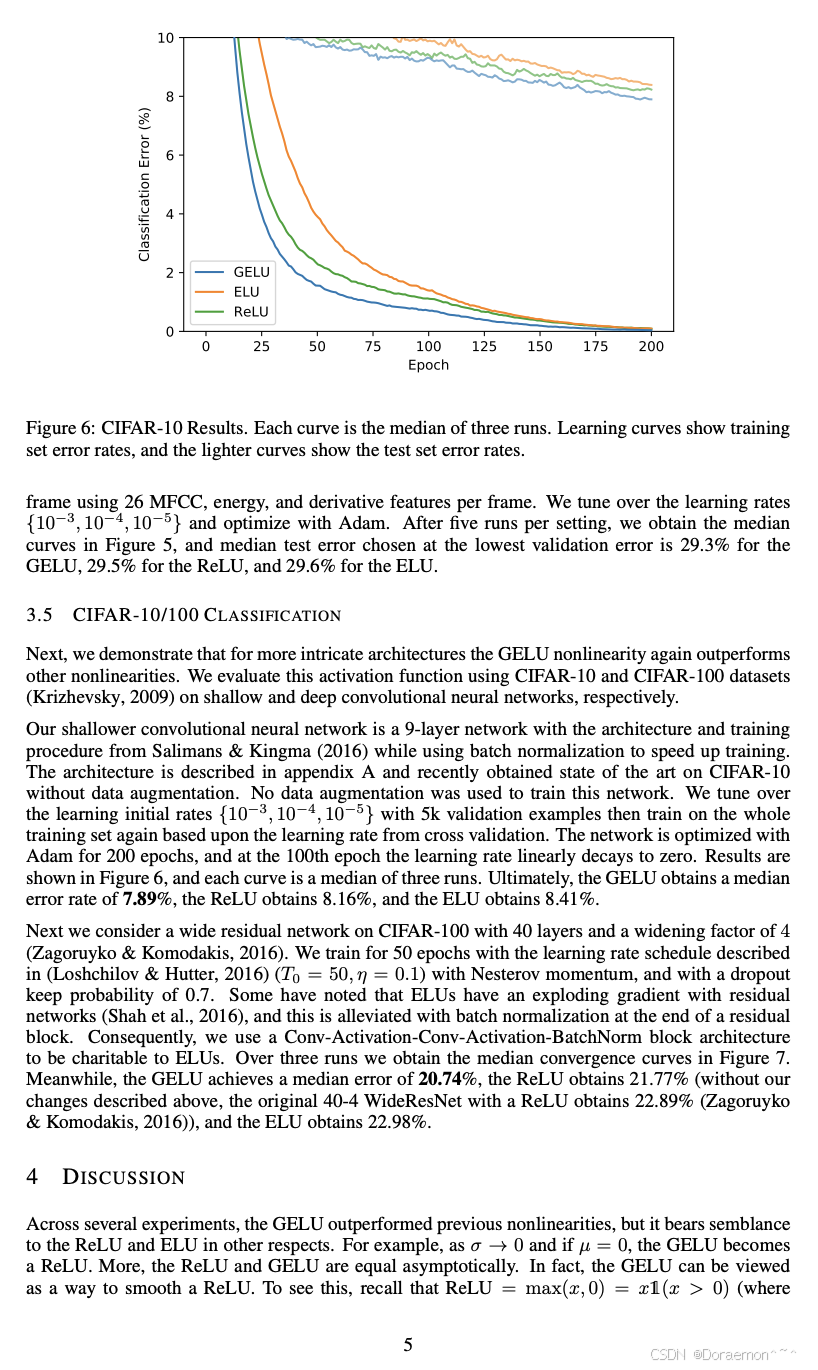
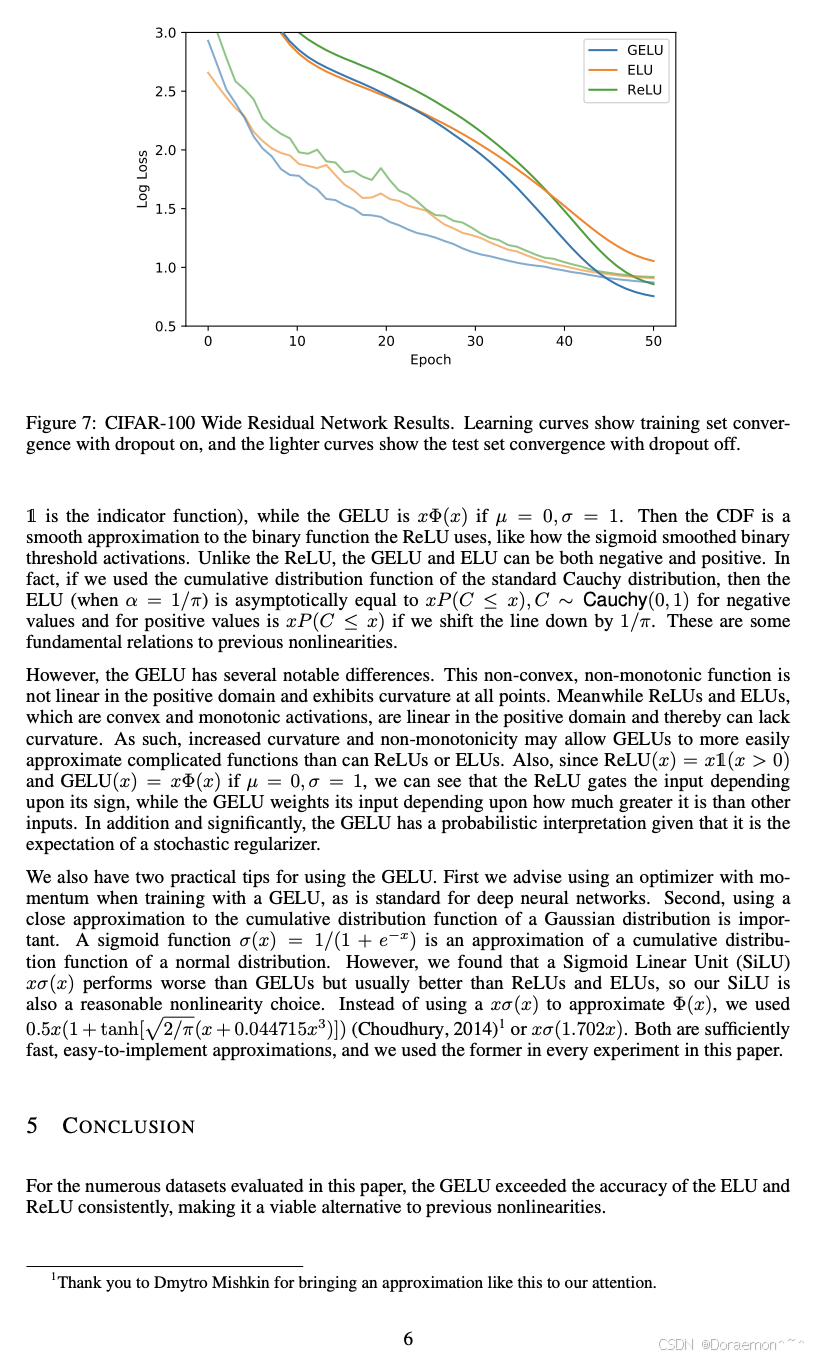
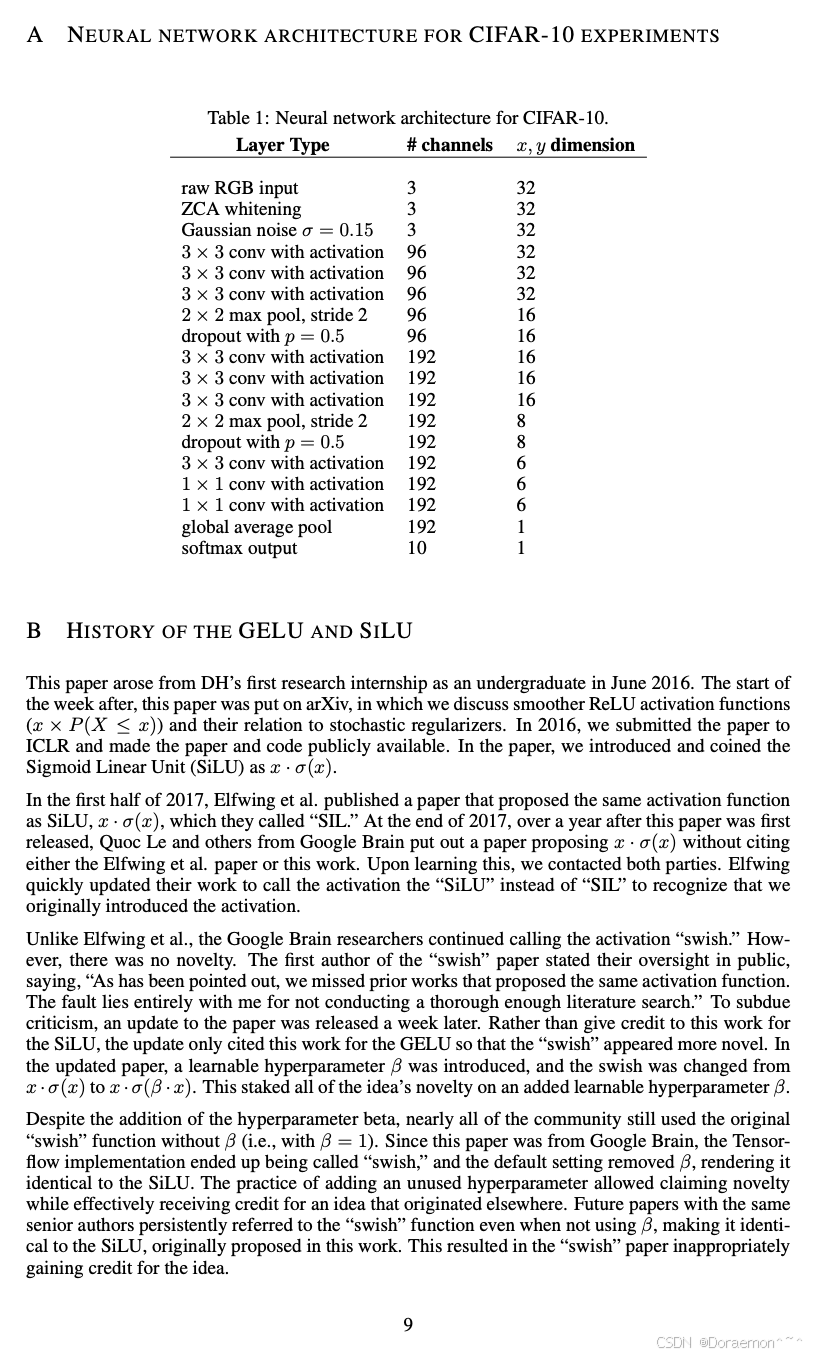
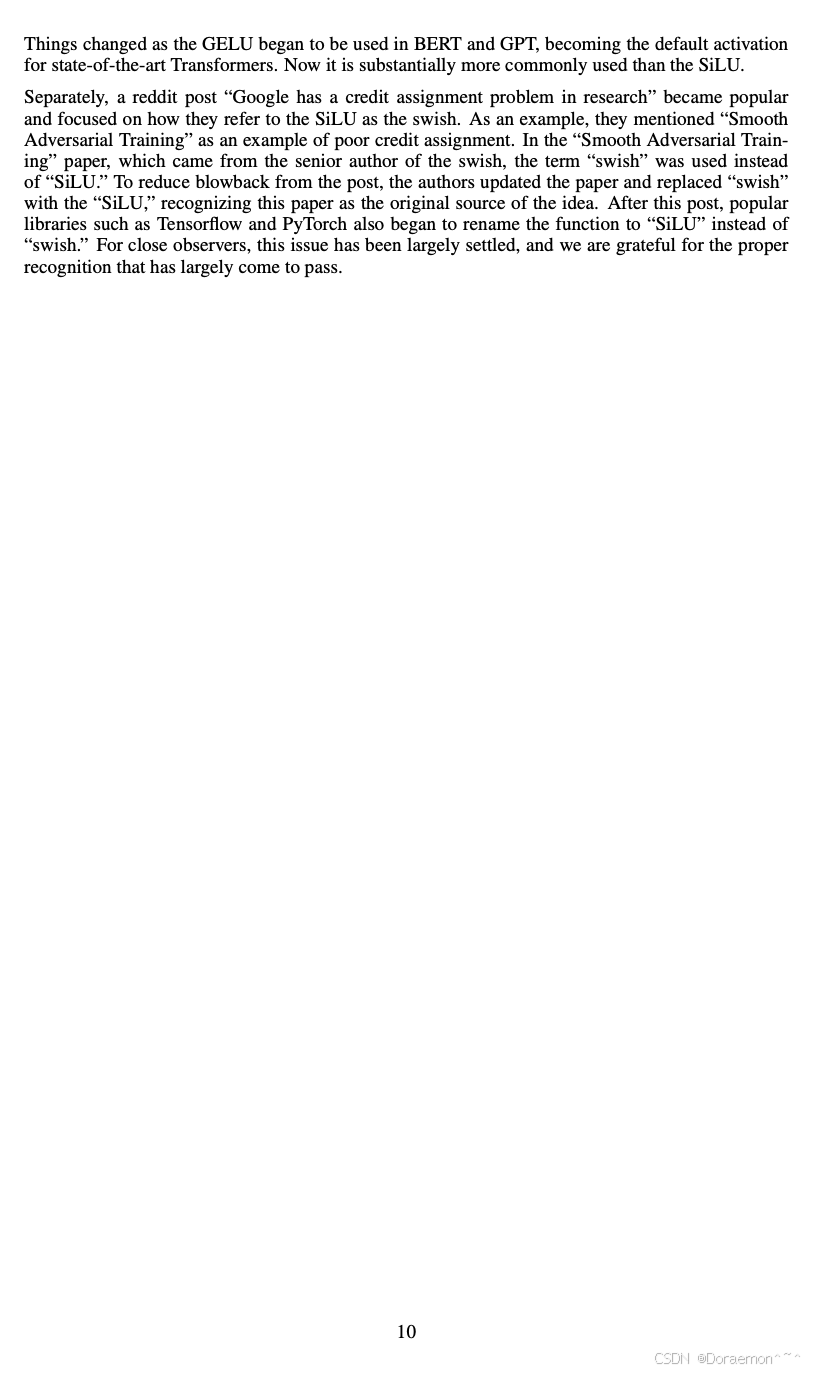
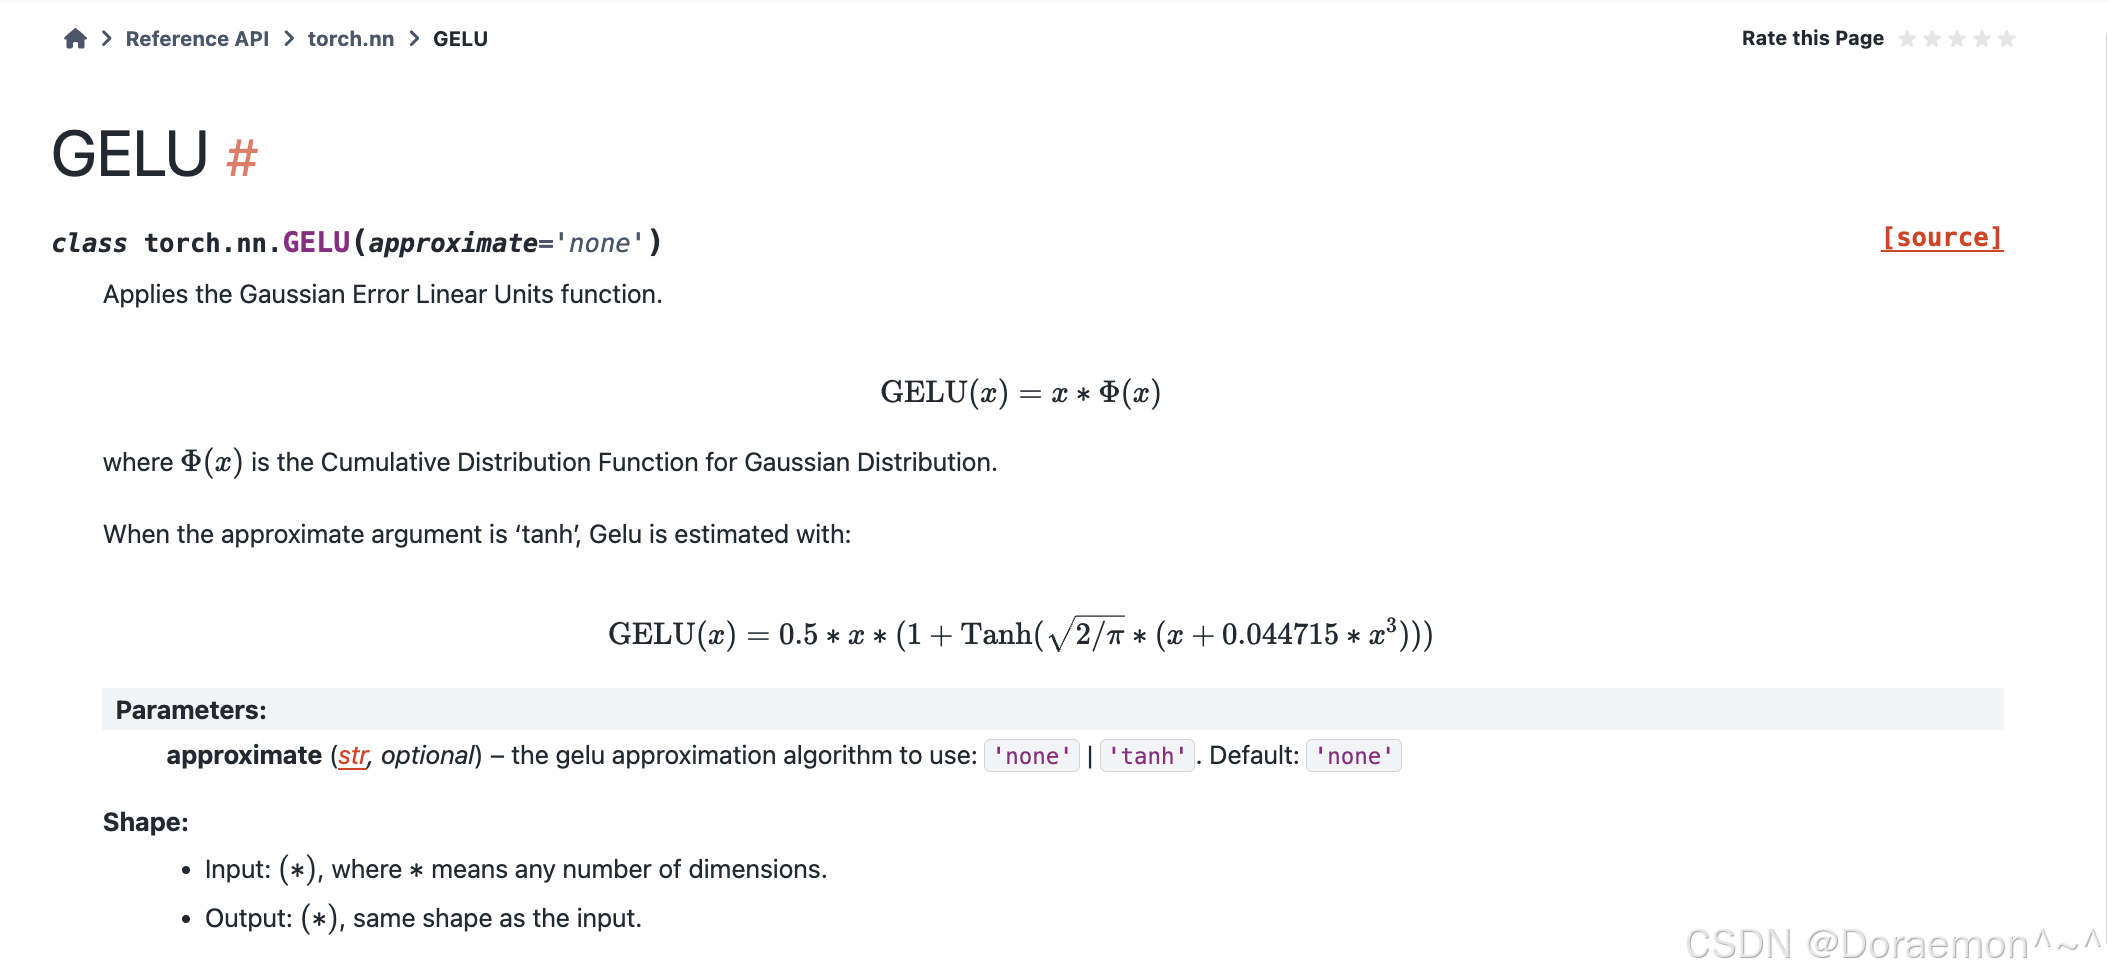
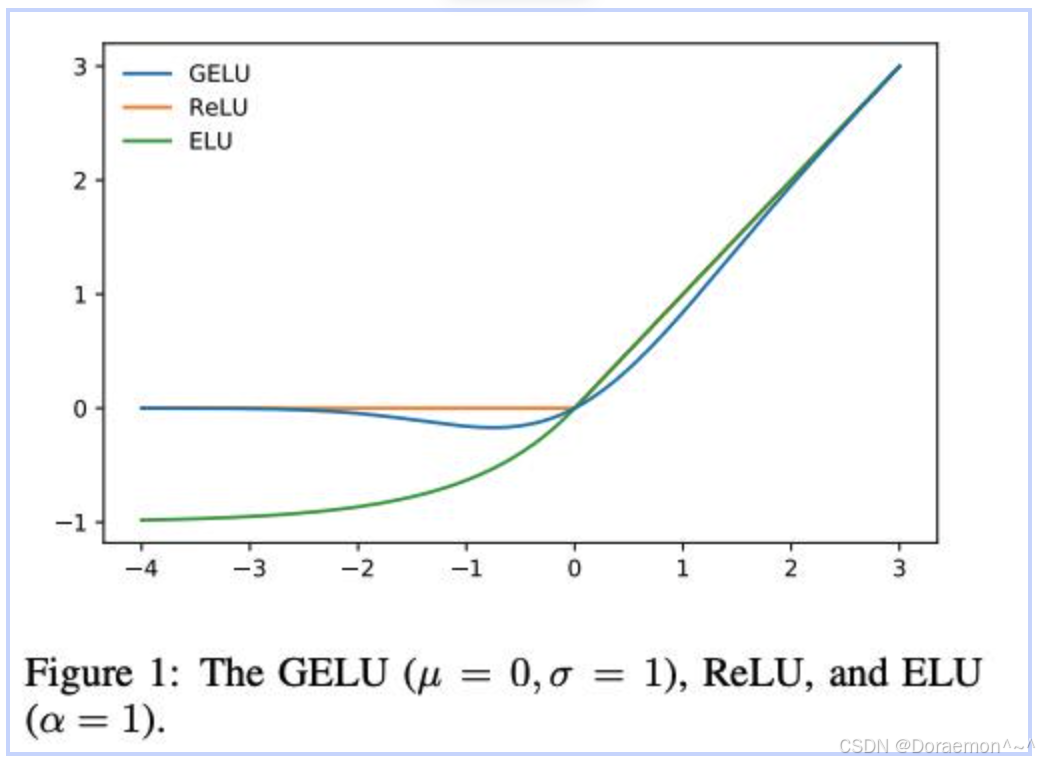
一些Transformer模型 (如BERT,LLM) 中采用了引入非线性门控机制的激活函数,用来代替FFN子层中的ReLU。这里我们先介绍在BERT模型中采用的GELU激活函数,其公式为:
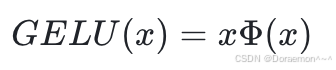
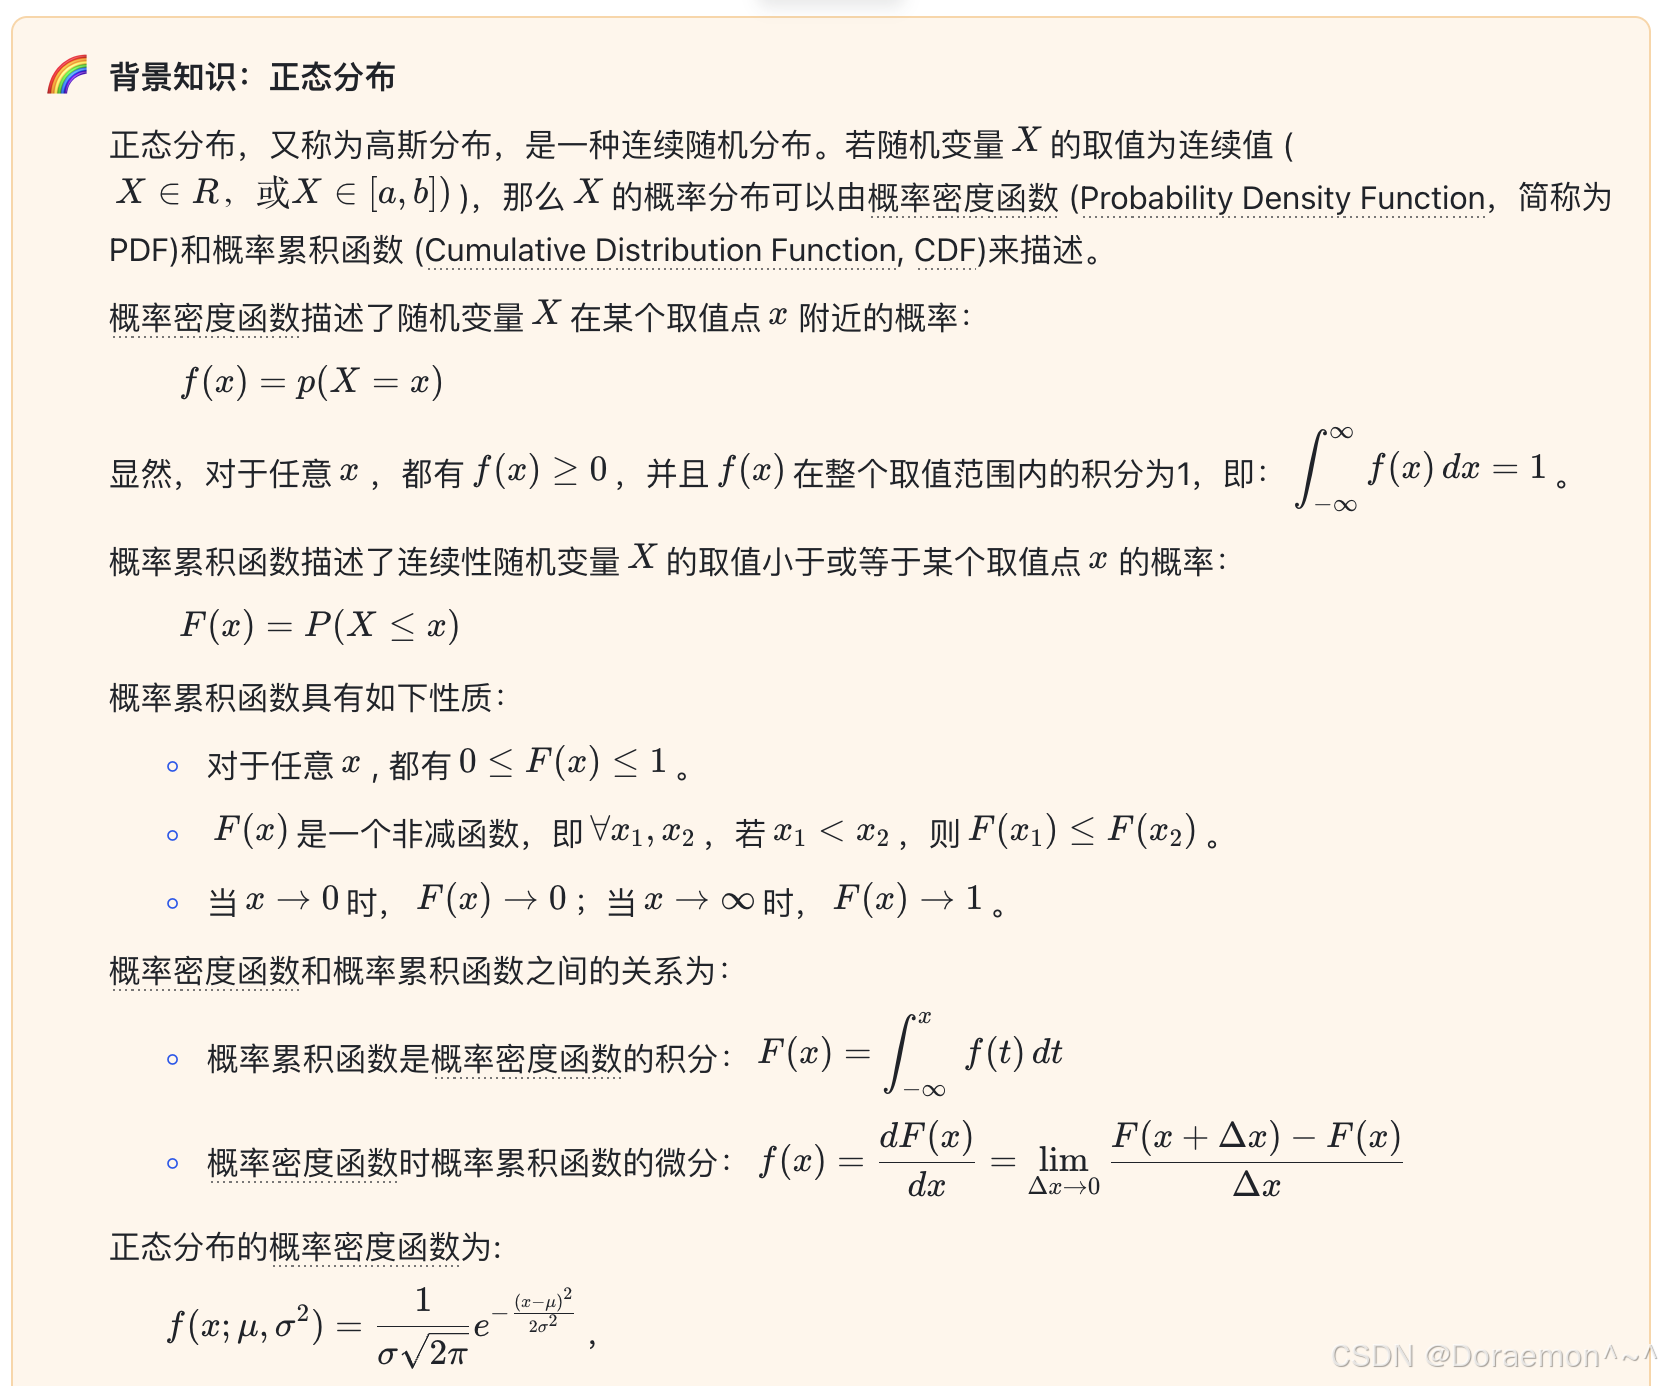
其中 为标准正态分布的概率累积函数,即:
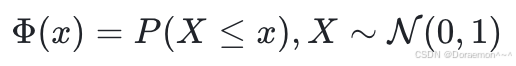
在Transformer中,输入数据通常经过了归一化,因此分布接近于标准正态分布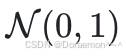 。在GELU的公式中,x值越大,其被透出的程度就越高,透出系数为输入数据 (表达为随机变量X)取值不大于x的概率 (概率累积函数的定义)。
显然, 可以理解为一个取值在0~1之间的非线性门控函数,可以带来以下优势:
-
提高模型的非线性表达能力。
-
通过门控机制过滤不重要的信息,提升模型效果。
-
梯度是连续的,而不是像ReLU那样存在梯度跳变点。
标准正态分布的概率密度函数 (PDF) 和概率累积函数 (CDF) 的图像如下所示:
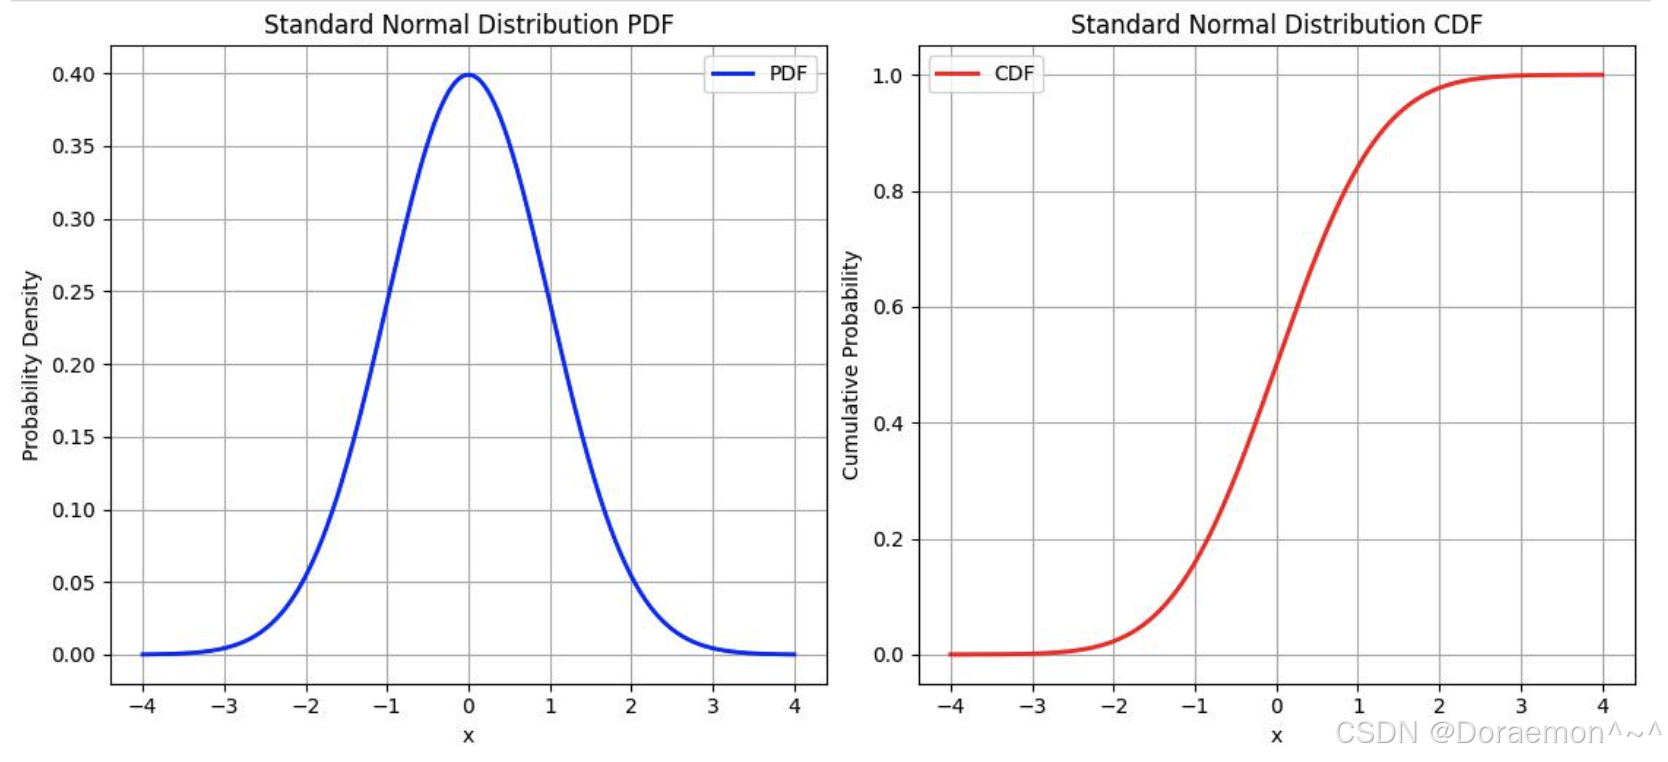
标准正态分布的CDF公式计算复杂,实际应用时可以采用以下近似公式:
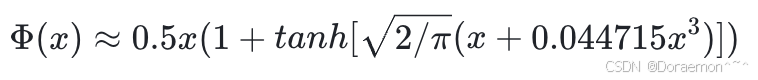
或者:
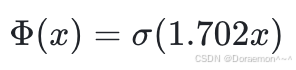
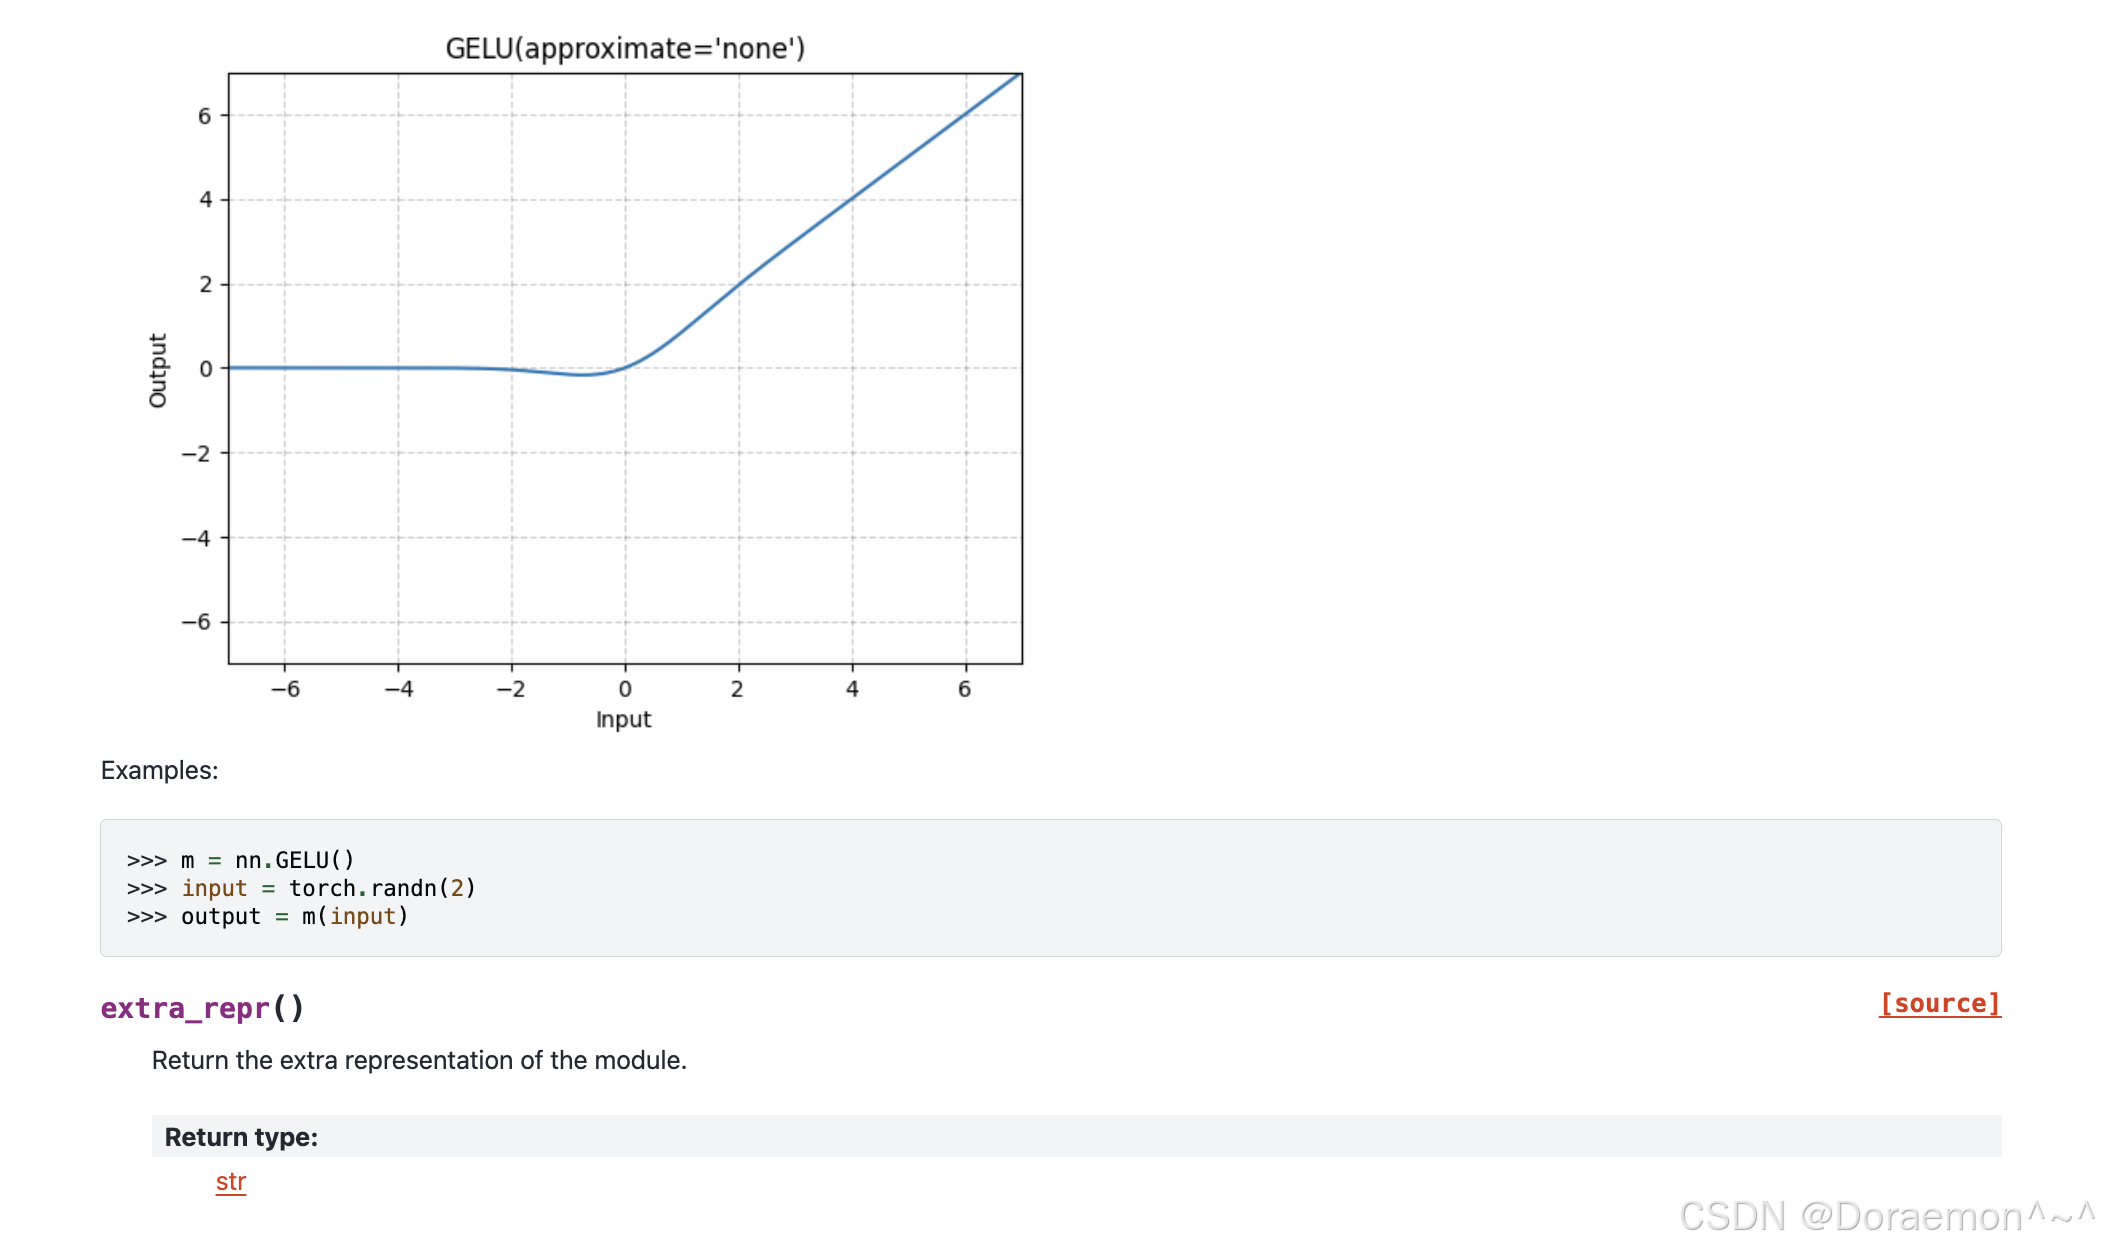
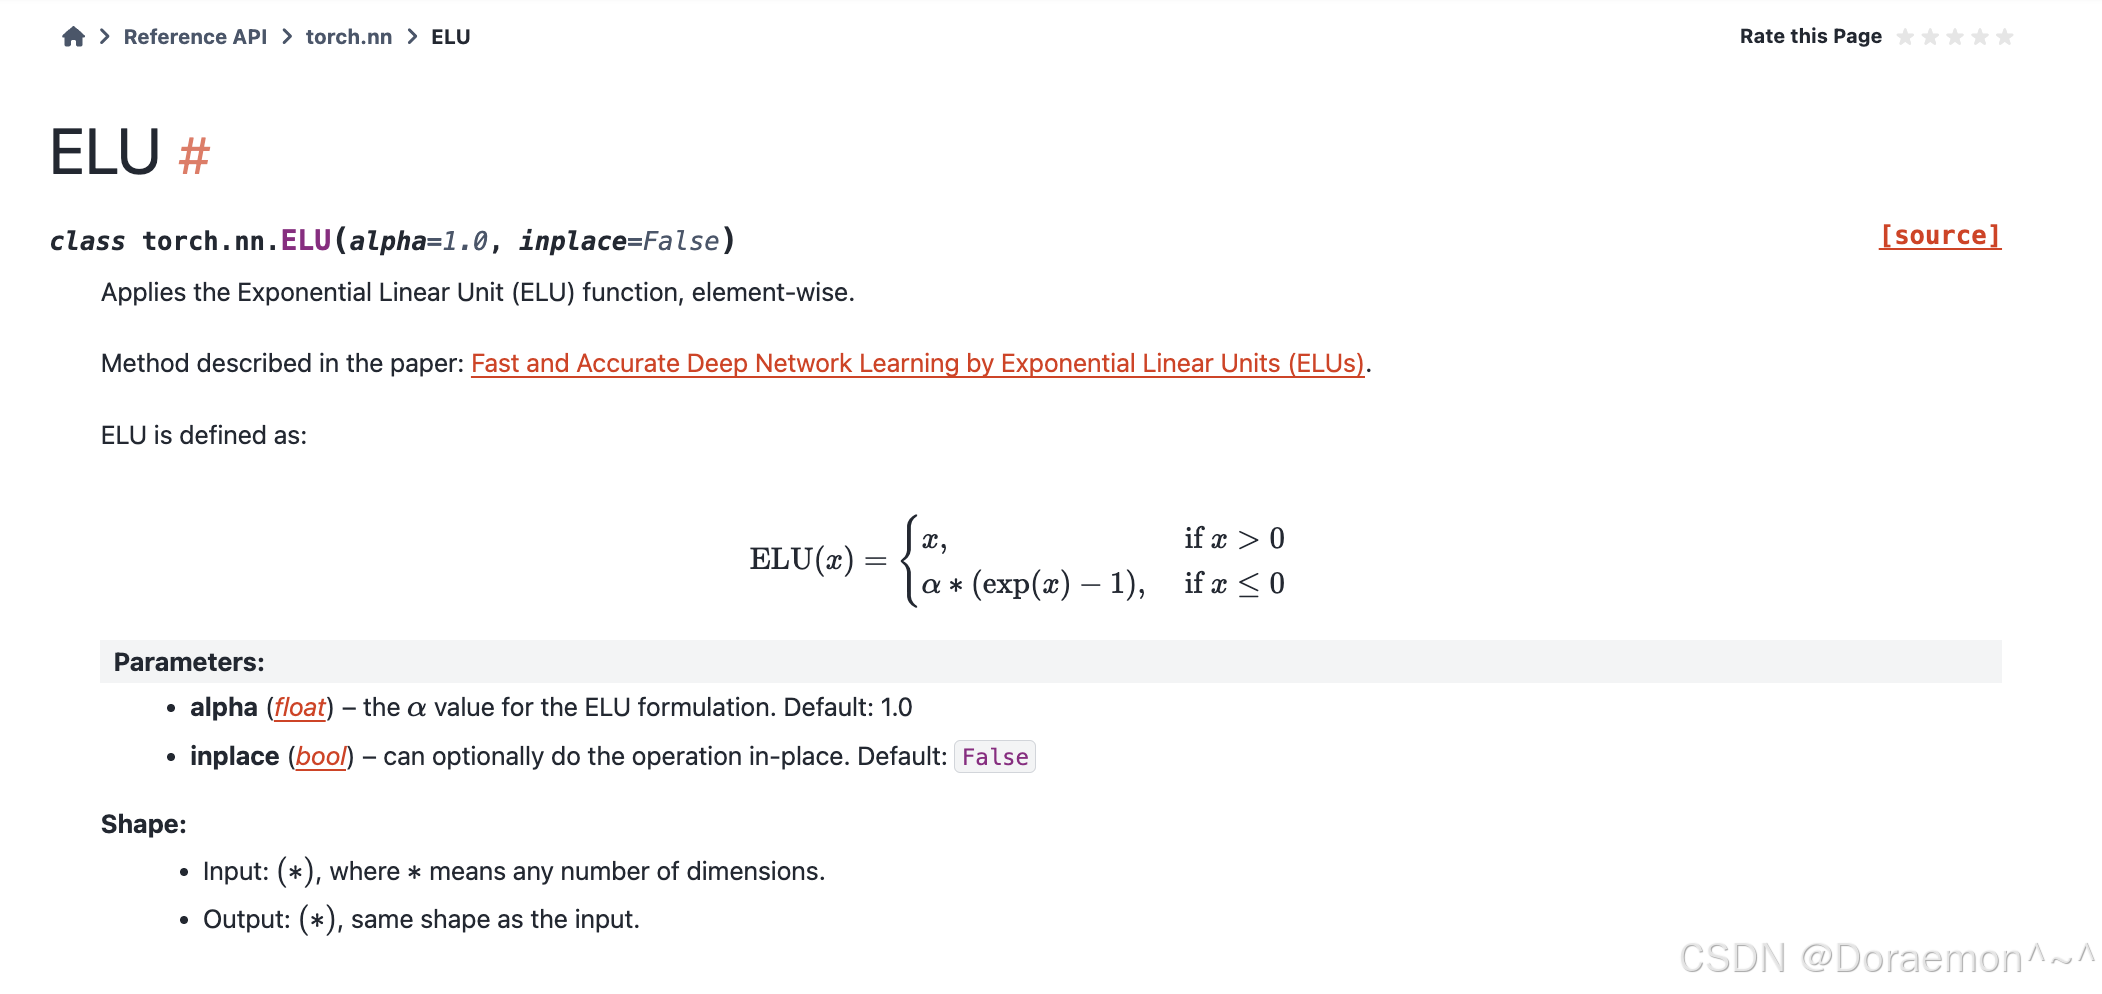
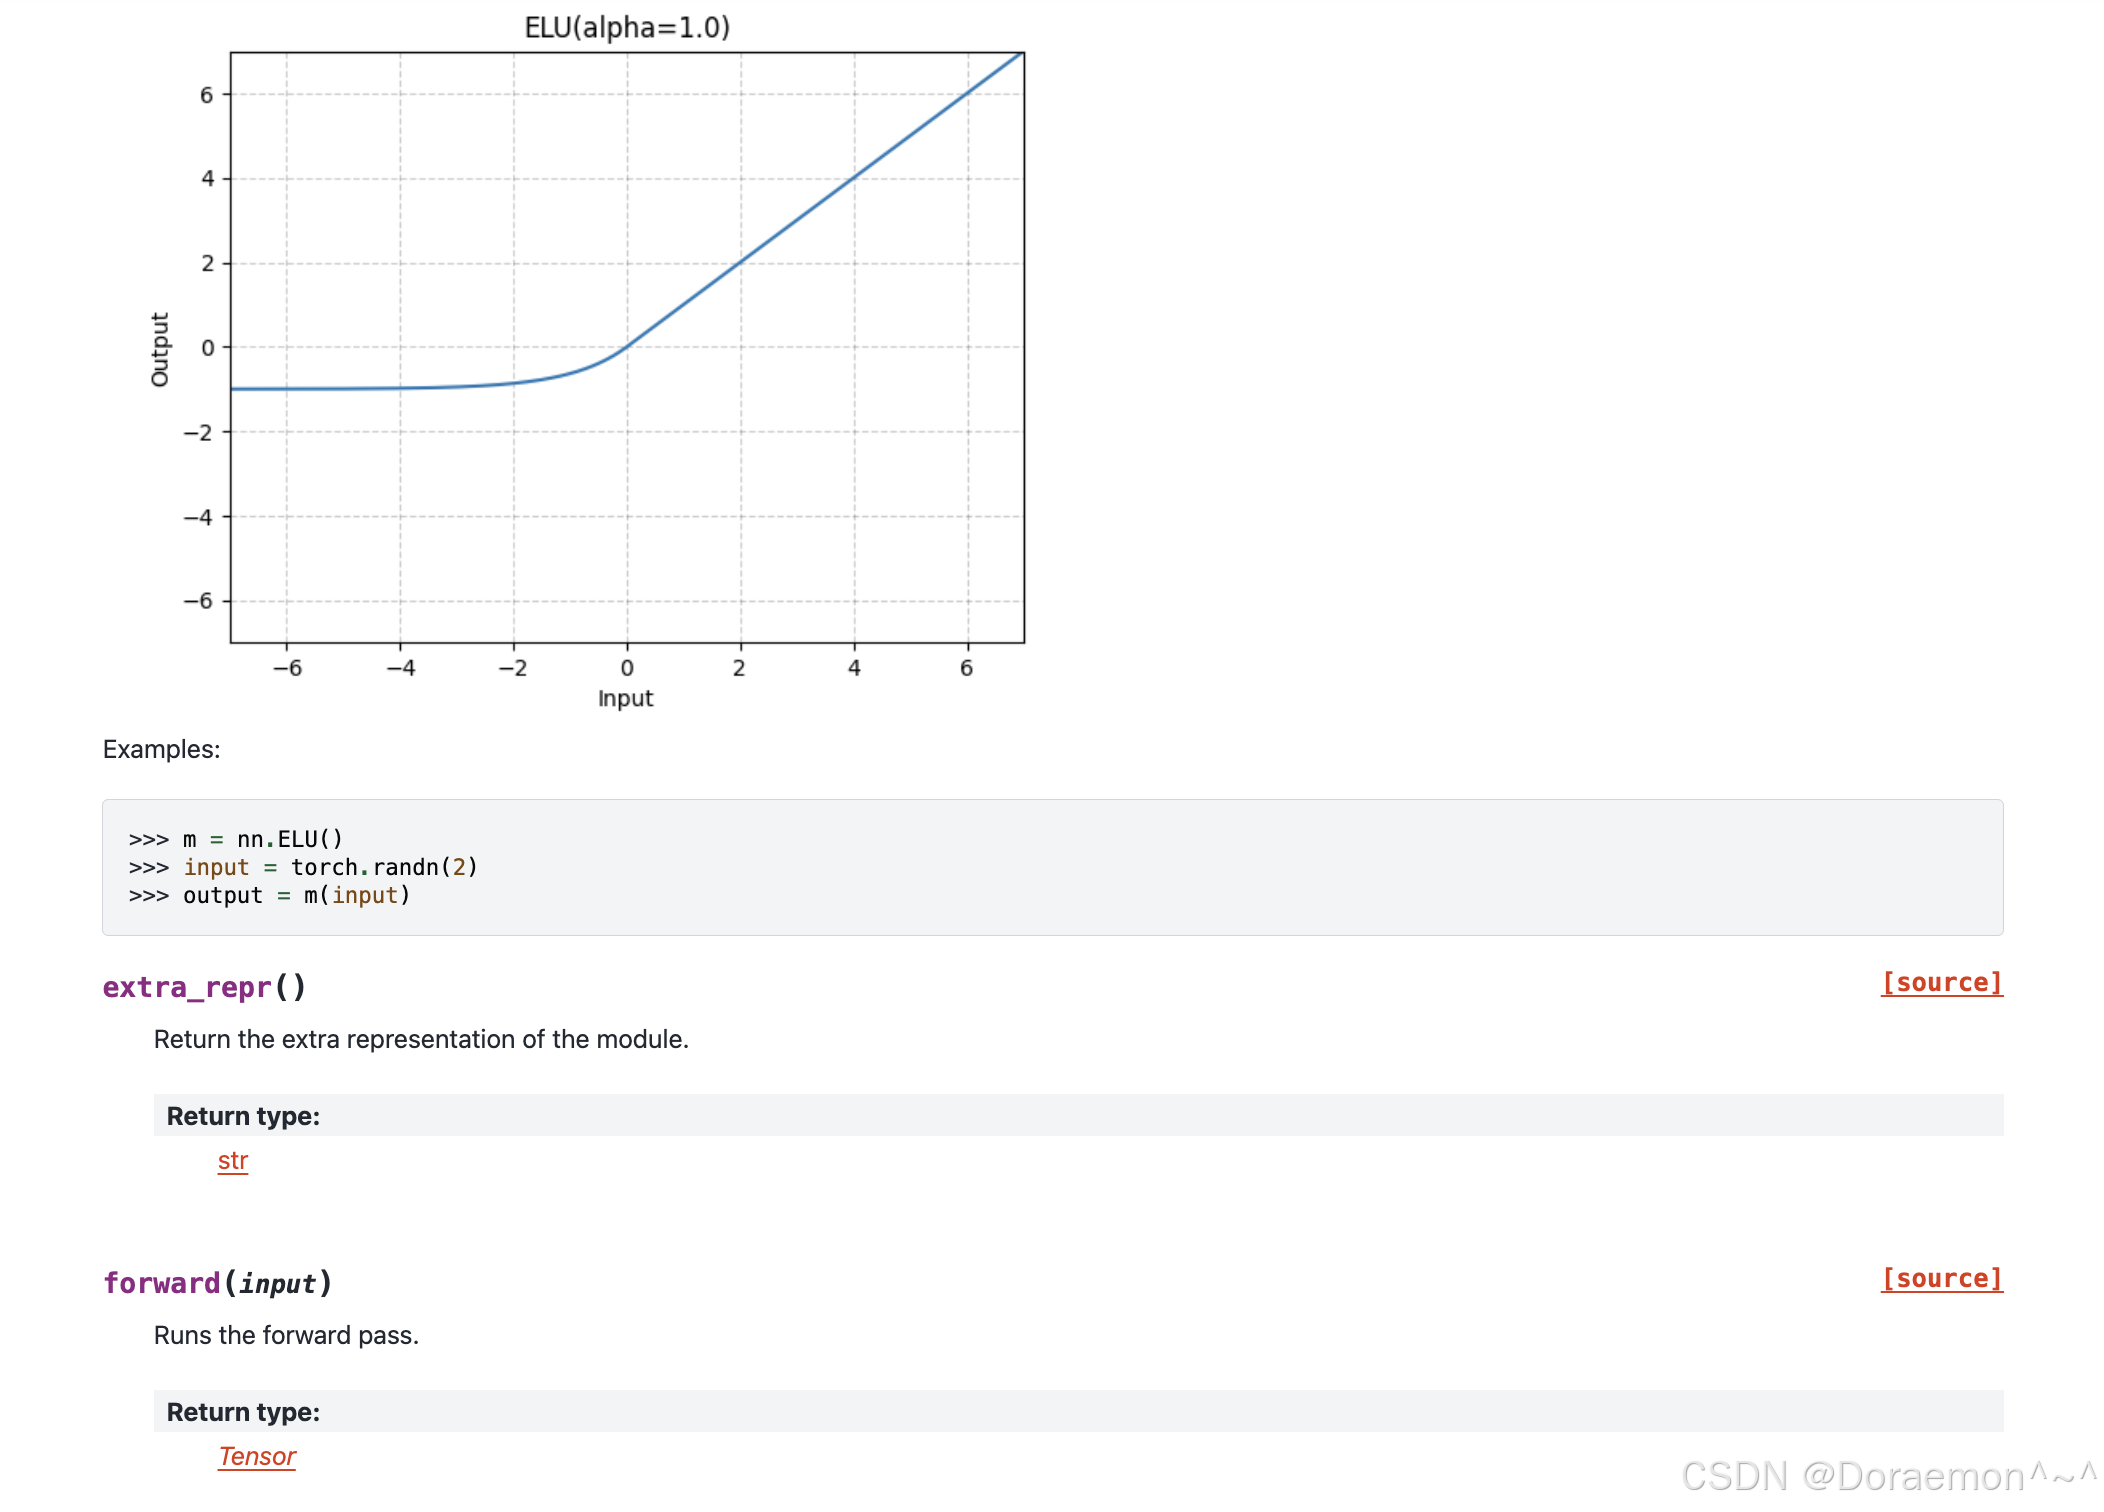
GELU论文中贴出的GELU、ReLU和ELU的图像比较:
相关的PyTorch模块:
GELU --- PyTorch 2.14 documentation
ELU --- PyTorch 2.14 documentation