目录
- JavaSE
-
- Java概述
- Java基础数据类型
- 变量和方法
- 类和对象
- String
-
- 1、String存储原理
- 2、String类能被继承吗
- 3、String底层使⽤的什么类型
- 4、String为什么是不可变的
- 5、String/StringBuffer/StringBuilder的区别
- 6、String类的常⻅⽅法有哪些
- 7、什么是字符串常量池
- 8、字符串拼接发生了什么?
- [9、new String("abc")和String a = "abc"的区别](#9、new String("abc")和String a = "abc"的区别)
- Object
- 异常
-
- Error(错误)
- Exception(异常)
- 两类异常的区别:
- 抓抛模型
- Throwable类的主要方法
- 自定义异常
- [Exception 和 Error 有什么区别?](#Exception 和 Error 有什么区别?)
- [Checked Exception 和 Unchecked Exception 有什么区别?](#Checked Exception 和 Unchecked Exception 有什么区别?)
- 如何处理异常?
- finally总是会被执行吗?
- 泛型
- 反射
- 注解
- 集合
-
- 集合基础
- List
-
- ArrayList和Array有什么区别?
- [ArrayList 与 LinkedList 的区别?](#ArrayList 与 LinkedList 的区别?)
- ArrayList的扩容机制
- Set
-
- [HashSet、LinkedHashSet 和 TreeSet 有什么区别](#HashSet、LinkedHashSet 和 TreeSet 有什么区别)
- Map和Set有什么区别?
- List和Map有什么区别
- Queue
-
- [ArrayDeque 与 LinkedList 的区别](#ArrayDeque 与 LinkedList 的区别)
- 说⼀说你对BlockingQueue的了解
- Map
- IO
- 线程
JavaSE
Java概述
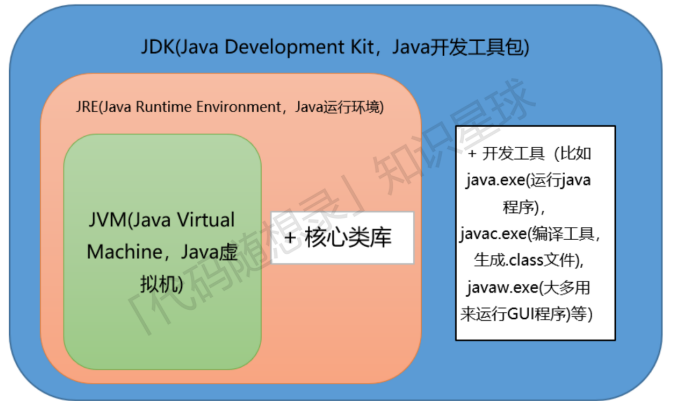
1、JVM、JRE、JDK之间的关系
JVM提供了Java程序运⾏的虚拟环境,JDK是⽤于开发Java程序的⼯具包,⽽JRE是⽤于运⾏Java程序的
环境。在开发阶段需要JDK;⽽在部署和运⾏阶段需要JRE。
JDK包含JRE包含JVM。
Java基础数据类型
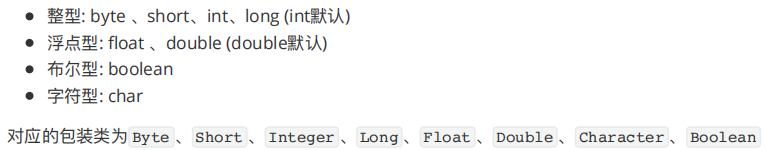
1、Java有⼏种数据类型
2、基础数据类型的转换⽅式

⾃增/⾃减运算符、复合赋值运算符内部⾃动强制类型转换; 如:++, --, +=, -=, ...
3、基本类型和包装类型的区别

4、什么是⾃动装箱和⾃动拆箱
⾃动装箱 是指将基本类型转换为对应的包装类型,调用valueOf()
⾃动拆箱 是指将包装类型转换为对应的基本类型。调用xxxValue()
变量和方法
1、成员变量和局部变量的区别
成员变量:
1、声明在类中,但在⽅法、构造函数或块之外。
2、具有类的整个实例的⽣命周期
3、随着对象的创建⽽创建,随着对象的销毁⽽销毁。
4、如果不显式初始化,会有默认值
局部变量:
1、声明在⽅法、构造函数或块中。
2、仅在声明它们的⽅法、构造函数或块中可⻅
3、在声明时分配内存,在⽅法调⽤结束时销毁。
4、不会⾃动初始化,必须在使⽤之前显式初始化。
2、静态变量是什么?
静态变量是被 static 关键字修饰的变量,被类的所有实例共享,通过类名来访问。
3、值传递和引⽤传递的区别

类和对象
1、⾯向对象和⾯向过程有什么区别
- ⾯向对象会先抽象出具有状态、⾏为的对象,然后⽤对象执⾏⽅法的⽅式解决问题,强调封装、继承和多态,更容易扩展和维护
- ⾯向过程将系统视为⼀系列的过程或函数,通过调⽤这些过程来完成任务。强调的是算法和流程,适合简单的、线性的任务。
2、⾯向对象的三⼤特征
1、封装
将对象内部状态隐藏,通过定义公共方法操作对象,外部代码只需知道如何使用方法而无需了解内部实现。
2、继承
子类可以重用父类代码,并可以通过添加新方法或修改已有方法来扩展或改进功能,提高了代码的可重用性和可扩展性。
3、多态
相同的操作或⽅法在不同的对象上产⽣不同的⾏为,通过⽅法的重载和重写实现。提⾼了代码的灵活性。
3、编译时多态和运⾏时多态的区别
编译时多态: 也称为静态多态或早期绑定,通过⽅法的重载在编译阶段确定调⽤的⽅法。
运行时多态: 也成为动态多态或晚期绑定,通过⽅法的重写在程序运⾏时确定调⽤的⽅法,实现动态绑定。
4、接⼝和抽象类有什么区别
接口:
1、接口是一种抽象类型,只包含常量和抽象方法
2、一个类可以实现多个接口
3、不能包含构造器,实现接口必须实现接口中定义的所有方法。
4、接⼝中的⽅法默认是 public abstract 的。接⼝中的变量默认是 public static final 的。
抽象类:
1、抽象类是一个类,包含抽象方法和具体方法,不能被实例化,需要子类继承并实现其中抽象方法。
2、一个类只能继承一个抽象类
3、可以包含构造器,子类实例化会调用父类构造器
4、抽象类中的抽象⽅法默认是 protected 的,具体⽅法的访问修饰符可以是 public 、 protected
或 private 。
5、构造⽅法能不能重写
构造方法不能重写,重写要求子类方法和父类方法保持同名,构造方法需要和类保持同名,子类与父类不同名,所以构造方法不能重写。
6、说一说你对Java访问权限的了解
public: 对所有类可见
protected: 对同一包内的类和所有子类可见,子类可以访问父类中声明为protected的成员
private: 对同一类内可见
若未使用任何访问修饰符,默认包级别访问
7、你对static关键字有哪些认识
被static关键字修饰得到静态变量、静态方法、静态代码块、静态内部类,静态成员可以被类直接访问,不需要创建类的实例。静态成员无法直接访问非静态成员,因为非静态成员依赖于类的实例。
8、static和final有什么区别
static ⽤于修饰成员时,该成员成为类级别的,⽽不是实例级别的。
当 final ⽤于修饰变量、⽅法或类时,表示它是不可变的。
9、final、finally、finalize的区别
final: 不可变,修饰的变量必须初始化。
finally: 在try/catch中,无论是否抛出异常,表示这段语句一定会被执行
finalize: 每⼀个对象都有这个⽅法,⼀个对象的finalize⽅法只会调⽤⼀
次,调⽤了不⼀定被回收
10、⽅法的重载和重写有什么区别
重载 是在同⼀个类中定义多个⽅法,⽅法名相同但参数列表不同。与返回类型和访问修饰符⽆关,编译时多态
重写 是在⼦类中重新定义⽗类中已有的⽅法,⽅法名和参数列表必须相同。运⾏时多态。
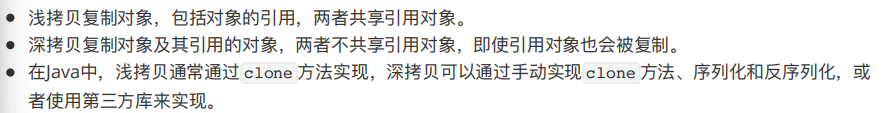
11、深拷⻉和浅拷⻉有什么区别
String
1、String存储原理
- String 类型是不可变的
- Java 中⽤双引号括起来的字符串,都是直接存储在"⽅法区"的"字符串常量池"当中的。放在常量池可以提高执行效率。
2、String类能被继承吗
不能被继承,因为String类有final修饰符,⽽final修饰的类是不能被继承的。
3、String底层使⽤的什么类型
在JDK1.8之前,底层使⽤的是 char 类型的数组
在JDK1.9以后,底层是 byte 类型的数组
4、String为什么是不可变的
保存字符串的数组被final修饰且为私有的,并且String类没有提供修改这个字符串的方法,String类被final修饰不能被继承。
5、String/StringBuffer/StringBuilder的区别
String: 不可变,修改字符串会创建新对象,影响性能;线程安全
StringBuffer: 可变,线程安全,适用于多线程环境中频繁操作字符串。
StringBuilder: 可变、非线程安全,用于单线程环境中频繁操作字符串。
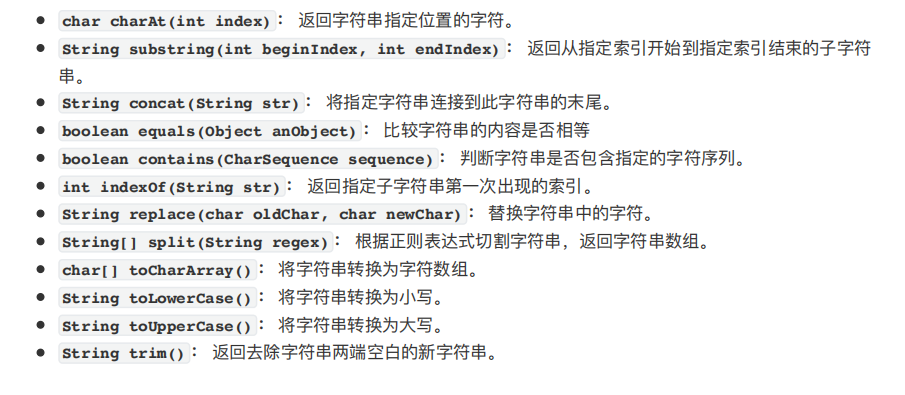
6、String类的常⻅⽅法有哪些
7、什么是字符串常量池
java中字符串不可变,将这些字符串常量存储在字符串常量池中,若后续创建了相同内容的字符串常量,不会创建新对象,而是直接引用已经存在的字符串常量。
8、字符串拼接发生了什么?
1、使用+运算符拼接
- 由于 String 不可变,每次
+拼接都会生成新的 String 对象;纯常量拼接编译器会直接合并成一个字面量,变量拼接则由编译器自动用StringBuilder.append()完成。 - 循环里不要用
+,因为每次循环都会新建一个StringBuilder,产生大量临时对象,应手动在循环外创建一个StringBuilder复用。
2、使用concat()
每次调用都会创建一个新的字符串对象。
3、使⽤ StringBuilder/StringBuffer
StringBuilder 对象 stringBuilder 可以通过 append() ⽅法多次追加字符串。不会产生大量的中间字符串。
9、new String("abc")和String a = "abc"的区别
使⽤ new String("abc") 会在堆内存中创建⼀个新的字符串对象
使⽤ String a = "abc" 会检查字符串常量池中是否已经存在值为 "abc" 的字符串。如果存在,直接引⽤该字符串,如果不存在,则在常量池中创建⼀个新的字符串。
Object
1、Object类的常⻅⽅法有哪些
toString():返回⼀个由类名和该对象的哈希码组成的字符串。通常重写这个⽅法以提供更有⽤的信息
equals(Object obj): ⽐较对象的引⽤是否相等
hashCode(): 返回对象的哈希码值,哈希码⽤于在使⽤哈希表的集合类中快速查找对象
getClass(): 返回对象的运⾏时类。通常,⽤于获取对象的类信息。
clone() : 创建⼀个浅拷⻉
finalize() 垃圾回收器销毁对象之前调⽤
notify() : 唤醒⼀个等待的线程
notifyAll(): 唤醒所有等待的线程
wait(): 使当前线程等待,直到被唤醒。
2、===和equals()的区别
== 操作符⽐较的是对象的引⽤
equals() ⽅法⽤于⽐较对象的内容。
3、说⼀说hashCode()和equals()的关系
如果两个对象相等(equals()),则它们必须有相同的哈希码(hashCode())。
如果两个对象有相同的哈希码,则它们未必相等。
4、为什么要重写hashCode()和equals()
java中equals()方法默认实现是比较对象的引用,通常我们希望比较内容是否相等,所以需要重写。
若两个对象相等,必须有相同的哈希码,所以equal()重写,则hashCode()也要重写
异常
Error(错误)
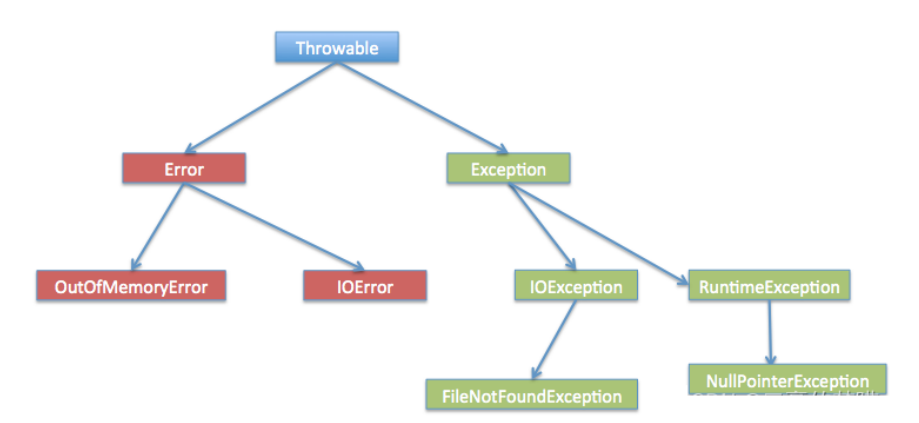
Error 类层次结构描述了 Java 运⾏时系统的内部错误和资源耗尽错误。表示比较严重的问题
Exception(异常)
运行时异常(RuntimeException) :程序错误导致的异常,运行时才可能抛出,编译器不会处理此类异常,比如数组索引越界、使用的对象为空、强制类型转换错误、除0等。一般程序逻辑有问题。
其他异常(I/OException): 编译时异常,要求必须处置,由于外部运行环境导致,并不是代码编译间发⽣的错误。
受检异常和非受检异常:
Error和RuntimeException运⾏时异常都不能被检查。他们都是程序运⾏过程中所产⽣的
受检异常就是编译时异常,这些异常在编译时被强制要求捕获或者声明。编译器将会为所有的受检异常提供异常处理器。
异常处理机制:
两类异常的区别:
- 受检异常(Checked) :编译器强制要求 ------ 要么
try-catch捕获,要么用throws声明给调用者,且必须全部声明,否则编译报错。 - 非受检异常(RuntimeException / Error):不强制捕获或声明,因为 Error 无法处理、RuntimeException 说明代码本身有 bug,应去修代码而非声明可能性。
四个关键字分工:
throw:方法内部手动抛出一个异常对象;throws:方法签名处声明可能抛出的受检异常;try-catch:捕获并处理异常,多个 catch 时子类异常必须放前面、父类放后面,否则父类会先捕获掉所有子类异常,后面的 catch 永远执行不到;finally:无论是否发生异常都会执行,通常用于关闭资源、释放占用。
抓抛模型
异常先有实例(JVM 自动造或 throw 手动造),要么被 try-catch-finally 抓住处理,要么通过 throws 往上抛给调用者。
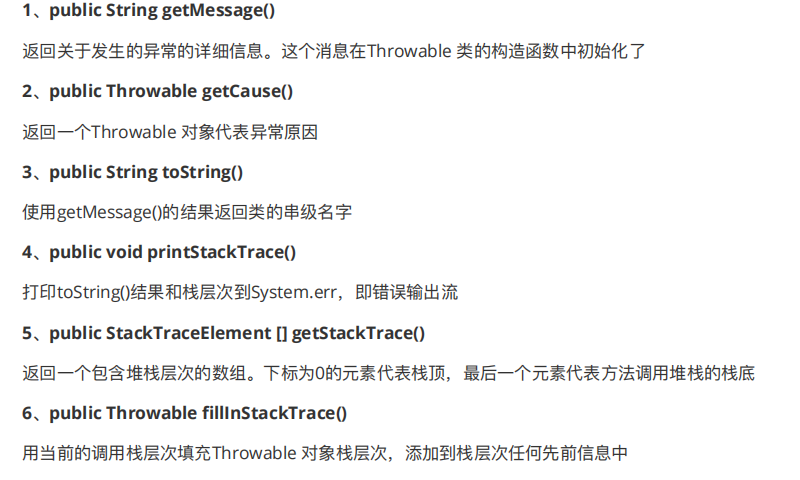
Throwable类的主要方法
自定义异常
一般用户自定义异常类都是RuntimeException的子类,需要提供serialVersionUID方便调试。
Exception 和 Error 有什么区别?
Exception 类及其⼦类主要⽤于表示程序可以处理的异常情况。可以选择捕获并处理异常,也可以通过在⽅法签名中使⽤ throws 关键字声明⽅法可能抛出的异常。
Error 类及其⼦类通常表示虚拟机⽆法恢复的严重错误。不会直接捕获和处理 Error 。这些错误的发⽣通常意味着程序⽆法继续正常执⾏。
Checked Exception 和 Unchecked Exception 有什么区别?
可检查异常是在编译时由编译器检查的异常,程序员必须显式处理或声明这些异常。通常派⽣⾃ Exception 类及其⼦类。
不可检查异常是在运⾏时才会被检测到的异常,通常是由编程错误导致的。不强制处理这些异常。通常派⽣⾃RuntimeException 或其⼦类。
如何处理异常?
发生异常时,系统创建一个异常对象,由JVM找到可以处理这个异常的catch块,将异常对象交给这个catch块处理。可以在finally中关闭某项资源。
finally总是会被执行吗?
如下情况不会被执行:
- 在 try 或 catch 块中调⽤了 System.exit(),会导致JVM退出
- 在 try 块中发⽣了死循环
泛型
说⼀说你对泛型的理解
创建集合时指定集合元素的具体类型,编译期就限制只能存指定类型、取出元素时无需强制类型转换,从根源上杜绝了运行时 ClassCastException。
泛型的使用
- 泛型类
在类的声明中使⽤尖括号引⼊类型参数,然后在类中使⽤这个类型参数。在实例化时,指定具体的类型 - 泛型⽅法
在⽅法声明中使⽤尖括号引⼊类型参数,然后在⽅法中使⽤这个类型参数。调⽤泛型⽅法时,编译器通常可以从上下⽂中推断出类型参数,⽆需显式指定。 - 泛型接⼝
类似于泛型类,泛型接⼝在声明时引⼊类型参数,然后在接⼝的⽅法中使⽤这个类型参数。
泛型擦除
在编译时期,编译器会将泛型信息从泛型代码中移除。
在编译时,泛型类、接⼝和⽅法中的类型参数会被擦除为它们的上界(对于有上界的情况)。
在泛型类或接⼝中,如果有泛型⽅法并且涉及到泛型类型参数的类型转换,编译器会⽣成桥⽅法(bridge method)来保持类型安全。
由于泛型擦除,不能直接创建泛型数组。
反射
反射机制是什么?
定义 :反射是 Java 在运行时 动态获取类信息、并直接操作类或对象的能力,核心入口是 Class 类 ------ 不需要在编译期就确定类的结构。
基本步骤:
- 拿到
Class对象(反射的入口); - 通过它取出类的构造器、方法、字段
- 再用这些对象的实例去进行具体的操作
优点:运行时动态的获取和操作类的信息,代码高度灵活,能够适应不同的场景和需求。
缺点:
- 绕过了编译期类型检查,类型错误只能留到运行时爆发,有类型安全风险;
- 运行时动态解析和分派,有性能开销。
Java反射在实际项⽬中有哪些应⽤场景?
1、多数框架支持注解/XML配置,从配置中解析出来的类是字符串,需要利用反射机制实例化。
2、Spring框架通过反射和注解来实现依赖注入。
注解
以 @ 符号开头,通常紧跟着⼀个标识符,后⾯可以跟⼀些参数,⽤于给类、⽅法、字段等添加元数据信息,
这些息可以在编译时、运⾏时被读取和处理。
常见注解:
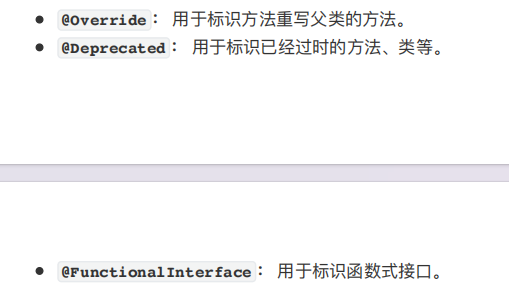
还可以通过@interface自定义注解。
集合
集合基础
Java集合类有哪些
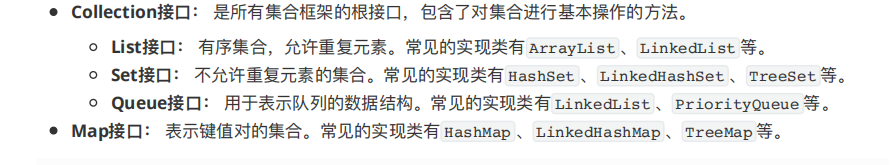
集合框架底层使⽤了什么数据结构
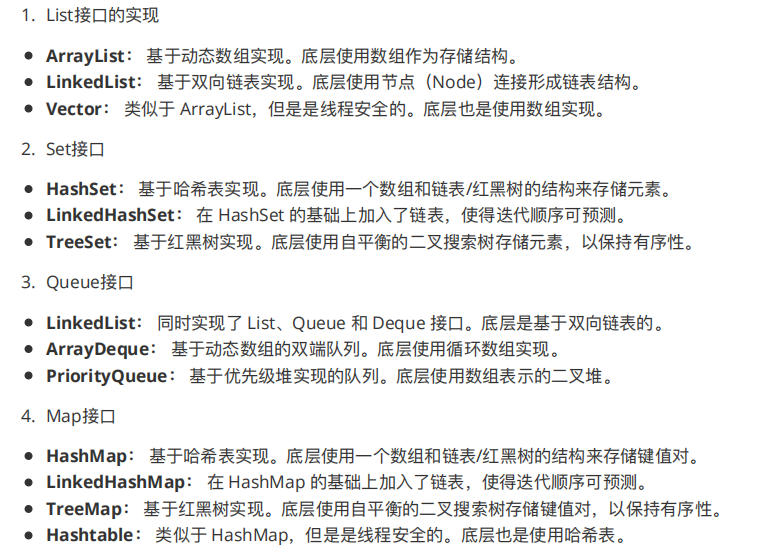
有哪些集合是线程安全和线程不安全的
线程安全:
Vector:线程安全,但不够灵活,建议使用ArrayListHashTable:线程安全,建议使用HashMapCollections.synchronizedList 、 Collections.synchronizedSet 、 Collections.synchronizedMap:可将非线程安全包装成线程安全的集合
线程不安全:ArrayList 、 LinkedList 、 HashSet 、 HashMap:非线程安全、TreeMap 、 TreeSet:非线程安全
List
ArrayList和Array有什么区别?
Array:
- 创建时必须指定大小,大小固定不能更改
- 不支持泛型
- 可存储任何类型元素
- 不提供额外方法对元素增删查改
ArrayList:
- 动态数组实现,大小可以自动扩容
- 支持泛型
- 只能存储对象,基本数据类型需要使用包装类
- 提供丰富的方法用于增删查改。
ArrayList 与 LinkedList 的区别?
ArrayList:
- 基于动态数组实现
- 支持快速的随机访问和遍历
- 插入删除在末尾高效,在开头和中间需要移动元素,性能差
- 适用于频繁随机访问,对插入删除要求不严格的场景
LinkedList:
- 基于双向链表实现
- 随机访问性能较差
- 插入删除性能较好
- 适用于频繁插入删除,对随机访问需求少的场景
ArrayList的扩容机制
本质是计算出新的扩容数组的size实例化,并将原有数组内容复制到新数组中去。
默认情况新容量是原容量的1.5倍。新容量=旧容量右移一位+旧容量。
- 添加第一个元素,调用扩容方法并返回最小容量10
- 扩容发生在
grow()方法里,底层用Arrays.copyOf()实现复制 - 如果扩容的新数组大小还是小于最小容量,就直接取需要的最小容量
Set
HashSet、LinkedHashSet 和 TreeSet 有什么区别
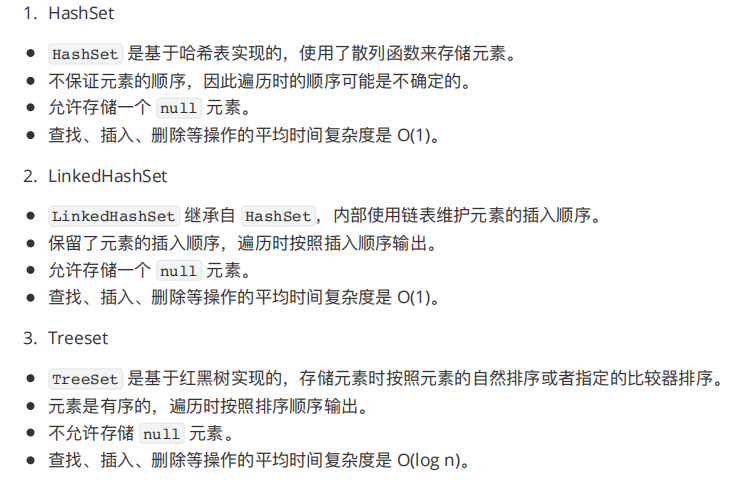
Map和Set有什么区别?
Set代表⽆序的,元素不可重复的集合;
Map代表具有映射关系(key-value)的集合
List和Map有什么区别
Set代表⽆序的,元素不可重复的集合;
List代表有序的,元素可以重复的集合。
Queue
ArrayDeque 与 LinkedList 的区别
1. ArrayDeque
- ArrayDeque 是基于动态数组实现的双端队列。
- 支持高效的随机访问,可以通过索引直接访问元素。
- 在头部和尾部进行插入和删除操作的平均时间复杂度是 O (1)。
- 存储元素时比 LinkedList 更节省空间,因为不需要存储每个节点的前后引用。
- 迭代元素时通常比 LinkedList 更快,因为数组的元素在内存中是连续存储的,对缓存更友好。
- 不是线程安全的,如果在多线程环境中使用,需要进行外部同步。
2. LinkedList
- LinkedList 是基于双向链表实现的双端队列。
- 随机访问性能较差,因为要从头或尾开始遍历链表才能找到指定位置的元素。
- 在头部和尾部进行插入和删除操作的平均时间复杂度也是 O (1),但由于涉及到节点的指针操作,性能可能相对较低。
- 每个节点都需要额外的空间来存储前一个节点和后一个节点的引用,占用空间更多。
- 迭代性能较差,因为节点在内存中是分散存储的。
- 不是线程安全的,如果在多线程环境中使用,需要进行外部同步。
说⼀说你对BlockingQueue的了解
核心作用:
用于多线程之间安全地传递数据,队列为空或满时自动阻塞等待,是生产者 - 消费者模型的核心工具。
- 阻塞操作
put():添加元素,队列满时阻塞等待take():取出元素,队列空时阻塞等待
- 超时操作
offer(e, time, unit):添加元素,等待超时后返回 falsepoll(time, unit):取出元素,等待超时后返回 null
- 容量
- 支持有界队列(固定容量)和无界队列(可无限添加)
- 公平性
- 部分实现支持公平锁,按等待顺序唤醒线程
- 常⻅实现类 :
ArrayBlockingQueue:基于数组实现的有界队列。
LinkedBlockingQueue:基于链表实现的有界或⽆界队列。
PriorityBlockingQueue:基于优先级的⽆界队列。
DelayQueue:⽤于实现延迟任务的⽆界队列。
Map
Map接⼝有那些实现类
HashMap、LinkedHashMap、TreeMap、ConcurrentHashMap
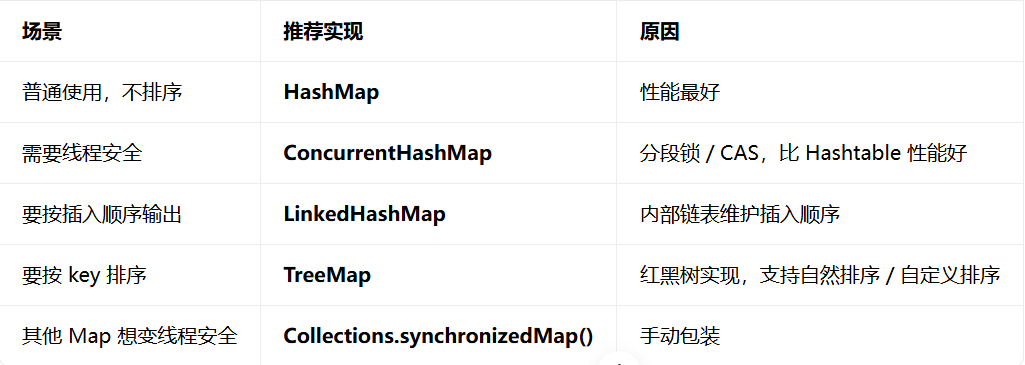
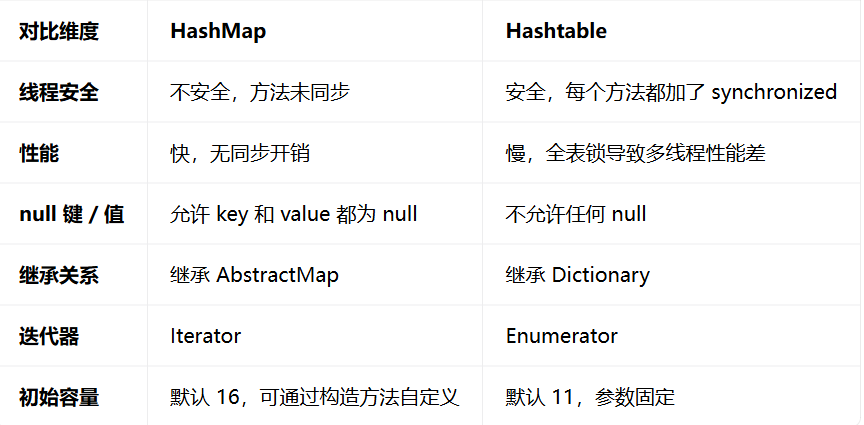
HashMap和Hashtabe的区别
HashMap和HashSet的区别
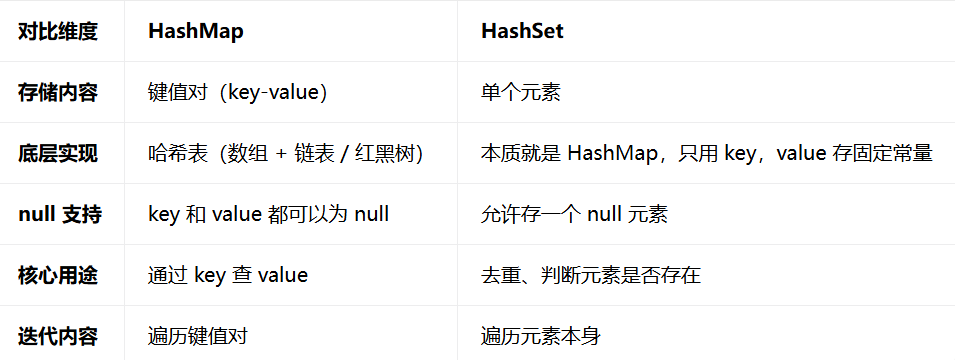
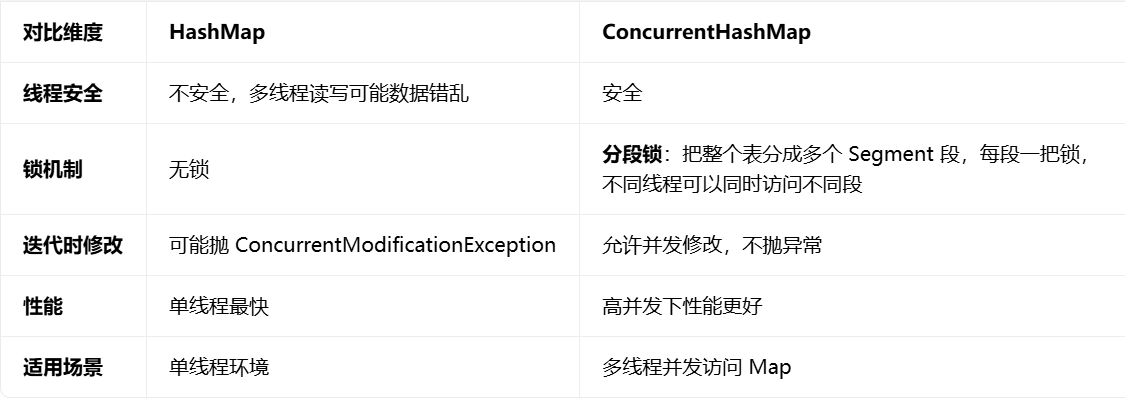
HashMap和ConcurrentHashMap的区别
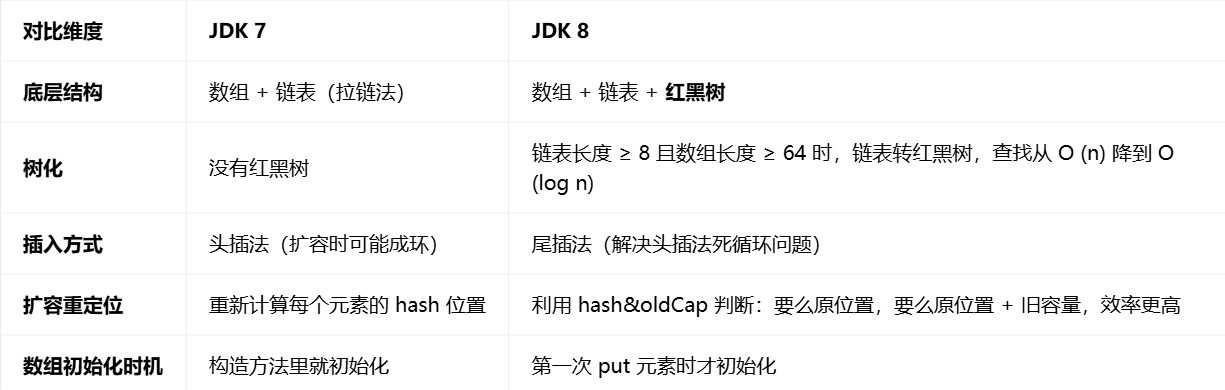
JDK7和JDK8中的HashMap有什么区别?
HashMap如何解决哈希冲突的
HashMap 主要使⽤拉链法来解决哈希冲突
HashMap为什么线程不安全?如何实现线程安全
主要原因是它的操作不是原⼦的,即在多个线程同时进⾏读写操作时,可能会导致数据不⼀致性或抛出异常.
使⽤ Collections.synchronizedMap() ⽅法:该⽅法返回⼀个同步的 Map 包装器,使得所有对 Map 的操作都是同步的。
使⽤ ConcurrentHashMap :它使⽤分段锁机制,允许多个线程同时进⾏读操作,提⾼并发性能。
使⽤锁机制:可以在⾃定义的 HashMap 操作中使⽤显式的锁来保证线程安全。
Map put的过程
- ⾸次扩容:
先判断数组是否为空,若数组为空则进⾏第⼀次扩容(resize); - 计算索引:
通过hash算法,计算键值对在数组中的索引; - 插⼊数据:
如果当前位置元素为空,则直接插⼊数据;
如果当前位置元素⾮空,且key已存在,则直接覆盖其value;
如果当前位置元素⾮空,且key不存在,则将数据链到链表末端;
若链表⻓度达到8,则将链表转换成红⿊树,并将数据插⼊树中;
再次扩容 - 如果数组中元素个数(size)超过threshold,则再次进⾏扩容操作。
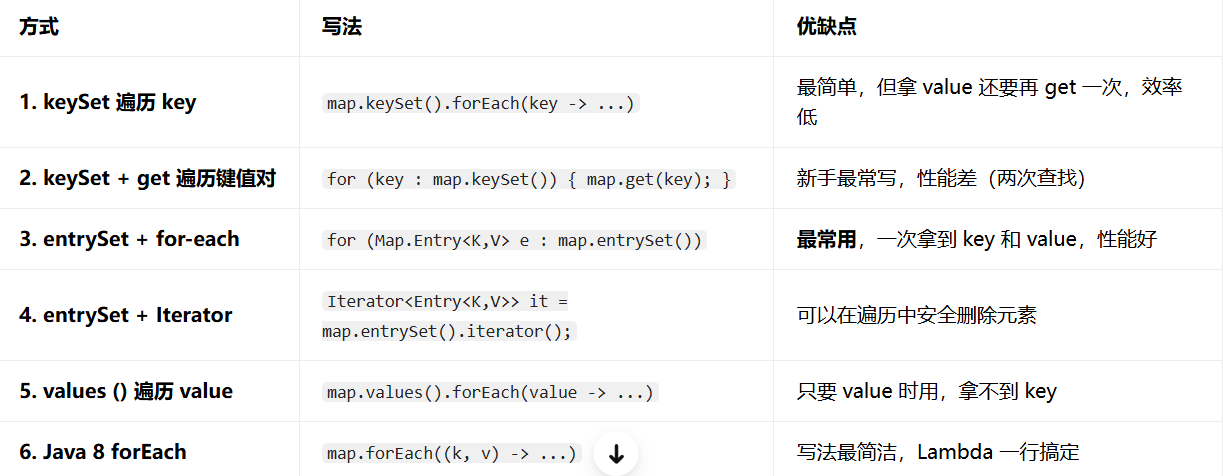
Map的遍历方式
IO
IO流基本认识
- 字节流
InputStream和OutputStream: 是所有字节输⼊流和输出流的抽象基类。它们分别⽤于读取和写⼊字节。
FileInputStream和FileOutputStream: ⽤于从⽂件中读取字节和向⽂件中写⼊字节。
ByteArrayInputStream和ByteArrayOutputStream: 分别⽤于从字节数组中读取数据和将数据写⼊字节数组。 - 字符流
Reader和Writer: 是所有字符输⼊流和输出流的抽象基类。它们分别⽤于读取和写⼊字符。
FileReader和FileWriter: ⽤于从⽂件中读取字符和向⽂件中写⼊字符。
BufferedReader和BufferedWriter: ⽤于提供缓冲区,提⾼读取和写⼊的效率。 - ⾼级流
ObjectInputStream和ObjectOutputStream: ⽤于读取和写⼊对象。可以序列化和反序列化对象。
DataInputStream和DataOutputStream: ⽤于读取和写⼊基本数据类型。
谈一下你对IO流的基本理解
数据流的基本概念
在Java中,把不同类型的输⼊、输出源抽象为流(Stream),其中输⼊或输出的数据称为数据流 ,⽤统⼀的接⼝来表示。
IO流的分类
按照流的流向分
输出:把程序(内存)中的内容输出到磁盘、光盘等存储设备中。
输⼊:读取外部数据(磁盘、光盘等存储设备的数据)到程序(内存)中。
按处理数据单位不同分
字节流:每次读取(写出)⼀个字节,当传输的资源⽂件有中 ⽂时,就会出现乱码。
字符流:每次读取(写出)两个字节,有中⽂时,使⽤该流就可以正确传输显示中⽂。
按照流的⻆⾊划分
节点流:从或向⼀个特定的地⽅(节点)读写数据。如 FileInputStream。
处理流(包装流):是对⼀个已存在的流的连接和封装,通过所封装的流的功能调⽤实现数据读写。如BufferedReader。
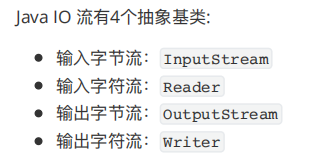
字节输入流
inputStream主要数据的操作方法:
int read():从输⼊流中读取⼀个字节的⼆进制数据。
int read(byte[] b):将多个字节读到数组中,填满 整个数组
int read(byte[] b, int off, int len):从输⼊流中读取⻓度为 len 的数据,从数组 b 中下标为 off 的位置开始放置读⼊的数据,读完返回读取的字节数。
void close():关闭数据流。
int available():返回⽬前可以从数据流中读取的字节数(但实际的读操作所读得的字节数可能⼤于该返回值)
long skip(long l):跳过数据流中指定数量的字节不读取,返回值表示实际跳过的字节数。
对数据流中字节的 读取通常是按从头到尾顺序进⾏的,如果需要以反⽅向读取,则需要使⽤回推(Push Back)操作。
在 ⽀持回推操作的数据流中经常⽤到如下⼏个⽅法:
boolean markSupported():⽤于测试数据流是否⽀持回推操作,当⼀个数据流⽀持 mark() 和 reset() ⽅法时,返回 true,否则返回 false。void mark(int readlimit):⽤于标记数据流的当前位置,并划出 ⼀个指定参数大小的缓冲区。void reset():将输⼊流重新定位到对此流最后调⽤ mark() ⽅法时的位置。
InputStream子类
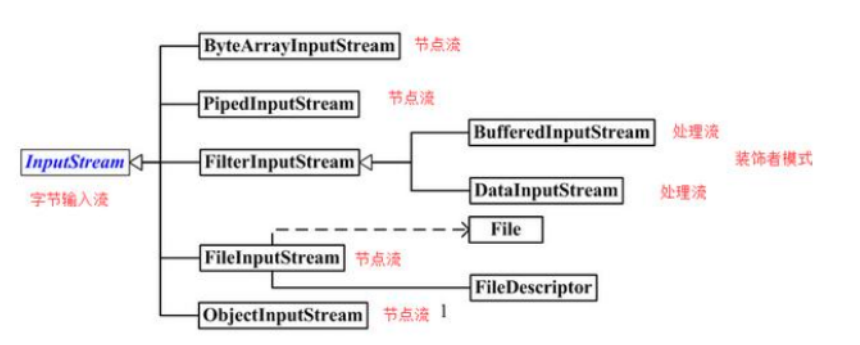
ByteArrayInputStream:字节数组输⼊流,从字节数组 byte\[\] 中进⾏以字节为单位的 读取。
PipedInputStream:管道字节输⼊流,能实现多线程间的 管道通信。
FilterInputStream:装饰者模式中充当装饰者的⻆⾊,具体的装饰者都要继承它,处理类。
BufferedInputStream:缓冲流,对处理流进⾏装饰、增强,内部会有⼀个存放字节的缓冲区,每次都是将缓冲区存满然后发送,效率更⾼。
DataInputStream:数据输⼊流,⽤来装饰其他输⼊流,它允许通过数据流来读写Java基本类型。
FileInputStream:⽂件输⼊流,通常⽤于对⽂件进⾏读取操作。
ObjectInputStream:对象输⼊流,能直接传输Java对象。
字节输出流
OUtputStream主要数据的操作方法:
void write(int i):将字节 i 写⼊到数据流中,它只输出所读⼊参数的最低 8 位,该⽅法是抽象⽅法,需 要在其输出流⼦类中加以实现,然后才能使⽤。
void write(byte[] b):将数组 b 中的全部 b.length 个字 节写⼊数据流。
void write(byte[] b, int off, int len):将数组 b 中从下标 off 开始的 len 个字节写⼊数据 流。
void close():关闭输出流。
void flush():刷新此输出流并强制写出所有缓冲的输出字节。
字符输入流
Reader及其一些常用子类
CharReader和SringReader是两种基本的介质流,它们分别将Char数组、String中读取数据。
PipedReader 是从与其它线程共⽤的管道中读取数据。
BufferedReader是⼀个装饰器为Reader 提供缓冲 功能。
FilterReader是所有⾃定义具体装饰流的⽗类,其⼦类PushBackReader对Reader对象进⾏装饰,会增 加⼀个⾏号。
InputStreamReader⽤来在字节输⼊流和字符输⼊流之间作为中介,可以将字节 输⼊流转换为字符输⼊流。
FileReader 常⽤的⼯具类,在其源代码中使⽤了将FileInputStream 转变为Reader 的⽅法。
字符输出流
Writer及其一些常用子类
CharWriter、StringWriter 是两种基本的介质流,它们分别向Char 数组、String 中写⼊数据。
PipedWriter 是向与其它线程共⽤的管道中写⼊数据。
BufferedWriter
PrintWriter 和PrintStream 极其类似,功能和使⽤也⾮常相似。、OutputStreamWriter⽤来在字节输出流和字符输出流之间作为中介,可以将字节输出流转换为字符输出流。
FileWriter 常⽤的⼯具类,在其源代码中使⽤了将OutputStream转变为Writer 的
⽅法。
字节流和字符流的区别
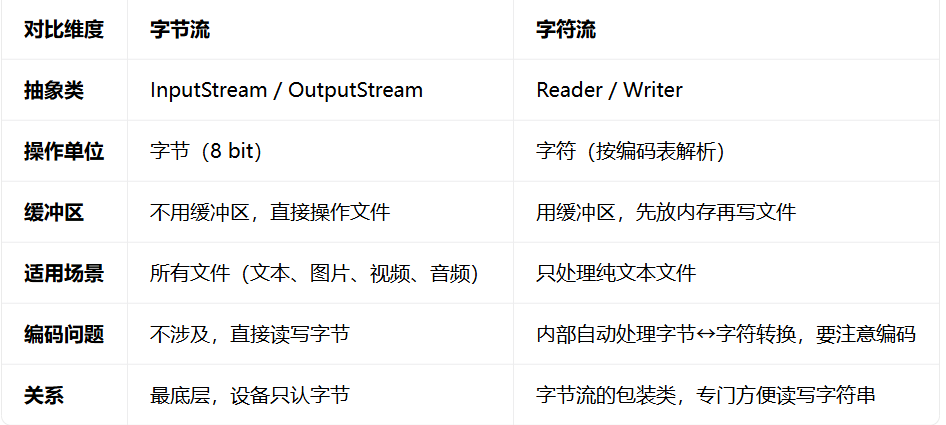
使用场景:
字节流:处理图像,视频,以及PPT,Word类型的⽂件,可以处理纯文本。
字符流:处理纯⽂本类型的⽂ 件,如TXT⽂,但不能处理图像视频等非文本文件。
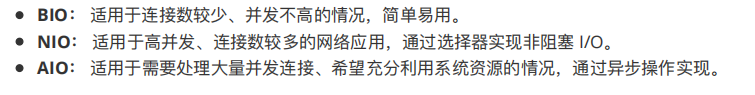
I/O模型
1、BIO(Blocking I/O 阻塞I/O模型)
同步阻塞I/O模型,读取写入数据时,线程一直等待,直到数据准备就绪或写入完成,高并发性能不佳。
2、NIO(Non-blocking I/O)
同步非阻塞,执行I/O操作不会等待,继续执行其他任务,使用轮询或回调函数机制检查I/O操作是否完成。更好支持并发,轮询会导致CPU资源浪费。
3、I/O多路复用
选择器机制,一个线程可以监听多个通道上的I/O事件,从而在单线程中处理多个连接。
4、AIO(Asynchronous I/O)
异步I/O允许程序在执⾏I/O操作时继续执⾏其他任务,⽽不需要等待I/O操作完成。
BIO/NI0/AIO的区别
介绍⼀下Java的序列化与反序列化
1、需要实现Serializable接⼝,没有提供任何⽅法,只是标明该类是可以序列化的,如包装类、String、Date等已经实现了Serializable接⼝。
2、还需要使⽤对象流ObjectInputStream和ObjectOutputStream
对象的序列化(Serialize) ,是指将⼀个Java对象写⼊IO流中,用 ObjectOutputStream 的 writeObject() 方法把对象写出去
对象的反序列化(Deserialize) ,则是指从IO流中恢复该Java对象。用 ObjectInputStream 的 readObject() 方法把字节流读回来