Finetuning with Sampling: SFT Learns Better Than You Think
基于采样的微调:SFT 学习得比你想的更好
摘要
为前沿模型引入新能力长期以来一直是后训练的目标,后训练主要为此采用监督微调(SFT)和强化学习(RL)。传统观点认为,RL 能在新任务上实现强泛化且不丧失现有能力,而 SFT 则容易泛化较弱并出现灾难性遗忘。与此同时,SFT 可以从离策略专家数据中学习,而 RL 必须依赖模型通过重复采样找到成功轨迹的能力。在我们的工作中,我们力求利用在策略学习的优势,同时利用离策略数据中包含的特权信息。然而,我们并非通过修改学习目标来适配这些数据,而是调整数据分布以更好地适配学习器。我们引入一种马尔可夫链蒙特卡洛(MCMC)采样算法,该算法在给定用于微调的参考模型时,逐步将离策略轨迹转化为更接近在策略的轨迹。在科学技能获取、数学推理和开放式专长等任务中,我们的采样算法使 SFT 能够与主流后训练技术相媲美,并且通常比强在策略基线泛化更好、遗忘更少。此外,所得的微调模型展现出强分布性能,并能够进行超越锐化基础模型分布的学习。在更高层面上,我们的方法将采样呈现为一种模型原生算子,用于塑造数据以提升可学习性,并在整个后训练栈中作为通用原语提供更广泛的用途。
1.引言
后训练为前沿大语言模型(LLMs)的能力带来了革命性进展Guo 等, 2025, Hu 等, 2025,在数学、科学和编程等领域带来了可观的性能提升Hendrycks 等, 2021, Li 等, 2022, Rein 等, 2024。尽管如此,一个关键的开放问题仍然存在:我们如何能在后训练期间引入根本性的新能力,同时不放弃已有能力?近期大量文献一直致力于理解现有学习框架------即监督微调(SFT)和强化学习(RL)------能在多大程度上实现这一目标。压倒性证据Chen 等, 2025, Chu 等, 2025, Shenfeld 等, 2025表明 RL 是首选范式,其依据是在未见领域上具有更优的泛化能力,且似乎能使先前能力保持完好。与此同时,SFT 则受困于弱泛化和灾难性遗忘Kirkpatrick 等, 2017, Luo 等, 2023:即微调模型在现有能力上表现出显著退化的现象。Chen 等2025、Shenfeld 等2025将这一性能差距归因于 RL 的同策略特性:模型自身的样本决定学习更新,将微调约束在不会偏离原始起点太远的分布上。另一方面,SFT 是异策略的,使微调更容易受到剧烈更新和行为偏移的影响Xiong 等, 2025。同时,严格进行同策略学习也是一种局限,因为它依赖于模型自身通过重复采样找到成功轨迹的能力。如果模型无法生成一个对于训练样本上的正确 rollout,奖励中不存在集体方差,从而导致没有学习信号。Qu 等人 2026 在实践中观察到这一缺陷,识别出相当大一类困难训练样本,这些样本由于过于困难而无法产生任何可训练性,因而在 RL 过程中实际上被丢弃。对于引入新能力而言,这一局限并不理想,因为在这种情况下,模型不太可能已经足够胜任以产生成功轨迹。在此,SFT 具有优势,因为它利用由异策略特权信息构造的轨迹,这些轨迹提供丰富的监督信号,而无需显式奖励。在本工作中,我们没有修改学习算法以适应异策略数据,而是询问能否转而塑造数据分布以适应学习。更确切地说,我们能否以算法方式采样同策略轨迹,同时使其保持忠实于特权异策略信息?为此,我们提出一种采样算法,它逐步将异策略专家轨迹数据集变换为在分布上更接近给定基座模型分布的数据集。值得注意的是,这一采样步骤使 SFT 能够与主流后训练技术相媲美,并且往往比强同策略学习算法泛化得更好、遗忘更少。我们的贡献可总结如下:
• 我们引入了一个框架,将用于微调的异策略数据转换为同策略数据这一任务形式化。具体而言,给定一个基座模型和一个专家轨迹数据集,我们指定一个目标数据生成策略,该策略在保持与基座模型分布最大接近程度的同时,保留原始数据集的信息内容。
• 为了从该策略生成增强样本,我们引入投影采样,这是一种使用马尔可夫链蒙特卡洛(MCMC)技术的近似采样算法,它根据专家轨迹相对于基座模型的似然来迭代地精炼这些轨迹。
• 我们在包括科学技能获取、数学推理和开放式专业知识在内的一系列任务上,实证展示了我们的采样流程对 SFT 的有效性。我们的结果表明,带采样的 SFT 在新任务泛化以及先前能力保持方面,可以优于 RL 和自蒸馏等同策略对应方法。
我们的结果共同表明,将采样与微调相结合是一种强大的范式,能够使像 SFT 这样标准的学习算法表现得远超传统预期。
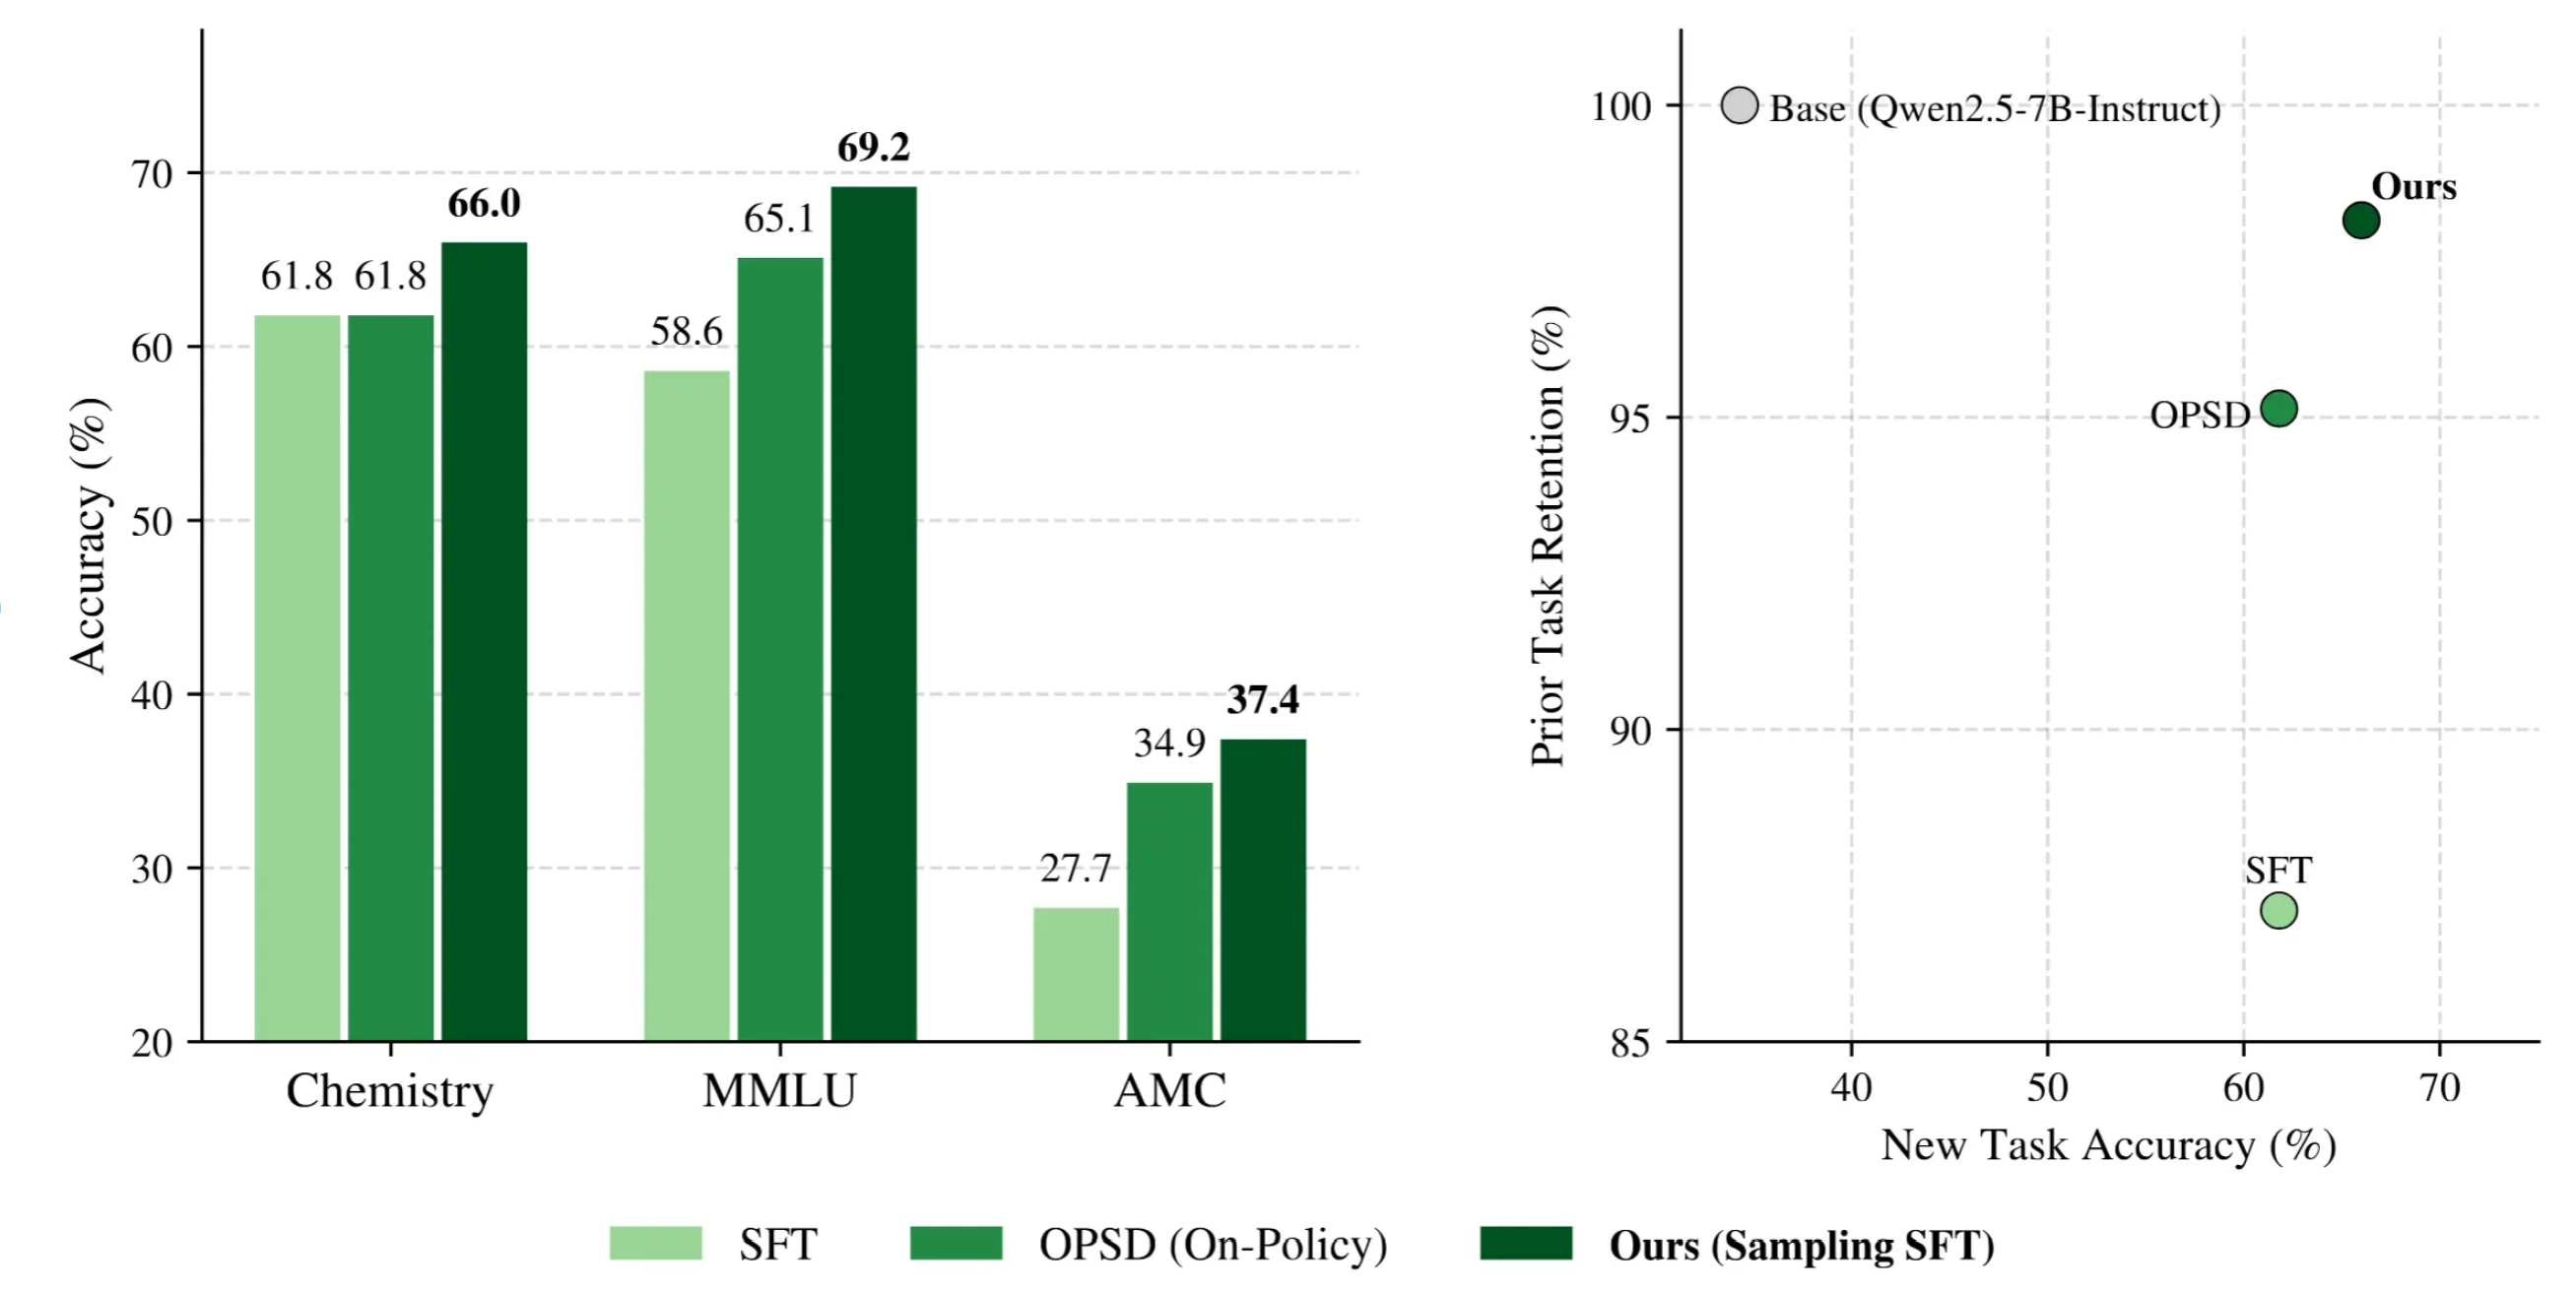
图 1:与采样相结合时,SFT 比同策略学习具有更好的泛化能力且遗忘更少。左图:我们将与面向异策略数据的采样算法相结合的 SFT,与在原始数据集上进行 SFT 以及一种将异策略数据整合到自蒸馏中的同策略学习算法(OPSD)Shenfeld et al., 2026 进行比较。我们以化学问题的科学推理任务为例对此进行说明,并绘制其在预训练期间引入的先前能力(MMLU 和 AMC)上的性能。右图:我们沿两个轴比较这三种方法:新任务准确率(化学)和先前任务保留率,后者衡量微调模型能够保持的基础模型性能百分比。与采样相结合的 SFT 在这两个轴上均表现最佳。
2 相关工作
SFT 与 RL。许多近期工作研究了后训练中 SFT 与 RL 之间的性能差距。Chu 等 2025 是早期注意到泛化性能差距的工作,断言 SFT 易于记忆化,而 RL 能够泛化到训练分布之外。Xiong 等 2025 为这一现象提供了数学解释,表明离策略训练可能导致大幅且不稳定的梯度更新,从而促使过拟合并损害泛化。Shenfeld 等 2025 和 Chen 等 2025 从先前能力保持的视角考察这一性能差距,指出 SFT 极易发生灾难性遗忘 Kirkpatrick 等,2017;Luo 等,2023。Shenfeld 等 2025 进行了广泛的实证分析,将这一现象归因于 SFT 的离策略性质,甚至表明遗忘程度与微调模型和基础模型之间的 KL 散度相关。类似地,Chen 等 2025 提供了一种模式寻求的依据,并得出类似结论:在策略数据减轻遗忘,而离策略数据促进遗忘。若干工作还试图通过在离策略与在策略学习之间进行插值来弥合 SFT 与 RL 之间的差距。Liu 等 2025 和 Qu 等 2026 都构建了 GRPO Guo 等,2025 的变体,这些变体在上下文中使用专家数据,以鼓励在 RL 期间为困难问题生成正确的 rollout,并在训练时将其视为普通生成。在 SFT 方面,Wu 等 2025 通过重要性采样权重调节 SFT 目标,以匹配在策略梯度,而 Zhu 等 2025 则添加 KL 散度项,以进一步促使其接近基础模型。尽管这些方法改变学习目标以更好地考虑离策略数据,但我们的方法保持 SFT 不变,转而专注于调节离策略数据,使其更接近在策略。
自蒸馏。自蒸馏是一种在策略的 RL 替代方案,最近因纳入离策略数据而开始获得认可。自蒸馏通常通过以特权信息(例如专家数据或环境反馈)为条件,从基础模型构建教师模型,然后通过 KL 散度损失进行蒸馏。若干工作 Shenfeld 等,2026;Ye 等,2026;Zhao 等,2026 对这一思想提出了变体,并展示了有前景的结果。OPSD Shenfeld 等,2026;Zhao 等,2026(本文中我们将其称为基线)为持续学习提供了一条有前景的途径:即在不遗忘的情况下适应新任务。
使用 LLM 的 MCMC 采样。先前研究还探索了如何将 MCMC 方法整合到 LLM 采样中。若干工作探索了使用 MCMC 向外部奖励函数 Zhao 等,2024;Faria 等,2024 或概率程序 Lew 等,2023 倾斜。与我们的工作最相关的是 Karan 和 Du 2025、Azizi 等 2026、Arzhantsev 等 2026,它们使用 MCMC 采样从锐化分布中采样以进行推理。其他工作通过针对关键 token Li 等,2025 来扩展该框架,以使 MCMC 采样更高效 Zhou 等,2026;Ji 等,2026。相比之下,我们的方法使用采样来转换离策略数据,以供后续微调使用。
3 预备知识
设 X X X 为有限的词元词表,并令 X T X^T XT 表示有限词元序列 x 0 : T = ( x 0 , x 1 , ... , x T ) x_{0:T} = (x_0, x_1, \ldots, x_T) x0:T=(x0,x1,...,xT) 的集合,其中对所有 i i i 有 x i ∈ X x_i \in X xi∈X,且 T ∈ Z ≥ 0 T \in \mathbb{Z}{\ge 0} T∈Z≥0 为某个非负整数。为方便起见,对于给定的 t t t,令 x < t = ( x 0 , ... , x t − 1 ) x{<t} = (x_0, \ldots, x_{t-1}) x<t=(x0,...,xt−1) 和 x > t = ( x t + 1 , ... , x T ) x_{>t} = (x_{t+1}, \ldots, x_T) x>t=(xt+1,...,xT),类似地定义 x ≤ t x_{\le t} x≤t 和 x ≥ t x_{\ge t} x≥t。一般而言, x x x 指词元序列 x 0 : T x_{0:T} x0:T,其中 T T T 隐含给定,而 X ∗ X^* X∗ 表示长度有限但任意的词元序列的集合。
随后,LLM 通过自回归地学习所有 t t t 的条件词元分布 p ( x t ∣ x < t ) p(x_t \mid x_{<t}) p(xt∣x<t),在词元序列 X ∗ X^* X∗ 上定义分布 p p p,并通过恒等式给出联合分布
p ( x 0 : T ) = ∏ t = 0 T p ( x t ∣ x < t ) . (1) p(x_{0:T}) = \prod_{t=0}^{T} p(x_t \mid x_{<t}). \tag{1} p(x0:T)=t=0∏Tp(xt∣x<t).(1)
为了从 p p p 中采样一个序列,我们只需利用条件分布从 LLM 中逐词元地采样,而根据 (1),这直接对联合分布进行采样。
有监督微调。令 D = { ( q i , x i ) } i = 1 N \mathcal{D} = \{(q_i, x_i)\}_{i=1}^N D={(qi,xi)}i=1N 表示由针对查询 q i q_i qi 的专家轨迹 x i x_i xi 组成的数据集。然后 SFT 通过对 LLM 对 p p p 的参数化进行梯度更新来优化交叉熵损失目标
L SFT = E ( q , x ) ∼ D − log p ( x ∣ q ) , (2) L_{\text{SFT}} = \mathbb{E}_{(q,x)\sim \mathcal{D}} -\\log p(x \\mid q), \tag{2} LSFT=E(q,x)∼D−logp(x∣q),(2)
4 利用 MCMC 采样增强离策略数据
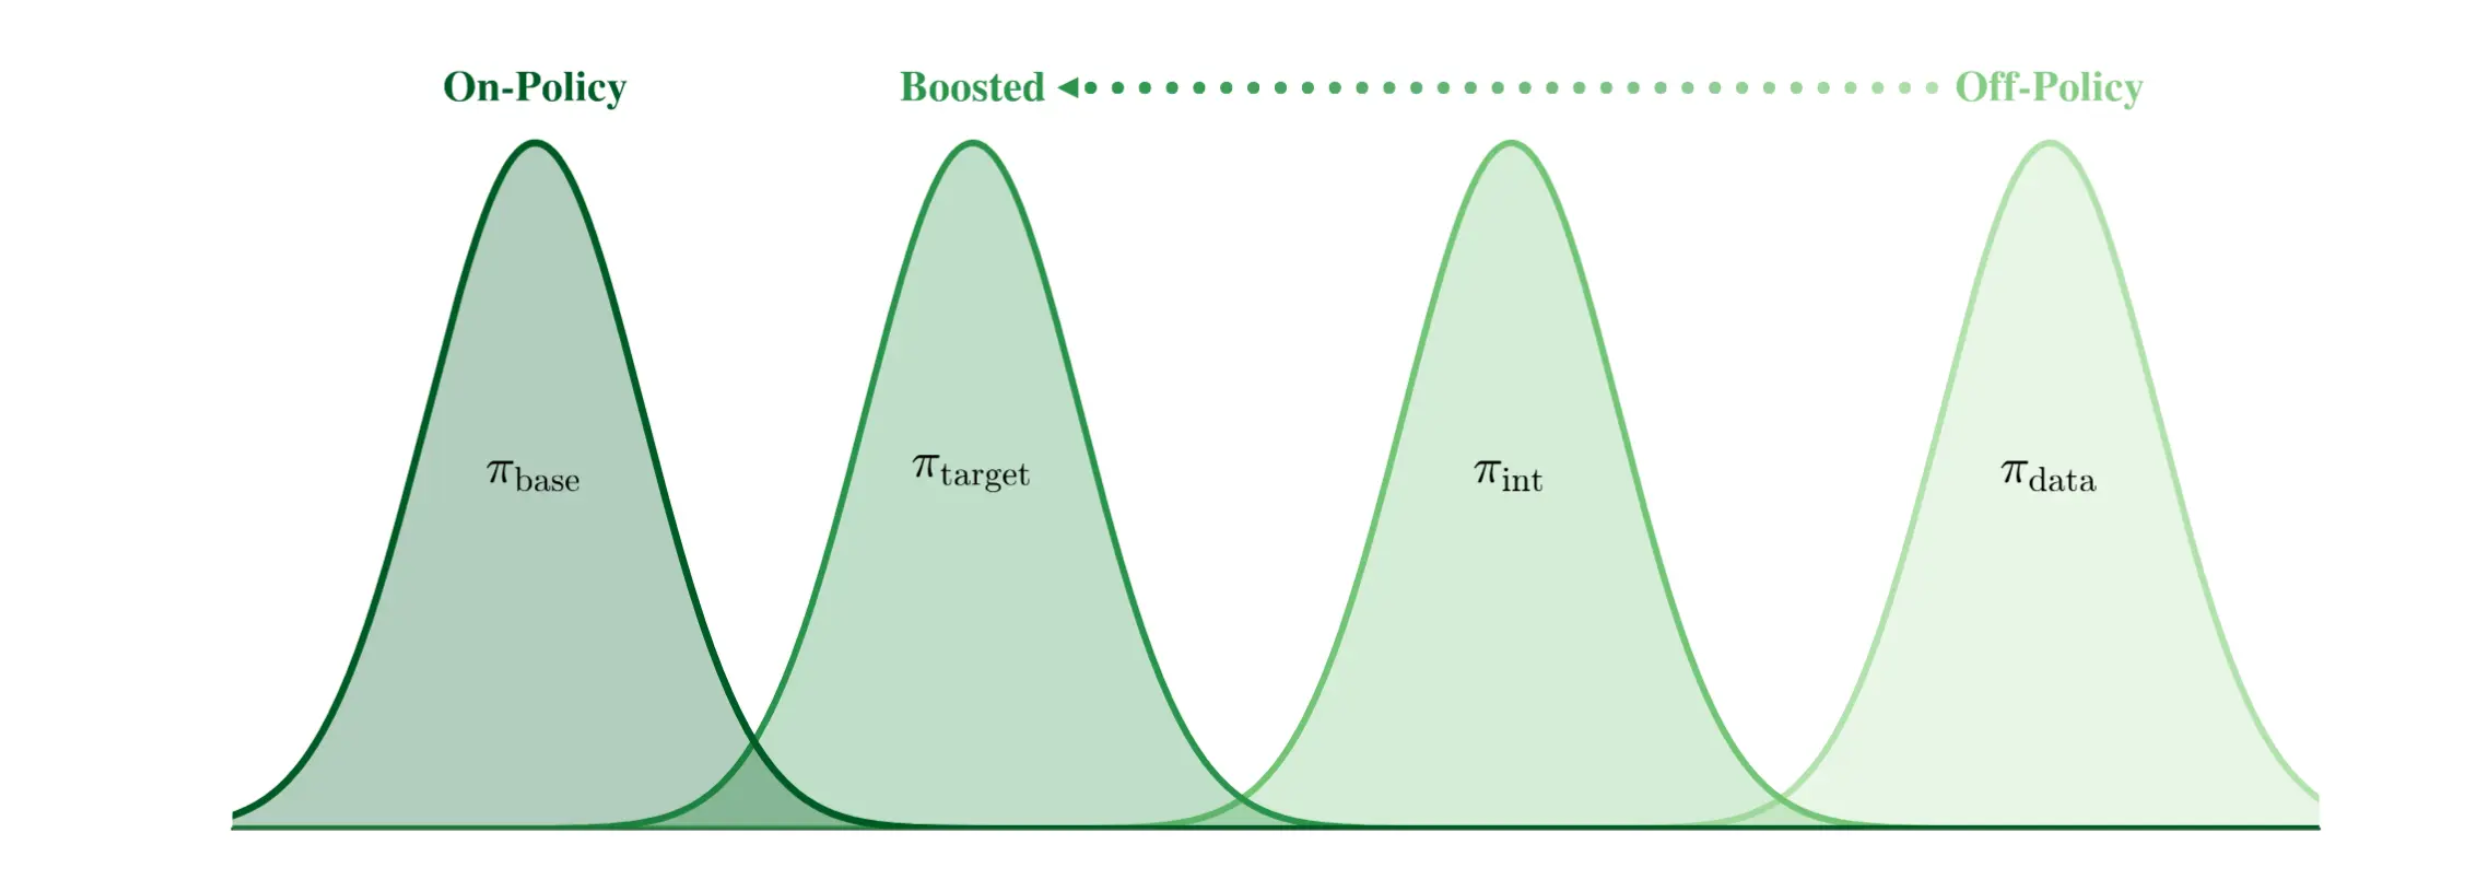
图2:玩具示意图。我们的采样算法逐步将原始数据策略 π data \pi_{\text{data}} πdata 迁移到目标策略 π target \pi_{\text{target}} πtarget,该目标策略更接近基础模型分布 π base \pi_{\text{base}} πbase。
在本节中,我们提出一种采样算法,该算法在微调中将离策略专家数据映射得更接近基座模型分布。我们的过程形式化了将离策略信息插值到在策略学习中的做法,如第 1 节所强调。为了构建一个最容易被基座模型内化的信息等价数据集,我们必须提供一种生成策略,该策略以最小的 K L \mathrm{KL} KL 散度保持这一信息。这指定了一个目标数据生成分布,因此,剩下要做的就是明确提供一种从该分布采样的算法。本节其余部分组织如下。第 4.1 节给出我们的形式化,用以指定这一(未归一化的)提升后的目标数据策略。第 4.2 节介绍一种马尔可夫链蒙特卡洛(MCMC)算法,该算法近似地从该策略中采样,并确保我们的采样过程产生逐步更接近基座模型分布的生成策略。最后,第 4.3 节概述我们针对 LLMs 对该算法的实现。
4.1 以信息投影为目标
假设给定一个专家查询-轨迹对数据集 D = { ( q i , x i ) } i = 1 N D = \{(q_i, x_i)\}_{i=1}^{N} D={(qi,xi)}i=1N。为记号方便,在本节剩余部分,我们固定某个 i i i 对应的查询 q i q_i qi,并假设所有分布都隐式地以 q i q_i qi 为条件。通过拼接 1 ≤ i ≤ N 1 \le i \le N 1≤i≤N 上的条件分布,我们可以轻松解除这一假设。
对于给定的轨迹等价关系,令 C C C 定义所有与相应专家轨迹 x i x_i xi 等价的轨迹 x ∈ X ∗ x \in X^* x∈X∗ 的集合。出于理论目的,我们先验地假设这种等价关系存在;然而在实践中, C C C 指一种任务相关的"正确性"或"语义等价"概念。例如,对于数学/科学推理,语义等价的轨迹 x x x 指任何利用专家轨迹 x i x_i xi 中的信息并得到正确最终答案的轨迹。对于事实学习,语义等价的 x x x 必须包含与 x i x_i xi 相同的事实内容,这由自动化(LLM)评分器判定。
定义 1。令 P C P_C PC 表示所有在 C C C 上具有条件支撑的、定义于词元序列 X ∗ X^* X∗ 上的分布构成的空间:也就是说,对于策略 π ∈ P C \pi \in P_C π∈PC,若 x ∉ C x \notin C x∈/C,则 π ( x ) = 0 \pi(x)=0 π(x)=0。换言之,非正式地说, P C P_C PC 是所有仅输出与专家轨迹等价的轨迹的分布之集合。
我们的设定自然允许一个定义明确的形式化体系来提升离策略数据。专家轨迹数据集本身是从某个任意策略 q ∈ P C q \in P_C q∈PC 中抽取的,这意味着 SFT 目标(2)最小化交叉熵 E q − log p \mathbb{E}_q-\\log p Eq−logp。然而,对于任意的 q q q,该目标可能任意地是离策略的。鉴于我们希望用尽可能在策略的轨迹来保留 D D D 的信息信号,这等价于寻找 P C P_C PC 中最接近基座模型分布 p p p 的分布。
定义 2。 p p p 到 P C P_C PC 的信息投影 Csiszár, 1975 定义为
p C : = arg min π ∈ P C K L ( π ∥ p ) . ( 3 ) p_C := \arg\min_{\pi \in P_C} \mathrm{KL}(\pi \parallel p). \quad (3) pC:=argπ∈PCminKL(π∥p).(3)
命题 1。唯一最小化目标(3)的分布是基座模型在等价轨迹上的限制:
p C ( x ) = p ( x ) ⋅ 1 x ∈ C ∑ x ′ ∈ X ∗ p ( x ′ ) ⋅ 1 x ′ ∈ C , p_C(x) = \frac{p(x) \cdot \mathbf{1}{x \in C}}{\sum{x' \in X^*} p(x') \cdot \mathbf{1}_{x' \in C}}, pC(x)=∑x′∈X∗p(x′)⋅1x′∈Cp(x)⋅1x∈C,
其中 1 x ∈ C \mathbf{1}_{x \in C} 1x∈C 在 x ∈ C x \in C x∈C 时取值为 1,否则为 0。
证明。注意到对于任意 π ∈ P C \pi \in P_C π∈PC,有
K L ( π ∥ p ) = ∑ x ∈ X ∗ π ( x ) log π ( x ) p ( x ) = ∑ x ∈ C π ( x ) log π ( x ) p ( x ) , \mathrm{KL}(\pi \parallel p) = \sum_{x \in X^*} \pi(x) \log \frac{\pi(x)}{p(x)} = \sum_{x \in C} \pi(x) \log \frac{\pi(x)}{p(x)}, KL(π∥p)=x∈X∗∑π(x)logp(x)π(x)=x∈C∑π(x)logp(x)π(x),
因为若 x ∉ C x \notin C x∈/C,则 π ( x ) = 0 \pi(x)=0 π(x)=0。现在 π \pi π 定义了 x ∈ C x \in C x∈C 上的分布,但 p p p 在限制到正确轨迹上并未归一化。然而,对于 x ∈ C x \in C x∈C,我们可以将 p ( x ) p(x) p(x) 重写为 p ( x ) = Z ⋅ p C ( x ) p(x)=Z \cdot p_C(x) p(x)=Z⋅pC(x),其中 Z = ∑ x ′ ∈ C p ( x ′ ) Z=\sum_{x' \in C} p(x') Z=∑x′∈Cp(x′),因此 K L ( π ∥ p ) \mathrm{KL}(\pi \parallel p) KL(π∥p) 简化为
∑ x ∈ C π ( x ) log π ( x ) Z ⋅ p C ( x ) = − log Z + ∑ x ∈ C π ( x ) log π ( x ) p C ( x ) = K L ( π ∥ p C ) − log Z , ( 4 ) \sum_{x \in C} \pi(x) \log \frac{\pi(x)}{Z \cdot p_C(x)} = -\log Z + \sum_{x \in C} \pi(x) \log \frac{\pi(x)}{p_C(x)} = \mathrm{KL}(\pi \parallel p_C) - \log Z, \quad (4) x∈C∑π(x)logZ⋅pC(x)π(x)=−logZ+x∈C∑π(x)logpC(x)π(x)=KL(π∥pC)−logZ,(4)
因为 ∑ x ∈ C π ( x ) = 1 \sum_{x \in C} \pi(x)=1 ∑x∈Cπ(x)=1,且 π \pi π 和 p C p_C pC 都定义了 C C C 上的分布。于是,由于 log Z \log Z logZ 是独立于 π \pi π 的常数,可知该表达式在 π = p C \pi=p_C π=pC 处唯一取得最小值,得证。
未归一化的投影 p C ( x ) ∝ p ( x ) ⋅ 1 x ∈ C p_C(x) \propto p(x) \cdot \mathbf{1}_{x \in C} pC(x)∝p(x)⋅1x∈C 因此是我们的目标分布,因为它是既最接近基座模型、又保持离策略专家轨迹信息内容的分布。当然,如果基座模型 p p p 自身能够可靠地生成专家轨迹,那么从 p C p_C pC 采样的最简单方法就是直接执行拒绝采样;这已经适用于一种初步形式的在策略 RL Xiong et al., 2025。
然而,我们感兴趣的是拒绝采样不可行、且仅通过基座模型难以获得专家轨迹的情形。那么,我们现在的任务如下:在可通过数据集轨迹访问任意初始专家策略 q q q 的情况下,我们能否通过算法将从 q q q 得到的样本演化为信息等价但更在策略的、来自 p C p_C pC 的样本?
4.2 Metropolis-Hastings 算法
我们确实可以,通过借助马尔可夫链蒙特卡洛(MCMC)近似采样技术。具体来说,我们将使用 Metropolis-Hastings(MH)采样器 Metropolis et al., 1953, Hastings, 1970,它利用提议分布 κ ( x ∣ x i ) \kappa(x \mid x_i) κ(x∣xi) 构造样本序列 ( x 0 , x 1 , ... , x n ) (x_0, x_1, \ldots, x_n) (x0,x1,...,xn) 的马尔可夫链,以选择下一个候选 x i + 1 x_{i+1} xi+1。以概率 A ( x , x i ) = min ( 1 , p C ( x ) ⋅ κ ( x i ∣ x ) p C ( x i ) ⋅ κ ( x ∣ x i ) ) , (5) A(x, x_i) = \min\left(1, \frac{p_C(x) \cdot \kappa(x_i \mid x)}{p_C(x_i) \cdot \kappa(x \mid x_i)}\right), \tag{5} A(x,xi)=min(1,pC(xi)⋅κ(x∣xi)pC(x)⋅κ(xi∣x)),(5) 候选 x x x 被接受为 x i + 1 x_{i+1} xi+1;否则,MH 设置 x i + 1 = x i x_{i+1} = x_i xi+1=xi。一个经典事实是,当 n → ∞ n \to \infty n→∞ 时,该过程收敛到从目标分布 p C p_C pC 采样,前提是该马尔可夫链满足以下性质: 定义 3。提议分布 κ \kappa κ 是不可约的,如果在诱导的马尔可夫链下,对于目标分布 p C p_C pC 下具有非零质量的任意状态 x , x ′ x, x' x,x′,从 x x x 出发经过若干步转移到 x ′ x' x′ 的概率非零。该提议是非周期的,如果诱导的样本链不会在固定间隔步数后返回同一样本。 由于我们给定了一个专家轨迹数据集,我们希望用这样一条轨迹初始化马尔可夫链,并将注意力限制在确保对所有 i i i 都有 x i ∈ C x_i \in C xi∈C 的提议分布 κ C \kappa_C κC 上。我们将此类提议分布称为信息保持的。 尽管这似乎可能违反不可约性准则,但请注意我们可以将 (5) 改写如下: A ( x , x i ) = min ( 1 , p ( x ) ⋅ κ ( x i ∣ x ) ⋅ 1 x ∈ C p ( x i ) ⋅ κ ( x ∣ x i ) ⋅ 1 x i ∈ C ) = min ( 1 , p ( x ) ⋅ κ C ( x i ∣ x ) p ( x i ) ⋅ κ C ( x ∣ x i ) ) . (6) A(x, x_i) = \min\left(1, \frac{p(x) \cdot \kappa(x_i \mid x) \cdot \mathbf{1}{x \in C}}{p(x_i) \cdot \kappa(x \mid x_i) \cdot \mathbf{1}{x_i \in C}}\right) = \min\left(1, \frac{p(x) \cdot \kappa_C(x_i \mid x)}{p(x_i) \cdot \kappa_C(x \mid x_i)}\right). \tag{6} A(x,xi)=min(1,p(xi)⋅κ(x∣xi)⋅1xi∈Cp(x)⋅κ(xi∣x)⋅1x∈C)=min(1,p(xi)⋅κC(x∣xi)p(x)⋅κC(xi∣x)).(6) 假设当前候选 x i ∈ C x_i \in C xi∈C,如果新候选 x ∉ C x \notin C x∈/C,则接受比率默认为 0。特别地:命题 2。使用不可约提议 κ \kappa κ 和目标分布 p C p_C pC 运行 Metropolis-Hastings,等价于使用信息保持提议 κ C \kappa_C κC 和目标分布 p p p 运行 MH。 这为我们提供了一个便捷的方法来增强离策略数据集:在专家轨迹处初始化,用某个信息保持提议分布 κ C \kappa_C κC 对候选进行变异,并使用 (6) 接受或拒绝候选。事实上,该过程不仅最终收敛到 p C p_C pC,而且保证数据生成策略与基础模型之间的策略差距逐步减小。 命题 3。对于所有 k ≥ 0 k \ge 0 k≥0,令 π k \pi_k πk 表示对初始专家策略 q q q 应用 k k k 步 MCMC 后得到的候选分布。则有 K L ( π k + 1 ∥ p ) ≤ K L ( π k ∥ p ) . (7) \mathrm{KL}(\pi_{k+1} \parallel p) \le \mathrm{KL}(\pi_k \parallel p). \tag{7} KL(πk+1∥p)≤KL(πk∥p).(7) 证明。令 Ψ \Psi Ψ 表示 MCMC 转移核;即,通过应用我们 Metropolis-Hastings 过程的一步所诱导的变换。 Ψ \Psi Ψ 具有平稳分布 p C p_C pC,因此 Ψ ( p C ) = p C \Psi(p_C) = p_C Ψ(pC)=pC。由于 Ψ \Psi Ψ 是马尔可夫的,由数据处理不等式可得 K L ( π k + 1 ∥ p C ) = K L ( Ψ ( π k ) ∥ Ψ ( p C ) ) ≤ K L ( π k ∥ p C ) . (8) \mathrm{KL}(\pi_{k+1} \parallel p_C) = \mathrm{KL}(\Psi(\pi_k) \parallel \Psi(p_C)) \le \mathrm{KL}(\pi_k \parallel p_C). \tag{8} KL(πk+1∥pC)=KL(Ψ(πk)∥Ψ(pC))≤KL(πk∥pC).(8) 现在,对于任意 π \pi π,回想 (4) 可知,对于某个固定常数 Z Z Z,有 K L ( π ∥ p C ) = K L ( π ∥ p ) + log Z \mathrm{KL}(\pi \parallel p_C) = \mathrm{KL}(\pi \parallel p) + \log Z KL(π∥pC)=KL(π∥p)+logZ,因此可得 K L ( π k + 1 ∥ p ) ≤ K L ( π k ∥ p ) \mathrm{KL}(\pi_{k+1} \parallel p) \le \mathrm{KL}(\pi_k \parallel p) KL(πk+1∥p)≤KL(πk∥p),如所断言。 换句话说,Metropolis-Hastings 过程逐步将原始专家策略转变为信息等价的策略,这些策略逐渐更接近基础模型分布。
4.3 面向 LLM 的投影采样
如 Karan 和 Du 2025 所述,直接为 LLM 实现 Metropolis-Hastings 是不可行的,因为它需要通过重复的 LLM 推理调用来重新生成全长的 token 序列。这种不可行性因缓慢混合而进一步加剧;在高维样本空间或提议与初始化选择不佳的情况下,收敛可能需要指数级数量的 MCMC 步。
为帮助避免这些问题,我们调整了 Karan 和 Du 2025 中用于幂采样的 Metropolis-Hastings 实现,并请读者参阅该文献以了解进一步细节。简言之,我们定义目标投影 p C p_C pC 在长度以块大小 B B B 为单位递增的序列上的限制分布。我们在每个分布内使用 Metropolis-Hastings 进行采样,从而为从下一个分布开始采样提供强初始化。完整细节见算法 1。
仍需定义一个合适的提议分布,因为这一关键对象有助于信息保持,并且是算法 1 中唯一与专家轨迹交互的组件。
为构造我们对 κ C \kappa_C κC 的选择,我们使用 Qu 等 2026、Shenfeld 等 2026 中也使用的一种技巧,该技巧利用了预训练 LLM 强大的上下文指令遵循能力。假设给定候选 x = ( x 0 , ⋯ , x L ) x = (x_0, \cdots, x_L) x=(x0,⋯,xL)。我们的提议分布均匀随机地选择一个索引 t ∈ 1 , L t \in 1, L t∈1,L,并通过截断 t t t 之后的后缀来创建部分轨迹: x ~ = ( x 0 , ⋯ , x t ) \tilde{x} = (x_0, \cdots, x_t) x~=(x0,⋯,xt)。然后,我们将该部分轨迹与专家轨迹 τ \tau τ 一起作为上下文传入一个简单的提示模板,该模板类似于 Qu 等 2026 中使用的模板:
markdown
给定一个问题、一个专家解答以及一个初始的部分回答。请审阅该解答,识别推理过程中提供的所有信息。问题:<QUERY> 这是针对该查询的专家解答:<TRAJECTORY> 以下是一个部分回答:<PARTIAL TRACE> 从该部分回答开始,用你自己的话继续,包括思考过程。确保你的回答与专家解答在逻辑上一致,并得出完整且正确的最终答案。

仅返回翻译后的文本。不要提供解释、注释、评论、引号或任何其他附加内容。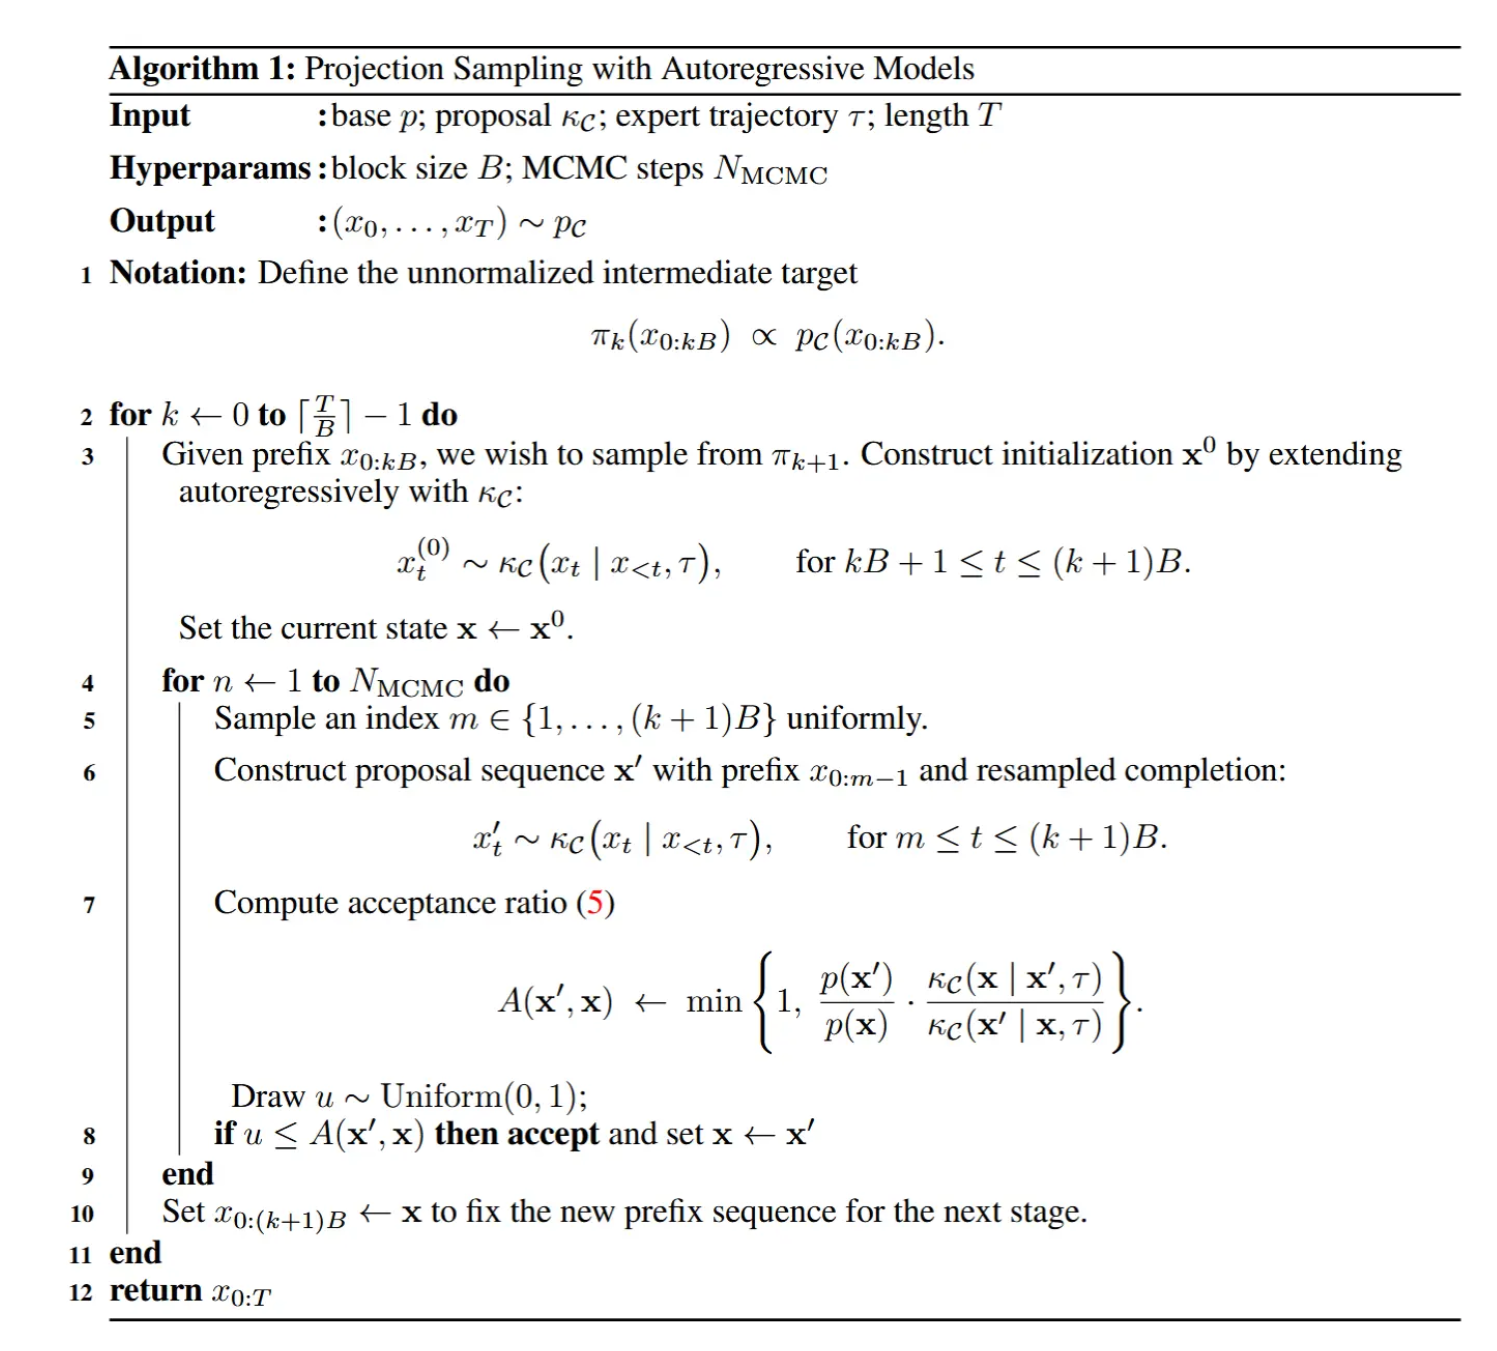
那么,我们的提议 κ C \kappa_C κC 就是通过将基础模型 p p p 以此提示为条件而定义的分布。在实践中,我们发现该提示足以从专家演示中生成正确的轨迹,从而满足信息保持约束。在确定这最后一部分后,为了构建用于微调的增强数据集,我们只需将算法 1 应用于专家数据集 D D D 中的每个查询-轨迹对。关于不同模型和数据集上的增强轨迹示例,见附录 A。由于我们的 Metropolis-Hastings 过程的目标是在给定信息约束 C C C 的情况下从信息投影中采样,我们将该采样算法称为投影采样。与 Karan 和 Du 2025 中采样算法会产生推理时成本不同,投影采样仅产生一次性成本,因为它是在微调之前于训练数据集上进行的。为了量化这一成本,我们可以估计算法 1 所消耗的平均 token 数。对于每条轨迹 τ ∈ D \tau \in D τ∈D,每个 MCMC 步骤平均重采样 k B 2 \frac{kB}{2} 2kB 个 token,执行 N M C M C N_{\mathrm{MCMC}} NMCMC 次。求和可得
E c o s t = ∣ D ∣ ⋅ N M C M C ∑ k = 1 ⌈ T / B ⌉ k B 2 ≈ ∣ D ∣ ⋅ N M C M C T 2 4 B . (9) E_{\mathrm{cost}} = |D| \cdot N_{\mathrm{MCMC}} \sum_{k=1}^{\lceil T/B \rceil} \frac{kB}{2} \approx |D| \cdot \frac{N_{\mathrm{MCMC}} T^2}{4B}. \tag{9} Ecost=∣D∣⋅NMCMCk=1∑⌈T/B⌉2kB≈∣D∣⋅4BNMCMCT2.(9)
我们可以通过增大块大小 B B B 来降低成本,但一般而言,由于投影采样是固定成本,我们更偏好能提供更高分辨率和更小近似误差的较小块大小。
5 实验
我们现在通过实证表明,由我们的采样算法生成的轨迹使 SFT 能够突破其弱刻画,并经常优于现有的用于后训练的在策略学习算法。
5.1 实验设置
任务。我们选择一组学习任务,这些任务能够体现后训练试图引入的能力范围,包括新技能获取、推理和开放式专业知识。在以下讨论中,我们介绍三个任务。每个学习任务都配有专家轨迹,这些轨迹要么是数据集固有的,要么由 GPT-5 生成。
• 化学:我们考察预训练 LLM 是否能习得一组此前未经过显式微调的新技能。遵循 Shenfeld et al. 2026,我们以科学推理作为测试领域。在此设置中,我们使用 SciKnowEval Feng et al., 2024 的 Chemistry L-3 子集,其包含反应预测、摩尔质量计算和化学方程式配平等技能。此外,一些问题采用多项选择格式,而另一些(配平)为自由形式,代表一个混合数据集,其对在策略 RL 而言具有更难指定的奖励。总共有 2400 道题,其中 1800 道训练题和 600 道测试题。专家轨迹由 GPT-5 生成。
• 数学:我们研究具有某些通用数学能力的预训练 LLM 能否相较于基础模型提高在一组困难数学推理问题上的性能。在此设置中,我们使用 MATH Hendrycks et al., 2021 数据集,并限制在最难的问题类别:Level 3、4 和 5。总共有 9254 道题,其中 8230 道训练题和 1024 道测试题,且测试题配有现有专家解答。
• 医学:我们测试我们的方法在更具开放性、且不能像前两者那样即时验证的领域中是否有效。如同 Shenfeld et al. 2026,我们关注医学问答。我们使用 HuatuoGPT-o1 SFT 数据集 Chen et al., 2024,其提供 19704 个需要诊断、治疗和一般医学知识方面临床推理技能的问题,且每个问题都有一个提供的专家回答。为了评估,我们从 HuatuoGPT-o1 RL 数据集中均匀随机抽取 1000 个训练期间从未见过的问题。
模型。对于给定的后训练任务,我们选择来自不同模型家族和规模、且尚未在任务领域中表现熟练或经过微调的基座模型。对于化学,我们使用 Qwen2.5-7B-Instruct Yang et al., 2024 和 Olmo-3-7B-Instruct Team Olmo et al., 2025,它们分别达到 34.3% 和 32.8% 的测试集准确率。对于数学,我们使用 Qwen2.5-3B,其达到 31.5% 的测试准确率。最后,对于医学,我们使用 Qwen2.5-7B-Instruct,其达到 35.3% 的测试准确率。
评估。我们为每个任务纳入若干基准,以整体衡量任务特定泛化能力和先前能力保持。所有基准均基于单次准确率评分。
• 化学:我们使用 SciKnowEval 的测试集衡量领域内泛化能力。为衡量先前能力,我们在数学基准 AMC、MATH500 和 GSM8K Cobbe et al., 2021 以及 MMLU Hendrycks et al., 2020 和 GPQA Rein et al., 2024 上评估。
• 数学:为衡量泛化能力,我们跟踪在测试集 MATH(3,4,5) 上的性能,以及在 AMC、MATH500 和 GSM8K 上的分布外泛化性能。为跟踪先前能力,我们在 MMLU、Chemistry 和 GPQA 上评估。
• 医学:由于医学推理是更开放的领域,我们使用自动 LLM 评分器(GPT-5-mini)评估测试集上的正确性(确切的评分提示见附录 C.3)。对于能力保持,我们评估 AMC、MATH500、GSM8K、MMLU 和 GPQA。
基线。对于每个任务,我们将方法与多种后训练算法进行基准比较,范围从普通 SFT 到通过 RL 和自蒸馏利用特权信息的在策略学习。
• 化学:我们将本方法在该任务所有评估上的表现与基座模型、使用专家数据集轨迹的 SFT,以及使用我们的采样提议提示重写每条专家轨迹的 SFT 变体(即"0 阶 MCMC")进行比较。此外,我们纳入在策略自蒸馏(OPSD)Shenfeld et al., 2026, Zhao et al., 2026,其以特权信息为条件从基座模型进行蒸馏。
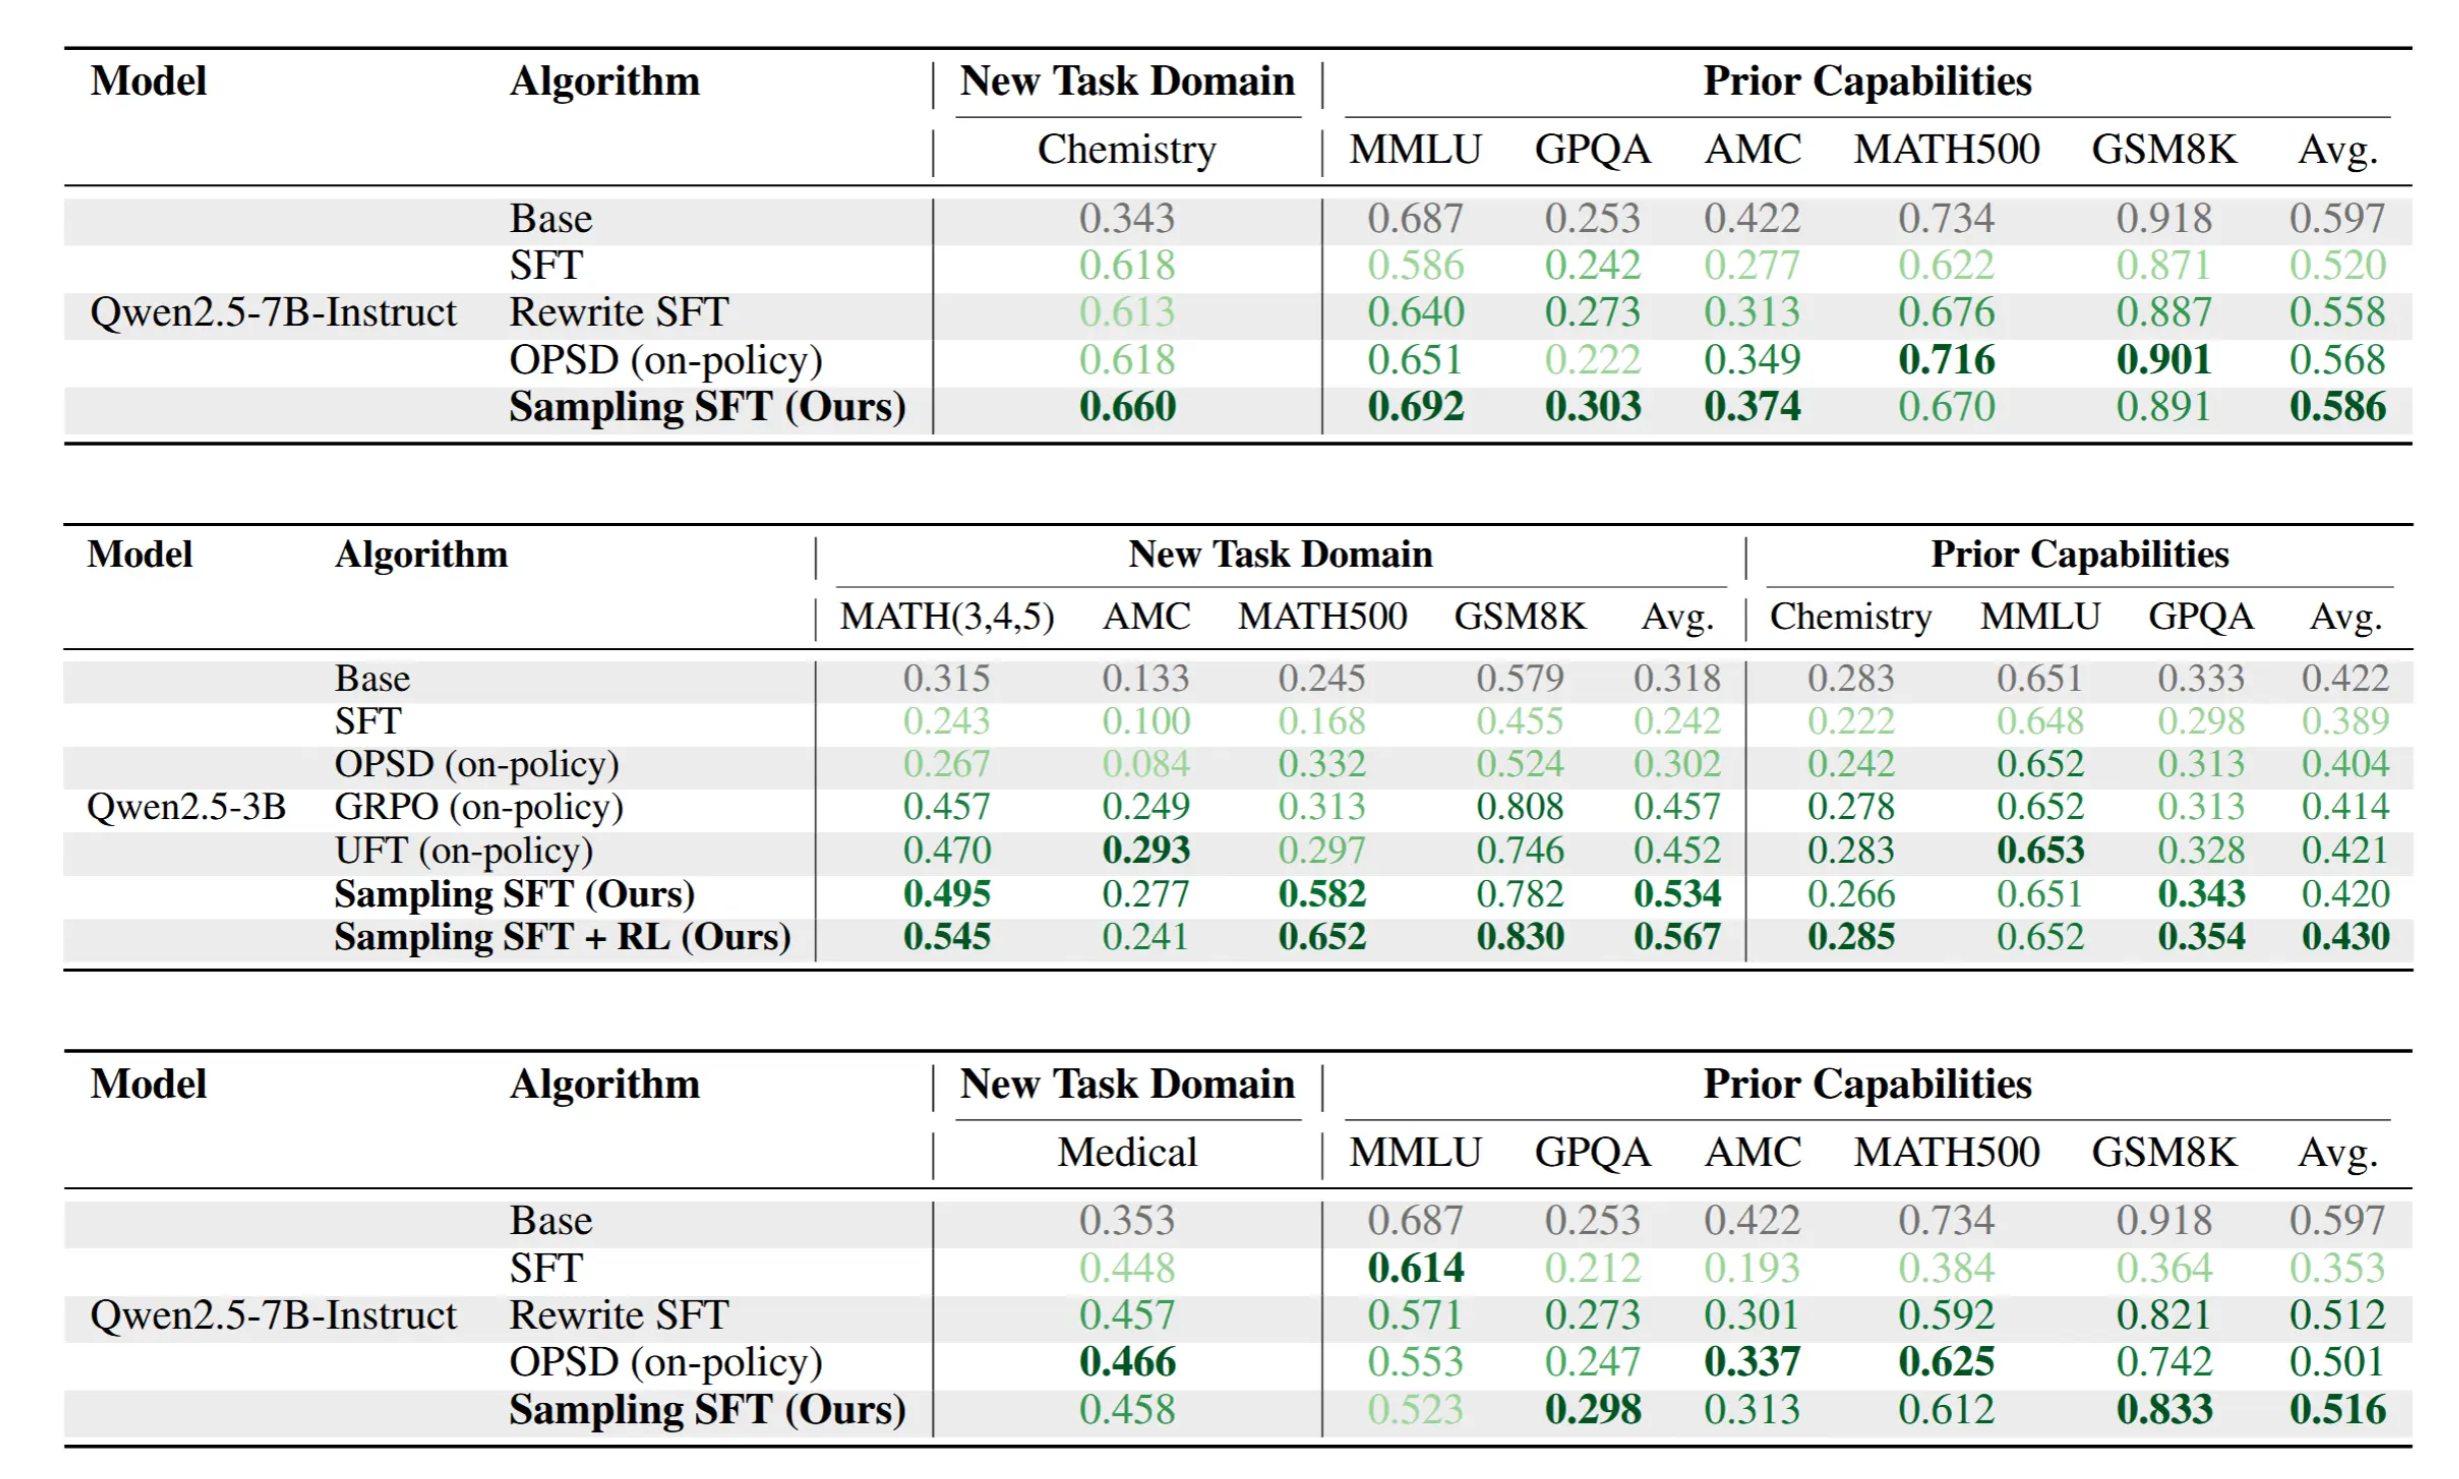
表 1:采样使 SFT 能更好地泛化,同时遗忘更少。上:Qwen2.5-7BInstruct 上的化学。中:Qwen2.5-3B 上的数学。下:Qwen2.5-7B-Instruct 上的医学。我们将每一列中的最高分加粗,对于数学,如果我们所列方法之一优于其他基线,也将其加粗,并用颜色渐变强调数值差距。在不同模型规模和评估任务中,采样始终使 SFT 能够泛化并保留先验能力,其表现至少不逊于、甚至优于其同策略后训练对应方法。
• 数学:我们使用化学中所用的基线以及两个 RL 基线,因为 rollout 易于验证。我们纳入 GRPO Shao et al., 2024 以及更强的变体 UFT Liu et al., 2025,后者在 rollout 生成期间将离策略专家轨迹用作特权信息。 • 医学:与化学相同的基线。 采样。对于所有数据集,我们使用块数 B = 32 B = 32 B=32、最大序列长度 T = 1856 T = 1856 T=1856,并运行 N M C M C = 10 N_{\mathrm{MCMC}} = 10 NMCMC=10 个 MCMC 步骤。 训练。对于所有任务,所有 SFT 训练运行都在相应范围内使用以下超参数进行调优:轮数: { 1 , 2 } \{1, 2\} {1,2},学习率: { 5 × 10 − 5 , 1 × 10 − 5 , 5 × 10 − 6 } \{5 \times 10^{-5}, 1 \times 10^{-5}, 5 \times 10^{-6}\} {5×10−5,1×10−5,5×10⁻⁶},以及批量大小: { 16 , 32 , 64 } \{16, 32, 64\} {16,32,64}。对于医学任务,我们将轮数范围扩展到 { 1 , 2 , 4 , 6 } \{1, 2, 4, 6\} {1,2,4,6},以适应更大的数据集。优化器为 AdamW,使用余弦调度器,并对范数大于 1 1 1 的情况进行梯度裁剪。在策略自蒸馏运行使用来自 Shenfeld et al., 2026 的超参数进行调优,而 RL 基线使用来自 Liu et al., 2025 的默认超参数。所有模型均使用 H100 和 H200 训练。
5.2 主要结果
我们在表 1 中展示 Qwen 模型系列的主要结果。关于 Olmo 的结果,见第 5.3 节和附录 B。 更强的泛化能力。在不同预训练基础模型和不同任务上,我们看到投影采样使 SFT 在评估微调所引入的新能力时能够取得极其强劲的性能。在化学中,采样 SFT 能够将基础模型在化学上的性能提升 + 31.7 % +31.7\% +31.7%,甚至比在策略 OPSD 所带来的提升还高出 + 4.20 % +4.20\% +4.20%。对离策略轨迹进行简单的零样本重写在此设置下表现不那么强,这表明算法 1 中完整 MCMC 过程的重要性。 数学推理生动地表明,能力增益也会迁移到相邻的分布外测试领域。普通 SFT 在数学基准中导致性能全面下降,而采样 SFT 在 MATH 基准中最难的问题上带来 + 18.0 % +18.0\% +18.0% 的提升,甚至超过 GRPO 和 UFT 所获得的推理提升。这扩展到 AMC 上 + 14.4 % +14.4\% +14.4% 的提升以及 GSM8K 上 + 20.3 % +20.3\% +20.3% 的提升,与任一 RL 算法所获得的提升相当。MATH500 上的性能增益尤其显著,为基础模型带来 + 33.7 % +33.7\% +33.7% 的提升,并比表现次优的(RL)基线高出 + 26.9 % +26.9\% +26.9%。 采样 SFT 模型不仅泛化良好,还为 RL 提供了强有力的初始化,从而带来进一步提升。在表 1 的数学部分,我们记录了用采样 SFT 检查点初始化的 GRPO(Sampling SFT-RL),并观察到它是总体上表现最强的模型,在 MATH500 上达到 + 40.7 % +40.7\% +40.7% 的性能,在 GSM8K 上达到 + 25.1 % +25.1\% +25.1% 的性能:接近 7B-Instruct 模型。 仅使用离策略专家轨迹时,SFT 可能无法很好地泛化。但与我们采样算法结合后,SFT 可以展现出极其强大的泛化能力,甚至优于 RL 和 OPSD 基线。这一采样过程是针对基础模型分布定制的事实至关重要:附录 B 详细给出了结果,表明例如使用相同基础任务数据微调 Qwen,但这些数据是为 Olmo 增强的,会严重不如所有基线。 保留先验能力。这种强大的泛化能力并非以灾难性遗忘为代价。对于表 1 中的化学任务,普通 SFT 导致能力大幅下降。与此同时,采样 SFT 没有损失任何 MMLU 知识,并将先验任务准确率的平均损失降至仅 − 1.10 % -1.10\% −1.10%。事实上,即使将 OPSD 包括在内,我们的模型遗忘也最少。这些结果在医学领域得到印证:采样挽回了普通 SFT 下平均先验能力 16.3 % 16.3\% 16.3% 的损失,并且同样在所有基线中遗忘最少。
5.3 分析
我们现在考察用于微调的采样轨迹的分布特性,以及所得模型能力的分布特性。 数据集似然。我们可以直接观察投影采样对专家轨迹的影响。
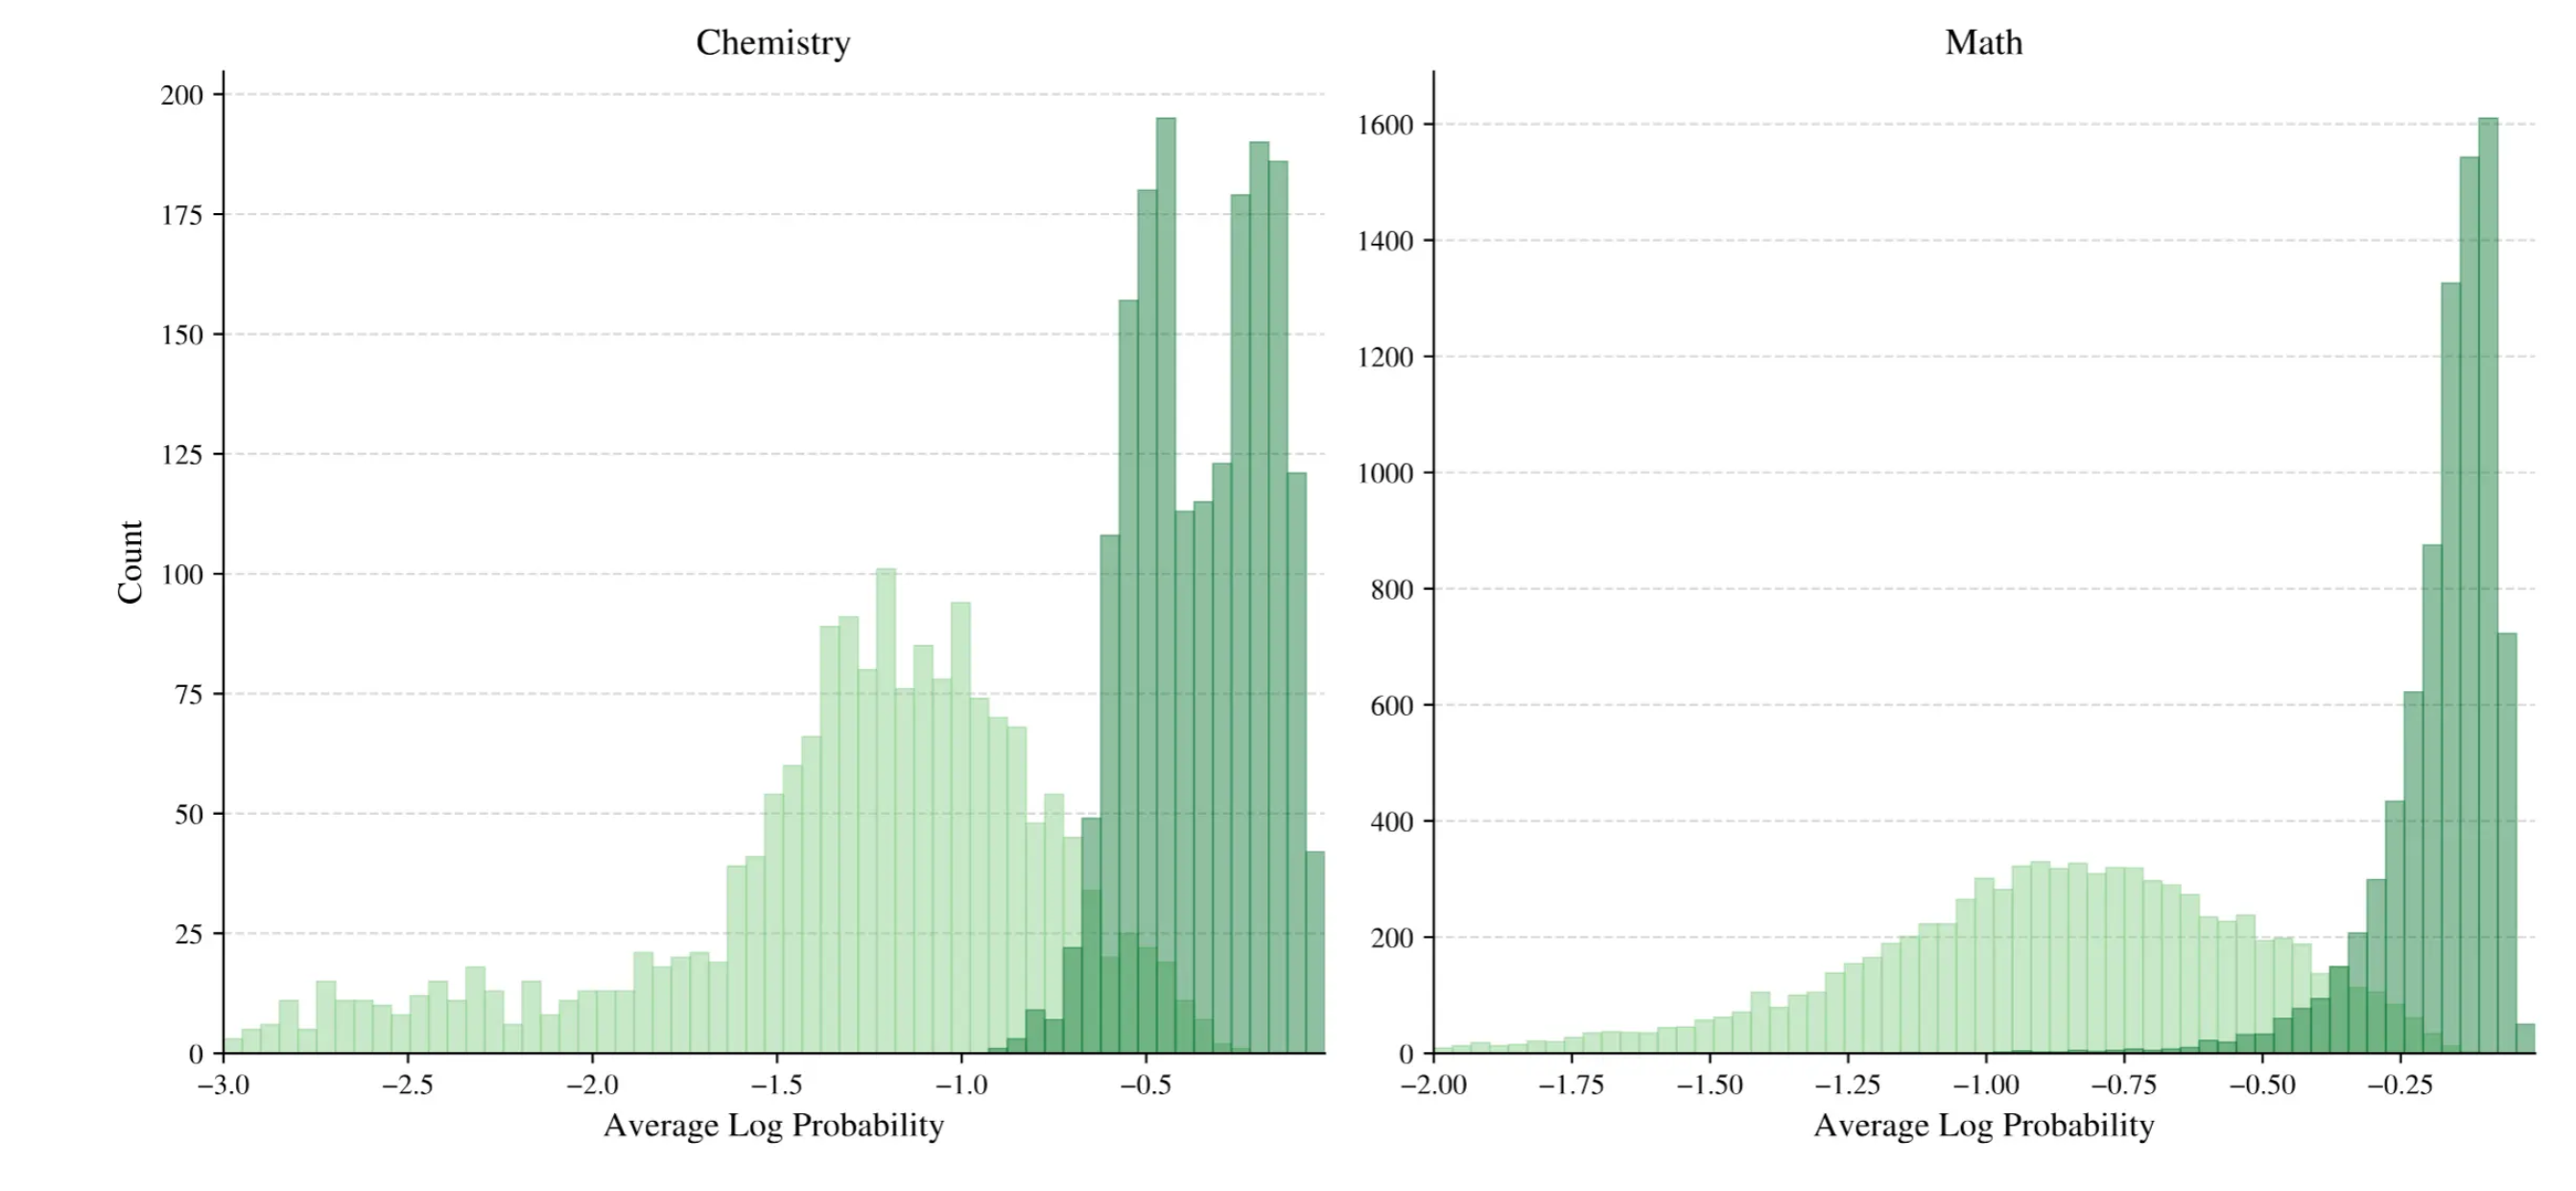
图3:投影采样的数据集似然度。我们绘制了化学和数学任务在各自对应的基础模型(Qwen2.5-7B-Instruct 和 Qwen2.5-3B)下,增强数据集轨迹的似然度。
图3 绘制了在基础模型下,专家轨迹和增强轨迹在科学和数学推理中的序列对数似然(按长度平均)直方图。同策略投影显而易见,产生的轨迹相对于基础模型具有高得多的似然,同时保持正确性。超越锐化的学习。在第1节中,我们强调了后训练的总体目标,即引入基础模型中不存在的根本性新能力。鉴于投影采样将离策略数据推向更接近分布内,我们的微调模型是否仍能获得超越单纯锐化既有能力的新行为?我们的回答是肯定的。在图4中,我们考察了 Olmo-3-7B-Instruct 在科学任务上相对于带采样的微调(我们的方法)以及带特权信息的同策略蒸馏(OPSD)的 pass@ k k k 准确率。如果使用我们的采样算法进行微调仅仅是在锐化既有能力,那么我们会预期我们的 pass@ k k k 曲线最终收敛到基础模型。然而,我们实际上观察到,在直至非常大的 k k k 的范围内, p a s s @ k \mathrm{pass}@k pass@k 率存在大而一致的差距,这表明我们的微调模型具有从根本上强于基座模型的能力。此外,对于 k > 2 k > 2 k>2,我们观察到我们的 p a s s @ k \mathrm{pass}@k pass@k 率相对于 OPSD 存在显著差距,这表明我们的方法能够使 OPSD 未学习到的学习能力成为可能。我们还可以在单个评估问题的层面上进行更细粒度的分析。换言之,我们可以识别出基座模型绝对无法解决的"难题"(对于最大的 k k k, p a s s @ k \mathrm{pass}@k pass@k 率为零),而我们的微调模型能够开始可靠地解决:事实上,一些评估任务从基座模型的零通过率变为高达 67.2 % 67.2\% 67.2% 或 53.1 % 53.1\% 53.1% 的通过率。扩展采样计算。命题 3 观察到,在投影采样中增加 MCMC 步数会导致数据生成策略 π k \pi_k πk 在 KL 散度上逐步更接近基座模型。这将采样框定为扩展计算的一个自然轴,即投入更多 MCMC 步以获取更多同策略学习数据。
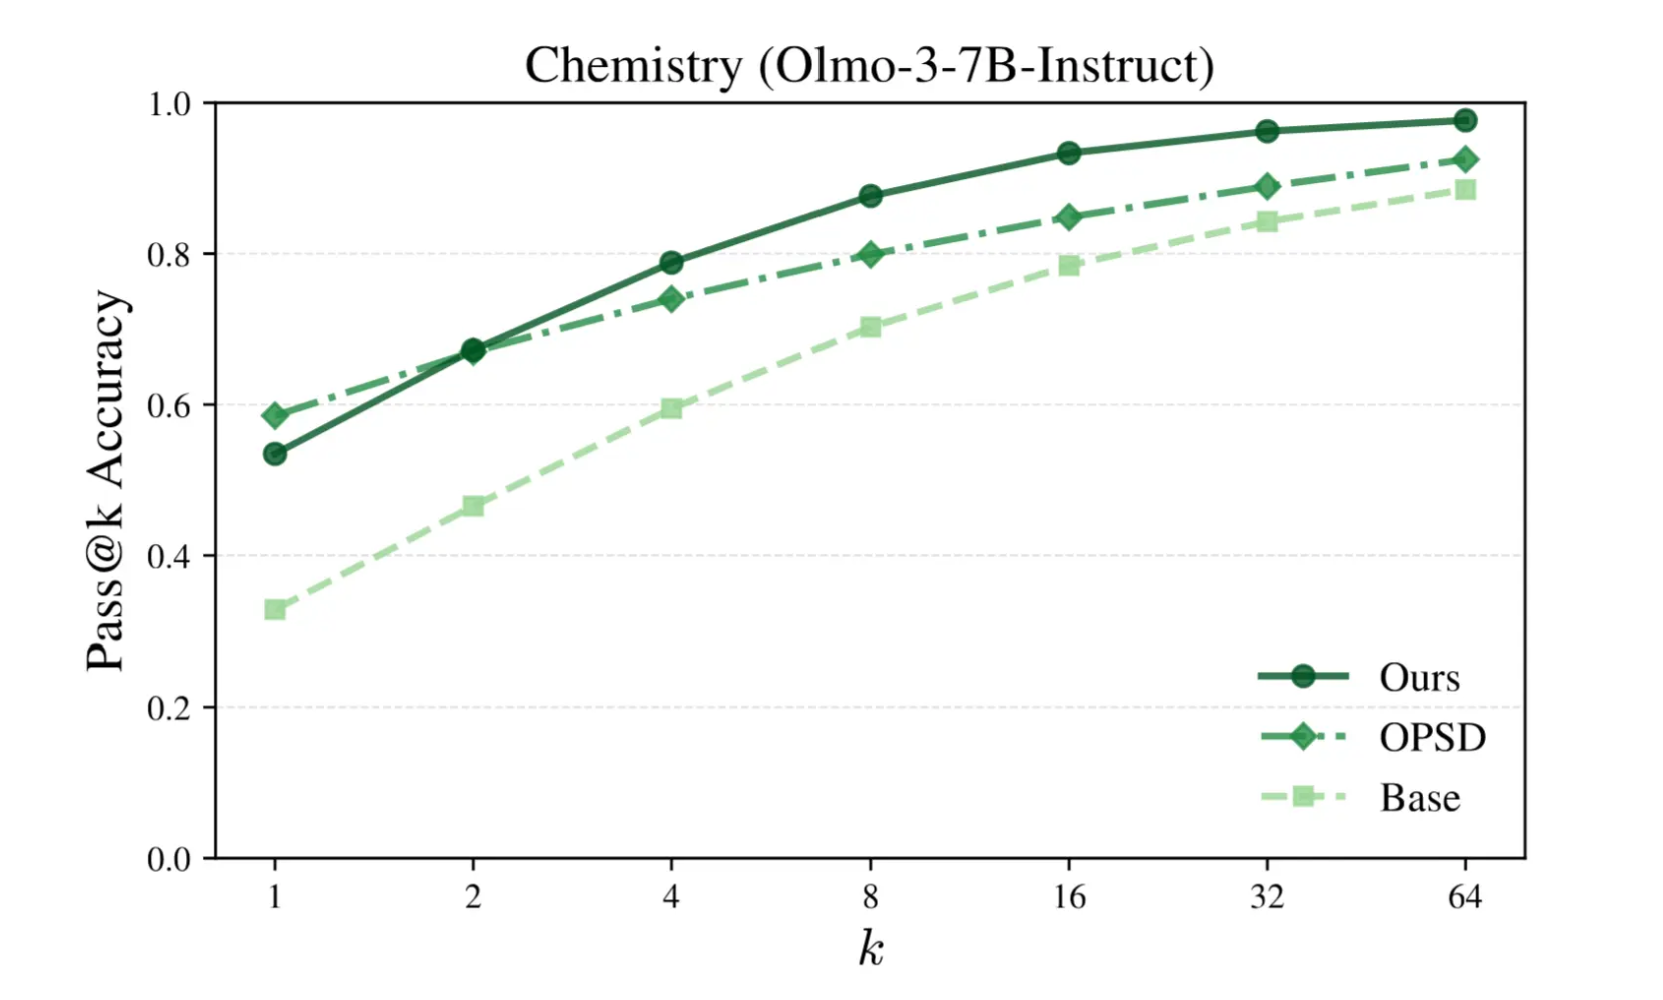
图 4:在 Chemistry(Olmo-3-7B-Instruct)上的 Pass@ k k k 性能。我们绘制了采用投影采样的 SFT(我们的方法)以及带特权信息的同策略学习(OPSD)相对于基础模型的 pass@ k k k 准确率(若 k k k 个样本中至少有一个样本正确,则视为正确)。我们的性能曲线严格优于 OPSD 和基础模型二者,并且在高 k k k 值下,我们的通过率同时超过基础模型和 OPSD 二者的通过率。
我们可以在图5中从经验上直接观察到这种缩放。对于科学任务上的基础模型 Qwen2.5-7B-Instruct,我们对离策略训练数据应用 k k k 个 MCMC 步,其中 k ∈ 0 , 2 , 4 , 6 , 8 , 10 k \in 0, 2, 4, 6, 8, 10 k∈0,2,4,6,8,10。注意, k = 0 k = 0 k=0 对应于一次数据重写,即要求基础模型仅将离策略数据"用自己的话"重写。在左侧纵轴上,我们绘制 K L ( π k ∥ π b a s e ) \mathrm{KL}(\pi_k \parallel \pi_{\mathrm{base}}) KL(πk∥πbase),其中 π k \pi_k πk 是由 k k k 个 MCMC 步诱导的数据生成策略。由于轨迹由以 LLM 为参数的提议分布(算法1中的 κ C ( ⋅ ∣ τ ) \kappa_C(\cdot \mid \tau) κC(⋅∣τ))重复生成,并从中可以提取下一 token 的对数概率,因此我们可以直接估计该 KL 散度。在右侧纵轴上,我们绘制每个 k k k 对应的、在提升后的数据上微调的基础模型的准确率。随着我们增加采样计算量,提升后的数据分布单调地缩小与基础模型之间的 KL 差距,而相应的微调模型在准确率上呈上升趋势。因此,从经验上看,更多的 MCMC 步会带来更多的在策略数据,从而在微调后获得更好的泛化。
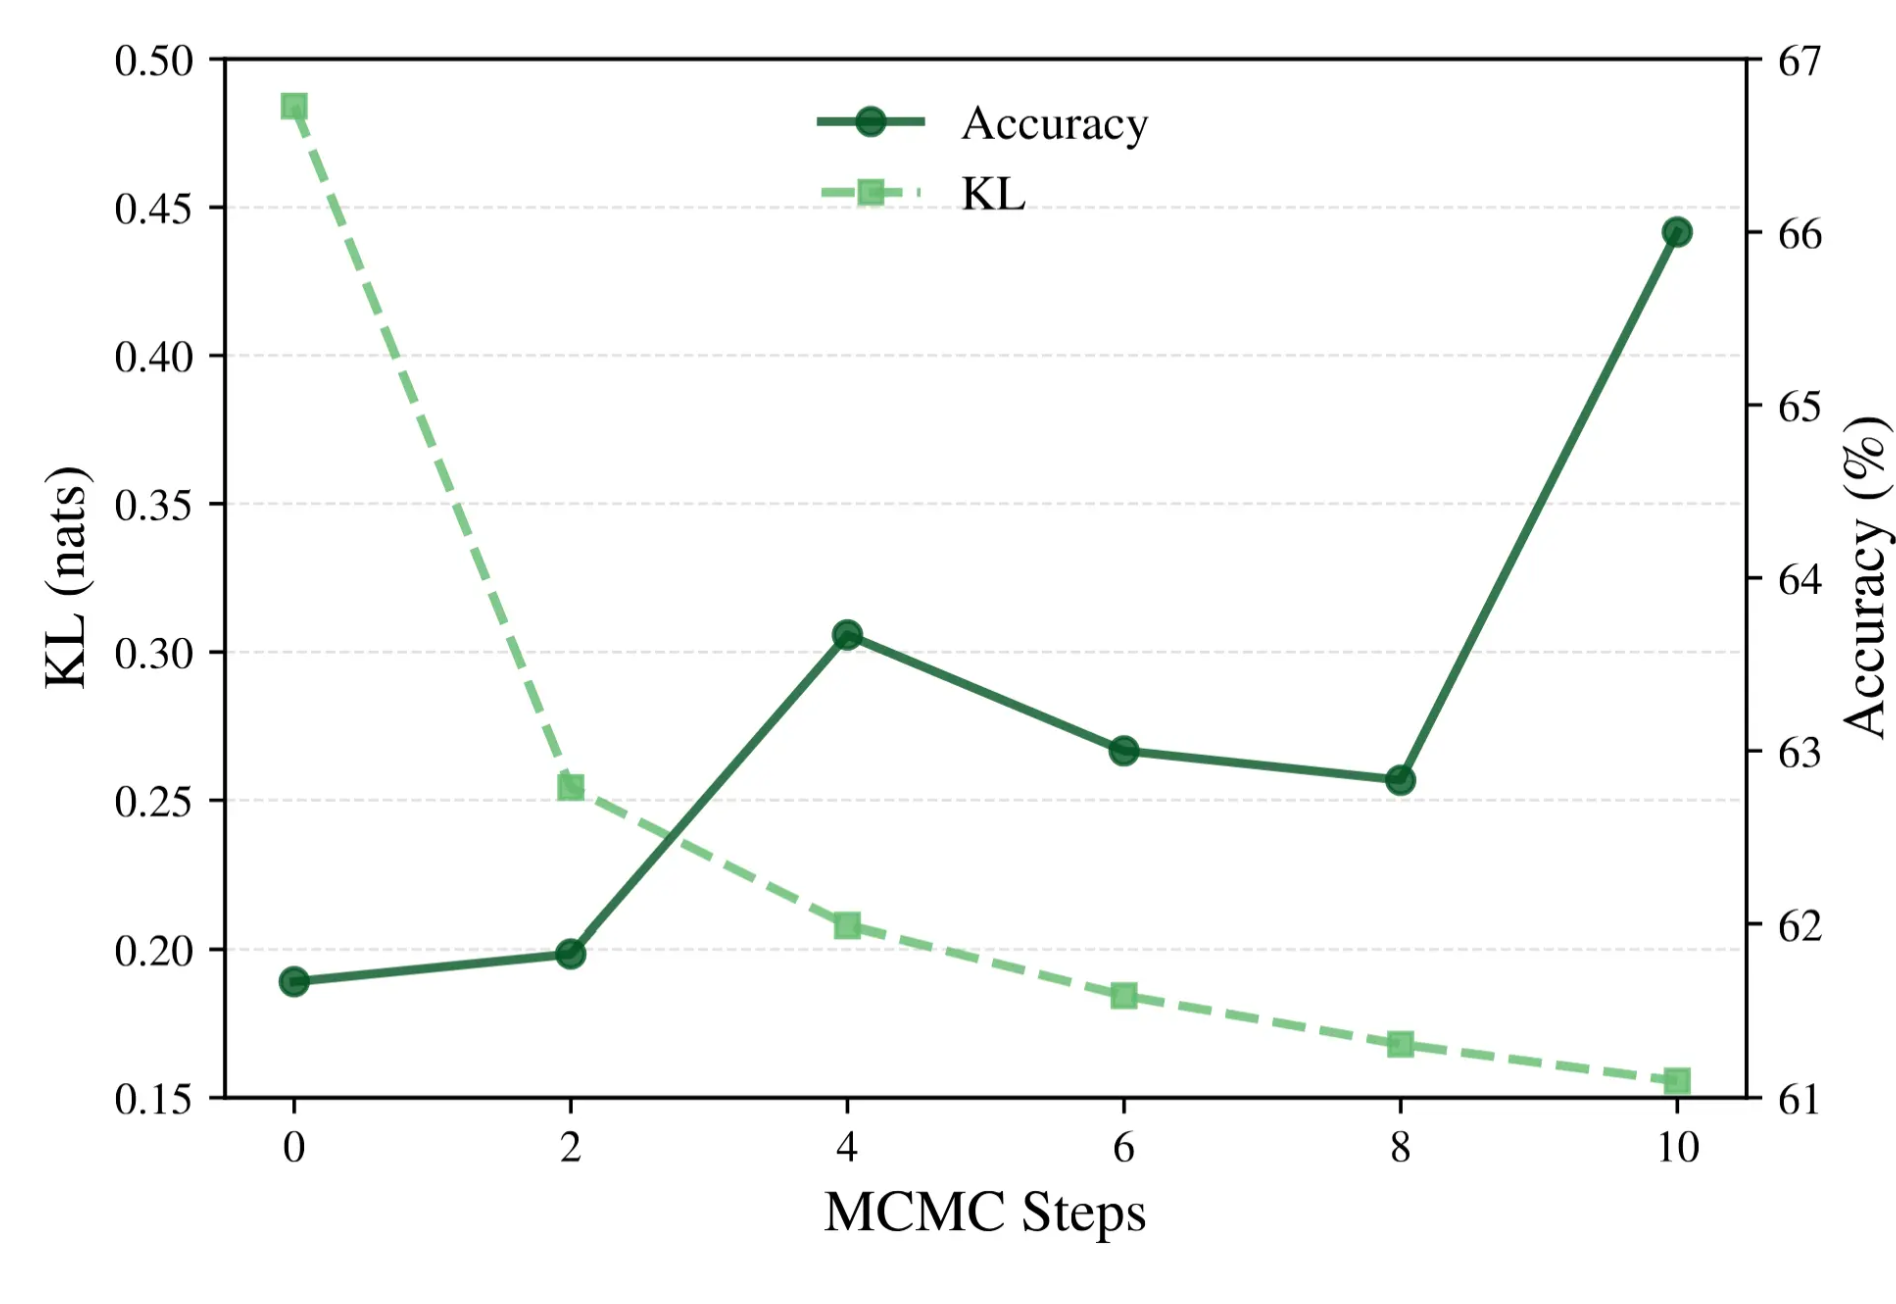
图 5:KL 散度 vs. 准确率 vs. MCMC 步数(Qwen2.5-7B-Instruct)。对于 k ∈ 0 , 2 , 4 , 6 , 8 , 10 k \in 0, 2, 4, 6, 8, 10 k∈0,2,4,6,8,10,我们既绘制增强数据分布与基础模型(Qwen2.5-7B-Instruct)的 KL 散度,也绘制在科学任务上微调的准确率。随着采样计算量增加,KL 差距减小,而准确率提高。
6 结论
在本工作中,我们引入了一种形式体系,弥合了特权离策略信息与在策略训练之间表面上的脱节。通过审慎地提升离策略专家数据的似然,使其朝基础模型的分布靠拢,我们获得了更具在策略性的等价物,其远更适合学习。事实上,在科学、数学推理和开放式专业知识领域,在增强数据上进行 SFT 能够比普通 SFT 以及强在策略基线(包括 RL 和自蒸馏)更好地泛化,且遗忘更少。所得模型还在多个样本上展现出较强的分布性能,并能够学习基础模型中不存在的本质上全新的能力。
除 SFT 之外,采样为后训练技术栈提供了一个强大的框架,作为一种模型原生算子,为可学习性塑造数据。例如,对于在策略蒸馏,我们的 MCMC 过程从初始蒸馏轨迹中直接诱导出一个教师分布,该分布与学生的 KL 散度小得多,从而促进更稳定的更新。同样,在以专家信息为条件时,我们的方法可以在基础模型无法生成信号的困难任务上为 RL 模拟在策略 rollout。通过消耗采样时的计算量,换取由特权信息构建的更强、更具在策略性的轨迹分布,采样为持续扩展 LLM 能力提供了一条简单、稳健且可扩展的路径。
A 增强的离策略数据示例
化学(Olmo-3-7B-Instruct) 问题:给定一个化学方程式,请配平该方程式,并保持反应物和产物按给定顺序不变。下面是一个未配平的化学方程式: C O 2 + H 2 O = C 3 H 6 O 3 + O 2 \mathrm{CO_2} + \mathrm{H_2O} = \mathrm{C_3H_6O_3} + \mathrm{O_2} CO2+H2O=C3H6O3+O2 请解释你的推理,逐步思考,并在一行中返回配平后的方程式。保持反应物和产物与所提供的顺序相同。 原始:为了配平给定的化学方程式,我们需要确保方程式两边每种元素的原子数相等。从碳( C \mathrm{C} C)开始,反应物侧的 C O 2 \mathrm{CO_2} CO2 中有 1 1 1 个 C \mathrm{C} C 原子,但产物侧的 C 3 H 6 O 3 \mathrm{C_3H_6O_3} C3H6O3 中有 3 3 3 个 C \mathrm{C} C 原子。为了配平碳原子,我们需要 3 3 3 个 C O 2 \mathrm{CO_2} CO2 分子。接下来,配平氢( H \mathrm{H} H)原子。每个 H 2 O \mathrm{H_2O} H2O 分子中有 2 2 2 个 H \mathrm{H} H 原子,而 C 3 H 6 O 3 \mathrm{C_3H_6O_3} C3H6O3 中有 6 6 6 个 H \mathrm{H} H 原子。因此,我们需要 3 3 3 个 H 2 O \mathrm{H_2O} H2O 分子。现在,配平氧( O \mathrm{O} O)原子。反应物侧共有来自 C O 2 \mathrm{CO_2} CO2 的 3 × 2 = 6 3 \times 2 = 6 3×2=6 个 O \mathrm{O} O,以及来自 H 2 O \mathrm{H_2O} H2O 的 3 × 1 = 3 3 \times 1 = 3 3×1=3 个 O \mathrm{O} O,总计 9 9 9 个 O \mathrm{O} O 原子。在产物侧, C 3 H 6 O 3 \mathrm{C_3H_6O_3} C3H6O3 贡献 3 3 3 个 O \mathrm{O} O 原子,剩下需要由 O 2 \mathrm{O_2} O2 提供的 6 6 6 个 O \mathrm{O} O 原子。由于一个 O 2 \mathrm{O_2} O2 分子含有 2 2 2 个 O \mathrm{O} O 原子,因此需要 3 3 3 个 O 2 \mathrm{O_2} O2 分子。配平后的方程式为: 3 C O 2 + 3 H 2 O → C 3 H 6 O 3 + 3 O 2 3\mathrm{CO_2} + 3\mathrm{H_2O} \rightarrow \mathrm{C_3H_6O_3} + 3\mathrm{O_2} 3CO2+3H2O→C3H6O3+3O2。 增强版:观察给定的方程式, C O 2 + H 2 O → C 3 H 6 O 3 + O 2 \mathrm{CO_2} + \mathrm{H_2O} \rightarrow \mathrm{C_3H_6O_3} + \mathrm{O_2} CO2+H2O→C3H6O3+O2,第一步是确定两边每种元素的原子数。对于碳,左侧每个 C O 2 \mathrm{CO_2} CO2 分子中有 1 1 1 个 C \mathrm{C} C,但右侧 C 3 H 6 O 3 \mathrm{C_3H_6O_3} C3H6O3 中有 3 3 3 个 C \mathrm{C} C 原子,因此我们必须在 C O 2 \mathrm{CO_2} CO2 前放置系数 3 3 3 以配平碳。这使左侧有 3 C O 2 3\mathrm{CO_2} 3CO2。接下来,我们检查氢:右侧在 C 3 H 6 O 3 \mathrm{C_3H_6O_3} C3H6O3 中有 6 6 6 个 H \mathrm{H} H 原子,而每个 H 2 O \mathrm{H_2O} H2O 提供 2 2 2 个 H \mathrm{H} H 原子。因此我们需要 3 3 3 个 H 2 O \mathrm{H_2O} H2O 分子(因为 3 × 2 = 6 3 \times 2 = 6 3×2=6 个 H \mathrm{H} H)。现在,对于氧:在左侧, 3 C O 2 3\mathrm{CO_2} 3CO2 给出 6 6 6 个 O \mathrm{O} O 原子, 3 H 2 O 3\mathrm{H_2O} 3H2O 给出 3 3 3 个 O \mathrm{O} O 原子,总计 9 9 9 个 O \mathrm{O} O 原子。在右侧, C 3 H 6 O 3 \mathrm{C_3H_6O_3} C3H6O3 含有 3 3 3 个 O \mathrm{O} O 原子,因此剩余的 6 6 6 个 O \mathrm{O} O 原子必须来自 O 2 \mathrm{O_2} O2(由于每个 O 2 \mathrm{O_2} O2 分子有 2 2 2 个 O \mathrm{O} O 原子,我们需要 3 3 3 个 O 2 \mathrm{O_2} O2 分子来提供 6 6 6 个 O \mathrm{O} O 原子)。因此,配平后的方程式为: 3 C O 2 + 3 H 2 O → C 3 H 6 O 3 + 3 O 2 3\mathrm{CO_2} + 3\mathrm{H_2O} \rightarrow \mathrm{C_3H_6O_3} + 3\mathrm{O_2} 3CO2+3H2O→C3H6O3+3O2。
数学(Qwen2.5-3B) 问题:将 1 + 3 1 − 3 \frac{1+\sqrt{3}}{1-\sqrt{3}} 1−3 1+3 的分母有理化。当你将答案写成 A + B C A+B\sqrt{C} A+BC 的形式时,其中 A A A、 B B B 和 C C C 是整数, A B C ABC ABC 是多少?解释你的推理,逐步思考,并将最终答案置于 \boxed{} 内返回。 原始:当我们将分子和分母都乘以分母的共轭式时,我们得到
1 + 3 1 − 3 = ( 1 + 3 ) ( 1 + 3 ) ( 1 − 3 ) ( 1 + 3 ) . \frac{1+\sqrt{3}}{1-\sqrt{3}} = \frac{(1+\sqrt{3})(1+\sqrt{3})}{(1-\sqrt{3})(1+\sqrt{3})}. 1−3 1+3 =(1−3 )(1+3 )(1+3 )(1+3 ).
化简后,我们得到
1 + 2 3 + 3 1 − 3 = 4 + 2 3 − 2 = − 2 − 3 . \frac{1+2\sqrt{3}+3}{1-3} = \frac{4+2\sqrt{3}}{-2} = -2-\sqrt{3}. 1−31+23 +3=−24+23 =−2−3 .
因此 A = − 2 A=-2 A=−2, B = − 1 B=-1 B=−1, C = 3 C=3 C=3,且 A B C = 6 ABC=6 ABC=6。 增强:要将 1 + 3 1 − 3 \frac{1+\sqrt{3}}{1-\sqrt{3}} 1−3 1+3 的分母有理化,我们需要将分子和分母都乘以分母的共轭式,即 1 + 3 1+\sqrt{3} 1+3 。
1 + 3 1 − 3 = ( 1 + 3 ) ( 1 + 3 ) ( 1 − 3 ) ( 1 + 3 ) = 1 + 2 3 + 3 1 − 3 = 4 + 2 3 − 2 = − 2 − 3 . \frac{1+\sqrt{3}}{1-\sqrt{3}} = \frac{(1+\sqrt{3})(1+\sqrt{3})}{(1-\sqrt{3})(1+\sqrt{3})} = \frac{1+2\sqrt{3}+3}{1-3} = \frac{4+2\sqrt{3}}{-2} = -2-\sqrt{3}. 1−3 1+3 =(1−3 )(1+3 )(1+3 )(1+3 )=1−31+23 +3=−24+23 =−2−3 .
因此,在 A + B C A+B\sqrt{C} A+BC 的形式中,我们有 A = − 2 A=-2 A=−2, B = − 1 B=-1 B=−1,且 C = 3 C=3 C=3。因此, A B C = ( − 2 ) ( − 1 ) ( 3 ) = 6 ABC=(-2)(-1)(3)=6 ABC=(−2)(−1)(3)=6。
Medical(Qwen2.5-7B-Instruct) 问题:鉴于左臂和左腿突发无力、近期长途旅行以及右小腿肿胀且有压痛的症状,进一步评估中最可能发现哪种特定的心脏异常可以解释这些表现? 原始回答:在此情景下,最可能发现的特定心脏异常是卵圆孔未闭(PFO)。这种情况可能使来自静脉系统的血栓,例如来自腿部深静脉血栓形成的血栓,绕过肺部并直接进入动脉循环。当血栓通过PFO从右心房移动到左心房时,就会发生这种情况。一旦进入动脉系统,血栓可前往大脑,可能导致栓塞性卒中,从而解释左臂和左腿的突发无力。近期旅行增加深静脉血栓形成风险,而该风险与神经系统症状之间的联系提示存在促进反常栓塞的PFO。 增强回答:鉴于患者近期有长途旅行史,由于飞行期间长时间不活动,发生深静脉血栓形成(DVT)的风险增加。如果该DVT发生于右小腿,则可导致该区域肿胀和压痛。此外,卵圆孔未闭(PFO)的存在提供了一种潜在机制,使来自DVT的血栓可能绕过肺循环并前往心脏左侧。从那里,血栓可进入体循环,并可能在大脑中引起栓塞事件,导致左臂和左腿突发无力。因此,进一步评估后,最可能的发现是:卵圆孔未闭(PFO),其促进血栓从心脏右侧通向左侧,使其能够到达脑循环并引起卒中样表现。
数学(Qwen2.5-3B) 问题:你是一位专业数学家。你能解决以下数学问题吗?假设 h ( x ) = f − 1 ( x ) h(x) = f^{-1}(x) h(x)=f−1(x)。如果 h ( 2 ) = 10 h(2) = 10 h(2)=10, h ( 10 ) = 1 h(10) = 1 h(10)=1 且 h ( 1 ) = 2 h(1) = 2 h(1)=2,那么 f ( f ( 10 ) ) f(f(10)) f(f(10)) 是什么?解释你的推理,逐步思考,并将最终答案置于 \boxed{} 内。 原始:由于 f f f 和 h h h 是反函数,且 h ( 2 ) = 10 h(2) = 10 h(2)=10,所以 f ( 10 ) = 2 f(10) = 2 f(10)=2,因此 f ( f ( 10 ) ) = f ( 2 ) f(f(10)) = f(2) f(f(10))=f(2)。又由于 h ( 1 ) = 2 h(1) = 2 h(1)=2,所以 f ( 2 ) = 1 f(2) = 1 f(2)=1。 增强:为了求 f ( f ( 10 ) ) f(f(10)) f(f(10)),我们可以利用关于函数 h ( x ) = f − 1 ( x ) h(x) = f^{-1}(x) h(x)=f−1(x) 所给的信息。由于 h ( 2 ) = 10 h(2) = 10 h(2)=10,这意味着 f ( 10 ) = 2 f(10) = 2 f(10)=2。类似地,由于 h ( 1 ) = 2 h(1) = 2 h(1)=2,它意味着 f ( 2 ) = 1 f(2) = 1 f(2)=1。因此, f ( f ( 10 ) ) = f ( 2 ) = 1 f(f(10)) = f(2) = 1 f(f(10))=f(2)=1。
医学(Qwen2.5-7B-Instruct) 问题:一名 4 岁男孩因麻疹样皮疹、发热、口唇皲裂、颈部淋巴结肿大和肛周脱屑被送至急诊科,这些表现提示一种可能导致严重并发症的疾病。在此临床情境中,为评估潜在并发症,最关键的解剖结构是什么? 原始:在此临床情境中,该 4 岁男孩表现出的症状提示川崎病,这是一种尤其因其可能累及心脏的并发症而具有重要意义的疾病。最关键的是,此病例中需要评估的解剖结构是冠状动脉。这是因为川崎病的严重并发症之一是冠状动脉瘤的形成,其可导致显著的心脏问题。通常采用超声心动图进行定期监测,以评估冠状动脉状况,并在需要时确保及时干预。 增强:基于临床表现,该患者的症状强烈提示川崎病。鉴于麻疹样皮疹、发热、口唇皲裂、颈部淋巴结肿大和肛周脱屑等症状,重点评估心血管系统以发现潜在并发症至关重要。在此病例中,冠状动脉是最关键需要评估的解剖结构。这是由于发生冠状动脉瘤的风险很高,在未治疗病例中其发生率可高达 25%。这些动脉瘤可导致严重的心脏问题,如心肌梗死或心源性猝死。因此,定期进行超声心动图监测对于早期发现任何异常并在必要时提供及时干预至关重要。总之,在评估该患者时,主要关注点应为冠状动脉,以预防与川崎病相关的危及生命的并发症。
化学(Qwen2.5-7B-Instruct) 问题:给定一个问题与四个选项,逐步思考,然后返回正确字母:A、B、C 或 D。你回答的最后一行应采用以下格式:LETTER,其中 LETTER 是 ABCD 之一(例如 A)。IUPAC 名称为"(2R,3R,4S,5S)-oxane-2,3,4,5tetrol"的分子的摩尔质量( g/mol \text{g/mol} g/mol)是多少?选项:A) 148.160 148.160 148.160 B) 150.130 150.130 150.130 C) 151.140 151.140 151.140 D) 149.150 149.150 149.150 逐步解释你的推理,并在 \boxed{} 内返回最终答案。 原始:为求分子"(2R,3R,4S,5S)-oxane-2,3,4,5-tetrol"的摩尔质量,我们首先需要确定其分子式。该名称表明它是氧杂环己烷的四羟基衍生物,而氧杂环己烷是一种含六个原子的环状醚(结构类似吡喃)。由于氧杂环己烷可视为四氢吡喃(化学式为 C 5 H 10 O \mathrm{C_5H_{10}O} C5H10O),分子"(2R,3R,4S,5S)-oxane-2,3,4,5-tetrol"将具有四个连接在其上的羟基( − O H -\mathrm{OH} −OH)基团。因此,分子式应为 C 5 H 10 O 5 \mathrm{C_5H_{10}O_5} C5H10O5: • 碳(C): 5 5 5 个原子 × 12.01 g/mol = 60.05 g/mol \times 12.01\ \text{g/mol} = 60.05\ \text{g/mol} ×12.01 g/mol=60.05 g/mol • 氢(H): 10 10 10 个原子 × 1.008 g/mol = 10.08 g/mol \times 1.008\ \text{g/mol} = 10.08\ \text{g/mol} ×1.008 g/mol=10.08 g/mol • 氧(O): 5 5 5 个原子 × 16.00 g/mol = 80.00 g/mol \times 16.00\ \text{g/mol} = 80.00\ \text{g/mol} ×16.00 g/mol=80.00 g/mol 将这些相加得到摩尔质量: 60.05 g/mol + 10.08 g/mol + 80.00 g/mol = 150.13 g/mol 60.05\ \text{g/mol} + 10.08\ \text{g/mol} + 80.00\ \text{g/mol} = 150.13\ \text{g/mol} 60.05 g/mol+10.08 g/mol+80.00 g/mol=150.13 g/mol 因此,该分子的摩尔质量为 150.130 g/mol 150.130\ \text{g/mol} 150.130 g/mol。B 增强:从 IUPAC 名称"(2R,3R,4S,5S)-oxane-2,3,4,5-tetrol"出发,我们可以推断出该分子的结构。氧杂环己烷,也称为四氢吡喃,具有含一个氧原子的五元环结构。术语"tetrol"表明该分子有四个连接在环上的羟基( − O H -\mathrm{OH} −OH)基团。因此,该化合物的分子式将为 C 5 H 10 O 5 \mathrm{C_5H_{10}O_5} C5H10O5。让我们逐步分解摩尔质量的计算:1. 碳(C) :分子中有 5 5 5 个碳原子。碳的原子量约为 12.01 g/mol 12.01\ \text{g/mol} 12.01 g/mol。 5 × 12.01 g/mol = 60.05 g/mol 5 \times 12.01\ \text{g/mol} = 60.05\ \text{g/mol} 5×12.01 g/mol=60.05 g/mol 2. 氢(H) :分子中有 10 10 10 个氢原子。氢的原子量约为 1.008 g/mol 1.008\ \text{g/mol} 1.008 g/mol。 10 × 1.008 g/mol = 10.08 g/mol 10 \times 1.008\ \text{g/mol} = 10.08\ \text{g/mol} 10×1.008 g/mol=10.08 g/mol 3. 氧(O) :分子中有 5 5 5 个氧原子。氧的原子量约为 16.00 g/mol 16.00\ \text{g/mol} 16.00 g/mol。 5 × 16.00 g/mol = 80.00 g/mol 5 \times 16.00\ \text{g/mol} = 80.00\ \text{g/mol} 5×16.00 g/mol=80.00 g/mol 将这些相加得到该分子的摩尔质量: 60.05 g/mol + 10.08 g/mol + 80.00 g/mol = 150.13 g/mol 60.05\ \text{g/mol} + 10.08\ \text{g/mol} + 80.00\ \text{g/mol} = 150.13\ \text{g/mol} 60.05 g/mol+10.08 g/mol+80.00 g/mol=150.13 g/mol 因此,该分子的摩尔质量为 150.130 g/mol 150.130\ \text{g/mol} 150.130 g/mol。B
B 补充结果
我们纳入了在一个非 Qwen 系列模型上的结果,以证明我们的方法适用于多种预训练模型系列。即,我们提供了 Olmo-3-7B-Instruct 在化学任务上的结果。
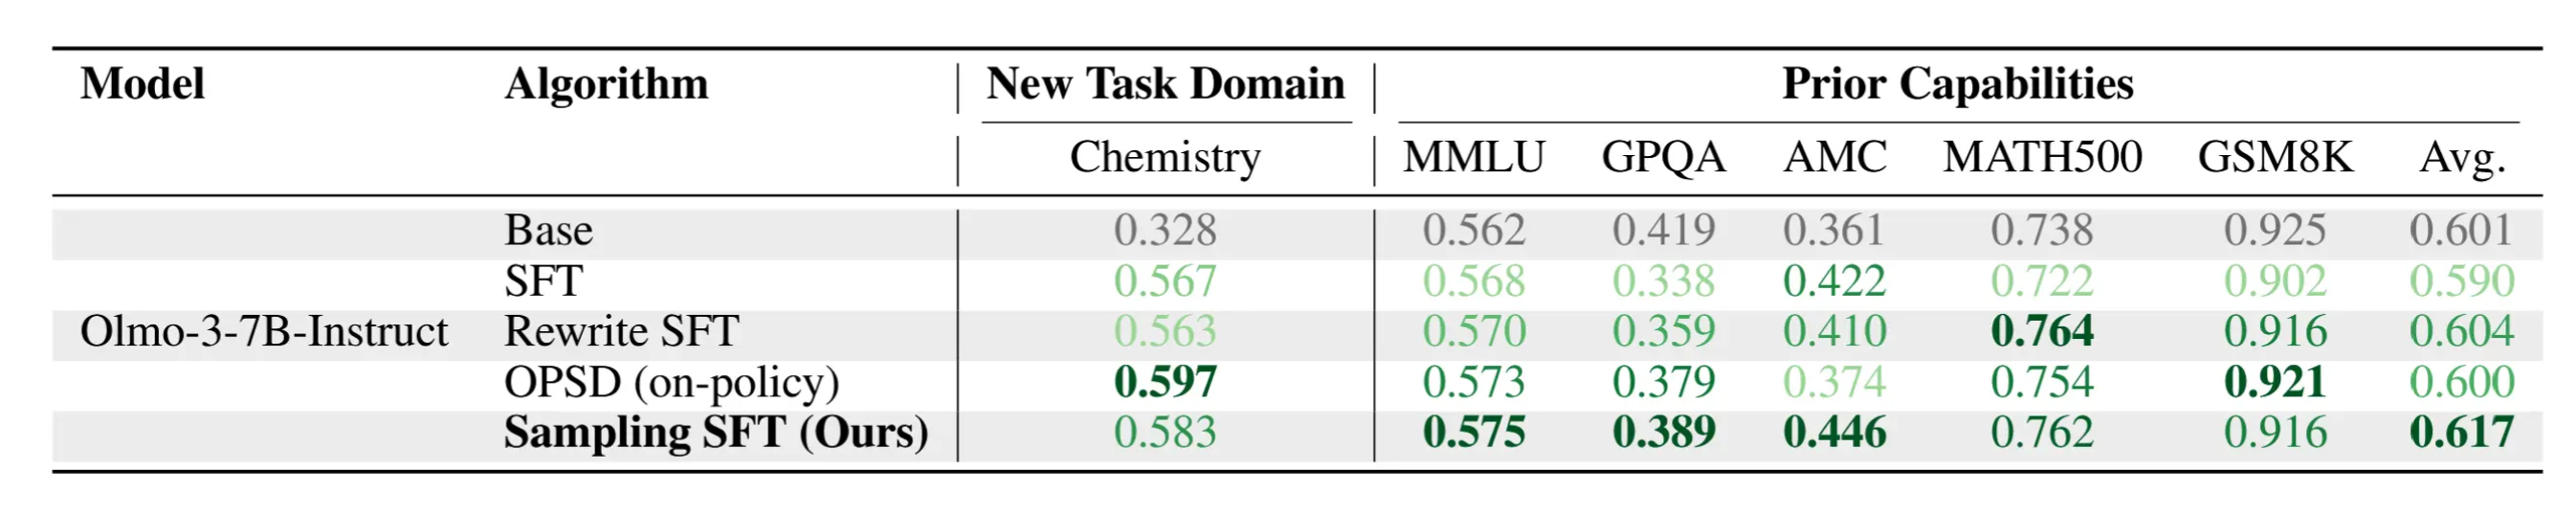
表2:使用 Olmo-3-7B-Instruct 在 Chemistry 上的结果。Chemistry 衡量对新任务领域的泛化能力,而 MMLU、GPQA、AMC、MATH500 和 GSM8K 衡量对先前能力的保持。我们在最后一列报告先前能力评估的平均性能。
我们还为 Qwen2.5-7B-Instruct 的化学任务额外加入了两项对比实验,以强调数据分布与学习分布之间的对齐至关重要。在第一项实验中,我们采用相对于 Olmo-3-7B 的增强数据集,并在该数据集上微调 Qwen2.5-7B-Instruct。我们发现化学任务的准确率下降到 57.33%,这显著差于其他基线(普通 SFT 为 61.8%)。在第二项实验中,我们在增强数据与原始 SFT 数据的 50/50 混合上训练 Qwen2.5-7B-Instruct,以观察离策略与在策略数据之间插值的效果。我们发现化学任务的准确率达到 62.14%,介于标准 SFT 与在增强数据集上进行 SFT 之间。 C 进一步的实验细节 C.1 信息保留 算法 1 中提议分布需要验证的一个条件,是我们的 MCMC 过程在离策略数据上的保留有效性。我们通过报告每个任务的增强数据集的准确率来衡量这一点:对于化学,我们的数据集在 Qwen 上保留 94.33% 的准确率,在 Olmo 上保留 93.94%。对于数学,我们保留 95.33%,对于医学,我们保留 95.86%。 C.2 采样 注意,算法 1 的完整实现可能每次迭代需要对 LLM 进行两次前向传递:一次用于通过提议 κ C \kappa_C κC 生成候选 x ′ x' x′,另一次用于估计转移概率 κ C ( x ∣ x ′ ) \kappa_C(x \mid x') κC(x∣x′)。为减少推理开销,我们通过只要生成的候选比当前候选具有更高似然就进行交换,来近似交换条件。这会产生在基础模型下更激进地移向高似然区域的效果,但如图 5 所示,这些激进移动仍单调降低数据生成策略与基础分布之间的 KL 散度。 C.3 提议与评分提示词 我们在下面提供了一个用于化学任务的示例提议核 κ C \kappa_C κC(其他任务遵循类似的提示词),以及输入到 GPT5-mini 的医学任务语义等价性评分提示词。 你是一位专家化学家,给定一个化学问题、其解答以及一个初始的部分回答。请仔细研究该解答,识别已经提供了哪些推理或步骤,然后继续该部分回答。确保你的回答与解答逻辑一致,并导向完整且正确的最终答案。任务:<PROBLEM> 这是该问题解答的一个示例:<SOLUTION> 这是一个部分回答:<RESPONSE> 从该部分回答开始,用你自己的话继续回答,包括思考过程。确保最终答案与所提供的解答完全一致。 你是一位专家医学评估员,负责评估模型的回答是否正确回答了一个医学问题。你的任务是将模型的回答与参考答案进行比较,并确定模型的回答是:1. CORRECT:回答包含参考答案中的关键医学信息,即使表述不同或包含额外正确的医学细节。2. INCORRECT:回答在医学上是错误的、遗漏了要点,或提供了错误的医学信息。关注医学准确性和完整性,而非写作风格或冗长程度。 医学问题:<QUESTION> 参考答案:<ANSWER> 模型回答:<RESPONSE> 评估模型的回答。仅输出以下之一:CORRECT 或 INCORRECT。
引用文献
Aleksei Arzhantsev, Otmane Sakhi, and Nicolas Chopin. Self-consistency via marginal sharpening. arXiv preprint arXiv:2605.28142, 2026. doi: 10.48550/arXiv.2605.28142. URL https://arxiv. org/abs/2605.28142. 3
Seyedarmin Azizi, Erfan Baghaei Potraghloo, Minoo Ahmadi, Souvik Kundu, and Massoud Pedram. Power-smc: Low-latency sequence-level power sampling for training-free llm reasoning. arXiv preprint arXiv:2602.10273, 2026. URL https://arxiv.org/abs/2602.10273. 3
Howard Chen, Noam Razin, Karthik Narasimhan, and Danqi Chen. Retaining by doing: The role of on-policy data in mitigating forgetting. arXiv preprint arXiv:2510.18874, 2025. URL https://arxiv.org/abs/2510.18874. 1, 3
Junying Chen, Zhenyang Cai, Ke Ji, Xidong Wang, Wanlong Liu, Rongsheng Wang, Jianye Hou, and Benyou Wang. Huatuogpt-o1, towards medical complex reasoning with llms. arXiv preprint arXiv:2412.18925, 2024. 8
Tianzhe Chu, Yuexiang Zhai, Jihan Yang, Shengbang Tong, Saining Xie, Dale Schuurmans, Quoc V. Le, Sergey Levine, and Yi Ma. Sft memorizes, rl generalizes: A comparative study of foundation model post-training. arXiv preprint arXiv:2501.17161, 2025. URL https://arxiv.org/abs/ 2501.17161. 1, 3
Karl Cobbe, Vineet Kosaraju, Mohammad Bavarian, Mark Chen, Heewoo Jun, Lukasz Kaiser, Matthias Plappert, Jerry Tworek, Jacob Hilton, Reiichiro Nakano, et al. Training verifiers to solve math word problems. arXiv preprint arXiv:2110.14168, 2021. 8
Imre Csiszár. I-divergence geometry of probability distributions and minimization problems. The annals of probability, pages 146--158, 1975. 4
Gonçalo R. A. Faria, Sweta Agrawal, António Farinhas, Ricardo Rei, José G. C. de Souza, and André F. T. Martins. Quest: Quality-aware metropolis-hastings sampling for machine translation. In NeurIPS, 2024. URL https://proceedings.neurips.cc/paper_files/paper/2024/ file/a221d22ff6a33599142c8299c7ed06bb-Paper-Conference.pdf. 3
Kehua Feng, Xinyi Shen, Weijie Wang, Xiang Zhuang, Yuqi Tang, Qiang Zhang, and Keyan Ding. Sciknoweval: Evaluating multi-level scientific knowledge of large language models. arXiv preprint arXiv:2406.09098, 2024. 8
Aravind Gollakota, Parikshit Gopalan, Aayush Karan, Charlotte Peale, and Udi Wieder. When does a predictor know its own loss? arXiv preprint arXiv:2502.20375, 2025. URL https: //arxiv.org/abs/2502.20375.
Daya Guo, Dejian Yang, Haowei Zhang, Junxiao Song, Ruoyu Zhang, Runxin Xu, Qihao Zhu, Shirong Ma, Peiyi Wang, Xiao Bi, et al. Deepseek-r1: Incentivizing reasoning capability in LLMs via reinforcement learning. arXiv preprint arXiv:2501.12948, 2025. 1, 3
W Keith Hastings. Monte carlo sampling methods using markov chains and their applications. 1970. 5
Dan Hendrycks, Collin Burns, Steven Basart, Andy Zou, Mantas Mazeika, Dawn Song, and Jacob Steinhardt. Measuring massive multitask language understanding. arXiv preprint arXiv:2009.03300, 2020. 8
Dan Hendrycks, Collin Burns, Saurav Kadavath, Akul Arora, Steven Basart, Eric Tang, Dawn Song, and Jacob Steinhardt. Measuring mathematical problem solving with the MATH dataset. arXiv preprint arXiv:2103.03874, 2021. 1, 8
Jingcheng Hu, Yinmin Zhang, Qi Han, Daxin Jiang, Xiangyu Zhang, and Heung-Yeung Shum. Open-reasoner-zero: An open source approach to scaling up reinforcement learning on the base model. arXiv preprint arXiv:2503.24290, 2025. 1
Xiaotong Ji, Rasul Tutunov, Matthieu Zimmer, and Haitham Bou Ammar. Scalable power sampling: Unlocking efficient, training-free reasoning for llms via distribution sharpening. arXiv preprint arXiv:2601.21590, 2026. 3
Aayush Karan and Yilun Du. Reasoning with sampling: Your base model is smarter than you think. arXiv preprint arXiv:2510.14901, 2025. URL https://arxiv.org/abs/2510.14901. 3, 6, 7
Aayush Karan, Kulin Shah, Sitan Chen, and Yonina C. Eldar. Unrolled denoising networks provably learn optimal bayesian inference. arXiv preprint arXiv:2409.12947, 2024. URL https://arxiv. org/abs/2409.12947.
Aayush Karan, Kulin Shah, and Sitan Chen. Reguidance: A simple diffusion wrapper for boosting sample quality on hard inverse problems. arXiv preprint arXiv:2506.10955, 2025. URL https: //arxiv.org/abs/2506.10955.
James Kirkpatrick, Razvan Pascanu, Neil Rabinowitz, Joel Veness, Guillaume Desjardins, Andrei A. Rusu, Kieran Milan, John Quan, Tiago Ramalho, Agnieszka Grabska-Barwinska, et al. Overcoming catastrophic forgetting in neural networks. Proceedings of the National Academy of Sciences, 114 (13):3521--3526, 2017. 1, 3
Alexander K Lew, Tan Zhi-Xuan, Gabriel Grand, and Vikash K Mansinghka. Sequential monte carlo steering of large language models using probabilistic programs. arXiv preprint arXiv:2306.03081, 2023. 3
Marvin Li, Aayush Karan, and Sitan Chen. Blink of an eye: A simple theory for feature localization in generative models. arXiv preprint arXiv:2502.00921, 2025. URL https://arxiv.org/abs/ 2502.00921. 3
Yujia Li, David Choi, Junyoung Chung, Nate Kushman, Julian Schrittwieser, Rémi Leblond, Tom Eccles, James Keeling, Felix Gimeno, Agustin Dal Lago, Thomas Hubert, Peter Choy, Cyprien de Masson d'Autume, Igor Babuschkin, Xinyun Chen, Po-Sen Huang, Johannes Welbl, Sven Gowal, Alexey Cherepanov, James Molloy, Daniel Mankowitz, Esme Sutherland Robson, Pushmeet Kohli, Nando de Freitas, Koray Kavukcuoglu, and Oriol Vinyals. Competition-level code generation with AlphaCode. arXiv preprint arXiv:2203.07814, 2022. 1
Mingyang Liu, Gabriele Farina, and Asuman Ozdaglar. Uft: Unifying supervised and reinforcement fine-tuning. arXiv preprint arXiv:2505.16984, 2025. URL https://arxiv.org/abs/2505. 16984. 3, 9
Yun Luo, Zhen Yang, Fandong Meng, Yafu Li, Jie Zhou, and Yue Zhang. An empirical study of catastrophic forgetting in large language models during continual fine-tuning. arXiv preprint arXiv:2308.08747, 2023. URL https://arxiv.org/abs/2308.08747. 1, 3
Nicholas Metropolis, Arianna W. Rosenbluth, Marshall N. Rosenbluth, Augusta H. Teller, and Edward Teller. Equation of state calculations by fast computing machines. Journal of Chemical Physics, 21(6):1087--1092, 1953. doi: 10.1063/1.1699114. 5
Yuxiao Qu, Amrith Setlur, Virginia Smith, Ruslan Salakhutdinov, and Aviral Kumar. Pope: Learning to reason on hard problems via privileged on-policy exploration. arXiv preprint arXiv:2601.18779, 2026. URL https://arxiv.org/abs/2601.18779. 2, 3, 6
David Rein, Betty Li Hou, Asa Cooper Stickland, Jackson Petty, Richard Yuanzhe Pang, Julien Dirani, Julian Michael, and Samuel R Bowman. GPQA: A graduate-level google-proof q&a benchmark. In First Conference on Language Modeling, 2024. 1, 8
Zhihong Shao, Peiyi Wang, Qihao Zhu, Runxin Xu, Junxiao Song, Xiao Bi, Haowei Zhang, Mingchuan Zhang, Y. K. Li, Y. Wu, and Daya Guo. Deepseek-math: Advancing mathematical reasoning through step-by-step exploration. arXiv preprint arXiv:2404.01140, 2024. 9
Idan Shenfeld, Jyothish Pari, and Pulkit Agrawal. Rl's razor: Why online reinforcement learning forgets less. arXiv preprint arXiv:2509.04259, 2025. 1, 3
Idan Shenfeld, Mehul Damani, Jonas Hübotter, and Pulkit Agrawal. Self-distillation enables continual learning. arXiv preprint arXiv:2601.19897, 2026. 2, 3, 6, 8, 9
Team Olmo, Allyson Ettinger, Amanda Bertsch, Bailey Kuehl, David Graham, David Heineman, Dirk Groeneveld, Faeze Brahman, Finbarr Timbers, Hamish Ivison, et al. Olmo 3. arXiv preprint arXiv:2512.13961, 2025. 8
Yongliang Wu, Yizhou Zhou, Ziheng Zhou, Yingzhe Peng, Xinyu Ye, Xinting Hu, Wenbo Zhu, Lu Qi, Ming-Hsuan Yang, and Xu Yang. On the generalization of sft: A reinforcement learning perspective with reward rectification. arXiv preprint arXiv:2508.05629, 2025. doi: 10.48550/arXiv.2508.05629. URL https://arxiv.org/abs/2508.05629. 3
Wei Xiong, Jiarui Yao, Yuhui Xu, Bo Pang, Lei Wang, Doyen Sahoo, Junnan Li, Nan Jiang, Tong Zhang, Caiming Xiong, et al. A minimalist approach to llm reasoning: from rejection sampling to reinforce. arXiv preprint arXiv:2504.11343, 2025. 1, 3, 5
An Yang, Baosong Yang, Beichen Zhang, Binyuan Hui, Bo Zheng, Bowen Yu, Chengyuan Li, Dayiheng Liu, Fei Huang, Haoran Wei, et al. Qwen2.5 technical report. arXiv preprint arXiv:2412.15115, 2024. 8
Tianzhu Ye, Li Dong, Xun Wu, Shaohan Huang, and Furu Wei. On-policy context distillation for language models. arXiv preprint arXiv:2602.12275, 2026. URL https://arxiv.org/abs/ 2602.12275. 3
Siyan Zhao, Zhihui Xie, Mengchen Liu, Jing Huang, Guan Pang, Feiyu Chen, and Aditya Grover. Self-distilled reasoner: On-policy self-distillation for large language models. arXiv preprint arXiv:2601.18734, 2026. URL https://arxiv.org/abs/2601.18734. 3, 8
Stephen Zhao, Rob Brekelmans, Alireza Makhzani, and Roger Grosse. Probabilistic inference in language models via twisted sequential monte carlo. arXiv preprint arXiv:2404.17546, 2024. URL https://arxiv.org/abs/2404.17546. 3
Felix Zhou, Anay Mehrotra, and Quanquan C. Liu. Reasoning with sampling: Cutting at decision points. arXiv preprint arXiv:2605.30327, 2026. URL https://arxiv.org/abs/2605.30327. 3
He Zhu, Junyou Su, Peng Lai, Ren Ma, Wenjia Zhang, Linyi Yang, and Guanhua Chen. Anchored supervised fine-tuning. arXiv preprint arXiv:2509.23753, 2025. doi: 10.48550/arXiv.2509.23753. URL https://arxiv.org/abs/2509.23753. 3