✍✍计算机毕设指导师**
⭐⭐个人介绍:自己非常喜欢研究技术问题!专业做Java、Python、小程序、安卓、大数据、爬虫、Golang、大屏等实战项目。
⛽⛽实战项目:有源码或者技术上的问题欢迎在评论区一起讨论交流!也可以在主页上或文末下与博主交流~~
⚡⚡Java、Python、小程序、大数据实战项目集](https://blog.csdn.net/2301_80395604/category_12487856.html)
⚡⚡文末获取源码
温馨提示:文末有CSDN平台官方提供的博客联系方式!
温馨提示:文末有CSDN平台官方提供的博客联系方式!
温馨提示:文末有CSDN平台官方提供的博客联系方式!
白鹿的抖音评论分析与可视化系统-简介
本系统是一个基于Python语言和Hadoop+Spark大数据框架构建的白鹿抖音评论分析与可视化平台,在技术实现上,系统后端采用Django框架进行接口开发,利用HDFS进行海量评论数据的分布式存储,并借助Spark和Spark SQL进行大规模数据的快速清洗与聚合计算,结合Pandas和NumPy对数据进行本地化预处理,前端则通过Vue搭配ElementUI构建交互界面,使用Echarts将分析结果以图表形式直观呈现,在功能方面,系统围绕抖音评论数据展开了多维度的剖析,包含情感分布与地域分布的基础统计,能清晰呈现整体舆论倾向和用户地理集中度,时段和日期趋势分析揭示了用户活跃的时间规律,点赞排行和点赞分层帮助挖掘高热度评论特征,地域情感和情感时段交叉分析则展现了不同地区或时间段的情绪差异,词云生成依赖jieba分词和TF-IDF算法提取核心关键词,评论长度和用户活跃度模块进一步刻画了文本特征和关键意见领袖,系统还引入了K-Means算法对评论进行聚类,将具有相似互动与文本特征的评论归类,利用FP-Growth算法挖掘情感与地域标签之间的关联规则,并通过Isolation Forest模型识别点赞数或文本长度异常的评论,整个系统将大数据处理能力与可视化展示紧密结合,实现了从数据存储到分析挖掘再到图表呈现的完整闭环。
白鹿的抖音评论分析与可视化系统-技术
大数据框架:Hadoop+Spark(本次没用Hive,支持定制)
开发语言:Python+Java(两个版本都支持)
后端框架:Django+Spring Boot(Spring+SpringMVC+Mybatis)(两个版本都支持)
前端:Vue+ElementUI+Echarts+HTML+CSS+JavaScript+jQuery
数据库:MySQL
白鹿的抖音评论分析与可视化系统-背景
现在短视频平台特别火,大家平时都喜欢在抖音上看视频、发评论,像白鹿这样的演员有很多粉丝,每条视频下面都有成千上万的留言。这些评论里其实藏着很多有价值的信息,比如大家到底喜不喜欢这个视频、哪里的粉丝最活跃、粉丝们都关心些什么话题。但是面对这么海量的留言数据,光靠人工去看根本看不过来,也没法得出一个整体的结论。刚好现在大数据技术发展得挺成熟,Hadoop和Spark这些工具就是专门用来处理这种海量数据的。所以我就想着,能不能把这些技术用到实际的评论数据上,做一个专门分析白鹿抖音评论的系统,把那些杂乱的文字变成直观的图表,这也就是我做这个课题的出发点。
做这个系统其实还是有一些实际用处的。一方面,对于想要了解粉丝反馈的人来说,通过这个系统能快速看到评论的情感倾向和热门话题,不用一条条去翻留言,能省下不少时间,也能更客观地掌握粉丝的整体态度。另一方面,从咱们学生做毕业设计的角度来看,这个课题把大数据的理论知识用到了具体的场景里。在做系统的过程中,我实打实地练习了Hadoop和Spark的操作,也跑通了TF-IDF、K-Means这些算法,算是把课本上的东西变成了一个能运行的软件。虽然系统肯定还有不完善的地方,功能也比较基础,但对自己来说算是一次挺完整的实践锻炼,对以后处理类似的数据分析工作也有点参考价值。
白鹿的抖音评论分析与可视化系统-视频展示
基于Hadoop+Spark的白鹿的抖音评论分析与可视化系统
白鹿的抖音评论分析与可视化系统-图片展示
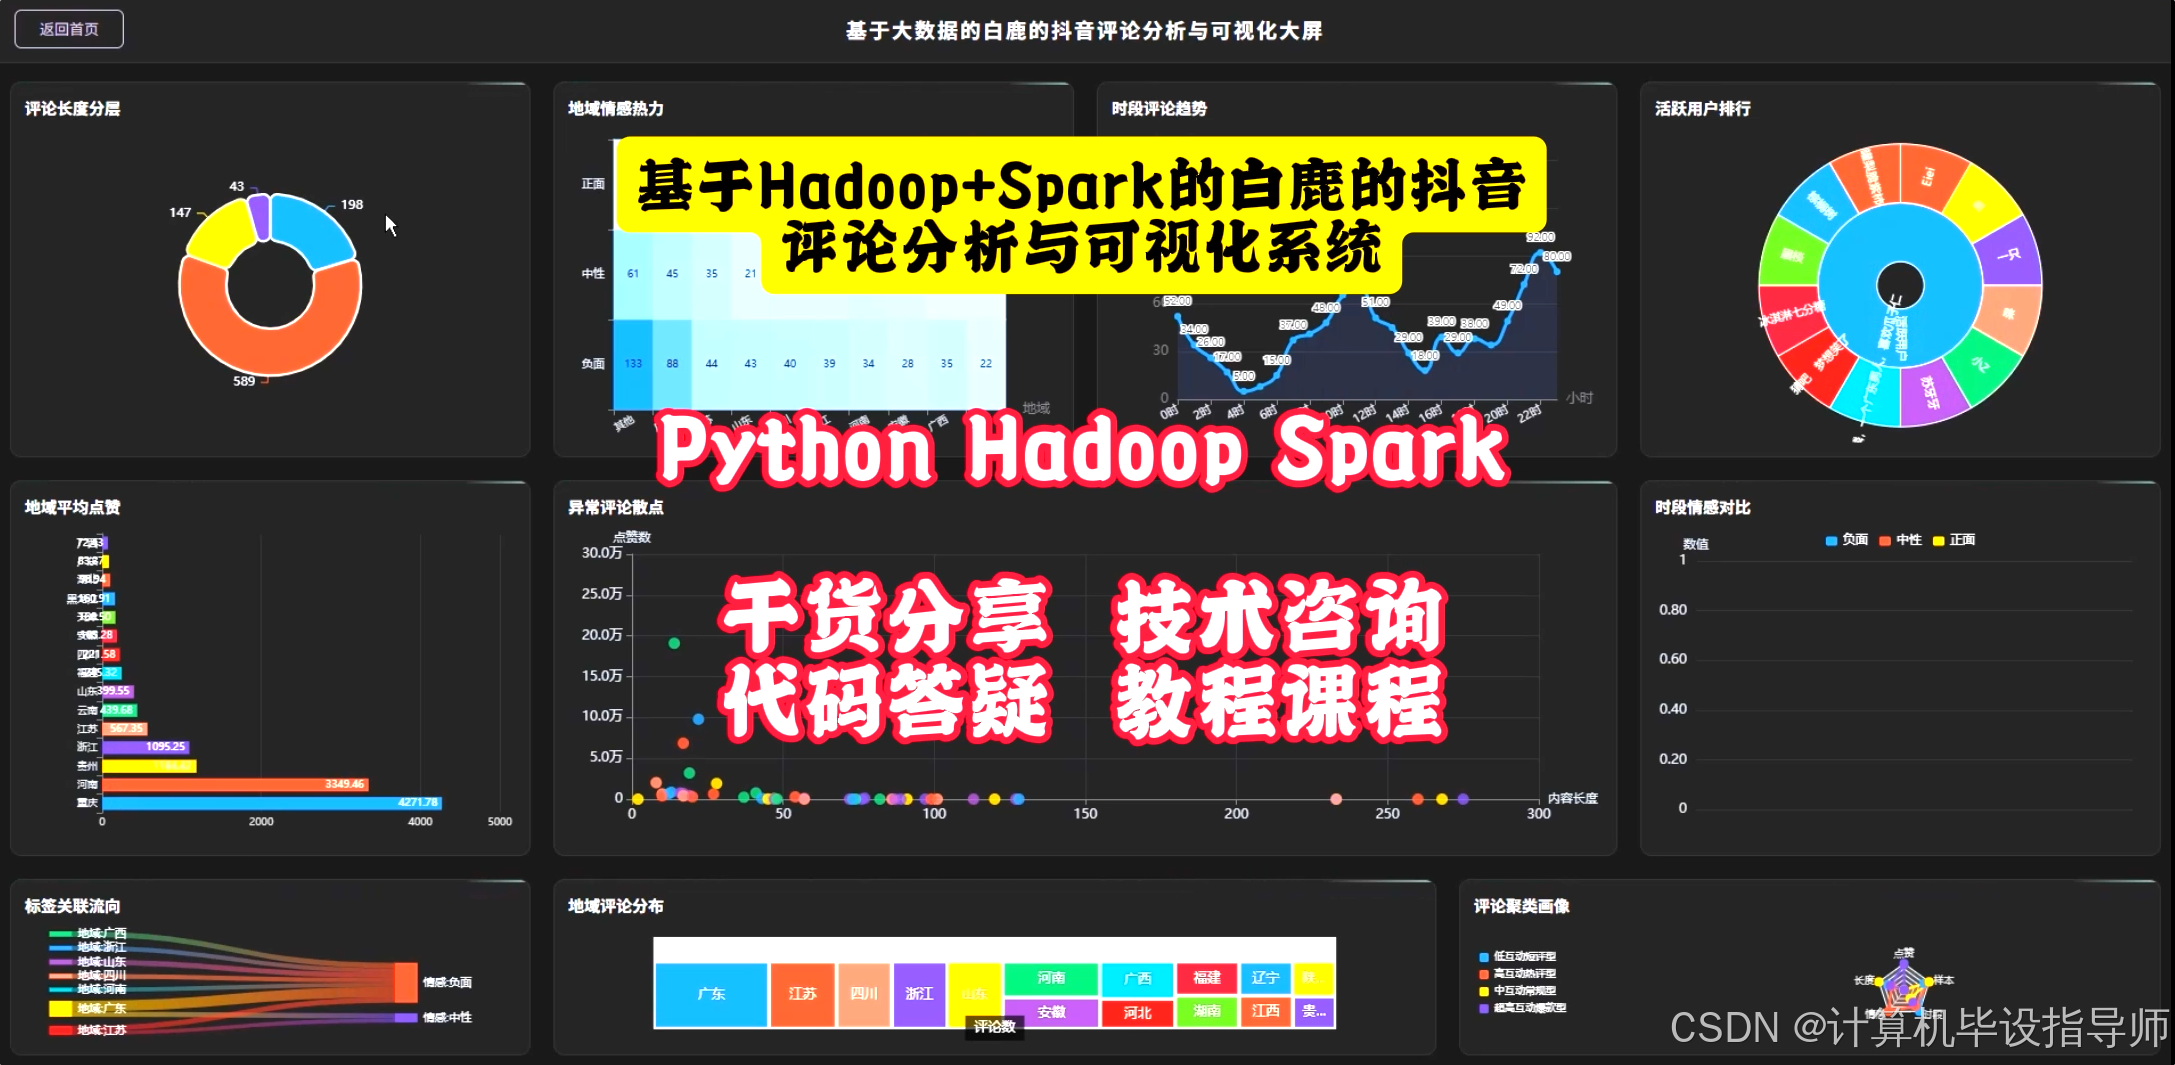
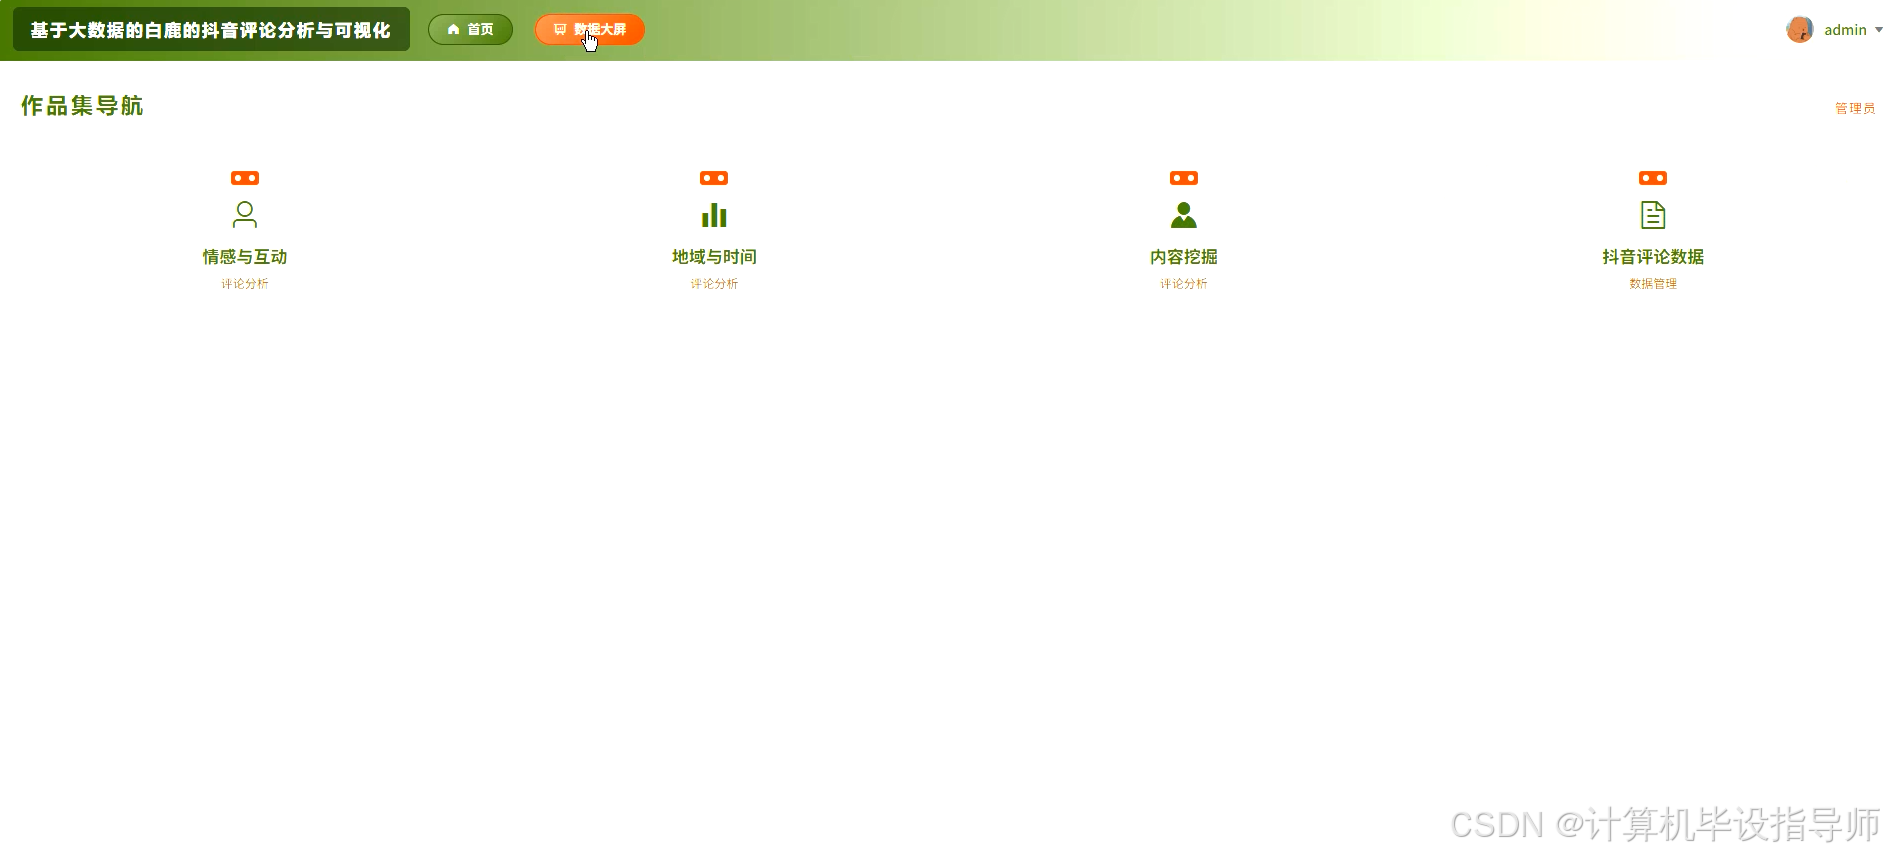
白鹿的抖音评论分析与可视化系统-代码展示
python
spark = SparkSession.builder.appName("BaiLuDouyinAnalysis").master("local[*]").getOrCreate()
def process_tfidf_keywords(rdd):
    data = rdd.map(lambda x: (x['内容'], )).filter(lambda x: x[0] is not None and x[0].strip() != '')
    words_rdd = data.map(lambda x: list(jieba.cut(x[0]))).map(lambda words: [w for w in words if w not in stop_words and len(w)>1])
    hashing_tf = HashingTF(inputCol="words", outputCol="rawFeatures", numFeatures=10000)
    tf_df = hashing_tf.transform(spark.createDataFrame(words_rdd.map(lambda w: (w,)), ["words"]))
    idf = IDF(inputCol="rawFeatures", outputCol="features")
    idf_model = idf.fit(tf_df)
    tfidf_df = idf_model.transform(tf_df)
    def extract_top_words(row):
        word_scores = []
        for i in range(len(row['words'])):
            score = float(row['features'][i])
            if score > 0.0:
                word_scores.append((row['words'][i], score))
        return word_scores
    top_keywords = tfidf_df.rdd.flatMap(extract_top_words)
    result = top_keywords.reduceByKey(lambda a, b: max(a, b)).sortBy(lambda x: x[1], False).take(30)
    return result
def process_kmeans_clustering(rdd):
    def extract_features(x):
        likes = float(x['点赞数']) if x['点赞数'] is not None else 0.0
        content_len = float(len(x['内容']) if x['内容'] else 0)
        sentiment_code = float(sentiment_map.get(x['情感倾向'], 1))
        pub_hour = float(parse_hour(x['发布时间']) if x['发布时间'] else 0)
        return Vectors.dense(likes, content_len, sentiment_code, pub_hour)
    data = rdd.map(extract_features)
    df = spark.createDataFrame(data.map(lambda x: (x,)), ["features"])
    scaler = StandardScaler(inputCol="features", outputCol="scaledFeatures", withStd=True, withMean=True)
    scaled_df = scaler.fit(df).transform(df)
    kmeans = KMeans(featuresCol="scaledFeatures", predictionCol="cluster", k=4, maxIter=20, seed=42)
    model = kmeans.fit(scaled_df)
    predictions = model.transform(scaled_df)
    centers = model.clusterCenters()
    cluster_counts = predictions.groupBy("cluster").count().collect()
    sample_data = predictions.select("features", "cluster").take(20)
    return centers, cluster_counts, sample_data
def process_fpgrowth_tags(rdd):
    region_counts = rdd.map(lambda x: (x['来自于'], 1)).reduceByKey(lambda a, b: a + b)
    top_regions = region_counts.sortBy(lambda x: x[1], False).take(10)
    top_region_set = set([r[0] for r in top_regions])
    def build_transaction(x):
        items = []
        if x['情感倾向'] is not None:
            items.append(str(x['情感倾向']))
        if x['来自于'] in top_region_set:
            items.append(str(x['来自于']))
        return items
    transactions = rdd.map(build_transaction).filter(lambda x: len(x) > 0)
    df = spark.createDataFrame(transactions.map(lambda x: (x,)), ["items"])
    fpg = FPGrowth(itemsCol="items", minSupport=0.05, minConfidence=0.3)
    model = fpg.fit(df)
    freq_itemsets = model.freqItemsets().collect()
    assoc_rules = model.associationRules().collect()
    transformed_rules = []
    for rule in assoc_rules:
        antecedent = list(rule.antecedent)
        consequent = list(rule.consequent)
        confidence = float(rule.confidence)
        support = float(rule.lift)
        transformed_rules.append((antecedent, consequent, confidence, support))
    return freq_itemsets, transformed_rules
白鹿的抖音评论分析与可视化系统-结语
在计算机毕业设计过程中遇到技术难点是很正常的情况,如果你也在做 Hadoop 或 Spark 相关的大数据毕设,或者对这套系统的具体实现细节感兴趣,欢迎在评论区留言讨论,我会尽量解答大家的疑问,一起交流学习、共同进步。觉得这篇内容对你有帮助的话,可以点赞、收藏、关注支持一下,方便第一时间获取后续的模块拆解与技术分享。也欢迎在评论区分享你在项目实现中遇到的具体问题,后续会根据大家的需求安排对应方向的详细讲解。
实战项目:有源码或者技术上的问题欢迎在评论区一起讨论交流!
如果遇到具体的技术问题或其他需求,你也可以问我,我会尽力帮你分析和解决问题所在,支持我记得点赞、收藏,再点个关注,学习不迷路!~~