《Jev-IDS:网络入侵检测一种系统模型》论文深度分析总结
一、论文概览与总体评价
1.1 论文基本信息
本论文题为《Jev-IDS: A System One Model for Network Intrusion Detection in Label-Scarce and Zero-Day Scenarios》,作者为 Paulo Severo、Silvio E. Quincozes(通讯作者)与 Amanda Dias,其中第一作者隶属于巴西联邦帕姆帕大学(UNIPAMPA)软件工程研究生项目。论文的关键词为:网络入侵检测(Network Intrusion Detection)、Jev、System One Model(SOM)、上下文学习(In-Context Learning)、少样本学习(Few-Shot Learning)、网络安全(Cybersecurity)。
从整体定位看,这是一篇"方法验证型"论文:它不声称发明了提示式检测、少样本分类或结构化输出这些既有技术,而是首次把"System One Model"这一类新型决策模型作为逐流(per-flow)流量分类器引入入侵检测,并在受控实验条件下,与结构化输出的生成式 LLM 和传统机器学习基线进行系统比较。其方法学价值在于"在匹配的信息预算下进行联合评估"------同时测量检测精度、标签使用量、延迟与成本四个维度。
1.2 一句话概括论文贡献
论文的核心命题是:SOM 类模型(以 JEV 为代表)可以在标签稀缺与零日攻击场景下,以远低于生成式 LLM 的延迟和成本、远低于低数据传统模型的误报率,获得有竞争力的入侵检测性能。JEV 与生成式 LLM 之间不是简单的"谁更准",而是"检测性能---推理效率"这一权衡曲线上的不同位置。
二、研究背景与问题动机
2.1 传统学习式 NIDS 的标注困境
网络入侵检测系统(NIDS)通过监控网络流量识别恶意活动,为及时的事件响应提供支撑。基于学习的 NIDS 用流量特征识别攻击模式,替代人工逐条编写检测规则。但论文明确指出:这类系统的实际价值不只看分类准确率------漏报使服务暴露在风险中,误报增加安全团队的运维负担,推理开销则限制了可检测的流量规模。
传统监督式检测器依赖能"充分代表实际部署流量与攻击"的标注数据。当攻击类型稀有或新出现时,获取这种标注数据极其困难,这催生了"仅凭少量示例即可适应"的研究方向。论文将这种少样本场景明确划分为两种不同性质的评估:若攻击类型出现在示例池中,对新流分类衡量的是少样本泛化 ;若攻击类型不在示例池中,实验衡量的是识别未见攻击(即模拟零日)的能力。这一区分构成了全文实验设计的主轴。
2.2 LLM 检测的机会与代价
大语言模型(LLM)的兴起提供了降低对任务特定训练依赖的机会:通过把流量记录文本化,配合指令和可选示例,提示式 LLM 无需更新模型参数即可完成入侵分类。但论文强调,LLM 检测存在三个操作性局限:
- 推理开销高:有对比证据表明,LLM 的推理开销显著高于强传统分类器,却未必在性能上胜出;对高流量速率 NIDS 而言,基于 LLM 的检测器每秒可处理的流量远少于传统机器学习模型。
- 输出需要控制:自回归 LLM 通过逐 token 生成表达决策,即使施加语法约束(如 JSON schema),也只是限制了响应格式,并未消除 token 生成过程本身;结构化响应中仍然包含字段名、分隔符、解释性文本等对"只需要类别标签和攻击概率"的 IDS 而言多余的 token。
- 成本随流量累积:商业 API 按 token 计费,多余输出 token 直接转化为逐请求成本,并随处理流量规模累积放大。
因此,论文主张对"输出有效性、预测正确性、延迟、资源消耗、货币成本"五项指标分别评估,不能混为一谈。
2.3 System One Model:类型化概率决策的新范式
TypeSafe AI 引入了 SOM 这一模型家族概念,其设计目标是直接返回有界、概率化的类型化判断,而非自由文本。JEV 是该类模型中第一个公开可用的实现(2026 年 9 月发布)。SOM 的文档化接口接收"状态 + 一组类型化问题":
- noul 问题:对某个二值命题返回 0,1 区间内的概率值;
- choice 问题:从预定义选项集合中返回一个选项及其对应概率。
多个问题可共享同一状态并被独立评估,应用程序通过普通程序逻辑组合这些答案。这一接口的意义在于:把"语义判断"与"响应生成"分离------应用在推理前就定义了合法答案空间,拿到的是可直接用于阈值化、排序或路由的值;同时把"决策模型"与"完整 Agent"分离,后者还需要状态管理和执行策略。
论文同时给出一个清醒的方法论提示:类型化概率不等于校准概率。概率是否与实际结果频率一致,需要针对每个模型和任务单独评估。此前将 JEV 用于警察事故记录文本信息抽取的研究即发现,即使概率是直接返回的,校准性仍需验证。这一提示为后文"阈值选择与校准是未来工作"埋下伏笔。
2.4 研究问题与四大贡献
基于上述背景,论文凝练出三个待答问题:SOM 能否区分良性流与恶意流?少量标注示例能否改善其决策?在受控 NIDS 对比中其操作性优势(延迟/成本)是否保持?
论文归纳的四大贡献为:
- 提出 JEV-IDS------首个将 SOM 通过类型化概率与有限选择问题集成到基于流的 NIDS 中的系统(第 4 节);
- 定义受控评估协议:可变标注示例数量、可模拟零日场景(第 5 节);
- 在两个入侵数据集上、以每类别 1--2 个标注示例和三个随机种子,对比三个检测器的检测错误、延迟与估计成本(第 6 节);
- 开放全部复现材料:实现代码、提示词、冻结切分(frozen splits)与逐流 pilot 预测结果(第 5 节)。
三、相关工作梳理
3.1 语言模型作为流量分类器
早期研究确立了"网络记录可文本化并通过提示分类"的技术路线:Zhang 等考察上下文示例用于自动入侵检测;Hussel 等评估零样本与微调模型并研究生成式解释;Bui 等比较提示、检索与微调在安全事件上的表现。这些工作的共同点是"任务适应从参数更新转移到指令、示例或检索上下文",但判定结果仍是生成响应的一部分。
后续研究给这条路径施加了更多结构:RLFE-IDS 用检索增强记录(RAG)先通过学习到的网络特定嵌入检索相似流量,再让 LLM 分类;Rehman 等组合流实现、人工指标、语法约束 JSON 与在开发数据上选取的决策阈值------这是"机器可读、带分数输出"的最接近先例,但受约束的生成分数不等同于推理前就定义好合法答案的模型接口,这是论文与既有工作本质区别的关键论点。
2026 年发表的研究进一步拓宽了标签效率与运行成本的证据:Mehavilla 等比较微调与预训练语言模型对传统 ML/DL 基线,包含推理吞吐量与资源使用;Guan 等把少样本流量分类表述为无需更新权重的自然语言元任务,实测约每样本 0.8--4.0 秒,说明"免除训练并不免除逐条记录的推理开销";Lv 和 Ding 组合检索、重排与少样本 LLM 推理;LLM-NIRED 微调紧凑语言模型处理 token 化流序列并评估跨网络迁移与受限设备部署;Uccello 和 Nadjm-Tehrani 直接研究 5G 遥测上零样本/少样本 LLM 推理的性能---成本权衡。
3.2 语言模型作为 NIDS 支持组件
另一类混合系统把 LLM 放在逐流决策路径之外:Think Fast 在边缘运行轻量检测器,仅将紧凑遥测发给 LLM 做威胁解读与缓解建议;SCALA-NIDS 让 LLM 观察运行时统计量并选择有界的适应意图,而师生检测器处理流量、候选更新需通过安全验证。这些系统是重要的架构先例------把语言模型推理保留给更高级决策,但其运行测量刻画的是"告警解读或偶尔适应"的成本,而非"用通用模型逐流分类"的成本。
3.3 JEV-IDS 的定位
至此文献版图清晰:提示、检索、微调、约束生成、跨网络迁移、LLM 引导适应均已被覆盖,但据作者所知,尚无 NIDS 研究把 SOM 作为直接流分类器评估。JEV-IDS 正是填补这一空白:它在每个实验单元内固定流量表示与标注示例,隔离示例池之外的攻击类别名,并把预测结果与成功调用延迟、目录价成本挂钩。
四、JEV-IDS 系统架构
4.1 总体架构(Figure 1)
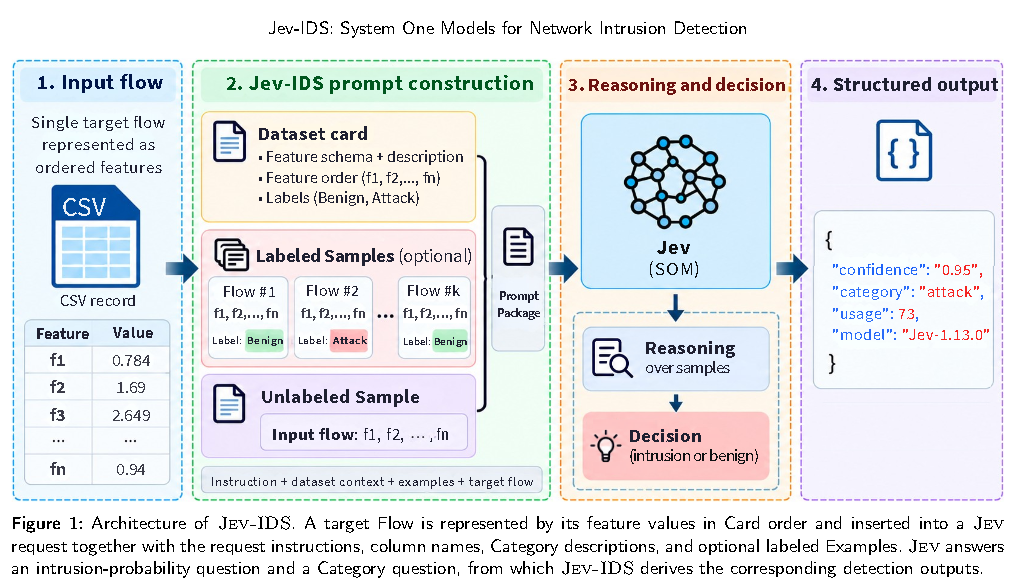
【Figure 1(原文图片,此处以文字还原)】JEV-IDS 系统架构图:图中展示一条目标网络流(Target Flow)的处理路径。左侧为目标流的特征值,按数据集卡(Card)定义的字段顺序排列;这些特征值被插入一个 JEV 请求中,请求同时包含固定请求指令(instructions)、列名(column names)、类别描述(Category descriptions)以及可选的标注示例(labeled Examples)。右侧为 JEV 模型:它针对同一状态回答两个类型化问题------入侵概率问题(intrusion-probability question)与流量类别问题(Category question)。JEV-IDS 从这两个答案中推导出对应的检测输出:攻击概率 p_attack、预测类别 category_pred、置信度 confidence,以及本地计算的二元判定 Verdict。图中清晰体现了"目标流特征 → 请求组装 → JEV 双问题评估 → 检测输出提取"的四阶段流水线。
JEV-IDS 作为围绕 JEV 构建的入侵检测流水线,每次处理一条网络流,包含四个主阶段:构造有序流表示;从固定请求模板和可选标注示例构造 JEV 请求;让 JEV 评估两个类型化问题;提取对应检测输出。
4.2 流表示与数据集卡(Dataset Card)
数据集由一张 Card 描述,定义其名称、有序特征(ordered features)、符号特征、类别集合以及良性类别。一条 Flow 包含这些特征的值及 JEV-IDS 维护的类别信息。发往 JEV 的请求只使用目标流的特征值,这些值按 Card 定义的顺序连接为逗号分隔字符串,与源 CSV 的列顺序无关。
设计上有一个关键约束:目标流的类别与攻击状态不出现在请求中,具体攻击名也不属于提供给检测器的流表示。这对 NSL-KDD 尤为重要------其中个别攻击名在内部映射到更粗的类别(如 DoS、R2L),检测器只能看到粗粒度类别空间,从而保证"零日"评估的纯洁性。
4.3 JEV 请求构建
请求基于数据集特定的 JSON 模板构造:模板定义 JEV 模型(当前配置显式指定 jev-1.13.0 版本)、包含任务指令/有序列名/类别描述的 state,以及两个类型化问题。请求时,JEV-IDS 将目标流加入 state.flows.under_test;有标注示例时加入 state.examples。每个示例只含逗号分隔的特征值与类别标签------具体攻击名不会发给 JEV,类别描述同时充当类别问题的判定标准。
4.4 类型化决策与检测输出
同一请求内向 JEV 提出两个问题:
- is_attack (noul 问题):询问该流代表入侵而非正常流量,答案解释为攻击概率 p a t t a c k ( x ) p_{attack}(x) pattack(x);
- category(choice 问题):选项为数据集定义的类别,答案给出预测类别及对应置信度。
由于是类型化答案,JEV-IDS 直接读取返回字段,无需解析自由文本。三个检测字段的映射为:answers.is_attack.noul → p_attack;answers.category.choice → category_pred;answers.category.confidence → confidence。
二元 Verdict 不由 JEV 返回,而是本地由 p_attack 计算,决策规则为论文中的公式 (1):
y ^ ( x ) = { 1 , p attack ( x ) ≥ 0.5 , 0 , p attack ( x ) < 0.5 , ( 1 ) \hat{y}(x) = \begin{cases} 1, & p_{\text{attack}}(x) \ge 0.5, \\ 0, & p_{\text{attack}}(x) < 0.5, \end{cases} \qquad (1) y^(x)={1,0,pattack(x)≥0.5,pattack(x)<0.5,(1)
其中 y ^ = 1 \hat{y} = 1 y^=1 表示攻击判定, y ^ = 0 \hat{y} = 0 y^=0 表示正常判定。检测接口还保留响应报告的模型版本、请求延迟与供应商用量信息(输入/输出 token 数),完整供应商响应与提取字段分离存档。
4.5 执行与部署
请求执行采用"每请求一条流"模式;瞬时网络故障、限流响应与部分服务器错误触发指数退避,单请求最多尝试 5 次,全部失败则返回错误而非抛异常,从而把通信失败与成功响应分离。部署定位上,JEV-IDS 是异步旁路通道 而非内联包过滤器:传感器可继续向既有安全基础设施供流,流记录副本异步提交给 JEV-IDS;队列解耦流导出与处理;使用托管服务时仅传输选定的流特征,数据包载荷不出现在请求中。
五、实验设计与方法
5.1 实验因素设计
实验考察三个因素:检测器、每类别标注示例数 k、采样种子 。每个种子下,标注示例独立于评估集从训练池采样;采样跨 k 嵌套(小预算下的示例在大预算下保留);同一采样示例被所有检测器共用。JEV 与生成式基线取 k ∈ { 0 , 1 , 2 , 4 , 8 } k \in \{0,1,2,4,8\} k∈{0,1,2,4,8}(k=0 为零样本);Random Forest 取 k ∈ { 1 , 2 , 4 , 8 } k \in \{1,2,4,8\} k∈{1,2,4,8},并额外用完整标注训练池训练,提供全监督参考。每个有限 k 条件使用 3 个独立种子。目标流独立分类;产生攻击概率的检测器用公共决策阈值做二值判定;无有效预测的输出按"故障开放(fail-open)"约定记为良性并单独计入调用错误率。
5.2 三个对比基线
- 结构化输出 LLM(Gemini 3.6 Flash):与 JEV 接收相同的有序流表示、类别描述与标注示例;输出含攻击概率、二值分类与预测类别;采用确定性生成设置以降低与示例采样无关的变异性。
- Random Forest(100 棵树):数值属性直接表示、类别属性 one-hot 编码;每个有限 k 用与 JEV 完全相同的标注流训练;附加条件用完整训练池训练。
- Isolation Forest(100 棵树):无监督参考,只用训练池良性流训练,异常分数用于区分正常与异常流量,代表"训练时没有任何攻击示例"的检测设定。
5.3 数据集与评估协议
实验使用 NSL-KDD 数据集。论文坦承 NSL-KDD 不能反映当代网络流量,但它是入侵检测研究中使用最广的历史基准之一,可对接大量前人工作;其训练/测试集界限清晰,能显式区分"池中存在"与"池中缺失"的攻击类型,非常适合研究标签稀缺下的检测行为。因此论文将其定位为"受控比较与可复现性的方法学基准",而非当代运营网络的代理。
KDDTrain+ 构成训练池(从中获取标注示例),评估流仅从 KDDTest+ 采样,确保没有任何评估流参与示例选择或基线拟合。评估集共 2,000 条流,构成如 Table 1。
Table 1:NSL-KDD 评估集组成
| Flows | Normal | DoS | Probe | R2L | U2R |
|---|---|---|---|---|---|
| 2,000 | 874 | 642 | 213 | 248 | 23 |
即 874 条正常流、1,126 条攻击流(DoS 642、R2L 248、Probe 213、U2R 23),评估集在执行前固定、跨所有实验条件共享。
为进一步评估超越训练池的泛化,攻击实例被划分为已知 与新颖两类:当某个具体攻击类型出现在 KDDTest+ 而缺失于 KDDTrain+ 时,该攻击被视为新颖。据此,1,126 条攻击流中 300 条为新颖,826 条属训练池已代表的类型。检测器只能输出五个粗类别(normal、DoS、probe、R2L、U2R),具体攻击名不提供。
5.4 评估指标
主指标为攻击类的 F1 分数:
F 1 = 2 T P 2 T P + F P + F N ( 2 ) F_1 = \frac{2TP}{2TP + FP + FN} \qquad (2) F1=2TP+FP+FN2TP(2)
另报告精确率、攻击召回率、PR-AUC、ROC-AUC 及各流量类别召回率;为考察对未见攻击类型的泛化,召回率分别对已知/新颖攻击单独计算;子集 F1 分析中,选定的攻击子集与全部正常流一起评估,保证误报始终体现在指标中。有限 k 条件的指标先按种子独立计算再跨 3 个种子汇总,F1 以均值±样本标准差报告。成本按"每百万流分类"归一化,由实验当时适用的公开目录价估算。
5.5 统计分析与可复现性
成对比较基于同一评估流、等价 k 与种子的预测结果,采用双侧精确 McNemar 检验 检验二值分类结果的差异;跨监督制度比较(如少样本检测器 vs 全池训练 RF)单独处理并明确标注为跨预算比较。全部评估集、示例选择、检测器配置、提示词与源码修订号被固定并记录,逐预测输出与实验条件一起留存,可在 https://github.com/jevids/jev-ids 获取实现与实验工件。
六、实验结果
6.1 总体检测性能
每个有限 k 条件包含 6,000 次决策(2,000 条目标流 × 3 个独立示例集)。Table 2 汇总了 2,000 流评估集上的预测结果。
Table 2:2,000 流 NSL-KDD 评估集上的预测结果(F1 为跨三个示例种子的均值±样本标准差,其余指标为种子均值)
| Detector | k | F1 | Precision | Recall | Known recall | Novel recall | PR-AUC | ROC-AUC |
|---|---|---|---|---|---|---|---|---|
| JEV | 0 | 0.782 ± 0.005 0.782 \pm 0.005 0.782±0.005 | 0.972 | 0.654 | 0.665 | 0.622 | 0.940 | 0.925 |
| JEV | 1 | 0.856 ± 0.025 0.856 \pm 0.025 0.856±0.025 | 0.953 | 0.778 | 0.790 | 0.747 | 0.952 | 0.950 |
| JEV | 2 | 0.846 ± 0.009 0.846 \pm 0.009 0.846±0.009 | 0.949 | 0.763 | 0.772 | 0.738 | 0.949 | 0.944 |
| JEV | 4 | 0.856 ± 0.015 0.856 \pm 0.015 0.856±0.015 | 0.944 | 0.784 | 0.803 | 0.731 | 0.959 | 0.959 |
| JEV | 8 | 0.854 ± 0.017 0.854 \pm 0.017 0.854±0.017 | 0.942 | 0.783 | 0.805 | 0.721 | 0.964 | 0.962 |
| Gemini 3.6 Flash | 0 | 0.867 ± 0.005 0.867 \pm 0.005 0.867±0.005 | 0.946 | 0.801 | 0.842 | 0.687 | 0.949 | 0.959 |
| Gemini 3.6 Flash | 1 | 0.880 ± 0.020 0.880 \pm 0.020 0.880±0.020 | 0.942 | 0.826 | 0.866 | 0.713 | 0.948 | 0.959 |
| Gemini 3.6 Flash | 2 | 0.869 ± 0.017 0.869 \pm 0.017 0.869±0.017 | 0.943 | 0.806 | 0.849 | 0.684 | 0.947 | 0.959 |
| Gemini 3.6 Flash | 4 | 0.884 ± 0.002 0.884 \pm 0.002 0.884±0.002 | 0.942 | 0.833 | 0.875 | 0.717 | 0.946 | 0.958 |
| Gemini 3.6 Flash | 8 | 0.881 ± 0.012 0.881 \pm 0.012 0.881±0.012 | 0.949 | 0.823 | 0.867 | 0.702 | 0.951 | 0.961 |
| Random Forest | 1 | 0.748 ± 0.036 0.748 \pm 0.036 0.748±0.036 | 0.598 | 1.000 | 1.000 | 1.000 | 0.791 | 0.740 |
| Random Forest | 2 | 0.777 ± 0.062 0.777 \pm 0.062 0.777±0.062 | 0.644 | 0.987 | 0.988 | 0.983 | 0.875 | 0.854 |
| Random Forest | 4 | 0.853 ± 0.011 0.853 \pm 0.011 0.853±0.011 | 0.771 | 0.955 | 0.969 | 0.914 | 0.913 | 0.907 |
| Random Forest | 8 | 0.865 ± 0.013 0.865 \pm 0.013 0.865±0.013 | 0.794 | 0.950 | 0.964 | 0.912 | 0.935 | 0.922 |
| Random Forest | all | 0.765 ± 0.000 0.765 \pm 0.000 0.765±0.000 | 0.971 | 0.631 | 0.764 | 0.263 | 0.963 | 0.964 |
结果呈现三个鲜明特征:
其一,生成式 LLM 总体更强。 Gemini 在每一个评估的 k 值上都取得比 JEV 更高的总体 F1。以 k=1 为例,Gemini 的 F1 为 0.880,JEV 为 0.856,差距主要来自攻击召回率(0.826 vs 0.778)。
其二,少样本 Random Forest 呈现截然不同的精确率---召回率权衡。 k=1 时它检出了全部攻击(召回率 1.000),但精确率仅 0.598------对应每个种子的 874 条正常流中约 764 条误报,而 JEV 仅约 43 条。增加标注预算逐步改善该行为:k=8 时 RF 达到 F1=0.865、精确率 0.794,但仍远多于两个模型类检测器的误报。值得注意的是,用完整标注池训练的 RF 在评估集上并未变得更好:精确率升至 0.971,但召回率降至 0.631,新颖攻击召回率骤降至 0.263------"数据更多"没有转化为对评估集(特别是未见攻击)的更好表现。
其三,Isolation Forest 呈保守运行剖面。 其精确率 0.974、召回率 0.624,新颖攻击召回率 0.573------高于全监督 RF 的 0.263,但低于对应的少样本 JEV 与 Gemini 条件。论文由此总结:仅凭总体 F1 无法完整刻画检测器差异,尤其当把误报成本与标注可用性纳入考量时。
6.2 对新颖攻击的泛化
这是全文最核心的问题:标注示例能否帮助检测器识别"示例池中不存在"的攻击类型?结果呈现一个有趣的"反转":
- 零样本(k=0)时,Gemini 在新颖攻击上的召回率高于 JEV(0.687 vs 0.622);
- 一旦引入标注示例,JEV 在新颖攻击召回率上持续反超:k=1、2、4、8 分别为 0.747、0.738、0.731、0.721,而 Gemini 为 0.713、0.684、0.717、0.702。
但差异并非跨类别均匀分布:最大分离出现在新颖 R2L 攻击------有标注示例时 JEV 在 k=1、2、4、8 上分别取得 0.151、0.198、0.262、0.222 的召回率,而 Gemini 仅 0.071、0.000、0.008、0.008;反之,Gemini 在若干其他攻击类型(最明显是 probe 流量)上更强。因此,聚合新颖召回率反映的是"不同攻击族上的差异化泛化行为",而非某一检测器对所有未见攻击类型的一致优势。
Random Forest 则说明了"新颖攻击召回率不能孤立看待":少样本条件下它在新颖攻击上的召回率达 0.912--1.000,但代价是精确率大幅下滑------k=1 时完美的新颖攻击召回伴随总体精确率仅 0.598。新颖攻击的检测能力必须与相应的误报率同时考量。
6.3 成对统计比较(McNemar 检验)
Table 3 报告 JEV 与 Gemini 的成对比较。全流比较含 6,000 个配对决策,已知/新颖攻击子集分别含 2,478 与 900 个配对决策。
Table 3:JEV 与 Gemini 3.6 Flash 的成对比较("Jev correct"与"Gemini correct"列为不一致决策中被正确分类的实例数)
| Subset | k | Pairs | Discordant | Jev correct | Gemini correct | Exact p |
|---|---|---|---|---|---|---|
| All Flows | 0 | 6,000 | 833 | 213 | 620 | < 0.001 |
| All Flows | 1 | 6,000 | 508 | 195 | 313 | < 0.001 |
| All Flows | 2 | 6,000 | 515 | 199 | 316 | < 0.001 |
| All Flows | 4 | 6,000 | 506 | 178 | 328 | < 0.001 |
| All Flows | 8 | 6,000 | 472 | 159 | 313 | < 0.001 |
| Known attacks | 0 | 2,478 | 489 | 25 | 464 | < 0.001 |
| Known attacks | 1 | 2,478 | 266 | 38 | 228 | < 0.001 |
| Known attacks | 2 | 2,478 | 235 | 22 | 213 | < 0.001 |
| Known attacks | 4 | 2,478 | 227 | 24 | 203 | < 0.001 |
| Known attacks | 8 | 2,478 | 190 | 18 | 172 | < 0.001 |
| Novel attacks | 0 | 900 | 206 | 74 | 132 | < 0.001 |
| Novel attacks | 1 | 900 | 118 | 74 | 44 | 0.007 |
| Novel attacks | 2 | 900 | 162 | 105 | 57 | < 0.001 |
| Novel attacks | 4 | 900 | 167 | 90 | 77 | 0.353 |
| Novel attacks | 8 | 900 | 171 | 94 | 77 | 0.221 |
解读如下:
- 完整评估集与已知攻击:Gemini 在每个 k 值上正确更多的不一致决策(全部 p<0.001),与 Table 2 中其更高的总体与已知攻击召回率一致。
- 新颖攻击:k=1 时 JEV 在 118 个不一致决策中正确 74 个、Gemini 44 个(p=0.007);k=2 时差距扩大------JEV 105 vs Gemini 57(p<0.001)。虽然 JEV 在 k=4、k=8 上仍保持数值更高的新颖攻击召回率,但配对检验未识别出显著差异(p=0.353 与 p=0.221)。
论文的结论措辞相当克制:引入标注示例后 JEV 在新颖攻击类型上获得一致更高的召回率,但统计证据在最小示例预算下最强;这一效应不应被解释为检测未见攻击的一般性优势。
6.4 运行效率
对基于 API 的 IDS,逐流评估的计算成本不可忽略。Table 4 报告 JEV 与 Gemini 的请求延迟与估计目录价成本。
Table 4:JEV 与 Gemini 3.6 Flash 的运行对比(成本为每百万流决策的估计目录价,延迟为成功模型请求的平均墙钟时长;比值为 Gemini/JEV)
| k | JEV cost | Gemini cost | Cost ratio | JEV latency | Gemini latency | Latency ratio |
|---|---|---|---|---|---|---|
| 0 | US$43 | US$1,068 | 25× | 310 ms | 2.24 s | 7.2× |
| 1 | US$74 | US$1,651 | 22× | 315 ms | 2.42 s | 7.7× |
| 2 | US$106 | US$2,409 | 23× | 308 ms | 2.65 s | 8.6× |
| 4 | US$169 | US$2,869 | 17× | 322 ms | 2.13 s | 6.6× |
| 8 | US$295 | US$3,035 | 10× | 335 ms | 1.99 s | 5.9× |
在全部评估的示例预算下,JEV 每次成功请求约需 0.31--0.34 秒,Gemini 需 1.99--2.65 秒;JEV 每百万流决策的估计成本为 US43--295,Gemini 为 US1,068--3,035。k=1 时(每个检测器共 5 个标注示例)JEV 的请求延迟约低 7.7 倍、估计目录价成本约低 22 倍;这一运行差异伴随的 F1 降幅仅 0.024,且 JEV 保持略高的精确率(0.953 vs 0.942)。全程延迟比介于 5.9×--8.6×,成本比介于 10×--25×。
七、讨论:权衡、局限与扩展方向
7.1 主要发现不是"更准"而是"不同权衡"
论文明确总结:主要发现并非 SOM 在检测精度上持续超越生成式 LLM,而是它提供了"预测性能---推理效率"之间的一种独特权衡。Gemini 依靠更高的攻击召回率在整体 F1 上占优,JEV 则以可比精确率和显著更低的延迟、成本相抗衡。对模型调用成本与响应时间约束"AI 检测器能铺开多广"的 IDS 场景而言,这一区别具有现实意义。
7.2 混合级联策略的设想
由于 JEV 同时暴露结构化攻击分数与预测类别,论文提出混合策略设想:构建级联架构 ------简单情况由低成本组件处理,不确定情况升级到更昂贵的生成模型或人工分析师。这种架构有望结合 JEV 的效率与 LLM 更强的总体召回率。但论文强调这尚未被本文评估,只是未来研究方向,不应视为 JEV-IDS 的既得收益。
7.3 局限性的清醒声明
论文对自身边界保持清醒:NSL-KDD 是受控、广泛使用的基准,支持与既往 IDS 研究可复现比较,但不代表当代运营流量 ;本文的新颖性定义同样是特定的------攻击具体类型不在训练池,不等于根本性的新行为或新漏洞。因此,新颖攻击召回率的差异应被理解为"该基准内跨保留攻击类型的泛化证据",而非运营网络中零日检测的直接证据。此外,使用公共决策阈值便于受控比较,但不应被解读为每个检测器的优化部署配置,阈值选择与概率校准仍是未来评估的重要维度。
7.4 未来工作的四条路径
论文提出:①在更新、更多样的数据集上评估,并引入训练/测试流量间的时间或组织隔离;②研究概率校准、在独立验证集上做检测器特定阈值选择;③引入更强的表格学习基线;④统计上显式考虑同一目标流跨多次示例抽取被重复评估的依赖性,并增加种子数以更稳健地表征少样本采样的变异性。
八、结论
论文回答的核心问题是:SOM 能否在有限标注监督下有效用于流式网络入侵检测?答案是肯定的。JEV-IDS 将有序流表示、可选类别标注示例、类型化攻击与类别问题、结构化输出组合为检测流水线,通过避免任务特定训练、保持简单管道与可追溯推理记录,与传统监督方法形成差异。
结果表明:JEV 在仅有少量标注示例时即可获得强检测性能------在 NSL-KDD pilot 中,它在所考察的设置下取得评估方法中的最佳总体结果,误报少于 Random Forest,新颖攻击检测优于 GPT-5.6 Luna,且在标注最少时呈现有利的延迟与估计推理成本。未来工作将扩展 k 值与其他数据集,加强统计(考虑种子与重复引入的依赖性),并进一步研究概率校准、对新颖攻击的鲁棒性及真实网络条件下的运行行为。
九、综合评析(分析视角)
作为一篇方法验证型论文,JEV-IDS 有以下值得称道之处与可挑剔之处。
亮点一:实验设计的严谨性。 "冻结切分 + 嵌套采样 + 三种子 + 公共阈值 + fail-open 约定 + 全材料开源"构成了一个可复现性极强的协议;"已知/新颖攻击"的显式划分直接对接零日检测场景,比笼统报告总体 F1 更有信息量。McNemar 精确检验的使用也避免了"只看均值高低"的常见误区。
亮点二:多维评估观。 论文坚持"精度、标签使用、延迟、成本"联合测量,并给出误报数的绝对量级(k=1 时 RF 约 764 次 vs JEV 约 43 次),这一呈现方式比单一 F1 更能指导工程取舍。
亮点三:对"类型化概率≠校准概率"的自觉。 论文没有把 SOM 接口的"直接返回概率"神化,明确提示校准与阈值选择留待后续,这是方法论成熟度的体现。
可挑剔之处:
- 基准陈旧:NSL-KDD 反映的是二十余年前的流量格局,DoS/R2L/U2R 的类别划分与现代攻击形态差异巨大,结论向真实运营场景外推的力度有限------论文自己对此有充分声明。
- 对比口径略有不一致:摘要与结论中生成式对比对象写的是 GPT-5.6 Luna(pilot 阶段),正文正式评估却用 Gemini 3.6 Flash,读者需要自行厘清两个阶段的对象差异。
- 示例数极少:k 最大仅 8,每类别示例个位数,虽符合"标签稀缺"定位,但"增加 k 是否持续改善"的规律(Table 2 显示 JEV 在 k≥1 后 F1 基本持平甚至波动)未被深入解释。
- 新颖攻击的类别间不均衡:JEV 的优势集中在 R2L,Gemini 在 probe 更强,聚合指标可能掩盖"对哪类未见攻击更鲁棒"的机制性差异,论文已承认但未深入。
对后续研究的启示:若将 JEV-IDS 的协议迁移到更现代的数据集(如 CIC-IDS 系列),并补上校准分析、级联架构验证与"时间隔离"切分,将能更扎实地回答"SOM 是否值得成为逐流检测的候选组件"。总体而言,这篇论文以干净的方法、克制的结论和开放的态度,为"类型化决策模型进入网络安全"开辟了一个可复现的起点。