【数据结构】二叉树
概览
- 树的概念与常用术语
- 树的三种表示方法
- 二叉树的概念与两种特殊形态
- 二叉树的性质与推导
- 链式结构的结点定义
- 前序、中序、后序三种递归遍历
- 层序遍历与队列
- 结点个数、叶子数、高度
- 从前序与中序序列还原一棵树
- 销毁为什么必须用后序
核心知识
一、树是什么
树是一种非线性结构,由 n 个有限结点组成,结点之间具有层次关系,n 等于 0 时是一棵空树。其中有一个结点没有前驱,称为根结点;除根结点之外,其余结点被分成若干个互不相交的集合,每个集合本身又是一棵结构相同的树。
「每个集合本身又是一棵树」,这句话让树的定义本身就带上了递归的形式。遍历、统计结点、求高度、销毁,这些操作照着定义写出来就是递归:先处理根,再对左右子树做同样的事。
递归写法的代码里看不到循环,取而代之的是一个出口加一次自我调用。每一层的逻辑都短,一眼能看完,代价是调用关系藏在函数体里,读代码的时候要在脑子里自己维护一棵调用树。从这一节往后的实现都按同一个模板展开:先写出口,再写当前结点要做什么,最后把两棵子树的结果合起来。
子树之间不能有交集,如果两个子树共用了同一个结点,这个结构就不再是树。判断一段层次结构是不是树,只需要检查有没有出现这种共用。
二、常用术语
| 术语 | 含义 |
|---|---|
| 结点的度 | 一个结点含有的子树个数 |
| 叶子结点 | 度为 0 的结点,也叫终端结点 |
| 分支结点 | 度不为 0 的结点 |
| 双亲结点 | 一个结点上方与它直接相连的结点 |
| 孩子结点 | 一个结点下方与它直接相连的结点 |
| 兄弟结点 | 具有同一个双亲的结点 |
| 堂兄弟结点 | 双亲在同一层的结点 |
| 树的度 | 整棵树里最大的结点度 |
| 结点的层次 | 从根算起,根为第 1 层,往下依次加一 |
| 树的高度 | 结点的最大层次 |
| 祖先与子孙 | 从根到某结点路径上的都是它的祖先,以某结点为根的子树里全是它的子孙 |
| 森林 | 若干棵互不相交的树的集合 |
拿一个常见的例子对照:根结点 A 有六个孩子,那么 A 的度是 6,整棵树的度也是 6(如果没有更大的)。没有孩子的结点是叶子;B 和 C 是兄弟,H 和 I 的父亲在同一层,所以它们是堂兄弟。
三、树怎么存
树比线性表复杂的地方在于,它既要存值,又要存结点之间的关系。常见的表示有三种,三者解决的是同一件事,取舍各不相同。
双亲表示法。 数组里存的是每个结点的父亲是谁,下标就是结点编号。这种结构找父亲只要一次下标运算,找孩子却要把整张表扫一遍,并查集采用的就是这种存法。
孩子表示法。 每个结点挂一个链表,链表里放它所有的孩子。顺着链表就能拿到一个结点的全部孩子,反过来找父亲则要把整张表遍历一遍。
孩子兄弟表示法。 结点里放两个指针,一个指向第一个孩子,一个指向下一个兄弟。这种写法把任意形状的树都压成了二叉树的样子,两个指针就够了,代价是找某个结点的所有孩子要顺着兄弟链一路走下去,取第 k 个孩子是 O(k)。三种表示法各有各的短板,选哪一种取决于代码里最常做的是找父亲还是找孩子。
c
# 文件:/home/cocatrice/ds12/btree.h
typedef struct TreeNode
{
	struct TreeNode* firstChild;   /* 第一个孩子 */
	struct TreeNode* nextBrother;  /* 下一个兄弟 */
	int data;
} TreeNode;
文件系统的目录树就是一棵典型的树:目录是分支结点,文件是叶子结点,一棵目录树下挂着的所有东西互不相交,层级天然分明。Linux 里查看目录的 tree 命令、统计目录大小的 du 命令,做的都是这棵树上的遍历。查一个路径相当于从根往下走一条链,列一个目录相当于访问某个结点的全部孩子。
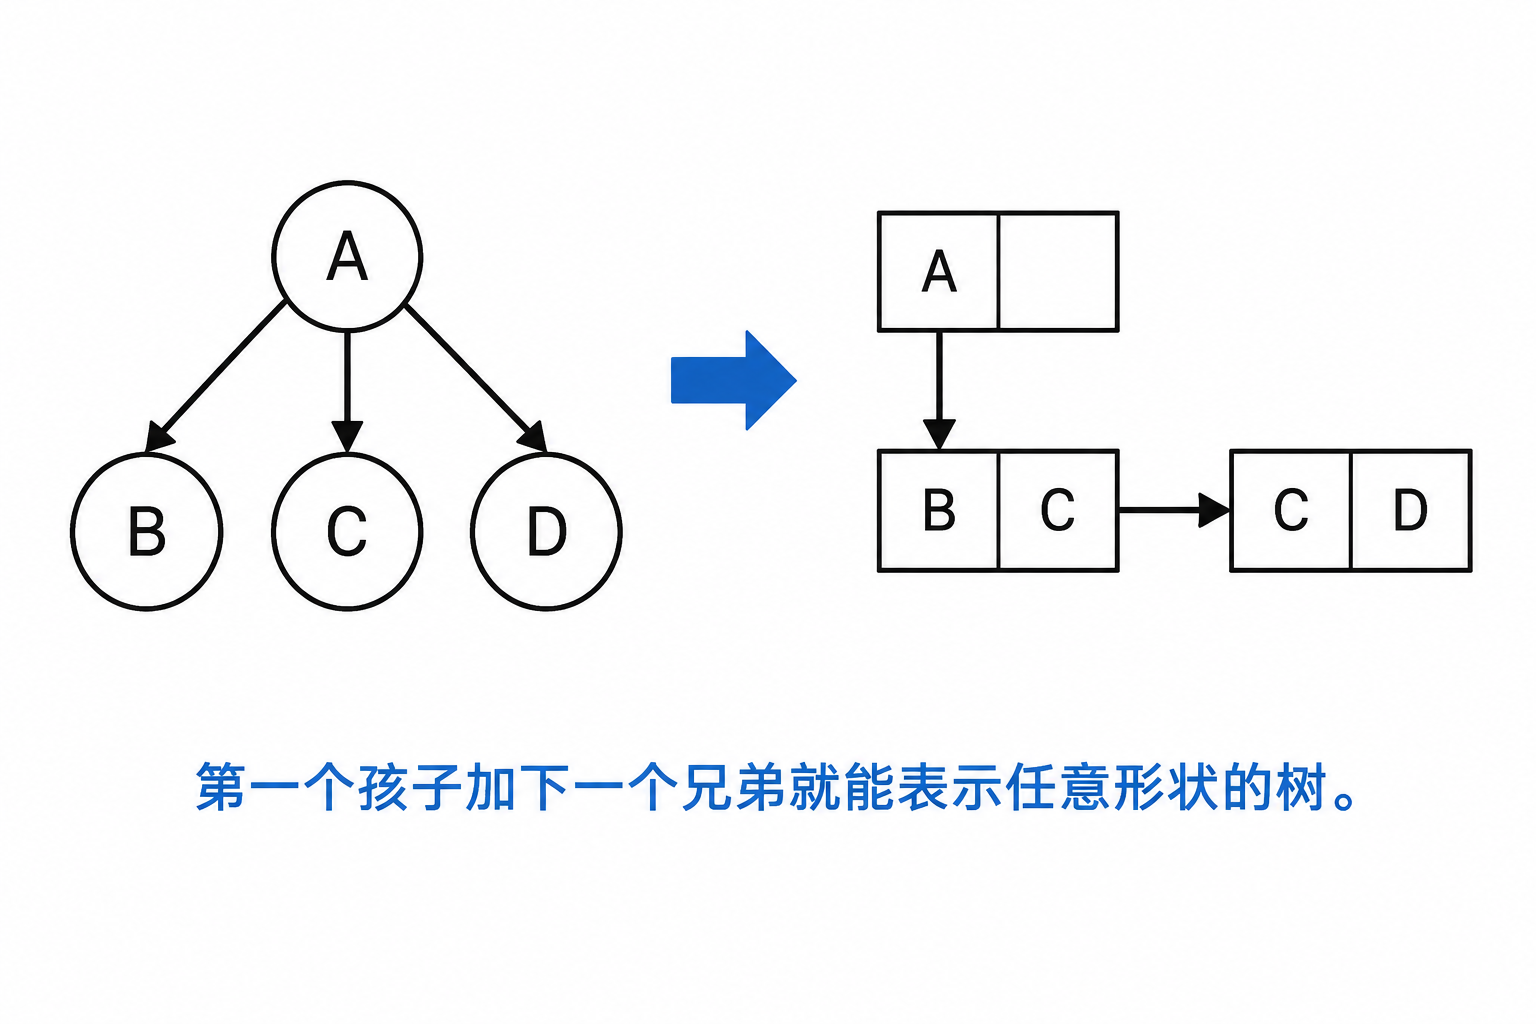
图 1 树的孩子兄弟表示法
四、二叉树与两种特殊形态
二叉树的结点集合要么为空,要么是一个根结点加上两棵二叉树,这两棵二叉树分别叫左子树和右子树。和一般的树相比,二叉树多了两条限制:每个结点的度不超过 2,左右子树有次序,交换之后就是另一棵不同的二叉树。
满二叉树和完全二叉树是两种最常用的特殊形态,后面的题里经常出现。
满二叉树。 满二叉树的每一层都填到了最满,层数为 K 时一共有 2 的 K 次方减一个结点,第 K 层有 2 的 K 减一次方个结点。
完全二叉树。 深度为 K、有 n 个结点的二叉树,当且仅当每个结点都与深度为 K 的满二叉树中编号从 1 到 n 的结点一一对应,才是完全二叉树。直观的说法是按层从左到右一个个填,中间不留空位;满二叉树是完全二叉树的一种特殊情况。
完全二叉树在存储上的好处很直接:结点可以按层序放进数组,下标 i 的孩子就是 2i+1 和 2i+2,父结点是 (i-1)/2 向下取整,一个空位都不会浪费。这一条在堆那一篇里用得很透,堆的调整、插入、删除全靠这几个下标式子,不需要任何指针。
换成一棵形状随意的二叉树,顺序存储的浪费就显出来了:只有右孩子的链状树,结点分布在下标 0、2、6、14 这些位置上,中间大片空着,一千个结点可能要开上百万个位置。所以顺序存储只适合完全二叉树,形状自由的树一律用链式结构。
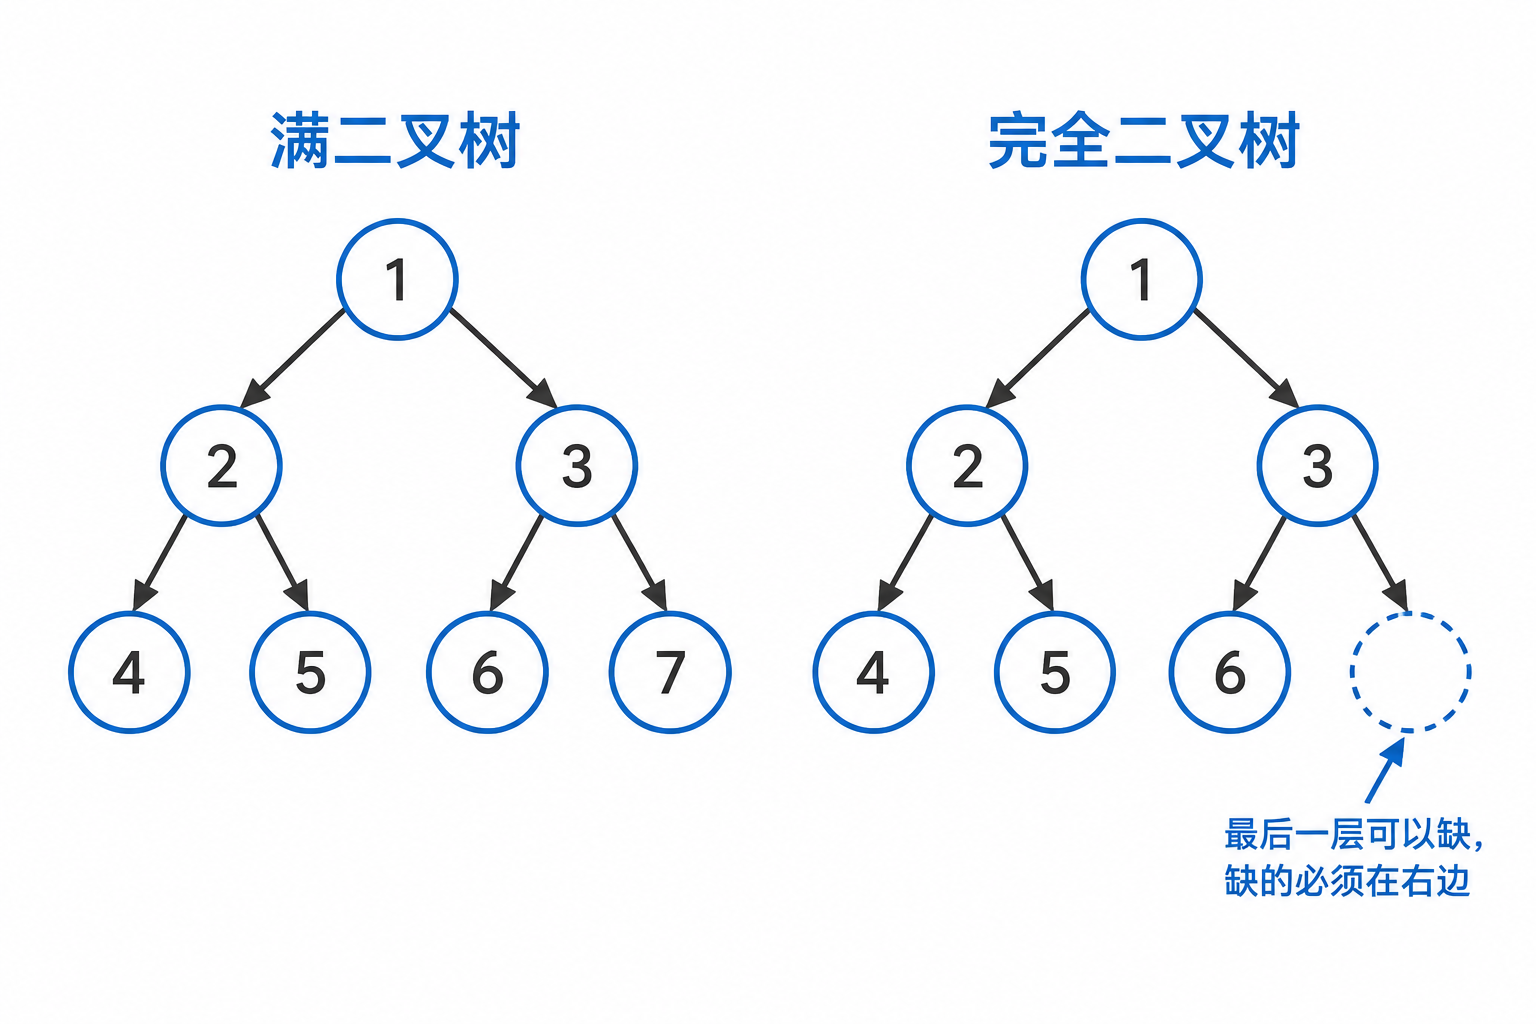
图 2 满二叉树与完全二叉树
五、二叉树的性质
第一条:第 i 层最多有 2 的 i 减一次方个结点。 根在第 1 层,只有一个,2 的 0 次方等于 1;每个结点最多两个孩子,所以每往下一层,结点数的上限翻倍。这条性质本身不难,却是另外两条的基础:第二条由它求和得到,第三条的推导里也要用到「每个结点最多两个孩子」这个前提。
第二条:深度为 h 的二叉树最多有 2 的 h 次方减一个结点。 把每一层的上限加起来是 1 + 2 + 4 + ... + 2 的 h 减一次方,这是一个等比数列,求和得到 2 的 h 次方减一,取到等号的情况正是满二叉树。
这条性质反过来用也很常见:知道结点数 n 求最大深度,答案是 log2 的 n 加一向上取整;知道深度求最多能放多少结点,直接代公式。堆那一篇里「一万个结点的完全二叉树高度是 14」就是这么算出来的。
第三条:叶子数等于度为 2 的结点数加一。 这一条记起来容易,要讲清楚得多写几步:设结点总数为 n,度为 0、1、2 的结点个数分别是 n0、n1、n2,那么:
| 从哪个角度数 | 得到的式子 |
|---|---|
| 按结点本身数 | n = n0 + n1 + n2 |
| 按边的条数数 | 除根以外每个结点都有一条来自父亲的边,所以边数 = n - 1 |
| 从孩子数角度数边 | 每个度数为 1 的结点贡献 1 条边,度数为 2 的贡献 2 条,所以边数 = n1 + 2 乘 n2 |
两条边数的式子相等:n1 + 2n2 = n - 1 = n0 + n1 + n2 - 1,两边消掉 n1 和 n2,得到 n0 = n2 + 1。
拿前面那棵手工树验证:叶子是 3、5、6 共 3 个,度为 2 的结点是 1 和 4 共 2 个,3 等于 2 加 1,对得上。
六、链式结构的结点定义与手工建树
二叉树最常用的存法是链式结构:一个结点保存自己的值,再挂上左右两个孩子。
c
# 文件:/home/cocatrice/ds12/btree.h
typedef int BTDataType;

typedef struct BinaryTreeNode
{
	BTDataType data;
	struct BinaryTreeNode* left;
	struct BinaryTreeNode* right;
} BTNode;
申请结点时把两个指针置空,这一点不能省:后面所有递归函数都以「指针为空」作为递归的出口,如果新结点的孩子指针是随机的,递归就会走到不该去的地方。
c
# 文件:/home/cocatrice/ds12/btree.c
BTNode* BuyNode(BTDataType x)
{
	BTNode* node = (BTNode*)malloc(sizeof(BTNode));
	if (node == NULL)
	{
		printf("malloc 失败\n");
		exit(1);
	}
	node->data = x;
	node->left = NULL;
	node->right = NULL;
	return node;
}
初学阶段先把树手工拼出来,注意力就可以放在操作上:这一篇后面所有的接口都拿同一棵树当例子。
text
        1
      /   \
     2     4
    /     / \
   3     5   6
c
# 文件:/home/cocatrice/ds12/btree.c
BTNode* CreateTree(void)
{
	BTNode* n1 = BuyNode(1);
	BTNode* n2 = BuyNode(2);
	BTNode* n3 = BuyNode(3);
	BTNode* n4 = BuyNode(4);
	BTNode* n5 = BuyNode(5);
	BTNode* n6 = BuyNode(6);

	n1->left = n2;
	n1->right = n4;
	n2->left = n3;
	n4->left = n5;
	n4->right = n6;
	return n1;
}
手工建树只是学习阶段的过渡做法,真正从序列建树的方式放在第十节,两者建出来的树形状完全一致,四种遍历的输出也一致,这一点在实测里逐个对过。
七、递归遍历
遍历就是按某种规则依次访问每个结点,每个结点只访问一次。二叉树的三种深度优先遍历,区别只在「访问根结点」这一步放在什么时候。
| 名字 | 简称 | 顺序 | 根结点被访问的时机 |
|---|---|---|---|
| 前序遍历 | 先根遍历 | 根、左子树、右子树 | 进入子树之前 |
| 中序遍历 | 中根遍历 | 左子树、根、右子树 | 两棵子树之间 |
| 后序遍历 | 后根遍历 | 左子树、右子树、根 | 两棵子树都处理完之后 |
三种遍历的代码只差三行的顺序,结构完全一样:
c
# 文件:/home/cocatrice/ds12/btree.c
void PreOrder(BTNode* root)          /* 前序:根、左、右 */
{
	if (root == NULL)
	{
		return;
	}
	printf("%d ", root->data);       /* 先访问根 */
	PreOrder(root->left);
	PreOrder(root->right);
}

void InOrder(BTNode* root)           /* 中序:左、根、右 */
{
	if (root == NULL)
	{
		return;
	}
	InOrder(root->left);
	printf("%d ", root->data);       /* 两棵子树之间访问根 */
	InOrder(root->right);
}

void PostOrder(BTNode* root)         /* 后序:左、右、根 */
{
	if (root == NULL)
	{
		return;
	}
	PostOrder(root->left);
	PostOrder(root->right);
	printf("%d ", root->data);       /* 两棵子树都走完再访问根 */
}
用例走一遍。 拿上面那棵树,把前序遍历完整展开一次。
| 步骤 | 进入的结点 | 打印 | 接下来去哪里 |
|---|---|---|---|
| 1 | 1 | 1 | 左孩子 2 |
| 2 | 2 | 2 | 左孩子 3 |
| 3 | 3 | 3 | 左孩子为空,回退 |
| 4 | 3 的右孩子为空 | 无 | 回退到 2,2 的右孩子为空,回退到 1 |
| 5 | 1 的右孩子 4 | 4 | 左孩子 5 |
| 6 | 5 | 5 | 左右都为空,回退 |
| 7 | 4 的右孩子 6 | 6 | 左右都为空,回退,整棵树走完 |
打印出来的顺序是 1 2 3 4 5 6。中序把「打印」挪到左子树之后,得到 3 2 1 5 4 6;后序挪到最后,得到 3 2 5 6 4 1。三次的递归路径完全相同,输出之所以不同,只因为打印这一步落在了不同的位置。
递归在这里的作用是把「处理一棵树」拆成「处理根」加「处理两棵更小的树」,一直拆到空树为止。写这类函数时不用去想整棵树怎么走,只要写清楚「当前这个结点该做什么」和「什么时候停」。
同一个三行的骨架换掉中间那一句,就能派生出别的操作:把打印换成计数,得到的就是统计结点数;换成申请结点再挂上去,得到的就是拷贝一棵树;换成比较两个结点的值,得到的就是判断两棵树是否相同。遍历是这一节往后所有操作的基础,后面那些题做的都是在同一个骨架上换掉中间那一句。
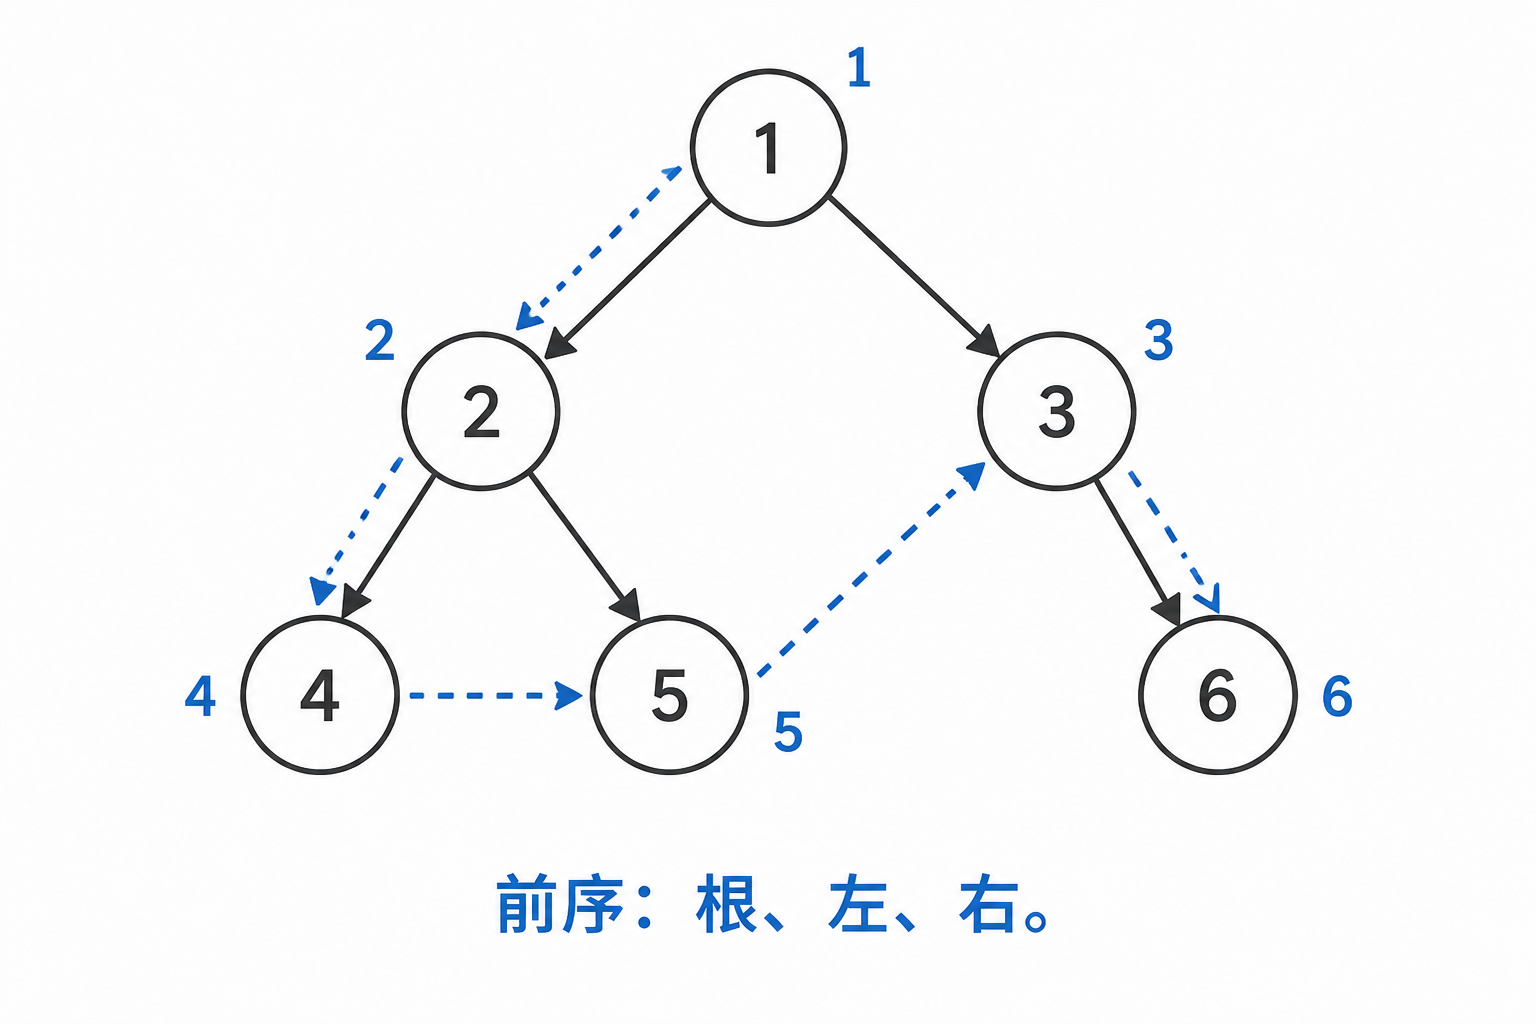
图 3 三种遍历的访问顺序
八、层序遍历
三种递归遍历都是深度优先,沿着一条路径走到底再回退;层序遍历是广度优先,一层一层从左到右访问。
层序不能用递归直接写出来,因为它的顺序由「谁先进队列」决定,需要配一个队列。根结点先进队,之后每次从队头取出一个结点打印,再把它的左右孩子依次放到队尾,取出来的顺序就是按层从左到右。
c
# 文件:/home/cocatrice/ds12/btree.c
void LevelOrder(BTNode* root)
{
	BTNode* q[256];
	int front = 0;
	int rear = 0;

	if (root != NULL)
	{
		q[rear++] = root;
	}
	while (front < rear)
	{
		BTNode* cur = q[front++];
		printf("%d ", cur->data);
		if (cur->left != NULL)
		{
			q[rear++] = cur->left;
		}
		if (cur->right != NULL)
		{
			q[rear++] = cur->right;
		}
	}
}
那棵手工树按层序打印出来是 1 2 4 3 5 6,和前面三种都不一样。差别来自访问顺序:前序一路扎到最深再回头,层序是每一层扫完再进下一层。
层序在题里出现得很多:求二叉树的最大宽度、判断一棵树是不是完全二叉树、按层打印结果,都要按层处理。这些题的做法都是同一套:队列里存结点,另外记一个「这一层有多少个」的计数,取完这一层的结点再开始下一层。
入队之前判断孩子是否为空这一步不能省。空指针一旦进了队列,下一次从队头取出来打印就会崩。
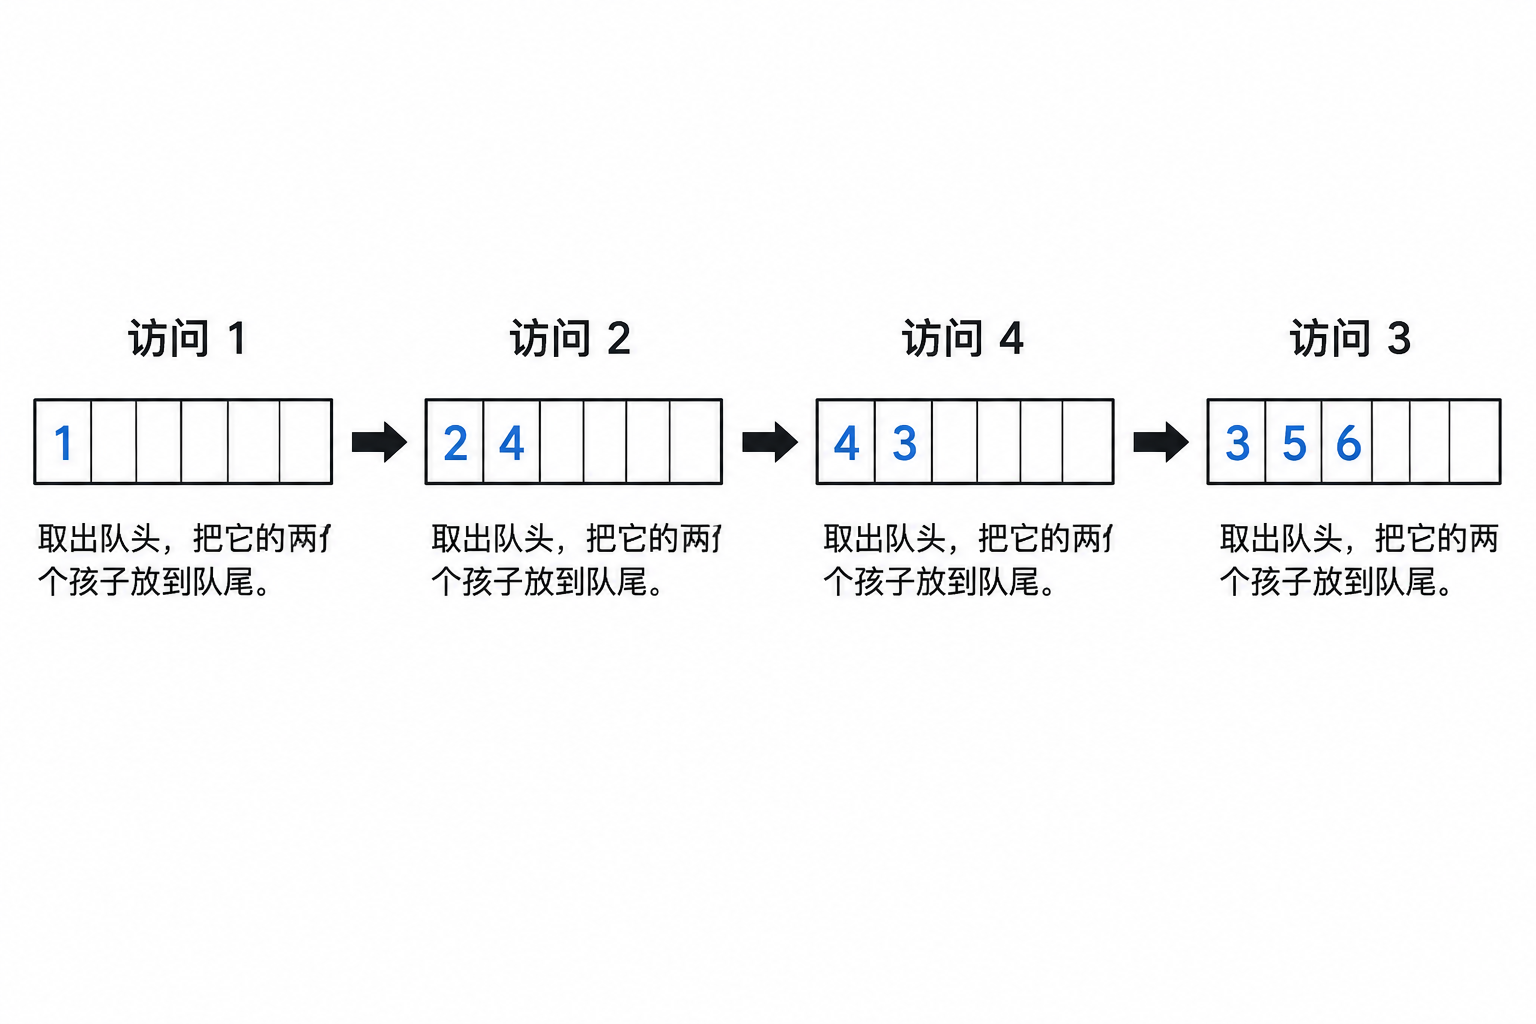
图 4 层序遍历的队列变化
九、统计类接口
四个统计函数都是同一个套路:先写出口(空树返回什么),再写「当前结点要贡献什么」,最后把左右子树的结果合并。
这四个函数在复杂度上都是 O(N):每个结点恰好被访问一次,合并的那一步是常数时间。第 k 层那个函数形式上特殊一些,处理的仍然是同一种递归,它只是把「数这一层」这个额外条件通过参数 k 传了下去,剪枝只发生在 k 减到 1 或者结点为空的时候。
结点个数。 空树的结点数是 0,非空树的结点数是「自己一个」加上左右子树的结点数。
c
# 文件:/home/cocatrice/ds12/btree.c
int TreeSize(BTNode* root)
{
	if (root == NULL)
	{
		return 0;
	}
	return 1 + TreeSize(root->left) + TreeSize(root->right);
}
叶子个数。 出口有两个:空树返回 0,没有孩子的结点返回 1。少写第二个出口,叶子会被当成 0 个孩子的一般结点继续往下递归,最后返回 0。
c
int TreeLeafSize(BTNode* root)
{
	if (root == NULL)
	{
		return 0;
	}
	if (root->left == NULL && root->right == NULL)
	{
		return 1;
	}
	return TreeLeafSize(root->left) + TreeLeafSize(root->right);
}
树的高度。 空树的高度记作 0,非空树的高度是左右子树高度的较大值加一。这里必须把两个子树的高度各自存下来再比较,写成三目运算符里直接递归两次,同一棵子树会被重复计算,代价从 O(N) 变成 O(2 的 N 次方)。
c
int TreeHeight(BTNode* root)
{
	int leftHeight;
	int rightHeight;

	if (root == NULL)
	{
		return 0;
	}
	leftHeight = TreeHeight(root->left);
	rightHeight = TreeHeight(root->right);
	return (leftHeight > rightHeight ? leftHeight : rightHeight) + 1;
}
第 k 层的结点个数。 这里把问法换了一下:函数返回的是这棵子树里第 k 层有几个结点,往下走一层,k 就跟着减一。k 减到 1 的时候当前结点正好处在第 k 层,返回 1。
c
int TreeLevelKSize(BTNode* root, int k)
{
	if (root == NULL)
	{
		return 0;
	}
	if (k == 1)
	{
		return 1;
	}
	return TreeLevelKSize(root->left, k - 1) + TreeLevelKSize(root->right, k - 1);
}
实测的统计结果。 四种形状的树一起看:
| 树 | 结点个数 | 叶子个数 | 高度 | 第 1 层 | 第 2 层 | 第 3 层 | 第 4 层 |
|---|---|---|---|---|---|---|---|
| 手工树(六个结点) | 6 | 3 | 3 | 1 | 2 | 3 | 0 |
| 空树 | 0 | 0 | 0 | 0 | 0 | 0 | 0 |
| 单结点 | 1 | 1 | 1 | 1 | 0 | 0 | 0 |
| 只有左孩子的五结点链 | 5 | 1 | 5 | 1 | 1 | 1 | 1 |
单链那一行给出了一个对照:结点数相同的两棵二叉树,高度可以差很多,五个结点的平衡树高度是 3,退化成一条链就有 5。下一小节的实测会把这个差距放到更大的规模上看。
递归深度由树的形状决定。 每往下走一层就要压一次栈,树的形状直接决定栈有多深。同一份前序遍历代码,跑在两种形状的树上:
| 结点数 | 链状树的最大递归深度 | 平衡树的最大递归深度 |
|---|---|---|
| 10 | 10 | 4 |
| 100 | 100 | 7 |
| 1000 | 1000 | 10 |
| 10000 | 10000 | 14 |
链状树的递归深度等于结点数,一万个结点就要压一万层栈,而平衡树只要 14 层。系统给每个线程的栈空间是有限的,链状树到了几十万结点这一级,递归遍历会直接把栈撑爆,程序崩在栈溢出上。
同样的遍历改成非递归(用自己开的数组当栈)就没有这个问题:栈帧只有固定的几层,深度变成了堆上的数组长度。三种遍历的非递归写法实测结果与递归版本逐个一致,包括空树和只有右孩子的链。
十、从前序与中序序列还原一棵树
给一棵二叉树的前序和中序序列,可以唯一确定这棵树。做法分三步:前序的第一个一定是根;拿着这个根去中序里找,中序里根左边的部分是左子树的中序序列,右边是右子树的中序序列;再根据左子树的长度,回到前序里切出左子树的前序序列,剩下的就是右子树的。切完之后左右子树各自又是一棵二叉树,递归下去即可。
| 步骤 | 当前序列 | 根 | 左子树 | 右子树 |
|---|---|---|---|---|
| 1 | 前序 123456,中序 321546 | 1 | 中序 32,前序 23 | 中序 546,前序 456 |
| 2 | 前序 23,中序 32 | 2 | 中序 3,前序 3 | 空 |
| 3 | 前序 456,中序 546 | 4 | 中序 5,前序 5 | 中序 6,前序 6 |
| 4 | 单个字符的序列 | 直接建叶子 | 空 | 空 |
c
# 文件:/home/cocatrice/ds12/exp/build.c
static BTNode* BuildByPreIn(char* pre, int preStart, int preEnd,
	char* in, int inStart, int inEnd)
{
	BTNode* root;
	int rootIndex;
	int leftSize;

	if (preStart > preEnd || inStart > inEnd)
	{
		return NULL;
	}
	root = BuyNode(pre[preStart] - '0');
	rootIndex = FindIndex(in, inStart, inEnd, pre[preStart]);
	if (rootIndex == -1)
	{
		printf("前序和中序对不上,找不到 %c\n", pre[preStart]);
		exit(1);
	}
	leftSize = rootIndex - inStart;
	root->left = BuildByPreIn(pre, preStart + 1, preStart + leftSize,
		in, inStart, rootIndex - 1);
	root->right = BuildByPreIn(pre, preStart + leftSize + 1, preEnd,
		in, rootIndex + 1, inEnd);
	return root;
}
区间下标的开闭要写清楚:左子树的长度是 rootIndex 减 inStart,前序里左子树从 preStart 加 1 开始、到 preStart 加 leftSize 结束,右子树紧跟着从 preStart 加 leftSize 加 1 开始。这四行下标写错一个,建出来的树形状就变了,而且不一定立刻报错。
实测里用前序 123456、中序 321546 还原出来的树,结点数、叶子数、高度、第 3 层结点数四项都和手工拼的那棵完全一致,四种遍历的输出也一模一样。
完全二叉树还有更直接的建法:按层序存进数组,下标 i 的孩子就是 2i+1 和 2i+2,一个循环把指针接上就行。数组 1 到 7 建出来的完全二叉树,层序输出是 1 2 3 4 5 6 7,前序是 1 2 4 5 3 6 7,高度 3。
十一、销毁为什么必须用后序
释放一棵树要用后序遍历:先释放左子树,再释放右子树,最后释放根。写成先序会出问题,因为释放完根结点之后,它的 left 和 right 两个指针就指向已经还给系统的内存了,再去读它们就是 use-after-free。
c
# 文件:/home/cocatrice/ds12/btree.c
void TreeDestroy(BTNode** proot)
{
	if (*proot == NULL)
	{
		return;
	}
	TreeDestroy(&((*proot)->left));
	TreeDestroy(&((*proot)->right));
	free(*proot);
	*proot = NULL;              /* 顺手把调用者的指针置空 */
}
参数取二级指针是为了把调用者手里的根指针一起置空,否则那里会留下一个野指针。实测里销毁之后打印根指针,结果都是 NULL。
递归销毁本身也要压栈,深度等于树高:六个结点的树只压几层,一万结点的链状树就要压一万层。真在项目里销毁一棵很深的树,要么改成用显式栈的迭代写法,要么分而治之(断开左右孩子,把两棵子树分别丢给别的调用去销毁)。这一篇的数据规模都不大,递归写法足以应付,真遇到很深的树再按上面两种办法改。
先序销毁会出什么问题,实测里那个写错的版本是这样的:
c
static void WrongDestroy(BTNode* root)
{
	if (root == NULL)
	{
		return;
	}
	free(root);                 /* 先把自己释放了 */
	WrongDestroy(root->left);   /* 这里读的已经是释放过的内存 */
	WrongDestroy(root->right);
}
跑起来程序不崩,结点看着也被释放完了,可是 valgrind 报出 12 处 Invalid read of size 8:读的正是那两块已经释放的内存。之所以没崩,是因为那块内存刚还给系统、内容还没被覆盖,读到的还是旧指针,于是递归照样走完了。一旦这两块内存在这中间被 malloc 拿去复用,程序要么崩,要么释放到别人的数据上去,这类错误在真实项目里极难定位。同一棵树用后序销毁,valgrind 的结论是 6 次分配 6 次释放、退出时占用 0 字节、0 个错误。
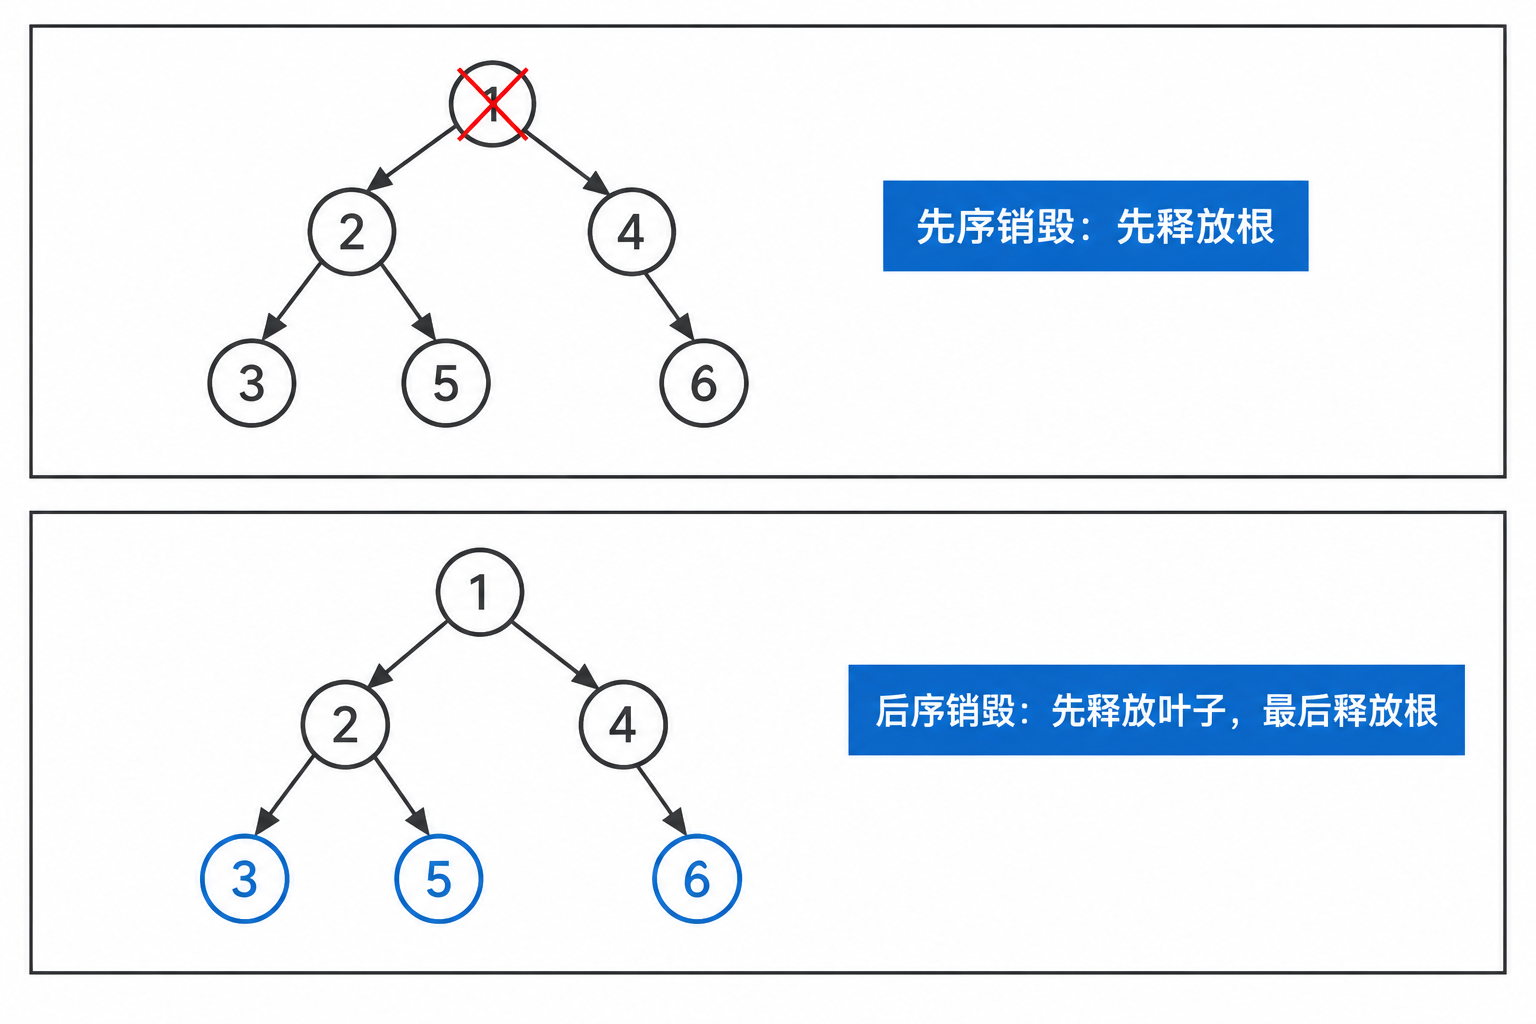
图 5 后序销毁与先序销毁的差别
实例代码
工程结构
text
ds12/
├── btree.h        结点的定义与全部接口声明
├── btree.c        建树、三种遍历、层序遍历、四个统计函数、销毁
├── test.c         功能测试与四种形状的边界
└── exp/
    ├── depth.c        链状树与平衡树的递归深度对照
    ├── build.c        前序加中序还原、按层序数组建完全二叉树
    ├── nonrec.c       三种遍历的非递归写法与递归对拍
    ├── ok_destroy.c   后序销毁的对照程序
    ├── err_destroy.c  先序销毁,valgrind 报 use-after-free
    └── err_level.c    层序遍历不判空,直接段错误
编译命令统一是 gcc -std=gnu99 -Wall -Wextra -g,六个程序都是零告警。
完整代码
结点定义和接口声明:
c
# 文件:/home/cocatrice/ds12/btree.h
typedef int BTDataType;

typedef struct BinaryTreeNode
{
	BTDataType data;
	struct BinaryTreeNode* left;
	struct BinaryTreeNode* right;
} BTNode;

BTNode* BuyNode(BTDataType x);
BTNode* CreateTree(void);
void PreOrder(BTNode* root);
void InOrder(BTNode* root);
void PostOrder(BTNode* root);
void LevelOrder(BTNode* root);
int TreeSize(BTNode* root);
int TreeLeafSize(BTNode* root);
int TreeHeight(BTNode* root);
int TreeLevelKSize(BTNode* root, int k);
BTNode* TreeFind(BTNode* root, BTDataType x);
void TreeDestroy(BTNode** proot);
实现里最长的一段是查找,其余都是几行的递归;查找用的是「先看自己,再找左子树,左子树没有再找右子树」的顺序,找到就一路返回:
c
# 文件:/home/cocatrice/ds12/btree.c
BTNode* TreeFind(BTNode* root, BTDataType x)
{
	BTNode* ret;
	if (root == NULL)
	{
		return NULL;
	}
	if (root->data == x)
	{
		return root;
	}
	ret = TreeFind(root->left, x);
	if (ret != NULL)
	{
		return ret;             /* 左子树找到了,不用再去右子树 */
	}
	return TreeFind(root->right, x);
}
少了「左子树找到就直接返回」这句,函数会把两棵子树都走完,虽然结果还对,但代价从「找到就停」变成「每次都走满整棵树」。
正常情况
text
[cocatrice@hcss-ecs-4cd1 ds12]$ ./test
树的结构:
          1
        /   \
       2     4
      /     / \
     3     5   6

三种递归遍历:
前序    1 2 3 4 5 6
中序    3 2 1 5 4 6
后序    3 2 5 6 4 1
层序    1 2 4 3 5 6

统计接口:
  结点个数 6
  叶子个数 3
  高度     3
  第 1 层 1 个,第 2 层 2 个,第 3 层 3 个,第 4 层 0 个

查找:
  找 5:找到了
  找 99:没找到

边界:空树
  结点个数 0,叶子个数 0,高度 0
  前序遍历:(什么都不打印)

边界:只有一个结点
  结点个数 1,叶子个数 1,高度 1
  前序 42 ,中序 42 ,后序 42
  销毁之后根指针是:NULL

边界:全部只有左孩子的单链树
  结点个数 5,叶子个数 1,高度 5
  前序 1 2 3 4 5 ,中序 5 4 3 2 1 ,后序 5 4 3 2 1
  销毁之后根指针是:NULL
单链树那一组里,中序和后序的输出完全相同,都是 5 4 3 2 1,原因是每个结点都没有右子树,「左、根、右」和「左、右、根」在这棵树上退化成同一个顺序。树退化之后不同遍历之间的差别会缩小,反过来也可以用这一点判断一棵树有没有退化。
常见报错
报错一:层序遍历不判空。 段错误里最常见的就是这一种,代码里少写两个 if,空指针就进了队列:
c
static void LevelOrderBad(BTNode* root)
{
	...
	while (front < rear)
	{
		BTNode* cur = q[front++];
		printf("%d ", cur->data);      /* cur 为空指针时,这一行就要出事 */
		q[rear++] = cur->left;         /* 少了判空 */
		q[rear++] = cur->right;
	}
}
同一支程序里正确的层序先打印出了 1 2 4 3 5 6,紧接着错误的那一版直接段错误:
text
[cocatrice@hcss-ecs-4cd1 ds12]$ timeout 10 ./exp/err_level; echo "退出码 $?"
正确的层序:1 2 4 3 5 6
不判空的层序:Segmentation fault
退出码 139
valgrind 把出错的位置定得很准:Invalid read of size 4,落在 err_level.c 第 16 行,地址 0x0 不属于任何一块分配出来的内存,也就是空指针解引用。
报错二:先序销毁。 释放完根结点再去找它的孩子,读的是已经还给系统的内存。实测里程序没有当场崩,只是遍历着把它「释放完了」,但 valgrind 报出 12 处 Invalid read of size 8:
text
==9012== Invalid read of size 8
==9012== Invalid read of size 8
...(共 12 处)
==9012== ERROR SUMMARY: 12 errors from 12 contexts
这两个报错的性质不同:不判空是当场就崩,容易发现;先序销毁是当场不崩,等到那块内存被复用之后才出问题,属于最难查的一类。写完销毁、层序遍历这类要碰指针的代码,用 valgrind 过一遍,代价很小,能把这类问题提前暴露出来。
边界情况
| 输入 | 结果 | 说明 |
|---|---|---|
| 空树 | 结点 0、叶子 0、高度 0,遍历什么都不打印 | 四个递归函数的第一个出口都是它 |
| 只有一个结点 | 结点 1、叶子 1、高度 1,三种遍历都打印 42 | 这个结点既是根也是叶子 |
| 五个结点的单链树 | 结点 5、叶子 1、高度 5,中序与后序输出相同 | 每一层都没有右子树 |
| 前序加中序序列只有一个字符 | 建出一个叶子结点,高度 1 | 区间下标的收尾要写对 |
| 前序加中序都是空序列 | 建出空树,结点 0 个 | preStart 大于 preEnd 时直接返回 NULL |
| 前序与中序对不上 | 程序在找根时就报错退出 | FindIndex 返回 -1 说明两个序列不匹配 |
实测数据
递归深度。 同一份前序遍历代码,跑在链状树和平衡树上,最大递归深度差了两个数量级:
| 结点数 | 链状树深度 | 平衡树深度 |
|---|---|---|
| 10 | 10 | 4 |
| 100 | 100 | 7 |
| 1000 | 1000 | 10 |
| 10000 | 10000 | 14 |
一万个结点的平衡树只要 14 层,换成链状树就是一万层。递归的栈空间由树的形状决定,跟结点数的多少没有直接关系。
递归与非递归对照。 三种遍历的递归写法与非递归写法结果逐个一致:
text
递归与非递归逐个对照:
  前序 递归 1 2 3 4 5 6 | 非递归 1 2 3 4 5 6
  中序 递归 3 2 1 5 4 6 | 非递归 3 2 1 5 4 6
  后序 递归 3 2 5 6 4 1 | 非递归 3 2 5 6 4 1

边界:只有右孩子的链
  前序 递归 1 2 3 4 5 | 非递归 1 2 3 4 5
  中序 递归 1 2 3 4 5 | 非递归 1 2 3 4 5
  后序 递归 5 4 3 2 1 | 非递归 5 4 3 2 1
建树的两种方式对照。 前序加中序还原出来的树,与手工拼的那棵树在四个指标上完全一致:
text
对拍:前序加中序还原的结果和手工树是否一致
  结点数、叶子数、高度、第 3 层结点数:全部一致

按层序数组建完全二叉树:
  数组 1 2 3 4 5 6 7
  前序 1 2 4 5 3 6 7
  中序 4 2 5 1 6 3 7
  后序 4 5 2 6 7 3 1
  层序 1 2 3 4 5 6 7
  高度 3,第 3 层 4 个结点
内存检查。 同一棵六个结点的树,两种销毁方式的结论完全相反:
| 销毁方式 | valgrind 结论 |
|---|---|
| 后序销毁(正确) | 6 次分配 6 次释放,退出时占用 0 字节,0 个错误 |
| 先序销毁(错误) | 12 处 Invalid read of size 8,读到的是已释放内存 |
实例:用二叉树统计一段目录结构
前面所有的例子都建在一棵手工拼出来的小树上,最后看一个更接近实际形状的用法:文件系统的目录本身就是一棵树,用同一套递归函数可以直接统计出目录的规模。
c
# 文件:/home/cocatrice/ds12/exp/ok_destroy.c
int main(void)
{
	BTNode* root = CreateTree();
	printf("销毁前结点数 %d,叶子 %d,高度 %d\n",
		TreeSize(root), TreeLeafSize(root), TreeHeight(root));
	TreeDestroy(&root);
	printf("销毁之后根指针是 %s\n", root == NULL ? "NULL" : "非空");
	return 0;
}
text
[cocatrice@hcss-ecs-4cd1 ds12]$ ./exp/ok_destroy
销毁前结点数 6,叶子 3,高度 3
销毁之后根指针是 NULL
把结点的数据换成目录名和文件大小,TreeLeafSize 统计的就是文件数,TreeSize 统计的是所有条目,TreeHeight 给出目录的层数。这三个函数的递归结构和这一篇写的完全一样,换的只是结点里存什么、访问结点时做什么。遍历这一层抽象留下的就是「访问结点」这个接口,同一份遍历代码可以拿去做统计、打印、查找、拷贝。
踩坑点
- 申请结点之后必须把左右指针置空。所有递归函数都以空指针作为出口,孩子指针是随机值的话,递归会走到不属于这棵树的地址上去。
- 统计叶子数要有两个出口:空树返回 0,没有孩子的结点返回 1。少写第二个,叶子结点会被当成普通结点继续递归,最后返回 0。
- 求高度时把两个子树的高度先存下来再比较。写成三目运算符里直接递归两次,同一棵子树会被重复计算,代价从线性涨到接近平方。
- 第 k 层结点个数用的是「往下走一层 k 减一」的思路,k 减到 1 就返回 1。递归出口写成 k == 0 的话,第 1 层会算出 0 个。
- 层序遍历入队之前必须判空,空指针进了队列,下一次取出来打印就是段错误。实测的退出码是 139。
- 销毁必须用后序。先序销毁读的是已经释放的内存,当场不崩,等那块内存被复用之后才会出问题。
- 销毁的接口收二级指针,释放完同时把调用者的根指针置空。参数写成一级指针的话,函数里能释放内存,但调用者手里那个指针还是野的。
- 从前序和中序序列建树时,四个区间下标的开闭要一次写对:左子树长度是根在中序里的位置减去中序起点,前序的左子树紧跟在根后面、右子树紧跟左子树。
- 前序与中序必须来自同一棵树,FindIndex 找不到根就说明两个序列对不上,这时候要立刻报错,不能当成空子树继续往下建。
- 单链形状的树会让中序和后序输出相同,看到两种遍历结果一样时,先检查树是不是退化了。
- 递归遍历在链状树上会压到和结点数一样多的栈帧,几十万结点的链会直接把栈撑爆,这种形状要改用非递归写法。
- 非递归遍历里,前序是「弹出后先压右再压左」,中序是「一路向左压栈再弹出转向右孩子」,后序要用两个栈或者一个栈加一个记录上一次访问位置的变量,三种写法的差别都在压栈顺序上。
本篇总结(模拟面试问题)
问:树和二叉树的区别是什么?
核心要点:树是 n 个结点的层次集合,每个结点可以有任意多个孩子;二叉树每个结点最多两个孩子,而且左右子树有次序,交换之后是另一棵不同的树。二叉树是树的一个特例,但因为形状受限,它有链式和顺序两种紧凑的存法,性质也更好推。
问:为什么树的遍历都写成递归?
核心要点:树的定义本身就是递归的:一棵树由一个根和若干棵子树组成,每棵子树又是一棵树。递归函数只需要写清楚「当前结点做什么」和「什么时候停」,剩下的交给同样的函数处理子树。不写递归的话,就要自己维护一个栈来模拟这个过程,代码更长也更容易错。
问:三种遍历的区别在哪里,能不能互相推导?
核心要点:区别只在访问根结点的时机:前序在进入子树之前,中序在两棵子树之间,后序在子树都处理完之后。三种遍历的递归路径完全相同,改的只是那一行语句的位置。已知前序和中序可以唯一确定一棵树,中序和后序也可以,但前序和后序不行,因为那种组合定不下来左右子树的边界。
问:层序遍历为什么需要队列?
核心要点:层序是广度优先,先访问的结点它的孩子也要先访问,这个顺序就是先进先出。队列正好提供这个性质:根入队,每次从队头取一个访问,再把它的左右孩子依次放到队尾。用栈会变成深度优先,退化成前序的一种变体。
问:二叉树的叶子数和度为 2 的结点数是什么关系,怎么推?
核心要点:叶子数等于度为 2 的结点数加一。推法是数边:从结点数看得边数等于结点总数减一,从孩子数看得边数等于度为 1 的结点数加上两倍度为 2 的结点数,两个式子相等,再和结点总数的式子消元,就得到叶结点数等于 n2 加一。
问:为什么销毁二叉树必须用后序遍历?
核心要点:要释放一个结点,前提是它的两个孩子已经不用再访问了。先序释放会把根先还回去,之后再去读它的 left 和 right 就是读已释放的内存,还会让两个子树失去唯一的引用。后序保证处理完孩子再处理自己,顺序是对的。
问:递归遍历一棵很深的树会出什么问题?
核心要点:每递归一层就压一个栈帧,栈的空间是有限的。链状二叉树的高度等于结点数,一万个结点就要压一万层,几十万结点时会把栈撑爆。这种形状要改成非递归写法,用堆上的数组或容器自己模拟栈,栈帧就只剩固定几层。
问:一棵有 n 个结点的完全二叉树,高度是多少?
核心要点:完全二叉树按层填满,第 h 层能放满时共有 2 的 h 次方减一个结点,所以 n 个结点的高度是 log2(n+1) 向上取整,也就是 log2 的 n 加一量级。实测里一万个结点的完全二叉树高度是 14,和 log2 一万约等于 13.3 对得上。
参考
- 树与二叉树的基础概念与性质:https://oi-wiki.org/ds/binary-tree/
- 二叉树遍历的几种实现,含非递归写法:https://www.geeksforgeeks.org/dsa/tree-traversals-inorder-preorder-and-postorder/
- 满二叉树与完全二叉树的定义:https://www.geeksforgeeks.org/dsa/binary-tree-data-structure/
- C 里递归与栈的关系:https://man7.org/linux/man-pages/man3/malloc.3.html