朴素贝叶斯算法介绍
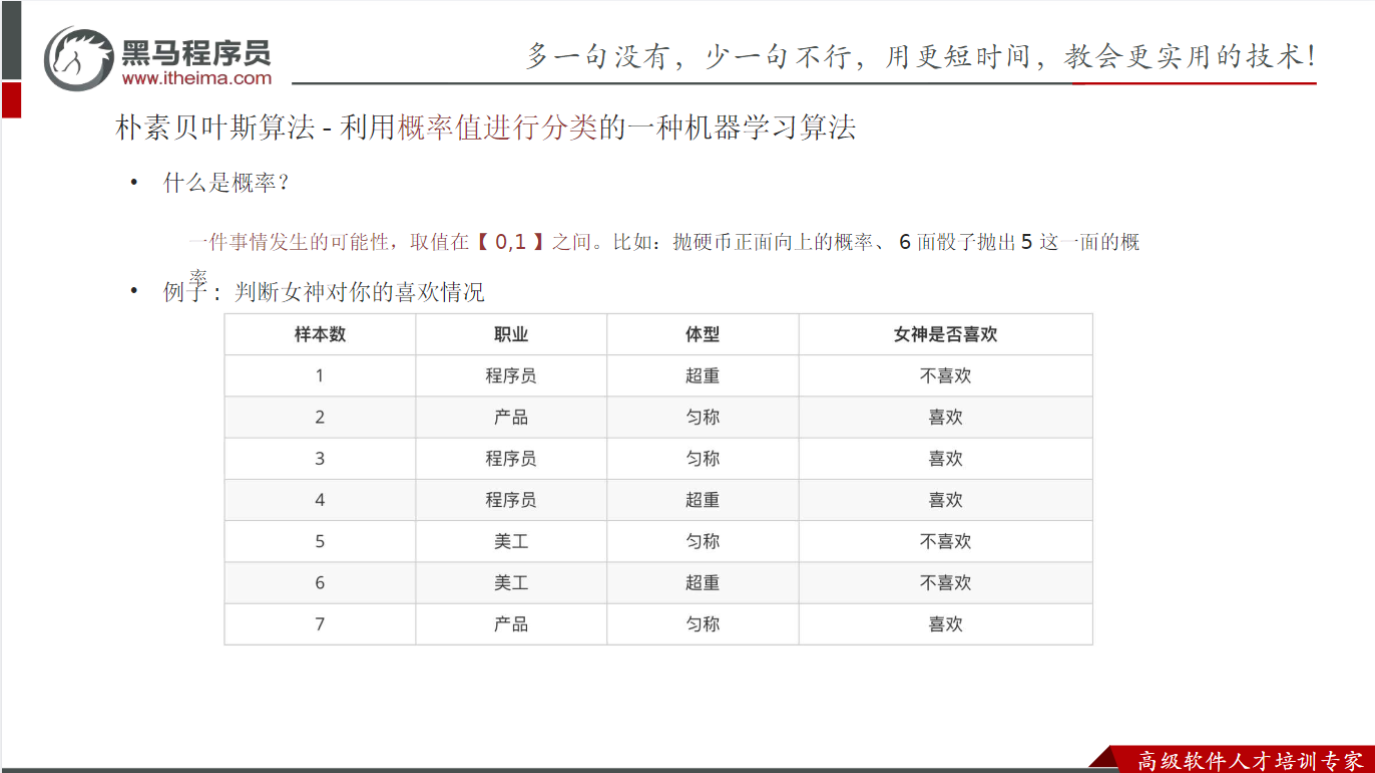
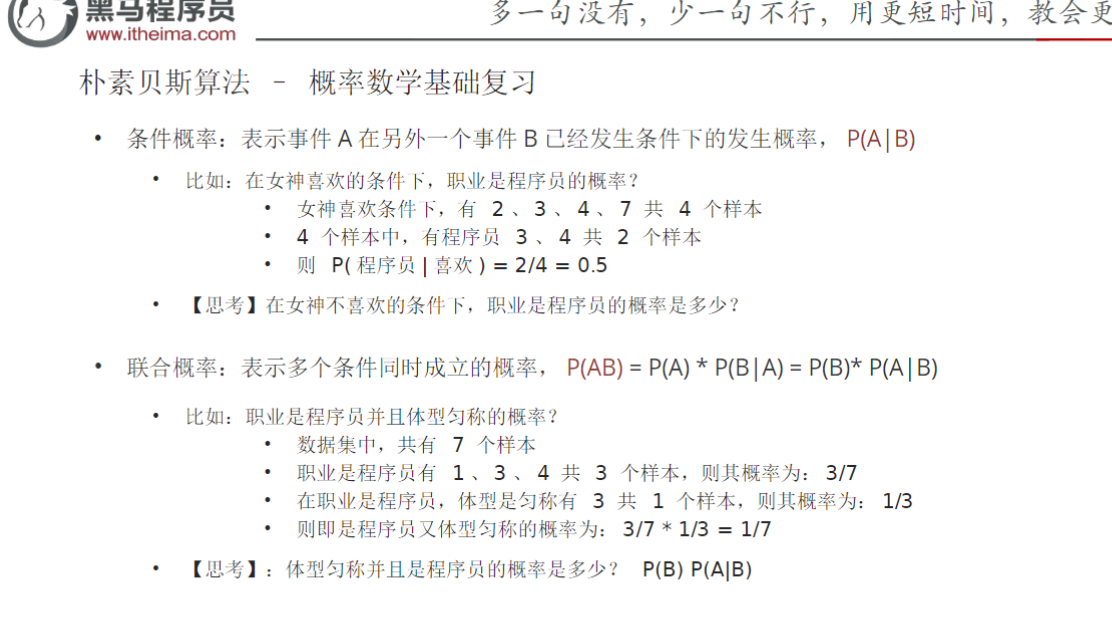
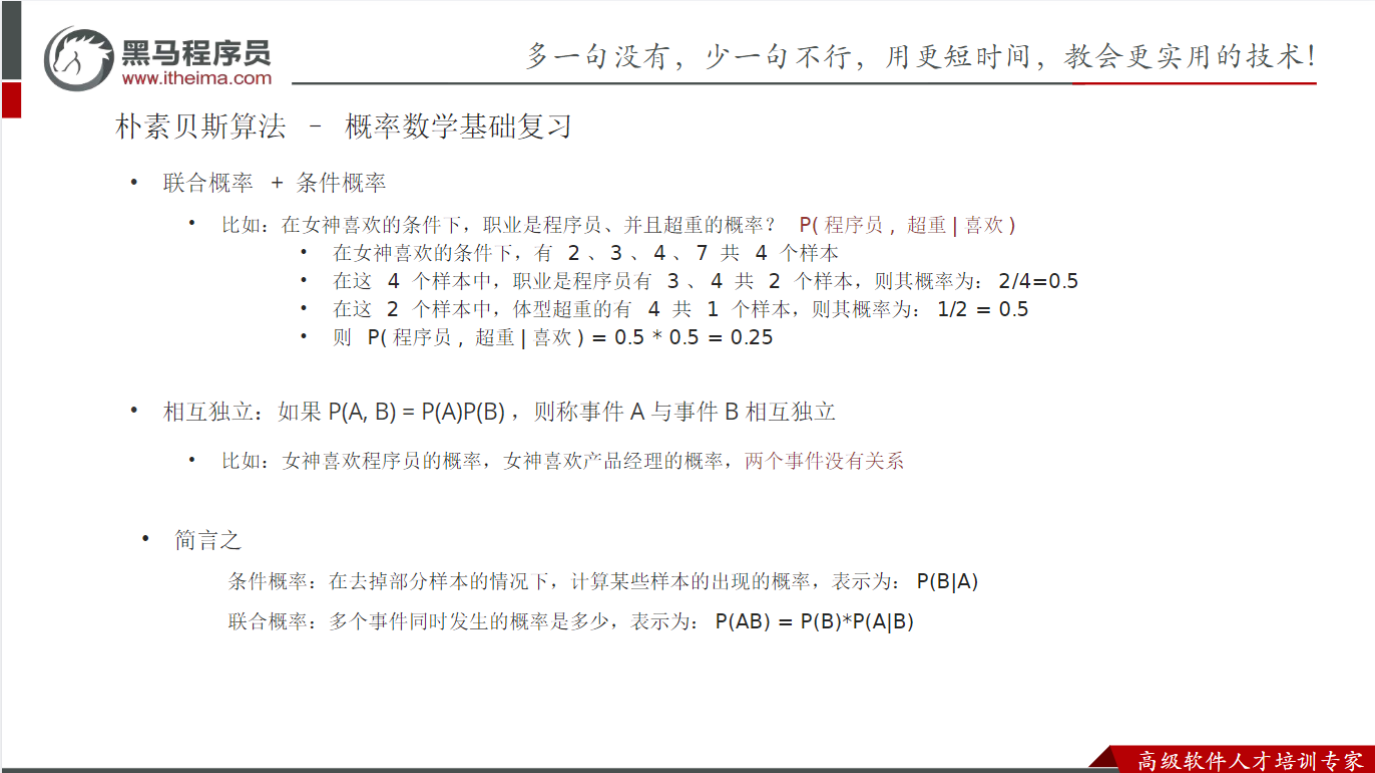
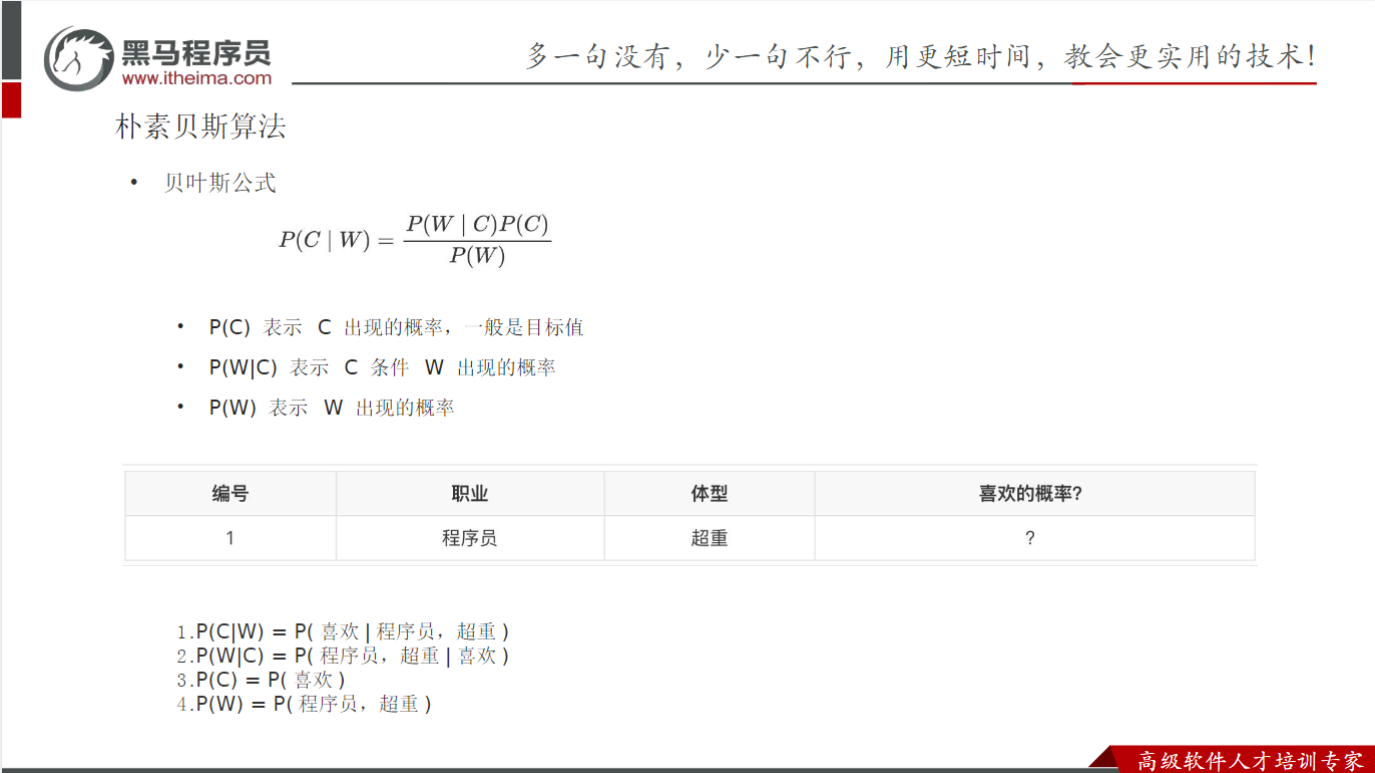
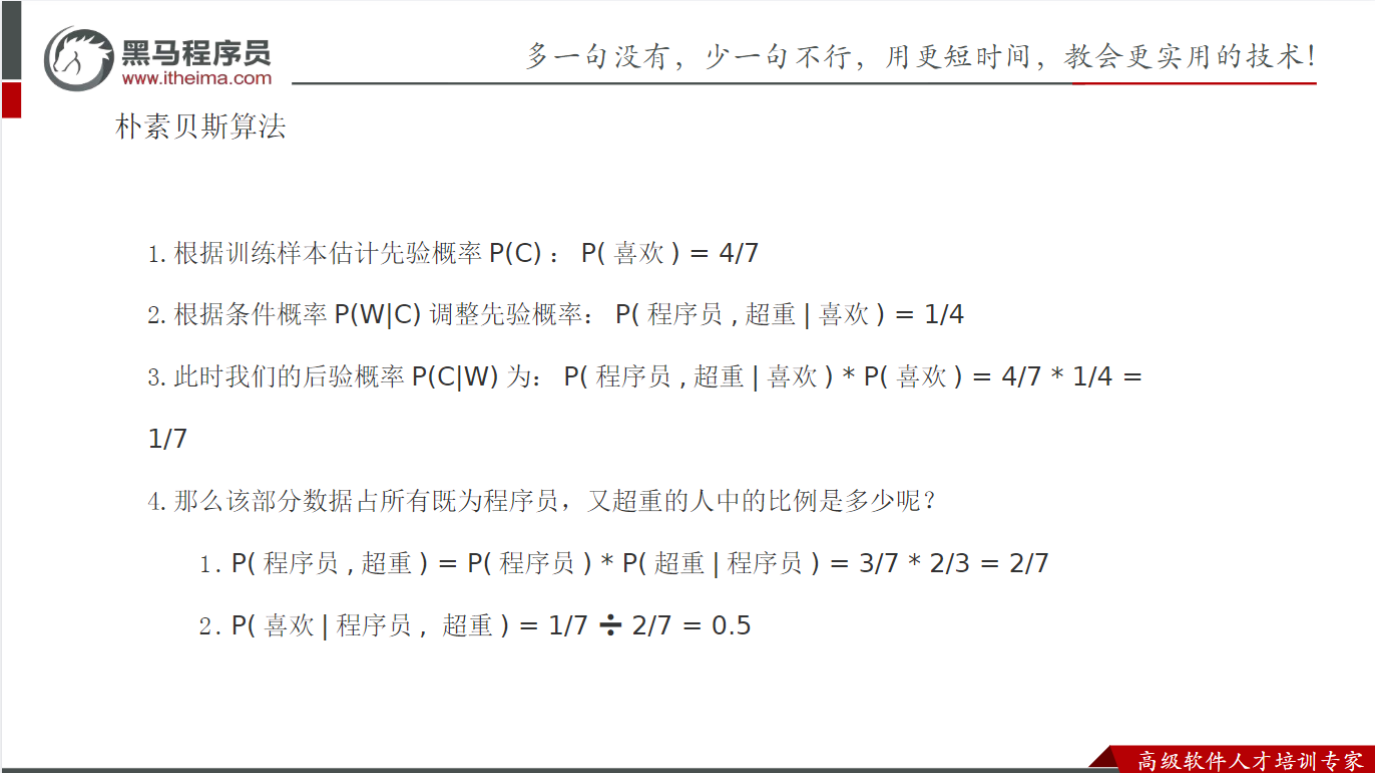
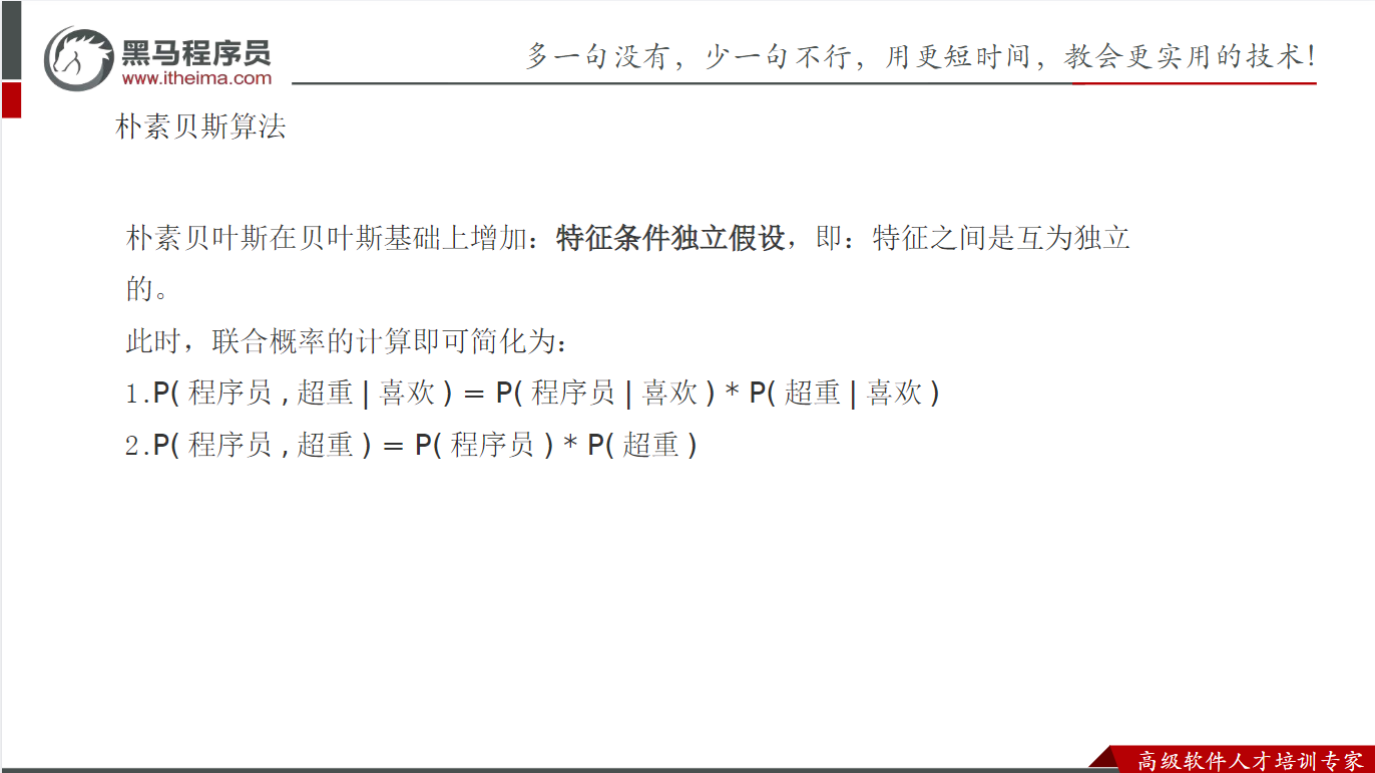
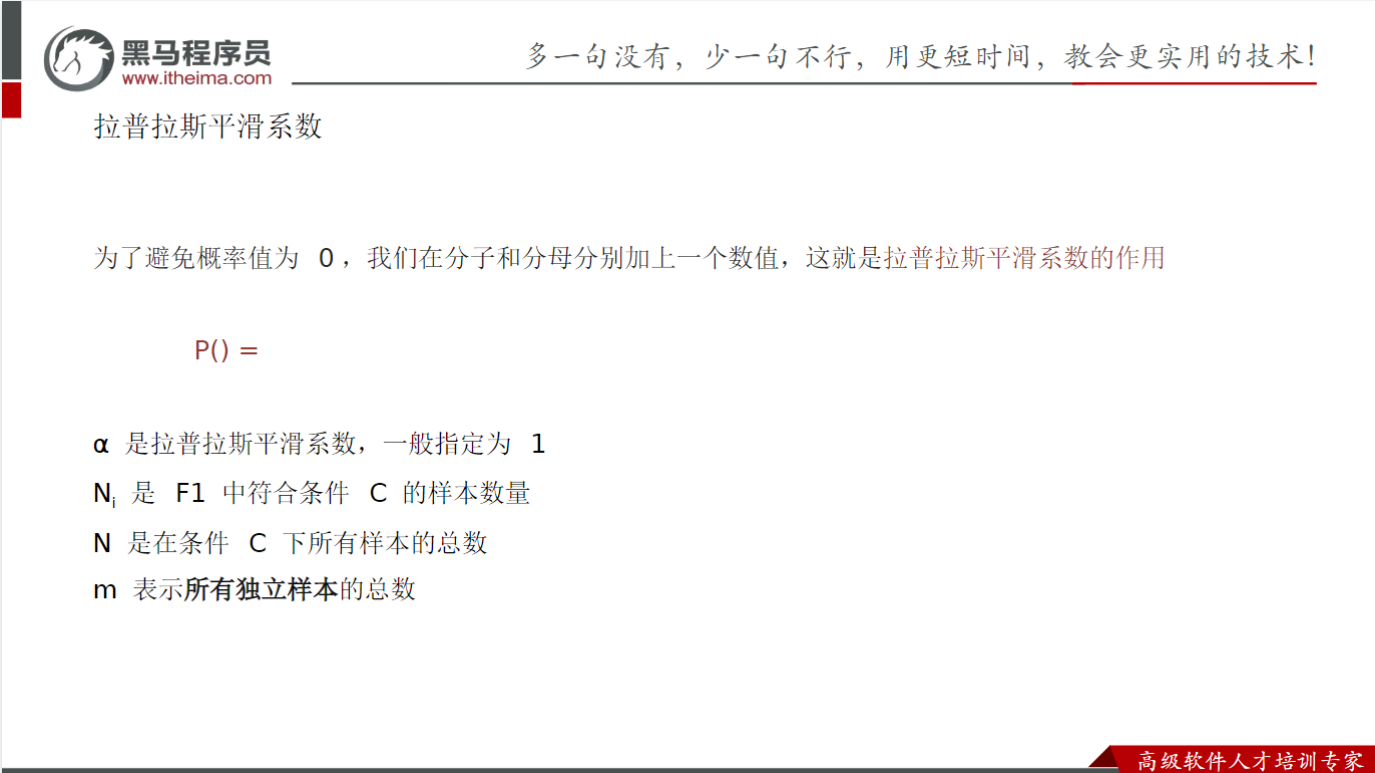
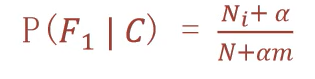
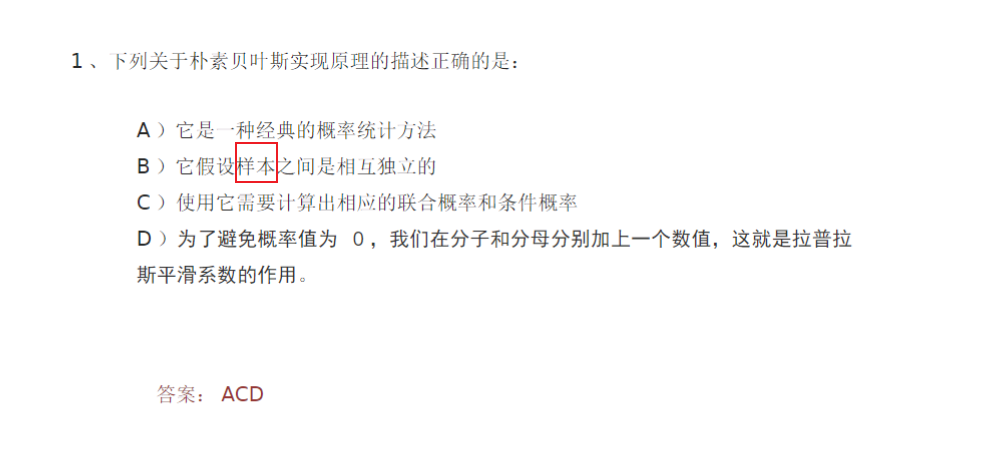
朴素贝叶斯的"朴素"之处在于假设特征(属性)之间是相互独立的,而不是样本之间
朴素贝叶斯情感分类案例
pip install jieba->jieba分词器,可以切词,删除无效词
python
'''
案例:
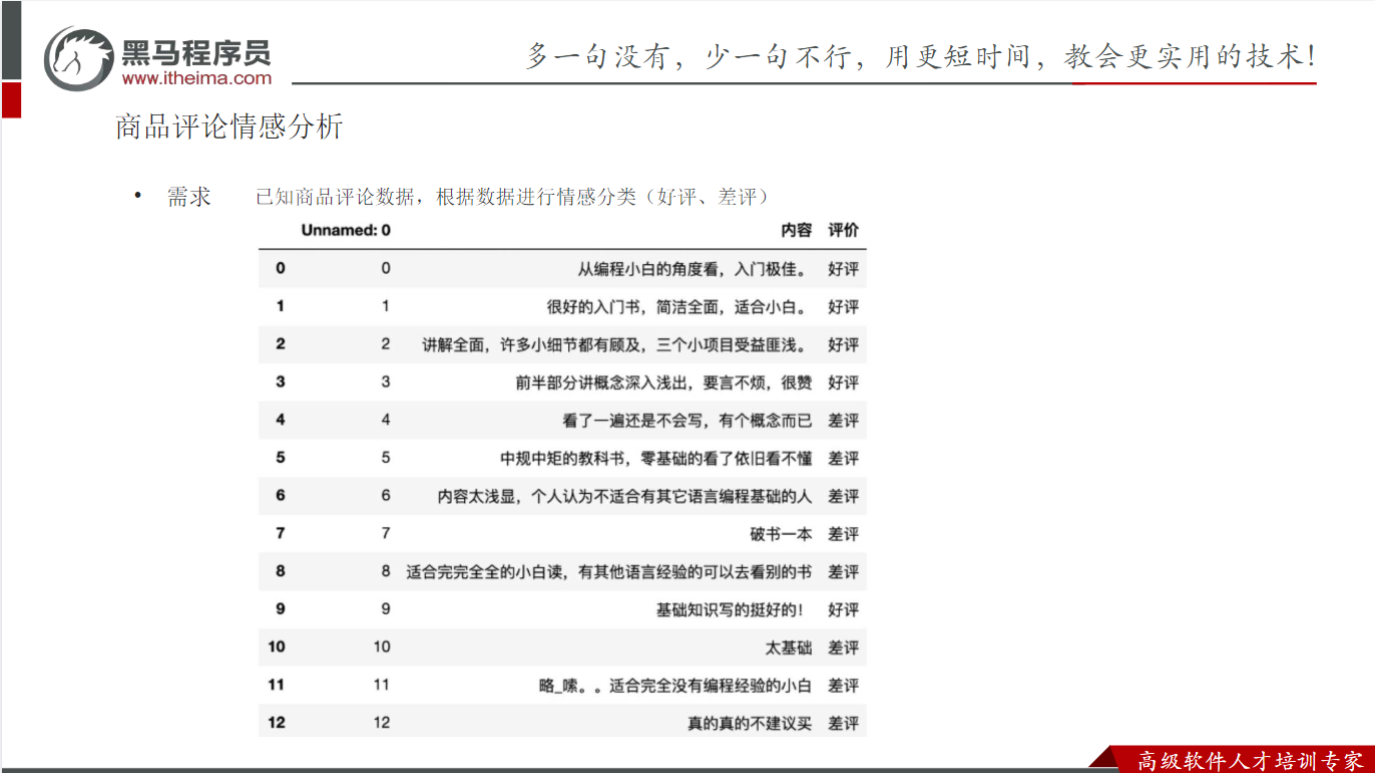
     演示通过朴素贝叶斯算法 实现 商品评论情感分析,即:好评,差评...
朴素贝叶斯介绍:
    概述:
        贝叶斯:仅仅依赖 概率 就可以进行分类的 一种机器学习算法
        朴素:不考虑特征之间的关联性,即:特征间都是相互独立的
             原始:p(AB)=P(A)*P(B|A
             加入朴素后:p(AB)=P(A)*P(B)
        细节:
            因为我们分词要用到jieba分词器,所以要先装一下pip install jieba
'''
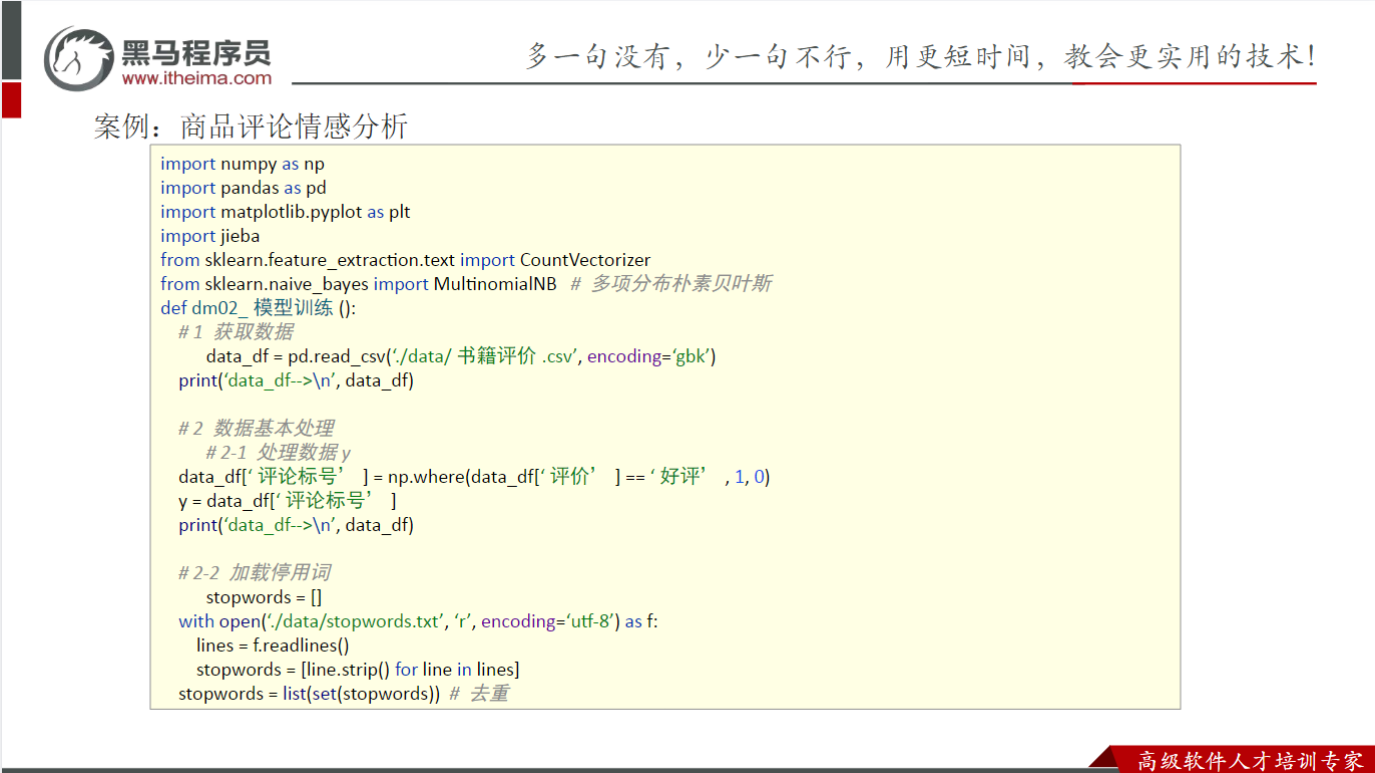
#导包
import jieba#分词器
import pandas as pd#数据处理包
import numpy as np#数学计算包
import matplotlib.pyplot as plt#画图包
from sklearn.feature_extraction.text import CountVectorizer#词频统计包,把评论内容转换为词频矩阵
from sklearn.metrics import accuracy_score
from sklearn.naive_bayes import MultinomialNB#朴素贝叶斯模型
#1.读取文件,获取到原始数据
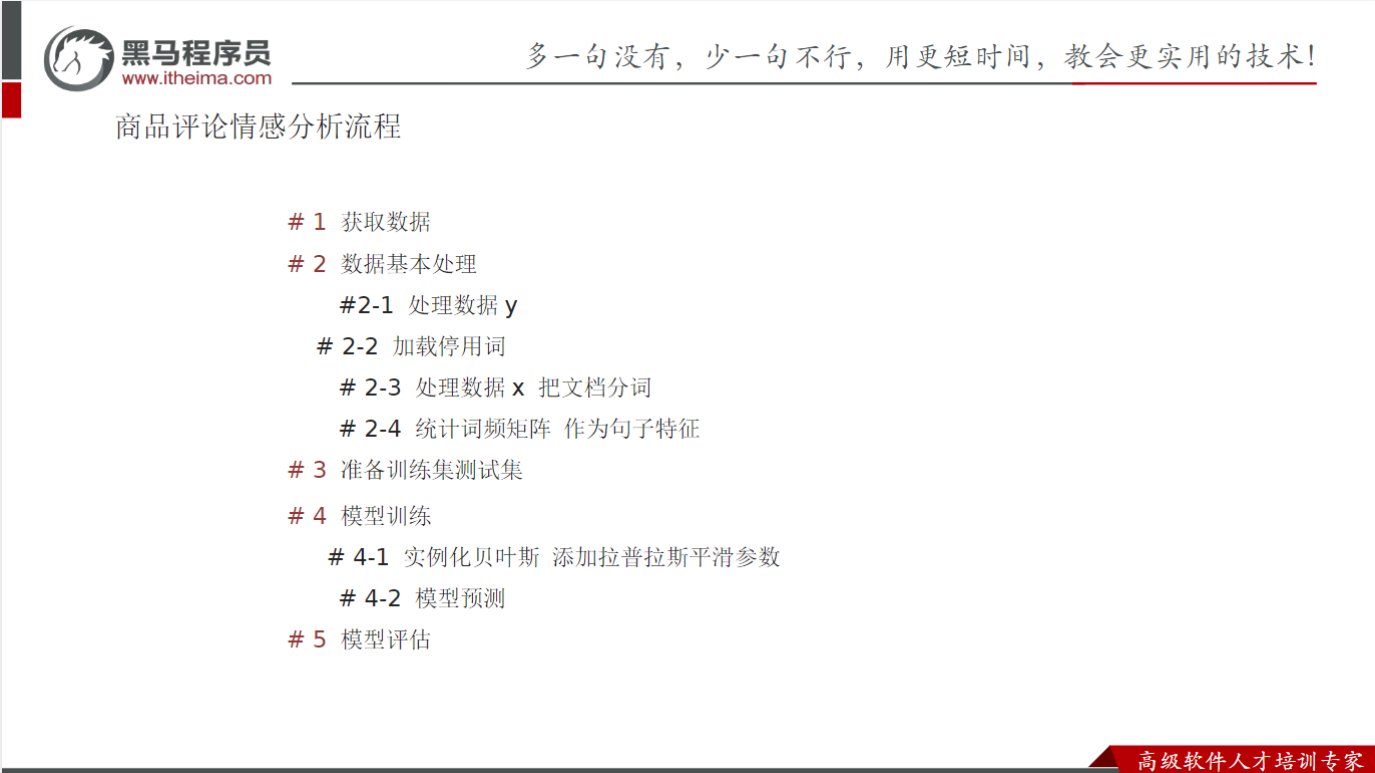
df=pd.read_csv('./datas/书籍评价.csv',encoding='gbk')
# df.info()
# print(df)
#2.数据预处理
#2.1添加labels列,充当:标签列。好评:1,差评:0
df['labels']=np.where(df['评价']=='好评',1,0)
# df.info()
# print(df)
#2.2抽取labels列,作为标签
y=df['labels']
#2.3演示jieba分词
# print(list(jieba.cut('我是一个学生')))#['我', '是', '一个', '学生']
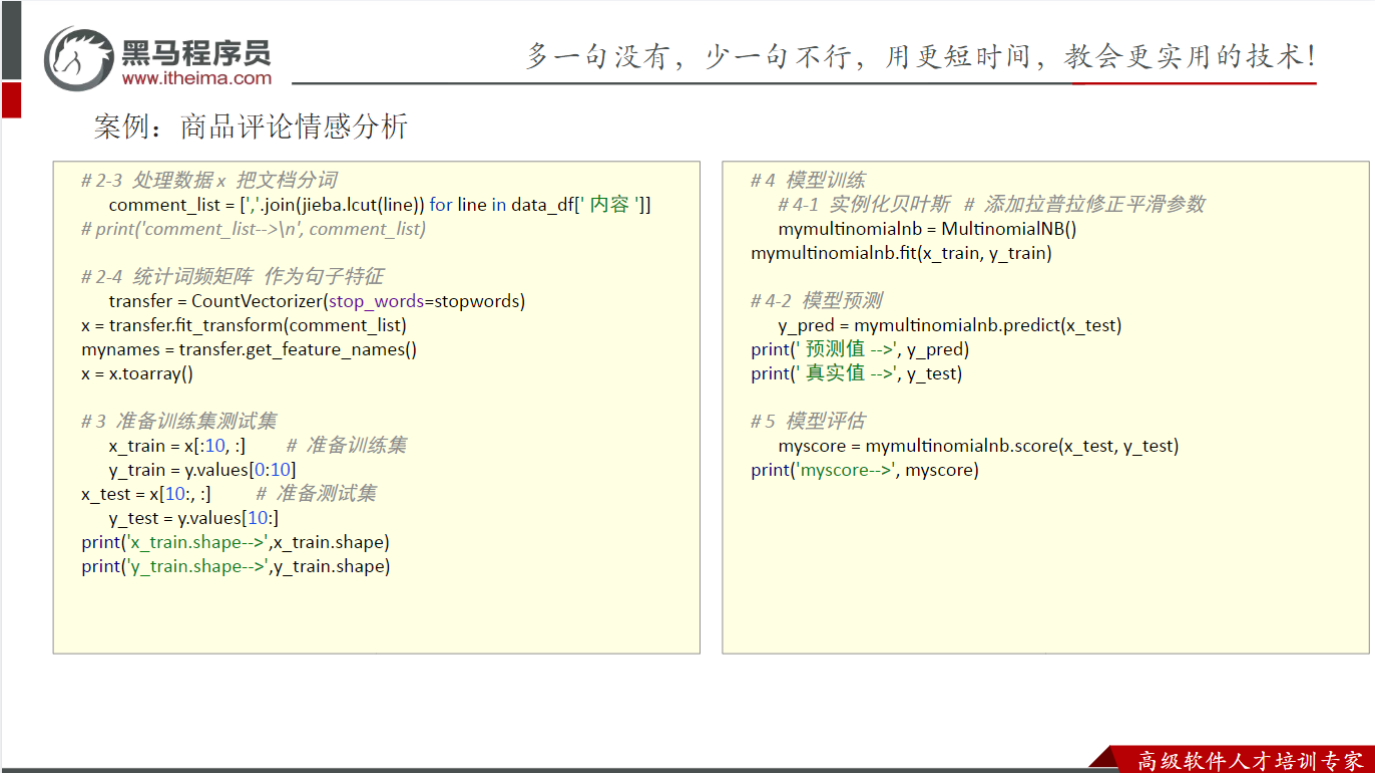
#2.4对用户的评论信息,做切词
# 数据格式: [[第1条评论切词1, 切词2, 切词3...], [第2条评论切词1, 切词2, 切词3...], ...]
comment_list = [','.join(jieba.cut(line)) for line in df['内容']]
# 数据格式: ['第1条评论切词1, 切词2, 切词3...', '第2条评论切词1, 切词2, 切词3...', ...],加上','.join就可以转换成这个形式
# print(comment_list)
#演示字符串的join()函数用法
# my_list=['aa','bb','cc']
# print(','.join(my_list))#aa,bb,cc
#2.5加载停用词列表,即:里面记录的词,不需要参与模型训练,预测,要被删除的词,例如:的,啊,哈...
with open('./datas/stopwords.txt','r',encoding='utf-8') as src_f:
    #2.5.1一次读取所有的行
    stopwords_list=src_f.readlines()
    #2.5.2删除换行符
    stopwords_list=[line.strip() for line in stopwords_list]
    #2.5.3对停用词列进行去重
    stopwords_list=list(set(stopwords_list))
    #2.5.4打印停用词列表
    print(stopwords_list)
#2.6创建向量化对象,从评论词列表(comment_list)中删除停用词,并统计词频(单词矩阵)
transfer=CountVectorizer(stop_words=stopwords_list)#参数:stop_words=停用词列表
#2.7统计词频矩阵,先训练,后转换,再转数组
transfer.fit(comment_list)
# x的格式: [[第1条评论的切词分布, 有就是1, 没有就是0], [第2条评论的切词分布, 有就是1, 没有就是0], ...]
x=transfer.transform(comment_list).toarray()
print(x)
#2.8看一下,我们13条评论,切词,且删除停用词后,一共剩下多少个词了
print(transfer.get_feature_names_out())
print(len(transfer.get_feature_names_out()))#37个词,即:13条评论,切词,且删除停用词后,剩下37个词
#2.9因为就13条数据,我们把前10条当训练集,后3条当测试集
x_train=x[:10]
y_train=y[:10]
x_test=x[10:]
y_test=y[10:]
#3.特征工程
#4.模型训练
estimator=MultinomialNB()#创建朴素贝叶斯模型对象
estimator.fit(x_train,y_train)#训练模型
#5.预测模型
y_predict=estimator.predict(x_test)
print(f'预测结果:{y_predict}')
# 6. 模型评估.
print(f'准确率: {accuracy_score(y_test, y_predict)}')
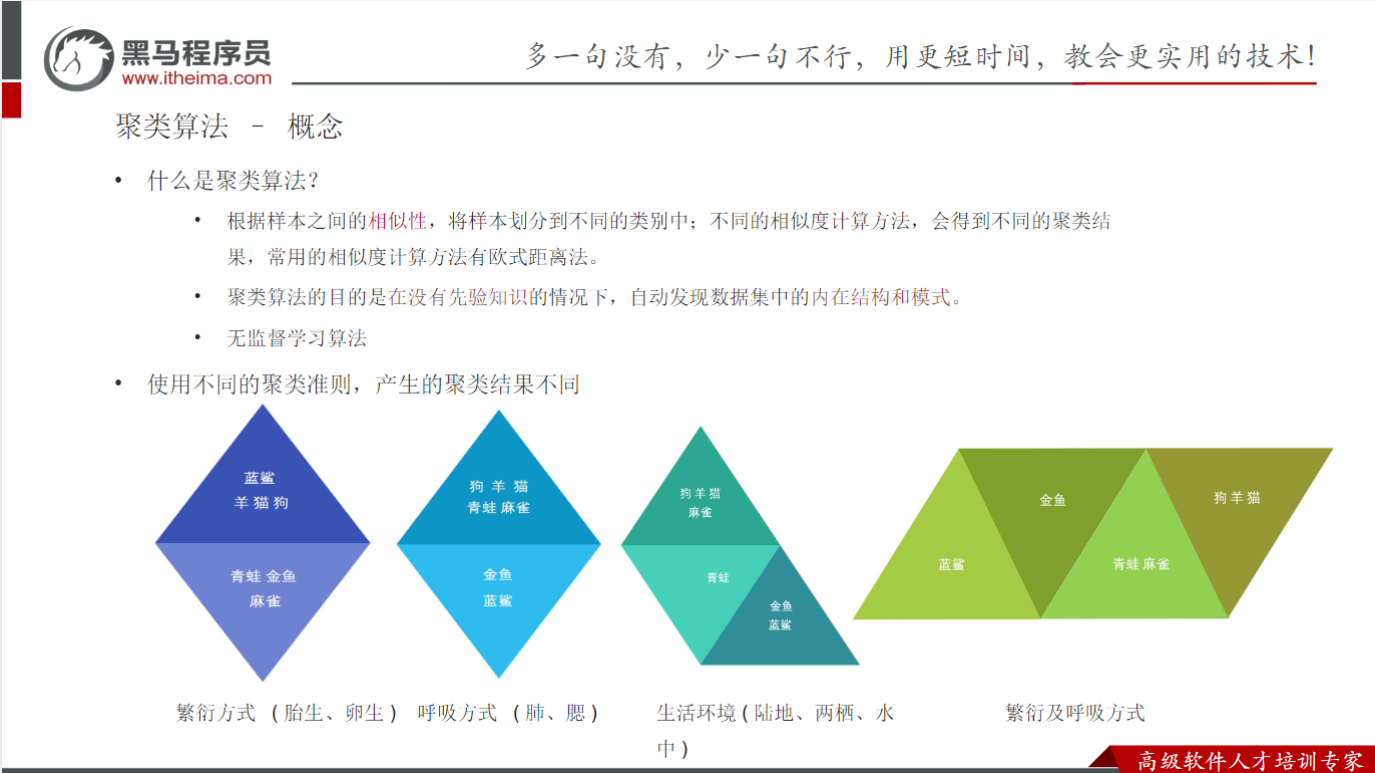
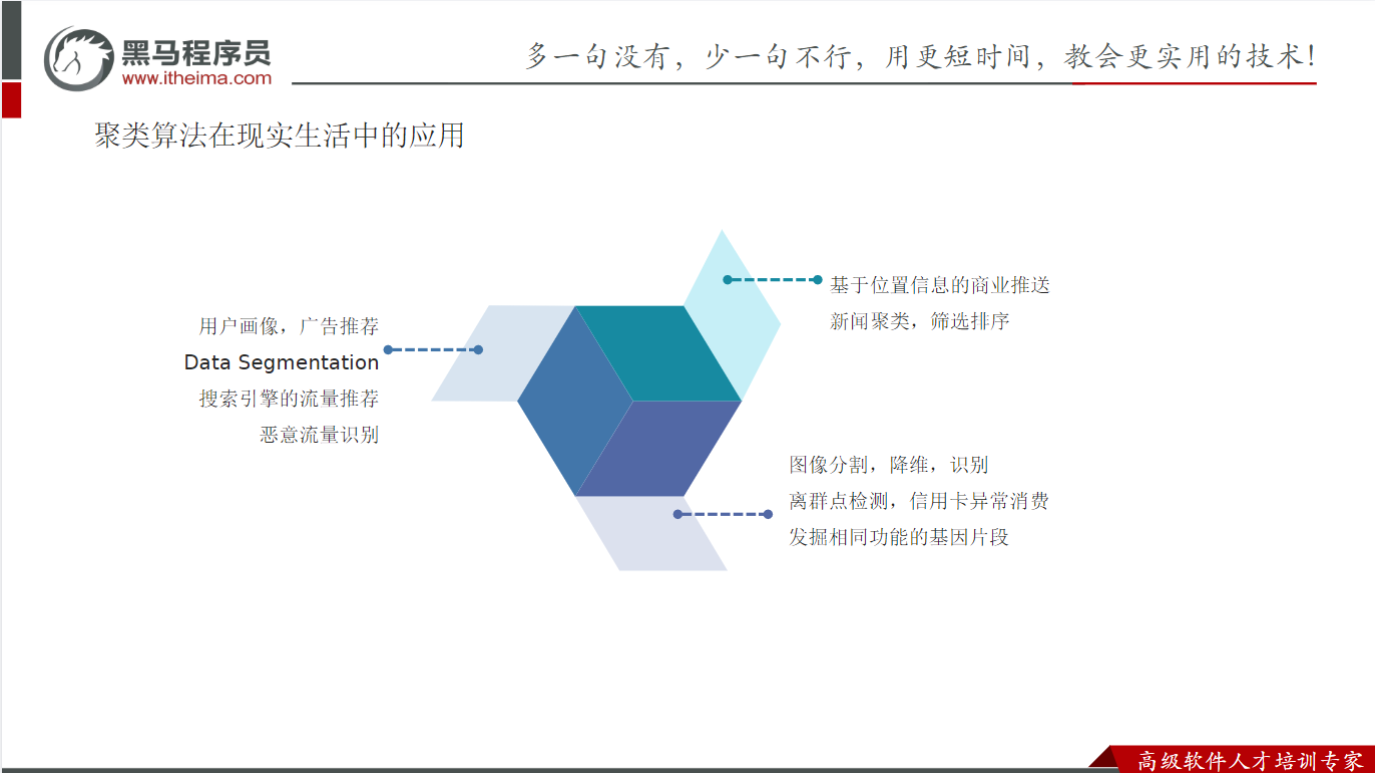
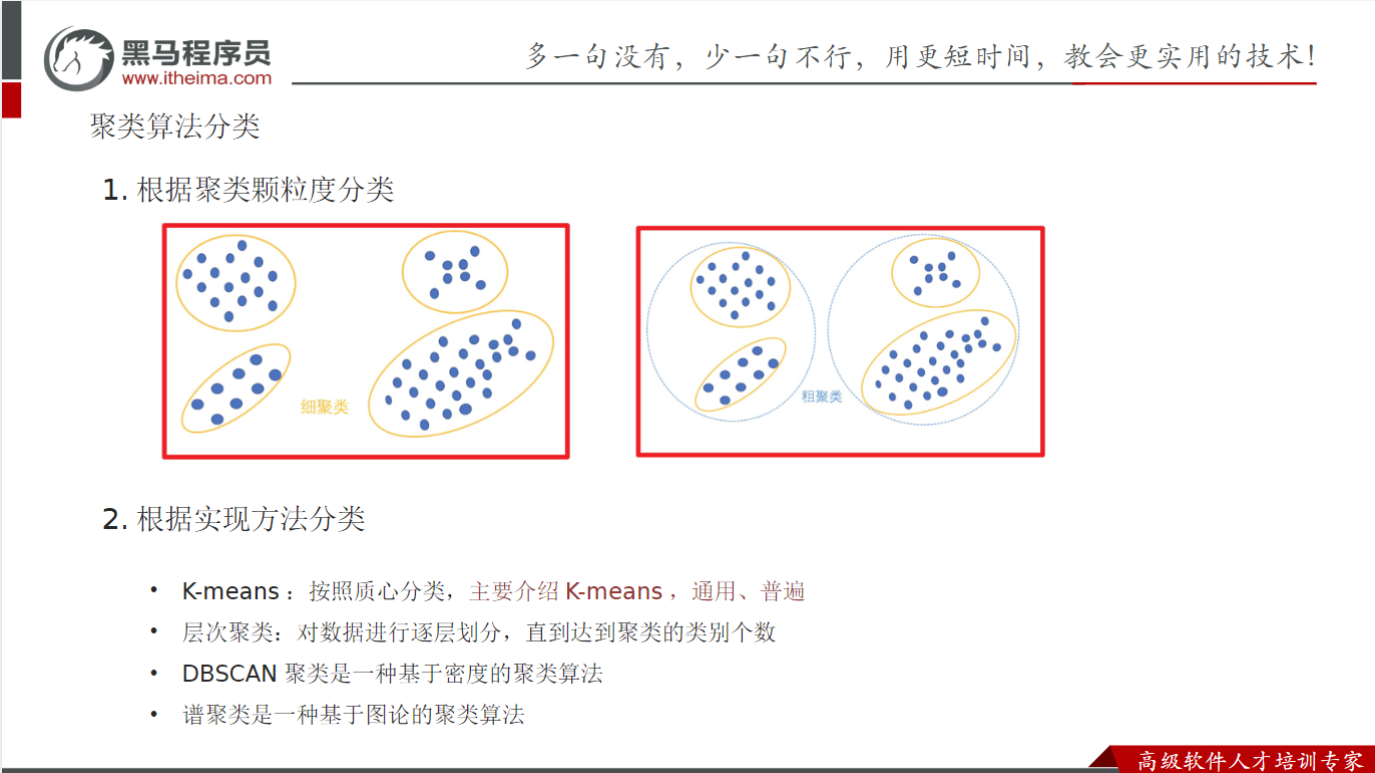
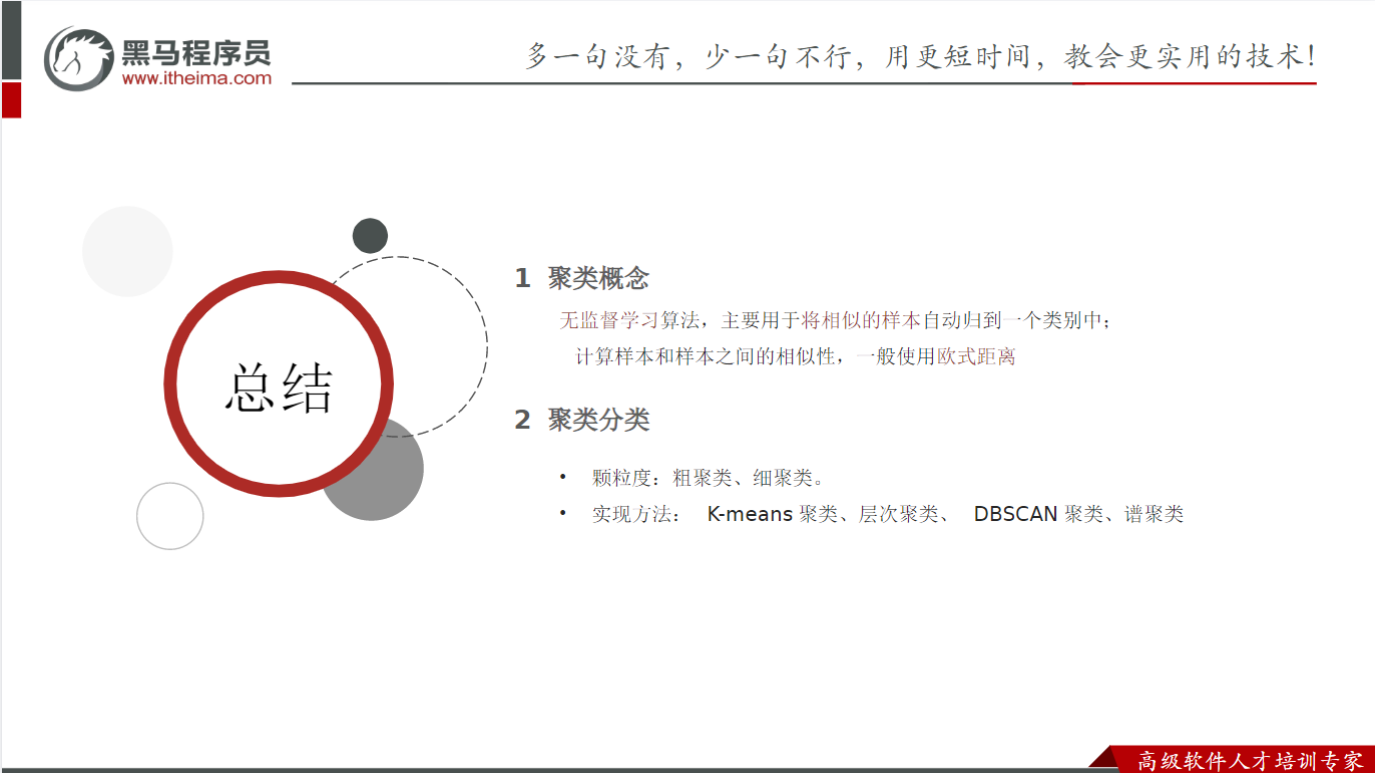
聚类算法简介
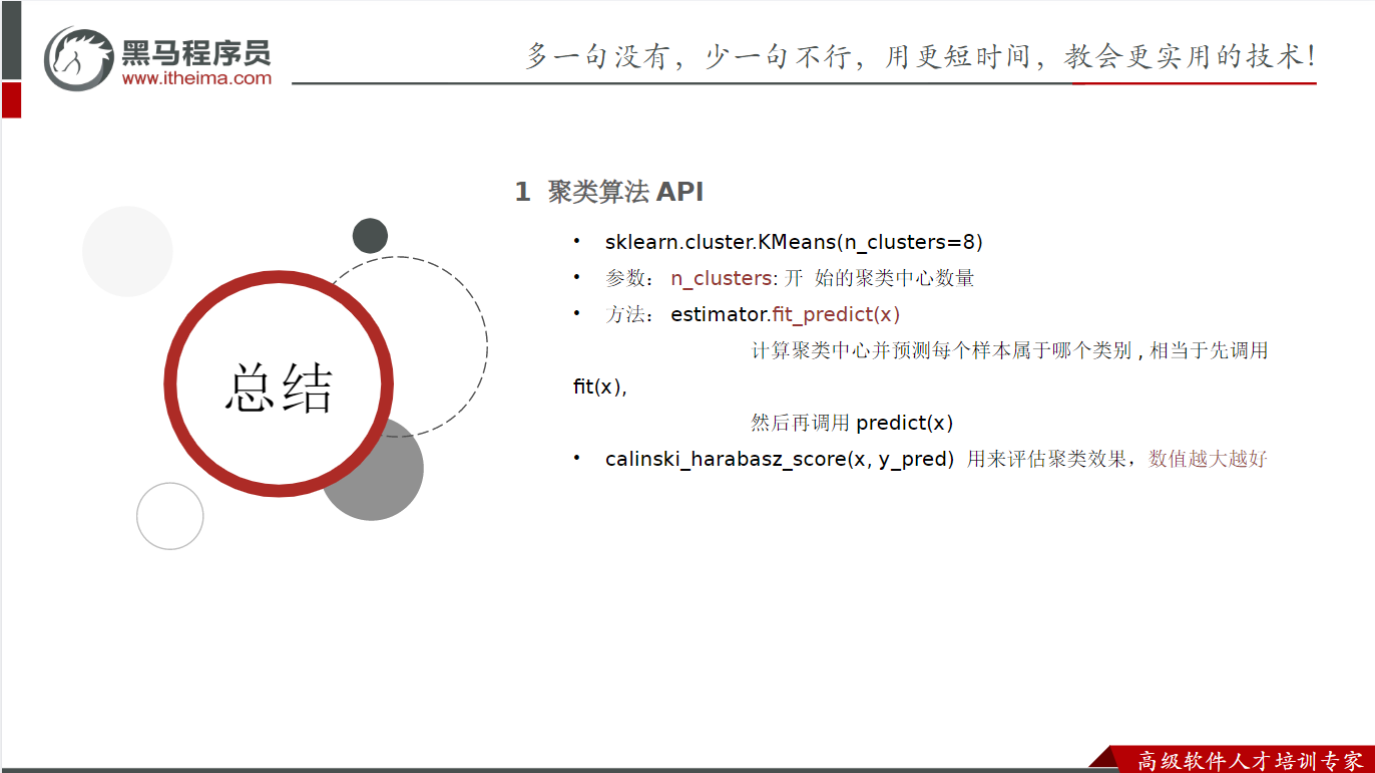
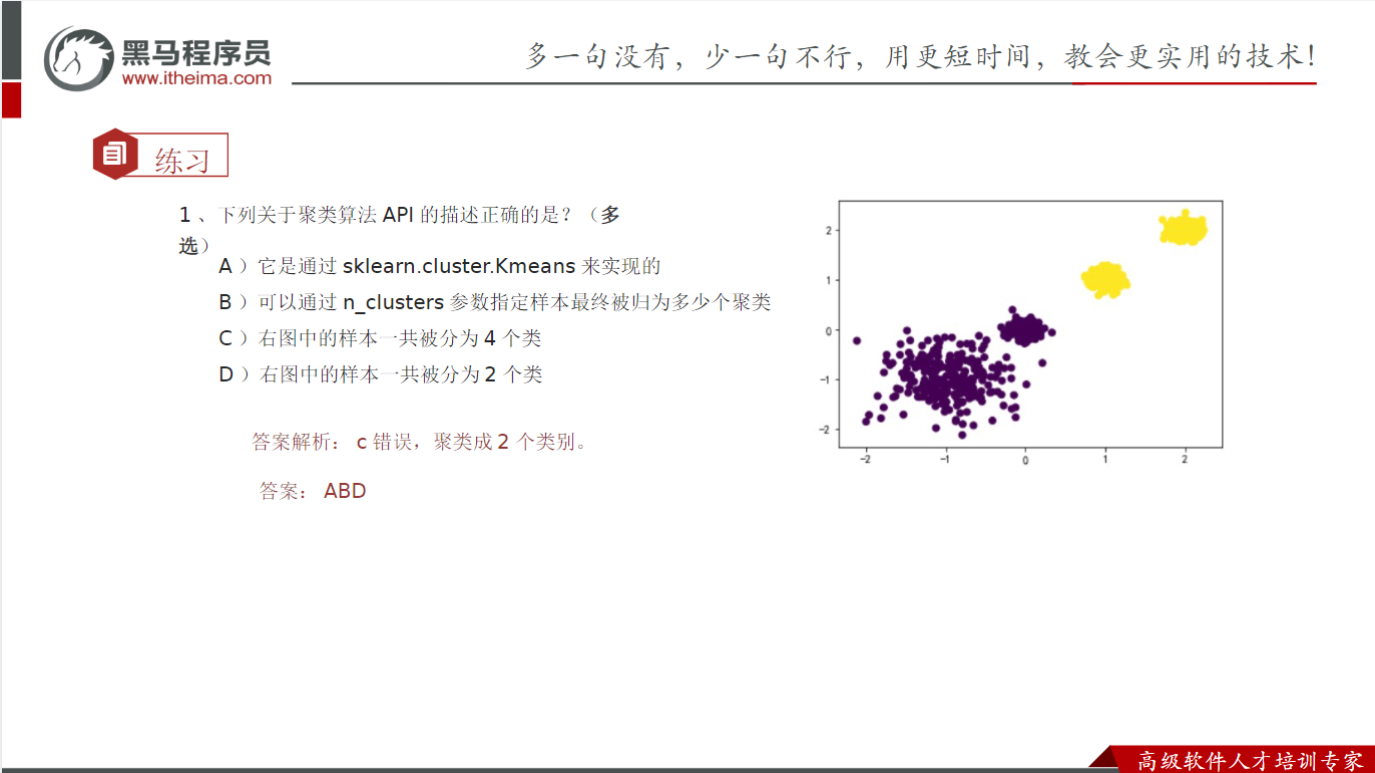
聚类算法API的使用
python
'''
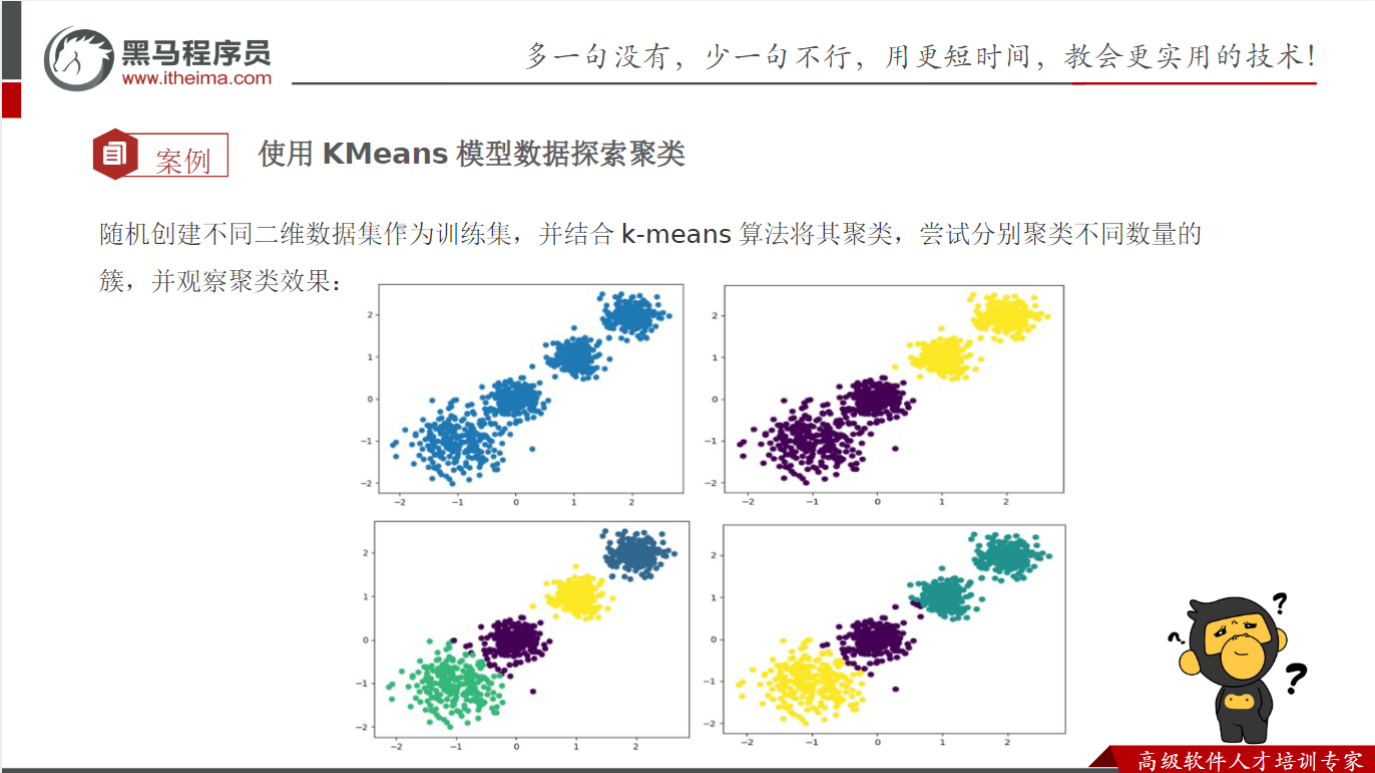
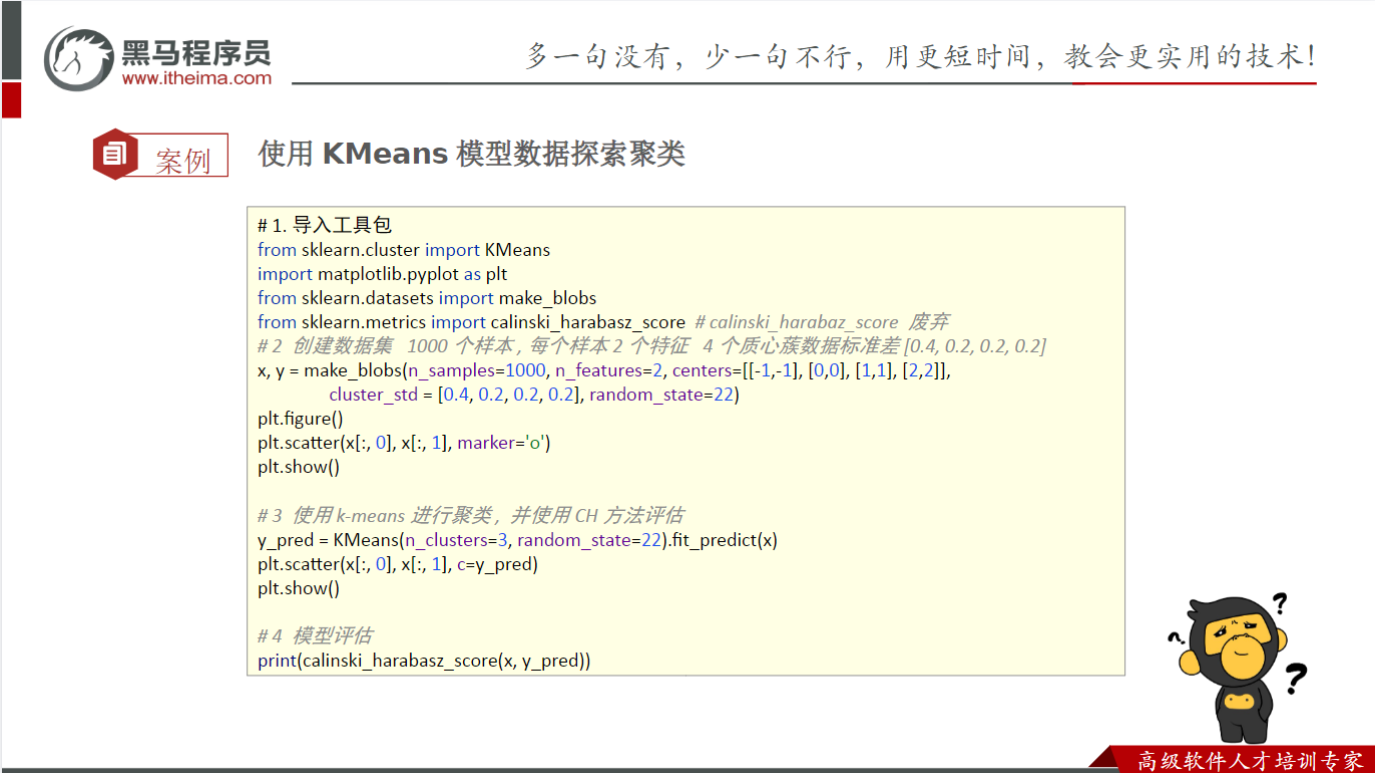
Kmeans聚类算法入门案例
Kmeans简介:
    它属于无监督学习,即,有特征,无标签,根据样本间的相似性进行划分
    所谓相似性 可以理解为就是距离,例如:欧式距离,曼哈顿(城市街区)距离,切比雪夫距离,闵式距离

    一般大厂,项目初期在没有先备知识(标签)的情况下,可能会用
'''
import os
os.environ["LOKY_MAX_CPU_COUNT"] = "4"
import warnings
warnings.filterwarnings("ignore")
os.environ['TF_CPP_MIN_LOG_LEVEL'] = '4'#OpenMP多任务程序,这里设置为4个线程,防止出现线程冲突等
#导包
import numpy as np
from sklearn.cluster import KMeans#聚类的API,采用指定质心来分簇
import matplotlib.pyplot as plt#绘图的
from sklearn.datasets import make_blobs#默认会按照高斯分布(正态分布)生成数据集,只需要指定均值、标准差
from sklearn.metrics import calinski_harabasz_score#评价指标,值越大,效果越好

#1.准备数据集
#参1:样本数量 参2:样本特征数量2列 参3:质心数量4个 参4:每个质心的标准差 参5:随机种子
x,y=make_blobs(n_samples=100,n_features=2,centers=[[-1,-1],[0,0],[1,1],[2,2]],cluster_std=[0.4,0.2,0.3,0.5],random_state=42)
# print(x)
# print(y)
#2.绘制上述的图形
#参1:x轴坐标 参2:y轴坐标 参3:颜色
plt.scatter(x[:,0],x[:,1])
plt.show()
#3.创建Kmeans对象
#参1:聚类数量 参2:随机种子
estimator=KMeans(n_clusters=4,random_state=4)
#4.模型训练和预测
y_pred=estimator.fit_predict(x)
#5.绘制预测结果
#参1:x轴坐标 参2:y轴坐标 参3:预测结果
plt.scatter(x[:,0],x[:,1], c=y_pred)
plt.show()
#6.评价指标
print(f'评价指标(评分):{calinski_harabasz_score(x,y_pred)}')#越大越好
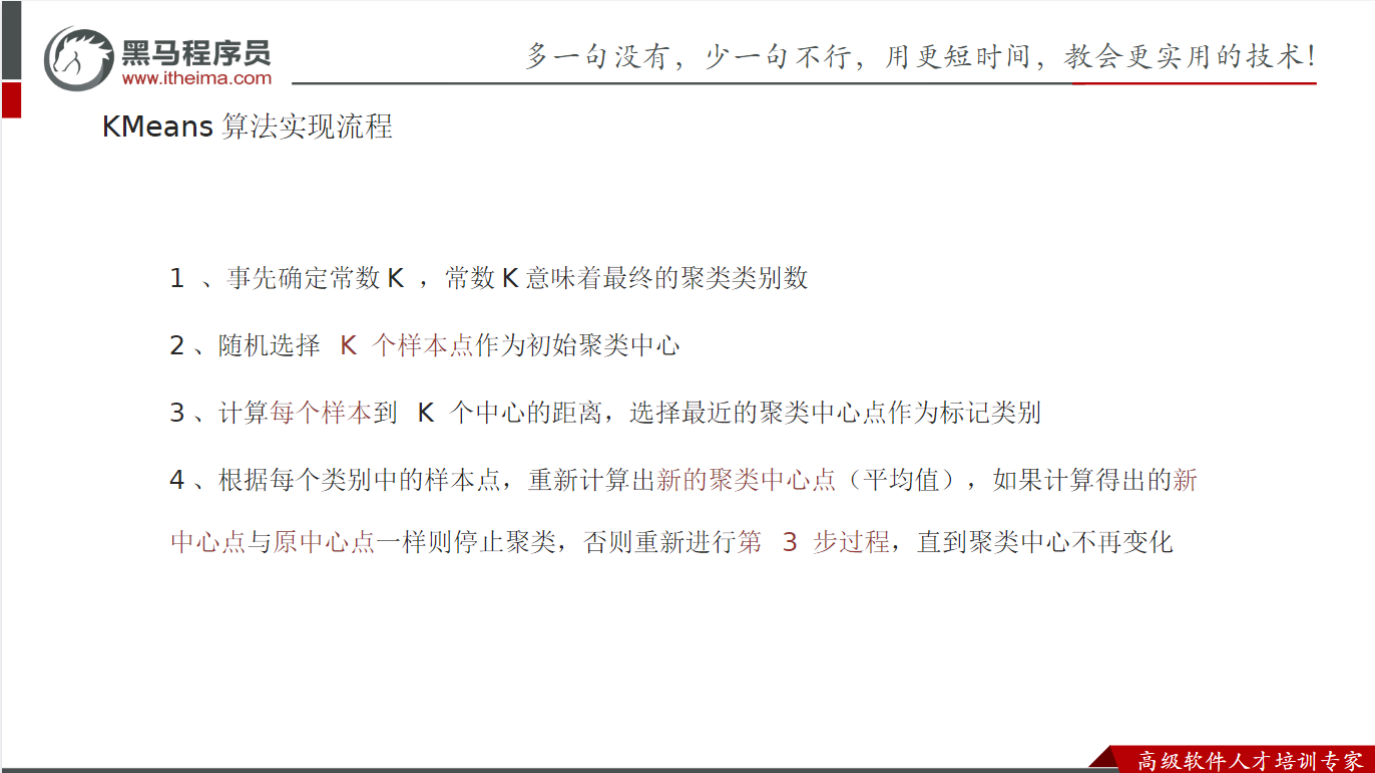
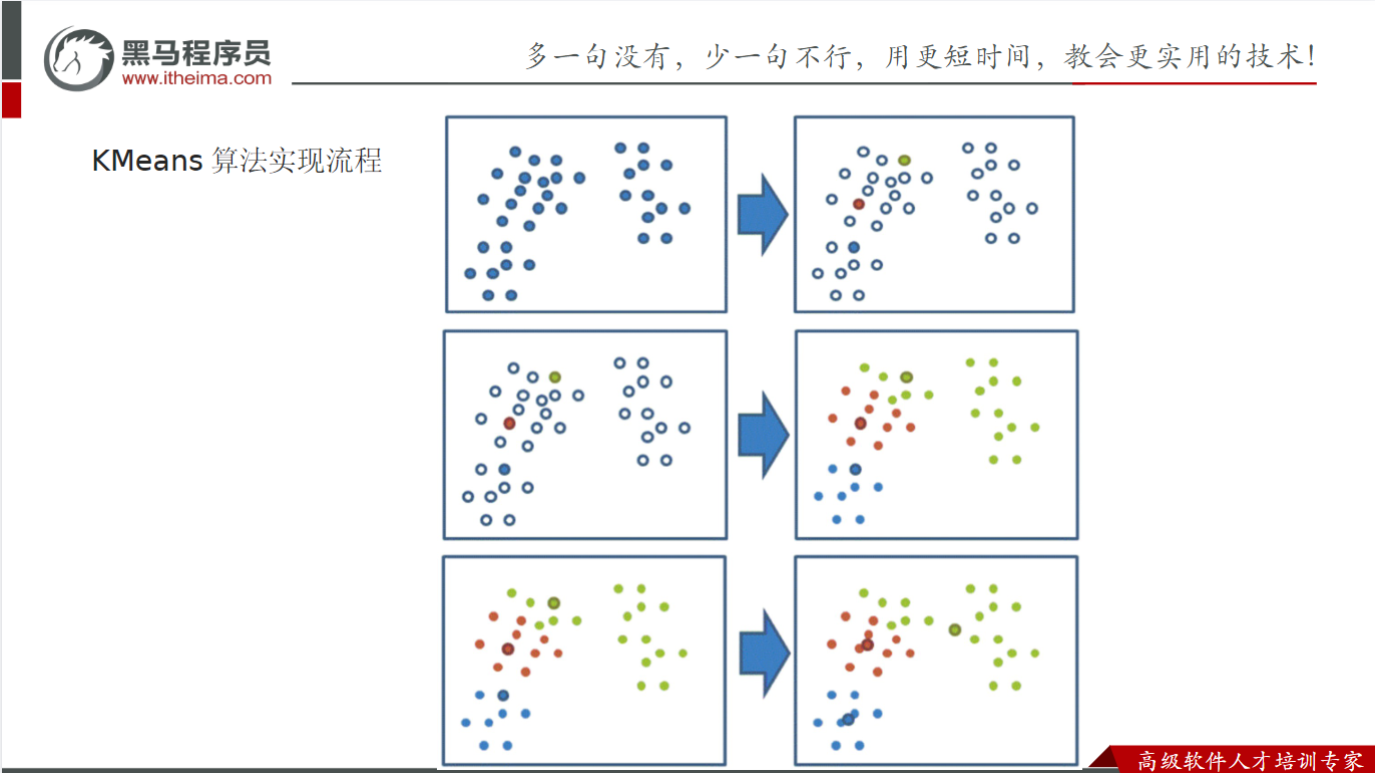
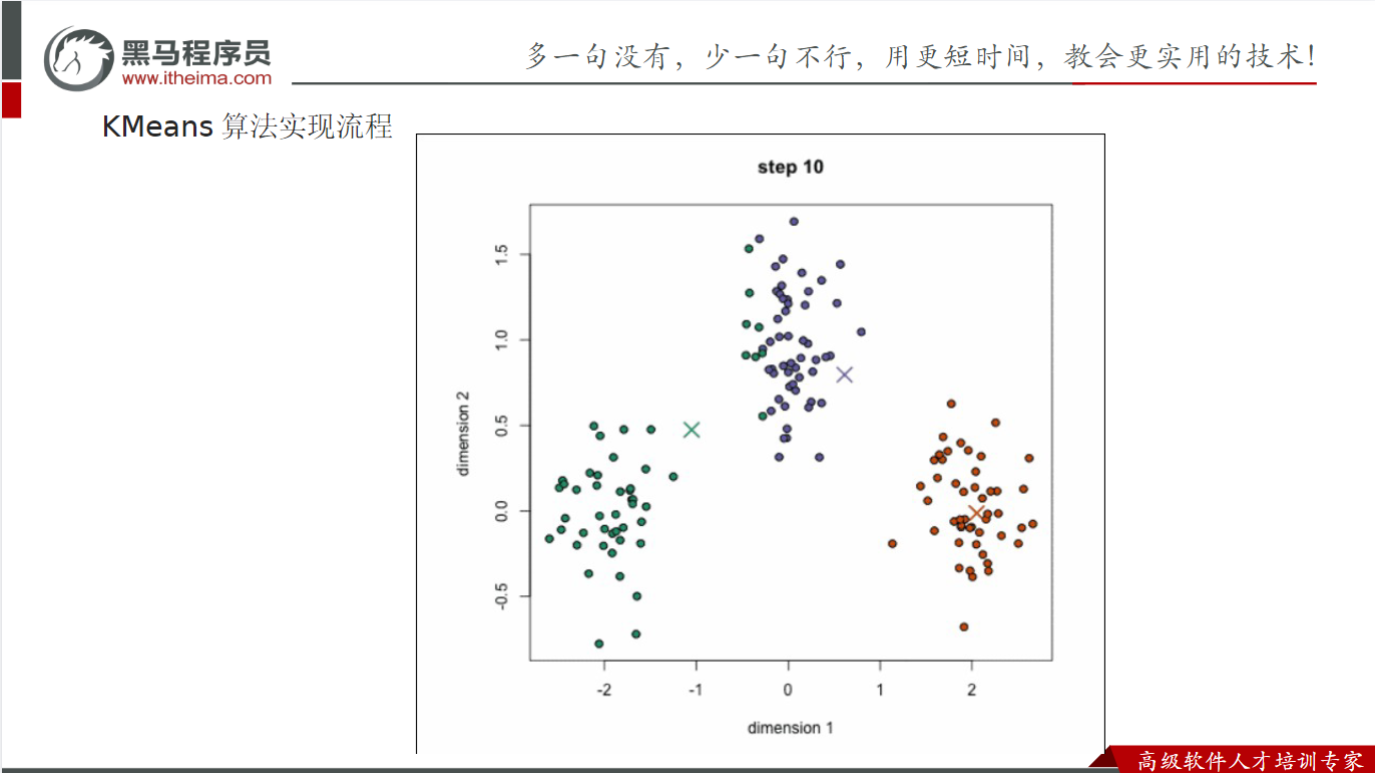
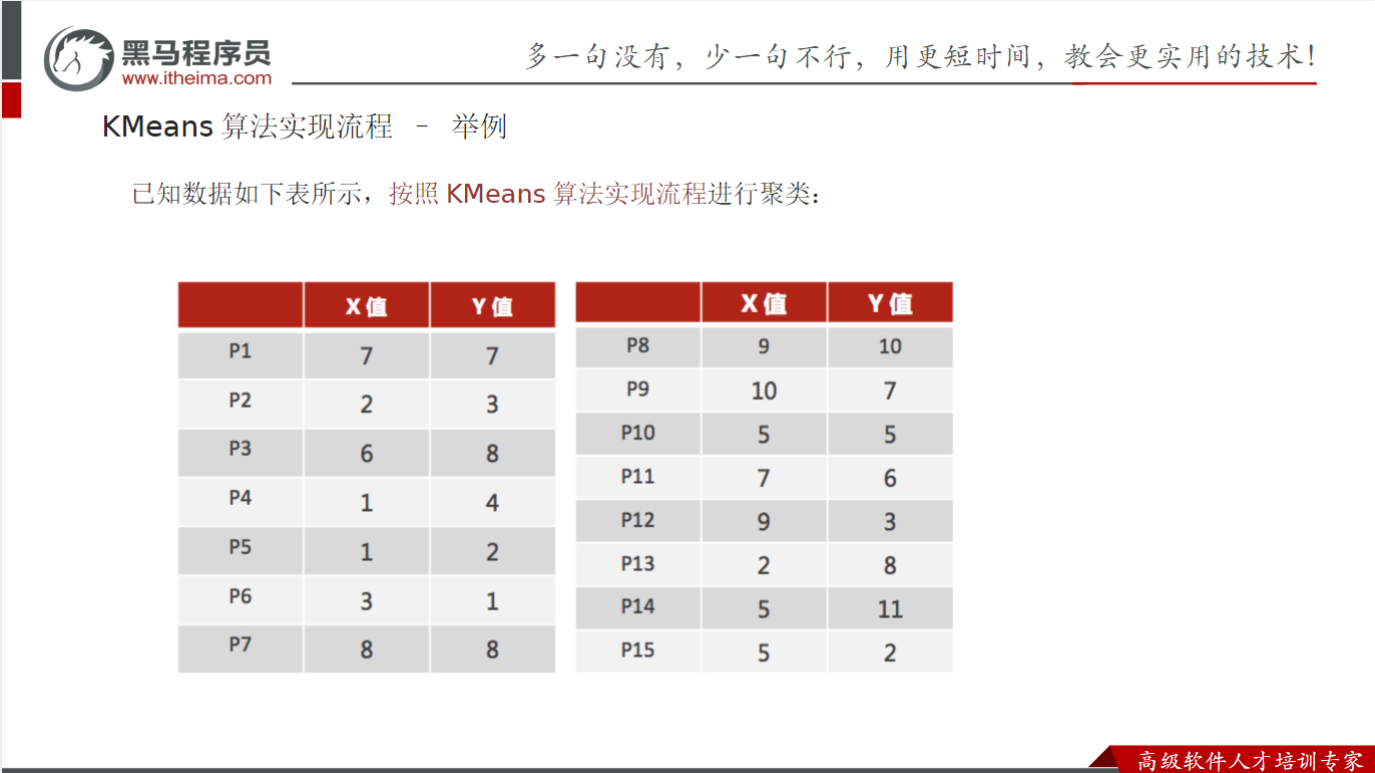
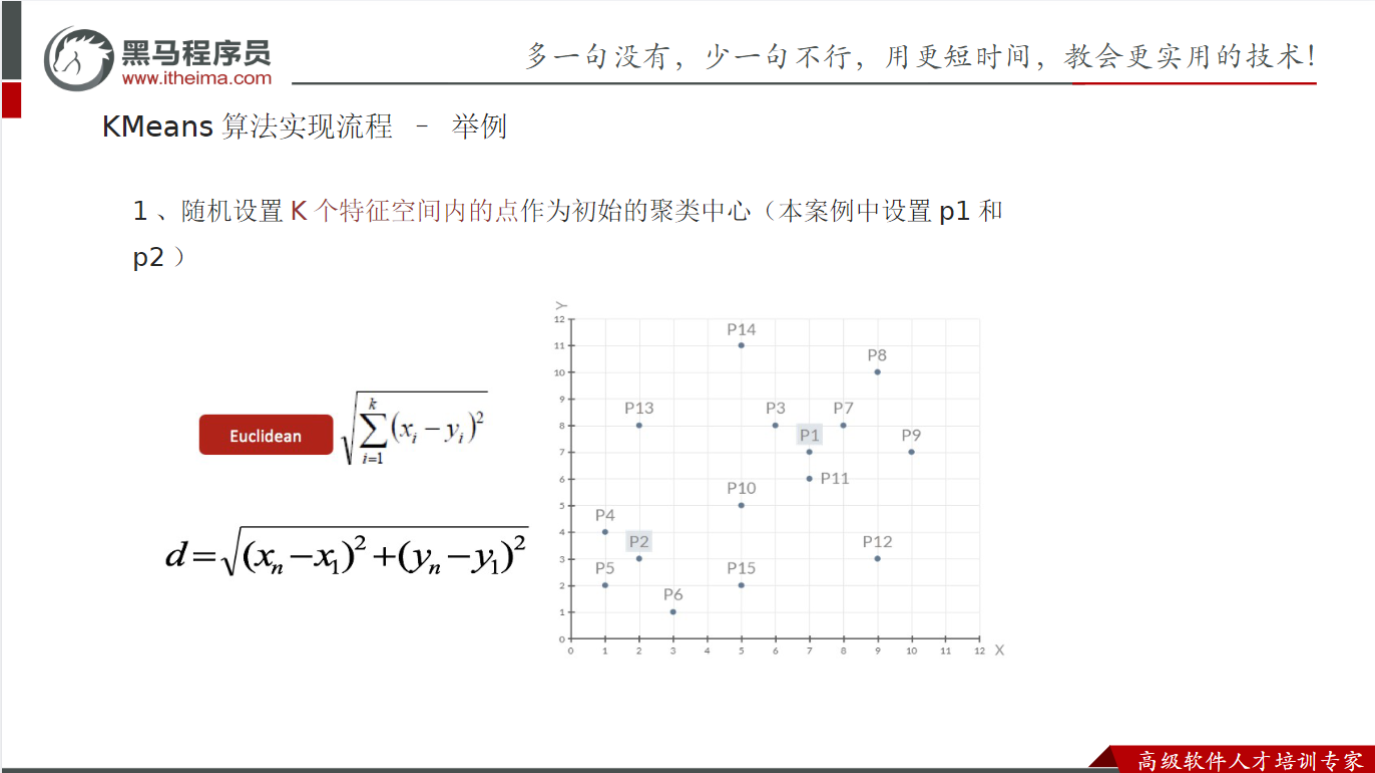
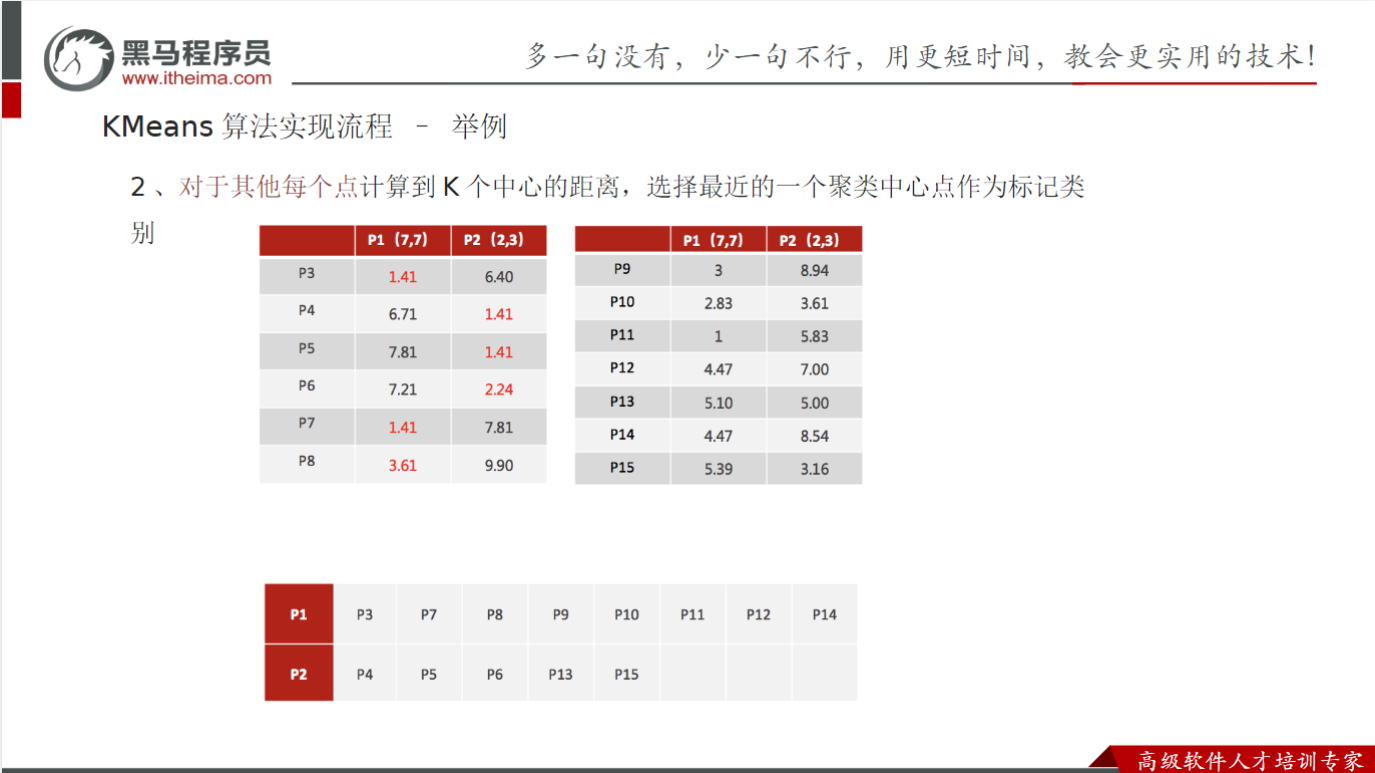
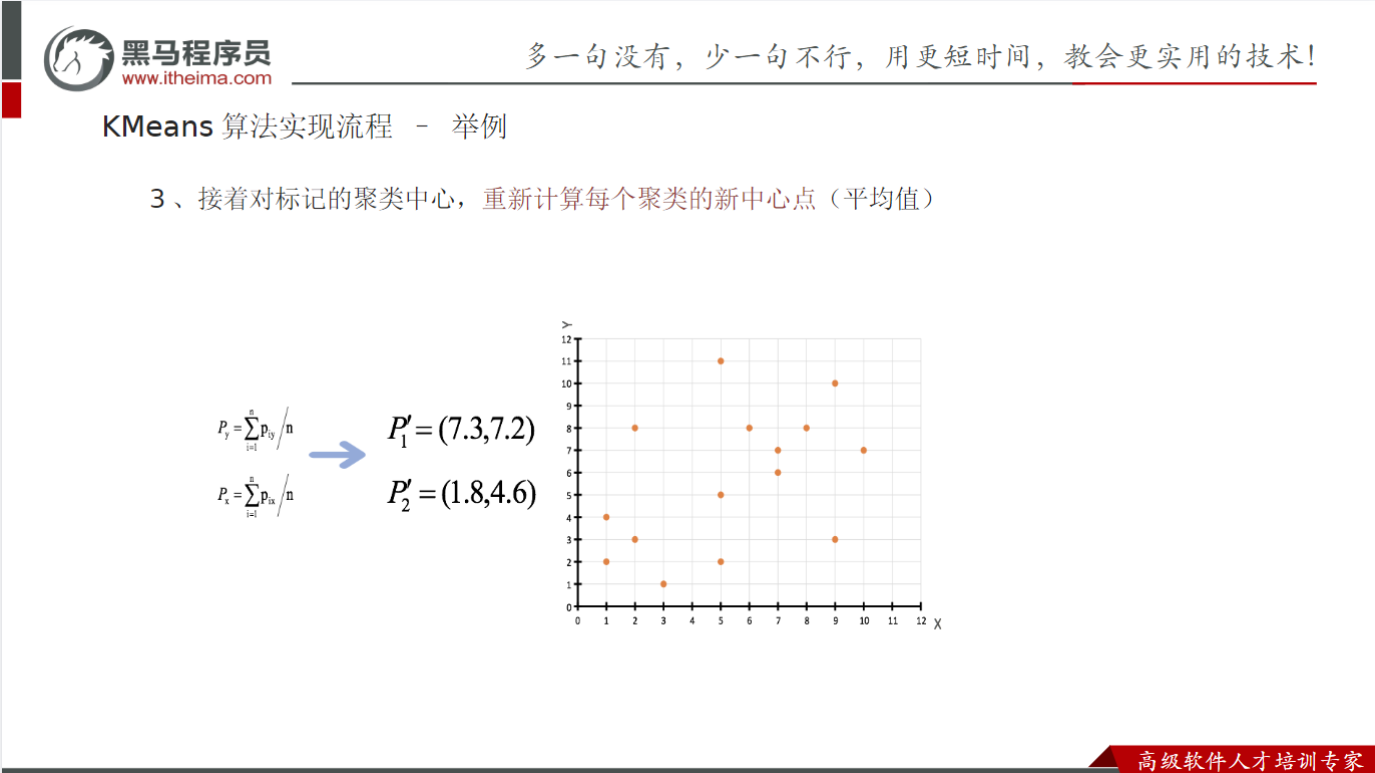
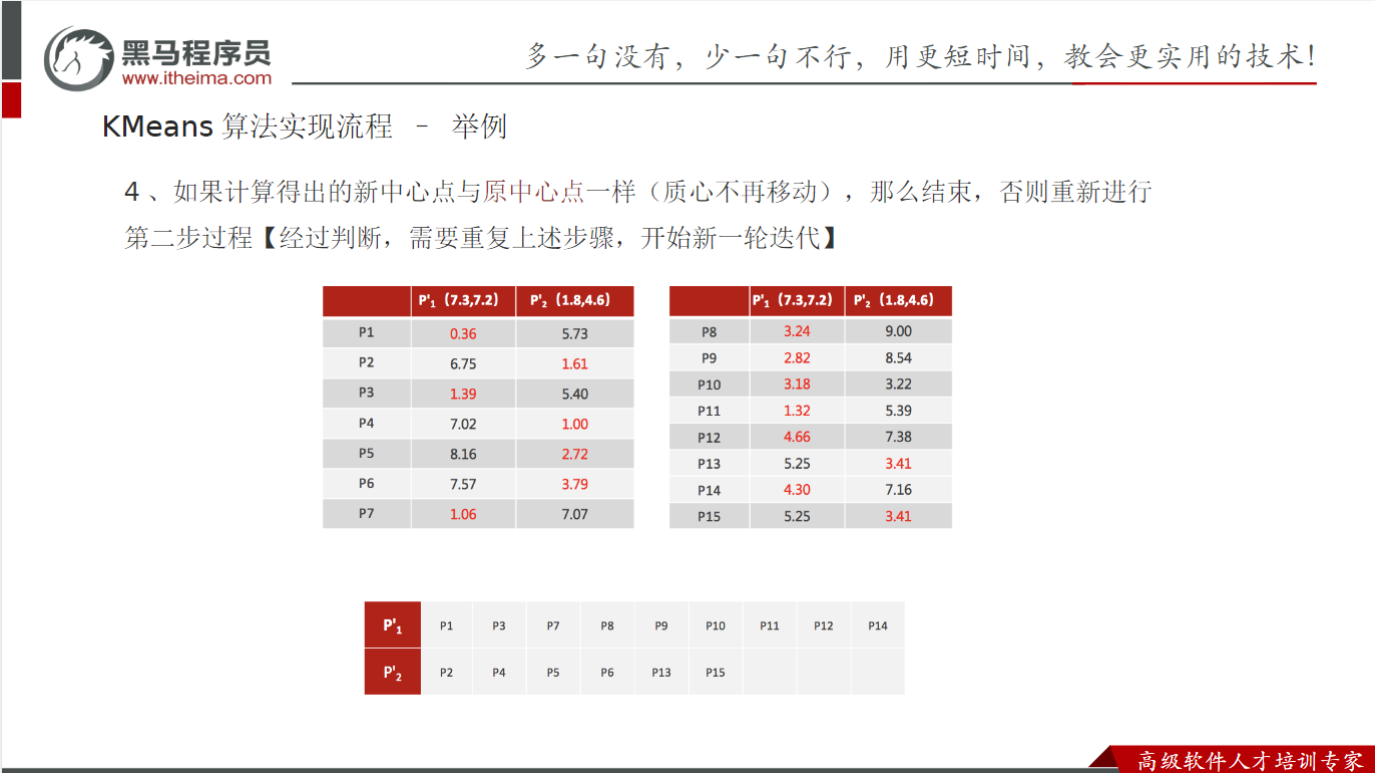
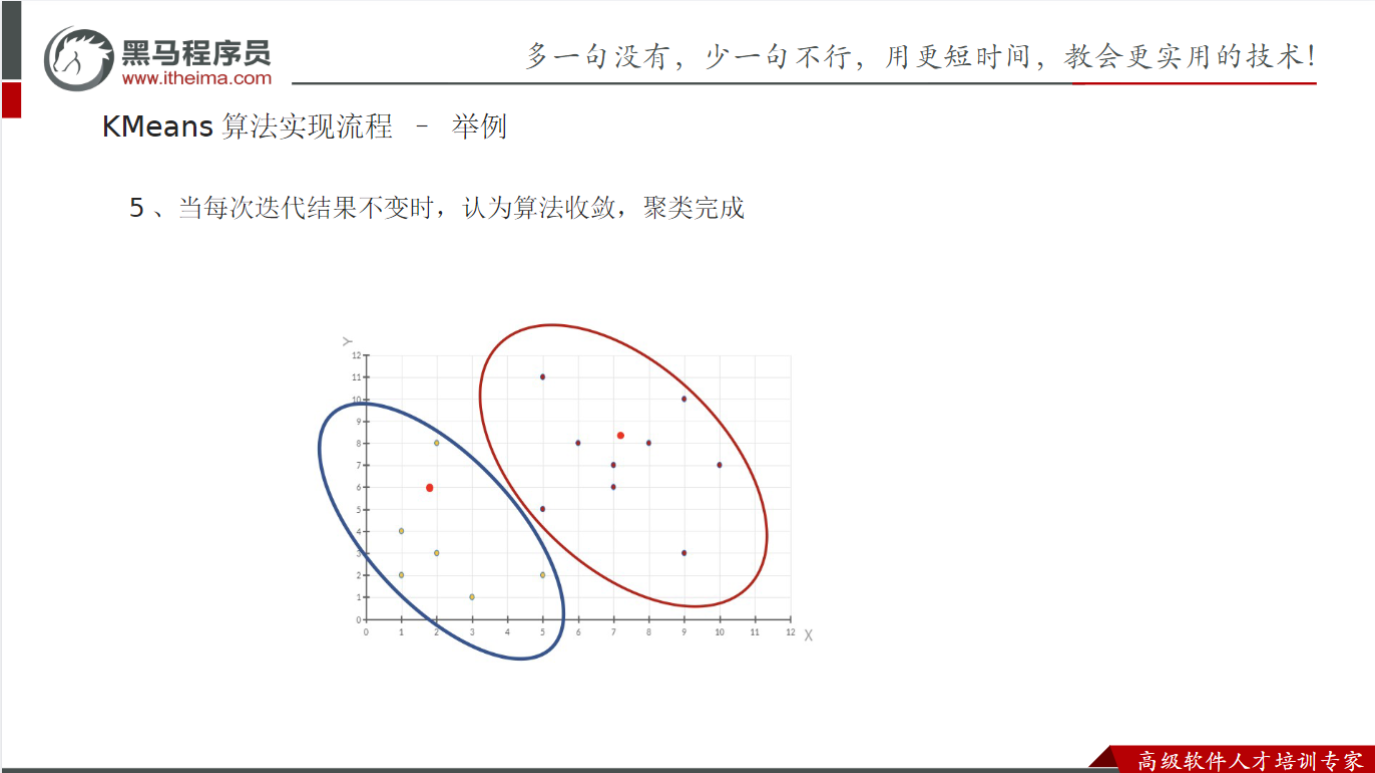
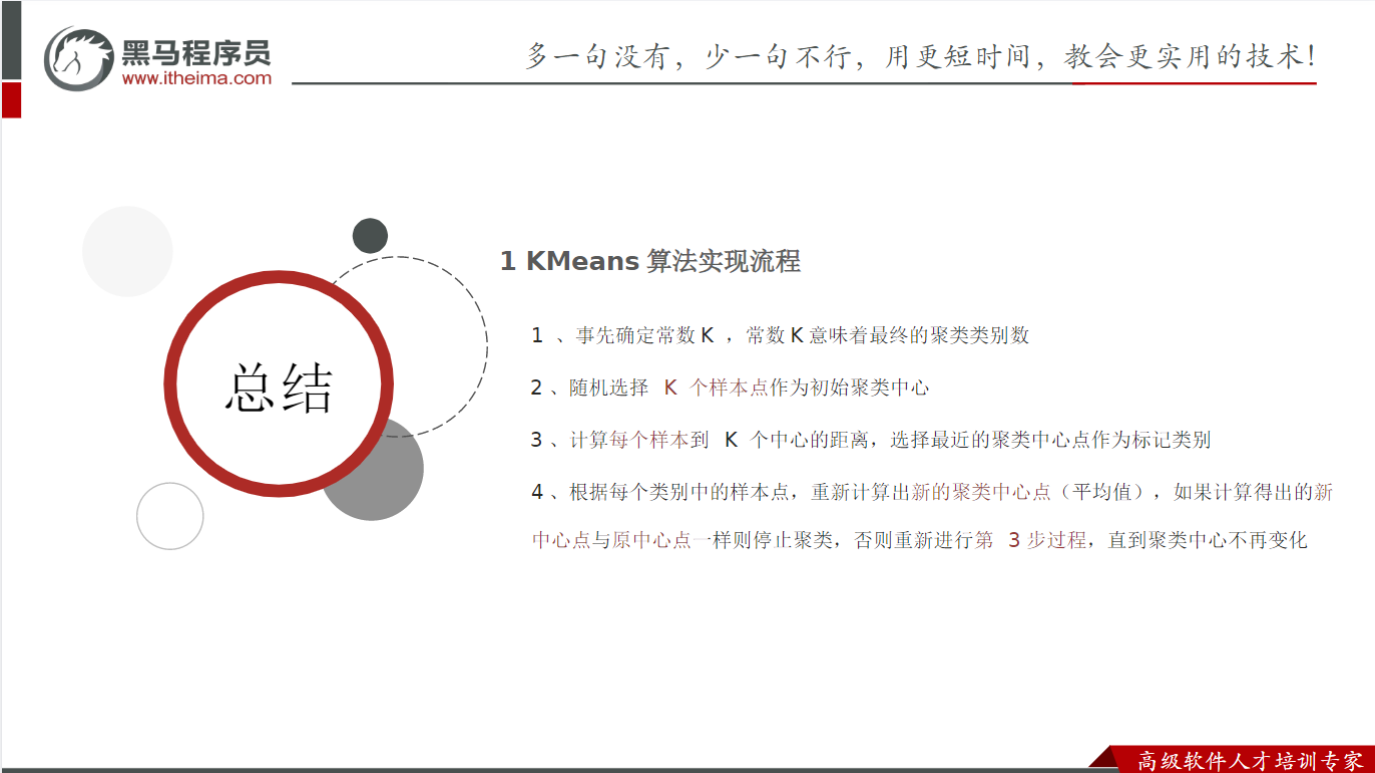
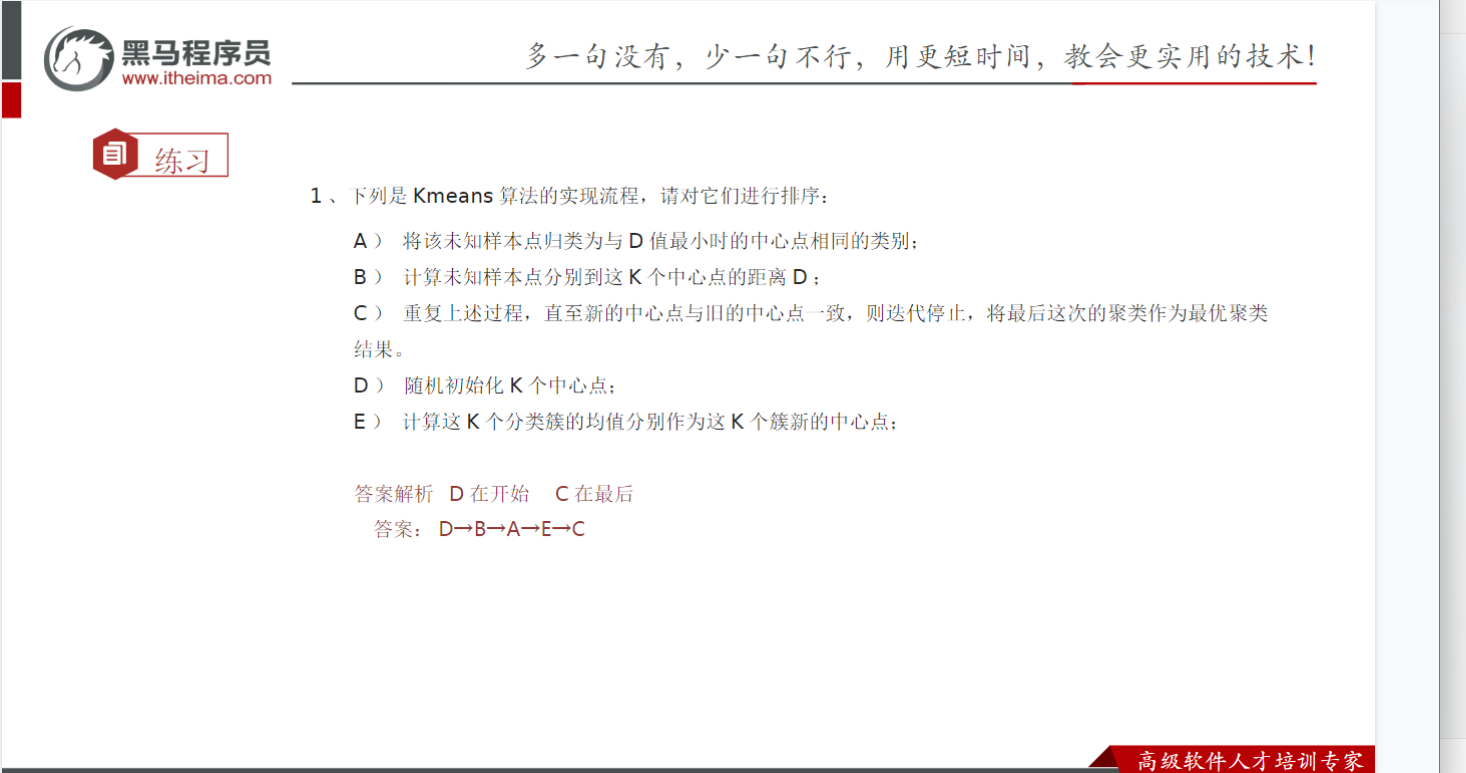
Kmeans实现流程
模型评估方法
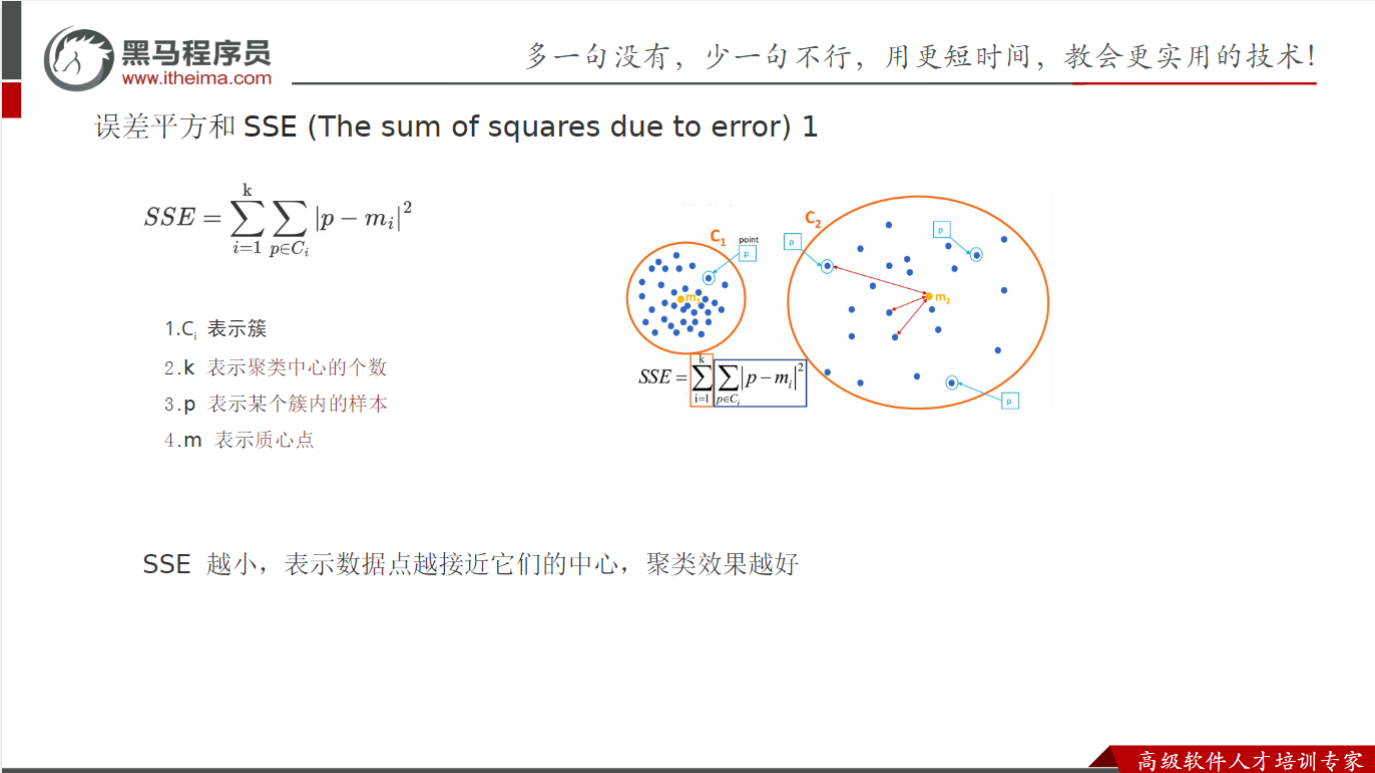
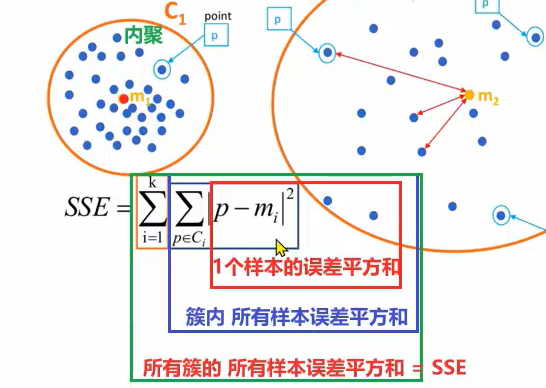
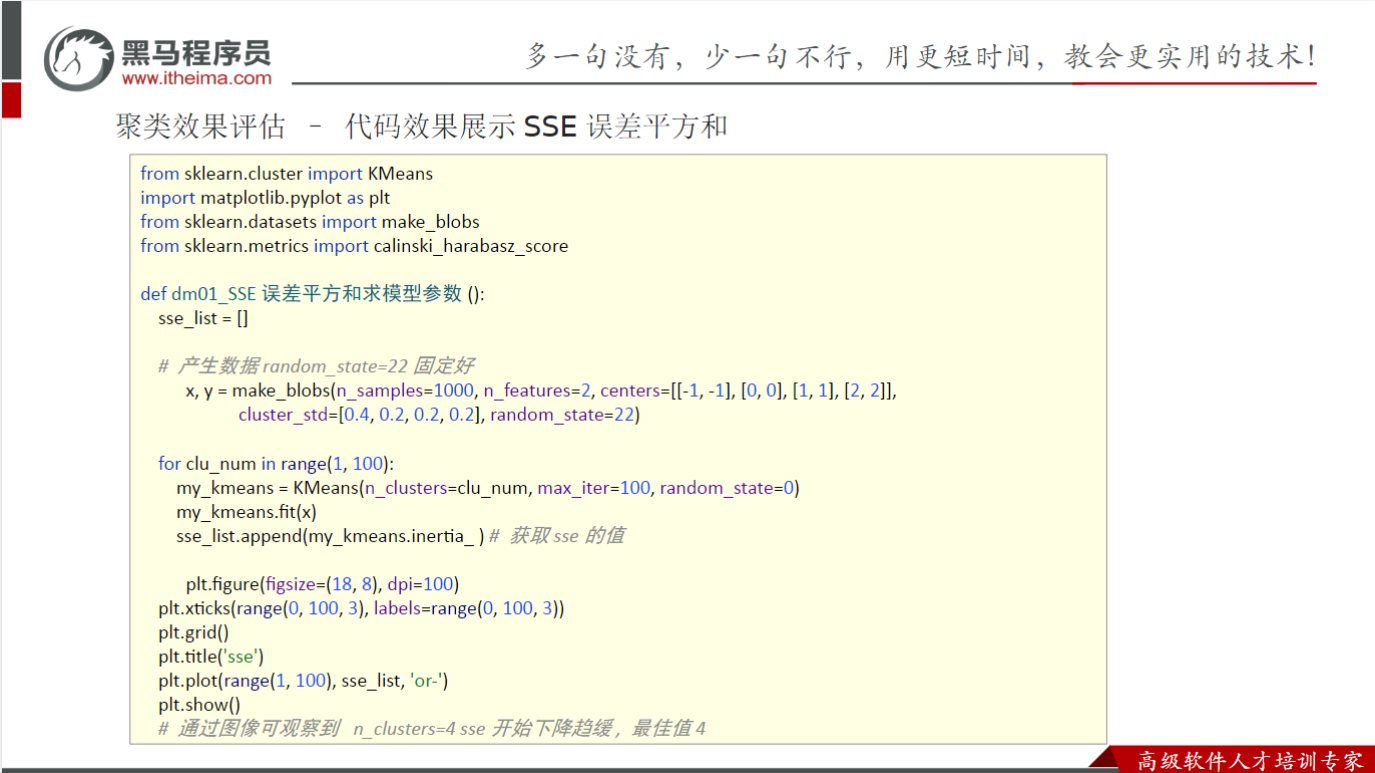
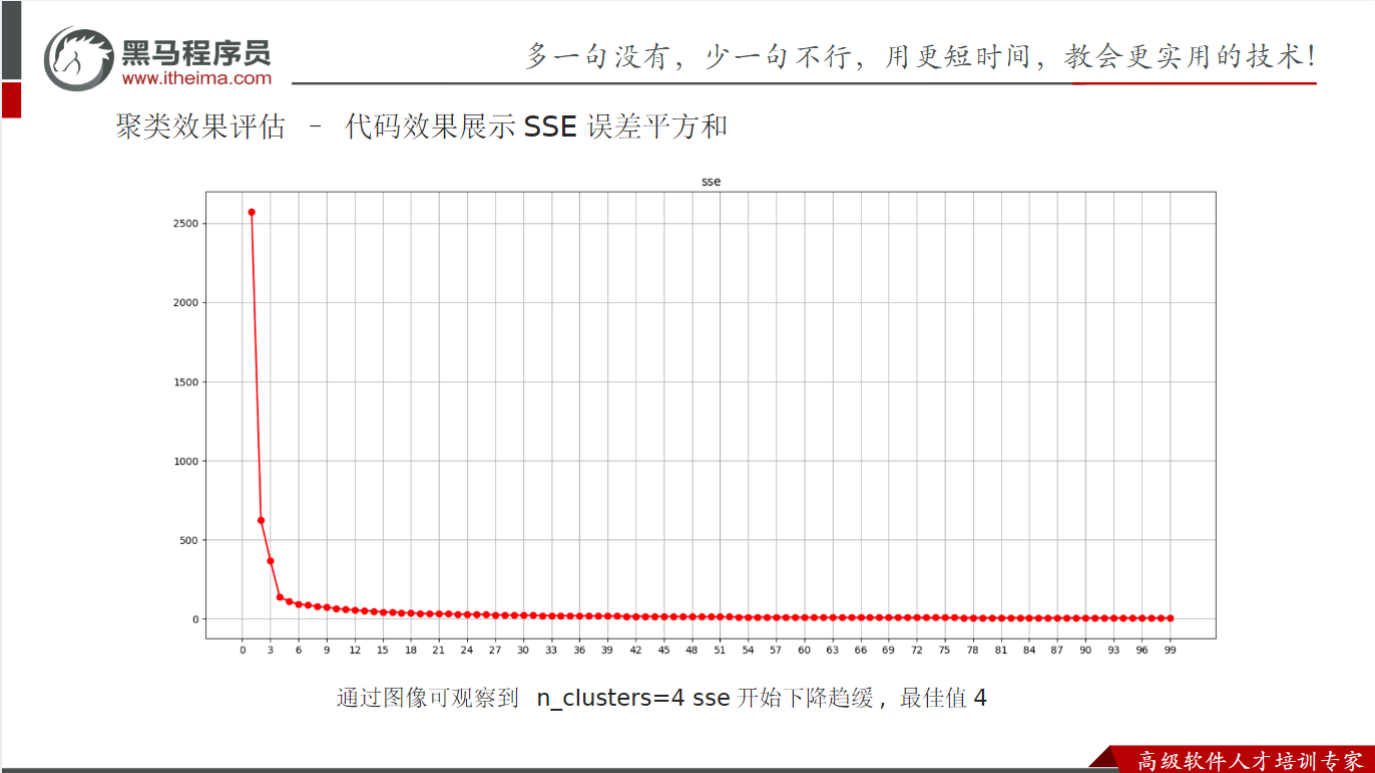
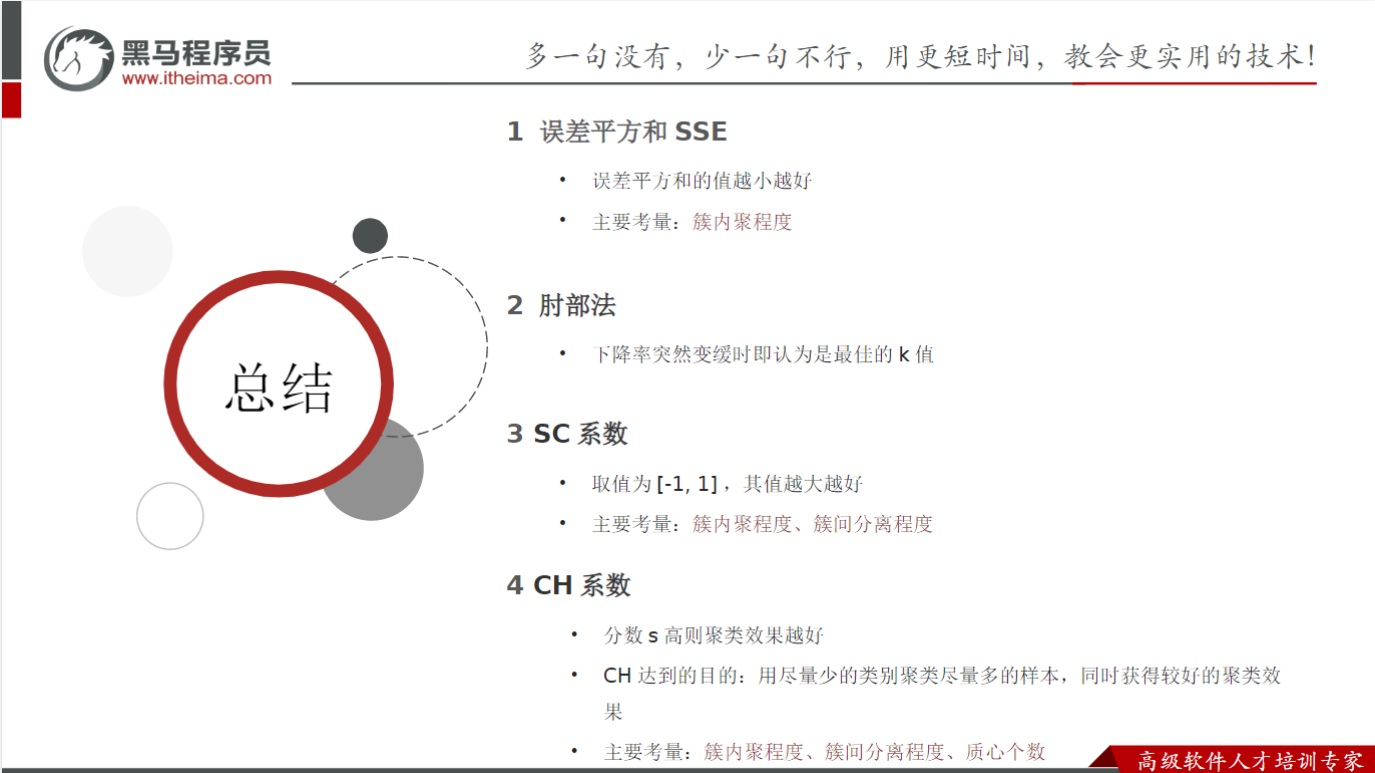
误差平方和SSE
真实值-质心=簇内距离(误差)
开发流程:高内聚,低耦合;自己能搞定的事,就不麻烦别人
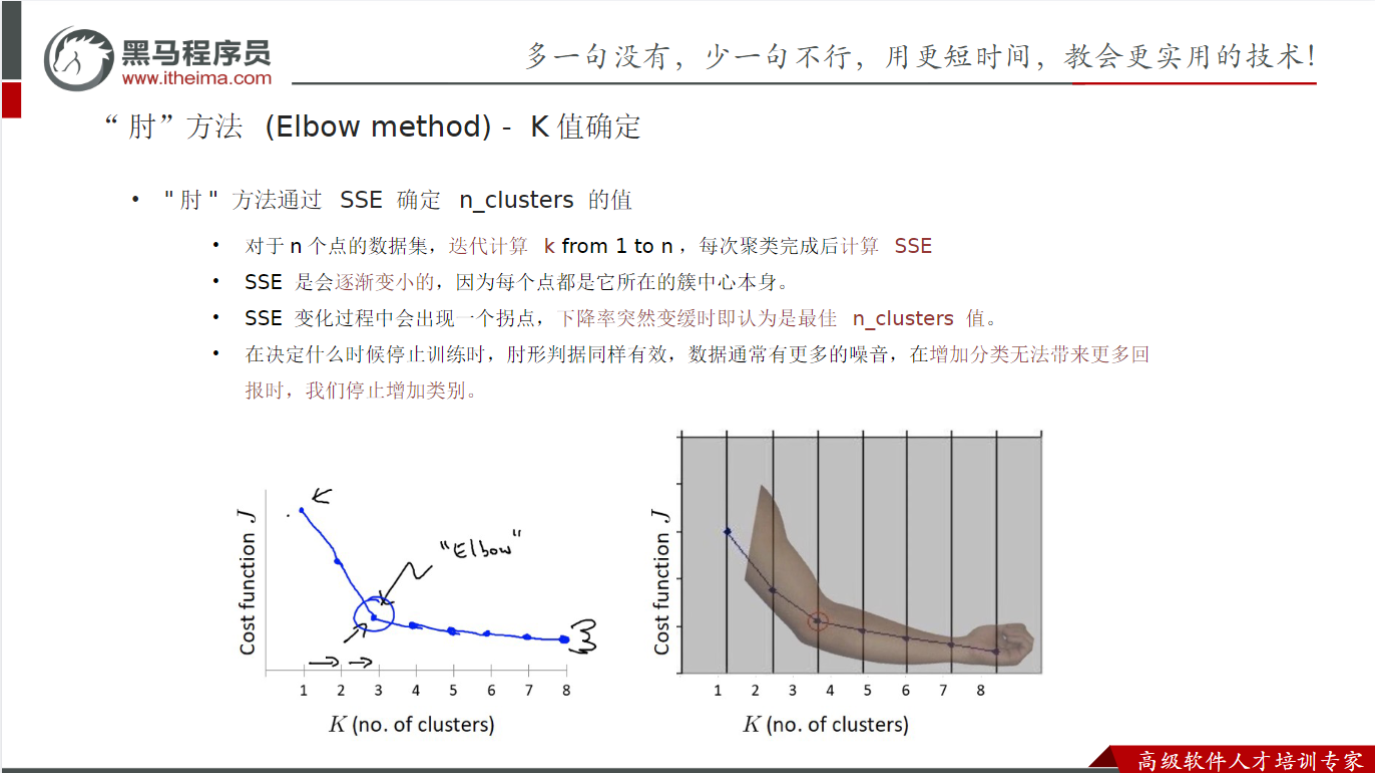
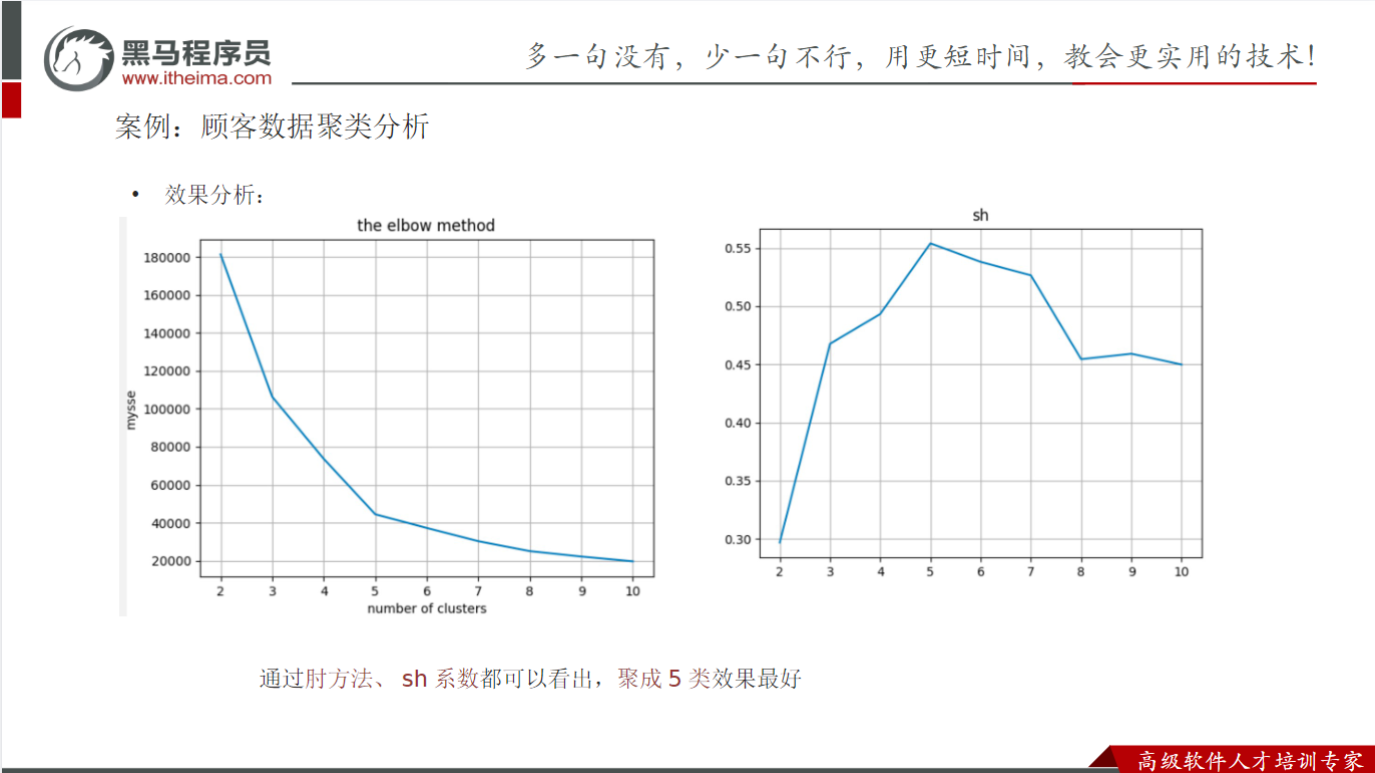
SSE越小,说明点越密集,内聚程度越高
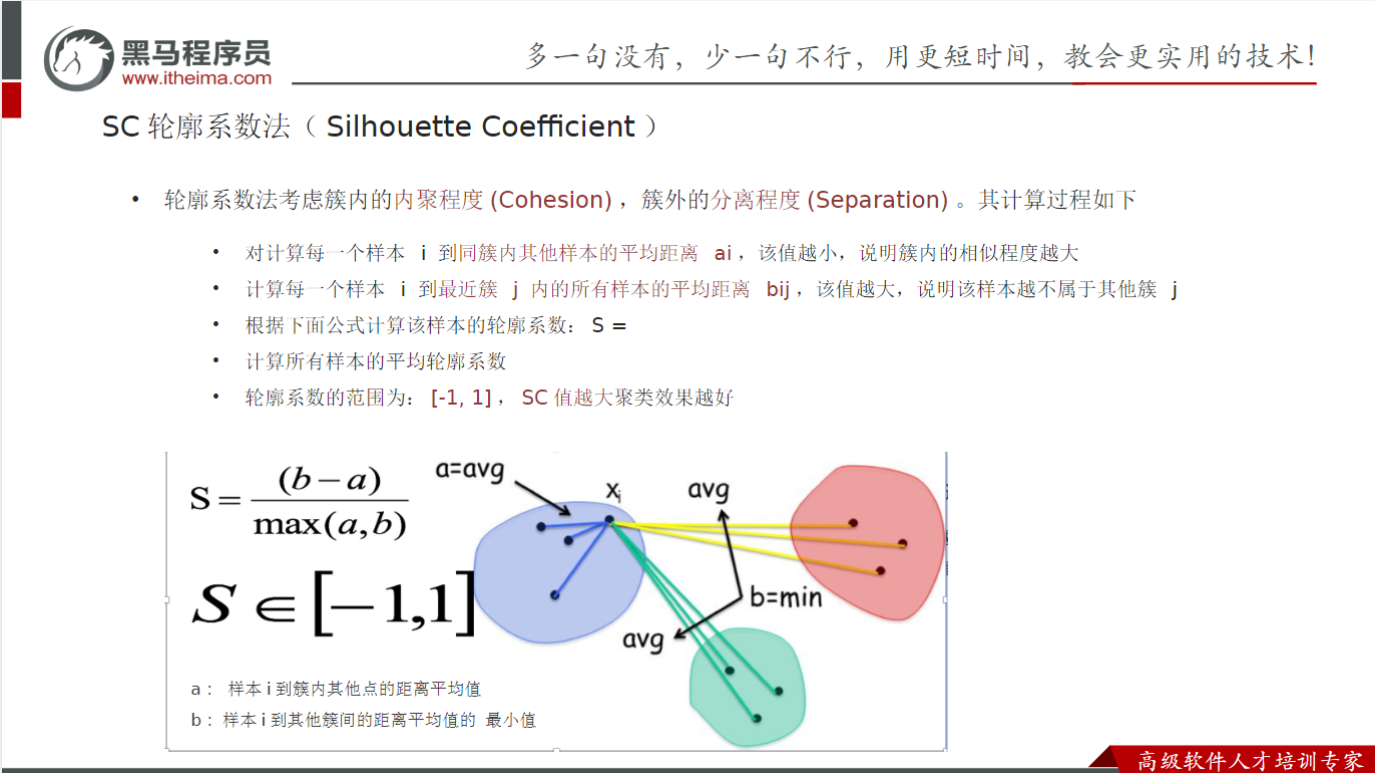
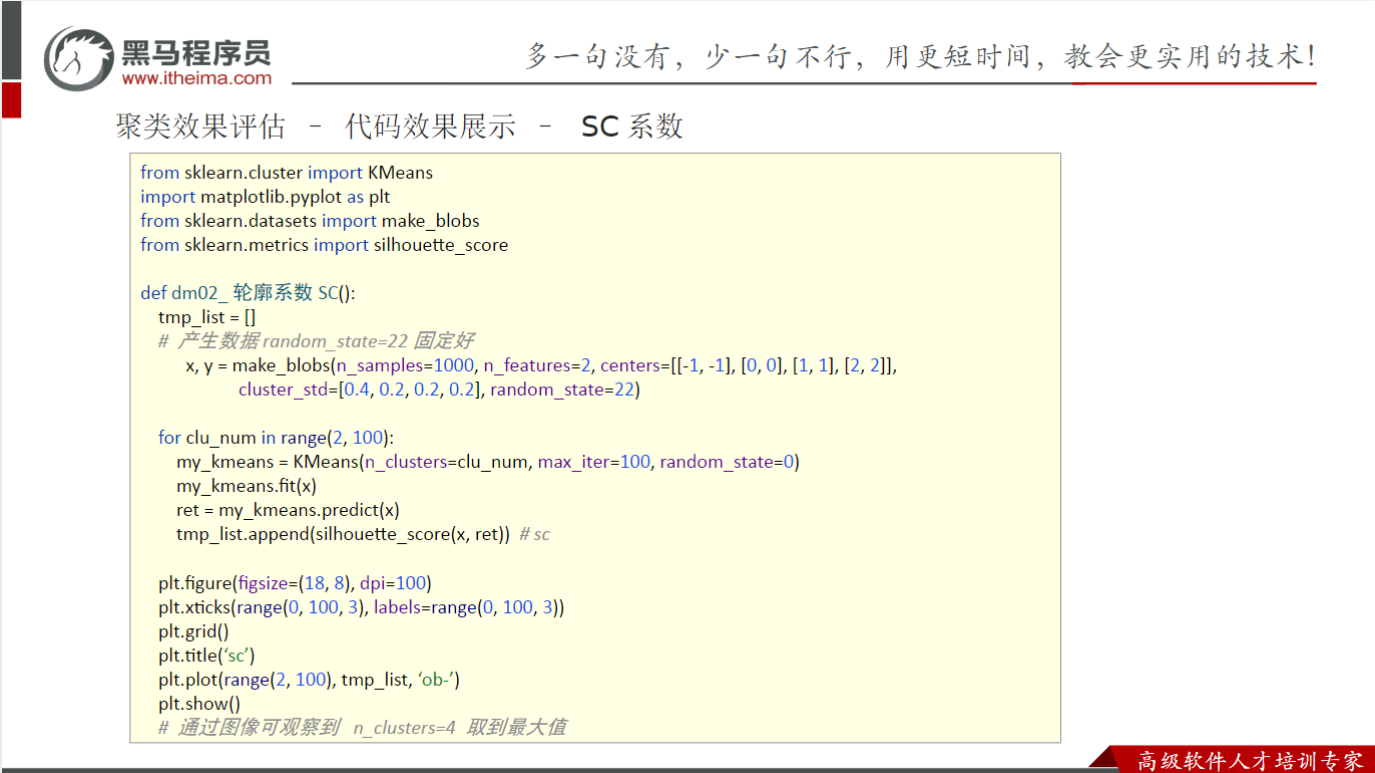
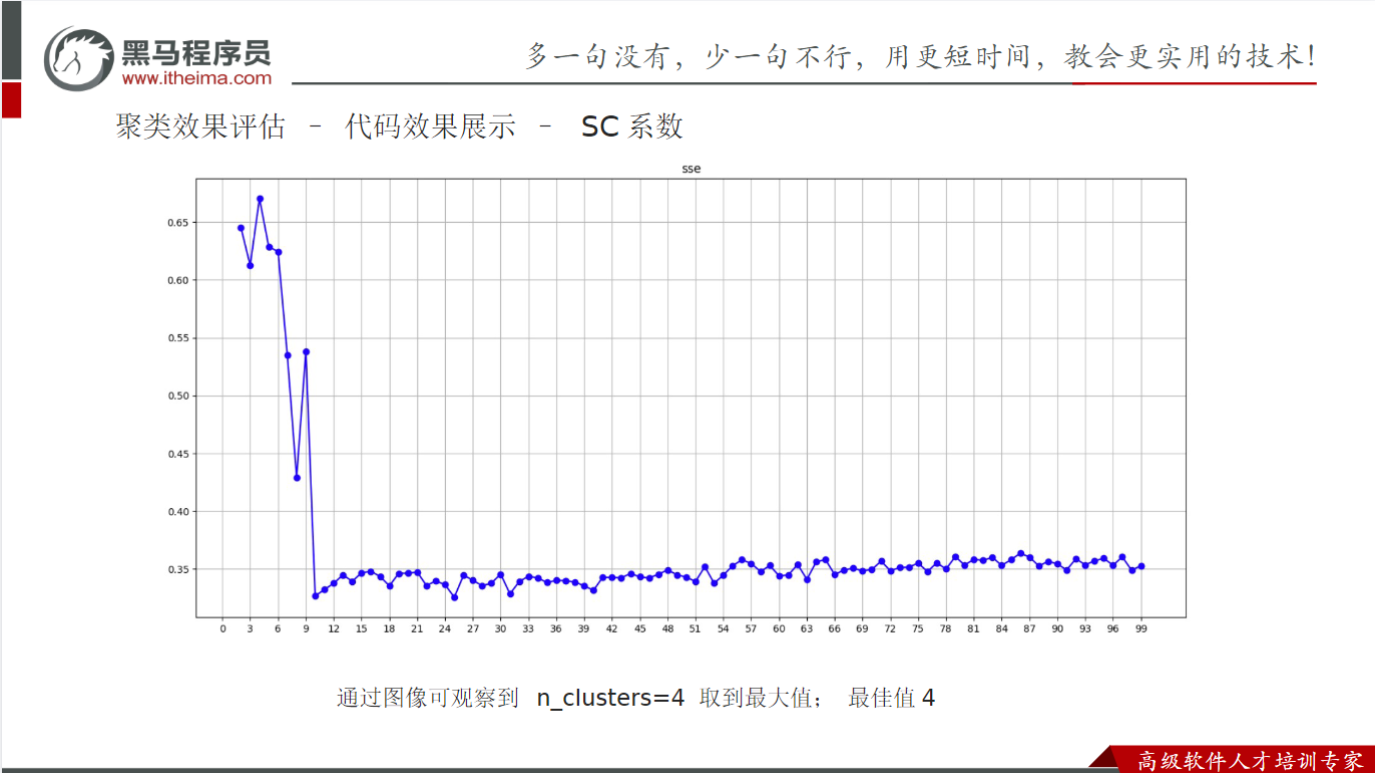
SC轮廓系数法
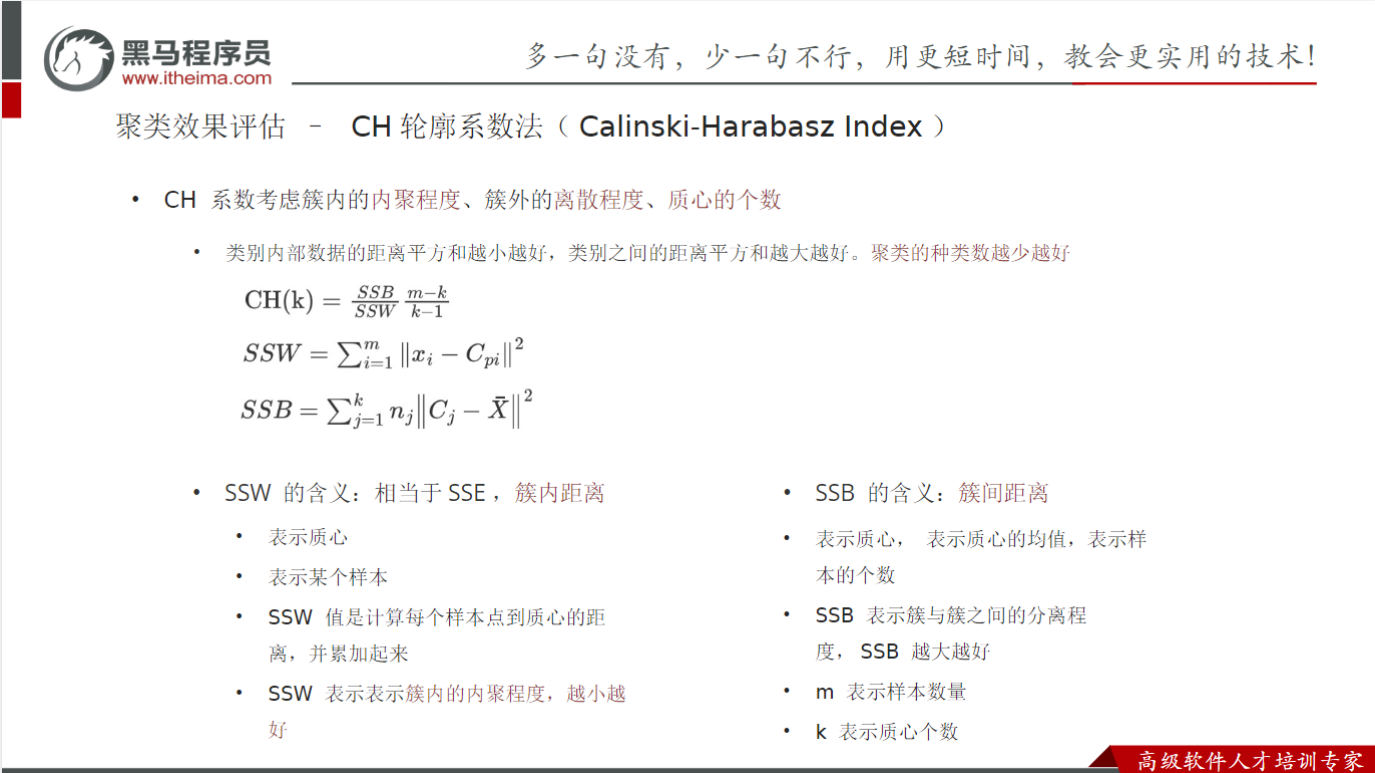
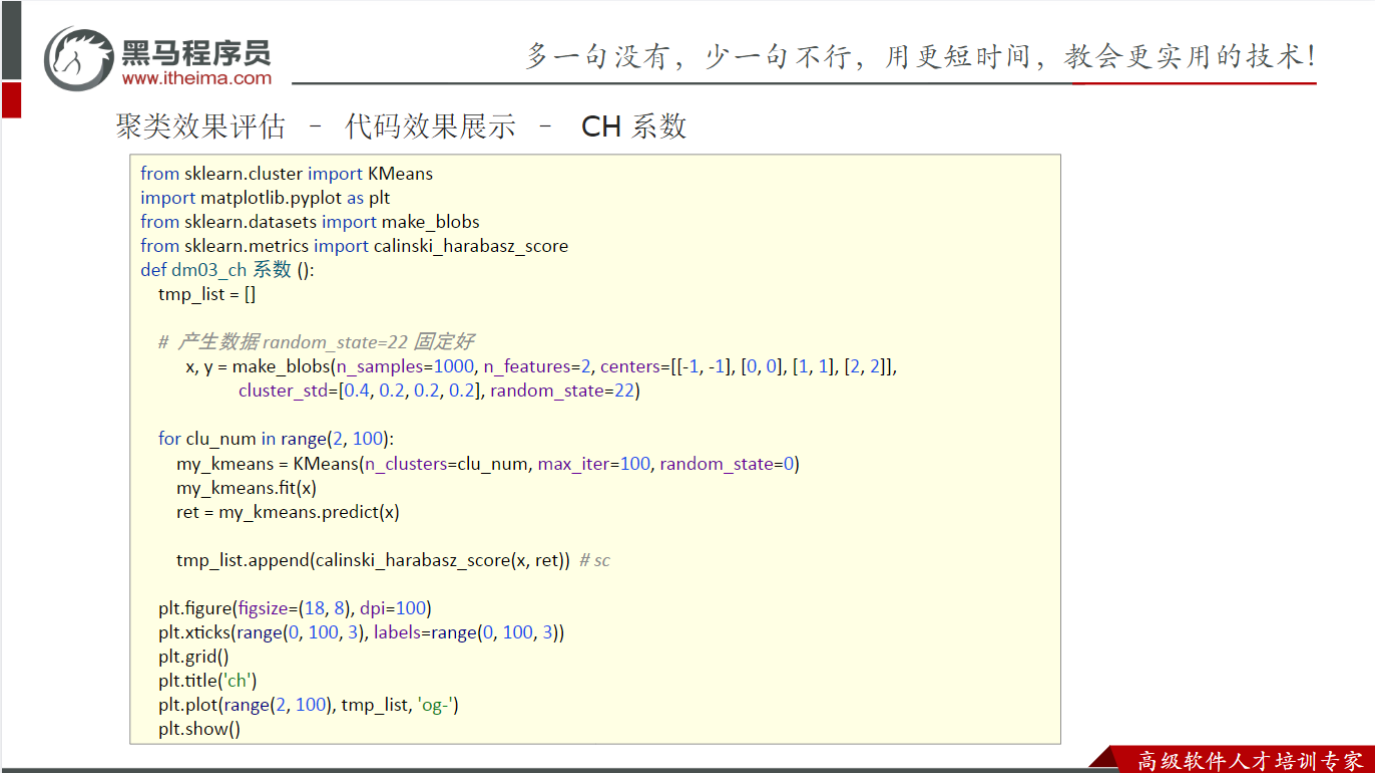
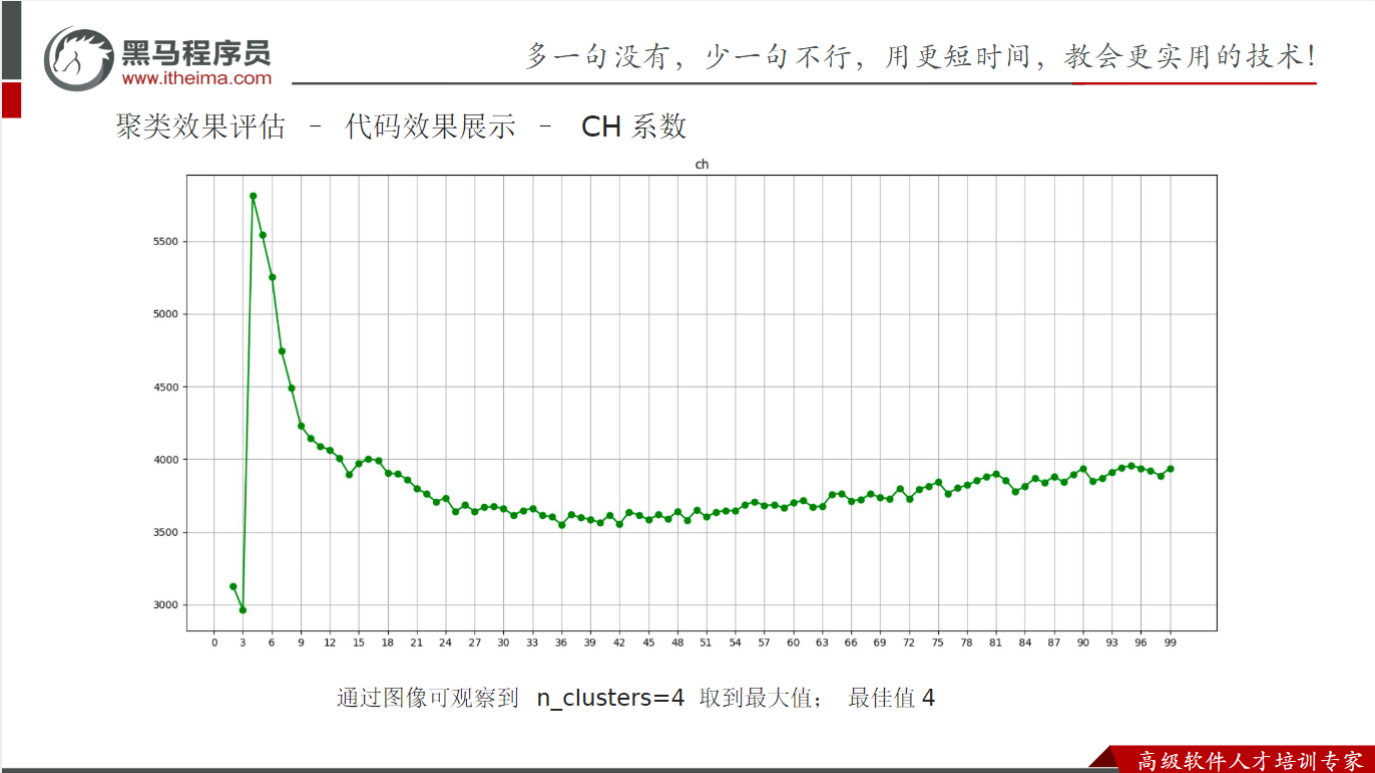
CH轮廓系数法
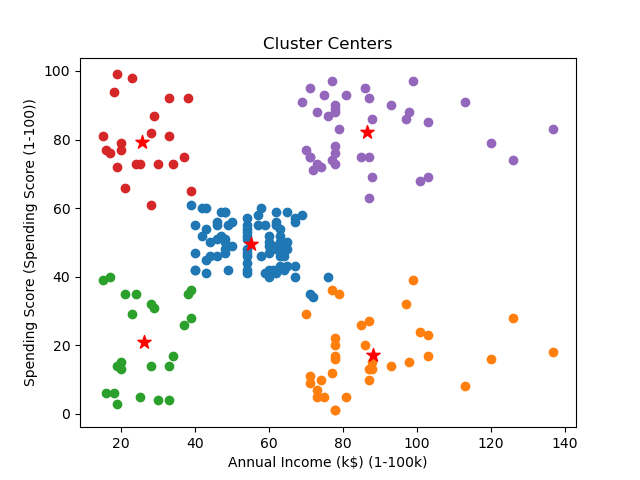
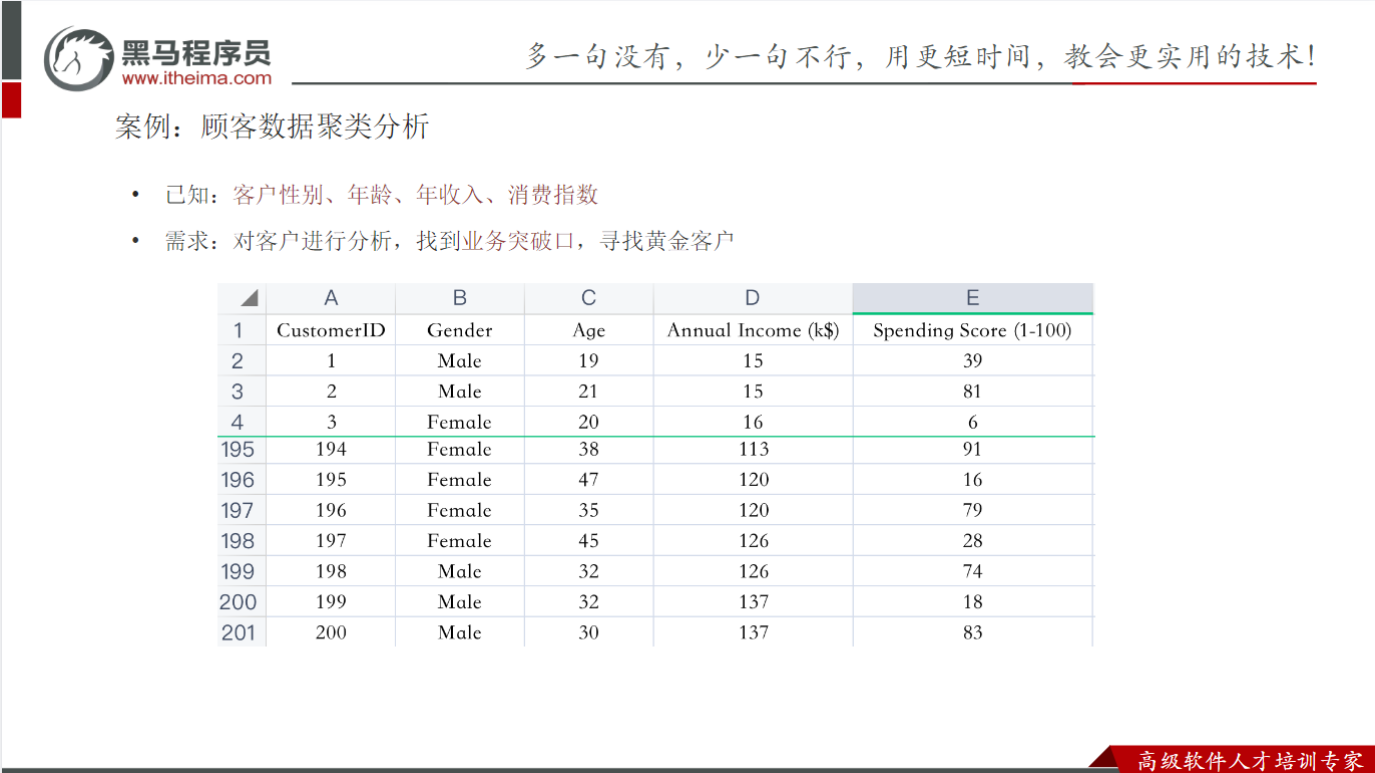
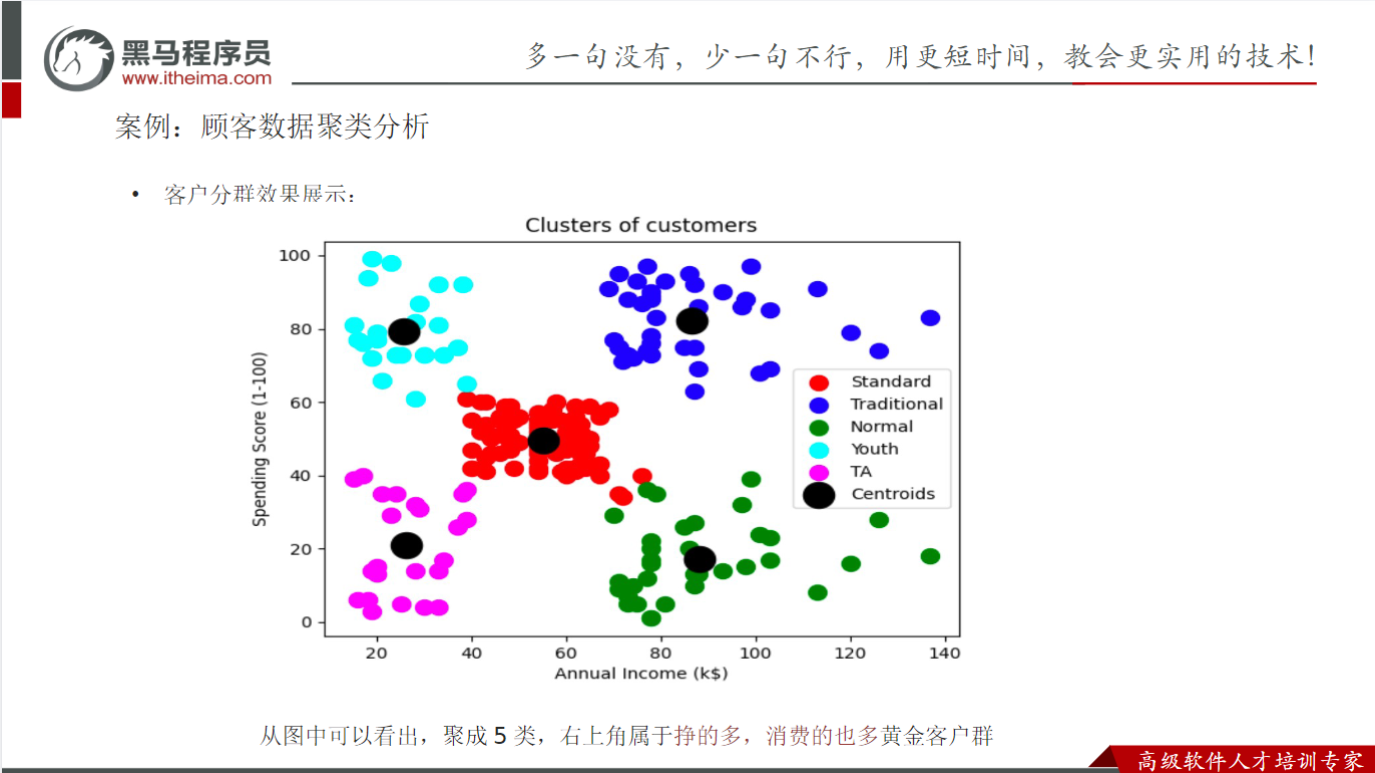
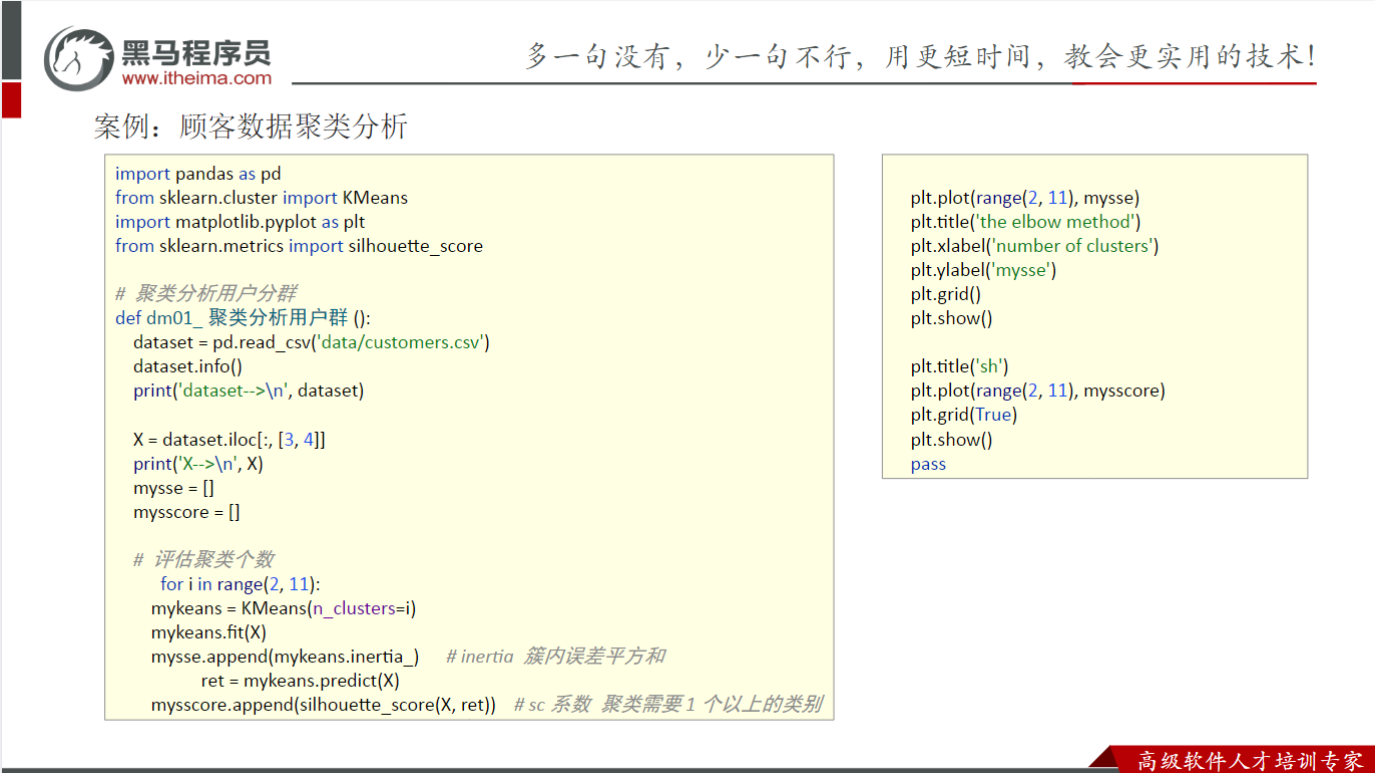
案例顾客数据聚类分析法
python
'''
案例:基于用户的年收入和消费指数,根据用户的相似性进行聚类
'''
import os
os.environ["LOKY_MAX_CPU_COUNT"] = "4"
import warnings
warnings.filterwarnings("ignore")
os.environ['TF_CPP_MIN_LOG_LEVEL'] = '4'#OpenMP多任务程序,这里设置为4个线程,防止出现线程冲突等
#导包
from sklearn.cluster import KMeans
import pandas as pd
import matplotlib.pyplot as plt
from sklearn.datasets import make_blobs
from sklearn.metrics import calinski_harabasz_score, silhouette_score
#1.定义函数,找聚类的质心数(K值)
def dm01_find_k():
    #1.加载数据集
    df=pd.read_csv("./datas/customers.csv")
    #2.定义sse_list,sc_list,记录不同K值的评估效果
    sse_list=[]
    sc_list=[]
    #抽取特征
    x=df.iloc[:,3:5]
    #3.定义for训练,测试不同K值的评估效果
    for k in range(2,20):
        #3.1创建KMeans模型
        estimator=KMeans(n_clusters=k,random_state=23)
        #3.2训练模型
        estimator.fit(x)
        #模型预测
        y_pred=estimator.predict(x)
        #3.3获取模型的评估效果
        sse_value=estimator.inertia_
        sc_value=silhouette_score(x,y_pred)
        #3.4将每个K值对应的评估效果,添加到sse_list,sc_list列表中
        sse_list.append(sse_value)
        sc_list.append(sc_value)
    #4.绘制sse_list,sc_list的折线图
    plt.figure(figsize=(20,10))
    plt.plot(range(2,20),sse_list,label="sse")
    plt.show()
    plt.figure(figsize=(20, 10))
    plt.plot(range(2,20),sc_list,label="sc")
    plt.show()
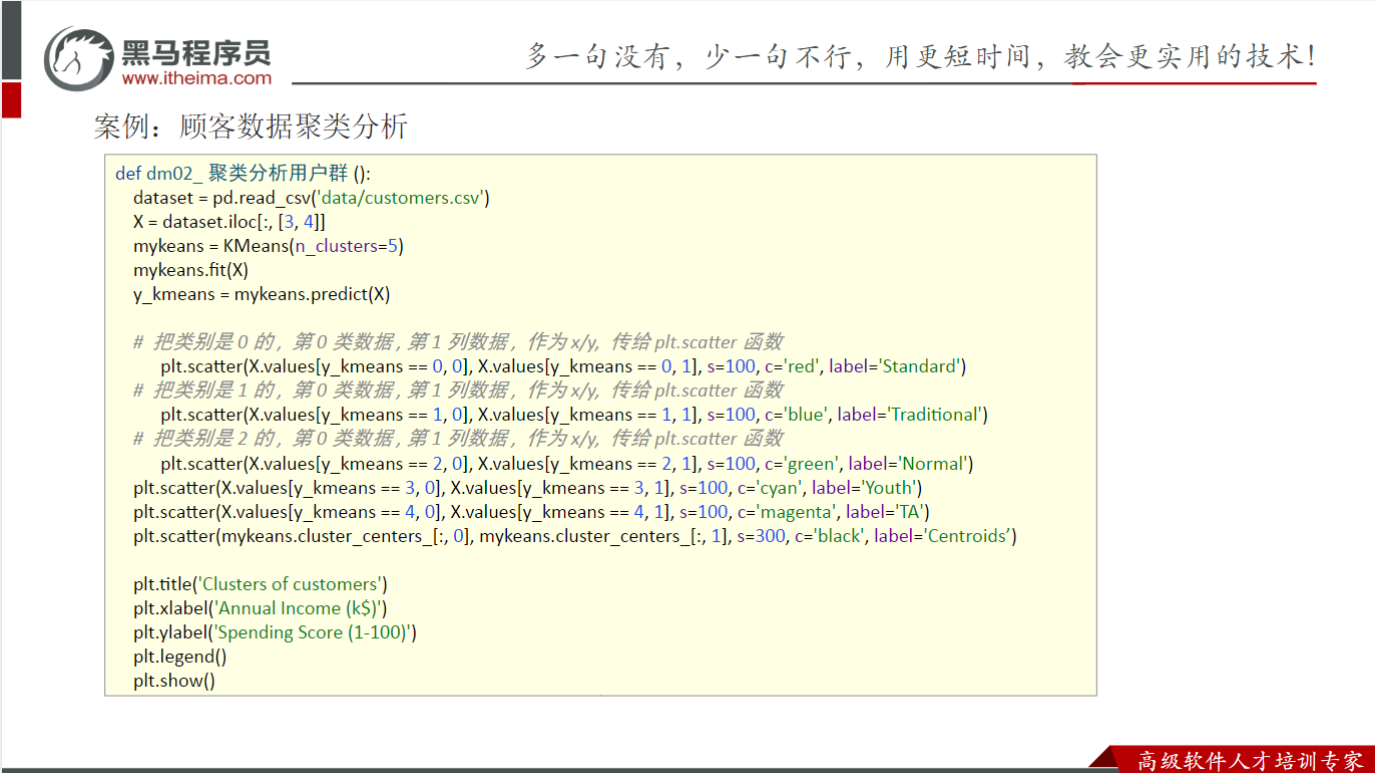
#2.定义函数,实现:模型训练,模型预测
def dm02_train_predict():
    #1.加载数据集
    df=pd.read_csv("./datas/customers.csv")
    #2.抽取特征
    x=df.iloc[:,3:5]
    #3.模型训练,k=5是刚才通过SSE+肘部法,SC轮廓系数 获取出来的
    estimator=KMeans(n_clusters=5,max_iter=100,random_state=23)
    estimator.fit(x)
    #4.模型预测
    y_pred=estimator.predict(x)
    #5.绘制5个簇的样本点->散点图
    plt.scatter(x.values[y_pred==0,0],x.values[y_pred==0,1])#簇0
    plt.scatter(x.values[y_pred==1,0],x.values[y_pred==1,1])#簇1
    plt.scatter(x.values[y_pred==2,0],x.values[y_pred==2,1])#簇2
    plt.scatter(x.values[y_pred==3,0],x.values[y_pred==3,1])#簇3
    plt.scatter(x.values[y_pred==4,0],x.values[y_pred==4,1])#簇4
    #6.绘制质心->散点图
    plt.scatter(estimator.cluster_centers_[:,0],estimator.cluster_centers_[:,1],s=100,c="red",marker="*")#质心
    #7.设置坐标轴标签,标题
    plt.xlabel("Annual Income (k$) (1-100k)")
    plt.ylabel("Spending Score (Spending Score (1-100))")
    plt.title("Cluster Centers")
    # plt.legend(["簇0","簇1","簇2","簇3","簇4","质心"])
    plt.show()
#测试
if __name__ == '__main__':
    # dm01_find_k()
    dm02_train_predict()