大家好,我是 HLAIA 光子。
最近在给我的项目 OpenMMV 做 RAG 检索优化,其中很重要的一环是 Chunks 切分优化。之所以要优化,其一是因为服务器性能实在不好,有两台服务器是我在闲鱼上淘的七八年前退役、淘汰的硬件组成的,也就比 E3、E5之流强一点;内存、存储更是丐中之丐了。优化之后,服务器性能压力会少一些。其二就是烧钱的问题,本文主角之一"父子切割"策略,实测下来是烧钱大户,优化了之后成本可以降低 86%。 对你没听错,降低 86%
父子切割
我饱览 RAG chunks 切分八股时 看到过父子切割方案,
父子切割就是,将原文切分为较大的"父块"和较小的"子块"。子块用于向量化和检索,以提高匹配的精准度;父块则作为实际召回内容,为模型提供更完整的上下文。
当用户问题命中某个子块时,系统不只返回这一小段内容,而是关联召回它所属的父块。这样既能避免文本切分过大导致检索粒度粗、噪声多,也能防止切分过小造成上下文缺失,在检索准确率和回答完整性之间取得更好的平衡。
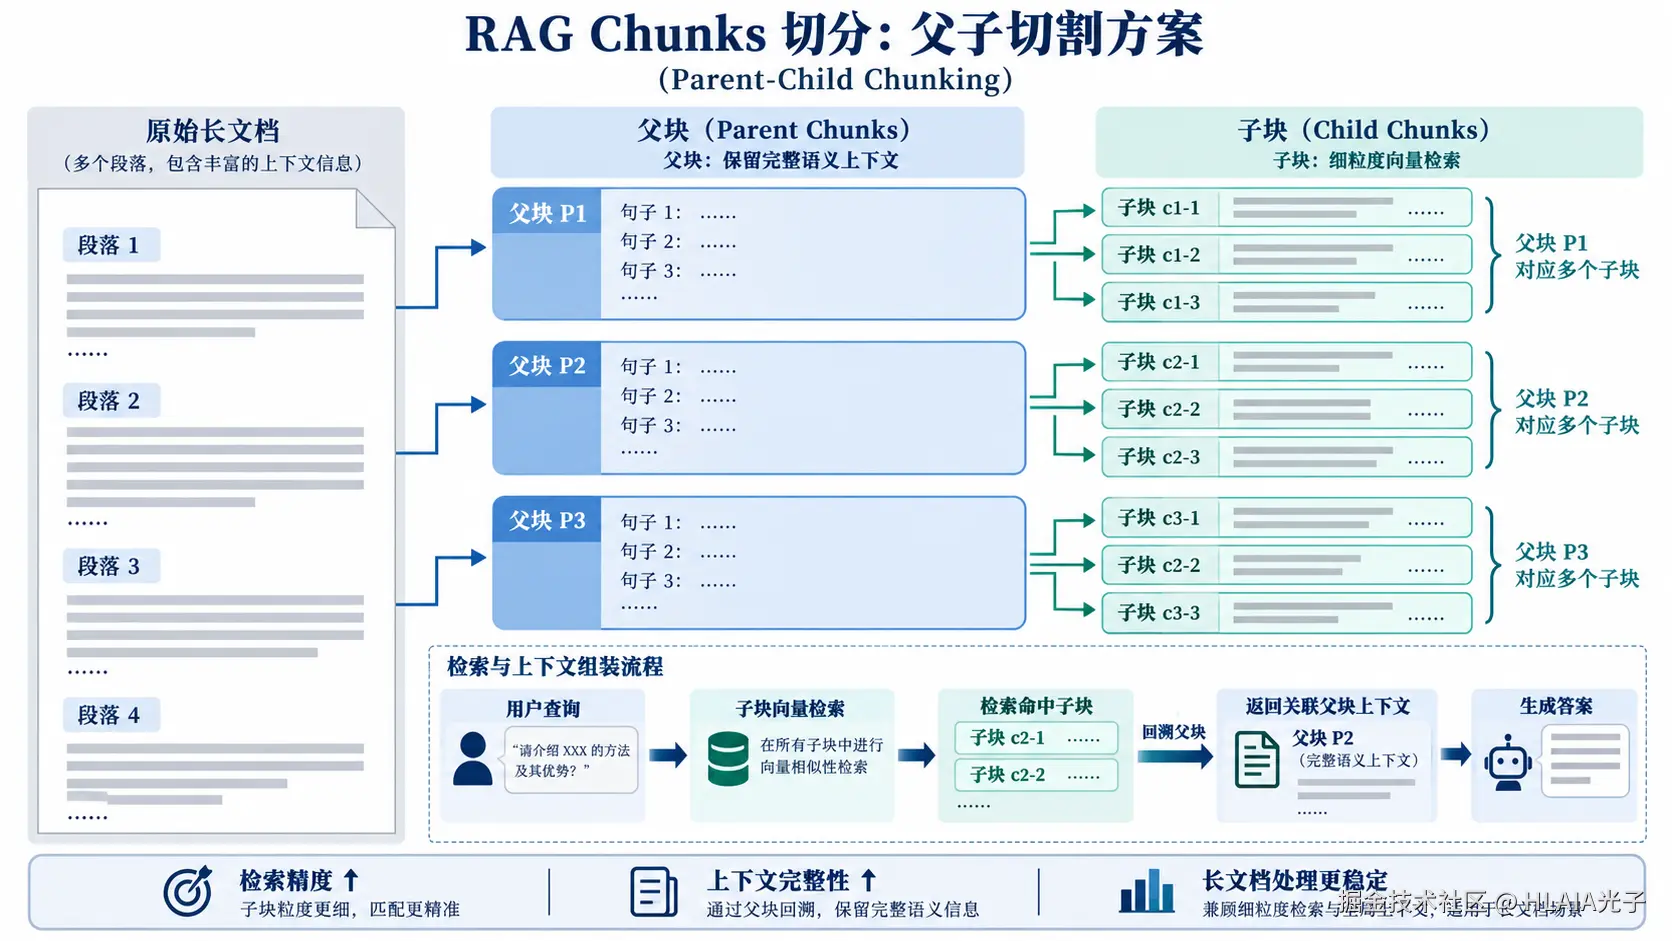
总结起来就是,小块负责被检索、定位大块;大块被小块定位后,就返回原文内容。
当初我看到这个方案的时候,一眼相中,觉得这个是个很妙的 chunks 切分方案。于是乎我在 OpenMMV 里采用了父子切割,用来做历年数学建模国赛的赛题、优秀论文的 RAG 检索。
结构感知分块
结构感知分块根据文档的结构拆分 chunks,是工程中挺常见的一种拆分方案。
比如 PDF 的结构提取,就是利用文字位置、字号、行距和标题编号,识别页内标题与段落,再合并同一标题下的短段。数学建模论文是有格式要求的,所以可以根据一个 pdf 文档里字体大小、行距等推断出它是标题还是正文。
边界重叠,如果你查过 RAG 检索优化的话,应该知道这个策略。如果你不清楚 可以看这段定义:
"边界重叠"是指相邻文本块之间保留一定数量的重叠内容,使前一块结尾与后一块开头共享部分上下文。这样可以减少关键信息因切分而被割裂,提升检索结果的上下文完整性与召回效果。
OpenMMV 在同一结构段的相邻块保留 80 字符的重叠。
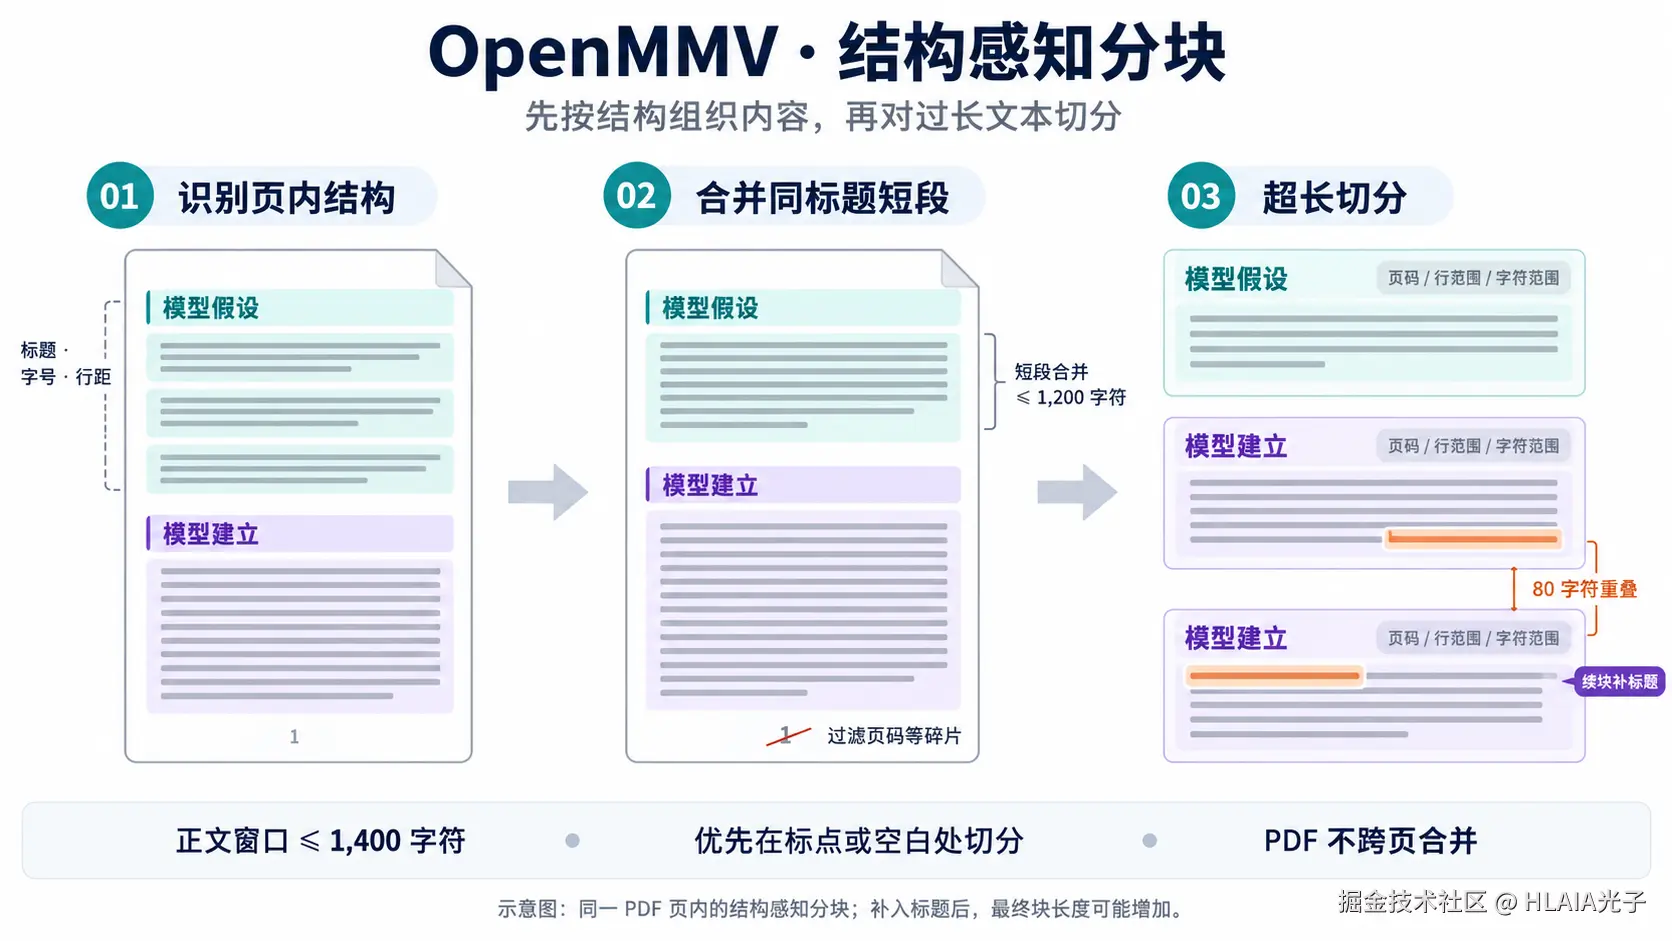
DOCX 文档的结构提取,通过识别 Heading、Title、标题 这些段落样式,把标题与后续正文组织在一起。
PPTX 幻灯片的结构提取,以单张幻灯片为边界,合并连续文本形状。遇到表格就单独提取,遇到其他形状会结束当前文本组。
至于数据表 CSV,XLSX,目前不进入向量检索流程,这是工程上的一个权衡。主要因为数学建模赛题所给出的数据表,有许多都是上万行,甚至百万行级别的,拆散了喂给 Embedding 模型没有意义,数据量大所以特别烧钱。索性我就不让数据表进行语义搜索了。
像 TXT、Markdown 这类纯文本编码的文档,有明确的格式,特别好拆分,以空行、#、## 来分边界。
拆分方案的核心就是先根据文档结构组织内容,再用长度限制处理过长的部分,让一个检索块尽量带有足够的上下文。
Benchmark 测试
为了方案选型,从父子切割和结构感知分块中择优,我特意设置了一个专门为 OpenMMV 设计的 Benchmark,也为用户开放了一个查看 Benchmark 测试结果的页面。
Benchmark 的设置如下:
我从 2016 --- 2025 历年的国赛赛题和优秀论文里,选出 30 份文档原件,其中 20 份是答案来源,另外 10 份用于干扰。
首轮为 Normal 难度,设置了 24 题,其中 12 题测试检索和读取、另 12 题测试生成回答的能力。
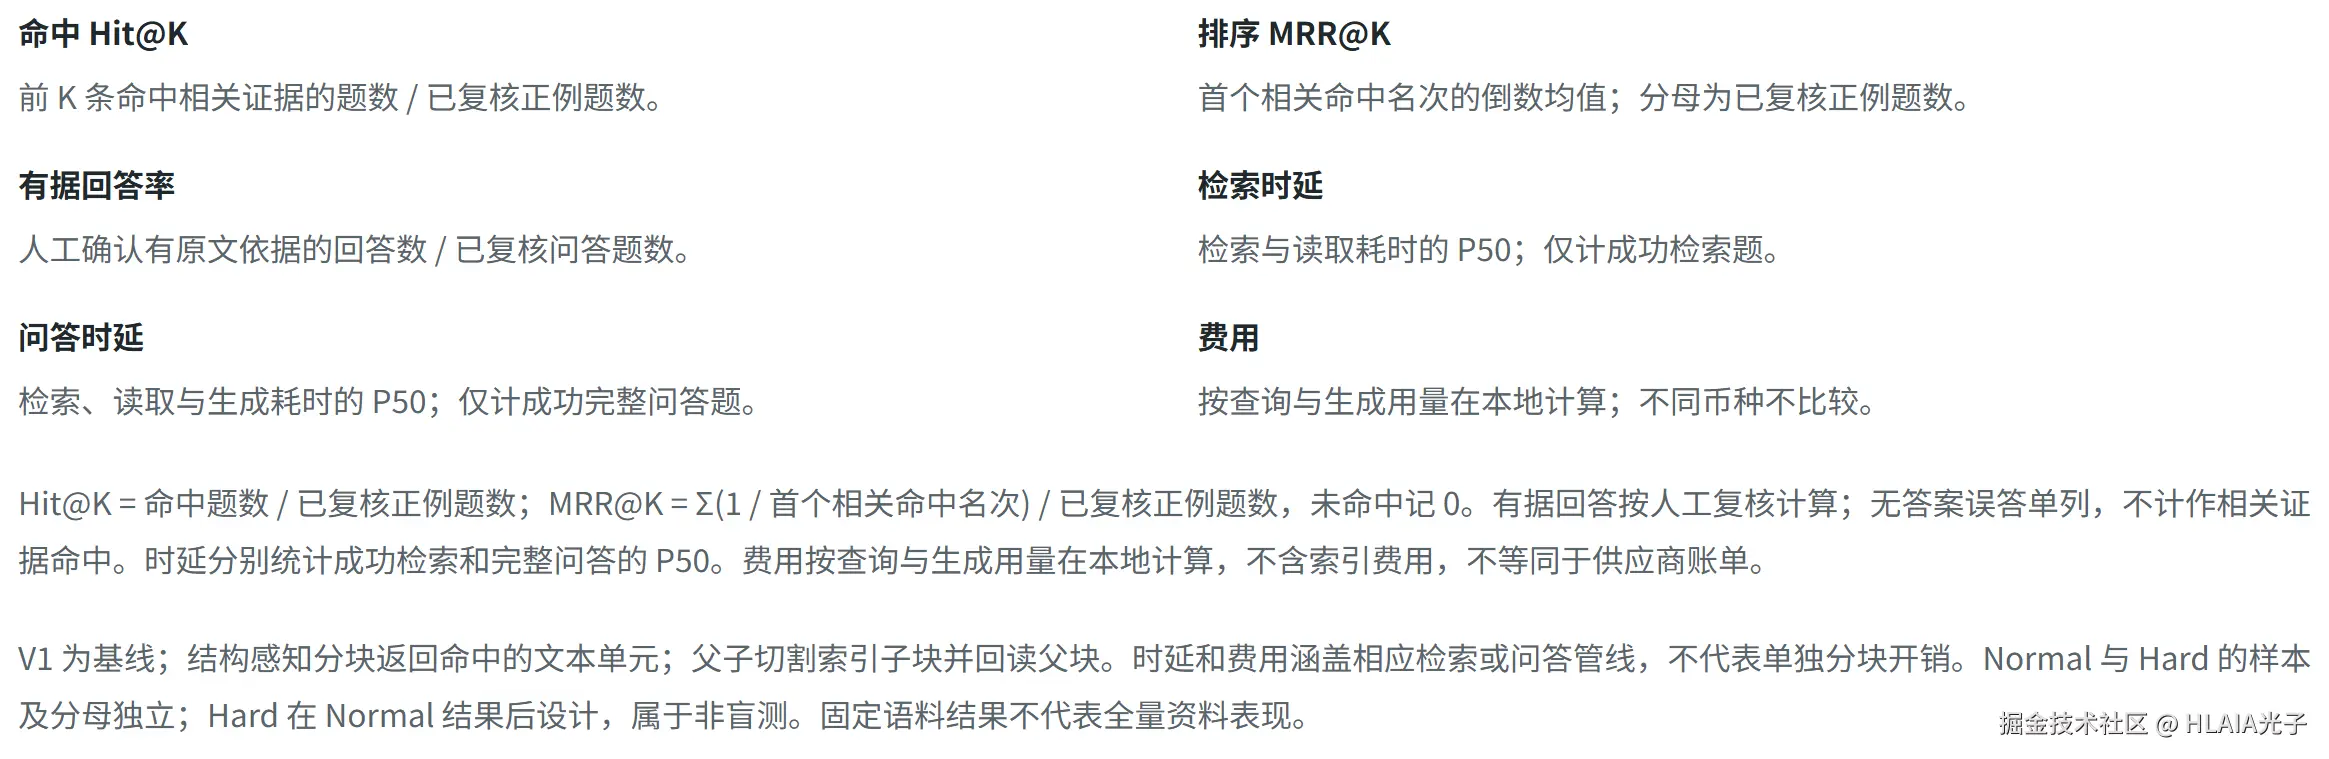
评测 6 个维度:Hit@K、MRR@K、有据回答率、检索时延 P50、问答时延 P50、费用。相关解释如下:
有 3 个方案参与比较,除了父子切割、结构感知分块外,还有个 V1 细粒度分块,chunks 分的很细。比较结果如下图:
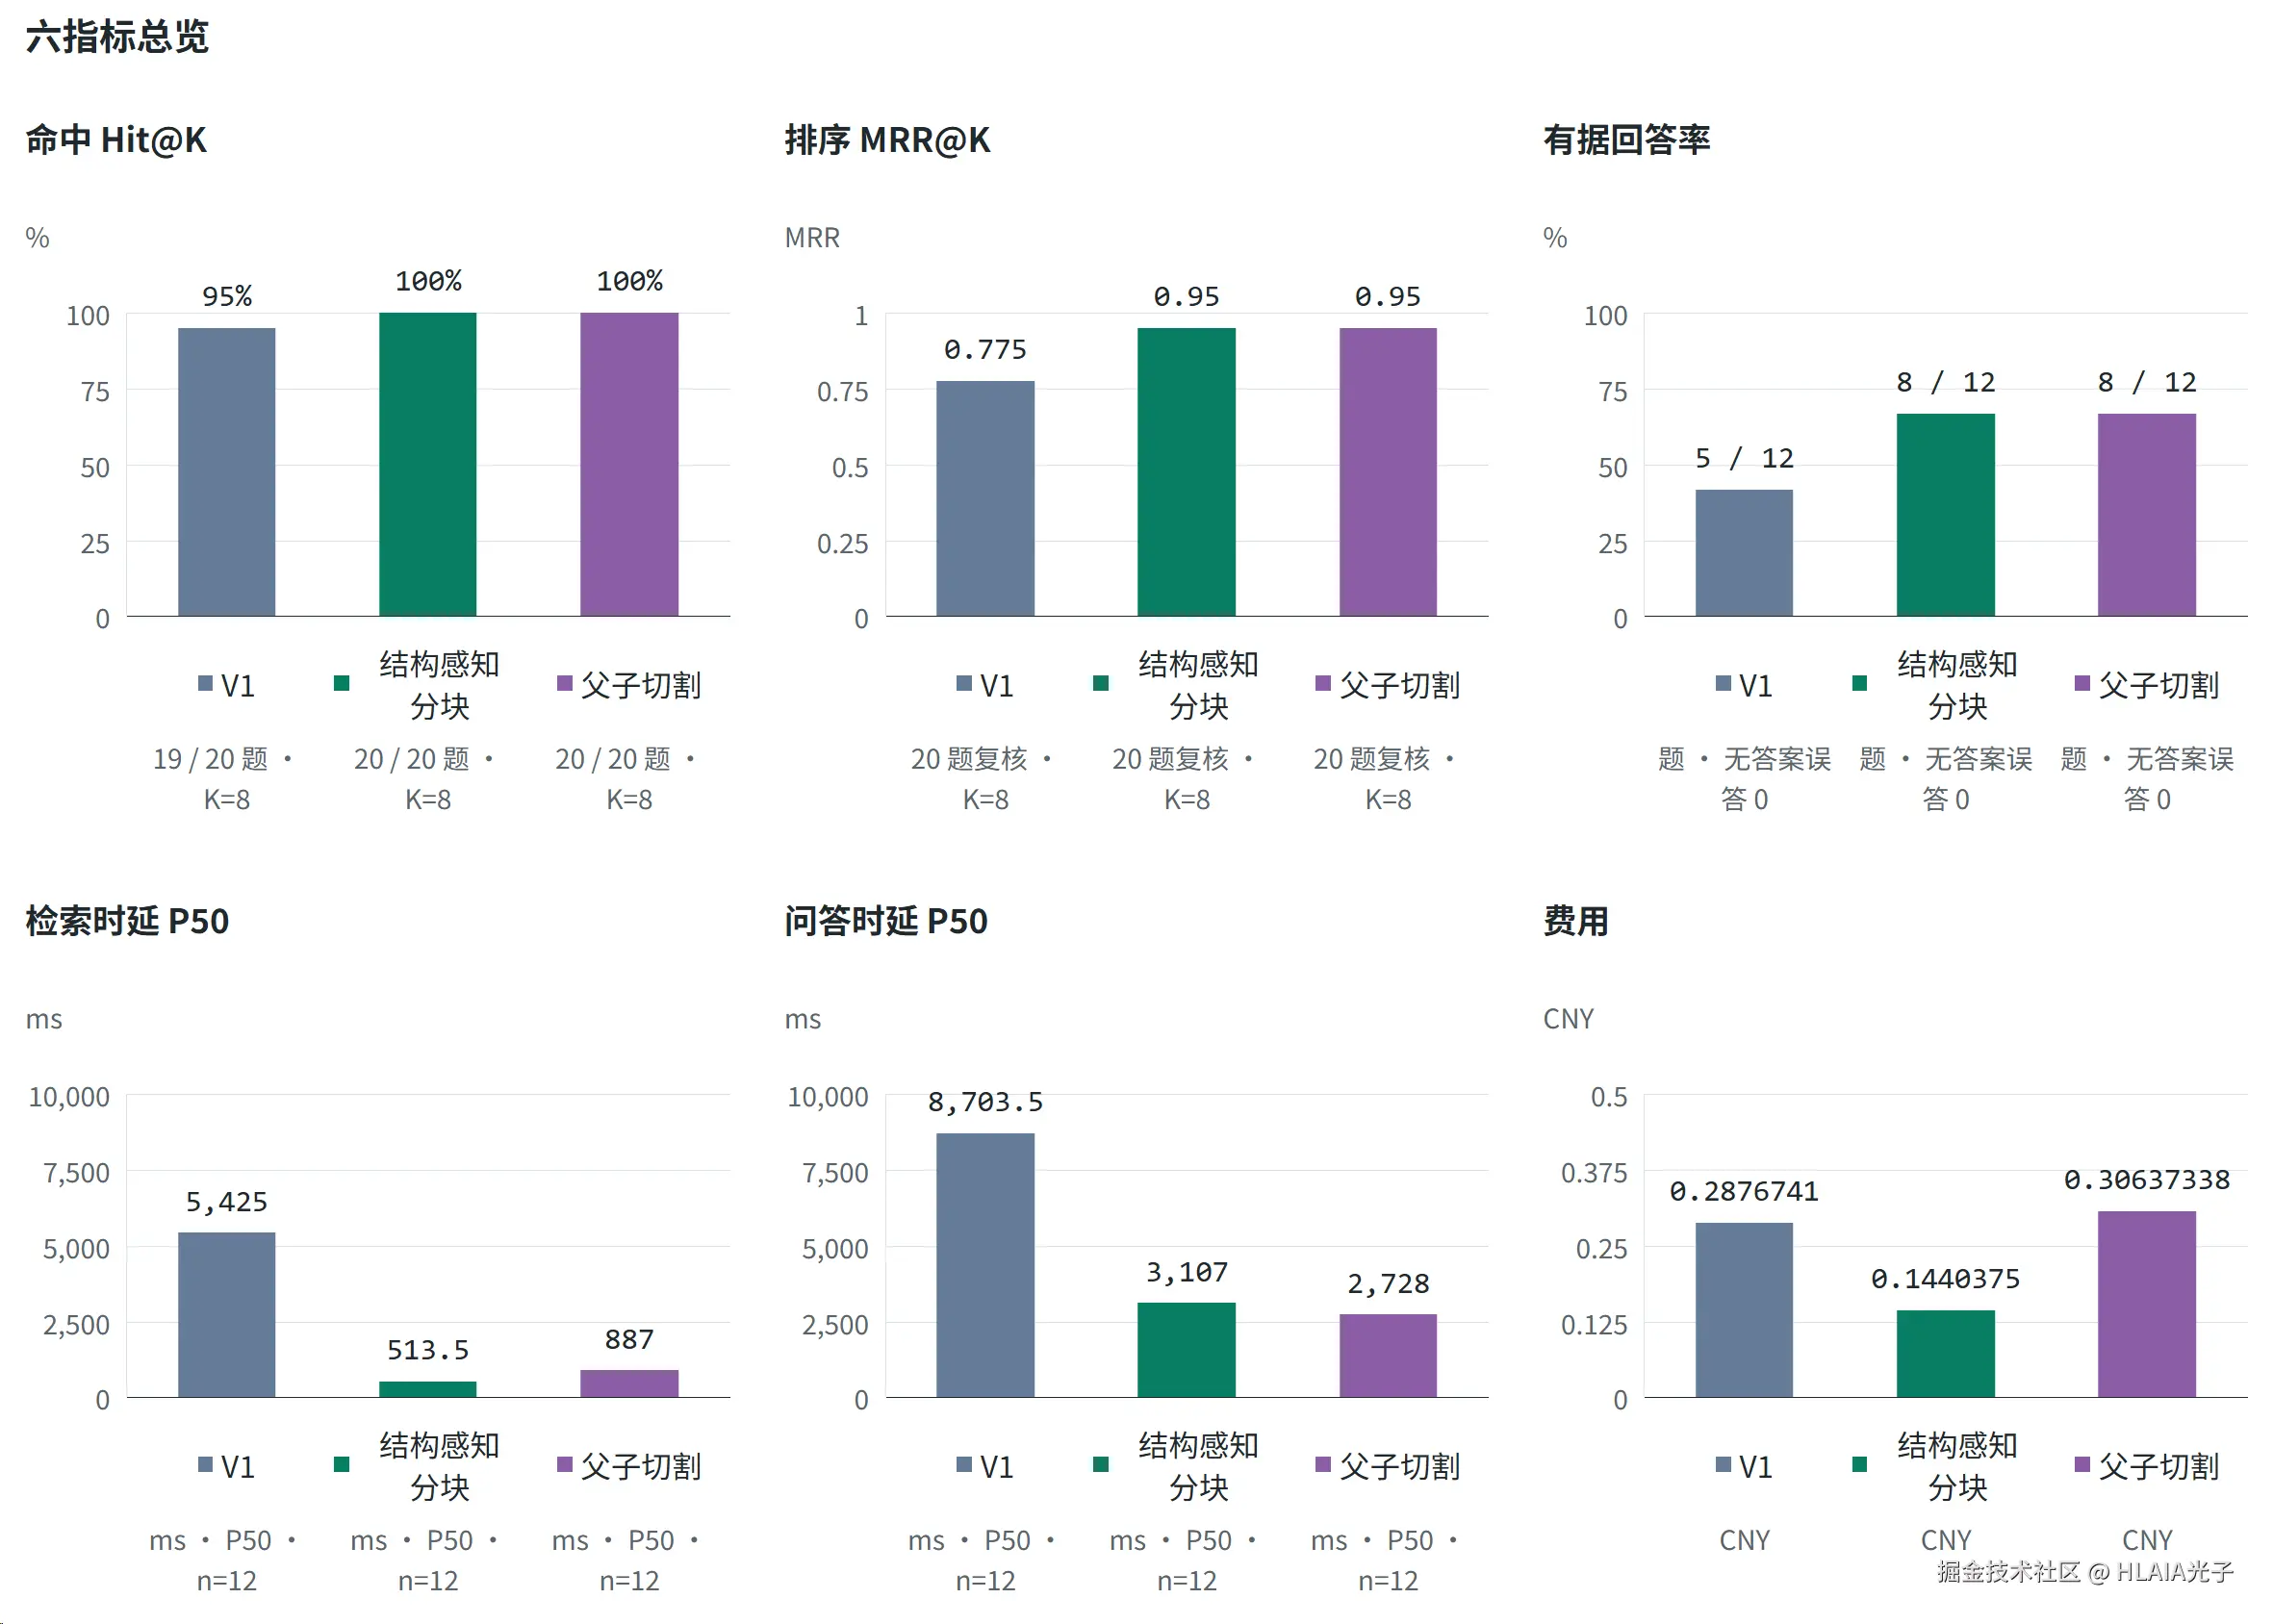
这里 V1 被完爆了,毕竟 V1 chunks拆分的太细,明显不行。父子切割和结构感知分块在检索效果上没有区分出来,但是成本这一点,父子切割要高出结构感知分块 1 倍多。
然后第二轮是 Hard 难度,设置 8 道题,比上一轮难得多。
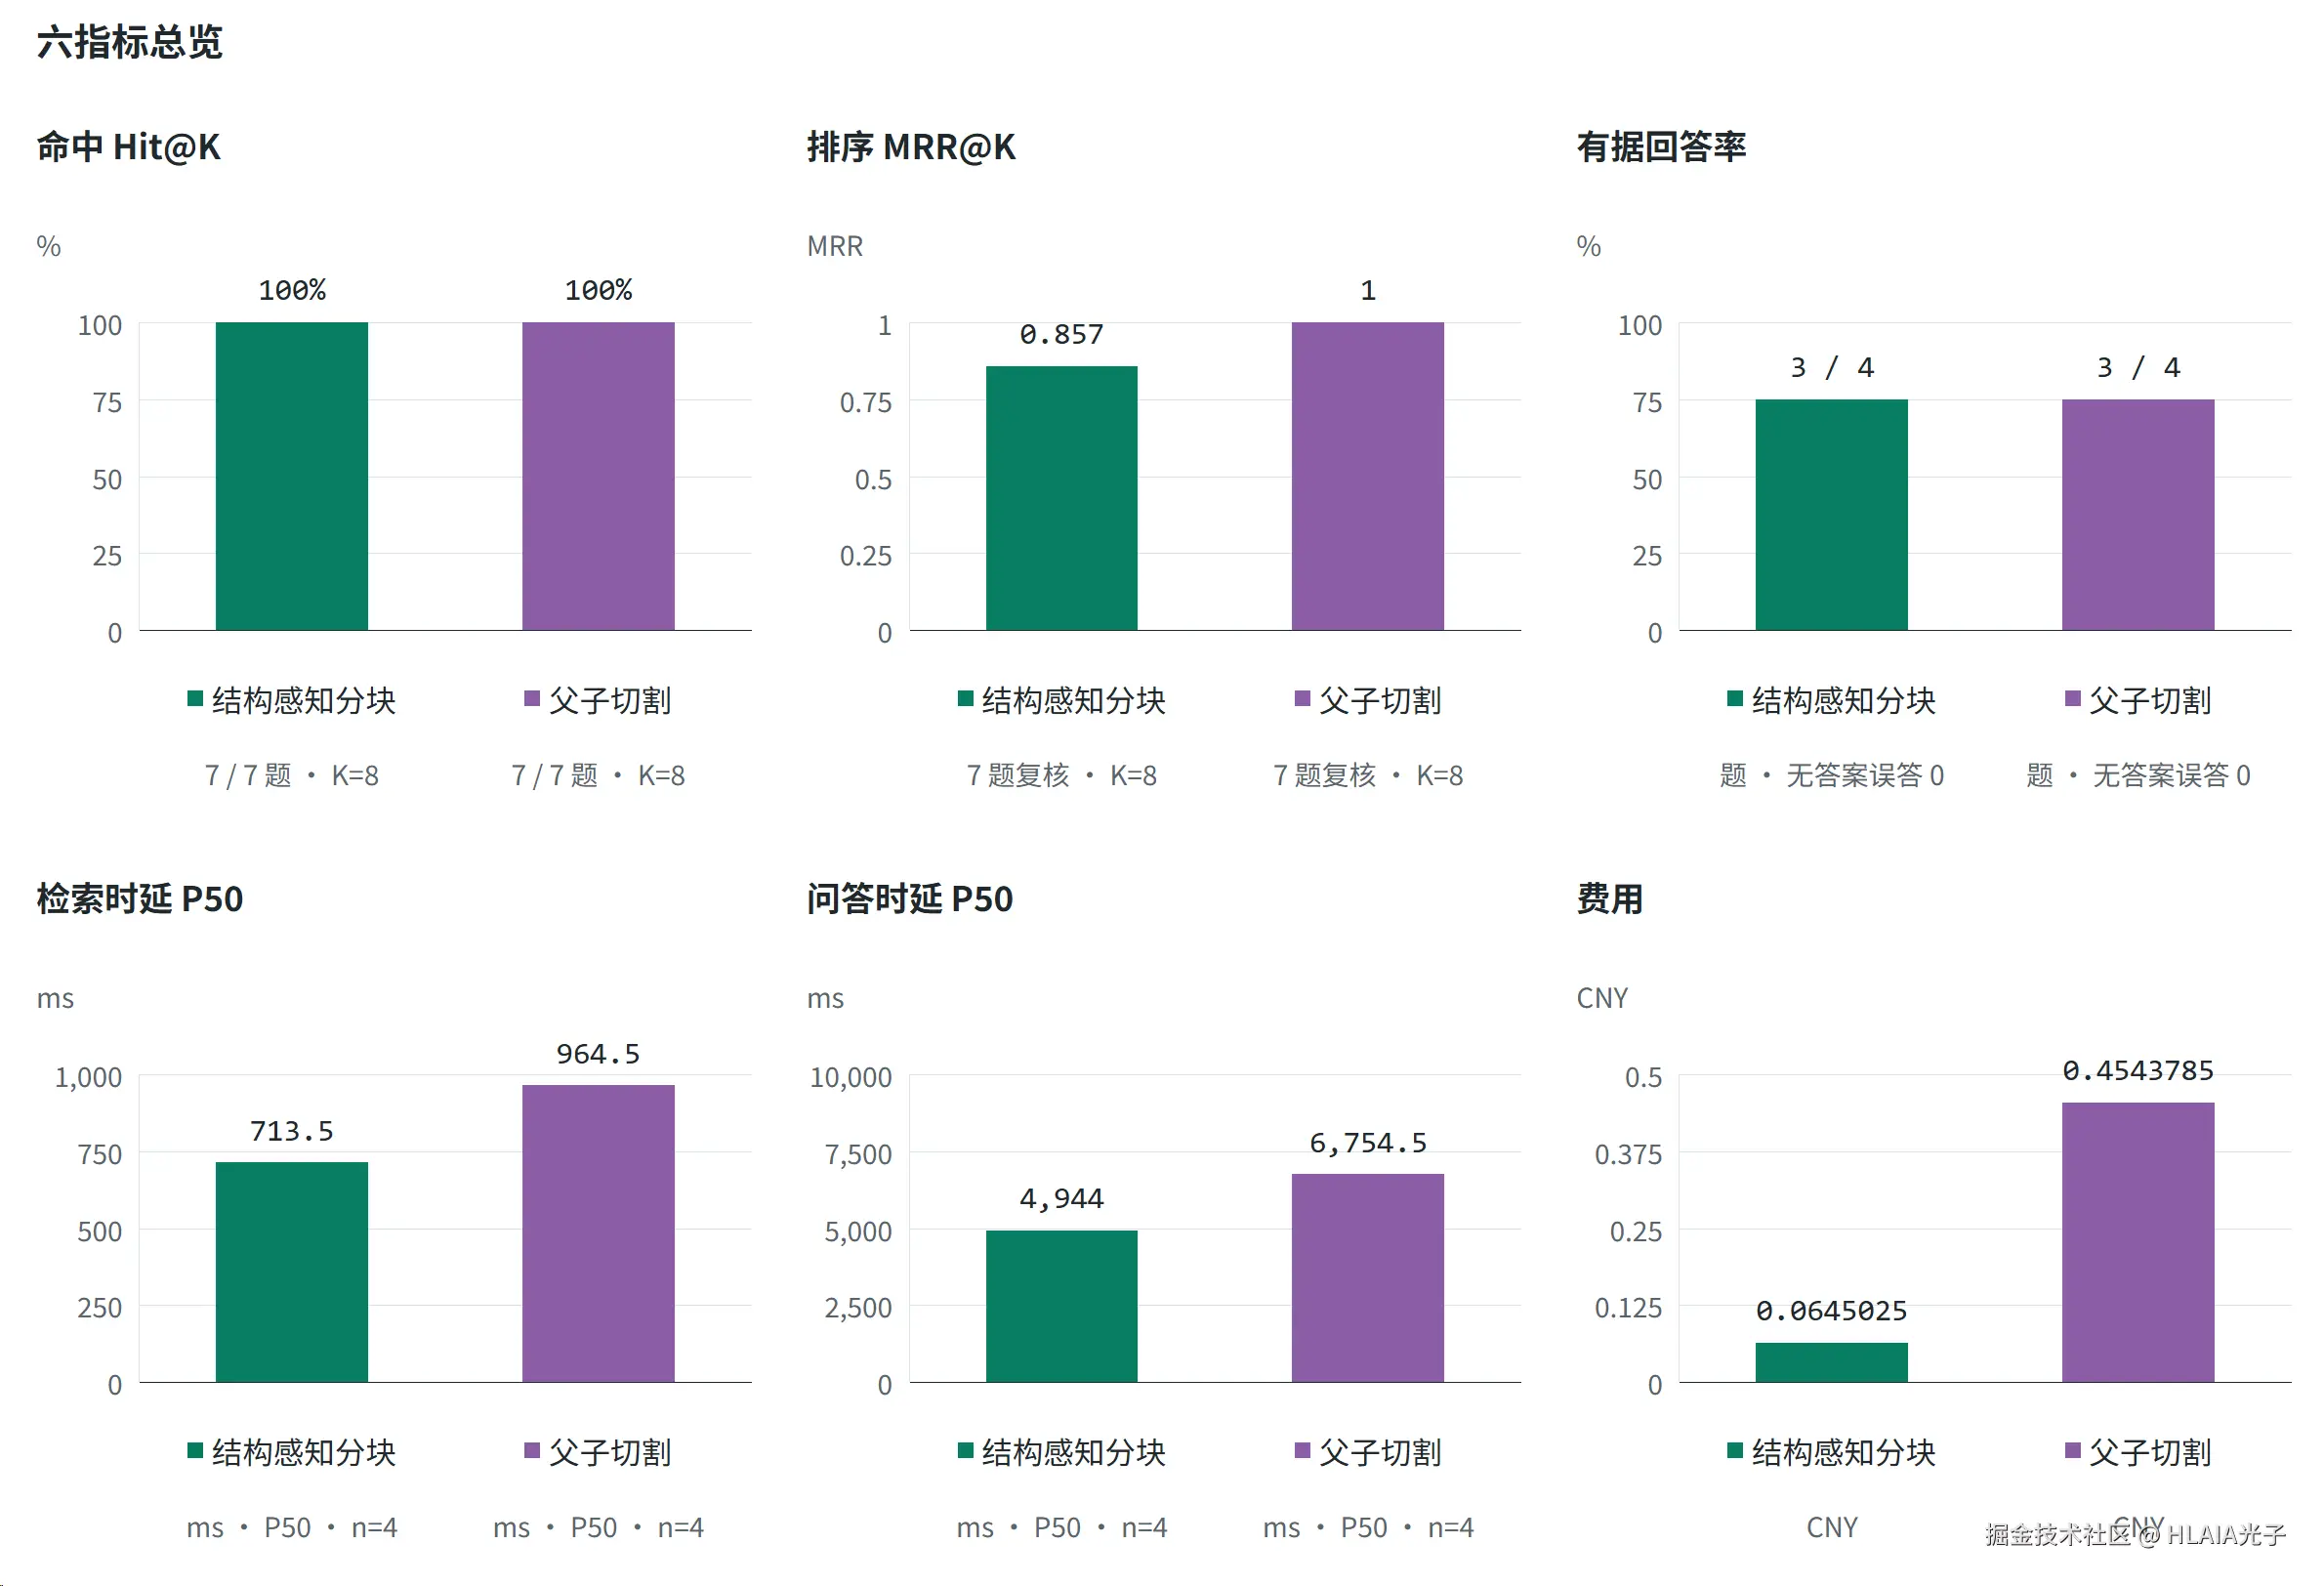
Hard 集就区分出结构感知分块和父子切割的检索水平了,在 父子切割的 MRR@K 上,7道题都把正确答案排在第一位,而结构感知分块有道题把正确答案排在了第二位。所以检索效果上父子切割的确更优一些。
那为什么我最后还是选择了结构感知分块呢,因为 成本---性能 得综合看。结构感知分块只在高难测试题集的 MRR@K这一项指标上,稍微劣父子切割一点点;况且在稍劣的那道题上,它将正确答案排在第二位,并没有那么不堪。
最关键的来了,结构感知分块的整体时延都明显低于父子切割,而成本甚至只有父子切割的 14% !
那傻子都知道该选结构感知分块啊。
写在最后
起初我看好父子切割,这套方案是我在看八股时令我眼前一量的,算法流程头头是道,方案名称鹤立鸡群。但是实际测试的结果却指向结构感知分块,20% 的成本达到 98% 的效果,这才是更适合 OpenMMV 的。
我觉得找老婆也是同样的道理吧,那些你一眼看上的美人,不一定适合和你成家;实际搭伙过、不要那么多钱的,才是懂你的贤惠老婆。
所以 RAG 分块分案的选取,不是去网上查一些方案就能一锤定音的,我的建议是根据项目业务知识库的内容,去做一个benchmark,然后把候选方案都做一遍实际测试,根据测试结果来选取最合适的方案。
点点关注点点赞~ 蟹蟹~