💡 一句话总结:失败经验是「条件性知识」------不失败的时候看攻略只会分心。Sentry 把失败教训存在 agent 上下文之外,只在诊断到失败时才取出来用,且只有验证恢复成功才收录新经验,四个基准平均领先最强基线 37%。
导语:你调 agent 时最怕的那一幕
先问一个可能戳到你的问题:你的 agent 跑到第 40 步,搜索连续返回空结果,它开始原地重复同一个查询------这时候谁来救它?
调过 agent 的人对这种场景都不陌生:无效的工具调用、停不下来的死循环、推理和观察完全脱节。任务越长,中途失败越是家常便饭,真正决定成败的往往不是「每一步都对」,而是「错了之后能不能爬起来」。
社区里现有两条路。一条是上下文演进:Reflexion、ACE 这些方法把历史轨迹提炼成经验教训,下次任务开始前塞进上下文。另一条是运行时干预:AgentGuard、Wink 这些监视器盯着轨迹,发现异常就喊一嗓子。前者能学但不管时机,后者管时机但不学习------各对一半。
这篇 arXiv 2610.02994 的论文(Sentry)从一组对照实验出发,把这个僵局捅破了:失败经验常驻上下文,本身就是有害的。他们甚至发现,把 ACE 学到的失败教训从经验库里删掉,agent 成绩不降反升。听起来离谱,但数据就是这么写的。
想自己动手试?
- 📄 论文:arXiv 2610.02994
- 📖 HTML 全文:arxiv.org/html/2610.0...
这篇论文到底想解决什么问题?
论文的问题意识从一个具体的失败案例开始。ACE 在任务 6594 里学到了三条恢复规则------「结果不好就扩查询」「第一页没匹配就翻下一页」「结果还是不相关就精炼查询」------这些规则本身没毛病,被存进经验库,下个任务开始前注入上下文。
到了任务 4494,agent 搜「20 英寸 80 美元以下的假发」,第一条结果完美匹配。按剧本它该下单了。但那三条恢复规则还在上下文里飘着,于是 agent 决定「让我也看看第二、第三、第四条,确保没有更好的」------比较来比较去,一步没走,reward 为 0。
为什么会这样?因为「什么时候该扩查询」这类知识是条件性知识:它只在特定失败正在发生时才有用。常驻上下文的后果是 agent 每一步都要判断「这条经验现在适不适用」,而它经常判断错。实验数字更扎心:从 ACE 的经验库删掉失败教训,WebShop 奖励从 0.335 涨到 0.391,Mind2Web Replay 从 0.562 涨到 0.643------都是 held-out 任务上的成绩。
那运行时干预呢?论文也补了一刀:不管三七二十一就介入,WebShop 奖励掉到 0.136,比裸跑的 0.170 还低。图 1 把两条路线的翻车现场并排放在一起看。
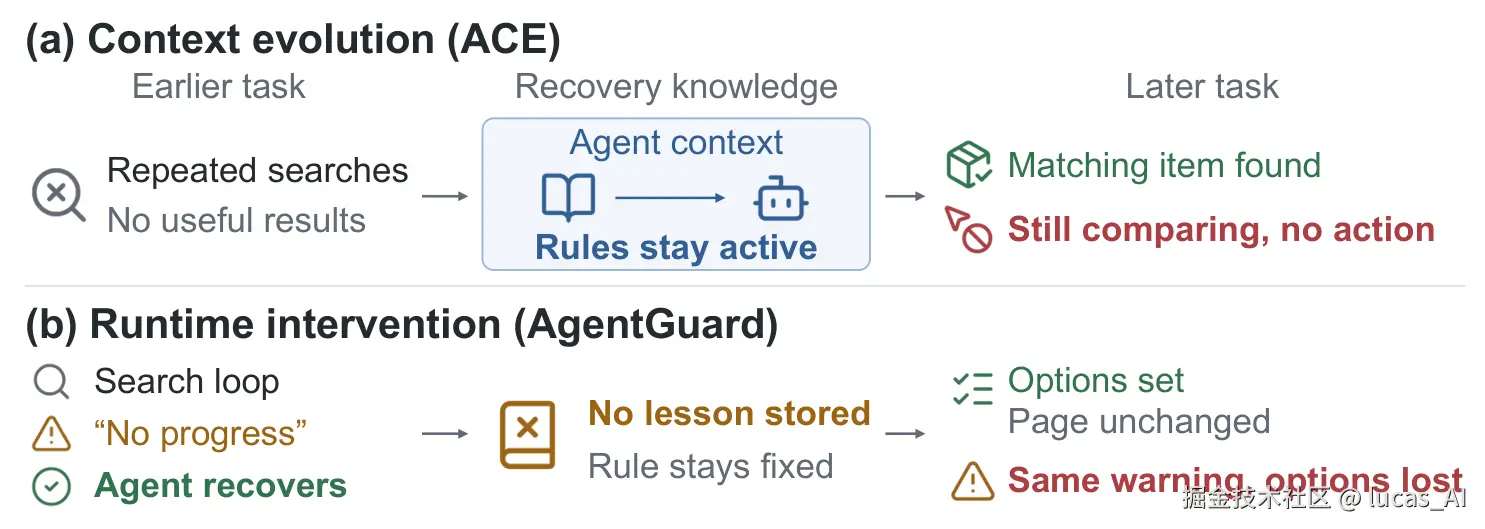
图说:左 (a) ACE 的恢复规则常驻上下文,agent 找到完美匹配后仍迟迟不下单;右 (b) AgentGuard 的「页面无变化就警告」在搜索死循环时救了场,但教训没存下来,下个任务同一警告在正常选完选项后误触发,agent 弃页面而去。
于是论文把问题收敛成一句话:失败知识是条件性知识,应该被条件性地暴露------该学的时候学(像上下文演进那样跨任务积累),该露面的时候才露面(像运行时干预那样只在失败时介入)。
它的思路是什么?
Sentry 的答案可以浓缩成三条规矩,每条都对着上面一个坑:
- 🎓 该学就学:失败经验跨任务积累,越攒越厚------这是从上下文演进那边借来的。
- ⏰ 该露才露:playbook 整体存在 agent 上下文之外(论文叫 isolation,隔离),只在诊断到匹配失败时才取最多 5 条进来------这是从运行时干预那边借来的。
- ✅ 验证才收录:一次修复要经过验证、确认失败真的解除了,这次的经验才准写进 playbook------这是 Sentry 自己加的把关,防止「从失败修复里学歪的经验」将来误伤。
整体怎么运转?看架构图,Sentry 是和任务 agent 并行的一层,每一步都瞄着 agent 的最近 5 个「推理-动作-观察」循环。
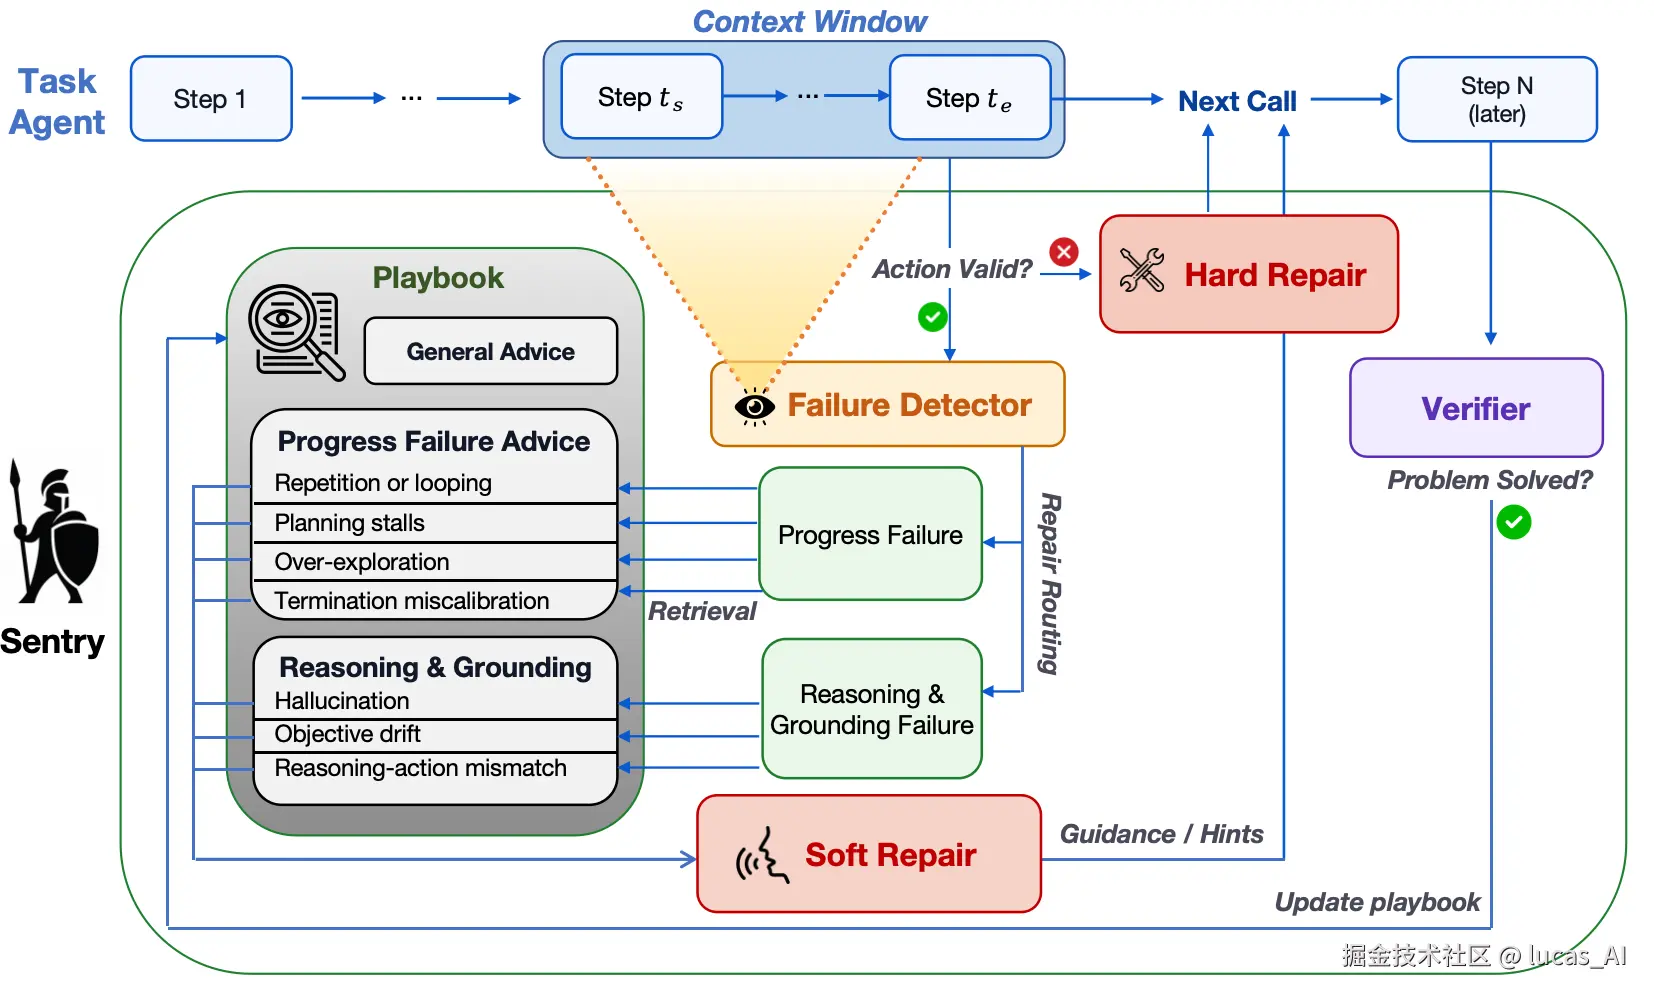
图说:左边是检测与路由,中间是两条修复通道,右边是经验库的验证准入。注意 playbook 始终在 agent 的持久上下文之外,每次干预只放行几条。
具体分两个通道。硬修复管无效动作:动作不符合环境要求的格式,Sentry 就把非法动作、相关轨迹和格式要求打包发给 agent,要求它只回一个修正动作------环境接受与否立见分晓,这条通道的验证是即时的、二值的。
软修复管行为层面的失败:重复动作、执行停滞、推理没有观察支撑、推理和动作对不上。检测到之后,Sentry 先生成一个诊断------失败类型、细粒度检索标签、局部证据------然后拿诊断去 playbook 里检索:先筛同失败类型的条目,再要求至少共享一个检索标签,按标签重叠度排序取前 5 条,拼进修复提示引导 agent 下一步。
这里有个值得注意的设计:playbook 为空的时候怎么办?软修复退化成只用通用修复指令,照样能干活;随着验证过的救场越攒越多,检索到的经验逐渐主导指导内容。冷启动不翻车,长大后不浪费------检索是有界的,经验库可以无限增长,但 agent 每次最多只见 5 条。
最后是准入闸门。硬修复的验证很朴素:修正动作被环境接受就算过。软修复的验证则需要一点耐心:Sentry 盯着后续 10 个循环,判断标准是「被诊断的那种失败模式停了,且 agent 恢复了基于观察的任务推进」。关键在于验证器刻意不看任务奖励------它只判断「那个失败解没解除」,不判断「任务做没做成」。这样验证器就不依赖环境的评价信号,换成你的生产环境也能用。
效果到底怎么样?
四个基准(WebShop 网购、AppWorld 有状态应用操作、SWE-bench Lite 真实仓库修 bug、Mind2Web Replay 网页操作回放),先看对运行时干预基线这组(Qwen3.5-9B,从空经验库在线积累):
| 方法 | WebShop 奖励 | AppWorld 通过率 | SWE-bench Lite | Mind2Web Replay |
|---|---|---|---|---|
| 裸 agent | 0.170 | 25.59% | 0.20 | 0.420 |
| 最强干预基线 | 0.264 | 27.56% | 0.24 | 0.687 |
| Sentry | 0.468 | 38.53% | 0.30 | 0.736 |
| 领先幅度 | +77.3% | +39.8% | +25.0% | +7.1% |
对上下文演进那组,重点看 ACE(held-out 协议:50 个任务初始化经验、50 个不相交任务考试):Sentry 0.495 对 ACE 0.335,领先 47.8%;Mind2Web Replay 上 0.729 对 0.562,领先 29.7%。更有意思的是 ACE + Sentry 组合------0.555 和 0.789,全场最佳。任务级知识和失败级知识是互补的,不是二选一。
再看重振士气的因果证据:200 个软修复干预点上做配对分叉实验,同一 agent 状态一边接受干预一边裸跑,局部恢复率从 33.5% 拉到 60.5%;200 对里 74 胜 101 平 25 负。人类标注员对 Sentry「该不该干预」的判断一致率 86.0%,对「恢复成功没」的一致率 81.8%------机器的自觉没那么玄,但确实和人的判断对得上。
消融实验里最值钱的一个组件有点意外:「要不要介入」的检查。把它去掉、变成有疑点就出手,平均掉 54.7%------比去掉软修复(-41.9%)还伤。选择性介入这个看起来朴素的开关,恰恰是价值最高的部分。这和导语里「无差别干预掉到 0.136」的观察完全对上了。
还有一组实验值得单独说:同一份冻结的经验库、同一套修复机制,唯一区别是要不要把完整 playbook 常驻 agent 的背景上下文。常驻版 WebShop 从 0.364 掉到 0.296。同一份知识,全量塞进去就掉分,失败触发检索就涨分------论文标题里那个原则,被这一组对照钉得死死的。
为什么你要关心?
如果你在做 agent 应用,这篇论文有三条可以直接搬走的东西。
- 别再把教训写进 system prompt 让它全程在场。很多团队的惯性做法是把踩过的坑总结成规则、塞进提示词或长期记忆。这篇论文的证据说明:这些规则在没有对应失败的场景里是负资产。教训该放进一个「按需取用」的库,而不是「常驻」的上下文。
- 给 agent 配一个解耦的失败监视层,性价比极高。Sentry 的架构位------检测、路由、检索、验证------不碰 agent 本体、不改模型、不看任务奖励,四件事全部可以外挂。你的生产 agent 大概率也能在不重构的前提下加上这一层。
- 经验库的准入门槛应该绑「验证过的成功」,不是「经历过的失败」。没有验证准入,失败修复里的歪经验会污染库、将来误触发。这个原则同样适用于你自己的 RAG 记忆系统或多 agent 协作经验池。
再往远看一步:agent 跑得越长、记忆攒得越多,「知识怎么进上下文」这个问题只会越来越重要。论文作者的理由很直接------毛病出在知识进入上下文的方式上,而不是某个模型的弱点,所以记忆越长、任务越久,这个问题只会放大,不会自己消失。
理性看待
几处需要保持清醒的地方。实验模型是 Qwen3.5-9B 和 GPT-OSS-120B,旗舰闭源模型上是否同样成立还未验证;检测器、验证器和任务 agent 用的是同一个模型,虽然人类一致率不低,但「自己验证自己」的系统性偏差没有被完全排除。另外「对 ACE 领先 39%」的口径只在两个 web 基准上成立,SWE-bench Lite 和 AppWorld 没有上下文演进对比,引述时别把数字用大了。论文也没放开源仓库,Mind2Web Replay 是作者自己改造的协议,想复现得按附录的提示词模板重写一遍。