从摸石头过河到看录像学习:强化学习与离线RL的进化故事
举例:一个刚"出生"的机械臂,它面前有一个红色杯子。它想抓住这个杯子,但一开始它连手臂怎么动都会碰倒杯子。经过无数次摔倒和重来,它终于学会了稳稳抓取。这个"试错-学习-变强"的过程,就是强化学习的核心思想。本文将通过一个贯穿始终的机械臂学抓取的故事,由浅入深地揭开强化学习(RL)与离线强化学习(Offline RL)的算法演进史。
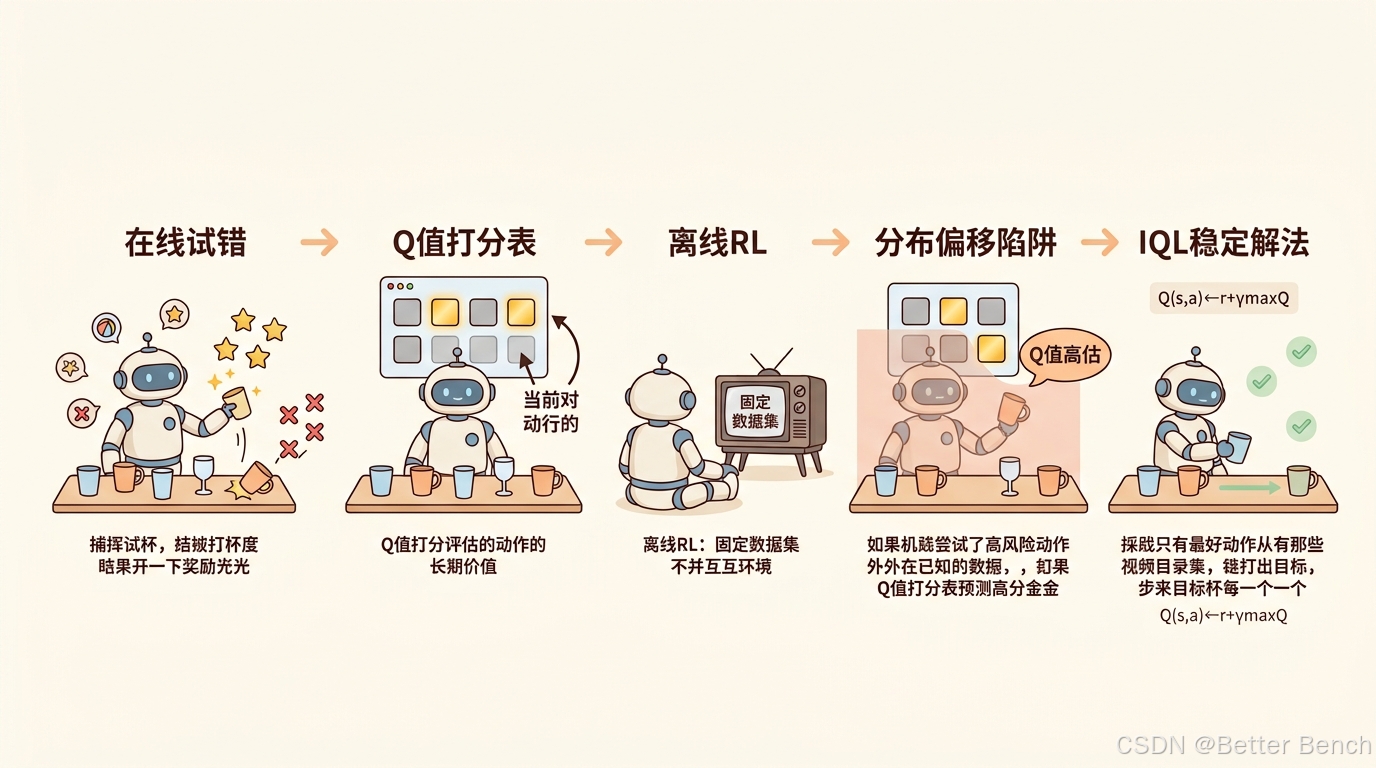
一、 强化学习是什么?------机械臂的"试错"童年
在人工智能领域,强化学习(Reinforcement Learning, RL) 是让智能体(Agent)在环境(Environment)中通过试错来学习最优行为策略的科学。
核心概念定义:
- 智能体(Agent):学习者,比如那台机械臂。
- 环境(Environment):智能体所处的世界,比如放满杯子的桌子。
- 状态(State, sss):环境在某一时刻的快照,比如机械臂关节的角度、杯子的位置。
- 动作(Action, aaa):智能体能执行的操作,比如"向前移动1厘米"或"夹紧手指"。
- 奖励(Reward, rrr) :环境对动作的即时反馈,抓到杯子得 +100+100+100 分,碰倒杯子扣 −50-50−50 分。
- 策略(Policy, π\piπ):智能体的行为准则,即"在什么状态下,应该做什么动作"。
强化学习的目标就是找到一个最优策略 π∗\pi^*π∗,使得智能体在整个生命周期内获得的累计奖励最大化。
二、 Q值:给动作"算命"的打分表
机械臂在试错时面临一个问题:抓取动作是连续的,当前动作的效果可能要等几秒后才能看到(比如手移过去才发现没对准)。为了评估一个动作的长期价值,研究者引入了 Q值(动作价值函数)。
Q值 Q(s,a)Q(s, a)Q(s,a) 表示:在状态 sss 下执行动作 aaa,智能体未来能获得的累计折扣奖励的期望。它就像一张"打分表",告诉机械臂"在这个位置做这个动作,长远来看能得多少分"。
贝尔曼方程:Q值的自我更新
Q值可以通过贝尔曼方程(Bellman Equation) 进行迭代更新:
Q(s,a)←r+γmaxa′Q(s′,a′) Q(s,a) \leftarrow r + \gamma \max_{a'} Q(s', a') Q(s,a)←r+γa′maxQ(s′,a′)
其中 γ\gammaγ 是折扣因子(0到1之间),代表对远期奖励的重视程度;s′s's′ 是执行动作后的新状态;maxa′Q(s′,a′)\max_{a'} Q(s', a')maxa′Q(s′,a′) 表示在新状态下所有可能动作中最大的Q值。
最早的算法:Q-Learning 与 DQN
最早的价值迭代算法是 Q-Learning ,它维护一张Q表。后来深度学习兴起,DQN(Deep Q-Network) 用神经网络拟合Q函数,让机械臂能处理高维视觉输入。
- 缺点 :DQN 只能处理离散动作 (比如"左、右、上、下"),但机械臂关节是连续旋转的;且它需要在线交互,即机械臂必须在真实环境中不断试错。
三、 在线RL的进化:从"同策略"到"离策略"
为了让机械臂能处理连续动作,并且学得快一点,研究者提出了不同的算法路线。
1. PPO(Proximal Policy Optimization):稳字当头
PPO 是一种同策略(On-policy) 算法。它直接优化策略网络,通过"裁剪"机制限制每次更新的幅度,防止机械臂学"歪"了。
- 优点:极其稳定,调参简单,适合连续控制。
- 缺点 :样本效率极低。它只用当前策略采集的数据训练一次就丢弃,需要海量交互。让机械臂在真实世界撞几千次才能学会,显然不现实。
2. SAC(Soft Actor-Critic):又稳又快
SAC 是一种离策略(Off-policy) 算法。它引入了"最大熵"思想(在最大化奖励的同时最大化策略的随机性,鼓励探索),并使用经验回放缓冲区(Replay Buffer) 存储历史数据,反复利用。
- 优点:样本效率高,是连续控制的主流算法。
- 缺点 :对超参数敏感。虽然它用回放缓冲区,但它仍然需要与环境实时交互来填充缓冲区。
关键区别:离策略(Off-policy)不等于离线(Offline)。离策略只是"可以复用旧数据",但依然需要在线探索;而离线则是"完全不能探索"。
四、 离线RL的诞生:不能试错,只能"看录像"
在真实机器人、自动驾驶、医疗等领域,让算法在线试错成本太高(撞坏机械臂、出车祸、治死病人)。于是,离线强化学习(Offline RL) 应运而生。
定义 :智能体只能从一个预先收集好的、固定的数据集(比如人类操作员遥操作机械臂采集的100条轨迹)中学习策略,不能与环境进行任何交互。
| 类型 | 是否与环境交互 | 数据来源 | 代表算法 |
|---|---|---|---|
| 在线RL | 是,边交互边学习 | 实时采集 | PPO, SAC |
| 离策略RL | 是,使用回放缓冲区 | 实时采集 + 历史数据 | DQN, SAC, TD3 |
| 离线RL | 否,完全不交互 | 固定数据集 | BCQ, CQL, IQL |
| 模仿学习 | 否(通常) | 专家演示数据 | BC, Diffusion Policy |
与模仿学习的区别 :模仿学习只是"照猫画虎",目标是模仿专家;离线RL则试图从次优数据中找到最优策略,甚至可能超越数据集中的表现。
五、 离线RL的核心挑战:分布偏移与Q值高估
离线RL看似美好,但有一个致命陷阱:分布偏移(Distribution Shift)。
机械臂在数据集里只见过"轻轻抓取"的动作,但它通过贝尔曼方程更新Q值时,会遇到 max\maxmax 操作:
Q(s,a)←r+γmaxa′Q(s′,a′) Q(s,a) \leftarrow r + \gamma \max_{a'} Q(s', a') Q(s,a)←r+γa′maxQ(s′,a′)
这个 max\maxmax 会鼓励机械臂去查询数据集中从未出现过 的动作 a′a'a′。由于没有这些动作的真实回报,神经网络只能靠外推(Extrapolation) ,导致对这些未知动作的Q值严重高估。机械臂会被错误的高估Q值误导,执行危险动作,最终任务崩溃。
六、 离线RL的破局之路:算法演进史
为了解决分布偏移,研究者们提出了一系列算法,形成了一条清晰的演进链条。
1. BCQ(Batch-Constrained Q-Learning):给动作"画地为牢"
- 提出背景:既然不能查询数据集外的动作,那就先学一个模型,只生成数据集里有的动作。
- 原理 :用 VAE(变分自编码器)建模行为策略 πβ\pi_\betaπβ。在策略提升时,只从 VAE 生成的、与数据集相似的动作中选Q值最大的。
- 缺点:VAE 训练不稳定,生成的动作可能仍偏离数据集,调参困难。
2. CQL(Conservative Q-Learning):给Q值"泼冷水"
- 提出背景:BCQ 的生成模型太复杂,能否直接约束Q函数?
- 原理 :在Q值更新中加入保守惩罚项,最小化未知动作的Q值,最大化数据集中动作的Q值。
minQmaxμαEs∼D,a∼μQ(s,a)−Es,a∼DQ(s,a) \min_Q \max_\mu \alpha \mathbb{E}{s\sim D, a\sim \mu}Q(s,a) - \mathbb{E}{s,a\sim D}Q(s,a) QminμmaxαEs∼D,a∼μQ(s,a)−Es,a∼DQ(s,a) - 缺点 :保守系数 α\alphaα 极难调优。过大导致Q值过度保守(机械臂不学习),过小则无法抑制高估。在高维动作空间(如7自由度机械臂)中容易失效。
3. TD3-BC:大道至简
- 提出背景:CQL 太复杂,能否用最简单的方式把行为克隆加进去?
- 原理 :在 TD3(一种离策略确定性策略梯度算法)基础上,直接加入行为克隆(BC)正则项。策略损失 = TD3损失 + λ⋅\lambda \cdotλ⋅ BC损失。
- 缺点:BC 正则项会限制策略超越数据,如果数据质量差,性能上限很低。
4. IQL(Implicit Q-Learning):彻底避开陷阱
- 提出背景:既然查询分布外动作是万恶之源,能否完全不查询?
- 原理 :通过期望回归(Expectile Regression) 拟合Q函数,使用 τ\tauτ 分位数(如0.7)来近似 max\maxmax 操作。策略提取时只使用数据集中的动作。
- 优点 :极其稳定,无需对抗训练,无需保守系数,是目前离线RL最推荐的基线。
- 缺点 :对 τ\tauτ 敏感;不直接优化策略,提升幅度有限。
算法对比总结
| 算法 | 核心思想 | 优点 | 缺点 |
|---|---|---|---|
| BCQ | VAE约束动作空间 | 理论优雅 | VAE不稳定,调参难 |
| CQL | Q值保守惩罚 | 简单有效 | α\alphaα 极难调,高维崩溃 |
| TD3-BC | TD3 + BC正则 | 实现简单 | 受限于数据质量 |
| IQL | 期望回归,不查询OOD | 极稳定 | 策略提升有限 |
七、 应用领域与实例
- 机器人控制:从人类遥操作数据中学习抓取、装配。例如,某实验室使用 IQL 算法,让 Kinova Gen3 机械臂从仅50条次优轨迹中学会了稳定的插拔动作。
- 自动驾驶:从人类驾驶记录中学习策略,避免在线碰撞。
- 医疗决策:从病史数据中学习最优治疗方案,不能拿病人试药。
- 推荐系统:从用户历史点击中学习,不能频繁给用户推奇怪的内容。
八、 总结
强化学习的发展史,是一部从"盲目试错"到"高效利用数据"的进化史:
- Q-Learning/DQN 开启了价值学习,但只能处理离散动作且需在线交互。
- PPO/SAC 解决了连续控制问题,提升了样本效率,但依然依赖在线探索。
- 离线RL(BCQ/CQL/TD3-BC/IQL) 彻底切断了与环境的实时交互,通过不同的约束机制(生成模型、保守惩罚、行为克隆、期望回归)解决了分布偏移问题。