一、一篇两千字的稿子要配五张图
内容团队的图库是从零开始攒的,到去年底一共一万两千多张自有素材,来源是几年的实地拍摄和合作方给的授权片。文章生成系统上线之后,写手的工作流里多了一段纯体力活,每篇稿子要人工翻图库找三到五张配图,按内容挑场景、按色调挑气质,平均一篇十五分钟。一天三十篇稿子,光找图这一项就要吃掉七个半钟头,还得有人在旁边盯着别重复。
更麻烦的是图库本身没有可检索的信息。大部分文件的命名是导入工具生成的流水号,标签是导入时批量刷上去的,一篇稿子讲的是村里的节气活动,按标签搜出来的却可能是同一批导入的硬件设备照。人会累、会挑烦,挑到后面几篇就开始随手抓图,配图和正文对不上,发出去读者第一眼就能看出来。
 二、问题的根子是图库没有可检索的语义
按文件名匹配这条路没得走,流水号里没有内容信息。按导入时打的标签匹配也不靠谱,标签是整批素材共用的粗标签,一张照片可能同时被打上乡村和设备两个标签,落到具体段落上完全没有区分度。想让机器替人挑图,前提是每张图先有一句话能说清它画的是什么,而且这句话要能跟段落的意思对上。
于是问题被拆成两段,一段是把一万两千张图变成可比的描述,另一段是把段落和描述放在同一个空间里算距离。第一段的难度被低估了,我们一开始以为描述随便生成一句就行,结果配出来的图驴唇不对马嘴,回头看那些描述,模型给出来的句子是同一张风景照片这种毫无信息量的东西。描述的质量直接决定配图的准度,这句话我们是踩了半个月才认的。
三、两条路子和各自的代价
第一条路是人工给图库打细标签,按场景、主体、时节、色调四个维度各打几个词,再接一个关键词匹配的选图逻辑。好处是标签准,坏处是一万两千张图按每张两分钟算,要四百个小时,也就是一个人两个多月不干别的,而且新素材进来还得继续打。第二条路是让模型批量生成描述,再进行向量相似度匹配,前期只要把描述生成的提示词调好,后续新素材自动进队列。
我们选了第二条,代价是描述生成要花钱花时间,一万两千张图跑了一整夜,中途还得处理接口限流。匹配的准确率也不是一步到位的,第一版相似度阈值定得太松,配出来的图相关性很勉强;阈值收紧之后又频繁出现某个段落配不出图的情况。这个阈值的最终值是在几百篇真实稿子上试出来的。
 四、描述和匹配是怎么串起来的
图库这边分成入库、生成、匹配三层。入库时算一遍图片指纹并记录宽高和体积;生成层按队列逐张调模型出描述,描述落库的同时算一次向量并存下来;匹配层在文章生成阶段被调用,逐段取向量算相似度,挑分高的插到该段之后。生成层和匹配层完全解耦,图库描述没生成完也不影响其它图的匹配。
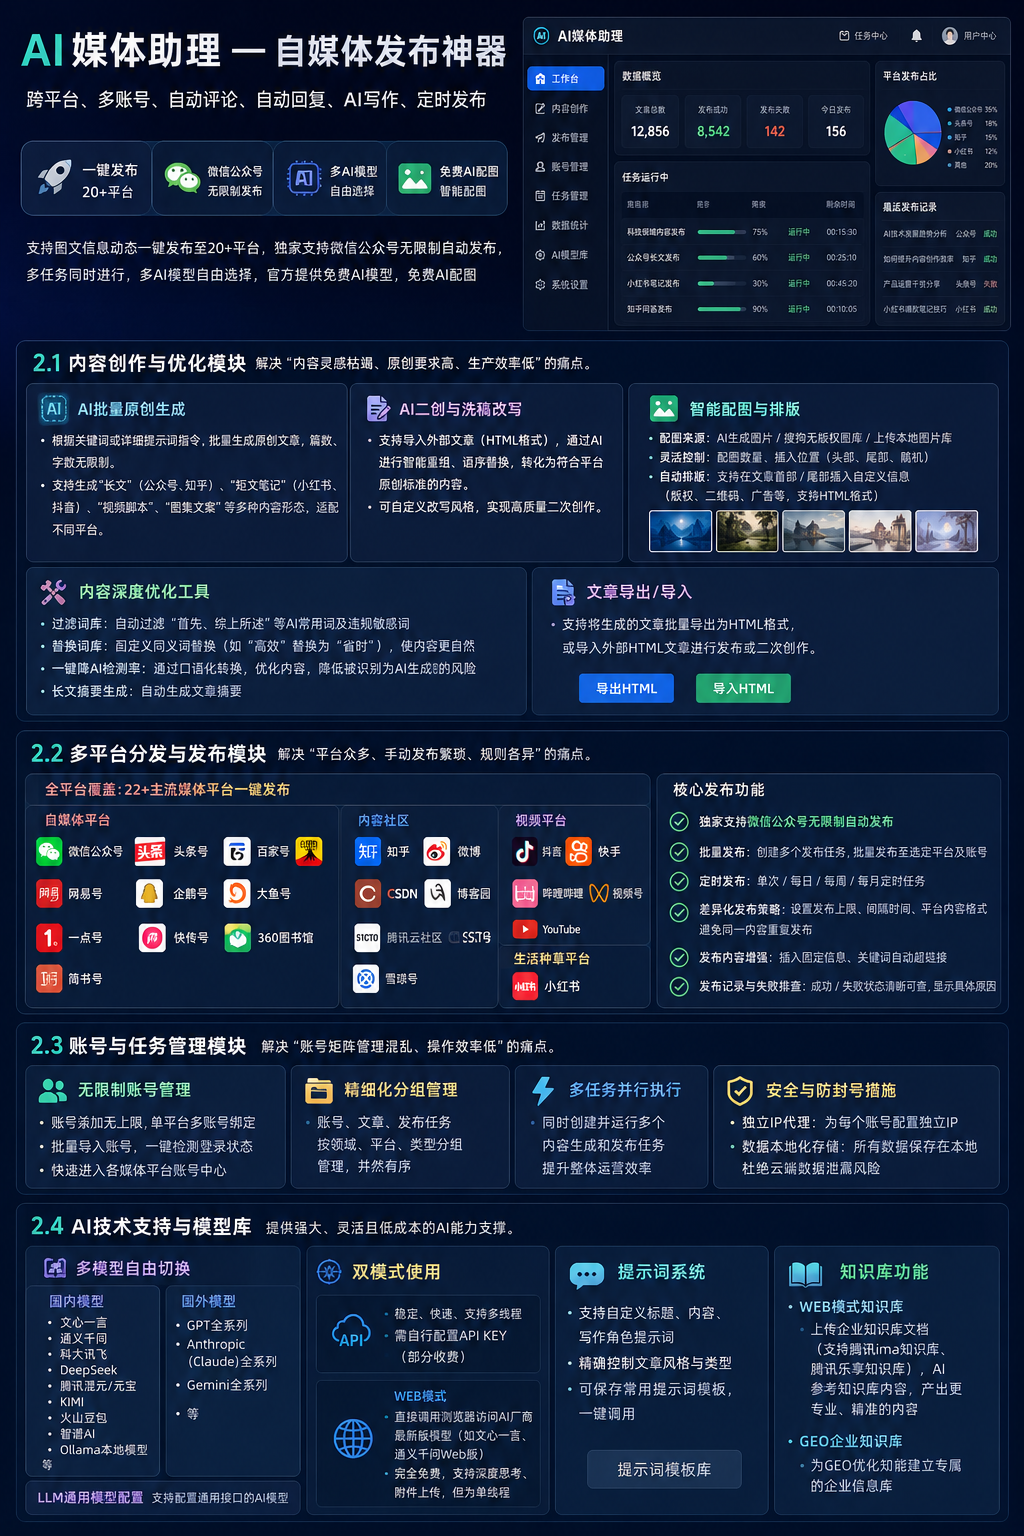
匹配调用发生在文章成稿之后、排版之前。系统把正文按空行切段,太短的段合并到相邻段,然后为每个候选位置挑一张图,同一篇内已经用过的图直接跳过。匹配逻辑归属 AI智能媒体助理,图库和正文生成共用同一张描述表,写手在文章预览里看到的配图建议就是这一层给出来的。
描述生成的提示词是可配置的,这是后来加的。最初的提示词只要求模型简短描述图片,输出全是套话。改成要求写清主体、场景、色调和适合搭配的题材之后,配图准确率明显上来。不同产品线还用了不同风格的提示词,同一张图在两个库里生成的描述会不一样,好在描述和图片的对应关系是按库隔离的,不会互相串。
 五、几个关键字段和参数
图片表上的关键字段有八个,图片指纹、原始路径、压缩后路径、宽、高、体积、描述文本、描述向量。指纹用感知哈希算,主要用来做近重复过滤;描述向量存成定长数组,维度按模型给的容量走,匹配时统一做归一化再算余弦。体积字段在选图时也参与排序,同一分段的候选里优先挑体积较小的那张,避免首屏被一张大图拖住。
描述生成任务的并发开到四路就不再往上加了,加到十六路的时候接口直接限流,任务整体反而更慢。每张图的描述生成状态单独记,分待生成、生成中、已完成、失败四种,失败重试三次,退避间隔取五秒、二十秒、六十秒,三次仍失败就跳过并在列表里标红。压缩统一按长边一千二百像素处理,体积控制在一百五十千字节上下,超过这个量级的原图只在详情页保留。
六、踩过的三个坑
第一个坑是描述质量。现象是生成的文章里配图和段落完全对不上,讲种植技术的段落底下配了一张会议室照片。根因是描述提示词只要求模型简短描述图片,模型很自然地给出了一张照片这类没有区分度的句子,一万多张图的描述彼此高度相似,算出来的相似度自然没有意义。改法是把提示词改成必须写清主体、场景、色调和适用题材,并把描述长度卡在四十到八十字之间,太短的直接重生成。
第二个坑是同篇重复。现象是同一篇文章里插了三张构图几乎一样的图,读者一眼看出是同一批素材。根因是匹配只按相似度取每段的前几名,段落之间互不知道对方选了什么,图库里本来就存在同一次外拍的连拍图,于是被分散选走。改法是选图时维护一个本篇已用集合,指纹相近的图直接跳过,同一张图在篇内只允许出现一次。
第三个坑是批量描述的并发。现象是一次导入八百张图,任务跑到一半卡死,重启之后又从头开始,前面的结果白算。根因是并发开到了十六路触发接口限流,同时任务没有记录单张图的状态,失败也就是静默跳过。改法是把并发降到四路,逐张落状态并支持断点续跑,失败重试三次带退避,重跑只处理未完成和失败的那部分。
七、这层解决不了什么
相似度算出来的分高,只能说明文字描述接近,不代表这张图放在这里就合适。一篇讲政策的稿子,段落里出现了村和会议这两个词,模型会挑出一张开会的照片,但这篇稿子真正想要的是村口的实景,这种事机器判断不了。我们对这类稿子保留了人工替换的入口,写手可以在预览里把建议图换成自己挑的,并且把这次替换记下来,作为后续调整阈值的样本。
描述生成也依赖图片本身有内容。纯色背景、产品白底图、构图极简的插画,模型给出来的描述往往很空,一段话里全是抽象词,这类图怎么调阈值都匹配不上具体段落,最后只能退化成按图库的顺序补位。我们接受了这个现实,白底图本来也就不适合做正文配图。
八、小结
现在一篇两千字的稿子,从成稿到配图完成平均在九十秒以内,写手只需要在预览里扫一眼、替换掉个别不满意的图。省下来的时间不是在效率数字上,而是稿子终于不用配得那么敷衍,读者翻到图的时候不会再觉得莫名其妙。真正决定效果的是描述那一层,提示词多写几个约束,后面所有匹配都会跟着变准。图库的批量描述生成和正文的配图挑选,是 AI智能媒体助理 在这一层给出的两块功能。