一、IoTDB集群架构:不只是"分布式"那么简单
我刚开始接触IoTDB那会儿,以为它就是个简单的分布式数据库,多加几个节点就能提升性能。但真正深入了解之后才发现,IoTDB的集群架构设计有它自己的考虑。
1.1 ConfigNode与DataNode:管事的和干活的
IoTDB集群把计算和存储给分开了。啥意思呢?就是说管数据这事儿和数据实际存在哪儿、怎么去查,是两拨"人"在干【turn0search37】。
- ConfigNode:这个角色,其实就是干管理活儿的。管啥呢?管元数据、管权限、管分区这些"行政"上的事
- DataNode:这是干活的。数据怎么存、查询怎么执行,都归它管
这么分的好处是管理节点不会变成性能瓶颈。就算元数据操作特别频繁,也不会影响到数据读写的性能。我们的环境里,ConfigNode放在3台配置比较高的机器上,DataNode则放在多台性价比更高的机器上。
1.2 Region:数据是怎么分片存的
IoTDB集群里,Region说白了就是个数据分片【turn0search37】。每个Region本质上是个逻辑上的数据文件夹,负责存一部分数据。Region有两种:
- SchemaRegion:存元数据信息(比如时间序列定义、模板这些)
- DataRegion:存实际的时间序列数据
Region会自动分布在多个DataNode上,这样能保证数据不会因为一个节点坏了就丢掉,负载也能均衡。每个Region默认有多个副本(通常是3个),放在不同的DataNode上,这样单个节点坏了数据也不会丢。
💡 踩坑提示 :维护集群的时候,必须保证正常运行的DataNode数量不能少于数据复制因子(通常是2)或者元数据复制因子(通常是3)【turn0search37】。不然的话,数据可能会丢,集群也可能用不了。
1.3 集群之间怎么通信
IoTDB集群内部通过好几种协议来通信:
- Raft协议:用在ConfigNode和SchemaRegion上,保证元数据是一致的
- IoTConsensus协议:用在DataRegion上,保证数据是一致的
- 心跳机制:节点之间靠心跳来感知彼此的状态
二、分区机制:数据如何分布到不同节点
理解了Region是什么,下一个关键问题是:数据是怎么被分到不同Region里的? 这就涉及到IoTDB的分区机制。
2.1 序列分区:基于设备的哈希分区
IoTDB用哈希分区的策略,把不同时间序列的数据分布到不同的DataRegion里【turn0search11】。具体怎么做的呢?就是拿序列的存储路径做个哈希计算,把哈希值映射到不同的序列槽,每个序列槽对应一个DataRegion。
序列分区有几个关键点:
- 哈希函数保证相同设备的数据尽量放在同一个Region,这样查询起来快
- 序列槽的数量通过
series_slot_num参数配置,默认是1000【turn0search2】 - 没法手动指定序列的分区位置,系统自动分配
注意:如果你的业务经常要跨设备查询,可能需要调整序列槽数量,避免数据倾斜。
2.2 时间分区:基于时间范围的分区
除了序列分区,IoTDB还会按时间范围 对数据进行分区【turn0search11】。时间分区通过time_partition_interval参数配置,默认是604800000毫秒(也就是1周)【turn0search2】。
时间分区的好处:
- 时间范围查询快:查特定时间段的数据,只需要访问相关的Region
- 数据生命周期管理:可以基于时间分区设置TTL(生存时间),自动删掉过期数据
- 并行处理:不同时间分区的数据可以并行处理,查询效率高
2.3 分区与Region的关系
每个DataRegion实际上是由序列分区和时间分区组成的矩阵里的一个格子。比如,一个集群可能有100个序列槽和10个时间分区,那理论上最多会有1000个DataRegion(但实际上会根据数据量和负载动态调整)。
数据分布计算公式:
Region数量 ≈ 序列槽数量 × 时间分片数量三、集群扩容
当 IoTDB 集群因数据量或访问压力激增,出现 CPU、内存、磁盘或网络等资源瓶颈时,可通过本指南进行横向扩容,以提升集群整体性能与承载力。
3.1 实现原理
IoTDB 集群扩容的核心是增加 DataNode 节点,因为 DataNode 是处理读写请求的主要节点。其内部的数据分区(DataRegion)是承载负载的关键单元,扩容的本质即通过增加数据分区组来提升集群并发能力与吞吐量。
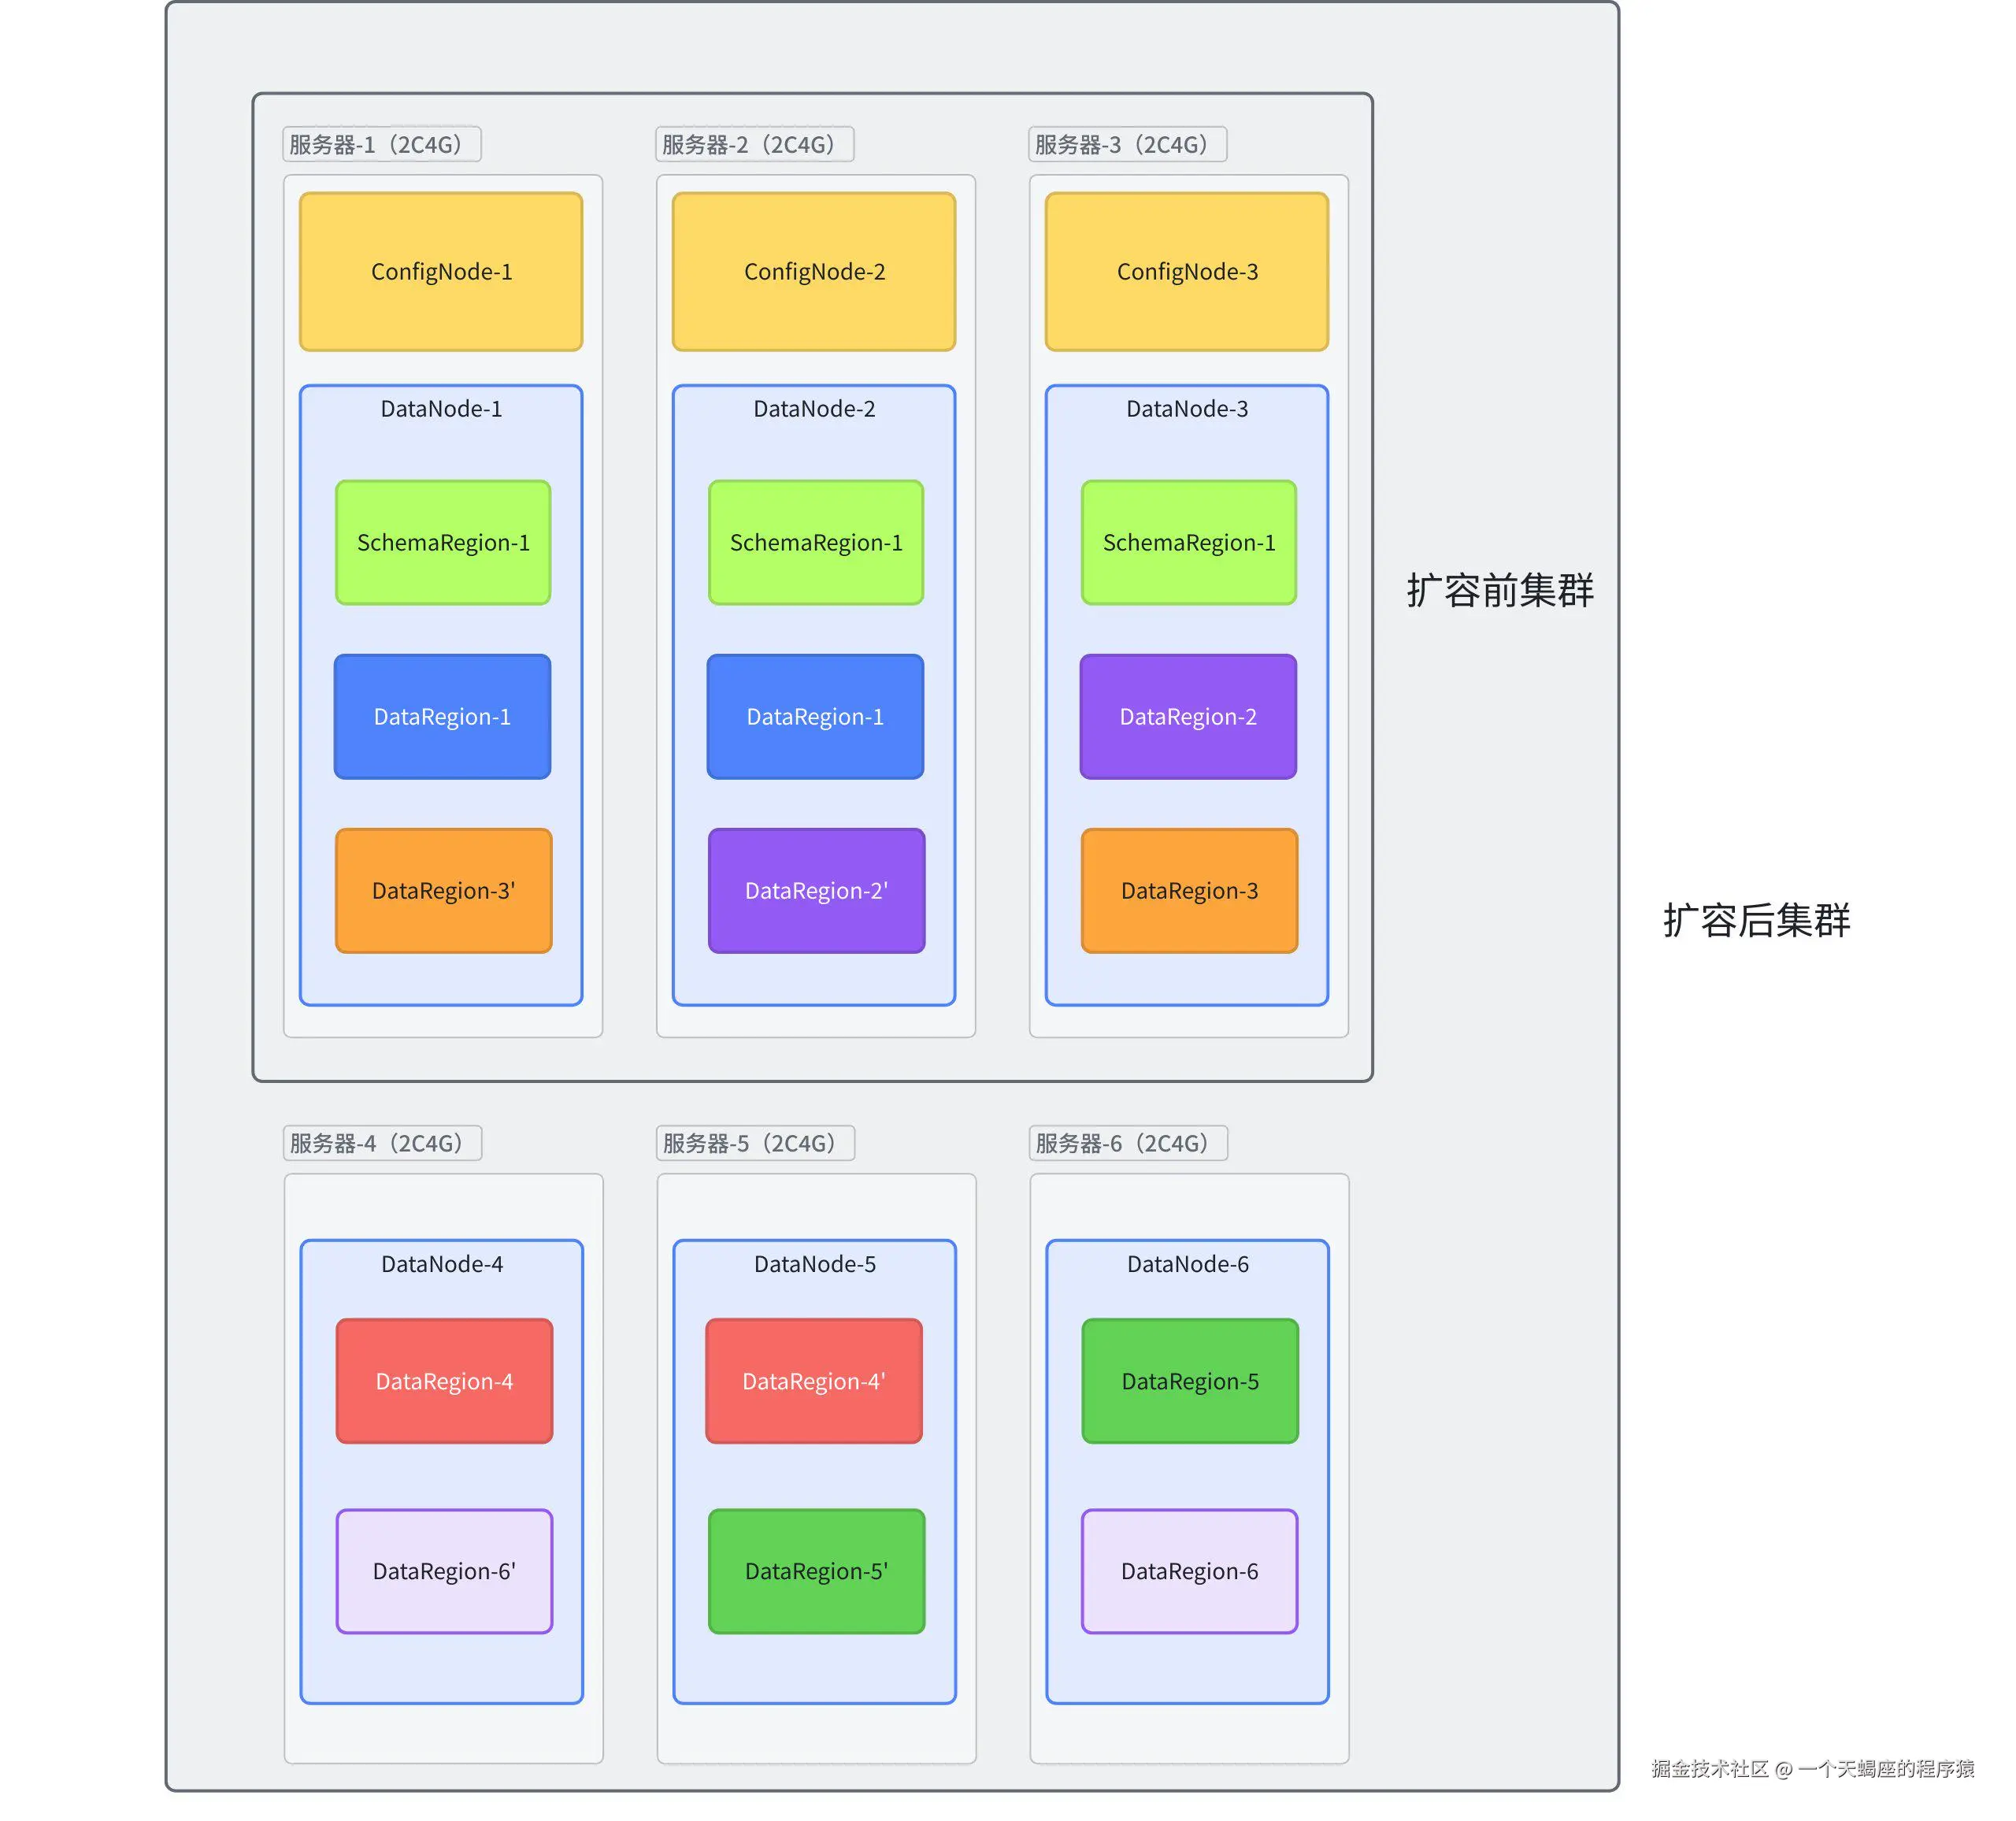
默认情况下,假设集群的元数据副本数为三,数据副本数为二,初次初始化时会创建集群总核数除以二的数据分区。如下图一个由3台2核服务器组成的集群,假设每个数据副本组的处理能力为1,那么该集群(包含3个数据副本组)的总吞吐能力为3。因此,将服务器数量由三台扩展为六台,集群由原来的三数据分区组扩容为六数据分区组,总吞吐能力也相应实现翻倍。
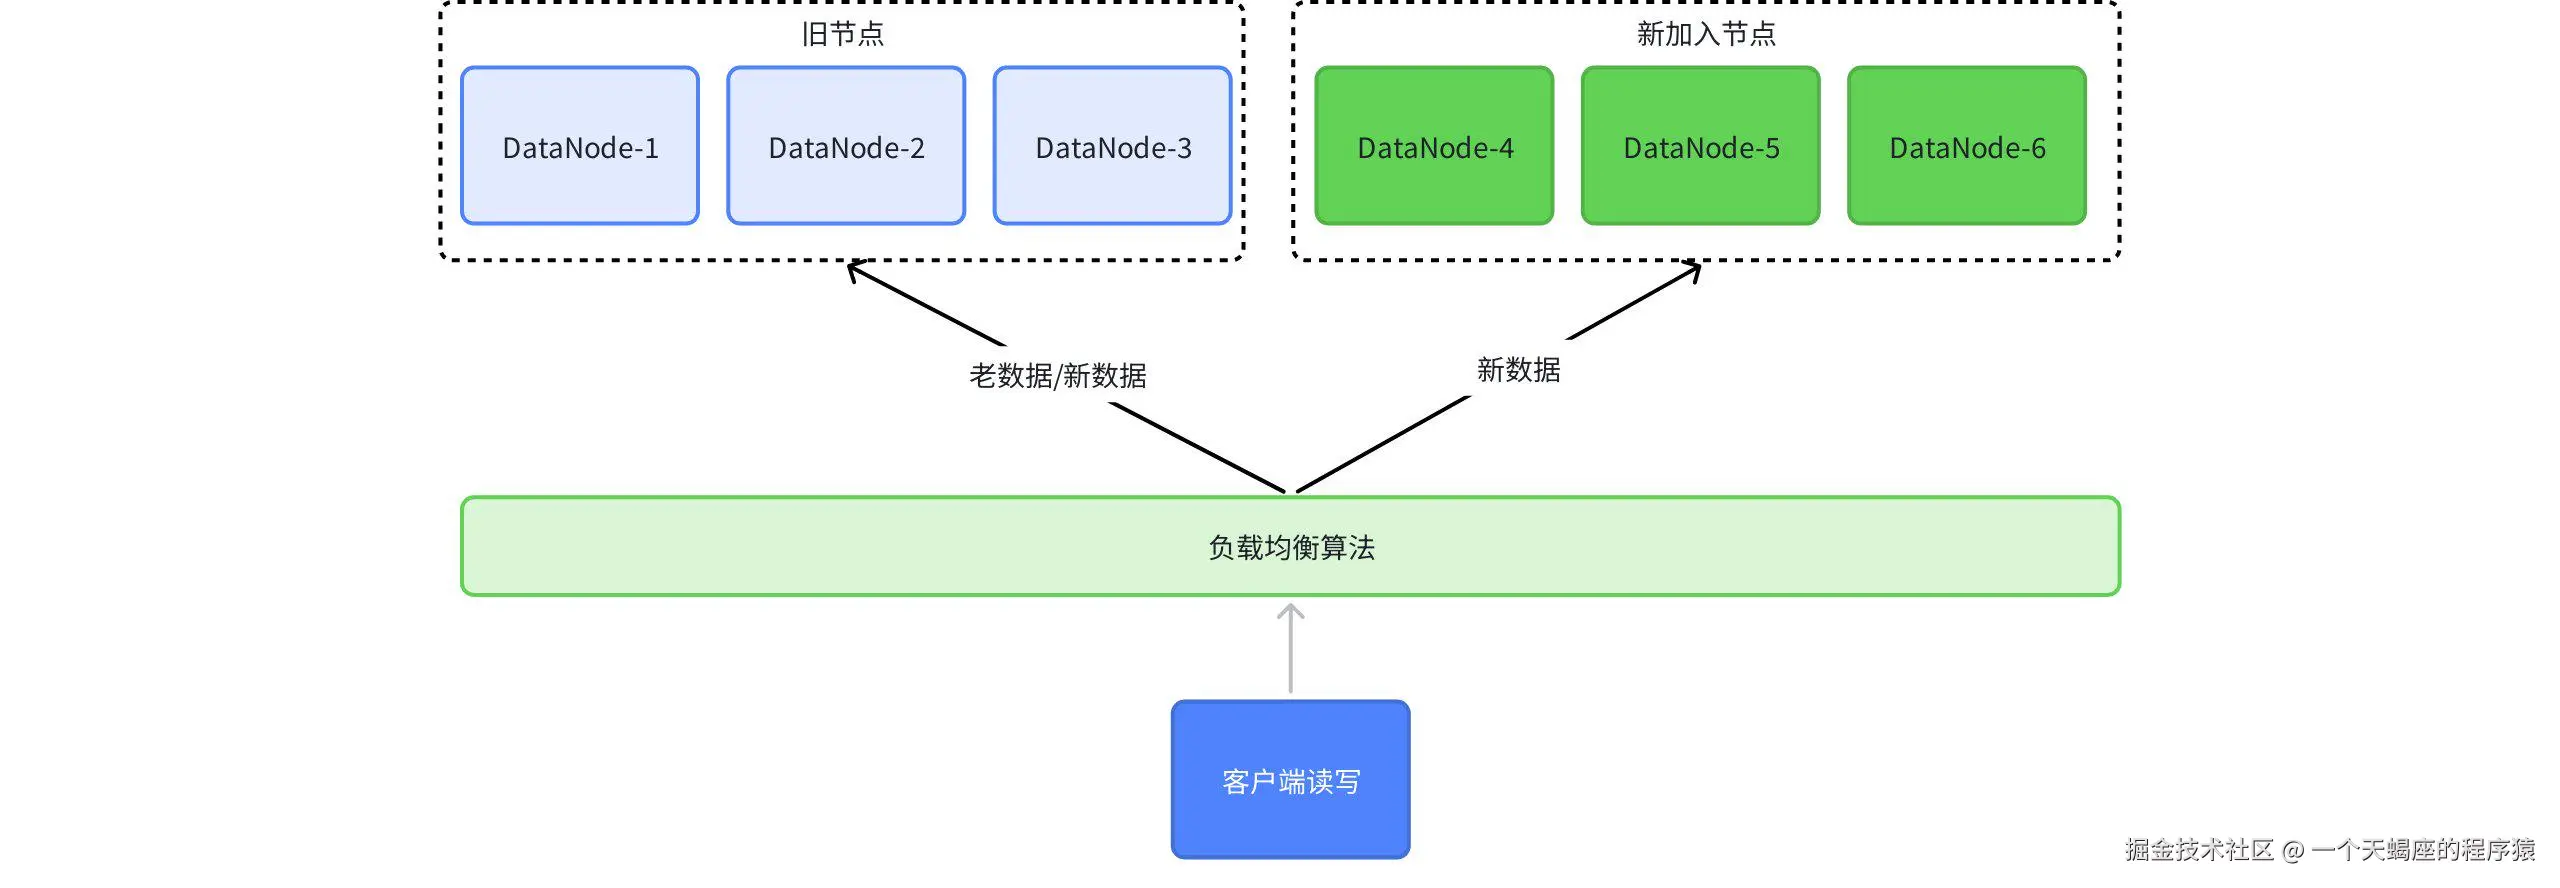
扩容后,客户端读写负载的均衡规则是旧节点可能同时处理老设备(集群中已存在的 DeviceId 的数据)和新设备(集群中不存在的 DeviceId 的数据)的数据读写,而新节点仅接收新增数据的读写,旧节点不会对原有副本组进行自动重均衡。数据负载均衡通常在每个新时间分区创建时进行,默认时间为每周四上午八点。其核心原理是通过序列分区槽和时间分区槽进行负载均衡算法运算,从而决定数据由哪个节点的哪个分区处理。
如果希望在扩容后进一步均衡历史数据,可按需执行 Region 迁移或 Region 重均衡:当需要精确指定 Region、源 DataNode 和目标 DataNode 时,可参考【4. 手动 Region 迁移】;当希望系统自动计算迁移方案并完成整体均衡时,可参考【5. 自动 Region 重均衡】
3.2 操作步骤
1、前置准备
1 服务器环境检查,建议操作系统版本与原集群保持一致。
2 数据库版本检查,建议版本与原集群版本保持一致。
3 操作系统环境检查,保证所需端口不被占用,DataNode 会占用端口 6667、10730、10740、10750 、10760、9090、9190、3000请确保这些端口未被占用。
bash
lsof -i:6667  或  netstat -tunp | grep 6667
lsof -i:10710  或  netstat -tunp | grep 10710
lsof -i:10720  或  netstat -tunp | grep 10720
4 数据目录检查,确认服务器已挂载数据盘,建议将安装包放在数据盘目录下。
5 软件依赖:安装 Java 运行环境 ,Java 版本 >= 1.8,请确保已设置 jdk 环境变量。
6 域名配置:部署时推荐优先使用 hostname 进行 IP 配置,可避免后期修改主机 IP 导致数据库无法启动的问题。设置 hostname 需要在目标服务器上配置/etc/hosts,如本机 IP 是192.168.1.3,hostname 是 iotdb-1,则可以使用以下命令设置服务器的 hostname,并使用 hostname 配置 IoTDB 的 cn_internal_address、dn_internal_address、dn_rpc_address。
2、扩容操作
1 为确保您获取的 IoTDB 安装包完整且正确,在执行安装部署前建议您进行 SHA512 校验。
2 解压安装包并进入安装目录
bash
unzip  iotdb-{version}-bin.zip
cd  iotdb-{version}-bin
3 修改相应配置
bash
cd  iotdb-{version}-bin/conf
vim iotdb-system.properies
4 启动 DataNode 节点 进入 IoTDB 的 sbin 目录下,启动 Datanode:
bash
./sbin/start-datanode.sh -d #"-d"参数将在后台进行启动5 通过 CLI 命令连接原集群,进行扩容后验证
bash
# Linux 或 macOS系统
  ./iotdb-{version}-bin/sbin/start-cli.sh

  # Windows 系统
  ./iotdb-{version}-bin/sbin/start-cli.bat
6 执行命令进行验证
执行show datanodes命令进行验证,预期结果列表中出现新加入的节点,且节点状态为 Running。
test
IoTDB> show datanodes
+------+-------+----------+-------+-------------+---------------+
|NodeID| Status|RpcAddress|RpcPort|DataRegionNum|SchemaRegionNum|
+------+-------+----------+-------+-------------+---------------+
|     1|Running|   0.0.0.0|   6667|            0|              0|
|     2|Running|   0.0.0.0|   6668|            1|              1|
|     3|Running|   0.0.0.0|   6669|            1|              0|
|     4|Running|   0.0.0.0|   6669|            1|              0| # 新加入节点
+------+-------+----------+-------+-------------+---------------+
Total line number = 4
It costs 0.110s
7 其他节点重复以上操作。新节点能够成功加入原集群的前提是原集群允许加入的 DataNode 节点数量足够
3、手动负载均衡(按需选择)
默认情况下,扩容后历史数据不会自动迁移。若需进一步均衡各节点的数据分布,可选择以下方式:
手动 Region 迁移:适用于已明确需要迁移的 Region、源 DataNode 和目标 DataNode 的场景。
自动 Region 重均衡:适用于扩容后希望系统自动选择迁移方案、整体均衡历史数据的场景。
四、集群缩容与节点移除:安全下线的艺术
比起扩容,缩容(移除节点)更要小心,必须保证数据安全。
4.1 移除DataNode的安全流程
我第一次试着移除DataNode时,差点搞丢数据,后来总结出这么一套安全流程:
详细操作步骤:
-
看看要移除的节点上有什么Region:
sql-- 看看DataNode 2上有什么Region SHOW REGIONS WHERE DataNodeId=2; -
把Region迁到其他节点:
sql-- 把所有Region从DataNode 2迁到DataNode 3 MIGRATE REGION ALL FROM 2 TO 3; -
等迁移完成:
sql-- 检查迁移状态,直到所有Region都迁完了 SHOW REGIONS WHERE DataNodeId=2; -
移除DataNode:
sqlREMOVE DATANODE 2; -
验证移除成功:
sqlSHOW DATANODES;
4.2 移除ConfigNode的注意事项
移除ConfigNode相对简单,但要保证剩下的ConfigNode数量是奇数(通常是3或5),维护Raft共识。
sql
REMOVE CONFIGNODE 1;⚠️ 重要提示 :永远不要把集群里最后一个ConfigNode移掉,不然元数据就丢了,集群都起不来!
五、集群监控与日常维护:预防胜于治疗
折腾了几次集群维护后,我深刻体会到日常监控和定期维护有多重要。下面是我们的监控体系:
5.1 关键监控指标
| 指标类别 | 关键指标 | 告警阈值 | 说明 |
|---|---|---|---|
| CPU | CPU使用率 | >80% | 持续5分钟高于阈值告警 |
| 内存 | JVM堆内存使用率 | >85% | 可能导致频繁GC |
| 磁盘 | 磁盘使用率 | >80% | 得考虑扩容或清理了 |
| 磁盘 | 磁盘I/O等待时间 | >20% | 磁盘I/O有瓶颈 |
| 网络 | 网络带宽使用率 | >70% | 可能成为查询瓶颈 |
| Region | Region数量 | >1000/节点 | Region太多影响性能 |
| 查询 | 查询延迟P99 | >5秒 | 用户体验受影响 |
5.2 日常维护操作
下面是我们日常做的维护操作:
1. 定期检查集群健康状态
bash
# 每天跑一次的健康检查脚本
#!/bin/bash
# 检查节点状态
NODES=$(iotdb-cli -e "SHOW DATANODES;" | grep -c "Running")
if [ "$NODES" -lt 3 ]; then
  echo "警告:DataNode数量不足3个,当前数量:$NODES"
fi
2. 定期合并数据
sql
-- 手动触发合并(建议在低峰期执行)
MERGE;
FULL MERGE;
3. 清理缓存
sql
-- 清理查询缓存
CLEAR QUERY CACHE;
4. 检查并修复数据
sql
-- 启动数据修复任务
START REPAIR DATA;
六、性能调优:从集群配置到查询优化
集群维护不光是管节点,还包括性能调优。下面是我总结的性能调优经验:
6.1 集群参数调优
根据我们的硬件配置和业务负载,调了这些参数:
properties
# conf/iotdb-common.properties
# 增加查询线程数,提高并发查询能力
max_query_worker_threads=32
# 增加查询队列大小,避免查询被拒绝
max_query_queue_size=100
# 优化内存分配,根据硬件调整
storage_query_schema_consensus_free_memory_proportion=3:3:1:1:2
6.2 查询优化技巧
-
用索引加速查询:
sql-- 给时间序列建索引 CREATE INDEX ON root.sg.d1.s1 USING BLOOM_FILTER; -
合理设计查询语句:
sql-- 别全表扫描,加上时间过滤条件 SELECT * FROM root.sg.d1 WHERE time > 2026-01-01 AND s1 > 100; -- 用降采样减少数据量 SELECT AVG(s1) FROM root.sg.d1 GROUP BY ([2026-01-01, 2026-01-31], 1h); -
用缓存:
properties# 启用查询缓存 enable_query_cache=true query_cache_size=1073741824
七、结语
IoTDB这个集群吧,它把管事的和干活的给分开了。ConfigNode就负责管元数据、管权限这些事,DataNode就负责数据怎么存、查询怎么跑。这么分的好处是管理不会拖累干活,系统就稳当多了。
数据怎么分是靠Region这个分片。Region说白了就是个数据文件夹,有存元数据的,有存实际数据的。每个Region默认有3个副本,放在不同节点上,这样坏一个也不怕。
分区主要看两个东西:按设备做哈希 ,还有按时间范围切。这两个一交叉,就成了个矩阵,查询快,负载也均匀。
想扩容就加DataNode。加了之后数据不会马上过去,得等新数据写进来,或者手动迁移Region,负载才能平衡。