(一).概念
前面介绍哨兵的时候,我们发现,哨兵机制并不能帮助我们解决数据存储容量问题。为了解决这个问题,我们可以引入多组主节点/从节点,每一组主节点/从节点存储数据全集的一部分,从而构成了一个更大的整体,称为Redis集群
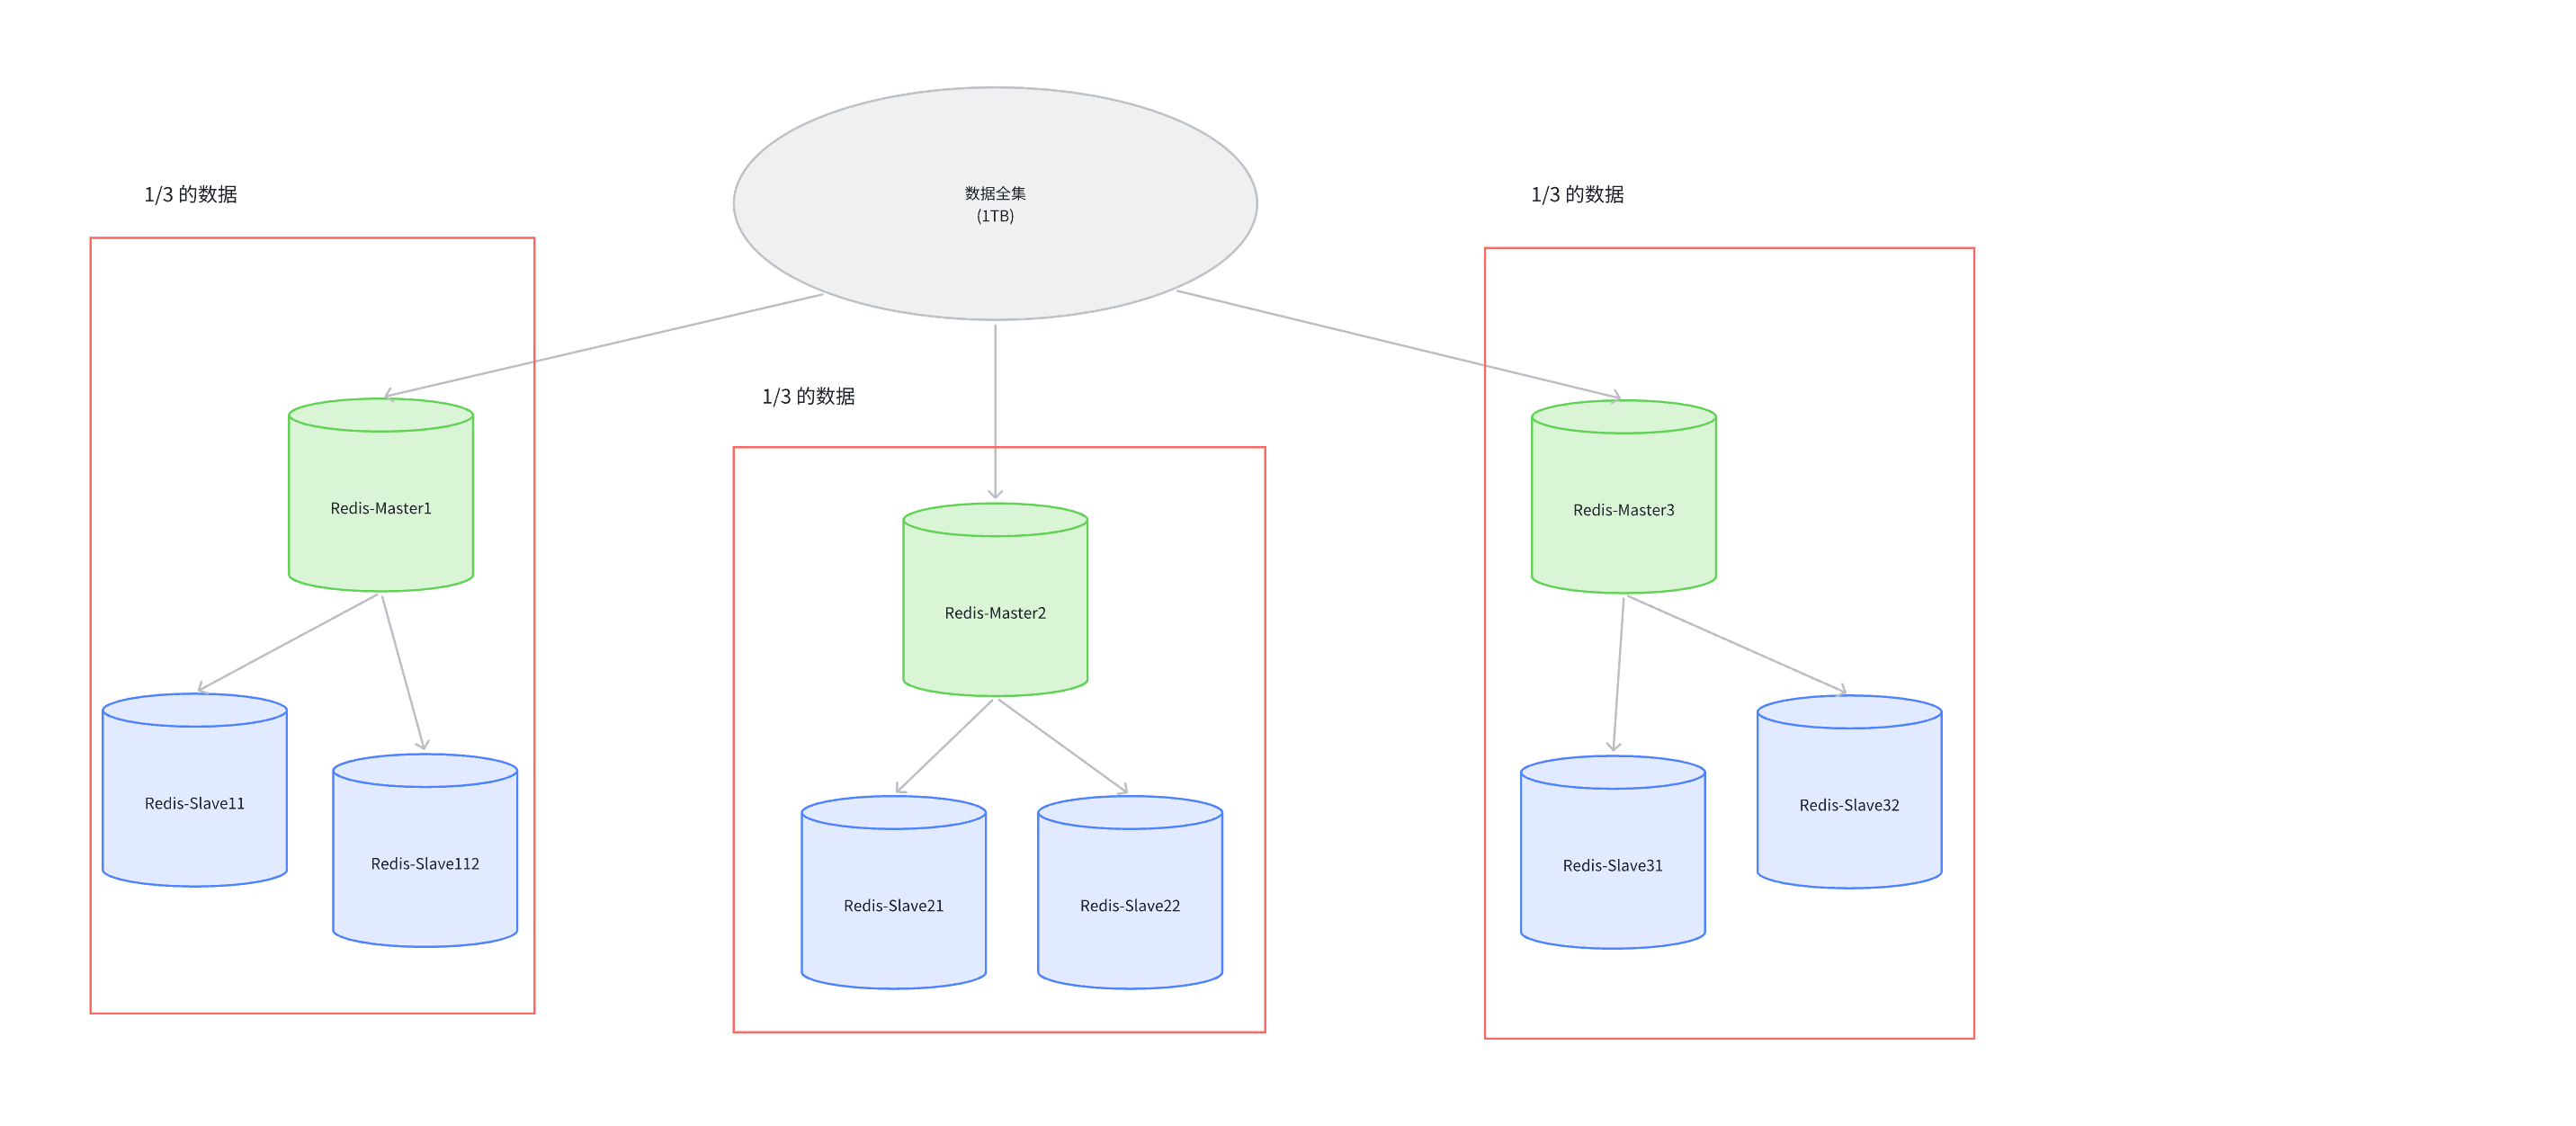
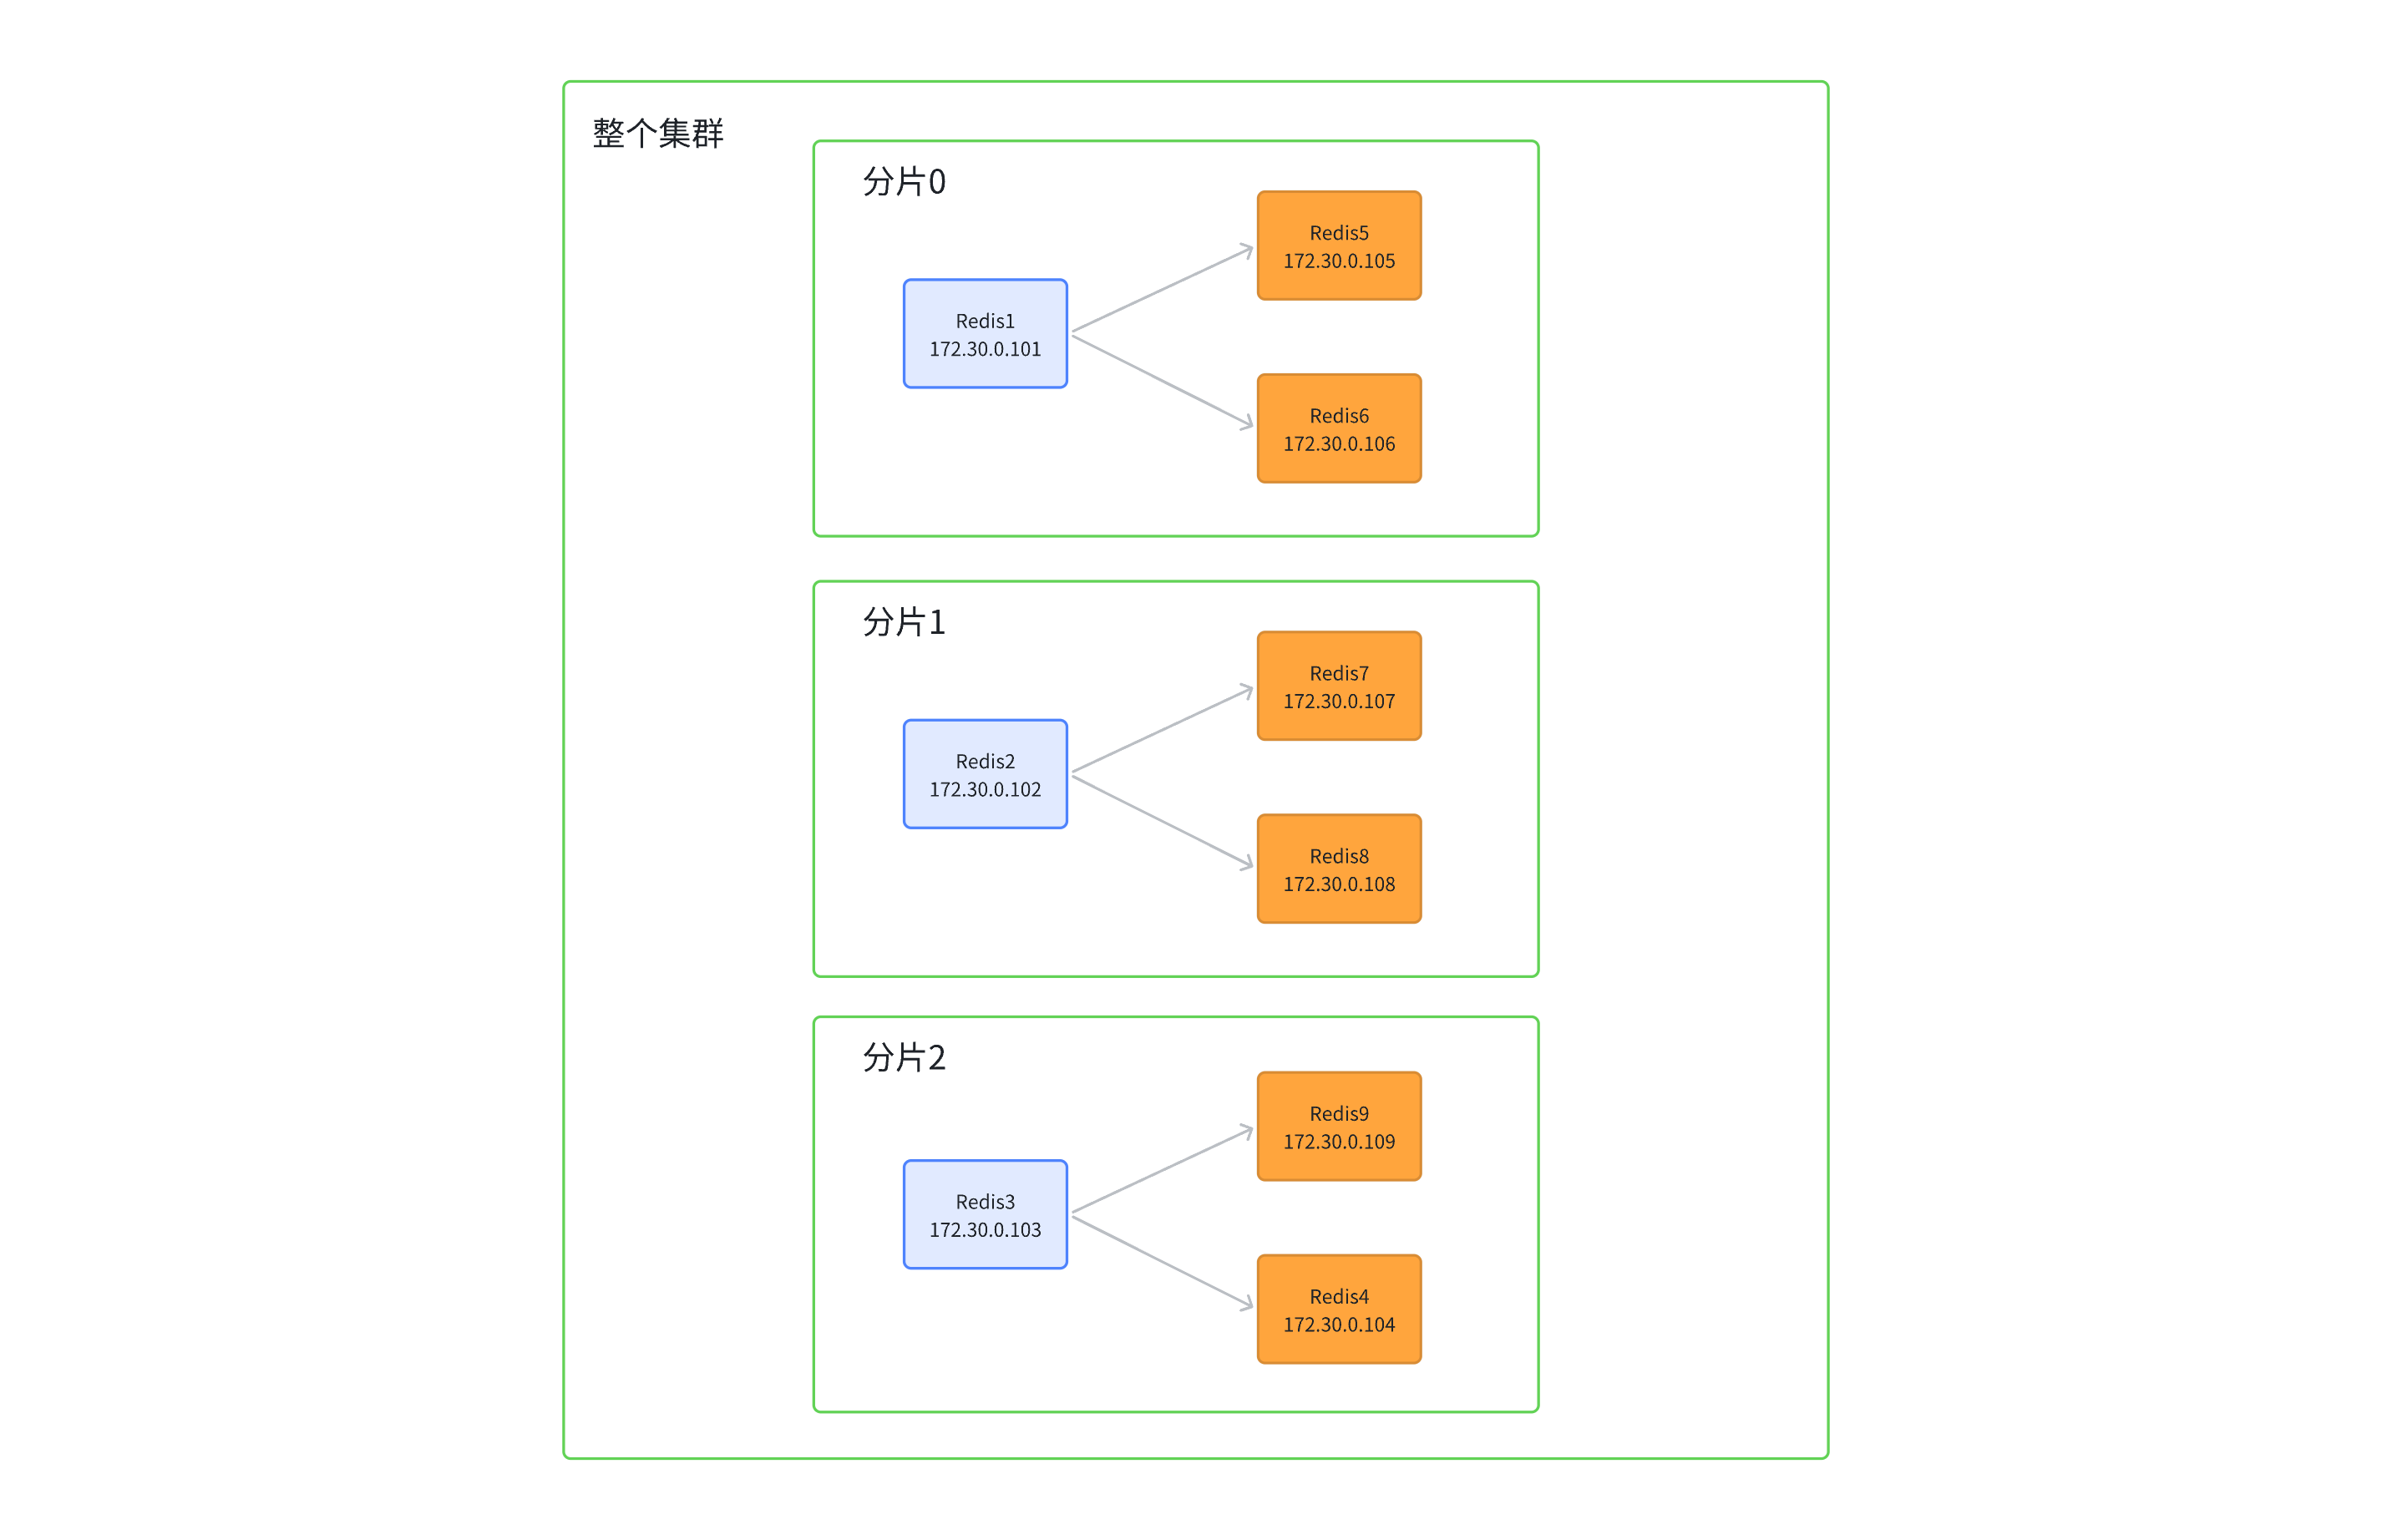
通过上图可以发现,每一个红框部分都保存1/3的数据,每部分可以称为是一个"分片",如果数据量持续增加,那么只需要增加更多的分片来解决即可。
(二).数据分片算法
目前来说,有三种主流的分片算法分别为1.哈希求余 2.一致性哈希算法 3.哈希槽分区算法
1.哈希求余
哈希求余算法,借助了hash函数,把一个key映射到整数,在针对数组的长度进行求余,就可以得到一个数组的下标。
例如,现在有3个分片,即N=3。此时就可以针对要插入的key计算hash,再把这个hash值余上分片的个数,然后就得到了一个下标,此时,这个数据就放到对应的分片中了 hash(key) % N
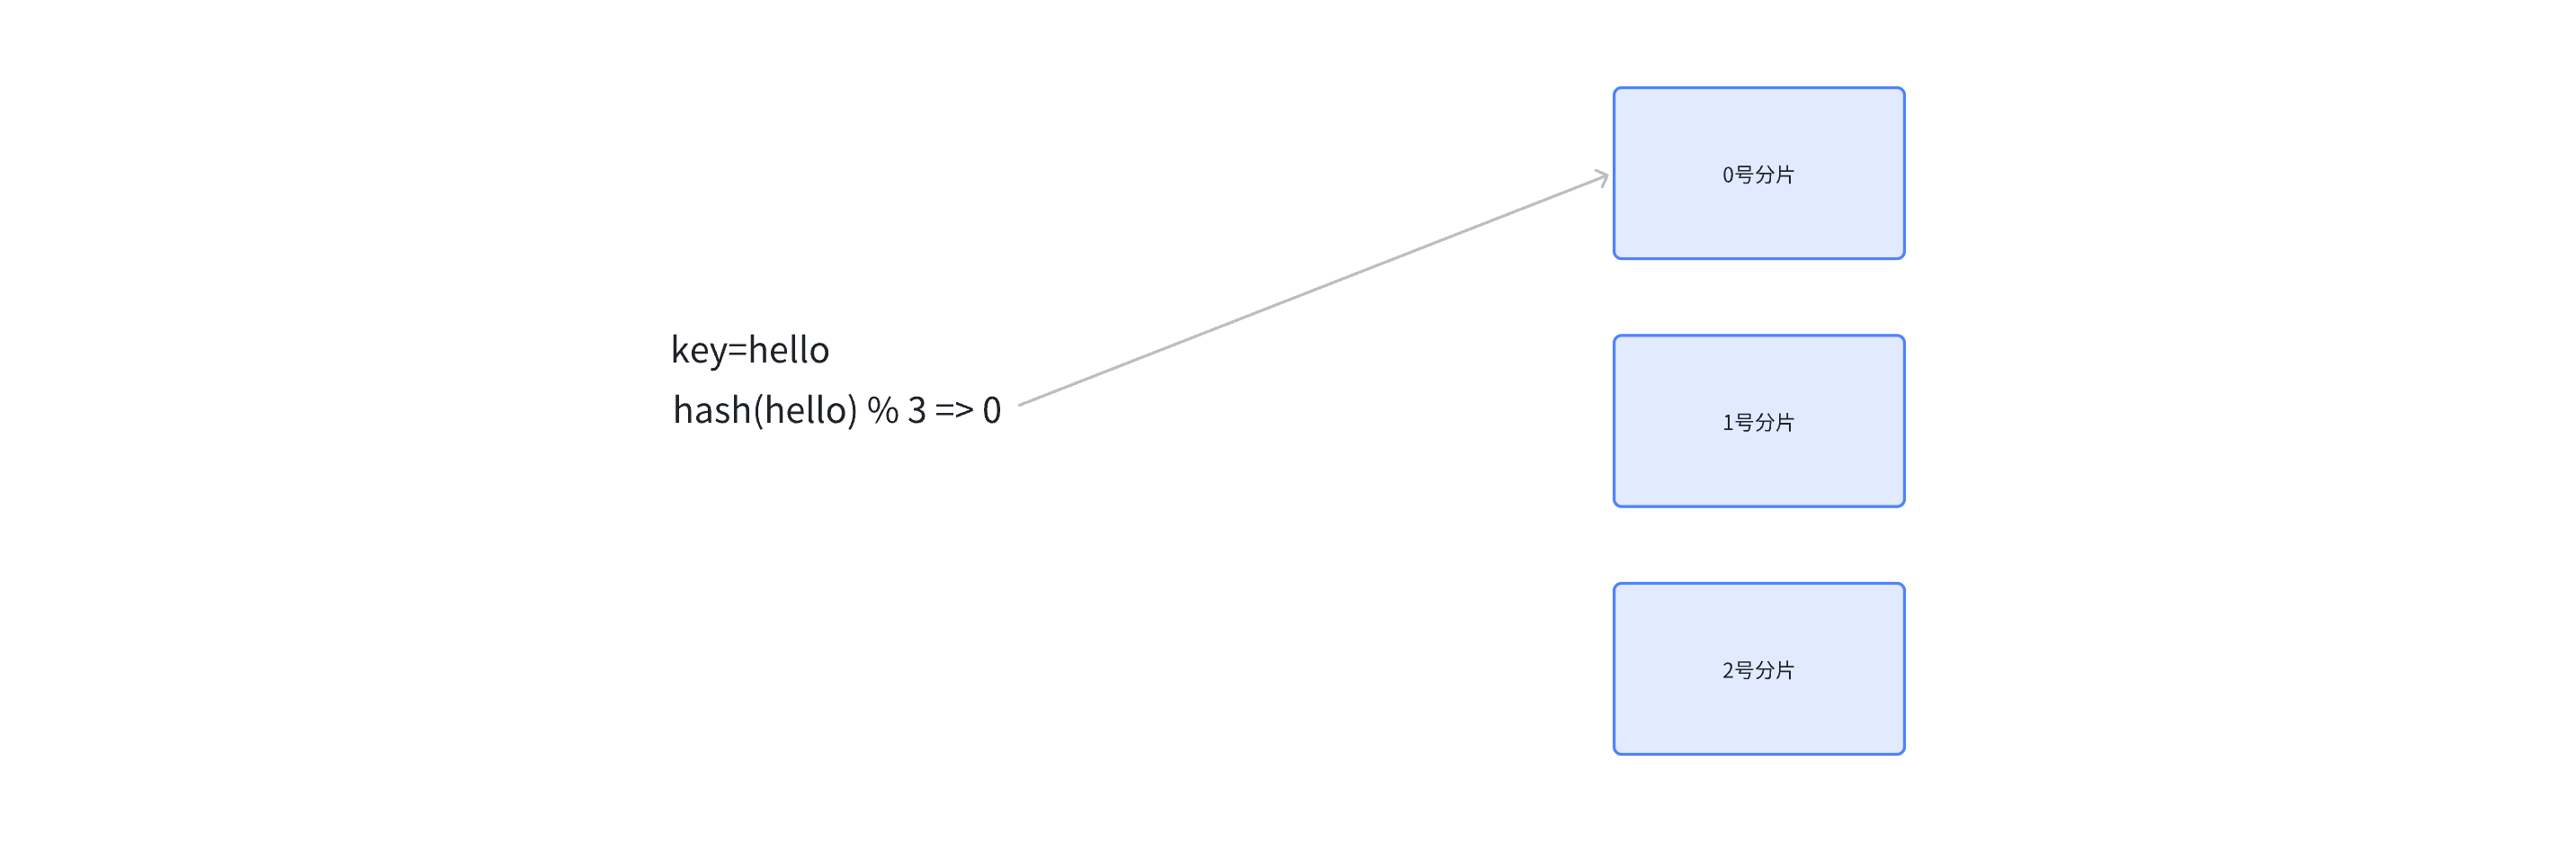
优点:简单高效,数据分配均匀
缺点:一旦进行了扩容,增加新分片,那么N就变了,原来的映射规则就被破坏,此时节点的数据需要重新排列来满足新的映射规则,开销比较大
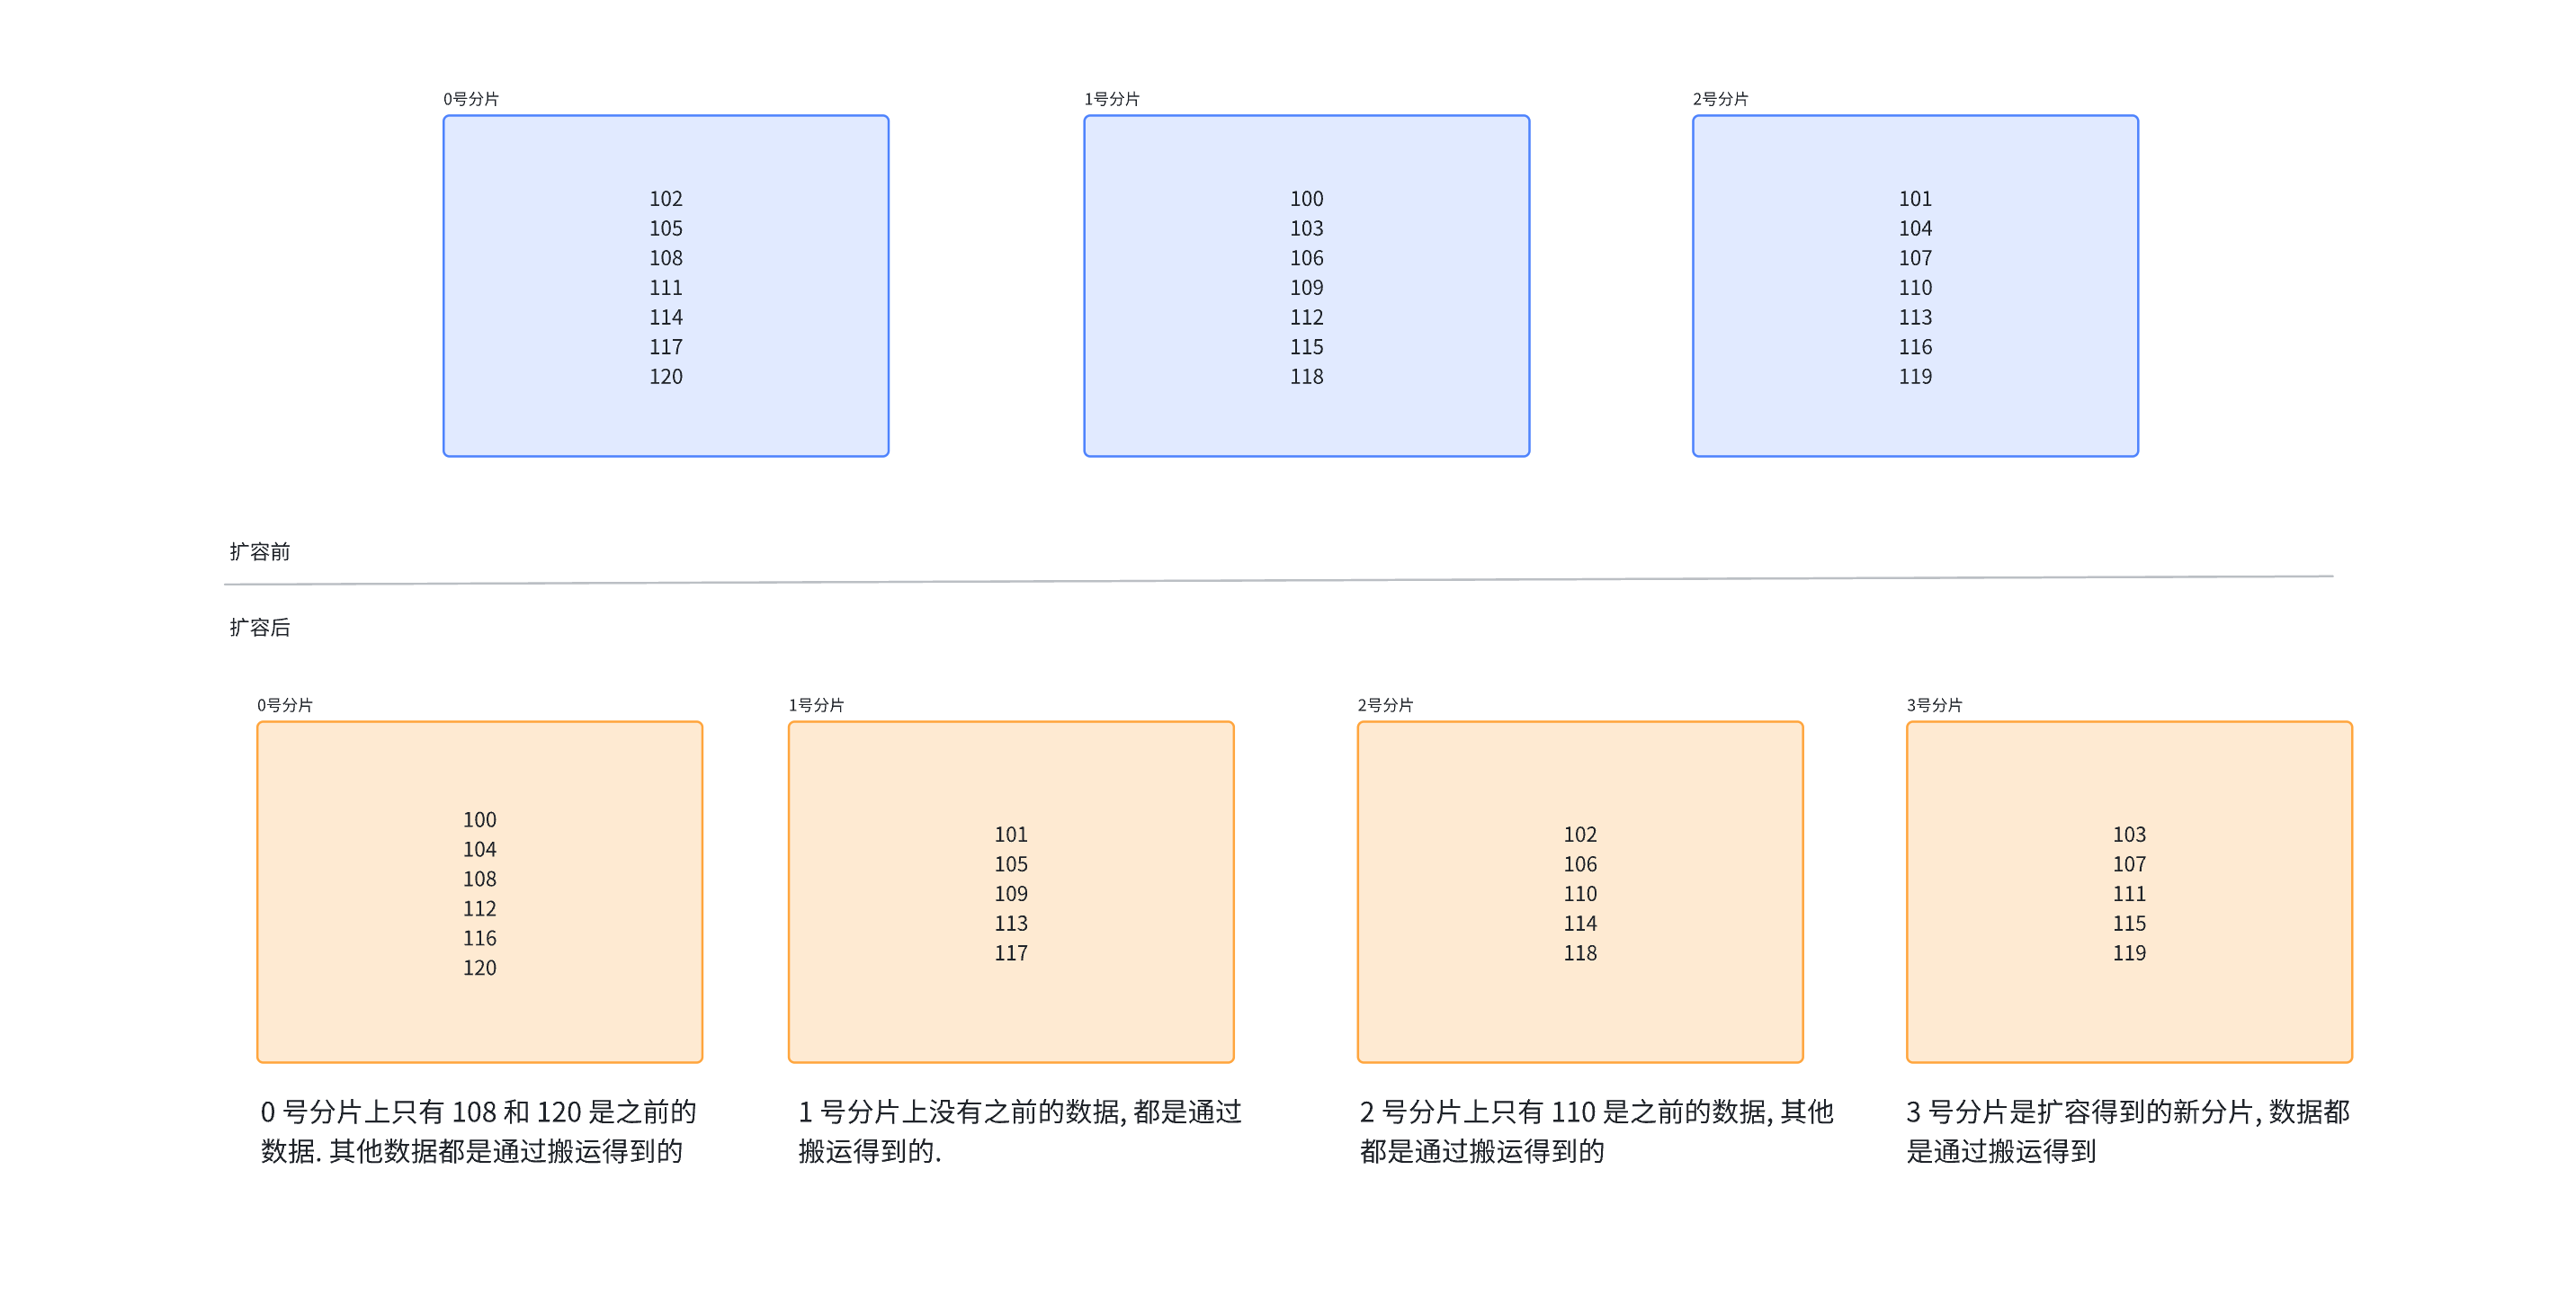
如上图,一共有21个key,只有3个是没有经过搬运的,其他的key都没有进行搬运
2.一致性哈希算法
在哈希求余这种操作中,当前key是属于哪个分片是通过分片的个数来交替的,但是一致性哈希算法把交替出现改成了连续出现
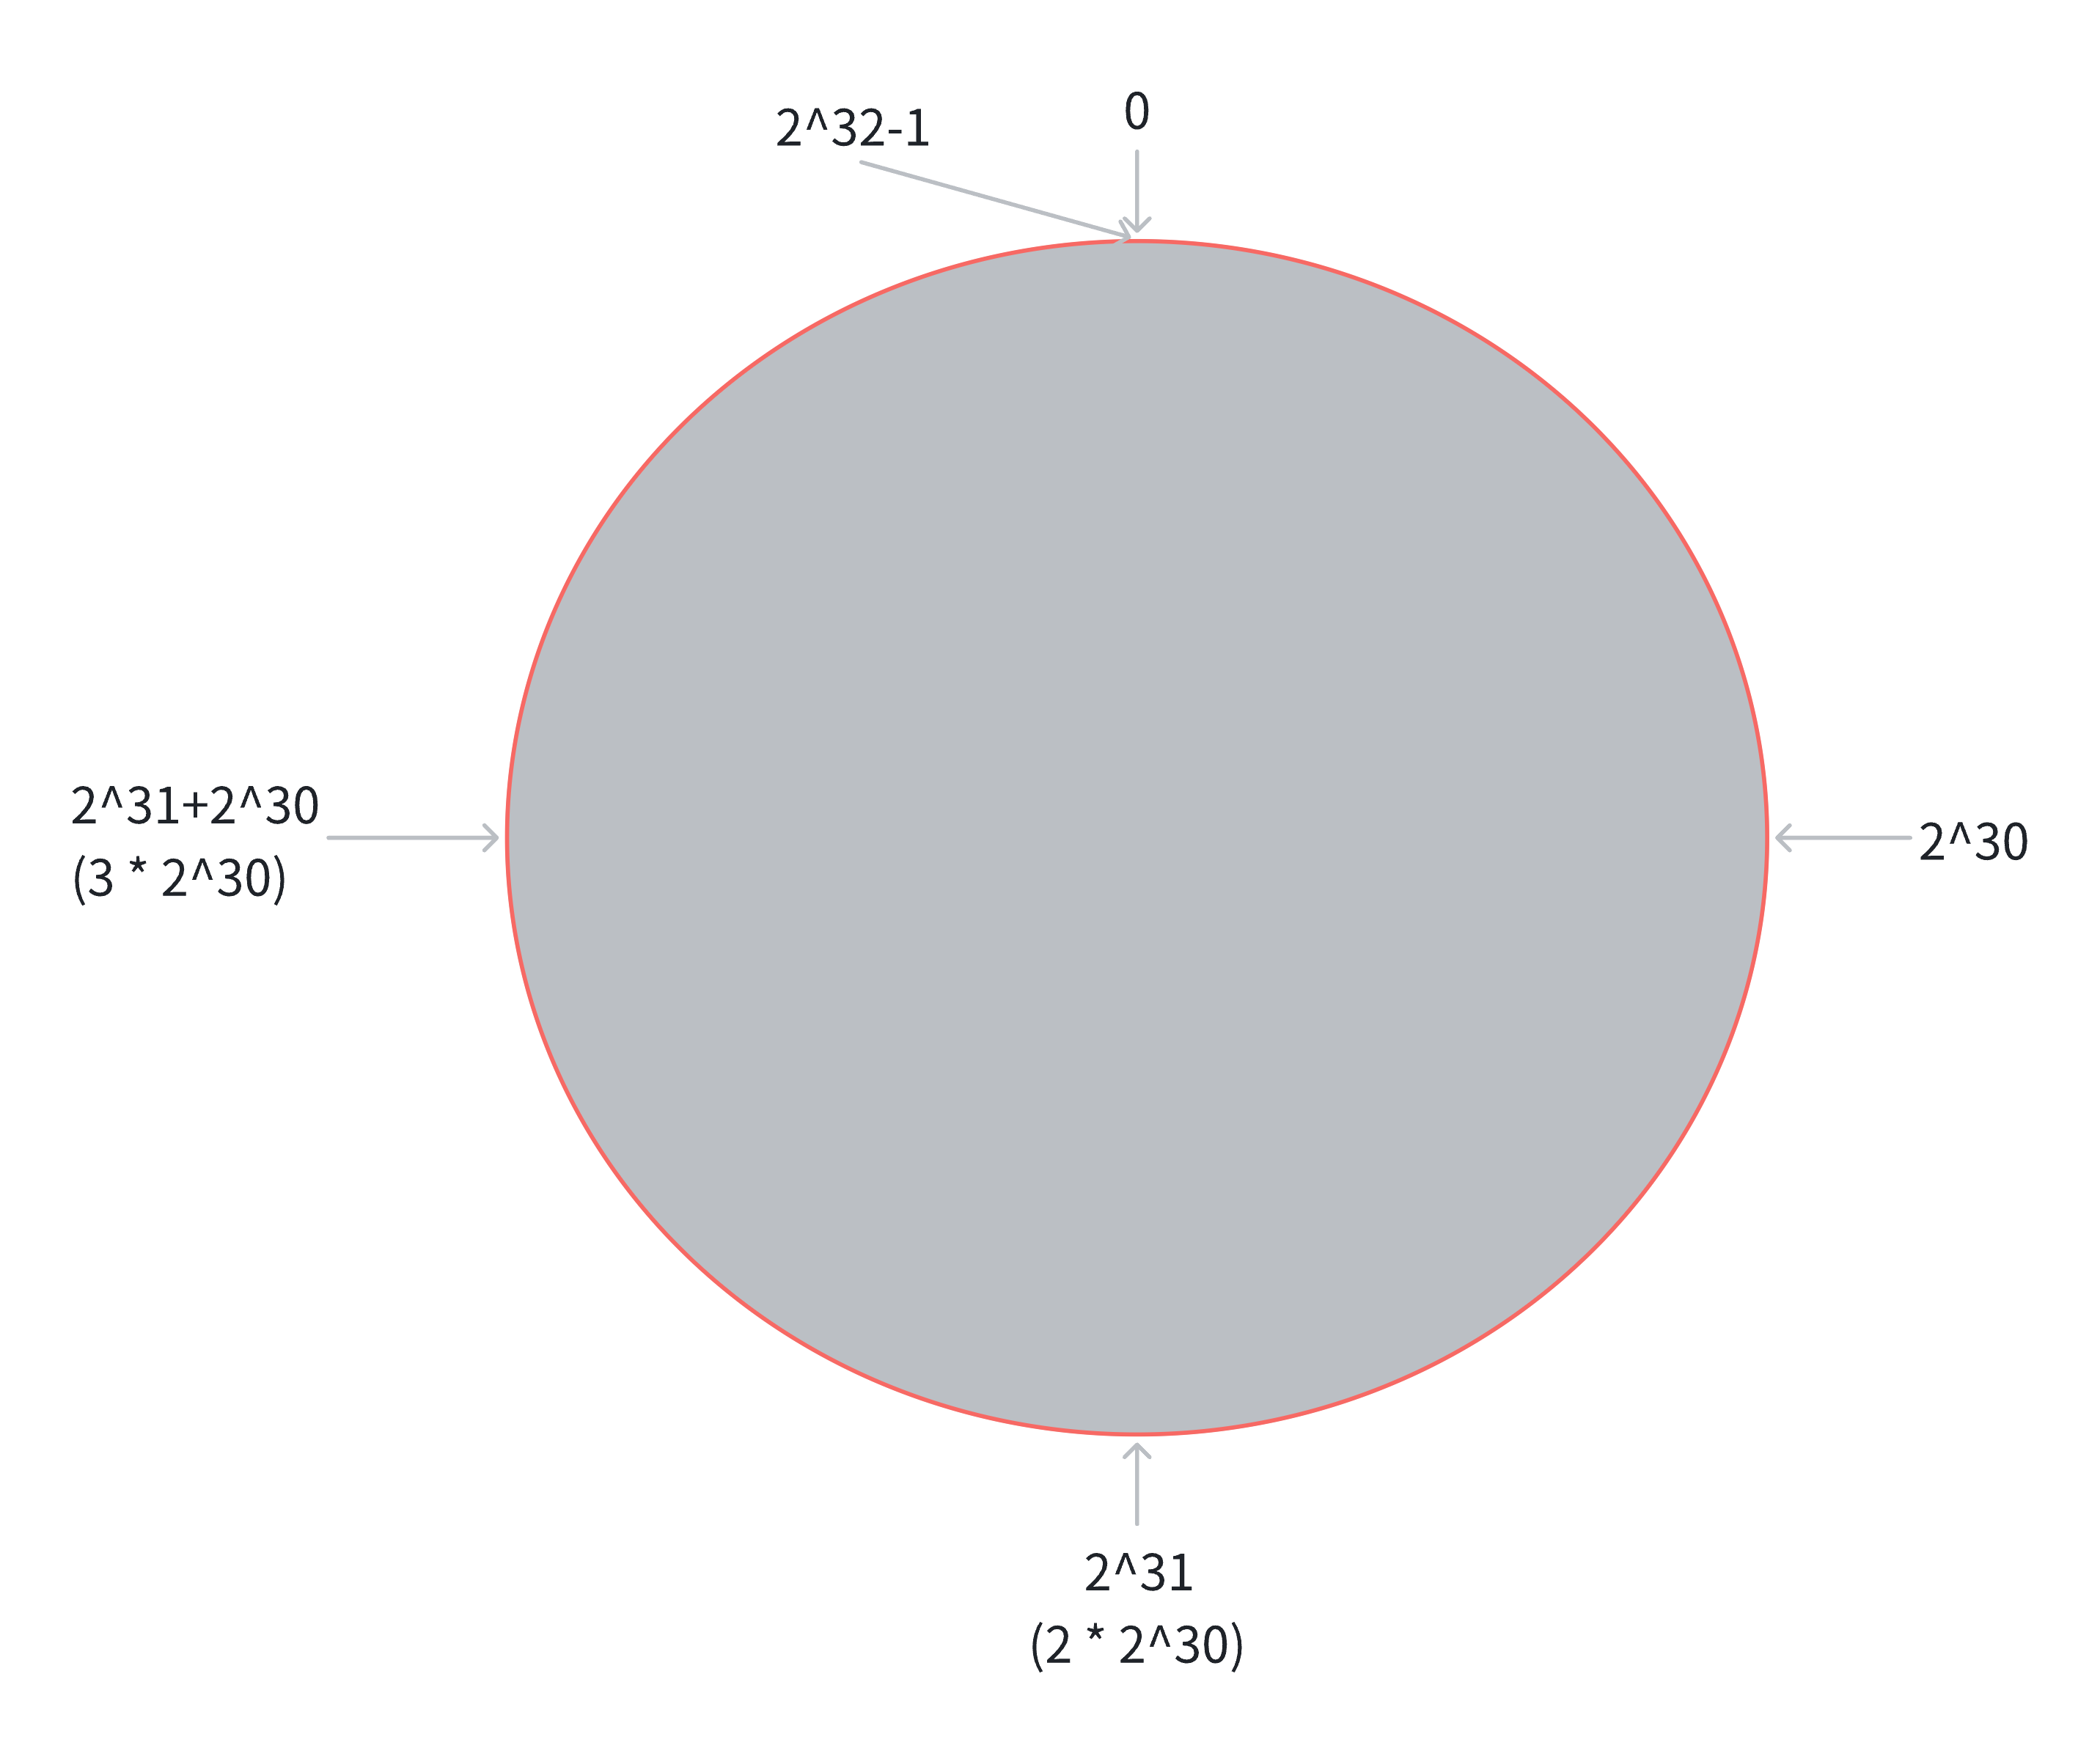
①.把 0 ~ 2 ^32-1这个数据空间,映射到一个圆环上,数据按照顺时针方向增长。
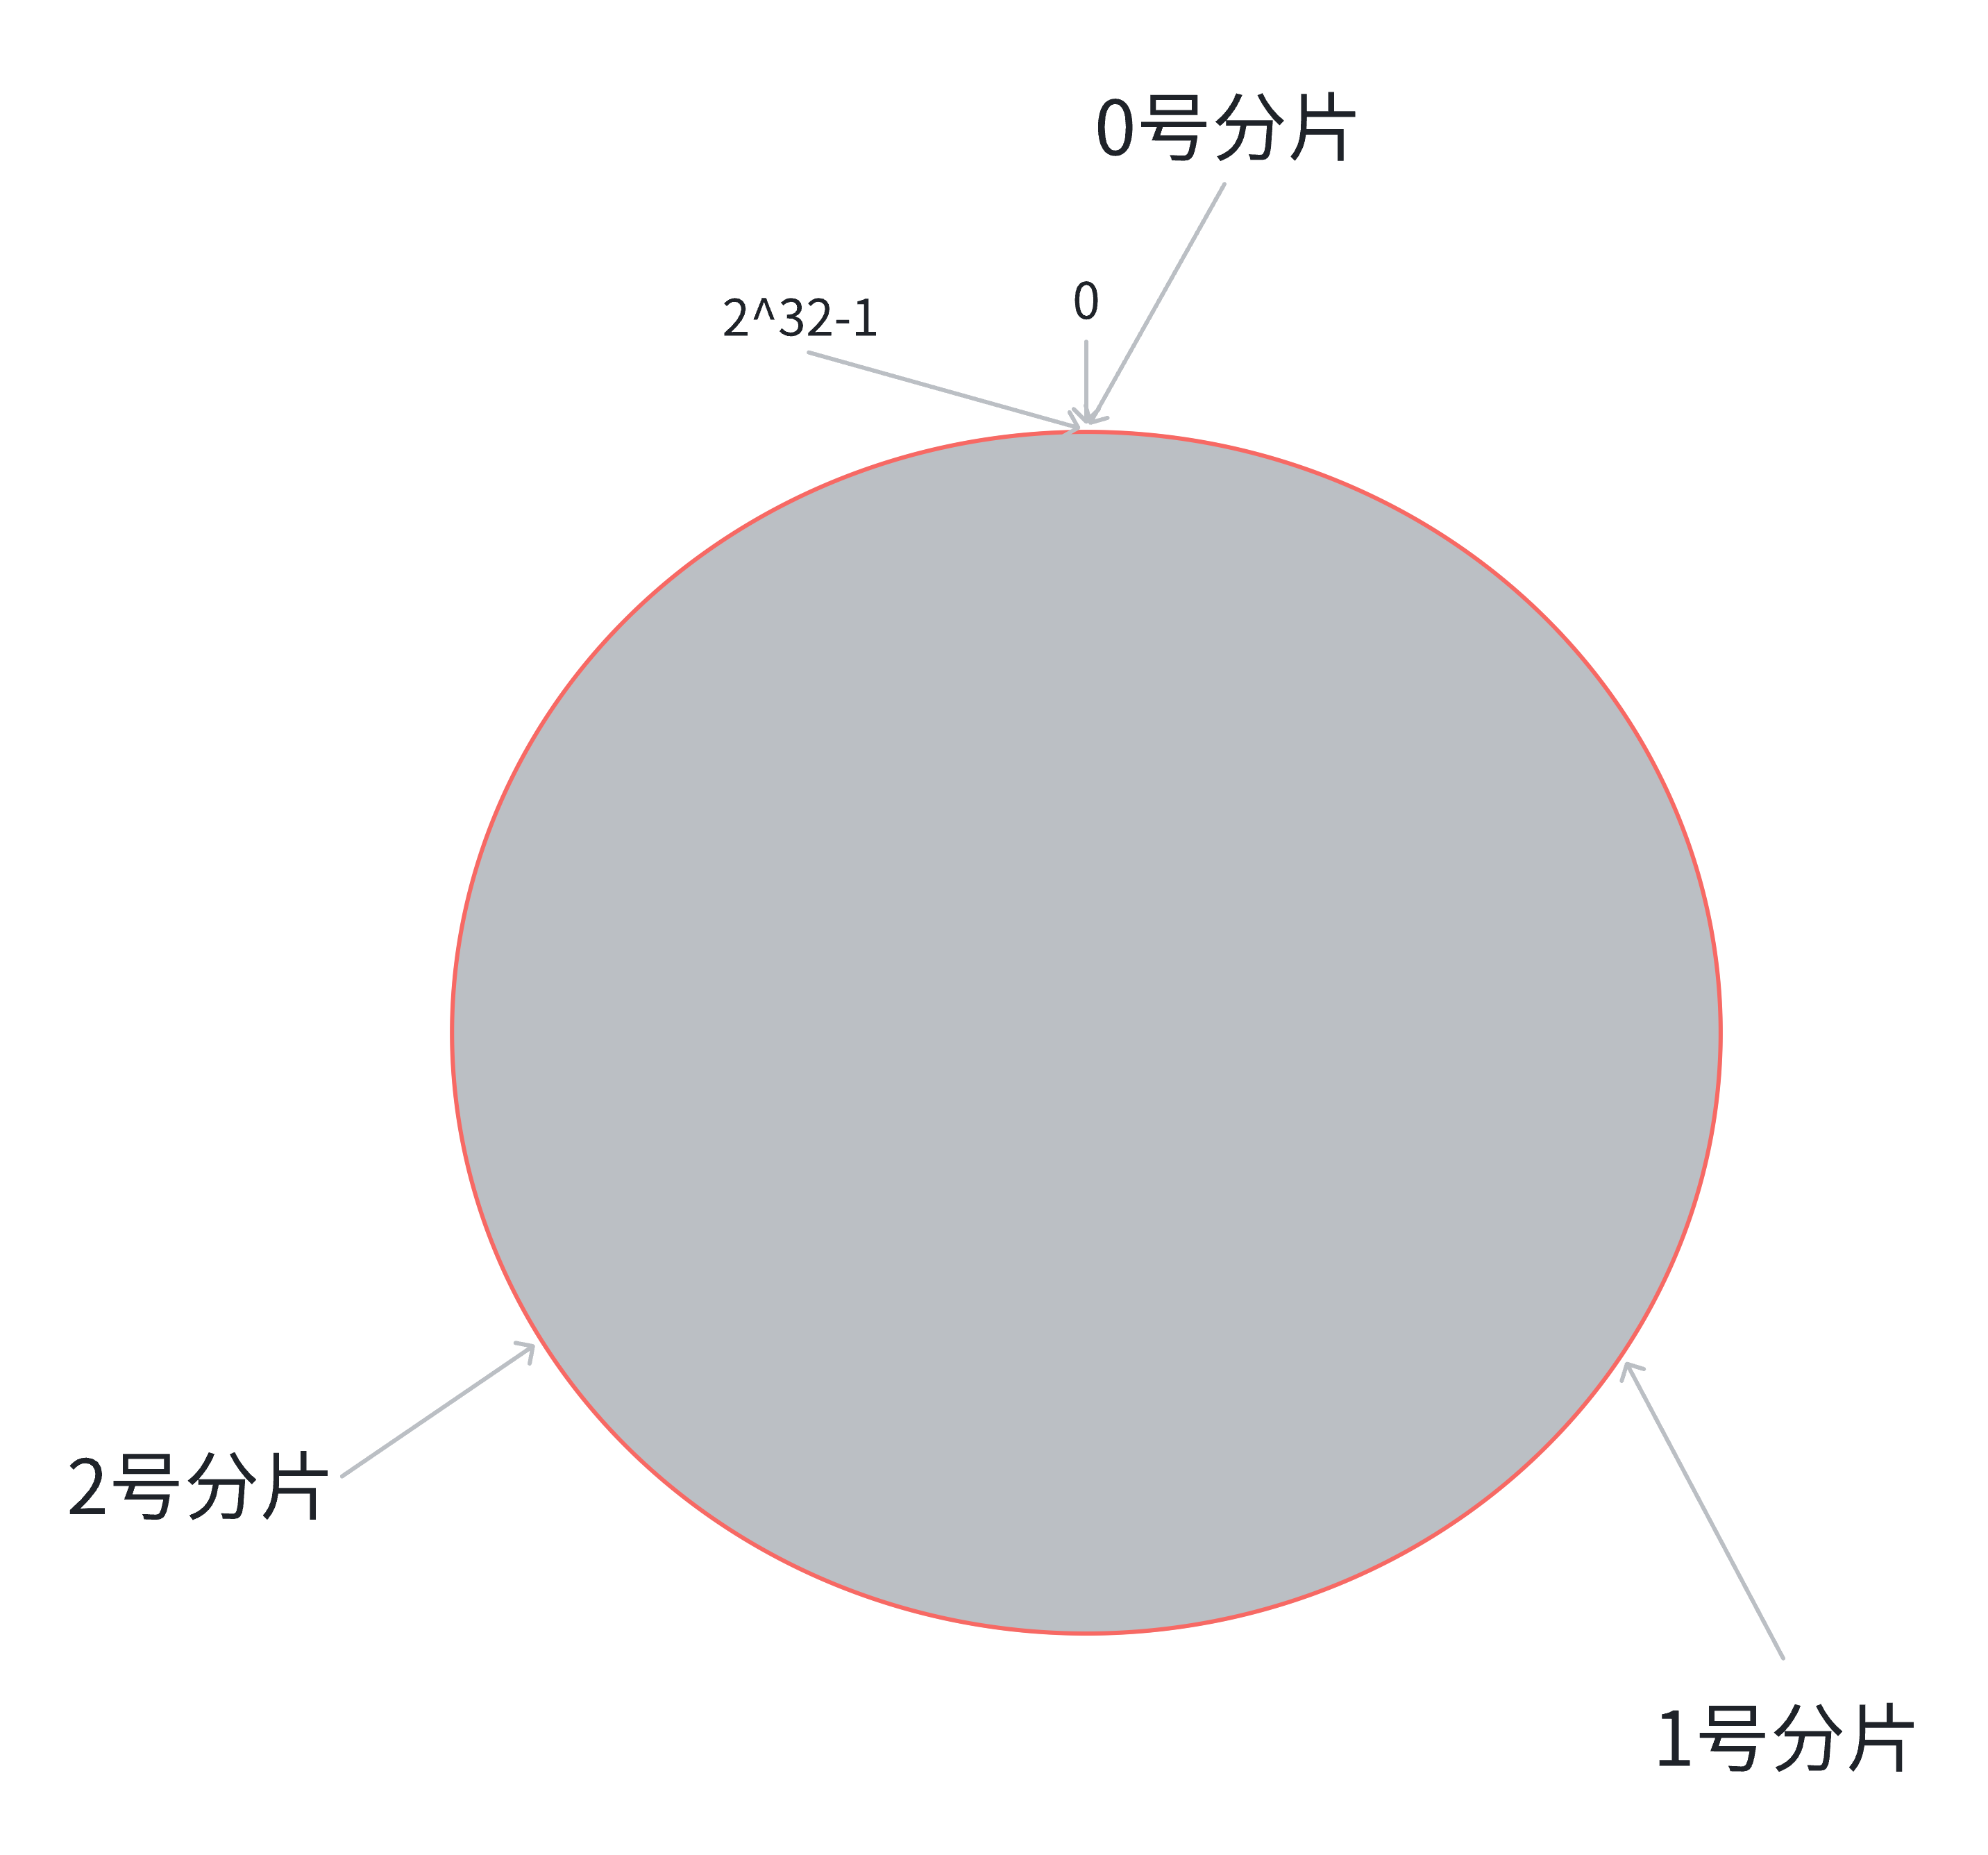
②.假设当前存在3个分片,就把分片放到圆环的某个位置上
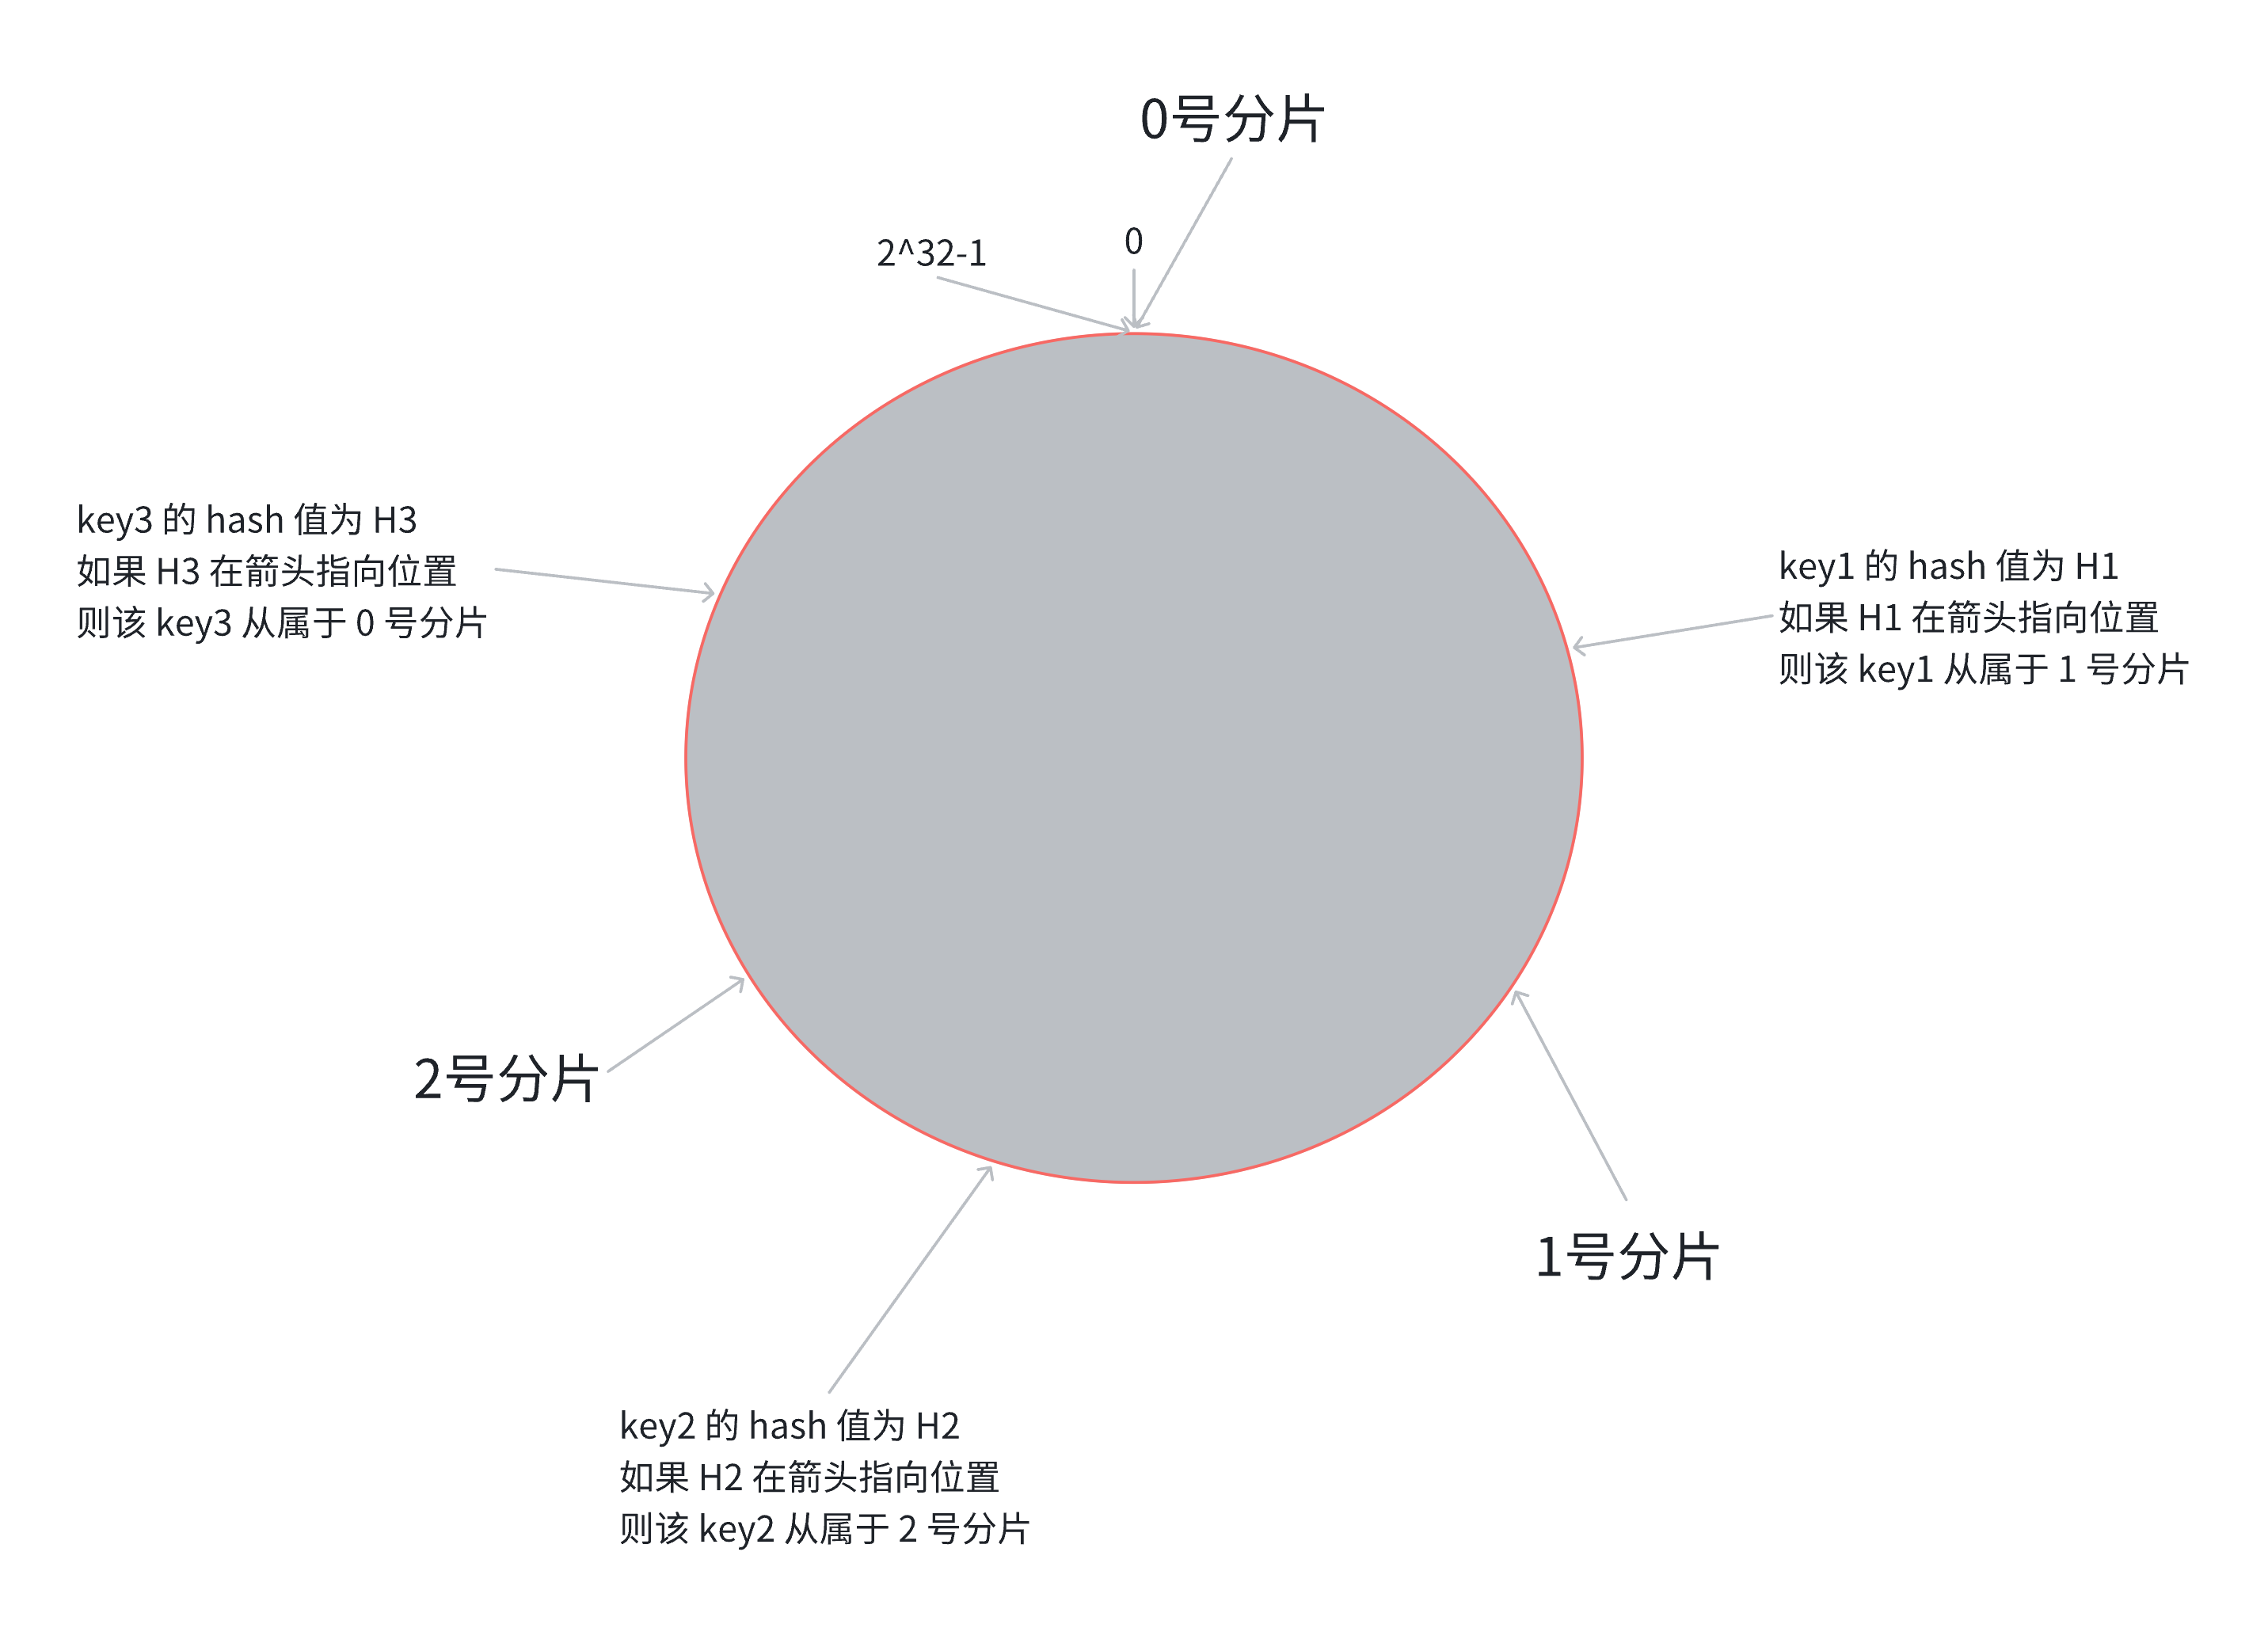
③.根据key计算哈希值,然后从会选择所在的位置顺时针向下找,找到的第一个分片,就是key所从属的分片
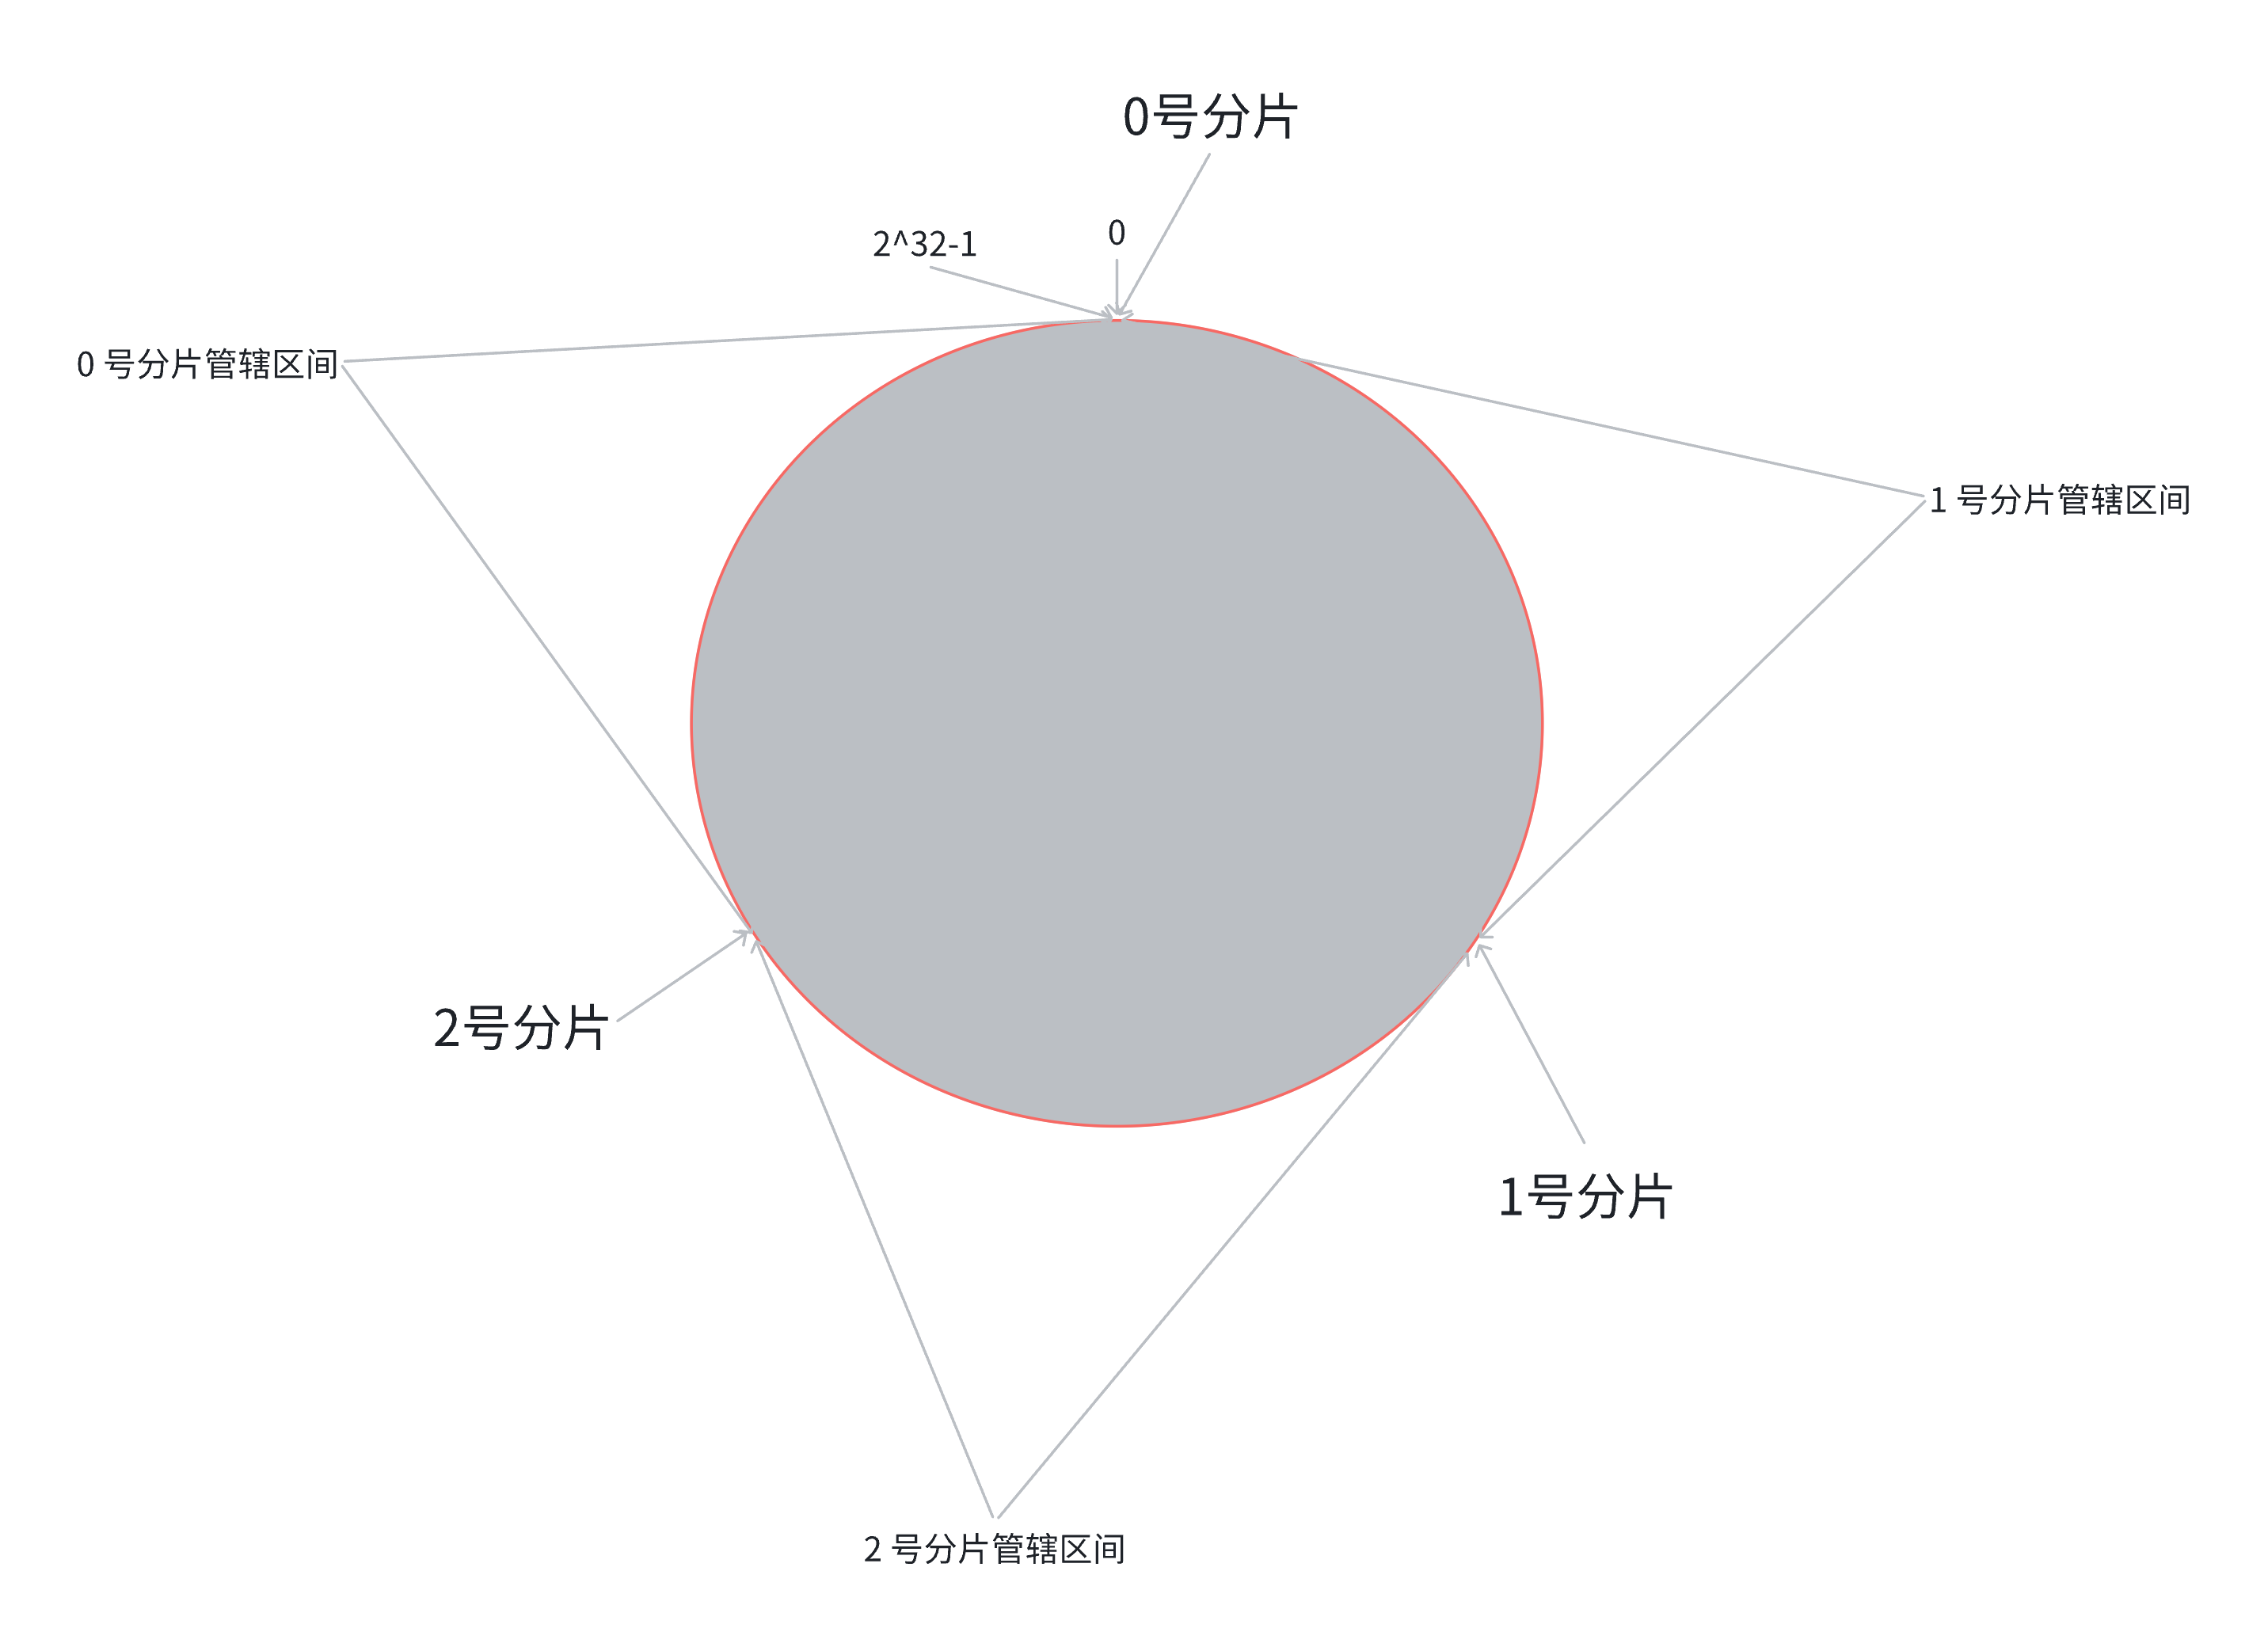
这就相当于,N个分片的位置,把整个圆环分成了N个管辖区间。Key的hash值在某个区间内,就归对应的区间管理
如果进行扩容,此时,原有分片在环上的位置不动,只需要在环上新安排一个分片的位置即可
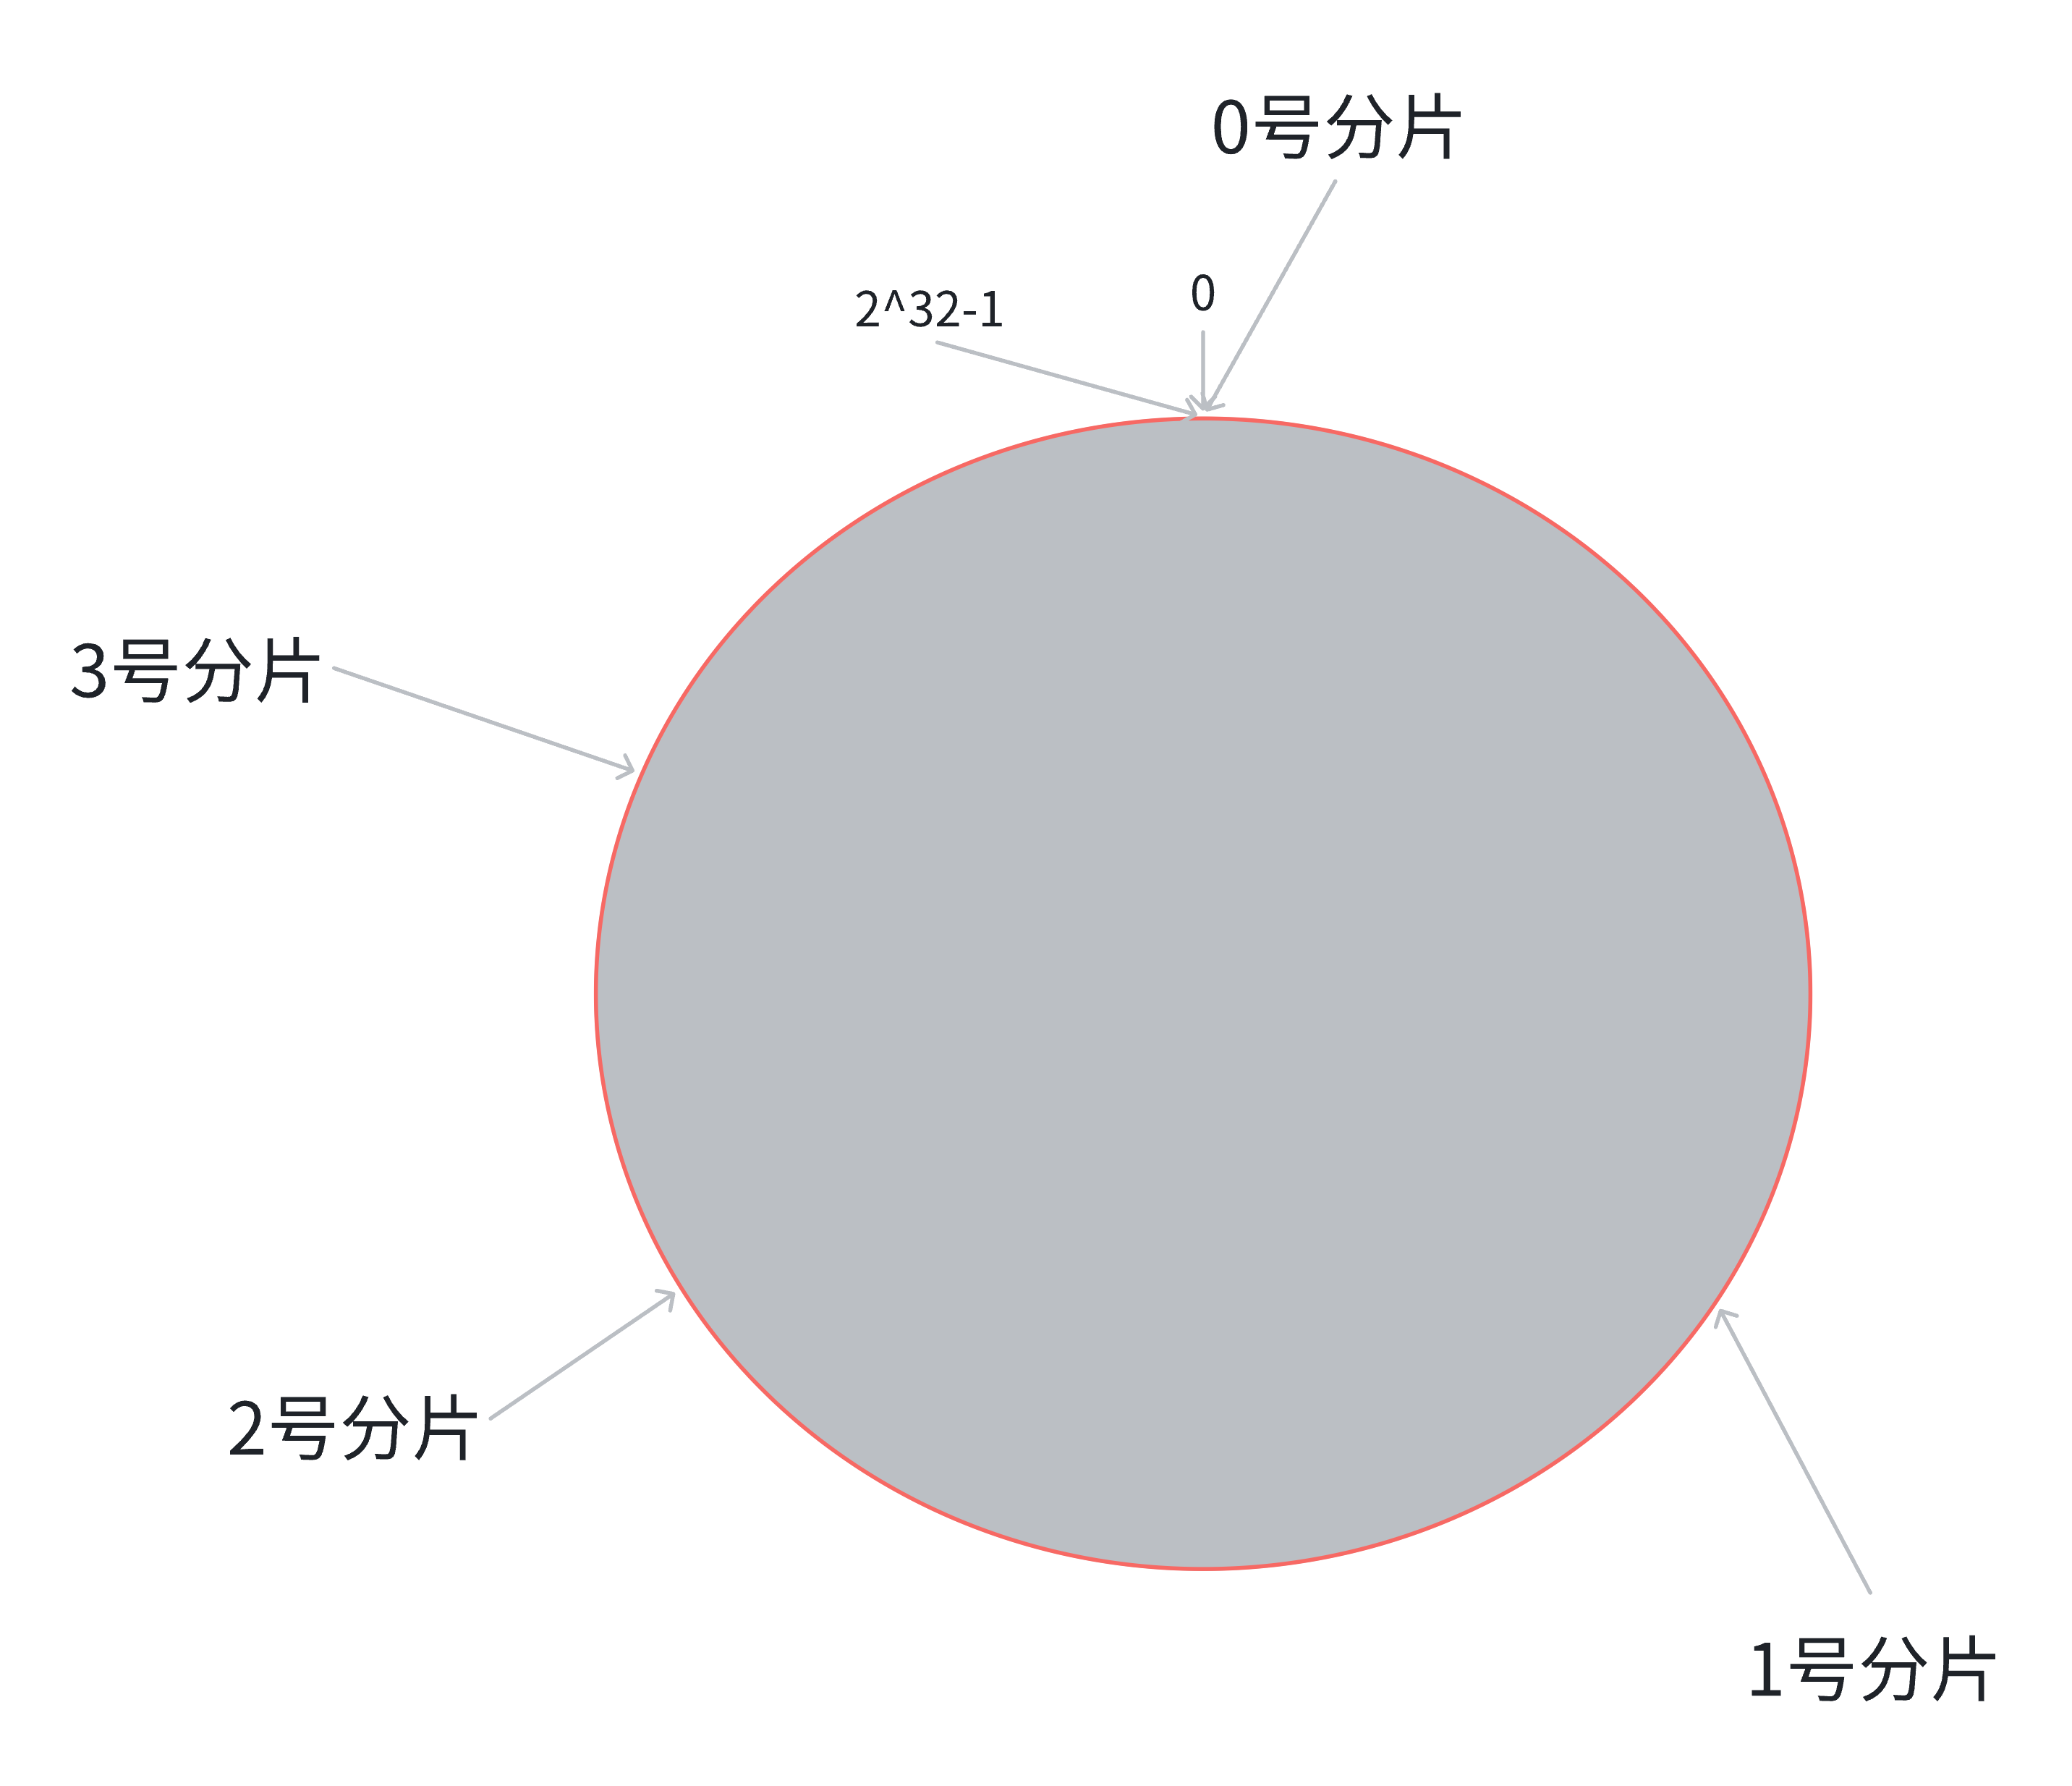
此时,只需要把0号分片上的部分数据搬运给3号分片即可。1号和2号分片管理的区间都是不变的。
优点:大大降低了扩容时数据搬运的规模,提高了扩容操作的效率
缺点:数据分配不均匀,容易造成**"数据倾斜"**
3.哈希槽分区算法
哈希槽分区算法,是Redis Cluster引入的算法。
hash_slot = crc16(key) % 16384
crc16()也是一种哈希算法;16384=16*1024
这种算法,相当于把整个哈希值映射到了16384个槽位上,也就是0,16383。然后再把这些槽位比较均匀的分配给每个分片,每个分片的节点都需要记录自己持有哪些分片
假设现在有三个分片,一种可能的分配方式就是:
0 号分⽚: 0, 5461, 共 5462 个槽位
1 号分⽚: 5462, 10923, 共 5462 个槽位
2 号分⽚: 10924, 16383, 共 5460 个槽位
如果进行了扩容,例如,新增了3号分片,那么就可以针对原有的槽位进行重新分配,例如
0 号分⽚: 0, 4095, 共 4096 个槽位
1 号分⽚: 5462, 9557, 共 4096 个槽位
2 号分⽚: 10924, 15019, 共 4096 个槽位
3 号分⽚: 4096, 5461 + 9558, 10923 + 15019, 16383, 共 4096 个槽位
注意:分片的规则是很灵活的,每个分片持有的槽位也不一定连续。每个分片的节点使用位图来表示自己持有哪些槽位,对于16384(16384个bit位,用每一位的0/1来区分自己的分片当前是否持有该槽位号)个槽位来说,需要2048个字节,即2KB的内存空间来表示。
我们不需要手动指定哪些槽位分配给某个分片,只需要告诉某个分片应该持有多少个槽位即可,Redis会自动完成后续的槽位分配,以及对应的key的搬运工作
注意:分片并不一定是越多越好。Redis的作者建议集群的分片不应该超过1000。key需要先映射到槽位,再映射到分片,如果分片太多,就无法保证数据在各个分片上的均衡性。
注意:这里设置成16384个槽位的原因是,节点和节点之间是通过心跳包来进行通信的。心跳包中就包含了该节点持有那些slots。使用的是位图这样的数据结构来表示的,如果给定的slots(槽位)更多,例如 65535个,那么就需要耗费更多的空间,即8KB,站在网络心跳包的角度,这是一个非常吃网络带宽的操作。而且,本身16384这个值基本上够用了,同时占用的硬件资源的个数也不多
(三).基于docker进行集群搭建
下面,我们将基于docker来搭建一个集群
1.创建目录和配置

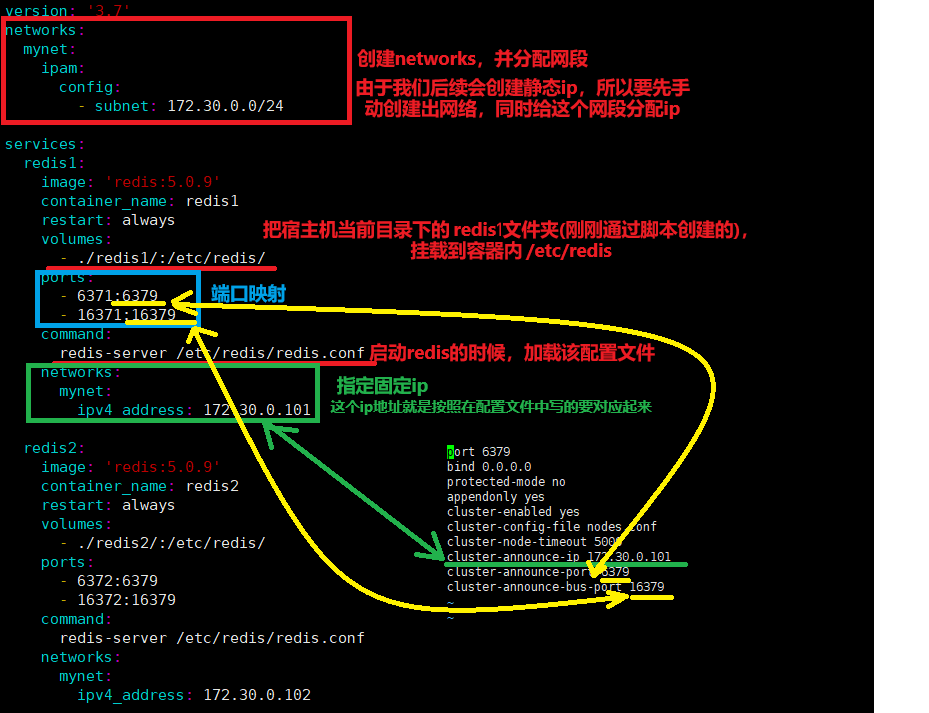
在redis-cluster文件夹中,我创建了一个.yml文件和一个.sh文件。我们使用docker-compose来进行容器的编排,所以创建了一个docker-compose.yml的配置文件,把具体的要创建的这些容器,每个容器运行的各种参数给描述清楚,然后通过一个命令,就能批量的启动和停止这些容器。
这个.sh文件是一个shell脚本。在linux环境下,我们通常都是采用命令行的方式进行操作。我们可以把这些命令写入到一个文件中,然后批量化的执行,同时也可以写入循环,条件,函数等机制。
这个集群环境,我们需要创建11个节点
有9个节点构成了3个分片,然后剩下的两个节点是用来扩容的
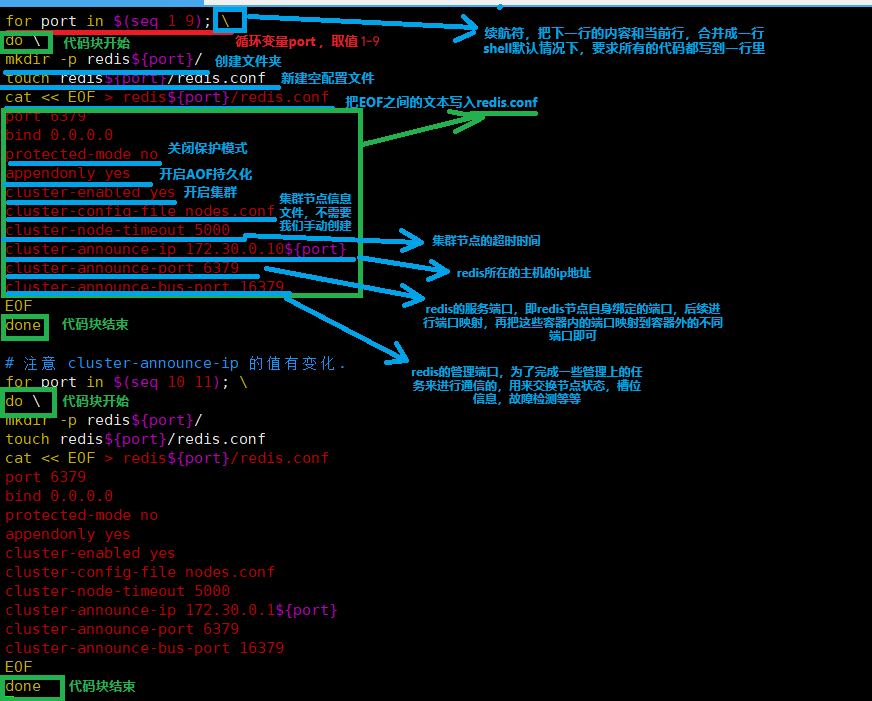
上图是shell脚本中的内容。我们可以通过bash generate.sh命令,来运行这个shell脚本

可以看到,所有的文件都创建出来了

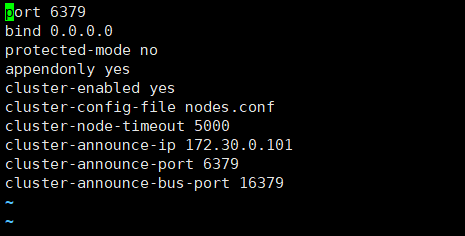
可以看到,配置文件中的内容正好是我们配置的
2.编写docker-compose.yml
version: '3.7'
networks:
  mynet:
    ipam:
      config:
        - subnet: 172.30.0.0/24

services:
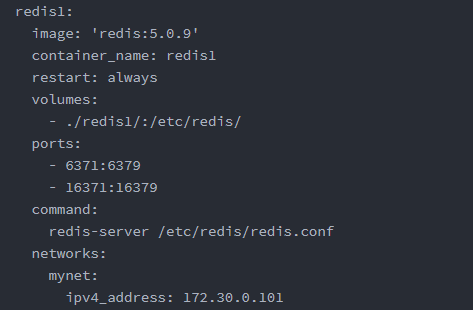
  redis1:
    image: 'redis:5.0.9'
    container_name: redis1
    restart: always
    volumes:
      - ./redis1/:/etc/redis/
    ports:
      - 6371:6379
      - 16371:16379
    command:
      redis-server /etc/redis/redis.conf
    networks:
      mynet:
        ipv4_address: 172.30.0.101

  redis2:
    image: 'redis:5.0.9'
    container_name: redis2
    restart: always
    volumes:
      - ./redis2/:/etc/redis/
    ports:
      - 6372:6379
      - 16372:16379
    command:
      redis-server /etc/redis/redis.conf
    networks:
      mynet:
        ipv4_address: 172.30.0.102

  redis3:
    image: 'redis:5.0.9'
    container_name: redis3
    restart: always
    volumes:
      - ./redis3/:/etc/redis/
    ports:
      - 6373:6379
      - 16373:16379
    command:
      redis-server /etc/redis/redis.conf
    networks:
      mynet:
        ipv4_address: 172.30.0.103

  redis4:
    image: 'redis:5.0.9'
    container_name: redis4
    restart: always
    volumes:
      - ./redis4/:/etc/redis/
    ports:
      - 6374:6379
      - 16374:16379
    command:
      redis-server /etc/redis/redis.conf
    networks:
      mynet:
        ipv4_address: 172.30.0.104

  redis5:
    image: 'redis:5.0.9'
    container_name: redis5
    restart: always
    volumes:
      - ./redis5/:/etc/redis/
    ports:
      - 6375:6379
      - 16375:16379
    command:
      redis-server /etc/redis/redis.conf
    networks:
      mynet:
        ipv4_address: 172.30.0.105

  redis6:
    image: 'redis:5.0.9'
    container_name: redis6
    restart: always
    volumes:
      - ./redis6/:/etc/redis/
    ports:
      - 6376:6379
      - 16376:16379
    command:
      redis-server /etc/redis/redis.conf
    networks:
      mynet:
        ipv4_address: 172.30.0.106

  redis7:
    image: 'redis:5.0.9'
    container_name: redis7
    restart: always
    volumes:
      - ./redis7/:/etc/redis/
    ports:
      - 6377:6379
      - 16377:16379
    command:
      redis-server /etc/redis/redis.conf
    networks:
      mynet:
        ipv4_address: 172.30.0.107

  redis8:
    image: 'redis:5.0.9'
    container_name: redis8
    restart: always
    volumes:
      - ./redis8/:/etc/redis/
    ports:
      - 6378:6379
      - 16378:16379
    command:
      redis-server /etc/redis/redis.conf
    networks:
      mynet:
        ipv4_address: 172.30.0.108

  redis9:
    image: 'redis:5.0.9'
    container_name: redis9
    restart: always
    volumes:
      - ./redis9/:/etc/redis/
    ports:
      - 6379:6379
      - 16379:16379
    command:
      redis-server /etc/redis/redis.conf
    networks:
      mynet:
        ipv4_address: 172.30.0.109

  redis10:
    image: 'redis:5.0.9'
    container_name: redis10
    restart: always
    volumes:
      - ./redis10/:/etc/redis/
    ports:
      - 6380:6379
      - 16380:16379
    command:
      redis-server /etc/redis/redis.conf
    networks:
      mynet:
        ipv4_address: 172.30.0.110

  redis11:
    image: 'redis:5.0.9'
    container_name: redis11
    restart: always
    volumes:
      - ./redis11/:/etc/redis/
    ports:
      - 6381:6379
      - 16381:16379
    command:
      redis-server /etc/redis/redis.conf
    networks:
      mynet:
        ipv4_address: 172.30.0.111
上面是我yml文件中的内容
3.启动容器
通过 docker-compose up -d 启动容器
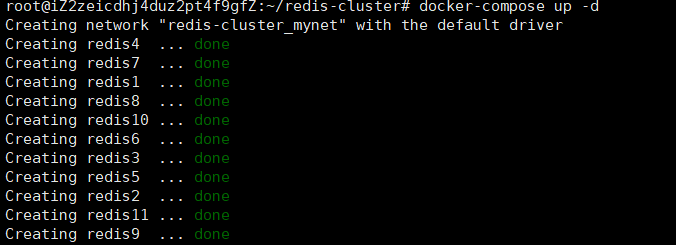
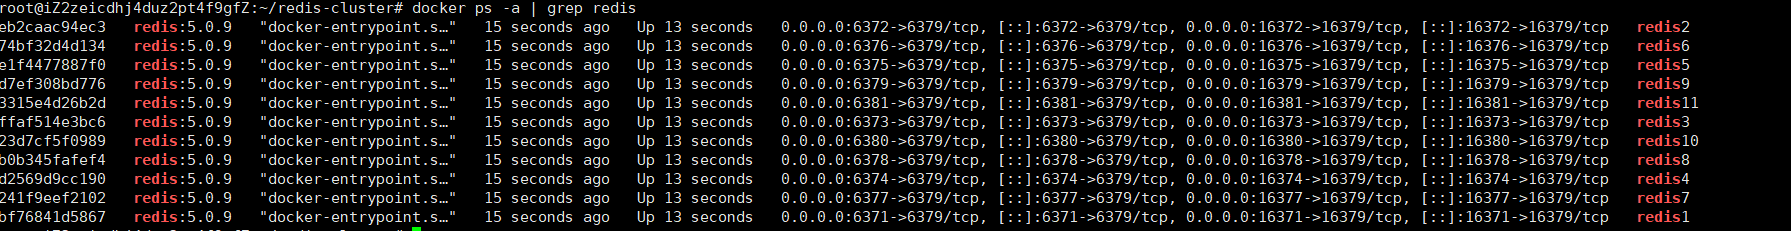
可以发现,所有的容器都已经启动了
4.构建集群
这里,我们是把前9个主机构成集群,3主6从,剩下的那两个作为扩容用,目前先不用

这样配置设置成了之后,redis就知道了,3个节点是一伙的,即一个分片,一共9个节点,即3个分片。命令直接在在命令行中执行即可
我们可以通过 cluster nodes来查看当前集群的信息
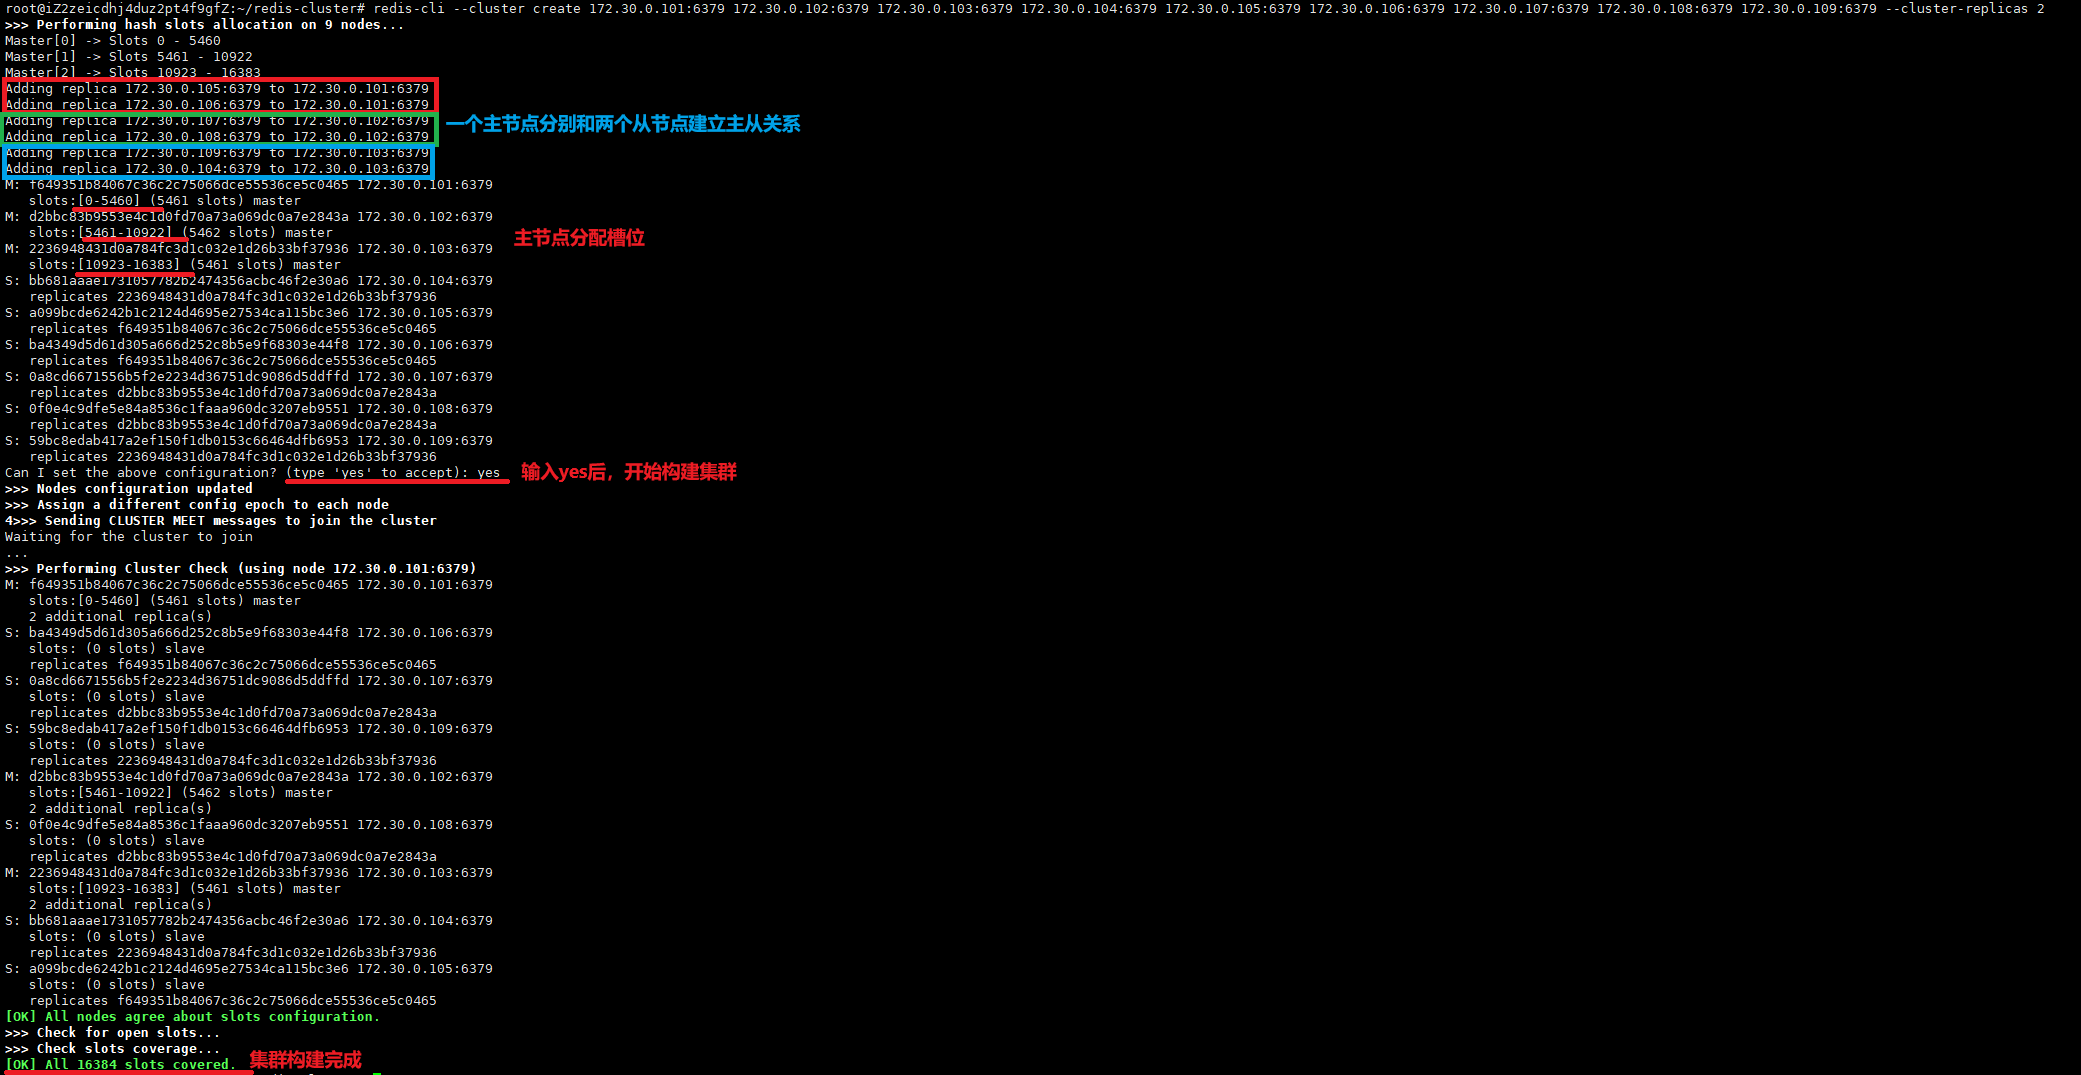
此时,我们可以连接上任何一个redis服务了
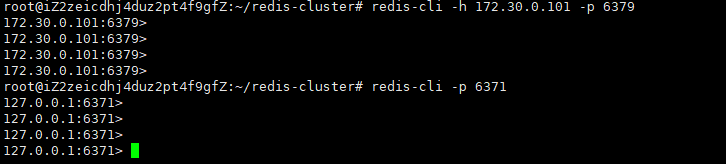
我们可以同通过两种方式来连接。第一种是通过容器内网IP进行访问;第二种是通过宿主机端口映射访问。这也是我们之前配置的端口映射
同时,我们可以通过cluster nodes命令,来查看当前集群的信息
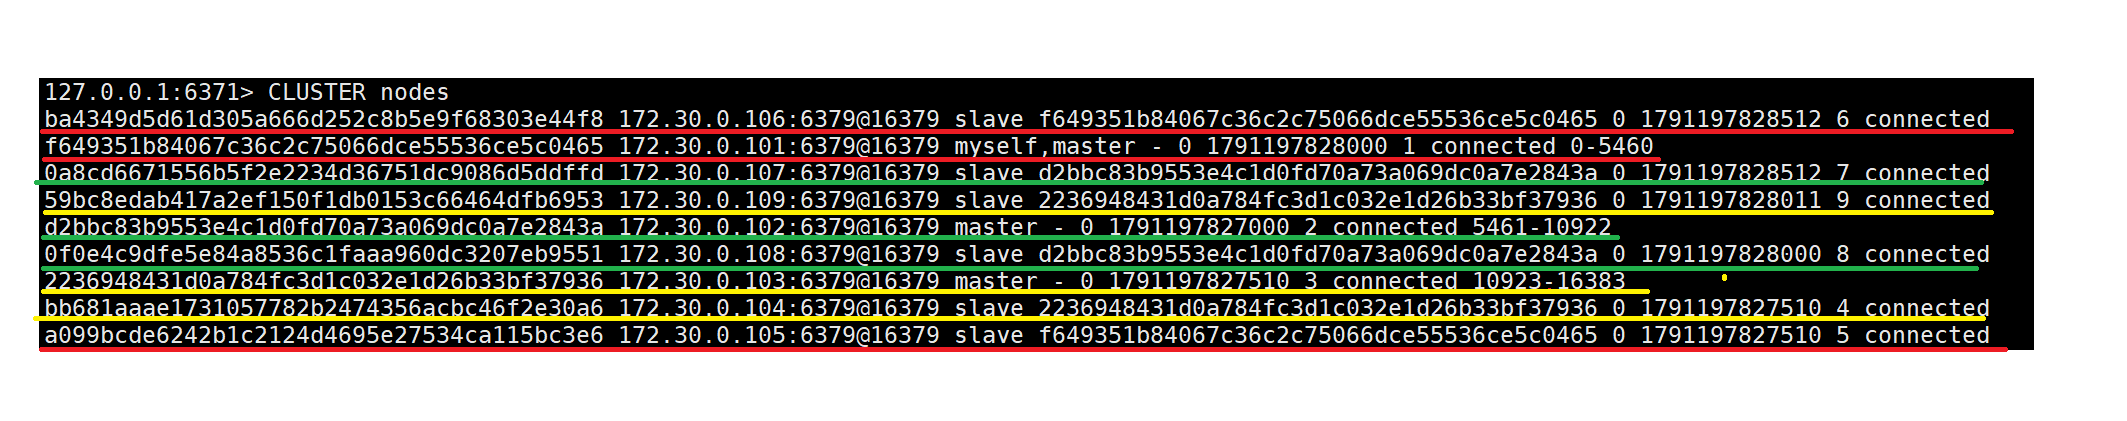
注意:目前来说,我们的集群已经设置好了,当前再存放数据就可以成功完成分片了。

但是,当我们运行程序的时候,发现,好像出错了。这是因为,"key111" 这个 key 通过hash计算之后,得到的槽位为13680,属于172.30.0.103这个分片,我们无法在172.30.0.101这个分片上存储
我们可以在启动redis-cli的时候,加上 -c选项。加上-c选项之后,即使当前的key不在当前分片上,也能够自己重定向到对应的分片主机上
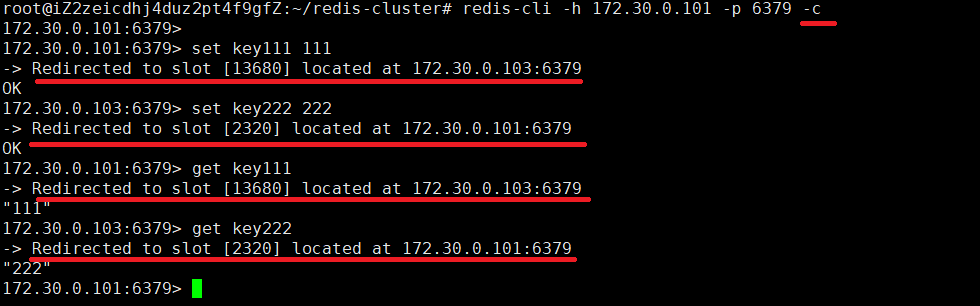
可以看到,已经自己重定向到对应的分片主机上。-c 添加完成之后,客户端会根据当前key实际算出来的槽位号,自动找到匹配的分片主机。
注意:目前来看,我们是可以正常使用的。但是一旦使用了一些操作多个key的命令,并且这多个key是分散在不同的分片上,就可能会出现问题。

解决上面的问题,可以采取hash tag的方式来解决。
(四).主节点挂了
1.演示

我现在将redis1这个主节点停掉,然后再来看当前的集群信息
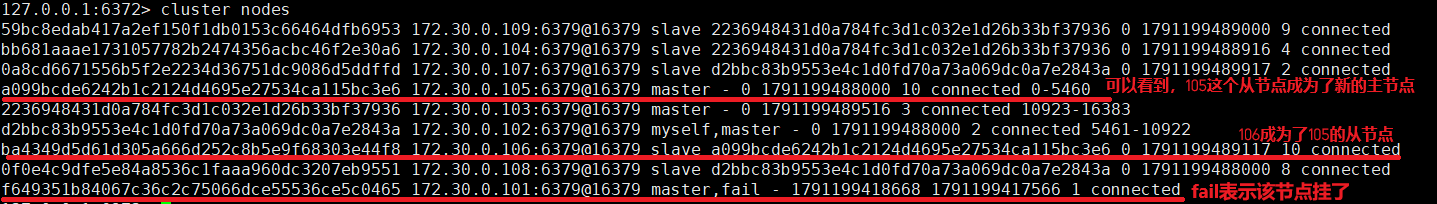
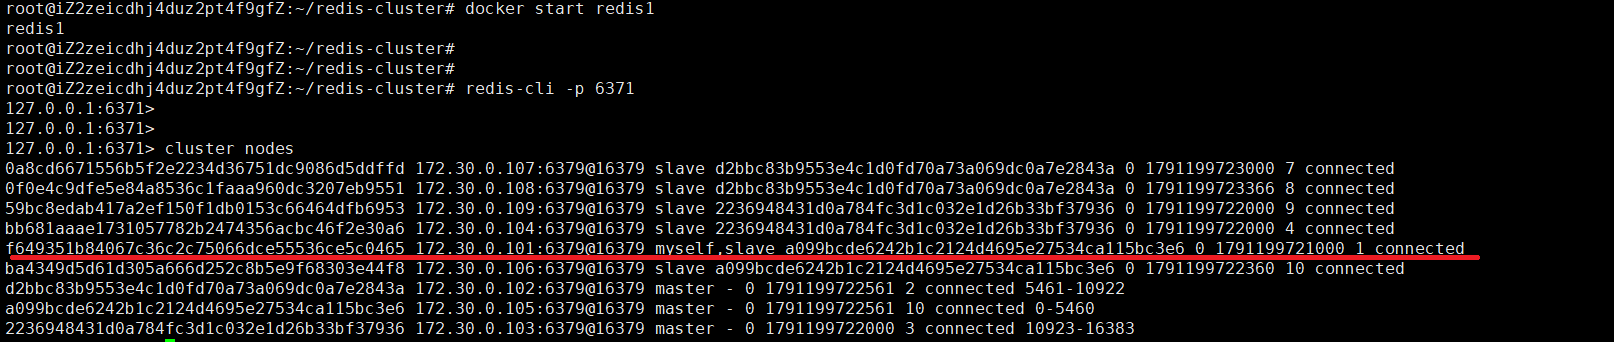
即使我将redis1重启了,依然是一个从节点。我们可以通过cluster failover 命令 对集群进行恢复,把101 重新设置为master
2.具体的执行流程
(1).故障判定
集群中的所有节点都是通过周期性的心跳包来进行通信的
①.节点A给节点B发送ping包,B就会给A返回一个pong包。里面包含了汲取你的配置信息,例如节点的id,该节点属于哪个分片,是主节点还是从节点等等信息
②.每个节点,每秒钟,都会给一些随机的节点发送ping包,而不是全发一遍,这样的设计是避免节点数多的时候,心跳包也很多
③.当A给B发送ping包,B不能如期回应的时候,此时A就会尝试重置和B的tcp连接,看能否连接成功,如果依然失败,此时节点A就会把节点B设置为PFAI状态(相当于主观下线)
④.A判定B为PFAIL之后,会通过redis内置的Gossip协议,和其他的节点进行沟通,向其他节点确认B的状态
⑤.此时A发现,很多节点也认为B为PFAIL,并且数目超过了总集群个数的一半,此时A就会把B标记为FAIL(相当于客观下线),并且把这个消息同步给其他节点,其他节点也会把B标记为FAIL,此时B就成为故障节点了
注意:这几种情况下,这个集群都会挂掉:
①.某个分片,所有的主节点和从节点都挂了
②.某个分片,主节点挂了,但是没有从节点
③.超过半数的主节点都挂了
(2).故障迁移
故障迁移,指的是把从节点晋升为主节点,继续给整个集群提供支持
①.从节点判定自己是否具有参选资格,如果从节点和主节点太久没有通信,时间超过了阈值,那么就会失去竞选资格
②.具有资格的节点,例如C和D,那么就会先休眠一定的时间,休眠时间=500ms 基础时间 + 0,500ms随机时间 + 排名 *1000ms 。这里的"排名"是和offset的值有关,offset值越大,说明从节点和主节点的数据越靠近,所以排名就越靠前
③.假设,C的休眠时间到了,此时C就会给其他所有集群中的节点,进行拉票操作,但是只有主节点才有投票的资格
④.主节点会把自己的票投给C,每个主节点只有1票,当C收到的票数超过主节点数目的一般,C就晋升为主节点,C负责执行slaveof no one,并且让D执行 slaveof C
⑤.同时,C还会把自己成为主节点的信息同步给其他集群的节点,大家也都会更新自己保存的集群结构信息
上面选举的过程,称为 "Raft算法",是一种在分布式系统中广泛使用的算法,在随机休眠时间的加持下,基本上是谁先唤醒,谁就能竞选成功
(五).集群扩容
目前来说,我们的集群包含了172.30.0.101 ~ 172.30.0.109这9个节点。下面,我们将110和111这两个节点也加入到集群中,并且110作为主节点,111作为从节点
1.把新的节点添加到集群中
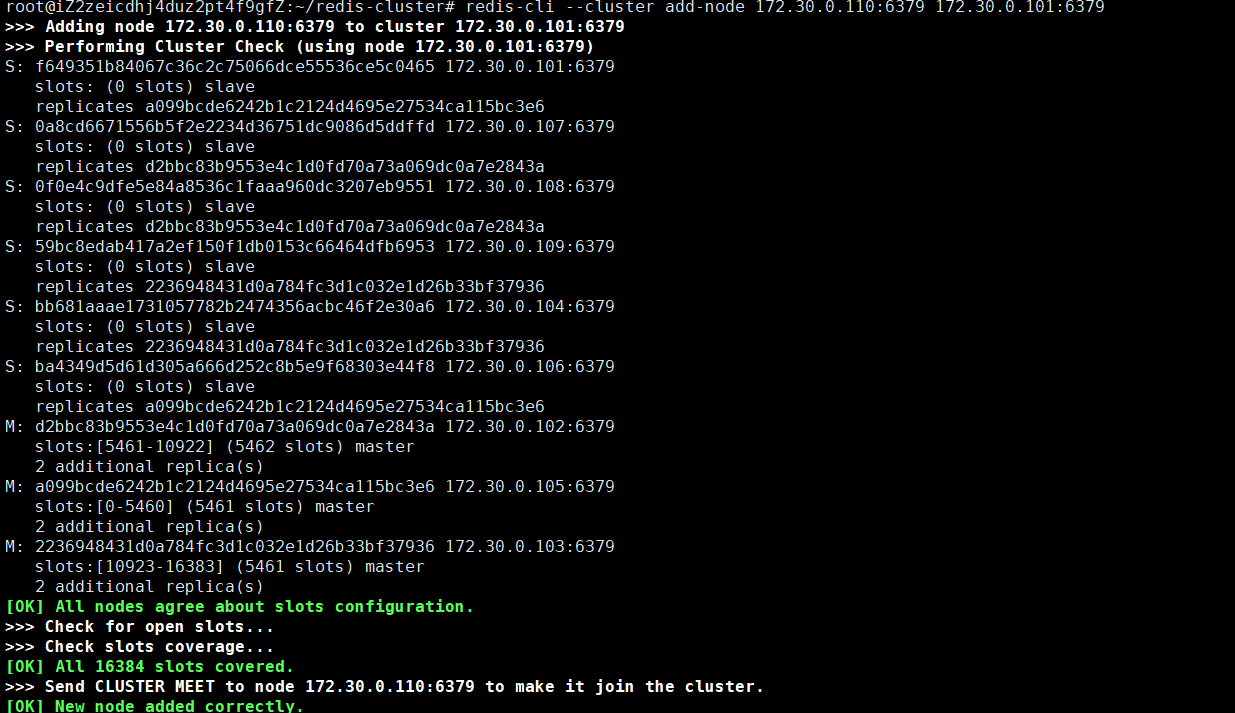
add-node 后面的第一组地址是新节点的地址,第二组地址是集群中的任意节点的地址
然后我们通过cluster nodes命令,查看当前集群的信息
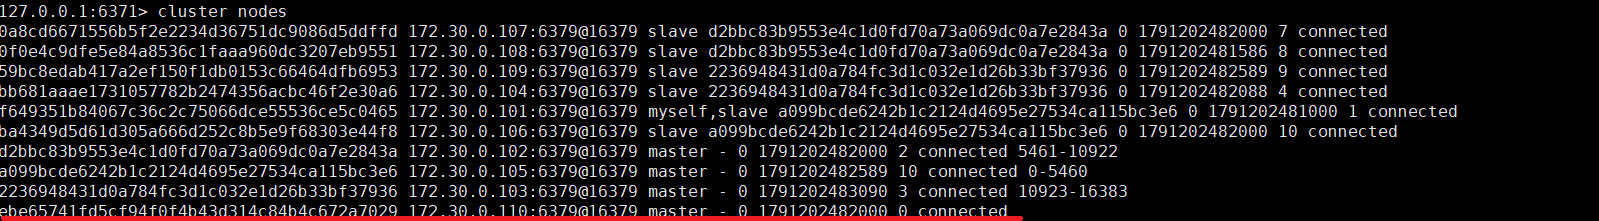
可以看到虽然110这个节点为主节点,但是没有任何的槽位
2.重新分配slots(槽位)
这里我们采取的方式是,把之前三组的主节点上的slots拎出来一些,分配给新的主节点110
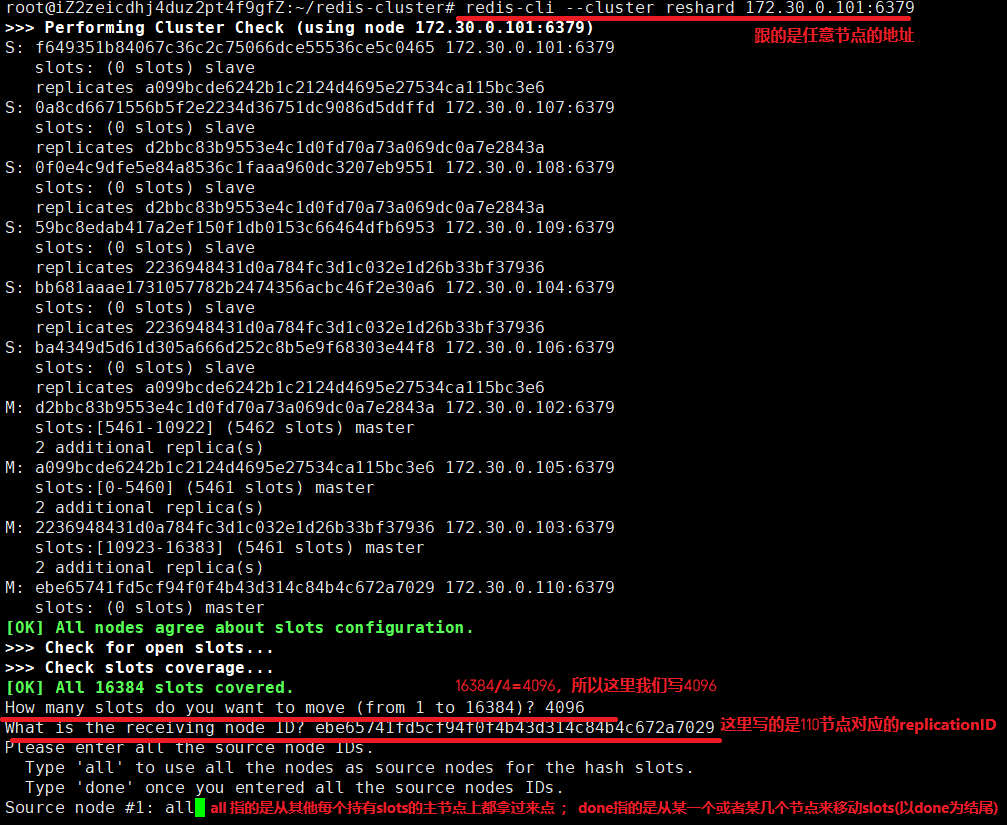
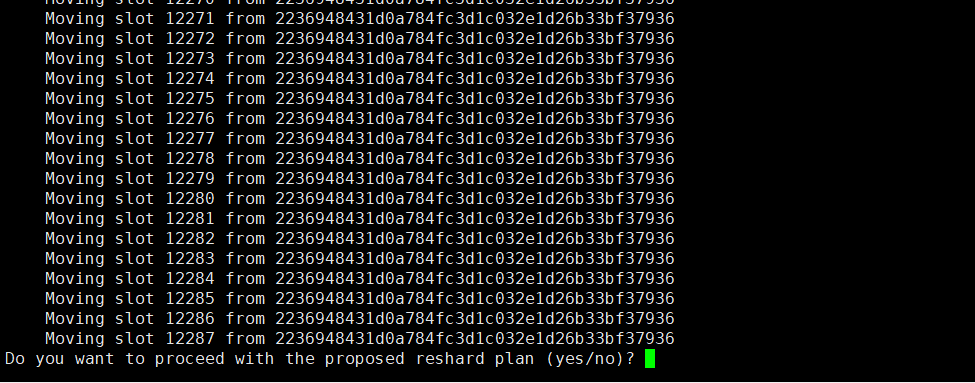
输入"yes"
此时,再执行cluster nodes命令,来查看当前集群的信息
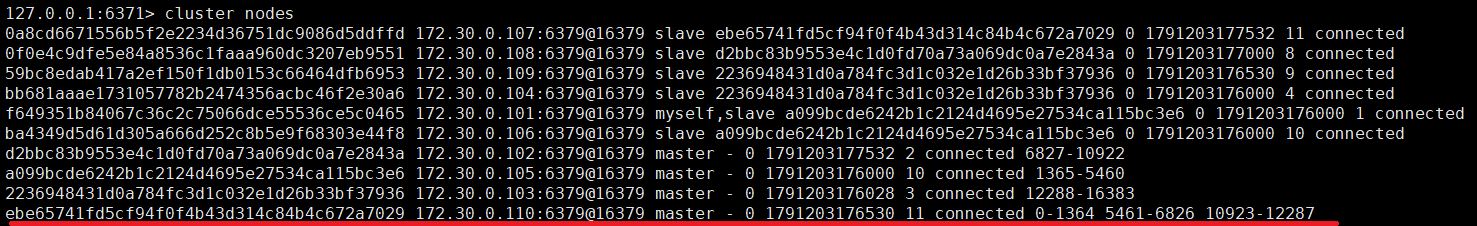
可以看到,110这个节点已经成功获取到了对应的槽位信息
注意:当获取到槽位信息之后,就要进行分配,任何搬运对应的key。在搬运key的过程中,对于那些不需要搬运的key,访问的时候是没有任何的问题的。但是对于需要搬运的key,进行访问可能会出现短暂的访问错误,这是因为key的位置发生了变化,随着搬运的完成,这样的错误也就恢复了
3.给新的主节点添加从节点
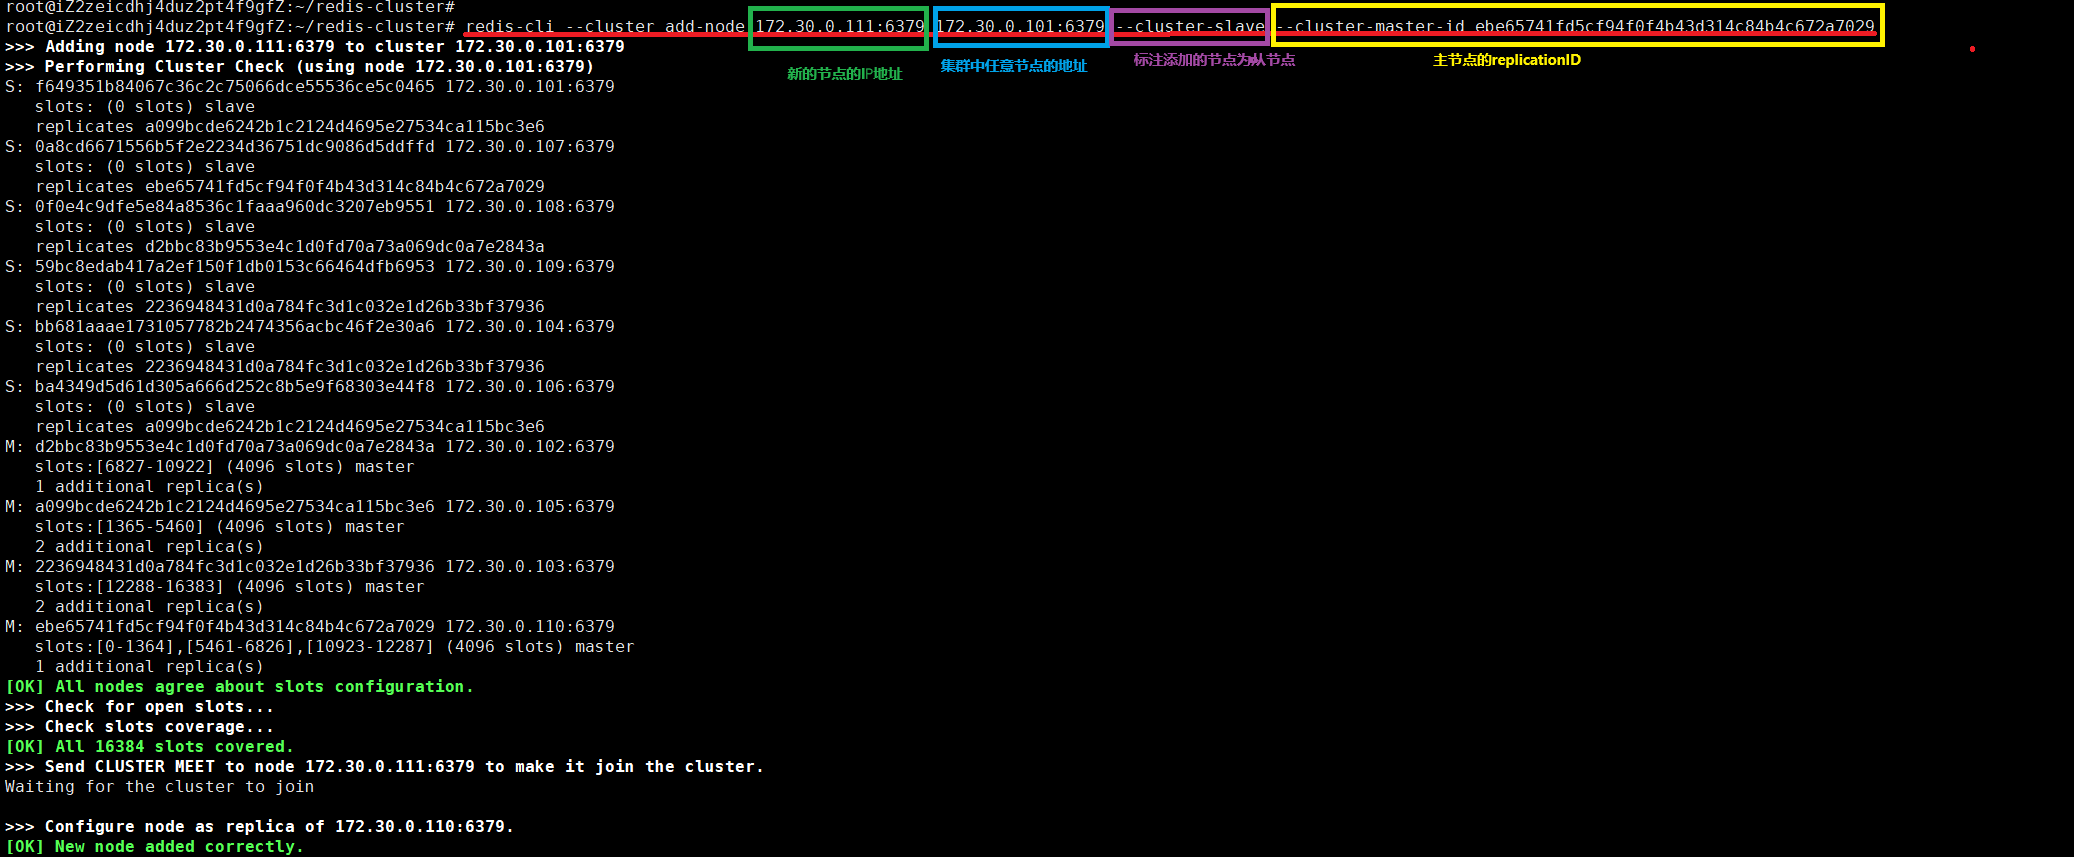
此时,我们再通过 cluster nodes命令来查看当前集群的信息
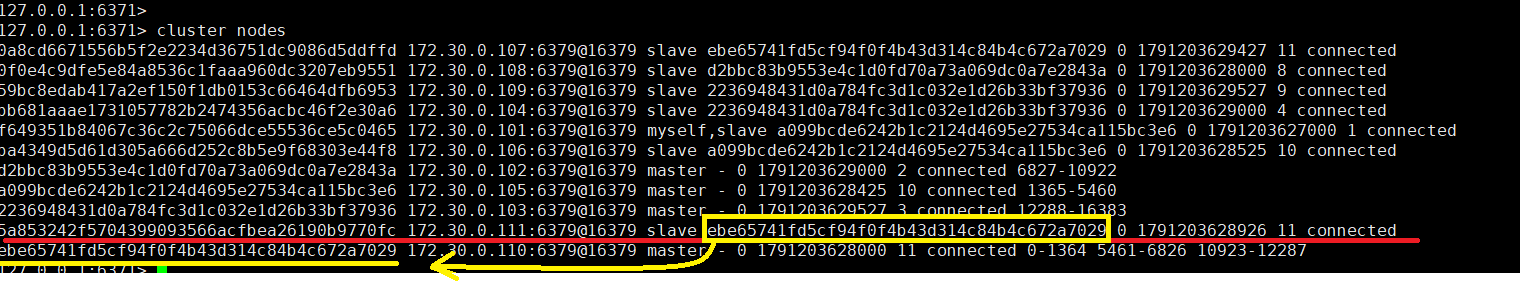
可以看到,我们添加的丛节点也成功了