同样是三表关联,有人查出的销售额比财务报表多出 30%,问题不在数据,在 JOIN 选错了。
这篇用一个电商库,把用户、商品、订单三张表的关联、聚合、子查询串成一条问题链,照着走就能写对。
一、场景:三表查询到底在查什么
电商库最核心的链路是"人---货---单":用户表回答谁在买,商品表回答买了什么,订单表记录什么时候买、买多少、花多少钱。
三张表的字段和角色先对齐:
| 表 | 别名 | 回答的问题 | 核心字段 |
|---|---|---|---|
| user 用户表 | u | 谁在买 | user_id(主键)、user_name、user_phone、user_region、register_time |
| product 商品表 | p | 买了什么 | product_id(主键)、product_name、product_category、unit_price、stock |
| order 订单表 | o | 何时买、买多少、花多少 | order_id(主键)、user_id(外键)、product_id(外键)、order_quantity、order_amount、order_time、order_status |
三张表的关联关系一眼能看清:
latex
 user(用户表)                     product(商品表)
       ▲                                    ▲
       │ user_id                            │ product_id
       │                                    │
       └───────── order(订单表)────────────┘
                    (事实表,居中)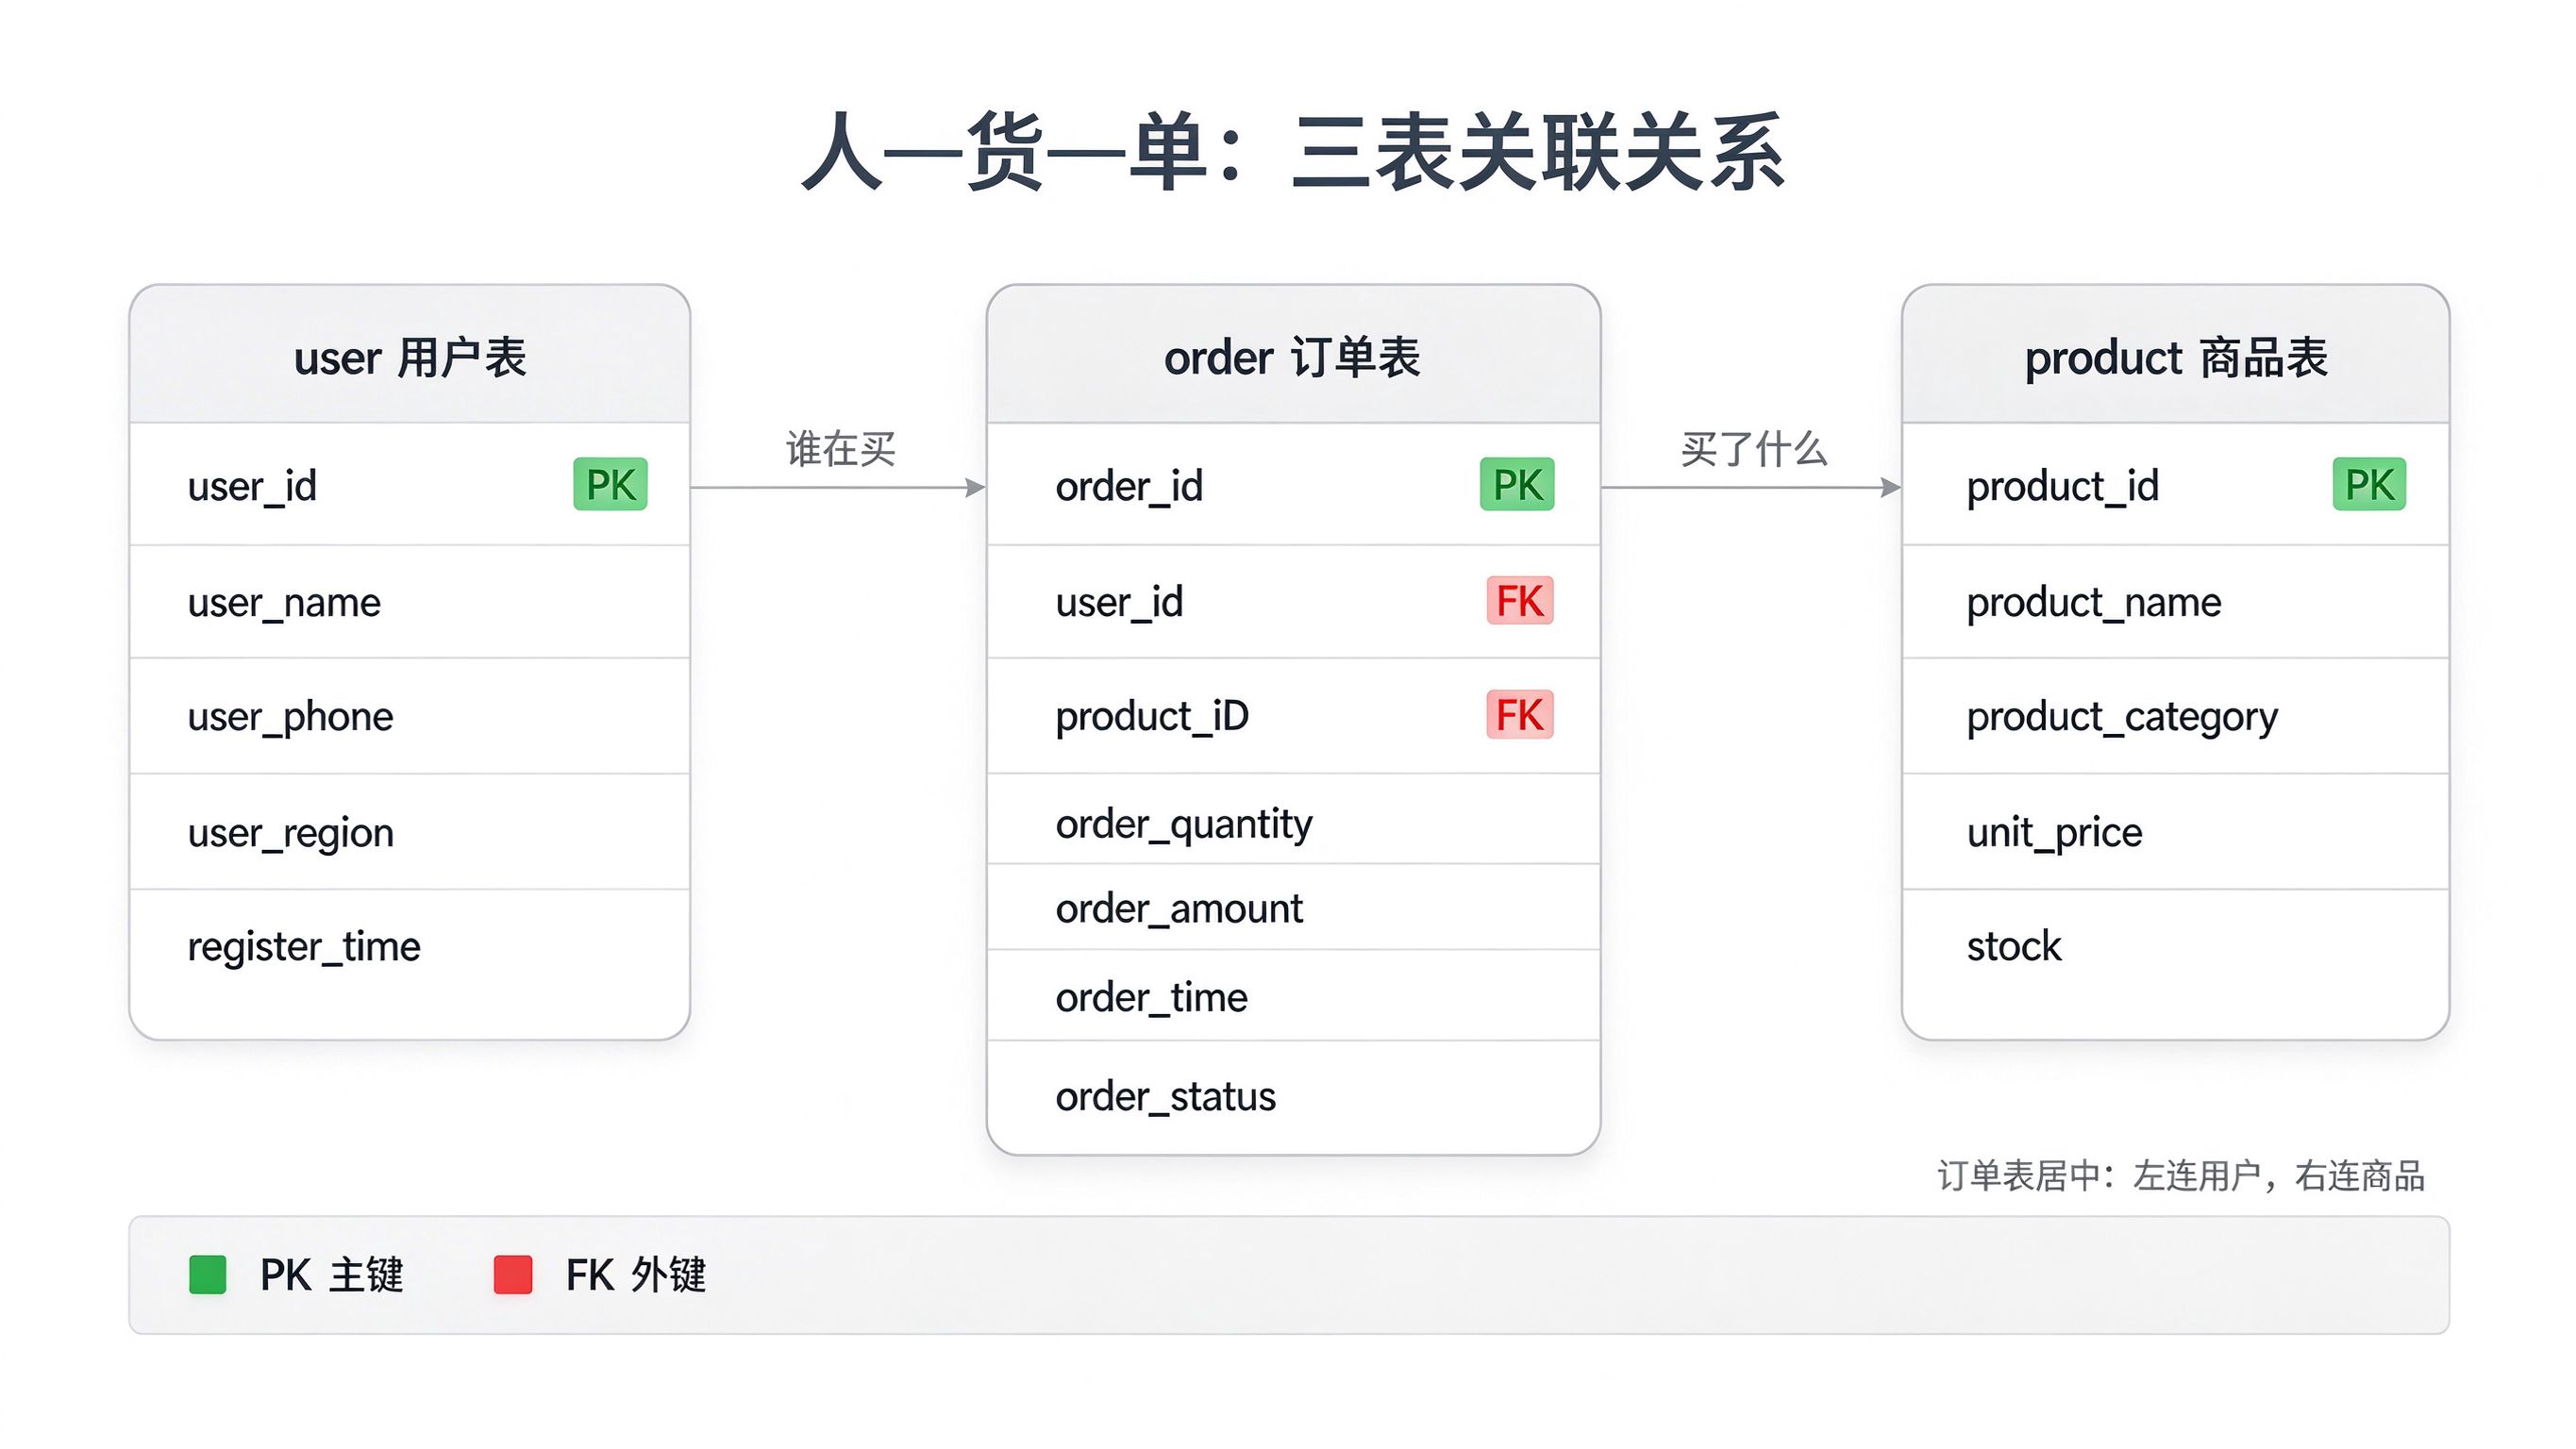
表结构就这么简单,那三张表一拼是不是就完事了?我第一次写三表查询,拼出来的就是一场事故。
二、踩坑:三表一拼,结果要么翻倍,要么丢行
我图省事写过逗号隐式连接,还漏了连接条件:
sql
SELECT u.user_name, p.product_name, o.order_amount
FROM `user` u, `order` o, product p;
没有连接条件,三张表的行数两两相乘,order_amount 被重复累加,销售额自然比财务多出一大截。这就是笛卡尔积(Cartesian Product)。
后来换成 JOIN,又栽在第二个坑:用内连接做销量榜,没卖出去的商品直接消失,排行榜变成"全员有销量"。
连接类型的差异,决定了哪些行能留下:
| 连接方式 | 保留哪些行 | 无匹配时 | 典型场景 |
|---|---|---|---|
| INNER JOIN 内连接 | 双方都匹配的行 | 直接过滤 | 查有效订单明细 |
| LEFT JOIN 左连接 | 左表全部行 | 右表补 NULL | 查全部用户及订单 |
| RIGHT JOIN 右连接 | 右表全部行 | 左表补 NULL | 查全部商品及订单 |
要查每笔订单的用户名、商品名、数量、金额,订单表做驱动表,两次内连接:
sql
SELECT u.user_name, p.product_name, o.order_quantity, o.order_amount
FROM `order` o
INNER JOIN `user` u ON o.user_id = u.user_id
INNER JOIN product p ON o.product_id = p.product_id;
要保留全部用户,包括从没下单的,换成左连接:
sql
SELECT u.user_name, o.order_id, o.order_amount
FROM `user` u
LEFT JOIN `order` o ON u.user_id = o.user_id;
只想看哪些用户从未下单,在外连接后补一刀:
sql
SELECT u.user_name
FROM `user` u
LEFT JOIN `order` o ON u.user_id = o.user_id
WHERE o.order_id IS NULL;
注意:订单表是中心,驱动表选谁,取决于你要保留谁的全部行;要保留全部行,就用外连接。
明细看对了,算指标呢?我第一次写消费排行,直接在 WHERE 里写 SUM,数据库当场报错。
三、聚合:WHERE 报错,HAVING 才算对
我当时的写法是这样的:
sql
SELECT u.user_name, SUM(o.order_amount) AS total_spent
FROM `user` u
INNER JOIN `order` o ON u.user_id = o.user_id
WHERE SUM(o.order_amount) > 1000
GROUP BY u.user_id, u.user_name;
WHERE 执行在分组之前,此刻还没有聚合结果,聚合函数写进 WHERE 必然报错。
一条 SQL 的实际执行顺序如下,和书写顺序并不一样:
latex
FROM/JOIN → WHERE → GROUP BY → 聚合函数 → HAVING → SELECT → ORDER BY
取数连接 过滤行 分组 SUM/COUNT 过滤组 取列 排序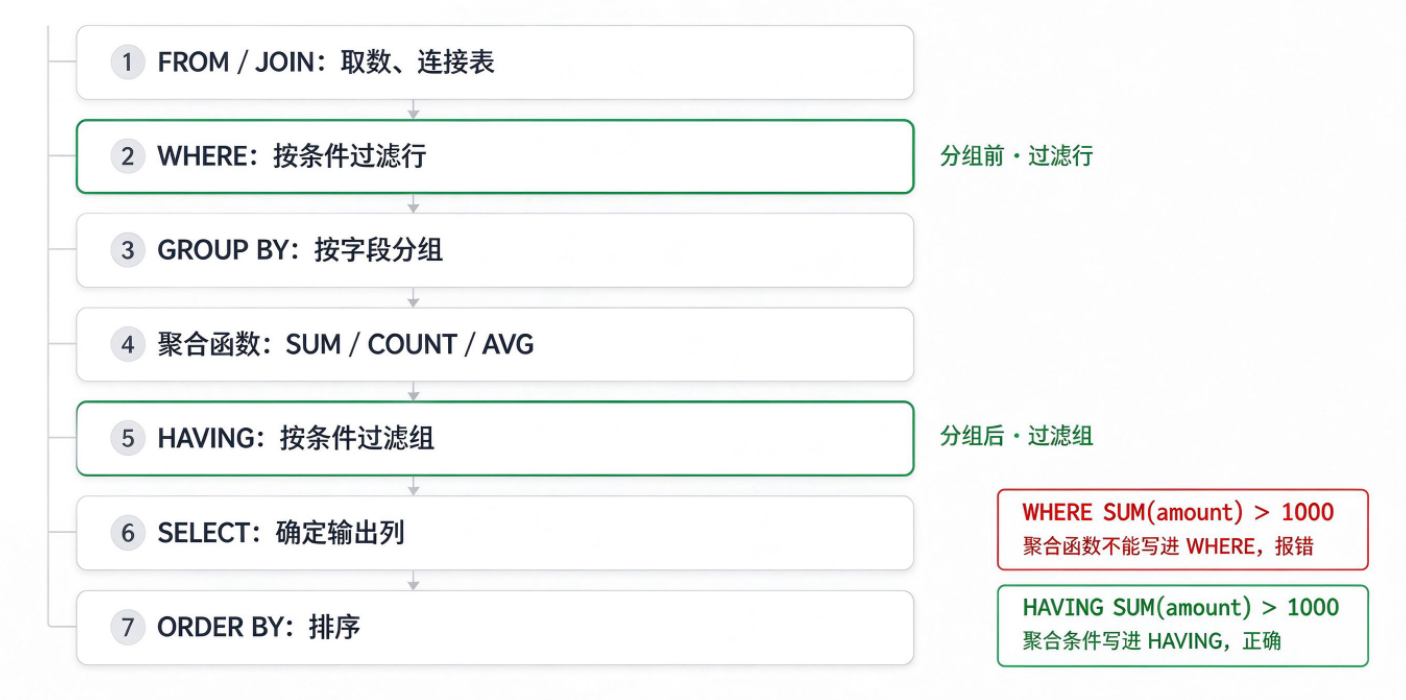 统计每个用户的消费总额并排序,状态过滤放在 WHERE,排序用聚合列:
sql
SELECT u.user_name, SUM(o.order_amount) AS total_spent
FROM `user` u
INNER JOIN `order` o ON u.user_id = o.user_id
WHERE o.order_status = '已支付'
GROUP BY u.user_id, u.user_name
ORDER BY total_spent DESC;
再筛"消费超 1000 的用户",把条件挪到 HAVING:
sql
SELECT u.user_name, SUM(o.order_amount) AS total_spent
FROM `user` u
INNER JOIN `order` o ON u.user_id = o.user_id
GROUP BY u.user_id, u.user_name
HAVING SUM(o.order_amount) > 1000;
这里有两个细节不能省:
- 状态过滤放 WHERE:聚合前就剔除无效订单,指标不被污染
- GROUP BY 带上 user_id 和 user_name:SELECT 里所有非聚合列,都要出现在 GROUP BY 中
商品销量榜要把没卖动的商品也显示出来、销量为 0,就得换左连接加 COALESCE:
sql
SELECT p.product_name, COALESCE(SUM(o.order_quantity), 0) AS total_sold
FROM product p
LEFT JOIN `order` o ON p.product_id = o.product_id
GROUP BY p.product_id, p.product_name
ORDER BY total_sold DESC;
注意:WHERE 过滤行,HAVING 过滤组;聚合条件写进 HAVING,没有例外。
如果筛选条件本身就是另一组聚合结果------比如买过手机的用户、消费超过平均值的用户------又该怎么办?这时候该子查询出场。
四、进阶:条件套结果,子查询分步拆
找买过某类商品的用户,先在内层确定符合条件的用户 ID,外层再取用户信息:
sql
SELECT user_name, user_phone
FROM `user`
WHERE user_id IN (
    SELECT DISTINCT o.user_id
    FROM `order` o
    INNER JOIN product p ON o.product_id = p.product_id
    WHERE p.product_category = '手机'
);
找消费金额高于平台平均值的用户,内层先算每人总额,再算总额平均值,外层用 HAVING 比较:
sql
SELECT u.user_name, SUM(o.order_amount) AS total_spent
FROM `user` u
INNER JOIN `order` o ON u.user_id = o.user_id
GROUP BY u.user_id, u.user_name
HAVING SUM(o.order_amount) > (
    SELECT AVG(user_total)
    FROM (
        SELECT user_id, SUM(order_amount) AS user_total
        FROM `order`
        GROUP BY user_id
    ) AS t
);
找"从未被购买过的商品",我在生产上踩过一次:订单表的 product_id 允许 NULL,NOT IN 子查询里只要混进一个 NULL,外层结果直接为空------任何值和 NULL 比较,结果都是未知。
稳妥写法是在子查询里先排除 NULL:
sql
SELECT product_name, product_category
FROM product
WHERE product_id NOT IN (
    SELECT product_id
    FROM `order`
    WHERE product_id IS NOT NULL
);
更省心的写法是直接用 NOT EXISTS,语义和空值行为都更稳:
sql
SELECT p.product_name, p.product_category
FROM product p
WHERE NOT EXISTS (
    SELECT 1
    FROM `order` o
    WHERE o.product_id = p.product_id
);注意:NOT IN 怕 NULL,要么先排除 NULL,要么改用 NOT EXISTS,后者更稳。**
单点查询都会了,把它们串成一条完整的分析链路,还能不能一次写对?下面用一个真实报表需求验证。
五、实操验证:一条完整分析链路
需求是:统计 2025 年第一季度各地区"已支付"订单的销售额,按销售额降序,同时显示该地区的下单用户数。
你可以按下面这条链路写:
sql
SELECT
    u.user_region AS region,
    COUNT(DISTINCT o.user_id) AS user_count,
    SUM(o.order_amount) AS total_sales
FROM `order` o
INNER JOIN `user` u ON o.user_id = u.user_id
WHERE o.order_status = '已支付'
  AND o.order_time >= '2025-01-01'
  AND o.order_time < '2025-04-01'
GROUP BY u.user_region
ORDER BY total_sales DESC;
写完别急着交,按这张表逐项核对:
| 检查点 | 这条 SQL 的处理 | 目的 |
|---|---|---|
| 连接方式 | INNER JOIN 用户表 | 只统计有地区归属的订单 |
| 过滤位置 | 状态、时间放 WHERE | 聚合前剔除,金额不被污染 |
| 用户数 | COUNT(DISTINCT o.user_id) | 一人多单只算一次 |
| 时间范围 | >= 季度首日 AND < 下季度首日 | 避开边界和时分秒误差 |
| 追加筛选 | HAVING SUM(o.order_amount) > 5000 | 组级条件必须放在聚合后 |
收尾交叉验证:把同一时间、同一状态的订单明细单独拉出来求和,和地区汇总的 total_sales 合计对齐,数字才敢往报表上放。
sql
SELECT order_id, order_amount
FROM `order`
WHERE order_status = '已支付'
  AND order_time >= '2025-01-01'
  AND order_time < '2025-04-01';
能跑通、能核对、能解释,这条 SQL 才算真正落地。
六、总结延伸:把语法变成决策链路
三表查询的难点不在语法,在于拿到需求先做哪个判断。下面这条链路,我现在写每条 SQL 都在走:
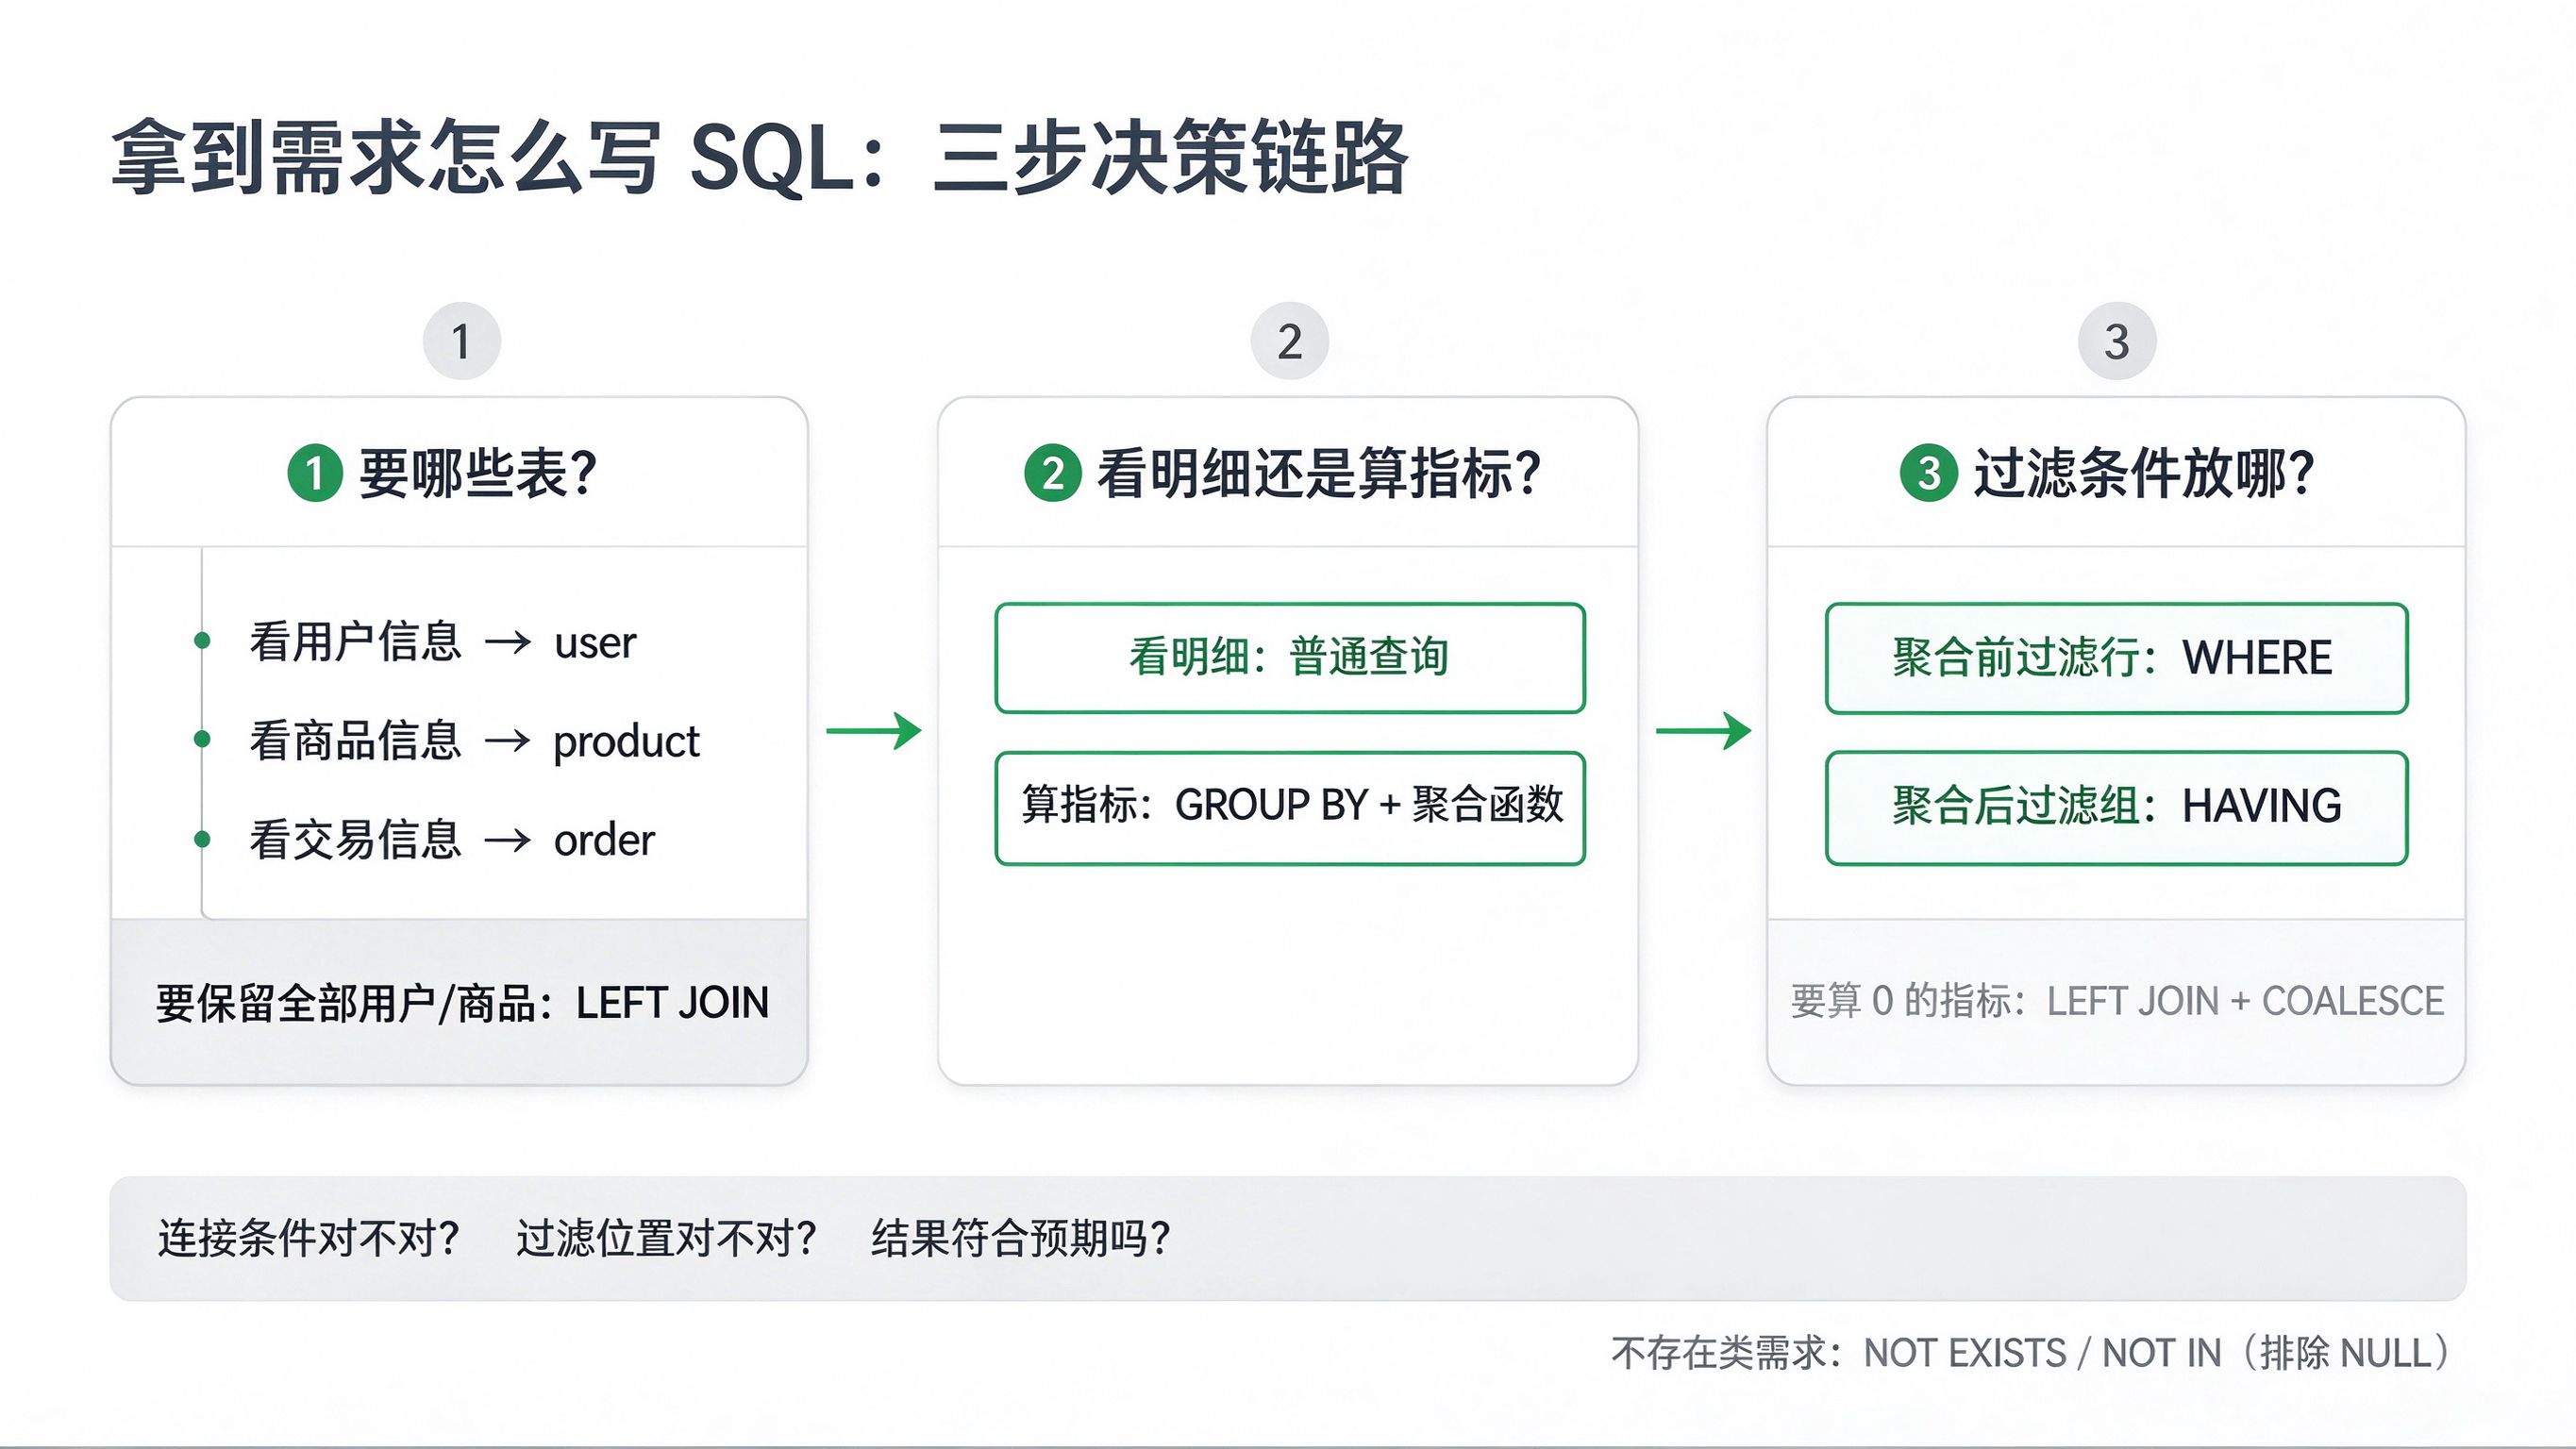
- 先定表:需要哪些表的信息,决定 JOIN 谁
- 再定形态:看明细用普通查询,算指标用 GROUP BY 加聚合函数
- 后定过滤:聚合前用 WHERE,聚合后用 HAVING
术语统一速查:
| 术语 | 英文 | 一句话说明 |
|---|---|---|
| 主键 | Primary Key(PK) | 唯一标识表内一行的字段 |
| 外键 | Foreign Key(FK) | 指向其他表主键的关联字段 |
| 内连接 | INNER JOIN | 只保留双方匹配的行 |
| 外连接 | OUTER JOIN | 保留一侧全部行,如 LEFT/RIGHT JOIN |
| 笛卡尔积 | Cartesian Product | 缺连接条件时,行数两两相乘 |
| 分组 | GROUP BY | 按字段把多行归为一组 |
| 聚合函数 | Aggregate Function | 对组计算的 SUM/COUNT/AVG 等 |
| 子查询 | Subquery | 嵌套在其他语句中的查询 |
| 表别名 | Table Alias | u、o、p 这类表的临时简称 |
参考链接(官方文档):
- MySQL 8.4 Reference Manual · JOIN Syntax --- https://dev.mysql.com/doc/refman/8.4/en/join.html
- MySQL 8.4 Reference Manual · SELECT / WHERE / HAVING --- https://dev.mysql.com/doc/refman/8.4/en/select.html
- MySQL 8.4 Reference Manual · Subqueries --- https://dev.mysql.com/doc/refman/8.4/en/subqueries.html
- MySQL 8.4 Reference Manual · COALESCE --- https://dev.mysql.com/doc/refman/8.4/en/comparison-operators.html#function_coalesce