🏆浮世尘弦:个人主页****
💎:非淡薄无以明志,非宁静无以致远
前言
前言:stack和queue是C++中的容器适配器,不是自己实现存储的新容器,而是把现有的容器包装一下,只暴露特定的接口,让他的行为变成栈或队列,这就是容器适配器。在本篇内容中我们使用不同的容器来实现栈和队列,比较他们的优缺点,进而学习deque容器。这也是本篇的重点内容。让我们开始学习今天的内容吧!
文章目录:
[四,vector vs list 深度对比⭐](#四,vector vs list 深度对比⭐)
[五,deque(双端队列)](#五,deque(双端队列))
C++参考文档(cplusplus)
一,回顾stack和queue的基础特性
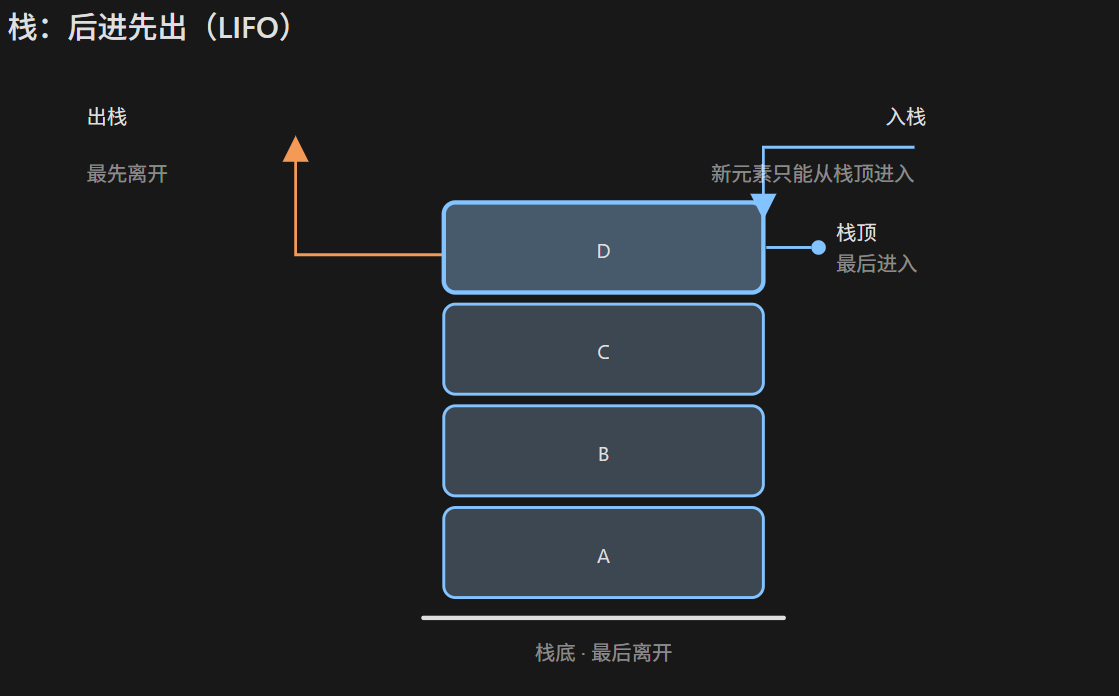
1,stack
栈最基本的特点是后进先出
-
仅允许在栈顶操作。
-
核心接口:
push(压栈)、pop(弹栈)、top(取栈顶)。
2,queue
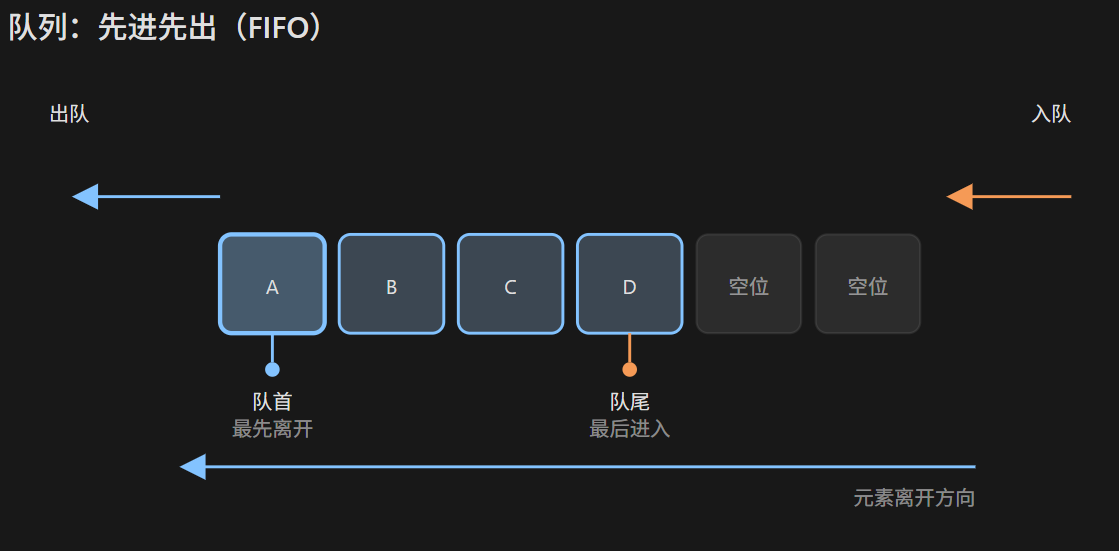
队列最基本的特点是先进先出
-
仅在队头和队尾进行操作。
-
核心接口:
push(入队)、pop(出队)、front(取队头)、back(取队尾)。
详细可见:【数据结构】详解栈和队列
二,使用容器适配器模拟实现栈
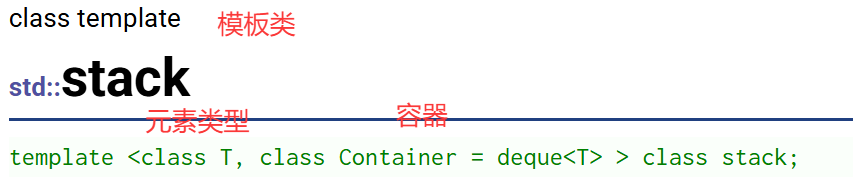
首先再介绍一下容器适配器:
容器适配器就是一种设计模式,该种模式是将一个类的接口转换成客户希望的另外一个接口
stack和queue都是容器适配器。
首先看之前手动管理内存实现的栈:
cpp
//手动管理内存实现栈
template <class T>
class stack
{
private:
	T* q;  //动态数组指针,用来在堆上开辟空间
	size_t top;//栈顶元素索引/元素的个数
	size_t capacity;//总容量
};
使用vector实现栈和使用list实现有什么区别?
首先栈的基础操作和vector在尾部的操作完美契合。
-
操作匹配 :
std::stack是 LIFO(后进先出),所有操作(push、pop、top)都只在栈顶 进行。而vector正好提供了push_back()、pop_back()、back(),并且都是在尾部操作。 -
效率极高 :在
vector尾部增删元素,不需要移动其他元素。虽然vector扩容时会拷贝数据,但均摊时间复杂度是 O(1) 。而且vector内存连续,CPU 缓存命中率极高但是使用vector依旧有许多的缺点。 -
如果使用list,list的内存不连续,导致缓存命中率较差,实际与逆行速度比vector慢。
-
在单次插入/删除下,每次new/delete,堆分配开销大。
-
在内存开销上,list每个节点要多开两个指针,导致内存占用大。
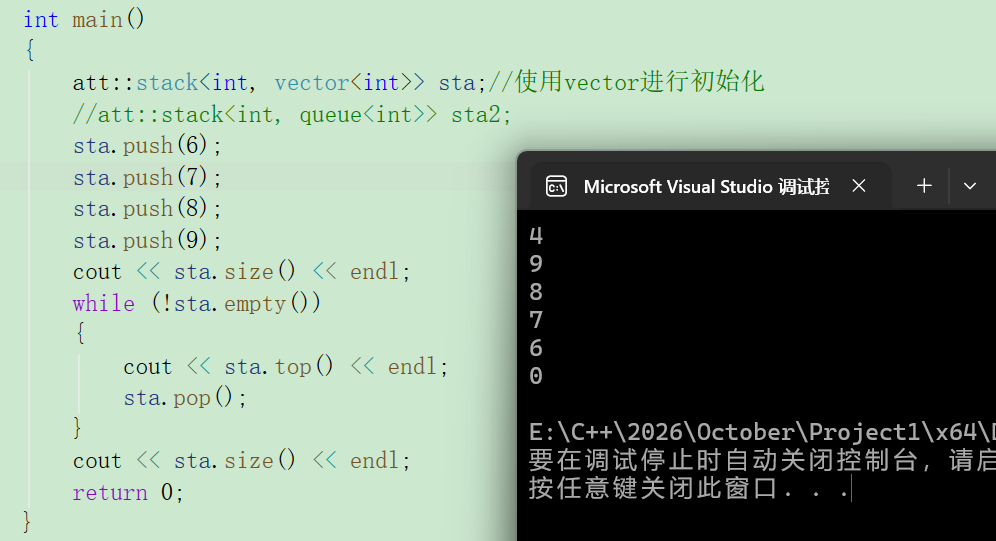
接下来是容器适配器下使用vector实现的栈:
cpp
namespace att
{
	//使用容器vector实现栈
	template <class T>//T为容器中元素的类型
	class stack
	{
	public:
		//入栈
		void push(const T& x)
		{
			var.push_back(x);
		}
		//出栈
		void pop()
		{
			var.pop_back();
		}
		//返回栈顶元素
		const T& top()const
		{
			return var.back();
		}
		//栈中元素个数
		size_t size()const
		{
			return var.size();
		}
		//判空
		bool empty()const
		{
			return var.empty();
		}
	private:
		vector<T> var;
	};
}
测试展示:
三,使用list模拟实现队列
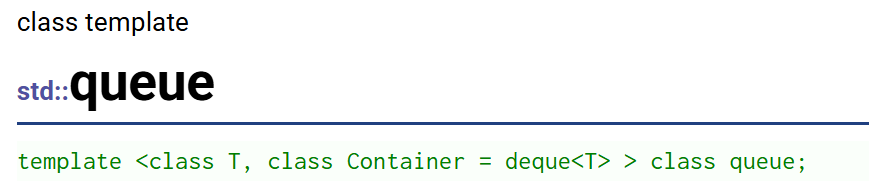
由于vector不支持头删pop_front(),所以不能使用vector实现队列
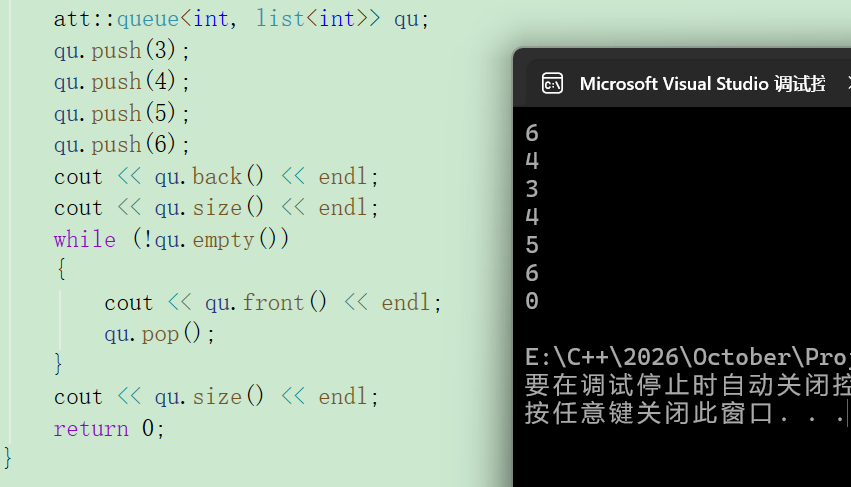
因此直接使用list实现队列:
cpp
//容器适配器下的队列
namespace att
{
	//使用容器list实现队列
	template <class T, class Container>//T为容器中元素的类型
	class stack
	{
	public:
		//入队列
		void push(const T& x)
		{
			var.push_back(x);
		}
		//出队列
		void pop()
		{
			var.pop_front();
		}
		//返回队头元素
		const T& front()const
		{
			return var.front();
		}
		//返回队尾元素
		const T& back()const
		{
			return var.back();
		}
		//队列中元素个数
		size_t size()const
		{
			return var.size();
		}
		//判空
		bool empty()const
		{
			return var.empty();
		}
	private:
		Container var;
	};
}
测试展示:
四,vector vs list 深度对比⭐
| 对比维度 | vector(动态数组) |
list(双向链表) |
|---|---|---|
| 底层结构 | 物理空间连续的动态数组 | 物理空间不连续的双向链表 |
| 随机访问 | ✅ 支持高效下标随机访问,O(1) | ❌ 不支持下标随机访问,只能遍历,O(n) |
| 插入/删除 | ❌ 头部和中间插入删除效率低,O(n)(需搬移元素) ✅ 尾部操作效率不错,均摊 O(1) | ✅ 任意位置插入删除极快,O(1)(已知位置) ❌ 需要遍历找到位置,且每次分配/释放节点开销大 |
| 空间管理 | ❌ 空间不足需扩容,有代价(效率损失+空间浪费,通常 1.5~2倍扩容) | ✅ 按需申请释放空间,不需要扩容,没有预留浪费 |
| 缓存与内存 | ✅ 物理空间连续,高速缓存利用率高 ✅ 额外内存开销极小 | ❌ 缓存不友好(节点散落堆各处) ❌ 每个节点需额外存前驱、后继指针,内存开销大,易产生碎片 |
| 迭代器失效 | ❌ 扩容后所有指针、引用、迭代器全部失效 | ✅ 除被删元素外,其他元素的迭代器/引用始终有效 |
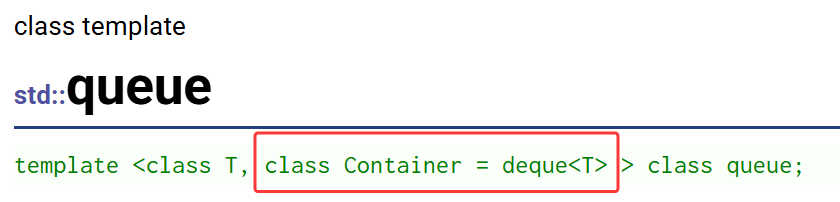
为了解决vector和list的问题,C++引入了一个新的容器deque,库中使用的默认容器就是deque
五,deque(双端队列)
1,deque的介绍
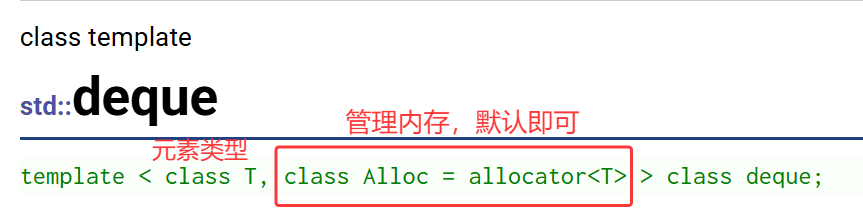
std::deque 是 C++ STL 中的双端队列容器 。你可以把它理解为**"支持头尾两端高效插入删除的动态数组"** 。与vector比较,头插效率高,不需要搬移元素;与 list比较,空间利用率比较高。
deque是vector和list的缝合,使用随机迭代器。融合了两种容器的优点。
2,deque的结构
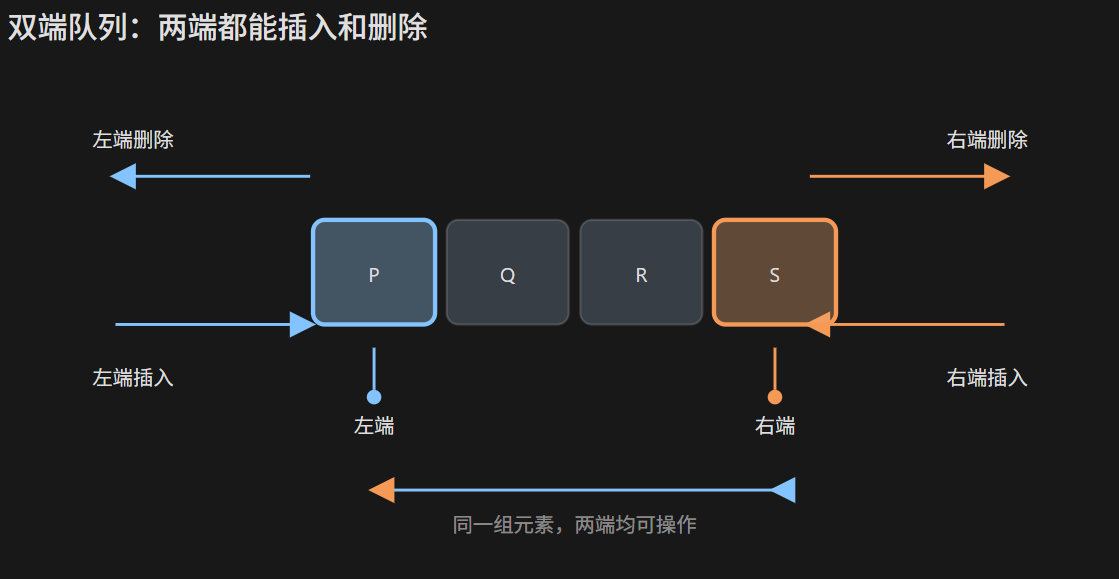
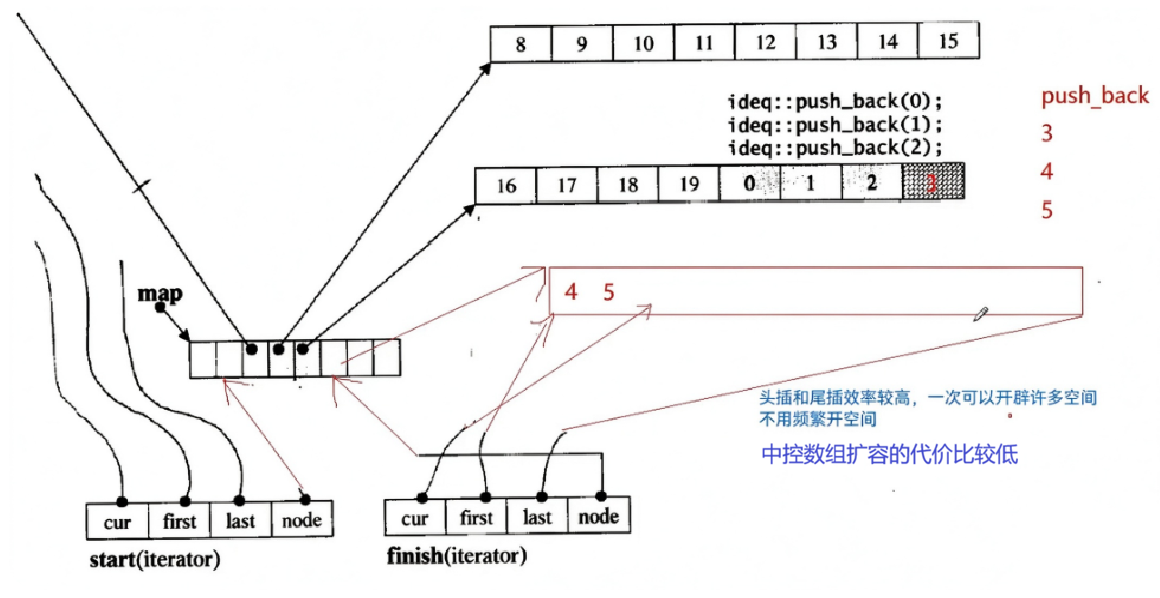
deque并不是真正的连续的空间。而是由一段段连续的小空间组成,类似一个动态的二维数组
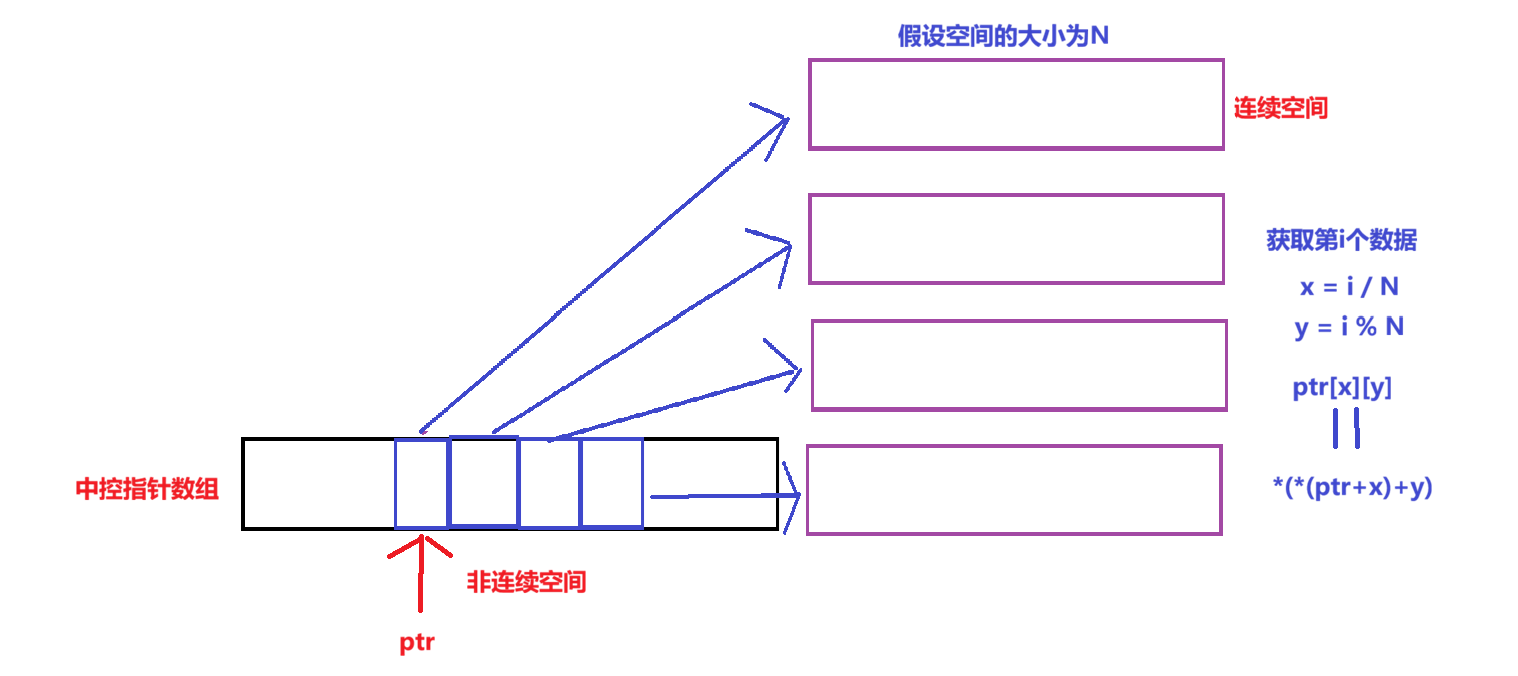
中控数组当中放的是不同空间的指针,指向的空间是连续的 ,中控数组不是从数组的开头开辟空间的,而是在数组的中间,方便左右两边插入或者删除元素。
每个空间依靠4个迭代器来维护:
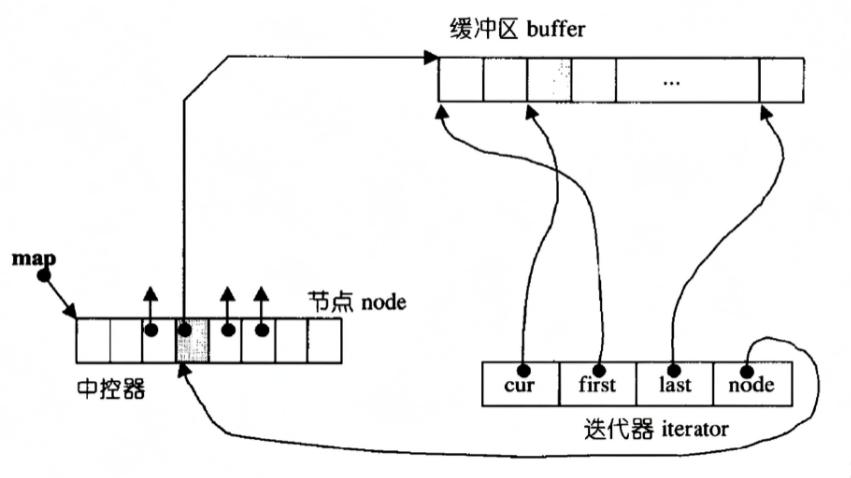
cur指向当前元素位置,first和last分别指向起始元素位置和最后一个元素的下一个位置
node作为一个二级指针,指向中控数组的每个节点。
上面是每个连续空间的迭代器,还有两个迭代器维护中控数组本身,分别是start和finish
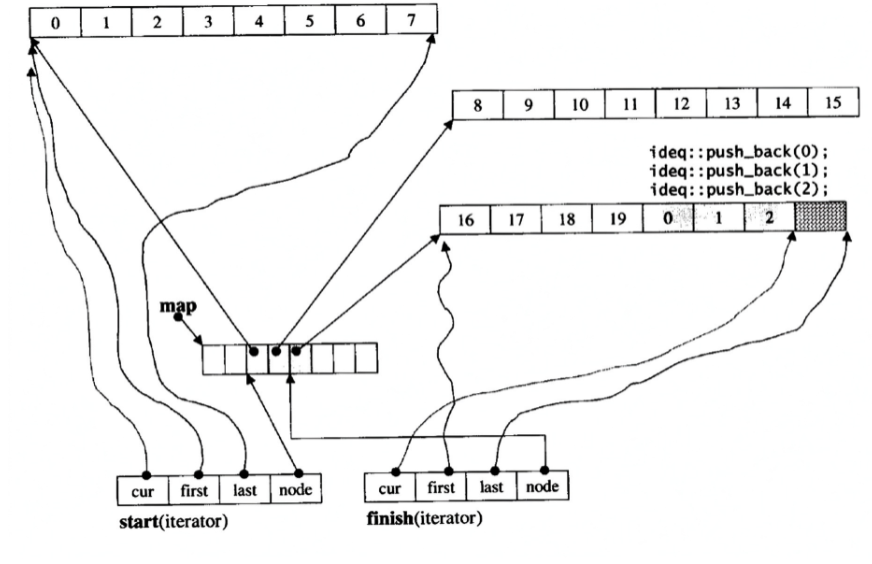
start指向中控数组当中第一个元素,finish指向中控数组当中最后一个元素。
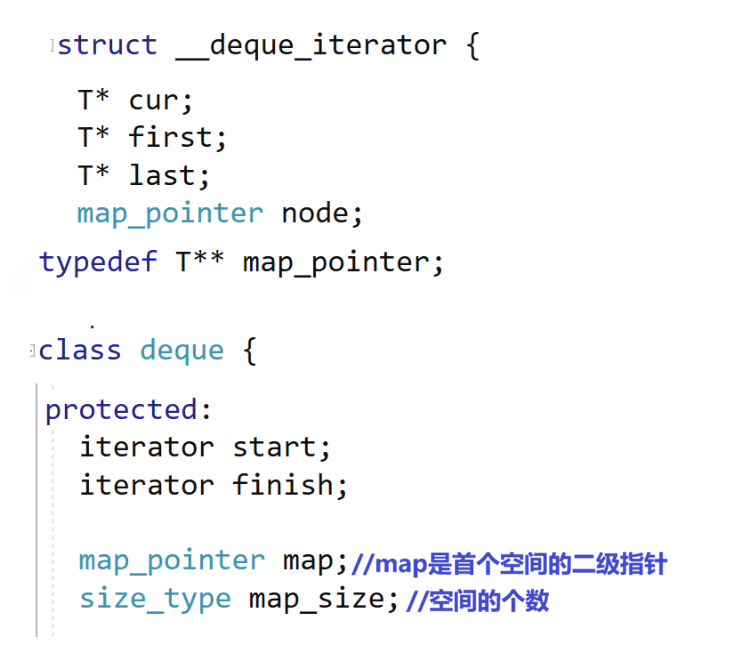
3,deque的遍历和插入元素
deque的遍历:
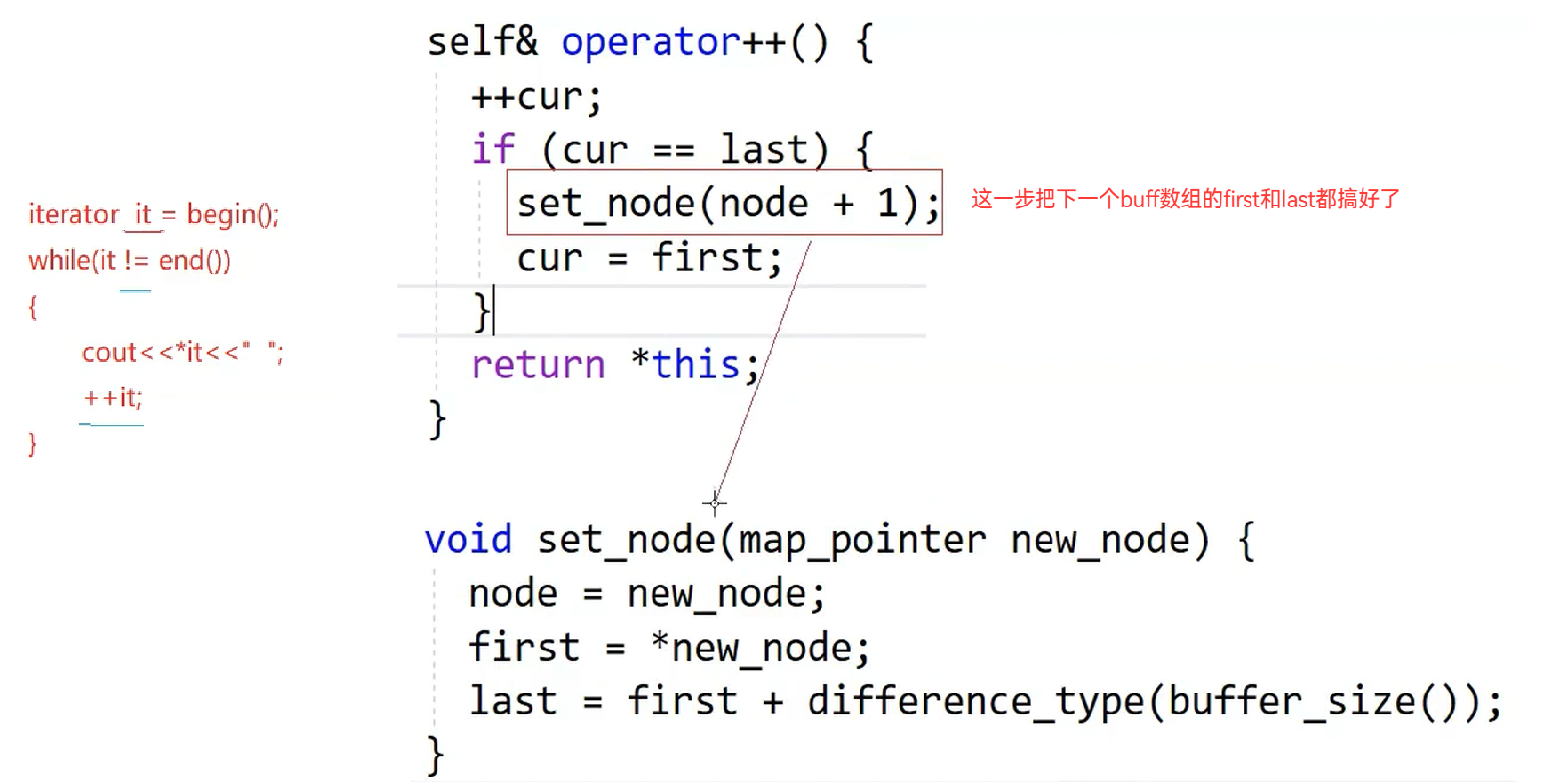
deque插入元素:
头插:
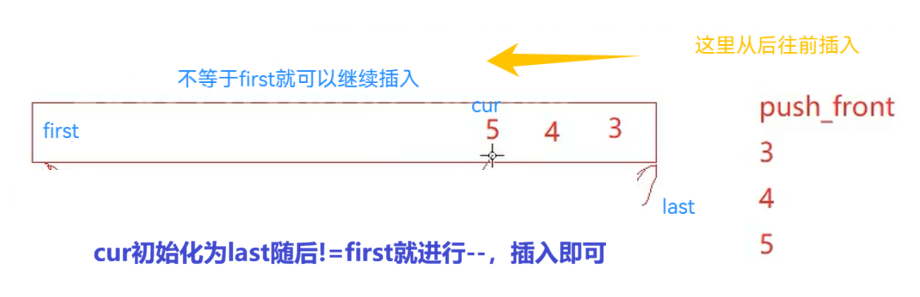
尾插:
4,deque的优缺点
| 对比维度 | 具体表现 | 判定 |
|---|---|---|
| 双端操作 | 头尾插入/删除均为 O(1),不像 vector 头部操作需要搬移 |
✅ 优点 |
| 随机访问 | 提供 [] 和 at(),支持 O(1) 随机访问,list 做不到 |
✅ 优点 |
| 扩容机制 | 只需分配新缓冲区并在中控数组加指针,不拷贝/移动旧元素 | ✅ 优点 |
| 引用稳定性 | 头尾增删时,除被删元素外,其他元素的指针和引用保持有效 | ✅ 优点 |
| STL 适配 | stack 和 queue 默认底层容器,兼顾尾插、头删、尾删的高效性 |
✅ 优点 |
| 中间插删 | 依然是 O(n),且因分段连续,搬移元素的常数开销比 vector 更大 |
❌ 缺点 |
| 缓存命中率 | 内存分段连续,遍历跨缓冲区需指针跳转,CPU 预读效率不如 vector |
❌ 缺点 |
| 内存控制 | 无 capacity() 和 reserve(),不支持像 vector 那样精确预分配内存 |
❌ 缺点 |
| 内存碎片 | 有中控数组和多个缓冲区的额外开销,碎片多于 vector,但远少于 list |
❌ 缺点 |
| 迭代器 | 不是原生指针,是封装了缓冲区边界检查的复杂对象,实现复杂且有轻微开销 | ❌ 缺点 |
补充deque的缺点:deque不适合遍历,因为在遍历时,deque需要频繁的检查是否移动到小数组的边界,导致效率低下。而实际情景下,可能需要经常进行遍历,因此实际情况下,通常使用的线性结构大多数是vector和list这样的,deque使用的不多。
而使用deque作为stack和queue的底层容器,则是stack和queue不需要遍历,只需要在一端进行操作。因此避免了deque的缺点,使用了其优点。
5,性能对比
使用排序对比一下vector和deque的下标访问效率
cpp
//容器排序效率比对
//deque和vector直接进行对比
void test1()
{
	srand(time(0));
	const int N = 1000000;

	deque<int> dq;
	vector<int> v;

	for (int i = 0; i < N; ++i)
	{
		auto e = rand() + i;
		v.push_back(e);
		dq.push_back(e);
	}

	int begin1 = clock();
	sort(v.begin(), v.end());
	int end1 = clock();

	int begin2 = clock();
	sort(dq.begin(), dq.end());
	int end2 = clock();

	printf("vector:%d\n", end1 - begin1);
	printf("deque:%d\n", end2 - begin2);
}
//deque拷贝成vector进行排序和直接排序对比
void test2()
{
	srand(time(0));
	const int N = 1000000;

	deque<int> dq1;
	deque<int> dq2;

	for (int i = 0; i < N; ++i)
	{
		auto e = rand() + i;
		dq1.push_back(e);
		dq2.push_back(e);
	}

	int begin1 = clock();
	sort(dq1.begin(), dq1.end());
	int end1 = clock();

	int begin2 = clock();
	// 拷贝到vector
	vector<int> v(dq2.begin(), dq2.end());
	sort(v.begin(), v.end());
	dq2.assign(v.begin(), v.end());
	int end2 = clock();

	printf("deque sort:%d\n", end1 - begin1);
	printf("deque copy vector sort:%d\n", end2 - begin2);
}
release下结果: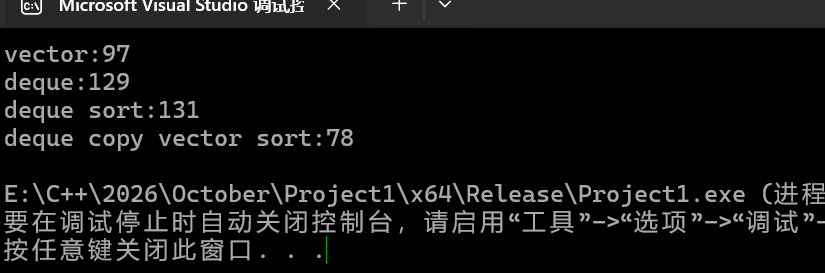
这表明vector下标访问的效率比deque访问下标的效率高。
优先级队列官方文档:
六,优先级队列priority_queue
1,优先级队列的介绍和特征
优先级队列是C++STL中的容器适配器,不遵循"先进先出"的原则 。而是优先级最高的元素先出队。默认值的大小作为优先级。
1,使用时需要包含头文件#include <queue>
2,默认底层容器是vector,默认使用大堆维护元素顺序。
3,无迭代器,不支持遍历,不支持随机访问,只能访问堆顶元素。
4,时间复杂度:插入和删除均为O(logN),取堆顶元素为O(1)
5,对底层容器的要求:_1,是序列容器 _2,迭代器是随机访问容器 _3,提供以下成员函数
front() ``back()push_back()pop_back()size()empty()begin()/end()
因此标准库当中一般只有deque和vector能够支持。
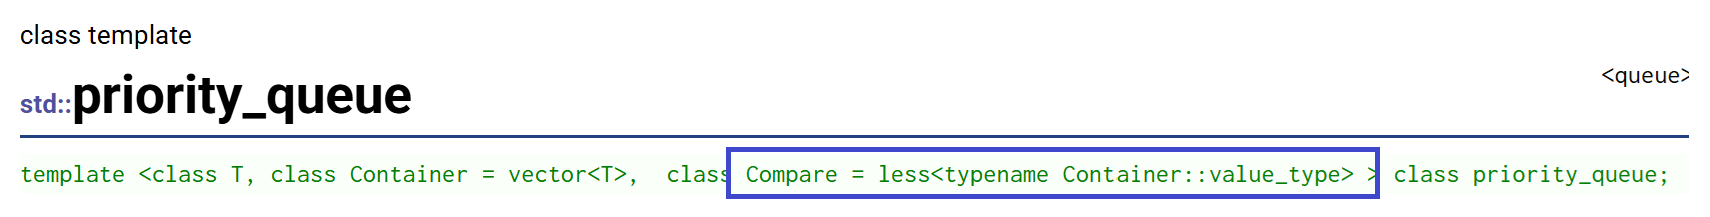
图中参数的第一个部分是元素的类型,第二个部分是容器,第三个部分是比较器
比较器部分决定了"谁先出队"的排序规则,默认是less,也就是大堆(最大的元素优先级最高)。
typename Container::value_type是容器中的元素类型也就是T
优先级队列支持的功能:
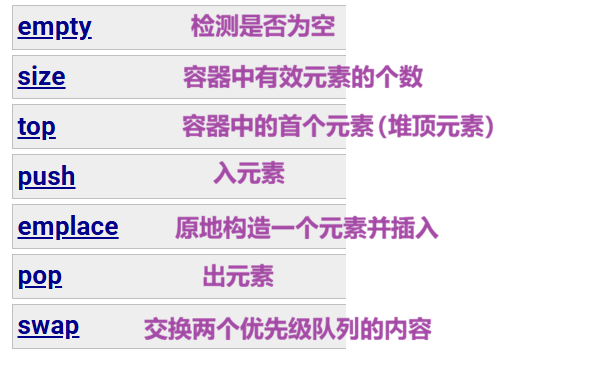
如何调整为一个小堆呢?
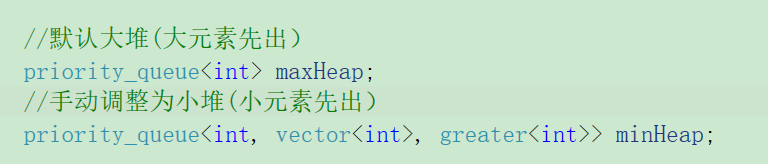
只需要将容器中比较器中的less改成greater即可。
这里的比较器部分就是一个仿函数,实际上是一个类。这个类当中写了元素的比较规则。
2,模拟实现一个优先级队列
cpp
#pragma once
//模拟实现优先级队列
template <class T>
class Less
{
public:
	bool operator()(const T& x, const T& y)
	{
		return x < y;
	}
};
template <class T>
class Greater
{
public:
	bool operator()(const T& x, const T& y)
	{
		return x > y;
	}
};

namespace att
{
	template<class T,class Container = vector<T> ,class Compare = Less<T>>
	class priority_queue
	{
	public:
		//向上调整-大堆
		void AdjustUp(int child)
		{
			Compare com;
			int parent = (child - 1) / 2;
			while (child > 0)
			{
				if (com(con[parent], con[child]))//通过仿函数
				{
					swap(con[parent], con[child]);
					child = parent;
					parent = (child - 1) / 2;
				}
				else
				{
					break;
				}
			}
		}

		//向下调整-大堆
		void Adjustdown(int parent)
		{
			Compare com;
			int child = parent * 2 + 1;//假设左孩子大
			while (child < con.size())//
			{
				//先找到大的那个孩子
				if (child + 1 < con.size() && com(con[child], con[child + 1]))
				{
					child++;
				}
				if (com(con[parent], con[child]))
				{
					swap(con[parent], con[child]);
					parent = child;
					child = parent * 2 + 1;
				}
				else
				{
					break;
				}
			}

		}
		//插入元素
		void push(const T& x)
		{
			con.push_back(x);
			AdjustUp(con.size() - 1);
		}

		//删除元素
		void pop()
		{
			swap(con[0], con[con.size() - 1]);
			con.pop_back();
			Adjustdown(0);
		}

		size_t size()const
		{
			return con.size();
		}
		const T& top()
		{
			return con[0];
		}
		bool empty()const
		{
			return con.empty();
		}
	private:
		Container con;
	};
}
运行结果:
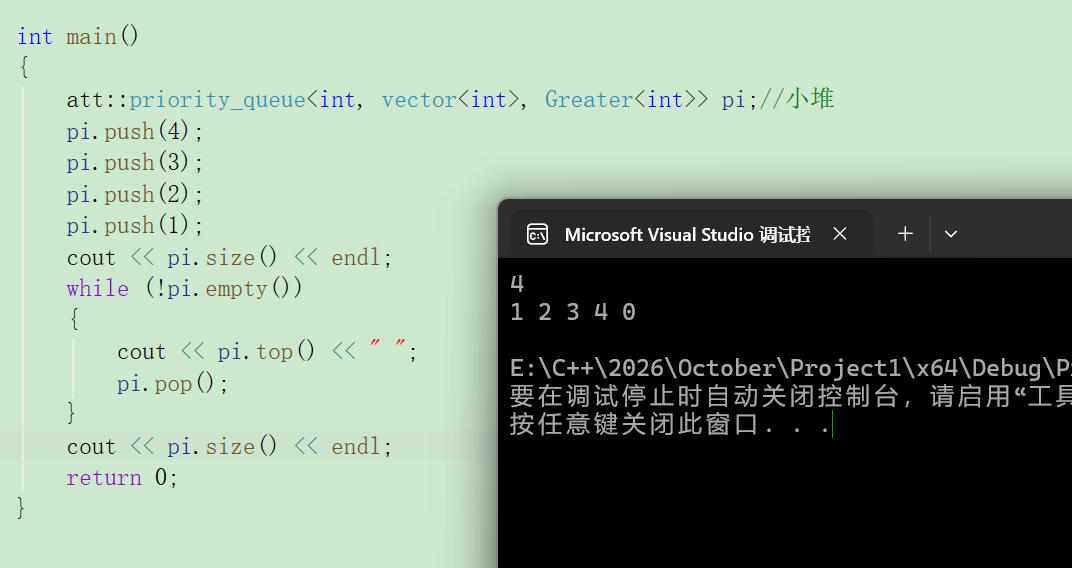
3,优先级队列的作用:
1,解决TOP-K问题
leetcode题目:数组当中的第k个最大元素
解法:
cpp
class Solution {
public:
    int findKthLargest(vector<int>& nums, int k) {
        priority_queue<int> q(nums.begin(),nums.end());
        for(int i = 0;i<k-1;i++)
        {
            q.pop(); //取出前k-1个元素
        }
        return q.top();
    }
};
七,仿函数
1,仿函数的介绍
仿函数,又称为函数对象,本质上是一个重载了operator() 的类 ,他的对象可以像普通函数那样进行调用:对象名(函数参数)。
对比普通函数,使用仿函数的好处:
-
可以携带状态 :仿函数是一个类,可以有成员变量。普通函数只能靠全局变量或静态变量来记录状态,而仿函数每次实例化都可以有不同的状态。
-
性能更高 :作为类,编译器在编译时就能确定调用逻辑,容易内联(Inline),没有函数指针跳转的开销。
-
可以作为类型 :普通函数是函数指针(运行时才能确定),而仿函数是一个类型,可以作为模板参数。
上面使用的Less和Greater就是仿函数。
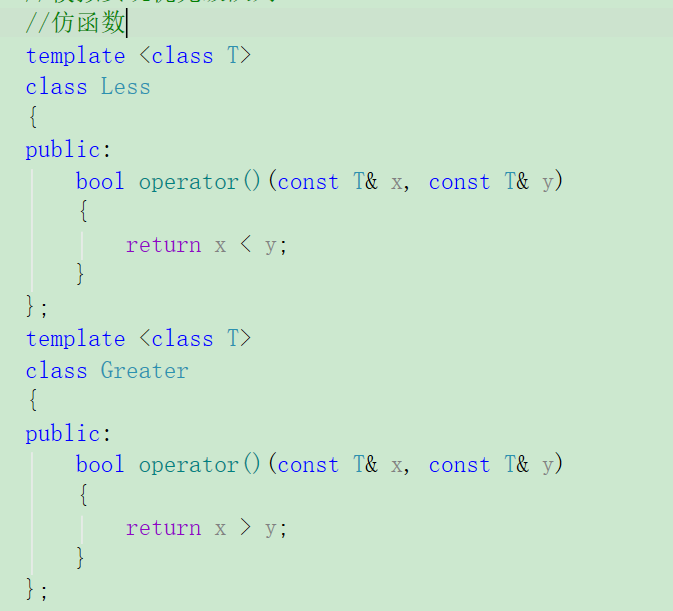
如上面所示:许多的仿函数都是一个空类,大小都是1
2,仿函数的使用
下面看一个仿函数的使用案例:排序
cpp
//仿函数控制升序和降序
template <class Compare>
void Buffsort(int* a, size_t n, Compare com)
{
	//控制趟数
	for (int i = 0;i < n;i++)
	{
		//单趟
		int flag = 0;
		for (int j = 1;j < n - i;j++)
		{
			if (com(a[j], a[j - 1]))//less升序,grather降序
			{
				swap(a[j], a[j - 1]);
				flag = 1;
			}
		}
		if (flag == 0)
		{
			break;//提前返回
		}
	}
}
运行展示:
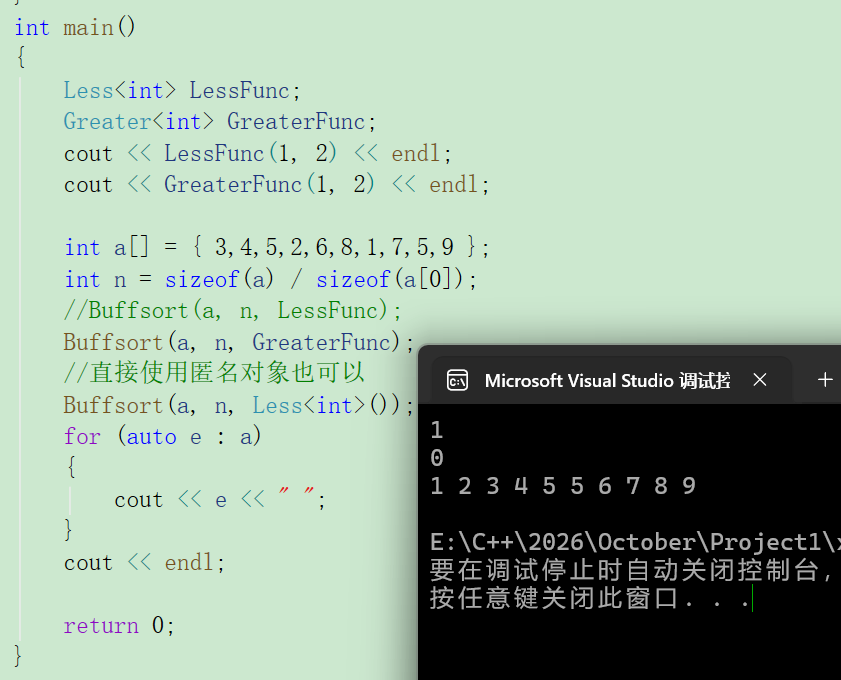
这里通过仿函数直接实现了升序和降序。有点类似模版,不过模版是自定义类型,而仿函数可以控制函数内部的规则。
使用案例2:日期类的比较
cpp
class Date
{
	friend ostream& operator<<(ostream& _cout, const Date& d);
public:
	Date(int year = 1980, int month = 1, int day = 1)
		: _year(year)
		, _month(month)
		, _day(day)
	{}

	bool operator<(const Date& d)const
	{
		return (_year < d._year) ||
			(_year == d._year && _month < d._month) ||
			(_year == d._year && _month == d._month && _day < d._day);
	}

	bool operator>(const Date& d)const
	{
		return (_year > d._year) ||
			(_year == d._year && _month > d._month) ||
			(_year == d._year && _month == d._month && _day > d._day);
	}
private:
	int _year;
	int _month;
	int _day;
};

ostream& operator<<(ostream& _cout, const Date& d)
{
	_cout << d._year << "-" << d._month << "-" << d._day;
	return _cout;
}
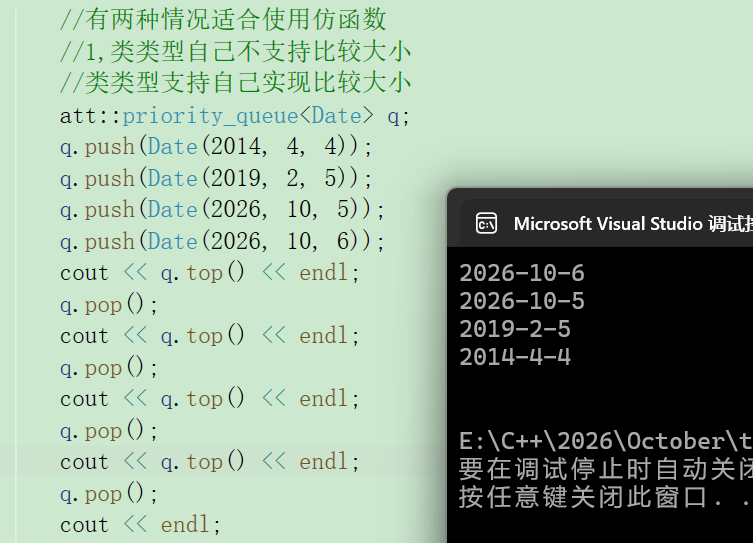
上面的日期类自己实现了比较的逻辑。
测试1:
测试2:
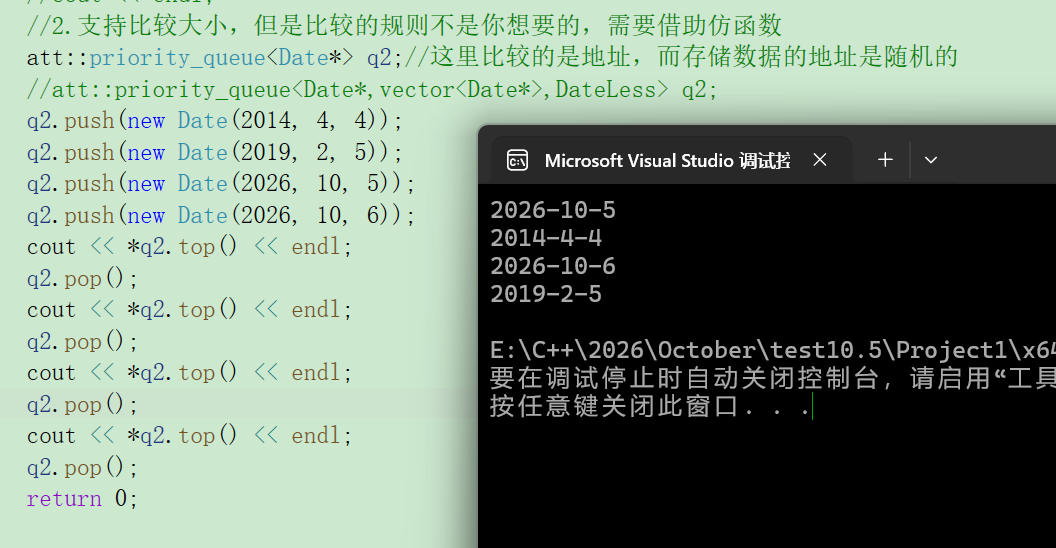
由于生成的地址大小是随机的,所以排列的顺序也是随机的。
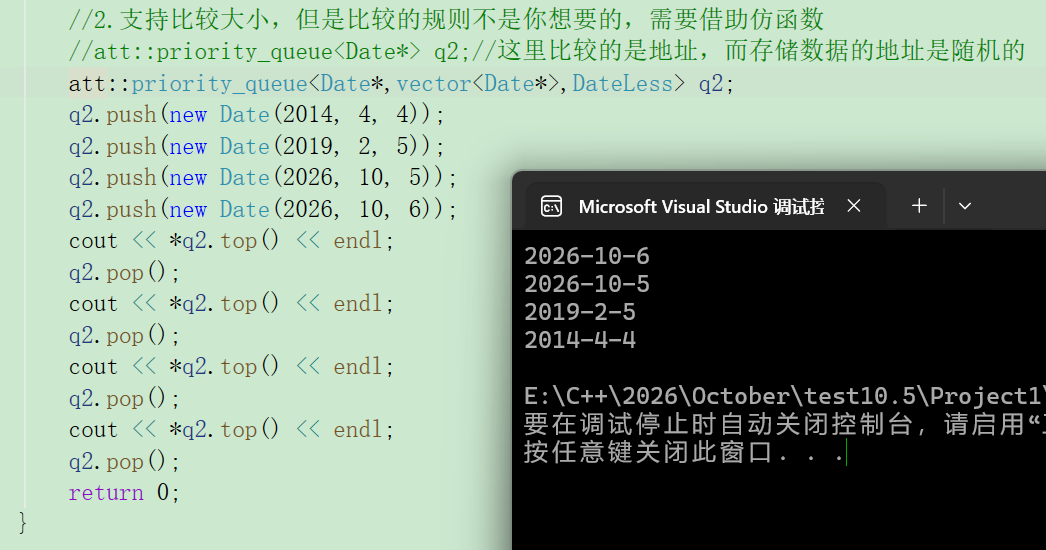
此时就需要仿函数来控制排序的逻辑
cpp
class DateLess
{
public:
	bool operator()(Date* p1, Date* p2)
	{
		return *p1 < *p2;
	}
};
本篇文章中所涉及到的代码:
gitee链接:容器适配器与仿函数
以上就是本文《 泛型世界的两块拼图:容器适配器与仿函数》的全部内容了,如果对你有所帮助的话,请大佬不妨给博主来个"一键三连",这对我是大大的支持,也能让博主产出更优质的内容。
结尾:
往期回顾:
总结:本文系统讲解C++中stack与queue的容器适配器实现,对比vector与list在栈、队列模拟中的优劣,并深入剖析deque(双端队列)的结构与性能特点。指出deque兼顾头尾高效操作与随机访问,成为stack和queue的默认底层容器。同时介绍priority_queue的原理与应用,结合仿函数实现自定义比较逻辑。
⚡把上面的内容吃透就休息一下吧⚡