▒ 目录 ▒
-
- [🛫 导读](#🛫 导读)
- [1️⃣ TCP编程](#1️⃣ TCP编程)
- [2️⃣ 详解TCP协议栈](#2️⃣ 详解TCP协议栈)
-
- [listen 参数的意义](#listen 参数的意义)
- [connect 和三次握手](#connect 和三次握手)
- [accept 做了什么](#accept 做了什么)
- [send 和协议栈发送缓冲区](#send 和协议栈发送缓冲区)
- [recv 和协议栈接收缓冲区](#recv 和协议栈接收缓冲区)
- 套接字发送和接收数据图解
- [close 的注意事项](#close 的注意事项)
- [send 和 sendall 区别](#send 和 sendall 区别)
- [3️⃣ 粘包和分包处理](#3️⃣ 粘包和分包处理)
- [4️⃣ UDP编程](#4️⃣ UDP编程)
-
- [使用 UDP 协议](#使用 UDP 协议)
- [UDP 有消息边界](#UDP 有消息边界)
- [UDP 和 TCP 区别](#UDP 和 TCP 区别)
- [5️⃣ TCP 没有天然的消息边界](#5️⃣ TCP 没有天然的消息边界)
- [🛬 文章小结](#🛬 文章小结)
🛫 导读
Socket 编程真正难的地方不是连上服务器,而是正确处理字节流、消息边界和连接生命周期。
本篇从 TCP 客户端和服务器端入手,沿着 listen()、connect()、accept()、send() 和 recv() 解释连接过程,再讨论粘包、分包与应用层协议。最后通过 UDP 理解面向连接与无连接通信的区别。
本篇知识路线
text
客户端                         服务器
 socket()                       socket()
    │                              │
 connect() ───── TCP 握手 ─────► bind()/listen()
    │                              │
    │ ◄──── accept() 建立连接 ─────┤
 send()/recv() ◄──── 字节流 ────► recv()/send()
 close()                         close()
1️⃣ TCP编程
两台计算机相互通信,就需要遵守规定的协议,就如人相互之间做生意要遵守约定的合同一样,早期的计算机网络,都是由各厂商自己规定一套协议,各大公司如 IBM,Apple 和 Microsoft 都有各自的网络协议,互不兼容,如果两台计算机使用不同的协议就会导致无法通信,就如两个人约定的合同不一样就无法做生意一样。
为了把全世界的所有不同类型的计算机都连接起来,就必须规定一套全球通用的协议,就如我们都遵守世贸协定,各个国家之间做生意就有章可循了。计算机之间最流行的通信协议为 TCP 和 UDP 协议。
目前世界上的操作系统基本上都实现了 TCP 和 UDP 协议,我们在编写程序的时候,用套接字直接使用操作系统提供的 API 即可。
套接字就是网络通信协议其中一种最常见的现实方式,套接字也叫 socket,它是基于 C/S 架构的,也就是说进行 socket 网络编程,通常需要编写两个程序,一个服务端,一个客户端。
我们基于 TCP 协议,写两个应用程序进行通信,一个叫做服务器,一个叫做客户端。客户端就如打电话的一端,服务器类似于被呼叫的一端。
服务器
首先要创建套接字,绑定套接字到本地 IP 与端口,然后开始监听连接,等待客户端的连接请求,接收传来的数据,或者发送数据给对方,传输完毕后,关闭套接字。
python
import socket

sv_socket = socket.socket(socket.AF_INET, socket.SOCK_STREAM)  # 创建套接字
sv_ipport = ("0.0.0.0", 8889)          # 监听的 ip 和端口
sv_socket.bind(sv_ipport)              # 绑定服务地址
sv_socket.listen(5)                    # 协议栈缓冲区最大套接字存放个数
print('启动服务器,等待客户端连接......')

server_socket, addr = sv_socket.accept()
while True:
    client_data = server_socket.recv(1024).decode("utf-8")  # 接收信息
    if (client_data == "exit") or (not client_data):        # 判断客户端是否申请结束会话或客户端是否退出
        break
    print("收到客户端信息:%s" % client_data)
    server_data = input("请输入要发送给客户端的信息:")
    server_socket.send(server_data.encode("utf-8"))         # 发送信息

server_socket.close()  # 关闭套接字
现在我们先简单分析一下服务器端的代码,下节课我们会详细讲解套接字的各种知识,大家这节课先把服务器和客户端跑起来,能正常通信就达到了学习的目的。
首先,创建一个基于 IPv4 和 TCP 协议的 Socket。其中 AF_INET 代表协议家族,AF_INET(又称 PF_INET)是 IPv4 网络协议的套接字类型,AF_INET6 则是 IPv6 的;而 AF_UNIX 则是 Unix 系统本地通信,我们使用 AF_INET 的目的就是使用 IPv4 进行通信,因为 目前 IPv6 还没有普及。SOCK_STREAM 是指流式套接字,也就是基于 TCP 协议的 socket。
text
sv_socket = socket.socket(socket.AF_INET, socket.SOCK_STREAM)服务器进程的套接字首先要绑定一个 IP,我在此绑定的 IP 是 0.0.0.0,该 IP 代表本机的所有 IP 都可以,该 IP 代表本机回送 IP127.0.0.1 或者本机公网 IP 或者本机局域网 IP。然后服务器进程还需要绑定一个端口并监听来自其他客户端的连接。如果某个客户端连接过来了,服务器就与该客户端建立 socket 连接,随后的通信就靠这个 socket 连接了。
如果我们把电脑看成一个小区,IP 地址就相当于一个小区,一个小区有很多户人家,端口就相当于一个小区的某户人家,两个进程通信,就是来访者到该小区的某户进行拜访交流。所以套接字一定要包含 IP 和端口才能通信。
服务器可以同时响应多个客户端的请求,就如某户人家可以同时接待很多朋友来访一样。但是,每个服务器对每个客户端的连接都需要并发处理,这样才不会让客户端感觉受到了怠慢,并发的方案有多进程多线程或者单线程异步轮询比如协程等等,否则,服务器一次就只能服务一个客户端了。
text
sv_socket.bind(('0.0.0.0', 8889))listen 的参数代表的是 TCP/IP 协议栈缓冲区最大阻塞监听连接数,也就是可以存储的返回给 accept 的客户端的连接请求最大个数,这个参数是面试题经常问到的问题,很少有人能正确的回答,下节课我们会用案例来详细讲解这个参数。
text
sv_socket.listen(5)关于 accept 的是什么意思,也是面试的时候经常问到的问题,accept 是服务器进程从操作系统的 TCP/IP 协议栈缓冲区中取出发起连接的客户端的套接字,这个套接字就是 listen 对接的客户端的套接字,当 accept 取出该套接字返回给应用层,协议栈就把该套接字去掉,listen 可处理的客户端连接就多出来一个。
text
server_socket, addr = sv_socket.accept()很多人认为 recv 是接收客户端发来的字节流,这是错误的认知,实际上 recv 是从当前操作系统的 TCP/IP 协议栈缓冲区内取出网卡已经接收到的客户端发来的字节流。关于 recv 的案例我们下节课详细讲解。
注意:我们用 recv 接收到的数据是客户端发来的字节流(因为网络上只能传输字节流),所以我们用 decode("utf-8") 解码成字符串。
text
client_data = server_socket.recv(1024).decode("utf-8")如果客户端调用 close 关闭套接字,我们服务器端就会收到客户端发来的空字节流(注意:这个空字节流是客户端的操作系统的 TCP 协议栈发送的),所以我们判断 client_data 为空时,我就认为客户端关闭连接。
我们脑补一下,双方通信就如一次会谈,有的客人想主动结束这次会谈,直接就走了(直接调用套接字的 close),但有些客人出于礼貌,他在走之前发给我们一个含蓄的信息,告诉我们他想走了,让我们主动结束这次会谈。对于代码 client_data == "exit",这个意思就是客户端告诉我们他想走了,我们也不强人所难,就调用了 break 退出这个循环。然后调用 server_socket.close()结束这次会谈。
python
if (client_data == "exit") or (not client_data)
    break
send 函数并不是把数据发送到对方机器上,而是发送数据到本机操作系统的 TCP/IP 协议栈缓冲区,然后由协议栈缓冲区通过网卡把数据发送到网络上,数据在网络上通过路由器找到客户端的 IP 地址,然后在通过端口号找到客户端的通信进程。
因为网络上只能传送字节流,我们首先用代码 encode("utf-8")要把发送的数据编码成字节流,然后调用 send 发送到本机的 TCP/IP 协议栈缓冲区。
text
server_socket.send(server_data.encode("utf-8"))注意,在输入内容的时候,如果直接敲回车,input 会收到空字符串,但是,send 函数是不能发送空内容的(只有调用 close 的时候,操作系统的 TCP 协议栈才能发送空字节流),所以,send 就成了一条无效的语句。
客户端
我们在此写个和服务器通信的客户端代码,大家先运行上面的服务器代码,然后再运行这个客户端代码,双方就可以进行数据传输了,客户端代码如下。
python
import socket

client_socket = socket.socket()     # 创建套接字
ip_port = ("127.0.0.1", 8889)       # 要连接的服务器的 ip 和端口
client_socket.connect(ip_port)      # 连接服务器
while True:
    client_data = input("请输入要发送给服务器的信息:")
    client_socket.send(client_data.encode("utf-8"))         # 发送信息

    server_data = client_socket.recv(1024).decode("utf-8")  # 接收信息
    if (server_data == "exit") or (not server_data):        # 判断服务器是否申请结束会话或客户端是否退出
        break
    print("收到服务器信息:%s" % server_data)

client_socket.close()  # 关闭套接字
我们在此先简单分析一下客户端的代码,下节课我们会详细讲解客户端的几个经常被理解错误,面试经常被问到的几个函数,这节课先把服务器和客户端跑起来,能正常通信就达到了学习的目的。
首先,客户端应该知道通信的服务器端的 IP 和端口,注意,客户端不能用 "0.0.0.0"这个地址去连接服务器,如果客户端和服务器是在一台机器上,我们一般用 "127.0.0.1",如果是在同一个局域网的不同机器上,我们用服务器的局域网 IP 地址(192.168.X.X 或者10.X.X.X)开头的 IP 地址,如果不在同一局域网上,我们用服务器的公网 IP。当然,如果是同一台机器,我们可以使用 "127.0.0.1",也可以使用局域网 IP 或者公网 IP。
text
ip_port = ("127.0.0.1", 8889) # 要连接的服务器的 ip 和端口connect 函数向服务器端发起来三次握手,三次握手成功后,就和服务器建立了连接,关于连接这个概念,也是面试的时候经常要问的,老鸟面试了 N 多个程序员,能说出个所以然的码农很少,包括很多大厂的资深程序员,我在此简单说一下,详细分析放到下一节课,三次握手建立的连接是逻辑上的概念,也就是双方的操作系统的 TCP/IP 协议栈缓冲区的套接字状态设定为 ESTABLISHED 状态,这个值就是认为双方是连接上了(经过了三次握手的考验),哪怕你把双方的网线拔掉了,这两个进程也认为他俩还是连接着的。就如有个段子说的:"我们只认证,不认人"。
text
client_socket.connect(ip_port) # 连接服务器大家还记得服务器端的 listen 函数吗,我们这个客户端的 connect 成功后,服务器进程所在的计算机就会在他的操作系统的 TCP/IP 协议栈缓冲区中创建一个和客户端通信的套接字,这个套接字就占用了一个 listen 名额,被阻塞在 listen 队列中,直到服务器的 accept 函数从协议栈缓冲区取出这个套接字。
程序结果演示
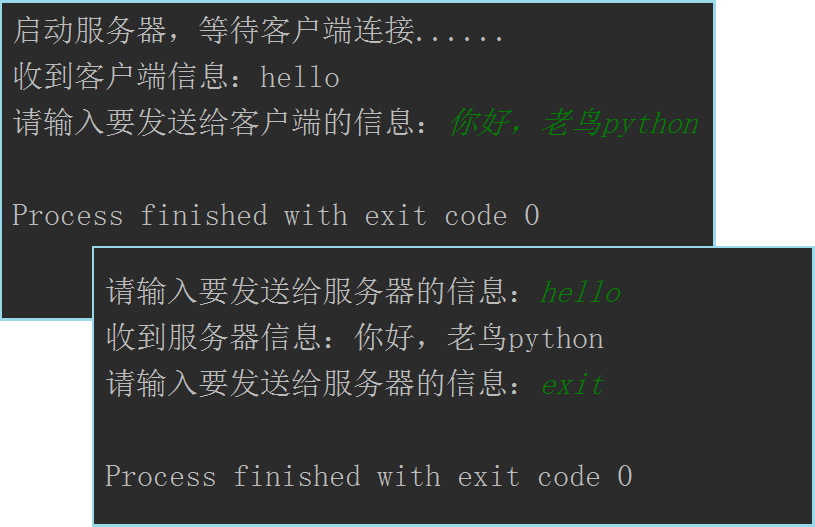
首先我们先运行服务器,然后运行客户端,在客户端中输入"hello",然后敲回车,这时候我们就看到服务器程序打印出了"收到客户端信息:hello"。然后服务器输入"你好,老鸟python",这时候我们看到客户端程序打印出"收到服务器信息:你好,老鸟python"。我们在客户端输入"exit",然后我们发现服务器进程结束,客户端进程也结束了。
注意:同一种协议类型的端口一旦被占用,就不能再被其它进程使用了,比如我们服务器绑定了基于 TCP 协议的端口 8889,其它基于 TCP 协议的进程如果再绑定 8889 端口,就会失败。如果是基于其它协议类型,比如 UDP,则可以使用 8889端口,这个端口和 TCP 的 8889 端口不是一个。当然,UDP 的端口也不能被同一种协议重复绑定。
2️⃣ 详解TCP协议栈
上一节,我们手把手教大家编写一个基于 TCP 协议的服务器和客户端,并完成了简单的通信功能。我们还给大家简单分析了套接字的各个函数的意思,其实 TCP 协议是很复杂的,但是,我们只需要了解几个重要的概念,就可以使用 TCP 协议完成公司的项目的开发。
本节课,我们详细讲解 TCP 协议的 connect,listen,accept,send,recv,close 等这些函数在面试的时候经常被问到,但是,大多数老码农弄错了,教科书上更是错误百出。
在详细讲解 TCP 协议的这些函数之前,大家一定要弄明白一个概念,TCP 协议是在操作系统中实现的,我们应用层调用的套接字提供的所有函数,全都是和操作系统的 TCP 协议栈交互的。比如,套接字的 send 函数是发送数据到本机操作系统的 TCP 协议栈缓冲区中,而协议栈缓冲区才负责把这些数据通过网络发送到对方的机器上。我们本节课会给大家详细的讲解和试验。
listen 参数的意义
在讲解 listen 之前,我们先规定一个概念,就是调用 listen 函数的进程叫服务器,调用 connect 函数的进程叫客户端。
listen 参数代表的是协议栈缓冲区内能存放的 connect 连接成功的最大套接字个数,假设这个参数设置为 2,当 客户端 connect 成功一次,服务器端就生成一个套接字放在协议栈缓冲区中,这时候再来一个客户端 connect 成功了,协议栈缓冲区就有两个套接字了,此时,协议栈缓冲区能存放的套接字个数已经达到了上限。
如果再有客户端 connect 过来,我们的操作系统一般会直接拒绝该连接请求,或者操作系统会做一个超时暂存,就是把该连接请求暂缓,如果一定时间内,协议栈缓冲区有了空位(有套接字被 accept 取出),就和客户端进行连接,连接成功后,就把该套接字放入协议栈缓冲区。
一般情况下,我们设置 listen 参数为 5,至于为什么是 5 而不是 6,其实,没多大啥区别,因为都够用哈哈,因为我们连接成功一个客户端,在协议栈缓冲区生成一个套接字,就会马上调用 accept 函数从该协议栈缓冲区取出一个套接字,这个存放套接字的协议栈缓冲区就如一个漏斗,倒入(connect)的水马上就漏出来(accept)了,除非我们特意的不调用 accept 取出套接字,下面我们就做一个实验。
python
'''
此为服务器程序
'''
import socket

sv_socket = socket.socket(socket.AF_INET, socket.SOCK_STREAM)  # 创建套接字
sv_ipport = ("0.0.0.0", 8889)          # 监听的 ip 和端口
sv_socket.bind(sv_ipport)              # 绑定服务器地址
sv_socket.listen(2)                    # 协议栈缓冲区最大套接字存放个数
print('启动服务器,等待客户端连接......')

while True:
    input("阻塞中......")  # 让代码阻塞在此处
    server_socket, addr = sv_socket.accept()  # 从协议栈缓冲区中取出一个套接字

server_socket.close()  # 关闭套接字
python
'''
此为客户端程序
'''
import socket

client_socket = socket.socket()     # 创建套接字
ip_port = ("127.0.0.1", 8889)       # 要连接的服务器的 ip 和端口
client_socket.connect(ip_port)      # 连接服务器
input("已经连接服务器成功......")    # 让代码阻塞在此处,防止客户端退出
client_socket.close()
我们启动服务器程序后,程序会阻塞在 input("阻塞中......") 这条语句,然后启动两个客户端(注意,客户端启动后不要关闭),你会发现这两个客户端都连接成功了, 当你启动第三个客户端的时候,大概等待一两秒钟,服务器就拒绝了我们的连接,此时,你会发现客户端报如下错误。
python
Traceback (most recent call last):
  File "E:/tcpproject/tcpclient.py", line 5, in <module>
    client_socket.connect(ip_port)      # 连接服务器
ConnectionRefusedError: [WinError 10061] 由于目标计算机积极拒绝,无法连接。
这个时候,我们随便在服务器端输入一些内容,敲回车,目的是让服务器通过 input("阻塞中......") 这条语句,然后服务器进程开始执行 server_socket, addr = sv_socket.accept() 这条语句,该语句从服务器的 TCP 协议栈缓冲区中取出第一个和客户端连接成功生成的套接字,这个时候,我们协议栈缓冲区就多出来一个空位了,然后我们第四次运行客户端程序,你会发现第四个客户端就可以连接成功了。
connect 和三次握手
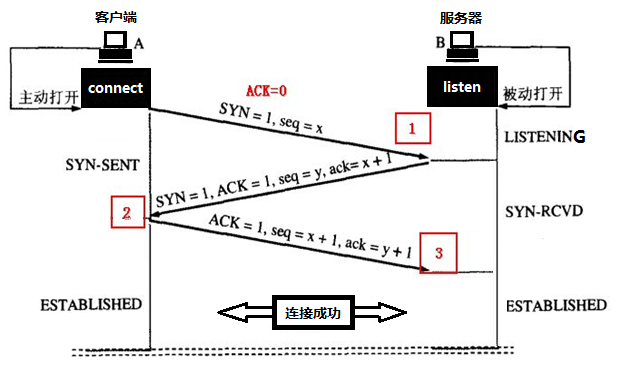
当服务器执行完 listen 后,服务器就处于被动监听状态,一直等待着客户端的连接到来,当客户端执行 connect 函数后,如果 connect 成功,服务器就会在 TCP 协议栈缓冲区内生成一个和该客户端通信的套接字,这个套接字是在服务器端调用 accept 函数时返回给我们的程序的。那么客户端的 connect 到底是怎么和服务器建立连接的呢?整个建立连接的过程如下图所示。
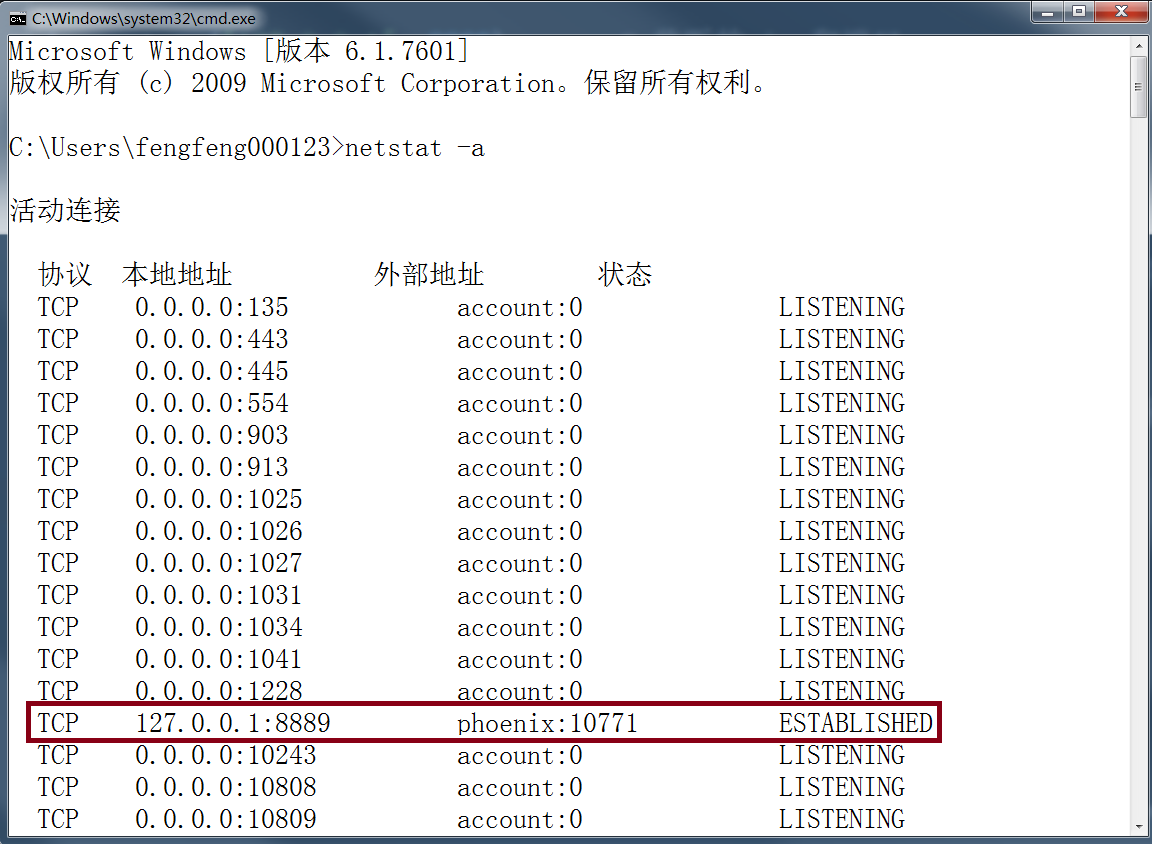
基于 TCP 的应用程序之间如何保证双方的线路是通的,就是靠 TCP 三次握手来确定的,首先服务器进程调用的 listen 函数使得服务器进程的套接字处于进入 LISTENING 状态,然后,进入控制台下,输入命令 natstat -a 列出进程正在使用的 TCP 套接字,此时我们可以看到 IP 为 0.0.0.0 端口为 8889 的套接字所处的状态是 LISTENING。
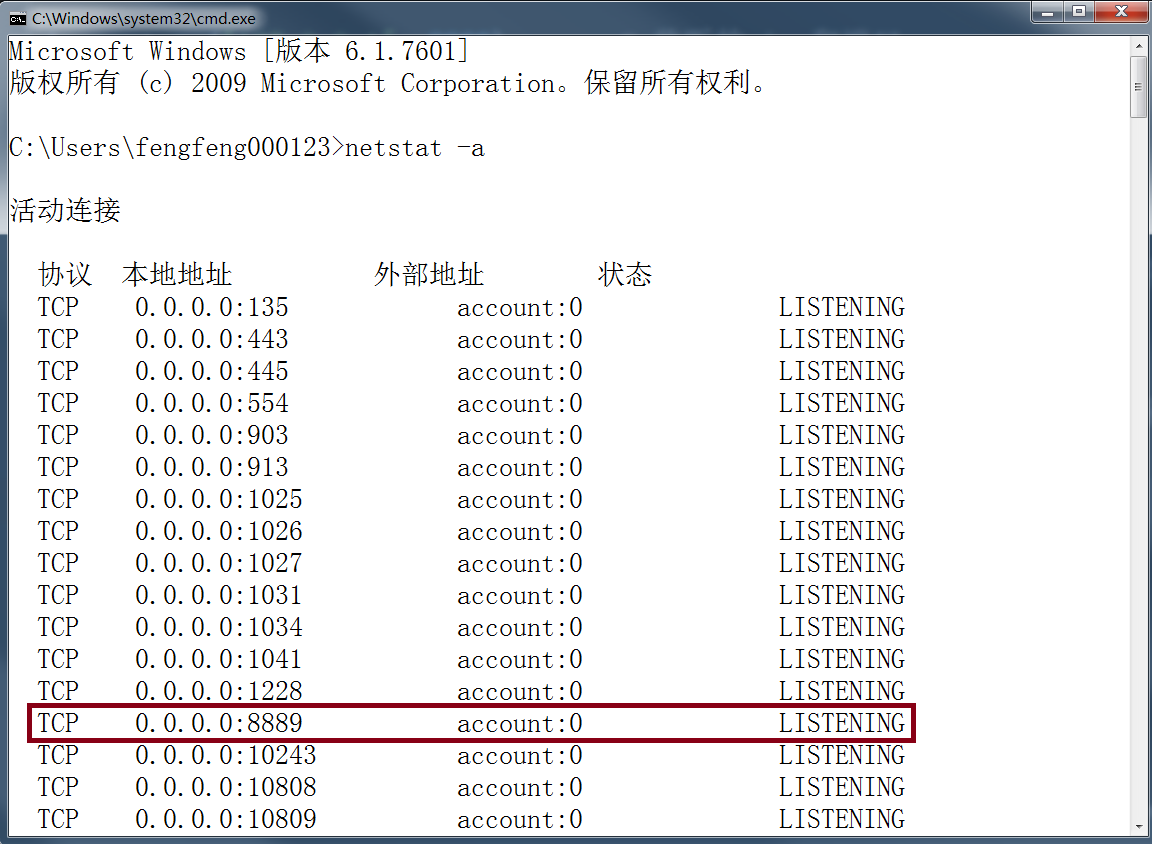
然后我们执行客户端程序,客户端进程调用 connect 函数触发三次握手。第一次握手:建立连接时,客户端发送 SYN 包到服务器,并进入 SYN_SEND 状态,等待服务器确认;第二次握手:服务器收到 syn 包,必须确认客户的 SYN,同时自己也发送一个 SYN 包,此时服务器进入 SYN_RECV 状态;第三次握手:客户端收到服务器的 SYN+ACK 包,向服务器发送确认包,此包发送完毕,客户端和服务器进入 ESTABLISHED 状态,完成三次握手。当然,由于建立三次握手过程变化很快,我们的 natstat -a 命令只能看到连接成功或不成功的结果,如下图是握手成功的结果。
如果同学们想看每次握手中套接字变化的状态,可以使用抓包工具,比如 wireshark,具体使用方式请自行搜索。
accept 做了什么
首先,大多数同学都误认为 accept 对应的是客户端的 connect,其实大家通过我前面的理论阐述和实例验证,应该知道这是错误的认知了。
一句话,accept 和 connect 并没有任何关系,accept 函数只是从本地 TCP 协议栈缓冲区的套接字存放队列中取出一个已经完成三次握手的套接字而已。 accept 每取出一个套接字,协议栈缓冲区的套接字存放队列就移除一个最早完成的套接字, listen 函数的参数可接收最大三次握手的个数就会空出来一个。
大家注意,不要把 accept 取出的套接字和我们服务器监听的套接字混淆了,我们可以把服务器监听的套接字看做电话的主机,accept 返回的套接字看做电话的分机,主机负责监听客户端的连接,分机负责和客户端发送和接收数据。
send 和协议栈发送缓冲区
我们在应用程序中调用套接字的 send 函数往对方发送数据,并不是直接发送到网络上,而是把数据发送到我们本机操作系统的 TCP 协议栈缓冲区中,这个套接字缓冲区是由操作系统维护的,至于何时把缓冲区中的数据发送到网络上,是由操作系统决定的。
下面我们就做个试验,在服务器代码中的 recv 语句之前多加上一句代码 input("阻塞中......"), 我们让客户端 send 两次,然后在服务器端随便输入内容,敲回车通过 input 语句,就调用 recv 一次,看看是不是一次性就能收全。
python
'''
此为服务器程序
'''
import socket

sv_socket = socket.socket(socket.AF_INET, socket.SOCK_STREAM)  # 创建套接字
sv_ipport = ("0.0.0.0", 8889)          # 监听的 ip 和端口
sv_socket.bind(sv_ipport)              # 绑定服务地址
sv_socket.listen(5)                    # 协议栈缓冲区最大套接字存放个数
print('启动服务器,等待客户端连接......')
server_socket, addr = sv_socket.accept()

input("阻塞中......")  # 让代码阻塞在此处

client_data = server_socket.recv(1024).decode("utf-8")  # 调用 1 次
print("收到客户端信息:%s" % client_data)

server_socket.close()  # 关闭套接字
python
'''
此为客户端程序
'''
import socket

client_socket = socket.socket()     # 创建套接字
ip_port = ("127.0.0.1", 8889)       # 要连接的服务器的 ip 和端口
client_socket.connect(ip_port)      # 连接服务器

client_data = input("请输入要发送给服务器的信息:")
client_socket.send(client_data.encode("utf-8"))    # 第一次发送信息

client_data = input("请输入要发送给服务器的信息:")
client_socket.send(client_data.encode("utf-8"))    # 第二次发送信息

client_socket.close()
通过实验,我们发现在等客户端调用两次 send 后,再调用服务器端的 recv,确实一次性收到了客户端两次发送的全部内容。
注意:系统存在缓冲区默认字节一般为 8 K,这个值我们可以通过 setsockopt 进行修改。调用 send 发送的数据如果大于发送缓冲区所能容纳的数据量,send 函数就会阻塞。我们可以让服务器代码阻塞在 recv 函数之前,然后让客户端不停的 send 数据,直到客户端的协议栈发送缓冲区满了,你就会发现客户端代码就会阻塞在 send 函数处了,然后你让服务器端的 recv 接收一小部分,客户端就又可以发送数据了。这个原理就如水管被堵塞,储水的水池慢慢的就满了,然后让水管流出一部分水,就又可以往水池里面加水了,同学们可以做个试验验证一下。
recv 和协议栈接收缓冲区
我们在应用程序中调用套接字的 recv 函数,该函数是从本机操作系统的 TCP 协议栈接收缓冲区中取出数据,这个协议栈缓冲区是由操作系统维护的,我们在程序中调用 recv 取出一部分数据,操作系统的协议栈接收缓冲区就去除掉这一部分数据。
recv 的参数代表一次性从协议栈接收缓冲区内取出多少数据,一般情况下我们会写个 while 循环不停的取数据,直到取出我们想要的完整数据。在此,该参数我设为 1024 只是随手一挥。注意,recv 并不是要取出这么多的数据才返回,只要协议栈接收缓冲区里面有数据,我们的 recv 函数就马上返回,recv 的参数只是代表一次性最多取多少数据。
下面我们就做个试验,我们让客户端 send 一次,让服务器 recv 多次,直到取出客户端发送的所有数据为止。
python
'''
此为服务器程序
'''
import socket

sv_socket = socket.socket(socket.AF_INET, socket.SOCK_STREAM)  # 创建套接字
sv_ipport = ("0.0.0.0", 8889)          # 监听的 ip 和端口
sv_socket.bind(sv_ipport)              # 绑定服务地址
sv_socket.listen(5)                    # 协议栈缓冲区最大套接字存放个数
print('启动服务器,等待客户端连接......')

server_socket, addr = sv_socket.accept()
while True:
    client_data = server_socket.recv(3).decode("utf-8")  # 每次从接收缓冲区取出 2 个字节流
    if (client_data == "exit") or (not client_data):     # 判断客户端是否申请结束会话或客户端是否退出
        break
    print("收到客户端信息:%s" % client_data)

server_socket.close()  # 关闭套接字
python
'''
此为客户端程序
'''
import socket

client_socket = socket.socket()     # 创建套接字
ip_port = ("127.0.0.1", 8889)       # 要连接的服务器的 ip 和端口
client_socket.connect(ip_port)      # 连接服务器
while True:
    client_data = input("请输入要发送给服务器的信息:")  # 输入内容的长度请大于 2
    client_socket.send(client_data.encode("utf-8"))     # 发送信息
    if client_data == "exit":  # 输入 exit 客户端退出循环
        break

client_socket.close()
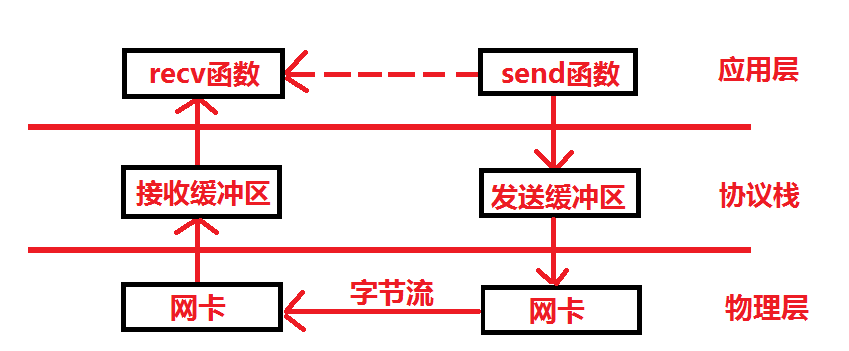
套接字发送和接收数据图解
最后,我们用一个简单的图来描述一下基于 TCP 协议的应用程序发送和接收数据的流程图。
close 的注意事项
套接字的 close 函数完成了断开连接,也就是把操作系统维护的 TCP 协议栈缓冲区中的套接字移除,这个移除的过程被称为四次挥手,具体是如何挥手的,有兴趣的话,大家可以自行搜索。
你不需要了解四次挥手的过程,你只要知道 close 做了什么,以及如何安全的使用 close 即可。
无论是在服务器进程还是客户端进程,谁先调用 close,谁的协议栈缓冲区就往对方发送一个空字节流。所以,我们在客户端和服务器的代码中都有一个判断 recv 收到的内容是不是空字符串,如果为空,我们就退出循环,然后调用 close 函数,那这个后调用的 close 起到了什么作用呢?这个大家可以理解为一个礼貌的回应,就是告诉先调用 close 的一方:"好的,我收到了,我关闭了,你也关闭吧",然后先调用 close 的一方也就关闭了套接字。
如果你的进程结束了,但是你代码中忘记调用 close,此时,操作系统会替你给对方发送一个空字节流(和你调用 close 触发的行为一样)。这是因为进程使用的套接字是操作系统分配的文件对象,当进程结束后,操作系统会检查该进程是否有未归还的资源,如果有的话,操作系统会自动回收,你进程中忘记调用套接字的 close 函数,套接字这个文件对象就没有归还给操作系统,此时,操作系统就会强制回收该套接字,然后善后套接字未完成的行为(给通信的一方发送空字节流)。
最后说一句,虽然操作系统有给我们擦屁股的功能,但是我们也要养成一个好习惯,就是套接字使用完,一定要调用 close 函数关闭套接字。
send 和 sendall 区别
python 的套接字提供两个可以发送数据的函数 send 和 sendall,当然这两个函数都是把数据发送到本地协议栈发送缓冲区中,但是,他们在发送数据的方式方面有些不同。
send 函数发送数据时,如果返回值大于 0 代表发送数据成功,如果是其它值则代表发送错误。注意,调用一次 send,并不一定发送完你要发送的所有数据,send 的返回值是发送到缓冲区的字节流个数,所以要根据返回值判断,编程继续发送剩余的部分。
举个栗子:我们在应用层调用 send 发送的内容有 20000 个字节流,但协议栈发送缓冲区目前还剩下的空间只能接受 8000 个字节流就满了,这时候 send 的返回值就是 8000,还剩余 12000 个字节流没有发送到协议栈接收缓冲区内, 这时候,我们就需要继续调用 send 继续发送剩余的内容。
而 python 的哲学讲究简单即是真理,所以 python 给我们提供了 sendall 函数,sendall 函数会自动判断每次发送的字节流个数,然后从总内容中删除已发送的部分,继续自动发送剩余的部分,一直到把数据全部发送完成。 实际上,sendall 函数是对 send 函数的封装,当发送的数据太大时(没法一次性把数据发送到协议栈发送缓冲区内),sendall 是不停的调用 send 发送数据,直到全部发送完才返回,注意,sendall 发送成功的返回值为 None。下面的代码就是 sendall 是如何实现的。
python
def sendall(data):
    len = 0
    while True:
        len = s.send(data[len:])
        if not len:
            break
    return None
3️⃣ 粘包和分包处理
大家发现我们前面举的例子,发送数据时都是直接 send,接收数据时都是直接 recv,前面的例子只适合作为 demo 来学习,而这种写法在实际项目开发中是不切合实际的。在实际项目开发中,编写基于 TCP 协议通信的应用程序,最容易犯的错误就是粘包分包问题,本节课我们详细分析粘包分包的原因以及如何解决粘包分包。
粘包分包的原因
经过前面我们对 TCP 协议的详细分析,我们知道调用套接字的 send 发送数据时,是把数据发送到本机操作系统维护的 TCP 协议栈发送缓冲区中,而发送缓冲区"28LLLLLLLL"什么时候把数据发送到网络上,则是由操作系统规定的。而调用 recv 接收数据时,是从本机操作系统的 TCP 协议栈接收缓冲区内取数据,我们可以自己设置参数一次性最大取多少。应用层的 send 和 recv 无法一一对应,这是导致粘包分包的根本原因所在。
分包原因
我们目前的互联网结构是基于以太网的,一个以太网包只能传输 1500 字节长度的数据,而这其中,IP 头和 TCP 头各占去了 20 个字节,因此,有效载荷为 1460。
如果你要发的一段数据的长度超过了 1460,假设为 3000,那么必然被分成多个以太网包发送过来,对于接收方来说,如果每次接受 1024 个字节,则需要多次 recv 才能把整段数据接收。当然,也有可能你发送的数据不足 1460,由于网络问题,协议栈发送缓冲区也有可能给把数据分成多次发送到客户端。
举个栗子:发送方发送字符串"老鸟python",接收方却接收到了三个字符串"老"和"鸟pyth"和"on"。
python
'''
此为服务器程序
'''
import socket

sv_socket = socket.socket(socket.AF_INET, socket.SOCK_STREAM)  # 创建套接字
sv_ipport = ("0.0.0.0", 8889)          # 监听的 ip 和端口
sv_socket.bind(sv_ipport)              # 绑定服务地址
sv_socket.listen(5)                    # 协议栈缓冲区最大套接字存放个数
print('启动服务器,等待客户端连接......')

server_socket, addr = sv_socket.accept()

while True:
    client_data = server_socket.recv(1024).decode("utf-8")  # 接收信息
    if (client_data == "exit") or (not client_data):  # 判断客户端是否申请结束会话或客户端是否退出
        break
    print("收到客户端信息:%s" % client_data)

server_socket.close()  # 关闭监听的服务器套接字
python
'''
此为客户端程序
'''
import socket
import time

client_socket = socket.socket()     # 创建套接字
ip_port = ("127.0.0.1", 8889)       # 要连接的服务器的 ip 和端口
client_socket.connect(ip_port)      # 连接服务器

'''
假如我们的代码是:client_socket.send("老鸟python".encode("utf-8"))
我们本意是把"老鸟python"看成一个整体发送给客户端。
结果协议栈由于某种原因给我们分为三次发送。
下面的代码我们模拟协议栈的发送行为。
'''

# 模拟协议栈第 1 次发送
client_socket.send("老".encode("utf-8"))  # 发送信息
time.sleep(1)

# 模拟协议栈第 2 次发送
client_socket.send("鸟pyth".encode("utf-8"))  # 发送信息
time.sleep(1)

# 模拟协议栈第 3 次发送
client_socket.send("on".encode("utf-8"))  # 发送信息

client_socket.close()  # 关闭套接字
运行结果:
text
启动服务器,等待客户端连接......
收到客户端信息:老
收到客户端信息:鸟pyth
收到客户端信息:on
粘包原因
粘包则和分包相反,你要发送的数据长度很短,比如只有 20 个字节左右,如果你以非常快的速度发送,那么有可能一个以太网包里包含了好几段数据,他们是被一起发送过来的,这时接收方 recv 得到的数据是好几段数据连在一起,无法分开。
举个栗子:发送方发送两个字符串"老鸟"和"python",接收方却一次性接收到了"老鸟python"。
python
'''
此为服务器程序
'''
import socket

sv_socket = socket.socket(socket.AF_INET, socket.SOCK_STREAM)  # 创建套接字
sv_ipport = ("0.0.0.0", 8889)          # 监听的 ip 和端口
sv_socket.bind(sv_ipport)              # 绑定服务地址
sv_socket.listen(5)                    # 协议栈缓冲区最大套接字存放个数
print('启动服务器,等待客户端连接......')

server_socket, addr = sv_socket.accept()

while True:
    client_data = server_socket.recv(1024).decode("utf-8")  # 接收信息
    if (client_data == "exit") or (not client_data):  # 判断客户端是否申请结束会话或客户端是否退出
        break
    print("收到客户端信息:%s" % client_data)

server_socket.close()  # 关闭监听的服务器套接字
python
'''
此为客户端程序
'''
import socket

client_socket = socket.socket()     # 创建套接字
ip_port = ("127.0.0.1", 8889)       # 要连接的服务器的 ip 和端口
client_socket.connect(ip_port)      # 连接服务器

'''
我们的本意是发送两个消息包,send 先把这两个消息包发送到协议栈缓冲区。
但是我们的协议栈缓冲区并没有消息包的概念,所有的信息到了协议栈缓冲区都变成了数据流。
协议栈缓冲区把我们应用层认为的信息包作为数据流一次性发送给客户端了。
'''

client_socket.send("老鸟".encode("utf-8"))  # 发送信息
client_socket.send("python".encode("utf-8"))  # 发送信息

client_socket.close()  # 关闭套接字
运行结果:
text
启动服务器,等待客户端连接......
收到客户端信息:老鸟python
粘包分包处理
关于粘包分包的处理方案,在面试的时候经常被问到,往往很少有面试者回答的令人满意,下面我们来正确的分析解决粘包分包的算法,并编码解决粘包分包问题。
算法分析
一种方法就是约定好数据的长度,这样一来,接收方就可以根据提前约定好的数据长度来解析数据了。但这样会产生许多不必要的麻烦了,比如实际发送数据小于约定长度时需要填充,这样也造成了传输上的浪费。面试的时候,这种解决方案基本上是 0 分。
另一种方法是,对于用户每次用 send 发送的内容,我们都人为的添加一个特殊标识,我们自己来定义它是一个完整的消息包,这样一来,接收方可以根据约定的这个特殊字符来分辨一次完整的消息,但是,如果发送的消息内容里面有这个特殊字符(因为用户发送的内容你无法预测),接收方就会解析错误。这种方案面试也是 0 分。
正确的方法是,对要传输的数据进行封装,在发送的数据前面加上一个消息头部,消息头部里面记录发送数据的长度,这样一来,接收方先解析消息头部获得数据的长度,然后根据数据的长度来获取实际数据。
对于给发送的数据增加一个消息头部的解决方案,有以下几点需要注意。
- 消息头部可以放入的内容不止是发送数据内容的长度,也可以放入其它信息,比如版本号等等。
- 消息头部的长度可以是固定的,这样接收方直到收完固定长度的头部,然后从头部信息里面取出发送数据的长度。
- 消息头部长度可以是不固定的,消息头部可以以某个特殊字符结束,这样接收方根据这个特殊字符解析出整个头部,然后从头部信息里面取出发送数据的长度。
- 用户接收消息的时候,编程中要确保消息头部完整的接收,才能进行解析。
代码实现
做粘包分包指的是对接收来的数据进行粘包分包处理,无论是在客户端还是服务器端,只要是基于 TCP 协议发送的数据,都需要做粘包分包处理。
首先我们在服务器端和客户端要有个约定,这个约定就是发送的数据包的包头是什么格式,在此,我们采用固定长度包头,包头占有 10 个字符,这 10 个字符来记录包内容的长度。在此,为了简化,我们在服务器端只接收数据,客户端只发送数据。
python
'''
此为服务器端程序
'''
import socket
import json
import os

ptl_headerlen = 12  # 包头用 12 个字符表示,有 2 个是序列化的产生的引号
alldata = ""

sv_socket = socket.socket(socket.AF_INET, socket.SOCK_STREAM)
sv_socket.bind(('0.0.0.0', 9998))
sv_socket.listen(5)
print("服务器在监听......")
sock, addr = sv_socket.accept()
print("新客户端连接到来:", addr)
while True:
    while True:
        if len(alldata) < ptl_headerlen:  # 一直到包头字节流全部接收完成
            alldata += sock.recv(12).decode("utf-8")
            if not alldata:  # 收到服务器的套接字的 close 消息
                sock.close()
                os._exit(0)  # 通信完毕,退出进程
        else:
            header = json.loads(alldata[:ptl_headerlen])  # 反序列化包头
            print("包头:", header)
            index = header.find("L")  # 取出包头结束符 L 之前的内容
            bodylen = int(header[0: index])
            print("包内容长度:", bodylen)
            break

    while True:
        if len(alldata) < ptl_headerlen + bodylen:  # 一直到包内容的字节流全部接收完成
            alldata += sock.recv(1024).decode("utf-8")
            continue
        else:
            bodydata = json.loads(alldata[ptl_headerlen: (ptl_headerlen + bodylen)])
            print("包内容:", bodydata)
            alldata = alldata[ptl_headerlen + bodylen:]
            print("多余部分:", alldata)
            break
客户端代码如下:
python
'''
此为客户端程序
'''
import socket
import json
import time

'''
总纲:协议包(package)由包头(header)和包内容(body)组成

一:协议包包头(header)说明
1.说明:
协议包包头(header)共占用 10 个字符,协议包头记录包内容的长度,内容长度以 L 为补充识别结束
注意对包头 json 序列化后,会多出两个引号,所以包头的总长度为 12(是个固定值)

2.模型:
header = "LLLLLLLLLL"
其中 L 代表包内容(body)实际长度值,但要保证包头的值要以 L 结束,这样方便解析

3.样例:
header = "28LLLLLLLL"。我们自己组成包头(header)共 10 个字符,包内容(body)长度为"28"。

4.注意事项
在网络上我们都是发送序列化后的字节流,所以对 header 序列化后为:'"28LLLLLLLL"',共 12 个字符
'''

ptl_header = "LLLLLLLLLL"  # 定义包头

def ptl_dealheader(body):
    header = str(len(body)) + ptl_header[len(str(len(body))):]
    return json.dumps(header)

def ptl_dealbody(body):
    return json.dumps(body)

def getpackage(body):
    body = ptl_dealbody(body)
    header = ptl_dealheader(body)
    return header + body

clt_socket = socket.socket(socket.AF_INET, socket.SOCK_STREAM)
clt_socket.connect(('127.0.0.1 ', 9998))

dataone = [3, "python", 4]     # 第 1 个包内容
pkgone = getpackage(dataone)   # 封装成 pkgone 包(包头和包内容)

datatwo = "老鸟python"         # 第 2 个包内容
pkgtwo = getpackage(datatwo)   # 封装成 pkgtwo 包(包头和包内容)

# 粘包测试
clt_socket.send((pkgone + pkgtwo).encode("utf-8"))  # 一次性发送 pkgone 包和 pkgtwo 包
time.sleep(2)

# 分包测试
clt_socket.send(pkgone[:4].encode("utf-8"))  # 发送第 pkgone 包的前四个字节流
time.sleep(2)
clt_socket.send(pkgone[4:].encode("utf-8"))  # 发送第 pkgone 包剩余的部分
time.sleep(2)

# 粘包和分包同时测试
clt_socket.send(pkgone[:4].encode("utf-8"))  # 发送 pkgone 包的前四个字节流
time.sleep(2)
clt_socket.send((pkgone[4:] + pkgtwo).encode("utf-8"))  # 发送 pkgone 包剩余的部分和 pkgtwo 包

clt_socket.close()
运行结果如下:
text
服务器在监听......
新客户端连接到来: ('127.0.0.1', 6279)
包头: 16LLLLLLLL
包内容长度: 16
包内容: [3, 'python', 4]
多余部分: "20LLLLLLLL""\u8001\u9e1fpython"
包头: 20LLLLLLLL
包内容长度: 20
包内容: 老鸟python
多余部分:
包头: 16LLLLLLLL
包内容长度: 16
包内容: [3, 'python', 4]
多余部分:
包头: 16LLLLLLLL
包内容长度: 16
包内容: [3, 'python', 4]
多余部分: "20LLLLLLLL""\u8001\u9e1fpython"
包头: 20LLLLLLLL
包内容长度: 20
包内容: 老鸟python
多余部分:
上面的案例,我们在包头中用字符记录包内容的长度,如果能用整数记录就会更好了,python 中提供了 struct 模块,可以表示字节。
python
import struct
import json

body = json.dumps(dict(hello="world"))  # 对包内容序列化
print(body)  # '{"hello": "world"}'     # 序列成了字符串
header = body.__len__()  # 18           # 包头记录包内容的长度
headPack = struct.pack("I", header)     # I 代表无符号整数,占 4 个字节
print(headPack)  # b'\x12\x00\x00\x00'  # 18 的字节流

header = struct.unpack("I", headPack)   # 还原数据
print(header)  # (18,)                  # 注意:结果是个元组
4️⃣ UDP编程
TCP 就如打电话一样,要先建立连接,然后才能通信,这样可以保证我们通信的内容完整性。而 UDP 则是面向无连接的协议,使用 UDP 协议时,不需要建立连接,只需要知道对方的 IP 地址和端口号,就可以直接发数据包。但是,我们无法确保我们发的数据能不能或能不能全部到达对方。
使用 UDP 协议
服务器首先需要绑定端口,创建 Socket 时,SOCK_DGRAM 指定了这个 Socket 的类型是 UDP。绑定端口和 TCP 一样,但是不需要调用 listen 方法,而是直接接收来自任何客户端的数据。
python
'''
此为服务器端程序
'''
import socket

server_socket = socket.socket(socket.AF_INET, socket.SOCK_DGRAM)  # 创建套接字
server_socket.bind(('127.0.0.1', 8889))  # 绑定的 IP 和端口
while True:
    # 接收数据:
    print("等待客户端发送来的数据......")
    client_data, server_addr = server_socket.recvfrom(1024)  # 接收客户端信息
    client_data = client_data.decode("utf-8")  # 解码字节流
    if client_data == "exit":  # 判断客户端是否申请结束会话
        print("服务器端退出通信")
        server_socket.sendto("exit".encode("utf-8"), server_addr)  # 通知客户端关闭
        break
    print(client_data)

    # 发送数据
    server_data = input("请输入要发送给客户端的信息:")
    server_socket.sendto(server_data.encode("utf-8"), server_addr)  # 发送信息

server_socket.close()
我们在此写个和服务器通信的客户端代码,大家先运行上面的服务器代码,然后再运行这个客户端代码,双方就可以进行数据发送了,客户端代码如下。
python
'''
此为客户端程序
'''
import socket

client_socket = socket.socket(socket.AF_INET, socket.SOCK_DGRAM)  # 创建套接字
server_ipport = ("127.0.0.1", 8889)       # 通信的服务器的 ip 和端口

while True:
    # 发送数据
    client_data = input("请输入要发送给服务器的信息:")
    client_socket.sendto(client_data.encode("utf-8"), server_ipport)  # 发送信息

    # 接收数据
    server_data, client_addr = client_socket.recvfrom(1024)  # 接收服务器信息
    server_data = server_data.decode("utf-8")  # 解码字节流
    if server_data == "exit":  # 判断服务器是否申请结束会话
        print("客户端退出通信")
        client_socket.sendto("exit".encode("utf-8"), server_ipport)  # 通知服务器端关闭
        break
    print("收到服务器信息:%s" % server_data)

client_socket.close()  # 关闭套接字
UDP 有消息边界
UDP 是有消息边界的,我们每次调用 sendto(udp 协议发送消息用的是 sendto 函数)发送一个数据包,都是一个完整的包发送到对方(当然这个包的数据有可能会有部分丢失),但是每一次的 sendto 发送的数据包都不会和下次的 sendto 发送的数据包有任何粘包,这种在协议层发送的每个包都是独立的关系,我们叫做 该协议是有消息边界的协议,所以 UDP 是有消息边界的,我们不需要处理粘包分包问题。
python
'''
此为服务器端程序
'''
import socket

server_socket = socket.socket(socket.AF_INET, socket.SOCK_DGRAM)  # 创建套接字
server_socket.bind(('127.0.0.1', 8889))  # 绑定的 IP 和端口
while True:
    # 接收数据:
    input("输入任何字符开始接收数据......")
    client_data, server_addr = server_socket.recvfrom(1024)  # 接收客户端信息
    client_data = client_data.decode("utf-8")  # 解码字节流
    if client_data == "exit":  # 判断服务器是否申请结束会话
        break
    print(client_data)

server_socket.close()
python
'''
此为客户端程序
'''
import socket
import time

client_socket = socket.socket(socket.AF_INET, socket.SOCK_DGRAM)  # 创建套接字
server_ipport = ("127.0.0.1", 8889)       # 通信的服务器的 ip 和端口

# 发送数据
client_data = "hello"
client_socket.sendto("老鸟".encode("utf-8"), server_ipport)    # 发送信息
client_socket.sendto("python".encode("utf-8"), server_ipport)  # 发送信息
client_socket.sendto("exit".encode("utf-8"), server_ipport)    # 发送信息
client_socket.close()  # 关闭套接字
我们先运行服务器代码,阻塞到 input 处。然后运行客户端代码,连续发送三条信息("老鸟","python","exit")。然后我们在服务器端输入任意字符,进入 recvfrom 函数,我们发现服务器端程序从 UDP 协议栈接收缓冲区内分三次收取这些信息。
UDP 和 TCP 区别
我们分析以上基于 UDP 的服务器和客户端代码,发现和前面我们学的 TCP 协议有一些不同地方。
- 服务器端不需要 accept,客户端不需要 connect。
- 发送数据用的是函数 sendto,接收数据用的是函数 recvfrom。
- recvfrom 收到的信息不但含有发送方发送的数据内容,还有发送方的 ip 和端口号。
- sendto 可以发送空字节流,recvfrom 也会收到空字节流。
- TCP 协议无消息边界,UDP 协议有消息边界。
- 当调用 close 关闭套接字的时候,不会向对方发送一个空字节流。
最后注意:绑定 UDP 端口和 TCP 端口互不冲突,也就是说,UDP 的 8889 端口与 TCP 的 8889 端口可以同时绑定使用。
5️⃣ TCP 没有天然的消息边界
一次 send() 不保证对应接收方的一次 recv()。应用层需要自己定义消息格式,常见做法是在正文前放固定长度的长度字段,或使用明确分隔符。接收方要先累计足够数据,再按协议取出完整消息;发送方也要处理未一次发送完的情况。
🛬 文章小结
- TCP 服务端和客户端分别完成监听、接受连接与连接建立;
send()和recv()面向字节流,一次调用不保证对应一条完整消息。 - 可用长度前缀定义消息边界,并在包头加入版本等字段;发送缓冲区满时还应理解阻塞与非阻塞套接字的不同表现。
- UDP 保留数据报边界,但不保证送达或顺序。可给数据报加序号,在接收端统计缺失情况,比较它与 TCP 的适用场景。