参考
人工智能神经网络介绍 清华博士介绍人工智能
深度学习 3blue1brown 的深度学习系列视频,可视化神经网络计算原理
Calculus on Computational Graphs: Backpropagation 计算图的微积分:反向传播。作者 Christopher Olah,OpenAI 联合创始人的文章
神经网络的发展
符号主义
通过符号逻辑组合推理,例如
e.g. 医疗上通过症状组合,诊断对应的病症:流鼻涕 + 轻微咳嗽 => 感冒
e.g. 金融上通过 K 线形态组合,判断股票拐点:下/上影线 + 放量 => 价格拐点
联结主义
通过不同属性 * 系数来推理,用数值计算模拟逻辑
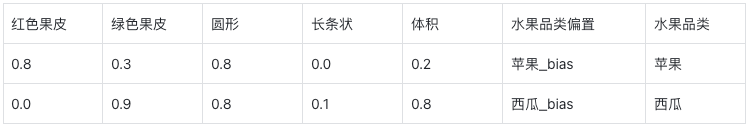
e.g. 水果分类,只看"红色果皮","绿色果皮", "圆形","长条状","体积" 5 个属性,那么有公式:
w0 * 红色果皮 + w1 * 绿色果皮 + w2 * 圆形 + w3 * 长条状 + w4 * 体积 - 水果品类偏置 > 0
输入一个水果属性权重/评分(归一化后的数值),如果计算结果 >0,认为该水果是偏置对应的品类。
生物神经元
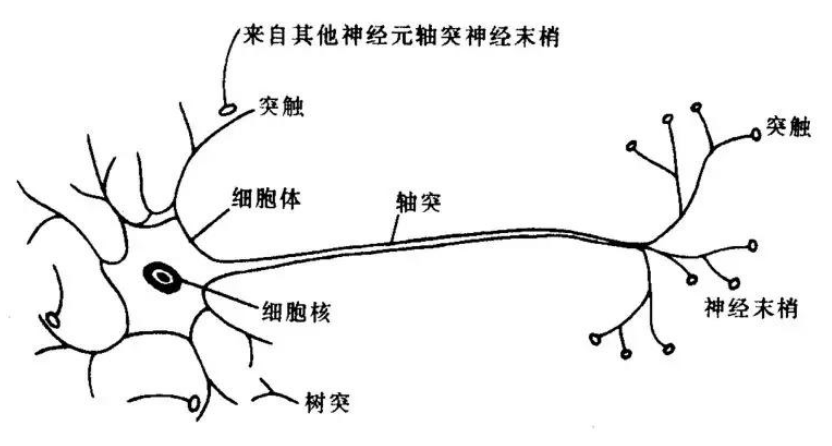
树突接收其他神经元信号,轴突输出自己的信号。每个神经元随着所接受的多个激励信号的综合结果出现兴奋和抑制状态。
人工神经元模型
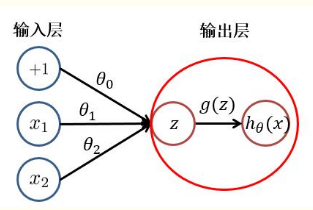
类似联结主义的公式,但用激活函数 g 代替 "> 0"。激活函数引入非线性特征,让神经元可导,神经网络可反向传播。同时控制输出范围。
神经网络模型
多个神经元之间传递信息实现复杂逻辑,形成神经网络。
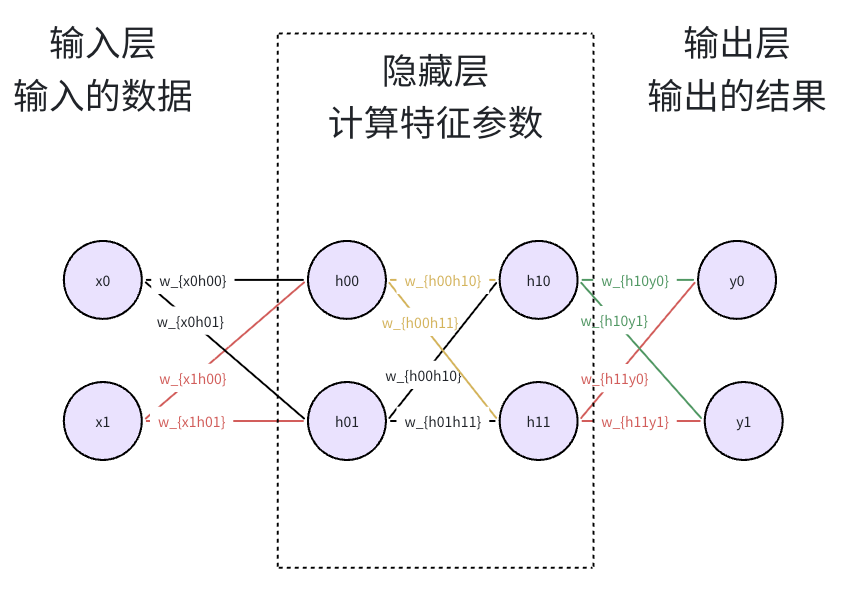
上图模型(下文简称 242模型,两个输入,两个输出,共 4 层网络)神经网络的可学习参数由权重和偏置两部分组成。上图中有 12 条权重线,6 个偏置参数(输入单元没有包含偏置),共 18 个模型参数。
激活函数
线性函数的局限性
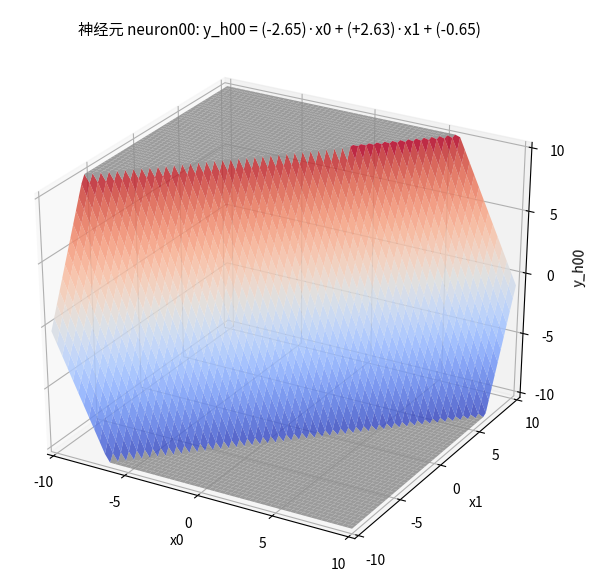
假设 242 模型的神经元没有使用激活函数,单个神经元 h00 :
下图是对应的曲面图像,w_{x0h00} = -2.65,w_{x1h00} = 2.63,b = -0.65,超出输出轴 y_{h00} 部分用灰色显示:
242 模型多层神经元网络(部分网络):输入层 {x0, x1} - 隐藏层1 {h00, h01} - 隐藏层2 {h10}
h00:y_{h00} = w_{x0h00}*x0 + w_{x1h00}*x1 + b_{h00}。
h01:y_{h01} = w_{x0h01}*x0 + w_{x1h01}*x1 + b_{h01}。
h10:y_{h10} = w_{h00h10}*x0 + w_{h01h10}*x1 + b_{h10}。
当 w_{x0h00} = 3.02,w_{x1h00} = -2.05,b_{h00} = 1.83;w_{x0h01} = -1.96,w_{x1h01} = 3.11,b_{h01} = 0.5;w_{h00h10} = 2.00,w_{h01h10} = -2.39,b_{h10} = -1.35;x0,x1 和神经元 h10 的输出 y_{h10} 曲面是:
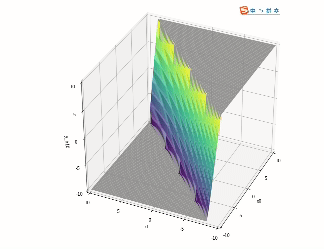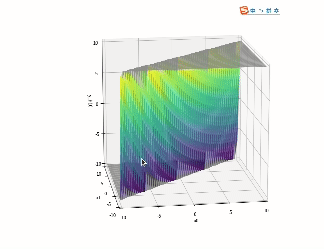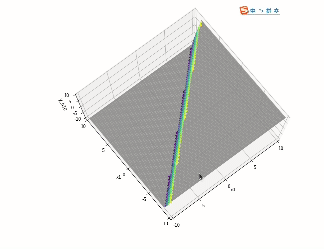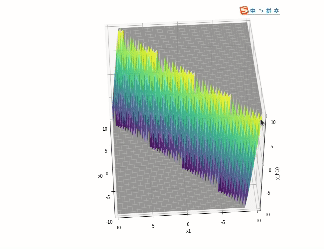 无激活函数多层神经网络输出 {x0-x1-y_h10}
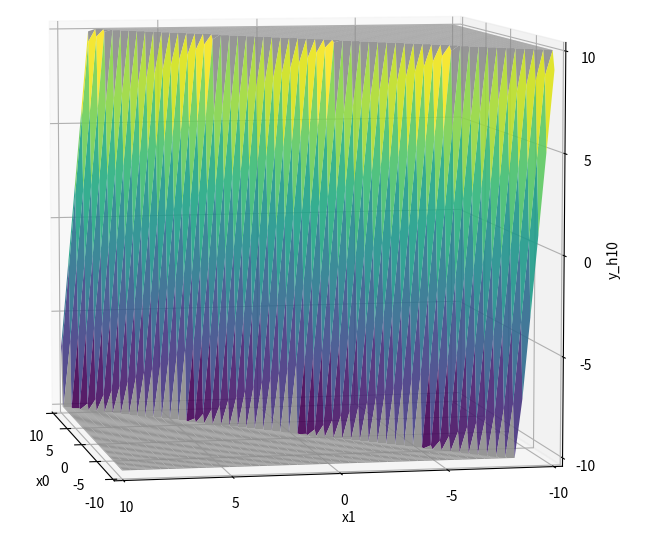
可以看出无激活函数,多层神经网络堆叠后输出的函数依然是线性的。难以满足现实中多种非线性函数工作的需求。
增加非线性特性
将线性神经元的输出,输入到非线性函数即可获得非线性特性。
经典激活函数 softplus:
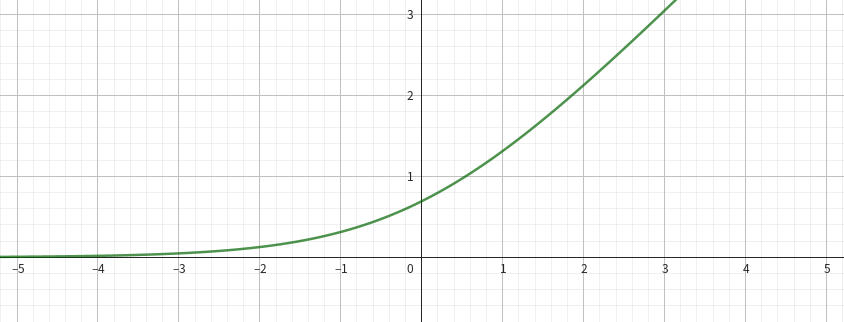
应用 softplus 的神经元 h00:ln(1 + e^(y_{h00} = w_{x0h00}*x0 + w_{x1h00}*x1 + b_{h00}))
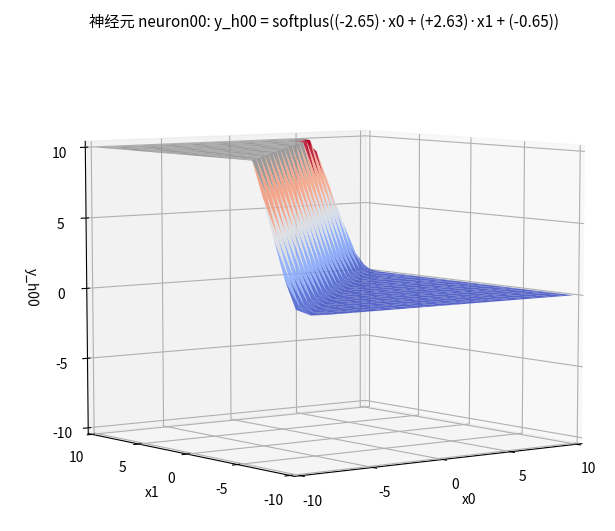
下图是应用激活函数后的曲面图像,参数和上次一样 w_{x0h00} = -2.65,w_{x1h00} = 2.63,b = -0.65:
242 模型多层神经元网络(部分网络):输入层 {x0, x1} - 隐藏层1 {h00, h01} - 隐藏层2 {h10}
h00:y_{h00} = w_{x0h00}*x0 + w_{x1h00}*x1 + b_{h00},激活函数 g(x) 使用 sofltplus。
h01:y_{h01} = w_{x0h01}*x0 + w_{x1h01}*x1 + b_{h01},激活函数 g(x) 使用 sofltplus。
h10:y_{h10} = w_{h00h10}*x0 + w_{h01h10}*x1 + b_{h10},激活函数 g(x) = x,无激活函数。
当 w_{x0h00} = -0.911,w_{x1h00} = 1.711,b_{h00} = -0.65;w_{x0h01} = -0.688,w_{x1h01} = -0.155,b_{h01} = 2.022;w_{h00h10} = -1.933,w_{h01h10} = 2.244,b_{h10} = -1.533。x0,x1 和神经元 h10 的输出 y_{h10} 曲面是:
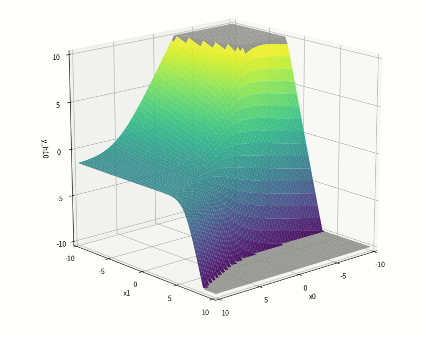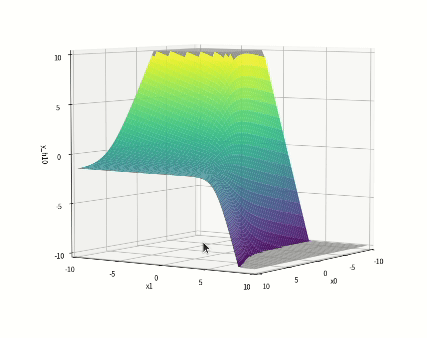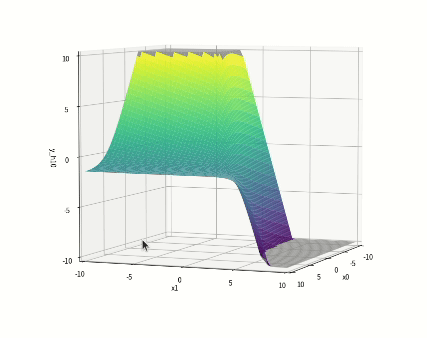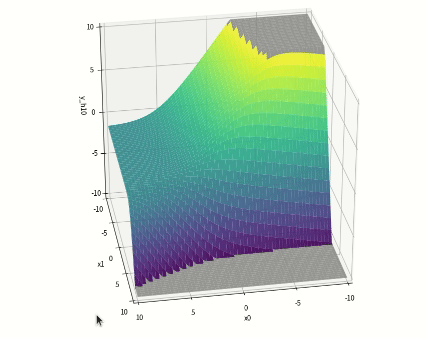 带激活函数多层神经网络输出 {x0-x1-y_h10}
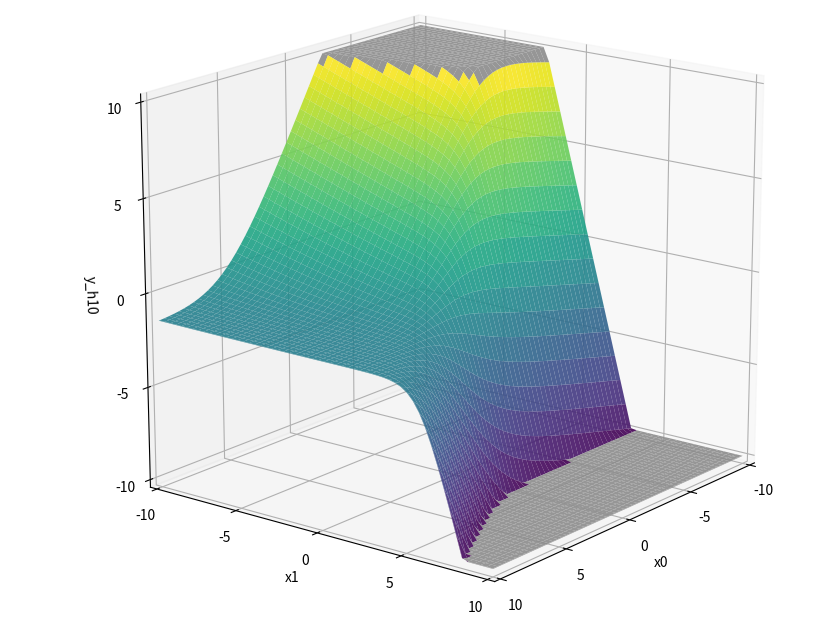
增加激活函数后,多层神经网络堆叠后输出的函数曲线更加丰富。
工业实践中,习惯用 "简单神经元 + 激活函数 + 多层叠加" 的方式实现非线性函数,拟合任意连续函数。
而不是让一个神经元自身具备非线性函数性质,例如 w0x0^2+w1x0x1 + b 这样,否则计算量爆炸。实际上也有个别模型这么做,这里不展开。
常见的激活函数
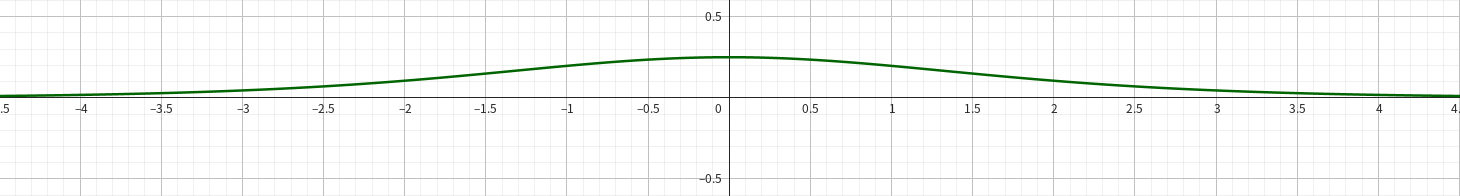
- sigmoid 函数
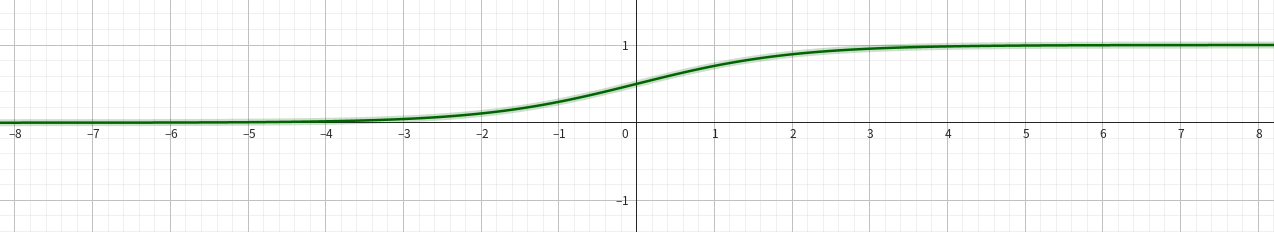
导数
- ReLU 函数
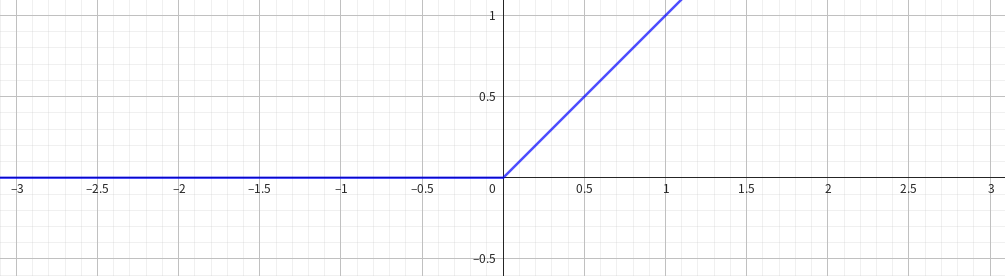
导数
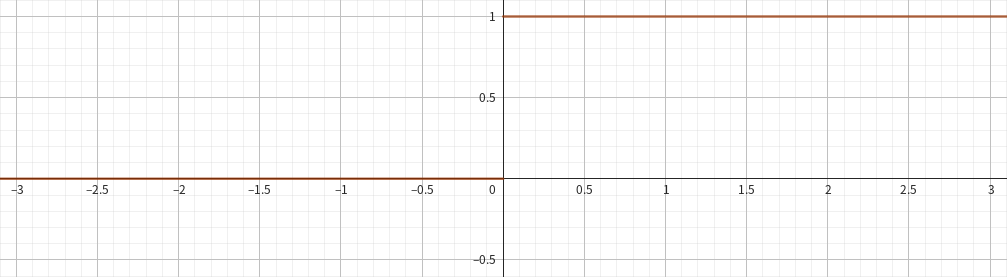
向前传播
242 模型的向前传播:
第一层网络计算得到第二层网络:
,
第二层网络计算得到第三层网络:
,
第三层网络计算得到第四层网络:
,
第四层网络这里已经计算出结果。
计算图 Computation Graph
计算图由节点(算子,例如加减乘除等)和边(张量,tensor/数据状态等)构成。由于神经网络的计算是一层层计算的,所以计算图的边是有向的,也就是数据流动有方向。
以 242 模型的神经元 h00 使用 softplus 激活函数为例子说明:
把每个计算步骤拆出来:
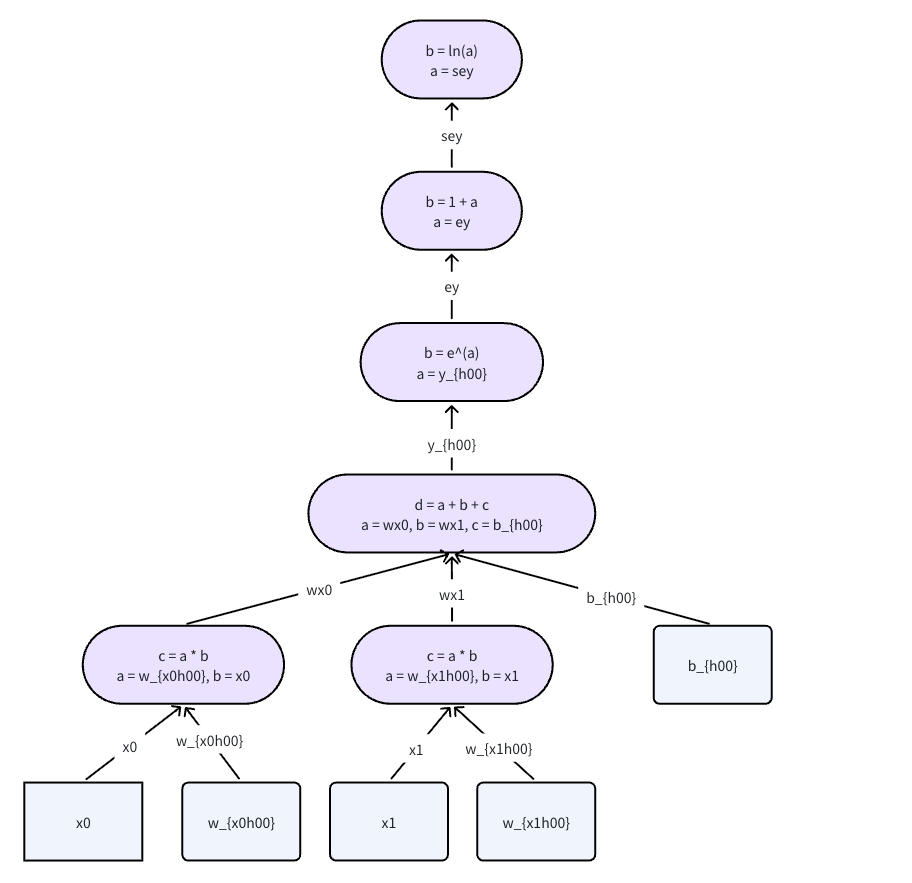
在神经网络向前传播的计算中,计算图就在后台一步步搭建了。当神经网络训练好参数后,导出的模型文件例如TorchScript,onnx,pt2 包括了计算图和权重参数值(w 和 b)。pt 或 pth 文件只包含权重参数值。模型文件在实际运行中,将实时数据输入到计算图入口,按照计算图搭建的流程,和权重参数一步步计算输出结果。
损失函数
AI 模型向前传播计算出结果,但这个结果不一定是正确的,需要有学习纠正错误的过程,也就是模型训练/学习,最终模型才能提高输出精度。
损失函数就是负责告诉模型它错了多少。"损失/成本"通过向前传播计算结果和标准答案(监督学习)或者和任务约束(无标准答案,无监督学习)计算得到。
损失函数根据模型任务来确定计算方法的,常见的损失函数计算有均方误差 MSE 和交叉熵损失 Cross-Entropy。
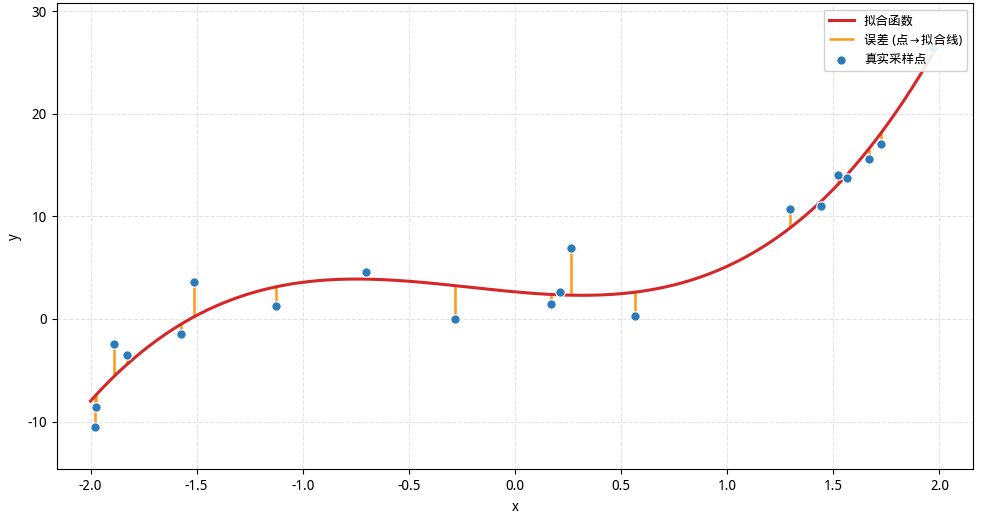
均方误差 MSE
计算模型输出值和真实值之间的误差平方的平均值,来估计模型的输出误差。
:真值
:模型输出值
误差平方具有保序和放大的性质。保证了误差方向一致,不会反向。同时对小误差宽容,对大误差放大。
工程上通常用
这样损失函数 MSE 求偏导公式更加简洁,且不影响对误差的估计。
交叉熵损失 Cross-Entropy
交叉熵是用来衡量两个概率分布之间差异的指标。
:事件 xi 真实分布概率
:模型输出的事件 xi 分布概率
这里 log 的底默认是 e。
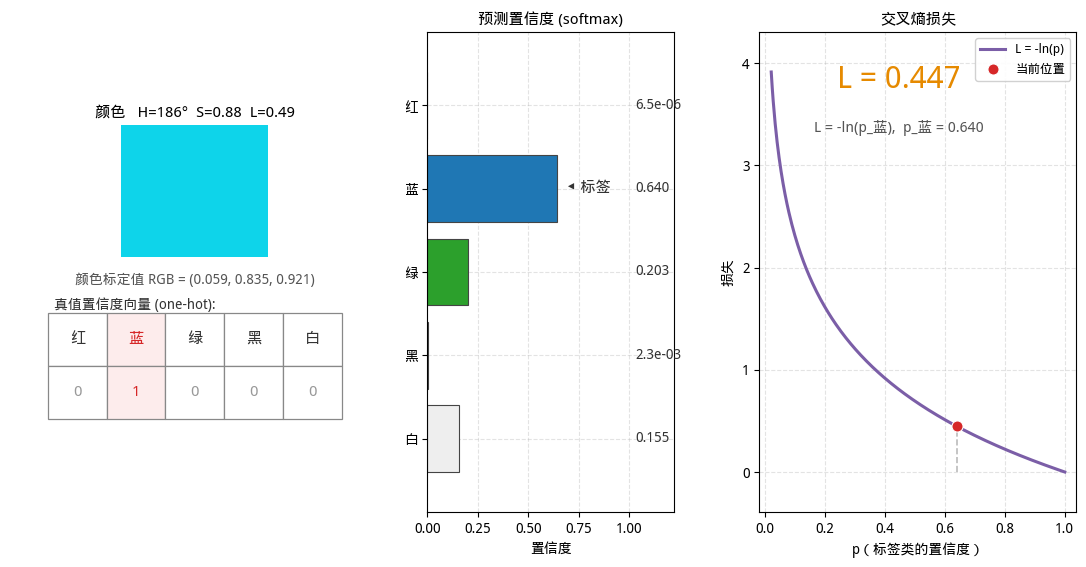
左侧色块是当前颜色,下方是手动标注的颜色。颜色真值置信度向量:rp_red = 0.0,rp_blue = 1.0,p_green = 0.0,rp_black = 0.0,rp_while = 0.0。
中间柱状图输出预测颜色置信度向量: p_red = 0.0,p_blue = 0.64,p_green = 0.203,p_black = 0.0,p_while = 0.155。
右侧是标注的颜色的交叉熵损失计算:
由于 rp_red = 0.0,rp_blue = 1.0,p_green = 0.0,rp_black = 0.0,rp_while = 0.0,公式简化为:
真值概率分布向量有很大操作空间!如果真值概率分布太绝对,模型泛化能力变差!
有些情况会给真值减去一个泛化误差 e。例如真值概率分布是 rp_grass = 1.0-e,rp_flower = e/2, rp_earth = e/2,以提高模型泛化能力。
在图像分割中,通常会调整不同类别接触边缘的真值概率分布,因为人工标注很难保证像素级精确。例如图像中猫和狗挨在一块,猫狗边缘像素真值概率分布向量可能为 rp_cat = 0.5, rp_dog = 0.5。
梯度下降
现在模型可以输出结果,可以计算损失,那要如何调节权重参数 w 和 b,让模型输出结果朝着损失更小方向进行呢?
把损失 L 看作是关于参数 w 和 b 的函数:L = L(w, b)。我们的目标就是找到一组 (w, b),让 L 更小。
在数值优化中,微调输入量 (w, b),观察输出量变化,进而选择让输出量更小(损失更小)的输入量的的方法叫优化。这里的关键是计算"输出量随输入量变化的变化"。
在单变量函数中使用导数观察函数 f(x) 跟随 x 变化的方向和快慢,常用中心差分法:
,且是极小值!
在多变量函数中使用偏导数估计函数 f(x, y, ...) 跟随 x,y,... 变化的方向和快慢:
,且是极小值!
向量 称为 f(x, y, ...) 的梯度,梯度是向量。对损失函数来说梯度就是
。
梯度方向
梯度向量指向函数上升最快的方向!
在优化相关论文中也会提到梯度,可能会看到上面的结论,但具体怎么回事呢?下面用可视化方法观察梯度。
函数图像如下:
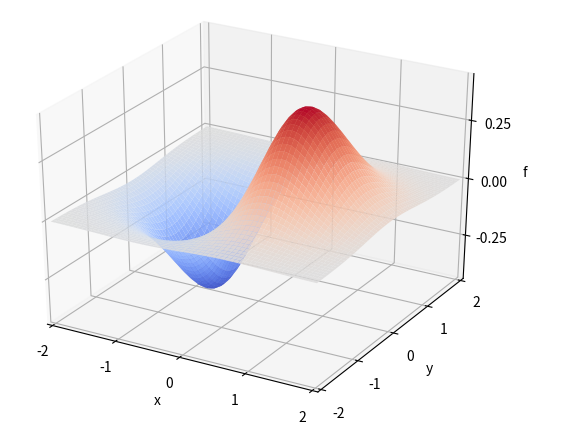
把 f(x, y) 函数值作为高度,高度从低到高映射为紫色到黄色,函数值越大颜色越黄,绘制等高线图:
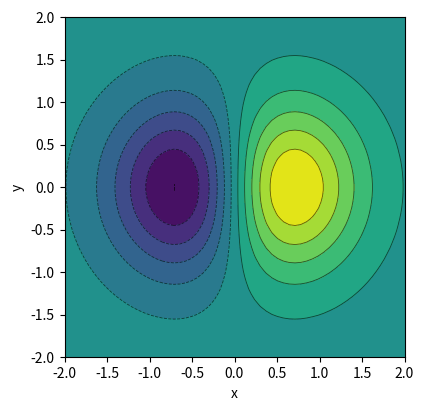
在等高线图中,等高线越密集的位置表示该位置越陡,也就是函数上升最快的地方。上图等高线疏密和 3d 函数曲面一致。由于梯度向量是指向函数上升最快的方向,在等高线图中梯度向量是从低等高线垂直指向相邻的高等高线。
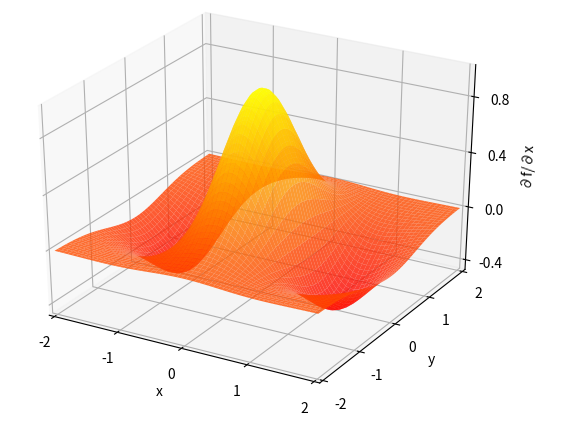
f(x, y) 对 x 偏导函数 ,函数图像如下:
f(x, y) 对 y 偏导函数 ,函数图像如下:
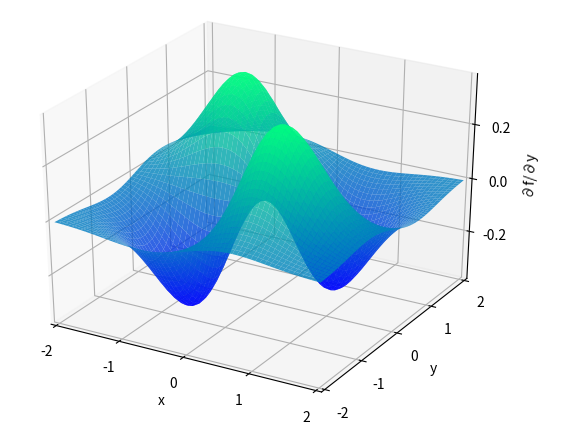
采样分辨率 0.3,每隔一个分辨率采样 x, y 计算 g(x, y) 和 h(x, y)。梯度向量就是 g, h,在采样位置绘制箭头,朝向就是梯度向量方向,向量长度(向量的模)映射到颜色(向量的模越大,颜色越黄)。得到了梯度向量方向图!
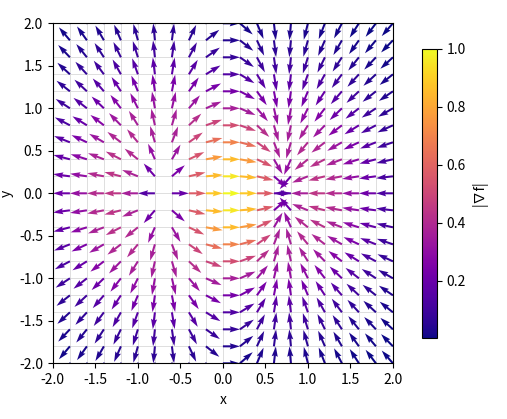
把梯度方向向量图叠加在等高线图中:
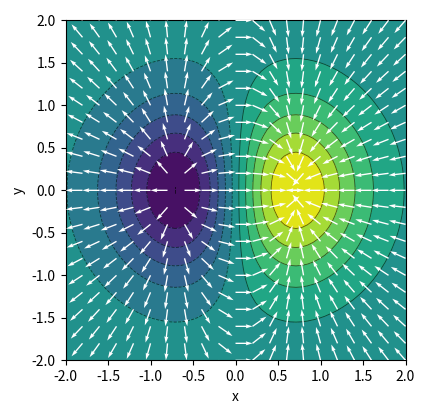
可以看到梯度方向图的箭头在等高线图中是从低等高线指向相邻高等高线的,符合梯度向量指向函数上升最快方向。
当 x, y 随机初始化后,x,y 只要朝着梯度向量指向移动,就可以来到函数高值位置。下面手动控制光标模拟过程:
梯度向量
这样就可以看懂函数梯度向量了。现在把函数 f(x, y) 改为损失函数 L(w, b),x, y 变为模型参数 w,b。模型训练的过程就是将损失降低,所以是朝着损失函数梯度向量反方向移动!模型参数 w,b 沿着损失函数梯度向量反方向调节!这个优化参数的方法叫梯度下降法。
从上面的函数图像演示中可以看出,函数梯度只能指向局部最高点!如何找到更大范围的最高点,甚至是全局最高点是另外需要解决的问题。
反向传播
知道梯度下降法可以优化模型参数了,问题来到如何计算梯度向量。
前向模式
对于 242 模型来说,想观察参数 w_{x0h00} 对输出 y0 的影响,需要计算参数 w_{x0h00} 影响并连接到 y0 的导数。相关神经元用黄色高亮表示出来:
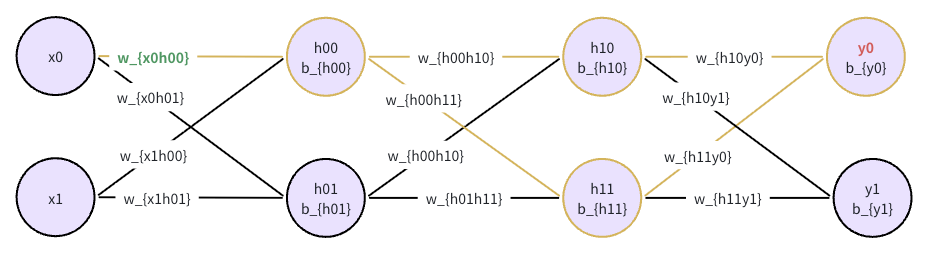
h00 神经元 对
求偏导,根据链式法则有:
h10 神经元 对
求偏导:
h11 神经元 对
求偏导:
y0 神经元 对
求偏导:
结合神经网络图像看,神经元 h00 的输出 y_{h00} 分两路经过神经元 h10 和 h11 对输出 y0 产生影响,公式上表现为两条路径上偏导乘积求和。
从输入端向输出端求导称作前向模式。前向模式观察一个参数如何影响每个节点。
分解路径
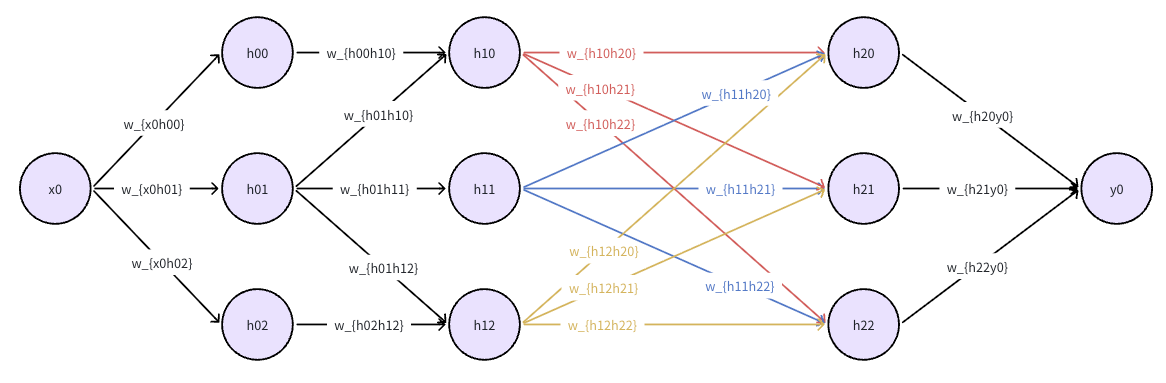
对于上图 151 神经网络模型, 共有 9 条偏导路径需要求和:
-
w_{x0h01} => h01 => h10 => h20 => y0:
-
w_{x0h01} => h01 => h10 => h21 => y0:
-
w_{x0h01} => h01 => h10 => h22 => y0:
-
w_{x0h01} => h01 => h11 => h20 => y0:
-
w_{x0h01} => h01 => h11 => h21 => y0:
-
w_{x0h01} => h01 => h11 => h22 => y0:
-
w_{x0h01} => h01 => h12 => h20 => y0:
-
w_{x0h01} => h01 => h12 => h21 => y0:
-
w_{x0h01} => h01 => h12 => h22 => y0:
-
合并公式 1,2,3:
-
合并公式 4,5,6 有:
-
合并公式 7,8,9 有:
-
合并公式 10,11,12 有:
-
化简:
如果计算也是找出每一条偏导路径后再求和(公式 1~9),那对复杂神经网络模型来说计算量爆炸。
公式中,每个神经元的输出作为下一个神经元输入,仅对下一个神经元输出求偏导一次。参数偏导公式从多路径偏导求和变为矩阵乘法,在 gpu 计算速度得到大幅提升!
观察神经网络和公式可以发现,当输出端和多个输出端连接的时候,可以直接用累加符号把输出对输入求偏导合并。
例如输出 y0 和输入 y_{h20},y_{h21},y_{h22} 连接,它们的偏导直接表示为:
反向模式
从输出端出发,沿计算图反向计算,输出对每个参数(通常是 w 和 b,某些激活函数也包含参数)的偏导。
从输出端向输入端求导称作反向模式。反向模式观察输出如何被每个节点影响(即输出对每个节点的敏感程度)。
图 151 神经网络模型反向传播对 w 求偏导(省略 b,不然公式太多了 (╥_╥))有
w_{h20y0} 对输出 y0 的影响,y0 对 w_{h20y0} 求偏导,y0 => w_{h20y0}:
w_{h21y0} 对输出 y0 的影响,y0 对 w_{h21y0} 求偏导,y0 => w_{h21y0}:
w_{h22y0} 对输出 y0 的影响,y0 对 w_{h22y0} 求偏导,y0 => w_{h22y0}:
w_{h10h20} 对输出 y0 的影响,y0 对 w_{h10h20} 求偏导,y0 => y_{h20} => w_{h10h20}:
w_{h11h20} 对输出 y0 的影响,y0 对 w_{h11h20} 求偏导,y0 => y_{h20} => w_{h11h20}:
w_{h12h20} 对输出 y0 的影响,y0 对 w_{h12h20} 求偏导,y0 => y_{h20} => w_{h12h20}:
w_{h10h21} 对输出 y0 的影响,y0 对 w_{h10h21} 求偏导,y0 => y_{h21} => w_{h10h21}:
w_{h11h21} 对输出 y0 的影响,y0 对 w_{h11h21} 求偏导,y0 => y_{h21} => w_{h11h21}:
w_{h12h21} 对输出 y0 的影响,y0 对 w_{h12h21} 求偏导,y0 => y_{h21} => w_{h12h21}:
w_{h10h22} 对输出 y0 的影响,y0 对 w_{h10h22} 求偏导,y0 => y_{h22} => w_{h10h22}:
w_{h11h22} 对输出 y0 的影响,y0 对 w_{h11h22} 求偏导,y0 => y_{h22} => w_{h11h22}:
w_{h12h22} 对输出 y0 的影响,y0 对 w_{h12h22} 求偏导,y0 => y_{h22} => w_{h12h22}:
w_{h00h10} 对输出 y0 的影响,y0 对 w_{h00h10} 求偏导,y0 => y_{h20} => y_{h10} => w_{h00h10},y0 => y_{h21} => y_{h10} => w_{h00h10},y0 => y_{h22} => y_{h10} => w_{h00h10}。根据分解路径知道可以合并 y_h{20}, y_h{21}, y_h{22} 对 y_h{10} 的偏导:
w_{h01h10} 对输出 y0 的影响,y0 对 w_{h01h10} 求偏导:
w_{h01h11} 对输出 y0 的影响,y0 对 w_{h01h11} 求偏导:
w_{h01h12} 对输出 y0 的影响,y0 对 w_{h01h12} 求偏导:
w_{h02h12} 对输出 y0 的影响,y0 对 w_{h02h12} 求偏导:
w_{x0h00} 对输出 y0 的影响,y0 对 w_{x0h00} 求偏导:
w_{x0h01} 对输出 y0 的影响,y0 对 w_{x0h01} 求偏导,根据分解路径知道可以合并 y_h{10}, y_h{11}, y_h{12} 对 y_h{01} 的偏导:
w_{x0h02} 对输出 y0 的影响,y0 对 w_{x0h02} 求偏导:
神经网络的输入参数是已知的,每轮前向传播时候模型参数是已知的,神经元计算公式和激活函数是已知的,反向传播计算出神经网络输出量对所有模型参数的偏导函数公式。直接代入数值计算就能得到梯度向量,这里就不举例子了。
更新参数
反函数梯度向量:
对于参数 ,其优化方向就是
。
梯度下降参数更新公式:
,称为学习率,学习率太小模型参数优化收敛慢,学习率太大优化震荡甚至发散。
更新模型参数的过程类似上面"梯度下降"章节中移动光标的演示。
至此,从向前传播,计算损失函数,反向传播计算梯度向量,最后更新参数,神经网络完成了一次参数优化。下一轮训练输入新的输入量和标定结果,再次训练可以得到新的优化后的参数。如此反复训练,让模型参数收敛到某个局部最优,就认为模型训练完成。