(一)哈希函数和哈希表的实现
认识哈希函数和哈希表的实现
1.哈希函数的定义
f(in)=out
(1)in->∞,out->s.比如md5算法输出的范围是0~2^64-1,SHA1算法的输入范围是0~2^128-1;
(2)same in ->same out.不随机
(3)dif in ->same out.(哈希碰撞)
(4)均匀分布,散列表.固定区域的点数量差不多,满足均匀分布.
示例:
输入序列{in1,in2,in3......}通过哈希函数f得到输出序列{out1,out2,out3......},输出序列通过%m运算得到{m1,m2,m3....},那么它的结果必然存在在0~m-1上.它必须保证输出序列{out1,out2,out3......}在s上均匀分布,在0~m-1上均匀分布.
无符号整数0~2^32-1大约有42亿个 。问题:如果只有1G内存,求最多次出现的数字是哪个?
在经典解法里,我们可以设置一个Hash表,key(int) value(int),用于记录次数。一记录里,由于key占用4B内存,value占用4B内存,至少8B内存。按照最差的情况,40亿条记录都不相同,那么最少要320亿B内存,大约是32G。显然不够,会爆内存。因此需要用到hash函数。
40亿个数的输入序列{a1,a2,a3......}通过哈希函数f得到输出序列{b1,b2,b3......},输出序列通过%100运算得到{m1,m2,m3....},这样可以把40亿个数分配到100个文件里面去,32G/100=0.32G,内存不会爆,得到100个0.32G的小文件,这些小文件里有100个出现频率最多的数。接下来对100个小文件对出现次数最多的数统计。
流程:
一次只读取一个文件
↓
在内存建立HashMap
↓
统计这个文件每个数字出现次数
↓
找这个文件出现次数最多的数字
↓
清空HashMap
↓
处理下一个文件
另,由于只有100个小文件,会存在碰撞的情况,比如1000和4327存到同一个文件里去,value值分别是2和1,但是碰撞不等于把1000和4327当成同一个数字,能够做到词频压缩,在总数上做到均分。
2.哈希表的实现
如图所示:
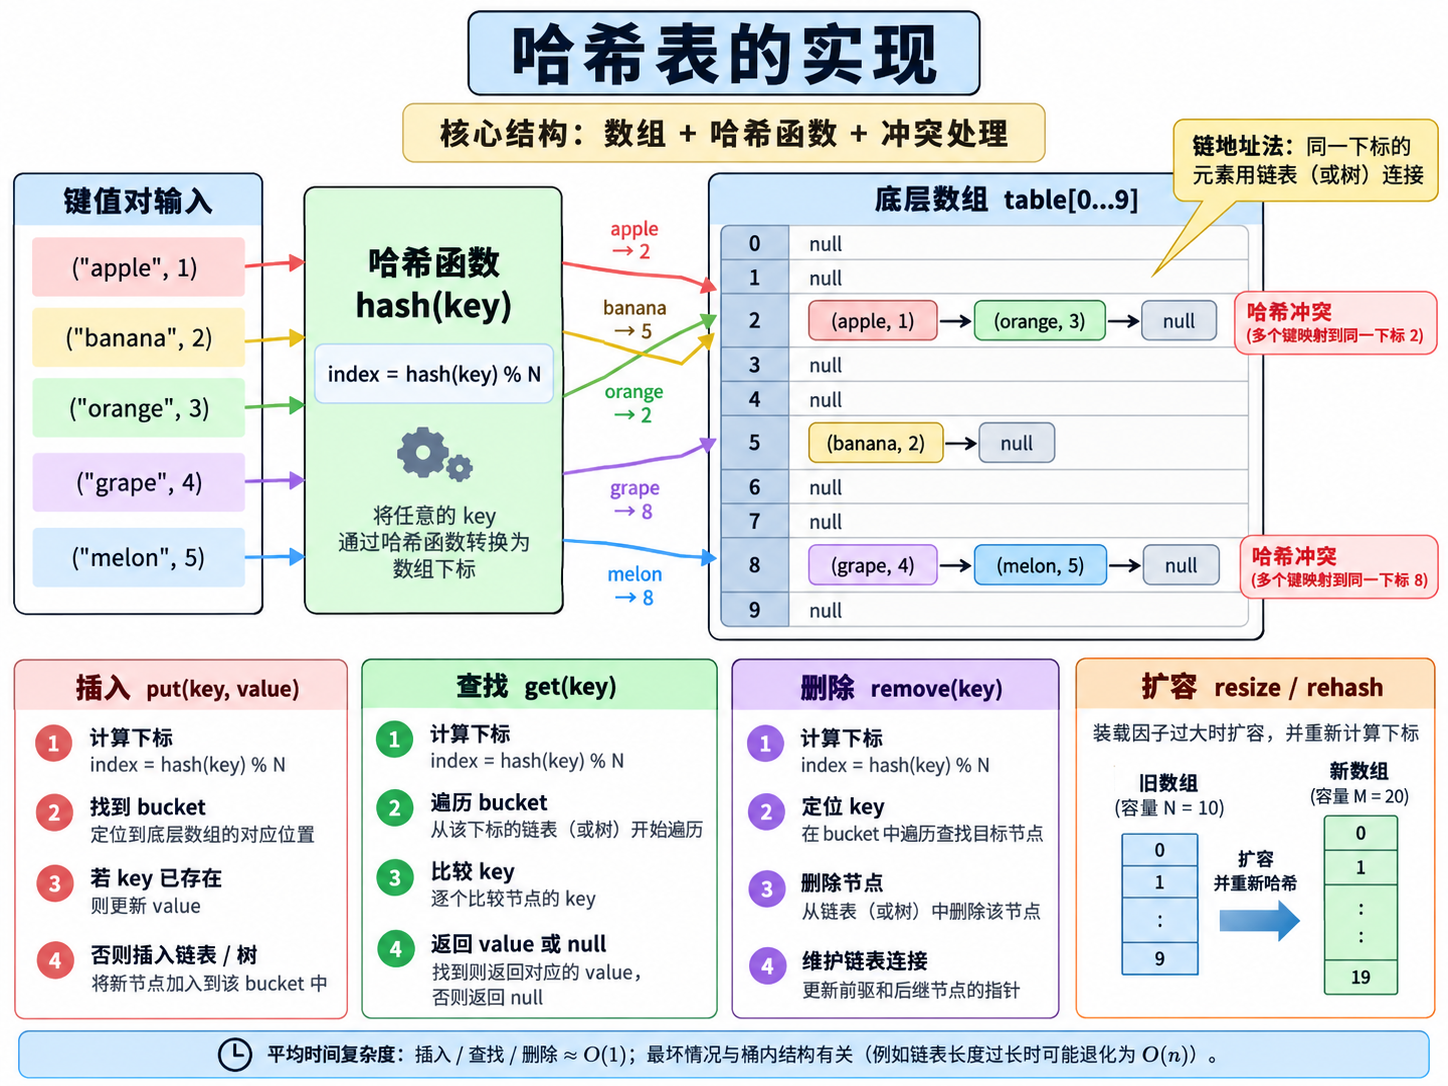
思考:随着每一个字符的加入,hash表的链条几乎是均匀变长的。但是,随着N的增大,要寻找某个字符串的位置,要遍历的链条的长度是N/m,这样hash表的性能做不到O(1),假设N/m的值超过了某个阈值(比若说6),那么对hash表进行扩容。
举例,对于一个长度为17的哈希表,如果其中的一条链的长度达到了6,我们就对hash表进行2倍数的扩容,将表长度扩容为34,那么最长链条的长度会变成3。
计算代价:对于输入x,哈希函数f的代价是O(1);得到out后对它取m的代价是O(1);当在hash表的格子中寻找时,如果链的长度为k的话,遍历的代价是O(k),如果k的长度很小,可以看作O(1)。
如果一次扩容扩一倍,1 + 2 + 4 + 8 + ... + N/2=N-1,数量级与N一致
扩容的总代价:如果加了N个字符串,最差情况每个位置只放一个字符串(k到达2就扩容),那么扩容次数的的级别为O(logN)(换底公式,logk(N)=log2(N)/log2(k),只差一个常数);由于每一次都要重新计算,那么重新形成hash表的代价为O(N)。不断扩容的总代价为O(N*logN),单次扩容的代价为O(N*logN)/(N-1)=O(N*logN)/N=O(logN)。
另,Java虚拟机(JVM语言)可以利用离线扩容技术来提高运算速度,在操作hash表时做到常数级别的增删改查。原理是利用倍增扩容和均摊分析,使 HashMap 的插入操作在平均意义下保持 O(1)。比如说:
java
正常情况:
put / get / remove
    ↓
hash(key)
    ↓
定位桶
    ↓
桶内元素很少
    ↓
接近 O(1)


当元素越来越多,超过装载因子阈值时:

旧表容量:16
元素过多
    ↓
触发扩容
    ↓
新表容量:32
    ↓
把旧表中的元素重新分配到新表
Java HashMap通过数组扩容、较好的哈希分布以及链表/红黑树来保证增删改查通常具有很高效率。
在哈希分布良好的情况下:get/remove平均为O(1),put的均摊复杂度为O(1)。
扩容本身不是O(1),而是一次较昂贵的O(N)级操作,但由于扩容按倍数发生,扩容次数很少,因此均摊到每次插入后仍为O(1)。
(二)相关理论
1.设计RandomPool结构
【题目】
设计一种结构,在该结构中有如下三个功能:
insert(key):将某个key加入到该结构,做到不重复加入
delete(key):将原本在结构中的某个key移除
getRandom():等概率随机返回结构中的任何一个key
【要求】
Insert、delete和getRandom方法的时间复杂度都是O(1)。(leetcode380)
思路:
对于insert,可以准备两张表,map1(str->index),map2(index->str),以及一个int size=0。比如说第一个加入的字符串是"A",则map1中存为("A",0),map2中存为(0,"A"),int size=1;第二个加入的字符串是"B",则map1中存为("B",1),map2中存为(1,"B"),int size=2;以此类推,直到size=26。
对于getrandom,没有删除行为时,size=26,由于0~25没有任何一个区域是空着的,可以做到等概率随机返回对应的字符串。如果删除若干个字符串,由于随机数对应的区域可能是空的,需要试很多次才能得到可行的返回字符串,因此要保证index区域是连续的。假设删除的是D这个记录,那么就用最后一行的Z(index最后1条记录)来填补D的空缺,对于map1和map2中index=25的记录消失,Z对应的记录变为("Z",3)(3,"Z"),那么在0-24这个区间上就变得连续了。
代码:
java
package Class009;
import java.util.HashMap;
public class Code_RandomPool {
    public static class Pool<K>{
        private HashMap<K, Integer>keyIndexMap;
        private HashMap<Integer,K>indexKeyMap;
        private int size;
        public Pool(){
            this.keyIndexMap=new HashMap<K,Integer>();
            this.indexKeyMap=new HashMap<Integer,K>();
            this.size=0;
        }
        public void insert(K key){
            if(!this.keyIndexMap.containsKey(key)){
                this.keyIndexMap.put(key,this.size);
                this.indexKeyMap.put(this.size++,key);
            }
        }
        public void delete(K key){
            if (this.keyIndexMap.containsKey(key)){
                int deleteIndex=this.keyIndexMap.get(key);
                int lastIndex=--this.size;
                K lastKey=this.indexKeyMap.get(lastIndex);
                this.keyIndexMap.put(lastKey,deleteIndex);
                this.indexKeyMap.put(deleteIndex,lastKey);
                this.keyIndexMap.remove(key);
                this.indexKeyMap.remove(lastIndex);
            }
        }
        public K getRandom(){
            if (this.size==0){
                return null;
            }
            int randomIndex=(int) (Math.random()*this.size);//0~size-1
            return this.indexKeyMap.get(randomIndex);
        }
        public static void main(String [] args){
            Pool<String>pool=new Pool<String>();
            pool.insert("zuo");
            pool.insert("cheng");
            pool.insert("yun");
            System.out.println(pool.keyIndexMap);
            System.out.println(pool.indexKeyMap);
            System.out.println(pool.getRandom());
            System.out.println("\n===== 删除 cheng =====");
            pool.delete("cheng");
            System.out.println(pool.keyIndexMap);
            System.out.println(pool.indexKeyMap);
            System.out.println("size = " + pool.size);
        }

    }
}
运行结果:
java
{yun=2, zuo=0, cheng=1}
{0=zuo, 1=cheng, 2=yun}
cheng

===== 删除 cheng =====
{yun=1, zuo=0}
{0=zuo, 1=yun}
size = 2
2.布隆过滤器
布隆过滤器(Bloom Filter)是一种利用"bit数组 + 多个哈希函数"实现的概率型数据结构,用来快速判断一个元素是否属于某个超大集合(常用机器的内存可以运行。且容许非常小的失误(比如万分之一),比如将白名单列入黑名单)。
特点:
- 占用内存很小。
- 查询速度很快,通常接近O(1)。
- 如果判断"不存在",则一定不存在。
- 如果判断"存在",则只是可能存在,有一定误判率。
例如有100亿个危险URL,每个URL最长64Byte,希望限制用户访问这些URL。
如果直接保存所有URL:
100亿 × 64Byte ≈ 640GB
还没有计算HashMap等数据结构的额外空间,内存开销非常大。
使用布隆过滤器时,不直接保存URL,而是准备一个很大的bit数组:
0 0 0 0 0 0 0 0 0 ...
再准备多个哈希函数,例如:
hash1(url)
hash2(url)
hash3(url)
加入危险URL:
例如:
url = "bad.com"
计算得到:
hash1 -> 2
hash2 -> 7
hash3 -> 11
于是把bit数组中的2、7、11位置设置为1:
0 0 1 0 0 0 0 1 0 0 0 1
↑ ↑ ↑
所有100亿个危险URL都执行同样的操作。
查询时:
用户访问:
"abc.com"
通过三个哈希函数得到:
hash1 -> 2
hash2 -> 5
hash3 -> 11
检查对应位置:
2号位置 = 1
5号位置 = 0
11号位置 = 1
只要其中有一个位置是0:
说明"abc.com"一定没有加入过布隆过滤器,
因此一定不是这100亿个危险URL之一。
如果三个位置全部为1:
1 1 1
只能说明:
这个URL"可能"属于危险URL。
因为这些1也可能是其他URL产生的哈希结果。
因此实际流程通常是:
用户访问URL
↓
布隆过滤器
↓
只要有一个bit=0
↓
一定不在危险URL集合
↓
直接放行
所有bit都是1
↓
可能是危险URL
↓
再去数据库或真实URL集合中确认
↓
确认危险后拦截
一句话总结:
布隆过滤器用少量bit位代替大量原始数据,可以快速判断一个URL"一定不在危险集合中"还是"可能在危险集合中"。
核心特点:
判断不存在 -> 一定不存在
判断存在 -> 可能存在,有误判可能
因此特别适合100亿URL这种"数据量巨大、查询次数很多"的场景。
接下来介绍一下位图(bit arr,或bit map)。
int 类型的数组,设其长度为100,占400Byte,共有0\~99个格子,每个格子4字节,总共32bit
long 类型的数组,设其长度为100,占800Byte,共有0\~99个格子,每个格子8字节,总共64bit
那么能不能有以下数组:
bit 类型的数组,设其长度为100,占100/8Byte,共有0\~99个格子,总共1bit?
方法是用基础数据类型拼。
示例代码:
java
package Class009;

public class Code_BitMap {
    public static void main(String [] args){
        int a=0;
        //a 32bit
        int[] arr=new int[10];//32bit*10->320bit
        //arr[0] int 0~32
        //arr[1] int 32~63
        //arr[2] int 64~95
        int i=178;//想取得178个bit的状态
        int numIndex=178/32;//定位出应该在哪个数上找
        int bitIndex=178%32;//定位到哪个位

        //拿到178位的状态,这个数右移bitIndex位,那么这个位的信息跑到了最右侧,
        // 然后把它和1与操作,得到了这个位的状态
        //这个位上是1,那么s就是1;这个位上如果是0,那么s就是0
        int s=((arr[numIndex]>>(bitIndex))&1);

        //请把178位的状态改为1
        //1先向左移bitIndex位,然后将这个位上找到的数相或,将老信息改成新信息
        arr[numIndex]=arr[numIndex]|(1<<(bitIndex));

        //请把178位的状态改为0
        //1先向左移bitIndex位后取反,然后将这个位上找到的数相与,将老信息改成新信息
        i=178;
        arr[numIndex]=arr[numIndex]&(~(1<<bitIndex));

        //请把178位的状态拿出来
        i=178;
        //bit 0 1
        int bit=(arr[i/32]>>(i%32))&1;
    }
}
解释:
java
可以直接把 Bitmap 理解成:用一个 int 的 32 个二进制位,分别保存 32 个状态。

例如:

int[] arr = new int[10];

一个 int 有 32bit,所以:

arr[0] 管理第 0~31 位
arr[1] 管理第 32~63 位
arr[2] 管理第 64~95 位
...
arr[5] 管理第 160~191 位

现在:

i = 178

先定位:

numIndex = 178 / 32 = 5
bitIndex = 178 % 32 = 18

所以第178个状态,其实就是:

arr[5] 的第18个bit


一、查询第178位的状态

代码:

int s = (arr[5] >>> 18) & 1;

假设 arr[5] 的二进制状态是:

00000000 00000100 00000000 00000000
              ↑
           第18位是1

用汇编思想理解:

MOV EAX, arr[5]
SHR EAX, 18

也就是把整个32位数据向右移动18位。

原来:

00000000 00000100 00000000 00000000
              ↑
           第18位

右移18位以后:

00000000 00000000 00000000 00000001
                                       ↑
                                     最低位

目标bit被移动到了最右边。

然后:

AND EAX, 1

即:

00000000 00000000 00000000 00000001
&
00000000 00000000 00000000 00000001
-----------------------------------
00000000 00000000 00000000 00000001

所以:

s = 1

说明第178位状态是1。

如果第178位原来是0:

00000000 00000000 00000000 00000000

右移18位后最低位也是0:

00000000 00000000 00000000 00000000

再 & 1:

结果 = 0

所以查询可以理解成:

右移:
把目标bit搬到最右边

& 1:
只保留最右边这一位

因此:

(arr[i / 32] >>> (i % 32)) & 1

就是"取出第i位的状态"。


二、把第178位状态改成1

代码:

arr[5] = arr[5] | (1 << 18);

先看:

1 << 18

汇编思想:

MOV EAX, 1
SHL EAX, 18

最开始:

00000000 00000000 00000000 00000001

左移18位:

00000000 00000100 00000000 00000000
              ↑
           第18位是1

这个数叫"掩码"。

假设原来的 arr[5]:

00000000 00000000 00000000 00001010

和掩码做 OR:

原数据:
00000000 00000000 00000000 00001010

掩码:
00000000 00000100 00000000 00000000

OR:
00000000 00000100 00000000 00001010
              ↑
           第18位变成1

为什么?

因为:

0 | 1 = 1
1 | 1 = 1

所以目标位置无论原来是0还是1,最后一定是1。

而其他位置掩码都是0:

x | 0 = x

所以其他bit保持不变。

因此:

arr[i / 32] |= 1 << (i % 32);

意思就是:

制造一个"只有目标位置是1"的掩码,
然后用 OR 把目标bit打开。


三、把第178位状态改成0

代码:

arr[5] = arr[5] & (~(1 << 18));

先生成:

1 << 18

得到:

00000000 00000100 00000000 00000000
              ↑
              1

然后取反:

~(1 << 18)

得到:

11111111 11111011 11111111 11111111
              ↑
              0

也就是说:

目标位置 = 0
其他位置 = 1

假设原数据:

00000000 00000100 00000000 00001010
              ↑
           第18位为1

做 AND:

原数据:
00000000 00000100 00000000 00001010

掩码:
11111111 11111011 11111111 11111111

AND:
00000000 00000000 00000000 00001010
              ↑
           第18位被清零

因为:

x & 0 = 0
x & 1 = x

所以:

目标位置和0与 -> 强制变成0
其他位置和1与 -> 保持原值

因此:

arr[i / 32] &= ~(1 << (i % 32));

意思就是:

先制造一个"只有目标位置是0"的掩码,
再通过 AND 把目标bit关闭。


四、完整例子

假设:

int[] arr = new int[10];
int i = 178;

开始时:

arr[5] =
00000000 00000000 00000000 00000000

第178位状态:

0


执行:

arr[5] |= (1 << 18);

变成:

00000000 00000100 00000000 00000000
              ↑
           第178位=1


查询:

(arr[5] >>> 18) & 1

过程:

00000000 00000100 00000000 00000000
              ↓ 右移18位

00000000 00000000 00000000 00000001

& 1

结果:

1


然后执行:

arr[5] &= ~(1 << 18);

变成:

00000000 00000000 00000000 00000000

再次查询:

(arr[5] >>> 18) & 1

结果:

0


最终可以这样记:

查询某位:

右移 -> 把目标bit移动到最右边
& 1 -> 只保留这一位

设置为1:

1左移 -> 制造目标位为1的掩码
OR -> 把目标位强制变成1

设置为0:

1左移 -> 找到目标位
取反 -> 让目标位变成0,其余都是1
AND -> 把目标位强制变成0


从汇编角度可以近似理解成:

查询:
MOV
SHR
AND

置1:
MOV
SHL
OR

置0:
MOV
SHL
NOT
AND

所以 Bitmap 的本质就是:

利用 CPU 的 SHL、SHR、AND、OR、NOT 等位运算指令,直接操作整数内部的某一个二进制位。
最后来解释布隆过滤器。(leetcode705)
布隆过滤器可以看成一个大位图(长度为m,类型为bit,占用m/8字节的内存),同时有k个哈希函数。
第一个url,记为u1,先通过哈希函数f1得到out1,out1%m,得到它在0~m-1中的位置(哪个格子),接着把这个位置描黑;第一个url同样,记为u1,先通过哈希函数f2得到out2,out2%m,得到它在0~m-1中的位置(哪个格子),接着也把这个位置描黑......假设有k个哈希函数,那么url1会调用k个哈希函数,得到k个位置,有可能两或多个个格子一样,也有可能都不同;
同样的,url2,也调用k个哈希函数得到k个位置,也把这些位置描黑......直到url(100亿),每个url都如此操作。这样,布隆过滤器版本的黑名单集合建立好了。
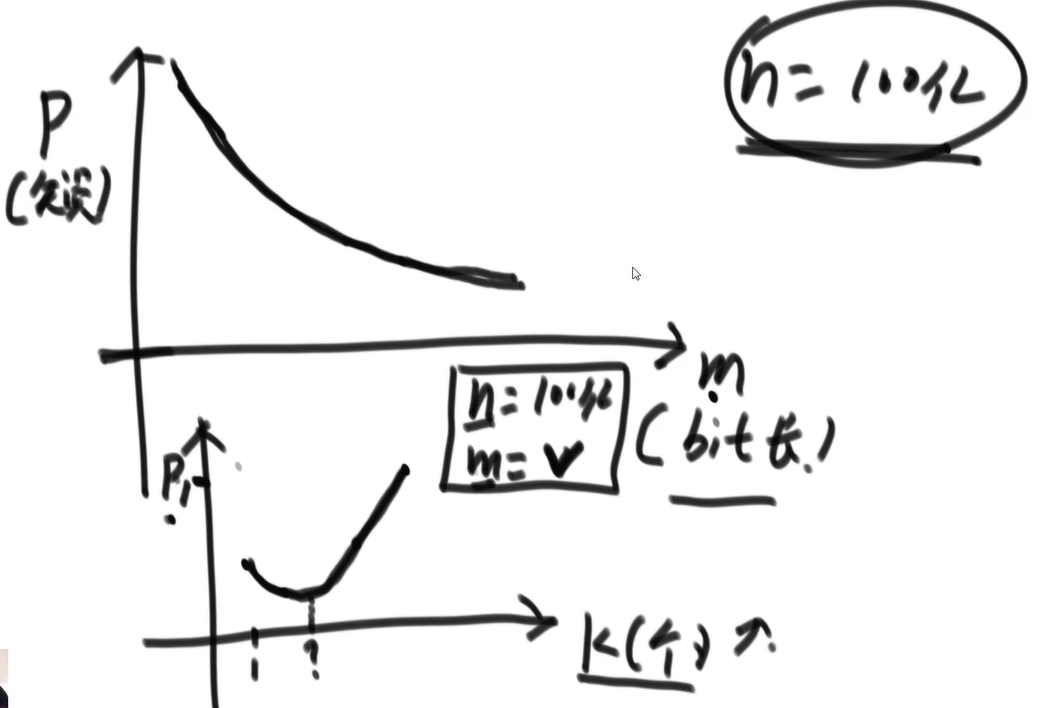
接下来我们对这个黑名单进行查询,对于某一个urlx,算k个哈希函数,得到的值都%m,然后在位图中拿状态,只有位图中全是1的时候,那么urlx在这个集合里面,有一个位置不是1,那么urlx就不在这个集合里面。一旦有一个位置是白,那么就说明这个urlx之前没有映射过,则必然不存在于黑名单中。失误的情形,第一在于m的数量非常小,经过100亿次映射的时候,m个格子都被占满了,无论怎么查都是黑名单;第二在于哈希函数k的多少,如果k的规模很大,那么特征采集的点就会变得非常密集;第一种是有决定作用的,而第二种中的k应该根据m的大小来定多少。设m是轴,P是失误比率为y轴,在n=100亿时,P与m成反比例关系;设k是轴,P是失误比率为y轴,在n=100亿时,P与k成开口向上的二次函数关系关系。利用两个图像可以决定m和k的关系。如图所示:
接下来给出三个公式,用以设计布隆过滤器(面试套路),数学推导略。
条件:n=样本量,P=失误率
判断:是不是集合查询结构,有没有失误率限制?注意,它与单样本大小无关。
(1)m=-n*lnp/(ln2)^2,如果失误率为0.0001,带入算出m的值,除以8得到比特值,接着计算出n约为26G,
(2)k=ln2*m/n=0.7*m/n(向上取整)
(3)P(真)=(1-e^(-n*k(真)/m(真)))^(k(真))
示例:
java
三个公式可以分别理解成三个问题:

条件:
n = 样本量
P = 允许的误判率
m = 位图长度,单位是 bit
k = 哈希函数个数

注意:布隆过滤器只关心"有多少个样本"和"允许多大的误判率",与单个样本本身占多少字节基本无关。


(1)计算位图大小 m

公式:

m = -n * ln(P) / (ln2)^2

作用:

已知:
n = 样本数量
P = 允许误判率

求:
需要多大的位图 m


计算样例:

假设:

n = 100亿
  = 10,000,000,000

P = 0.0001

已知:

ln(0.0001) ≈ -9.2103
ln2 ≈ 0.6931
(ln2)^2 ≈ 0.48045

代入:

m
= -100亿 × (-9.2103) / 0.48045

≈ 1917亿 bit

所以需要的位图长度约为:

1917亿 bit

转换成字节:

1917亿 / 8
≈ 239.6亿 Byte

约:

23.96 GB

所以可以记:

100亿个样本
允许误判率 0.0001
大约需要 24GB 的位图。

注意:

m / 8 得到的是 Byte,不是 bit。


(2)计算哈希函数数量 k

公式:

k = ln2 * m / n

也可以近似写成:

k ≈ 0.7 * m / n

作用:

已经知道位图大小 m 和样本量 n,
计算每个样本应该经过多少个哈希函数最合适。


计算样例:

沿用上面的数据:

m ≈ 1917亿 bit
n = 100亿

代入:

k
= 0.693 × 1917亿 / 100亿

= 0.693 × 19.17

≈ 13.29

所以最优的哈希函数数量大约是:

13.29个

但哈希函数不可能有0.29个,所以只能取整数。

可以取:

13个

或者按照"向上取整"的规则:

14个

也就是说:

每加入一个URL,大约计算13~14次哈希,
在位图中设置13~14个位置。


(3)计算实际误判率 P(真)

公式:

P(真)
= (1 - e^(-n*k(真)/m(真))) ^ k(真)

作用:

实际程序中使用的 m 和 k 往往经过取整,
所以用这个公式检查实际误判率到底是多少。


计算样例:

假设最终实际采用:

n = 100亿

m(真) = 1917亿 bit

k(真) = 13

代入:

P(真)
=
(1 - e^(-100亿 × 13 / 1917亿))^13

先算指数部分:

100亿 × 13 / 1917亿
≈ 0.678

所以:

P(真)
≈ (1 - e^(-0.678))^13

≈ 0.00010013

也就是:

P(真) ≈ 0.010013%

非常接近最初要求的:

P = 0.0001
  = 0.01%


如果实际使用14个哈希函数:

k(真) = 14

则:

P(真)
≈ 0.00010079

也就是:

约0.010079%

也非常接近目标。


三个公式可以这样记:

第一步:

n + P
↓
算m

m = -n * ln(P) / (ln2)^2

回答:

"需要多大的位图?"


第二步:

m + n
↓
算k

k = ln2 * m/n
≈ 0.7 * m/n

回答:

"需要几个哈希函数?"


第三步:

实际m + 实际k + n
↓
算P真

P真 = (1-e^(-nk/m))^k

回答:

"最终真实误判率是多少?"


完整样例:

n = 100亿
P = 0.0001

第一步:
m ≈ 1917亿 bit
≈ 24GB

第二步:
k ≈ 13.29
取13或14

第三步:
如果k=13:

P真 ≈ 0.00010013

≈ 0.010013%

所以这个布隆过滤器基本满足最初要求。
3.一致性哈希原理
主要是用来讨论数据服务器的问题。
可以将它们分为逻辑端和数据端两部分,逻辑端是可以一致的,但数据端可能会分布式存储(机器1,机器2,......机器n),比如将姓名表中的"name:key"字段记录,通过hash函数得到不同的hash值,存到不同的机器上(每个机器存储不同hash值的字段)。hash key的选择,要让不同机器上高中低频率的数据尽量平衡(比如,一个几百万行的表,name,country,sex,如果选择country字段,那么印度和中国的数据最多,对应服务器负载大;如果选择sex,那么通常情况下只有两种划分,两台服务器负载特别大;如果选择name划分,由于A-Z均匀分布,可以做到不同数据服务器负载均衡。)。
此外,如果开拓海外市场,数据量扩充要求增加几台数据机器,所有数据机器都需要重新计算hash值来存储数据,数据迁移的代价特别大。那么如何减少这个代价?此时需要采用一致性hash原理。
在md5算法中,输入经过映射可以得到0~2^64-1个范围内的数,我们把这2^64个数想象成一个环。假设有三台机器:m1,hostname1;m2,hostname2;m3,hostname3。h1经过hash运算可以得到hashcode;h2经过hash运算可以得到hashcode;h3经过hash运算可以得到hashcode。将这三台机器插入到这个环里面去,m1-hash->10亿,m2-hash->5347亿,m3-hash->7万万亿,按照顺时针依次排列,(m1~m2)归属于m2,(m2~m3)归属于m3,(m3~m1)归属于m1。假设"zuo"这个字符串经过hash运算后,得到一个数(假设是3457亿),就按照之前机器的分布,顺时针找离它最近的机器,也就是m2。
此时假设加入一台m4机器(3万万亿)位于m2和m3之前,则数据划分区域变成了:(m1~m2)归属于m2,(m2~m4)归属于m4,(m4~m3)归属于m3,(m3~m1)归属于m1.此时,m4只需要向m3索取(m2,m4)之间的数据即可实现少量的数据迁移,这样比全量的数据迁移少很多开销。
就以上的讨论,此时假设减少一台m4机器(3万万亿)位于m2和m3之前,则数据划分区域变成了:(m1~m2)归属于m2,(m2~m3)归属于m3,(m3~m1)归属于m1。此时,m3只需要向m4索取原来(m4,m2)之间的数据即可实现少量的数据迁移,这样比全量的数据迁移少很多开销。
但是这样存在潜在的划分问题:机器数量很少的时候,做不到环的均衡;即使之前能够做到环的均衡,但是如果增加或减少机器的时候,环就不均衡了。
解决方案:虚拟节点技术。假设有三台机器,拥有1000个字符串:m1(a1,a2,a3,......a1000),m2(b1,b2,b3,......b1000),m3(c1,c2,c3,......c1000)
假设有3台真实机器:
M1
M2
M3
不是让每台机器在环上只有一个位置,而是创建很多虚拟身份:
M1#1
M1#2
M1#3
...
M1#1000

M2#1
M2#2
...
M2#1000

M3#1
M3#2
...
M3#1000
然后分别 hash:
hash("M1#1")
hash("M1#2")
...
这样一共:
3000个虚拟节点被均匀打散到环上。
例如:
                  M1#2
                    ●

       M3#1                     M2#3
        ●                         ●


 M2#1                                M1#1
  ●                                   ●


       M1#3                     M3#2
        ●                         ●

                    M2#2
                     ●
虽然物理上只有:
3台机器逻辑上环中却有几千个节点。
所以每台机器会负责很多零散的小区间,而不是一个巨大的连续区间。
结果就更加接近:
M1 ≈ 1/3
M2 ≈ 1/3
M3 ≈ 1/3
如果要增加一台机器(m4),则设置一个虚拟节点,按照比例索取m1,m2,m3上的字符串;如果要减少机器(m4),则去掉虚拟节点,按照比例将自己的字符串分配给m1,m2,m3。
M4的多个虚拟节点,随机/均匀地落在环的不同位置,每个虚拟节点自动接管它前面的区间。因为虚拟节点很多,统计结果自然接近从多台机器分别拿走一部分数据。
此外,如果不同机器的性能不同(比如m1可以管理1500个字符串,m2可以管理1000个字符串,m3只能管理500个字符串),还可以利用虚拟节点来调整m1和m3的管理的数据的量
以上是一致性哈希和redis集群之间的区别是:
经典一致性哈希:hash环 + 虚拟节点
Redis Cluster:固定16384个hash slots + 节点负责若干slots