文章目录
- 前言
- 一、派生类的默认成员函数
-
- 1.派生类的默认构造
- 2.派生类的拷贝构造函数
- [3.派生类的赋值运算符 operator=](#3.派生类的赋值运算符 operator=)
- 4.派生类的析构函数
- 5.派生类的调用顺序
- 二、实现一个不能被继承的类
- 三、继承的特殊情况
- 四、多继承及其菱形继承问题
- 五、继承和组合
前言
本篇博客是对C++继承知识剩余的内容做的补充。
一、派生类的默认成员函数
6个默认成员函数,默认的意思就是指我们不写,编译器会帮我们自动生成一个,那么在派生类中,这几个成员函数是如何生成的呢?
1.派生类的默认构造
派生类的构造函数必须调用基类的构造函数初始化基类的那一部分成员。如果基类没有默认的构造函数,则必须在派生类构造函数的初始化列表阶段显式调用。
1.基类存在默认构造函数
如果基类有可访问的无参默认构造函数,派生类构造函数可以不显式调用。编译器会自动在派生类构造函数的初始化列表阶段,插入基类默认构造函数的调用。
cpp
class Base {
public:
    Base() { cout << "Base默认构造" << endl; }
};

class Derived : public Base {
public:
    Derived() { cout << "Derived构造" << endl; }
    // 编译器自动等价于:Derived() : Base() { ... }
};
2.基类没有默认构造函数
如果基类只定义了带参构造函数(编译器不会再生成默认构造),那么派生类的所有构造函数都必须在初始化列表中显式调用基类的某个带参构造函数,否则编译直接报错。
cpp
class Base {
public:
    int a;
    Base(int x) : a(x) { cout << "Base带参构造" << endl; }
};

class Derived : public Base {
public:
    int b;
    // 错误:编译器无法自动调用Base的默认构造(不存在)
    // Derived(int x, int y) : b(y) {}

    // 正确:初始化列表显式调用基类带参构造
    Derived(int x, int y) : Base(x), b(y) {
        cout << "Derived构造" << endl;
    }
};
2.派生类的拷贝构造函数
拷贝构造是特殊的构造函数,同样遵循 "先基类后派生类" 的初始化顺序。
派生类的拷贝构造函数必须显式调用基类的拷贝构造函数,否则编译器会自动调用基类的默认构造函数,导致基类子对象被默认初始化,而非拷贝源对象的基类部分,出现 "拷贝不完整" 的切片问题。
cpp
class Base {
public:
    int a;
    Base(int x = 0) : a(x) {}
    Base(const Base& other) : a(other.a) {
        cout << "Base拷贝构造" << endl;
    }
};

class Derived : public Base {
public:
    int b;
    Derived(int x = 0, int y = 0) : Base(x), b(y) {}

    // 正确:显式调用基类拷贝构造
    Derived(const Derived& other) : Base(other), b(other.b) {
        cout << "Derived拷贝构造" << endl;
    }
};
错误写法:不调用Base拷贝构造
Derived(const Derived& other) : b(other.b) {}
编译器自动调用Base()默认构造,基类a被初始化为0,而非other.a
3.派生类的赋值运算符 operator=
派生类的operator=必须要调用基类的operator=完成基类的复制。需要注意的是派生类的operator=隐藏了基类的operator=,所以显式调用基类operator=,需要指定基类作用域。
cpp
class Base {
public:
    int a;
    Base(int x = 0) : a(x) {}
    Base& operator=(const Base& other) {
        if (this != &other) {
            a = other.a;
            cout << "Base赋值运算符" << endl;
        }
        return *this;
    }
};

class Derived : public Base {
public:
    int b;
    Derived(int x = 0, int y = 0) : Base(x), b(y) {}

    Derived& operator=(const Derived& other) {
        if (this != &other) {        // 自赋值检查,避免自己给自己赋值出错
            Base::operator=(other);  // 显式调用基类赋值运算符,必须加Base::作用域
            b = other.b;             // 处理派生类自身成员
            cout << "Derived赋值运算符" << endl;
        }
        return *this; // 支持链式赋值
    }
};
4.派生类的析构函数
派生类的析构函数会在被调用完成后自动调用基类的析构函数清理基类成员。因为这样才能保证派生类对象先清理派生类成员再清理基类成员的顺序。
cpp
class Base {
public:
    ~Base() { cout << "Base析构" << endl; }
};

class Derived : public Base {
public:
    ~Derived() { cout << "Derived析构" << endl; }
};

// 定义局部对象 Derived d; 程序输出顺序:
// Derived析构
// Base析构
无需显式调用基类析构:派生类析构函数中不需要手动写Base::~Base(),编译器会自动在派生类析构的末尾插入基类析构的调用。
5.派生类的调用顺序
派生类对象初始化先调用基类构造再调派生类构造,派生类对象析构清理先调用派生类析构再调基类的析构。
即初始化时先父后子,析构时先子后父。
原因 :
因为派生类可能依赖基类的资源运行,必须先释放派生类的资源(可能还在使用基类成员),再释放基类资源;反之如果先释放基类,派生类析构时再访问基类资源就会出现野访问错误。
同时为什么要子类自动调用父类的析构函数,也是因为了,保证这个顺序。
特殊点 :
因为多态中一些场景析构函数需要构成重写,重写的条件之一是函数名相同。那么编译器会对析构函数名进行特殊处理,处理成destructor(),所以基类析构函数不加virtual的情况下,派生类析构函数和基类析构函数构成隐藏关系。这里后边的多态我会详细介绍。
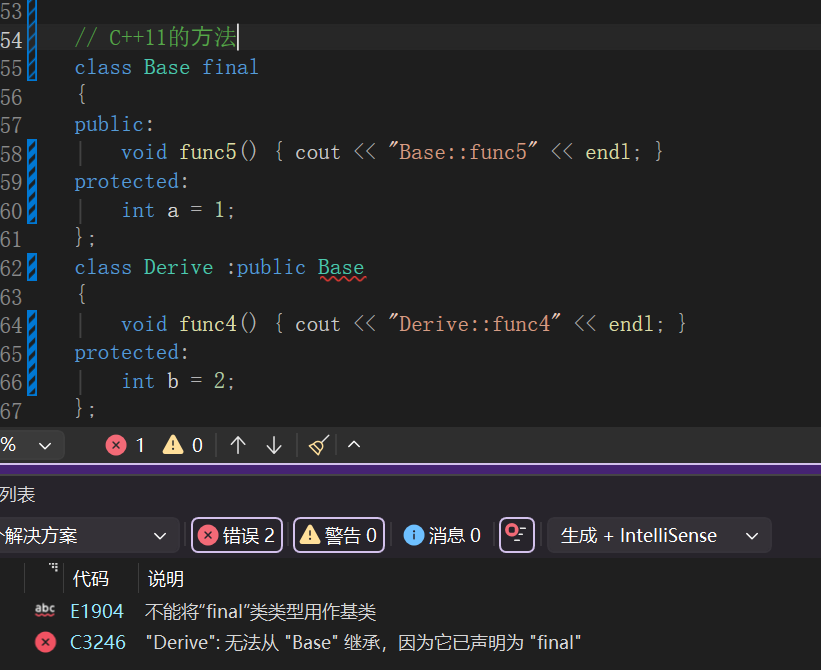
二、实现一个不能被继承的类
方法一
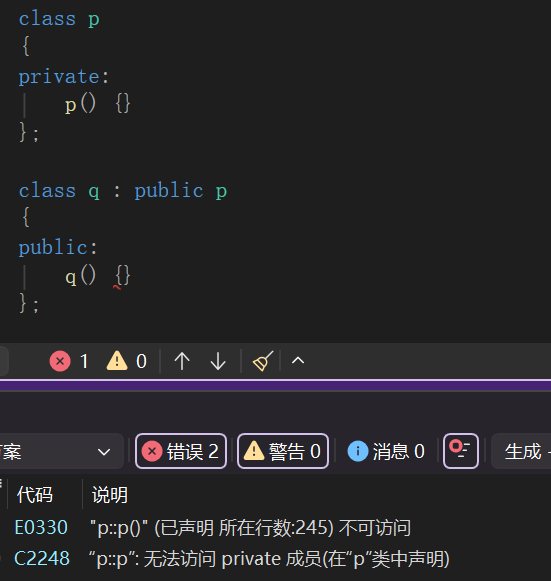
基类的构造函数私有,派生类的构成必须调用基类的构造函数,但是基类的构造函数私有化以后,派生类看不见就不能调用了,那么派生类就无法实例化出对象。
方法二
三、继承的特殊情况
1.继承与友元
友元关系不能继承,也就是说基类友元不能访问派生类私有和保护成员 。
其实也很好理解,你父亲的朋友,不可能一定是你的朋友。
cpp
class Student;
class Person
{
public:
	friend void Display(const Person& p, const Student& s);
protected:
	string _name; // 姓名

};
class Student : public Person
{
protected:
	int _stuNum; // 学号
};
void Display(const Person& p, const Student& s)
{
	cout << p._name << endl;
	cout << s._stuNum << endl;
}
int main()
{
	Person p;
	Student s;
	// 编译报错:error C2248 : "Student::_stuNum" :⽆法访问protected成员
	// 解决⽅案:Display也变成Student的友元即可
	Display(p, s);
	return 0;
}
另外这里的小细节是前置声明class是为了告诉编译器这是个类
2.继承与静态成员
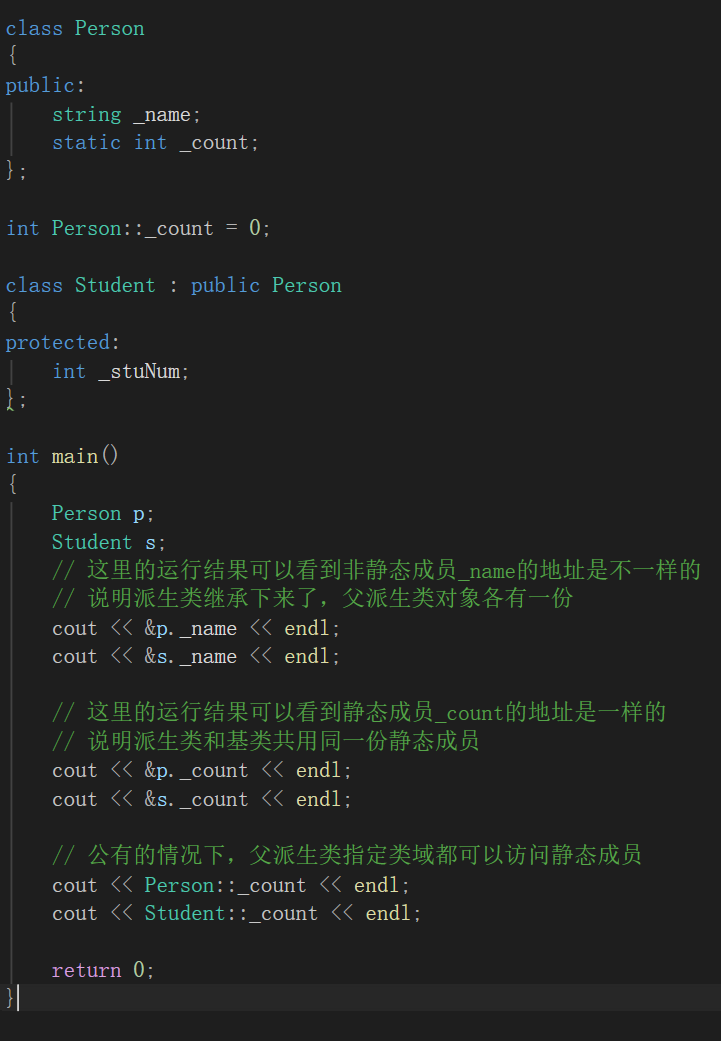
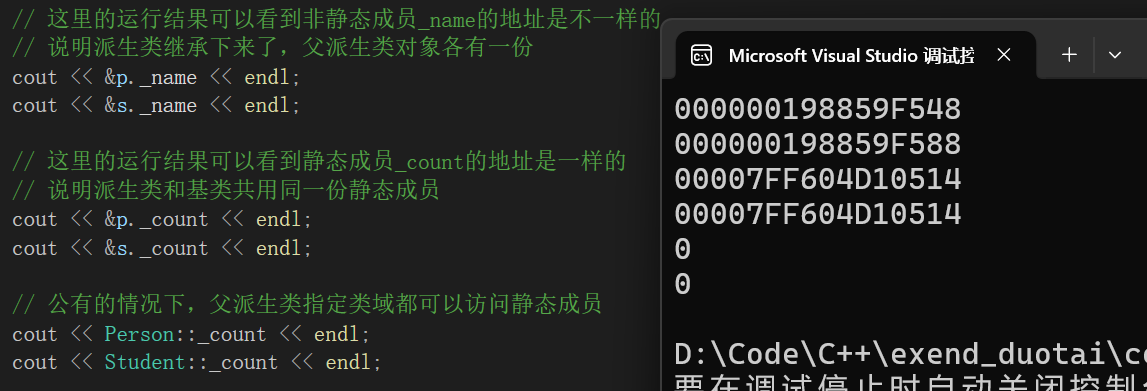
基类定义了static静态成员,则整个继承体系里面只有一个这样的成员。无论派生出多少个派生类,都只有一个static成员实例。
- 可继承性:派生类会继承基类的静态成员变量和静态成员函数,访问权限由基类成员的访问级别 + 继承方式共同决定,规则与普通非静态成员完全一致。
- 全局唯一性:整个继承层次中,基类的静态成员只有唯一一份实例,所有派生类、所有对象共享该静态成员,内存地址完全相同。
- 初始化规则:静态成员变量必须在类外全局初始化,且只能由定义它的基类完成初始化,派生类不能初始化基类的静态成员。
四、多继承及其菱形继承问题
1.继承模型
-
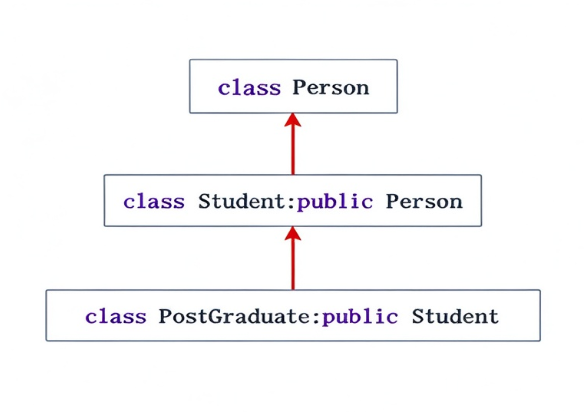
单继承:一个派生类只有一个直接基类时称这个继承关系为单继承
-
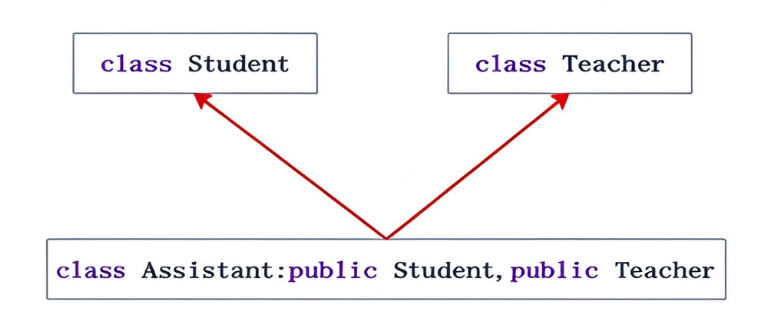
多继承:一个派生类有两个或以上直接基类时称这个继承关系为多继承,多继承对象在内存中的模型是,先继承的基类在前面,后面继承的基类在后面,派生类成员放到最后面。
-
菱形继承:菱形继承是多继承的一种特殊情况。菱形继承的问题,从下面的对象成员模型构造,可以看出菱形继承有数据冗余和二义性的问题,在 Assistant 的对象中 Person 成员会有两份。支持多继承就一定会有菱形继承,像 Java 就直接不支持多继承,规避掉了这里的问题,所以实践中我们也是不建议设计出菱形继承这样的模型的。
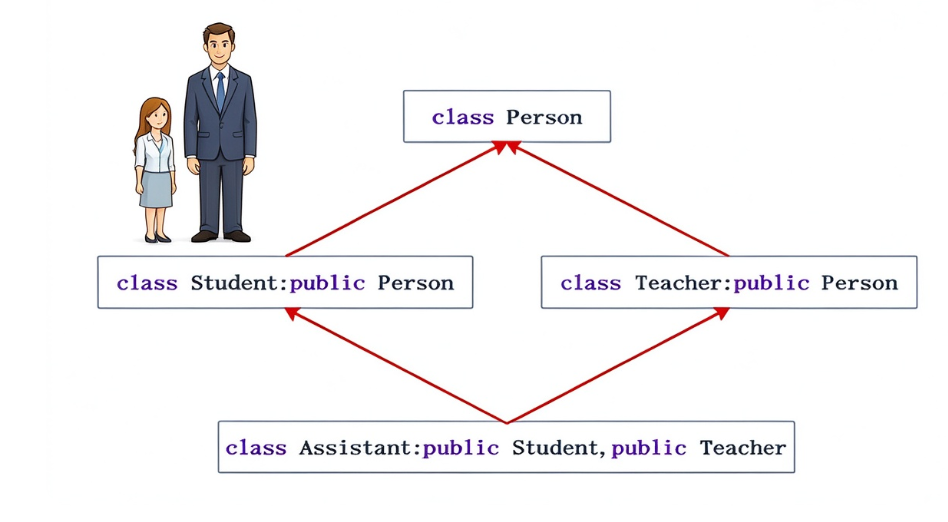
其实从现实出发一个人,怎么可能有多个父亲。这里确实是c++会产生一些问题的地方。
cpp
using namespace std;

class Person
{
public:
    string _name; // 姓名
};

class Student : public Person
{
protected:
    int _num; //学号
};

class Teacher : public Person
{
protected:
    int _id; // 职工编号
};

class Assistant : public Student, public Teacher
{
protected:
    string _majorCourse; // 主修课程
};

int main()
{
    // 编译报错: error C2385: 对"_name"的访问不明确
    Assistant a;
    a._name = "peter";


    a.Student::_name = "xxx";
    a.Teacher::_name = "yyy";

    return 0;
}
这里产生的两个核心问题
-
数据冗余
在普通继承机制下,B 和 C 都会各自继承一份 A 的完整成员(比如上面的person的name对象);当 D 同时继承 B 和 C 时,D 的对象中会包含两份独立的 A 类子对象(一份通过 B 路径继承,一份通过 C 路径继承),造成内存数据冗余。
-
访问二义性
由于 D 对象中存在两份 A 的成员,当直接访问 A 中的成员时,编译器无法判断要访问的是 B 路径下的 A 成员,还是 C 路径下的 A 成员,会产生二义性编译错误。
cpp
 a.Student::_name = "xxx";
 a.Teacher::_name = "yyy";
显示指定访问哪个基类的成员可以解决二义性问题,但是数据冗余问题无法解决。
2.虚继承
这时候就需要虚继承的出现。很多人说 C++ 语法复杂,其实多继承就是一个体现。有了多继承,就存在菱形继承,有了菱形继承就有菱形虚拟继承,底层实现就很复杂,性能也会有一些损失,所以最好不要设计出菱形继承。多继承可以认为是 C++ 的缺陷之一,后来的一些编程语言都没有多继承,如 Java。后续我们的学习中我们会发现,c++有很多为了修补某些错误,而设计出来的语法,比如说的多态里的虚函数。
cpp
class Person
{
public:
    string _name; // 姓名
    /*int _tel;
    int _age;
    string _gender;
    string _address;*/
    // ...
};

// 使用虚继承Person类
class Student : virtual public Person
{
protected:
    int _num; //学号
};

// 使用虚继承Person类
class Teacher : virtual public Person
{
protected:
    int _id; // 职工编号
};

// 教授助理
class Assistant : public Student, public Teacher
{
protected:
    string _majorCourse; // 主修课程
};

int main()
{
    // 使用虚继承,可以解决数据冗余和二义性
    Assistant a;
    a._name = "peter";

    return 0;
}-
使用
记住在两个中间派生类第一次继承顶层基类时,使用virtual关键字修饰继承方式,声明为虚继承:
-
原理
虚继承的底层依赖虚基类指针(vbptr, virtual base pointer)和虚基类表(vbtable, virtual base table)实现:
虚基类表(vbtable):每个使用虚继承的类,编译器会生成一张虚基类表,表中存储虚基类子对象相对于当前类起始地址的偏移量。
虚基类指针(vbptr):每个派生类对象中会包含一个虚基类指针,指向自身对应的虚基类表。
当最终派生类 D 访问虚基类 A 的成员时:
通过 D 对象中 B 部分的vbptr找到 B 的虚基类表;
从表中读取 A 子对象相对于 B 的偏移量;
加上 B 的起始地址,计算出唯一的 A 子对象地址,完成成员访问。
通过这种偏移寻址,保证了无论有多少条继承路径,最终都指向同一份虚基类子对象。
3.具体实例
- 问题一:运行结果为多少。
cpp
class Person
{
public:
    Person(const char* name)
        :_name(name)
    {}
    string _name;
};

// virtual public 虚继承
class Student : virtual public Person
{
public:
    Student(const char* name, int num)
        :Person(name)  // 虚继承场景:这个Person构造【不会执行】
        , _num(num)
    {}
protected:
    int _num;
};

class Teacher : virtual public Person
{
public:
    Teacher(const char* name, int id)
        :Person(name)  // 虚继承场景:这个Person构造【不会执行】
        , _id(id)
    {}
protected:
    int _id;
};

class Assistant : public Student, public Teacher
{
public:
    Assistant(const char* name1, const char* name2, const char* name3)
        :Person(name3)   // 【唯一执行的Person构造】
        , Student(name1, 1)
        , Teacher(name2, 2)
    {}
protected:
    string _majorCourse;
};

int main()
{
    Assistant a("张三", "李四", "王五");
    return 0;
}
这里最终的运行结果为王五
虚继承 virtual public:整个继承体系只存在一份虚基类 Person。虚基类的构造,由最底层派生类(这里就是 Assistant)负责调用!上层子类 Student、Teacher 初始化列表里写的Person(...),编译器直接跳过,不调用。
所以执行顺序:
Assistant初始化列表先执行:Person(name3) → Person("王五"),_name="王五"
接着构造Student(name1,1):进入 Student 构造,Student 初始化列表里Person(name1)被忽略,只初始化_num
接着构造Teacher(name2,2):进入 Teacher 构造,Person(name2)被忽略,只初始化_id
Student 里的Person("张三")、Teacher 里的Person("李四"),完全不会跑。
最终 a._name == "王五"。
- 问题二 :p1,p2,p3的关系
cpp
class Base1 {  public:  int _b1; };
class Base2 {  public:  int _b2; };
class Derive : public Base1, public Base2 { public: int _d; };
int main()
{
    Derive d;
    Base1* p1 = &d;
    Base2* p2 = &d;
    Derive* p3 = &d;
    return 0;
}
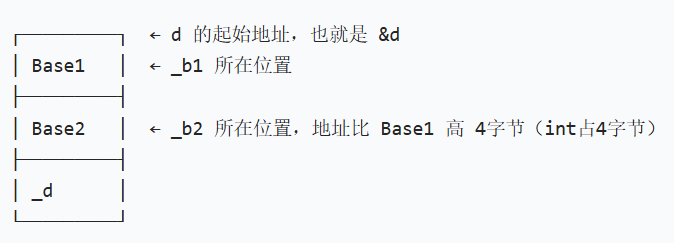
Derive* p3 = &d;:p3 保存的是整个 Derive 对象起始地址。
Base1* p1 = &d;:Base1 是第一个继承的父类,Base1 子对象刚好在 Derive 对象开头,所以p1 的值 == p3 的值。
Base2* p2 = &d;:Base2 子对象在 Base1 后面,编译器自动对指针做偏移,向后偏移sizeof(Base1)(4 字节),所以p2 地址 > p1、p3。
4.总结
我们可以设计出多继承,但是不建议设计出菱形继承,因为菱形虚拟继承以后,无论是使用还是底层都会复杂很多。
五、继承和组合
-
public 继承是一种 is-a 的关系。也就是说每个派生类对象都是一个基类对象。
继承允许你根据基类的实现来定义派生类的实现。这种通过生成派生类的复用通常被称为白箱复用 (white-box reuse)。术语 "白箱" 是相对可视性而言:在继承方式中,基类的内部细节对派生类可见。继承一定程度破坏了基类的封装,基类的改变,对派生类有很大的影响。派生类和基类间的依赖关系很强,耦合度高。
-
组合是一种 has-a 的关系。假设 B 组合了 A,每个 B 对象中都有一个 A 对象。
对象组合是类继承之外的另一种复用选择。新的更复杂的功能可以通过组装或组合对象来获得。对象组合要求被组合的对象具有良好定义的接口。这种复用风格被称为黑箱复用 (black-box reuse),因为对象的内部细节是不可见的。对象只以 "黑箱" 的形式出现。组合类之间没有很强的依赖关系,耦合度低。优先使用对象组合有助于你保持每个类被封装。
-
优先使用组合,而不是继承。实际尽量多去用组合,组合的耦合度低,代码维护性好。不过也不太那么绝对,类之间的关系就适合继承 (is-a) 那就用继承,另外要实现多态,也必须要继承。类之间的关系既适合用继承 (is-a) 也适合组合 (has-a),就用组合。